220. Yapısal konu modeli (STM)
Şablon kimliği: yapisal_konu_modeli · Kategori: metin · Dil: R · Dosya: pro/sablonlar/metin/yapisal_konu_modeli.R (satır 1–675; üstbilgi 1–221) · Örnek veri: _ornek/yapisal_konu_modeli_gadarian.csv (ikinci örnek: yapisal_konu_modeli_anayasalar.csv) · Paketler: stm 1.3-8, tm 0.7-20, SnowballC 0.7-1, stringi 1.8-7, igraph 2.3-4
220.1 Ne işe yarar
Açık uçlu anket yanıtları, haberler, tutanaklar ya da makale özetleri gibi metin koleksiyonunda gizli konuları bulur ve konuların belgelerdeki payının (yaygınlık) ve sözcük kullanımının (içerik) belge düzeyindeki ortak değişkenlerle nasıl değiştiğini kestirir (Roberts, Stewart ve Tingley, 2019; stm paketi). Her belge, K konunun karışımıdır; her konu, sözcükler üzerinde bir olasılık dağılımıdır.
- d: belge; n: belgedeki sözcük konumu; K: konu sayısı; \boldsymbol\theta_d (K boyutlu, toplamı 1): belgenin konu payları.
- \mathbf x_d: yaygınlık ortak değişkenleri (doğrusal terimler ve düzgün s() terimleri); \boldsymbol\Gamma: ortak değişken katsayıları; \boldsymbol\Sigma: konular arası kovaryans (konu korelasyonlarını verir).
- z_{d,n}: sözcüğün konusu; w_{d,n}: gözlenen sözcük; \boldsymbol\beta_{d,k}: k konusunun sözcük dağılımı; içerik ortak değişkeni varsa belgenin içerik düzeyine göre değişir.
Kestirim, değişimli (variational) EM ile yapılır; yakınsama ölçütü kanıt alt sınırının (ELBO) göreli değişimidir (220.4.3).
Ne zaman kullanılır? Metinden konuları bulmak ve konu yaygınlığının belge özellikleriyle (deney grubu, yıl, parti, yazar) ilişkisini sınamak; örnek veride "göçmenlik kaygısı" deneysel koşulunun konuları nasıl değiştirdiği.
Ne zaman kullanılmaz?
- Yalnız sınıflandırma ya da gözetimli etiketleme gerekiyorsa: bu şablon konuları gözetimsiz bulur; etiketli veri için başka yöntem gerekir (şablon yok).
- Çok kısa belgeler (birkaç sözcük) için konu kestirimi kararsızdır; belgeleri birleştirmek gerekir.
- Belgeler zamana göre sıralı ve konu dinamiği isteniyorsa: bu şablon zaman için yalnız ortak değişken kullanır (düzgün s() terimi); dinamik konu modeli değildir.
- Sözcüklerin sırası ve anlamı önemliyse (cümle düzeyi anlam): çantadaki sözcük (bag-of-words) varsayımı yetmez.
Temel programla ilişki. Temel programda metin madenciliği, metin ön işleme ya da konu modeli analizi yoktur; analiz kayıt defterinde (core/analysis_registry.py) metin verisine dönük bir analiz bulunmaz. Yakın analizler sayısal ya da kategorik veri içindir: K-Means Clustering, Hierarchical Clustering, Latent Class Analysis (LCA) ve PCA belgeleri/sütunları gruplar ya da boyut indirger, ama sözcük sayımından konu çıkarmaz ve belge düzeyinde ortak değişkenle konu yaygınlığını modellemez. Bu şablonun getirdiği: metin ön işleme (küçük harf, durak sözcük, kök bulma), konu modeli, K seçimi, konu yaygınlığı ve içerik etkileri, temsilî belgeler ve konu korelasyonları.
220.2 Şablonun girdileri
Form, üstbilgideki yirmi sekiz [[param]] bloğundan kurulur (yapisal_konu_modeli.R:12–220).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Metin sütunu · metin |
sütun · Değişkenler | boş | herhangi | Belge metni (247–250). |
Yaygınlık ortak değişkenleri (doğrusal) · yayginlik |
sütunlar · Değişkenler | boş | herhangi | Yaygınlık formülüne doğrusal (429–432). |
Yaygınlık ortak değişkenleri (düzgün, s()) · yayginlik_duzgun |
sütunlar (sayısal) · Değişkenler | boş | sayısal, \ge4 farklı değer | s() B-spline terimi (429–432). |
İçerik ortak değişkeni · icerik |
sütunlar · Değişkenler | boş | kategorik, \le20 düzey; yalnız ilki | content (433). |
Konu sayısı · K |
tamsayı · Model | 10 | 2–200 | stm(K = ) (490). |
Başlatma · baslatma |
seçim · Model | Spectral |
Spectral, LDA, Random |
init.type (490). |
Tohum (0 = çalıştırmanın tohumu) · tohum |
tamsayı · Model | 12345 | 0–2147483647 | seed, set.seed (268, 466, 584). |
Metin dili · dil |
seçim · Seçenekler | english |
13 dil | Durak sözcük, kök bulucu, küçük harf kuralı (304–383). |
Durak sözcükler · durak |
seçim · Seçenekler | otomatik |
otomatik, snowball, stopwords-iso, nltk, yok |
Durak listesi (311–345). |
Ek durak sözcükler · ek_durak |
metin · Seçenekler | boş | virgül/boşlukla ayrılmış | Küçük harfe çevrilip çıkarılır (346–353). |
Kök bulma · kok_bul |
onay · Seçenekler | açık | açık / kapalı | stem (355–362). |
Küçük harfe çevir · kucuk_harf |
onay · Seçenekler | açık | açık / kapalı | lowercase (305–310, 379). |
Sayıları sil · sayi_sil |
onay · Seçenekler | açık | açık / kapalı | removenumbers (380). |
Noktalamayı sil · noktalama_sil |
onay · Seçenekler | açık | açık / kapalı | removepunctuation (380). |
Unicode noktalamayı da sil · unicode_noktalama |
onay · Gelişmiş | kapalı | açık / kapalı | ucp (380). |
En kısa sözcük · en_kisa |
tamsayı · Seçenekler | 3 | 1–20 | wordLengths = c(en_kisa, Inf) (381). |
Seyrek terim alt eşiği · alt_esik |
tamsayı · Seçenekler | 1 | 0–100000 | prepDocuments(lower.thresh = ) (394). |
K seçimi (searchK) · k_ara |
onay · Seçenekler | kapalı | açık / kapalı | searchK (453). |
Aday K değerleri · k_adaylari |
metin · Seçenekler | 5, 10, 15, 20 |
tamsayılar | searchK(K = ) (454–460). |
En çok EM iterasyonu · en_cok_iter |
tamsayı · Gelişmiş | 500 | 1–10000 | max.em.its (468, 491). |
Yakınsama ölçütü · yakinsama |
ondalık · Gelişmiş | 0,00001 | 10^{-10}–0,01 | emtol (468, 491). |
s() serbestlik derecesi · duzgun_sd |
tamsayı · Gelişmiş | 10 | 3–30 | s(x, df = ) (429–431). |
Spectral başlatmada en çok sözcük · spektral_v |
tamsayı · Gelişmiş | 10000 | 100–100000 | control$maxV (436–443). |
Konu başına gösterilecek sözcük · sozcuk_sayisi |
tamsayı · Çıktı | 7 | 1–50 | labelTopics(n = ) (524). |
Konu başına temsilî belge · temsili_belge |
tamsayı · Çıktı | 3 | 0–20 | findThoughts (562–579). |
Temsilî belgede en çok karakter · belge_uzunlugu |
tamsayı · Çıktı | 300 | 40–5000 | Metin kesme (568–575). |
Konu korelasyonu yöntemi · korelasyon |
seçim · Çıktı | simple |
simple, huge |
topicCorr(method = ) (627–635). |
Korelasyon eşiği · korelasyon_esik |
ondalık · Çıktı | 0,01 | 0–1 | cutoff (635). |
Örnek ayar (ornek_param, satır 9): metin = open.ended.response, yayginlik = [treatment], yayginlik_duzgun = [pid_rep], K = 3, tohum = 12345, temsili_belge = 2; diğer alanlar varsayılandır.
Şablonun kendi denetimleri (mq_hata ve .uyar):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 247 |
| Metin sütunu seçilmemiş | "Metin sütununu seçin." | 249 |
| Metin sütunu ortak değişken de | "…çıkarın." | 252 |
| Aynı değişken doğrusal ve düzgün | uyarı: yalnız düzgün terim kullanıldı | 253–258 |
| Birden çok içerik değişkeni | uyarı: yalnız ilki kullanıldı | 260–265 |
| Eksiksiz belge <5 | "Eksiksiz en az 5 belge gerekli." | 286 |
| Ortak değişken sabit ya da tek düzeyli | "'…' sabit ya da tek düzeyli; çıkarın." | 287–291 |
| Düzgün terim için <4 farklı değer | "…doğrusal olarak girin." | 293–294 |
| İçerik değişkeni sayısal | uyarı: her farklı değer ayrı düzey | 293–296 |
| İçerik değişkeni >20 düzey | "…20'den çok düzey içeriyor." | 300 |
| Gerekli paketler kurulu değil | kurulum talimatı | 234–244 |
| Ön işlemeden sonra belge <5 | "…5'ten az boş olmayan belge kaldı." | 388–390 |
| K> terim sayısı | "K = … sözlükteki terim sayısından büyük." | 424 |
| K\ge belge sayısı | "K = … belge sayısından küçük olmalı." | 425 |
| İçerik değişkeni ön işlemeden sonra tek düzeyli | "…tek düzeyli kaldı." | 426 |
| Spectral başlatma başarısız | "Spectral başlatma başarısız oldu…" (başka başlatmaya geçilmez) | 489–499 |
Eksik değerler ve sütun türü. Metni boş ya da eksik olan satırlar ve ortak değişkenlerinden biri eksik olan satırlar çıkarılır ve sayıları yazılır (274–285). Ön işlemede içi boşalan belgeler ve seyrek terim süzgeciyle çıkan belgeler "Ön işleme özeti" tablosunda ayrıca görünür. Doğrusal yayginlik listesinde sayısal olarak aktarılan 0/1 sütun (örnek veride treatment) sayısal terim olarak girer (katsayı adı treatment); metin ya da kategorik sütun faktöre çevrilir ve kukla değişkenlerle girer (örnek: anayasa1961 Anayasası). Faktör düzeyleri veri sekmesinin düzey sırasıyla gelir (Bölüm 1.3) ve ilk düzey başvurudur. Tohum. Şablonun formunda kendi tohum alanı vardır (varsayılan 12345; 0–2147483647) ve çıktının ilk satırında "Tohum (seed): …" yazılır (272). Atama modeli bu değeri stm(seed =), searchK(seed =, heldout.seed =) ve set.seed() olarak kullanır. Alan 0 ya da boşsa Kod panelindeki çalıştırma tohumu (Bölüm 1.3) kullanılır (268–270); doluysa panel tohumu sonucu belirlemez ve çıktıdaki "Tohum (seed)" satırı kullanılan tohumdur. Spectral başlatma belirlenimcidir: tohum değişse de EM sonucu aynıdır; tohum yalnız estimateEffect benzetimini ve searchK'nın ayrılmış-veri bölünmesini etkiler. LDA ve Random başlatma tohuma bağlıdır (220.8).
220.3 Örnek veri
yapisal_konu_modeli_gadarian.csv, stm paketinin gadarian veri setidir (Gadarian ve Albertson, 2014; Roberts ve ark., 2014): Amerikalı katılımcıların göçmenlik konusundaki endişelerini açık uçlu soruyla yazdığı 341 yanıt. Deneysel koşul (treatment) göçmenlik konusunda kaygı uyandırıcı ya da nötr bir metin okutulmasıdır. Eksik değer yoktur; yanıtlar ortalama 22,7 sözcüktür (ortanca 14; en uzunu 183).
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
MetaID |
kullanılmaz | sayısal | belge kimliği |
treatment |
yaygınlık (doğrusal) | ikili (0/1) | 1: 171 yanıt, 0: 170 yanıt |
pid_rep |
yaygınlık (düzgün) | sayısal | Cumhuriyetçi parti kimliği; 7 farklı değer (0–1) |
open.ended.response |
metin | metin | küçük harfli İngilizce yanıt |
İkinci örnek veri yapisal_konu_modeli_anayasalar.csv: Türkiye anayasa metinlerinden madde düzeyinde 402 kayıt (1876 Kânûn-ı Esâsî 119, 1921 Teşkîlât-ı Esâsîye 23, 1924 Teşkîlât-ı Esâsîye 105, 1961 Anayasası 155 madde; metin uzunluğu ortalama 296 karakter); sütunlar anayasa, yil, madde, bolum (9 eksik), metin.
Bölümde kullanılan çalıştırmalar (dogrulama/cikti/): ykm_ornek (örnek ayar); ykm_t2 (tohum = 2); ykm_kara (k_ara, k_adaylari = 2, 3, 4, 5, 8); ykm_icerik (yayginlik = [pid_rep], icerik = [treatment]); ykm_lda, ykm_lda_t2 (baslatma = LDA, tohum 12345 ve 2); ykm_yak (en_cok_iter = 5); ykm_nostem (kok_bul = kapalı); ykm_tr (anayasalar; metin, dil = turkish, yayginlik = [anayasa], K = 4, tohum = 1, temsili_belge = 1).
220.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) metin ön işleme, (2) seyrek terim süzgeci, (3) konu modeli, (4) konu sözcükleri ve yaygınlık, (5) temsilî belgeler, (6) ortak değişken etkileri, (7) konu korelasyonları, (8) \boldsymbol\theta ve \boldsymbol\beta tabloları. İsteğe bağlı olarak (3)'ten önce K seçimi yapılır.
220.4.1 Ön işleme
tm::textProcessor (379) şu sırayla çalışır: küçük harfe çevirme, noktalama silme (sözcük içi tireler kalır), durak sözcük silme, sayı silme, Snowball kök bulma, ardından en kısa sözcük uzunluğu süzgeci. Şablon bu adımları form seçeneklerine bağlar. Sonra prepDocuments(lower.thresh) (394), en çok alt_esik belgede geçen terimleri çıkarır (varsayılan 1: yalnız bir belgede geçen terimler). Çıkarılan belge, terim ve sözcük sayıları "Ön işleme özeti" tablosuna yazılır (400–415); örnek veride sözlük 1102 terimden 462'ye iner (220.7).
Koddaki tercih
Küçük harf: Türkçede stringi::stri_trans_tolower(x, locale = "tr") (I→ı, İ→i) şablonda yapılır ve textProcessor lowercase = FALSE ile çağrılır (305–310, 379); diğer dillerde textProcessor kendi tolower'ını kullanır. Durak sözcük: dilin tm (Snowball) listesi varsa o (İngilizce 174 sözcük); yoksa (Türkçe, Arapça, Yunanca, Lehçe, Çekçe) stopwords paketinin stopwords-iso listesi (Türkçe 471 sözcük); kullanılan liste çıktıya yazılır (311–345). Kök bulma: SnowballC kök bulucusu dilde yoksa uyarı verilir ve kök bulma uygulanmaz (355–362). Türkçede kök bulucu kuralla ek kırpar; çıktıya uyarı notu yazılır (363–367).
220.4.2 Konu modeli
Model stm(documents, vocab, K, prevalence, content, data, init.type, seed, max.em.its, emtol, control) ile kurulur (489–499). Yaygınlık formülü doğrusal terimleri ve s(x) (B-spline) terimlerini birleştirir; boşsa yaygınlık ortak değişkensiz (ortak önsel) kestirilir ve estimateEffect çalıştırılmaz (434–435). İçerik formülü ~ içerik_değişkeni biçimindedir (433).
Neden Spectral başlatma
Spectral başlatma (Arora ve ark., 2013; Roberts ve ark., 2016), eş-oluşum matrisinin ayrışımından belirlenimci bir başlangıç verir: tohum bağımsızdır ve rastgele ya da LDA başlatmalarının sık düştüğü yerel eniyilerden kaçınır. Bu yüzden önerilen ve varsayılandır. Sözlük spektral_v'den büyükse (varsayılan 10000) başlatma yalnız en sık sözcüklerle yapılır ve bu uyarı olarak yazılır (436–443); kestirim bütün sözlükle sürer.
Başlatma ve yerel eniyi
Değişimli EM yerel eniyiye yakınsar. Spectral belirlenimci olsa da LDA ve Random başlatmalar tohuma bağlıdır ve farklı tohumlar farklı çözümlere (ve farklı ELBO'ya) götürür: örnek veride LDA, tohum 12345'te \mathrm{ELBO}=-18060{,}97 (318 iterasyon), tohum 2'de -18175{,}81 (248 iterasyon) verir (220.7). Şablon başka bir başlatmaya kendiliğinden geçmez (489–499).
220.4.3 Yakınsama
EM her iterasyonda kanıt alt sınırını (ELBO, b_t) hesaplar; durma kuralı göreli değişimdir:
- b_t: iterasyon t sonundaki ELBO (büyük = daha iyi; negatiftir); \delta_t: göreli değişim.
- \varepsilon:
yakinsamaalanı (varsayılan 10^{-5}); t: EM iterasyon sayısı.
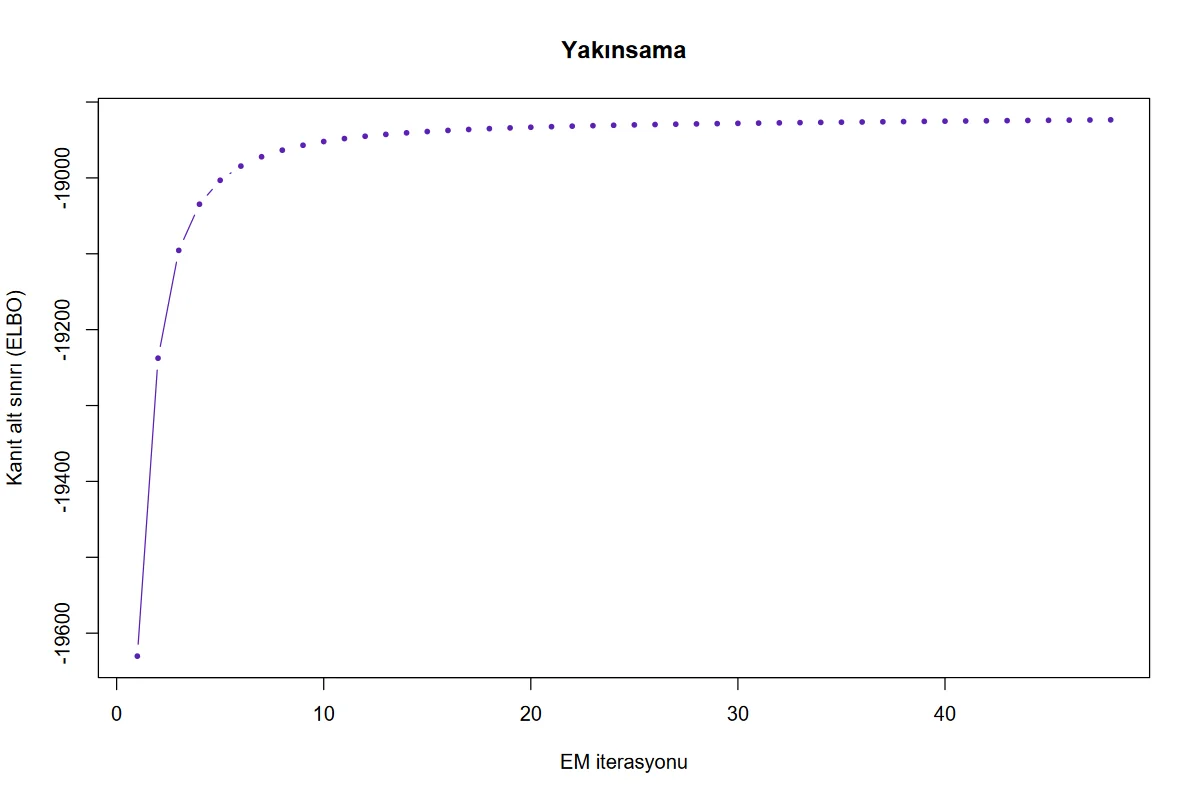
Şablon yakınsama durumunu, son ELBO'yu ve son göreli değişimi yazar; yakınsamadıysa uyarı verir ve ELBO tablosunu ve grafiğini sunar (500–521). Göreli değişim eksi ise (b_t<b_{t-1}), stm yine "yakınsadı" sayar (\delta_t<\varepsilon eksi değerde de sağlanır) ve şablon bu durumu ayrıca uyarır (512–516). İçerik değişkenli modellerde sık görülür (örnek: ykm_icerik, 13 iterasyon, \delta=-1{,}40\cdot10^{-4}).
220.4.4 K seçimi (searchK)
k_ara açıksa her aday K için ayrı bir model kurulur (searchK, 453–486); belgelerin bir kısmının sözcükleri ayrılır ve ölçütler hesaplanır: ayrılmış olabilirlik (ayrılan sözcüklerin log-olabilirliği; büyük iyidir), artık dağılımı (1'e yakınsa iyi; Taddy, 2012), kanıt alt sınırı, anlamsal tutarlılık (Mimno ve ark., 2011; büyük iyidir), dışlayıcılık (Roberts ve ark., 2014). Geçersiz adaylar (K<2, K>V, K\ge belge sayısı) atlanır ve yazılır (455–460).
searchK sonucu asıl modelle karşılaştırılamaz
searchK her aday için ayrılmış-veri üzerinde kendi modelini kurar; sinir, iterasyon ve artik değerleri asıl modelin ELBO tablosuyla aynı değildir (örnek veri, K=3: searchK 422 iterasyon ve -17462{,}14; asıl model 486 iterasyon ve -18182{,}64). Ölçüt tablosu K'lar arasında karşılaştırma içindir. Şablon searchK sonucuna göre K'yi kendiliğinden değiştirmez; seçilen K forma elle yazılır.
Şablonun searchK çağrısında iki ölçüt hesaplanmaz
Şablon searchK'yı do.call ile çağırır ve content argümanını yalnız içerik değişkeni varken iletir (467–471); içerik değişkeni yokken content hiç verilmez ve anlamsal tutarlılık ile dışlayıcılık hesaplanır (bağımsız doğrulama: dogrulama/yapisal_konu_modeli/searchk_dogrudan.R). İçerik değişkenli modelde stm bu iki ölçüyü hesaplamaz; sütunlar boş kalır ve çıktıdaki uyarı bunu söyler.
220.4.5 Konu sözcükleri, yaygınlık, temsilî belgeler
labelTopics dört sözcük listesi verir: en olası (\beta_{kv} büyük), FREX (sıklık ve dışlayıcılığın uyumlu ortalaması), Lift (\beta_{kv} / sözcüğün genel sıklığı) ve Score (log-oran tipi bir ağırlık) (524–549). İçerik modelinde labelTopics bu listeler yerine konu, içerik düzeyi ve etkileşim sözcüklerini döndürür (stm tanımı; 527–548). Konu yaygınlığı, belgeler üzerinden ortalama \bar\theta_k=\frac1D\sum_d\theta_{dk} ve bu yaygınlığın sırasıdır (552–559). findThoughts her konunun en yüksek \theta_{dk}'li belgelerini (temsilî belge) listeler (562–579).
220.4.6 Ortak değişken etkileri
estimateEffect(1:K ~ yaygınlık formülü, fit, uncertainty = "Global") (581–585), her konunun \theta'sını ortak değişkenlere bağlayan doğrusal regresyonu, \theta'nın belirsizliğini hesaba katarak kestirir: \theta'nın posterior dağılımından 25 örnek çekilir (Global belirsizlik), her örnekte regresyon kestirilir ve sonuçlar birleştirilir; summary 500 benzetimle standart hata ve t verir. Katsayılar konu oranı ölçeğindedir (doğrusal olasılık). Çekimler rastgele olduğundan şablon önce set.seed(tohum) çağırır (584).
Neden Global belirsizlik
uncertainty = "None" \theta'yı sabit sayar ve standart hataları küçültür; "Global" belge düzeyindeki belirsizliği yayar ve daha dürüst güven aralıkları verir. Bedeli: sonucun Monte Carlo değişkenliği (220.8, S6).
220.4.7 Konu korelasyonları
topicCorr(fit, method, cutoff) konular arasındaki korelasyonu \boldsymbol\Sigma'dan çıkarır (627–651): simple yöntemi korelasyon kestirimini cutoff eşiğiyle süzer; huge yöntemi yarı parametrik bir grafik model kestirir (huge paketi kuruluysa). Grafik, pozitif korelasyonlu konuları bağlar (igraph kuruluysa).
220.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 222–232 | Üç dilli .m; .uyar; .dolu. |
Uyarılar hem anında hem sonda listelenir. |
| 234–245 | Paket denetimi (stm, tm); kurulum talimatı. |
Paket kurulmaz. |
| 246–272 | Veri, sütun rolleri, birden çok içerik ve doğrusal/düzgün çakışması uyarıları; K ve tohum; "Tohum" satırı. | Çıktının ilk satırı tohumu yazar. |
| 274–301 | Eksik/boş satırlar; faktör kodlaması; düzgün terim ve içerik denetimleri. | Çıkarılan satır sayısı yazılır. |
| 303–367 | Dil kodu; Türkçe küçük harf; durak sözcük kaynağı; ek durak sözcükler; kök bulma; Türkçe notu. | Kullanılan durak listesi çıktıya yazılır. |
| 378–396 | textProcessor ve prepDocuments. |
Başarısızlık iletiyle durur. |
| 397–426 | "Ön işleme özeti" tablosu ve konsol özeti; belge, K, içerik denetimleri. | Seyrek terim eşiğini yükseltmek sözlüğü küçültür. |
| 428–446 | Formüller; Spectral maxV; model özeti. |
Yaygınlık yoksa estimateEffect yapılmaz. |
| 448–486 | İsteğe bağlı searchK; tablo ve grafik. |
İçerik değişkeni yoksa anlamsal tutarlılık ve dışlayıcılık dolu gelir; content yalnız içerik değişkeni varken iletilir. |
| 488–521 | stm; ELBO, göreli değişim; yakınsama uyarıları; tablo ve grafik. |
Yakınsama durumu her çıktıda yazılır. |
| 523–559 | labelTopics; yaygınlık tablosu ve grafiği. |
İçerik modelinde sözcük tablosu farklı. |
| 561–579 | Temsilî belgeler (findThoughts). |
Metin belge_uzunlugu karaktere kesilir. |
| 581–625 | estimateEffect (Global); tablo; en çok dört ortak değişken için grafik. |
Çekimler set.seed(tohum)'a bağlıdır. |
| 627–651 | Konu korelasyonu ve ağ. | huge yoksa simple'a düşer ve yazar. |
| 653–668 | \boldsymbol\theta ve \boldsymbol\beta tabloları. | 5000 satırdan sonrası gösterilmez. |
| 670–675 | Uygulanamayan seçenekler ve uyarılar listesi. |
220.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bağımsız hesap iki yoldan yapılmıştır. dogrulama/yapisal_konu_modeli/r_dogrulama.R, stm'yi şablon sarmalayıcısı olmadan doğrudan çağırır (textProcessor, prepDocuments, stm, labelTopics, estimateEffect; aynı girdi, tohum ve ayar) ve searchk_dogrudan.R searchK'yı doğrudan çağırır. elle_hesap.py ise şablonun kaydettiği tablolardan ve metinden bağımsız hesaplar yapar: (1) kök bulma kapalıyken ön işlemeyi elle (küçük harf, Unicode noktalama silme, durak sözcük listesi, sayı silme, en kısa sözcük uzunluğu, belge sıklığı eşiği) yazar; (2) \theta ve \beta tablolarından satır/sütun toplamlarını, konu yaygınlığını ve en olası sözcükleri yeniden hesaplar; (3) ELBO tablosundan göreli değişimi hesaplar. Kök bulucu (Snowball) Python'da yeniden yazılmamıştır; kök bulma açık koşularda ön işleme sayıları yalnız R doğrudan çağrısıyla karşılaştırılır.
Adım 1 — Ön işleme (kök bulma kapalı). 341 yanıttan sözlük 1374 terim, 4096 sözcük; yalnız bir belgede geçen 875 terim çıkarılır (bir belge de boşalır) ve modele 499 terim, 3208 sözcük girer. Elle yazılan ön işleme aynı sayıları verir.
Adım 2 — Spectral başlatmalı model. K=3; yaygınlık formülü ~ treatment + s(pid_rep). 486 EM iterasyonundan sonra b_{486}=-18182{,}6399, \delta_{486}=(b_{486}-b_{485})/|b_{485}|=9{,}4965\cdot10^{-6}<10^{-5}.
Adım 3 — Yaygınlık. \bar\theta=(0{,}238024;\,0{,}348919;\,0{,}413056); \theta satırları ve \beta sütunları 1'e 10^{-14} içinde toplanır.
Adım 4 — En olası sözcükler. \beta tablosundan en büyük yedi değer: konu 1 immigr, american, need, countri, care, citizen, becom; konu 2 illeg, job, tax, will, worri, take, secur; konu 3 peopl, come, think, get, countri, work, english. Şablonun ve labelTopics'in listeleriyle aynıdır.
Adım 5 — Etki kestirimi. Aynı tohumla doğrudan estimateEffect: treatment katsayıları konu 1 için -0{,}009220, konu 2 için 0{,}142457, konu 3 için -0{,}132896; şablonun tablosuyla 9 haneye kadar aynıdır.
Adım 6 — K seçimi. K=2, 3, 5 için ayrılmış olabilirlik, artık dağılımı, kanıt alt sınırı ve iterasyon sayısı doğrudan searchK çağrısıyla aynıdır; anlamsal tutarlılık ve dışlayıcılık da doğrudan çağrıyla aynıdır (220.4.4).
220.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Kök bulma kapalı: terim sayısı | 1374 | 1374 | 1374 | 0 | ✓ |
| Kök bulma kapalı: sözcük sayısı | 4096 | 4096 | 4096 | 0 | ✓ |
| Kök bulma kapalı: seyrek terim (çıkarılan) | 875 | 875 | 875 | 0 | ✓ |
| Kök bulma kapalı: modele giren terim | 499 | 499 | 499 | 0 | ✓ |
| Kök bulma kapalı: modele giren sözcük | 3208 | 3208 | 3208 | 0 | ✓ |
| Örnek: terim sayısı (kök bulma açık) | 1092 | — | 1092 | 0 | ✓ |
| Örnek: sözcük sayısı (kök bulma açık) | 4087 | — | 4087 | 0 | ✓ |
| Örnek: seyrek terim (çıkarılan) (kök bulma açık) | 639 | — | 639 | 0 | ✓ |
| Örnek: modele giren terim (kök bulma açık) | 453 | — | 453 | 0 | ✓ |
| Örnek: modele giren sözcük (kök bulma açık) | 3437 | — | 3437 | 0 | ✓ |
| Örnek: EM iterasyon sayısı | 486 | 486 | 486 | 0 | ✓ |
| Örnek: son ELBO | −18182,63993861 | −18182,63993861 | −18182,63993861 | 0 | ✓ |
| Örnek: ilk ELBO | −19213,14400202 | — | −19213,14400202 | 0 | ✓ |
| Örnek: son göreli değişim | 9,496471·10−6 | 9,496471·10−6 | 9,496471·10−6 | 2,0e−16 | ✓ |
| Örnek: konu 1 yaygınlığı | 0,23802444 | 0,23802444 | 0,23802444 | 3,1e−16 | ✓ |
| Örnek: konu 2 yaygınlığı | 0,34891922 | 0,34891922 | 0,34891922 | 0 | ✓ |
| Örnek: konu 3 yaygınlığı | 0,41305635 | 0,41305635 | 0,41305635 | 3,3e−16 | ✓ |
| Örnek: konu 1 (Intercept) kestirim (estimateEffect, tohum 12345) | 0,20471044 | — | 0,20471044 | 0 | ✓ |
| Örnek: konu 1 (Intercept) SH | 0,02730939 | — | 0,02730939 | 0 | ✓ |
| Örnek: konu 1 treatment kestirim (estimateEffect, tohum 12345) | −0,00921998 | — | −0,00921998 | 0 | ✓ |
| Örnek: konu 1 treatment SH | 0,02033959 | — | 0,02033959 | 0 | ✓ |
| Örnek: konu 1 s(pid_rep)1 kestirim (estimateEffect, tohum 12345) | 0,02438557 | — | 0,02438557 | 0 | ✓ |
| Örnek: konu 1 s(pid_rep)1 SH | 0,14103287 | — | 0,14103287 | 0 | ✓ |
| Örnek: konu 2 (Intercept) kestirim (estimateEffect, tohum 12345) | 0,18585591 | — | 0,18585591 | 0 | ✓ |
| Örnek: konu 2 (Intercept) SH | 0,03942636 | — | 0,03942636 | 0 | ✓ |
| Örnek: konu 2 treatment kestirim (estimateEffect, tohum 12345) | 0,14245708 | — | 0,14245708 | 0 | ✓ |
| Örnek: konu 2 treatment SH | 0,02638876 | — | 0,02638876 | 0 | ✓ |
| Örnek: konu 2 s(pid_rep)1 kestirim (estimateEffect, tohum 12345) | 0,28106572 | — | 0,28106572 | 0 | ✓ |
| Örnek: konu 2 s(pid_rep)1 SH | 0,17819277 | — | 0,17819277 | 0 | ✓ |
| Örnek: konu 3 (Intercept) kestirim (estimateEffect, tohum 12345) | 0,60941675 | — | 0,60941675 | 0 | ✓ |
| Örnek: konu 3 (Intercept) SH | 0,04331221 | — | 0,04331221 | 0 | ✓ |
| Örnek: konu 3 treatment kestirim (estimateEffect, tohum 12345) | −0,13289581 | — | −0,13289581 | 0 | ✓ |
| Örnek: konu 3 treatment SH | 0,0301996 | — | 0,0301996 | 0 | ✓ |
| Örnek: konu 3 s(pid_rep)1 kestirim (estimateEffect, tohum 12345) | −0,3030935 | — | −0,3030935 | 0 | ✓ |
| Örnek: konu 3 s(pid_rep)1 SH | 0,19844461 | — | 0,19844461 | 0 | ✓ |
| İçerik modeli: modele giren terim | 453 | — | 453 | 0 | ✓ |
| İçerik modeli: EM iterasyon sayısı | 13 | — | 13 | 0 | ✓ |
| İçerik modeli: son ELBO | −18317,82749072 | — | −18317,82749072 | 0 | ✓ |
| İçerik modeli: konu 1 yaygınlığı | 0,25059757 | — | 0,25059757 | 0 | ✓ |
| İçerik modeli: konu 2 yaygınlığı | 0,37428685 | — | 0,37428685 | 0 | ✓ |
| İçerik modeli: konu 3 yaygınlığı | 0,37511558 | — | 0,37511558 | 0 | ✓ |
| Türkçe örnek: terim sayısı (kök bulma açık) | 4704 | — | 4704 | 0 | ✓ |
| Türkçe örnek: sözcük sayısı | 11893 | — | 11893 | 0 | ✓ |
| Türkçe örnek: modele giren terim | 1685 | — | 1685 | 0 | ✓ |
| Türkçe örnek: EM iterasyon sayısı | 278 | — | 278 | 0 | ✓ |
| Türkçe örnek: son ELBO | −54062,39755296 | — | −54062,39755296 | 0 | ✓ |
| Türkçe örnek: konu 1 yaygınlığı | 0,08423602 | — | 0,08423602 | 0 | ✓ |
| Türkçe örnek: konu 2 yaygınlığı | 0,50933827 | — | 0,50933827 | 0 | ✓ |
| Türkçe örnek: konu 3 yaygınlığı | 0,18919861 | — | 0,18919861 | 0 | ✓ |
| Türkçe örnek: konu 4 yaygınlığı | 0,2172271 | — | 0,2172271 | 0 | ✓ |
| θ satır toplamları − 1 (en büyük mutlak sapma) | 0 | 1,110223·10−15 | — | 1,1e−15 | ✓ |
| β sütun toplamları − 1 (en büyük mutlak sapma) | 0 | 8,770762·10−15 | — | 8,8e−15 | ✓ |
| En olası 7 sözcük: eşleşen konu sayısı (şablon = β'dan elle = labelTopics) | 3 | 3 | 3 | 0 | ✓ |
| searchK K = 2: ayrılmış olabilirlik | −5,17135024 | — | −5,17135024 | 0 | ✓ |
| searchK K = 2: artık dağılımı | 2,05562739 | — | 2,05562739 | 0 | ✓ |
| searchK K = 2: kanıt alt sınırı | −17649,90446916 | — | −17649,90446916 | 0 | ✓ |
| searchK K = 2: EM iterasyonu | 222 | — | 222 | 0 | ✓ |
| searchK K = 2: anlamsal tutarlılık | −90,15888305 | — | −90,15888305 | 0 | ✓ |
| searchK K = 2: dışlayıcılık | 7,47629075 | — | 7,47629075 | 0 | ✓ |
| searchK K = 3: ayrılmış olabilirlik | −5,31995073 | — | −5,31995073 | 0 | ✓ |
| searchK K = 3: artık dağılımı | 1,97886828 | — | 1,97886828 | 0 | ✓ |
| searchK K = 3: kanıt alt sınırı | −17462,13857018 | — | −17462,13857018 | 0 | ✓ |
| searchK K = 3: EM iterasyonu | 422 | — | 422 | 0 | ✓ |
| searchK K = 3: anlamsal tutarlılık | −89,35801445 | — | −89,35801445 | 0 | ✓ |
| searchK K = 3: dışlayıcılık | 8,44865209 | — | 8,44865209 | 0 | ✓ |
| searchK K = 5: ayrılmış olabilirlik | −5,17221081 | — | −5,17221081 | 0 | ✓ |
| searchK K = 5: artık dağılımı | 1,81579375 | — | 1,81579375 | 0 | ✓ |
| searchK K = 5: kanıt alt sınırı | −17216,58144238 | — | −17216,58144238 | 0 | ✓ |
| searchK K = 5: EM iterasyonu | 473 | — | 473 | 0 | ✓ |
| searchK K = 5: anlamsal tutarlılık | −108,20511754 | — | −108,20511754 | 0 | ✓ |
| searchK K = 5: dışlayıcılık | 9,0518595 | — | 9,0518595 | 0 | ✓ |
| searchK: anlamsal tutarlılık ve dışlayıcılık sütunlarındaki dolu hücre sayısı (şablon; doğrudan çağrıda 3 K için 6 değer; aday K = 2, 3, 4, 5, 8 için 10 hücre) | 10 | — | 10 | 0 | ✓ |
Ölçütü karşılayan: 72/72. Bağımsız R sütunu stm paketini şablon sarmalayıcısı olmadan doğrudan çağırır (aynı girdi, tohum ve ayar); bağımsız Python sütunu ön işlemeyi elle (kök bulma kapalı) ve θ, β, ELBO denetimlerini şablonun kaydettiği tablolardan yeniden hesaplar. Python sütunu boşsa o büyüklük için bağımsız Python hesabı yoktur. searchK satırları şablonun content argümanı vermeden yaptığı çağrıyı doğrudan stm::searchK çağrısıyla karşılaştırır. Kök bulma açıkken (Snowball kök bulucu) ön işleme Python'da yeniden yazılmamıştır.
220.7 Çıktıyı okuma
Örnek veri, örnek ayar (ykm_ornek); konsol (kısaltılmış):
Tohum (seed): 12345
Kesme işaretli durak sözcükler (50 farklı sözcük, ör. don't, can't) noktalama silinmeden önce eşleştirildi: 75 geçiş çıkarıldı.
Dil: english; durak sözcükler: Snowball (174 sözcük; textProcessor varsayılanı); kök bulma: açık; küçük harf: açık; sayı silme: açık; noktalama silme: açık; en kısa sözcük: 3 karakter.
Model: K = 3; yaygınlık: ~treatment + s(pid_rep); içerik: yok; başlatma: Spectral; en çok 500 EM iterasyonu, emtol = 1e-05.
Yakınsama: 486 EM iterasyonu; yakınsadı. Son kanıt alt sınırı (ELBO) = -18182,6399; son göreli değişim = 9,4964711e-06 (emtol = 1e-05).
estimateEffect: θ'nın 25 örneklemi (Global belirsizlik) ve özet için 500 benzetim; tohum 12345. Katsayılar konu oranı ölçeğindedir (doğrusal olasılık).
Not: estimateEffect p değerleri 25 θ çekimine dayanır ve tohuma duyarlıdır; ...
Ön işleme özeti: 341 satır; sözlük 1092 terim ve 4087 sözcük; seyrek süzgeçle 639 terim ve 650 sözcük çıkar; modele 341 belge, 453 terim, 3437 sözcük girer.
Konu sözcükleri ve yaygınlıkları:
| Konu | En olası sözcükler | FREX | Yaygınlık | Sıra |
|---|---|---|---|---|
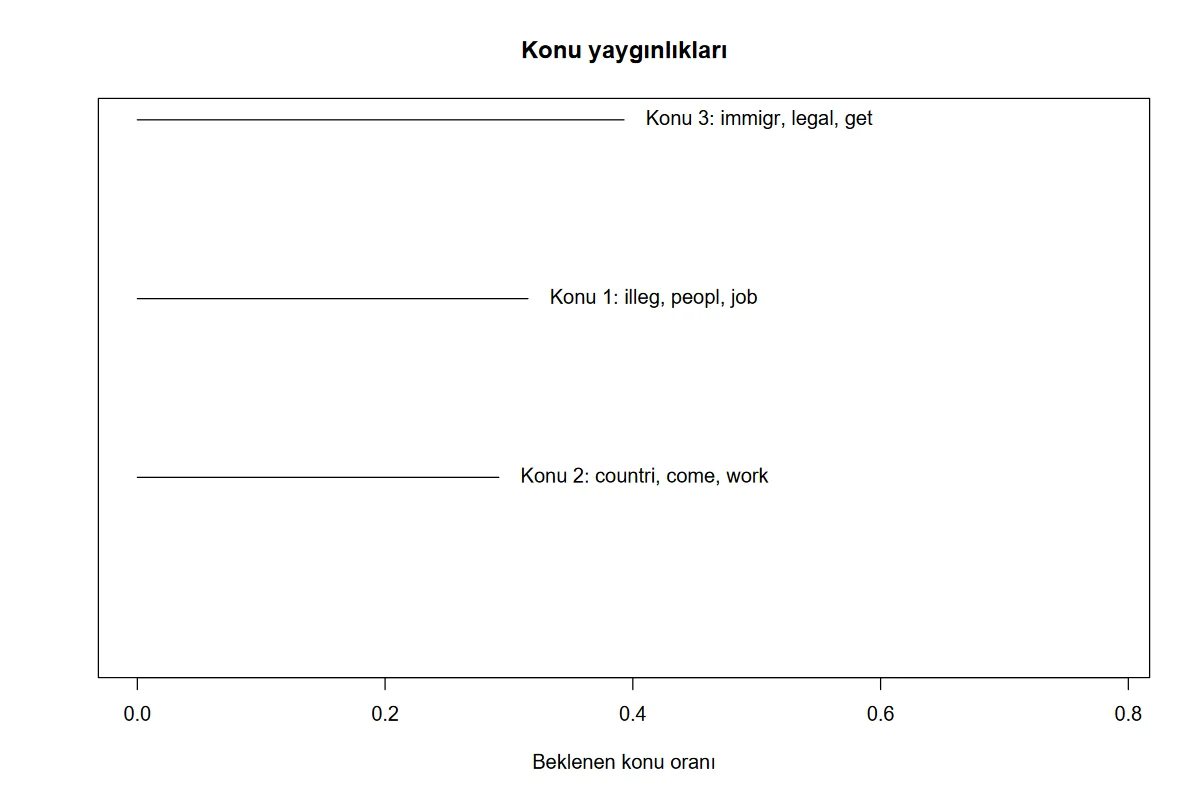
| 1 | immigr, american, need, countri, care, citizen, becom | immigr, need, money, concern, new, bring, just | 0,2380 | 3 |
| 2 | illeg, job, tax, will, worri, take, secur | illeg, job, tax, secur, welfar, crime, social | 0,3489 | 2 |
| 3 | peopl, come, think, get, countri, work, english | peopl, come, think, get, work, english, live | 0,4131 | 1 |
Konular kök sözcüklerle yazılır (kök bulma açık): illeg = illegal, peopl = people. Konu 2 yasa dışı göçmenliği iş, vergi ve güvenlikle ilişkilendirir, konu 3 genel olarak insanlar, ülke ve dil üzerine yazılan yanıtları toplar, konu 1 göçmen ve vatandaşlık ihtiyacına odaklanır. Konu korelasyonları (simple): konu 2–3 -0{,}862, konu 1–3 -0{,}379, konu 1–2 -0{,}143.
treatment etkisi (estimateEffect, Global belirsizlik):
| Konu | Kestirim | SH | t | p |
|---|---|---|---|---|
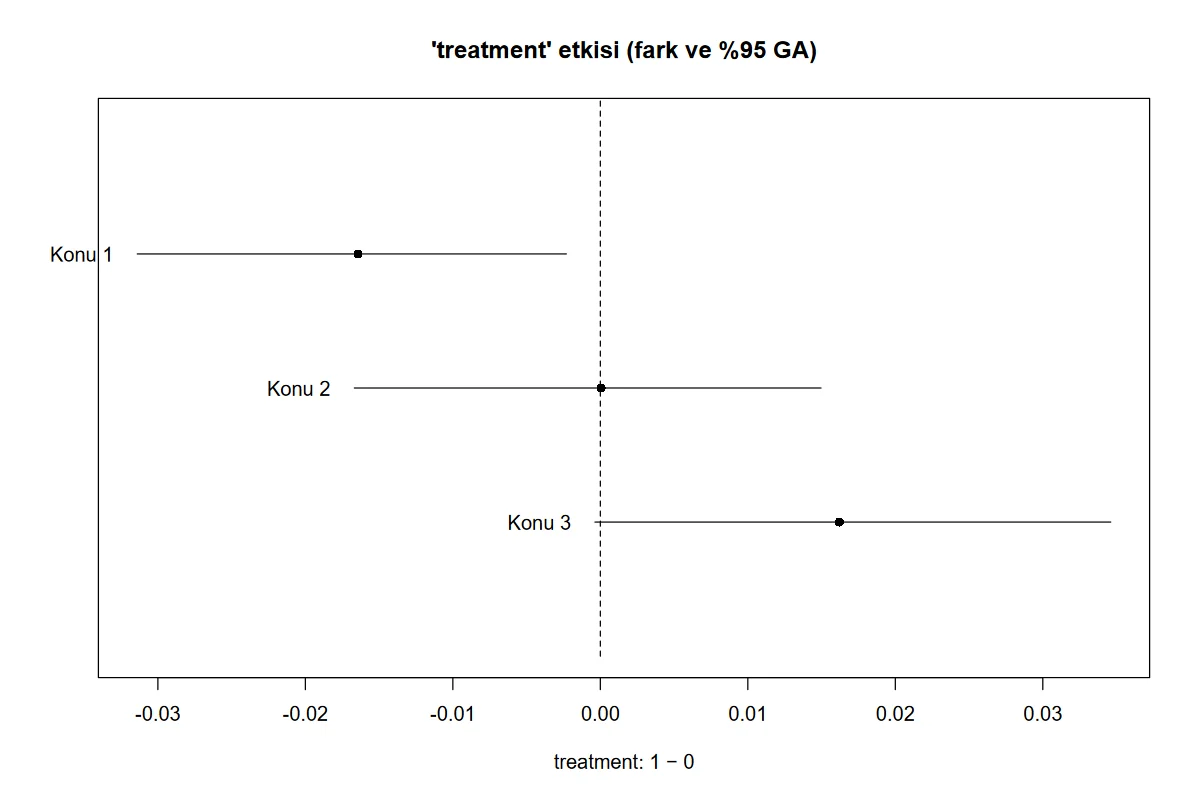
| 1 | −0,0092 | 0,0203 | −0,453 | 0,6506 |
| 2 | 0,1425 | 0,0264 | 5,398 | 1{,}3\cdot10^{-7} |
| 3 | −0,1329 | 0,0302 | −4,401 | 1{,}5\cdot10^{-5} |
pid_rep için düzgün terimin altı baz katsayısı da tabloda yer alır (s(pid_rep)1 … s(pid_rep)6); bunlar tek tek yorumlanmaz, pid_rep grafiğiyle okunur.
Şekil 220.1. Yakınsama: kanıt alt sınırının (ELBO) EM iterasyonuna göre izi (`ykm_ornek`; 486 iterasyon).
Şekil 220.2. Konu yaygınlıkları: belgeler üzerinden ortalama konu oranı ve en olası üç sözcük.
Şekil 220.3. `treatment` etkisi: konulara göre kaygı koşulu − nötr koşul farkı ve %95 güven aralığı.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Ön işleme özeti | Her adımda çıkan belge, terim ve sözcük. | Sözlüğün çoğu seyrek terimdir (639/1092); çok seyrek ön işleme sonucu değiştirir. |
| Yakınsama | EM iterasyonu, ELBO, son göreli değişim. | YAKINSAMADI ya da eksi göreli değişim uyarı demektir; sonuçlar kesin değildir. |
| Konu sözcükleri | En olası, FREX, Lift, Score. | Konuyu adlandırmak için en olası ve FREX birlikte okunur; Lift ve Score nadir sözcükleri öne çıkarır. |
| Konu yaygınlığı | Belgeler üzerinden ortalama \theta ve sıra. | Konunun korpustaki payı. |
| Temsilî belgeler | Her konunun en yüksek \theta'lı belgeleri. | Konu adı için sözcük listesinden daha güvenilir; satır, veri setindeki satırdır. |
| Ortak değişken etkileri | Konu başına katsayı, SH, t, p. | Katsayı konu oranının değişimidir (doğrusal olasılık); p rastgele çekime bağlıdır (S6). |
| Konu korelasyonları | \boldsymbol\Sigma'dan konu korelasyonu. | Yüksek pozitif değer konuların birlikte geçtiğini gösterir. |
| \theta, \beta tabloları | Belge–konu ve konu–sözcük olasılıkları. | Satır/sütun toplamı 1'dir; sonraki analizler için dışa alınır. |
Tohum ve başlatma. Spectral başlatmada tohum 2 ile (ykm_t2) ELBO, iterasyon sayısı, konu sözcükleri ve yaygınlıklar aynıdır; yalnız estimateEffect çekimleri değişir: konu 2 için treatment katsayısı 0,1425'ten 0,1411'e (p=1{,}3\cdot10^{-7} yerine 1{,}7\cdot10^{-7}), konu 3 için −0,1329'dan −0,1293'e (p=1{,}5\cdot10^{-5} yerine 1{,}9\cdot10^{-6}) değişir; bu veride karar tohumla değişmez. LDA başlatma (ykm_lda) 318 iterasyonda -18060{,}97, tohum 2'de (ykm_lda_t2) 248 iterasyonda -18175{,}81'e yakınsar; yaygınlıklar (0{,}305;\,0{,}367;\,0{,}328) ve (0{,}322;\,0{,}319;\,0{,}359) olur ve konu 1'in treatment p değeri sırasıyla 1{,}1\cdot10^{-13} ve 0{,}0572'dir: farklı çözümde konular ve kararlar farklı çıkabilir.
K seçimi (ykm_kara; K=2{,}3{,}4{,}5{,}8): ayrılmış olabilirlik -5{,}171; -5{,}320; -5{,}086; -5{,}172; -5{,}219 (büyük iyidir; en iyisi K=4); artık dağılımı 2{,}056; 1{,}979; 1{,}857; 1{,}816; 1{,}812 (K=8 en yakın 1'e); anlamsal tutarlılık -90{,}16; -89{,}36; -98{,}92; -108{,}21; -153{,}36 (büyük iyidir; en iyisi K=3); dışlayıcılık 7{,}48; 8{,}45; 8{,}82; 9{,}05; 9{,}46 (K arttıkça yükselir). K=4 500 iterasyona ulaşır.
İçerik modeli (ykm_icerik): içerik değişkeni sayısal (0/1) olduğundan her değer düzey sayılır ve uyarı yazılır; model 13 iterasyonda \delta=-1{,}40\cdot10^{-4} ile "yakınsadı" der ve eksi değişim uyarısı verir. labelTopics sözcük tablosu konu, içerik düzeyi ve konu × düzey etkileşimi satırlarından oluşur.
Yakınsamayan model (ykm_yak, en_cok_iter = 5): "5 EM iterasyonu; YAKINSAMADI", \delta=0{,}00157 ve uyarı.
Türkçe örnek (ykm_tr): 402 madde; Türkçe küçük harf kuralı uygulanır, durak sözcükler stopwords-iso listesinden (471 sözcük) gelir, Snowball Türkçe kök bulucusu kullanılır; sözlük 4704 terimden 1685'e iner (8720 sözcük); K=4; 278 EM iterasyonu, ELBO -54062{,}40. Konu 2 (heyeti, olunur, intihap, meclisi, icra, tâyin, kanunu) yaygınlığı 0,509 ile en büyüktür ve 1876–1924 dönemi metinlerine özgü sözcüklerle belirginleşir; konu 4 (kanunla, kamu, düzenlenir, devlet, özel, sahiptir, hallerde) 1961 metninde belirgindir (anayasa1961 Anayasası katsayısı +0{,}515). anayasa1961 Anayasası katsayısı konu 1'de +0{,}233 (p<10^{-13}), konu 2'de -0{,}967 (p<10^{-170}).
Rapor cümlesi. Açık uçlu yanıtlar (341) İngilizce metin için küçük harfe çevrildi, durak sözcükler ve sayılar silindi, sözcükler Snowball ile köklerine indirildi ve yalnız bir belgede geçen terimler çıkarıldı (453 terim); "don't", "can't" gibi kesme işaretli durak sözcükler noktalama silinmeden önce çıkarıldı. Spectral başlatmalı yapısal konu modeli (K=3; yaygınlıkta deney koşulu ve
pid_repiçin düzgün terim) 486 EM iterasyonunda yakınsadı (\delta=9{,}5\cdot10^{-6}). En yaygın konu genel göç ve ülke yanıtlarına ilişkindi (0,41). Kaygı koşulu, yasa dışı göçmenlik, iş ve vergi konusunun (konu 2) payını 0{,}142 artırdı (SH=0{,}026; p<0{,}001) ve konu 3'ün payını 0{,}133 azalttı (SH=0{,}030; p<0{,}001); farklı bir tohumla bu iki sonuç da p<0{,}001 kaldı.
220.8 Sık hatalar ve tuzaklar
- K seçimi bir kural değil bir araçtır. Ayrılmış olabilirlik, artık dağılımı ve (hesaplanabildiğinde) anlamsal tutarlılık/dışlayıcılık farklı K önerebilir (örnek veride ayrılmış olabilirlik K=2, artık dağılımı K=8). Sonuç, konuların yorumlanabilirliğiyle birlikte değerlendirilir; şablon K'yi kendiliğinden seçmez.
- searchK'da içerik değişkeni varsa anlamsal tutarlılık ve dışlayıcılık yok. stm bu iki ölçüyü içerik değişkenli modelde hesaplamaz; sütunlar boş kalır. İçerik değişkeni yoksa dolu gelir.
- Yakınsama durumuna bakmadan yorum yapmak. "YAKINSAMADI" ya da eksi göreli değişim uyarısı varsa sonuçlar kesin değildir;
en_cok_iterartırılır ya da farklı başlatma/tohumla denetlenir. Eksi değişimle "yakınsadı" yazılması bilinen bir stm davranışıdır (220.4.3). - LDA ve Random başlatma tohuma bağlıdır. Farklı tohumlar farklı konu çözümleri verir; çözüm kararlılığı için birkaç tohum denenir. Spectral başlatma belirlenimcidir.
- p değerleri tohuma bağlıdır.
estimateEffectyalnız 25 çekim kullanır; tohum değişince katsayı, SH ve p değişir; sınır değerler (p\approx0{,}05) iki yana düşebilir. Çıktı ve tohum alanı açıklaması bunu not eder; sonucu birkaç tohumla yineleyin. - Ön işleme seçimleri konuları değiştirir. Kök bulma, durak listesi, en kısa sözcük ve seyrek terim eşiği konu sözcüklerini ve \theta'yı etkiler. Kök bulma açık ve kapalı karşılaştırması önerilir; özellikle Türkçede (Snowball Türkçe kök bulucusu sınırlıdır).
- Kesme işaretli durak sözcükler. İngilizce durak listesindeki
don't,can't,i'mgibi 50 sözcük noktalama silinmeden önce tam sözcük olarak metinden çıkarılır (368–377) ve çıkarılan geçiş sayısı çıktıya yazılır; kullanıcının kesme işaretsiz yazdığı biçimler (dont,cant) listede olmadığından kalır, gerekiyorsaek_durakalanına yazın. - Düzgün terim katsayıları tek tek yorumlanmaz.
s(x)baz katsayılarıdır; etkiyi grafik gösterir. - İçerik değişkeni yalnız bir tane. Birden çok seçilirse yalnız ilki kullanılır (uyarı yazılır). Sayısal içerik değişkeni her farklı değerle düzeye dönüşür.
- Kategorik yaygınlık değişkeninde başvuru düzeyi. Faktörün ilk düzeyi (Bölüm 1.3) başvurudur; katsayılar bu düzeye göre farktır.
- Çok sayıda belge ya da sözcük. \theta ve \beta tabloları 5000 satırdan sonra gösterilmez (666–668).
- Belge sayısı çok az. En az 5 belge zorunludur; anlamlı konu için yüzlerce belge gerekir.
- Tohum. Formdaki
tohumbelirler; alan 0 ya da boşsa Kod panelindeki çalıştırma tohumu kullanılır.
220.9 Uzman soruları
S1. STM, LDA'dan nasıl ayrılır?
LDA belge–konu dağılımı için tek bir Dirichlet önseli kullanır ve belge özelliklerinden habersizdir. STM, konu yaygınlığını ortak değişkenlerin doğrusal (ya da düzgün) bir fonksiyonu olarak, lojistik-normal önselle modeller; bu önsel konular arası korelasyona da izin verir (Dirichlet vermez). İçerik ortak değişkeni de konu–sözcük dağılımını belge grubuna göre değiştirir (Roberts ve ark., 2014; 2016).
S2. Spectral başlatma neden tohumdan bağımsız?
Spectral başlatma, sözcük eş-oluşum matrisinin ayrıştırılmasıyla (Arora ve ark., 2013) konu–sözcük dağılımlarına belirlenimci bir başlangıç verir. Aynı veri ve aynı K için başlangıç hep aynıdır; EM de belirlenimcidir. Örnek veride tohum 12345 ve 2 aynı ELBO (-18182{,}6399) ve iterasyon sayısını (486) verir (220.7).
S3. Neden estimateEffect "Global" belirsizlikle?
Yaygınlık \theta_{dk} gözlenmeyen bir niceliktir; yalnız kestirimini regresyona koymak standart hatayı küçültür. Global belirsizlik \theta'yı posteriorundan çekip her çekimde regresyon kurar ve sonuçları birleştirir. Bu, hem \theta belirsizliğini hem örnekleme belirsizliğini yansıtır; bedeli Monte Carlo değişkenliğidir (S6).
S4. Konu sayısı nasıl seçilir?
Tek bir doğru ölçüt yoktur. Ayrılmış olabilirlik ayrılan sözcüklerin tahmin gücünü, artık dağılımı modelin açıklanamayan değişkenliğini (1'e yakın iyi; Taddy, 2012), anlamsal tutarlılık konunun üst sözcüklerinin birlikte geçmesini (Mimno ve ark., 2011), dışlayıcılık konuyu diğerlerinden ayıran sözcükleri ölçer. Şablonun searchK çağrısı içerik değişkeni yokken son ikisini de hesaplar. Seçim ölçüt, yorumlanabilirlik ve çalışmanın amacıyla birlikte yapılır.
S5. Eksi göreli değişim neden "yakınsadı" yazılıyor?
stm, durma kuralını \delta_t<\varepsilon olarak uygular; ELBO azaldığında \delta_t eksi olur ve kural sağlanır. Bu, gerçek yakınsama olmayabilir (iyileşme yoktur ama modelin sabit olduğu söylenemez). İçerik değişkenli modelde ykm_icerik 13 iterasyonda -1{,}4\cdot10^{-4} ile durur; şablon bunu ayrıca uyarır.
S6. Aynı model neden iki tohumda farklı p değeri verir?
estimateEffect \theta'dan yalnız 25 çekim yapar ve her çekimde regresyon kestirir; kestirimler çekimlerin ortalamasıdır. Çekim sayısı az olduğundan Monte Carlo değişkenliği standart hatanın birkaç yüzde noktasına çıkar. Örnek veride konu 3 için p=1{,}5\cdot10^{-5} (tohum 12345) ve 1{,}9\cdot10^{-6} (tohum 2); model, ELBO ve konular aynıdır ve karar değişmez; ama LDA başlatmalı çözümde konu 1 için p=0{,}057 ve 1{,}1\cdot10^{-13} gibi farklı sonuçlar çıkabilir (220.7). Sınıra yakın p değerlerinde karar tohumla değişebilir. Önlem: birkaç tohumla yinelemek ve kararlı sonucu raporlamak.
S7. Türkçe için kök bulma ne kadar güvenilir?
Snowball'un Türkçe kök bulucusu yalnız ekleri kuralla kırpar; eklemeli biçimlerde, ünlü uyumunda ve Osmanlıca sözcüklerde zayıftır, farklı sözcükleri aynı köke bağlayabilir ya da aynı sözcüğü farklı köklerde bırakabilir (örnek: türkiy, meclisi/mec). Şablon bunu çıktıya not düşer; kök bulma açık ve kapalı iki koşulla konuların kararlılığı denetlenmelidir.
S8. İçerik ortak değişkeni ile yaygınlık ortak değişkeni arasındaki fark nedir?
Yaygınlık, konunun belgedeki payını (hangi konular ne kadar konuşuluyor) değiştirir; içerik, aynı konuyu anlatırken kullanılan sözcükleri (bir konuyu nasıl konuşuyorlar) değiştirir. İçerik modeli parametre sayısını artırır, searchK anlamsal tutarlılığı hesaplayamaz ve ELBO daha kararsız seyreder.
220.10 Kaynaklar
- Arora, S., Ge, R., Halpern, Y., Mimno, D., Moitra, A., Sontag, D., Wu, Y., & Zhu, M. (2013). A practical algorithm for topic modeling with provable guarantees. Proceedings of the 30th International Conference on Machine Learning (PMLR 28), 280–288.
- Gadarian, S. K., & Albertson, B. (2014). Anxiety, immigration, and the search for information. Political Psychology, 35(2), 133–164. https://doi.org/10.1111/pops.12034
- Mimno, D., Wallach, H. M., Talley, E., Leenders, M., & McCallum, A. (2011). Optimizing semantic coherence in topic models. Proceedings of the 2011 Conference on Empirical Methods in Natural Language Processing, 262–272.
- Porter, M. F. (1980). An algorithm for suffix stripping. Program, 14(3), 130–137. https://doi.org/10.1108/eb046814
- Roberts, M. E., Stewart, B. M., & Airoldi, E. M. (2016). A model of text for experimentation in the social sciences. Journal of the American Statistical Association, 111(515), 988–1003. https://doi.org/10.1080/01621459.2016.1141684
- Roberts, M. E., Stewart, B. M., Tingley, D., Lucas, C., Leder-Luis, J., Gadarian, S. K., Albertson, B., & Rand, D. G. (2014). Structural topic models for open-ended survey responses. American Journal of Political Science, 58(4), 1064–1082. https://doi.org/10.1111/ajps.12103
- Roberts, M. E., Stewart, B. M., & Tingley, D. (2019). stm: An R package for structural topic models. Journal of Statistical Software, 91(2), 1–40. https://doi.org/10.18637/jss.v091.i02
- Taddy, M. (2012). On estimation and selection for topic models. Proceedings of the 15th International Conference on Artificial Intelligence and Statistics (PMLR 22), 1184–1193.