59. Tip I hata ve GA kapsama benzetimi
Şablon kimliği: yontem_benzetim · Kategori: benzetim · Dil: Python · Dosya: pro/sablonlar/benzetim/yontem_benzetim.py (satır 1–198; üstbilgi 1–81) · Örnek veri: yok (veriyi şablon üretir) · Paketler: numpy 2.4.6, scipy 1.16.3, pandas 2.3.3, matplotlib 3.10.9
59.1 Ne işe yarar
Şablon, iki ortalamanın farkı için üç yöntemi aynı yapay veriler üzerinde yarıştırır: Student t (eş varyans varsayar), Welch t (varsaymaz) ve bootstrap yüzdelik güven aralığı. Cevapladığı soru şudur: "Grup büyüklüklerim ve varyanslarım eşit değilken bu yöntemler söz verdikleri hata oranını tutuyor mu?"
İki ölçüt hesaplanır. \text{GA}_b=[A_b,\,U_b], b. yapay veride bir yöntemin güven aralığı ve \Delta=\mu_1-\mu_2 gerçek fark olsun:
- \mathbf 1\{\cdot\}: koşul doğruysa 1, değilse 0.
- Aralığın 0'ı içermemesi, "fark sıfırdır" hipotezinin \alpha düzeyinde reddedilmesiyle aynı şeydir.
- \Delta=0 ise reddetme oranı I. tür hata oranıdır ve hedefi \alpha'dır; \Delta\ne0 ise güçtür.
- Kapsamanın hedefi her durumda 1-\alpha'dır.
Bu, bir veri analizi değil, bir yöntem denemesidir: gerçek bilindiği için yöntemin ne sıklıkta yanıldığı sayılabilir. Varsayılan ayar bilinçli olarak en kötü durumdur: küçük grup (n_1=10) büyük varyanslıdır (\sigma_1=3), büyük grup (n_2=30) küçük varyanslıdır (\sigma_2=1). Bu düzende Student testinin gerçek hata oranı 0,05 değil, 0,21'dir.
Ne zaman kullanılır?
- Planlanan grup büyüklükleri ve beklenen varyans oranıyla Student testinin güvenilir olup olmadığı görülmek isteniyorsa.
- Derste ya da bir hakem yanıtında "neden Welch" sorusu sayıyla cevaplanmak isteniyorsa.
- Normal olmayan veride (ağır kuyruklu, çarpık) üç yöntemin davranışı karşılaştırılmak isteniyorsa.
- Küçük örneklemde bootstrap yüzdelik aralığının ne kadar dar kaldığı gösterilmek isteniyorsa.
Ne zaman kullanılmaz?
- Eldeki veride iki grubu karşılaştırmak için: temel programdaki Bağımsız Örneklem t Testi (Welch seçeneğiyle) ya da Bootstrap Güven Aralığı.
- Belirli bir test için gereken örneklem büyüklüğünü bulmak için: temel programdaki Güç Analizi ya da
guc_benzetim(Bölüm 57). - İkiden çok grup, eşleştirilmiş ölçüm ya da başka bir istatistik için: şablon yalnız iki bağımsız grubun ortalama farkını ele alır; öteki tasarımlar için üretici ve aralık satırları Kod sekmesinde değiştirilir.
- Kendi istatistiğinizin bootstrap aralığı için:
bootstrap_ozel(Bölüm 53).
Temel programla ilişki. Temel programın Bağımsız Örneklem t Testi iki testi de (Student ve Welch) tek bir veri setine uygular. Bu şablon aynı formülleri binlerce yapay veri setine uygular ve sonuçların uzun dönem davranışını raporlar; elde ettiği sayılar bir veri setinin değil, yöntemin özelliğidir.
59.2 Şablonun girdileri
Form, üstbilgideki dokuz [[param]] bloğundan kurulur (yontem_benzetim.py:9–87). Şablon veri sekmesindeki veriyi kullanmaz.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
1. grup n · n1 |
tamsayı · Seçenekler | 10 | 3 – 5000 | Birinci grubun büyüklüğü (111–119). |
2. grup n · n2 |
tamsayı · Seçenekler | 30 | 3 – 5000 | İkinci grubun büyüklüğü. |
1. grup SS · sd1 |
ondalık · Model | 3,0 | 0,001 – 1000 | Birinci grubun evren standart sapması \sigma_1. |
2. grup SS · sd2 |
ondalık · Model | 1,0 | 0,001 – 1000 | İkinci grubun evren standart sapması \sigma_2. |
Gerçek ortalama farkı (μ1 − μ2) · fark |
ondalık · Model | 0,0 | −1000 – 1000 | Birinci grubun ortalaması; ikinci grubunki 0'dır (111–112). Kapsamanın sınandığı değer (151). |
Benzetim sayısı · B |
tamsayı · Seçenekler | 2000 | 50 – 200000 | Yapay veri seti sayısı. |
Bootstrap yeniden örnekleme sayısı · boot_B |
tamsayı · Seçenekler | 499 | 99 – 9999 | Her yapay veride çekilen bootstrap kopyası (136–137); α'ya göre denetlenir (100–107, 163–167). |
Anlamlılık düzeyi (α) · alfa |
ondalık · Seçenekler | 0,05 | 0,001 – 0,5 | t kantilleri (126, 131) ve bootstrap yüzdelikleri (138); güven düzeyi 1-\alpha. |
Veri üreten dağılım · dagilim |
seçim · Model | normal |
normal, t3, lognormal |
Çekilişlerin dağılımı (109–119). |
Kapsama için %95 Wald aralığı sütunları · kapsama_araligi |
onay · Seçenekler | kapalı | açık/kapalı | Açıkken tablonun sonuna kapsama_ga_alt, kapsama_ga_ust eklenir (141–147, 155). |
Örnek ayar (ornek_param, satır 8): B = 200, boot_B = 199; öteki alanlar varsayılandır. Örnek ayar hız için küçüktür: 200 benzetimle 0,05 düzeyindeki bir oranın standart hatası 0,015'tir.
Şablonun kendi denetimleri. Tek mq.hata satırı bootstrap yeniden örnekleme sayısını \alpha'ya göre denetler (102–106): (\text{boot\_B}+1)\,\alpha/2<1 ise yüzdelik sınırlar en uç kopyalar olurdu ve çalıştırma durur (ör. \alpha=0{,}001 ile boot_B \le 1998). (\text{boot\_B}+1)\,\alpha/2<5 ise çalıştırma sürer, çıktıya bir uyarı satırı yazılır (163–167): bootstrap aralığı yapay olarak daralır ve reddetme oranı şişer. Öteki denetimler formun aralık sınırlarıdır (Bölüm 1.2). Üç dağılım da verilen ortalama ve standart sapmaya ölçeklenir.
59.3 Örnek veri
Şablonun örnek veri dosyası yoktur. Her çalıştırmada B kez iki grup üretilir:
| Dağılım | Üretim | Özellik |
|---|---|---|
| Normal | x\sim N(\Delta,\sigma_1^2), y\sim N(0,\sigma_2^2) | Her iki t yönteminin varsayımı. |
| Student t (3 sd) | x=\Delta+\sigma_1\,T_3/\sqrt3, y=\sigma_2\,T_3/\sqrt3 | Ağır kuyruklu, simetrik. T_3'ün varyansı 3 olduğundan \sqrt3'e bölünür. |
| Log-normal | x=\Delta+\sigma_1\,(L-e^{1/2})/\sqrt{(e-1)e}, L=e^{Z} | Sağa çarpık. L'nin ortalaması e^{1/2}=1{,}6487, standart sapması \sqrt{(e-1)e}=2{,}1612. |
Üç dağılımda da grupların evren ortalaması \Delta ve 0, evren standart sapmaları \sigma_1 ve \sigma_2'dir; değişen yalnız biçimdir. Böylece "gerçek fark" her dağılımda aynı anlama gelir ve kapsama aynı değere göre sınanır.
Rastgele sayı üreteci numpy'nin default_rng üretecidir ve çalıştırmanın tohumuyla kurulur (97); tohumun arayüzdeki davranışı Bölüm 57.3'te anlatılmıştır.
Bu bölümde kullanılan çalıştırmalar (aksi belirtilmedikçe tohum 2026 ve normal dağılım): (1) örnek ayar; (2) B=20000, boot_B = 499; (3) n_1=n_2=20, \sigma_1=\sigma_2=1; (4) n_1=30, n_2=10 (büyük varyans büyük grupta); (5) fark 2; (6) t_3 dağılımı; (7) log-normal; (8) log-normal, n_1=n_2=20, \sigma_1=\sigma_2=1; (9) \alpha=0{,}01; (10) örnek ayar, boot_B = 99; (11) örnek ayar, \sigma_1=30, \sigma_2=10; (12) örnek ayar, tohum 7 ve tohumsuz; (13) n_1=n_2=3. (3)–(9) çalıştırmalarında B=20000, boot_B = 199.
59.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) B\times n_1 ve B\times n_2 boyutlu iki matris üret; (2) her satırda ortalama farkını ve grup varyanslarını hesapla; (3) Student ve Welch aralıklarını kapalı formülle kur; (4) her satırda grupları ayrı ayrı yeniden örnekleyip bootstrap yüzdelik aralığını bul; (5) üç yöntem için reddetme oranını, kapsamayı ve ortalama aralık genişliğini çıkar.
59.4.1 Student t aralığı
\bar x, \bar y grup ortalamaları, s_1^2, s_2^2 (n-1 bölenli) grup varyansları ve d=\bar x-\bar y olsun:
- s_p^2: havuzlanmış varyans; iki grubun varyansının serbestlik derecesiyle ağırlıklı ortalaması.
- t_{1-\alpha/2;\,\nu}: \nu serbestlik dereceli t dağılımının kantili.
- Varsayım: iki evrenin varyansı eşittir. Bu doğruysa aralık her n_1, n_2 için tam olarak 1-\alpha kapsar.
Eş varyans bozulunca Student neden yanılır?
d'nin gerçek varyansı \sigma_1^2/n_1+\sigma_2^2/n_2'dir. Student ise onu s_p^2(1/n_1+1/n_2) ile kestirir ve s_p^2, büyük grubun varyansına doğru çekilir. Varsayılan ayarda gerçek varyans 9/10+1/30=0{,}933, havuzlanmış kestirimin beklenen değeri \frac{9\cdot9+29\cdot1}{38}\big(\frac1{10}+\frac1{30}\big)=0{,}386'dır: standart hata gerçeğin 1/1{,}555'i kadardır. Test istatistiği 1,555 kat şişer ve nominal 0,05'lik test, büyük örneklem sınırında 2\Phi(-1{,}96/1{,}555)=0{,}208 oranında reddeder. Düzen tersine dönerse (büyük varyans büyük grupta) standart hata gereğinden büyük kestirilir ve test aşırı tutucu olur. Gruplar eşit büyüklükteyse iki etki birbirini götürür.
59.4.2 Welch t aralığı
- \operatorname{SH}_W: her grubun varyansı kendi büyüklüğüne bölünür; havuzlama yoktur.
- \nu: Welch-Satterthwaite serbestlik derecesi; tamsayı olmak zorunda değildir ve \min(n_1,n_2)-1 ile n_1+n_2-2 arasında kalır.
- \nu veriden hesaplanır: her yapay veride farklıdır.
Serbestlik derecesi neden veriden kestirilir?
\operatorname{SH}_W^2 iki ayrı ki-karenin ağırlıklı toplamıdır ve tek bir ki-kare dağılımına uymaz. Satterthwaite (1946) bu toplamı, ilk iki momenti tutan tek bir ki-kareyle değiştirir; \nu bu eşleştirmenin serbestlik derecesidir. Varsayılan ayarda belirsizliğin neredeyse tamamı küçük gruptan gelir (s_1^2/n_1\approx0{,}9, s_2^2/n_2\approx0{,}03) ve \nu küçük grubun serbestlik derecesine yakındır: beklenen değeri 9,88'dir. Student aynı veride 38 serbestlik derecesi kullanır.
Koddaki tercih
İki aralık da hazır bir test işlevi çağrılmadan, B uzunluklu dizilerle açık formülden kurulur (123–132). Kantiller scipy.stats.t.ppf ile alınır; Welch'te df_w bir dizidir ve her yapay veri için ayrı bir kantil hesaplanır (131).
59.4.3 Bootstrap yüzdelik aralığı
Her yapay veride gruplar ayrı ayrı, yerine koyarak yeniden örneklenir:
- \bar x^{*}_r: birinci grubun n_1 gözleminden yerine koyarak çekilen n_1 değerin ortalaması; \bar y^{*}_r ikinci grup için aynısı.
- R: bootstrap yeniden örnekleme sayısı (
boot_B). - q^{*}_p: R farkın p. kantili; numpy'nin varsayılan tanımıyla, sıralı değerler arasında doğrusal ara değerle (h=(R-1)p).
Gruplar neden ayrı örnekleniyor?
Havuzlanmış veriden yeniden örneklemek, iki grubun aynı dağılımdan geldiğini varsaymak olurdu; oysa sınanan durum tam da varyansların farklı olmasıdır. Ayrı örnekleme her grubun kendi dağılımını korur ve aralık, farkın örnekleme dağılımını taklit eder. Bu yüzden bootstrap aralığı Student gibi varyans oranından etkilenmez.
Yüzdelik aralık küçük örneklemde dardır
Yüzdelik aralığın iki zayıflığı vardır ve ikisi de aralığı daraltır. Birincisi, yeniden örneklem ortalamasının varyansı \frac{n-1}{n}\cdot\frac{s^2}{n}'dir: n bölenli varyans kullanılır ve n_1=10'da standart hata %5 küçük kalır. İkincisi, aralık kabaca normal kantille (\mp1{,}96) kurulur; varyansın kendisinin kestirilmiş olmasından gelen belirsizlik (t düzeltmesi; 10 serbestlik derecesinde 2,23) hesaba girmez. Varsayılan ayarda bu iki etki birlikte aralığı Welch aralığının yaklaşık %83'üne indirir ve reddetme oranı 0,05 yerine 0,10 çıkar. Etki örneklem büyüdükçe kaybolur; yöntemin bozuk olduğunu değil, yüzdelik biçiminin küçük örneklem düzeltmesi içermediğini gösterir (Hesterberg, 2015).
Koddaki tercih
Bootstrap döngüsü yapay veri başına bir kez döner (135–138). Dizinler rng.integers(0, n1, (bB, n1)) ile tek seferde çekilir; her satır bir yeniden örneklemdir. Kantiller np.quantile(bx - by, [alfa / 2, 1 - alfa / 2]) ile alınır. Yeniden örnekleme sayısı \alpha'ya göre denetlenir (100–107): kuyruk sıra sayısı (\text{boot\_B}+1)\,\alpha/2 en az 1 olmalıdır, 5'in altındaysa çıktıya uyarı yazılır. \alpha=0{,}01 ve boot_B = 199 için sayı 1'dir: 0,005 kantili sıralı değerlerin 1. ve 2.'si arasına düşer, aralığın uçları çok oynak olur ve şablon uyarır. Küçük \alpha ile çalışırken boot_B en az 10/\alpha-1 düzeyine çıkarılır.
59.4.4 Özet ölçütler ve Monte Carlo hatası
Her yöntem için dört sayı raporlanır (149–155): reddetme oranı \hat r, onun güven aralığı, kapsama ve ortalama aralık genişliği.
- \operatorname{SH}(\hat r): reddetme oranının Monte Carlo standart hatası.
- Aralık Wald biçimindedir, çarpan 1,96 sabittir (\alpha'dan bağımsız, her zaman %95) ve sınırlar [0{,}1]'e kırpılır.
- Varsayılanda kapsama için aralık yazılmaz; \Delta=0 iken kapsama 1-\hat r olduğundan aynı standart hata geçerlidir. "Kapsama için %95 Wald aralığı sütunları" açılırsa tablonun sonuna \hat c\mp1{,}96\sqrt{\hat c(1-\hat c)/B} ([0{,}1] ile sınırlı; \hat c kapsama oranı) aralığı
kapsama_ga_altvekapsama_ga_ustolarak eklenir ve şekildeki kapsama çubuklarına hata çubuğu çizilir; mevcut sütunlar ve sayılar değişmez.
Ortalama genişlik neden raporlanır?
Kapsama tek başına yeterli değildir: sonsuz geniş bir aralık her zaman kapsar. İki yöntemin kapsaması aynıysa dar olan yeğlenir. Varsayılan ayarda Student aralığı en dardır (2,47) ama kapsaması 0,79'dur; Welch aralığı 4,20 genişliğindedir ve 0,95 kapsar. Darlık burada bir erdem değil, yanlış standart hatanın sonucudur.
Fark sıfır değilken "güç" sütunu yöntemler arasında karşılaştırılamaz
Gerçek fark sıfırdan farklı girildiğinde reddetme oranı güç olarak adlandırılır (160). Fark 2 iken Student 0,78, Welch 0,47 "güç" gösterir; ama Student'ın 0,05'lik testi bu tasarımda gerçekte 0,21'lik bir testtir. Hata oranını tutmayan bir testin gücü, tutanınkiyle yan yana konamaz. Güç karşılaştırması yalnız, fark sıfırken reddetme oranı \alpha'ya yakın çıkan yöntemler arasında anlamlıdır.
59.4.5 Benzetimin yaklaştığı kesin değer
Normal dağılımda Student ve Welch için reddetme olasılığı benzetimsiz hesaplanabilir. d, s_1^2 ve s_2^2 birbirinden bağımsızdır; varyanslar verildiğinde d normal dağılımlıdır:
- Beklenen değer, (n_1-1)s_1^2/\sigma_1^2\sim\chi^2_{n_1-1} ve (n_2-1)s_2^2/\sigma_2^2\sim\chi^2_{n_2-1} bağımsız değişkenleri üzerindedir.
- \operatorname{SH} ve q: yöntemin standart hatası ve t kantili; ikisi de s_1^2, s_2^2'nin işlevidir (Welch'te q de değişir).
- \tau: d'nin gerçek standart sapması.
Bu iki katlı tümlev sayısal olarak alınır (Welch, 1938; Moser, Stevens ve Watts, 1989). Varsayılan tasarımda Student için 0,210794, Welch için 0,050779 bulunur. Welch testi de tam değildir: Satterthwaite yaklaşımı nedeniyle 0,05'ten 0,0008 sapar.
59.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–81 | Üstbilgi: kimlik, açıklama, örnek ayar, dokuz parametre. | Form buradan kurulur (Bölüm 1.2). |
| 82–92 | matplotlib, scipy.stats; dil yardımcısı; üreteç; parametreler. |
Üreteç mq.seed ile kurulur; tohum yoksa 2026 (97). |
| 93–100 | Bootstrap yeniden örnekleme sayısı denetimi: kuyruk sıra sayısı (\text{boot\_B}+1)\,\alpha/2. | 1'in altında durur, 5'in altında uyarı bayrağı kurar. |
| 102–112 | Seçilen dağılımdan X (B\times n_1) ve Y (B\times n_2). |
Önce X'in tamamı, sonra Y'nin tamamı çekilir. Bellek B(n_1+n_2) ile büyür. |
| 113–114 | Satır ortalamalarının farkı d; grup varyansları (ddof=1). |
Bütün yapay veriler tek işlemde. |
| 116–120 | Student: havuzlanmış varyans, standart hata, kantil, alt ve üst sınır. | Serbestlik derecesi n_1+n_2-2 sabittir. |
| 121–125 | Welch: standart hata, veriden serbestlik derecesi, kantil dizisi, sınırlar. | df_w her satır için ayrıdır. |
| 126–131 | Bootstrap: her yapay veride bB yeniden örneklem, yüzdelik sınırlar. |
Şablonun tek döngüsüdür; süre B\cdotboot_B ile artar. |
| 134–144 | ozet: reddetme, Wald aralığı, kapsama, ortalama genişlik; üç satırlık tablo. |
Reddetme alt > 0 ya da ust < 0; kapsama alt ≤ fark ≤ ust. |
| 145–157 | Özet satırları: tasarım, bootstrap sayısı uyarısı (163–167), ölçütlerin anlamı, yöntem başına bir satır. | Fark 0 ise "Tip I hata", değilse "Güç" yazılır. |
| 159–179 | İki panelli çubuk grafik: reddetme oranı (hata çubuklu) ve kapsama; tablo ve şekil. | Kesikli çizgiler hedeflerdir: \alpha (yalnız fark 0 iken) ve 1-\alpha. |
Kritik satırlar:
sp2 = ((n1 - 1) * v1 + (n2 - 1) * v2) / (n1 + n2 - 2)
se_s = np.sqrt(sp2 * (1 / n1 + 1 / n2))
…
se_w = np.sqrt(v1 / n1 + v2 / n2)
df_w = se_w ** 4 / ((v1 / n1) ** 2 / (n1 - 1) + (v2 / n2) ** 2 / (n2 - 1))
…
bx = X[i][rng.integers(0, n1, (bB, n1))].mean(1)
Çekiliş sırasının iki sonucu vardır. Yapay veriler bootstrap'tan önce üretildiği için boot_B değiştirildiğinde Student ve Welch satırları aynı kalır, yalnız bootstrap satırı değişir. Fark ve standart sapmalar da çekilen standart normal sayıları ötelediği ve ölçeklediği için, \sigma_1, \sigma_2 ve \Delta aynı sayıyla çarpıldığında üç yöntemin reddetme ve kapsama oranları değişmez; yalnız aralık genişlikleri o sayıyla çarpılır (çalıştırma 11: oranlar aynı, genişlikler 10 kat).
59.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bağımsız hesap dogrulama/yontem_benzetim/elle_hesap.py ile yapılmıştır. Aynı numpy üreteci aynı tohumla (2026) kurulmuş, çekilişler şablondaki sırayla yapılmıştır. Aralıklar başka yoldan hesaplanmıştır: Student standart hatası iki gruplu regresyonun (\mathbf X^{\top}\mathbf X)^{-1} matrisinden, Welch serbestlik derecesi varyans oranı biçiminden, t kantilleri scipy.special.stdtrit ile, bootstrap yüzdelikleri sıralama ve doğrusal ara değerle. R tarafında (r_dogrulama.R) aynı yapay veriler ve aynı bootstrap dizinleri dosyadan okunmuş; aralıklar t.test(var.equal = TRUE), t.test(var.equal = FALSE) ve quantile(type = 7) ile alınmıştır.
Adım 1 — İlk yapay veri (örnek ayar). n_1=10, n_2=30. \bar x=-0{,}3626, \bar y=0{,}0222, d=-0{,}3847; s_1^2=6{,}8901, s_2^2=0{,}6322 (evren değerleri 9 ve 1).
Adım 2 — Student.
t_{0{,}975;\,38}=2{,}0244; \text{GA}_S=-0{,}3847\mp2{,}0244\times0{,}5310=[-1{,}4596;\ 0{,}6901].
Adım 3 — Welch.
t_{0{,}975;\,9{,}556}=2{,}2422; \text{GA}_W=-0{,}3847\mp2{,}2422\times0{,}8427=[-2{,}2742;\ 1{,}5047]. Aynı veride Welch standart hatası Student'ınkinin 1,59 katıdır.
Adım 4 — Bootstrap. İlk yeniden örneklemde birinci gruptan çekilen gözlem sıraları 1, 6, 8, 3, 5, 3, 5, 3, 8, 3'tür (3. gözlem dört kez, 2., 4., 7., 9. ve 10. gözlemler hiç). 199 farkın 0,025 ve 0,975 kantilleri: \text{GA}_{\text{boot}}=[-2{,}1046;\ 1{,}0420]. Genişliği 3,147'dir; Welch aralığının (3,779) %83'ü.
Üç aralık da 0'ı içerir: bu yapay veri üç yöntemde de "reddetmedi" ve "kapsadı" sayılır.
Adım 5 — 200 yapay verinin özeti. Student 46, Welch 10, bootstrap 21 kez reddeder: 0,230; 0,050; 0,105. Student için Monte Carlo aralığı 0{,}230\mp1{,}96\sqrt{0{,}230\times0{,}770/200}=[0{,}1717;\ 0{,}2883]. Welch serbestlik derecesi 200 veride 9,17 ile 12,37 arasında değişir; ortalaması 9,91'dir.
Adım 6 — Kesin değerler. 59.4.5'teki tümlev, iki ki-kare üzerinde 160 × 160 düğümlü genelleştirilmiş Gauss-Laguerre kuralıyla alınmıştır (80 × 80 düğümle fark 10^{-10}'un altındadır):
| Tasarım | Student | Welch |
|---|---|---|
| n=10{,}30; \sigma=3{,}1 (varsayılan) | 0,210794 | 0,050779 |
| n=20{,}20; \sigma=1{,}1 | 0,050000 | 0,049644 |
| n=30{,}10; \sigma=3{,}1 | 0,003930 | 0,049623 |
| n=10{,}30; \sigma=3{,}1; \alpha=0{,}01 | 0,099544 | 0,010703 |
| n=10{,}30; \sigma=3{,}1; fark 2 (güç) | 0,779589 | 0,462907 |
Aynı tümlevle beklenen aralık genişliği de bulunur: varsayılan tasarımda Student 2,4775, Welch 4,2115. Varyans oranının etkisi tek başına izlenebilir: n=10{,}30 sabitken \sigma_1/\sigma_2 = 1, 2, 3 için Student'ın hata oranı 0,0500; 0,1543; 0,2108'dir.
59.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablosundan tam hassasiyetle alınmıştır. Üç yol aynı yapay verileri ve aynı bootstrap dizinlerini kullanır.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Örnek ayar, Student t: reddetme oranı | 0,23 | 0,23 | 0,23 | 0 | ✓ |
| Örnek ayar, Student t: reddetme GA alt | 0,17167559 | 0,17167559 | 0,17167559 | 0 | ✓ |
| Örnek ayar, Student t: reddetme GA üst | 0,28832441 | 0,28832441 | 0,28832441 | 0 | ✓ |
| Örnek ayar, Student t: kapsama | 0,77 | 0,77 | 0,77 | 0 | ✓ |
| Örnek ayar, Student t: ortalama GA genişliği | 2,48746013 | 2,48746013 | 2,48746013 | 1,8e−16 | ✓ |
| Örnek ayar, Welch t: reddetme oranı | 0,05 | 0,05 | 0,05 | 0 | ✓ |
| Örnek ayar, Welch t: reddetme GA alt | 0,01979437 | 0,01979437 | 0,01979437 | 2,1e−17 | ✓ |
| Örnek ayar, Welch t: reddetme GA üst | 0,08020563 | 0,08020563 | 0,08020563 | 8,3e−17 | ✓ |
| Örnek ayar, Welch t: kapsama | 0,95 | 0,95 | 0,95 | 0 | ✓ |
| Örnek ayar, Welch t: ortalama GA genişliği | 4,21118991 | 4,21118991 | 4,21118991 | 1,3e−11 | ✓ |
| Örnek ayar, Bootstrap: reddetme oranı | 0,105 | 0,105 | 0,105 | 0 | ✓ |
| Örnek ayar, Bootstrap: reddetme GA alt | 0,06251386 | 0,06251386 | 0,06251386 | 8,3e−17 | ✓ |
| Örnek ayar, Bootstrap: reddetme GA üst | 0,14748614 | 0,14748614 | 0,14748614 | 0 | ✓ |
| Örnek ayar, Bootstrap: kapsama | 0,895 | 0,895 | 0,895 | 0 | ✓ |
| Örnek ayar, Bootstrap: ortalama GA genişliği | 3,39853827 | 3,39853827 | 3,39853827 | 0 | ✓ |
| Tohum 7, Student t: reddetme oranı | 0,28 | 0,28 | — | 0 | ✓ |
| Tohum 7, Welch t: reddetme oranı | 0,09 | 0,09 | — | 0 | ✓ |
| Tohum 7, Bootstrap: reddetme oranı | 0,15 | 0,15 | — | 0 | ✓ |
| 99 bootstrap, Student t: reddetme oranı | 0,23 | 0,23 | — | 0 | ✓ |
| 99 bootstrap, Student t: ortalama GA genişliği | 2,48746013 | 2,48746013 | — | 0 | ✓ |
| 99 bootstrap, Welch t: reddetme oranı | 0,05 | 0,05 | — | 0 | ✓ |
| 99 bootstrap, Welch t: ortalama GA genişliği | 4,21118991 | 4,21118991 | — | 2,1e−16 | ✓ |
| 99 bootstrap, Bootstrap: reddetme oranı | 0,105 | 0,105 | — | 0 | ✓ |
| 99 bootstrap, Bootstrap: ortalama GA genişliği | 3,34392497 | 3,34392497 | — | 0 | ✓ |
| B=20000, Student t: reddetme oranı | 0,21 | 0,21 | — | 0 | ✓ |
| B=20000, Student t: kapsama | 0,79 | 0,79 | — | 0 | ✓ |
| B=20000, Student t: ortalama GA genişliği | 2,47430293 | 2,47430293 | — | 0 | ✓ |
| B=20000, Welch t: reddetme oranı | 0,0538 | 0,0538 | — | 0 | ✓ |
| B=20000, Welch t: kapsama | 0,9462 | 0,9462 | — | 0 | ✓ |
| B=20000, Welch t: ortalama GA genişliği | 4,20354608 | 4,20354608 | — | 0 | ✓ |
| B=20000, Bootstrap: reddetme oranı | 0,09965 | 0,09965 | — | 0 | ✓ |
| B=20000, Bootstrap: kapsama | 0,90035 | 0,90035 | — | 0 | ✓ |
| B=20000, Bootstrap: ortalama GA genişliği | 3,45354776 | 3,45354776 | — | 0 | ✓ |
| Fark 2, Student t: reddetme oranı | 0,78355 | 0,78355 | — | 0 | ✓ |
| Fark 2, Student t: kapsama | 0,79 | 0,79 | — | 0 | ✓ |
| Fark 2, Welch t: reddetme oranı | 0,46715 | 0,46715 | — | 0 | ✓ |
| Fark 2, Welch t: kapsama | 0,9462 | 0,9462 | — | 0 | ✓ |
| Fark 2, Bootstrap: reddetme oranı | 0,61825 | 0,61825 | — | 0 | ✓ |
| Fark 2, Bootstrap: kapsama | 0,8935 | 0,8935 | — | 0 | ✓ |
| Eşit tasarım, Student t: reddetme oranı | 0,0485 | 0,0485 | — | 0 | ✓ |
| Eşit tasarım, Welch t: reddetme oranı | 0,0483 | 0,0483 | — | 0 | ✓ |
| Eşit tasarım, Bootstrap: reddetme oranı | 0,07135 | 0,07135 | — | 0 | ✓ |
| Ters tasarım, Student t: reddetme oranı | 0,00385 | 0,00385 | — | 0 | ✓ |
| Ters tasarım, Welch t: reddetme oranı | 0,04895 | 0,04895 | — | 0 | ✓ |
| Ters tasarım, Bootstrap: reddetme oranı | 0,0717 | 0,0717 | — | 0 | ✓ |
| t_3 dağılımı, Student t: reddetme oranı | 0,19845 | 0,19845 | — | 0 | ✓ |
| t_3 dağılımı, Welch t: reddetme oranı | 0,0397 | 0,0397 | — | 0 | ✓ |
| t_3 dağılımı, Bootstrap: reddetme oranı | 0,10855 | 0,10855 | — | 0 | ✓ |
| Log-normal, Student t: reddetme oranı | 0,24925 | 0,24925 | — | 0 | ✓ |
| Log-normal, Welch t: reddetme oranı | 0,1511 | 0,1511 | — | 0 | ✓ |
| Log-normal, Bootstrap: reddetme oranı | 0,1924 | 0,1924 | — | 0 | ✓ |
| \alpha=0{,}01, Student t: reddetme oranı | 0,10115 | 0,10115 | — | 0 | ✓ |
| \alpha=0{,}01, Student t: ortalama GA genişliği | 3,31418408 | 3,31418408 | — | 0 | ✓ |
| \alpha=0{,}01, Welch t: reddetme oranı | 0,01215 | 0,01215 | — | 0 | ✓ |
| \alpha=0{,}01, Welch t: ortalama GA genişliği | 5,9930465 | 5,9930465 | — | 0 | ✓ |
| \alpha=0{,}01, Bootstrap: reddetme oranı | 0,0556 | 0,0556 | — | 0 | ✓ |
| \alpha=0{,}01, Bootstrap: ortalama GA genişliği | 4,2540583 | 4,2540583 | — | 0 | ✓ |
Ölçütü karşılayan: 57/57. Python: aynı numpy akışı; Student aralığı iki gruplu regresyonun (\mathbf X^{\top}\mathbf X)^{-1} matrisinden, Welch sd'si varyans oranı biçiminden, bootstrap yüzdelikleri sıralama ve doğrusal ara değerle. R: aynı yapay veriler ve aynı bootstrap dizinleriyle t.test(var.equal = TRUE / FALSE) ve quantile(type = 7) (yalnız örnek ayar).
İkinci denetim istatistikseldir: B=20000 benzetimden elde edilen reddetme oranı, kesin değerle Monte Carlo standart hatası içinde tutmalıdır. Son sütun farkın standart hataya oranıdır; mutlak değeri 3'ü aşmayan satır uyumlu sayılır.
| Tasarım ve yöntem | Benzetim | B | Kesin (Python) | Kesin (R) | SHMC | Fark / SH | |
|---|---|---|---|---|---|---|---|
| n=10{,}30; SS =3{,}1: Student t | 0,21 | 20000 | 0,210794 | 0,210794 | 0,00288 | −0,28 | ✓ |
| n=10{,}30; SS =3{,}1: Welch t | 0,0538 | 20000 | 0,050779 | 0,050779 | 0,00155 | +1,95 | ✓ |
| n=20{,}20; SS =1{,}1: Student t | 0,0485 | 20000 | 0,05 | 0,05 | 0,00154 | −0,97 | ✓ |
| n=20{,}20; SS =1{,}1: Welch t | 0,0483 | 20000 | 0,049644 | 0,049644 | 0,00154 | −0,88 | ✓ |
| n=30{,}10; SS =3{,}1: Student t | 0,00385 | 20000 | 0,00393 | 0,00393 | 4,423873·10−4 | −0,18 | ✓ |
| n=30{,}10; SS =3{,}1: Welch t | 0,04895 | 20000 | 0,049623 | 0,049623 | 0,00154 | −0,44 | ✓ |
| n=10{,}30; SS =3{,}1; fark 2 (güç): Student t | 0,78355 | 20000 | 0,779589 | 0,779589 | 0,00293 | +1,35 | ✓ |
| n=10{,}30; SS =3{,}1; fark 2 (güç): Welch t | 0,46715 | 20000 | 0,462907 | 0,462907 | 0,00353 | +1,20 | ✓ |
| n=10{,}30; SS =3{,}1; \alpha=0{,}01: Student t | 0,10115 | 20000 | 0,099544 | 0,099544 | 0,00212 | +0,76 | ✓ |
| n=10{,}30; SS =3{,}1; \alpha=0{,}01: Welch t | 0,01215 | 20000 | 0,010703 | 0,010703 | 7,276170·10−4 | +1,99 | ✓ |
Ölçütü karşılayan: 10/10. Kesin değer: iki bağımsız ki-kare üzerinde iki katlı sayısal tümlev (Python: genelleştirilmiş Gauss-Laguerre, 160 × 160 düğüm; R: iç içe integrate). Bootstrap yüzdelik aralığının kesin değeri yoktur.
Ortalama aralık genişlikleri de beklenen değerle örtüşür: çalıştırma 2'de Student 2,4743 (beklenen 2,4775), Welch 4,2035 (beklenen 4,2115). Bootstrap yüzdelik aralığının kapalı bir değeri yoktur. Yeniden örneklem ortalamaları farkı normal sayılarak aynı tümlevle yapılan yaklaşık hesap varsayılan tasarım için 0,093 reddetme oranı ve 3,51 genişlik verir; benzetim 0,100 ve 3,45 bulur. Aradaki fark, 10 gözlemlik bir gruptan çekilen ortalamaların dağılımının tam normal olmamasından ve sonlu yeniden örnekleme sayısından gelir.
59.7 Çıktıyı okuma
Çalıştırma 2'nin çıktısı (B=20000, boot_B = 499; tablo dört ondalığa yuvarlanmış):
n1 = 10; n2 = 30; SS1 = 3,0; SS2 = 1,0; gerçek fark = 0,0; 20000 benzetim, 499 bootstrap.
Reddetme oranı = Tip I hata (hedef α = 0,05). Kapsama: GA'nın gerçek farkı içerme oranı (hedef 0,950).
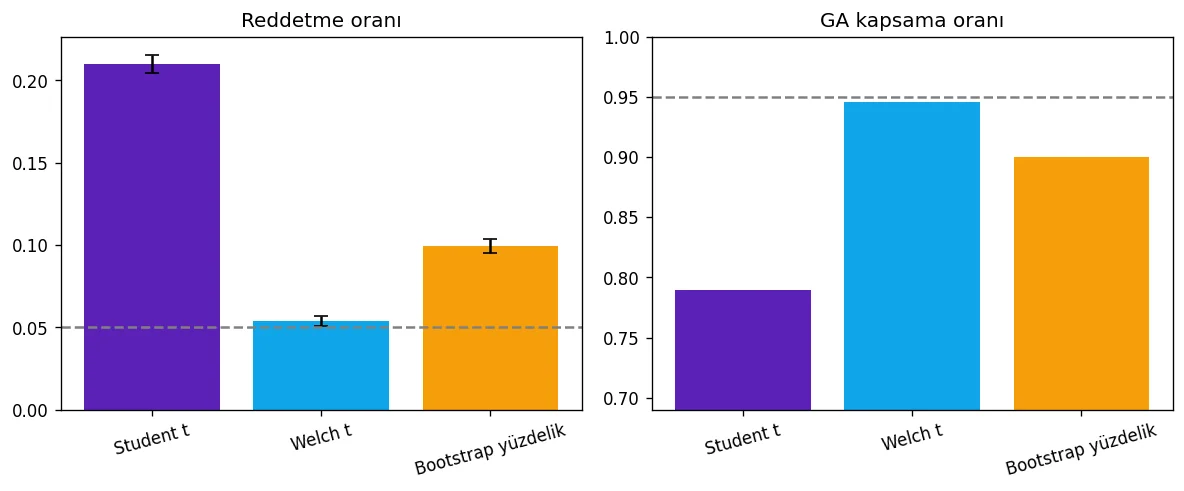
  Student t            reddetme = 0,2100   kapsama = 0,7900
  Welch t              reddetme = 0,0538   kapsama = 0,9462
  Bootstrap yüzdelik   reddetme = 0,0997   kapsama = 0,9003

Yöntem karşılaştırması
            yontem  reddetme_orani  reddetme_ga_alt  reddetme_ga_ust  kapsama  ort_ga_genisligi
         Student t          0.2100           0.2044           0.2156   0.7900            2.4743
           Welch t          0.0538           0.0507           0.0569   0.9462            4.2035
Bootstrap yüzdelik          0.0997           0.0955           0.1038   0.9003            3.4535
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İlk satır | Tasarım: grup büyüklükleri, standart sapmalar, gerçek fark, benzetim ve bootstrap sayıları | Bütün oranlar bu tasarıma özgüdür; başka bir tasarıma taşınmaz. |
| İkinci satır | Reddetme oranının anlamı ve hedefler | Fark 0 ise "Tip I hata (hedef α)", değilse "Güç". |
reddetme_orani |
Aralığı 0'ı içermeyen yapay verilerin oranı | Fark 0 iken \alpha'ya eşit olmalıdır. Student 0,21: nominal düzeyin dört katı. |
reddetme_ga_alt, _ust |
\hat r\mp1{,}96\operatorname{SH} | Monte Carlo belirsizliği. \alpha bu aralığın içindeyse yöntem hedefi tutuyor sayılır. |
kapsama |
Aralığı gerçek farkı içeren yapay verilerin oranı | Hedef 1-\alpha. Fark 0 iken 1- reddetme oranıdır. |
ort_ga_genisligi |
Aralıkların ortalama genişliği | Yalnız kapsaması hedefe yakın yöntemler arasında karşılaştırılır. |
Bu çalıştırmada Welch'in Monte Carlo aralığı [0,0507; 0,0569] 0,05'i kıl payı dışarıda bırakır. Kesin değer 0,0508'dir; gözlenen 0,0538 ondan 1,95 standart hata uzaktadır. Tek bir çalıştırmada üç yöntem ve iki ölçüt birlikte okunduğunda böyle bir sapma olağandır; bir yöntemin hedefi tutmadığı sonucuna tek aralıktan varılmaz.
Şekil 59.1. Şablonun şekli (çalıştırma 2). Sol: reddetme oranı ve Monte Carlo aralığı; kesikli çizgi α = 0,05. Sağ: kapsama; kesikli çizgi 0,95. Dikey eksen sağ panelde en düşük kapsamanın 0,1 altından başlar.
Tasarım ve dağılım değiştiğinde tablo şöyle değişir (fark 0; reddetme oranları; B=20000):
| Çalıştırma | Student t | Welch t | Bootstrap yüzdelik |
|---|---|---|---|
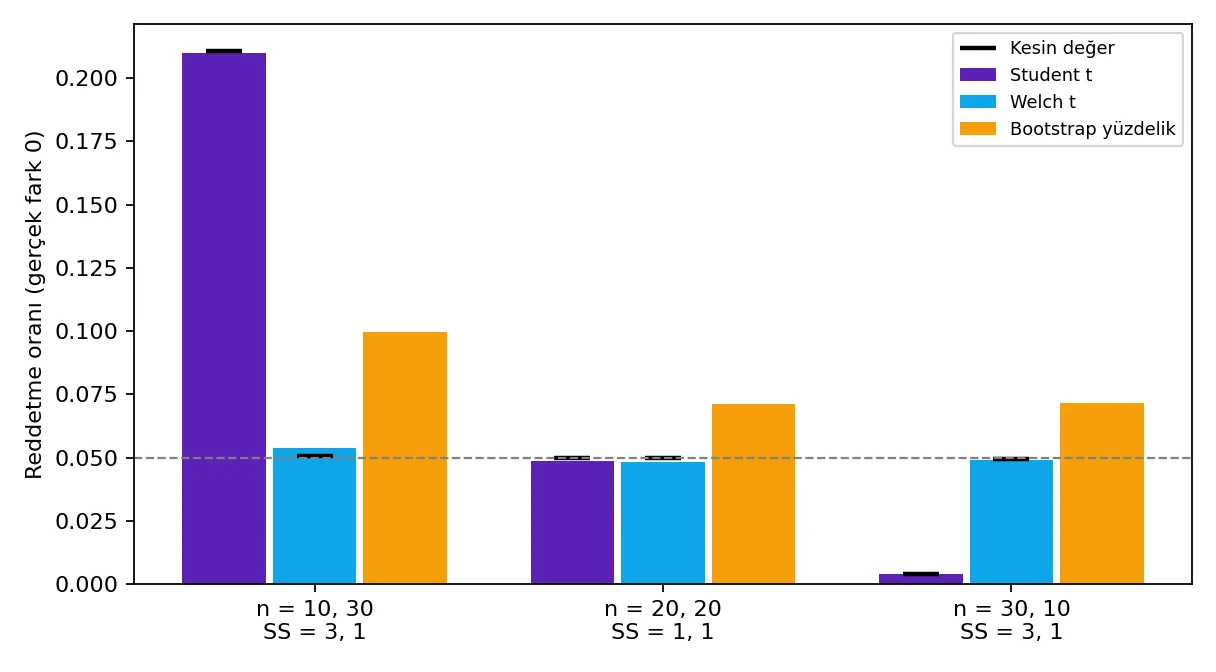
| (2) n=10{,}30; \sigma=3{,}1; normal | 0,2100 | 0,0538 | 0,0997 |
| (3) n=20{,}20; \sigma=1{,}1; normal | 0,0485 | 0,0483 | 0,0713 |
| (4) n=30{,}10; \sigma=3{,}1; normal | 0,0039 | 0,0490 | 0,0717 |
| (6) n=10{,}30; \sigma=3{,}1; t_3 | 0,1984 | 0,0397 | 0,1085 |
| (7) n=10{,}30; \sigma=3{,}1; log-normal | 0,2492 | 0,1511 | 0,1924 |
| (8) n=20{,}20; \sigma=1{,}1; log-normal | 0,0373 | 0,0344 | 0,0898 |
| (9) n=10{,}30; \sigma=3{,}1; normal; \alpha=0{,}01 | 0,1012 | 0,0121 | 0,0556 |
Normal dağılımda Welch her tasarımda hedefi tutar; Student yalnız dengeli ve eş varyanslı tasarımda tutar, öteki ikisinde bir yönde ya da ötekinde sapar. Ağır kuyruklu simetrik dağılımda (t_3) Welch biraz tutucudur. Çarpık dağılımda küçük grup büyük varyanslıyken (7) üç yöntem de hedefi tutmaz: 10 gözlemin ortalaması henüz normale yaklaşmamıştır ve çarpıklık iki grupta farklı ölçeklendiği için fark da çarpıktır. Aynı dağılımda gruplar dengeli ve eş varyanslı olduğunda (8) iki grubun çarpıklığı farkta birbirini götürür ve t yöntemleri tutucu tarafa geçer.
Şekil 59.2. Normal dağılımda üç tasarım (çalıştırmalar 2, 3, 4). Çubuklar benzetimin reddetme oranı, yatay çizgiler Student ve Welch için kesin değerdir. Student'ın hata oranı, büyük varyansın hangi grupta olduğuna göre 0,21 ile 0,004 arasında değişir; Welch üçünde de 0,05'tedir.
Örnek ayarın çıktısı (çalıştırma 1) aynı biçimdedir: Student 0,2300 [0,1717; 0,2883], Welch 0,0500 [0,0198; 0,0802], bootstrap 0,1050 [0,0625; 0,1475]. Sıralama aynıdır, ama aralıklar geniştir: 200 benzetim Welch ile bootstrap'ı ayıramaz.
Rapor cümlesi (çalıştırma 2):
Grup büyüklükleri 10 ve 30, standart sapmaları 3 ve 1 olan iki normal evrenden 20 000 yapay veri üretildi (gerçek fark 0, α = 0,05, tohum 2026). Sıfır farkı reddetme oranı Student t testinde 0,210 (Monte Carlo %95 GA [0,204; 0,216]), Welch t testinde 0,054 ([0,051; 0,057]), bootstrap yüzdelik aralığında (499 yeniden örneklem) 0,100 ([0,095; 0,104]) bulundu. Student ve Welch için sayısal tümlevle hesaplanan kesin değerler 0,211 ve 0,051'dir. %95 güven aralıklarının gerçek farkı kapsama oranları sırasıyla 0,790; 0,946 ve 0,900; ortalama genişlikleri 2,47; 4,20 ve 3,45'tir.
59.8 Sık hatalar ve tuzaklar
- Sonucu tasarımdan bağımsız sanmak. "Student %21 hata yapar" bu tasarımın sonucudur. Büyük varyans büyük gruba geçtiğinde aynı test 0,004 oranında reddeder; gruplar eşitse sorun kaybolur. Kendi n ve varyans oranınızla çalıştırın.
- Örnek ayarla karar vermek. 200 benzetimde 0,05 düzeyindeki oranın Monte Carlo aralığı \mp0{,}03'tür. Karşılaştırma için B en az birkaç bin alınır.
- Güç sütununu yöntemler arasında karşılaştırmak. Hata oranını tutmayan yöntemin "gücü" şişkindir (59.4.4). Önce fark 0 ile çalıştırılır.
- Bootstrap'ı varsayımsız çözüm saymak. Yüzdelik aralık küçük örneklemde dardır: n_1=n_2=3'te reddetme oranı 0,23'e çıkar. Küçük gruplarda bootstrap-t ya da BCa aralığı gerekir; bunlar şablonda yoktur.
- Yeniden örnekleme sayısını α'ya göre ayarlamamak. \alpha=0{,}01 ve 199 yeniden örneklemle bootstrap satırı 0,056 gösterir; bunun bir bölümü yöntemin değil, 0,005 kantilinin iki uç değerden okunmasının sonucudur. Şablon bu durumda uyarı satırı yazar; sayı 1'in altına düşerse (ör. \alpha=0{,}001,
boot_B99) çalıştırmayı durdurur. - Reddetme aralığını her α için %95 dışında yorumlamak. Aralığın çarpanı 1,96 sabittir; \alpha=0{,}01 seçilse de Monte Carlo aralığı %95'liktir.
- Tek sapmayı yöntemin kusuru saymak. Üç yöntem, iki ölçüt: altı karşılaştırmadan birinin Monte Carlo aralığının dışına düşmesi şaşırtıcı değildir. Şüpheli sonuç başka bir tohumla ya da daha büyük B ile yinelenir.
- Normal olmayan dağılım seçeneklerinin standart sapmasını yanlış anlamak. t_3 ve log-normal seçeneklerinde de girilen değerler evren standart sapmalarıdır; şablon çekilişleri buna göre ölçekler. Örneklem standart sapması ağır kuyruklu dağılımda çok oynar.
- Kapsamayı tek başına okumak. Kapsama ile genişlik birlikte değerlendirilir; geniş aralık kolay kapsar.
59.9 Uzman soruları
S1. Student testinin 0,21'lik hata oranı kuramla tutuyor mu?
Evet. Kesin değer 0,210794'tür (59.4.5); B=20000 ile benzetim 0,2100 bulur (fark 0,3 standart hata). Büyük örneklem yaklaşımı da aynı yeri gösterir: gerçek standart hatanın Student'ın kestirdiğine oranı \sqrt{0{,}933/0{,}386}=1{,}555'tir ve 2\Phi(-1{,}96/1{,}555)=0{,}208. Sonuç bir benzetim artığı değil, havuzlanmış varyansın bu tasarımdaki yanlılığıdır.
S2. Welch testi tam mı; 0,0538 bir sorun mu?
Welch testi yaklaşık bir testtir: serbestlik derecesi veriden kestirilir ve t dağılımı yalnız yaklaşımdır. Varsayılan tasarımda kesin hata oranı 0,050779, dengeli tasarımda 0,049644'tür; sapma binde bir düzeyindedir. Çalıştırma 2'deki 0,0538, kesin değerden 1,95 Monte Carlo standart hatası uzaktadır ve şans içindedir; öteki iki normal tasarımda (çalıştırma 3 ve 4) Welch 0,0483 ve 0,0490 verir, kesin değerler 0,0496'dır.
S3. Bootstrap yüzdelik aralığı neden %10 reddediyor; bootstrap eş varyans varsaymıyor ki?
Varsaymıyor; sorun varyans oranında değil, küçük örneklemdedir. Yüzdelik aralık (a) n bölenli varyans kullanır ve (b) t düzeltmesi içermez (59.4.3). Yeniden örneklem ortalamaları farkı normal sayılarak yapılan hesap, sonsuz yeniden örneklemde bile 0,093 reddetme oranı öngörür. Aynı hesap dengeli tasarımda (n=20{,}20) 0,064 verir; benzetim 0,071 bulur. Düzeltmenin yolu bootstrap-t (her kopyada t istatistiğini yeniden hesaplamak) ya da BCa aralığıdır; ikisi de küçük örneklemde yüzdelik aralıktan iyi kapsar (Efron ve Tibshirani, 1993).
S4. Fark sıfır değilken kapsama neden fark sıfırkenkiyle aynı çıkıyor?
Üç aralık da d çevresinde kurulur ve genişlikleri yalnız varyanslara bağlıdır; gerçek fark aralığı kaydırır, biçimini değiştirmez. Aynı tohumla fark 0 ve fark 2 çalıştırmalarında aynı standart normal sayılar kullanıldığından Student ve Welch kapsaması son basamağa kadar aynıdır (0,7900 ve 0,9462). Bootstrap satırı farklı boot_B ile çalıştırıldığı için değişmiştir. Kuramsal olarak da t aralıklarının kapsaması gerçek farktan bağımsızdır.
S5. Log-normal veride Welch neden 0,15'e çıkıyor?
Welch varyans eşitsizliğini düzeltir, normal dışılığı düzeltmez. On gözlemin ortalaması çarpık bir dağılımda hâlâ çarpıktır ve örneklem varyansı ortalamayla ilişkilidir: büyük bir değer hem ortalamayı hem varyansı büyütür. t istatistiğinin dağılımı sola çarpıklaşır ve bir kuyrukta nominalden çok daha sık reddeder. Küçük grup büyük varyanslı olduğunda bu etki farka doğrudan yansır. Gruplar dengeli ve eş ölçekliyken iki grubun çarpıklığı birbirini götürür; aynı dağılımda Welch 0,034'e iner. Çarpık veride dönüşüm (log), medyan temelli yöntemler ya da kırpılmış ortalama (saglam_anova_wrs2, Bölüm 43) düşünülür.
S6. Önce varyans eşitliği sınanıp sonuca göre Student ya da Welch seçilse olmaz mı?
Bu iki aşamalı yol önerilmez. Varyans eşitliği testinin gücü küçük örneklemde düşüktür: eşitsizlik en zararlı olduğu yerde en zor saptanır ve Student'a geçilir. Ayrıca son testin hata oranı, ön testin sonucuna koşullu olduğu için artık nominal değildir. Welch, varyanslar gerçekten eşitken de çok az güç kaybeder (dengeli tasarımda kesin hata oranı 0,0496, ortalama genişlik 1,274'e karşı 1,272). Bu nedenle varsayılan olarak Welch kullanılması önerilir (Delacre, Lakens ve Leys, 2017; Ruxton, 2006).
S7. Reddetme oranının aralığı neden Wald; güç şablonu Wilson kullanıyordu.
Şablon \hat r\mp1{,}96\sqrt{\hat r(1-\hat r)/B} yazar (152–154). Oran sıfıra yakın ve B küçükken Wald aralığı zayıftır: hiç reddetme olmazsa aralık [0; 0] olur. B binler düzeyindeyken ve oran 0,05 çevresindeyken iki aralık pratikte aynıdır: \hat r=0{,}0538, B=20000 için Wald [0,0507; 0,0569], Wilson [0,0508; 0,0570]. Küçük B ile çok küçük oranlar (ör. çalıştırma 4'te Student 0,004) okunurken Wilson aralığı elle hesaplanabilir.
S8. Yeniden örnekleme sayısı 199 ile 499 arasında sonuç değişir mi?
Az. Örnek ayarda boot_B 199'dan 99'a indirildiğinde reddetme oranı aynı kalır (0,105), ortalama genişlik 3,399'dan 3,344'e iner. Sonlu yeniden örnekleme, yüzdelik sınırlarına ek bir oynaklık katar ve aralığı ortalamada biraz daraltır. \alpha=0{,}05 için 499 yeterlidir; asıl belirsizlik B'den gelir. Hesap süresi ise B\cdotboot_B ile orantılıdır.
59.10 Kaynaklar
- Boneau, C. A. (1960). The effects of violations of assumptions underlying the t test. Psychological Bulletin, 57(1), 49–64. https://doi.org/10.1037/h0041412
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall. https://doi.org/10.1201/9780429246593
- Harris, C. R., Millman, K. J., van der Walt, S. J., et al. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hesterberg, T. C. (2015). What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum. The American Statistician, 69(4), 371–386. https://doi.org/10.1080/00031305.2015.1089789
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Morris, T. P., White, I. R., & Crowther, M. J. (2019). Using simulation studies to evaluate statistical methods. Statistics in Medicine, 38(11), 2074–2102. https://doi.org/10.1002/sim.8086
- Moser, B. K., Stevens, G. R., & Watts, C. L. (1989). The two-sample t test versus Satterthwaite's approximate F test. Communications in Statistics - Theory and Methods, 18(11), 3963–3975. https://doi.org/10.1080/03610928908830135
- Ruxton, G. D. (2006). The unequal variance t-test is an underused alternative to Student's t-test and the Mann–Whitney U test. Behavioral Ecology, 17(4), 688–690. https://doi.org/10.1093/beheco/ark016
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Virtanen, P., Gommers, R., Oliphant, T. E., et al. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Welch, B. L. (1938). The significance of the difference between two means when the population variances are unequal. Biometrika, 29(3–4), 350–362. https://doi.org/10.1093/biomet/29.3-4.350
- Welch, B. L. (1947). The generalization of 'Student's' problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28