44. Sağlam genelleştirilmiş doğrusal model: Poisson ve lojistik (Mallows/Huber yarı olabilirlik)
Şablon kimliği: saglam_glm · Kategori: model · Dil: R · Dosya: pro/sablonlar/model/saglam_glm.R (satır 1–181; üstbilgi 1–84) · Örnek veri: _ornek/carrots.csv · Paketler: robustbase 0.99-7, taban R (stats)
44.1 Ne işe yarar
Şablon, sayım (Poisson) ya da oran ve ikili (binom) yanıtlı genelleştirilmiş doğrusal modeli, birkaç aykırı gözlemin katsayıları belirlemesine izin vermeyen bir kestiriciyle kurar ve sonucu klasik (en çok olabilirlik) kestirimle yan yana verir. Cevapladığı soru şudur: "Açıklayıcıların etkisi, modele uymayan birkaç gözlemin ağırlığı azaltıldığında değişiyor mu; hangi gözlemlerin ağırlığı azaltıldı?"
- \mu_i: beklenen sayım (Poisson, g=\ln) ya da başarı olasılığı (binom, g=\operatorname{logit}); \mu_i'=d\mu_i/d\eta_i, V(\mu) varyans fonksiyonu (\mu ya da \mu(1-\mu)).
- n_i: binomda deneme sayısı (Poisson ve 0/1 yanıtta 1).
- r_i=(y_i-n_i\mu_i)/\sqrt{n_iV(\mu_i)}: Pearson artığı.
- \psi_c(r)=\max(-c,\min(c,r)): Huber fonksiyonu; artığı \pm c'de keser.
- w(\mathbf x_i): tasarım ağırlığı (varsayılan 1).
- İkinci denklem, en çok olabilirlik denkleminin (\sum r_i\,\sqrt{n_i}\mu_i'/\sqrt{V_i}\;\mathbf x_i=\mathbf 0) sınırlandırılmış biçimidir (Cantoni ve Ronchetti, 2001).
Ne zaman kullanılır? Sayım ya da oran verisinde birkaç gözlemin modelin öngördüğünden çok uzak olduğu (kayıt hatası, farklı bir alt kitle, olağan dışı bir parsel) düşünülüyorsa; klasik katsayıların tek bir gözleme duyarlı olup olmadığı sorulduğunda; aykırı gözlemleri elle silmek yerine nesnel bir kuralla ağırlıklandırmak istendiğinde.
Ne zaman kullanılmaz?
- Yanıt sürekliyse: temel programdaki Sağlam Regresyon.
- Aykırılık değil, bütün gözlemlere yayılmış aşırı yayılım varsa (varyans her yerde ortalamadan büyük): temel programdaki Poisson / Negatif Binomial Regresyon; yinelenen ölçümde
panel_sayim(Bölüm 40) ya dar_glmmtmb_nb(Bölüm 27). Sağlam GLM aşırı yayılımı modellemez; standart hataları Poisson ya da binom varyansına dayanır. - Poisson modelinde maruziyet (öteleme) gerekiyorsa: şablonda öteleme alanı yoktur; temel programdaki Poisson / Negatif Binomial Regresyon.
- Tam ya da yarı tam ayrışma varsa (küçük örneklemli lojistik):
kesin_lojistik(Bölüm 36). - Grup karşılaştırması isteniyor ve yanıt sürekliyse:
saglam_anova_wrs2(Bölüm 43). - Rastgele etki gerekiyorsa:
glmer_ileri(Bölüm 19); sürekli yanıtta sağlam karma model içinsaglam_karma(Bölüm 28).
Temel programla ilişki. Temel programın İkili Lojistik Regresyon ve Poisson / Negatif Binomial Regresyon çözümlemeleri en çok olabilirlik kestirimini verir; Sağlam Regresyon yalnız sürekli yanıt içindir. Bu şablonun "klasik" sütunu temel programın sonucuyla aynı modeldir; "sağlam" sütunu temel programda bulunmayan Cantoni–Ronchetti kestirimidir. c büyütüldükçe sağlam sütun klasik sütuna yaklaşır (c=10 iken örnek veride altı ondalıkta aynıdır).
44.2 Şablonun girdileri
Form, üstbilgideki on [[param]] bloğundan kurulur (saglam_glm.R:11–83).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | negatif olmayan tam sayılar | Sayım, başarı sayısı ya da 0/1 (98–100). |
Dağılım ailesi · aile |
seçim · Model | poisson |
poisson, binomial |
Log ya da lojit bağlı aile (123). |
Deneme sayısı · deneme |
sayısal sütun · Değişkenler | boş | pozitif tam sayı, ≥ yanıt | Binomda cbind(y, n − y) yanıtı (89, 118); boşsa 0/1 yanıt. Poisson'da kullanılmaz. |
Açıklayıcı değişkenler · x |
sütunlar · Değişkenler | — | en az 1 sütun | Model formülü; metin ve kategorik sütunlar etken olur (111–120). |
Huber ayar sabiti c · c |
ondalık · Model | 1,345 | 0,5–10 | glmrobMqle.control(tcc =) (137). |
Tasarım (x) ağırlıkları · x_agirlik |
seçim · Model | none |
none, hat, covMcd, robCov |
weights.on.x (136). |
Sağlam kestirici · yontem |
seçim · Model | Mqle |
Mqle, BY, WBY, MT |
glmrob(method =) (135–138). |
Oran GA güven düzeyi (%) · guven |
ondalık · Seçenekler | 95 | 50–99,9 | Oran tablosunun Wald aralığı (127–128, 157–158). |
Yakınsama ölçütü · yakinsama |
ondalık · Gelişmiş | 10⁻⁸ | 10⁻¹⁴–0,01 | acc; yalnız Mqle (129, 137). |
En çok yineleme · en_cok_yineleme |
tamsayı · Gelişmiş | 200 | 5–100000 | maxit; yalnız Mqle (130, 137). |
Örnek ayar (ornek_param, satır 9): y = success, deneme = total, aile = binomial, x = logdose, block2, block1, c = 1,2, x_agirlik = none. Aile ve c varsayılandan farklıdır (c=1{,}2, Cantoni'nin (2004) bu veri için kullandığı değerdir).
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 88 |
| Yanıt ve deneme dışında açıklayıcı kalmadı | "Yanıttan farklı en az bir açıklayıcı değişken seçin." | 91 |
| Deneme sütunu yanıtla aynı | "Deneme sayısı yanıttan farklı olmalı." | 92 |
| c pozitif değil | "Ayar sabiti c pozitif olmalı." | 94 |
| Tam satır sayısı < 10 | "En az 10 tam satır gerekli." | 97 |
| Yanıt sayısal değil | "Yanıt sayısal olmalı." | 99 |
| Yanıtta negatif ya da tam olmayan değer | "negatif olmayan tamsayılardan oluşmalı" | 100 |
| Binom, deneme yok, yanıt 0/1 değil | "Deneme sayısı verilmediğinde yanıt 0/1 olmalı." | 103 |
| Deneme sayısal değil, < 1, tam değil ya da < yanıt | "pozitif tamsayı ve başarı sayısından büyük ya da eşit olmalı" | 107 |
| Yanıt sabit | "Yanıt sabit." | 110 |
| Bir açıklayıcı sabit | "'…' sabit; açıklayıcılardan çıkarın." | 115 |
| n< katsayı sayısı + 5 | "Parametre sayısına göre çok az gözlem var." | 121 |
| Tasarım matrisi tam sıralı değil | "Açıklayıcılar doğrusal bağımlı" | 122 |
| BY/WBY, aile binom değil ya da deneme verilmiş | "yalnız deneme sütunu olmayan (0/1 yanıtlı) binom modelde" | 125 |
| MT, aile Poisson değil | "yalnız Poisson modelde" | 126 |
| MCD/MVE ağırlığı, sağlam kovaryans tekil | "tasarım ağırlıkları hesaplanamadı … Şapka değeri ağırlıklarını seçin" | 141 |
| Klasik ya da sağlam model kurulamadı | "… kurulamadı: …" | 134, 143 |
| Sağlam katsayılar ya da kovaryans sonlu değil | "model yakınsamadı" / "kovaryans matrisi hesaplanamadı" | 145, 147 |
Eksik değerli satırlar sessizce atılır (satır 96); kalan satır sayısı özet satırındaki n'dir. Paket uyarıları toplanır ve "Uyarılar:" satırında yazılır (132, 175); algoritma yakınsamazsa özet satırı "YAKINSAMADI" der.
Yanıt ya da deneme sütunu veri sekmesinde "kategorik" türdeyse şablon durur (satır 99, 107). Sayısal bir açıklayıcı "kategorik" türdeyse etken olarak modele girer: her değeri ayrı bir gösterge katsayısı alır (44.8).
44.3 Örnek veri
Dosya: _ornek/carrots.csv. Phelps'in (1982) havuç sineği denemesi; McCullagh ve Nelder (1989) ile Cantoni ve Ronchetti'nin (2001) kullandığı veri. Üç blokta sekiz böcek ilacı dozu: 24 parsel. Her parselde havuç sayısı ve sinek larvasından zarar görmüş havuç sayısı kaydedilmiştir. Eksik değer yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
success |
Yanıt | sayısal | Zarar görmüş havuç sayısı; 1–17. |
total |
Deneme sayısı | sayısal | Parseldeki havuç sayısı; 22–50; toplam 900. |
logdose |
Açıklayıcı | sayısal | Dozun logaritması; 1,52–2,36 (sekiz düzey, 0,12 adım). |
block2, block1 |
Açıklayıcı | ikili (0/1) | Blok göstergeleri; referans blok B3. |
block |
kullanılmaz | kategorik | B1, B2, B3 (göstergelerin kaynağı). |
Örnek ayar blok etkisini iki hazır gösterge sütunuyla kurar. block sütunu doğrudan seçilirse R etkeni ilk düzeyi (veri sekmesinin sırasında ilk görülen: B1) referans alır; katsayılar "B2 − B1" ve "B3 − B1" olur, uyum ve ağırlıklar değişmez (çalıştırma 6).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) c=1{,}345; (3) c=10; (4) x_agirlik = hat; (5) guven = 90; (6) açıklayıcılar logdose, block; (7) Poisson ailesi (yanıt success, c=1{,}345); (8) aynı verinin 0/1 biçimine açılmış hâli (900 satır; Mqle ve BY).
44.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) sütunlar alınır, eksik satırlar atılır, denetimler yapılır; (2) klasik model glm ile kurulur; (3) sağlam model glmrob ile kurulur; (4) katsayı, oran, ağırlık tabloları yazılır; (5) ağırlık grafiği çizilir.
44.4.1 Sınırlandırma ve Fisher tutarlılığı
En çok olabilirlik denkleminde her gözlem Pearson artığıyla orantılı katkı yapar; artık büyüdükçe katkı sınırsız büyür ve tek bir gözlem \hat{\boldsymbol\beta}'yı istediği yere çekebilir. Huber fonksiyonu katkıyı \pm c'de keser. Kesmenin bir bedeli vardır: Poisson ve binom dağılımları çarpıktır, bu yüzden model doğru olsa bile E\,\psi_c(r_i)\ne0'dır ve kesilmiş denklem yanlı bir kestirici verir. Düzeltme, beklenen değerin çıkarılmasıdır:
- Toplam, yanıtın alabileceği bütün değerler üzerindedir: binomda j=0,\dots,n_i; Poisson'da j=0{,}1{,}2,\dots (kuyruk ihmal edilebilir olana kadar).
- P(Y_i=j): o andaki \mu_i ile binom ya da Poisson olasılığı.
Neden beklenen değer çıkarılır?
Bir kestirim denklemi, model doğruyken beklenen değeri sıfır olduğunda doğru parametreyi hedefler (Fisher tutarlılığı). \psi_c simetrik keser, dağılım ise simetrik değildir: örnek veride 14. parsel için a_{14}=-0{,}0215'tir; küçük \mu'lü hücrelerde artık sağa çarpık olduğundan kesme en çok pozitif tarafı budar ve beklenti negatife kayar. a_i çıkarılmazsa kestirim sistematik olarak kayar; çıkarıldığında denklem her c için yansızdır. c\to\infty iken \psi_c(r)=r, a_i=0 olur ve denklem en çok olabilirlik denklemine iner.
Ayar sabiti. c, Pearson artığı ölçeğinde "olağan" ile "aykırı" arasındaki eşiktir. c=1{,}345 (paket varsayılanı), normal dağılımlı artıklarda Huber kestiricisine %95 etkinlik veren değerdir; kesikli ve çarpık dağılımlarda etkinlik bu değerden sapar. c küçüldükçe daha çok gözlemin ağırlığı azalır: örnek veride c=1{,}2 ile 9, c=1{,}345 ile 7 parselin ağırlığı 1'in altındadır.
44.4.2 Sağlamlık ağırlıkları
- \lvert r_i\rvert\le c ise ağırlık 1'dir: gözlem denkleme tam katkı yapar.
- \lvert r_i\rvert>c ise ağırlık artığın büyüklüğüyle ters orantılı azalır; hiçbir gözlem tümüyle atılmaz.
- Şablon ağırlığı 0,999'un altında olanları "ağırlığı 1'in altında" sayar (satır 166).
Ağırlıklar kestirimin yan ürünüdür ve tanı aracıdır: düşük ağırlıklı gözlemler, sağlam modelin "uymuyor" dediği gözlemlerdir. Artıklar sağlam uyuma göre hesaplandığından aykırı gözlem kendi artığını küçültemez (klasik modelde aykırı gözlem uyumu kendine çeker ve artığı olduğundan küçük görünür).
44.4.3 Tasarım ağırlıkları (Mallows)
\psi_c yalnız yanıt yönündeki aykırılığı sınırlar. Açıklayıcı uzayında uçta duran (kaldıraçlı) bir gözlem, artığı küçük olsa da kestirimi etkileyebilir; w(\mathbf x_i) böyle gözlemlerin katkısını azaltır.
| Seçenek | Ağırlık | Not |
|---|---|---|
none |
1 | Huber yarı olabilirlik; paketin ve şablonun varsayılanı. |
hat |
(1-h_{ii})^2 | h_{ii}: sabit terimli tasarım matrisinin şapka değeri. |
covMcd |
\big[1+\max\!\big(0,\ 8(D_i^2-p)/\sqrt{2p}\big)\big]^{-1/2} | D_i^2: MCD merkez ve kovaryansıyla sağlam Mahalanobis uzaklığı; p: açıklayıcı sayısı. |
robCov |
aynı biçim | Merkez ve kovaryans MASS::cov.rob (MVE) ile. |
Şapka değeri seçeneğinde uygulanan ağırlık (1 − h)²'dir
Formdaki etiket "Şapka değeri (1 − h)²" yazar. robustbase'in bu sürümünde weights.on.x = "hat" seçeneği ağırlığı (1-h_{ii})^2 olarak hesaplar (robXweights: wts_HiiDist(X)^2, wts_HiiDist =1-h_{ii}); paketin yardım sayfası ağırlığı \sqrt{1-h_{ii}} diye tarif eder, kod ise bunun karesini uygular. Örnek veride ağırlıklar 0,605 ile 0,762 arasındadır (\sqrt{1-h} ile 0,882–0,934 olurdu). Bağımsız hesap şablonun sonucunu (1-h)^2 ile yeniden üretir (44.6.1).
Sağlam Mahalanobis ağırlıkları gösterge değişkenlerle çalışmaz
MCD ve MVE, gözlemlerin en az yarısını içeren en sıkı alt kümeyi arar. Bir gösterge değişken gözlemlerin yarısından çoğunda aynı değeri alıyorsa bu alt kümenin kovaryans matrisi tekildir. Örnek ayarda (iki blok göstergesi) şablon açıklayıcı bir iletiyle durur (satır 141). Bu ağırlıklar yalnız sürekli açıklayıcılarda anlamlıdır.
44.4.4 Kovaryans matrisi ve çıkarım
k_i=\sqrt{n_i}\,\mu_i'/\sqrt{V(\mu_i)} olmak üzere:
- \mathbf M: kestirim denkleminin beklenen türevi (eksi işaretli); \mathbf Q: kestirim fonksiyonunun varyansı. İkisi de model dağılımı üzerinden beklenen değerlerdir, gözlenen artıklardan hesaplanmaz.
- Lojit ve log bağda k_i^2=n_i\mu_i(1-\mu_i) ve k_i^2=\mu_i'dir.
- c\to\infty iken E[\psi r]=E[\psi^2]=1, \boldsymbol\alpha=\mathbf 0 ve kovaryans olağan (\mathbf X^{\top}\mathbf W\mathbf X)^{-1}'e iner.
Her katsayı için z=\hat\beta/\operatorname{SH}, p=2\Phi(-\lvert z\rvert). Poisson ailesinde ve deneme sütunlu binomda sabit dışındaki katsayılar oran ölçeğine çevrilir: e^{\hat\beta}, güven aralığı e^{\hat\beta\mp z_q\operatorname{SH}}.
Koddaki tercih
Kovaryans saglam$cov'dan alınır (satır 146); paketin sandviç formülü yukarıdaki gibidir. Güven düzeyi %95 iken z_q=1{,}96 alınır, öteki düzeylerde qnorm ile tam kantil kullanılır (128). Olasılık oranları tablosu Poisson ailesinde ve deneme sütunu verilmiş binomda yazılır (156); 0/1 yanıtlı lojistik modelde oranlar katsayı tablosundan e^{\hat\beta} ile hesaplanır.
44.4.5 Yineleme ve öteki kestiriciler
Koddaki tercih
robustbase::glmrob(method = "Mqle") klasik kestirimden başlar ve Fisher puanlama adımını (\boldsymbol\beta\leftarrow\boldsymbol\beta+\mathbf M^{-1}\mathbf U, \mathbf U kestirim denkleminin ortalaması) katsayıların göreli değişimi acc'nin altına düşene kadar yineler. Şablon acc = 1e-8 ve maxit = 200 verir (satır 129–130, 137); paketin varsayılanları 10^{-4} ve 50'dir. Örnek veride 10^{-4} ile 9, 10^{-8} ile 18 yinelemede durulur; katsayılar beşinci ondalıkta ayrışır (sabit 1,938620 ↔ 1,938696). Klasik model stats::glm ile varsayılan toleransta kurulur (133).
yontem alanı üç kestirici daha sunar; bunlarda c, tasarım ağırlıkları, yakınsama ölçütü ve en çok yineleme kullanılmaz:
- BY (Bianco ve Yohai, 1996; Croux ve Haesbroeck, 2003): 0/1 yanıtlı lojistik model için sınırlı bir sapma fonksiyonunu en küçükler; yanlılık düzeltme terimi içerir. WBY aynı kestiriciyi ağırlıklı en çok olabilirlik başlangıcıyla kurar; çoğu veride BY ile aynı noktaya yakınsar.
- MT (Valdora ve Yohai, 2014): Poisson için, yanıtın varyans dengeleyici dönüşümü (\sqrt y) üzerinden M-kestirici; başlangıç değeri rastgele alt örneklemlerden seçildiğinden sonuç tohuma bağlıdır.
BY ve WBY gözlem ağırlığı bildirmez; bu kestiricilerde şablonun ağırlık tablosu ve grafiği bütün ağırlıkları 1 gösterir ve aykırı gözlem tanısı için kullanılamaz (44.8).
44.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–84 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on parametre. | Form buradan kurulur (Bölüm 1.2). |
| 85–97 | Paket, deneme sütununun belirlenmesi (yalnız binomda), açıklayıcı listesi, c denetimi, tam satırlar. | Poisson'da deneme sütunu verilse de kullanılmaz (89). |
| 98–116 | Yanıt, deneme ve açıklayıcı denetimleri; metin sütunların etkene çevrilmesi. | Etkenin referans düzeyi ilk düzeydir (Bölüm 1.3). |
| 117–131 | Formül (cbind(y, n − y) ~ … ya da y ~ …), tasarım matrisi, sıra denetimi, aile, yöntem, z_q, tolerans. |
Sütun adları ters tırnakla korunur (117). |
| 132–143 | Uyarı toplayıcı; klasik glm; sağlam glmrob; MCD/MVE tekillik iletisi. |
Mqle dışındaki yöntemlere yalnız method verilir (138). |
| 144–155 | Katsayı ve SH'lerin alınması, özet satırı, katsayı tablosu. | Özet satırı c ve x ağırlığını her yöntemde yazar. |
| 156–161 | Oran tablosu (Poisson ya da deneme sütunlu binom). | e^{\hat\beta} ve Wald aralığı. |
| 162–175 | Ağırlıklar, Pearson artıkları, ağırlık özeti, en düşük ağırlıklı en çok 10 gözlem, uyarılar. | satir veri sekmesindeki satır numarasıdır (170); uyum beklenen sayımdır (n_i\hat\mu_i). |
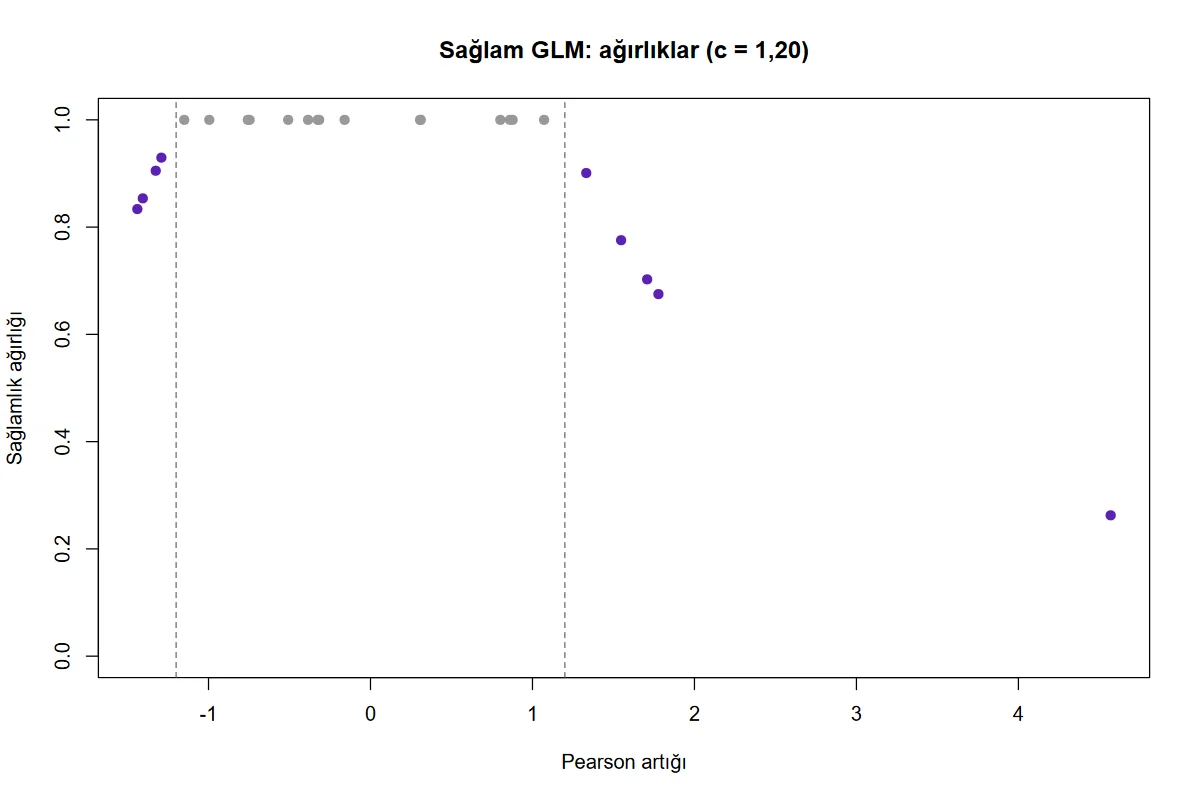
| 176–181 | Pearson artığı–ağırlık grafiği, \pm c çizgileri. | Mor noktalar ağırlığı azaltılan gözlemlerdir. |
44.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/saglam_glm/elle_hesap.py ile, robustbase ve şablon kodu kullanılmadan hesaplanmıştır: kestirim denklemi ve E\,\psi_c düzeltmesi binom olasılıkları üzerinden tam toplamla, kök Fisher puanlamayla, kovaryans 44.4.4'teki formüllerle. R tarafında (r_dogrulama.R) aynı denklemin kökü sayısal Jacobian'lı Newton yinelemesiyle bulunmuş, \mathbf M beklenen kestirim fonksiyonunun sayısal türevinden alınmıştır.
Adım 1 — Klasik kestirim (başlangıç). Kendi yinelemeli ağırlıklı en küçük kareler çözümümüz: sabit 1,480256; logdose −1,817404; block2 0,843271; block1 0,542390.
Adım 2 — Sağlam kestirim (c=1{,}2). Fisher puanlama 30 adımda kestirim denklemini 10^{-13}'e indirir:
| Sabit | logdose | block2 | block1 | |
|---|---|---|---|---|
| \hat\beta | 1,938696 | −2,049155 | 0,684738 | 0,449616 |
| SH | 0,697464 | 0,368479 | 0,236049 | 0,240913 |
| z | 2,7796 | −5,5611 | 2,9008 | 1,8663 |
Adım 3 — 14. parsel (blok 2, logdose 2,12; 42 havuçtan 17'si zararlı). \hat\eta=1{,}938696-2{,}049155\times2{,}12+0{,}684738=-1{,}720774; \hat\mu=0{,}151772; beklenen sayım 42\times0{,}151772=6{,}374404.
Bu parselin Fisher tutarlılığı düzeltmesi a_{14}=E\,\psi_{1{,}2}(r_{14})=-0{,}021515'tir (43 olası sayım üzerinden toplam).
Adım 4 — Ağırlıkların özeti. 24 parselden 9'unun ağırlığı 1'in altındadır; en küçük 0,262606 (parsel 14), sonraki 0,675063 (parsel 6); ortalama 0,909944.
Adım 5 — Olasılık oranı (logdose). e^{-2{,}049155}=0{,}128844; %95 GA =\exp(-2{,}049155\mp1{,}96\times0{,}368479)=[0{,}062576;\ 0{,}265289].
Adım 6 — Öteki çalıştırmalar. c=1{,}345: sabit 1,930081; logdose −2,052491; ağırlığı azalan 7 parsel; en küçük ağırlık 0,293677. Poisson ailesi (c=1{,}345): sabit 4,749501; logdose −1,720970 (SH 0,311502); ağırlığı azalan 3 parsel. Şapka ağırlığı (1-h)^2: sabit 1,902317; logdose −2,051007. 0/1 biçimi (900 satır): sabit 1,536281; logdose −1,817206; SH 0,360411.
44.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1, 2, 4, 5, 7, 8).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Sağlam \hat\beta sabit | 1,93869552 | 1,93869554 | 1,93869554 | 6,5e−9 | ✓ |
| Sağlam \hat\beta logdose | −2,04915455 | −2,04915455 | −2,04915455 | 3,8e−9 | ✓ |
| Sağlam \hat\beta block2 | 0,68473836 | 0,68473836 | 0,68473836 | 5,4e−10 | ✓ |
| Sağlam \hat\beta block1 | 0,44961582 | 0,44961581 | 0,44961581 | 2,6e−9 | ✓ |
| Sağlam SH sabit | 0,69746401 | 0,69746401 | 0,69746401 | 7,3e−10 | ✓ |
| Sağlam SH logdose | 0,36847912 | 0,36847912 | 0,36847912 | 4,8e−10 | ✓ |
| Sağlam SH block2 | 0,23604873 | 0,23604873 | 0,23604873 | 1,5e−10 | ✓ |
| Sağlam SH block1 | 0,24091322 | 0,24091322 | 0,24091322 | 2,3e−10 | ✓ |
| z logdose | −5,56111449 | −5,5611145 | −5,5611145 | 2,5e−9 | ✓ |
| p block1 | 0,06199971 | 0,06199971 | — | 1,7e−9 | ✓ |
| Klasik \hat\beta sabit | 1,48025552 | 1,48025552 | 1,48025552 | 1,4e−10 | ✓ |
| Klasik \hat\beta logdose | −1,81740435 | −1,81740435 | −1,81740435 | 8,5e−11 | ✓ |
| Klasik \hat\beta block2 | 0,84327141 | 0,84327141 | 0,84327141 | 6,3e−11 | ✓ |
| Klasik \hat\beta block1 | 0,54238978 | 0,54238978 | 0,54238978 | 5,7e−11 | ✓ |
| Klasik SH sabit | 0,65620672 | 0,65620858 | 0,65620672 | 1,9e−6 | ✗ |
| Klasik SH logdose | 0,34386884 | 0,34387005 | 0,34386884 | 1,2e−6 | ✗ |
| Klasik SH block2 | 0,22603538 | 0,22603618 | 0,22603538 | 8,0e−7 | ✓ |
| Klasik SH block1 | 0,23179553 | 0,23179633 | 0,23179553 | 8,0e−7 | ✓ |
| Olasılık oranı logdose | 0,12884379 | 0,12884379 | — | 1,0e−9 | ✓ |
| Olasılık oranı GA alt logdose (z=1{,}96) | 0,06257599 | 0,06257599 | — | 5,5e−10 | ✓ |
| Olasılık oranı GA üst logdose (z=1{,}96) | 0,265289 | 0,265289 | — | 1,8e−9 | ✓ |
| Olasılık oranı block2 | 1,98325286 | 1,98325287 | — | 5,4e−10 | ✓ |
| Olasılık oranı GA alt block2 (z=1{,}96) | 1,24867481 | 1,24867481 | — | 2,4e−10 | ✓ |
| Olasılık oranı GA üst block2 (z=1{,}96) | 3,14997298 | 3,14997299 | — | 8,4e−10 | ✓ |
| Olasılık oranı block1 | 1,56770978 | 1,56770978 | — | 2,6e−9 | ✓ |
| Olasılık oranı GA alt block1 (z=1{,}96) | 0,9776788 | 0,9776788 | — | 2,9e−9 | ✓ |
| Olasılık oranı GA üst block1 (z=1{,}96) | 2,51382557 | 2,51382556 | — | 2,1e−9 | ✓ |
| Ağırlığı 1'in altında (adet) | 9 | 9 | 9 | 0 | ✓ |
| En küçük ağırlık | 0,26260571 | 0,26260571 | 0,26260571 | 7,8e−10 | ✓ |
| Ortalama ağırlık | 0,90994407 | 0,90994407 | 0,90994407 | 3,6e−10 | ✓ |
| Satır 14: uyum | 6,37440409 | 6,37440407 | 6,37440407 | 2,9e−9 | ✓ |
| Satır 14: Pearson artığı | 4,56958833 | 4,56958834 | 4,56958834 | 3,0e−9 | ✓ |
| Satır 6: ağırlık | 0,67506263 | 0,67506262 | — | 7,0e−9 | ✓ |
| %90 GA alt, logdose (tam kantil) | 0,07028135 | 0,07028135 | — | 6,1e−10 | ✓ |
| c=1{,}345: \hat\beta sabit | 1,9300806 | 1,93008061 | 1,93008061 | 5,2e−9 | ✓ |
| c=1{,}345: \hat\beta logdose | −2,05249106 | −2,05249107 | −2,05249107 | 2,9e−9 | ✓ |
| c=1{,}345: \hat\beta block2 | 0,69780649 | 0,69780649 | 0,69780649 | 9,9e−11 | ✓ |
| c=1{,}345: \hat\beta block1 | 0,49924751 | 0,4992475 | 0,4992475 | 7,1e−9 | ✓ |
| c=1{,}345: SH sabit | 0,69003573 | 0,69003573 | 0,69003573 | 8,8e−10 | ✓ |
| c=1{,}345: SH logdose | 0,36456457 | 0,36456457 | 0,36456457 | 5,5e−10 | ✓ |
| c=1{,}345: SH block2 | 0,23480482 | 0,23480482 | 0,23480482 | 1,0e−10 | ✓ |
| c=1{,}345: SH block1 | 0,23858728 | 0,23858728 | 0,23858728 | 2,8e−10 | ✓ |
| şapka ağırlığı (1-h)^2: \hat\beta sabit | 1,90231734 | 1,90231736 | 1,90231736 | 8,2e−9 | ✓ |
| şapka ağırlığı (1-h)^2: \hat\beta logdose | −2,05100744 | −2,05100745 | −2,05100745 | 4,7e−9 | ✓ |
| şapka ağırlığı (1-h)^2: \hat\beta block2 | 0,7066219 | 0,7066219 | 0,7066219 | 5,2e−10 | ✓ |
| şapka ağırlığı (1-h)^2: \hat\beta block1 | 0,49783951 | 0,49783951 | 0,49783951 | 3,2e−9 | ✓ |
| şapka ağırlığı (1-h)^2: SH sabit | 0,70289747 | 0,70289747 | 0,70289747 | 9,0e−10 | ✓ |
| şapka ağırlığı (1-h)^2: SH logdose | 0,37133367 | 0,37133367 | 0,37133367 | 5,9e−10 | ✓ |
| şapka ağırlığı (1-h)^2: SH block2 | 0,23942566 | 0,23942566 | 0,23942566 | 1,9e−10 | ✓ |
| şapka ağırlığı (1-h)^2: SH block1 | 0,24363185 | 0,24363185 | 0,24363185 | 2,8e−10 | ✓ |
| Poisson, c=1{,}345: \hat\beta sabit | 4,74950138 | 4,74950138 | 4,74950138 | 4,0e−10 | ✓ |
| Poisson, c=1{,}345: \hat\beta logdose | −1,72096992 | −1,72096992 | −1,72096992 | 9,8e−10 | ✓ |
| Poisson, c=1{,}345: \hat\beta block2 | 0,60916592 | 0,60916593 | 0,60916593 | 1,6e−9 | ✓ |
| Poisson, c=1{,}345: \hat\beta block1 | 0,51084108 | 0,51084109 | 0,51084109 | 1,6e−9 | ✓ |
| Poisson, c=1{,}345: SH sabit | 0,59038542 | 0,59038542 | 0,59038524 | 1,8e−7 | ✓ |
| Poisson, c=1{,}345: SH logdose | 0,31150181 | 0,31150181 | 0,31150172 | 8,5e−8 | ✓ |
| Poisson, c=1{,}345: SH block2 | 0,21123053 | 0,21123053 | 0,21123053 | 6,5e−11 | ✓ |
| Poisson, c=1{,}345: SH block1 | 0,21507549 | 0,21507549 | 0,21507554 | 4,7e−8 | ✓ |
| Poisson: klasik \hat\beta logdose | −1,50917802 | −1,50917802 | −1,50917802 | 3,5e−15 | ✓ |
| Poisson: klasik SH logdose | 0,29204464 | 0,29204464 | 0,29204464 | 4,1e−10 | ✓ |
| 0/1 yanıt (900 satır): \hat\beta sabit | 1,5362812 | 1,5362812 | — | 5,6e−10 | ✓ |
| 0/1 yanıt (900 satır): \hat\beta logdose | −1,81720561 | −1,81720561 | — | 2,3e−10 | ✓ |
| 0/1 yanıt (900 satır): \hat\beta block2 | 0,75794345 | 0,75794345 | — | 1,9e−10 | ✓ |
| 0/1 yanıt (900 satır): \hat\beta block1 | 0,48883873 | 0,48883873 | — | 1,2e−10 | ✓ |
| 0/1 yanıt: SH logdose | 0,36041118 | 0,36041118 | — | 1,2e−11 | ✓ |
Ölçütü karşılayan: 63/65. Python: kestirim denklemi, E\psi_c düzeltmesi (binom ya da Poisson olasılıkları üzerinden tam toplam), Fisher puanlama, M ve Q matrisleri numpy ile (robustbase kullanılmadan); klasik model kendi IRLS yinelemesiyle. R: aynı denklemin kökü sayısal Jacobian'lı Newton ile, M beklenen kestirim fonksiyonunun sayısal türevinden; klasik model stats::glm.
Ölçütü karşılamayan iki satır klasik sütunun standart hatalarıdır. Şablon klasik modeli glm'in varsayılan toleransıyla (sapmanın göreli değişimi 10^{-8}) kurar; yineleme bu ölçütte durduğunda katsayılar 10^{-7}, standart hatalar 2\times10^{-6} içinde kalır. R sütunu da glm olduğundan şablonla aynıdır; Python sütunu tam yakınsamış değerdir (0,656209). c=10 çalıştırmasında sağlam sütunun standart hatası da 0,656209'dur.
44.7 Çıktıyı okuma
Örnek ayarın konsol satırı ve tabloları (şablonun tablolarından, altı ondalığa yuvarlanmış):
n = 24; aile binomial; c = 1,200; x ağırlıkları: none; 18 yinelemede yakınsadı

Katsayılar: sağlam (Mqle) ve klasik (en çok olabilirlik)
      terim     saglam  saglam_SH          z         p     klasik  klasik_SH
(Intercept)   1.938696   0.697464   2.779635  0.005442   1.480256   0.656207
    logdose  -2.049155   0.368479  -5.561114  0.000000  -1.817404   0.343869
     block2   0.684738   0.236049   2.900835  0.003722   0.843271   0.226035
     block1   0.449616   0.240913   1.866298  0.062000   0.542390   0.231796

Olasılık oranları (sağlam, %95 Wald GA)
  terim  saglam_oran    GA_alt    GA_ust  klasik_oran
logdose     0.128844  0.062576  0.265289     0.162447
 block2     1.983253  1.248675  3.149973     2.323957
 block1     1.567710  0.977679  2.513826     1.720113

Artık sağlamlık ağırlıkları (1 = tam ağırlık)
                olcut      deger
                    n  24.000000
ağırlığı 1'in altında   9.000000
                  min   0.262606
               medyan   1.000000
             ortalama   0.909944

En düşük ağırlıklı gözlemler
 satir  success  total       uyum  pearson_artik   agirlik
    14       17     42   6.374404       4.569588  0.262606
     6        9     42   5.204298       1.777613  0.675063
     5        9     35   5.360740       1.708052  0.702555
     2       16     42  11.525719       1.547202  0.775593
    21        2     49   5.068378      -1.439408  0.833676
    ...
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Özet satırı | n, aile, c, x ağırlığı, yineleme sayısı ve yakınsama | "YAKINSAMADI" görülürse sonuç kullanılmaz; en çok yineleme artırılır. |
saglam, saglam_SH, z, p |
Sağlam katsayı (bağ ölçeğinde), sandviç SH, Wald testi | Çıkarım bu sütunlardan yapılır. |
klasik, klasik_SH |
En çok olabilirlik katsayısı ve SH'si | Sağlam sütunla farkı, aykırı gözlemlerin klasik sonucu ne kadar çektiğini gösterir. |
saglam_oran, GA_* |
e^{\hat\beta} ve Wald aralığı | Lojistikte olasılık oranı, Poisson'da hız oranı. Log dozda bir birimlik artış zarar olasılık oranını 0,129 katına indirir. |
| Ağırlık özeti | Ağırlığı azalan gözlem sayısı, en küçük, medyan, ortalama | Ortalama 1'e yakın ve yalnız birkaç gözlem düşükse model verinin çoğuna uyuyor demektir. |
uyum, pearson_artik, agirlik |
Beklenen sayım, sağlam uyuma göre Pearson artığı, ağırlık | Parsel 14: beklenen 6,4, gözlenen 17; artık 4,57. |
Örnekteki bulgu. Tek bir parsel (14) belirgin biçimde aykırıdır. Klasik kestirim bu parselin etkisiyle doz eğimini sıfıra doğru çeker (−1,817) ve blok 2'nin etkisini büyütür (0,843; parsel blok 2'dedir); sağlam kestirimde eğim −2,049, blok 2 etkisi 0,685'tir. Sonuç yönünde değişiklik yoktur, büyüklükte vardır: olasılık oranı 0,162 yerine 0,129'dur. Blok 1 katsayısı sağlam modelde %5 düzeyinde anlamlı değildir (p=0{,}062); klasik modelde z=2{,}34'tür.
Şekil 44.1. Şablonun şekli (örnek ayar): sağlam uyuma göre Pearson artıkları ve sağlamlık ağırlıkları. Kesikli çizgiler ±c = ±1,2; çizgilerin dışındaki gözlemlerin ağırlığı c/|r| eğrisi boyunca azalır. En sağdaki nokta 14. parseldir.
Rapor cümlesi (örnek ayar):
Zarar görmüş havuç oranı, log doz ve blok açıklayıcılarıyla Cantoni–Ronchetti sağlam yarı olabilirlik kestiricisiyle (Huber sabiti c = 1,2; robustbase paketi) modellendi. Log dozdaki bir birimlik artış zarar olasılık oranını 0,13 katına indirdi (OO = 0,129; %95 GA [0,063; 0,265]; z = −5,56; p < 0,001). 24 parselden 9'unun ağırlığı azaltıldı; en düşük ağırlık (0,26) 14. parseldeydi (gözlenen 17, beklenen 6,4 zararlı havuç). En çok olabilirlik kestirimi daha zayıf bir doz etkisi verdi (OO = 0,162).
44.8 Sık hatalar ve tuzaklar
- Aşırı yayılımı aykırı gözlem sanmak. Gözlemlerin yarısının ağırlığı 1'in altındaysa sorun birkaç aykırı gözlem değil, varyans modelinin yetersizliğidir. Sağlam GLM'nin standart hataları binom ya da Poisson varyansını varsayar; yaygın aşırı yayılımda küçük kalır. O durumda negatif binom, yarı olabilirlik ya da rastgele etkili model kurulur.
- Gruplanmış ve 0/1 veriyi eşdeğer saymak. Klasik lojistik regresyonda başarı/deneme biçimi ile satır başına 0/1 biçimi aynı katsayıları verir. Sağlam kestirimde vermez: aykırılık Pearson artığıyla ölçülür ve artık, gözlemin tanımına bağlıdır. Havuç verisi 900 satırlık 0/1 biçimine açıldığında sabit 1,939 yerine 1,536, eğim −2,049 yerine −1,817 bulunur; "aykırı parsel" artık yoktur, yalnız düşük olasılıklı tek tek havuçlar vardır. Aykırılığın beklendiği birim (parsel, hasta, gün) neyse veri o düzeyde verilir.
- 0/1 yanıtta sınırlı korumayı gözden kaçırmak. İkili yanıtta Pearson artığı \sqrt{(1-\mu)/\mu} ile sınırlıdır; ancak çok düşük ya da çok yüksek kestirilen olasılıklarda büyür. Huber kesmesi orta olasılıklarda hiçbir gözlemi etkilemez. İkili veride yanlış sınıflanmış gözlemlere karşı BY kestiricisi ya da tasarım ağırlıkları daha uygundur.
- BY ve WBY'de ağırlık tablosuna bakmak. Bu kestiriciler gözlem ağırlığı üretmez; tablo "ağırlığı 1'in altında 0" yazar ve grafik düz bir çizgidir. Bu, aykırı gözlem olmadığı anlamına gelmez. Tanı için aynı model Mqle ile de çalıştırılır. Özet satırındaki c ve x ağırlığı da bu yöntemlerde kullanılmaz.
- Şapka ağırlığını \sqrt{1-h} sanmak. Paketin yardım sayfası ağırlığı \sqrt{1-h} diye tarif eder; uygulanan ağırlık (1-h)^2'dir ve formdaki etiket de bunu yazar (44.4.3).
- Sayısal açıklayıcıyı "kategorik" türde bırakmak. Veri sekmesinde türü "kategorik" olan sayısal bir sütun etken olarak girer:
logdoseiçin tek eğim yerine yedi gösterge katsayısı kestirilir; uyarı çıkmaz. Katsayı tablosundalogdose1.64gibi adlar görülüyorsa sütun türü sayısala çevrilir. - Gösterge değişkenlerle MCD/MVE ağırlığı seçmek. Şablon tekillik iletisiyle durur; şapka ağırlığı ya da ağırlıksız kestirim kullanılır.
- Poisson'da deneme sütununun işe yaradığını varsaymak. Aile Poisson iken deneme sütunu kullanılmaz ve not yazılmaz; hız (oran) modeli kurulmaz, sayımın kendisi modellenir.
- c'yi sonuca bakarak seçmek. c çözümlemeden önce belirlenir (1,345 ya da yazındaki 1,2–2 aralığından bir değer) ve raporlanır. Sonucun c'ye duyarlılığı iki üç değerle gösterilebilir.
- Düşük ağırlıklı gözlemi "hatalı" ilan etmek. Ağırlık, gözlemin modele uymadığını söyler; nedenini söylemez. Düşük ağırlıklı gözlemler kaynağına dönülerek incelenir; bazen modelde eksik bir açıklayıcının işaretidir.
44.9 Uzman soruları
S1. Fisher tutarlılığı düzeltmesi olmasaydı ne olurdu?
Kesilmiş denklem \sum\psi_c(r_i)k_i\mathbf x_i=\mathbf 0 model doğruyken bile sıfır beklentili değildir: binom ve Poisson çarpık olduğundan E\,\psi_c(r_i)\ne0'dır (örnek veride parsel başına −0,005 ile −0,072 arası). Kestirici, dağılımın çarpık olduğu yöne doğru sistematik kayar; kayma c küçüldükçe ve \mu sınıra yaklaştıkça büyür. a_i çıkarıldığında denklem her \boldsymbol\beta için model altında yansızdır. Normal dağılımlı doğrusal modelde dağılım simetrik olduğundan bu terim sıfırdır; bu yüzden olağan Huber regresyonunda görülmez.
S2. Sandviç kovaryans neden gözlenen artıklardan değil beklenen değerlerden kuruluyor?
\mathbf M ve \mathbf Q, kestirim fonksiyonunun model dağılımı altındaki türev ve varyans beklentileridir. Bu, "model doğru, yalnız birkaç gözlem bozuk" bakışıyla tutarlıdır: aykırı gözlemlerin varyans kestirimini şişirmesi istenmez. Bedeli, modelin varyans fonksiyonuna güvenmektir; aşırı yayılım varsa standart hatalar küçük kalır. \mathbf Q'daki \boldsymbol\alpha\boldsymbol\alpha^{\top} terimi ortalama düzeyinde merkezlemedir (Cantoni ve Ronchetti'nin tanımı); gözlem bazında merkezlenmiş (E\psi^2-a_i^2) bir tanım örnek veride standart hataları dördüncü ondalıkta değiştirir (0,697464 ↔ 0,697121).
S3. c = 1,345 normal dağılım için %95 etkinlik veriyor; binom ve Poisson'da da öyle mi?
Hayır. %95 etkinlik, artıkların standart normal olduğu durum içindir. Binom ve Poisson'da Pearson artığının dağılımı \mu'ye ve n_i'ye bağlıdır; küçük beklenen sayımlarda sağa çarpıktır ve \lvert r\rvert>c olasılığı normaldekinden farklıdır. Kaba bir ölçü, klasik ve sağlam standart hataların oranıdır: örnek veride (c=1{,}2) eğim için 0{,}3439/0{,}3685=0{,}933, varyans ölçeğinde 0,871. Sağlamlığın bedeli bu büyüklüktedir.
S4. Gruplanmış ve 0/1 biçimi neden farklı sağlam kestirim veriyor?
En çok olabilirlikte yeterlilik ilkesi geçerlidir: 0/1 gözlemlerin toplamı, binom sayımıyla aynı olabilirliği verir. Sağlam kestirim olabilirliğe değil kestirim denklemine dayanır ve denklem gözlem birimine göre tanımlanır. Parsel 14 gruplanmış veride r=4{,}57 ile aykırıdır ve ağırlığı 0,26'dır. Aynı parsel 42 ayrı satıra açıldığında her satırın artığı (1-\mu)/\sqrt{\mu(1-\mu)}\approx2{,}4 (zararlı) ya da -0{,}42'dir; 17 zararlı havucun her biri yalnız orta derecede küçültülür ve birlikte yine büyük etki yapar. Hangi biçimin doğru olduğu, bozulmanın hangi düzeyde beklendiğine bağlıdır: parselin tümü etkilenmişse (örnekteki gibi) gruplanmış biçim doğrudur.
S5. Tasarım ağırlıkları ne zaman gerekir?
Yanıt ağırlığı yalnız artığı büyük gözlemleri yakalar. Açıklayıcı uzayında uçta duran bir gözlem uyumu kendine çekerek artığını küçültebilir (iyi kaldıraç noktası gibi görünen kötü nokta). Açıklayıcılar tasarlanmış bir denemeden geliyorsa (örnekteki eşit aralıklı dozlar) kaldıraç sorunu yoktur ve yazarların önerdiği varsayılan (ağırlıksız) yeterlidir. Gözlemsel veride sürekli açıklayıcılarda uç değerler varsa Mallows ağırlıkları eklenir; bedeli, uçtaki doğru gözlemlerin de bilgi değerinin azalmasıdır.
S6. Yakınsama ölçütü neden paketin varsayılanından sıkı?
Paketin varsayılanı katsayıların göreli değişiminde 10^{-4}'tür; yineleme doğrusal hızla yakınsadığından bu ölçüt gerçek hatanın birkaç katını bırakabilir. Örnek veride 10^{-4} ile sabit terim 1,938620, 10^{-8} ile 1,938696'dır (yayımlanmış değer 1,9386955). Şablon 10^{-8} kullanır; fazladan dokuz yineleme süreyi ölçülebilir biçimde artırmaz. Yayımlanmış bir sonuçla karşılaştırırken kaynak çalışmanın toleransı bilinmiyorsa dördüncü ondalıktan sonrası karşılaştırılmaz.
S7. Ağırlığı 0,26 olan gözlem modelden çıkarılsaydı aynı sonuç mu alınırdı?
Yakın ama aynı değil. Gözlemi silmek ağırlığını 0 yapmaktır; sağlam kestirim 0,26 verir ve öteki sekiz parselin ağırlığını da biraz azaltır. Sağlam kestirimin üstünlüğü, hangi gözlemin ne kadar küçültüleceğine verinin kendisinin, önceden belirlenmiş bir kuralla (c) karar vermesidir; silme kararı ise çözümleyicinin yargısına bağlıdır ve standart hatalara yansımaz.
S8. WBY ile BY neden aynı sonucu verdi?
robustbase'te iki seçenek aynı amaç fonksiyonunu en küçükler; WBY yalnız başlangıç değerini ağırlıklı en çok olabilirlik kestiriminden alır. Amaç fonksiyonu tek tepeliyse iki başlangıç aynı noktaya yakınsar; 0/1 biçimindeki havuç verisinde katsayılar bütün basamaklarda aynıdır (sabit 1,435921). Fark, birden çok yerel en küçük noktanın bulunduğu, kaldıraçlı aykırı gözlem içeren verilerde ortaya çıkar.
44.10 Kaynaklar
- Bianco, A. M., & Yohai, V. J. (1996). Robust estimation in the logistic regression model. In H. Rieder (Ed.), Robust statistics, data analysis, and computer intensive methods (Lecture Notes in Statistics, Vol. 109, pp. 17–34). Springer. https://doi.org/10.1007/978-1-4612-2380-1_2
- Cantoni, E. (2004). Analysis of robust quasi-deviances for generalized linear models. Journal of Statistical Software, 10(4). https://doi.org/10.18637/jss.v010.i04
- Cantoni, E., & Ronchetti, E. (2001). Robust inference for generalized linear models. Journal of the American Statistical Association, 96(455), 1022–1030. https://doi.org/10.1198/016214501753209004
- Croux, C., & Haesbroeck, G. (2003). Implementing the Bianco and Yohai estimator for logistic regression. Computational Statistics & Data Analysis, 44(1–2), 273–295. https://doi.org/10.1016/S0167-9473(03)00042-2
- Huber, P. J. (1964). Robust estimation of a location parameter. The Annals of Mathematical Statistics, 35(1), 73–101. https://doi.org/10.1214/aoms/1177703732
- Maechler, M., Rousseeuw, P., Croux, C., Todorov, V., Ruckstuhl, A., Salibian-Barrera, M., Verbeke, T., Koller, M., Conceicao, E. L., & di Palma, M. A. (2026). robustbase: Basic robust statistics (R package version 0.99-7). https://doi.org/10.32614/CRAN.package.robustbase
- McCullagh, P., & Nelder, J. A. (1989). Generalized linear models (2nd ed.). Chapman and Hall. https://doi.org/10.1007/978-1-4899-3242-6
- Phelps, K. (1982). Use of the complementary log-log function to describe dose-response relationships in insecticide evaluation field trials. In R. Gilchrist (Ed.), GLIM 82: Proceedings of the International Conference on Generalised Linear Models (Lecture Notes in Statistics, Vol. 14, pp. 155–163). Springer. https://doi.org/10.1007/978-1-4612-5771-4_15
- Rousseeuw, P. J., & Van Driessen, K. (1999). A fast algorithm for the minimum covariance determinant estimator. Technometrics, 41(3), 212–223. https://doi.org/10.1080/00401706.1999.10485670
- Valdora, M., & Yohai, V. J. (2014). Robust estimators for generalized linear models. Journal of Statistical Planning and Inference, 146, 31–48. https://doi.org/10.1016/j.jspi.2013.09.016