125. Çift sağlam kestirim (AIPW): eğilim skoru ve sonuç modeli
Şablon kimliği: cift_saglam_aipw · Kategori: nedensel çıkarım · Dil: R · Dosya: pro/sablonlar/nedensel/cift_saglam_aipw.R (satır 1–240; üstbilgi 1–64) · Örnek veri: _ornek/lalonde.csv · Paketler: yalnız taban R (stats, graphics; R 4.5.3) · Python eşi: Bölüm 126
125.1 Ne işe yarar
Gözlemsel bir çalışmada ikili bir tedavinin (müdahale, maruziyet) sürekli ya da 0/1 bir sonuç üzerindeki ortalama tedavi etkisini (ATE) ölçülmüş karıştırıcılara göre düzelterek kestirmek için kullanılır. Tipik soru: iş eğitimi programına katılım, 1978 kazancını ortalamada ne kadar değiştirmiştir? Şablon artırılmış ters olasılık ağırlıklı (AIPW) kestiriciyi kurar: tedavi atamasını bir lojistik eğilim skoru modeliyle (Rosenbaum ve Rubin, 1983), sonucu bir regresyon modeliyle kestirir ve ikisini birleştirir.
- A_i\in\{0{,}1\}: tedavi göstergesi; Y_i: sonuç; X_i: ortak değişkenler (karıştırıcılar).
- \hat e(X)=\Pr(A=1\mid X): eğilim skoru (lojistik regresyon).
- \hat m_a(X)=\mathrm{E}[Y\mid A=a,X]: sonuç modeli (sürekli sonuçta doğrusal, 0/1 sonuçta lojistik).
- \hat\mu_a: a tedavisi altındaki potansiyel sonuç ortalaması.
"Çift sağlam" özellik şudur: eğilim modeli ya da sonuç modelinden biri doğru kurulmuşsa \hat\mu_a tutarlıdır (Robins ve ark., 1994; Bang ve Robins, 2005). Yalnız ters olasılık ağırlıklandırmasına (IPW) ya da yalnız regresyon düzeltmesine göre model yanlış belirlenmesine karşı daha korunaklıdır; ikisi de yanlışsa hata iki yönde birikebilir (Kang ve Schafer, 2007). Tüm yaklaşımlar "tedavi ataması, ortak değişkenler verildiğinde sonuçtan bağımsızdır" (gözlenmeyen karıştırıcı yoktur) ve "ortak değişkenlerin her değerinde her iki tedavi grubundan gözlem bulunabilir" (örtüşme, pozitiflik) varsayımlarını gerektirir.
Ne zaman kullanılır?
- İkili tedavi, gözlenen karıştırıcılarla savunulabilir parametrik eğilim ve sonuç modelleri ve ATE hedefi varsa.
- Yalnız IPW ya da yalnız regresyon düzeltmesi yerine ikisinin birleşimiyle model yanlış belirlenmesine karşı koruma isteniyorsa.
- IPW, AIPW ve regresyon düzeltmesinin yan yana karşılaştırılması isteniyorsa (şablon üçünü birlikte yazar).
Ne zaman kullanılmaz?
- Çok sayıda karıştırıcı ya da doğrusal olmayan ilişki varsa ve esnek öğreniciyle güvenilir SH isteniyorsa: Bölüm 124
cift_makine_ogrenmesi(çapraz uydurmalı çift/yansız makine öğrenmesi). - Ağırlıklı dengeleme ve ortak değişken dengesi tanısı (standartlaştırılmış fark) asıl amaçsa: Bölüm 127
dengeleme_agirliklari. - Eğilim modeli ve sonuç modelinin hedefli güncellenmesi isteniyorsa: Bölüm 139
tmle. - Gözlenmeyen karıştırıcı kuşkusu varsa: duyarlılık çözümlemesi için Bölüm 131
ihmal_duyarlilik. - Tedavi zamana göre değişiyorsa: Bölüm 134
msm_ipw. Üç ya da daha çok düzeyli tedavide şablon durur (125.2).
Temel programla ilişki. Temel programdaki Propensity Score Analysis (eğilim skoru) paneli lojistik eğilim skoruyla eşleştirme, ters olasılık ağırlıklandırma ve tabakalama yapar; denge tablosunu ve ortak destek grafiğini verir. Sonuç modeliyle birleşen çift sağlam (AIPW) kestirici, sandviç standart hata ve IPW/regresyon düzeltmesi karşılaştırması yalnız bu şablondadır.
125.2 Şablonun girdileri
Form, üstbilgideki 8 [[param]] bloğundan kurulur (cift_saglam_aipw.R:10–63). Türlerin anlamı ve formun ortak denetimi Bölüm 1.2'dedir.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
İkili tedavi değişkeni · tedavi |
sütun · Değişkenler | ilk sütun | tam iki düzeyli sütun | Tedavi göstergesi A (10–14, 73–86). |
Tedavi sayılan düzey (boş = sayısalda büyük, metinde alfabetik son düzey) · tedavi_duzeyi |
metin · Değişkenler | boş | tedavi sütunundaki iki düzeyden biri | Boşsa varsayılan kural, doluysa yazılan düzey tedavi sayılır (50–56, 81–86). |
Ortak değişkenler · ortak |
sütunlar · Değişkenler | yok | en az 1 sütun | Hem eğilim hem sonuç modeline giren X (15–20, 68, 100). |
Sonuç değişkeni · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Y (21–25, 87). |
Sonuç modeli · sonuc_modeli |
seçim · Model | ayri |
ayri, ortak |
Her tedavi grubunda ayrı ya da tek (tedavi ana etkili) model (26–32, 107, 139–149). |
Eğilim skoru kırpma sınırı \varepsilon · ps_sinir |
ondalık · Seçenekler | 0 | 0–0,1 | e\in[\varepsilon,1-\varepsilon] (33–40, 112, 118, 156). |
Sonuç modeli ailesi · sonuc_ailesi |
seçim · Model | otomatik |
otomatik, dogrusal, lojistik |
Sonuç modelinin ailesi (41–48, 90–92). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | GA ve tablo başlığı (57–63, 93, 185, 199–200). |
Şablonun kendi denetimleri (mq_hata):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 67 |
| Tedavi ve ortak değişkenlerden farklı değişken yok | "… en az bir ortak değişken seçin." | 68–69 |
| Tedavi ve sonuç aynı sütun | "Tedavi ve sonuç farklı olmalı." | 70 |
| Tedavinin düzey sayısı \ne2 | "Tedavi değişkeninin tam iki düzeyi olmalı." | 78 |
tedavi_duzeyi alanındaki düzey tedavi sütununda yok |
"'…' düzeyi tedavi sütununda yok; düzeyler: …" | 82–83 |
| Sonuç sabit | "Sonuç değişkeni sabit." | 88 |
Sonuç 0/1 değil, aile lojistik |
"Lojistik sonuç modeli için sonuç 0/1 olmalı." | 91 |
| Ortak değişken sabit ya da tek düzeyli | "'…' sabit (tek düzeyli); ortak değişkenlerden çıkarın." | 98 |
| Tasarım matrisi eş doğrusal | "Ortak değişkenler doğrusal bağımlı (eş doğrusallık)…" | 105 |
| Bir tedavi grubunda gözlem <k+2 | "Her tedavi grubunda model parametresi sayısından fazla gözlem gerekli." | 106 |
| Ayrı modellerde bir grupta tasarım eş doğrusal | "… 'tek model' seçin." | 108–109 |
Model kurulamadı (glm.fit hatası) |
"Model kurulamadı: …" | 133 |
| Katsayı sonlu değil | "Modeller yakınsamadı (tam ayrışma olabilir)." | 150 |
| Eğilim skoru modeli yakınsamadı, uyarı verdi ya da eğilim skorları 10^{-8}'den küçük/büyük (1-10^{-8}) | "Eğilim skoru modeli tam (ya da yarı) ayrışma gösteriyor: …" (varsa glm.fit uyarısı eklenir) |
151–154 |
| \hat\mu_1 ya da \hat\mu_0 sonlu değil | "Potansiyel sonuç ortalamaları sonlu değil …" | 159 |
Türev matrisi tersinemedi (solve ve qr.solve başarısız) |
"Sandviç varyansı hesaplanamadı (tekil türev matrisi)." | 172–173 |
Veriye ilişkin davranışlar: eksik değerli satırlar sessizce atılır (72), çıktıdaki n atıldıktan sonraki sayıdır; ortak değişken listesinde tedavi ya da sonuç sütunu varsa çıkarılır (68). Tedavi için iki düzeyli olmak yeter. Tedavi sayılan düzey sütun türüne ve Veri sekmesindeki düzey sırasına bağlı değildir (73–86): düzeyler mq_kimlik ile metne çevrilir; hepsi sayıya benziyorsa sayısal olarak sıralanır ve büyük olan (0/1'de 1, 1/2'de 2) tedavidir, değilse düzeyler alfabetik (bayt) sıralanır ve son düzey tedavidir (kontrol < tedavi: tedavi). tedavi_duzeyi alanı doluysa yazılan düzey tedavi sayılır; alandaki düzey tedavi sütununda yoksa şablon düzeyleri sayarak durur. Python eşi aynı kuralı kullanır (Bölüm 126). Çıktı, "Tedavi sayılan düzey: '…' (n = …); kontrol: '…' (n = …). Kural: …" satırıyla hangi düzeyin tedavi, hangisinin kontrol sayıldığını yazar. Aynı sorun ortak değişkenlerde yoktur: tam gösterge kodlu ve kesişimli modelde başvuru düzeyi sonucu değiştirmez.
Örnek ayar (ornek_param, satır 9): tedavi = treat, ortak = age, educ, race, married, nodegree, re74, re75, y = re78, sonuc_modeli = ayri, ps_sinir = 0; sonuc_ailesi ve guven varsayılandadır.
125.3 Örnek veri
lalonde.csv: LaLonde'un (1986) iş eğitimi programı çalışmasından Dehejia ve Wahba'nın (1999) çözümlemesinde kullanılan 185 programa katılan ve 429 karşılaştırma bireyi içeren biçim; 614 gözlem, 9 sütun, eksik değer yok. Tedavi treat (iş eğitimi programına katılım); sonuç re78 (1978 kazancı, dolar). Veri sekmesinin algıladığı türlerle:
| Değişken | Rol | Tür | Özet (kontrol / tedavi) |
|---|---|---|---|
treat |
tedavi | ikili | 0/1; 429 kontrol, 185 tedavi |
age |
ortak | sayısal | ortalama 28{,}03 / 25{,}82 |
educ |
ortak | sayısal | ortalama 10{,}24 / 10{,}35 |
race |
ortak | kategorik | black, hispan, white; kontrol 87/61/281, tedavi 156/11/18 |
married |
ortak | ikili | ortalama 0{,}513 / 0{,}189 |
nodegree |
ortak | ikili | ortalama 0{,}597 / 0{,}708 |
re74, re75 |
ortak | sayısal | re74 ortalama 5619{,}2 / 2095{,}6; re75 2466{,}5 / 1532{,}1 |
re78 |
sonuç | sayısal | ortalama 6984{,}2 / 6349{,}1 |
Düzey sırası. race "kategorik" türdedir; arayüzdeki düzey sırası ilk görülme kuralıyla black, hispan, white'tır ve başvuru düzeyi black'tir (Bölüm 1.3). Tam gösterge kodlu ve kesişimli modelde başvuru değişimi ATE ve SH'yi değiştirmez; düzeyleri ters sıraya koymak ve "kategorik" bırakmak aynı sonucu verir (ar_race_sira). Karşılaştırma grubunun ortak değişkenleri tedavi grubundan belirgin biçimde farklıdır (evlilik oranı, 1974 kazancı, ırk dağılımı): eğilim skorunun gerekçesi budur.
Bu bölümde kullanılan çalıştırmalar (örnek ayara eklenen ayarlarla; dogrulama/cift_saglam_aipw/kos.sh): aipw_ornek (örnek ayar), ar_ortak (sonuc_modeli = ortak), ar_ayri_ps05, ar_ortak_ps05 (ps_sinir = 0,05), ar_g90 (guven = 0,9), ar_ikili_ortak, ar_ikili_oto, ar_ikili_bin (sonuç 0/1; re78>0), ar_dogrusal_ikili, ar_sent (kazançlar sent biriminde), ve sınır durumları (ar_metin, ar_metin_kat, ar_t12, ar_uc, ar_eksik, ar_sabit, ar_esdogrusal, ar_tam_ayrisma, …). Türetilmiş veriler dogrulama/cift_saglam_aipw/lalonde_*.csv.
125.4 Yöntem: formüller ve hesap adımları
Hesap sırası: veri ve tasarım matrisi hazırlanır (67–113); yığılmış tahmin denklemleri tanımlanır (114–131); eğilim modeli ve sonuç modeli(leri) uydurulur (132–157); \hat\mu_1,\hat\mu_0 hesaplanır (158–160); sandviç varyans kurulur (162–178); etki fonksiyonu SH'si hesaplanır (179–185); tablolar yazılır (187–232); şekil çizilir (234–239).
125.4.1 Eğilim skoru ve sonuç modelleri
\hat e(X)=\operatorname{expit}(X\hat\gamma), \hat\gamma lojistik olabilirliğin en büyükleyicisidir (glm.fit, binom ailesi; 136). X tasarım matrisi: kesişim, sayısal ortak değişkenler ve kategorik değişkenlerin ilk düzey dışındaki göstergeleridir (model.matrix, 100). Sonuç modeli:
- Ayrı (varsayılan): \hat m_1 yalnız tedavi görenlerde, \hat m_0 yalnız kontrollerde uydurulur; tedavi ile her ortak değişken arasındaki tüm etkileşimlere izin vermiş olur (139–143).
- Tek model: Y ve (X,A) üzerinde tek model uydurulur; \hat m_1 ve \hat m_0 tedavi göstergesi 1 ve 0'a sabitlenerek tahmin edilir (145–148). Tedavi etkisi X'ten bağımsız sabit sayılır; küçük gruplarda daha kararlıdır.
Sonuç sürekliyse Gauss ailesi (doğrusal), 0/1 ise (ya da aile lojistik ise) binom ailesidir; sonuc_ailesi = dogrusal 0/1 sonuçta doğrusal olasılık modeli kurar (89–93, 111, 138).
125.4.2 AIPW kestiricisi
\hat\mu_1 ve \hat\mu_0 125.1'deki gibi hesaplanır (158). İlk terim regresyon düzeltmesinin (\overline{\hat m_a}), ikinci terim ağırlıklı artıkların ortalamasıdır; sonuç modeli doğruysa artıkların beklenen değeri sıfırdır ve ikinci terim yalnız varyans ekler, eğilim modeli doğruysa ikinci terim ilk terimin yanlılığını giderir. \widehat{\mathrm{ATE}}=\hat\mu_1-\hat\mu_0.
Neden iki terim
Yalnız \hat m_a ortalaması (regresyon düzeltmesi, g-hesaplama) sonuç modeli yanlışsa yanlıdır; yalnız IPW A\,Y/\hat e eğilim modeli yanlışsa yanlıdır ve \hat e sıfıra yaklaştıkça varyansı patlar. Artıklı terim, her iki modeli birleştirip yalnız birinin doğruluğuna dayanmayı sağlar.
125.4.3 Standart hata, güven aralığı ve p: etki fonksiyonu
Ana standart hata, kestiricinin etki (influence) fonksiyonundan alınır:
\widehat{\mathrm{Var}} örneklem varyansıdır (n-1 bölenli; 179–185). Aynı biçimde \mathrm{SH}(\hat\mu_a)=\sqrt{\widehat{\mathrm{Var}}(\mathrm{IF}_a)/n}. Güven aralığı \hat\theta\pm z_{(1+g)/2}\mathrm{SH}, z=\hat\theta/\mathrm{SH} ve iki yönlü p=2\Phi(-|z|) standart normal dağılıma göredir (185, 197–198).
Koddaki tercih
Etki fonksiyonu SH'si, tahmin edilen \hat\gamma ve \hat\beta'nın belirsizliğini hesaba katmaz: \hat e ve \hat m_a sabit sayılır. Bu, AIPW paketindeki (k\_split=1) tanımla aynıdır; şablonun ikinci sütunu (SH_sandvic) belirsizliğin tamamını yakalar (125.4.4).
125.4.4 Yığılmış tahmin denklemleri ve sandviç SH
Tüm modellerin kestirim belirsizliğini birlikte hesaba katmak için bütün tahmin denklemleri tek bir M-kestirim sistemi olarak yığılır (Lunceford ve Davidian, 2004). Parametre vektörü \boldsymbol\theta=(\gamma,\beta,\mu_1,\mu_0); ayrı modellerde \beta=(\beta_1,\beta_0). Her gözlem için tahmin fonksiyonu
ve \sum_i\boldsymbol\psi_i(\hat{\boldsymbol\theta})=0 olur. Varyans \widehat{\mathbf V}=\mathbf A^{-1}\mathbf B\,\mathbf A^{-\prime}/n, \mathbf A=-\tfrac1n\sum_i\partial\boldsymbol\psi_i/\partial\boldsymbol\theta', \mathbf B=\tfrac1n\sum_i\boldsymbol\psi_i\boldsymbol\psi_i' (170–174). \mathrm{SH}_{\mathrm{sandvic}}(\widehat{\mathrm{ATE}})=\sqrt{V_{\mu_1\mu_1}+V_{\mu_0\mu_0}-2V_{\mu_1\mu_0}} (178).
- \mathbf A'nın bloklarında eğilim için \tfrac1n\sum e_i(1-e_i)X_iX_i'; sonuç için \tfrac1n\sum A_i w_{1i}X_iX_i' ve \tfrac1n\sum(1-A_i)w_{0i}X_iX_i' (w=1 doğrusal, m(1-m) lojistik) bulunur.
- \mu_1 satırının eğilim bloğu \tfrac1n\sum A_i(Y_i-m_{1i})\frac{1-e_i}{e_i}X_i', sonuç bloğu \tfrac1n\sum w_{1i}\big(\tfrac{A_i}{e_i}-1\big)X_i''dir; \mu_0 için karşılığı simetriktir. Bu çözümsel türev şablonda kullanılmaz; bölüm 125.6'da bağımsız doğrulama için yazılmıştır.
Koddaki tercih
Şablon \mathbf A'yı sayısal türevle bulur: merkezi fark, adım h_j=10^{-6}\max(1,|\theta_j|) (165–169). Adımın duyarsız kalması için model matrisinin her sütunu, tahmin denklemleri kurulmadan önce en büyük mutlak değerine bölünür (102–104): model aynıdır, yalnız katsayılar yeniden ölçeklenir; \hat\mu_a, ATE ve her iki SH ortak değişkenlerin ölçü birimine bağlı değildir ve türev matrisi iyi koşullanır. solve yine de başarısız olursa qr.solve denenir (172–173). Örnek veride (dolar) sandviç SH çözümsel değerle 4\times10^{-9} göreli içinde uyuşur (1180{,}4488); sütunlar sent biriminde yazılınca da (\times100) sonuç 118044{,}88'dir.
125.4.5 Eğilim skoru kırpma
\varepsilon>0 iken e\leftarrow\min(\max(e,\varepsilon),1-\varepsilon) yalnız AIPW terimlerinde (118, 155–158) uygulanır; yığılmış sistemin eğilim bloğu kırpılmamış \hat e ile yazılır (117, 128): \hat\gamma kırpılmamış lojistik olabilirliğin kökü olduğundan bu blok \hat\gamma'da sıfırdır ve sandviç formülünün varsayımı korunur. Kırpma ağırlıkları 1/\varepsilon ile sınırlar, ama \hat\mu_a'yı yanlı kılar (kırpılan gözlemler için ağırlık gerçek eğilimden uzaklaşır). Çıktıdaki "eğilim skoru aralığı" kırpılmış değerlerdir (230–231); kırpılan gözlem sayısı ayrıca "Eğilim skoru kırpma: N gözlemin…" notunda ve tanı tablosunun kirpilan sütununda yazılır (157, 207–214, 225).
125.4.6 IPW ve regresyon düzeltmesi karşılaştırması
Karşılaştırma tablosu (202–206) iki ek kestirici yazar:
IPW normalize (Hájek) ağırlıklıdır: ağırlıkların toplamına bölünür; kestiricilerin karşılaştırmalı bir incelemesi için Imbens (2004). İki satırın SH'si yazılmaz.
125.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–64 | Üstbilgi: 8 parametre, örnek veri ve ayar. | |
| 65 | .m dil yardımcısı. |
|
| 67–72 | Veri, ortak değişken, tedavi–sonuç denetimi; eksik satırlar çıkarılır (72). | |
| 73–86 | Tedavi düzeyi: sütun türünden bağımsız kural, tedavi_duzeyi alanı, tedavi göstergesi A. |
Düzey sayısı \ne2 (78) ya da alandaki düzey yok (82–83) ise durur. |
| 87–99 | Sonuç, aile ve güven düzeyi; ortak değişkenlerde kategorik ve sabit sütun denetimi. | Sabit sütun durdurur (98). |
| 100–112 | Tasarım matrisi X; sütunların ölçeklenmesi (102–104); grup büyüklüğü ve eş doğrusallık denetimi; ilink, \varepsilon. |
k= sütun sayısı; her grupta \ge k+2 gözlem (106). |
| 114–131 | psi(th): yığılmış tahmin denklemleri (ayrı ya da tek model). |
Eğilim bloğu kırpılmamış e ile (117, 128); AIPW terimleri kırpılmış e ile (118, 129–130). |
| 132–159 | Eğilim ve sonuç modellerinin uydurulması; uyarılar toplanır; yakınsama, ayrışma ve sonluluk denetimi; \hat\mu_1,\hat\mu_0. | glm.fit; eğilim modelinde uyarı, yakınsamama ya da e<10^{-8}/e>1-10^{-8} durdurur (151–154). |
| 160–178 | \boldsymbol\theta, sayısal türev, \mathbf B, \mathbf V ve sandviç SH'ler. | solve, olmazsa qr.solve (172–173). |
| 179–185 | Etki fonksiyonları ve ana SH'ler; z_c. | n-1 bölenli. |
| 187–200 | Konsol satırı, tedavi sayılan düzey notu ve AIPW tablosu (SH, GA, z, p, SH_sandvic). |
Başlıkta güven düzeyi değiştirilir (199–200). |
| 202–206 | IPW ve regresyon düzeltmesi tablosu. | |
| 207–231 | Örtüşme tanısı tablosu, ağırlıklı SMD tablosu; kırpma, zayıf örtüşme ve denge uyarıları; eğilim skoru aralığı; glm uyarıları. |
Zayıf örtüşme eşiği: e<0{,}01 ya da e>0{,}99 (226); denge eşiği |\mathrm{SMD}|>0{,}1 (229). |
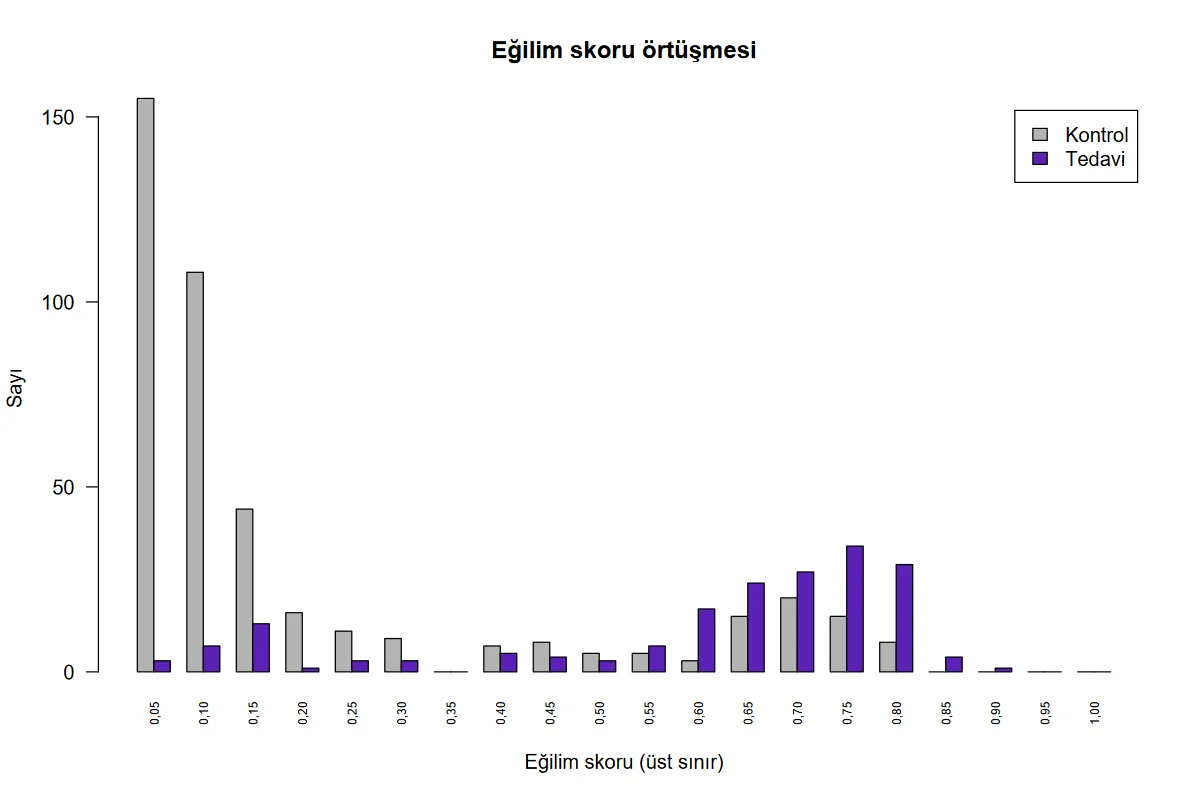
| 234–239 | Eğilim skoru örtüşme grafiği. | Şekil 125.1. |
Süre: örnek ayarda çalıştırma 1,96 s.
125.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bağımsız hesap iki yoldan yapıldı: dogrulama/cift_saglam_aipw/elle_hesap.py (yalnız numpy; lojistik regresyon ölçeklenmiş tasarımda adım yarılamalı Fisher puanlamasıyla, EKK normal denklemlerle, sandviç çözümsel türevle; şablonun işlevleri ve statsmodels kullanılmaz) ve r_dogrulama.R (taban R glm.fit ve açık formül; ayrıca tek model için AIPW paketi, Zhong ve ark., 2021, SL.glm, k_split = 1).
Adım 1 — Eğilim skoru. Lojistik regresyon katsayıları \hat\gamma (kesişim, age, educ, race=hispan, race=white, married, nodegree, re74, re75):
| kesişim | age |
educ |
hispan |
white |
married |
nodegree |
re74 |
re75 |
|---|---|---|---|---|---|---|---|---|
| -1{,}66328 | 0{,}015777 | 0{,}161307 | -2{,}08173 | -3{,}06537 | -0{,}832113 | 0{,}707297 | -7{,}178\times10^{-5} | 5{,}345\times10^{-5} |
Eğilim skoru aralığı tedavi [0{,}0250;\ 0{,}8532], kontrol [0{,}0091;\ 0{,}7892] (şablonun konsol satırıyla aynı). 158 gözlemin \hat e<0{,}05 olduğu görülür (155 kontrol, 3 tedavi): örtüşme tedavi grubunda zayıf, kontrol grubunda geniştir.
Adım 2 — Sonuç modelleri. Her grupta EKK. Tedavi grubunda \hat\beta_1: kesişim -2648{,}44, age 83{,}56, educ 623{,}96, hispan 1444{,}34, white 1140{,}01, married 1032{,}44, nodegree -319{,}01, re74 0{,}0395, re75 0{,}0887. \overline{\hat m_1}=7371{,}321, \overline{\hat m_0}=6296{,}413 (regresyon düzeltmesi: \overline{\hat m_1-\hat m_0}=1074{,}909).
Adım 3 — Artık düzeltmeleri ve AIPW. n^{-1}\sum A_i(Y_i-\hat m_{1i})/\hat e_i=-478{,}408 ve n^{-1}\sum(1-A_i)(Y_i-\hat m_{0i})/(1-\hat e_i)=126{,}860. Böylece \hat\mu_1=7371{,}321-478{,}408=6892{,}913, \hat\mu_0=6296{,}413+126{,}860=6423{,}273, \widehat{\mathrm{ATE}}=469{,}640. Normalize IPW 224{,}676. Tedavi grubunda ağırlık 1/\hat e'nin en büyüğü 40{,}08 ve etkin örneklem büyüklüğü (\sum w)^2/\sum w^2=58{,}3 (n_1=185); kontrolde 4{,}74 ve 329{,}0 (n_0=429).
Adım 4 — Etki fonksiyonu SH'si. \mathrm{SH}(\widehat{\mathrm{ATE}})=926{,}155080; \mathrm{SH}(\hat\mu_1)=867{,}611272, \mathrm{SH}(\hat\mu_0)=355{,}083168. z=0{,}507086, p=0{,}612095, %95 GA [-1345{,}59;\ 2284{,}87].
Adım 5 — Sandviç SH. Çözümsel türevli \mathbf A ile \mathrm{SH}_{\mathrm{sandvic}}(\widehat{\mathrm{ATE}})=1180{,}448823 (şablon 1180{,}448818; göreli fark 3{,}7\times10^{-9}). Sandviç, ana SH'den büyüktür çünkü \hat\gamma ve \hat\beta'nın belirsizliğini de içerir; zayıf örtüşmede fark büyür.
Adım 6 — Tek sonuç modeli ve AIPW paketi. sonuc_modeli = ortak ile \hat\mu_1=7317{,}8128, \hat\mu_0=6430{,}6429, ATE 887{,}1699, SH 937{,}3385; AIPW paketi aynı değerleri verir (887{,}1699; SH 937{,}3385, 10^{-8} içinde). İki sonuç modeli seçeneği arasındaki fark (469{,}6 ve 887{,}2) örnek verinin kendisindendir (125.8).
Adım 7 — Kırpma, 0/1 sonuç. \varepsilon=0{,}05 (ayrı modeller): ATE 799{,}6186, SH 716{,}2381; tek model 1210{,}3384, SH 713{,}0636. re78>0 sonucu, tek model, lojistik: ATE 0{,}0321503, SH 0{,}0671042; ayrı modeller: 0{,}0368187, SH 0{,}0682890 (125.8'deki ölçek notuyla).
125.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| ayrı sonuç modelleri: \hat\mu_1 | 6892,91324026 | 6892,91323181 | 6892,91324026 | 1,2e−9 | ✓ |
| ayrı sonuç modelleri: \hat\mu_0 | 6423,27325725 | 6423,27325822 | 6423,27325725 | 1,5e−10 | ✓ |
| ayrı sonuç modelleri: ATE | 469,63998301 | 469,63997359 | 469,63998301 | 2,0e−8 | ✓ |
| ayrı sonuç modelleri: SH(ATE), etki fonksiyonu | 926,1550679 | 926,15507993 | 926,1550679 | 1,3e−8 | ✓ |
| ayrı sonuç modelleri: SH(\hat\mu_1) | 867,61125919 | 867,61127209 | 867,61125919 | 1,5e−8 | ✓ |
| ayrı sonuç modelleri: SH(ATE), sandviç | 1180,44881817 | 1180,44882254 | — | 3,7e−9 | ✓ |
| ayrı sonuç modelleri: IPW (normalize) | 224,67630827 | 224,6763091 | 224,67630827 | 3,7e−9 | ✓ |
| ayrı sonuç modelleri: regresyon düzeltmesi | 1074,9085414 | 1074,9085414 | 1074,9085414 | 2,1e−14 | ✓ |
| tek sonuç modeli: \hat\mu_1 | 7317,81284847 | 7317,81283884 | 7317,81284847 | 1,3e−9 | ✓ |
| tek sonuç modeli: \hat\mu_0 | 6430,64293243 | 6430,64293336 | 6430,64293243 | 1,4e−10 | ✓ |
| tek sonuç modeli: ATE | 887,16991604 | 887,16990548 | 887,16991604 | 1,2e−8 | ✓ |
| tek sonuç modeli: SH(ATE), etki fonksiyonu | 937,33850551 | 937,33851761 | 937,33850551 | 1,3e−8 | ✓ |
| tek sonuç modeli: SH(\hat\mu_1) | 880,97493498 | 880,97494782 | 880,97493498 | 1,5e−8 | ✓ |
| tek sonuç modeli: SH(ATE), sandviç | 958,72287987 | 958,72288866 | — | 9,2e−9 | ✓ |
| tek sonuç modeli: IPW (normalize) | 224,67630827 | 224,6763091 | 224,67630827 | 3,7e−9 | ✓ |
| tek sonuç modeli: regresyon düzeltmesi | 1548,243802 | 1548,243802 | 1548,243802 | 3,7e−15 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: \hat\mu_1 | 7227,97458193 | 7227,97458612 | 7227,97458193 | 5,8e−10 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: \hat\mu_0 | 6428,35602443 | 6428,3560254 | 6428,35602443 | 1,5e−10 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: ATE | 799,61855751 | 799,61856072 | 799,61855751 | 4,0e−9 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: SH(ATE), etki fonksiyonu | 716,23814739 | 716,23815052 | 716,23814739 | 4,4e−9 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: SH(\hat\mu_1) | 639,88087734 | 639,88088098 | 639,88087734 | 5,7e−9 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: IPW (normalize) | 432,17343414 | 432,17344173 | 432,17343414 | 1,8e−8 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: regresyon düzeltmesi | 1074,9085414 | 1074,9085414 | 1074,9085414 | 2,1e−14 | ✓ |
| tek model, \varepsilon=0{,}05: \hat\mu_1 | 7647,87028807 | 7647,87029019 | 7647,87028807 | 2,8e−10 | ✓ |
| tek model, \varepsilon=0{,}05: \hat\mu_0 | 6437,53190235 | 6437,5319033 | 6437,53190235 | 1,5e−10 | ✓ |
| tek model, \varepsilon=0{,}05: ATE | 1210,33838572 | 1210,33838689 | 1210,33838572 | 9,6e−10 | ✓ |
| tek model, \varepsilon=0{,}05: SH(ATE), etki fonksiyonu | 713,06360801 | 713,06361031 | 713,06360801 | 3,2e−9 | ✓ |
| tek model, \varepsilon=0{,}05: SH(\hat\mu_1) | 638,73826172 | 638,73826431 | 638,73826172 | 4,1e−9 | ✓ |
| tek model, \varepsilon=0{,}05: IPW (normalize) | 432,17343414 | 432,17344173 | 432,17343414 | 1,8e−8 | ✓ |
| tek model, \varepsilon=0{,}05: regresyon düzeltmesi | 1548,243802 | 1548,243802 | 1548,243802 | 3,7e−15 | ✓ |
| 0/1 sonuç, tek model: \hat\mu_1 | 0,79358359 | 0,79358359 | 0,79358359 | 5,7e−10 | ✓ |
| 0/1 sonuç, tek model: \hat\mu_0 | 0,76143334 | 0,76143334 | 0,76143334 | 4,1e−11 | ✓ |
| 0/1 sonuç, tek model: ATE | 0,03215025 | 0,03215025 | 0,03215025 | 6,1e−10 | ✓ |
| 0/1 sonuç, tek model: SH(ATE), etki fonksiyonu | 0,06710424 | 0,06710424 | 0,06710424 | 1,0e−9 | ✓ |
| 0/1 sonuç, tek model: SH(\hat\mu_1) | 0,06313619 | 0,06313619 | 0,06313619 | 1,1e−9 | ✓ |
| 0/1 sonuç, tek model: SH(ATE), sandviç | 0,06588857 | 0,06588857 | — | 8,1e−10 | ✓ |
| 0/1 sonuç, tek model: IPW (normalize) | 0,02154976 | 0,02154976 | 0,02154976 | 5,4e−10 | ✓ |
| 0/1 sonuç, tek model: regresyon düzeltmesi | 0,062262 | 0,062262 | 0,062262 | 2,8e−11 | ✓ |
| 0/1 sonuç, ayrı modeller: \hat\mu_1 | 0,79724303 | 0,79724303 | 0,79724303 | 8,9e−10 | ✓ |
| 0/1 sonuç, ayrı modeller: \hat\mu_0 | 0,76042433 | 0,76042433 | 0,76042433 | 1,3e−11 | ✓ |
| 0/1 sonuç, ayrı modeller: ATE | 0,03681871 | 0,03681871 | 0,03681871 | 9,0e−10 | ✓ |
| 0/1 sonuç, ayrı modeller: SH(ATE), etki fonksiyonu | 0,06828904 | 0,06828904 | 0,06828904 | 1,0e−9 | ✓ |
| 0/1 sonuç, ayrı modeller: SH(\hat\mu_1) | 0,06427872 | 0,06427873 | 0,06427872 | 1,1e−9 | ✓ |
| 0/1 sonuç, ayrı modeller: SH(ATE), sandviç | 0,07242269 | 0,07242269 | — | 5,3e−10 | ✓ |
| 0/1 sonuç, ayrı modeller: IPW (normalize) | 0,02154976 | 0,02154976 | 0,02154976 | 5,4e−10 | ✓ |
| 0/1 sonuç, ayrı modeller: regresyon düzeltmesi | 0,09115917 | 0,09115917 | 0,09115917 | 2,2e−9 | ✓ |
| AIPW paketi, tek model: \hat\mu_1 | 7317,81284847 | 7317,81284847 | — | 0 | ✓ |
| AIPW paketi, tek model: \hat\mu_0 | 6430,64293243 | 6430,64293243 | — | 0 | ✓ |
| AIPW paketi, tek model: ATE | 887,16991604 | 887,16991604 | — | 2,2e−15 | ✓ |
| AIPW paketi, tek model: SH(ATE) | 937,33850551 | 937,33850551 | — | 2,2e−15 | ✓ |
| AIPW paketi, tek model: SH(\hat\mu_1) | 880,97493498 | 880,97493498 | — | 2,2e−15 | ✓ |
Ölçütü karşılayan: 51/51. Ölçüt satır başına 10^{-6} (değer 1'den büyükse göreli); sandviç SH'de 10^{-5} göreli: şablon türev matrisini sayısal türevle alır (sütunları en büyük mutlak değerlerine bölünmüş tasarımda, adım h=10^{-6}\max(1,|\theta_j|)), bağımsız Python çözümsel türev kullanır (bölüm 125.4.4). R sütunu taban R (glm.fit, açık formül) ve ayrıca tek model için AIPW paketidir (aşağıdaki satırlar). \varepsilon>0 iken sandviç satırı verilmez. 0/1 sonuç ve ayrı modeller satırında R şablonu da çalışır; re74 ve re75 bin dolar biriminde yazılmış aynı verinin R sütunu ATE ve SH'yi ölçekten bağımsız olarak verir.
125.7 Çıktıyı okuma
Örnek ayarda şablonun dört tablosu ve konsol notları (aipw_ornek; sayılar olduğu gibi):
n = 614 (tedavi 185, kontrol 429); sonuç: sürekli (doğrusal); sonuç modeli: gruplara göre ayrı
Tedavi sayılan düzey: '1' (n = 185); kontrol: '0' (n = 429). Kural: sayıya benzeyen düzeylerde büyük, değilse alfabetik son düzey.

AIPW kestirimleri (SH, %95 GA ve p: etki fonksiyonu; SH_sandvic: yığılmış M-kestirimi)
  parametre                             kestirim       SH SH_sandvic    GA_alt    GA_ust
  Potansiyel sonuç ortalaması, tedavi  6892.9132 867.6113  1141.9127 5192.4264 8593.4001
  Potansiyel sonuç ortalaması, kontrol 6423.2733 355.0832   351.3101 5727.3230 7119.2235
  ATE                                   469.6400 926.1551  1180.4488 -1345.5906 2284.8706
  (devamı) z: 7.944702; 18.089490; 0.507086   p: 1.946576e-15; 3.856424e-73; 0.6120947

Kestiricilerin karşılaştırması
  kestirici                              ATE        SH  SH_sandvic
  AIPW                               469.6400  926.1551   1180.4488
  IPW (normalize ağırlık)            224.6763        NA          NA
  Regresyon düzeltmesi (g-hesaplama) 1074.9085        NA          NA

Örtüşme tanısı (eğilim skoru ve ters olasılık ağırlıkları)
  grup     n e_en_kucuk e_en_buyuk en_buyuk_agirlik etkin_n kirpilan
  tedavi 185     0.0250     0.8532          40.0773 58.3267        0
  kontrol 429    0.0091     0.7892           4.7432 329.0078        0

Ortak değişken dengesi (standartlaştırılmış ortalama farkı; hedef |SMD| < 0,1)
  degisken    SMD_ham SMD_agirlikli
  age         -0.2419       -0.1676
  educ         0.0448        0.1296
  racehispan  -0.2769        0.0156
  racewhite   -1.4057       -0.1376
  married     -0.7195       -0.2098
  nodegree     0.2350       -0.1155
  re74        -0.5958       -0.2740
  re75        -0.2870       -0.1579

Uyarı: 1 gözlemin eğilim skoru 0,01'in altında ya da 0,99'un üstünde (örtüşme zayıf; en büyük ağırlık 40,1, etkin n tedavi 58,3, kontrol 329,0); kırpma sınırı düşünün.
Uyarı: ağırlıklandırmadan sonra bazı ortak değişkenlerde |SMD| 0,1'in üstünde; eğilim modeli dengeyi sağlamıyor olabilir.
Eğilim skoru aralığı: tedavi [0,0250; 0,8532], kontrol [0,0091; 0,7892].
Şekil 125.1. Şablonun şekli: eğilim skoru örtüşmesi (üst sınırı 0,05 aralıklı sütunlar; gri kontrol, mor tedavi). Kontrol grubu 0,05–0,15'te, tedavi grubu 0,60–0,80'de toplanmıştır.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Konsol satırı ve tedavi düzeyi notu | n, tedavi ve kontrol sayısı, sonuç ve model türü; hangi düzeyin tedavi, hangisinin kontrol sayıldığı ve bunun kuralı. | Tedavi sayılan düzeyin beklediğiniz grup olduğunu doğrulayın; değilse tedavi_duzeyi alanıyla seçin (125.8). |
| Potansiyel sonuç ortalamaları | \hat\mu_1 ve \hat\mu_0, SH'ler, GA, z, p. | Herkes tedavi alsaydı (ya da almasaydı) beklenen sonuç. p değerleri \mu=0 sınaması içindir; ilgilenilen sınama ATE'ninkidir. |
ATE |
\hat\mu_1-\hat\mu_0; SH etki fonksiyonundan; SH_sandvic yığılmış sistemden. |
Program ortalamada yaklaşık 470 dolar kazanç farkıyla ilişkilidir; SH 926 olduğundan fark sıfırdan ayırt edilemez (p=0{,}61). |
SH_sandvic |
Yığılmış M-kestirimi sandviç SH. | Ana SH'den büyükse (1180 ve 926) eğilim ve sonuç modellerinin belirsizliği de önemlidir; zayıf örtüşmenin göstergesidir. |
| Kestiricilerin karşılaştırması | AIPW, normalize IPW ve regresyon düzeltmesi. | Üçü uzaktaysa (470; 225; 1075) örtüşme ya da model belirleme duyarlı demektir; AIPW'nin tek başına güvenilir olduğu anlamına gelmez. |
| Eğilim skoru aralığı | Tedavi ve kontrol gruplarının en küçük ve en büyük \hat e'si (kırpılmışsa kırpılmış). | Kontrolün \hat e en küçüğü 0{,}009: ağırlıklar uçlaşabilir. Ayrıntı için şekle bakın. |
| Örtüşme tanısı tablosu | Her grupta gözlem sayısı, kırpılmış \hat e'nin en küçük ve en büyüğü, en büyük ters olasılık ağırlığı (1/\hat e tedavilide, 1/(1-\hat e) kontrolde), etkin örneklem büyüklüğü (\sum w)^2/\sum w^2 ve kırpılan gözlem sayısı. | Tedavi grubunda en büyük ağırlık 40{,}1 ve etkin n 58{,}3 (n_1=185): tedavi grubunun kestirime katkısı yaklaşık 58 gözleme eşdeğerdir. |
| Ortak değişken dengesi | Her model matrisi sütunu için tedavi–kontrol standartlaştırılmış ortalama farkı, ham ve ters olasılık ağırlıklı (ağırlıklı ortalama farkı, ham havuzlanmış sd'ye bölünür). | Ağırlıklandırma dengeyi sağlıyorsa |\mathrm{SMD}|<0{,}1; örnek veride re74 (-0{,}274), married (-0{,}210) ve öteki bazı sütunlar bu eşiği aşar: eğilim modeli dengeyi tam sağlamaz ve şablon uyarır. |
İş eğitimi programına katılımın 1978 kazancı üzerindeki ortalama etkisi, yaş, eğitim, ırk, evlilik, diploma durumu ve 1974–1975 kazançları kontrol edilerek çift sağlam (AIPW) kestiriciyle 469{,}64 dolar bulunmuştur (SH 926{,}16; %95 GA -1345{,}59 ile 2284{,}87; z=0{,}51; p=0{,}612). Yığılmış sandviç SH 1180{,}45'tir. Etki sıfırdan ayırt edilememiştir.
125.8 Sık hatalar ve tuzaklar
- Tedavi düzeyinin seçimi. Hangi düzeyin tedavi sayıldığı sütun türüne ve düzey sırasına bağlı değildir: sayıya benzeyen düzeylerde büyük, metinde alfabetik son düzey tedavidir;
tedavi/kontroletiketli sütunda "kategorik" ya da "ikili" türde ATE +469{,}64 ve tedavi n=185 çıkar (R ve Python aynı). Çıktının "Tedavi sayılan düzey" satırı seçimi yazar; beklediğiniz grupla uyuşmuyorsatedavi_duzeyialanına tedavi düzeyini yazın (kontrolyazılırsa ATE -469{,}64 olur, SH aynıdır). - Ağırlık patlaması ve örtüşme. Örtüşme tanısı tablosu ve uyarısı \hat e<0{,}01 ya da \hat e>0{,}99 olan gözlemleri sayar (örnek veride 1 gözlem; en büyük ağırlık 40{,}1, tedavi grubunun etkin n'si 58{,}3). 158 gözlemin eğilim skoru 0{,}05'in altındadır; \varepsilon=0{,}05 ile bu sayı "Eğilim skoru kırpma" notunda yazılır. IPW, AIPW ve regresyon düzeltmesinin 225, 470 ve 1075 gibi dağılması örtüşme zayıflığının göstergesidir. Şekilde örtüşmenin olduğu aralığa bakın.
-
Kırpma ve sonucun kayması. \varepsilon=0{,}05 ATE'yi 469{,}64'ten 799{,}62'ye (ayrı modeller) ve 887{,}17'den 1210{,}34'e (tek model) taşır; kırpılan 158 gözlem notta ve tanı tablosunda yazılır, "eğilim skoru aralığı" satırı kırpılmış değerleri gösterir (0{,}0500 alt sınır). Eğilim bloğu kırpılmamış skorla yazıldığından
SH_sandvickırpmayla da anlamını korur (ayrı modellerde 1089{,}24; ana SH 716{,}24). -
Ayrı mı, tek model mi? Örnek veride ATE 469{,}6 (ayrı) ve 887{,}2 (tek model): sonuç modeli seçimi karşılaştırılabilir büyüklükte fark yaratır; bu, tedavi etkisinin ortak değişkenlere göre değiştiğini ve (ya da) modelin tek kategoriyle uyumsuz olduğunu gösterir. İkisini de raporlayın.
- 0/1 sonuç ve varsayılan ayrı model. Sonuç 0/1 iken lojistik sonuç modelleri ayrı uydurulur. Ortak değişkenlerin ölçü birimi (
re74,re75dolar) artık türev matrisini bozmaz: şablon çalışır (ATE 0{,}0368187,SH_sandvic0{,}0724227),re74,re75bin dolar biriminde yazılınca ya da "tek model" seçilince de aynı sonucu verir. Python eşi aynı değeri verir (Bölüm 126). - Ölçü birimi ve SH_sandvic. ATE ve iki SH ölçeğe uygun biçimde ölçeklenir (\times100 için 46963{,}998; SH 92615{,}51;
SH_sandvic118044{,}88), ve R şablonu bu çalıştırmada da durmaz (ar_sent). -
Tam ayrışma. Bir ortak değişken tedaviyi tam ayırıyorsa eğilim skoru modeli yakınsamaz ya da eğilim skorları 0/1'e çakılır; şablon "Eğilim skoru modeli tam (ya da yarı) ayrışma gösteriyor" iletisiyle durur ve
glm.fituyarısını iletiye ekler (ar_tam_ayrisma). Ayrışan değişkeni ortak değişkenlerden çıkarın. -
Eksik değer ve atılan satırlar. Eksik satırlar sessizce atılır (ATE 204{,}4, n=607; yedi satır eksikken). Çıktıdaki n'yi veri sayınızla karşılaştırın.
- Kategorik karıştırıcı sayısı.
educ'u "kategorik" yapmaknodegreeile birlikte eş doğrusallık doğurur ("doğrusal bağımlı" hatası;ar_race_kat), çünkünodegree,educ'un bir fonksiyonudur. - Tedavi sonrası değişkenler. Tedaviden sonra ölçülen değişkenler
ortak'a konmamalıdır; bunları şablon denetlemez.
125.9 Uzman soruları
S1. Çift sağlamlık neyi güvence eder, neyi etmez?
Eğilim ya da sonuç modelinden biri doğruysa \hat\mu_a tutarlıdır; ikisi birlikte yanlışsa hata birikebilir ve AIPW, IPW'den ya da regresyondan daha kötü olabilir (Kang ve Schafer, 2007). Çift sağlamlık yanlış belirlenmenin yokluğunu değil, iki şansı verir. Bu veride üç kestirici (225, 470, 1075) dağılıyorsa en az birinin modeli yanlıştır.
S2. Hangi SH'yi raporlamalıyım: etki fonksiyonu mu, sandviç mi?
Ana SH (926{,}16) \hat e ve \hat m'yi sabit sayar; sandviç (1180{,}45) tahmin belirsizliğini de içerir. İki durumda küçük fark beklenir: modeller iyi belirlenmiş ve örtüşme iyi ise. Aralarında belirgin fark, örtüşmenin ya da modellerin zayıf olduğunu gösterir; sandviçi raporlamak daha temkinlidir. Ana SH, AIPW paketinin ve yaygın pratiğin değeriyle aynıdır.
S3. Neden ayrı ve tek model bu kadar farklı ATE verdi?
Ayrı modelde \hat m_1 yalnız 185 tedavi gözleminde uydurulur; tedavi ve ortak değişkenler arasındaki tüm etkileşimlere izin verilir. Tek modelde tedavi etkisi \hat\beta_A sabittir. Eğilim skoru zayıf örtüşmede kontrol grubunun \hat m_1'i tedavi grubunun az gözlem içerdiği bölgelerde ekstrapole edilebilir; regresyon düzeltmesi bu veride 1075 (\mathrm{ayri}) ve 1548 (tek) gibi ayrılır. Bu, sonuç modelinin ATE'yi belirlemede ne kadar belirleyici olduğunu gösterir.
S4. Kırpma sınırı nasıl seçilir?
Kırpma bir yanlılık-varyans değiş tokuşudur: ağırlıkları sınırlar (SH azalır, 716) ve \hat\mu_a'yı yanlı kılar. Uygulamada \varepsilon=0{,}01–0{,}05 ve sonucun \varepsilon ile nasıl kaydığı raporlanır (Crump ve ark., 2009, örtüşme için örneklem kırpmayı önerir). Şablonun varsayılanı kırpmamaktır.
S5. Sonuç 0/1 iken ATE'nin yorumu nedir ve doğrusal olasılık modeli ne zaman yeterli?
0/1 sonuçta \hat\mu_a olasılıktır; ATE risk farkıdır (0{,}0321; 0{,}0368). Lojistik sonuç modeli \hat m_a\in(0{,}1) garantiler; sonuc_ailesi = dogrusal doğrusal olasılık modelidir ve olasılığı [0{,}1] dışına taşıyabilir (ATE 0{,}0422, SH 0{,}0695). Sonuç modeli yanlışsa da çift sağlamlık bozulmaz; yine de \hat m_a sınırlıysa AIPW daha kararlıdır.
S6. Sınır durumu: tek bir ortak değişken tedaviyi tam ayırıyor
Eğilim skoru 0 ya da 1 olur, ağırlıklar sonsuzlaşır ve \hat\mu_0 tanımsızdır; şablon "Eğilim skoru modeli tam (ya da yarı) ayrışma gösteriyor" iletisiyle durur. Gerçek veride "yakın ayrışma" daha sık görülür ve katsayı sonlu kalır; eğilim modelinin glm.fit uyarısı ya da e<10^{-8}, e>1-10^{-8} ölçütü bunu yakalar, eşiğin üstünde kalan yakın ayrışmayı ise tanı tablosundaki küçük e, büyük ağırlık ve küçük etkin n gösterir. Ayrışan değişkeni ortak değişkenlerden çıkarmak yetmez: örtüşme yoktur ve ATE kestirilemez.
S7. AIPW paketi ile şablon aynı mı?
Tek model için evet: ATE 887{,}1699, SH 937{,}3385 (10^{-8}). Paket sonuç modelini tedaviyi ana etki alan tek model olarak kurar ve SH'yi etki fonksiyonundan verir; şablonun varsayılanı (ayrı modeller) paketin kurmadığı bir seçenektir ve onunla karşılaştırılamaz. Paket çapraz uydurmayı k\_split>1 ile açar; şablonda çapraz uydurma yoktur.
S8. Python eşi ile ne zaman ayrışıyor?
Sonuçlar 10^{-8} göreli içinde aynıdır (Bölüm 126.6). Tedavi düzeyi seçimi ve sandviç türevi iki şablonda aynı kurala ve aynı sayısal koşullamaya dayanır; ayrışma noktası kalmamıştır.
S9. Gözlenmeyen karıştırıcı varsa ne yapılır?
AIPW gözlenen karıştırıcılar için düzeltir; gözlenmeyen karıştırıcı yanlılığı gidermez. Duyarlılık çözümlemesi (Bölüm 131) ya da araç değişken (Bölüm 140) gerekir.
125.10 Kaynaklar
- Bang, H., & Robins, J. M. (2005). Doubly robust estimation in missing data and causal inference models. Biometrics, 61(4), 962–973. https://doi.org/10.1111/j.1541-0420.2005.00377.x
- Crump, R. K., Hotz, V. J., Imbens, G. W., & Mitnik, O. A. (2009). Dealing with limited overlap in estimation of average treatment effects. Biometrika, 96(1), 187–199. https://doi.org/10.1093/biomet/asn055
- Dehejia, R. H., & Wahba, S. (1999). Causal effects in nonexperimental studies: Reevaluating the evaluation of training programs. Journal of the American Statistical Association, 94(448), 1053–1062. https://doi.org/10.1080/01621459.1999.10473858
- Imbens, G. W. (2004). Nonparametric estimation of average treatment effects under exogeneity: A review. Review of Economics and Statistics, 86(1), 4–29. https://doi.org/10.1162/003465304323023651
- Kang, J. D. Y., & Schafer, J. L. (2007). Demystifying double robustness: A comparison of alternative strategies for estimating a population mean from incomplete data. Statistical Science, 22(4), 523–539. https://doi.org/10.1214/07-STS227
- LaLonde, R. J. (1986). Evaluating the econometric evaluations of training programs with experimental data. The American Economic Review, 76(4), 604–620.
- Lunceford, J. K., & Davidian, M. (2004). Stratification and weighting via the propensity score in estimation of causal treatment effects: A comparative study. Statistics in Medicine, 23(19), 2937–2960. https://doi.org/10.1002/sim.1903
- Robins, J. M., Rotnitzky, A., & Zhao, L. P. (1994). Estimation of regression coefficients when some regressors are not always observed. Journal of the American Statistical Association, 89(427), 846–866. https://doi.org/10.1080/01621459.1994.10476818
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41
- Zhong, Y., Kennedy, E. H., Bodnar, L. M., & Naimi, A. I. (2021). AIPW: An R package for augmented inverse probability–weighted estimation of average causal effects. American Journal of Epidemiology, 190(12), 2690–2699. https://doi.org/10.1093/aje/kwab207
- Yazılım kaydı: R 4.5.3 (taban paketler); doğrulamada AIPW 0.6.9.3 ve SuperLearner 2.0.42.