83. Orijin–Döl Denemesi: Varyans Bileşenleri ve Kalıtım
Şablon kimliği: orijin_dol_denemesi · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/orijin_dol_denemesi.R (satır 1–1030; üstbilgi 1–138) · Örnek veri: _ornek/orijin_dol_denemesi_kizilcam.csv (dengeli sınama verisi: orijin_dol_denemesi_dengeli.csv) · Paketler: lme4, Matrix, minqa
83.1 Ne işe yarar
Orman ağacı ıslahının temel denemesi olan orijin–döl (provenans–döl) denemesinde tohumlar birkaç populasyondan (orijinden), her populasyonda birkaç ana ağaçtan toplanır ve fidanlar tekrarlı bir denemeye dikilir. Şablon, bu iç içe yapıda ölçülen bir ya da daha çok özellik için tek çalıştırmada şunları verir: varyans bileşenleri, iç içe varyans analizi tablosu, bireysel ve aile ortalaması kalıtım dereceleri, populasyonlar arası nicel farklılaşma (Q_{ST}), populasyon ortalamalarının çoklu karşılaştırması, aile ortalamaları ve özellikler arası fenotipik ve genetik korelasyonlar.
- P_i: populasyon; F_{j(i)}: populasyon içinde aile (açık tozlaşmış ana ağacın dölleri); R_k: tekrar (blok).
- (RP)_{ik}: tekrar × populasyon; (RF)_{kj(i)}: tekrar × aile(populasyon), yani parsel etkisi; e: parsel içi fidanlar arası artık.
- Tekrar rastgele (varsayılan) ya da sabit; öteki bütün etkiler rastgele.
Kalıtım derecesinin, akrabalık çarpanının ve standart hataların genel kuramı Bölüm 79.4'tedir. Bu bölüm iç içe modele özgü olanı anlatır: hangi bileşenin fenotipik varyansa girdiği, dengesiz veride varyans analizinin nasıl kurulduğu ve genetik korelasyonun üç ayrı kestiricisi.
Ne zaman kullanılır? Populasyon içinde aile yapısı olan tek lokasyonlu denemelerde; tohum ve kozalak ölçümleri gibi tekrarsız özellikler de aynı çalıştırmada çözümlenebilir.
Ne zaman kullanılmaz?
- Populasyon yapısı yoksa (yalnız aileler):
kalitim_derecesi(Bölüm 79) ya daseleksiyon_kazanci(Bölüm 89). - Birden çok lokasyon, klon denemesi, yaş–yaş korelasyonu:
klon_lokasyon_genetik(Bölüm 80). - Q_{ST}'nin belirteçlerden hesaplanan F_{ST} ile karşılaştırılması:
qst_fst. - Seleksiyon kazancı ve indeks:
seleksiyon_kazanci(Bölüm 89).
Temel programla ilişki. Temel programın iç içe varyans analizi ve karma model analizleri aynı modelin sabit etki testlerini ya da bileşenlerini verebilir; beklenen kareler ortalamasından sentezlenen paydaları, kalıtım derecelerini, Q_{ST}'yi ve genetik korelasyonları bir arada hesaplamaz.
83.2 Şablonun girdileri
Form, üstbilgideki on sekiz [[param]] bloğundan kurulur (orijin_dol_denemesi.R:10–137).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Özellikler · ozellikler |
sütunlar · Değişkenler | boş | sayısal sütunlar | Tekrarlı modelle çözümlenen özellikler (145). |
Populasyon / orijin · populasyon |
kategorik sütun · Değişkenler | ilk sütun | herhangi bir sütun | P etkisi (186). |
Aile · aile |
kategorik sütun · Değişkenler | ilk sütun | herhangi bir sütun | Populasyon içinde yuvalanır: düzey = populasyon:aile (206). |
Tekrar / blok · tekrar |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Yalnız bütün özellikler tekrarsızsa boş bırakılabilir (150–151). |
Tekrarsız ölçülen özellikler · tekrarsiz_ozellikler |
sütunlar · Değişkenler | boş | sayısal sütunlar | y=\mu+P+F(P)+e modeli (144, 600). |
Kestirim yöntemi · yontem |
seçim · Model | reml |
reml, ml, tip1 |
Bileşenlerin kestiricisi (158, 425–439). |
Tekrar etkisi · tekrar_etkisi |
seçim · Model | rastgele |
rastgele, sabit |
R rastgele ya da sabit (160, 345). |
Tekrar × aile terimi · tekrar_aile |
onay · Model | açık | açık / kapalı | Parsel etkisi; tek fidanlı parsellerde kendiliğinden çıkar (161, 609). |
Aile içi akrabalık · akrabalik |
seçim · Model | yarim_kardes |
yarim_kardes (k=4), tam_kardes (2), squillace (3), elle |
\sigma^2_A=k\sigma^2_F (162–165). |
Elle girilen k · k_elle |
ondalık · Model | 4 | 1–4 | Yalnız akrabalik = elle iken (164). |
h²f paydasında r ve n · h2f_katsayi |
seçim · Gelişmiş | harmonik |
harmonik, eko |
Harmonik ortalama ya da beklenen KO katsayıları (166, 723–728). |
Çoklu karşılaştırma · coklu_karsilastirma |
seçim · Seçenekler | duncan |
duncan, tukey, bonferroni, yok |
Populasyon ortalamalarının harf grupları (170, 837–859). |
Çoklu karşılaştırmada hata terimi · karsilastirma_hatasi |
seçim · Gelişmiş | payda |
payda, artik, aile |
Varsayılan: populasyon F testinin sentezlenmiş paydası; seçenekle artık KO ya da aile(populasyon) KO (172, 866–880). |
Anlamlılık düzeyi · alfa |
ondalık · Seçenekler | 0,05 | 0,0001–0,49 | Çoklu karşılaştırma düzeyi (173–174). |
Genetik korelasyon · genetik_korelasyon |
onay · Seçenekler | açık | açık / kapalı | Özellik çiftleri için r_G (175, 929, 957). |
Genetik korelasyonun türü · gk_tipi |
seçim · Seçenekler | ayni_birey |
ayni_birey, tip_b |
Aynı ya da farklı bireylerde ölçülen özellikler (167). |
Genetik korelasyonun SH'si · rg_sh |
onay · Seçenekler | kapalı | açık / kapalı | Delta ve Falconer–Mackay standart hataları (168). |
Değişkenlik katsayıları tablosu · degiskenlik |
onay · Seçenekler | kapalı | açık / kapalı | \sigma^2_u, \sigma^2_{fm} ve DK'lar (169, 770–786). |
Örnek ayar (ornek_param, satır 9): dört özellik (boy, kbc, dal_sayisi, igne_boyu), populasyon, aile, tekrar; öteki alanlar varsayılanda.
Şablonun kendi denetimleri (çalıştırmayı durduranlar):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri yok; hiç özellik seçilmemiş | "Önce … veri açın." / "En az bir özellik … seçin." | 142, 146 |
| Populasyon ya da aile seçilmemiş; tekrarlı özellik varken tekrar boş | "… sütunlarını seçin." / "Tekrar sütununu seçin …" | 148–151 |
| Aynı sütun iki rolde; özellik bir sınıflama sütunuyla aynı; veride olmayan sütun | "farklı sütunlar olmalı" / "Veride olmayan sütun" | 153–156 |
| Özellik sayısal değil | "sayısal olmalı" | 157 |
| Geçersiz yöntem, akrabalık ya da çoklu karşılaştırma; k 1–4 dışında; \alpha (0;\,0{,}5) dışında | "Geçersiz …" / "k 1 ile 4 arasında olmalı" / "α 0 ile 0,5 arasında olmalı" | 159–174 |
| REML/ML istenmiş, lme4 kurulu değil | "lme4 paketi gerekli" | 176–177 |
| 2'den az populasyon; 2'den az tekrar; hiçbir populasyonda birden çok aile yok | "En az 2 populasyon gerekli …" | 591–594 |
| Hiçbir özellik çözümlenemedi | "Çözümlenebilir özellik yok." | 617 |
Bir özellik tek başına çözümlenemiyorsa (10'dan az gözlem, tek populasyon, tek tekrar, sabit değerler …) çalıştırma durmaz; özellik atlanır ve neden Notlar'a yazılır (602–608). Notlar çıktının sonunda toplanır (1029): boş hücre (613), lme4 uyarıları (614), sınırdaki bileşenler (655), negatif Tip I kestirimleri (657), h^2>1 (790–809), tanımsız Q_{ST} standart hatası (758), genetik korelasyon uyarıları (954–956, 990, 1006–1008).
Eksik değer özellik bazındadır: her özellik kendi eksiksiz satırlarıyla çözümlenir (200); genetik korelasyonda çiftin iki özelliği de ölçülmüş fidanlar kullanılır (963–964).
83.3 Örnek veri
orijin_dol_denemesi_kizilcam.csv yapaydır: sabit tohumla üretilmiş, kızılçam fidanlık denemesine benzeyen bir veri. 22 populasyon × 10 aile × 3 tekrar; parsel başına 1–8 fidan, toplam 3785 fidan satırı. Ayrıca her aileden 6 tohumun tekrarsız ölçümleri 1320 ayrı satırda durur (bu satırlarda tekrar ve fidan özellikleri boştur).
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
populasyon |
Populasyon | kategorik (22 düzey) | P01–P22. |
aile |
Aile | sayısal | 1–10; her populasyonda yeniden numaralanır. |
tekrar |
Tekrar | sayısal | 1, 2, 3; tohum satırlarında boş. |
fidan |
kullanılmaz | sayısal | Parsel içi sıra numarası. |
boy, kbc, dal_sayisi |
Özellik | sayısal | Fidan boyu, kök boğazı çapı, dal sayısı; 3785 değer. |
igne_boyu |
Özellik | sayısal | 3710 değer (%2 eksik). |
tohum_agirligi, tohum_boyu |
Tekrarsız özellik | sayısal | 1320 değer (220 aile × 6 tohum). |
Aile numaraları populasyonlar arasında yinelenir; şablon aileyi her zaman populasyon:aile birleşimiyle tanımlar (206), bu yüzden numaraların tekil olması gerekmez. Sınıflama sütunları metne çevrilir (185); düzeyler hepsi sayıya çevrilebiliyorsa sayısal, değilse alfabetik sıralanır (180–184). Sıra tabloların satır düzenini belirler, kestirimleri etkilemez.
Tasarım dengesizdir: aile başına tekrar sayısının harmonik ortalaması 3, parsel başına fidan sayısının harmonik ortalaması 5,362'dir (aritmetik ortalama 5,73).
orijin_dol_denemesi_dengeli.csv (6 populasyon × 5 aile × 3 tekrar × 4 fidan = 360 satır) kapalı biçimli formüllerle karşılaştırma içindir.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar (dört özellik, REML; yaklaşık 2,5 dakika); (2) ML; (3) Tip I; (4) tekrar sabit; (5) k=3, beklenen KO katsayılı h^2_f, değişkenlik katsayıları, Tukey–Kramer ve aile(populasyon) hata terimi; (6) elle k=2{,}5, Bonferroni, parsel terimsiz; (7) tekrarsız tohum özellikleri ve tip B korelasyon; (8) genetik korelasyonun standart hataları; (9) dengeli veri, REML ve Tip I; (10) altı populasyonluk alt küme ve satırları karıştırılmış kopyası; (11) bir ailenin bir tekrarı silinmiş (boş hücreli) veri.
83.4 Yöntem: formüller ve hesap adımları
Her özellik için sıra: (1) tasarım matrisleri ve iç içe varyans analizi (tip I ve tip III kareler toplamları, beklenen KO katsayıları); (2) varyans bileşenleri (REML, ML ya da Tip I) ve standart hataları; (3) her terimin F testi için sentezlenmiş payda; (4) kalıtım dereceleri ve Q_{ST}; (5) populasyon ortalamaları ve harf grupları; (6) aile ve parsel ortalamaları, korelasyonlar; (7) genetik korelasyonlar.
83.4.1 Dengesiz veride iç içe varyans analizi
Dengeli veride kareler toplamları ortalamalardan yazılır (83.6, Adım 1). Dengesiz veride terimlerin kareler toplamı hesap sırasına bağlıdır; şablon iki tanımı da kurar.
- R(\cdot\mid\cdot): terim modele sırayla eklendiğinde artık kareler toplamındaki azalma; sıra R, P, RP, F, RF'dir.
- \mathbf L_t: terim t'nin tip III hipotez matrisi; terimi içeren üst düzey terimlerin etkilerine dik kılınmış tahmin edilebilir fonksiyonlar (Goodnight, 1980).
- Boş hücre yokken tip III kareler toplamı, toplam-sıfır kodlu tam modelden terimin sütunları çıkarıldığında artık kareler toplamındaki artışa eşittir; iç içe terim her populasyonda ayrı kodlanır.
Neden iki tip birden?
Tip I toplamları toplam kareler toplamını tam olarak böler ve beklenen değerlerine eşitlenerek bileşen kestirimine uygundur (Henderson'ın 1. yöntemi). Tip III toplamları her terimi ötekilerin hepsine göre düzeltir; hipotez testi için tercih edilir, çünkü sınanan hipotez hücre büyüklüklerine bağlı değildir. Şablon testleri tip III ile, Tip I seçeneğindeki bileşenleri tip I ile kurar. Dengeli veride ikisi aynıdır.
Her kareler ortalamasının beklenen değeri bileşenlerin doğrusal bileşimidir. Katsayılar Hartley'in (1967) sentez yöntemiyle bulunur:
- \mathbf z_{jm}: rastgele terim j'nin m. düzeyinin gösterge sütunu; KT_t(\mathbf z): yanıt yerine bu sütun konduğunda terim t'nin kareler toplamı.
- c_{tj}: terim j'nin varyansının terim t'nin beklenen KO'sundaki katsayısı. Dengeli veride n, nr, nf, nfr, nfp çarpımlarıdır; dengesiz veride kesirli sayılardır.
Koddaki tercih
Tasarım gösterge kodlamasıyla kurulur (243–251); tip I parçaları sinif işlevinde (252–264), tip III hipotezleri genel tahmin edilebilir fonksiyonlardan (270–287) hesaplanır. Kareler toplamı ve katsayılar \mathbf X^{\top}\mathbf X üzerinden bulunur, n\times n matris kurulmaz. Aynı satır kümesi ve model için tasarım parçaları bellekte tutulur ve yeniden kullanılır (291–299): dört özelliğin tasarımı bir kez hesaplanır. Boş hücre varsa (bir aile bir tekrarda hiç yoksa) tip III hipotezleri tahmin edilebilir kısımla sınırlanır ve not yazılır (289, 613).
83.4.2 Sentezlenmiş payda ve Satterthwaite serbestlik derecesi
Rastgele etkili modelde bir terimin F testinin paydası, o terimin kendi bileşeni dışında aynı beklenen değere sahip bir kareler ortalaması olmalıdır. Böyle tek bir satır çoğu kez yoktur; payda öteki satırların doğrusal bileşimi olarak sentezlenir:
- a_k: katsayılar; beklenen KO matrisinden doğrusal denklem çözülerek bulunur (321–340). Negatif olabilirler.
- sd_{\text{payda}}: Satterthwaite'in (1946) yaklaşık serbestlik derecesi (691).
- Populasyon için dengeli veride payda KO_{RP}+KO_{F}-KO_{RF}'dir; dengesiz örnek veride 0{,}9973\,KO_{RP}+0{,}9770\,KO_{F}-0{,}9580\,KO_{RF}-0{,}0162\,KO_e.
Populasyon testi neden bu kadar karmaşık?
E(KO_P) dört bileşen içerir: \sigma^2_e, parsel, aile ve tekrar × populasyon. Populasyon farkı yoksa geriye kalan beklenen değer, RP ve F satırlarının toplamından ikisinde de bulunan parsel ve artık kısmının bir kez çıkarılmasıyla elde edilir. Çıkarma yapıldığı için sentezlenmiş KO negatif bile olabilir; o zaman F hesaplanmaz (692). Satterthwaite yaklaşımı negatif katsayılarda güvenilirliğini yitirir; populasyon testinin p değeri yaklaşık okunur.
Tekrar sabit seçildiğinde tekrar satırının beklenen KO'suna Q(\text{tekrar}) terimi eklenir (667) ve tekrar bileşeni kestirilmez.
83.4.3 Varyans bileşenleri: REML, ML ve Tip I
| Yöntem | Nasıl | Standart hata | Sınır |
|---|---|---|---|
| REML | lme4::lmer(..., REML = TRUE) |
Gözlenen bilgi matrisinin tersi | Sıfırın altına inmez; sınırdaki bileşen 0 yazılır |
| ML | lmer(..., REML = FALSE) |
Gözlenen bilgi matrisinin tersi | Aynı |
| Tip I | Tip I kareler ortalamaları beklenen değerlerine eşitlenir: \hat{\boldsymbol\sigma}^2=\mathbf E^{-1}\mathbf{KO} | \mathbf E^{-1}\operatorname{diag}\!\big(2KO^2/(sd+2)\big)\mathbf E^{-\top} | Negatif olabilir |
- \mathbf J: REML log olabilirliğinin ikinci türevlerinin eksi işaretlisi (gözlenen bilgi); \mathbf P ve \mathbf V_i Bölüm 79.4.3'teki gibidir. ML'de iz teriminde \mathbf P yerine \mathbf V^{-1} kullanılır.
- Çarpımlar Woodbury özdeşliğiyle rastgele etki düzeyi sayısı boyutunda yapılır (358–410).
Bu şablon gözlenen, Bölüm 79 ve 80'dekiler beklenen bilgiyi kullanır
İkisi de asimptotik olarak aynı kovaryansı kestirir; sonlu örneklemde farklıdır. Örnek veride aile bileşeninin standart hatası gözlenen bilgiyle 0,3252, beklenen bilgiyle 0,3241'dir. Tablo başlığı hangisinin kullanıldığını yazar ("asimptotik, gözlenen bilgi matrisinden").
Koddaki tercih
lme4 bobyqa ile rhoend = 1e-12 toleransında çağrılır; tekillik ve düzey sayısı denetimleri kapatılır (347–348). lme4 uyarıları toplanır ve Notlar'a yazılır (349–350, 614). En büyük bileşenin 10^{-10} katından küçük bileşen 0 yapılır (436). Sınırdaki bileşen bilgi matrisinden çıkarılır: standart hatası boş kalır, öteki bileşenlerin kovaryansı o bileşen sabit sayılarak hesaplanır (360, 408); delta yönteminde de sınırdaki bileşenin türevi atlanır (715).
Tip I yöntemi neden hâlâ seçenek?
Henderson'ın (1953) 1. yöntemi kapalı biçimlidir, yinelemesizdir ve eski yayınlardaki sonuçlarla doğrudan karşılaştırılabilir. Normallik varsaymaz. Zayıf yanı: negatif kestirim verebilir ve dengesiz veride REML'den daha az etkindir. Standart hatası kareler ortalamalarının bağımsız ve ki-kare dağılımlı olduğu varsayımına dayanır; bu, dengesiz veride yalnız yaklaşık doğrudur (Searle ve ark., 1992).
83.4.4 Kalıtım dereceleri ve Q_{ST}
- \sigma^2_F: aile(populasyon) bileşeni; k: akrabalık çarpanı (Bölüm 79.4.1).
- h^2_i: populasyon içi bireysel, dar anlamda kalıtım derecesi; payda \sigma^2_u=\sigma^2_F+\sigma^2_{RF}+\sigma^2_e'dir.
- h^2_f: aile ortalaması kalıtım derecesi; r aile başına tekrar, n parsel başına fidan sayısı. Payda aile ortalamasının fenotipik varyansı \sigma^2_{fm}'dir. Çarpan k kullanılmaz.
- Q_{ST}: nicel özellikte populasyonlar arası farklılaşma (Spitze, 1993); nötr belirteçlerin F_{ST}'sinin karşılığıdır.
Populasyon, tekrar ve tekrar × populasyon neden paydada yok?
Kalıtım derecesi, seçimin yapılacağı birimler arasındaki varyansa göre tanımlanır. Orijin–döl denemesinde aile ve birey seçimi populasyonların içinde yapılır; populasyon ortalamaları arasındaki fark ve populasyonların tekrarlara göre farklı tepkisi bir populasyonun bütün ailelerine ortaktır, aileler arası sıralamayı etkilemez. Tekrar etkisi de deneme düzeninden gelir. Bu bileşenler paydaya alınsaydı h^2 küçülürdü ve "bütün populasyonlar tek havuzmuş gibi seçim" anlamına gelirdi (White ve ark., 2007). Populasyon bileşeni Q_{ST}'de ayrıca değerlendirilir.
Q_{ST}'de neden 2\sigma^2_A?
Rastgele çiftleşen diploit populasyonlarda nötr bir eklemeli özelliğin populasyonlar arası varyansı 2F_{ST}\sigma^2_A, populasyon içi eklemeli varyansı (1-F_{ST})\sigma^2_A ile orantılıdır. Oran çözüldüğünde F_{ST}=\sigma^2_P/(\sigma^2_P+2\sigma^2_A) çıkar. Q_{ST}>F_{ST} populasyonların farklı yönlerde seçildiğine, Q_{ST}<F_{ST} ortak dengeleyici seçilime işaret eder. \sigma^2_A, k'ye bağlı olduğundan Q_{ST} de akrabalık varsayımına duyarlıdır.
Akrabalık çarpanı. Açık tozlaşmış ailelerde bir kısım kardeş aynı babadan gelir, bir kısmı kendileme ürünüdür; aile içi ortalama akrabalık ¼'ten büyüktür. Squillace (1974) iğne yapraklılar için ⅓'ü (k=3) önerir. Seçenek squillace bunu, elle 1 ile 4 arasında herhangi bir k'yi uygular (164). h^2_i ve \sigma^2_A k ile doğru orantılıdır; h^2_f değişmez.
Dengesiz veride r ve n. Varsayılan, Holland ve ark.'nın (2003) önerdiği harmonik ortalamalardır (633–640, 725). h2f_katsayi = eko seçilirse aile satırının tip III beklenen KO katsayıları kullanılır: E(KO_F)=\sigma^2_e+c_1\sigma^2_{RF}+c_2\sigma^2_F için r=c_2/c_1, n=c_1 (726–727); bu, \sigma^2_{fm}=KO_F/c_2 yaklaşımıdır. Dengeli veride ikisi aynıdır.
Standart hatalar delta yöntemiyledir (713–748); türevler açık yazılmıştır (737–739). h^2>1 kestirildiğinde değer kesilmez; Notlar'a oran, delta yöntemli %95 aralığın 1'i içerip içermediği ve yarım kardeş varsayımında k=3 ile ne olacağı yazılır (790–809).
Değişkenlik katsayıları (degiskenlik açıkken): DK=100\sqrt{\sigma^2}/\lvert\bar x\rvert; eklemeli genetik (DK_A; Houle, 1992), bireysel fenotipik (DK_u), aile ortalaması (DK_{fm}), aile, populasyon ve artık için (770–784).
Tekrarsız özellikler. Model y=\mu+P+F(P)+e olur; h^2_i=k\sigma^2_F/(\sigma^2_F+\sigma^2_e), h^2_f=\sigma^2_F/(\sigma^2_F+\sigma^2_e/n), n aile başına birey sayısının harmonik ortalamasıdır (725, 732–740).
83.4.5 Populasyon ortalamaları ve çoklu karşılaştırma
Her populasyonun ham ortalaması, gözlem sayısı ve standart sapması verilir; seçilen yöntemle harf grupları eklenir.
| Yöntem | Karar kuralı | Satır |
|---|---|---|
| Duncan | Sıralı ortalamalarda p ortalamayı kapsayan aralık anlamlıdır, eğer fark R_p=q_{(1-\alpha)^{p-1}}(p,\,sd)\sqrt{KO/\tilde n}'den büyükse; geniş aralık anlamsızsa içindeki aralıklar sınanmaz | 840–851 |
| Tukey–Kramer | \lvert\bar y_i-\bar y_j\rvert>\dfrac{q_{1-\alpha}(a,\,sd)}{\sqrt2}\sqrt{KO\big(\tfrac1{n_i}+\tfrac1{n_j}\big)} | 853–854 |
| Bonferroni | \lvert\bar y_i-\bar y_j\rvert>t_{1-\alpha/(a(a-1))}(sd)\sqrt{KO\big(\tfrac1{n_i}+\tfrac1{n_j}\big)} | 853–854 |
- q: stüdentleştirilmiş aralık dağılımının nicemi; a: populasyon sayısı; \tilde n: populasyon büyüklüklerinin harmonik ortalaması (Duncan'da).
- KO ve sd: hata terimi. Varsayılan, varyans analizi tablosunda populasyonu sınayan sentezlenmiş paydanın KO'su ve Satterthwaite serbestlik derecesidir (700, 866–880);
karsilastirma_hatasi = artikseçilirse artık KO ve sd,aileseçilirse aile(populasyon) satırının tip III KO'su ve serbestlik derecesi kullanılır. Sentezlenmiş payda pozitif değilse ya da kurulamıyorsa artık KO'ya düşülür ve not yazılır (866–870).
Hata terimi karşılaştırmanın anlamını belirler
Artık KO ile yapılan karşılaştırma "bu denemedeki bu fidanların ortalamaları farklı mı" sorusunu sınar ve çok sayıda harf grubu verir. Populasyonların, örneklenen ailelerin ötesine genellenmesi isteniyorsa hata, aileler arası değişimi de içermelidir. Örnek veride boy için artık KO 15,09 (sd 3125), aile(populasyon) KO 50,95 (sd 198), populasyon F testinin sentezlenmiş paydası ise 91,87'dir (sd 80,36). Kritik fark \sqrt{KO} ile orantılı olduğundan artık KO ile yapılan karşılaştırma, aynı çıktıdaki populasyon F testine göre farkları yaklaşık \sqrt{91{,}87/15{,}09}\approx2{,}5 kat kolay anlamlı bulur. Bu yüzden şablon varsayılan olarak varyans analizi tablosundaki populasyon testiyle aynı hata terimini kullanır (yayımlanmış orman ağacı ıslahı uygulaması da Duncan'ı F testinin hata terimiyle yapar); harf grupları ile F testi çelişmez. Artık KO ya da aile(populasyon) KO formdan seçilebilir.
83.4.6 Fenotipik ve genetik korelasyonlar
Fenotipik. Aile ortalamaları (populasyon × aile) ve parsel ortalamaları (tekrar × aile) arasında Pearson korelasyonu ve t testi (904–917).
Genetik, aynı bireylerde ölçülen özellikler. Tanım her yöntemde aynıdır:
REML ve ML'de aile kovaryansı iki değişkenli karma modelden gelir: her rastgele terim ve artık için 2\times2 yapılandırılmamış kovaryans matrisi kestirilir (Holland, 2006). Tip I'de toplam yöntemi kullanılır (Bölüm 80.4.3). İki durumda da özellikler önce kendi standart sapmalarına bölünür (970–974).
Koddaki tercih
İki değişkenli model şablonun kendi çözücüsüyle uydurulur (ikili_reml, 461–522): her kovaryans matrisi Cholesky çarpanıyla parametrelenir (\mathbf G=\mathbf L\mathbf L^{\top}; matris pozitif yarı tanımlı kalır, \lvert r\rvert\le1), olabilirlik Henderson'ın karma model denklemlerinin seyrek Cholesky ayrışımından hesaplanır, en iyileme minqa::bobyqa ile yapılır (516). Başlangıç değerleri tek değişkenli çözümlerden ve toplam değişkenden alınır (577–586, 986). En iyileyici yakınsama kodu sıfır değilse Notlar'a yazılır (990). Bir çift tekrarlı ve tekrarsız özellikten oluşuyorsa tekrarsız modelle çözülür (961).
Genetik, farklı bireylerde ölçülen özellikler (tip B). Tohum ağırlığı ile fidan boyu gibi özellikler aynı bireyde ölçülemez. Burdon'un (1977) tip B korelasyonu aile ortalamalarından kurulur:
- \bar x_{ij}, \bar y_{ij}: populasyon i'deki aile j'nin iki özellikteki ortalaması; f_i: populasyondaki ortak aile sayısı.
- Pay, aile ortalamalarının populasyon içi birleştirilmiş kovaryansıdır (945). Farklı bireylerin hataları bağımsız olduğundan beklenen değeri aile kovaryansıdır.
- Paydadaki aile varyansları her özelliğin kendi modelinden alınır (946–948).
Tip B seçeneği aynı bireylerde ölçülen çiftte boş kalır
gk_tipi = tip_b seçildiğinde aynı bireylerde de ölçülmüş çiftlerde hata ve parsel kovaryansı aile ortalamalarının kovaryansına karışır; bu yüzden şablon bu çiftlerde r_B ve standart hatasını hesaplamaz (boş bırakır; 949) ve çifti ortak birey sayısıyla Notlar'da listeler (954). Örnek veride boy–kök boğazı çapı (3785 ortak fidan) ve tohum ağırlığı–tohum boyu (1320 ortak tohum) çiftleri böyledir; bunlar için çözümleme ayni_birey seçeneğiyle ayrıca çalıştırılır. Farklı bireylerde ölçülen çiftler (boy–tohum ağırlığı: r_B=0{,}5091) etkilenmez.
Genetik korelasyonun standart hatası (rg_sh açıkken iki sütun):
- \mathbf C: iki değişkenli modelde aile teriminin (\sigma_{11},\sigma_{12},\sigma_{22}) parametrelerinin asimptotik kovaryansı; -2\log L'nin sayısal Hessian'ından 2\mathbf H^{-1} (525–575). Sınırdaki terimler sabit tutulur.
- \operatorname{SH}_{FM}: Falconer ve Mackay'ın (1996) verdiği, Robertson'a (1959) dayanan yaklaşım; bireysel h^2 ve delta SH'leriyle (924–928).
- Tip I'de ve tip B'de yalnız \operatorname{SH}_{FM} verilir.
83.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–138 | Üstbilgi ve on sekiz parametre. | Açıklama alanı yöntemin tamamını özetler. |
| 139–177 | Parametrelerin okunması ve denetimi; k (164). | Tekrarsız özellikler ozl listesine eklenir (145). |
| 179–210 | Düzey sırası, etiket temizliği, veri_kur: eksiksiz satırlar ve F, RP, RF etkileşim etkenleri. |
Tekrarsız modelde tekrar tek düzeye indirilir (201). |
| 212–340 | Genelleştirilmiş ters yardımcıları, tasarim_kur, anova_motoru, ems_matrisi, payda_kur. |
Bölüm 83.4.1–83.4.2. |
| 342–410 | lme_kur (lme4) ve bilgi_kov (beklenen ve gözlenen bilgi). |
Sınırdaki bileşenler etkin dışında kalır (360). |
| 412–457 | coz: bir özelliğin tam çözümü; bilesen_kestir: yalnız bileşenler. |
Tip I: solve(E1, ms1) (427). |
| 459–586 | İki değişkenli REML/ML, sayısal Hessian'dan kovaryans, başlangıç değerleri. | Çalışma süresinin büyük kısmı buradadır. |
| 588–630 | Genel yapı denetimi; özellik döngüsü; model satırlarının konsola yazılması. | Atlanan özellikler Notlar'a (608). |
| 632–710 | Tasarım özeti, bileşen tablosu, tip III varyans analizi, beklenen KO tablosu, Tip I tablosu. | Bileşen tablosundaki yuzde bütün bileşenlerin toplamına göredir. |
| 712–810 | Kalıtım dereceleri, Q_{ST}, değişkenlik katsayıları, h^2>1 notları. | Q_{ST}'nin SH'si \sigma^2_P sınırdaysa "—" (752–760). |
| 812–884 | Harf atama (harf_bul), nicem (qtk), üç karşılaştırma yöntemi, populasyon tablosu. |
qtukey sonuç vermezse ptukey'in kökü aranır (830–836). |
| 886–917 | Aile ortalamaları tablosu; iki Pearson korelasyon tablosu. | Parsel korelasyonu yalnız tekrarlı özelliklerde. |
| 919–1012 | Genetik korelasyon: tip B ya da aynı birey kolu; standart hatalar. | Çift başına bir iki değişkenli çözüm. |
| 1014–1030 | Bileşen payları grafiği; Notlar. | Negatif bileşenler grafikte 0 sayılır (1019). |
83.6 Elle hesap: örnek veride bağımsız yeniden hesap
Hesaplar dogrulama/orijin_dol_denemesi/elle_hesap.py ile yapılmıştır: dengeli veride kapalı biçimli formüller; dengesiz veride tip III toplamları toplam-sıfır kodlu regresyonda terim çıkarılarak, tip I toplamları sıralı QR ayrışımıyla, beklenen KO katsayıları gösterge sütunlarının aynı izdüşümdeki kareler toplamından; REML ve ML Bölüm 79'daki Fisher puanlamalı çözücüyle. R tarafında (r_dogrulama.R) lm/anova, lm.fit, agricolae::duncan.test, cor.test ve glmmTMB kullanılmıştır.
Adım 1 — Dengeli veri: kapalı biçim. p=6 populasyon, f=5 aile, r=3 tekrar, n=4 fidan; özellik boy.
| Kaynak | sd | KT | KO | Beklenen KO |
|---|---|---|---|---|
| Tekrar | 2 | 883,956 | 441,978 | \sigma^2_e+n\sigma^2_{RF}+nf\sigma^2_{RP}+nfp\,\sigma^2_R |
| Populasyon | 5 | 2137,783 | 427,557 | \sigma^2_e+n\sigma^2_{RF}+nr\sigma^2_F+nf\sigma^2_{RP}+nfr\,\sigma^2_P |
| Tekrar × populasyon | 10 | 216,432 | 21,643 | \sigma^2_e+n\sigma^2_{RF}+nf\sigma^2_{RP} |
| Aile(populasyon) | 24 | 1450,933 | 60,456 | \sigma^2_e+n\sigma^2_{RF}+nr\sigma^2_F |
| Tekrar × aile(populasyon) | 48 | 1238,259 | 25,797 | \sigma^2_e+n\sigma^2_{RF} |
| Hata | 270 | 4348,095 | 16,104 | \sigma^2_e |
Katsayılar n=4, nr=12, nf=20, nfr=60, nfp=120'dir. Bileşenler:
Tekrar × populasyon bileşeni negatiftir. Tip I seçeneği bu değeri olduğu gibi yazar; REML aynı veride bileşeni 0 yapar ve ötekileri yeniden dağıtır.
Populasyon testi: payda 21{,}643+60{,}456-25{,}797=56{,}302; Satterthwaite sd=56{,}302^2/\big(\tfrac{21{,}643^2}{10}+\tfrac{60{,}456^2}{24}+\tfrac{25{,}797^2}{48}\big)=14{,}88; F=427{,}557/56{,}302=7{,}594, p=0{,}0010. Kalıtım: \hat h^2_i=4\cdot2{,}8882/(2{,}8882+2{,}4233+16{,}104)=0{,}5395; \hat h^2_f=2{,}8882/(2{,}8882+2{,}4233/3+16{,}104/12)=0{,}5733; \hat Q_{ST}=6{,}1876/(6{,}1876+8\cdot2{,}8882)=0{,}2112.
Adım 2 — Örnek veri: tip III varyans analizi (boy). 3785 fidan; tam modelde 660 parametre, artık serbestlik derecesi 3125.
| Kaynak | sd | Tip III KT | KO | Payda KO | Payda sd | F |
|---|---|---|---|---|---|---|
| Tekrar | 2 | 7829,08 | 3914,54 | 61,971 | 42,09 | 63,17 |
| Populasyon | 21 | 27255,49 | 1297,88 | 91,873 | 80,36 | 14,13 |
| Tekrar × populasyon | 42 | 2611,42 | 62,177 | 20,309 | 420,14 | 3,061 |
| Aile(populasyon) | 198 | 10087,21 | 50,946 | 20,418 | 407,59 | 2,495 |
| Tekrar × aile(populasyon) | 396 | 8127,04 | 20,523 | 15,090 | 3125 | 1,360 |
| Hata | 3125 | 47155,54 | 15,090 |
Aile satırının beklenen KO'su \sigma^2_e+5{,}4976\,\sigma^2_{RF}+16{,}4927\,\sigma^2_F, populasyon satırınınki \sigma^2_e+5{,}3710\,\sigma^2_{RF}+16{,}1131\,\sigma^2_F+53{,}7103\,\sigma^2_{RP}+161{,}1309\,\sigma^2_P'dir. Aile testinin paydası 0{,}9806\,KO_{RF}+0{,}0194\,KO_e=20{,}418'dir: parsel katsayıları aile satırında 5,4976, parsel satırında 5,6062 olduğundan KO_{RF} tek başına biraz büyük kalır ve küçük bir artık payıyla düzeltilir.
Adım 3 — REML bileşenleri ve standart hatalar (boy). Fisher puanlaması 24 adımda yakınsar:
| Bileşen | Kestirim | SH (gözlenen bilgi) | Tip I kestirimi |
|---|---|---|---|
| Tekrar | 3,2516 | 3,3025 | 3,1738 |
| Populasyon | 7,5255 | 2,4970 | 7,3829 |
| Tekrar × populasyon | 0,7503 | 0,2462 | 0,7462 |
| Aile(populasyon) | 1,8701 | 0,3252 | 1,8831 |
| Tekrar × aile(populasyon) | 1,0065 | 0,2668 | 0,9691 |
| Hata | 15,0698 | 0,3801 | 15,0898 |
Adım 4 — Kalıtım dereceleri ve Q_{ST}. r=3, n=5{,}3619 (harmonik).
Delta yöntemiyle standart hatalar: \hat\sigma^2_A 1,3009; \hat h^2_i 0,0673; \hat h^2_f 0,0490; \hat Q_{ST} 0,0838. k=3 ile \hat h^2_i=0{,}3126 olur. Beklenen KO katsayılarıyla (r=3{,}0000, n=5{,}4976) \hat h^2_f=0{,}5995, \hat\sigma^2_{fm}=3{,}1193.
Adım 5 — Duncan. Varsayılan hata terimi populasyon testinin sentezlenmiş paydasıdır: KO 91,8728, sd=80{,}364 (Adım 3'teki F testinin paydasıyla aynı), harmonik \tilde n=171{,}911. R_2=q_{0{,}95}(2,\,80{,}364)\sqrt{91{,}8728/171{,}911}=2{,}0573; R_3=2{,}1647; R_{22}=2{,}5457. Sıralı ortalamalara uygulandığında 22 populasyon 11 harf grubuna ayrılır (P10: a; P21: ab; P18: abc; … P13: k). Bağımsız Python/scipy hesabı (test_duzeltme_371_orijin_dol_denemesi.py) 22 populasyonun hepsinde aynı grupları verir. karsilastirma_hatasi = artik ile hata KO'su 15,0898, sd=3125, R_2=0{,}8215, R_3=0{,}8650, R_{22}=1{,}0329 olur ve 22 populasyon 12 harf grubuna ayrılır (P10: a; P21: b; P18: bc; … P13: l); bu sonuç agricolae::duncan.test ile 22 populasyonun hepsinde aynı harfleri verir.
Adım 6 — Genetik korelasyon. Tip I, boy–kök boğazı çapı, ölçünlenmiş özelliklerle: toplam yönteminden \hat r_G=0{,}7457. İki değişkenli REML'de şablon \hat r_G=0{,}7447 verir (\operatorname{SH}_\delta=0{,}0701, \operatorname{SH}_{FM}=0{,}0511). Dengeli sınama verisinde aile kareler ve çarpımlar ortalamalarından \hat\sigma_{F(xy)}=0{,}4766, \hat r_G=0{,}9243 bulunur; şablonun Tip I sonucu aynıdır. Dengesiz veride iki değişkenli REML için bağımsız bir çözüm kurulmamıştır; bu kestirim yalnız Tip I değeriyle yakınlığı üzerinden denetlenmiştir.
Adım 7 — Tekrarsız özellik ve tip B. Tohum ağırlığı: \hat\sigma^2_P=27{,}741, \hat\sigma^2_F=37{,}350, \hat\sigma^2_e=155{,}468; n=6. \hat h^2_i=4\cdot37{,}350/192{,}817=0{,}7748 (SH 0,1155), \hat h^2_f=37{,}350/(37{,}350+155{,}468/6)=0{,}5904. Boy ile tip B: aile ortalamalarının populasyon içi kovaryansı 4,2545 (198 serbestlik derecesi); \hat r_B=4{,}2545/\sqrt{1{,}8701\cdot37{,}350}=0{,}5091, \operatorname{SH}_{FM}=0{,}0813.
83.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Dengeli, Tip I: σ²(tekrar) | 3,50279111 | 3,50279111 | 3,50279111 | 3,7e−15 | ✓ |
| Dengeli, Tip I: σ²(populasyon) | 6,18758278 | 6,18758278 | 6,18758278 | 3,4e−15 | ✓ |
| Dengeli, Tip I: σ²(tekrar × populasyon) | −0,20769389 | −0,20769389 | −0,20769389 | 2,0e−14 | ✓ |
| Dengeli, Tip I: σ²(aile(populasyon)) | 2,88820833 | 2,88820833 | 2,88820833 | 1,0e−14 | ✓ |
| Dengeli, Tip I: σ²(tekrar × aile(populasyon)) | 2,42325 | 2,42325 | 2,42325 | 1,0e−12 | ✓ |
| Dengeli, Tip I: σ²(hata) | 16,10405556 | 16,10405556 | 16,10405556 | 6,4e−13 | ✓ |
| Dengeli: KT(populasyon) | 2137,78322222 | 2137,78322222 | 2137,78322222 | 1,5e−13 | ✓ |
| Dengeli: KT(aile(populasyon)) | 1450,93333333 | 1450,93333333 | 1450,93333333 | 5,5e−15 | ✓ |
| Dengeli: KT(tekrar × aile(populasyon)) | 1238,25866667 | 1238,25866667 | 1238,25866667 | 3,9e−14 | ✓ |
| Dengeli: populasyon testinin payda KO'su | 56,30167778 | 56,30167778 | 56,30167778 | 1,4e−13 | ✓ |
| Dengeli: paydanın Satterthwaite sd'si | 14,88251662 | 14,88251662 | 14,88251662 | 1,5e−13 | ✓ |
| Dengeli: populasyon F | 7,59403025 | 7,59403025 | — | 2,9e−13 | ✓ |
| Dengeli: populasyon p | 0,00100768 | 0,00100768 | — | 9,2e−16 | ✓ |
| Dengeli, Tip I: h^2_i | 0,53946094 | 0,53946094 | 0,53946094 | 2,0e−13 | ✓ |
| Dengeli, Tip I: h^2_f | 0,57328892 | 0,57328892 | 0,57328892 | 3,9e−15 | ✓ |
| Dengeli, Tip I: Q_{ST} | 0,21122897 | 0,21122897 | 0,21122897 | 1,9e−15 | ✓ |
| Dengeli, Tip I: r_G (boy, kbc) | 0,92428424 | 0,92428424 | — | 2,0e−15 | ✓ |
| Dengeli, Tip I: aile kovaryansı (boy, kbc) | 0,47659922 | 0,47659922 | — | 1,4e−15 | ✓ |
| Tip III KT(tekrar) | 7829,07705794 | 7829,07705794 | 7829,07705794 | 2,0e−13 | ✓ |
| Tip III KT(populasyon) | 27255,48807819 | 27255,48807821 | 27255,48807821 | 6,0e−13 | ✓ |
| Tip III KT(tekrar × populasyon) | 2611,41585073 | 2611,41585073 | 2611,41585073 | 1,7e−12 | ✓ |
| Tip III KT(aile(populasyon)) | 10087,21178192 | 10087,21178192 | 10087,21178192 | 1,7e−13 | ✓ |
| Tip III KT(tekrar × aile(populasyon)) | 8127,03945474 | 8127,03945474 | 8127,03945474 | 4,8e−14 | ✓ |
| Hata KO | 15,08977123 | 15,08977123 | 15,08977123 | 4,2e−12 | ✓ |
| Beklenen KO katsayısı: aile satırı, σ²aile | 16,492662 | 16,492662 | — | 1,3e−15 | ✓ |
| Beklenen KO katsayısı: aile satırı, σ²tekrar×aile | 5,497554 | 5,497554 | — | 6,5e−16 | ✓ |
| Beklenen KO katsayısı: populasyon satırı, σ²pop | 161,13094785 | 161,13094785 | — | 1,8e−15 | ✓ |
| Beklenen KO katsayısı: populasyon satırı, σ²tekrar×pop | 53,71031595 | 53,71031595 | — | 2,0e−15 | ✓ |
| populasyon: payda KO | 91,87277554 | 91,87277554 | — | 1,1e−12 | ✓ |
| populasyon: payda sd (Satterthwaite) | 80,36418292 | 80,36418292 | — | 7,6e−13 | ✓ |
| populasyon: F | 14,12693126 | 14,12693126 | — | 5,0e−13 | ✓ |
| aile(populasyon): payda KO | 20,41750002 | 20,41750002 | — | 5,8e−14 | ✓ |
| aile(populasyon): payda sd (Satterthwaite) | 407,58520966 | 407,58520966 | — | 1,2e−13 | ✓ |
| aile(populasyon): F | 2,49518864 | 2,49518864 | — | 1,6e−13 | ✓ |
| REML: σ²(tekrar) | 3,25162559 | 3,25159904 | 3,25159814 | 8,4e−6 | ✗ |
| REML: σ²(populasyon) | 7,52553043 | 7,52552251 | 7,52552692 | 1,1e−6 | ✗ |
| REML: σ²(tekrar × populasyon) | 0,75031871 | 0,7503185 | 0,75031884 | 2,1e−7 | ✓ |
| REML: σ²(aile(populasyon)) | 1,87005485 | 1,87005618 | 1,87005666 | 9,7e−7 | ✓ |
| REML: σ²(tekrar × aile(populasyon)) | 1,00649155 | 1,00649125 | 1,0064915 | 3,0e−7 | ✓ |
| REML: σ²(hata) | 15,06977247 | 15,06977247 | 15,0697721 | 2,4e−8 | ✓ |
| REML: SH σ²(populasyon) (gözlenen bilgi) | 2,4970053 | 2,49700045 | — | 1,9e−6 | ✗ |
| REML: SH σ²(aile(populasyon)) (gözlenen bilgi) | 0,32523025 | 0,32523048 | — | 2,3e−7 | ✓ |
| REML: SH σ²(tekrar × aile(populasyon)) (gözlenen bilgi) | 0,26678245 | 0,26678241 | — | 4,2e−8 | ✓ |
| REML: SH σ²(hata) (gözlenen bilgi) | 0,38012784 | 0,38012784 | — | 9,2e−11 | ✓ |
| REML: σ²A | 7,48021938 | 7,48022472 | — | 7,1e−7 | ✓ |
| REML: SH σ²A | 1,300921 | 1,30092194 | — | 7,2e−7 | ✓ |
| REML: h^2_i | 0,41681079 | 0,41681107 | 0,41681116 | 3,7e−7 | ✓ |
| REML: SH h^2_i | 0,067261 | 0,06726103 | — | 3,8e−8 | ✓ |
| REML: h^2_f | 0,59510359 | 0,59510378 | — | 1,9e−7 | ✓ |
| REML: SH h^2_f | 0,04903554 | 0,04903553 | — | 1,1e−8 | ✓ |
| REML: Q_{ST} | 0,33467672 | 0,33467633 | — | 3,9e−7 | ✓ |
| REML: SH Q_{ST} | 0,08383259 | 0,08383249 | — | 1,1e−7 | ✓ |
| İğne boyu: σ²(tekrar × aile) (sınır) | 0 | 0 | — | 0 | ✓ |
| İğne boyu: h^2_i | 0,28552945 | 0,28552945 | — | 9,7e−10 | ✓ |
| İğne boyu: SH h^2_i | 0,04851929 | 0,04851929 | — | 1,3e−10 | ✓ |
| ML: σ²(populasyon) | 7,40681941 | 7,40682022 | — | 1,1e−7 | ✓ |
| ML: σ²(aile(populasyon)) | 1,86998443 | 1,86998486 | — | 2,3e−7 | ✓ |
| ML: SH σ²(aile(populasyon)) | 0,32522396 | 0,32522406 | — | 9,9e−8 | ✓ |
| Tip I: σ²(tekrar) | 3,17382683 | 3,17382683 | — | 1,2e−14 | ✓ |
| Tip I: σ²(populasyon) | 7,38285901 | 7,38285901 | — | 1,0e−14 | ✓ |
| Tip I: σ²(tekrar × populasyon) | 0,74615755 | 0,74615755 | — | 6,8e−14 | ✓ |
| Tip I: σ²(aile(populasyon)) | 1,88313747 | 1,88313747 | — | 7,6e−14 | ✓ |
| Tip I: σ²(tekrar × aile(populasyon)) | 0,96910895 | 0,96910895 | — | 1,1e−11 | ✓ |
| Tip I: σ²(hata) | 15,08977123 | 15,08977123 | — | 4,2e−12 | ✓ |
| Tip I KT(populasyon) | 28699,89618669 | 28699,89618669 | 28699,89618669 | 1,1e−14 | ✓ |
| Tip I KT(aile(populasyon)) | 10501,36631129 | 10501,36631129 | 10501,36631129 | 2,2e−14 | ✓ |
| Tip I: SH σ²(aile(populasyon)) | 0,32256732 | 0,32256732 | — | 4,0e−15 | ✓ |
| Tip I: h^2_i | 0,41982736 | 0,41982736 | — | 1,2e−12 | ✓ |
| Tip I: SH h^2_i | 0,06668601 | 0,06668601 | — | 1,8e−13 | ✓ |
| Tip I: r_G (boy, kbc) | 0,7456878 | 0,7456878 | — | 7,9e−14 | ✓ |
| Duncan: harf grubu aynı olan populasyon sayısı (22 populasyon) | 22 | 22 | 22 | 0 | ✓ |
| Populasyon ortalaması (P10) | 28,64705882 | 28,64705882 | 28,64705882 | 5,0e−16 | ✓ |
| Pearson r: aile ortalamaları (boy, kbc) | 0,54266943 | 0,54266943 | 0,54266943 | 2,2e−16 | ✓ |
| Pearson p: aile ortalamaları (boy, kbc) | 3,019320·10−18 | 3,019320·10−18 | — | 5,0e−33 | ✓ |
| Pearson r: parsel ortalamaları (boy, kbc) | 0,41307336 | 0,41307336 | 0,41307336 | 5,6e−16 | ✓ |
| k=3: h^2_i | 0,31260809 | 0,3126083 | — | 2,1e−7 | ✓ |
| Beklenen KO katsayılı h^2_f | 0,5995153 | 0,59951549 | — | 1,9e−7 | ✓ |
| σ²fm (beklenen KO katsayılı) | 3,11927793 | 3,11927916 | — | 4,0e−7 | ✓ |
| DK_A (k=3) | 9,82779294 | 9,82779645 | — | 3,6e−7 | ✓ |
| Tohum ağırlığı: σ²(aile(populasyon)) | 37,34963951 | 37,34964085 | — | 3,6e−8 | ✓ |
| Tohum ağırlığı: SH σ²(aile(populasyon)) | 6,45324502 | 6,45324528 | — | 3,9e−8 | ✓ |
| Tohum ağırlığı: h^2_i | 0,77481954 | 0,77481956 | — | 2,4e−8 | ✓ |
| Tohum ağırlığı: SH h^2_i | 0,11552261 | 0,11552261 | — | 2,8e−9 | ✓ |
| Tohum ağırlığı: h^2_f | 0,59040634 | 0,59040635 | — | 9,2e−9 | ✓ |
| Tip B: aile kovaryansı (boy, tohum ağırlığı) | 4,25450791 | 4,25450791 | — | 1,5e−15 | ✓ |
| Tip B: r_B (boy, tohum ağırlığı) | 0,5090717 | 0,50907151 | — | 1,9e−7 | ✓ |
| Tip B: SH (Falconer–Mackay) | 0,08125654 | 0,08125656 | — | 1,7e−8 | ✓ |
Ölçütü karşılayan: 84/87. Python: dengeli veride kapalı biçimli iç içe varyans analizi; dengesiz veride toplam-sıfır kodlu regresyonla tip III KT, sıralı QR ile tip I KT, Hartley senteziyle beklenen KO katsayıları, Fisher puanlamalı REML/ML ve gözlenen bilgi matrisi. R: lm/anova (tip I), lm.fit ile artık kareler farkı (tip III), agricolae::duncan.test, cor.test, glmmTMB (REML). ✗ işaretli REML satırlarında fark en iyileyicilerin yakınsama toleransındandır (σ²tekrar yalnız üç düzeyden kestirilir, olabilirlik bu yönde düzdür); Python ve R sütunları birbiriyle 10⁻⁶ içinde uyuşur.
83.7 Çıktıyı okuma
Örnek ayarın konsol metni (kısaltılmış) ve boy özelliğine ait satırlar:
Model: y = μ + tekrar + populasyon + tekrar × populasyon + aile(populasyon) + tekrar × aile(populasyon) + hata
Tekrar rastgele; populasyon, aile ve etkileşimleri rastgele. Kestirim: REML. σ²A = 4·σ²aile (yarım kardeş).
h²i = k·σ²aile/(σ²aile + σ²tekrar×aile + σ²e); h²f = σ²aile/(σ²aile + σ²tekrar×aile/r + σ²e/(n·r)); r ve n harmonik ortalamalar (tasarım özeti).
boy — hata terimi: populasyon testinin paydası 0,9973 KO(tekrar × populasyon) + 0,9770 KO(aile(populasyon))
− 0,9580 KO(tekrar × aile(populasyon)) − 0,0162 KO(hata) = 91,8728 (sd = 80,36; Satterthwaite); Duncan:
harmonik n = 171,9113; kritik aralıklar R(p), p = 2…22: 2,0573; 2,1647; …

Notlar:
- Sınırda (σ² = 0) kestirilen bileşenler — standart hatası verilmez ve bilgi matrisinden çıkarılır: igne_boyu: tekrar × aile(populasyon).

Tasarım özeti (r: aile başına tekrar, n: parsel başına fidan; harmonik ortalamalar)
 ozellik     n  populasyon  aile  tekrar  parsel  r_harmonik  n_harmonik   ortalama
     boy  3785          22   220       3     660           3    5.361858  24.100819

Varyans bileşenleri (REML; SH: asimptotik, gözlenen bilgi matrisinden)
 ozellik                    bilesen    varyans        SH      yuzde
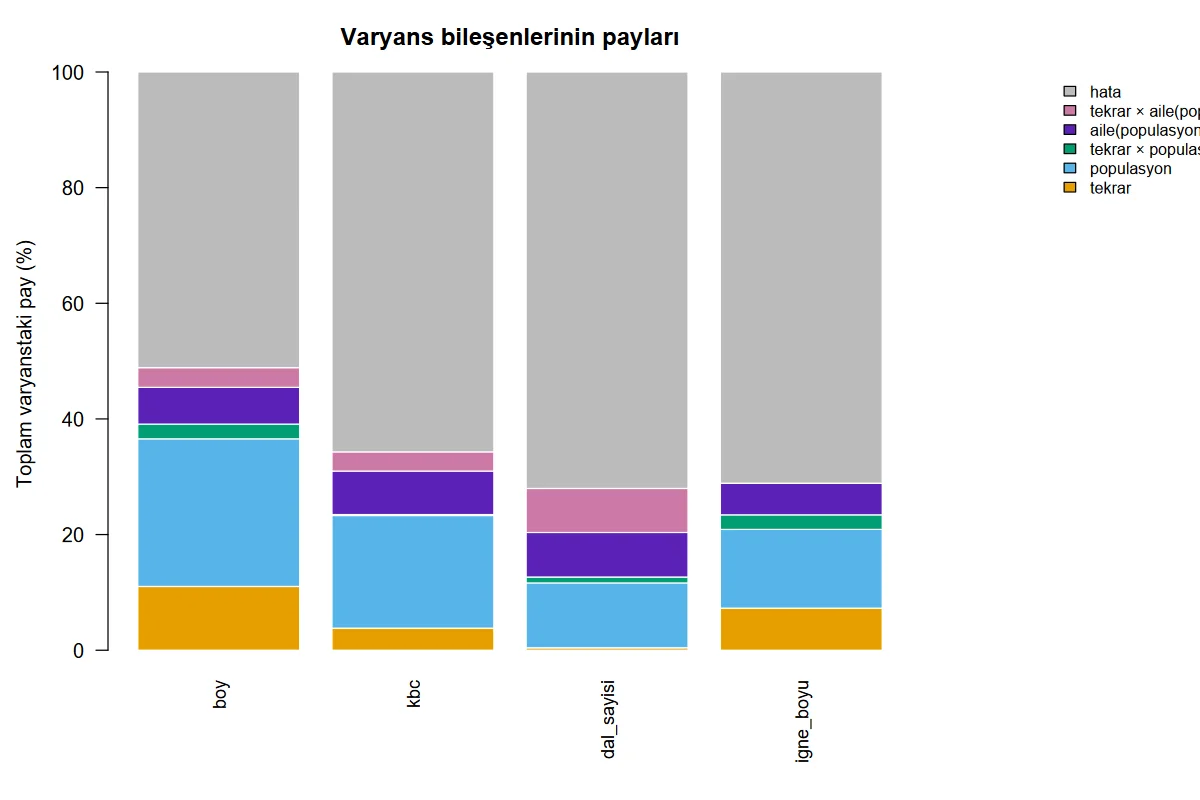
     boy                     tekrar   3.251626  3.302541  11.032260
     boy                 populasyon   7.525530  2.497005  25.532955
     boy        tekrar × populasyon   0.750319  0.246220   2.545715
     boy           aile(populasyon)   1.870055  0.325230   6.344805
     boy  tekrar × aile(populasyon)   1.006492  0.266782   3.414869
     boy                       hata  15.069772  0.380128  51.129395

Kalıtım dereceleri ve populasyonlar arası farklılaşma (SH: delta yöntemi)
 ozellik                                       olcut     deger        SH
     boy   σ²A = 4·σ²aile (eklemeli genetik varyans)  7.480219  1.300921
     boy  h²i: bireysel dar anlamda kalıtım derecesi  0.416811  0.067261
     boy       h²f: aile ortalaması kalıtım derecesi  0.595104  0.049036
     boy                  Qst = σ²pop/(σ²pop + 2σ²A)  0.334677  0.083833

Genetik korelasyon (aile bileşeni; iki değişkenli REML, her terimde 2×2 yapılandırılmamış kovaryans)
 ozellik_1   ozellik_2     n  kov_aile       r_G
       boy         kbc  3785  0.189202  0.744749
       boy  dal_sayisi  3785  0.401492  0.551142
       boy   igne_boyu  3710  0.382472  0.164018
 …
| Tablo | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Tasarım özeti | Özellik başına gözlem, populasyon, aile, tekrar, parsel sayıları; r ve n harmonik ortalamaları; genel ortalama | h^2_f'nin bölenleri buradadır. Tekrarsız özellikte tekrar ve parsel boştur. |
| Varyans bileşenleri | Bileşen, SH, bütün bileşenlerin toplamındaki yüzde | Yüzde tekrar varyansını da içerir; kalıtım derecesinin paydası değildir. Sınırdaki bileşenin SH'si boştur. |
| İç içe varyans analizi | Tip III KT, KO, F, sentezlenmiş paydanın yazılı biçimi, payda KO ve sd, p | "Genel" satırı düzeltilmiş toplamdır; tip III toplamları ona toplanmaz. |
| Tip III beklenen KO | Her satırın katsayıları ve yazılı beklenen değeri | Sentezlenmiş paydanın dayanağı. |
| Tip I KT ve beklenen KO | Yalnız Tip I yönteminde | Bileşen kestiriminin dayanağı. |
| Kalıtım dereceleri | \sigma^2_A, h^2_i, h^2_f, Q_{ST} ve delta SH | h^2_i ve \sigma^2_A k'ye bağlıdır; konsolun ikinci satırı k'yi yazar. |
| Populasyon ortalamaları | n, ortalama, SS, harf grubu | Aynı harfi paylaşan populasyonlar seçilen yönteme göre farklı değildir; hata terimi konsolda yazılıdır. |
| Aile ortalamaları | Populasyon × aile ortalamaları (220 satır) | Ham ortalamalar; aile seçimi için başlangıç. |
| Fenotipik korelasyonlar | Aile ve parsel ortalamaları arasında Pearson r, n, p | Aile ortalaması korelasyonu genetik korelasyonun kaba bir yaklaşımıdır. |
| Genetik korelasyon | Çift, gözlem sayısı, aile kovaryansı (özgün ölçekte), r_G; istenirse iki SH | \lvert r_G\rvert 1'e yakınsa iki özellik aynı genlerle denetleniyor demektir. |
| Şekil | Bileşenlerin toplam varyanstaki payları, özellik başına yığılmış çubuk | Populasyon ve aile payları özellikler arasında karşılaştırılır. |
Şekil 83.1. Şablonun çizdiği varyans bileşeni payları (örnek veri, dört özellik). Aile(populasyon) payı mor, populasyon payı mavi dilimdir.
Rapor cümlesi:
Yirmi iki populasyondan 220 açık tozlaşmış ailenin üç tekrarlı fidanlık denemesinde (3785 fidan) fidan boyunun varyans bileşenleri REML ile kestirildi. Populasyonlar arasındaki fark anlamlıydı (F_{21;\,80{,}4}=14{,}13; p<0{,}001) ve toplam varyansın %25,5'ini oluşturdu; populasyon içi aileler arası fark da anlamlıydı (F_{198;\,407{,}6}=2{,}50; p<0{,}001). Yarım kardeş varsayımıyla bireysel kalıtım derecesi 0,42 (SH = 0,07), aile ortalaması kalıtım derecesi 0,60 (SH = 0,05), Q_{ST} 0,33 (SH = 0,08) bulundu. Boy ile kök boğazı çapı arasındaki genetik korelasyon 0,74 idi.
83.8 Sık hatalar ve tuzaklar
- Yarım kardeş varsayımını sorgulamadan k=4 kullanmak. Açık tozlaşmış ailelerde k=4 eklemeli varyansı ve h^2_i'yi büyütür; örnekte k=3 ile 0,42 yerine 0,31 çıkar. Hangi k'nin kullanıldığı raporda yazılır.
- Populasyon varyansını kalıtım derecesinin paydasında beklemek. Şablonun h^2'leri populasyon içidir. Başka bir kaynakla karşılaştırırken paydanın tanımı denetlenir; bütün bileşenlerin toplamına bölünmüş bir "kalıtım" bu değerlerden küçüktür.
- Bileşen tablosundaki yüzdeyi kalıtım derecesi sanmak.
yuzdesütunu tekrar ve populasyon dahil bütün bileşenlerin toplamına göredir; aile satırındaki %6,3 ne h^2_i ne de h^2_f'dir. - Hata terimini değiştirdiğini unutmak. Varsayılan hata terimi populasyon F testinin sentezlenmiş paydasıdır;
karsilastirma_hatasi = artikseçilirse harf grupları yalnız artığa dayanır ve aynı çıktıdaki populasyon testiyle çelişebilir (örnekte 12 grup, varsayılanda 11).aileseçeneği de sentezlenmiş paydadan küçüktür (tekrar × populasyon bileşenini içermez). Konsol hangi terimin kullanıldığını yazar. - Tekrarsız özellikleri tekrarlı listeye koymak. Tohum özellikleri
ozellikleralanına yazılırsa tekrar sütunu boş olduğundan hiçbir satır kalmaz ve özellik "10'dan az tam gözlem" notuyla atlanır. Bu özelliklertekrarsiz_ozellikleralanına girilir. - Tip B seçeneğini karışık çiftlerle kullanmak. Aynı bireylerde ölçülen çiftlerde r_B boş kalır (yanlı olurdu ve 1'i aşabilirdi); Notlar'daki liste okunur ve bu çiftler için
ayni_bireyseçeneği kullanılır. - Sınırdaki bileşeni "etki yok" diye raporlamak. REML'de 0, kestirimin parametre uzayının sınırına dayandığını gösterir; aynı veride Tip I negatif bir değer verir. İkisi de "bileşen küçük ve bu veriden ayırt edilemiyor" anlamına gelir. Standart hata verilmez.
- Negatif katsayılı paydanın serbestlik derecesine güvenmek. Populasyon testinde payda bir çıkarma içerir; Satterthwaite yaklaşımı bu durumda kabadır. p değeri sınıra yakınsa karar tek başına bu teste bırakılmaz.
- Dört özellik ve altı çift için uzun süreyi beklememek. İki değişkenli REML her çift için ayrı en iyileme yapar; örnek ayar yaklaşık 2,5 dakika sürer. Yalnız bileşenler gerekiyorsa
genetik_korelasyonkapatılır. - \alpha=0{,}5 girmek. Form 0,5'e izin verir, şablon \alpha<0{,}5 ister ve çalıştırma durur.
- Boş hücreli veride tip III testlerini tam saymak. Bir aile bir tekrarda hiç yoksa tip III hipotezleri tahmin edilebilir kısımla sınırlanır; şablon not yazar. REML bileşenleri bu durumdan etkilenmez.
83.9 Uzman soruları
S1. Hangi kalıtım derecesi tanımları kullanılıyor ve akrabalık çarpanı kodda nerede?
İki tanım: populasyon içi bireysel dar anlamda h^2_i=k\sigma^2_F/(\sigma^2_F+\sigma^2_{RF}+\sigma^2_e) ve aile ortalaması h^2_f=\sigma^2_F/(\sigma^2_F+\sigma^2_{RF}/r+\sigma^2_e/(nr)) (satır 735–746). Çarpan 164. satırda belirlenir: switch(akr, yarim_kardes = 4, tam_kardes = 2, squillace = 3, elle = …); yalnız \sigma^2_A, h^2_i ve Q_{ST}'ye girer, h^2_f'de yoktur. Populasyon, tekrar ve tekrar × populasyon bileşenleri hiçbir paydada yer almaz.
S2. Standart hatalar hangi bilgi matrisinden, hangi yöntemle?
REML ve ML'de gözlenen bilgi matrisinin tersinden (391–406); Tip I'de kareler ortalamalarının 2KO^2/(sd+2) örnekleme varyansından (430). Oranlar için delta yöntemi (713–748). Genetik korelasyon için iki ayrı sütun: iki değişkenli modelin sayısal Hessian'ından delta yöntemi ve Falconer–Mackay yaklaşık formülü. Başlıklar her birini adıyla yazar. Bootstrap ya da profil olabilirlik aralığı yoktur.
S3. h^2_f için harmonik ortalama mı, beklenen KO katsayıları mı doğru?
İkisi de dengesiz veride yaklaşımdır. Harmonik ortalama, aile ortalamalarının hata varyanslarının ortalamasını doğru verir ve bileşenler REML ile kestirildiğinde doğal seçimdir. Beklenen KO katsayıları h^2_f=1-KO_{\text{hata}}/KO_F biçimindeki klasik varyans analizi tanımıyla tutarlıdır. Örnek veride fark küçüktür: 0,5951 ve 0,5995.
S4. İki değişkenli REML ile toplam yöntemi neden farklı sonuç veriyor?
Dengeli veride ve sınırda bileşen yokken iki yöntem aynı kovaryansı verir. Dengesiz veride iki değişkenli model iki özelliğin bilgisini birlikte kullanır ve her terimin kovaryans matrisini pozitif yarı tanımlı tutar; toplam yöntemi üç ayrı tek değişkenli kestirimin farkıdır. Örnekte boy–kök boğazı çapı için 0,7447 (iki değişkenli REML) ve 0,7457 (Tip I, toplam yöntemi) bulunur.
S5. Delta ve Falconer–Mackay standart hataları neden bu kadar farklı olabiliyor?
Falconer–Mackay formülü dengeli bir yarım kardeş tasarımı için türetilmiş yaklaşık bir ifadedir ve yalnız iki kalıtım derecesinin göreli hatasına bakar; populasyon, tekrar ve parsel terimlerinin kovaryanslarını hesaba katmaz. Delta yöntemi iki değişkenli modelin kendi bilgi matrisini kullanır. Örnekte 0,070 (delta) ve 0,051 (Falconer–Mackay). Model tabanlı olan delta değeridir; öteki, eski yayınlarla karşılaştırma içindir.
S6. Duncan testi neden hâlâ varsayılan?
Orman ağacı orijin denemelerinin yayın geleneğinde ortalama ayırma tabloları çoğunlukla Duncan harfleriyle verilir; şablon bu tabloları yeniden üretebilmek için varsayılanı böyle seçer, hata terimini ise populasyon F testinin paydasından alır. Duncan'ın deney düzeyinde hata oranı populasyon sayısı arttıkça büyür (1-(1-\alpha)^{p-1} korunma düzeyi); 22 populasyonda en geniş aralık için koruma yalnız 0,34'tür. Deney düzeyinde hata denetimi isteniyorsa Tukey–Kramer seçilir.
S7. Satır sırası ya da düzey adları sonucu değiştirir mi?
Kareler toplamları, beklenen KO katsayıları, ortalamalar ve harf grupları sıradan bağımsızdır; altı populasyonluk alt kümenin satırları karıştırıldığında bu tablolar birebir aynı kaldı. REML bileşenleri altıncı, iki değişkenli REML'den gelen r_G altıncı anlamlı basamakta değişti (yinelemeli en iyileme). Tip I'de modeldeki terim sırası sabittir (tekrar, populasyon, etkileşim, aile, parsel); sütunların formdaki sırası etkilemez.
S8. REML bileşenleri başka bir çözücüyle kaçıncı basamağa kadar tutar?
Aile, parsel ve hata bileşenleri altı anlamlı basamakta tutar. Tekrar bileşeni yalnız üç düzeyden kestirilir; olabilirlik bu yönde çok düzdür ve iki bağımsız çözüm (Fisher puanlaması ve glmmTMB) birbiriyle 3,25160'ta buluşurken şablon 3,25163 verir. Fark standart hatanın (3,30) milyonda biri düzeyindedir ve raporlanan hiçbir büyüklüğü etkilemez; h^2_i altı ondalık basamakta aynıdır.
S9. Q_{ST}'nin standart hatası neden bazen "—"?
Populasyon bileşeni sınırdaysa (REML/ML'de 0, Tip I'de sıfır ya da negatif) Q_{ST}=0'dır ve delta yöntemi sınırdaki bileşeni sabit saydığından türev vektörü boş kalır. Şablon tabloda tire gösterir ve nedenini Notlar'a yazar (752–760). Dengeli sınama verisinde dal sayısı özelliği bu durumdadır.
83.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Burdon, R. D. (1977). Genetic correlation as a concept for studying genotype-environment interaction in forest tree breeding. Silvae Genetica, 26(5–6), 168–175.
- Duncan, D. B. (1955). Multiple range and multiple F tests. Biometrics, 11(1), 1–42. https://doi.org/10.2307/3001478
- Falconer, D. S., & Mackay, T. F. C. (1996). Introduction to quantitative genetics (4th ed.). Longman.
- Goodnight, J. H. (1980). Tests of hypotheses in fixed effects linear models. Communications in Statistics – Theory and Methods, 9(2), 167–180. https://doi.org/10.1080/03610928008827869
- Hartley, H. O. (1967). Expectations, variances and covariances of ANOVA mean squares by "synthesis". Biometrics, 23(1), 105–114. https://doi.org/10.2307/2528284
- Henderson, C. R. (1953). Estimation of variance and covariance components. Biometrics, 9(2), 226–252. https://doi.org/10.2307/3001853
- Hill, W. G., & Thompson, R. (1978). Probabilities of non-positive definite between-group or genetic covariance matrices. Biometrics, 34(3), 429–439. https://doi.org/10.2307/2530605
- Holland, J. B. (2006). Estimating genotypic correlations and their standard errors using multivariate restricted maximum likelihood estimation with SAS Proc MIXED. Crop Science, 46(2), 642–654. https://doi.org/10.2135/cropsci2005.0191
- Holland, J. B., Nyquist, W. E., & Cervantes-Martínez, C. T. (2003). Estimating and interpreting heritability for plant breeding: An update. Plant Breeding Reviews, 22, 9–112. https://doi.org/10.1002/9780470650202.ch2
- Houle, D. (1992). Comparing evolvability and variability of quantitative traits. Genetics, 130(1), 195–204. https://doi.org/10.1093/genetics/130.1.195
- Kramer, C. Y. (1956). Extension of multiple range tests to group means with unequal numbers of replications. Biometrics, 12(3), 307–310. https://doi.org/10.2307/3001469
- Robertson, A. (1959). The sampling variance of the genetic correlation coefficient. Biometrics, 15(3), 469–485. https://doi.org/10.2307/2527750
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Searle, S. R., Casella, G., & McCulloch, C. E. (1992). Variance components. Wiley. https://doi.org/10.1002/9780470316856
- Spitze, K. (1993). Population structure in Daphnia obtusa: Quantitative genetic and allozymic variation. Genetics, 135(2), 367–374. https://doi.org/10.1093/genetics/135.2.367
- Squillace, A. E. (1974). Average genetic correlations among offspring from open-pollinated forest trees. Silvae Genetica, 23(5), 149–156.
- White, T. L., Adams, W. T., & Neale, D. B. (2007). Forest genetics. CABI. https://doi.org/10.1079/9781845932855.0000