18. Faktör analitik (FA) kovaryans yapılı karma model: çok çevreli denemeler, genotip × çevre
Şablon kimliği: fa_karma_model · Kategori: karma model · Dil: R · Dosya: pro/sablonlar/karma_model/fa_karma_model.R (satır 1–373; üstbilgi 1–77) · Örnek veri: _ornek/fa_karma_model.csv · Paketler: glmmTMB 1.1.15.2
18.1 Ne işe yarar
Şablon, aynı genotiplerin birçok çevrede (lokasyon × yıl) denendiği verilerde genotip etkilerinin çevreler arasındaki kovaryansını az sayıda ortak faktörle kestirir. Cevapladığı soru şudur: "Genotiplerin sıralaması çevreden çevreye ne kadar değişiyor, bu değişim birkaç gizil eksenle özetlenebilir mi, ve hangi genotipler hem yüksek hem kararlı?"
- y_{ijr}: i. genotipin j. çevredeki r. gözlemi; i=1,\dots,g, j=1,\dots,q.
- \mu_j: çevre ortalaması (sabit etki). u_{ij}: genotipin o çevredeki rastgele etkisi (genotip ana etkisi ile genotip × çevre etkileşiminin toplamı).
- \mathbf G: bir genotipin q çevredeki etkilerinin kovaryans matrisi; köşegeni çevreye özgü genetik varyanslar, köşegen dışı öğeleri çevreler arası genetik kovaryanslardır.
- \boldsymbol\Lambda: q\times k yük matrisi (k ortak faktör); \boldsymbol\Psi=\operatorname{diag}(\psi_1,\dots,\psi_q): çevreye özgü (özgül) varyanslar. Eşdeğer yazım: u_{ij}=\sum_{m=1}^{k}\lambda_{jm}f_{im}+\delta_{ij}, f_{im}\sim N(0{,}1), \delta_{ij}\sim N(0,\psi_j).
- \sigma^2: artık varyansı; istenirse çevreye özgü (\sigma_j^2).
Yapısız bir \mathbf G için q(q+1)/2 parametre gerekir (15 çevrede 120). Faktör analitik (FA) yapı aynı matrisi qk-k(k-1)/2+q parametreyle yaklaşıklar (15 çevre, iki faktörde 44) ve çoğu denemede yapısız matrisin kestirilemediği durumlarda da çalışır (Smith ve ark., 2001).
Şablon şunları verir: köşegen ve FA1…FAk modellerinin karşılaştırması, çevre başına genetik varyans ve ortak varyans payı, temel eksenlere döndürülmüş yükler, faktörlerin açıkladığı genetik varyans, çevreler arası genetik korelasyon matrisi, genotip × çevre tahminleri (BLUP), faktör skorları ve iki seçim ölçütü: genel performans (OP) ile kararlılık (RMSD) (Smith ve Cullis, 2018).
Ne zaman kullanılır? Çok çevreli çeşit denemelerinde; veri dengesizse (her genotip her çevrede yoksa); çevre sayısı yapısız kovaryans için fazlaysa; çevreler arası genetik korelasyonlar ve çevreye özgü tahminler isteniyorsa.
Ne zaman kullanılmaz?
- Üçten az çevre ya da beşten az genotip varsa: şablon durur (18.2). İki çevrede çevreler arası tek korelasyon için
cok_yanitli_karma(Bölüm 17; çevreler yanıt olarak) ya da temel programdaki LMM (Doğrusal Karma Modeller) kullanılır. - Veri dengeliyse ve genotipler sabit etki sayılacaksa (az sayıda tescil adayı, sıralama değil karşılaştırma):
lokasyon_yil_tbdşablonu ve temel programın Stabilite (G×E) grubundaki AMMI ve GGE biplot çözümlemeleri. - Her çevrenin kendi deneme deseni (satır–sütun, eksik blok) ve mekânsal eğilimi modellenecekse: şablon çevre içinde yalnız blok rastgele etkisi alır; mekânsal artık yapısı için
lme_uzamsal_korelasyontek çevrede kullanılır, çok çevreli mekânsal FA modeli şablon kodunun düzenlenmesini gerektirir. - Genotipler arası akrabalık (soy ağacı, genomik ilişki matrisi) hesaba katılacaksa: şablon genotipleri bağımsız sayar; genetik kategorisindeki şablonlara bakılır.
Temel programla ilişki. Temel programın karma model analizleri genotip × çevre etkisine tek bir varyans (bileşik simetri) verir: bütün çevre çiftlerinde aynı genetik korelasyon ve bütün çevrelerde aynı genetik varyans varsayılır. AMMI ve GGE biplot aynı gizil eksen düşüncesini sabit etkili, dengeli veri gerektiren biçimde uygular. FA karma modeli bu ikisinin birleşimidir: çarpımsal terimler rastgeledir, veri dengesiz olabilir ve tahminler büzülmüş (BLUP) değerlerdir (Piepho, 1997).
18.2 Şablonun girdileri
Form, üstbilgideki on [[param]] bloğundan kurulur (fa_karma_model.R:10–76).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt (verim, kalite vb.) · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Bağımlı değişken (108–111, 133). |
Genotip (çeşit, hat) · genotip |
kategorik sütun · Değişkenler | ilk uygun sütun | herhangi bir sütun | Rastgele etkinin gruplaması (112). |
Çevre (lokasyon × yıl) · cevre |
kategorik sütun · Değişkenler | ilk uygun sütun | herhangi bir sütun | Sabit çevre ortalamaları ve \mathbf G'nin boyutu (113–114). |
Blok (çevre içinde; isteğe bağlı) · blok |
kategorik sütun · Değişkenler | boş | sütun ya da boş | Verilirse (1 | çevre:blok) rastgele etkisi (102, 131, 138). |
Faktör sayısı (k) · k |
tamsayı · Model | 2 | 1–6 | rr(…, d = k) (118–123, 142). |
Artık varyansı · artik |
seçim · Model | homojen |
homojen, cevre |
dispformula = ~1 ya da ~0 + çevre (135). |
Kestirim yöntemi · yontem |
seçim · Model | REML |
REML, ML |
glmmTMB(REML = …) (134, 145). |
Köşegen ve FA1…FAk modellerini karşılaştır · karsilastir |
onay · Seçenekler | açık | açık / kapalı | k+1 modelin tümü kurulur (222–239). |
Grafikte adı yazılacak en iyi genotip sayısı · gosterilecek |
tamsayı · Çıktı | 10 | 1–100 | OP–kararlılık grafiğindeki etiketler (347–355). |
En çok optimizasyon yinelemesi · maks_yineleme |
tamsayı · Gelişmiş | 1000 | 50–100000 | nlminb için hem iter.max hem eval.max (136). |
Ek başlangıç sayısı · ek_baslangic |
tamsayı · Gelişmiş | 0 | 0–10 | 0 = tek başlangıç. ≥ 1: Hessian'ı pozitif tanımlı olmayan her model, incelt içinde (153–165) bu sayıda belirlenimci sarsılmış başlangıçtan (BFGS, iki geçiş) yeniden eniyilenir; en düşük -2\ell alınır (137, 166–180). |
Örnek ayar (ornek_param, satır 9): y = y, genotip = Name, cevre = Env, k = 2; öteki alanlar varsayılandadır.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| glmmTMB kurulu değil | "… gerekli R paketleri kurulu değil: …" | 79–88 |
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 92 |
| Yanıt, genotip, çevre, blok aynı sütunu paylaşıyor | "… farklı sütunlar olmalı." | 95 |
| Yanıt sayısal değil | "Yanıt ('…') sayısal olmalı." | 99 |
| Eksiksiz satır 20'den az | "Eksiksiz en az 20 satır gerekli." | 100 |
| Yanıtta sonlu olmayan değer / yanıt sabit | "Yanıtta sonlu olmayan değer var." / "Yanıt sabit; model kurulamaz." | 101–102 |
| 3'ten az çevre / 5'ten az genotip | "En az 3 çevre gerekli." / "En az 5 genotip gerekli." | 107–108 |
| k tanımlanabilir en büyük değerden büyük | "%d çevre ile en çok %d faktör tanımlanabilir (k = %d verildi)." | 110–113 |
| k\ge genotip sayısı | "Faktör sayısı genotip sayısından küçük olmalı." | 114 |
| Bir çevrede 3'ten az gözlem | "Şu çevrelerde 3'ten az gözlem var: …" | 115–117 |
| Birden çok çevrede bulunan genotip 3'ten az | "Çevreler arası kovaryans için en az 3 genotip birden çok çevrede bulunmalı." | 118–121 |
| Model kurulamadı | "Model kurulamadı (FA…): …" | 135–137 |
| Olabilirlik sonlu değil | "… model yakınsamadı. Daha az faktör deneyin." | 172–173 |
Tanımlanabilirlik sınırı (satır 119–120): FA parametre sayısı yapısız matrisinkini aşmamalıdır, qk-k(k-1)/2+q\le q(q+1)/2. Bu koşul 3 ve 4 çevrede en çok 1, 5 çevrede 2, 6 çevrede 3, 15 çevrede 10 faktöre izin verir; form ayrıca k\le6 ile sınırlar.
Eksik değer: yanıt, genotip, çevre ya da blokta eksik olan satır liste bazında atılır ve atılan satır sayısı not olarak yazılır (107, 132). Uyarılar (durdurmaz): Hessian pozitif tanımlı değil (286; "Model uyumu" tablosunda yakınsama "doğrulanamadı" yazılır), eniyileyici yakınsamadı (311), glmmTMB'nin öteki kestirim uyarıları (312–313), BLUP ayrıştırması uydurulmuş değerleri yeniden üretmedi (277–279).
18.3 Örnek veri
Dosya: _ornek/fa_karma_model.csv. sommer ve enhancer paketlerindeki DT_h2 patates denemesi (Covarrubias-Pazaran, 2016): 41 patates hattı, 5 lokasyon (CA, FL, MI, MO, NY) × 3 yıl (2011–2013) = 15 çevre, her çevrede 2 blok. 872 satır, eksik değer yok.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
y |
Yanıt | sayısal | Ortalama 11,607; SS 4,707; 2–31. |
Name |
Genotip | kategorik (41 düzey) | Hat adı; genotip başına 6–15 çevre (ortanca 10). |
Env |
Çevre | kategorik (15 düzey) | CA.2011, …, NY.2013; çevre başına 36–78 gözlem. |
Block |
(isteğe bağlı) Blok | kategorik (30 düzey) | Çevre içinde 2 blok; kodlar çevreyle birlikte benzersiz (CA.2011.1). |
Loc, Year |
kullanılmaz | kategorik, sayısal | Lokasyon ve yıl. |
Veri dengesizdir: 41 × 15 = 615 genotip–çevre hücresinin 448'i doludur (%73); dolu hücrelerin 421'inde 2, 26'sında 1, birinde 4 gözlem vardır. Dengesizlik, AMMI gibi iki yönlü tablo yöntemlerini doğrudan uygulanamaz kılar; karma model boş hücreleri öteki çevrelerdeki bilgiyle tahmin eder.
Çevre düzeylerinin sırası (verideki ilk görülme; Bölüm 1.3) CA.2011, CA.2012, CA.2013, FL.2011, …, NY.2013'tür ve bütün tabloların satır/sütun sırasını belirler. Kestirimler düzey sırasına bağlı değildir: döndürülmüş yükler, özdeğerler ve skorlar sıralama değişse de aynı kalır (18.4.3).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar (FA2, REML, ortak artık); (2) k = 1; (3) k = 3; (4) yontem = ML; (5) k = 1, artik = cevre; (6) blok = Block; (7) k = 6.
18.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) eksik satırları at, genotip ve çevreyi faktör yap, k'yi denetle; (2) FAk modelini glmmTMB ile kestir; (3) istenirse köşegen ve daha az faktörlü modelleri de kur, karşılaştırma tablosunu yaz; (4) \boldsymbol\Lambda\boldsymbol\Lambda^{\top} ve \boldsymbol\Psi'den \mathbf G'yi kur, yükleri temel eksenlere döndür; (5) genetik korelasyon matrisi; (6) BLUP'ları ortak ve özgül kısımlara ayır, faktör skorlarını, OP ve RMSD'yi hesapla; (7) tablolar ve dört şekil.
18.4.1 Model ve olabilirlik
Bir genotipin gözlemleri için \mathbf Z_i, gözlemleri çevrelere eşleyen gösterge matrisi olsun. Genotipler bağımsızdır:
- \bigoplus: blok köşegen birleşim; her genotipin bloğu, o genotipin gözlendiği çevrelere karşılık gelen \mathbf G alt matrisidir (yinelenen gözlemlerde satırlar yinelenir).
- \mathbf X: çevre gösterge matrisi (N\times q); \hat{\boldsymbol\mu}=(\mathbf X^{\top}\mathbf V^{-1}\mathbf X)^{-1}\mathbf X^{\top}\mathbf V^{-1}\mathbf y çevre ortalamalarının genelleştirilmiş en küçük kareler kestirimidir (tablodaki
ortalama). - ML'de ikinci terim yoktur ve sabit N\log2\pi'dir. Çıktıdaki "−2 log L" bu ifadenin değeridir (
2 * m$fit$objective, satır 187). - Blok seçilmişse \mathbf V'ye \sigma_b^2 çarpı "aynı çevre ve blok" gösterge matrisi eklenir; çevreye özgü artıkta \sigma^2\mathbf I yerine \operatorname{diag}(\sigma_{j(n)}^2) gelir.
Koddaki tercih
Model tek bir glmmTMB (Brooks ve ark., 2017) çağrısıdır (satır 142–145): .y ~ 0 + .env + rr(0 + .env | .gen, d = k) + diag(0 + .env | .gen). rr() terimi düşük ranklı \boldsymbol\Lambda\boldsymbol\Lambda^{\top} kısmını, diag() terimi \boldsymbol\Psi'yi verir; ikisinin toplamı FA yapısıdır (McGillycuddy ve ark., 2025). Köşegen model (k=0) rr() terimi atılarak kurulur. Eniyileyici nlminb'dir; yineleme ve işlev değerlendirme sınırı formdaki tek değerden gelir (136).
Neden yapısız ya da bileşik simetri değil?
Bileşik simetri (tek genotip varyansı + tek etkileşim varyansı) bütün çevre çiftlerine aynı korelasyonu verir; örnek veride kestirilen genetik korelasyonlar 0,02 ile 0,99 arasında değişir, bu varsayım tutmaz. Yapısız matris en esnek seçenektir, ama 15 çevrede 120 parametre 41 genotipten kestirilemez. FA yapısı arada durur: birkaç gizil eksen ("genotipler çevrelere nasıl farklı tepki veriyor?") kovaryansın büyük bölümünü taşır, \boldsymbol\Psi her çevrenin kendine özgü kalanını tutar.
18.4.2 Parametre sayısı ve model karşılaştırması
- k(k-1)/2: yüklerin döndürme serbestliği. \boldsymbol\Lambda\boldsymbol\Lambda^{\top} herhangi bir dik döndürmede aynı kaldığından k\times k döndürme matrisinin serbest öğe sayısı kadar yük tanımsızdır; kestirimde yük matrisinin üst üçgeni sıfıra bağlanır.
- REML'de m=m_k (yalnız kovaryans parametreleri) ve n^{*}=N-q; ML'de m=m_k+q (sabit etkiler eklenir) ve n^{*}=N (satır 184–191).
delta_AIC: tablodaki en küçük AIC'den fark.
Olabilirlik oranı testi burada kesin değildir
FAk modelleri iç içedir, ama daha küçük model büyük modelin parametre uzayının sınırındadır (yükler sıfır) ve özgül varyanslar sıfır sınırına yapışabilir. Böyle durumlarda -2\ell farkının dağılımı \chi^2 değildir (Self ve Liang, 1987). Şablon bu notu çıktıya yazar ve seçim için AIC/BIC önerir (satır 237–238). REML ölçütüyle yalnız aynı sabit etkili modeller karşılaştırılır; burada bütün modellerin sabit etkisi aynıdır (çevre ortalamaları).
18.4.3 Döndürme: temel eksenler
Kestirilen ortak kısım \mathbf C=\hat{\boldsymbol\Lambda}\hat{\boldsymbol\Lambda}^{\top} öz ayrışımla yeniden yazılır:
- d_1\ge\dots\ge d_k: \mathbf C'nin sıfırdan farklı özdeğerleri; \mathbf U: karşılık gelen özvektörler.
- \boldsymbol\Lambda^{*}: döndürülmüş yükler. \boldsymbol\Lambda^{*\top}\boldsymbol\Lambda^{*}=\operatorname{diag}(d_m) köşegendir: birinci faktör ortak genetik varyansın olabilecek en büyük bölümünü, ikincisi kalanın en büyüğünü taşır.
- \operatorname{iz}(\mathbf G)=\sum_j G_{jj}: çevreler üzerinden toplam genetik varyans. Özgül pay 100\sum_j\psi_j/\operatorname{iz}(\mathbf G)'dir; yüzdelerin toplamı 100'dür.
- Çevre başına ortak varyans yüzdesi 100\,(\boldsymbol\Lambda^{*}\boldsymbol\Lambda^{*\top})_{jj}/G_{jj}'dir (tablodaki
ortak_yuzde).
Koddaki tercih
Her yük sütununun işareti, sütun toplamı pozitif olacak biçimde seçilir (satır 209–211). Birinci faktörün yükleri çoğunlukla aynı işaretli olduğundan bu kural onları pozitif yapar ve birinci faktör skoru "genel olarak iyi genotip" yönünde artar. İkinci ve sonraki faktörlerde yükler iki işaretlidir; işaret yalnız bir kuraldır ve başka bir yazılımın çıktısıyla karşılaştırmada skorların mutlak değeri kullanılır. \mathbf G, genetik korelasyonlar, özdeğerler, BLUP'lar, OP ve RMSD döndürmeden ve işaretten bağımsızdır.
18.4.4 Genetik korelasyon
- r_{jj'}: iki çevredeki genotip etkilerinin korelasyonu. 1'e yakınsa genotip sıralaması iki çevrede aynıdır; 0'a yakınsa bir çevredeki başarı ötekinde bilgi vermez; negatifse sıralama tersine döner (çapraz etkileşim).
- Köşegen dışı kovaryans yalnız ortak faktörlerden gelir; \psi_j yalnız varyansa katkı yapar. \psi_j=0 olan iki çevre arasında korelasyon yalnız yük vektörlerinin açısına bağlıdır.
18.4.5 BLUP, faktör skorları, genel performans ve kararlılık
- \tilde{\mathbf u}_i: genotipin q çevredeki etkilerinin en iyi doğrusal yansız tahmini (BLUP). Genotipin gözlenmediği çevreler için de değer üretir: bilgi, gözlendiği çevrelerden \mathbf G aracılığıyla taşınır. Blok seçilmemişse \hat{\mathbf V} genotiplere göre blok köşegendir ve \hat{\mathbf V}_i, \mathbf r_i o genotipin bloğudur.
- \tilde{\mathbf f}_i: döndürülmüş faktör skorları (tabloda
skor_F1,skor_F2, …); \tilde{\mathbf c}_i=\boldsymbol\Lambda^{*}\tilde{\mathbf f}_i. - \bar\lambda^{*}_1: birinci faktör yüklerinin çevreler üzerinden ortalaması. OP, genotipin birinci faktörden gelen etkisinin çevre ortalamasıdır: "ortalama bir çevrede beklenen üstünlük".
- RMSD: genotipin ortak (faktörlerle açıklanan) etkilerinin, birinci faktör doğrusundan (\lambda^{*}_{j1}\tilde f_{i1}) sapmalarının karekök ortalaması; \tilde c_{ij}-\lambda^{*}_{j1}\tilde f_{i1}=\sum_{m\ge2}\lambda^{*}_{jm}\tilde f_{im}. Küçük RMSD, genotipin çevrelere tepkisinin birinci faktörle öngörülebildiğini (kararlı) gösterir. Özgül etkiler (\tilde\delta_{ij}) ölçüte girmez.
- \widehat y_{ij}: "Genotip × çevre tahminleri" tablosundaki değer.
Koddaki tercih
Tanım Smith ve Cullis'in (2018) Eş. 7 ve 9'udur: ortak etki birinci faktörün payına ve kalana ayrılır, \tilde c_{ij}=\lambda^{*}_{j1}\tilde f_{i1}+\tilde\varepsilon_{ij}, ve \mathrm{RMSD}_i=\sqrt{\tfrac1q\sum_j\tilde\varepsilon_{ij}^2} (satır 282–287). Kararlılık böylece birinci faktörden sonraki faktörlere dayanır; iki faktörlü modelde \mathrm{RMSD}_i=\lvert\tilde f_{i2}\rvert\sqrt{d_2/q}'dir. Tek faktörlü modelde ortak etki yalnız birinci faktördür, sapma tanım gereği sıfırdır: şablon RMSD sütununa 0 yazar ve kararlılığı ölçmek için en az iki faktör gerektiğini not eder (294). Gizil regresyon grafiği de ortak etkiyi birinci faktör yüküne karşı çizer (360–367); "Genotip × çevre tahminleri" tablosu ise toplam etkiyi (\tilde u_{ij}=\tilde c_{ij}+\tilde\delta_{ij}) kullanır. Koşullu modlar glmmTMB'nin ranef() çıktısından değil, TMB parametre vektöründen doğrudan okunur ve çevre ortalaması + ortak + özgül (+ blok) toplamının modelin uydurulmuş değerlerini yeniden ürettiği denetlenir (260–279).
Neden OP yalnız birinci faktörden hesaplanıyor?
Birinci faktörün yükleri hepsi pozitifse (örnek veride öyle) bu faktör genotip sıralamasını değiştirmeyen etkileşimi temsil eder: skoru yüksek genotip her çevrede üsttedir, yalnız üstünlüğün büyüklüğü çevrenin yüküyle ölçeklenir. İkinci ve sonraki faktörlerin yükleri iki işaretlidir; çevreler üzerinden ortalamaları sıfıra yakındır ve sıralamayı tersine çeviren (çapraz) etkileşimi taşırlar. Smith ve Cullis (2018) bu yüzden genel performansı birinci faktörden, kararlılığı ondan sapmalardan tanımlar. Birinci faktörün yükleri arasında negatif olanlar varsa OP "genel" performans olarak yorumlanamaz; çevreler alt gruplara ayrılarak incelenir.
18.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–77 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on parametre. | Form ve varsayılanlar (Bölüm 1.2). |
| 78–89 | İleti dili; glmmTMB'nin kurulu olduğu denetlenir ve yüklenir. | Paket yoksa kurulum komutuyla birlikte ileti verilir. |
| 91–124 | Roller, eksik satırlar, yanıt denetimleri; genotip ve çevre faktörleri; k için tanımlanabilirlik sınırı; çevre ve genotip sayımları; blok varsa çevre:blok birleşimi. |
droplevels boş düzeyleri atar. Blok kodları çevreler arasında yinelense de birleşim benzersizdir (131). |
| 125–168 | Kestirim ayarları; kur(kk): kk faktörlü modeli kuran işlev; incelt: eniyilemeyi durduğu noktadan yarı-Newton (BFGS) ile sürdürür, amaç işlevi küçülürse yeni noktayı alır (151–181); yakinsama: "evet" / "doğrulanamadı" / "hayır" (182); kov_say: parametre sayısı; olc: -2\ell, AIC, BIC, Hessian ve yakınsama göstergeleri. |
Uyarılar yakalanıp biriktirilir (148). "Yakınsama: evet" yalnız eniyileyici olağan biçimde durmuş ve Hessian pozitif tanımlıysa yazılır. |
| 170–195 | FAk modeli; VarCorr'dan \mathbf C ve \boldsymbol\Psi; \mathbf G; öz ayrışım, döndürme, işaret kuralı; artık varyansı. |
Çevreye özgü artıkta varyanslar dağılım katsayılarından exp(2·) ile alınır (216–217). |
| 197–216 | Karşılaştırma: k=0,\dots,k modelleri; tablo ve olabilirlik oranı notu. | Ana model yeniden kurulmaz (225). k büyüdükçe süre artar: FA6'da yedi model. |
| 218–234 | Çevre tablosu, döndürülmüş yükler, faktörlerin açıkladığı varyans, genetik korelasyon matrisi. | ortak_yuzde'de payda sıfıra karşı korunur (246). |
| 236–274 | BLUP ayrıştırması, faktör skorları, OP, RMSD; "Genotip seçim ölçütleri" ve "Genotip × çevre tahminleri" tabloları (OP'ye göre azalan sıralı). | Ayrıştırma denetimi tutmazsa uyarı yazılır (277–279). |
| 275–293 | "Model uyumu" tablosu (yakınsama, Hessian göstergesi, en büyük |gradyan|); Hessian ve yakınsama uyarıları; tek cümlelik özet. | Özetteki yüzdeler mq_sayi ile arayüz dilinde yazılır. ML'de parametre satırının adı "Parametre (kovaryans + sabit etki)"dir (299). |
| 295–349 | Dört şekil: yükler (F1 × F2 ya da k=1'de çubuk), korelasyon ısı haritası (F1 yüküne göre sıralı), OP–RMSD saçılımı, seçilmiş dört genotipin gizil regresyonu. | Okabe–Ito renkleri; 20'den çok çevrede ısı haritasına sayılar yazılmaz (343). |
Model kurma işlevi (satır 141–150, kısaltılmış):
kur <- function(kk) {
  rr_terim <- if (kk > 0) sprintf(" + rr(0 + .env | .gen, d = %d)", kk) else ""
  f <- stats::as.formula(paste0(".y ~ 0 + .env", rr_terim, " + diag(0 + .env | .gen)", blok_terim))
  glmmTMB(f, data = d, dispformula = disp, REML = reml, control = kontrol)
}
18.6 Elle hesap: örnek veride bağımsız yeniden hesap
Hesaplar dogrulama/fa_karma_model/elle_hesap.py (numpy/scipy) ve r_dogrulama.R (temel R) ile, glmmTMB ve TMB kullanılmadan yapılmıştır. İki ayrı denetim vardır. (A) Şablonun kestirim noktasında: \boldsymbol\Lambda^{*}, \boldsymbol\Psi ve \sigma^2 şablonun tablolarından alınır; olabilirlik, çevre ortalamaları, öz ayrışım, korelasyonlar, BLUP'lar, skorlar, OP ve RMSD açık formüllerle yeniden hesaplanır (Python \mathbf V^{-1} yoluyla, R Woodbury özdeşliğiyle, \mathbf V kurulmadan). (B) Kendi eniyilememiz: Python, 18.4.1'deki olabilirliği analitik gradyanla, \psi_j\ge0 sınırlı L-BFGS-B ile dört farklı başlangıçtan en büyükler.
Adım 1 — Parametre sayısı, AIC, BIC (FA2, REML): q=15, k=2, N=872.
Adım 2 — Olabilirlik. Şablonun kestirimleriyle \mathbf V kurulup 18.4.1'deki ifade hesaplandığında -2\ell_R=4055{,}453086; şablonun yazdığı değerle aynıdır.
Adım 3 — Bir çevrenin genetik varyansı ve iki çevrenin korelasyonu. CA.2011'in döndürülmüş yükleri (2{,}666271;\ -1{,}379295), özgül varyansı 6,689062; CA.2012'nin yükleri (1{,}416048;\ -0{,}540337), G_{jj}=5{,}343582:
CA.2011'de ortak varyans payı 9{,}011459/15{,}700520=\%57{,}40'tır.
Adım 4 — Özdeğerler ve yüzdeler. d_1=49{,}137479, d_2=12{,}139258, \sum\psi_j=39{,}452593; \operatorname{iz}(\mathbf G)=100{,}729330.
Adım 5 — Genel performans. Birinci faktör yüklerinin ortalaması \bar\lambda^{*}_1=24{,}763640/15=1{,}650909. En üst sıradaki Accumulator(W2324-1) için BLUP'tan hesaplanan skor \tilde f_{1}=2{,}283797:
Aynı genotipin RMSD'si \lvert-0{,}917587\rvert\sqrt{12{,}139258/15}=0{,}825463, CA.2011 tahmini 16{,}298811+8{,}778755=25{,}077566'dır (gözlenen iki parselin ortalaması 25,5). Genotip FL.2012'de de gözlenmiştir (ortalama 6,5); tahmin 5,9686'dır: bu çevrede genetik varyans küçük olduğundan (0,338) değer çevre ortalamasına (5,407) güçlü biçimde büzülür.
Adım 6 — Kendi eniyilememiz.
| Model | -2\ell (bağımsız) | -2\ell (şablon) | Sınırdaki \psi_j sayısı |
|---|---|---|---|
| Köşegen (REML) | 4189,279461 | 4189,279461 | 1 |
| FA1 (REML) | 4078,337272 | 4078,337524 | 3 |
| FA2 (REML) | 4055,453085 | 4055,453086 | 5 |
| FA2 (ML) | 4055,979095 | 4055,982628 | 7 |
| FA1, çevreye özgü artık (REML) | 4025,858240 | 4025,858241 | 3 |
FA2'de bağımsız çözümün özdeğerleri 49,137455 ve 12,139283, artık varyansı 3,968912'dir (şablon 49,137479; 12,139258; 3,968919). Beş özgül varyans sıfır sınırındadır (FL.2012, FL.2013, MO.2011, NY.2011, NY.2012); şablonun tablosunda bunlar 10^{-9}–10^{-6} büyüklüğünde görünür.
Adım 7 — Yayımlanmış değerlerle karşılaştırma. Aynı veri ve aynı model (FA2, REML) sommer paketinin belgesinde çözülmüştür: CA.2011'in genetik varyansı 15,70155, özdeğerler 49,134 ve 12,157, açıklanan varyans %48,8 ve %12,1; ilk genotipin (A01143-3C) birinci faktör skoru 1,18406. Şablon 15,70052; 49,13748 ve 12,13926; %48,78 ve %12,05; 1,18346 verir. Farklar (en çok %0,15) iki yazılımın eniyileme algoritmalarının durduğu noktadan gelir.
18.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1, 2, 4 ve 5).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| FA2 -2\log L_R | 4055,45308557 | 4055,45308557 | 4055,45308557 | 7,0e−15 | ✓ |
| FA2 AIC | 4145,45308557 | 4145,45308557 | — | 6,6e−15 | ✓ |
| FA2 BIC | 4359,3577919 | 4359,3577919 | — | 6,5e−15 | ✓ |
| Çevre ortalaması: CA.2011 | 16,29881131 | 16,29881131 | 16,29881131 | 1,3e−15 | ✓ |
| Çevre ortalaması: FL.2012 | 5,40736964 | 5,40736964 | 5,40736964 | 1,6e−15 | ✓ |
| Çevre ortalaması: MI.2013 | 16,08191903 | 16,08191903 | 16,08191903 | 2,4e−15 | ✓ |
| Çevre ortalaması: NY.2013 | 14,99106378 | 14,99106378 | 14,99106378 | 5,3e−15 | ✓ |
| Özdeğer \lambda_1 | 49,13747856 | 49,13747856 | 49,13747856 | 5,8e−16 | ✓ |
| Açıklanan yüzde: F1 | 48,78169916 | 48,78169916 | 48,78169916 | 4,4e−16 | ✓ |
| Özdeğer \lambda_2 | 12,13925765 | 12,13925765 | 12,13925765 | 2,5e−15 | ✓ |
| Açıklanan yüzde: F2 | 12,05136348 | 12,05136348 | 12,05136348 | 9,7e−15 | ✓ |
| Özgül pay (%) | 39,16693737 | 39,16693737 | — | 2,4e−15 | ✓ |
| Yük: CA.2011, F1 | 2,66627133 | 2,66627133 | — | 3,3e−16 | ✓ |
| Yük: NY.2013, F2 | 2,0839542 | 2,0839542 | — | 4,3e−16 | ✓ |
| Ortak varyans yüzdesi: MI.2013 | 42,02232708 | 42,02232708 | — | 3,0e−15 | ✓ |
| Genetik korelasyon: CA.2011–CA.2012 | 0,49356819 | 0,49356819 | 0,49356819 | 7,2e−16 | ✓ |
| En küçük genetik korelasyon | 0,01767395 | 0,01767395 | 0,01767395 | 1,4e−15 | ✓ |
| OP: Accumulator(W2324-1) | 3,77034248 | 3,77034248 | 3,77034248 | 4,8e−15 | ✓ |
| RMSD: Accumulator(W2324-1) | 0,82546297 | 0,82546297 | 0,82546297 | 7,8e−15 | ✓ |
| Skor F1: Accumulator(W2324-1) | 2,28379741 | 2,28379741 | 2,28379741 | 5,3e−15 | ✓ |
| Skor F2: Accumulator(W2324-1) | −0,91758681 | −0,91758681 | −0,91758681 | 5,6e−15 | ✓ |
| OP: AC03452-2W | 3,30450215 | 3,30450215 | 3,30450215 | 4,7e−15 | ✓ |
| RMSD: AC03452-2W | 0,16708061 | 0,16708061 | 0,16708061 | 2,3e−15 | ✓ |
| Skor F1: AC03452-2W | 2,00162545 | 2,00162545 | 2,00162545 | 5,8e−15 | ✓ |
| Skor F2: AC03452-2W | 0,18572725 | 0,18572725 | 0,18572725 | 1,4e−15 | ✓ |
| OP: CO05061-2P | −2,55645037 | −2,55645037 | −2,55645037 | 6,6e−15 | ✓ |
| RMSD: CO05061-2P | 1,00251674 | 1,00251674 | 1,00251674 | 1,1e−14 | ✓ |
| Skor F1: CO05061-2P | −1,54851045 | −1,54851045 | −1,54851045 | 5,9e−15 | ✓ |
| Skor F2: CO05061-2P | −1,11440024 | −1,11440024 | −1,11440024 | 4,6e−15 | ✓ |
| Tahmin: Accumulator(W2324-1), CA.2011 | 25,07756596 | 25,07756596 | 25,07756596 | 1,1e−15 | ✓ |
| Tahmin: CO05061-2P, NY.2013 | 9,21212727 | 9,21212727 | 9,21212727 | 3,9e−16 | ✓ |
| FA1 -2\log L_R (şablonun noktasında) | 4078,33752398 | 4078,33752398 | 4078,33752398 | 1,8e−15 | ✓ |
| FA2 -2\log L (ML; şablonun noktasında) | 4055,98262741 | 4055,98262741 | 4055,98262741 | 4,0e−15 | ✓ |
| FA2 BIC (ML) | 4462,22999285 | 4462,22999285 | — | 4,1e−15 | ✓ |
| Kendi eniyileme: köşegen -2\log L_R | 4189,27946112 | 4189,27946077 | — | 8,3e−11 | ✓ |
| Kendi eniyileme: FA1 -2\log L_R | 4078,33752398 | 4078,33727228 | — | 6,2e−8 | ✓ |
| Kendi eniyileme: FA2 -2\log L_R | 4055,45308557 | 4055,45308503 | — | 1,3e−10 | ✓ |
| Kendi eniyileme: FA2 artık varyansı | 3,9689189 | 3,96891189 | — | 1,8e−6 | ✗ |
| Kendi eniyileme: FA2 \lambda_1 | 49,13747856 | 49,13745464 | — | 4,9e−7 | ✓ |
| Kendi eniyileme: FA2 \lambda_2 | 12,13925765 | 12,13928301 | — | 2,1e−6 | ✗ |
| Kendi eniyileme: FA2 G_{jj}, CA.2011 | 15,70052036 | 15,7004889 | — | 2,0e−6 | ✗ |
| Kendi eniyileme: FA2 G_{jj}, MI.2013 | 19,43493755 | 19,43502439 | — | 4,5e−6 | ✗ |
| Kendi eniyileme: FA2 G_{jj}, NY.2013 | 9,06282643 | 9,06283745 | — | 1,2e−6 | ✗ |
| Kendi eniyileme: FA1 + çevreye özgü artık -2\log L_R | 4025,85824096 | 4025,85824036 | — | 1,5e−10 | ✓ |
| Kendi eniyileme: FA2 -2\log L (ML) | 4055,98262741 | 4055,97909464 | — | 8,7e−7 | ✓ |
Ölçütü karşılayan: 40/45. İlk 34 satır şablonun kestirim noktasında (\boldsymbol\Lambda, \boldsymbol\Psi, \sigma^2 şablon tablolarından) açık formüllerle yeniden hesaptır: Python \mathbf V^{-1} yoluyla, R Woodbury özdeşliğiyle (\mathbf V kurulmadan). «Kendi eniyileme» satırlarında Python, olabilirliği farklı başlangıçlardan analitik gradyanlı L-BFGS-B ile (\psi_j\ge0 sınırlı) kendisi en büyükler; ✗ satırlarındaki fark eniyilemelerin durduğu noktadan gelir (18.6.1).
Kestirim noktasındaki 34 satırın tümü ölçütü karşılar: şablonun olabilirliği, çevre ortalamaları, döndürmesi, BLUP ayrıştırması, skorları, OP ve RMSD'si açık formüllerle 10^{-11} düzeyinde yeniden üretilir. "Kendi eniyileme" satırlarında -2\ell değerleri göreli ölçütü karşılar; kovaryans parametreleri ise beşinci–altıncı anlamlı basamakta ayrışır (✗ satırları). Olabilirlik tepe çevresinde düzdür: -2\ell'deki 5\times10^{-7}'lik fark G_{jj}'de 10^{-5} göreli farka karşılık gelir. Aynı düzlük FA1 (REML) ve FA2 (ML) modellerinde daha belirgindir: bağımsız çözüm sırasıyla 0,00025 ve 0,0035 daha küçük -2\ell bulur ve FA2 (ML)'de ikinci özdeğer 11,883'tür (şablon 11,938). Şablon bu iki modelde Hessian'ı pozitif tanımlı bulmaz ve yakınsamayı "doğrulanamadı" diye bildirir; yakınsaması "evet" olan modellerde (köşegen, FA2 REML, çevreye özgü artıklı FA1) şablon ile bağımsız çözüm aynıdır. Model seçimini (AIC farkları 4 ve üstü) ve yorumu etkilemeyen bu farklar, "doğrulanamadı" bildirilen modellerde kovaryans kestirimlerinin üç–dört anlamlı basamakla raporlanması gerektiğini gösterir.
18.7 Çıktıyı okuma
Örnek ayarda konsol metni:
Not: FA modelleri iç içedir, ancak özgül varyanslar ve yükler sınırda olabildiğinden olabilirlik oranı testinin χ² dağılımı kesin değildir; seçimde AIC/BIC kullanılması önerilir.
FA2 modeli: 41 genotip, 15 çevre, 872 gözlem. Ortak faktörler toplam genetik varyansın %60,8 kadarını açıklıyor; birinci faktörün payı %48,8.
Model karşılaştırması (REML; parametre sayısı = kovaryans parametreleri) (k=6 çalıştırmasından; ilk üç satır örnek ayarın tablosudur)
| model | parametre_sayisi | m2logL | AIC | BIC | hessian_pd | delta_AIC |
|---|---|---|---|---|---|---|
| Köşegen […] | 16 | 4189,279 | 4221,279 | 4297,334 | evet | 80,94 |
| FA1 | 31 | 4078,338 | 4140,338 | 4287,694 | hayır | 0,00 |
| FA2 | 45 | 4055,453 | 4145,453 | 4359,358 | evet | 5,12 |
| FA3 | 58 | 4040,656 | 4156,656 | 4432,356 | evet | 16,32 |
| FA4 | 70 | 4023,949 | 4163,949 | 4496,690 | hayır | 23,61 |
| FA5 | 81 | 4015,707 | 4177,707 | 4562,735 | hayır | 37,37 |
| FA6 | 91 | 4010,372 | 4192,372 | 4624,935 | hayır | 52,03 |
Çevre başına genetik varyans ve ortak varyans oranı (FA2) (seçilmiş satırlar)
| cevre | n | ortalama | genetik_varyans | ortak_varyans | ozgul_varyans | ortak_yuzde | artik_varyans |
|---|---|---|---|---|---|---|---|
| CA.2011 | 43 | 16,299 | 15,701 | 9,011 | 6,689 | 57,40 | 3,969 |
| FL.2012 | 78 | 5,407 | 0,338 | 0,338 | 0,000 | 100,00 | 3,969 |
| MI.2013 | 59 | 16,082 | 19,435 | 8,167 | 11,268 | 42,02 | 3,969 |
| MO.2012 | 49 | 16,369 | 16,496 | 7,483 | 9,013 | 45,36 | 3,969 |
| NY.2013 | 60 | 14,991 | 9,063 | 8,689 | 0,374 | 95,88 | 3,969 |
Faktörlerin açıkladığı genetik varyans: F1 özdeğer 49,137 (%48,78); F2 12,139 (%12,05; kümülatif %60,83); Özgül (Ψ) 39,453 (%39,17).
Genotip seçim ölçütleri (ilk beş ve son satır)
| genotip | OP | kararlilik_RMSD | skor_F1 | skor_F2 | sira |
|---|---|---|---|---|---|
| Accumulator(W2324-1) | 3,770 | 0,825 | 2,284 | −0,918 | 1 |
| AC03452-2W | 3,305 | 0,167 | 2,002 | 0,186 | 2 |
| NY148 | 2,310 | 1,581 | 1,399 | 1,757 | 3 |
| A01143-3C | 1,954 | 1,241 | 1,183 | −1,380 | 4 |
| NY152(NYH15-5) | 1,720 | 0,161 | 1,042 | 0,179 | 5 |
| CO05061-2P | −2,556 | 1,003 | −1,549 | −1,114 | 41 |
Model uyumu (FA2): n 872; genotip 41; çevre 15; yöntem REML; −2 log L 4055,453086; kovaryans parametresi 45; AIC 4145,453086; BIC 4359,357792; artık varyansı 3,9689189; ortak varyans oranı %60,8331; yakınsama evet; Hessian pozitif tanımlı evet; en büyük |gradyan| 0,000215.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Model karşılaştırması | Köşegen ve FA1…FAk için parametre sayısı, -2\ell, AIC, BIC, Hessian göstergesi, yakınsama | En küçük AIC/BIC seçilir. Örnek veride ikisi de FA1'i gösterir; FA2'nin AIC'si 5,1 büyüktür. Köşegen model (çevreler arası kovaryans yok) 81 AIC birimi geridedir. FA1'in yakınsaması "doğrulanamadı"dır (Hessian pozitif tanımlı değil). |
| genetik_varyans | G_{jj} | Çevrenin genotipleri ayırt etme gücü. FL çevrelerinde 0,3–1,7; MI.2013'te 19,4. |
| ortak_yuzde | Ortak faktörlerin G_{jj}'deki payı | %100'e yakınsa \psi_j sınırdadır: o çevredeki genotip etkileri tümüyle faktörlerle açıklanır. Düşükse çevrenin kendine özgü etkileşimi büyüktür. |
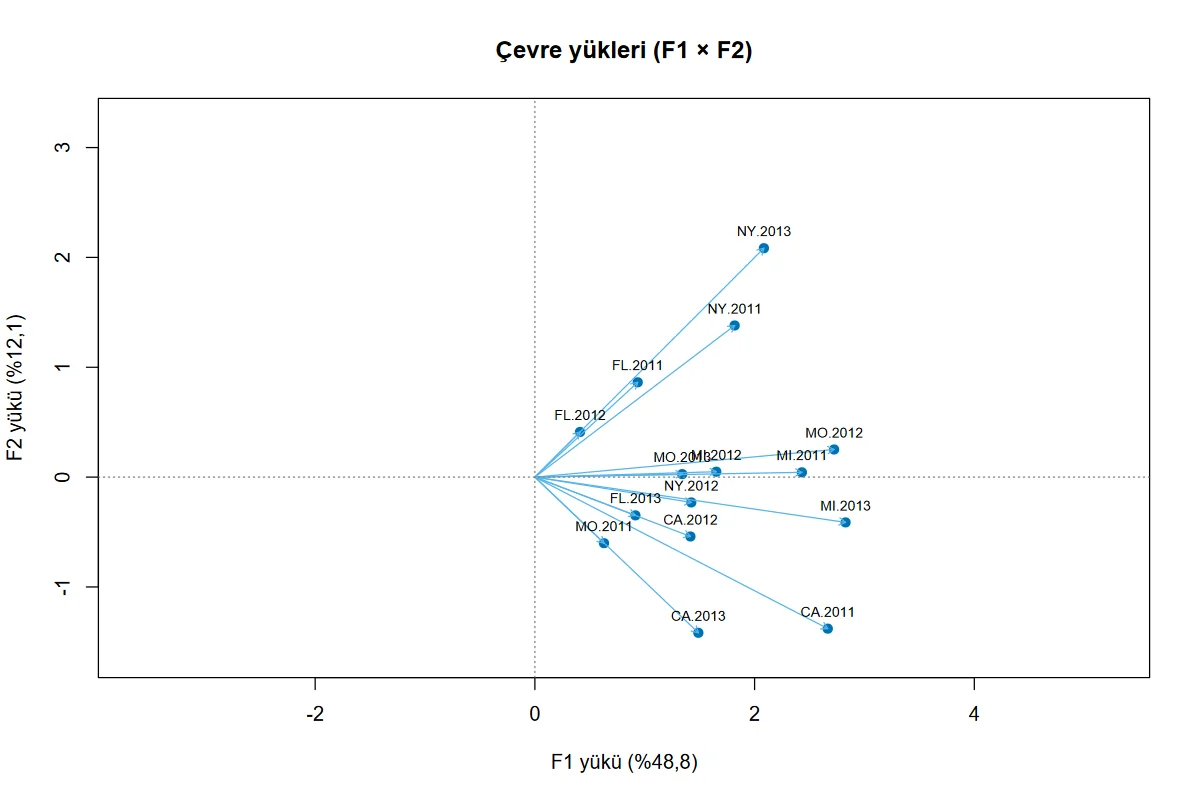
| Döndürülmüş faktör yükleri | \boldsymbol\Lambda^{*} | F1 yüklerinin hepsi pozitifse F1 "genel üstünlük" eksenidir. F2'de zıt işaretli çevreler (CA'lar negatif, NY ve FL.2011 pozitif) birbirine göre sıralamayı değiştiren çevre gruplarıdır. |
| Faktörlerin açıkladığı varyans | Özdeğerler ve yüzdeler | F1 genetik varyansın %48,8'ini, iki faktör birlikte %60,8'ini taşır; %39,2 çevreye özgüdür. |
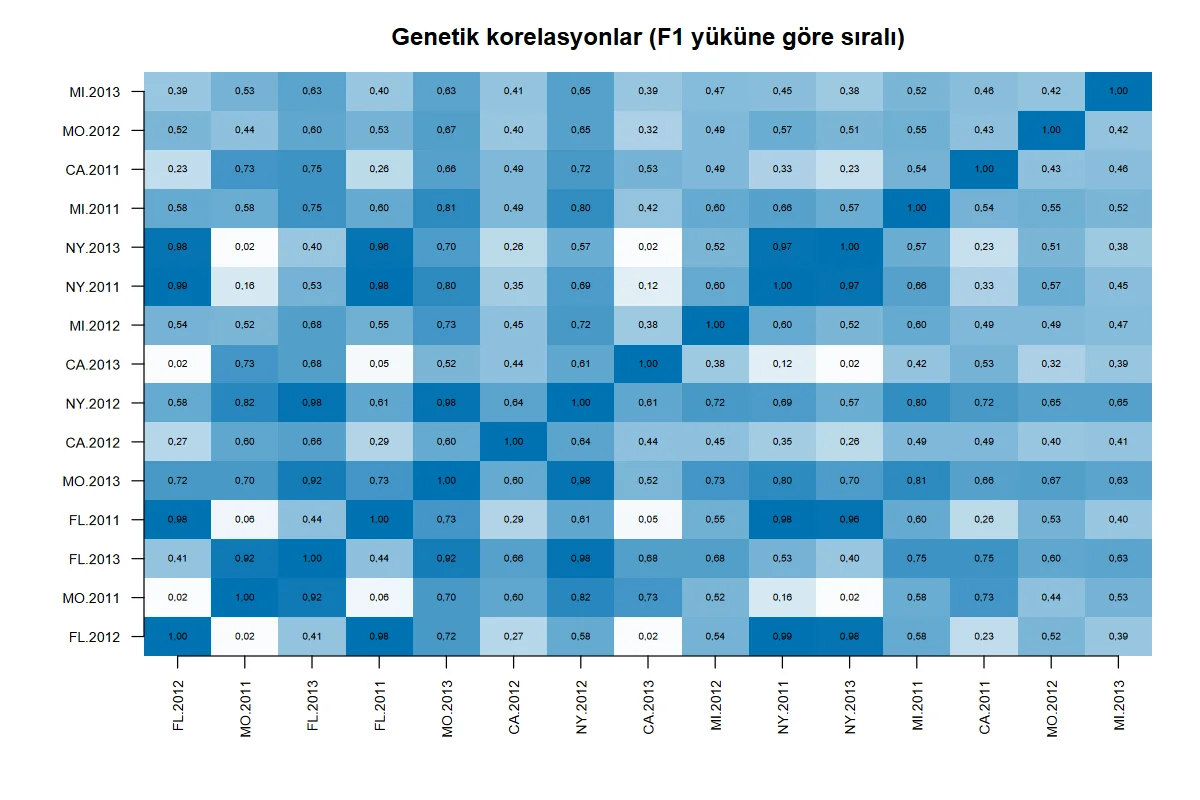
| Genetik korelasyon matrisi | r_{jj'} | Örnek veride 0,018 (CA.2013–NY.2013) ile 0,991 (FL.2012–NY.2011) arası; negatif korelasyon yoktur. |
| OP | \bar\lambda^{*}_1\tilde f_{i1} | Yanıtın biriminde, ortalama bir çevrede beklenen genetik üstünlük. Tablo OP'ye göre sıralıdır. |
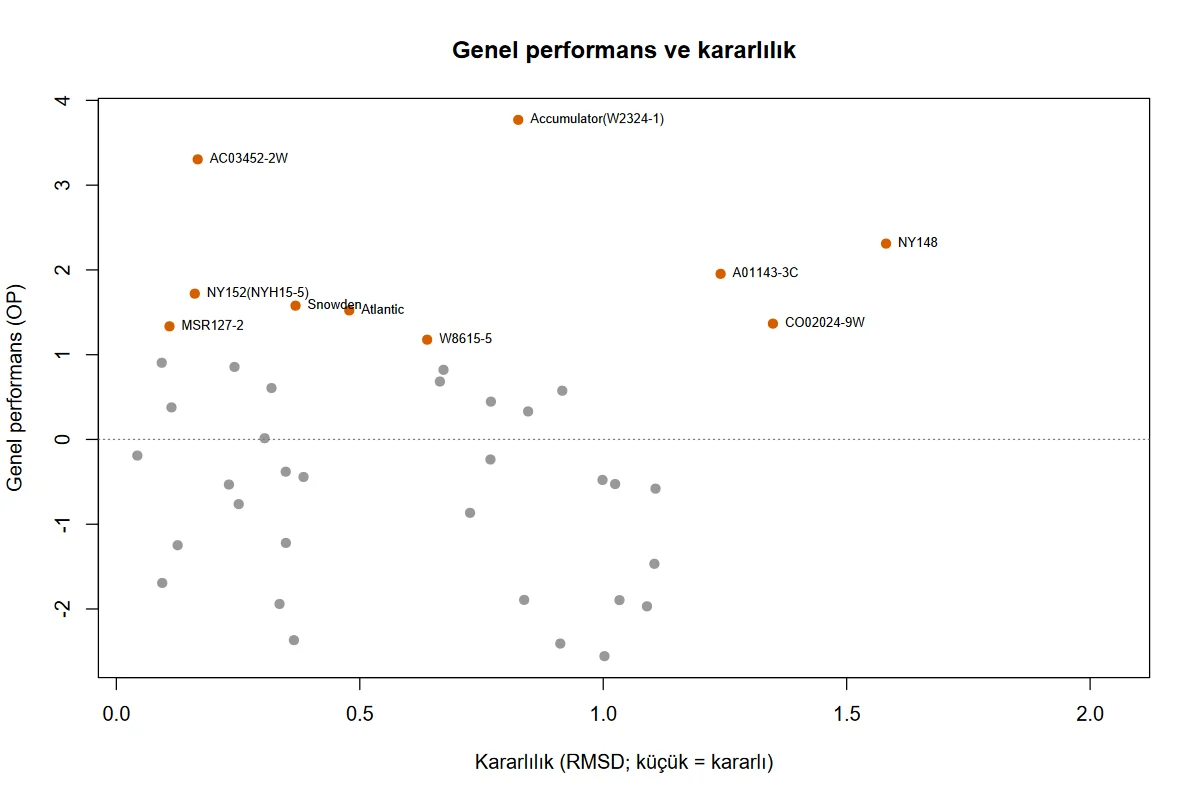
| kararlilik_RMSD | Ortak etkilerin birinci faktör doğrusundan sapması | Küçük = kararlı. İlk beş içinde en kararlılar NY152(NYH15-5) (0,161) ve AC03452-2W'dir (0,167); NY148 üçüncü sırada ama en kararsız genotiptir (1,581). k=1'de sütun sıfırdır. |
| Genotip × çevre tahminleri | \hat\mu_j+\tilde u_{ij} | Gözlenmeyen hücreler için de dolu; belirli bir çevre için seçimde kullanılır. |
| hessian_pd, yakinsama, "Hessian pozitif tanımlı", "Yakınsama" | Eniyileme sonundaki Hessian göstergesi ve yakınsama bildirimi | Hessian "hayır" çoğunlukla sınırdaki özgül varyanslardan kaynaklanır; yakınsama o zaman "doğrulanamadı"dır: nokta kestirimleri kullanılır, ama -2\ell ve kovaryans parametrelerinin son basamakları kesin değildir ve bu modelden standart hata istenmez. Yakınsama "hayır" ise eniyileyici olağan biçimde durmamıştır. |
Şekil 18.1. Çevre yükleri, F1 × F2 (örnek ayar). Bütün çevreler F1'de pozitiftir; F2, CA çevrelerini (negatif) NY.2011, NY.2013 ve FL.2011'den (pozitif) ayırır. Okun boyu çevrenin ortak genetik varyansının kareköküdür.
Şekil 18.2. Çevreler arası genetik korelasyon ısı haritası; çevreler F1 yüküne göre sıralıdır (mavi: 1'e yakın).
Şekil 18.3. Genel performans (OP) – kararlılık (RMSD). Seçim için aranan bölge sol üsttür: yüksek OP, küçük RMSD. Adı yazılanlar OP'si en yüksek 10 genotiptir.
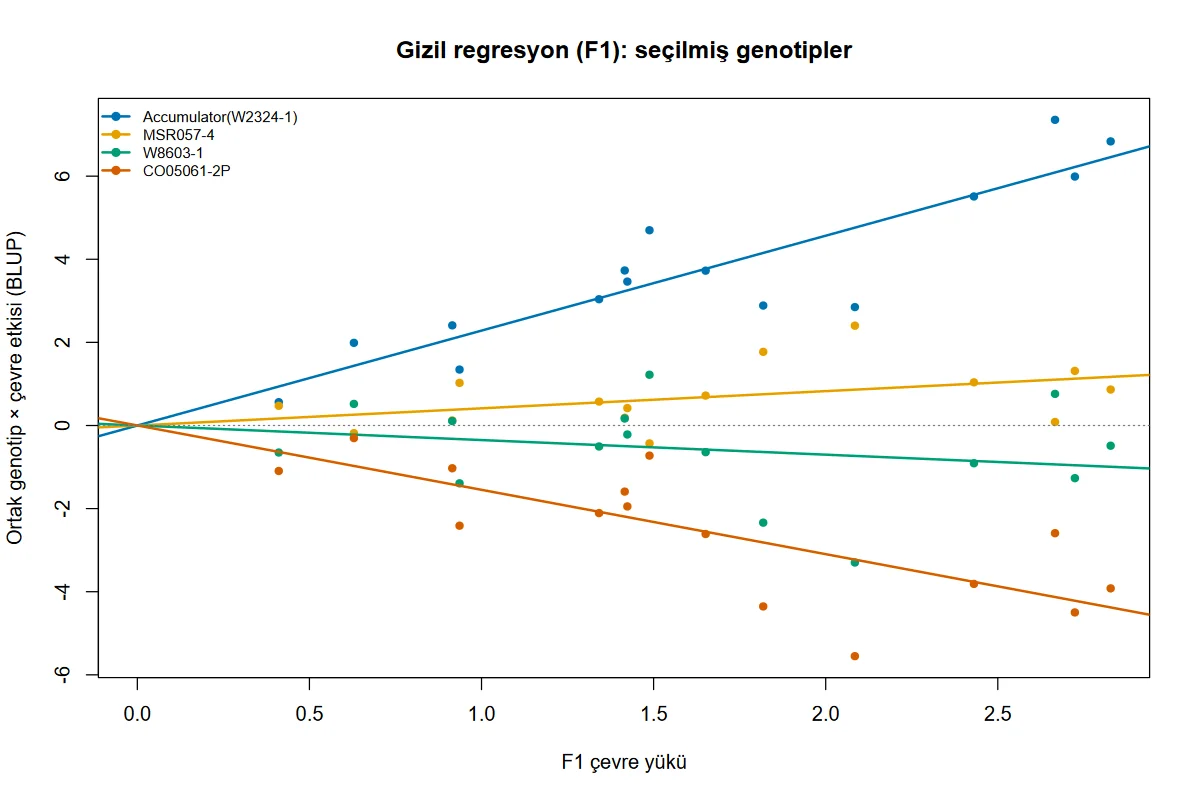
Şekil 18.4. Gizil regresyon: OP sıralamasından eşit aralıklı seçilen dört genotipin çevre etkileri (noktalar) ve birinci faktör doğrusu (eğim = F1 skoru). Noktalar ortak (faktörlerle açıklanan) etkilerdir; doğrudan uzaklıkları RMSD'yi oluşturur.
Öteki çalıştırmalar: çevreye özgü artık varyansı (FA1) -2\ell_R'yi 4078,34'ten 4025,86'ya indirir (14 ek parametre; AIC 4140,34 → 4115,86) ve artık varyansları 1,34 (NY.2011) ile 11,37 (MO.2012) arasında kestirir: bu veride ortak artık varsayımı zayıftır. Blok etkisi eklendiğinde (FA2) -2\ell_R 4032,24, artık varyansı 3,647 olur. ML ile FA2'nin -2\ell'si 4055,98, parametre sayısı 60'tır (45 + 15 sabit etki).
Rapor cümlesi (örnek ayar):
41 patates hattının 15 çevredeki verimi, çevre ortalamaları sabit ve genotip × çevre etkileri rastgele alınarak faktör analitik kovaryans yapılı doğrusal karma modelle çözümlendi (REML; 872 gözlem). İki faktörlü model (FA2; -2\log L = 4055{,}45; AIC = 4145{,}45) çevreler arası kovaryansın bulunmadığı köşegen modelden belirgin biçimde üstündü (AIC = 4221{,}28); tek faktörlü modelin AIC'si biraz daha küçüktü (4140,34). İki ortak faktör toplam genetik varyansın %60,8'ini açıkladı (birinci faktör %48,8). Çevreler arası genetik korelasyonlar 0,02 ile 0,99 arasındaydı. Genel performansı en yüksek hat Accumulator(W2324-1) (OP = 3{,}77; RMSD = 0{,}83), yüksek performanslı hatlar içinde en kararlılardan biri AC03452-2W idi (OP = 3{,}30; RMSD = 0{,}17).
18.8 Sık hatalar ve tuzaklar
- Faktör sayısını örnek ayardaki gibi bırakmak. k=2 bir başlangıçtır. Karşılaştırma tablosu örnek veride FA1'i gösterir; k arttıkça -2\ell hep küçülür, AIC ve BIC ise parametre cezası yüzünden büyür. Karar bu tablodan ve ortak varyans yüzdelerinden verilir.
- -2\ell farkını \chi^2 tablosuna bakarak sınamak. Sınır koşulları yüzünden dağılım \chi^2 değildir (18.4.2).
- Yük ve skor işaretlerini başka yazılımın çıktısıyla doğrudan karşılaştırmak. Yazılımlar farklı döndürme kullanır (çoğu, üst üçgeni sıfır olan ham yükleri verir). Karşılaştırılabilir büyüklükler \mathbf G, korelasyonlar, özdeğerler ve -2\ell'dir; yükler ancak aynı döndürmeden sonra, skorlar işaret farkıyla karşılaştırılır.
- Sıfıra yakın özgül varyansı "hata" sanmak. \psi_j\approx0 bir sınır çözümüdür ve FA modellerinde olağandır; o çevrenin genetik varyansı tümüyle ortak faktörlerden gelir. Sınırdaki parametreler yüzünden Hessian pozitif tanımlı olmayabilir; şablon bunu uyarı olarak yazar ve yakınsamayı "doğrulanamadı" diye bildirir.
- OP'yi birinci faktör yükleri iki işaretliyken kullanmak. OP "genel" üstünlük anlamını yalnız bütün F1 yükleri aynı işaretliyse taşır. Yükler tablosu önce incelenir.
- Sütun türlerini sonuçla ilişkilendirmek. Yanıt sayısal role atandığı için Veri sekmesindeki türü "kategorik" olsa da değerleriyle aktarılır (Bölüm 1.3); sütunda sayı olmayan değer varsa çalıştırma durur. Çevre ya da genotip sütununun sayısal türde olması (ör. yıl) sorun değildir: ikisi de faktöre çevrilir.
- Blok kodlarını yanlış role vermek. Blok alanı çevre içi blok içindir ve çevreyle birleştirilir; genotip ya da çevre sütunu blok olarak seçilemez (aynı sütun denetimi). Tam olmayan blok ya da satır–sütun desenleri tek bir blok etkisiyle temsil edilemez.
- ML sonucundaki parametre sayısını REML'dekiyle karşılaştırmak. ML'de sayıya 15 çevre ortalaması eklenir (60); REML'de yalnız kovaryans parametreleri sayılır (45). "Model uyumu" tablosunda satırın adı REML'de "Kovaryans parametresi", ML'de "Parametre (kovaryans + sabit etki)"dir. İki yöntemin AIC'leri birbiriyle karşılaştırılmaz.
- "Yakınsama: doğrulanamadı" bildirilen modelde kovaryansları çok basamakla raporlamak. Düz olabilirlikte eniyileyicinin durduğu nokta dördüncü–beşinci basamağı etkiler (18.6.1). Şablon eniyilemeyi durduğu noktadan sürdürür, ama Hessian pozitif tanımlı değilse en büyük olabilirlik noktasına varıldığı doğrulanamaz. "Ek başlangıç sayısı" alanı 1 ya da daha büyük verilirse, Hessian'ı pozitif tanımlı olmayan model ek başlangıçlardan yeniden eniyilenir (başlangıçlar tohuma bağlı değildir) ve en düşük -2\ell alınır. Örnek veride FA1 (REML) -2\ell değeri 4078,337524'ten 4078,337274'e iner ve Hessian pozitif tanımlı olur (bağımsız eniyileme 4078,337272); ML uyumlarında değişiklik 1e-6'dan küçüktür ve Hessian pozitif tanımlı çıkmaz. Varsayılan 0'dır.
- Tek faktörlü modelde kararlılık aramak. k=1'de RMSD bütün genotiplerde sıfırdır; kararlılık ölçütü birinci faktörden sonraki faktörlere dayanır.
- Az genotipli çevrelere güvenmek. Bir çevrede 3 gözlem şablonun alt sınırıdır, ama o çevrenin yükü ve özgül varyansı çok belirsiz kestirilir; şablon bu parametreler için standart hata vermez.
18.9 Uzman soruları
S1. `rr() + diag()` kurulumu, FA yapısını doğrudan sunan yazılımlardaki modelle aynı olabilirliği mi veriyor?
Evet. rr(0 + çevre | genotip, d = k) terimi kovaryansı \boldsymbol\Lambda\boldsymbol\Lambda^{\top} olan, diag(0 + çevre | genotip) terimi kovaryansı \boldsymbol\Psi olan iki bağımsız rastgele etki kurar; toplamlarının kovaryansı \boldsymbol\Lambda\boldsymbol\Lambda^{\top}+\boldsymbol\Psi'dir. Şablonun kestirimleriyle \mathbf V açıkça kurulup REML ölçütü hesaplandığında şablonun yazdığı -2\ell_R on anlamlı basamakta yeniden üretilir (4055,453086). Sabit (N-q)\log2\pi dahildir; -2\ell_R aynı tanımı kullanan uygulamalarla doğrudan karşılaştırılabilir.
S2. Parametre sayısında neden k(k-1)/2 çıkarılıyor ve sınırdaki özgül varyanslar sayılıyor mu?
Yük matrisi k\times k dik döndürmeye kadar tanımlıdır; döndürme matrisinin k(k-1)/2 serbest öğesi kadar yük veriden kestirilemez ve kısıtlanır. Şablon bu sayıyı çıkarır ve artık varyansını ekler: FA2'de 30-1+15+1=45. Sınıra yapışan \psi_j'ler sayıdan düşülmez; bazı uygulamalar sınırdaki parametreleri saymaz ve AIC'yi 2\times(\text{sınırdaki sayı}) kadar küçük raporlar (örnek veride FA2 için 10 birim). Karşılaştırmada hangi kuralın kullanıldığına bakılır.
S3. BIC'de n olarak neden 857 kullanılıyor?
REML olabilirliği, sabit etkilerden arındırılmış N-q hata kontrastının olabilirliğidir; şablon BIC cezasında bu sayıyı kullanır (872-15=857; satır 189–190). ML'de n^{*}=N=872'dir. Karma modellerde BIC için "etkin örneklem büyüklüğü" tartışmalıdır (gözlem sayısı mı, genotip sayısı mı); genotip sayısı (41) kullanılsaydı ceza küçülür, ama örnek veride sıralama yine FA1 lehine kalırdı.
S4. Döndürme sonuçları değiştirir mi?
\mathbf G'yi, korelasyonları, olabilirliği ve BLUP'ları değiştirmez; yalnız yüklerin ve skorların hangi eksenlerde ifade edildiğini değiştirir. Temel eksen döndürmesinde birinci eksen ortak varyansı en büyükleyen yöndür; bu yüzden OP ve RMSD, birinci faktörün bu tanımına bağlıdır, ama kestirimdeki ham yük kısıtına (hangi çevrenin önce yazıldığına) bağlı değildir. Öz ayrışım \boldsymbol\Lambda\boldsymbol\Lambda^{\top} üzerinden yapıldığından sonuç düzey sırasından etkilenmez.
S5. RMSD'de özgül etkiler de var mı; toplam etkiyle hesaplansa ne olurdu?
Hayır. Şablon sapmayı kaynaktaki gibi ortak etkiden hesaplar: \tilde c_{ij}-\lambda^{*}_{j1}\tilde f_{i1}=\sum_{m\ge2}\lambda^{*}_{jm}\tilde f_{im}; iki faktörlü modelde bu \lvert\tilde f_{i2}\rvert\sqrt{d_2/q}'dir. Smith ve Cullis (2018) seçimde ortak etkilerin kullanılmasını, bu etkilerin birkaç çevreye ortak olan etkileşimi taşıdığı ve tek bir çevreye özgü, yinelenmesi beklenmeyen etkileşimi dışarıda bıraktığı gerekçesiyle önerir. Sapma toplam BLUP'tan (\tilde u_{ij}=\tilde c_{ij}+\tilde\delta_{ij}) alınsaydı özgül etkiler de girerdi: örnek veride AC03452-2W için 0,278 (şablonda 0,167), Accumulator(W2324-1) için 1,609 (0,825) olurdu ve iki hesabın genotip sıralamaları arasındaki sıra korelasyonu 0,41'dir. Özgül payın büyük olduğu verilerde (burada %39) iki hesap belirgin biçimde ayrışır; toplam etkiye dayalı bir ölçü isteniyorsa "Genotip × çevre tahminleri" tablosundan ayrıca hesaplanır.
S6. Genotipin hiç denenmediği bir çevre için tahmin nasıl üretiliyor?
BLUP formülünde \hat{\mathbf G}\mathbf Z_i^{\top} çarpanı, genotipin gözlendiği çevrelerdeki artıkları bütün çevrelere taşır: gözlenmeyen j çevresi için tahmin \sum_{j'}G_{jj'}(\cdot) biçimindedir ve yalnız ortak faktörlerden beslenir (özgül kısım, o çevrede gözlem olmadığından sıfırdır). Tahminin güvenilirliği o çevrenin öteki çevrelerle genetik korelasyonuna bağlıdır; korelasyonları 0'a yakın bir çevrede tahmin çevre ortalamasına yaklaşır. Şablon tahminler için standart hata (tahmin hata varyansı) vermez.
S7. Sınırdaki özgül varyanslar ve "Hessian pozitif tanımlı değil" uyarısı sonucu geçersiz kılar mı?
Nokta kestirimlerini kılmaz. Bağımsız eniyileme \psi_j\ge0 sınırını açıkça koyar ve aynı -2\ell_R'ye, aynı beş sıfır özgül varyansa varır. glmmTMB varyansları logaritmik ölçekte tuttuğundan sıfıra ancak yaklaşır (10^{-8}); bu yönde olabilirlik düzleşir ve sayısal Hessian tekile yaklaşır. Gösterge bu yüzden modelden modele tutarlı davranmaz (örnekte FA1 "hayır", beş sınır parametreli FA2 "evet"). Uyarı, standart hataların kullanılmaması gerektiğini söyler; şablon zaten kovaryans parametreleri için standart hata raporlamaz.
S8. Örnek veride hangi model raporlanmalı: FA1 mi FA2 mi?
AIC (4140,3'e karşı 4145,5) ve BIC (4287,7'ye karşı 4359,4) FA1'i gösterir; -2\ell farkı 22,9'dur ve 14 ek parametreyi karşılamaz. FA2 genetik varyansın %60,8'ini (FA1 %48,4) açıklar ve çevreleri ikinci eksende ayırır; ıslah programlarında amaç çoğunlukla tahmin doğruluğu olduğundan ortak varyans yüzdesi yeterli düzeye gelene dek faktör eklenmesi de savunulur (Smith ve Cullis, 2018). İki ölçüt çelişiyorsa ikisi de raporlanır; OP sıralamasının iki modelde ne kadar değiştiği pratik sonucu gösterir. Çevreye özgü artık varyansı bu veride AIC'yi 24 birim düşürür ve faktör sayısından önce ele alınmalıdır.
18.10 Kaynaklar
- Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- Covarrubias-Pazaran, G. (2016). Genome-assisted prediction of quantitative traits using the R package sommer. PLOS ONE, 11(6), e0156744. https://doi.org/10.1371/journal.pone.0156744
- McGillycuddy, M., Warton, D. I., Popovic, G., & Bolker, B. M. (2025). Parsimoniously fitting large multivariate random effects in glmmTMB. Journal of Statistical Software, 112(1). https://doi.org/10.18637/jss.v112.i01
- Piepho, H.-P. (1997). Analyzing genotype-environment data by mixed models with multiplicative terms. Biometrics, 53(2), 761–766. https://doi.org/10.2307/2533976
- Self, S. G., & Liang, K.-Y. (1987). Asymptotic properties of maximum likelihood estimators and likelihood ratio tests under nonstandard conditions. Journal of the American Statistical Association, 82(398), 605–610. https://doi.org/10.1080/01621459.1987.10478472
- Smith, A. B., & Cullis, B. R. (2018). Plant breeding selection tools built on factor analytic mixed models for multi-environment trial data. Euphytica, 214(8), 143. https://doi.org/10.1007/s10681-018-2220-5
- Smith, A., Cullis, B., & Thompson, R. (2001). Analyzing variety by environment data using multiplicative mixed models and adjustments for spatial field trend. Biometrics, 57(4), 1138–1147. https://doi.org/10.1111/j.0006-341X.2001.01138.x