57. Benzetim tabanlı güç analizi
Şablon kimliği: guc_benzetim · Kategori: benzetim · Dil: Python · Dosya: pro/sablonlar/benzetim/guc_benzetim.py (satır 1–264; üstbilgi 1–117) · Örnek veri: yok (veriyi şablon üretir) · Paketler: numpy 2.4.6, scipy 1.16.3, statsmodels 0.14.6, pandas 2.3.3, matplotlib 3.10.9
57.1 Ne işe yarar
Şablon, bir hipotez testinin gücünü formülle değil deneyerek bulur. Cevapladığı soru şudur: "Gerçekte şu büyüklükte bir etki varsa ve ben n gözlem toplarsam, testim bu etkiyi yüzde kaç olasılıkla anlamlı bulur?"
Güç, sıfır hipotezi yanlışken testin onu reddetme olasılığıdır:
- p: testin p değeri; \alpha: anlamlılık düzeyi.
- Olasılık, aynı çalışmanın aynı koşullarda sonsuz kez yinelenmesi üzerinden alınır. Benzetim bu yinelemeyi bilgisayarda yapar.
- Etki sıfır alınırsa aynı oran testin I. tür hata oranıdır ve \alpha'ya eşit çıkmalıdır.
Yöntem üç adımdır: (1) varsayılan modelden n gözlemlik yapay bir veri üret; (2) testi uygula, p değerini sakla; (3) bunu B kez yinele ve p<\alpha olanların oranını al. Şablon bunu bir örneklem büyüklüğü ızgarasının her noktasında yapar, güç eğrisini çizer ve hedef güce ulaşılan ilk n'yi bildirir.
Üç hazır tasarım vardır: iki grup t testi, üç grup tek yönlü varyans analizi ve lojistik regresyonda sürekli bir değişken ile ikili bir değişkenin etkileşimi. İlk ikisinin gücü kapalı formülle de hesaplanabilir; şablonda benzetimi formülle karşılaştırıp yöntemi öğrenmek için bulunurlar. Üçüncüsü asıl kullanım alanını örnekler: kapalı güç formülü olmayan bir test.
Ne zaman kullanılır?
- Planlanan analizin gücü için hazır bir formül yoksa ya da formül kaba bir yaklaşımsa (etkileşim, doğrusal olmayan model, karma yapı).
- Bir güç formülünün verdiği sonucun kendi tasarımınızda tutup tutmadığı sınanmak isteniyorsa.
- Veri üreten işlev Kod sekmesinde değiştirilerek kendi tasarımınız (dengesiz gruplar, farklı varyanslar, ilişkili açıklayıcılar) denenmek isteniyorsa.
Ne zaman kullanılmaz?
- İki grup t testi, varyans analizi, korelasyon, oran karşılaştırması gibi kapalı formülü olan testlerde: temel programdaki Güç Analizi. Formül anında ve Monte Carlo hatası olmadan sonuç verir.
- Karma modelde (kümelenmiş, tekrarlı ölçümlü veri) bir sabit etkinin gücü isteniyorsa:
karma_guc_benzetimi(Bölüm 58). - Güç değil, bir yöntemin I. tür hata oranı ya da güven aralığının kapsama oranı sorgulanıyorsa:
yontem_benzetim(Bölüm 59). - Veri toplandıktan sonra, elde edilen etkiyle "gözlenen güç" hesaplamak için: bu hesap p değerinin yeniden yazımıdır ve yeni bilgi taşımaz (Hoenig ve Heisey, 2001). Güç analizi veri toplanmadan önce, varsayılan bir etkiyle yapılır.
Temel programla ilişki. Temel programın Güç Analizi menüsü gücü merkezi olmayan dağılımlardan kapalı biçimde hesaplar. Bu şablonun iki grup t testi ve üç grup varyans analizi seçenekleri aynı tasarımları benzetimle çözer; iki sonuç yalnız Monte Carlo hatası kadar ayrışır (57.6). Lojistik etkileşim seçeneğinin temel programda karşılığı yoktur.
57.2 Şablonun girdileri
Form, üstbilgideki on üç [[param]] bloğundan kurulur (guc_benzetim.py:9–116). Şablon veri sekmesindeki veriyi kullanmaz; açık bir veri olsa da sonuç değişmez.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Model · model |
seçim · Model | lojistik_etkilesim |
iki_grup_t, anova_3, lojistik_etkilesim |
Veri üreten işlevi ve testi seçer (199). |
Etki büyüklüğü · etki |
ondalık · Model | 0,8 | −10 – 10 | t testinde Cohen d (155), varyans analizinde Cohen f (164), lojistik modelde etkileşim katsayısı \gamma (176). |
En küçük toplam n · n_min |
tamsayı · Seçenekler | 40 | 6 – 20000 | Izgaranın alt ucu (141). |
En büyük toplam n · n_max |
tamsayı · Seçenekler | 400 | 6 – 20000 | Izgaranın üst ucu (141). |
Izgara nokta sayısı · adim_sayisi |
tamsayı · Seçenekler | 6 | 2 – 30 | Eşit aralıklı n sayısı (141). |
Benzetim sayısı (her n için) · B |
tamsayı · Seçenekler | 400 | 20 – 100000 | Her ızgara noktasındaki yapay veri sayısı (154–155, 165, 173); güç paydasıdır (203). |
En çok B·n (bellek üst sınırı; 0 = sınır yok) · en_cok_bn |
tamsayı · Gelişmiş | 0 | 0 – 2000000000 | >0 iken iki grup t ve üç grup ANOVA'da B\times n_{\max} bu değeri aşarsa çalıştırma başlamadan açık iletiyle durur (142–145). |
Anlamlılık düzeyi (α) · alfa |
ondalık · Seçenekler | 0,05 | 0,0001 – 0,5 | Reddetme eşiği: p<\alpha (204). |
Karşıt hipotez (t testi) · alternatif |
seçim · Seçenekler | two-sided |
two-sided, less, greater |
Yalnız t testinde (156–158). |
Lojistik modelde kesişim · kesisim |
ondalık · Model | −0,2 | −10 – 10 | Yalnız lojistik modelde \beta_0 (176). |
x1 ana etkisi (log odds) · b_x1 |
ondalık · Model | 0,5 | −10 – 10 | Yalnız lojistik modelde \beta_1 (176). |
x2 ana etkisi (log odds) · b_x2 |
ondalık · Model | 0,5 | −10 – 10 | Yalnız lojistik modelde \beta_2 (176). |
Hedef güç · hedef_guc |
ondalık · Çıktı | 0,8 | 0,5 – 0,99 | "Gerekli n" satırının eşiği (220–226) ve şekildeki kesikli çizgi (256). |
Güç güven aralığı düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5 – 0,999 | Wilson aralığının z değeri (195–196). |
Örnek ayar (ornek_param, satır 8): B = 60, adim_sayisi = 3, n_min = 40, n_max = 120; öteki alanlar varsayılandır (lojistik etkileşim, \gamma=0{,}8). Örnek ayar hızlı çalışsın diye küçük tutulmuştur: 60 benzetimle güç ancak \mp0{,}12 kesinlikle kestirilir. Raporlanacak bir sonuç için uygun değildir.
Şablonun kendi denetimleri.
| Koşul | İleti | Satır |
|---|---|---|
n_max < n_min |
"En büyük n, en küçük n'den küçük olamaz." | 131 |
Başka denetim yoktur. Seçilen modelde kullanılmayan alanlar sessizce yok sayılır: karşıt hipotez yalnız t testinde, kesişim ve iki ana etki yalnız lojistik modelde okunur.
Tek yönlü testte yön, etkinin işaretiyle birlikte seçilir
t testinde birinci grup N(0{,}1), ikinci grup N(d,1) dağılımından üretilir (154–155). "Tek yönlü (ikinci grup büyük)" seçeneği H_1:\mu_1<\mu_2 karşıt hipotezini sınar; etki pozitif girildiğinde doğru yön budur. Aynı etkiyle "birinci grup büyük" seçilirse test yanlış kuyruğa bakar ve güç \alpha'nın çok altına düşer: d=0{,}5 ve n=64 için doğru yönde 0,630, ters yönde 0,0002 bulunur; şablon etkinin işareti ile yönün çeliştiğini bir uyarı satırıyla bildirir (237–240). Negatif etkide yönler yer değiştirir.
57.3 Örnek veri
Şablonun örnek veri dosyası yoktur: her çalıştırma veriyi kendisi üretir. Üretilen veri kaydedilmez; tabloya yalnız reddetme oranları girer.
| Model | Üretilen değişkenler | Dağılım | Test |
|---|---|---|---|
| İki grup t | a_1,\dots,a_{n/2}; b_1,\dots,b_{n/2} | a\sim N(0{,}1), b\sim N(d,1) | Havuzlanmış varyanslı t testi |
| Üç grup varyans analizi | Üç grup, her biri n/3 gözlem | N(-\delta,1), N(0{,}1), N(\delta,1); \delta=f/\sqrt{2/3} | Tek yönlü F testi |
| Lojistik etkileşim | x_1, x_2, y; n gözlem | x_1\sim N(0{,}1), x_2\sim\text{Bernoulli}(0{,}5), y\sim\text{Bernoulli}(\pi) | Etkileşim katsayısının Wald z testi |
Varsayılan lojistik ayarda (\beta_0=-0{,}2, \beta_1=\beta_2=0{,}5, \gamma=0{,}8) olayın evren olasılığı 0,505'tir: veri dengelidir. x_2=0 grubunda x_1'in eğimi 0,5, x_2=1 grubunda 0{,}5+0{,}8=1{,}3'tür; sınanan şey bu iki eğimin farkıdır.
Rastgele sayı üreteci numpy'nin default_rng üretecidir ve çalıştırmanın tohumuyla kurulur (136). Aynı tohum ve aynı ayarla sonuç son basamağa kadar yinelenir. Kod panelindeki Tohum alanı boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar, doluysa o tohumu kullanır (pro/gui/kod_panel.py:552–572); kullanılan tohum sonuç kartının künyesine ve betik adımına yazılır (Bölüm 1.3). Tohum alanı boşken art arda iki çalıştırma bu nedenle Monte Carlo hatası kadar farklı sonuç verir; aynı tohum girildiğinde ya da kaydedilmiş betik yeniden oynatıldığında aynı sonuç alınır. Tohum hiç verilmezse şablon 2026 değerini kullanır.
Bu bölümde kullanılan çalıştırmalar (aksi belirtilmedikçe tohum 2026): (1) örnek ayar; (2) varsayılan ayar (B=400, n=40–400, 6 nokta); (3) lojistik, B=2000, n=100–600, 6 nokta; (4) t testi, d=0{,}5, n=64 ve 128, B=20000; (5) aynı tasarım tek yönlü, iki yönde; (6) t testi, d=0; (7) varyans analizi, f=0{,}25, n=78 ve 156, B=20000; (8) varyans analizi, n=40–400, 6 nokta, B=400; (9) lojistik, \gamma=0, n=200 ve 400, B=2000; (10) lojistik, n=6–30; (11) örnek ayar, tohum 7 ve tohumsuz; (12) örnek ayar, güven düzeyi 0,90; (13) B=2000 ile (4) ve (7).
57.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) örneklem büyüklüğü ızgarasını kur ve grup sayısının katına indir; (2) ızgaranın her noktasında B yapay veri üret ve her birinde p değerini hesapla; (3) p<\alpha olan tekrarların B'ye oranından (kurulamayan tekrar reddedilmeyen sayılır) gücü ve Wilson aralığını çıkar; (4) hedef güce ulaşan ilk n'yi ve hedefin Monte Carlo hatası içinde kalan ilk n'yi bul; (5) tabloyu ve güç eğrisini yaz.
57.4.1 Örneklem büyüklüğü ızgarası
- K: ızgara nokta sayısı; n_i^{\circ}: eşit aralıklı ham değer. Yuvarlama numpy kuralıyladır: tam buçuklu değer en yakın çift sayıya gider.
- g: grup sayısı; varyans analizinde 3, öteki iki modelde 2 (146–149).
- \lfloor\cdot\rfloor: aşağı yuvarlama. Her grupta en az 2 gözlem bırakılır.
- Çakışan değerler tek sayılır (
np.unique); tabloda K'den az satır olabilir.
Neden grup sayısının katına indiriliyor?
Üç model de eşit büyüklükte gruplar üretir: toplam n, g'ye bölünemiyorsa artan gözlem hiçbir gruba verilemez. Şablon n'yi aşağı yuvarlar ve tabloya kullandığı değeri yazar. Varyans analizinde n_{\min}=40, n_{\max}=400 ve 6 nokta için ham ızgara 40, 112, 184, 256, 328, 400; kullanılan ızgara 39, 111, 183, 255, 327, 399'dur. Lojistik modelde gruplar yoktur (x_2 her gözlem için ayrıca çekilir), ama aynı kural uygulanır ve n çift sayıya indirilir.
57.4.2 İki grup t testi
Her grupta m=n/2 gözlem vardır. s_a^2 ve s_b^2 grup varyansları olmak üzere:
- \bar a, \bar b: grup ortalamaları; s_p^2: havuzlanmış varyans (gruplar eşit büyüklükte olduğundan iki varyansın ortalaması).
- T_{2m-2}: 2m-2 serbestlik dereceli t dağılımı.
- Tek yönlü testte p=P(T\le t) ("ikinci grup büyük") ya da p=P(T\ge t) ("birinci grup büyük").
Bu tasarımın gücü kapalı biçimde bilinir; benzetimin yaklaştığı değer budur:
- T'_{\nu}(\lambda): \nu serbestlik dereceli, \lambda merkezi olmama parametreli t dağılımı.
- t_{1-\alpha/2}: merkezi t dağılımının kritik değeri.
- d: Cohen'in d'si. Ortak standart sapma 1 alındığından ortalama farkının kendisidir.
Koddaki tercih
Test scipy.stats.ttest_ind(a, b, axis=1) ile yapılır (156–158); equal_var varsayılanı True'dur, yani Student testidir, Welch düzeltmesi yoktur. axis=1 ile B veri setinin tümü tek çağrıda sınanır: a ve b, B\times m boyutlu matrislerdir (154–155). İki yönlü testte alternative hiç verilmez; tek yönlü testte formdaki değer (less, greater) doğrudan aktarılır.
57.4.3 Üç grup varyans analizi
Grup ortalamaları -\delta, 0, +\delta ve ortak varyans 1'dir. Cohen'in f'si, grup ortalamalarının standart sapmasının hata standart sapmasına oranıdır:
- \sigma_\mu: üç grup ortalamasının (n bölenli) standart sapması; \sigma=1.
- \text{KT}_{\text{arası}}=m\sum_j(\bar y_j-\bar y)^2, \text{KT}_{\text{içi}}=\sum_j\sum_i(y_{ji}-\bar y_j)^2; m=n/3.
- F'_{2,\,n-3}(\lambda): merkezi olmayan F dağılımı.
Neden ortalamalar −δ, 0, +δ?
Aynı f değerini sonsuz sayıda ortalama düzeni verir; F testinin gücü ise yalnız \lambda=f^2n'ye bağlıdır, düzenin biçimine değil. Şablon eşit aralıklı düzeni seçer (163–165); sonuç, ortalamaların ikisi eşit biri ayrı olduğu düzenle aynı olurdu. Etki negatif girilirse düzen tersine döner ve güç değişmez; etki 0 ise oran I. tür hata oranıdır.
57.4.4 Lojistik etkileşim
- x_{1i}\sim N(0{,}1) ve x_{2i}\sim\text{Bernoulli}(0{,}5) birbirinden bağımsız çekilir.
- \gamma: etkileşim katsayısı (form: "Etki büyüklüğü"). x_1'in bir birimlik artışının log olasılık oranı x_2=0 iken \beta_1, x_2=1 iken \beta_1+\gamma'dır.
- y_i şöyle üretilir: u_i\sim\text{Tekdüze}(0{,}1) çekilir, u_i<\pi_i ise y_i=1 (177).
Her yapay veride aynı model en çok olabilirlikle kurulur ve etkileşim katsayısı Wald testiyle sınanır:
- \mathbf X: sütunları 1, x_1, x_2, x_1x_2 olan tasarım matrisi; \hat{\mathbf W}=\operatorname{diag}\{\hat\pi_i(1-\hat\pi_i)\}.
- \Phi: standart normal dağılım işlevi.
Koddaki tercih
Model statsmodels.api.Logit(y, X).fit(disp=0, maxiter=100) ile kurulur (182): Newton-Raphson, başlangıç değeri sıfır, en çok 100 adım. Bir tekrar şu durumlarda kurulamadı sayılır ve p değeri boş bırakılır (183–191): uyum yakınsamadıysa (mle_retvals["converged"]), p değeri sonlu değilse, uyum bir istisnayla kesildiyse (tekil bilgi matrisi) ya da uyum "yakınsadı" dese de en büyük katsayının mutlak değeri 30'u ya da en büyük standart hata 1000'i aşıyorsa (tam ya da yarı ayrışma: katsayılar sonsuza giderken adım sayısal olarak sıfırlanır). Uyarılar bastırılır (179–180). Döngü her tekrar için ayrı bir model kurduğundan süre B ile doğrusal artar; öteki iki model matris işlemiyle bir kerede hesaplanır.
Kurulamayan tekrarlar reddedilmeyen sayılır; payda her zaman B
Güç, kurulamayan (yakınsamayan ya da ayrışan) tekrarlar da dahil olmak üzere B tekrarın tamamı üzerinden hesaplanır (203–204): kurulamayan tekrar anlamlı sonuç vermemiştir, reddedilmeyen sayılır ve payda B kalır. Ayrışan ya da yakınsamayan veri setleri rastgele bir alt küme değildir: çoğunlukla küçük ve dengesiz örneklemlerdir; bu tekrarları paydadan atmak gücü "analiz yapılabildiyse güç" biçimine, yani çoğu zaman yukarı çekerdi. Kural çıktıda yazılır: "Kural: kurulamayan tekrar reddedilmeyen sayılır, payda B" ve kaç tekrarın yakınsamadığı, kaçının ayrıştığı (242–251). basarisiz sütunu o n'deki kurulamayan tekrar sayısıdır. Aynı kural karma model şablonunda da geçerlidir (Bölüm 58): modeli kurulamayan benzetim anlamsız sayılır.
57.4.5 Güç kestirimi ve Wilson aralığı
- k: payda; her zaman B (kurulamayan tekrar reddedilmeyen sayılır); p_b: b. tekrarın p değeri (kurulamayanda yok).
- \operatorname{SH}_{\text{MC}}: Monte Carlo standart hatası; gücün kendisindeki belirsizlik değil, sonlu B'den gelen oynaklıktır.
- z: güven düzeyine karşılık gelen normal kantil; 0,95 için 1,959964.
- Sınırlar [0{,}1] aralığına kırpılır; \hat g=0 iken alt sınır tam 0, \hat g=1 iken üst sınır tam 1 yazılır (209–210).
Neden Wilson aralığı?
Reddetme sayısı binom dağılımlıdır. Bilinen \hat g\mp z\sqrt{\hat g(1-\hat g)/k} (Wald) aralığı, oran 0'a ya da 1'e yakınken ve k küçükken kötü çalışır: \hat g=0 olduğunda genişliği sıfırdır, sınırları [0{,}1] dışına taşabilir, gerçek kapsama oranı adının altında kalır. Wilson aralığı, "g hangi değerlerde olsaydı gözlenen oran reddedilmezdi" sorusunun cevabıdır; merkezi 0,5'e doğru çekilir ve uçlarda da anlamlı kalır (Brown, Cai ve DasGupta, 2001). Güç eğrisinin iki ucu tam da bu bölgelerdir.
Kaç benzetim yeter?
Monte Carlo standart hatası en çok g=0{,}5'te, 0{,}5/\sqrt{B} kadardır. B=60: 0,065; B=400: 0,025; B=2000: 0,011; B=20000: 0,0035. Gücü \mp0{,}02 kesinlikle (yaklaşık iki standart hata) bildirmek için g=0{,}8 çevresinde B\approx1600 gerekir. Kesinliği ikiye katlamak B'yi dörde katlar.
57.4.6 Gerekli örneklem büyüklüğü
- n^{*}: ızgarada güç kestiriminin hedefe ulaştığı ilk nokta (220–224). Ara değer kestirilmez. Ayrıca kestirimi hedefin Monte Carlo hatası içinde kalan ilk nokta bildirilir: \hat g(n)\ge g_{\text{hedef}}-1{,}64\sqrt{\hat g(1-\hat g)/B} (219–221, 225–229); bu n'de hedefe ulaşılmış sayılabilir. Hiçbir noktada ikisi de sağlanmazsa şablon n_{\max}'ı artırmayı önerir (235); etki 0 girildiyse iletide reddetme oranının I. tür hata oranı olduğu yazılır (232).
- Birinci ölçüt nokta kestirimidir; ikincisi Monte Carlo standart hatasını hesaba katar (katsayı 1,64: tek yönlü %95).
Gerekli n, ızgaranın aralığı ve Monte Carlo hatası kadar belirsizdir
n^{*} iki nedenle kaba bir sayıdır. Birincisi ızgaradır: varsayılan ayarda adım 72 gözlemdir ve gerçek değer n^{*} ile bir önceki nokta arasında herhangi bir yerdedir. İkincisi Monte Carlo hatasıdır: t testinde d=0{,}5 ve n=128 için gerçek güç 0,8015'tir; B=20000 ile kestirim hedefin hemen altında (tohum 2026'da 0,7989) çıkar. Şablon bu durumda "hedefe ulaşmadı" demez, kestirimin hedefin Monte Carlo hatası içinde kaldığı en küçük n'yi yazar. Gerekli n raporlanırken yine ızgara hedefin çevresinde daraltılır, B büyütülür ve aralığın alt sınırının hedefi geçtiği nokta esas alınır.
57.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–117 | Üstbilgi: kimlik, açıklama, örnek ayar, on üç parametre. | Form buradan kurulur (Bölüm 1.2). |
| 118–124 | matplotlib, scipy.stats; dil yardımcısı _m. |
np, pd, mq, P ad alanında hazırdır (Bölüm 1.3). |
| 127 | Rastgele sayı üreteci: default_rng(mq.seed); tohum yoksa 2026. |
Bütün çekilişler bu tek üreteçten, sırayla yapılır. |
| 128–136 | Parametreler; n_{\max}<n_{\min} denetimi; ızgara ve grup sayısının katına indirme. | Tabloya indirilmiş n yazılır. |
| 139–153 | p_t ve p_anova: B\times m matrisleri üretir, testi satır satır uygular. |
Bellek B\cdot n ile büyür: B=20000, n=128 için 20 MB; iki sınır birlikte uca çekilirse bellek yetmez. "En çok B·n" alanı 0'dan büyükse B\times n_{\max} bu sınırı aşan çalıştırma belleğe girmeden açık iletiyle durur; varsayılan 0 sınır koymaz. |
| 156–179 | p_lojistik: B kez veri üret, Logit kur, etkileşimin p değerini al; yakınsamayan ve ayrışan tekrarları say. |
Kurulamayan tekrarın p değeri nan kalır; sayılar sayac sözlüğünde. |
| 182–186 | Wilson için z; hedef güç; sayaç; model adından işleve eşleme. | Güven düzeyi tam 0,95 ise z sabit yazılır (196). |
| 187–198 | Izgara döngüsü: payda B, güç, Wilson sınırları, başarısız sayısı. | Payda hiçbir durumda küçülmez; güç 0 iken alt sınır tam 0 (209). |
| 200–238 | Özet satırı; gerekli n (nokta kestirimi ve Monte Carlo hatası içinde), "ulaşılmadı" ya da I. tür hata iletisi; ters yön uyarısı; kurulamayan tekrar kuralı ve sayıları. | Kural satırı lojistik modelde her zaman yazılır. |
| 240–251 | Güç eğrisi: nokta ve çizgi, Wilson bandı, hedef çizgisi; tablo ve şekil. | Tablo tam hassasiyetle saklanır. |
Kritik satırlar:
rng = np.random.default_rng(mq.seed if mq.seed is not None else 2026)
…
gecerli = p[np.isfinite(p)]
k = gecerli.size
g = float(np.mean(gecerli < alfa))
m = (g + z * z / (2 * k)) / (1 + z * z / k)
h = z * np.sqrt(g * (1 - g) / k + z * z / (4 * k * k)) / (1 + z * z / k)
Aynı n için sonuç, ızgaranın geri kalanına bağlıdır
Izgara noktaları aynı üreteçten art arda beslenir: n=80 için kullanılan rastgele sayılar, daha önce n=40 için kaç sayı tüketildiğine bağlıdır. Izgara ya da B değiştirildiğinde aynı tohumla aynı n için farklı bir kestirim çıkar (fark Monte Carlo hatası içindedir). Buna karşılık hedef güç ve güven düzeyi çekilişleri etkilemez: bu ikisi değiştirildiğinde güç sütunu aynı kalır, yalnız aralık ve "gerekli n" satırı değişir.
57.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bağımsız hesap dogrulama/guc_benzetim/elle_hesap.py ile yapılmıştır. Benzetimin şablonla aynı sayıları vermesi için aynı çekilişler gerekir: numpy üreteci aynı tohumla (2026) kurulmuş, çekilişler şablondaki sırayla yapılmıştır. Testler ise bağımsızdır: ttest_ind, f_oneway ve Logit kullanılmamış; t ve F istatistikleri açık formülle, p değerleri tamamlanmamış beta işlevinden, lojistik model kendi Newton-Raphson döngüsüyle hesaplanmıştır. R tarafında (r_dogrulama.R) aynı yapay veriler dosyadan okunmuş ve R'nin kendi işlevleriyle sınanmıştır (glm, t.test, oneway.test); Wilson aralığı prop.test(correct = FALSE) ile alınmıştır.
Adım 1 — Izgara. Örnek ayar: n_{\min}=40, n_{\max}=120, K=3. Ham değerler 40, 80, 120; hepsi çifttir ve değişmez.
Adım 2 — İlk yapay veri (n=40). Tohum 2026 ile ilk üç gözlem: x_1 = −0,7931; 0,2406; −1,8963 ve x_2 = 0; 0; 0. Birinci gözlemde \eta=-0{,}2+0{,}5\times(-0{,}7931)=-0{,}5966, \pi=1/(1+e^{0{,}5966})=0{,}3551. İlk üç yanıt 0, 1, 0'dır. Kırk gözlemin 19'unda x_2=1, 18'inde y=1'dir.
Adım 3 — Model ve Wald testi. Newton-Raphson 5 adımda yakınsar:
| Kesişim | x_1 | x_2 | x_1x_2 | |
|---|---|---|---|---|
| Kestirim | −0,3471 | 1,0721 | 0,1896 | −0,6401 |
| SH | 0,4850 | 0,6333 | 0,6770 | 0,9045 |
Gerçek etkileşim +0{,}8 iken bu veride kestirim -0{,}64 çıkmıştır: 40 gözlemde etkileşim katsayısının standart hatası (0,90) etkinin kendisinden büyüktür. Tekrar "reddetmedi" olarak sayılır.
Adım 4 — Güç. Altmış tekrarın 3'ünde p<0{,}05'tir: \hat g(40)=3/60=0{,}05. Aynı biçimde \hat g(80)=12/60=0{,}20 ve \hat g(129)=19/60=0{,}3167.
Adım 5 — Wilson aralığı (n=80). \hat g=0{,}2, k=60, z^2=3{,}841459:
Aralık [0{,}118285;\ 0{,}317818]'dir. Aynı veriyle Wald aralığı [0{,}0988;\ 0{,}3012] olurdu: Wilson aralığı 0,5'e doğru kaymıştır.
Adım 6 — t testinin ilk tekrarı (çalıştırma 13, n=64). \bar a=0{,}0028, \bar b=0{,}5578, s_p^2=0{,}8063:
Adım 7 — Kapalı biçimli güç. d=0{,}5, m=32: \lambda=0{,}5\sqrt{16}=2, t_{0{,}975;\,62}=1{,}99897; güç 0,503638. m=64: \lambda=2{,}8284; güç 0,801460. Varyans analizinde f=0{,}25, n=78: \lambda=0{,}0625\times78=4{,}875, F_{0{,}95;\,2,\,75}=3{,}1186; güç 0,476531; n=156: 0,796733. Gücün 0,80'i geçtiği en küçük grup büyüklüğü t testinde 64 (toplam 128), varyans analizinde 53'tür (toplam 159).
57.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun güç tablosundan tam hassasiyetle alınmıştır. Üç yol aynı yapay verileri kullanır; fark yalnız testlerin hesaplanma biçimindedir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Lojistik, örnek ayar, n=40: güç | 0,05 | 0,05 | 0,05 | 0 | ✓ |
| Lojistik, örnek ayar, n=40: Wilson alt | 0,0171495 | 0,0171495 | 0,0171495 | 8,0e−17 | ✓ |
| Lojistik, örnek ayar, n=40: Wilson üst | 0,13700516 | 0,13700516 | 0,13700516 | 0 | ✓ |
| Lojistik, örnek ayar, n=80: güç | 0,2 | 0,2 | 0,2 | 0 | ✓ |
| Lojistik, örnek ayar, n=80: Wilson alt | 0,11828505 | 0,11828505 | 0,11828505 | 1,1e−16 | ✓ |
| Lojistik, örnek ayar, n=80: Wilson üst | 0,31781806 | 0,31781806 | 0,31781806 | 1,1e−16 | ✓ |
| Lojistik, örnek ayar, n=120: güç | 0,31666667 | 0,31666667 | 0,31666667 | 1,1e−16 | ✓ |
| Lojistik, örnek ayar, n=120: Wilson alt | 0,21305868 | 0,21305868 | 0,21305868 | 0 | ✓ |
| Lojistik, örnek ayar, n=120: Wilson üst | 0,44233767 | 0,44233767 | 0,44233767 | 5,6e−17 | ✓ |
| Lojistik, tohum 7, n=40: güç | 0,08333333 | 0,08333333 | — | 2,8e−17 | ✓ |
| Lojistik, tohum 7, n=40: başarısız tekrar | 1 | 1 | — | 0 | ✓ |
| Lojistik, tohum 7, n=80: güç | 0,25 | 0,25 | — | 0 | ✓ |
| Lojistik, tohum 7, n=80: başarısız tekrar | 0 | 0 | — | 0 | ✓ |
| Lojistik, tohum 7, n=120: güç | 0,2 | 0,2 | — | 0 | ✓ |
| Lojistik, tohum 7, n=120: başarısız tekrar | 0 | 0 | — | 0 | ✓ |
| Lojistik, %90 aralık, n=40: Wilson alt | 0,02015699 | 0,02015699 | 0,02015699 | 6,9e−17 | ✓ |
| Lojistik, %90 aralık, n=40: Wilson üst | 0,11867513 | 0,11867513 | 0,11867513 | 1,4e−17 | ✓ |
| Lojistik, %90 aralık, n=80: Wilson alt | 0,12885459 | 0,12885459 | 0,12885459 | 0 | ✓ |
| Lojistik, %90 aralık, n=80: Wilson üst | 0,29703349 | 0,29703349 | 0,29703349 | 1,1e−16 | ✓ |
| Lojistik, %90 aralık, n=120: Wilson alt | 0,22762816 | 0,22762816 | 0,22762816 | 1,1e−16 | ✓ |
| Lojistik, %90 aralık, n=120: Wilson üst | 0,42152566 | 0,42152566 | 0,42152566 | 1,7e−16 | ✓ |
| t testi, B=2000, n=64: güç | 0,521 | 0,521 | 0,521 | 0 | ✓ |
| t testi, B=2000, n=64: Wilson alt | 0,49908697 | 0,49908697 | 0,49908697 | 8,3e−16 | ✓ |
| t testi, B=2000, n=64: Wilson üst | 0,54283251 | 0,54283251 | 0,54283251 | 8,9e−16 | ✓ |
| t testi, B=2000, n=128: güç | 0,797 | 0,797 | 0,797 | 0 | ✓ |
| t testi, B=2000, n=128: Wilson alt | 0,77881005 | 0,77881005 | 0,77881005 | 1,2e−15 | ✓ |
| t testi, B=2000, n=128: Wilson üst | 0,81405123 | 0,81405123 | 0,81405123 | 1,3e−15 | ✓ |
| Varyans analizi, B=2000, n=78: güç | 0,493 | 0,493 | 0,493 | 0 | ✓ |
| Varyans analizi, B=2000, n=78: Wilson alt | 0,47112351 | 0,47112351 | 0,47112351 | 1,1e−16 | ✓ |
| Varyans analizi, B=2000, n=78: Wilson üst | 0,51490333 | 0,51490333 | 0,51490333 | 0 | ✓ |
| Varyans analizi, B=2000, n=156: güç | 0,782 | 0,782 | 0,782 | 0 | ✓ |
| Varyans analizi, B=2000, n=156: Wilson alt | 0,76337341 | 0,76337341 | 0,76337341 | 3,1e−15 | ✓ |
| Varyans analizi, B=2000, n=156: Wilson üst | 0,79954538 | 0,79954538 | 0,79954538 | 3,1e−15 | ✓ |
| t testi, B=20000, n=64: güç | 0,5036 | 0,5036 | — | 0 | ✓ |
| t testi, B=20000, n=64: Wilson alt | 0,49667063 | 0,49667063 | 0,49667063 | 3,8e−15 | ✓ |
| t testi, B=20000, n=64: Wilson üst | 0,51052798 | 0,51052798 | 0,51052798 | 3,9e−15 | ✓ |
| t testi, B=20000, n=128: güç | 0,79885 | 0,79885 | — | 0 | ✓ |
| t testi, B=20000, n=128: Wilson alt | 0,79323731 | 0,79323731 | 0,79323731 | 1,4e−15 | ✓ |
| t testi, B=20000, n=128: Wilson üst | 0,80434791 | 0,80434791 | 0,80434791 | 1,3e−15 | ✓ |
| t testi, tek yönlü, n=64: güç | 0,6303 | 0,6303 | — | 0 | ✓ |
| t testi, tek yönlü, n=128: güç | 0,8788 | 0,8788 | — | 0 | ✓ |
| t testi, d=0, n=64: güç | 0,0483 | 0,0483 | — | 0 | ✓ |
| t testi, d=0, n=128: güç | 0,0496 | 0,0496 | — | 0 | ✓ |
| Varyans analizi, B=20000, n=78: güç | 0,47735 | 0,47735 | — | 0 | ✓ |
| Varyans analizi, B=20000, n=78: Wilson alt | 0,47043261 | 0,47043261 | 0,47043261 | 1,7e−15 | ✓ |
| Varyans analizi, B=20000, n=78: Wilson üst | 0,48427609 | 0,48427609 | 0,48427609 | 1,7e−15 | ✓ |
| Varyans analizi, B=20000, n=156: güç | 0,80175 | 0,80175 | — | 0 | ✓ |
| Varyans analizi, B=20000, n=156: Wilson alt | 0,79616694 | 0,79616694 | 0,79616694 | 3,8e−15 | ✓ |
| Varyans analizi, B=20000, n=156: Wilson üst | 0,80721717 | 0,80721717 | 0,80721717 | 3,8e−15 | ✓ |
| Lojistik, varsayılan ayar, n=40: güç | 0,0675 | 0,0675 | — | 0 | ✓ |
| Lojistik, varsayılan ayar, n=40: başarısız tekrar | 7 | 7 | — | 0 | ✓ |
| Lojistik, varsayılan ayar, n=112: güç | 0,3425 | 0,3425 | — | 0 | ✓ |
| Lojistik, varsayılan ayar, n=112: başarısız tekrar | 0 | 0 | — | 0 | ✓ |
| Lojistik, varsayılan ayar, n=184: güç | 0,5675 | 0,5675 | — | 0 | ✓ |
| Lojistik, varsayılan ayar, n=184: başarısız tekrar | 0 | 0 | — | 0 | ✓ |
| Lojistik, varsayılan ayar, n=256: güç | 0,66 | 0,66 | — | 0 | ✓ |
| Lojistik, varsayılan ayar, n=256: başarısız tekrar | 0 | 0 | — | 0 | ✓ |
| Lojistik, varsayılan ayar, n=328: güç | 0,7875 | 0,7875 | — | 0 | ✓ |
| Lojistik, varsayılan ayar, n=328: başarısız tekrar | 0 | 0 | — | 0 | ✓ |
| Lojistik, varsayılan ayar, n=400: güç | 0,8875 | 0,8875 | — | 0 | ✓ |
| Lojistik, varsayılan ayar, n=400: başarısız tekrar | 0 | 0 | — | 0 | ✓ |
| Lojistik, B=2000, n=100: güç | 0,2995 | 0,2995 | — | 0 | ✓ |
| Lojistik, B=2000, n=100: Wilson alt | 0,27982586 | 0,27982586 | 0,27982586 | 7,2e−16 | ✓ |
| Lojistik, B=2000, n=100: Wilson üst | 0,31994288 | 0,31994288 | 0,31994288 | 7,2e−16 | ✓ |
| Lojistik, B=2000, n=200: güç | 0,5785 | 0,5785 | — | 0 | ✓ |
| Lojistik, B=2000, n=200: Wilson alt | 0,55672843 | 0,55672843 | — | 5,6e−16 | ✓ |
| Lojistik, B=2000, n=200: Wilson üst | 0,59997059 | 0,59997059 | — | 5,6e−16 | ✓ |
| Lojistik, B=2000, n=300: güç | 0,7695 | 0,7695 | — | 0 | ✓ |
| Lojistik, B=2000, n=300: Wilson alt | 0,75053632 | 0,75053632 | — | 5,6e−16 | ✓ |
| Lojistik, B=2000, n=300: Wilson üst | 0,78743039 | 0,78743039 | — | 5,6e−16 | ✓ |
| Lojistik, B=2000, n=400: güç | 0,881 | 0,881 | — | 0 | ✓ |
| Lojistik, B=2000, n=400: Wilson alt | 0,86607401 | 0,86607401 | 0,86607401 | 2,2e−16 | ✓ |
| Lojistik, B=2000, n=400: Wilson üst | 0,8944652 | 0,8944652 | 0,8944652 | 2,2e−16 | ✓ |
| Lojistik, B=2000, n=500: güç | 0,931 | 0,931 | — | 0 | ✓ |
| Lojistik, B=2000, n=500: Wilson alt | 0,91904578 | 0,91904578 | — | 7,8e−16 | ✓ |
| Lojistik, B=2000, n=500: Wilson üst | 0,94130173 | 0,94130173 | — | 1,0e−15 | ✓ |
| Lojistik, B=2000, n=600: güç | 0,9725 | 0,9725 | — | 0 | ✓ |
| Lojistik, B=2000, n=600: Wilson alt | 0,96437689 | 0,96437689 | — | 2,9e−15 | ✓ |
| Lojistik, B=2000, n=600: Wilson üst | 0,9788115 | 0,9788115 | — | 2,9e−15 | ✓ |
Ölçütü karşılayan: 79/79. Python: aynı numpy akışı; t ve F açık formülle, p değerleri tamamlanmamış beta işlevinden, lojistik model kendi Newton-Raphson döngüsüyle (ttest_ind, f_oneway, Logit kullanılmadan). R: aynı yapay veriler üzerinde glm, t.test, oneway.test; Wilson aralığı prop.test(correct = FALSE). R sütunu boş olan satırlarda yapay veri R'ye aktarılmamıştır.
İkinci denetim istatistikseldir: benzetimin verdiği güç, kapalı biçimli değerle Monte Carlo standart hatası içinde tutmalıdır. Aşağıdaki tabloda \operatorname{SH}_{\text{MC}}=\sqrt{g(1-g)/B} analitik güçten hesaplanmış, son sütunda fark bu standart hataya bölünmüştür; mutlak değeri 3'ü aşmayan satır uyumlu sayılır.
| Tasarım | Benzetim | B | Kesin (Python) | Kesin (R) | SHMC | Fark / SH | |
|---|---|---|---|---|---|---|---|
| t testi, iki yönlü, n=64 | 0,5036 | 20000 | 0,503638 | 0,503638 | 0,00354 | −0,01 | ✓ |
| t testi, iki yönlü, n=128 | 0,79885 | 20000 | 0,80146 | 0,80146 | 0,00282 | −0,93 | ✓ |
| t testi, tek yönlü, n=64 | 0,6303 | 20000 | 0,630527 | 0,630527 | 0,00341 | −0,07 | ✓ |
| t testi, tek yönlü, n=128 | 0,8788 | 20000 | 0,878664 | 0,878664 | 0,00231 | +0,06 | ✓ |
| t testi, d=0, n=64 | 0,0483 | 20000 | 0,05 | 0,05 | 0,00154 | −1,10 | ✓ |
| t testi, d=0, n=128 | 0,0496 | 20000 | 0,05 | 0,05 | 0,00154 | −0,26 | ✓ |
| Varyans analizi, n=78 | 0,47735 | 20000 | 0,476531 | 0,476531 | 0,00353 | +0,23 | ✓ |
| Varyans analizi, n=156 | 0,80175 | 20000 | 0,796733 | 0,796733 | 0,00285 | +1,76 | ✓ |
| Varyans analizi, n=39 | 0,245 | 400 | 0,248851 | — | 0,02162 | −0,18 | ✓ |
| Varyans analizi, n=111 | 0,63 | 400 | 0,638261 | — | 0,02403 | −0,34 | ✓ |
| Varyans analizi, n=183 | 0,875 | 400 | 0,860771 | — | 0,01731 | +0,82 | ✓ |
| Varyans analizi, n=255 | 0,945 | 400 | 0,953775 | — | 0,0105 | −0,84 | ✓ |
| Varyans analizi, n=327 | 0,9925 | 400 | 0,986202 | — | 0,00583 | +1,08 | ✓ |
| Varyans analizi, n=399 | 0,9975 | 400 | 0,996203 | — | 0,00308 | +0,42 | ✓ |
| t testi, n=64 | 0,521 | 2000 | 0,503638 | 0,503638 | 0,01118 | +1,55 | ✓ |
| t testi, n=128 | 0,797 | 2000 | 0,80146 | 0,80146 | 0,00892 | −0,50 | ✓ |
Ölçütü karşılayan: 16/16. Kesin değer: merkezi olmayan t ve F dağılımları (Python scipy.stats.nct, ncf; R pt, pf ve pwr paketi). d=0 satırlarında kesin değer \alpha'dır.
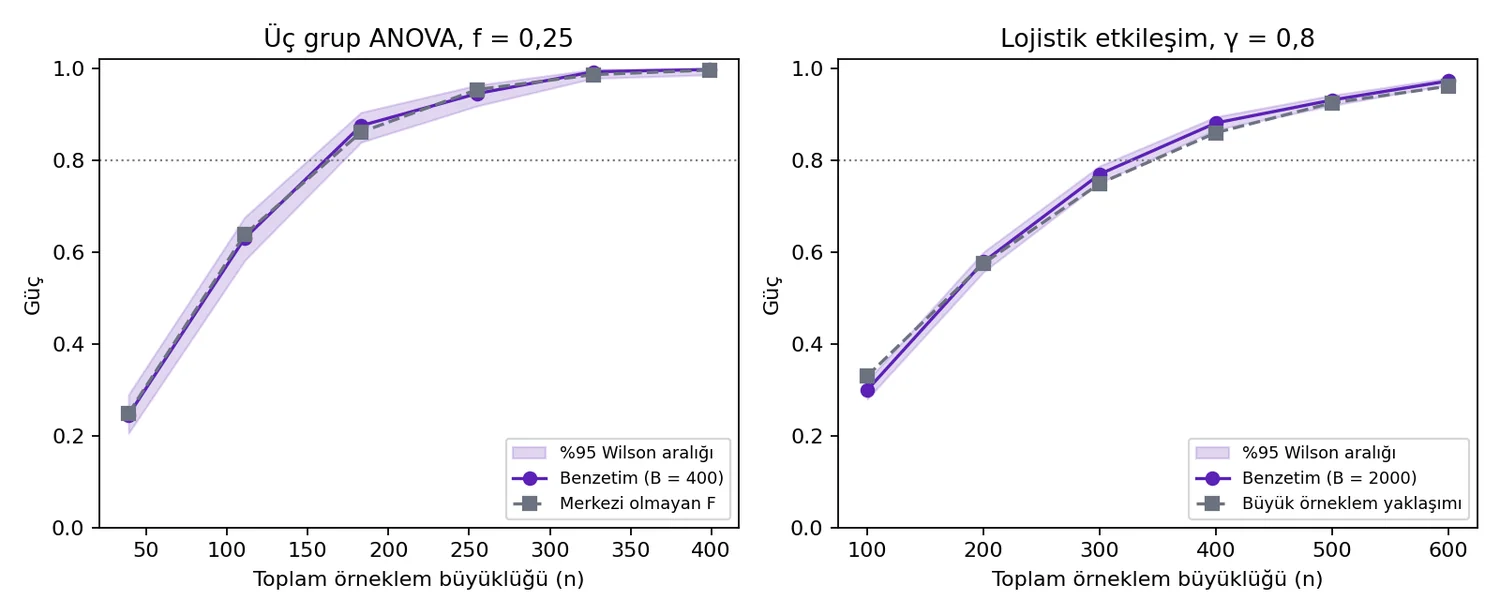
Lojistik etkileşimin kapalı güç formülü yoktur; karşılaştırma için beklenen Fisher bilgisine dayanan büyük örneklem yaklaşımı kullanılmıştır. Bilgi matrisi \mathbf I=E\big[\pi(1-\pi)\,\mathbf x\mathbf x^{\top}\big], x_1 üzerinde sayısal tümlevle ve x_2'nin iki değeri üzerinden ortalamayla bulunur; \hat\gamma'nın standart hatası yaklaşık s_1/\sqrt n, s_1=\sqrt{[\mathbf I^{-1}]_{44}}=5{,}2646 ve güç \Phi(\gamma\sqrt n/s_1-z_{1-\alpha/2})+\Phi(-\gamma\sqrt n/s_1-z_{1-\alpha/2})'dir. Yaklaşım benzetimden en çok 0,03 ayrılır: n=100'de 0,330'a karşı 0,300 (yaklaşım yüksek), n=400'de 0,860'a karşı 0,881 (yaklaşım düşük); eğrinin biçimi aynıdır (Şekil 57.2). Yaklaşıma göre 0,80 güç için gereken örneklem 340'tır; benzetimde güç n=300'de 0,770, n=400'de 0,881'dir.
Varsayılan ayarın n=40 noktasında 400 yapay verinin 7'si tam ayrışmıştır (doğrusal programlamayla ayrıca sınanmıştır: ayrisma_denetim.py). Bağımsız Newton-Raphson döngüsü yedisinde de yakınsamaz. Şablonun çağırdığı uyum altısında yakınsamadı bilgisini döndürür; birinde (209. tekrar) katsayılar 435 ve 942'ye ulaştıktan sonra adım büyüklüğü sayısal olarak sıfırlanır ve uyum "yakınsadı" der, ama katsayı eşiği (30) aşıldığı için şablon bu tekrarı da ayrışmış sayar. Yedisi de kurulamayan sayılır ve reddedilmeyen kabul edilir: şablonun gücü 27/400=0{,}0675, bağımsız hesabınki de 27/400'dür; basarisiz 7'dir.
57.7 Çıktıyı okuma
Varsayılan ayarın çıktısı (çalıştırma 2; tablo dört ondalığa yuvarlanmış):
Model: lojistik etkileşim; etki = 0,8; α = 0,05; her n için 400 benzetim.
Gücün 0,80'e ulaştığı en küçük toplam n (ızgarada, güç kestirimi ≥ hedef): 400
Güç kestirimi hedefin Monte Carlo hatası içinde (güç ≥ hedef − 1,64·SH) kalan en küçük toplam n: 328; bu n'de hedef güç ulaşılmış sayılabilir, kesinleştirmek için benzetim sayısını artırın.
Not: 7 tekrarda lojistik model kurulamadı (6 yakınsamadı ya da hata, 1 tam/yarı ayrışma). Kural: bu tekrarlar reddedilmeyen (anlamlı bulunmayan) sayılır ve payda her n için 400 olarak kalır; güç = reddedilen / 400.

Güç tablosu
  n     guc  ga_alt  ga_ust  basarisiz
 40  0.0675  0.0468  0.0964          7
112  0.3425  0.2977  0.3903          0
184  0.5675  0.5185  0.6152          0
256  0.6600  0.6123  0.7047          0
328  0.7875  0.7448  0.8248          0
400  0.8875  0.8528  0.9149          0
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Özet satırı | Model, etki, \alpha, her n için benzetim sayısı | Etki, seçilen modelin ölçeğindedir (d, f ya da log olasılık oranı). |
| "Gücün … ulaştığı en küçük toplam n" | Izgarada güç kestiriminin hedefi geçtiği ilk nokta | Gerçek değer bu nokta ile bir önceki arasındadır: burada 328 ile 400 arası. |
| "… Monte Carlo hatası içinde …" | Kestirimi hedefin 1,64 standart hatası içinde kalan ilk nokta | Birinci satırdan önce de görünebilir; o n'de hedefe ulaşılmış sayılabilir. Burada 328 (\hat g=0{,}7875; hedef − 1,64·SH =0{,}766). |
| Not satırı | Bütün ızgaradaki kurulamayan tekrarların toplamı, nedenleriyle, ve kural | Yalnız lojistik modelde görülür. Hangi n'de olduğu basarisiz sütunundadır. Kurulamayan tekrar reddedilmeyen sayılır, payda B. |
n |
Kullanılan toplam örneklem büyüklüğü | Grup sayısının katına indirilmiş değerdir. |
guc |
p<\alpha olan tekrarların B'ye oranı | Gücün Monte Carlo kestirimi; kurulamayan tekrar reddedilmeyen sayılmıştır. |
ga_alt, ga_ust |
Wilson aralığı | Yalnız benzetim sayısından gelen belirsizlik. Etki büyüklüğü varsayımının belirsizliğini içermez. |
basarisiz |
Kurulamayan (yakınsamayan ya da ayrışan) tekrar sayısı | Sıfırdan büyükse güç, bu tekrarların reddedilmeyen sayıldığı tutucu bir değerdir (57.4.4). |
Şekil 57.1. Şablonun şekli (varsayılan ayar): güç eğrisi, %95 Wilson bandı ve hedef güç (kesikli çizgi). Eğri hedefi 328 ile 400 arasında keser.
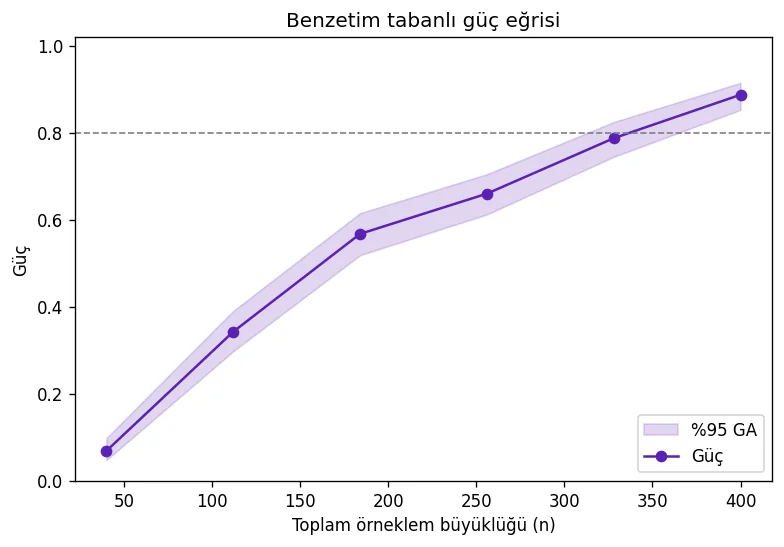
Eğri düzgün artmak zorunda değildir: her nokta ayrı bir Monte Carlo kestirimidir ve komşu noktalar birbirinden bağımsız oynar. Bant genişse (örnek ayarda \mp0{,}12) eğrinin biçimi yorumlanmaz; önce B büyütülür.
Şekil 57.2. Benzetim ile kapalı biçimin karşılaştırması. Sol: üç grup varyans analizi (f=0{,}25; çalıştırma 8); kesikli çizgi merkezi olmayan F dağılımından hesaplanan güçtür ve altı noktanın hepsinde Wilson bandının içindedir. Sağ: lojistik etkileşim (çalıştırma 3); kesikli çizgi büyük örneklem yaklaşımıdır.
Örnek ayarın çıktısı (çalıştırma 1) aynı biçimdedir; B=60 olduğundan aralıklar çok geniştir:
Model: lojistik etkileşim; etki = 0,8; α = 0,05; her n için 60 benzetim.
Izgaradaki hiçbir n'de güç 0,80'e ulaşmadı (Monte Carlo hatası payı dahil); n_max'ı artırın.
Kural: kurulamayan (yakınsamayan ya da ayrışan) tekrar reddedilmeyen sayılır, payda 60; bu çalıştırmada böyle tekrar olmadı.

Güç tablosu
  n     guc  ga_alt  ga_ust  basarisiz
 40  0.0500  0.0171  0.1370          0
 80  0.2000  0.1183  0.3178          0
120  0.3167  0.2131  0.4423          0
Aynı ayar tohum 7 ile çalıştırıldığında güçler 0,085; 0,250; 0,200 çıkar: 60 benzetimle eğrinin yönü bile güvenilir değildir.
Rapor cümlesi (çalıştırma 3):
Lojistik regresyonda sürekli bir açıklayıcı ile ikili bir açıklayıcının etkileşiminin (log olasılık oranı 0,8; kesişim −0,2; ana etkiler 0,5) Wald testiyle saptanma gücü benzetimle kestirildi (her örneklem büyüklüğü için 2000 yapay veri, α = 0,05, tohum 2026). Güç n = 300'de 0,770 (%95 Wilson GA [0,751; 0,787]), n = 400'de 0,881 (GA [0,866; 0,894]) bulundu; 0,80 güç için gereken örneklem büyüklüğü 300 ile 400 arasındadır. Hiçbir yapay veride yakınsama sorunu görülmedi.
57.8 Sık hatalar ve tuzaklar
- Örnek ayarı rapor için kullanmak. Altmış benzetimle gücün standart hatası 0,06'dır. Raporlanacak çalıştırmada B en az 1000 alınır.
- Gerekli n'yi tek bir çalıştırmadan okumak. n^{*} ızgara adımı kadar kaba ve Monte Carlo hatasına açıktır. Hedefin çevresinde dar bir ızgara ve büyük B ile yinelenir.
- Tohumu kaydetmemek. Tohum alanı boşsa her çalıştırmaya yeni bir tohum atanır; kullanılan tohum künyede yazar. Sonucun yinelenebilmesi için künyedeki tohum Tohum alanına girilir ya da çalıştırma betiğe kaydedilir; iki çalıştırma arasındaki farkın Monte Carlo hatası olduğu unutulmaz.
- Etkinin ölçeğini karıştırmak. Aynı kutuya t testinde d, varyans analizinde f, lojistik modelde log olasılık oranı yazılır. Varsayılan 0,8 değeri d için "büyük" etkidir; f için olağanüstü büyüktür (f=0{,}40 zaten büyük sayılır); log olasılık oranı olarak olasılık oranı 2,23'e karşılık gelir.
- Toplam n'yi grup başına n sanmak. Bütün alanlar ve tablo toplam örneklem büyüklüğüyle çalışır. Kaynaklardaki tablolar çoğunlukla grup başına n verir: d=0{,}5 için "64" grup başınadır, şablonda 128'e karşılık gelir.
- Eşit olmayan gruplar ya da varyanslar için hazır modelleri kullanmak. Üç tasarım da dengelidir ve eş varyanslıdır. Gerçek çalışma dengesiz olacaksa güç daha düşüktür; üretici işlev Kod sekmesinde değiştirilir.
- Lojistik modelde kesişimi ve ana etkileri varsayılanda bırakmak. Etkileşimin gücü yalnız \gamma'ya değil, olayın ne sıklıkta görüldüğüne ve x_1'in ana etkisine de bağlıdır. Olay seyrekse aynı n çok daha az bilgi taşır.
- Küçük n'de başarısız tekrarları görmezden gelmek.
basarisizsütunu büyükse tablodaki güç, kurulamayan tekrarların reddedilmeyen sayıldığı tutucu bir değerdir; gerçek analizde de o veri setlerinden sonuç çıkmayacaktır. - Güven aralığını etki belirsizliği sanmak. Wilson aralığı, etki tam varsayıldığı gibiyken benzetimin oynaklığını gösterir. Etki varsayımı yanlışsa aralık dar olsa da güç yanlıştır. Birkaç etki büyüklüğüyle duyarlılık analizi yapılır.
- Tek yönlü testte ters yönü seçmek. Güç sıfıra yakın çıkar; şablon bir uyarı satırı yazar (57.2).
57.9 Uzman soruları
S1. Benzetim gücü kapalı biçimli güçle tam aynı olmalı mı?
Hayır; Monte Carlo standart hatası kadar ayrışır. t testinde d=0{,}5, n=64 ve 128 için analitik güç 0,503638 ve 0,801460; B=20000 ile benzetim 0,50360 ve 0,79885'tir. Farklar −0,00004 ve −0,0026; standart hatalar 0,0035 ve 0,0028. Varyans analizinde (f=0{,}25; n=78 ve 156) analitik 0,476531 ve 0,796733, benzetim 0,47735 ve 0,80175'tir; ikinci fark 1,8 standart hatadır. On altı karşılaştırmanın hiçbirinde fark iki standart hatayı aşmaz (57.6.1). Sistematik bir sapma, üretici işlev ile testin aynı modeli anlatmadığını gösterirdi.
S2. Yakınsamayan uyumlar neden anlamsız sayılıyor; paydadan çıkarılması daha doğru olmaz mı?
İki tanım iki ayrı soruyu cevaplar. Paydadan çıkarmak "analiz yapılabildiğinde güç nedir" sorusunu, anlamsız saymak "bu çalışmayı planlarsam anlamlı bir sonuç bildirme olasılığım nedir" sorusunu cevaplar. Planlama için ikincisi daha dürüsttür ve şablon onu hesaplar: kurulamayan tekrar reddedilmeyen sayılır, payda B kalır (203–204); kaç tekrarın kurulamadığı çıktıda ve basarisiz sütunundadır. Paydadan çıkarılmış değer \hat g\cdot B/(B-\text{basarisiz}) ile tablodan elde edilir. Varsayılan ayarda n\ge112 için hiç başarısız tekrar yoktur ve iki tanım aynıdır. Çok küçük örneklemde fark büyüktür: n=6'da 400 tekrarın hemen hepsi kurulamaz ve paydadan çıkarılan güç birkaç veri setinden hesaplanırdı.
S3. Tam ayrışma nasıl ele alınıyor?
Ayrışmada en çok olabilirlik kestirimi sonlu değildir (Albert ve Anderson, 1984): katsayılar her adımda büyür ve Newton-Raphson 100 adımda durmaz; statsmodels yakınsamadı bilgisini döndürür ya da bilgi matrisi tekilleşir ve istisna oluşur. Her iki durumda tekrar başarısız sayılır. Seyrek olarak üçüncü bir yol görülür: katsayılar çok büyüdüğünde kestirilen olasılıklar tam 0 ve 1 olur, adım sayısal olarak sıfırlanır ve uyum "yakınsadı" bilgisiyle döner; standart hata astronomik, p değeri 1'dir. Şablon bu üçüncü yolu da yakalar: "yakınsadı" denmiş olsa bile en büyük katsayı mutlak değerce 30'u ya da en büyük standart hata 1000'i aşıyorsa tekrar ayrışmış sayılır; ayrışan ve yakınsamayan tekrarlar birlikte kurulamayan sayılır, reddedilmeyen kabul edilir ve çıktıda ayrı ayrı yazılır. Tohum 2026 ile n=40'ta ayrışan 7 veri setinin tamamı kurulamayan sayılır (eskiden biri p=1 ile paydada kalıyordu). Taranan 2400 yapay veride kurulamayan sayılan her tekrar gerçekten ayrışmıştır (ya da tasarım matrisi tekildir) ve ayrışmış hiçbir tekrar anlamlı sonuç vermemiştir.
S4. Wald testi yerine olabilirlik oranı testi kullanılsa güç değişir mi?
Büyük örneklemde iki test eşdeğerdir; küçük örneklemde ve büyük etkilerde Wald testi güç kaybeder, çünkü katsayı büyüdükçe standart hatası daha hızlı büyür (Hauck-Donner etkisi). Şablon, uygulamada en çok raporlanan testi, katsayı tablosundaki Wald z'yi kullanır (188–189). Analizde olabilirlik oranı testi planlanıyorsa p_lojistik işlevinde iki model kurulup llr farkı sınanacak biçimde değiştirilir; güç analizi, raporlanacak testle yapılmalıdır.
S5. Etki sıfır girildiğinde ne elde edilir?
Testin I. tür hata oranı. t testinde (B=20000) 0,0483 ve 0,0496; lojistik etkileşimde (B=2000) n=200 için 0,0535, n=400 için 0,0485 bulunur; hepsi 0,05'in iki standart hatası içindedir. Bu, benzetimin doğru kurulduğunun en ucuz denetimidir: oran \alpha'dan belirgin biçimde büyükse test o tasarımda geçerli değildir ve güç hesabı anlamsızdır. Şablon etki sıfırken de "güç" sözcüğünü kullanır ve "hedefe ulaşılmadı" iletisini yazar; ileti bu durumda dikkate alınmaz.
S6. Lojistik etkileşim için neden bu kadar büyük örneklem gerekiyor?
Etkileşim iki eğimin farkıdır; farkın varyansı iki eğimin varyanslarının toplamıdır ve her eğim verinin yalnız yarısından kestirilir. Varsayılan ayarda \hat\gamma'nın standart hatası yaklaşık 5{,}26/\sqrt n'dir: n=100'de 0,53; standart hata etkinin kendisine (0,8) ancak n\approx43'te iner. Log olasılık oranı 0,8 (olasılık oranı 2,2) büyüklüğündeki bir etkileşimi 0,80 güçle saptamak için yaklaşık 340 gözlem gerekir.
S7. Bu şablon ile temel programdaki Güç Analizi aynı tasarımda farklı n önerirse hangisi doğrudur?
Kapalı formül doğrudur; benzetim onun gürültülü bir kestirimidir. d=0{,}5 için formül grup başına 64 verir (güç 0,8015). Benzetim aynı noktada 0,7989 bulup hedefe "ulaşılmadı" diyebilir. Kapalı formülü olan tasarımlarda şablon öğretim ve denetim içindir; karar formülden verilir.
S8. Wilson aralığı yerine Clopper-Pearson kullanılmalı mıydı?
Clopper-Pearson aralığı tutucudur: kapsama oranı her zaman en az adındaki kadardır, çoğu zaman belirgin biçimde fazladır. Wilson aralığının kapsama oranı adındaki düzeyin çevresinde dalgalanır ve ortalamada ona yakındır. Benzetim sayısı yüzler düzeyindeyken fark küçüktür: \hat g=0{,}2, k=60 için Wilson [0,118; 0,318]. MerQuR+'ın karma model güç şablonu (Bölüm 58) Clopper-Pearson aralığını kullanır; iki şablonun aralıkları bu nedenle aynı sayımdan farklı sınırlar verir.
S9. Üretici işlevi kendi tasarımıma nasıl uyarlarım?
Kod sekmesinde üç şey değiştirilir: (1) veriyi üreten satırlar (ör. 141–142'de grup büyüklükleri ve standart sapmalar); (2) test (ör. ttest_ind(..., equal_var=False)); (3) gerekiyorsa ızgaranın katı (146–149). İşlev, uzunluğu B olan bir p değeri dizisi döndürdüğü sürece güç, aralık, tablo ve şekil değişmeden çalışır. Değişiklikten sonra önce etki sıfır girilerek I. tür hata oranı denetlenir (S5).
57.10 Kaynaklar
- Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1–10. https://doi.org/10.1093/biomet/71.1.1
- Arnold, B. F., Hogan, D. R., Colford, J. M., & Hubbard, A. E. (2011). Simulation methods to estimate design power: An overview for applied research. BMC Medical Research Methodology, 11, 94. https://doi.org/10.1186/1471-2288-11-94
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum. https://doi.org/10.4324/9780203771587
- Demidenko, E. (2008). Sample size and optimal design for logistic regression with binary interaction. Statistics in Medicine, 27(1), 36–46. https://doi.org/10.1002/sim.2980
- Harris, C. R., Millman, K. J., van der Walt, S. J., et al. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power: The pervasive fallacy of power calculations for data analysis. The American Statistician, 55(1), 19–24. https://doi.org/10.1198/000313001300339897
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Koehler, E., Brown, E., & Haneuse, S. J.-P. A. (2009). On the assessment of Monte Carlo error in simulation-based statistical analyses. The American Statistician, 63(2), 155–162. https://doi.org/10.1198/tast.2009.0030
- Morris, T. P., White, I. R., & Crowther, M. J. (2019). Using simulation studies to evaluate statistical methods. Statistics in Medicine, 38(11), 2074–2102. https://doi.org/10.1002/sim.8086
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. Proceedings of the 9th Python in Science Conference, 92–96. https://doi.org/10.25080/Majora-92bf1922-011
- Virtanen, P., Gommers, R., Oliphant, T. E., et al. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(171), 209–212. https://doi.org/10.1080/01621459.1927.10502953