38. Doğrusal modelde özel kontrastlar (L matrisi)
Şablon kimliği: ozel_kontrast · Kategori: model · Dil: Python · Dosya: pro/sablonlar/model/ozel_kontrast.py (satır 1–421; üstbilgi 1–71) · Örnek veri: _ornek/gruplu_verim.csv · Paketler: numpy, pandas, scipy (stats.t), statsmodels 0.14.6 (stats.multitest.multipletests), matplotlib; temel programın stats/contrasts_L.py modülü
38.1 Ne işe yarar
Varyans analizinin genel F testi "gruplar arasında herhangi bir fark var mı?" diye sorar; araştırmacının sorusu ise çoğu kez daha belirlidir: "İki gübrenin ortalaması kontrolden farklı mı?" Şablon, grup ortalamalarının kullanıcının yazdığı doğrusal bileşimlerini (kontrastları) kestirir, her birini t testiyle sınar ve birden çok kontrast için çoklu karşılaştırma düzeltmesi uygular.
- D_{ij}: i. gözlem j. gruptaysa 1, değilse 0. Sabit terim yoktur; her grubun kendi katsayısı \mu_j vardır (hücre ortalamaları parametrelemesi).
- x_{ih}: isteğe bağlı ortak değişkenler; ortalamalarından arındırılarak girer. Bu yüzden \mu_j, ortak değişkenlerin örneklem ortalamasındaki düzeltilmiş grup ortalamasıdır; ortak değişken yoksa sıradan grup ortalamasıdır.
- c_j: kontrast katsayıları. \sum_j c_j=0 ise \psi bir farktır (kontrast); toplam sıfır değilse \psi ortalamaların ağırlıklı toplamıdır ve "sıfırdan farklı mı?" sınanır.
- \psi_0: sınanan değer; yazılmazsa 0.
Ne zaman kullanılır? Karşılaştırmalar veriye bakılmadan, araştırma sorusundan türetilmişse (planlı kontrastlar); tek etkenli bir tasarımda ya da ortak değişkenle düzeltilmiş ortalamalarda; grup varyansları eşit değilse sağlam (HC) kovaryansla; ikili farkların hepsi isteniyor ama düzeltme yöntemi serbestçe seçilmek isteniyorsa.
Ne zaman kullanılmaz?
- Rastgele etki, blok ya da yinelenen ölçüm varsa: hata terimi tek katmanlı değildir;
r_emmeans_kontrastşablonu (karma modelde kontrast, Kenward-Roger serbestlik derecesi). - İki etkenli tasarımda etkileşim kontrastı isteniyorsa: şablon tek grup sütunu alır. İki etken birleştirilip tek sütun yapılırsa (A1B1, A1B2 …) hücre ortalamaları üzerinde her kontrast yazılabilir; hazır çözüm temel programdaki İki Yönlü ANOVA'dır.
- Bütün ikili farklar için Tukey ya da kontrole karşı Dunnett düzeltmesi isteniyorsa: bunlar şablonun listesinde yoktur; temel programdaki Tek Yönlü ANOVA'nın çoklu karşılaştırmaları.
- Yanıt normal dağılmıyor ya da sıralıysa: temel programdaki parametrik olmayan karşılaştırmalar ya da
saglam_anova_wrs2şablonu. - Yalnız eldeki p değerleri düzeltilecekse: temel programdaki Çoklu Karşılaştırma Düzeltme.
Temel programla ilişki. Kontrast metnini çözen ayrıştırıcı şablonun içindedir (140–358) ve temel programın ortak L matrisi modülünün (stats/contrasts_L.py) yazım kurallarını izler; şablon onu hücre ortalamaları modeliyle birleştirir. Fark şuradadır: temel programın doğrusal modellerinde kontrast, modelin katsayı adlarıyla (referans düzeye göre farklar) yazılır; burada düzey adlarıyla, doğrudan ortalamalar üzerinden yazılır. Ayrıca düzeltme yöntemi, tek yönlü karşıt hipotez ve HC kovaryansı aynı formdan seçilir.
38.2 Şablonun girdileri
Form dokuz [[param]] bloğundan kurulur (ozel_kontrast.py:10–70).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt değişkeni · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | y (satır 115). |
Grup (faktör) · grup |
kategorik sütun · Değişkenler | uygun ilk sütun | herhangi bir sütun | Düzeyler metne çevrilir; hepsi sayıysa sayısal, değilse alfabetik sıralanır (92–105). |
Ortak değişkenler · ortak |
sütunlar · Değişkenler | boş | sayısal sütunlar; isteğe bağlı | Merkezlenip \mathbf X'e eklenir (84, 101). |
Kontrastlar · kontrastlar |
metin · Model | boş | ; ile ayrılmış doğrusal ifadeler |
\mathbf L ve \psi_0; boşsa tüm ikili farklar (137–139). |
Çoklu karşılaştırma düzeltmesi · duzeltme |
seçim · Seçenekler | holm |
holm, bonferroni, fdr_bh, fdr_by, sidak, holm-sidak, simes-hochberg, hommel, yok |
multipletests(method = …) (370–371). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | t çeyreği (141, 144). |
Karşıt hipotez · alternatif |
seçim · Seçenekler | iki |
iki, buyuk, kucuk |
p'nin kuyruğu (368–369); GA iki yönlü kalır. |
Katsayı kovaryansı · kovaryans |
seçim · Seçenekler | klasik |
klasik, HC0, HC1, HC2, HC3 |
\hat{\mathbf V} (126–134). |
Bonferroni düzeltmeli eşzamanlı GA · ga_duzeltilmis |
onay · Seçenekler | kapalı | açık / kapalı | Çeyrek 1-\alpha/(2m)'den (373–375). |
Örnek ayar (satır 9): y = verim, grup = grup, kontrastlar = "Gübre_A - Kontrol; Gübre_B - Kontrol; 0.5*Gübre_A + 0.5*Gübre_B - Kontrol"; öteki alanlar varsayılandadır.
Kontrast metninin yazımı (ozel_kontrast.py:140–358; temel programdaki stats/contrasts_L.py ile aynı yazım):
| Yazım | Anlamı |
|---|---|
Gübre_A - Kontrol |
Katsayısı yazılmayan düzeyin katsayısı 1'dir. |
0.5*Gübre_A + 0.5*Gübre_B - Kontrol |
Katsayı * ile; ondalık ayırıcı nokta. 1/2*Gübre_A ve (Gübre_A + Gübre_B)/2 - Kontrol de geçerlidir. |
; ya da yeni satır |
Kontrastları ayırır. |
A ile kontrol | Gübre_A - Kontrol |
|'dan önceki metin çıktıdaki etikettir. |
Gübre_A - Kontrol = 1 |
Sondaki = sayı sınanan değerdir (\psi_0). |
1 0 -1 |
Yalnız sayılardan oluşan satır doğrudan ağırlık satırıdır; sayı adedi katsayı adedine (düzeyler + ortak değişkenler) eşit olmalı, sıra şablonun düzey sırasıdır (38.3); çıktıdaki "Düzey sırası" satırı hangi sıranın kullanıldığını yazar. |
gübre_a - KONTROL |
Adlar büyük/küçük harfe duyarsız eşlenir. Boşluk ya da özel karakter içeren ad ters tırnak, çift tırnak ya da {} içine alınabilir. |
Ortak değişken adları da ifadede kullanılabilir; yun_B yazmak o ortak değişkenin eğimini sınar.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 82–83 |
| Yanıt ve grup aynı sütun | "Yanıt ve grup farklı sütunlar olmalı." | 85–86 |
| İkiden az düzey | "Grup sütununda en az iki düzey gerekli." | 93–94 |
| Bir grupta 2'den az gözlem | "Her grupta en az 2 gözlem gerekli." | 96–97 |
| n-p<1 ya da \mathbf X tam ranklı değil | "Model kurulamıyor: gözlem sayısı yetersiz ya da ortak değişkenler doğrusal bağımlı." | 117–119 |
| HC2/HC3'te kaldıraç 1 | "Kaldıraç değeri 1 olan gözlem var; HC2/HC3 hesaplanamaz…" | 131–133 |
| Kontrast metni çözülemedi (bilinmeyen ad, sözdizimi, sayı adedi, tümü sıfır) | "Kontrast metni çözümlenemedi: … Düzeyler: …" | 359–363 |
Eksik değer: yanıt ve ortak değişkenler sayıya çevrilir; yanıtı, grubu ya da bir ortak değişkeni eksik olan satır atılır (satır 89–91). Yanıt ve grup sütunları ortak değişken listesinde seçilmişse listeden çıkarılır (85).
38.3 Örnek veri
Dosya: _ornek/gruplu_verim.csv. Üç gübre uygulamasında 20'şer parsel, toplam 60 gözlem; öğretim amaçlı üretilmiş yapay veridir, eksik değer yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
parsel |
— (kimlik) | metin | P01–P60. |
grup |
Grup | kategorik | Kontrol, Gübre_A, Gübre_B; 20'şer gözlem. |
blok |
— (kullanılmaz) | kategorik | B1–B5. |
verim |
Yanıt | sayısal | 2,31–15,27; ortalama 6,9945. |
| Grup | n | Ortalama | Standart sapma | Grup içi kareler toplamı |
|---|---|---|---|---|
| Gübre_A | 20 | 7,1930 | 2,0070 | 76,5298 |
| Gübre_B | 20 | 8,4180 | 2,8852 | 158,1631 |
| Kontrol | 20 | 5,3725 | 1,7082 | 55,4434 |
Bu şablonda düzey sırası arayüzdeki sıra değildir
Veri sekmesinde grup'un düzeyleri ilk görülme sırasıyla dizilir: Kontrol, Gübre_A, Gübre_B (Bölüm 1.3). Şablon düzey adlarını önce mq.kimlik ile metne çevirir; etiketlerin hepsi sayıysa (ondalık ayırıcı nokta ya da virgül) düzeyleri sayısal sıraya koyar (0, 50, 100, 150), değilse karakter sırasıyla dizer (sorted, satır 103–105): Gübre_A, Gübre_B, Kontrol. Sıra üç yerde görünür: "Grup ortalamaları" tablosunun satırları, kontrast boş bırakıldığında üretilen ikili farkların yönü (sırada önce gelen eksi sonra gelen) ve doğrudan ağırlık satırının hangi düzeye uygulandığı. Karakter sırasında büyük harfler küçük harflerden, Türkçeye özgü harfler (Ç, Ğ, İ, Ö, Ş, Ü) bütün temel Latin harflerinden sonra gelir. Çıktıdaki "Düzey sırası (sayısal | alfabetik): …" satırı (390–393) kullanılan sırayı ve ağırlık satırlarının bu sıraya uygulandığını yazar. Kontrastlar adlarla yazıldığında sıra sonucu etkilemez.
Örnek veride blok sütunu vardır, ama şablon blok etkisini modele almaz; bloklu bir denemede blok hata teriminden ayrılmadığı için bu çözümleme tutucu kalır (38.8).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) kontrast boş, Bonferroni düzeltmesi ve eşzamanlı GA; (3) kontrast boş, öteki yedi düzeltme yöntemi; (4) örnek kontrastlar, HC0–HC3 kovaryansı; HC3 ile tek yönlü (>) karşıt hipotez; (5) yayımlanmış bir veri: _ornek/ozel_kontrast_warpbreaks.csv (54 gözlem; kopma sayısı, gerilim düzeyi L/M/H, yün türü göstergesi), grup = tension, ortak = [yun_B], kontrastlar M - L; H - L; H - M; (6) Gübre_A - Kontrol = 1; (7) ağırlık satırı ve etiketli yazım; (8) dört dozlu kurgusal veri (dogrulama/ozel_kontrast/verim_dort.csv).
38.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) eksikleri at, düzeyleri sırala; (2) hücre ortalamaları tasarım matrisini kur, ortak değişkenleri merkezle; (3) EKK ile \hat{\boldsymbol\beta}, artıklar, s^2 ve kovaryansı hesapla; (4) kontrast metnini \mathbf L matrisine çevir; (5) her satır için tahmin, SH, t ve p; (6) p değerlerini düzelt; (7) GA'ları kur; (8) tabloları, metni ve şekli yaz.
38.4.1 Hücre ortalamaları modeli ve EKK
- \mathbf X: n\times p; ilk k sütun grup göstergeleri, sonraki r sütun merkezlenmiş ortak değişkenler; p=k+r. \boldsymbol\beta=(\mu_1,\dots,\mu_k,\gamma_1,\dots,\gamma_r).
- e_i=y_i-\mathbf x_i^{\top}\hat{\boldsymbol\beta}: artıklar. s^2: hata varyansının kestirimi; n-p artık serbestlik derecesi.
- Ortak değişken yoksa \mathbf X^{\top}\mathbf X=\operatorname{diag}(n_1,\dots,n_k)'dır: \hat\mu_j=\bar y_j, \operatorname{Var}(\hat\mu_j)=s^2/n_j ve ortalamalar birbirinden bağımsızdır.
Neden sabit terimsiz kodlama?
Sabitli kodlamada katsayılar "referans düzeye göre fark"tır ve bir kontrastı yazmak için hangi düzeyin referans olduğunu bilmek gerekir. Hücre ortalamaları kodlamasında her katsayı bir grubun ortalamasıdır; "0,5·A + 0,5·B − Kontrol" ifadesi doğrudan \mathbf L satırına çevrilir. İki kodlama aynı modeldir: uyum, artıklar ve her kontrastın tahmini ile SH'si aynıdır.
Neden ortak değişkenler merkezlenir?
Merkezleme yapılmasa \mu_j, ortak değişken 0 iken grubun kestirimi olurdu; çoğu veride 0 gözlenen aralığın dışındadır. Merkezlenince \mu_j, ortak değişkenin örneklem ortalamasındaki kestirimdir: en küçük kareler (düzeltilmiş) ortalama. Fark kontrastları merkezlemeden etkilenmez; grup ortalamaları tablosu ve toplamı sıfır olmayan ifadeler etkilenir.
38.4.2 Kontrastın tahmini, standart hatası ve testi
- \mathbf l_l: \mathbf L matrisinin l. satırı (p öğe); düzeylerin katsayıları ve varsa ortak değişkenlerin katsayıları.
- Tabloya yazılan "tahmin" \mathbf l^{\top}\hat{\boldsymbol\beta}-\psi_0'dır:
= 1yazılmışsa tahmin ve GA 1 kadar kaydırılmış olarak görünür; etiket= 1ile biter ve çıktıya "Sağ tarafı sıfırdan farklı kontrastlarda … tahmin ve GA Lβ − c farkınındır; t ve p Lβ = c hipotezini sınar" notu yazılır (394–396). - p: iki yönlüde 2P(T_{n-p}>\lvert t\rvert); "tek yönlü (>)" seçiminde P(T_{n-p}>t); "tek yönlü (<)" seçiminde P(T_{n-p}<t) (satır 369).
- İkinci satırdaki kapalı biçim, kontrastın kesinliğinin nereden geldiğini gösterir: büyük katsayı alan ve az gözlemli gruplar SH'yi büyütür.
- m: kontrast sayısı. İkinci biçim Bonferroni eşzamanlı aralıktır: m aralığın hepsinin birden gerçek değeri kapsama olasılığı en az 1-\alpha'dır.
- GA her zaman iki yönlüdür; tek yönlü karşıt hipotez yalnız p'yi değiştirir.
Koddaki tercih
GA'lar varsayılan olarak düzeltmesizdir; seçilen p düzeltmesi GA'ya yansımaz. Eşzamanlı aralık yalnız "Bonferroni düzeltmeli eşzamanlı GA" kutusu açılırsa ve her zaman Bonferroni çeyreğiyle kurulur (satır 372–375); p düzeltmesi Holm ya da Benjamini-Hochberg olsa da aralık Bonferroni'dir. Çıktının ikinci satırı hangisinin kullanıldığını yazar (385–393).
38.4.3 Heteroskedastisiteye dayanıklı kovaryans (HC0–HC3)
- h_{ii}=\mathbf x_i^{\top}(\mathbf X^{\top}\mathbf X)^{-1}\mathbf x_i: kaldıraç; ortak değişkensiz modelde h_{ii}=1/n_j.
- HC0 White'ın (1980) kestiricisidir; HC1 serbestlik derecesi düzeltmesi, HC2 ve HC3 kaldıraç düzeltmesi ekler (MacKinnon ve White, 1985). Küçük örneklemde HC3 önerilir (Long ve Ervin, 2000).
- Ortak değişkensiz modelde \operatorname{Var}_{\text{HC2}}(\hat\mu_j)=s_j^2/n_j olur (s_j^2: grubun kendi varyansı): HC2, ayrı varyanslı (Welch türü) standart hatayı verir. HC3'te \operatorname{Var}(\hat\mu_j)=\mathrm{KT}_j/(n_j-1)^2'dir.
Sağlam kovaryansta serbestlik derecesi değişmez
HC seçeneklerinde yalnız SH değişir; t istatistiği yine n-p serbestlik dereceli t dağılımıyla değerlendirilir (satır 123, 369). Ayrı varyanslı t testindeki Welch–Satterthwaite serbestlik derecesi uygulanmaz. Gruplar küçük ve varyanslar çok farklıysa bu, p değerini olduğundan küçük gösterir; öyle bir durumda sonuç, serbestlik derecesini de kestiren ayrı varyanslı (Welch) testle birlikte okunur.
38.4.4 Çoklu karşılaştırma düzeltmeleri
m kontrastın p değerleri küçükten büyüğe p_{(1)}\le\dots\le p_{(m)} sıralanır; düzeltilmiş değer \tilde p_{(i)} ile gösterilir.
| Seçenek | Düzeltilmiş p | Denetlediği hata |
|---|---|---|
| Bonferroni | \min(1,\ m\,p_{(i)}) | Aile boyu |
| Šidák | 1-(1-p_{(i)})^{m} | Aile boyu (bağımsızlık ya da pozitif bağımlılık) |
| Holm | \max_{j\le i}\min\big(1,\ (m-j+1)\,p_{(j)}\big) | Aile boyu |
| Holm-Šidák | \max_{j\le i}\big[1-(1-p_{(j)})^{m-j+1}\big] | Aile boyu |
| Hochberg | \min_{j\ge i}\min\big(1,\ (m-j+1)\,p_{(j)}\big) | Aile boyu (Simes koşulu) |
| Hommel | Simes testinin kapalı sınama yöntemi (Wright, 1992 algoritması) | Aile boyu (Simes koşulu) |
| Benjamini-Hochberg | \min_{j\ge i}\min\big(1,\ \tfrac{m}{j}\,p_{(j)}\big) | Yanlış bulma oranı |
| Benjamini-Yekutieli | \min_{j\ge i}\min\big(1,\ \tfrac{m}{j}\,p_{(j)}\sum_{h=1}^{m}\tfrac1h\big) | Yanlış bulma oranı (her bağımlılıkta) |
- \max_{j\le i} (aşağıdan yukarı) ve \min_{j\ge i} (yukarıdan aşağı), düzeltilmiş değerlerin özgün sırayı korumasını sağlar.
- Aile boyu hata: en az bir yanlış ret olasılığı. Yanlış bulma oranı: retler içinde yanlış olanların beklenen payı; daha gevşek bir ölçüttür.
Neden varsayılan Holm?
Holm, Bonferroni ile aynı güvenceyi (her bağımlılık yapısında aile boyu hata \le\alpha) verir ve hiçbir zaman ondan daha tutucu değildir: en küçük p m ile, ikincisi m-1 ile çarpılır. Hochberg ve Hommel biraz daha güçlüdür, ama testler arasında belirli bir bağımlılık koşulu ister. Aynı hata varyansını paylaşan kontrastların t istatistikleri bağımlıdır; koşulsuz geçerli en güçlü basit seçenek Holm'dur.
Koddaki tercih
Düzeltme statsmodels.stats.multitest.multipletests(p, method = …)'in ikinci çıktısıdır (satır 371); "Düzeltme yok" seçilirse ham p yinelenir. Düzeltme, tek yönlü seçimde tek kuyruklu p değerlerine uygulanır. Aile, formdaki kontrastların tamamıdır: aynı veride ayrı çalıştırmalarla sınanan kontrastlar birbirinin düzeltmesine girmez.
38.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–71 | Üstbilgi: açıklama, örnek veri ve ayar, 9 parametre. | Form buradan kurulur (Bölüm 1.2). |
| 72–91 | İçe aktarmalar; ortak değişken listesinin süzülmesi; sayıya çevirme; eksik satırların atılması. | Grup sütunu sayıya çevrilmez (89–90). |
| 92–110 | Grup etiketlerinin mq.kimlik ile metne çevrilmesi (tam sayı değerli ondalıklı sütunda 1 düzeyi "1" olur); düzey sırası (hepsi sayıysa sayısal, değilse alfabetik); düzey ve gözlem sayısı denetimi. |
Sayısal sıra _sayi_mi ile (95–105). |
| 112–125 | \mathbf X (göstergeler + merkezlenmiş ortak değişkenler), rank denetimi, EKK, s^2, klasik \hat{\mathbf V}. | Sabit terim yok (113–114). |
| 126–134 | HC ağırlıkları ve sandviç kovaryans. | Kaldıraç 1 ise HC2/HC3 durur (131–133). |
| 135–139 | Katsayı adları; boş metinde tüm ikili farklar. | Kontrast boşsa ikili farklar düzey sırasıyla üretilir. |
| 140–363 | Kontrast ayrıştırıcısı _kontrast_ayristir ve özyinelemeli ifade çözücü _ifade (eval kullanılmaz); \mathbf L, etiketler, \psi_0 ve ağırlık satırı bayrağı. |
Ayrıştırıcı şablonun içindedir (140–358); hata iletisi 359–363. |
| 365–381 | Tahmin, SH, t, p, düzeltilmiş p, GA çeyreği; "Kontrastlar" ve "Grup ortalamaları" tabloları. | Grup ortalamalarının SH'si seçilen kovaryanstan (381). |
| 382–404 | Metin: model satırı, düzeltme ve GA türü, kovaryans/karşıt hipotez satırı, düzey sırası ve sağ taraf notları, kontrast başına bir satır. | Üçüncü satır yalnız varsayılandan sapınca yazılır (397). |
| 406–421 | Şekil (tahmin ve GA, sıfır çizgisi), iki tablo ve şeklin kaydı. | Şekildeki aralıklar tablodaki GA'lardır. |
38.6 Elle hesap: örnek veride bağımsız yeniden hesap
Değerler dogrulama/ozel_kontrast/elle_hesap.py ile hesaplanmıştır. Betik şablonun matris çözümünü ve statsmodels'i kullanmaz: ortak değişkensiz modelde grup ortalamaları ile grup içi kareler toplamlarından 38.4.2 ve 38.4.3'teki kapalı formülleri uygular, düzeltmeleri 38.4.4'teki tanımlardan elle hesaplar; ortak değişkenli modeli başka bir parametrelemeyle (sabit + gösterge + ham ortak değişken, QR ayrışımı) çözer. R tarafında (r_dogrulama.R) sabitli lm modeli üzerinde multcomp::glht, stats::p.adjust, sandwich::vcovHC ve emmeans kullanılmıştır.
Adım 1 — Hata varyansı. Grup içi kareler toplamları 76,5298; 158,1631; 55,4434; toplam 290,1363; n-p=60-3=57:
Adım 2 — Kontrastlar. Düzey sırası (Gübre_A, Gübre_B, Kontrol) ile \mathbf L satırları (1{,}0,-1), (0{,}1,-1), (0{,}5;\ 0{,}5;\ -1).
| Kontrast | \hat\psi | \sum c_j^2/n_j | SH | t_{57} | p |
|---|---|---|---|---|---|
| Gübre_A − Kontrol | 7{,}1930-5{,}3725=1{,}8205 | 0,100 | 0,713450 | 2,551685 | 0,013427 |
| Gübre_B − Kontrol | 8{,}4180-5{,}3725=3{,}0455 | 0,100 | 0,713450 | 4,268694 | 7{,}516\cdot10^{-5} |
| ½(A + B) − Kontrol | 7{,}8055-5{,}3725=2{,}4330 | 0,075 | 0,617866 | 3,937747 | 2{,}2646\cdot10^{-4} |
Üçüncü kontrastın SH'si daha küçüktür: iki grubun ortalaması 40 gözleme dayanır ve \sum c_j^2/n_j 0,100'den 0,075'e iner.
Adım 3 — Güven aralığı. t_{0{,}975;\,57}=2{,}002465: 1{,}8205\pm2{,}002465\cdot0{,}713450=[0{,}391841;\ 3{,}249159].
Adım 4 — Holm düzeltmesi (m=3). Sıralı p değerleri: 7{,}516\cdot10^{-5} (B − K), 2{,}2646\cdot10^{-4} (ortalama − K), 0{,}013427 (A − K). Çarpanlar 3, 2, 1:
Değerler zaten artan sırada olduğundan en büyükleme adımı bir şey değiştirmez. Üç kontrast da aile boyu %5 düzeyinde anlamlıdır.
Adım 5 — Bütün ikili farklar ve öteki düzeltmeler (çalıştırma 2–3). Ham p: A − B 0,091407; A − K 0,013427; B − K 7{,}516\cdot10^{-5}.
| Yöntem | A − B | A − K | B − K |
|---|---|---|---|
| Düzeltme yok | 0,09141 | 0,01343 | 0,0000752 |
| Bonferroni | 0,27422 | 0,04028 | 0,0002255 |
| Šidák | 0,24992 | 0,03974 | 0,0002255 |
| Holm | 0,09141 | 0,02685 | 0,0002255 |
| Holm-Šidák | 0,09141 | 0,02667 | 0,0002255 |
| Hochberg | 0,09141 | 0,02685 | 0,0002255 |
| Hommel | 0,09141 | 0,02685 | 0,0002255 |
| Benjamini-Hochberg | 0,09141 | 0,02014 | 0,0002255 |
| Benjamini-Yekutieli | 0,16758 | 0,03692 | 0,0004134 |
Eşzamanlı Bonferroni GA'sı için çeyrek t_{1-0{,}05/6;\,57}=2{,}466687'dir; A − K için [0{,}060642;\ 3{,}580358] (düzeltmesiz aralık [0{,}391841;\ 3{,}249159]).
Adım 6 — HC3. \operatorname{Var}(\hat\mu_j)=\mathrm{KT}_j/(n_j-1)^2: Gübre_A 76{,}5298/361=0{,}211994; Gübre_B 0{,}438125; Kontrol 0{,}153583 (klasik: her biri 0,254506).
Tek yönlü (>) p=0{,}001938. Gübre_B'nin varyansı büyük olduğundan B − K kontrastının SH'si artar (0,713450 → 0,769225), A − K'nınki azalır (→ 0,604629). HC0 0,574398; HC1 ve HC2 0,589320 verir (dengeli tasarımda n/(n-p)=n_j/(n_j-1) olduğundan ikisi çakışır).
Adım 7 — Ortak değişkenli model ve yayımlanmış değerler (çalıştırma 5). Kopma sayısı ~ gerilim + yün göstergesi; n=54, n-p=50, s=11{,}6171. Düzeltilmiş ortalamalar: L 36,3889; M 26,3889; H 21,6667 (SH 2,7382).
| Kontrast | Tahmin | SH | t_{50} | p | p (Holm) |
|---|---|---|---|---|---|
| M − L | −10,0000 | 3,8724 | −2,582 | 0,012787 | 0,025574 |
| H − L | −14,7222 | 3,8724 | −3,802 | 0,000391 | 0,001174 |
| H − M | −4,7222 | 3,8724 | −1,219 | 0,228390 | 0,228390 |
Bu değerler multcomp paketinin belgelerinde aynı model için yayımlanan sonuçlarla (−10,00; −14,72; −4,72; SH 3,87; t −2,58; −3,80; −1,22) örtüşür (Hothorn, Bretz ve Westfall, 2008).
38.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun "Kontrastlar" ve "Grup ortalamaları" tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–6). Şablon, temel programın ayrıştırıcı modülünü içe aktardığından doğrulama çalıştırmalarında programın kaynak kökü modül yoluna eklenmiştir; şablonun kodu değiştirilmemiştir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| A − K: tahmin | 1,8205 | 1,8205 | 1,8205 | 4,9e−16 | ✓ |
| A − K: SH | 0,71345012 | 0,71345012 | 0,71345012 | 4,4e−16 | ✓ |
| A − K: t | 2,55168503 | 2,55168503 | 2,55168503 | 1,0e−15 | ✓ |
| A − K: p | 0,01342704 | 0,01342704 | 0,01342704 | 9,0e−17 | ✓ |
| A − K: p (Holm) | 0,01342704 | 0,01342704 | 0,01342704 | 9,0e−17 | ✓ |
| B − K: tahmin | 3,0455 | 3,0455 | 3,0455 | 1,0e−15 | ✓ |
| B − K: SH | 0,71345012 | 0,71345012 | 0,71345012 | 0 | ✓ |
| B − K: t | 4,26869363 | 4,26869363 | 4,26869363 | 1,0e−15 | ✓ |
| B − K: p | 7,516010·10−5 | 7,516010·10−5 | 7,516010·10−5 | 8,9e−19 | ✓ |
| B − K: p (Holm) | 2,254803·10−4 | 2,254803·10−4 | 2,254803·10−4 | 1,5e−17 | ✓ |
| ½(A + B) − K: tahmin | 2,433 | 2,433 | 2,433 | 5,5e−16 | ✓ |
| ½(A + B) − K: SH | 0,61786593 | 0,61786593 | 0,61786593 | 2,2e−16 | ✓ |
| ½(A + B) − K: t | 3,93774746 | 3,93774746 | 3,93774746 | 1,0e−15 | ✓ |
| ½(A + B) − K: p | 2,264569·10−4 | 2,264569·10−4 | 2,264569·10−4 | 7,2e−17 | ✓ |
| ½(A + B) − K: p (Holm) | 4,529137·10−4 | 4,529137·10−4 | 4,529137·10−4 | 4,4e−17 | ✓ |
| A − K: GA alt | 0,39184077 | 0,39184077 | 0,39184077 | 1,6e−15 | ✓ |
| A − K: GA üst | 3,24915923 | 3,24915923 | 3,24915923 | 2,7e−16 | ✓ |
| Grup ortalaması: Gübre_A | 7,193 | 7,193 | 7,193 | 3,7e−16 | ✓ |
| Grup ortalaması: Gübre_B | 8,418 | 8,418 | 8,418 | 0 | ✓ |
| Grup ortalaması: Kontrol | 5,3725 | 5,3725 | 5,3725 | 6,6e−16 | ✓ |
| Grup ortalaması SH | 0,50448542 | 0,50448542 | 0,50448542 | 1,1e−16 | ✓ |
| İkili A − B: p (Bonferroni) | 0,27422201 | 0,27422201 | 0,27422201 | 2,1e−15 | ✓ |
| İkili A − K: p (Bonferroni) | 0,04028111 | 0,04028111 | 0,04028111 | 1,7e−16 | ✓ |
| İkili A − K: eşzamanlı GA alt (Bonferroni) | 0,06064186 | 0,06064186 | 0,06064186 | 1,6e−15 | ✓ |
| İkili A − K: eşzamanlı GA üst (Bonferroni) | 3,58035814 | 3,58035814 | 3,58035814 | 2,5e−16 | ✓ |
| İkili A − K: p (Holm) | 0,02685408 | 0,02685408 | 0,02685408 | 1,5e−16 | ✓ |
| İkili A − K: p (Šidák) | 0,03974268 | 0,03974268 | 0,03974268 | 2,0e−16 | ✓ |
| İkili A − K: p (Holm-Šidák) | 0,02667379 | 0,02667379 | — | 1,6e−16 | ✓ |
| İkili A − K: p (Hochberg) | 0,02685408 | 0,02685408 | 0,02685408 | 1,5e−16 | ✓ |
| İkili A − K: p (Hommel) | 0,02685408 | 0,02685408 | 0,02685408 | 1,5e−16 | ✓ |
| İkili A − K: p (Benjamini-Hochberg) | 0,02014056 | 0,02014056 | 0,02014056 | 9,0e−17 | ✓ |
| İkili A − K: p (Benjamini-Yekutieli) | 0,03692435 | 0,03692435 | 0,03692435 | 1,7e−16 | ✓ |
| HC3, A − K: SH | 0,60462941 | 0,60462941 | 0,60462941 | 6,7e−16 | ✓ |
| HC3, A − K: tek yönlü p (>) | 0,00193847 | 0,00193847 | 0,00193847 | 5,5e−17 | ✓ |
| HC3, B − K: SH | 0,76922542 | 0,76922542 | 0,76922542 | 1,1e−16 | ✓ |
| HC3, B − K: tek yönlü p (>) | 1,055550·10−4 | 1,055550·10−4 | 1,055550·10−4 | 5,9e−17 | ✓ |
| HC3, ½(A + B) − K: SH | 0,56223882 | 0,56223882 | 0,56223882 | 3,3e−16 | ✓ |
| HC3, ½(A + B) − K: tek yönlü p (>) | 3,078268·10−5 | 3,078268·10−5 | 3,078268·10−5 | 5,1e−19 | ✓ |
| HC3, A − K: tek yönlü p (Holm) | 0,00193847 | 0,00193847 | 0,00193847 | 5,5e−17 | ✓ |
| HC0, A − K: SH | 0,57439793 | 0,57439793 | 0,57439793 | 5,6e−16 | ✓ |
| HC1, A − K: SH | 0,58931985 | 0,58931985 | 0,58931985 | 4,4e−16 | ✓ |
| HC2, A − K: SH | 0,58931985 | 0,58931985 | 0,58931985 | 3,3e−16 | ✓ |
| Ortak değişkenli, M − L: tahmin | −10 | −10 | −10 | 7,1e−16 | ✓ |
| Ortak değişkenli, M − L: SH | 3,87237765 | 3,87237765 | 3,87237765 | 2,3e−16 | ✓ |
| Ortak değişkenli, M − L: p (Holm) | 0,02557366 | 0,02557366 | 0,02557366 | 1,5e−16 | ✓ |
| Ortak değişkenli, H − L: tahmin | −14,72222222 | −14,72222222 | −14,72222222 | 3,6e−16 | ✓ |
| Ortak değişkenli, H − L: SH | 3,87237765 | 3,87237765 | 3,87237765 | 3,4e−16 | ✓ |
| Ortak değişkenli, H − L: p (Holm) | 0,00117415 | 0,00117415 | 0,00117415 | 2,6e−17 | ✓ |
| Ortak değişkenli, H − M: tahmin | −4,72222222 | −4,72222222 | −4,72222222 | 7,5e−16 | ✓ |
| Ortak değişkenli, H − M: SH | 3,87237765 | 3,87237765 | 3,87237765 | 2,3e−16 | ✓ |
| Ortak değişkenli, H − M: p (Holm) | 0,22838987 | 0,22838987 | 0,22838987 | 2,5e−16 | ✓ |
| Ortak değişkenli: düzeltilmiş ortalama (L) | 36,38888889 | 36,38888889 | 36,38888889 | 0 | ✓ |
| Ortak değişkenli: düzeltilmiş ortalama SH | 2,73818449 | 2,73818449 | 2,73818449 | 3,2e−16 | ✓ |
| Sağ taraflı (=1), A − K: t | 1,15004535 | 1,15004535 | 1,15004535 | 1,4e−15 | ✓ |
| Sağ taraflı (=1), A − K: p | 0,25492748 | 0,25492748 | 0,25492748 | 4,4e−16 | ✓ |
Ölçütü karşılayan: 55/55. A: Gübre_A, B: Gübre_B, K: Kontrol. Python: grup ortalamaları ve birleşik varyanstan kapalı formüller; düzeltmeler tanımlarından elle (statsmodels kullanılmadan); ortak değişkenli modelde sabitli parametreleme ve QR. R: lm + multcomp::glht, stats::p.adjust, sandwich::vcovHC, emmeans. Holm-Šidák p.adjust'ta bulunmaz.
Üç hesap farklı parametrelemelerle (hücre ortalamaları; kapalı formüller; sabitli model) aynı sonuca varır; farklar kayan nokta yuvarlaması düzeyindedir.
38.7 Çıktıyı okuma
Örnek ayarın metin çıktısı:
Model: verim ~ grup   (n = 60, artık sd = 57, σ̂ = 2,2561)
Düzeltme: holm; GA'lar düzeltmesizdir (%95).
  Gübre_A - Kontrol: tahmin = 1,8205; SH = 0,7135; t(57) = 2,552; p = 0,01343; düzeltilmiş p = 0,01343
  Gübre_B - Kontrol: tahmin = 3,0455; SH = 0,7135; t(57) = 4,269; p = 7,516e-05; düzeltilmiş p = 0,0002255
  0.5*Gübre_A + 0.5*Gübre_B - Kontrol: tahmin = 2,4330; SH = 0,6179; t(57) = 3,938; p = 0,0002265; düzeltilmiş p = 0,0004529
"Kontrastlar" tablosu (dört ondalık):
| kontrast | tahmin | SH | t | sd | p | p_duzeltilmis | ga_alt | ga_ust |
|---|---|---|---|---|---|---|---|---|
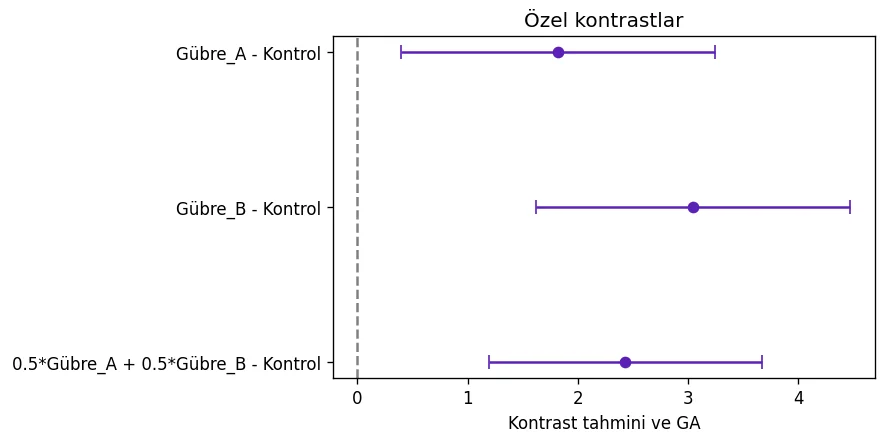
| Gübre_A - Kontrol | 1,8205 | 0,7135 | 2,5517 | 57 | 0,013427 | 0,013427 | 0,3918 | 3,2492 |
| Gübre_B - Kontrol | 3,0455 | 0,7135 | 4,2687 | 57 | 0,000075 | 0,000225 | 1,6168 | 4,4742 |
| 0.5Gübre_A + 0.5Gübre_B - Kontrol | 2,4330 | 0,6179 | 3,9377 | 57 | 0,000226 | 0,000453 | 1,1957 | 3,6703 |
"Grup ortalamaları" tablosu: Gübre_A 7,1930; Gübre_B 8,4180; Kontrol 5,3725; her biri n=20, SH 0,5045.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Model satırı | Formül, n, artık sd, \hat\sigma | \hat\sigma ortak hata standart sapmasıdır; bütün SH'ler ondan türer (klasik kovaryansta). |
| Düzeltme satırı | p düzeltmesinin kimliği; GA'ların düzeltmeli olup olmadığı | Karar p_duzeltilmis ile verilir; GA düzeltmesizse tek tek %95'tir, birlikte değil. |
| Kovaryans satırı | HC türü ve karşıt hipotez (yalnız varsayılandan farklıysa) | Bu satır varsa SH sandviç kestiricisinden, p belirtilen kuyruktandır. |
tahmin |
\mathbf l^{\top}\hat{\boldsymbol\beta}-\psi_0 | Yanıt biriminde fark; = değer yazıldıysa o değerden sapma. |
p, p_duzeltilmis |
Ham ve düzeltilmiş p | Tek kontrastta ikisi eşittir. |
ga_alt, ga_ust |
İki yönlü GA | Sıfırı içermeyen aralık, düzeltmesiz iki yönlü testte ret demektir; düzeltilmiş p ile çelişebilir. |
| Grup ortalamaları | Düzey (şablonun sırasıyla), n, (düzeltilmiş) ortalama, SH | Ağırlık satırı yazılacaksa sıra buradan okunur. |
Şekil 38.1. Şablonun şekli (örnek ayar): her kontrastın tahmini ve düzeltmesiz %95 GA'sı; kesikli çizgi sıfır. Üç aralık da sıfırın sağındadır.
Rapor cümlesi:
Planlı üç kontrast tek etkenli doğrusal modelde sınandı (hata serbestlik derecesi 57; p değerleri Holm yöntemiyle düzeltildi). Gübre A kontrolden 1,82 birim (SH = 0,71; t_{57} = 2{,}55; düzeltilmiş p = 0{,}013; %95 GA 0,39–3,25), Gübre B 3,05 birim (t_{57} = 4{,}27; düzeltilmiş p < 0{,}001; %95 GA 1,62–4,47) daha yüksek verim verdi. İki gübrenin ortalaması kontrolden 2,43 birim yüksekti (SH = 0,62; t_{57} = 3{,}94; düzeltilmiş p < 0{,}001).
38.8 Sık hatalar ve tuzaklar
- Ağırlık satırını arayüzdeki düzey sırasıyla yazmak.
1 0 -1satırı şablonun sıralı düzeylerine uygulanır (Gübre_A, Gübre_B, Kontrol), veri sekmesindeki sıraya (Kontrol, Gübre_A, Gübre_B) değil. Sayı biçimli düzeylerde sıra sayısaldır: 0, 50, 100, 150 dozlu kurgusal veride doğrusal eğilim için-3 -1 1 3yazıldığında katsayılar 0, 50, 100, 150 sırasına uygulanır ve tahmin 10,6083 (t=6{,}65) çıkar; adlarla yazılan-3*0 - 1*50 + 1*100 + 3*150aynı değeri verir. Metin etiketli düzeylerde sıra alfabetiktir; ağırlık satırı kullanılacaksa sıra çıktıdaki "Düzey sırası" satırından ya da "Grup ortalamaları" tablosundan okunur. - Ondalık virgül kullanmak.
0,5*Gübre_Açözülemez ve şablon durur; katsayılar noktayla (0.5) ya da kesirle (1/2) yazılır. = değeryazıp tahmini fark sanmak.Gübre_A - Kontrol = 1için tabloda tahmin 0,8205 görünür (1{,}8205-1); etiketGübre_A - Kontrol = 1olarak yazılır ve çıktıya sağ taraf notu eklenir (394–396). Bu, "fark 1'den büyük mü?" sorusunun tahminidir.- Toplamı sıfır olmayan ifadeyi kontrast sanmak.
Gübre_A + Gübre_B - Kontrolgeçerli bir ifadedir, ama bir fark değildir (tahmin 10,2385); "iki gübrenin ortalaması" için katsayılar 0,5 olmalıdır. Şablon katsayı toplamını denetlemez. - Kontrastları veriye bakarak seçmek. En büyük ile en küçük ortalamayı görüp yalnız o farkı yazmak, düzeltmeyi m=1 ile yapar; gerçek aile bütün ikili farklardır. Böyle bir karşılaştırma için kontrast boş bırakılır.
- Düzeltilmiş p ile düzeltmesiz GA'yı birlikte yorumlamak. Bonferroni ile A − K düzeltilmiş p=0{,}040 iken düzeltmesiz GA [0{,}39;\ 3{,}25], eşzamanlı GA [0{,}06;\ 3{,}58]'dir. Raporda hangisinin verildiği yazılır.
- Bloklu denemeyi bloksuz çözümlemek. Örnek veride
bloksütunu vardır; şablon onu modele almaz ve blok değişkenliği hata teriminde kalır. Blok sayısal değilse ortak değişken olarak da verilemez. Bloklu tasarımdar_emmeans_kontrastkullanılır. - Eşit olmayan varyansları görmezden gelmek. Grup standart sapmaları 1,71; 2,01; 2,89'dur. Klasik kovaryans bunları birleştirir ve varyansı büyük grubun kontrastını olduğundan kesin gösterir (B − K: SH 0,713; HC3 ile 0,769).
- Sayı kodlu grup sütununda eksik değer. Tamsayı kodlu bir sütunda eksik hücre varsa sütun ondalıklı okunur; şablon düzey adlarını tam sayı biçiminde yazar ("1", "2", "3"), eksik hücre olsa da olmasa da
2 - 1aynı çalışır. Düzeyler sayı olduğundan sayısal sıradadır. - Şablonu kendi Python yorumlayıcınızla çalıştırmak. Ayrıştırıcı şablonun içindedir (140–358); harici bir yorumlayıcı seçiliyken de çalışır, yalnız numpy, pandas, scipy, statsmodels ve matplotlib kurulu olmalıdır.
38.9 Uzman soruları
S1. Hücre ortalamaları kodlaması ile sabitli kodlama aynı kontrast sonucunu verir mi?
Verir. İki tasarım matrisi aynı sütun uzayını gerer; uyum değerleri, artıklar ve s^2 aynıdır. Kestirilebilir her doğrusal bileşimin tahmini ve varyansı parametrelemeden bağımsızdır. Doğrulama tablosunda R sütunu sabitli lm modelinden, MerQuR+ sütunu hücre ortalamaları modelinden gelir ve değerler 10^{-12}'nin altında bir farkla aynıdır.
S2. Ortak değişken varken "grup ortalaması" neyin ortalamasıdır?
Ortak değişkenin örneklem ortalamasında değerlendirilen model kestirimidir: \hat\mu_j=\bar y_j-\hat\gamma(\bar x_j-\bar x). Bu, en küçük kareler ortalaması (kestirilen marjinal ortalama) tanımıdır (Searle, Speed ve Milliken, 1980). Ortak değişken gruplarda dengeliyse düzeltilmiş ve ham ortalamalar çakışır; yün göstergeli örnekte her gerilim düzeyinde iki yün türü eşit sayıda olduğundan böyledir. Model, eğimin bütün gruplarda aynı olduğunu varsayar; etkileşim terimi yoktur.
S3. Sağlam kovaryansta serbestlik derecesi neden n − p; Welch testiyle fark ne kadar?
Şablon yalnız kovaryans matrisini değiştirir, başvuru dağılımını değiştirmez. İki grup için HC2 standart hatası Welch testinin standart hatasıdır, ama Welch testi serbestlik derecesini de kestirir. Örnek veride A − K için Welch–Satterthwaite serbestlik derecesi yaklaşık 37'dir; şablon 57 kullanır. t\approx3{,}09 için fark p değerinin üçüncü ondalığındadır. Grup başına 5–6 gözlemde fark belirginleşir ve n-p kullanımı iyimser kalır.
S4. Tukey düzeltmesi neden yok; Holm ile sonuç değişir mi?
Tukey ve Dunnett düzeltmeleri kontrastların ortak dağılımını (studentleştirilmiş aralık, çok değişkenli t) kullanır ve belirli kontrast kümeleri için tanımlıdır; şablonun düzeltmeleri yalnız p değerlerine dayanır ve her kontrast kümesine uygulanır. Bütün ikili farklarda Tukey genellikle Holm'dan biraz daha güçlüdür; az sayıda planlı kontrastta Holm daha güçlüdür, çünkü Tukey bütün ikili farkların bedelini öder.
S5. Doğrusal bağımlı kontrastlar yazılırsa ne olur?
Her satır ayrı sınandığından hesap bozulmaz. Örnek ayarın üçüncü kontrastı ilk ikisinin ortalamasıdır; üçü birlikte iki serbestlik derecelik bir uzay gerer. Düzeltme yine m=3 ile yapılır ve bu, bağımlılık yüzünden biraz tutucudur. Şablon satırların ortak F testini vermez; temel programdaki ayrıştırıcı modülde bu sınama tanımlıdır, ama şablon onu çağırmaz.
S6. Tek yönlü seçimde düzeltme ve GA nasıl davranır?
p değerleri seçilen kuyruktan hesaplanır ve düzeltme bu tek kuyruklu değerlere uygulanır. GA iki yönlü kalır (satır 372–378); tek yönlü bir alt sınır isteniyorsa güven düzeyi 1-2\alpha girilir ve aralığın alt ucu okunur. Beklenen yönün tersine çıkan bir kontrastta tek yönlü p 1'e yaklaşır: çalıştırmada "tek yönlü (<)" ile A − K için p=0{,}9933'tür.
S7. Bir grupta tek gözlem varsa neden durur; model yine de kurulabilir mi?
Klasik kovaryansla kurulabilirdi: s^2 öteki gruplardan kestirilir. Şablon her grupta en az iki gözlem ister (satır 109–110); bunun bir nedeni HC2 ve HC3'tür: tek gözlemli grupta kaldıraç 1'dir ve payda sıfır olur. Ortak değişkenli modelde kaldıracı 1 olan gözlem başka yoldan da ortaya çıkabilir; o durumda ikinci denetim devreye girer (131–133).
S8. Genel F testi anlamsızken planlı bir kontrast anlamlı olabilir mi?
Olabilir. F testi etkinin bütün yönlerine eşit ağırlık verir; tek bir kontrast gücünü tek yöne toplar. Örnek veride ikisi de anlamlıdır (F_{2,\,57}=9{,}23; p=0{,}0003), ama etkinin tek bir doğrusal eğilimde toplandığı çok gruplu tasarımlarda kontrast F'den belirgin biçimde güçlüdür. Planlı kontrastların sınanması için önce F testinin anlamlı çıkması gerekmez.
38.10 Kaynaklar
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Benjamini, Y., & Yekutieli, D. (2001). The control of the false discovery rate in multiple testing under dependency. The Annals of Statistics, 29(4), 1165–1188. https://doi.org/10.1214/aos/1013699998
- Hochberg, Y. (1988). A sharper Bonferroni procedure for multiple tests of significance. Biometrika, 75(4), 800–802. https://doi.org/10.1093/biomet/75.4.800
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Hommel, G. (1988). A stagewise rejective multiple test procedure based on a modified Bonferroni test. Biometrika, 75(2), 383–386. https://doi.org/10.1093/biomet/75.2.383
- Hothorn, T., Bretz, F., & Westfall, P. (2008). Simultaneous inference in general parametric models. Biometrical Journal, 50(3), 346–363. https://doi.org/10.1002/bimj.200810425
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- MacKinnon, J. G., & White, H. (1985). Some heteroskedasticity-consistent covariance matrix estimators with improved finite sample properties. Journal of Econometrics, 29(3), 305–325. https://doi.org/10.1016/0304-4076(85)90158-7
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. Proceedings of the 9th Python in Science Conference, 92–96. https://doi.org/10.25080/Majora-92bf1922-011
- Searle, S. R., Speed, F. M., & Milliken, G. A. (1980). Population marginal means in the linear model: An alternative to least squares means. The American Statistician, 34(4), 216–221. https://doi.org/10.1080/00031305.1980.10483031
- Šidák, Z. (1967). Rectangular confidence regions for the means of multivariate normal distributions. Journal of the American Statistical Association, 62(318), 626–633. https://doi.org/10.1080/01621459.1967.10482935
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
- Wright, S. P. (1992). Adjusted p-values for simultaneous inference. Biometrics, 48(4), 1005–1013. https://doi.org/10.2307/2532694
- Zeileis, A. (2004). Econometric computing with HC and HAC covariance matrix estimators. Journal of Statistical Software, 11(10), 1–17. https://doi.org/10.18637/jss.v011.i10