170. İleri DMF: lojistik, Mantel-Haenszel, Lord, Raju
Şablon kimliği: dmf_ileri · Kategori: psikometri · Dil: R · Dosya: pro/sablonlar/psikometri/dmf_ileri.R (satır 1–245; üstbilgi 1–110) · Örnek veri: _ornek/verbal.csv · Paketler: difR 6.1.0 (R 4.5.3); Lord ve Raju için difR, ltm 1.2-0'ı çağırır
170.1 Ne işe yarar
Şablon, iki kategorili (0/1) maddelerde iki grup (referans ve odak) arasında değişen madde fonksiyonunu (DMF; İngilizce differential item functioning, DIF) dört yöntemle birlikte sınar. Soru şudur: aynı yeteneğe sahip, ama farklı gruptan iki kişinin aynı maddeyi doğru yanıtlama olasılığı eşit midir? Eşit değilse madde, ölçmek istediği yetenek dışında bir şey (dil, kültür, cinsiyet gibi bir grup özelliği) ölçüyor olabilir. Dört yöntem:
- Lojistik regresyon (Swaminathan ve Rogers, 1990): madde yanıtı, eşleştirme puanı ve grup ile modellenir; tek biçimli (grup farkı), tek biçimli olmayan (puanla etkileşim) ya da ikisi birlikte sınanır. Etki büyüklüğü olarak Nagelkerke ΔR² ve iki yayımlanmış sınıflama (Zumbo–Thomas, Jodoin–Gierl) verilir.
- Mantel-Haenszel (MH; Holland ve Thayer, 1988): eşleştirme puanının her düzeyinde 2×2 tablolar birleştirilir; \chi^2_{MH}, ortak odds oranı \alpha_{MH}, \Delta_{MH} ve ETS A/B/C sınıfı verilir.
- Lord \chi^2 (Lord, 1980): iki grupta ayrı kestirilen madde parametrelerinin (1PL'de güçlük, 2PL'de ayırt edicilik ve güçlük) eşitliği sınanır.
- Raju işaretli alan (Raju, 1988): iki grubun madde karakteristik eğrileri arasındaki işaretli alanın sıfır olup olmadığı sınanır.
Dört yöntem aynı maddeler üzerinde yan yana çalıştırılır ve özet tabloda hangi maddenin kaç yöntemde işaretlendiği gösterilir. İstenirse madde arındırma (purification) ve çoklu karşılaştırma düzeltmesi (Benjamini–Hochberg, Holm) uygulanır.
Ne zaman kullanılır?
- Bir testin maddelerinin iki grup (cinsiyet, dil, ülke, ölçek formu) arasında adil olup olmadığı denetlenecekse ve maddeler 0/1 ise.
- Yöntem seçimi sonucu etkileyebileceğinden, birkaç yöntemin uyumuna bakılacaksa.
- Küçük etkilerin sınıflandırılması gerekiyorsa (ETS, Zumbo–Thomas, Jodoin–Gierl): yalnız anlamlılık yetmez, etki büyüklüğü de gerekir.
Ne zaman kullanılmaz?
- Maddeler iki değil çok kategorili (sıralı) ise: bu şablon yalnız 0/1 madde kabul eder; sıralı maddeler için temel programdaki ordinal çözümlemeler ya da MerQuR+'ta
sirali_cfa_wlsmv(Bölüm 185) ile ölçüm değişmezliği. - İkiden çok grup varsa: şablon tam iki grup ister. Gruplar ayrı ayrı çiftler hâlinde çalıştırılır.
- DMF değil ölçüm değişmezliği (çok gruplu doğrulayıcı faktör analizi) sınanacaksa:
cok_duzeyli_cfa(Bölüm 179) ya da temel programın çok gruplu CFA'sı. - Çok boyutlu yapıyı ayırmak gerekiyorsa:
mirt_cok_boyutlu(Bölüm 174). - Madde parametreleri iki grup için ayrı ayrı kestirilip ortak ölçeğe taşınacaksa (bağlama):
irt_baglama(Bölüm 173),test_esitleme(Bölüm 176).
Temel programla ilişki. Temel programda DMF çözümlemesi yoktur; en yakını madde analizi ve lojistik regresyondur. Bu şablon difR paketinin (Magis ve ark., 2010) yöntemlerini ve arındırma döngüsünü olduğu gibi kullanır; ek olarak ETS sınıfı, Nagelkerke ΔR² sınıfları ve özet tablo şablonun kendi hesabıdır.
170.2 Şablonun girdileri
Form, üstbilgideki 15 [[param]] bloğundan kurulur (dmf_ileri.R:10–109). Türlerin anlamı ve formun ortak denetimi Bölüm 1.2'dedir.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Maddeler (0/1) · maddeler |
sütunlar (sayısal, en az 5) · Değişkenler | boş | en az 5 sayısal sütun | J madde (10–16, 115–116). |
Grup değişkeni · grup |
kategorik sütun · Değişkenler | boş | iki düzeyli sütun | Grup (17–21, 123–129). |
Odak grup düzeyi · odak |
metin · Seçenekler | boş | düzey adı | Boşsa ikinci düzey; hangisinin odak alındığı konsola yazılır (22–27, 130–136). |
Lojistik regresyon · lojistik |
onay · Seçenekler | açık | açık/kapalı | Yöntemi açar (28–33, 169). |
Lojistik DMF türü · lojistik_tur |
seçim · Model | both |
both, udif, nudif |
Sınanan terimler (34–40, 171). |
Mantel-Haenszel · mh |
onay · Seçenekler | açık | açık/kapalı | Yöntemi açar (41–46, 188). |
Lord χ² · lord |
onay · Seçenekler | açık | açık/kapalı | Yöntemi açar (47–52, 205). |
Raju işaretli alan · raju |
onay · Seçenekler | açık | açık/kapalı | Yöntemi açar (53–58, 215). |
Lord ve Raju için MTK modeli · irt_model |
seçim · Model | 1PL |
1PL, 2PL |
Madde modeli (59–65, 206, 216). |
Madde arındırma · arindirma |
onay · Seçenekler | açık | açık/kapalı | purify (66–71, 154). |
Çoklu karşılaştırma düzeltmesi · duzeltme |
seçim · Seçenekler | none |
none, BH, holm |
p.adjust.method (72–78, 154). |
Anlamlılık düzeyi · alfa |
ondalık · Seçenekler | 0,05 | 0,001–0,2 | Yöntemlerin kararı (79–87, 154). ETS sınıfları sabit 0,05. |
Lojistik DMF test ölçütü · lojistik_olcut |
seçim · Seçenekler | LRT |
LRT, Wald |
Lojistik istatistik (88–94, 170). |
MH süreklilik düzeltmesi · mh_duzeltme |
onay · Seçenekler | açık | açık/kapalı | correct (95–100, 189). |
En çok arındırma yinelemesi · arindirma_yineleme |
tamsayı · Gelişmiş | 20 | 1–200 | nrIter (101–109, 154). Yalnız arındırma açıkken etkili; yakınsamazsa uyarı yazılır. |
Şablonun kendi denetimleri (mq_hata; ileti özeti):
| Koşul | İleti | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 114 |
| Gruptan farklı madde sayısı <5 | "En az 5 madde seçin (gruptan farklı)." | 116 |
| Hiçbir yöntem seçili değil | "En az bir yöntem seçin." | 117 |
| Bir madde 0/1 dışında değer içeriyor | "'…' yalnız 0/1 değerleri içermeli." | 122 |
| Grup tam iki düzey içermiyor | "Grup değişkeni tam iki düzey içermeli (şu an N)." | 129 |
| Odak düzeyi grupta yok | "Odak grup '…' bulunamadı; düzeyler: …" | 136 |
| Bir grupta 20'den az tam yanıtlı kişi | "Her grupta en az 20 tam yanıtlı kişi gerekli." | 138 |
| Bir madde bütün kişilerde sabit | "Şu maddeler sabit (herkes aynı yanıtı vermiş); çıkarın: …" | 140 |
| Hiçbir yöntem çalıştırılamadı | "Seçilen yöntemlerin hiçbiri çalıştırılamadı." | 228 |
Bir yöntem difR hatasıyla kesilirse tek başına durmaz: konsola "Yöntem çalıştırılamadı: …" yazılır ve öteki yöntemler sürer (155–164). maddeler listesinde grup sütunu da seçilmişse sessizce çıkarılır (115). Bir madde yalnız bir grupta sabitse (herkes aynı yanıtı vermiş) hangi yöntem seçili olursa olsun konsola "Not: şu maddeler bir grupta sabit … değerlendirilemedi" yazılır (141–144); o maddenin sonuç sütunları (MH \alpha, \Delta, ETS; lojistik \chi^2, \Delta R^2, sınıflar; Lord ve Raju istatistikleri) boş bırakılır ve DMF yanlıştır. Eksik yanıt nedeniyle çıkarılan satır sayısı ve yüzdesi konsola yazılır; yüzde 10 ve üzerindeyse uyarı eklenir (148–153).
Örnek ayar (ornek_param, 9): 24 madde, grup = Gender, odak = erkek; öteki alanlar varsayılandır: dört yöntem açık, both, 1PL, arındırma açık, düzeltme yok, \alpha=0{,}05.
170.3 Örnek veri
verbal.csv: Vansteelandt'ın sözel saldırganlık verisinin (De Boeck ve Wilson, 2004) ikili kodlanmış biçimi; 316 kişi, 24 madde ve cinsiyet sütunu. Maddeler dört engellenme durumunda (S1–S4) iki tür yanıtı (istemek: Want, yapmak: Do) ve üç davranışı (küfretmek: Curse, azarlamak: Scold, bağırmak: Shout) sorar. Eksik yanıt yoktur. Veri, Magis ve ark. (2010) difR makalesinin DMF uygulamasında kullanılan veridir; şablonun doğrulama notu MH (arındırmalı) için 9 DMF maddesi bildirir (7); bu bölümdeki çalıştırma da 9 madde saptar.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
24 madde (S1wantCurse … S4DoShout) |
madde | ikili (binary) |
0/1; doğru yanıt oranı 0,092 (S3DoShout) ile 0,788 (S2WantCurse) arasında. |
Gender |
grup | ikili | kadin 243, erkek 73. |
Toplam puan: erkek ortalaması 12,33 (sd 5,37), kadın ortalaması 11,16 (sd 5,75), her iki grupta 0–24 aralığındadır.
Düzey sırası. İki düzeyli metin sütunu R'ye metin olarak gider (Bölüm 1.3) ve factor() düzeyleri alfabetik sıralar: erkek, kadin. Örnek ayar odağı açıkça erkek verir; odak boş bırakılırsa ikinci düzey kadin odak olur ve referans erkek olur: tablodaki \alpha_{MH}, \Delta_{MH} ve Raju Z işaret değiştirir. Aynı veride grup sayı kodlu olsaydı (2 ve 10) düzeyler sayısal sıralanır ve ikinci düzey 10 olurdu (p6_dmf_grup_sayi_bos: "referans 2: 243, odak 10: 73"). Şablon hangi düzeyin odak alındığını konsola yazar ("Odak grup boş bırakıldı: …"); yine de odağı her zaman açıkça yazın.
Bölümde kullanılan çalıştırmalar (hepsi verbal.csv, tohum 1; çıktılar dogrulama/cikti/p6_dmf_*):
| Ad | Ayar |
|---|---|
ornek |
örnek ayar (arındırmalı, tüm yöntemler). |
arsiz |
arindirma = false. |
holm, bh_arindirmali |
duzeltme = holm (arındırmasız); duzeltme = BH (arındırmalı). |
wald_udif, nudif |
lojistik_tur = udif, lojistik_olcut = Wald; lojistik_tur = nudif (arındırmasız). |
alfa001, pl2, mh_duzeltmesiz |
\alpha=0{,}01; irt_model = 2PL; mh_duzeltme = false (hepsi arındırmasız). |
odak_kadin, odak_bos |
odak kadin; odak boş. |
| uç durumlar | kod12, eksik, grup3, grup_sayi_bos, kucuk, kucuk2, grup_sabit, sabit, bosluk, yineleme1 (veri: dogrulama/dmf_ileri/dm_*.csv). |
170.4 Yöntem: formüller ve hesap adımları
Şablon dört bağımsız sınamayı aynı X (maddeler) ve gv (grup, 1 = odak) üzerinde çalıştırır. Her yöntem bir sonuç nesnesi döndürür; şablon bunları tabloya çevirir, ek sütunları (ΔR², ΔMH, sınıflar, iki yönlü p) hesaplar ve özet tabloda birleştirir. Dört yöntemin ortak noktası eşleştirmedir: karşılaştırılan iki kişi, grup dışında aynı yetenek düzeyine sahip olmalıdır.
170.4.1 Eşleştirme puanı ve madde arındırma
MH ve lojistik yöntemlerde yetenek, toplam puan ile eşleştirilir. j maddesi için eşleştirme puanı
- x_{ik}\in\{0{,}1\}: i kişisinin k maddesine yanıtı.
- \mathcal A_j: çapa (anchor) madde kümesi; j maddesi çapa kümesinde değilse eşleştirme puanına eklenir (difR
mantelHaenszel:if (sum(anchor == item) == 0) data2 <- cbind(data2, data[, item])).
Neden toplam puana madde kendisi de dahil?
Eşleştirmede ölçüt, doğru yanıt sayısının, yani kestirilmemiş bir yetenek göstergesinin kendisidir. Madde kendi puanına girmezse eşleştirme puanı eğri kayar; girerse madde DMF'si diğerlerinin kirliliğinden arınmış olmasa bile madde eşleştirmeye katılır. Arındırma bu kirliliği azaltır.
Madde arındırma (purification, Magis ve ark., 2010): ilk adımda bütün maddeler çapadır. Her madde sınanır, p<\alpha olanlar DMF kümesi \mathcal D_0 olur. Sonra çapa kümesi \mathcal A=\{1,\dots,J\}\setminus\mathcal D_{k-1} alınır ve maddeler yeniden sınanır; \mathcal D_k=\mathcal D_{k-1} olunca ya da k arindirma_yineleme değerine ulaşınca durulur. DMF'li bir madde, kendi eşleştirme puanına yine dahildir (yukarıdaki kural); ama öteki maddelerin puanından çıkarılmıştır. Arındırma adımlarında difR varsayılanı (puriadjType = "simple") çoklu karşılaştırma düzeltmesi uygulamaz; yalnız son karar düzeltmelidir.
Koddaki tercih
dmf_ileri.R:154: ort <- list(group = gv, focal.name = 1, purify = isTRUE(P$arindirma), nrIter = as.integer(P$arindirma_yineleme), alpha = P$alfa, p.adjust.method = ...). Tüm yöntemler (difLogistic, difMH, difLord, difRaju) bu ortak liste ile çağrılır (155–164); difR uyarıları bastırılır (suppressWarnings). Arındırma yakınsamazsa difR'ın convergence alanı FALSE olur; şablon bu alanı okur: "Uyarı: … madde arındırması N yinelemede yakınsamadı; sonuç son ara kümeye dayanır" yazılır ve özet tablonun başlığı "arındırmalı" yerine "arındırma yakınsamadı" der (159–163, 230–231).
170.4.2 Mantel-Haenszel
Her eşleştirme puanı düzeyi s (katman) için referans ve odak grubun doğru/yanlış sayıları 2×2 tablo kurar:
| doğru (y=1) | yanlış (y=0) | toplam | |
|---|---|---|---|
| referans | A_s | B_s | n_{Rs} |
| odak | C_s | D_s | n_{Fs} |
| toplam | m_{1s} | m_{0s} | T_s |
Yalnız T_s>1 katmanlar hesaba girer. Ortak odds oranı ve istatistik:
- \hat\alpha_{MH}: katmanlar boyunca ortak odds oranı (referans ÷ odak); \hat\alpha_{MH}>1 referans grubu, <1 odak grubu kayırır.
- \chi^2_{MH}: 1 sd'li ki-kare; 0{,}5 Yates süreklilik düzeltmesidir (
mh_duzeltmekapalıysa çıkarılır). - E(A_s), \mathrm{Var}(A_s): sıfır varsayımı altında (hipergeometrik) beklenen değer ve varyans.
Neden süreklilik düzeltmesi varsayılan?
\chi^2_{MH} ayrık bir toplamın sürekli ki-kare yaklaşımıdır; 0{,}5'lik düzeltme küçük örneklemde p değerinin aşırı küçük çıkmasını önler. Düzeltme kapalıyken istatistik daima daha büyüktür (S2DoScold: 7{,}767 ve 6{,}839).
ETS ölçeğine çevrilmiş etki büyüklüğü ve onun varyansı (Robins ve ark., 1986):
- -2{,}35: ETS delta ölçeğine dönüştürme çarpanı; negatif \Delta_{MH} referans grubu kayırır, pozitif \Delta_{MH} odak grubu kayırır.
- P_s,Q_s,R_s,S_s: Robins–Breslow–Greenland varyans formülünün katman toplamları (difR:
varLambda).
Neden -2{,}35\ln\alpha?
ETS, odds oranını madde güçlüğü ölçeği olan "delta" ölçeğine (13+4z) çevirir; \ln\alpha'nın lojistik ölçekten delta ölçeğine karşılığı -4/1{,}702=-2{,}35'tir. Böylece DMF, "madde güçlüğünde kaç delta birimi fark" olarak okunur (Holland ve Thayer, 1988).
170.4.3 ETS A/B/C sınıfı
Şablon (193–196) sınıflamayı Zieky (1993) tanımıyla verir ve \alpha_{ETS}=0{,}05'i sabit tutar (kullanıcının alfa ayarından bağımsız):
- z_{0{,}95}=1{,}645: H_0:|\Delta_{MH}|\le 1 için tek yönlü %5 sınırı.
- p_{MH}: arındırmalı çalıştırmada son adımın düzeltilmemiş MH p'si.
Neden α sabit?
ETS tanımı bir sınıflama kuralıdır, karar eşiği değil: A sınıfında "anlamlı değil" demek, kullanıcının seçtiği \alpha'ya göre değişirse |\Delta|\ge 1{,}5 kuralı da anlamsızlaşır. Şablon bu yüzden ETS koşullarını her zaman 0,05'te sınar; alfa yalnız yöntemlerin DMF kararını (ve DMF sütununu) etkiler.
170.4.4 Lojistik regresyon
Madde j'nin yanıtı y, eşleştirme puanı S ve grup G (odak =1) için üç iç içe model:
- \beta_2\ne0: tek biçimli DMF (iki grubun eğrileri paralel, birbirinden uzak); \beta_3\ne0: tek biçimli olmayan DMF (eğrilerin eğimi farklı).
both: M_0 ile M_2 karşılaştırılır (2 sd);udif: M_0 ile M_1 (1 sd);nudif: M_1 ile M_2 (1 sd).
Olabilirlik oranı ölçütü: \chi^2_{LR}=2(\ell_{\text{büyük}}-\ell_{\text{küçük}}). Wald ölçütü: sınanan katsayı(lar)ın \hat\beta'\hat V^{-1}\hat\beta istatistiği; udif'te \hat\beta_2^2/\hat V_{22}, both'ta (\hat\beta_2,\hat\beta_3) ortak. Etki büyüklüğü, Nagelkerke (1991) R^2'sinin iki model arasındaki farkıdır:
- \ell: modelin logaritmik olabilirliği; \ell_{\text{boş}}: yalnız sabitli modelin logaritmik olabilirliği; n: kişi sayısı.
Şablon iki sınıflamayı (174–178) \Delta R^2 aralıklarıyla verir (right = FALSE: alt sınır dahil):
| Sınıf | Zumbo–Thomas (Zumbo, 1999) | Jodoin–Gierl (2001) |
|---|---|---|
| A (önemsiz) | \Delta R^2<0{,}13 | \Delta R^2<0{,}035 |
| B (orta) | 0{,}13\le\Delta R^2<0{,}26 | 0{,}035\le\Delta R^2<0{,}07 |
| C (büyük) | \Delta R^2\ge0{,}26 | \Delta R^2\ge0{,}07 |
Sınıf anlamlılıkla birlikte verilir
Yayımlanmış sınıflamalar B ve C için ayrıca testin anlamlı olmasını ister (Zumbo, 1999; Jodoin ve Gierl, 2001). Şablon testin anlamlı olmadığı (DMF yanlış) maddeye her iki sınıflamada da "A" yazar; B ve C yalnız DMF doğru olan ve \Delta R^2 eşiğini aşan maddelere verilir (176–178). 40 + 20 kişilik altkümede S2WantShout (p=0{,}071, \Delta R^2=0{,}077) bu yüzden "A"dır; yalnız eşiğe bakılsaydı Jodoin–Gierl C olurdu.
170.4.5 Lord \chi^2
Her grupta madde parametreleri ayrı ayrı kestirilir (ltm paketi, marjinal en çok olabilirlik, 21 Gauss–Hermite noktası; difR itemParEst). 1PL'de her maddenin yalnız güçlüğü b vardır (ayırt edicilik 1'e sabitlenir, yetenek N(0{,}1) kabul edilir); 2PL'de (a,b). İki grubun yetenek ölçekleri farklı olduğundan odak grubun parametreleri referans ölçeğe taşınır (difR itemRescale; tüm maddeler çapa):
- \bar b_R,\bar b_F: çapa maddelerin ortalama güçlükleri; s(\cdot) standart sapma.
- 1PL'de yalnız kayma (ortalama), 2PL'de ortalama–standart sapma (A,B) dönüşümü uygulanır; standart hatalar se(b^*)=A\,se(b), se(a^*)=se(a)/A olur.
Lord istatistiği iki grubun parametre vektörlerinin farkının Wald istatistiğidir:
1PL'de bu (b_R-b^*_F)^2/(se_R^2+se_F^2) ve 1 sd'li; 2PL'de 2 sd'lidir.
170.4.6 Raju işaretli alan
İki madde karakteristik eğrisi arasındaki işaretli alan, 2PL ve 1PL için (ve yalnız bu iki model için, üçüncü parametre kullanılmaz) güçlük farkına eşittir (Raju, 1988). difR signed = TRUE ile çağrılır ve
- Z_j>0: odak grupta madde daha zordur (eğri sağa kaymış); Z_j<0: odak grupta daha kolaydır.
difR işaretli alanda p'yi 2\bigl(1-\Phi(Z)\bigr) olarak verir; negatif Z için bu değer 1'den büyük olabilir. Şablon bu nedenle p'yi yeniden hesaplar (218–219):
1PL'de iki grubun ayırt edicilikleri eşit (1) olduğundan Raju Z'sinin karesi Lord \chi^2'sine eşittir ve iki yöntemin p değerleri aynıdır (örnekte \chi^2=6{,}584, Z=-2{,}566). Bu yüzden 1PL'de iki yöntem aynı kararı verir; 2PL'de farklı sonuç verebilirler (ayırt edicilik farkı yalnız Lord'a girer).
170.4.7 Karar kuralları ve düzeltme
- Lojistik, MH, Lord: difR
DIFitems'ı döndürür: düzeltmesiz iken p<\alpha; düzeltme açıkken düzeltilmiş p<\alpha. ŞablonDMFsütununu bu kümeden doldurur (175, 199, 209, 222); bir grupta sabit maddeler her zaman yanlıştır. - Raju: karar difR'dan gelir (|Z| eşik üstü); p sütunu iki yönlü 2\Phi(-|Z|)'dir; düzeltme
p.adjust(pz, duzeltme)ile şablonda uygulanır (221). - Özet tablo: her yöntemin
DMFsütunu yan yana veyontem_sayisi(kaç yöntem işaretledi) (228–231). - Şekil: her yöntemin istatistiği ve düzeltilmemiş eşik; noktaların rengi yöntemin
DMFkararına göredir (233–244).
Koddaki tercih
Lojistik, MH ve Lord için p ve düzeltilmiş p difR'dan, ETS ve ΔR² sınıfları şablondan, Raju p ve düzeltilmiş p şablondan gelir. Tabloda p_duzeltilmis, düzeltme none ise p ile aynıdır (165: padj <- function(r) if (!is.null(r$adjusted.p)) r$adjusted.p else r$p.value).
170.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–110 | Üstbilgi: 15 parametre, örnek veri ve ayar. | Yan dosyalar (*.ceviri.json, *.tablo.json, .sas) kitap dışıdır (Bölüm 1.1). |
| 111–113 | Dil yardımcısı .m, library(difR). |
difR yoksa şablon çalışmaz. |
| 114–121 | Veri denetimi, md <- setdiff(P$maddeler, P$grup), en az 5 madde, en az bir yöntem, d, complete.cases. |
Eksik değerli kişi tüm yöntemlerden çıkar; sayısı 148–153'te yazılır. |
| 122–136 | 0/1 denetimi, grup düzeyleri (kırpılır; hepsi sayıysa sayısal, değilse harf sırası), iki düzey denetimi, odak (boşsa ikinci düzey, konsola yazılır). | Düzey sırası Bölüm 1.3'te; odak ve düzeyler aynı biçimde kırpılır. |
| 137–153 | Grup başına n\ge20, sabit madde, grupta sabit madde notu (degersiz), gv, konsol satırı, atılan satır notu. |
Sabit madde hatası yalnız tümden sabiti yakalar; grupta sabit madde değerlendirilmez. |
| 154–166 | ort ortak liste; kos() her yöntemi tryCatch ve suppressWarnings içinde çağırır, convergence'ı okur. |
Arındırma yakınsamazsa uyarı yazılır. |
| 168–187 | Lojistik: difLogistic, ΔR² sınıfları (anlamsız madde A), tablo 1. |
|
| 188–204 | MH: difMH, \Delta_{MH}, SE, ETS, tablo 2. |
ETS sabit 0,05 (193). |
| 205–214 | Lord: difLord, tablo 3. |
1PL ayırt edicilik 1 sabit. |
| 215–227 | Raju: difRaju(signed = TRUE), iki yönlü p, tablo 4. |
difR'ın p'si negatif Z'de 1'i aşabilir (218). |
| 228–231 | Özet tablo (yontem_sayisi; başlıkta arındırma durumu). |
Hiçbir yöntem çalışmadıysa hata (228). |
| 233–244 | Çok panelli şekil: istatistik, düzeltmesiz eşik, DMF kararına göre renk. | Raju panelinde |Z| çizilir. |
Süre: örnek ayarda çalıştırma 6,7 s sürmüştür (2PL: 9,7 s).
170.6 Elle hesap: örnek veride bağımsız yeniden hesap
Hesap S2DoScold maddesinin arındırmasız çalıştırılması (arindirma = false) için gösterilir; eşleştirme puanı 24 maddenin toplamıdır (n=316: 243 referans, 73 odak). Sayılar dogrulama/dmf_ileri/elle_hesap.py (numpy/scipy; difR kullanılmaz) ve r_dogrulama.R çıktısındandır.
Adım 1 — MH katman toplamları. Toplam puanın 25 farklı düzeyi T_s>1 taşır. Referans grupta doğru yanıt sayısı \sum_sA_s=106; sıfır varsayımı altında beklenen \sum_sE(A_s)=114{,}116266; fark -8{,}116266 (referans grup beklenenden az doğru yanıtlamış). \sum_s\mathrm{Var}(A_s)=8{,}481269.
Adım 2 — MH istatistiği.
Adım 3 — Ortak odds oranı ve ΔMH. \sum_sA_sD_s/T_s=4{,}862170 ve \sum_sB_sC_s/T_s=12{,}978437:
RBG varyansı \widehat{\mathrm{Var}}(\ln\hat\alpha)=0{,}133455, dolayısıyla SE(\Delta_{MH})=2{,}35\sqrt{0{,}133455}=0{,}858491. ETS: |\Delta|\ge1{,}5 ve (2{,}307240-1)/0{,}858491=1{,}523>1{,}645 değildir; p<0{,}05 olduğundan sınıf B olur. (Arındırmalı çalıştırmada eşleştirme puanı 9 DMF maddesinden arındırılır ve \Delta_{MH}=2{,}81861, sınıf C çıkar; 170.7.)
Adım 4 — Lojistik, tek biçimli ve tek biçimli olmayan birlikte. Logaritmik olabilirlikler: boş model -218{,}933232; M_0 (yalnız puan) -150{,}651646; M_2 (puan, grup, etkileşim) -145{,}520549:
Nagelkerke: R^2_N(M_0)=0{,}467961, R^2_N(M_2)=0{,}495622, \Delta R^2=0{,}027661. Zumbo–Thomas sınıfı A, Jodoin–Gierl sınıfı A (eşik 0,035).
Adım 5 — Lord \chi^2 ve Raju Z (1PL). Referans grupta \hat b_R=0{,}324641 (se=0{,}160653), odak grupta \hat b_F=-0{,}830998 (se=0{,}298766); 24 maddenin ortalama güçlük farkı \bar b_R-\bar b_F=0{,}285207, bu yüzden b^*_F=-0{,}545791:
Z^2=6{,}5842=\chi^2_{Lord} ve iki yönlü p=0{,}01029.
Adım 6 — Arındırma döngüsü. MH'de ilk geçiş 6 madde, ardından arındırma 9 madde (\mathcal D_1), \mathcal D_2=\mathcal D_1 olunca durur. Aynı döngü bağımsız Python ve R kodlarıyla yazılmıştır; kümeler ve her madde için \chi^2_{MH}, \Delta_{MH} ve SE aynıdır.
170.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | Ölçüt | |
|---|---|---|---|---|---|---|
| MH χ², S2DoScold (arındırmasız) | 6,83948547 | 6,83948547 | 6,83948547 | 1,0e−15 | 1e−6 | ✓ |
| MH \alpha_{MH}, S2DoScold | 0,37463451 | 0,37463451 | 0,37463451 | 1,7e−16 | 1e−6 | ✓ |
| MH χ², S1DoScold (arındırmasız) | 2,75011391 | 2,75011391 | 2,75011391 | 9,7e−16 | 1e−6 | ✓ |
| MH \alpha_{MH}, S1DoScold | 0,49948412 | 0,49948412 | 0,49948412 | 2,2e−16 | 1e−6 | ✓ |
| MH χ², S3WantScold (arındırmasız) | 0,67521634 | 0,67521634 | 0,67521634 | 3,8e−15 | 1e−6 | ✓ |
| MH \alpha_{MH}, S3WantScold | 0,71936526 | 0,71936526 | 0,71936526 | 5,6e−16 | 1e−6 | ✓ |
| MH \Delta_{MH}, S2DoCurse | 2,6708548 | 2,6708548 | 2,6708548 | 1,2e−15 | 1e−6 | ✓ |
| MH SE(\Delta_{MH}), S2DoCurse (RBG varyansı) | 1,00356557 | 1,00356557 | — | 2,0e−15 | 1e−6 | ✓ |
| MH χ² (24 maddenin toplamı) | 56,28326133 | 56,28326133 | 56,28326133 | 1,3e−16 | 1e−6 | ✓ |
| MH p, S2DoScold | 0,00891645 | 0,00891645 | 0,00891645 | 6,9e−17 | 1e−6 | ✓ |
| Lojistik LR χ² (2 sd), S2DoScold | 10,26219409 | 10,26219409 | 10,26219409 | 7,3e−15 | 1e−6 | ✓ |
| Lojistik \Delta R^2 (Nagelkerke), S2DoScold | 0,0276609 | 0,0276609 | 0,0276609 | 2,8e−16 | 1e−6 | ✓ |
| Lojistik LR χ² (2 sd), S3DoCurse | 7,23786199 | 7,23786199 | 7,23786199 | 2,5e−16 | 1e−6 | ✓ |
| Lojistik \Delta R^2 (Nagelkerke), S3DoCurse | 0,02316679 | 0,02316679 | 0,02316679 | 9,7e−17 | 1e−6 | ✓ |
| Lojistik LR χ² (2 sd), S2WantShout | 11,41109401 | 11,41109401 | 11,41109401 | 2,2e−15 | 1e−6 | ✓ |
| Lojistik \Delta R^2 (Nagelkerke), S2WantShout | 0,034273 | 0,034273 | 0,034273 | 3,0e−16 | 1e−6 | ✓ |
| Lojistik LR χ² (24 maddenin toplamı) | 90,3261203 | 90,3261203 | 90,3261203 | 1,1e−15 | 1e−6 | ✓ |
| Lojistik p, S2DoScold | 0,00591007 | 0,00591007 | 0,00591007 | 2,5e−16 | 1e−6 | ✓ |
| Tek biçimli olmayan LR χ² (1 sd), S2DoScold | 1,12206341 | 1,12206341 | 1,12206341 | 4,8e−14 | 1e−6 | ✓ |
| Tek biçimli olmayan \Delta R^2, S2DoScold | 0,00298088 | 0,00298088 | 0,00298088 | 3,4e−16 | 1e−6 | ✓ |
| Tek biçimli \Delta R^2, S2DoScold (Wald ölçütü seçili) | 0,02468003 | 0,02468003 | 0,02468003 | 1,0e−16 | 1e−6 | ✓ |
| Lojistik Wald χ² (tek biçimli, 1 sd), S2DoScold | 8,74122463 | 8,74122087 | 8,74122463 | 4,3e−7 | 1e−4 | ✓ |
| Lojistik Wald χ² (tek biçimli, 1 sd), 24 maddenin toplamı | 71,55468099 | 71,5539743 | 71,55468099 | 9,9e−6 | 1e−4 | ✓ |
| Lojistik Wald χ² (ikisi birlikte, 2 sd), S2DoScold | 10,47975399 | — | 10,47975399 | 0 | 1e−6 | ✓ |
| Lojistik Wald χ² (ikisi birlikte, 2 sd), 24 maddenin toplamı | 88,08157926 | — | 88,08157926 | 0 | 1e−6 | ✓ |
| MH χ² süreklilik düzeltmesiz, S2DoScold | 7,76697248 | 7,76697248 | 7,76697248 | 1,1e−15 | 1e−6 | ✓ |
| Lord χ² (1PL), S2DoScold | 6,58423622 | 6,58609141 | 6,58423622 | 2,8e−4 | 1e−2 | ✓ |
| Raju Z (1PL), S2DoScold | −2,56597666 | −2,56633813 | −2,56597666 | 1,4e−4 | 1e−2 | ✓ |
| Lord χ² (1PL), S3DoCurse | 5,42061417 | 5,41720526 | 5,42061417 | 6,3e−4 | 1e−2 | ✓ |
| Raju Z (1PL), S3DoCurse | −2,32822125 | −2,32748905 | −2,32822125 | 3,1e−4 | 1e−2 | ✓ |
| Lord χ² (1PL), 24 maddenin toplamı | 56,31700353 | 56,35293712 | 56,31700353 | 6,4e−4 | 1e−2 | ✓ |
| Raju p (iki yönlü; 2\Phi(-\lvert Z\rvert)), S2DoScold | 0,01028858 | 0,01027786 | 0,01028858 | 1,1e−5 | 1e−2 | ✓ |
| Lord χ² (2PL), S2DoScold | 6,96835439 | — | 6,96835439 | 0 | 1e−6 | ✓ |
| Lord χ² (2PL), S1DoScold | 3,74479874 | — | 3,74479874 | 0 | 1e−6 | ✓ |
| Raju Z (2PL, işaretli), S2DoScold | −2,63379363 | — | −2,63379363 | 0 | 1e−6 | ✓ |
| Raju Z (2PL, işaretli), S4DoScold | −1,92071274 | — | −1,92071274 | 0 | 1e−6 | ✓ |
| MH χ² arındırmalı, S2DoScold | 11,94363843 | 11,94363843 | 11,94363843 | 1,5e−16 | 1e−6 | ✓ |
| MH χ² arındırmalı, S3WantScold | 4,37243424 | 4,37243424 | 4,37243424 | 1,6e−15 | 1e−6 | ✓ |
| MH χ² arındırmalı, S4DoCurse | 3,93230312 | 3,93230312 | 3,93230312 | 9,6e−15 | 1e−6 | ✓ |
| MH \Delta_{MH} arındırmalı, S4DoCurse | 1,75264237 | 1,75264237 | 1,75264237 | 2,0e−15 | 1e−6 | ✓ |
| MH SE(\Delta_{MH}) arındırmalı, S4DoCurse | 0,81932571 | 0,81932571 | — | 2,2e−16 | 1e−6 | ✓ |
| MH arındırmalı DMF sayısı (bayrak \sum) | 9 | 9 | 9 | 0 | 1e−6 | ✓ |
| MH arındırmalı DMF kümesi (madde numaraları toplamı, 0 tabanlı) | 136 | 136 | 136 | 0 | 1e−6 | ✓ |
| Lojistik LR χ² arındırmalı, S2DoScold | 12,67293975 | 12,67293975 | 12,67293975 | 4,5e−15 | 1e−6 | ✓ |
| Lojistik \Delta R^2 arındırmalı, S2DoScold | 0,0352478 | 0,0352478 | 0,0352478 | 1,2e−16 | 1e−6 | ✓ |
| Lojistik LR χ² arındırmalı, S1DoScold | 7,19266465 | 7,19266465 | 7,19266465 | 7,4e−15 | 1e−6 | ✓ |
| Lojistik \Delta R^2 arındırmalı, S1DoScold | 0,01881 | 0,01881 | 0,01881 | 1,0e−16 | 1e−6 | ✓ |
| Lojistik arındırmalı DMF sayısı | 6 | 6 | 6 | 0 | 1e−6 | ✓ |
Ölçütü karşılayan: 48/48. Arındırmasız satırlar arindirma = false, arındırmalı satırlar örnek ayarla (arindirma = true) çalıştırılmıştır. Lord ve Raju (1PL) satırlarında Python sütunu kendi Gauss–Hermite MML kestirimimizdir; ltm'in 21 noktalı kareleme yaklaşımından göreli \approx 4\cdot10^{-3} sapar (ölçüt 10^{-2}). Wald satırlarında ölçüt 10^{-4}'tür: R'ın glm yinelemesi göreli 10^{-8} sapma payıyla durur, bağımsız Python IRLS'i daha sıkı yakınsar. 2PL satırlarında Python ikizi yoktur.
MH ve lojistik büyüklükler üç yolda 10^{-13} içinde aynıdır; arındırmalı satırlar ornek çalıştırmasından, arındırmasızlar arsiz, nudif, wald_udif ve mh_duzeltmesiz çalıştırmalarındandır. Lord ve Raju (1PL) için R sütunu ltm::rasch ile doğrudan hesaptır ve MerQuR+ ile 10^{-15} içinde eşleşir; Python sütunu kendi Gauss–Hermite eniyilememizdir ve ltm'in kareleme yaklaşımından göreli 10^{-3} sapar (ölçüt 10^{-2}). 2PL'de R sütunu ltm'in 2PL uydurmasını doğrudan kullanır. Wald satırlarında R'ın glm yinelemesinin sınırı nedeniyle ölçüt 10^{-4}'tür.
170.7 Çıktıyı okuma
Örnek ayarın konsol satırı:
n = 316 (referans kadin: 243, odak erkek: 73); madde sayısı = 24
Beş tablo ve bir şekil üretilir (p6_dmf_ornek). Tablolardan DMF saptanan satırlar (tam tablo 24 satırdır):
Tablo 1. Lojistik regresyon DMF (both, olabilirlik oranı)
| madde | LR_ki_kare | sd | p | p_duzeltilmis | delta_R2 | Zumbo_Thomas | Jodoin_Gierl | DMF |
|---|---|---|---|---|---|---|---|---|
| S2WantShout | 7.40794 | 2 | 0.02463 | 0.02463 | 0.02107 | A | A | TRUE |
| S1DoScold | 7.19266 | 2 | 0.02742 | 0.02742 | 0.01881 | A | A | TRUE |
| S2DoCurse | 10.18851 | 2 | 0.00613 | 0.00613 | 0.03267 | A | A | TRUE |
| S2DoScold | 12.67294 | 2 | 0.00177 | 0.00177 | 0.03525 | A | B | TRUE |
| S3DoCurse | 9.11520 | 2 | 0.01049 | 0.01049 | 0.02939 | A | A | TRUE |
| S3DoScold | 7.46050 | 2 | 0.02399 | 0.02399 | 0.02753 | A | A | TRUE |
Tablo 2. Mantel-Haenszel DMF (süreklilik düzeltmeli)
| madde | MH_ki_kare | p | p_duzeltilmis | alfa_MH | delta_MH | SH_delta_MH | ETS | DMF |
|---|---|---|---|---|---|---|---|---|
| S2WantShout | 4.26799 | 0.03884 | 0.03884 | 2.20880 | −1.86226 | 0.84642 | B | TRUE |
| S3WantScold | 4.37243 | 0.03652 | 0.03652 | 0.45931 | 1.82835 | 0.81064 | B | TRUE |
| S1DoScold | 6.27363 | 0.01225 | 0.01225 | 0.38322 | 2.25400 | 0.86193 | B | TRUE |
| S2DoCurse | 9.66720 | 0.00188 | 0.00188 | 0.26584 | 3.11344 | 0.96053 | C | TRUE |
| S2DoScold | 11.94364 | 0.00055 | 0.00055 | 0.30137 | 2.81861 | 0.83743 | C | TRUE |
| S3DoCurse | 9.46439 | 0.00209 | 0.00209 | 0.37128 | 2.32838 | 0.74913 | C | TRUE |
| S3DoScold | 6.43564 | 0.01119 | 0.01119 | 0.40787 | 2.10748 | 0.80137 | B | TRUE |
| S4DoCurse | 3.93230 | 0.04737 | 0.04737 | 0.47435 | 1.75264 | 0.81933 | B | TRUE |
| S4DoScold | 5.79868 | 0.01604 | 0.01604 | 0.41476 | 2.06811 | 0.80131 | B | TRUE |
Tablo 3 ve 4 (Lord χ² ve Raju, 1PL) aynı altı maddeyi işaretler; ör. S2DoScold: Lord χ² = 9,22576 (p=0{,}00239), Raju Z=-3{,}03739.
Tablo 5. Özet: DMF saptanan maddeler (α = 0.05, arındırmalı)
| madde | lojistik | MH | Lord | Raju | yontem_sayisi |
|---|---|---|---|---|---|
| S2WantShout, S1DoScold, S2DoCurse, S2DoScold, S3DoCurse, S3DoScold | TRUE | TRUE | TRUE | TRUE | 4 |
| S3WantScold, S4DoCurse, S4DoScold | FALSE | TRUE | FALSE | FALSE | 1 |
| öteki 15 madde | FALSE | FALSE | FALSE | FALSE | 0 |
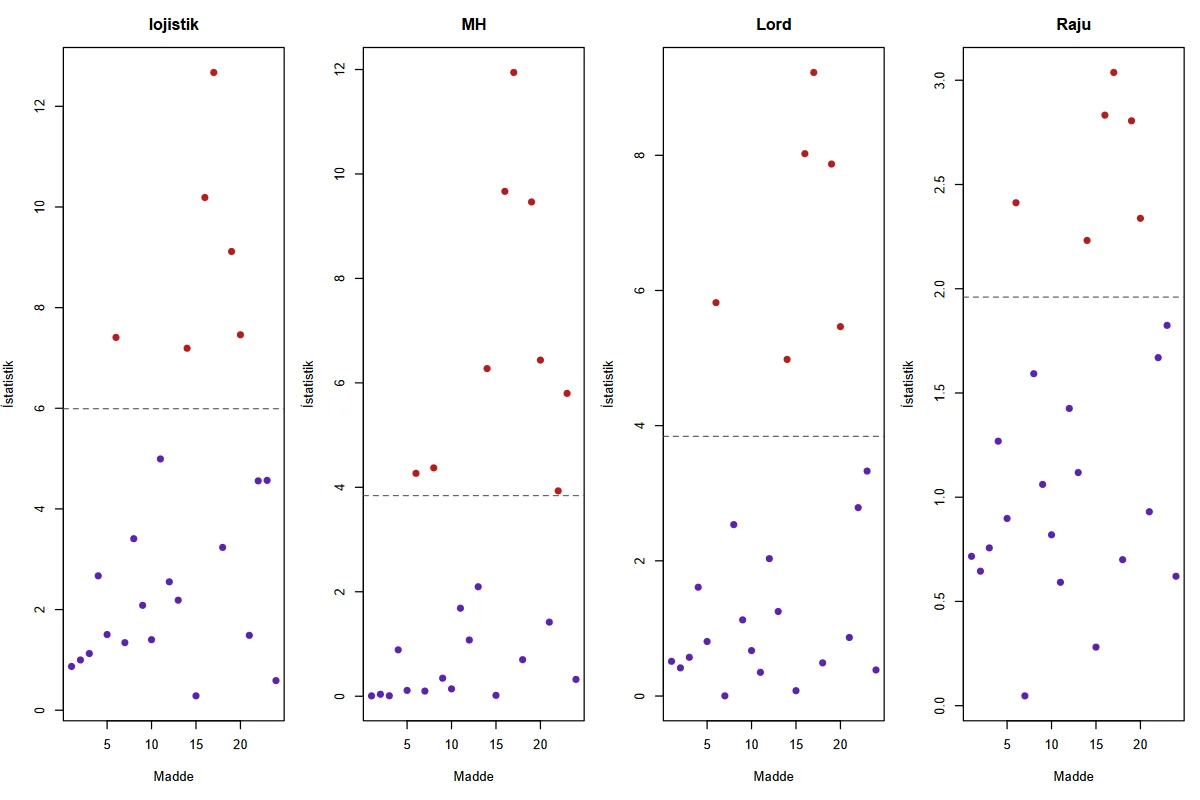
Şekil 170.1. Şablonun çizdiği DMF istatistikleri. Her panel bir yöntemin 24 madde için istatistiğini, kesikli çizgi α = 0,05'e karşılık gelen düzeltilmemiş eşiği gösterir; kırmızı noktalar yöntemin `DMF` kararını (α ve çoklu karşılaştırma düzeltmesi dahil) gösterir. Raju panelinde |Z| çizilir.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
LR_ki_kare, sd, p |
Lojistik sınama istatistiği, serbestlik derecesi ve p. | p<\alpha ise madde işaretlenir. |
delta_R2 |
Nagelkerke R^2 farkı. | Önemlilik ölçüsü; küçük \Delta R^2 (0,01–0,03) pratikte önemsizdir. |
Zumbo_Thomas, Jodoin_Gierl |
\Delta R^2'nin A/B/C sınıfı. | Testin anlamlı olduğu maddelerde ΔR² eşiğine göre; anlamsız madde A (170.4.4). |
MH_ki_kare, alfa_MH |
\chi^2_{MH} ve ortak odds oranı. | \alpha_{MH}<1: odak grubu kayırır. |
delta_MH, SH_delta_MH |
\Delta_{MH} ve standart hatası. | ETS ölçeğinde fark; $\lvert\Delta |
| vert\ge 1{,}5$ büyük. | ||
ETS |
A/B/C. | C: DMF büyük ve anlamlı; B: orta; A: önemsiz. |
Lord_ki_kare |
Parametre eşitliği sınaması. | 1PL'de 1 sd, 2PL'de 2 sd. |
Raju_Z |
İşaretli alan Z. | Negatif: odak grupta madde daha kolay. |
p_duzeltilmis |
Düzeltme açıkken düzeltilmiş p. | DMF bu sütuna göre karar verir. |
DMF |
\alpha'da karar. | Yöntemin kendi kararı. |
yontem_sayisi |
Özet tabloda kaç yöntem işaretledi. | 4: yöntemlerin uyumu; 1: yönteme bağlı bulgu. |
Okuma. Örnek veride yedi "yapmak" (Do) maddesi odak grup (erkek) lehine kayar (\alpha_{MH}<1, \Delta_{MH}>0, Raju Z<0): aynı toplam puanda erkekler bu davranışlarda "evet" deme olasılığı kadınlardan yüksektir. Altı madde dört yöntemde birden işaretlenir; en büyük etkiler S2DoCurse, S2DoScold ve S3DoCurse'tur (ETS C). MH'nin ek üç madde işaretlemesi yöntemler arası güç farkından gelir; ΔR² bu üç maddede de küçüktür (Jodoin–Gierl: A).
Çoklu karşılaştırma düzeltmesinin etkisi büyüktür. Arındırmasız çalıştırmada her yöntem 4–6 madde işaretler; Holm düzeltmesi ile lojistik, Lord ve Raju 0, MH yalnız 1 madde (p6_dmf_holm); BH ve arındırma ile lojistik 1, MH, Lord ve Raju 3 madde (p6_dmf_bh_arindirmali). 24 maddede 24 sınama yapıldığından düzeltmesiz sonuç yanlış pozitifleri içerebilir.
Rapor cümlesi (örnek ayar): Sözel saldırganlık ölçeğinin 24 ikili maddesinde (316 kişi; 243 kadın, referans; 73 erkek, odak) DMF, Mantel-Haenszel, lojistik regresyon, Lord \chi^2 ve Raju işaretli alan yöntemleriyle ve madde arındırmasıyla sınanmıştır (difR 6.1.0; Magis ve ark., 2010). Altı maddede (S2WantShout, S1DoScold, S2DoCurse, S2DoScold, S3DoCurse, S3DoScold) dört yöntem de \alpha=0{,}05'te DMF saptamıştır; Mantel-Haenszel üç maddeyi daha işaretlemiştir. ETS sınıflamasına göre S2DoCurse, S2DoScold ve S3DoCurse büyük (C), altı madde orta (B) düzeydedir; bütün DMF'li "yapmak" maddeleri erkekler lehinedir (\Delta_{MH}=1{,}75–3{,}11). Çoklu karşılaştırma düzeltmesi uygulanmamıştır.
170.8 Sık hatalar ve tuzaklar
- Odak grubu yazmamak.
odakboşsa ikinci düzey (iki düzeyli metinde alfabetik ikinci; sayı kodlu grupta sayısal sıradaki ikinci) odak olur ve tüm işaretler değişir. Örnek veride boş odakkadin'ı odak yapar. Şablon hangi düzeyin odak alındığını konsola yazar; yine de her zaman yazın. - Çoklu karşılaştırma düzeltmesini unutmak. 24 maddede düzeltmesiz \alpha=0{,}05 yanlış pozitif üretir; örnekte Holm düzeltmesi lojistik, Lord ve Raju'nun 4 maddesini sıfıra indirir. Raporda düzeltme açıkça belirtilmelidir.
- ETS sınıfını düzeltilmiş karar sanmak. ETS her zaman düzeltilmemiş p<0{,}05 ile verilir;
duzeltme = holmikenDMFyanlış, ETS "B" olan madde görülebilir (holm: MH'de 6 madde ETS \ne A, 1 maddeDMFdoğru). - Arındırma yakınsamadan sonuç okumak.
arindirma_yinelemeküçük ya da yöntem kararsızsa difR yakınsamaz; şablon bunu uyarıyla ve özet başlığındaki "arındırma yakınsamadı" ile bildirir, ama sonuç yine son ara kümeye dayanır (yineleme1: MH 5 madde, yakınsamış çözüm 9 madde). Uyarı çıkarsa yineleme sayısını artırın. - Küçük örneklem ve seyrek tablolar. Her grupta en az 20 kişi zorunludur; ama 20 kişilik odak grupta MH katmanları seyrektir, \Delta_{MH} standart hataları 1,5–2,7'ye çıkar ve hiçbir madde ETS "A"dan yukarı çıkmaz (
kucuk2: 40 + 20 kişi, 24 madde "A"). Bu bir hata değil, gücün düşüklüğüdür. - Bir grupta tümü aynı yanıt veren madde. Böyle maddede MH'nin \alpha_{MH} değeri sonsuz, lojistik regresyon tam ayrışmalıdır ve Lord 0 görünür (
grup_sabit); bu sayılar anlamsızdır. Şablon "bir grupta sabit" notunu yazar, o maddenin sonuç sütunlarını boş bırakır veDMF'yi yanlış sayar; maddeyi kendiniz değerlendirmeyin ya da çıkarın. - Eksik yanıt. Kişi, seçilen herhangi bir maddede eksikse bütün analizden çıkar; atılan sayı ve yüzde konsola yazılır (
eksik: 13 satır, %4,1, n=303). Eksikleri önceden kendiniz değerlendirin. - Madde kodlaması. Yalnız 0 ve 1 kabul edilir (1/2 ya da "evet/hayır" kodlaması "yalnız 0/1 değerleri içermeli" hatasıyla durur;
kod12). Ters maddeler önceden yeniden kodlanmalıdır; şablon bunu yapmaz. - Grubun boşluklu düzeyleri. " kadin" gibi baş/son boşluklu düzeyler kırpılarak okunur; odak adı boşluksuz yazılır (
bosluk: referans kadin 243, odak erkek 73). - Sınıf ve anlamlılık. Zumbo–Thomas ve Jodoin–Gierl sınıfı testin anlamlı olduğu maddelerde \Delta R^2 eşiğine göre verilir; anlamsız madde "A"dır (170.4.4).
- 1PL'de Lord ve Raju aynı sonucu verir. İkisini ayrı kanıt saymayın; 2PL'de ayırt edicilik farkı yalnız Lord'a girer.
- Çok boyutlu test. Eşleştirme tek bir toplam puandır; çok boyutlu testte DMF yanlış yorumlanır (Bölüm 174).
170.9 Uzman soruları
S1. Eşleştirme puanı neden madde kendisi dahil toplam puan?
Çapa kümesine madde dahil değilse difR maddeyi eşleştirme puanına ekler (mantelHaenszel'de data2 <- cbind(data2, data[, item])). Böylece madde kendi eşleştirmesine katılır; bu, DMF literatüründeki yaygın uygulamadır (Holland ve Thayer, 1988). Arındırmada DMF'li bir madde öteki maddelerin puanından çıkarılır ama kendi eşleştirmesinde kalır; bu nedenle arındırmalı ve arındırmasız \chi^2_{MH} değerleri farklıdır (S2DoScold: 11{,}944 ve 6{,}839).
S2. ETS sınıfı neden 0,05'e sabit ve \alpha ayarı neden onu değiştirmiyor?
ETS A/B/C, bir karar kuralı değil sabit bir sınıflama tanımıdır (Zieky, 1993): A, "\Delta_{MH} 1'den küçük ya da MH testi %5'te anlamsız"; C, "|\Delta_{MH}|\ge1{,}5 ve 1'den anlamlı büyük". Kullanıcının \alpha'sı yalnız yöntemlerin DMF kararını (DMF sütunu) değiştirir; arındırma açıkken \alpha eşleştirme maddelerini de belirlediğinden \Delta_{MH} ve dolayısıyla sınıf yine değişebilir. alfa001 çalıştırmasında MH 2 madde işaretlerken tablodaki ETS sınıfları \alpha=0{,}05 için hesaplanır.
S3. Neden \Delta_{MH}=-2{,}35\ln\alpha_{MH} ve işaret ne söyler?
ETS delta ölçeğinde madde güçlüğü \Delta=13+4z ve lojistik ölçekle -4/1{,}702=-2{,}35 ile ilişkilidir. \alpha_{MH} referans ÷ odak odds oranıdır; negatif \Delta referans grubu kayırır, pozitif \Delta odak grubu. Örnekte 'yapmak' maddeleri pozitif (\alpha_{MH}<1): erkekler (odak) kayırılır.
S4. difR işaretli alanın p değerini neden yeniden hesaplıyor?
difR işaretli alan için p=2\bigl(1-\Phi(Z)\bigr) verir; negatif Z'de bu 1'den büyük olabilir. Şablon bunu 2\Phi(-|Z|) ile değiştirir (218–219). Karar (DMF) ise difR'ın kendi |Z| eşiğinden gelir ve iki yönlü p<\alpha ile aynıdır; düzeltme açıkken şablonun p'si üzerinden düzeltilmiş p yazılır, difR düzeltmesi Raju'ya uygulanmaz.
S5. 1PL'de Lord ile Raju neden aynı sonucu veriyor; 2PL'de ne değişir?
1PL'de ayırt edicilik her iki grupta 1'dir; Lord \chi^2=(b_R-b^*_F)^2/(se_R^2+se_F^2) ve Raju Z=(b^*_F-b_R)/\sqrt{\cdot} olur, dolayısıyla \chi^2=Z^2 ve p aynıdır. 2PL'de Lord (a,b) ortak sınanır (2 sd), Raju işaretli alanda yalnız b farkı kullanılır; örnekte 2PL Lord yalnız 2, Raju 4 madde işaretler (pl2).
S6. Arındırma neden gerekli ve neden döngü?
Toplam puan DMF'li maddeler içerirse eşleştirme yeteneği yanlış ölçer ve DMF'siz maddelerde yapay DMF doğurabilir. Arındırma, DMF'li maddeleri çapadan çıkarıp sınamayı yineler; küme değişmeyene kadar sürer. Örnekte MH 6 maddeden 9 maddeye çıkar, lojistik 4'ten 6'ya (arsiz ve ornek).
S7. Tohum sonucu etkiler mi?
Hayır. Şablonun hiçbir adımı rastgele sayı kullanmaz; ltm'in 2PL uydurması da tohumdan bağımsızdır (tohum 1–4'te aynı logaritmik olabilirlik). Bölüm 1.3'teki Tohum alanı sonucu değiştirmez.
S8. Başka bir paketle ya da tanımla fark nerede?
(i) Lojistik regresyonda ΔR² bazı yazılımlarda McFadden ya da Cox–Snell R^2'sine dayanır; burada Nagelkerke vardır. (ii) MH'de \chi^2 süreklilik düzeltmeli (varsayılan) olup, düzeltmesiz istatistik bazı yazılımların varsayılanıdır. (iii) Lord'un 1PL'sinde güçlükler ltm'in marjinal en çok olabilirliğinden gelir ve Rasch koşullu en çok olabilirlikten küçük farklarla ayrılır. (iv) Eşleştirme "rest score" (madde dışarıda) seçilebilir; şablon yalnız toplam puan kullanır.
170.10 Kaynaklar
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B, 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- De Boeck, P., & Wilson, M. (Eds.). (2004). Explanatory item response models: A generalized linear and nonlinear approach. Springer. https://doi.org/10.1007/978-1-4757-3990-9
- Dorans, N. J., & Holland, P. W. (1993). DIF detection and description: Mantel-Haenszel and standardization. In P. W. Holland & H. Wainer (Eds.), Differential item functioning (pp. 35–66). Lawrence Erlbaum.
- Holland, P. W., & Thayer, D. T. (1988). Differential item performance and the Mantel-Haenszel procedure. In H. Wainer & H. I. Braun (Eds.), Test validity (pp. 129–145). Lawrence Erlbaum.
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Jodoin, M. G., & Gierl, M. J. (2001). Evaluating Type I error and power rates using an effect size measure with the logistic regression procedure for DIF detection. Applied Measurement in Education, 14(4), 329–349. https://doi.org/10.1207/S15324818AME1404_2
- Lord, F. M. (1980). Applications of item response theory to practical testing problems. Lawrence Erlbaum.
- Magis, D., Béland, S., Tuerlinckx, F., & De Boeck, P. (2010). A general framework and an R package for the detection of dichotomous differential item functioning. Behavior Research Methods, 42(3), 847–862. https://doi.org/10.3758/BRM.42.3.847
- Mantel, N., & Haenszel, W. (1959). Statistical aspects of the analysis of data from retrospective studies of disease. Journal of the National Cancer Institute, 22(4), 719–748. https://doi.org/10.1093/jnci/22.4.719
- Nagelkerke, N. J. D. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691–692. https://doi.org/10.1093/biomet/78.3.691
- Raju, N. S. (1988). The area between two item characteristic curves. Psychometrika, 53(4), 495–502. https://doi.org/10.1007/BF02294403
- Rizopoulos, D. (2006). ltm: An R package for latent variable modeling and item response theory analyses. Journal of Statistical Software, 17(5), 1–25. https://doi.org/10.18637/jss.v017.i05
- Robins, J., Breslow, N., & Greenland, S. (1986). Estimators of the Mantel-Haenszel variance consistent in both sparse data and large-strata limiting models. Biometrics, 42(2), 311–323. https://doi.org/10.2307/2531052
- Swaminathan, H., & Rogers, H. J. (1990). Detecting differential item functioning using logistic regression procedures. Journal of Educational Measurement, 27(4), 361–370. https://doi.org/10.1111/j.1745-3984.1990.tb00754.x
- Zieky, M. (1993). Practical questions in the use of DIF statistics in test development. In P. W. Holland & H. Wainer (Eds.), Differential item functioning (pp. 337–347). Lawrence Erlbaum.
- Zumbo, B. D. (1999). A handbook on the theory and methods of differential item functioning (DIF): Logistic regression modeling as a unitary framework for binary and Likert-type (ordinal) item scores. Directorate of Human Resources Research and Evaluation, Department of National Defense.