13. Optimal deney tasarımı (D-, A-, I-optimal; Fedorov aday küme değiş tokuşu)
Şablon kimliği: optimal_tasarim · Kategori: deney tasarımı · Dil: R · Dosya: pro/sablonlar/deney_tasarimi/optimal_tasarim.R (satır 1–163; üstbilgi 1–74) · Örnek veri: _ornek/aday_5x3.csv · Paketler: AlgDesign 1.2.1.2
13.1 Ne işe yarar
Şablon, yapılabilecek bütün denemelerin listesinden (aday küme), verilen model için en bilgilendirici N denemeyi seçer. Cevapladığı soru şudur: "Kurmak istediğim modelin katsayılarını elimdeki deneme sayısıyla en kesin kestirmek için hangi faktör birleşimlerinde deneme yapmalıyım?"
Model, faktörlerde doğrusal bir regresyon modelidir; tasarımın niteliği bilgi matrisiyle ölçülür:
- \mathbf f(\mathbf x): bir deneme noktasının model terimleri (kesişim, faktörler, seçime göre çarpımlar ve kareler); uzunluğu k (parametre sayısı).
- \mathbf X: seçilen N denemenin N\times k model matrisi; her satırı bir \mathbf f(\mathbf x)^{\top}.
- \mathbf M: deneme başına bilgi matrisi. Katsayıların kovaryansı yalnız \mathbf M'ye ve hata varyansı \sigma^2'ye bağlıdır; yanıt ölçülmeden önce hesaplanabilir.
Tasarım seçimi, \mathbf M^{-1}'i bir ölçüte göre "küçük" yapan satırları aramaktır. Şablon üç ölçüt sunar: D (katsayıların ortak güven bölgesinin hacmi), A (katsayı varyanslarının ortalaması), I (bölge üzerinde ortalama tahmin varyansı).
Ne zaman kullanılır? Standart tasarımlar uymadığında: deneme sayısı bütçeyle sabitse ve 2'nin kuvveti ya da merkezi bileşik tasarımın büyüklüğü değilse; bazı faktör birleşimleri yapılamıyorsa (aday kümeden çıkarılır); faktörlerin düzey sayıları farklıysa ya da sayısal ve kategorik faktörler birlikteyse; model belliyse ve o modele göre en verimli deneme kümesi isteniyorsa.
Ne zaman kullanılmaz?
- Faktörler iki düzeyliyse ve deneme sayısı 2'nin kuvveti olabiliyorsa:
kesirli_faktoriyel(Bölüm 10); takma ad yapısı açıkça bilinen dik tasarım verir. - Bölge düzgün bir küp ya da küreyse ve ikinci derece model kurulacaksa:
yanit_yuzeyi_tasarim(Bölüm 14); merkezi bileşik ve Box-Behnken tasarımları uyum eksikliği sınamasına elverişli yinelemeli merkez noktaları içerir. - Faktörler bir karışımın oranlarıysa:
karisim_deneyi(Bölüm 9); kısıtlı bölgenin uç noktaları ve merkezleri aday küme olarak buraya da verilebilir. - Amaç denemeyi çözümlemekse: şablon yanıt almaz. Yürütülen denemenin çözümlemesi için temel programdaki Doğrusal Regresyon ya da Yanıt Yüzeyi Regresyonu kullanılır.
Temel programla ilişki. Temel programda tasarım arama yoktur; Rastgeleleştirme (Deneme) Planı var olan muameleleri parsellere dağıtır, hangi muamelelerin deneneceğini seçmez. Bu şablon seçimi yapar; seçilen satırların deneme sırasına rastgele dizilmesi ayrıca yapılır.
13.2 Şablonun girdileri
Form, üstbilgideki dokuz [[param]] bloğundan kurulur (optimal_tasarim.R:10–73).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Faktörler · faktorler |
sütunlar · Değişkenler | — | en az 1 sütun | Aday kümenin sütunları (79–83). |
Model · model |
seçim · Model | kuadratik |
dogrusal, etkilesim, kuadratik |
Model formülü (96–99). |
Deneme sayısı N · deneme |
tamsayı · Seçenekler | 0 | 0–10000 | 0 ise N=k+5 (103); nTrials (111). |
Optimallik ölçütü · kriter |
seçim · Model | D |
D, A, I |
criterion = (107). |
Rastgele başlangıç sayısı · yineleme |
tamsayı · Gelişmiş | 20 | 1–1000 | nRepeats = (107). |
Yaklaşık kuram tasarımı · yaklasik |
onay · Model | kapalı | açık / kapalı | approximate = TRUE; N kullanılmaz (111). |
Sayısal faktörleri merkezle · merkezle |
onay · Model | kapalı | açık / kapalı | center = TRUE (108). |
Başlangıç tasarımı · baslangic |
seçim · Gelişmiş | 0 |
0, 1, 2 |
nullify = (109). |
Değiş tokuş en çok yinelemesi · en_cok_yineleme |
tamsayı · Gelişmiş | 100 | 1–100000 | maxIteration = (110). |
Örnek ayar (ornek_param, satır 9): faktorler = x1, x2, x3, model = kuadratik, deneme = 15, kriter = D, yineleme = 5, yaklasik = kapalı. Deneme sayısı (15) ve başlangıç sayısı (5) varsayılandan farklıdır.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde aday küme verisini açın." | 78 |
| Bir faktör aday kümede tek düzeyli | "'…' aday kümede tek düzeyli; faktörlerden çıkarın." | 87 |
| Kuadratik model, sayısal olmayan faktör | "Kuadratik model yalnız sayısal faktörlerle kurulur." | 91 |
| Kuadratik model, 3'ten az düzeyli faktör | "her faktörün aday kümede en az 3 düzeyi olmalı" | 92 |
| Model matrisi kurulamadı | "Model matrisi kurulamadı: …" | 100 |
| Aday kümenin model matrisi tam ranklı değil | "Aday küme bu modeldeki tüm parametreleri kestirmeye yetmiyor" | 102 |
| N<k | "Deneme sayısı (…) model parametre sayısından (…) az olamaz." | 104 |
| N>50\times aday nokta sayısı | "Deneme sayısı aday nokta sayısına göre çok büyük." | 105 |
optFederov hata verdi (ör. N aday nokta sayısından büyük) |
"Tasarım bulunamadı: …" ve paketin iletisi | 113 |
Aday küme şöyle hazırlanır (79–83): seçilen sütunlar alınır, eksik değerli satırlar atılır, yinelenen satırlar tekilleştirilir. Tablodaki "aday_no" bu tekilleştirilmiş kümenin satır numarasıdır. Metin ve mantıksal sütunlar kategorik faktöre çevrilir (85). optFederov çalışırken verdiği uyarılar toplanır ve çıktının sonunda "Uyarılar:" satırında gösterilir (112–114, 149). Deneme sayısı aday nokta sayısını aşamaz: optFederov her adayı en çok bir kez seçer ve daha büyük N için tasarım kurmaz.
13.3 Örnek veri
Dosya: _ornek/aday_5x3.csv. Üç faktörün beşer düzeyinin (-2,-1{,}0{,}1{,}2) tam ızgarası: 5^3=125 satır, yanıt sütunu yok, eksik değer yok. AlgDesign belgesindeki örnekle aynı aday kümedir (gen.factorial(5, 3)).
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
x1 |
Faktör | sayısal | −2, −1, 0, 1, 2; her düzeyde 25 aday; dosyada en hızlı değişen sütun |
x2 |
Faktör | sayısal | aynı düzeyler |
x3 |
Faktör | sayısal | aynı düzeyler; en yavaş değişen sütun |
Satır numarası düzeylerle şöyle bağlıdır: \text{aday\_no}=1+(x_1+2)+5(x_2+2)+25(x_3+2). Aday 1 (-2,-2,-2), aday 63 merkez (0{,}0{,}0), aday 125 (2{,}2{,}2)'dir.
Tam kuadratik modelin parametre sayısı k=1+3+3+3=10'dur (kesişim, üç doğrusal, üç çarpım, üç kare). Örnek ayar 125 adaydan 15'ini seçer; olası alt küme sayısı \binom{125}{15}\approx9{,}1\times10^{18}'dir ve tek tek denenemez.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar, tohum 1; (2) örnek ayar, tohum 2; (3) A ölçütü, 20 başlangıç; (4) I ölçütü, 20 başlangıç; (5) yaklaşık kuram; (6) ana etkiler modeli, N=8; (7) merkezleme açık, sıfırlama başlangıcı.
Sonuç tohuma bağlıdır
Arama rastgele başlangıç tasarımlarından başlar. Kod panelindeki Tohum alanı boşsa MerQuR+ her çalıştırmada yeni bir tohum kullanır (Bölüm 1.3); aynı ayarla iki çalıştırma farklı satırlar seçebilir. Örnek ayarda tohum 1 ve tohum 2 farklı iki tasarım, ama aynı ölçüt değerlerini verir (D=3{,}675919). Bu bölümdeki sayılar belirtilen tohumlarla yeniden üretilir; uygulanacak tasarım çalıştırma kaydındaki tohumla birlikte saklanır.
13.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) aday kümeyi hazırla ve model matrisini kur; (2) N'yi belirle; (3) optFederov ile seçilen ölçütü en iyileyen satırları ara; (4) seçilen tasarımın ölçütlerini, kodlu ölçekte verimliliklerini ve değerlendirme büyüklüklerini yaz; (5) düzey sıklıklarını ve şekli üret.
13.4.1 Model matrisi
| Model | Formül | Üç sayısal faktörde k |
|---|---|---|
| Ana etkiler | ~ . |
4 |
| Ana etkiler + iki yönlü etkileşimler | ~ .^2 |
7 |
| Tam kuadratik | ~ quad(.) |
10 |
Kategorik faktörler ilk iki modelde gösterge sütunlarıyla girer (L düzey için L-1 sütun). Şablon, aday kümenin model matrisini kendisi de kurar ve rankını denetler (97–102); ölçütlerin bağımsız hesabı bu matristen yapılır.
13.4.2 Optimallik ölçütleri
- \lvert\mathbf M\rvert: bilgi matrisinin determinantı. D büyük olmalıdır; katsayıların ortak güven elipsoidinin hacmi \lvert\mathbf M\rvert^{-1/2} ile orantılıdır. 1/k üssü ölçütü parametre başına ölçeğe getirir.
- \operatorname{iz}(\mathbf M^{-1}): \mathbf M^{-1}'in köşegen toplamı; A, katsayı varyanslarının (\sigma^2/N biriminde) ortalamasıdır ve küçük olmalıdır.
- \mathbf X_c: aday kümenin tamamının model matrisi (N_c satır); \mathbf B aday bölgenin moment matrisi. I, tahmin varyansı d(\mathbf x)'in aday noktalar üzerindeki ortalamasıdır ve küçük olmalıdır.
Bir noktadaki ölçekli tahmin varyansı ve ondan türeyen iki büyüklük:
- d(\mathbf x): \mathbf x noktasındaki tahminin varyansı, deneme başına ve \sigma^2 biriminde.
- G_e: G-verimi. Hiçbir tasarımda en büyük d(\mathbf x) değeri k'nın altına inemez; G_e=1 en iyi durumdur.
- D_{ea}: D-veriminin alt sınırı. Tasarımın D değerinin, aynı aday kümede ulaşılabilecek en büyük D'ye oranı en az bu kadardır. AlgDesign G_e ve D_{ea}'yı üç ondalığa yuvarlanmış verir.
Neden üç ayrı ölçüt?
Üçü de \mathbf M^{-1}'i küçültür, ama farklı şeyi ödüllendirir. D, bütün katsayıları birlikte ve aralarındaki korelasyonları hesaba katarak değerlendirir; modelin yeniden ölçeklenmesinden etkilenmez. A, yalnız varyansların toplamına bakar; katsayıların birimi farklıysa büyük ölçekli terim baskın olur. I, katsayılarla değil tahminle ilgilenir: amaç yanıt yüzeyini bölgenin içinde iyi tahmin etmekse uygundur ve köşelere D kadar yüklenmez, merkeze nokta koyar. Örnek veride D-optimal tasarım merkez noktasını seçmez; I-optimal tasarım seçer (13.7).
Neden G_e'nin üst sınırı 1?
\sum_{u}d(\mathbf x_u)=N\operatorname{iz}(\mathbf M^{-1}\mathbf M)=Nk olduğundan tasarım noktalarındaki d değerlerinin ortalaması tam k'dır; en büyüğü k'dan küçük olamaz. Kiefer ve Wolfowitz'in (1960) denklik teoremi, ağırlıklı (yaklaşık) tasarımlar arasında \lvert\mathbf M\rvert'yi en büyük yapan tasarımın aynı zamanda \max d(\mathbf x)'i en küçük yapan tasarım olduğunu ve o tasarımda \max d(\mathbf x)=k olduğunu söyler. G_e bu yüzden D-optimalliğe uzaklığın bir ölçüsüdür.
13.4.3 Kodlu ölçekte D- ve A-verimi
D, A ve I faktörlerin ham birimleriyle hesaplanır; faktör 0–100 yerine 0–1 diye yazılırsa değerleri değişir. Şablon, birimden bağımsız iki yüzde daha verir (satır 123–136). Önce her sayısal faktör aday kümedeki aralığına göre kodlanır:
sonra kodlu model matrisi \mathbf X' ile
- x_{\min}, x_{\max}: faktörün aday kümedeki en küçük ve en büyük değeri.
- Kategorik faktörler, dengeli tasarımda \mathbf X'^{\top}\mathbf X'=N\mathbf I verecek biçimde ölçeklenmiş dik zıtlıklarla kodlanır (
contr.poly\times\sqrt L, satır 130). - %100, bütün sütunları dik ve \pm1 değerli bir tasarımın değeridir; iki düzeyli dik tasarımlar ve ana etkiler modeli için ulaşılır. Kare terimli modelde sütunlar dik olamayacağından en iyi tasarım bile %100'ün epey altında kalır.
Yüzdeler "en iyi tasarıma göre" verim değildir
D-verimi %45,9 çıkması, tasarımın en iyinin yarısı kadar iyi olduğu anlamına gelmez; karşılaştırma ölçüsü, kuadratik modelde var olmayan düşsel bir dik tasarımdır. Yüzdeler, aynı model ve aynı aday küme için iki tasarımı karşılaştırmakta kullanılır. Gerçek üst sınıra uzaklık için D_{ea} ya da yaklaşık kuram tasarımının D değeri kullanılır (13.9 S3).
13.4.4 Fedorov değiş tokuş algoritması
Algoritma N noktalı bir başlangıç tasarımından başlar ve her adımda bir tasarım noktasını \mathbf x_i bir aday noktayla \mathbf x_j değiştirir. Değişimin determinant üzerindeki etkisi matrisi yeniden kurmadan hesaplanır:
- v(\mathbf x)=\mathbf f(\mathbf x)^{\top}(\mathbf X^{\top}\mathbf X)^{-1}\mathbf f(\mathbf x) ve v(\mathbf x_i,\mathbf x_j)=\mathbf f(\mathbf x_i)^{\top}(\mathbf X^{\top}\mathbf X)^{-1}\mathbf f(\mathbf x_j); d(\mathbf x)=N\,v(\mathbf x).
- \Delta: çıkan nokta \mathbf x_i, giren nokta \mathbf x_j için Fedorov'un delta fonksiyonu. Her adımda bütün (i,j) çiftleri arasında \Delta'sı en büyük olan değişim yapılır.
- Hiçbir değişim \Delta>0 vermediğinde arama durur. Sonuç, tek nokta değişimlerine göre yerel en iyidir.
Neden birden çok rastgele başlangıç?
Ölçüt yüzeyinde çok sayıda yerel en iyi vardır; tek bir başlangıç bunlardan birine takılabilir. nRepeats kadar rastgele başlangıç denenir ve en iyi sonuç tutulur. Başlangıç sayısı arttıkça gerçek en iyiyi bulma olasılığı artar, ama hiçbir sayı bunu güvence altına almaz. A ve I ölçütleri D'ye göre daha çok yerel en iyiye sahiptir; onlar için başlangıç sayısı yüksek tutulur.
Koddaki tercih
Çağrı AlgDesign::optFederov(frml, data = aday, criterion, evaluateI = TRUE, nRepeats, nTrials = N) biçimindedir (107–113). evaluateI = TRUE, ölçüt D ya da A olsa da I değerinin hesaplanmasını sağlar. center, nullify ve maxIteration yalnız formda varsayılandan farklı seçilirse çağrıya eklenir (108–110); eklenmediklerinde AlgDesign'ın kendi varsayılanları geçerlidir (center = FALSE, nullify = 0, maxIteration = 100). AlgDesign'ın nRepeats varsayılanı 5'tir; formun varsayılanı 20, örnek ayarınki 5'tir. optFederov bir adayı tasarıma birden çok kez almaz: tam (ayrık) tasarımda yinelenen deneme noktası olmaz.
Başlangıç tasarımı. nullify = 0 rastgele N satırla başlar. nullify = 1 başlangıcı sıfırlama yöntemiyle kurar: her adımda, o ana kadar seçilen noktaların geren uzayına en dik aday eklenir; böylece başlangıç tasarımı tekil olmaz. nullify = 2 aynı yöntemle k nokta seçer, kalanını rastgele tamamlar.
13.4.5 Yaklaşık kuram tasarımı
Yaklaşık (sürekli) tasarımda deneme sayısı yoktur; her aday noktaya toplamı 1 olan bir ağırlık w_i\ge0 verilir:
- w_i: i. adayın tasarımdaki payı. Ağırlığı sıfırdan büyük adaylar destek noktalarıdır; tabloda
Proportionsütunuyla verilir. - Sağdaki eşitlik denklik teoremidir: en iyi ağırlıklarda en büyük ölçekli tahmin varyansı tam k olur ve G_e=1'dir.
- Yaklaşık tasarımın D değeri, o aday kümede hiçbir N denemelik tasarımın aşamayacağı üst sınırdır.
Yaklaşık tasarım doğrudan uygulanamaz; N w_i tam sayı olmayabilir. İşlevi, destek noktalarını göstermek ve tam tasarımın ne kadar iyi olduğunu ölçecek sınırı vermektir. Bu kipte kodlu verim yüzdeleri ve değerlendirme tabloları hesaplanmaz (123, 141).
13.4.6 Tasarım değerlendirmesi
Tam tasarım için AlgDesign::eval.design() çağrılır (142–145):
- \mathbf M_1: \mathbf M'nin kesişim satırı ve sütunu çıkarılmış hâli; m_{1,jj} onun köşegen öğeleri.
- Köşegensellik 0 ile 1 arasındadır; 1, kesişim dışındaki sütunların birbirine dik olduğunu gösterir. Üç ondalığa yuvarlanmış verilir.
- Geometrik ortalama, kesişim dışındaki katsayıların varyanslarının (\sigma^2/N biriminde) geometrik ortalamasıdır.
- Tablodaki "determinant" sütunu D=\lvert\mathbf M\rvert^{1/k}'dir, ham determinant değildir.
13.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–74 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, dokuz parametre. | Form ve varsayılanlar buradan kurulur (Bölüm 1.2). |
| 75–83 | Paket; aday küme: sütun seçimi, eksik satırların atılması, tekilleştirme. | unique() sonrası satır numaraları yeniden verilir (83); "aday_no" bu numaradır. |
| 84–95 | Metin/mantıksal sütunlar faktöre çevrilir; tek düzey ve kuadratik model denetimleri; adlar R adına çevrilir. | Veri sekmesinin kategorik saydığı sütun R'ye zaten faktör olarak gelir (Bölüm 1.3). |
| 96–102 | optFederov formülü (f) ve aynı modelin açık yazımı (fs); model matrisi ve rank denetimi. |
Kuadratik modelde fs terimleri tek tek yazar: doğrusal, çarpım, kare (98). |
| 103–105 | N: form değeri ya da k+5; alt sınır denetimi. | Yaklaşık kuramda N denetlenmez. |
| 106–114 | Çağrı bağımsız değişkenleri, optFederov; uyarıların toplanması. |
Hata çevrilmiş önekle, paketin kendi iletisiyle gösterilir (113). |
| 116–120 | Özet satırı; "Seçilen tasarım" ya da "Destek noktaları ve ağırlıkları" tablosu. | Satırlar aday numarasına göre sıralıdır; deneme sırası değildir. |
| 121–140 | Kodlu ölçekte D- ve A-verimi; "Verimlilik ölçütleri" tablosu. | D, A, I, G_e, D_{ea} optFederov çıktısından alınır (137). |
| 141–149 | eval.design tablosu, düzey sıklıkları, uyarılar. |
Yalnız tam tasarımda. |
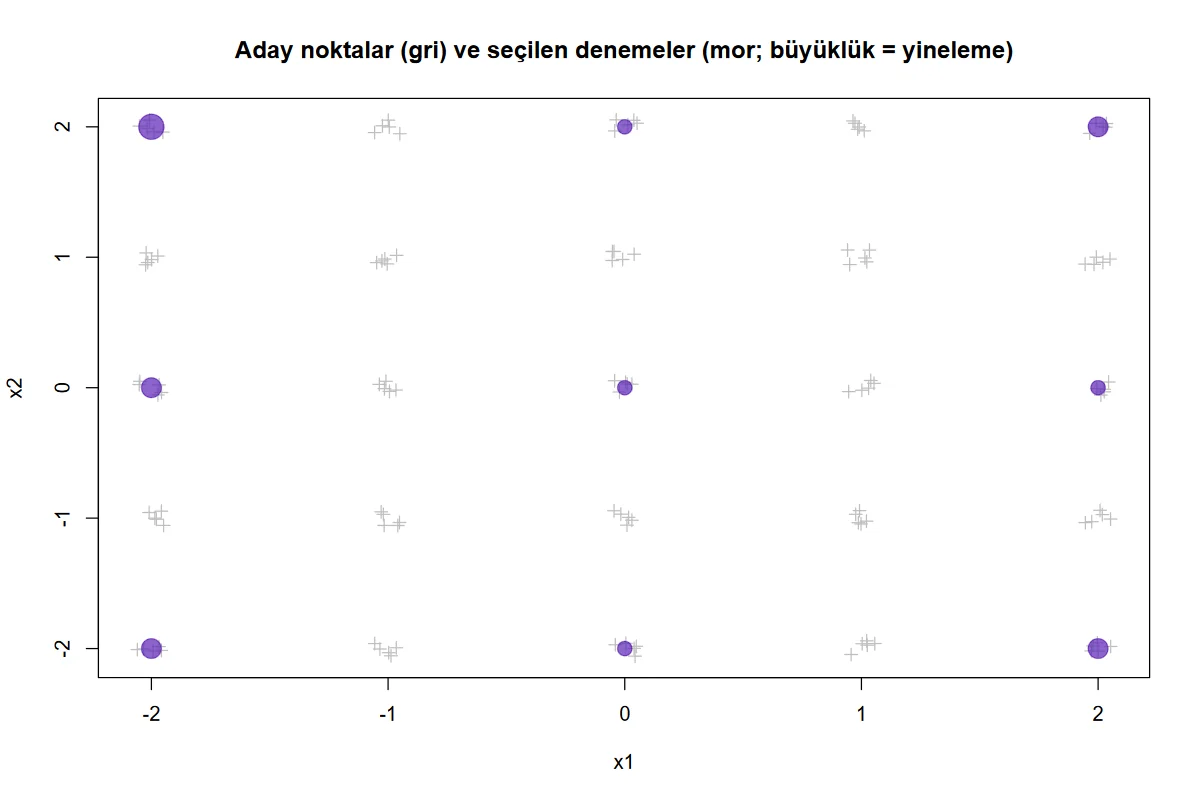
| 151–162 | Şekil: ilk iki sayısal faktörde adaylar ve seçilen noktalar; iki sayısal faktör yoksa seçilen adayların çubuk grafiği. | Nokta büyüklüğü, o (x_1,x_2) konumuna düşen seçilmiş nokta sayısıdır (155–156). |
13.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/optimal_tasarim/elle_hesap.py ile AlgDesign kullanılmadan hesaplanmıştır: ölçütler şablonun seçtiği aday satırlarından açık formüllerle, en iyi değerler ise ayrıca yazılmış bir değiş tokuş aramasıyla. R tarafında (r_dogrulama.R) ölçütler taban R ile yeniden kurulmuş ve tek nokta değişimleri taranmıştır.
Adım 1 — Seçilen tasarım (tohum 1). Aday numaraları 1, 5, 11, 21, 23, 25, 53, 65, 71, 101, 105, 111, 113, 121, 125. Sekiz köşenin tamamı, dört kenar ortası (bir koordinatı 0) ve üç yüz merkezi (iki koordinatı 0) seçilmiştir; hiçbir noktada \pm1 düzeyi yoktur ve küpün merkezi tasarımda değildir.
Adım 2 — Bilgi matrisi ve D. 15\times10 model matrisinden \mathbf M=\mathbf X^{\top}\mathbf X/15 kurulur:
Adım 3 — A ve I.
\mathbf B 125 adayın moment matrisidir. I<k=10 olması, aday bölgenin içindeki ortalama tahmin varyansının tasarım noktalarındaki ortalamadan küçük olduğunu gösterir.
Adım 4 — G-verimi ve alt sınır. 125 adayın her birinde d(\mathbf x) hesaplanır; en büyüğü 12,896'dır:
Şablon tablosundaki 0,775 ve 0,749 bunların üç ondalığa yuvarlanmış hâlidir.
Adım 5 — Kodlu ölçekte verim. Aralık [-2{,}2] olduğundan x'=x/2. Kodlu matriste \lvert\mathbf X'^{\top}\mathbf X'\rvert=241\,920\,000 ve \operatorname{iz}\{(\mathbf X'^{\top}\mathbf X')^{-1}\}=2{,}545533:
Ham ve kodlu ölçek arasındaki bağ bu örnekte kapalı biçimde yazılabilir: kodlamada üç doğrusal sütun 2'ye, altı ikinci derece sütun 4'e bölünür; determinant (2^3\cdot4^6)^2=2^{30} kat küçülür ve D=8\cdot(D\text{-verimi}/100)=8\cdot0{,}459490=3{,}675919 olur.
Adım 6 — Değerlendirme büyüklükleri. Kesişim çıkarılmış 9\times9 alt matristen köşegensellik 0{,}754869 (tabloda 0,755); \mathbf M^{-1}'in kesişim dışındaki dokuz köşegen öğesinin geometrik ortalaması 0{,}242297.
Adım 7 — Bağımsız arama. Kendi yazdığımız arama (rastgele N nokta, her adımda ölçütü en çok iyileştiren tek değişim, iyileşme kalmayınca dur) şu en iyi değerlere ulaşmıştır:
| Ölçüt | Başlangıç sayısı | Bağımsız aramanın en iyisi | Şablonun değeri |
|---|---|---|---|
| D | 12 | 3,675919 | 3,675919 |
| A | 8 | 0,651499 | 0,651499 |
| I | 24 | 7,927083 | 7,927083 |
I ölçütünde 8 başlangıçla yapılan ilk deneme 8,0968'de kalmış, 24 başlangıç 7,9271'e ulaşmıştır; yerel en iyilerin varlığının doğrudan bir örneğidir. R tarafında, şablonun D-optimal tasarımında olası 15\times110=1650 tek nokta değişiminin hiçbiri \Delta>0 vermemiş, en büyük \Delta sıfır bulunmuştur: D'yi değiştirmeyen değişimler vardır ve bunlar aynı değerli başka tasarımlara götürür (tohum 2'nin tasarımı gibi).
Adım 8 — Yaklaşık kuram. Ağırlıklar w_i\leftarrow w_i\,d(\mathbf x_i)/k kuralıyla yinelenmiştir (Silvey, Titterington ve Torsney, 1978). \max d(\mathbf x)-k<10^{-9} olduğunda D=3{,}795826 bulunur; destek, düzeyleri \{-2{,}0{,}2\} olan 27 noktadır. Şablonun yaklaşık tasarımı aynı 27 noktayı ve D=3{,}795821 verir (G_e=0{,}999). Tam tasarımın bu sınıra oranı:
15 denemelik tasarım, bu aday kümede ulaşılabilecek en büyük D'nin %96,8'indedir; D_{ea}=0{,}749 bunun yalnız bir alt sınırıdır.
Adım 9 — Ana etkiler modeli. N=8 için seçilen tasarım ızgaranın sekiz köşesidir: \mathbf M=\operatorname{diag}(1{,}4{,}4{,}4), D=(4^3)^{1/4}=2\sqrt2=2{,}828427, A=(1+3\cdot0{,}25)/4=0{,}4375, I=1+3\cdot2/4=2{,}5 (aday kümede x_j^2'nin ortalaması 2'dir). Kodlu ölçekte \mathbf X'^{\top}\mathbf X'=8\,\mathbf I ve iki verim de %100'dür.
13.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun "Verimlilik ölçütleri" ve "Tasarım değerlendirmesi" tablolarından alınmıştır (çalıştırmalar 1–4 ve 6).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| D =\lvert\mathbf M\rvert^{1/k} | 3,67591877 | 3,67591877 | 3,67591877 | 0 | ✓ |
| A | 1,25559732 | 1,25559732 | 1,25559732 | 1,4e−15 | ✓ |
| I | 8,84887381 | 8,84887381 | 8,84887381 | 0 | ✓ |
| Ge (3 ondalık) | 0,775 | 0,775 | 0,775 | 0 | ✓ |
| Dea (3 ondalık) | 0,749 | 0,749 | 0,749 | 0 | ✓ |
| D-verimi (%), kodlu | 45,94898457 | 45,94898457 | 45,94898457 | 4,6e−16 | ✓ |
| A-verimi (%), kodlu | 26,18966556 | 26,18966556 | 26,18966556 | 4,1e−16 | ✓ |
| Köşegensellik (3 ondalık) | 0,755 | 0,755 | 0,755 | 0 | ✓ |
| Varyansların geometrik ortalaması | 0,24229731 | 0,24229731 | 0,24229731 | 2,5e−16 | ✓ |
| Başka tohum (2): D | 3,67591877 | 3,67591877 | — | 2,4e−16 | ✓ |
| Bağımsız değiş tokuş aramasının en iyi D'si | 3,67591877 | 3,67591877 | — | 1,2e−16 | ✓ |
| A-optimal: A | 0,6514992 | 0,6514992 | 0,6514992 | 1,0e−15 | ✓ |
| A-optimal: D | 2,70281918 | 2,70281918 | 2,70281918 | 1,6e−16 | ✓ |
| A-optimal: I | 10,77081562 | 10,77081562 | 10,77081562 | 0 | ✓ |
| A-optimal: A-verimi (%) | 23,67627355 | 23,67627355 | 23,67627355 | 1,1e−15 | ✓ |
| Bağımsız aramanın en iyi A'sı | 0,6514992 | 0,6514992 | — | 2,2e−16 | ✓ |
| I-optimal: I | 7,92708333 | 7,92708333 | 7,92708333 | 1,2e−15 | ✓ |
| I-optimal: A | 0,69036458 | 0,69036458 | 0,69036458 | 1,1e−16 | ✓ |
| I-optimal: D | 3,57730504 | 3,57730504 | 3,57730504 | 7,4e−16 | ✓ |
| I-optimal: Ge (3 ondalık) | 0,836 | 0,836 | 0,836 | 0 | ✓ |
| Bağımsız aramanın en iyi I'sı | 7,92708333 | 7,92708333 | — | 1,0e−15 | ✓ |
| Ana etkiler, N=8: D =2\sqrt2 | 2,82842712 | 2,82842712 | 2,82842712 | 0 | ✓ |
| Ana etkiler, N=8: A | 0,4375 | 0,4375 | 0,4375 | 0 | ✓ |
| Ana etkiler, N=8: I | 2,5 | 2,5 | 2,5 | 0 | ✓ |
| Ana etkiler, N=8: D-verimi (%) | 100 | 100 | 100 | 2,8e−16 | ✓ |
Ölçütü karşılayan: 25/25. Python: ölçütler numpy.linalg ile açık formüllerden; ayrıca yinelemesiz nokta değişimli kendi araması (D için 12, A için 8, I için 24 rastgele başlangıç). R: determinant QR çarpanlarından, ters matris Cholesky çözümünden; optFederov ve eval.design kullanılmamıştır. Arama satırlarında R sütunu yoktur.
13.7 Çıktıyı okuma
Örnek ayarın (tohum 1) konsol metni ve tabloları:
Aday nokta: 125; model parametresi k = 10; ölçüt: D; N = 15 deneme

Seçilen tasarım
sira  aday_no  x1  x2  x3
   1        1  -2  -2  -2
   2        5   2  -2  -2
   3       11  -2   0  -2
   4       21  -2   2  -2
   5       23   0   2  -2
   6       25   2   2  -2
   7       53   0  -2   0
   8       65   2   0   0
   9       71  -2   2   0
  10      101  -2  -2   2
  11      105   2  -2   2
  12      111  -2   0   2
  13      113   0   0   2
  14      121  -2   2   2
  15      125   2   2   2

Verimlilik ölçütleri
       D        A        I     Ge    Dea  D_verimi_yuzde  A_verimi_yuzde
3.675919 1.255597 8.848874  0.775  0.749        45.94898        26.18967

Tasarım değerlendirmesi (eval.design)
determinant        A  kosegensellik  varyans_geometrik_ort
   3.675919 1.255597          0.755              0.2422973
Üç ölçütle bulunan tasarımların karşılaştırması (her satır o ölçütle aranan tasarımın bütün ölçütleri):
| Aranan ölçüt | D | A | I | G_e | D-verimi % | A-verimi % | Merkez noktası |
|---|---|---|---|---|---|---|---|
| D | 3,6759 | 1,2556 | 8,8489 | 0,775 | 45,95 | 26,19 | yok |
| A | 2,7028 | 0,6515 | 10,7708 | 0,371 | 33,79 | 23,68 | var |
| I | 3,5773 | 0,6904 | 7,9271 | 0,836 | 44,72 | 31,29 | var |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Özet satırı | Aday sayısı, k, ölçüt, N | k, seçilen modelin parametre sayısıdır; N\ge k olmalıdır. |
| Seçilen tasarım | aday_no ve faktör düzeyleri |
Yapılacak denemeler. Sıra aday numarasına göredir; uygulamadan önce rastgele dizilir. |
D, A, I |
Ham birimlerle üç ölçüt | D büyük, A ve I küçük iyidir. Yalnız aynı aday küme ve modelde karşılaştırılır. |
Ge, Dea |
G-verimi ve D-verimi alt sınırı | 1'e yakınlık yaklaşık kuramın en iyisine yakınlıktır; Dea kötümser bir sınırdır. |
D_verimi_yuzde, A_verimi_yuzde |
[-1{,}1] kodlu ölçekte yüzdeler | Birimden bağımsızdır; düşsel dik tasarıma göredir. |
kosegensellik |
Kesişim dışı sütunların dikliği | 1'den uzaklaştıkça katsayı kestirimleri birbirine bağımlıdır. |
| Düzey sıklıkları | Her faktörün her düzeyinin tasarımdaki sayısı | Kuadratik modelde uç ve orta düzeylerin baskın olması beklenir. |
| Destek noktaları (yaklaşık kuram) | Proportion ağırlıkları |
Ağırlıkların toplamı 1'dir; büyük ağırlıklı noktalar tam tasarımda öncelikle yer alır. |
Şekil 13.1. Şablonun çizdiği tasarım noktaları (örnek ayar, tohum 1). Gri artılar 125 adayın (x_1,x_2) izdüşümüdür (üst üste binmesin diye hafifçe dağıtılmış); mor dairelerin büyüklüğü o konuma düşen seçilmiş nokta sayısını (farklı x_3 düzeylerini) gösterir.
Rapor cümlesi (örnek ayar):
Üç faktörün beşer düzeyli tam ızgarasından (125 aday nokta) tam ikinci derece model (10 parametre) için 15 denemelik D-optimal tasarım Fedorov değiş tokuş algoritmasıyla seçildi (AlgDesign; 5 rastgele başlangıç). Tasarımın ölçütleri D = 3{,}676, A = 1{,}256 ve I = 8{,}849; G-verimi 0,775'tir. Aynı aday kümede yaklaşık kuramın D değeri 3,796 olduğundan tasarım ulaşılabilir en büyük D'nin %96,8'indedir. Seçilen noktaların tamamı faktörlerin −2, 0 ve 2 düzeylerindedir.
13.8 Sık hatalar ve tuzaklar
- Aday kümeyi modelden dar kurmak. Kuadratik model her faktörde en az üç düzey ister; iki düzeyli ızgara verilirse şablon durur. Etkileşimli modelde ilgili düzey birleşimleri aday kümede yoksa model matrisi tam ranklı olmaz.
- Yapılamayan birleşimleri aday kümede bırakmak. Algoritma köşeleri sever; yasak ya da tehlikeli birleşimler aday kümeden önceden silinmelidir. Şablonun bu yöndeki tek aracı aday kümedir.
- A ölçütünü ham birimlerle kullanmak. A, katsayı varyanslarının toplamıdır ve terimlerin ölçeğine bağlıdır. Örnek veride düzeyler \pm2 olduğundan kare terimlerinin sütunları 4 kat büyüktür ve varyansları küçük görünür; arama, doğrusal terimleri ve kesişimi iyileştiren noktalara (iç düzeyler, merkez) yönelir. Bulunan "A-optimal" tasarımın kodlu ölçekteki A-verimi %23,7'dir; D-optimal tasarımınki %26,2, I-optimal tasarımınki %31,3'tür. A ölçütüyle tasarım aranacaksa faktörler önce [-1{,}1]'e kodlanmış bir aday küme olarak verilir; düzeyleri \pm1 olan aynı ızgarada A ölçütü, yukarıdaki I-optimal tasarımın satırlarını seçer.
- Tohumu saklamamak. Aynı ölçüt değerine sahip birçok tasarım vardır; hangi satırların seçildiği tohuma bağlıdır. Rapor edilen tasarım ile uygulanan tasarımın aynı olması için tohum kaydedilir.
- Başlangıç sayısını düşük tutmak. Tek başlangıç yerel bir en iyide kalabilir. Ölçüt değeri, başlangıç sayısı artırıldığında değişmiyorsa sonuca güven artar; A ve I için 20 ve üstü önerilir.
- Verim yüzdelerini mutlak sanmak. Kuadratik modelde %46 D-verimi düşük değildir; ölçü biriminin dik tasarım olmasından gelir. İki tasarım karşılaştırılırken oranlarına bakılır.
- Saf hata beklemek. Tam tasarımda yinelenen nokta yoktur; uyum eksikliği sınaması için yineleme isteniyorsa seçilen tasarıma elle yineleme (ör. merkez noktası) eklenir ve N buna göre planlanır.
- Seçilen satır sırasını deneme sırası sanmak. Tablo aday numarasına göre sıralıdır; deneme sırası ayrıca rastgeleleştirilir.
- Merkezleme seçeneğinden ölçüt değişimi beklemek. Örnek aday küme sıfır çevresinde simetriktir; merkezleme model matrisini değiştirmez ve ölçütler aynı kalır. Düzeyleri sıfırdan uzak faktörlerde (ör. 150–200) merkezleme kare ve çarpım sütunlarının doğrusal sütunlarla bağımlılığını azaltır ve sayısal kararlılığı artırır; D, A ve I değerleri merkezlenmiş değişkenlere göre raporlanır.
13.9 Uzman soruları
S1. İki çalıştırma farklı tasarım verdi; hangisi doğru?
İkisi de. Tohum 1 ve tohum 2'nin tasarımları farklı satırlardan oluşur, ama D, A, I, G_e ve verim yüzdeleri son ondalığına kadar aynıdır. Aday küme üç eksende simetriktir; bir tasarımın eksen değişimi ve işaret çevirmesiyle elde edilen görüntüleri de aynı bilgi matrisini (satır ve sütunların yer değişimiyle) verir. Tek nokta değişimlerinin taranması bunu doğrular: 1650 değişimin en iyisi \Delta=0'dır, yani D'yi değiştirmeden başka bir tasarıma geçilebilir.
S2. Bulunan tasarım gerçekten en iyisi mi?
Kanıtlanamaz; alt küme sayısı 9{,}1\times10^{18}'dir. Elde olan üç dayanaktır: (i) tek nokta değişimlerine göre yerel en iyidir; (ii) bağımsız yazılmış bir arama, farklı rastgele başlangıçlardan aynı D=3{,}675919 değerine ulaşmıştır; (iii) yaklaşık kuramın sınırı 3,795826'dır, dolayısıyla daha iyi bir 15 denemelik tasarım olsa bile kazanç en çok %3,2'dir.
S3. D_{ea}=0{,}749 ile "%96,8" neden bu kadar farklı?
D_{ea}=\exp(1-1/G_e), yalnız en büyük tahmin varyansından türetilen bir alt sınırdır; gerçek D-verimi bundan büyük ya da ona eşittir. Gerçek verim, yaklaşık kuramın en iyi D'siyle oranlanarak bulunur: 3{,}675919/3{,}795826=0{,}968. Alt sınırın gevşekliği, tam tasarımın birkaç aday noktada yüksek tahmin varyansı bırakmasından gelir (\max d=12{,}896, k=10). Yaklaşık kuram tasarımı çalıştırılmadan yalnız D_{ea}'ya bakmak tasarımı olduğundan kötü gösterir.
S4. Yaklaşık kuramın ağırlıkları neden başka bir programınkiyle aynı çıkmayabilir?
En iyi bilgi matrisi tektir, ağırlıklar tek olmayabilir. Bu örnekte destek, \{-2{,}0{,}2\}^3 ızgarasının 27 noktasıdır ve simetriyle dört sınıfa ayrılır: 8 köşe, 12 kenar ortası, 6 yüz merkezi, 1 merkez. Kuadratik modelin bilgi matrisi bu destekte yalnız iki momente bağlıdır (x_j^2 ve x_j^2x_l^2 ortalamaları); dört sınıf ağırlığına karşılık toplam koşuluyla birlikte üç denklem vardır ve bir serbestlik kalır. Şablon köşelere 0,0696, merkeze 0,0184 verir; bağımsız çarpımsal algoritma köşelere 0,0681, merkeze 0,0313 vermiştir. İki ağırlık kümesinin D değerleri 3,795821 ve 3,795826'dır.
S5. D-optimal tasarım neden merkez noktasını seçmiyor, I-optimal neden seçiyor?
D ölçütü katsayıların ortak belirsizliğini küçültür; bunun için sütunların yayılımını büyütür ve noktaları bölgenin sınırına iter. I ölçütü tahmin varyansının bölge üzerindeki ortalamasını küçültür; bölgenin içi de hesaba girdiğinden merkezde bir gözlem ortalamayı belirgin düşürür. Örnekte I-optimal tasarım her faktörün -2, 0, 2 düzeylerini beşer kez kullanır ve merkezi (aday 63) içerir; I 8,849'dan 7,927'ye iner, D ise 3,676'dan 3,577'ye düşer (%2,7 kayıp).
S6. Aday küme sürekli bir bölgeyi temsil ediyorsa ızgaranın inceliği sonucu değiştirir mi?
Kuadratik model için D-optimal noktalar bölgenin uçlarında ve ortalarındadır; 5^3 ızgarasında seçilen bütün noktaların \{-2{,}0{,}2\} düzeylerinde olması bunu gösterir. Izgarayı inceltmek (9^3, 11^3) bu modelde tasarımı değiştirmez, yalnız aramayı uzatır. Daha yüksek dereceli ya da doğrusal olmayan modellerde en iyi noktalar ara düzeylere düşebilir; o zaman ızgara inceliği önem kazanır. I değeri aday kümenin kendisine göre ortalama alındığından ızgara değiştiğinde değişir.
S7. Kategorik faktör eklenirse ne değişir?
Ana etkiler ve etkileşimli modellerde kategorik faktör L-1 gösterge sütunuyla girer; kuadratik model yalnız sayısal faktörlerle kurulur ve şablon bunu denetler (satır 91). Kodlu ölçekteki verimlerde kategorik faktör, dengeli tasarımda \mathbf X'^{\top}\mathbf X'=N\mathbf I verecek biçimde ölçeklenmiş dik zıtlıklarla kodlanır; böylece %100, sayısal faktörlerde olduğu gibi dik ve dengeli tasarımı gösterir. D, A, I ise AlgDesign'ın kurduğu gösterge kodlu matristen gelir.
S8. Deneme sayısı parametre sayısına eşit seçilirse ne olur?
N=k doymuş tasarımdır: katsayılar kestirilir, ama artık serbestlik derecesi kalmaz ve hata varyansı kestirilemez. Şablon N<k'yı reddeder, N=k'yı kabul eder. Deneme sayısı boş (0) bırakıldığında N=k+5 alınır; beş ek deneme hata kestirimi için en az bir düzeyde serbestlik bırakmak içindir. Uyum eksikliği sınanacaksa ek denemelerin bir bölümü yineleme olarak ayrıca planlanır.
13.10 Kaynaklar
- Atkinson, A. C., Donev, A. N., & Tobias, R. D. (2007). Optimum experimental designs, with SAS. Oxford University Press. https://doi.org/10.1093/oso/9780199296590.001.0001
- Cook, R. D., & Nachtsheim, C. J. (1980). A comparison of algorithms for constructing exact D-optimal designs. Technometrics, 22(3), 315–324. https://doi.org/10.1080/00401706.1980.10486162
- Fedorov, V. V. (1972). Theory of optimal experiments. Academic Press.
- Kiefer, J., & Wolfowitz, J. (1960). The equivalence of two extremum problems. Canadian Journal of Mathematics, 12, 363–366. https://doi.org/10.4153/CJM-1960-030-4
- Silvey, S. D., Titterington, D. M., & Torsney, B. (1978). An algorithm for optimal designs on a design space. Communications in Statistics - Theory and Methods, 7(14), 1379–1389. https://doi.org/10.1080/03610927808827719
- St. John, R. C., & Draper, N. R. (1975). D-optimality for regression designs: A review. Technometrics, 17(1), 15–23. https://doi.org/10.1080/00401706.1975.10489266
- Wheeler, B. (2025). AlgDesign: Algorithmic experimental design (R package version 1.2.1.2). https://doi.org/10.32614/CRAN.package.AlgDesign