150. Klinik tahmin modeli (TRIPOD)
Şablon kimliği: klinik_tahmin · Kategori: sağkalım · Dil: R · Dosya: pro/sablonlar/sagkalim/klinik_tahmin.R (satır 1–441; üstbilgi 1–174) · Örnek veri: _ornek/klinik_tahmin_df_binary.csv (ve _df_surv.csv) · Paketler: rms 8.1-1, survival 3.8-6, dcurves 0.5.1 (Hmisc 5.3-0 birlikte yüklenir)
150.1 Ne işe yarar
Şablon, tek bir hastada bir olayın (tanı, komplikasyon, ölüm) olasılığını öngören çok değişkenli bir klinik tahmin modelini kurar ve Bireysel Prognoz ya da Tanı için Çok Değişkenli Tahmin Modelinin Şeffaf Raporlanması (TRIPOD) bildirgesinin istediği başarım ölçütleriyle değerlendirir (Collins vd., 2015). Sonuç ikili ise lojistik regresyon (rms::lrm), olaya kadar geçen süre ise Cox modeli (rms::cph) kurulur. Amaç etki kestirimi değil öngörüdür: model hastaların riskini doğru sıralamalı (ayırma), öngörülen olasılıklar gözlenenle uyuşmalı (kalibrasyon) ve karar vermeye yararlı olmalıdır (klinik yarar).
Şablon sırasıyla şunları yapar: sürekli öngörücülerde doğrusal olmamayı kısıtlı kübik spline ile modeller; Wald ANOVA ile doğrusal olmama sınar; görünen (apparent) ayırma ve kalibrasyon ölçütlerini verir; bootstrap (ya da .632 ya da çapraz doğrulama) ile iyimserlik düzeltmeli ölçütleri ve kalibrasyon eğrisini hesaplar (Harrell vd., 1996); karar eğrisi analiziyle her eşik olasılığında net yararı hesaplar (Vickers ve Elkin, 2006); rms::nomogram ile nomogram çizer.
Ne zaman kullanılır?
- Hedef öngörüdür; sonuç ikili (ör. kanser var/yok) ya da olaya kadar geçen süredir.
- Öngörücü sayısı olay sayısına göre sınırlıdır (olay/serbestlik derecesi en az yaklaşık 10; Peduzzi vd., 1996).
- Sürekli bir öngörücünün etkisi doğrusal olmayabilir ve bu sınanmak istenir.
- Modelin başka veriye geçerliliği için iç doğrulama (iyimserlik düzeltmesi) ve klinik yarar gösterimi gerekir.
Ne zaman kullanılmaz?
- Amaç bir maruziyetin etkisini kestirmekse:
cift_saglam_aipw(Bölüm 125) ve diğer nedensel çıkarım şablonları; öngörücü seçimi değil, karıştırıcı denetimi gerekir. - Yalnız bir belirtecin zamana bağlı ayırma gücü isteniyorsa:
zamana_bagli_roc(Bölüm 155). - Rakip olay veya çok durumlu süreç varsa:
cok_durumlu_mstate(Bölüm 145); bu şablon rakip olayı sansür sayan tek olaylı Cox modeli kurar. - Öngörücü sayısı olaydan çoksa (olay/sd < 10): aşırı uyum riski yüksektir; şablon uyarır ama durdurmaz (150.4.6).
- Çok düzeyli, kümeli ya da tekrarlı ölçümlü veri varsa: karma model şablonları (ör.
glmer_ileri, Bölüm 19).
Temel programla ilişki. Temel programda lojistik regresyon ve Cox modeli vardır; spline tabanı, bootstrap iyimserlik düzeltmesi, kalibrasyon eğrisi, karar eğrisi ve nomogram yoktur. Bu şablon yalnız MerQuR+'tadır.
150.2 Şablonun girdileri
Form yirmi [[param]] bloğundan kurulur (klinik_tahmin.R:10–173). Türlerin ve formun ortak denetiminin anlamı Bölüm 1.2'de anlatılmıştır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Model türü · model |
seçim · Model | lojistik |
lojistik, cox |
lrm ya da cph (10–17, 179, 251–255). |
Sonuç / olay durumu · yanit |
sayısal sütun · Değişkenler | yok (zorunlu) | yalnız 0 ve 1 | Y (18–23, 183–186). |
Takip süresi · zaman |
sayısal sütun · Değişkenler | boş | pozitif sayı | Yalnız Cox (24–30, 172–174, 188–190). |
Öngörücüler · ongoruculer |
sütunlar · Değişkenler | yok (zorunlu; en az 1) | herhangi sütunlar | Sayısal olmayan sütun faktör (31–37, 176–216). |
Sayı değerli kategorik/metin sütunları · kodlu_kategori |
seçim · Model | dogrusal |
dogrusal, kategorik |
etiketleri sayı olan sütunun tek doğrusal terim mi düzeylere ayrılmış kategori mi olacağı (39–45, 207–210). |
Spline öngörücüleri · spline_degiskenler |
sayısal sütunlar · Model | boş | sayısal sütunlar | rcs(x, k) (46–53, 183, 214–220). |
Spline düğüm sayısı · dugum |
tamsayı · Model | 4 | 3–7 | k (46–54, 196, 205–209). |
Tahmin zamanı t · zaman_noktasi |
ondalık · Model | 0 | \ge 0; 0 = olay zamanlarının ortancası | Yalnız Cox (55–62, 231–234). |
Ceza · ceza |
ondalık · Gelişmiş | 0 | \ge 0 | lrm(penalty =) (71–78, 254). |
İç doğrulama yöntemi · dogrulama |
seçim · Seçenekler | boot |
boot, .632, crossvalidation |
validate/calibrate(method =) (79–86, 314). |
Bootstrap yinelemesi · B |
tamsayı · Seçenekler | 200 | 2–2000 | B (79–87, 295). |
Çapraz doğrulama kat sayısı · kat |
tamsayı · Seçenekler | 10 | 2–100 | B olarak aktarılır (88–96, 297). |
Cox kalibrasyonunda grup başına gözlem · kal_m |
tamsayı · Gelişmiş | 0 | 0–100000; 0 = n/5 | calibrate(m =) (105–113, 350–353). |
Karar eğrisi en küçük eşik · esik_alt |
ondalık · Seçenekler | 0,01 | 0–0,99 | (106–114, 348). |
Karar eğrisi en büyük eşik · esik_ust |
ondalık · Seçenekler | 0,5 | 0,01–0,99 | (115–123, 348). |
Karar eğrisi eşik adımı · esik_adim |
ondalık · Seçenekler | 0,01 | 0,001–0,5 | (124–132, 349–353). |
Ek belirteçler · dca_degiskenler |
sayısal sütunlar · Seçenekler | boş | sayısal sütunlar | Karar eğrisine eklenir (133–140, 354–359). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | Wald GA (141–149, 226–228). |
Rastgele sayı tohumu · tohum |
tamsayı · Gelişmiş | 1 | 0–2 147 483 647; 0 = çalıştırmanın tohumu | set.seed(tohum) (158–166, 241–243, 323, 349). |
Nomogram çiz · nomogram |
onay · Çıktı | açık | açık/kapalı | rms::nomogram (167–173, 424–439). |
Örnek ayar (ornek_param, satır 9): model = lojistik, yanit = cancer, ongoruculer = age, famhistory, marker, spline_degiskenler = age, dugum = 4, esik_ust = 0,35; diğer alanlar varsayılandır (B = 200, tohum = 1, dogrulama = boot).
Şablonun kendi denetimleri (hepsi mq_hata ile çalıştırmayı durdurur):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 170 |
| Cox ve süre sütunu boş | "Cox modeli için takip süresi sütununu seçin." | 172 |
| Süre ve olay durumu aynı sütun | "Takip süresi ve olay durumu farklı sütunlar olmalı." | 174 |
| Sonuç ve süreden farklı öngörücü yok | "Sonuç ve süreden farklı en az bir öngörücü seçin." | 177 |
| Eksiksiz 20'den az gözlem | "Eksiksiz en az 20 gözlem gerekli." | 182 |
| Sonuç 0/1 dışında | "Sonuç / olay durumu yalnız 0 ve 1 değerlerini almalı." | 184 |
| Sınıfta 5'ten az gözlem | "Her sonuç sınıfında en az 5 gözlem gerekli (olay: …, olay yok: …)." | 186 |
| Süre \le 0 ya da sonlu değil | "Takip süreleri pozitif sayılar olmalı." | 189 |
| Sabit sayısal öngörücü | "'…' sabit; öngörücülerden çıkarın." | 202 |
| Tek düzeyli faktör | "'…' tek düzeyli; öngörücülerden çıkarın." | 214 |
| Güven düzeyi aralık dışında | "Güven düzeyi 0,5 ile 1 arasında olmalı …" | 227 |
| t\ge en büyük süre | "Tahmin zamanı t = …, en büyük takip süresinden (…) küçük olmalı." | 234 |
| Lojistik yakınsamadı | "Lojistik model yakınsamadı (olası tam ayrışma)." | 255 |
| Tam ayrışma (SH > 1000 ve olasılıkların > %5'i 0/1'e yakın) | "Tam ya da yarı tam ayrışma: … model sonuçları geçersiz." | 261–265 |
| Katsayı ya da SH sonlu değil | "Model katsayıları sonlu değil …" / "… standart hataları hesaplanamadı …" | 244, 246 |
| Kat sayısı >n ya da > en küçük sınıf | "Çapraz doğrulamada kat sayısı (…) …" | 298, 300 |
| Çapraz doğrulama başarısız | "Çapraz doğrulama yapılamadı: bazı test katlarında tek sonuç sınıfı kaldı …" | 301–302 |
| Cox kalibrasyonunda m\ge n | "… grup başına gözlem sayısı veri büyüklüğünden küçük olmalı." | 332 |
| En küçük eşik \ge en büyük eşik | "Karar eğrisi: en küçük eşik en büyük eşikten küçük olmalı." | 350 |
| İkiden az eşik | "Karar eğrisi için en az iki eşik gerekli (adımı küçültün)." | 353 |
rms/dcurves hataları |
"Lojistik model kurulamadı: …", "Karar eğrisi hesaplanamadı: …" ve benzerleri | 224–225, 237–240, 272, 304, 338, 362–364 |
Notlar (çalıştırmayı durdurmaz): eksik değerli satırlar sayısıyla birlikte bildirilerek çıkarılır (189); sayı etiketli sütun, faktör düzey sırası ve tohum notları (207–210, 224–225, 241–243); az farklı değerli sayısal sütunda spline yerine doğrusal girdi notu (217); Cox'ta ceza notu (247); olay/sd <10 uyarısı (275); tahminlerin %5'ten fazlası 0 ya da 1'e çok yakınsa ayrışma uyarısı (305); warning iletileri sonda toplanır ve model kestirimi ile yeniden örnekleme kaynaklı diye ayrı etiketlenir (401–402); .632 notu (342); karar eğrisine alınamayan ek belirteç notu (378); nomogram çizilemezse not (433).
Tohum. Şablon bootstrap ve çapraz doğrulama için kendi tohum alanını taşır (varsayılan 1) ve doğrulama ile kalibrasyondan hemen önce set.seed(tohum) çağırır (323, 349). Alan 0 verilirse Kod panelinin Tohum alanındaki çalıştırma tohumu kullanılır (o da yoksa 1; 241–243); varsayılan 1'de Kod panelinde 777 tohumu verilse de çıktı örnek ayarla aynıdır (düzeltilmiş eğim 0,964). Kullanılan tohum çıktının başında "Rastgele sayı tohumu (iç doğrulama ve kalibrasyon)" satırında yazılır (tohum = 2 iken düzeltilmiş eğim 0,963; kt_tohum2).
150.3 Örnek veri
klinik_tahmin_df_binary.csv ve klinik_tahmin_df_surv.csv: dcurves paketinin vinyet verileri df_binary ve df_surv (Sjoberg, 2025); her biri 750 hasta, sentetik. Eksik değer yoktur; iki dosyada age, famhistory ve marker aynıdır.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
cancer |
sonuç | ikili | 105 olay (%14), 645 olay yok |
ttcancer |
süre (yalnız df_surv) |
sayısal | 0,0005–5,285; ortanca 0,584; 105 olay |
age |
öngörücü (spline) | sayısal | ortalama 65,04; 45,30–79,77 |
famhistory |
öngörücü | ikili | 115 hasta (%15,3) 1 |
marker |
öngörücü | sayısal | ortalama 0,986; 0,001–6,721 |
risk_group |
ek faktör | kategorik | low 394, intermediate 335, high 21 (veride ilk görülme sırası: low, high, intermediate) |
cancerpredmarker |
karar eğrisinde ek belirteç | sayısal | 0–1 aralığında olasılık |
Düzey sırası. Sayısal olmayan öngörücü kategorik (faktör) sütunsa Veri sekmesinin düzey sırasıyla, metin sütunuysa alfabetik sırayla kurulur (224–225); ilk düzey başvurudur ve her sütun için sıra ve başvuru düzeyi çıktıya yazılır (mq_duzey_notu). risk_group Veri sekmesinde kategorik olduğunda (ilk görülme sırası low, high, intermediate) başvuru low'dur ve katsayılar risk_group=high ve risk_group=intermediate olarak yazılır; metin sütunu olarak seçilseydi başvuru alfabetik ilk düzey high olurdu (kt_fak). Etiketleri sayı olan sütunlar (ör. "2", "10", "20") varsayılan olarak tek doğrusal terim girer ve çıktıya not yazılır; kodlu_kategori = kategorik seçilirse düzeylere ayrılır (207–210, 150.8).
Bu bölümde kullanılan çalıştırmalar: kt_ornek (lojistik, örnek ayar); kt_cox (Cox, t=0{,}5242), kt_cox_t15 (t=1{,}5), kt_cox_cv, kt_cox_632, kt_cox_dogrusal; kt_fam_tek (yalnız famhistory); kt_dugum3, kt_dugum5, kt_dogrusal, kt_ceza (ceza = 5), kt_fak (risk_group ekli), kt_dca_ek, kt_esik, kt_guven90, kt_B20, kt_632, kt_cv; tohum kt_tohum2, kt_tohum1_mq; sınır durumları kt_kd_y12, kt_kd_eksik, kt_kd_sabit, kt_kd_tek, kt_kd_ayrisma, kt_kd_azolay (n = 150, 18 olay, 8 sd), kt_kd_txt, kt_kd_agetxt, kt_kd_adlar, kt_kd_kat_cok, kt_kd_tbuyuk, kt_kd_cox_neg, kt_kd_cox_sifir, kt_kd_cox_zamansiz, kt_kd_yanit_ong, kt_kd_spline_ikili, kt_kd_ceza_cox. Ek veriler veri_uret.py ile türetilmiştir (tohum 11).
150.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (i) veri denetlenir, öngörücüler spline ya da faktör olarak kurulur; (ii) lrm ya da cph uydurulur; (iii) katsayı, düğüm ve Wald ANOVA tabloları yazılır; (iv) görünen başarım ölçütleri hesaplanır; (v) rms::validate iyimserlik düzeltmeli ölçütleri verir; (vi) rms::calibrate kalibrasyon eğrisini verir; (vii) dcurves::dca net yararı hesaplar; (viii) üç şekil çizilir.
150.4.1 Kısıtlı kübik spline tabanı
Sürekli bir öngörücü x için k düğümlü (t_1<\dots<t_k) kısıtlı kübik spline, doğrusal terim ve k-2 kübik terimden oluşur; fonksiyon son iki aralıkta doğrusaldır (Durrleman ve Simon, 1989; Harrell, 2015). rms::rcs(x, k) tabanı (x_1=x)
- (u)_+=\max(u,0); x_1=x doğrusal terimdir, x_2,\dots,x_{k-1} kübik terimlerdir; k=4 için üç sütun (x, x', x'').
- Payda (t_k-t_1)^2 tabanı ölçekler (
rcsvarsayılanınorm = 2). - Spline için k-1 serbestlik derecesi harcanır.
Neden kısıtlı kübik spline?
Sürekli öngörücüyü doğrusal varsaymak ya da kategorilere bölmek bilgi kaybettirir ya da yanlı bir etki biçimi dayatır. Kısıtlı kübik spline esnek, yumuşak ve uçlarda (veri seyrek) doğrusal olduğundan uç değerlerde kararsız kübik kıvrımlar üretmez; birkaç parametreyle çoğu klinik ilişkiyi yakalar (Harrell, 2015, Bölüm 2.4).
Düğümler Harrell'in önerdiği kantillerdedir: k=3: %10, %50, %90; k=4: %5, %35, %65, %95; k=5: %5, %27,5, %50, %72,5, %95; k=6 ve k=7 için rms tablosu (Harrell, 2015). Kantiller R'nin varsayılan (tip 7) tanımıyla alınır. Örnekte age için k=4 düğümü 57{,}0583;\ 62{,}9975;\ 66{,}9399;\ 73{,}6381'dir.
Spline uygulanması. Spline yalnız spline_degiskenler'de seçilen sayısal sütunlara uygulanır; bu liste öngörücülerde yoksa o sütun modele eklenir (175–176). Farklı değer sayısı k+2'den azsa spline yerine doğrusal girdi ve not yazılır (205–207).
150.4.2 Lojistik ve Cox modeli
Lojistik (lrm, ceza yoksa en çok olabilirlik):
Cox (cph, Efron bağ düzeltmesi): h(t\mid x)=h_0(t)\exp(\eta), \eta=\sum_j f_j(x_j)\beta_j. t anındaki risk \hat p_i(t)=1-\hat S_0(t)^{\exp(\hat\eta_i)}'dir (rms::survest; surv = TRUE, time.inc =t; 237, 279). t boşsa olay zamanlarının ortancasıdır (233).
Katsayı tablosu Wald z=\hat\beta/SE, p=2\Phi(-|z|) ve \exp(\hat\beta) ile aralığını verir; spline terimleri için oran tek başına yorumlanmaz (tablo başlığı bunu söyler). Lojistikte kesişim satırında oran boştur.
Koddaki tercih
Lojistik model rms::lrm(fo, data = X, x = TRUE, y = TRUE, penalty = ceza), Cox modeli rms::cph(fo, data = X, x = TRUE, y = TRUE, surv = TRUE, time.inc = t_n) ile kurulur (237–240). x = TRUE, y = TRUE bootstrap yeniden kestirimleri için tasarım matrisini ve yanıtı saklar. datadist genel ortama yazılır (222). Öngörücü adları make.names ile güvenli adlara çevrilir ve tablolara özgün adlarıyla geri yazılır (192–193, 255–265); boşluk ve parantezli adlar sorunsuz çalışır (kt_kd_adlar).
Ceza. ceza > 0 iken lrm(penalty = ceza) büzülmeli (ridge) kestirim yapar; kesişim cezalandırılmaz, katsayılar büzülür ve etkin serbestlik derecesi küçülür (örnekte ceza = 5 ile 5 yerine yaklaşık 3,55; kt_ceza). Cox'ta ceza kullanılmaz; girilirse not yazılır ve model cezasız kurulur (235).
150.4.3 Wald ANOVA
anova(fit) her öngörücü için birleşik Wald \chi^2 verir: \chi^2=\hat\beta_S'\hat V_{SS}^{-1}\hat\beta_S (S: öngörücünün katsayı kümesi). Spline'lı öngörücü için "doğrusal olmayan" satırı yalnız kübik terimleri (k-2 sd) ve "TOPLAM" bütün terimleri sınar. Örnek: age \chi^2_3=78{,}0106; doğrusal olmama \chi^2_2=1{,}8139 (p=0{,}4037): yaş etkisi doğrusal olarak yeterli; TOPLAM \chi^2_5=107{,}6137.
150.4.4 Görünen başarım
| Ölçüt | Tanım |
|---|---|
| LR \chi^2 | 2(\ell_1-\ell_0); modelin yalnız kesişimli modele göre olabilirlik oranı. |
| C | Lojistikte P(\hat p_{\text{olay}}>\hat p_{\text{olaysız}}) (eşit çift yarım); Cox'ta Harrell C=(D_{xy}+1)/2. |
| Somers D_{xy} | 2C-1 (sıra korelasyonu). |
| Nagelkerke R^2 | \dfrac{1-\exp(-\mathrm{LR}/n)}{1-\exp(2\ell_0/n)}. |
| Brier | \frac1n\sum(\hat p_i-y_i)^2 (yalnız lojistik). |
| g | Doğrusal kestiricinin Gini ortalama farkı \binom{n}{2}^{-1}\sum_{i<j}\lvert\hat\eta_i-\hat\eta_j\rvert. |
Model serbestlik derecesi df= fit$stats[["d.f."]]; olay/sd (EPV) =\min(\text{olay},\text{olay yok})/df (Cox'ta olay sayısı) ve 10'un altındaysa uyarı yazılır (249–255).
150.4.5 İç doğrulama: bootstrap iyimserlik düzeltmesi
Modelin kendi verisinde ölçülen başarım iyimserdir. Bootstrap iyimserlik düzeltmesi (Harrell vd., 1996) şöyle işler: b=1,\dots,B için verinin bootstrap örneklemi (n gözlem, yerine koyarak) çekilir; model bu örneklemde yeniden kurulur; bir başarım ölçütü \theta için eğitim değeri \theta^{(b)}_{\text{eğitim}} bootstrap örnekleminde, test değeri \theta^{(b)}_{\text{test}} özgün veride (bootstrap modeliyle) hesaplanır. İyimserlik ve düzeltilmiş değer
- \theta: D_{xy}, R^2, Brier, kalibrasyon kesişimi ve eğimi (lojistik doğrusal kestiricinin özgün veriye yeniden uydurulmuş lojistik regresyonu: \operatorname{logit}P(Y=1)=a+b\hat\eta) vb.
- Kalibrasyon kesişimi için eğitim değeri 0, eğim için 1'dir; test değerleri sapmayı gösterir (b<1 aşırı uyum).
- Tablo C=(D_{xy}+1)/2 satırını ayrıca yazar (311–316).
rms::validate(fit, method = yon, B = B) Cox'ta dxy = TRUE ile çağrılır (304). .632 yönteminde "iyimserlik" sütunu eğitim − test değildir (.632 ağırlıklı toplam kullanır; 150.8). Çapraz doğrulama seçilirse B yerine kat sayısı kullanılır ve her test katında iki sonuç sınıfı bulunmalıdır (298–302). Bootstrap yinelemesinde ve kalibrasyonda set.seed(tohum) çağrılır (303, 328).
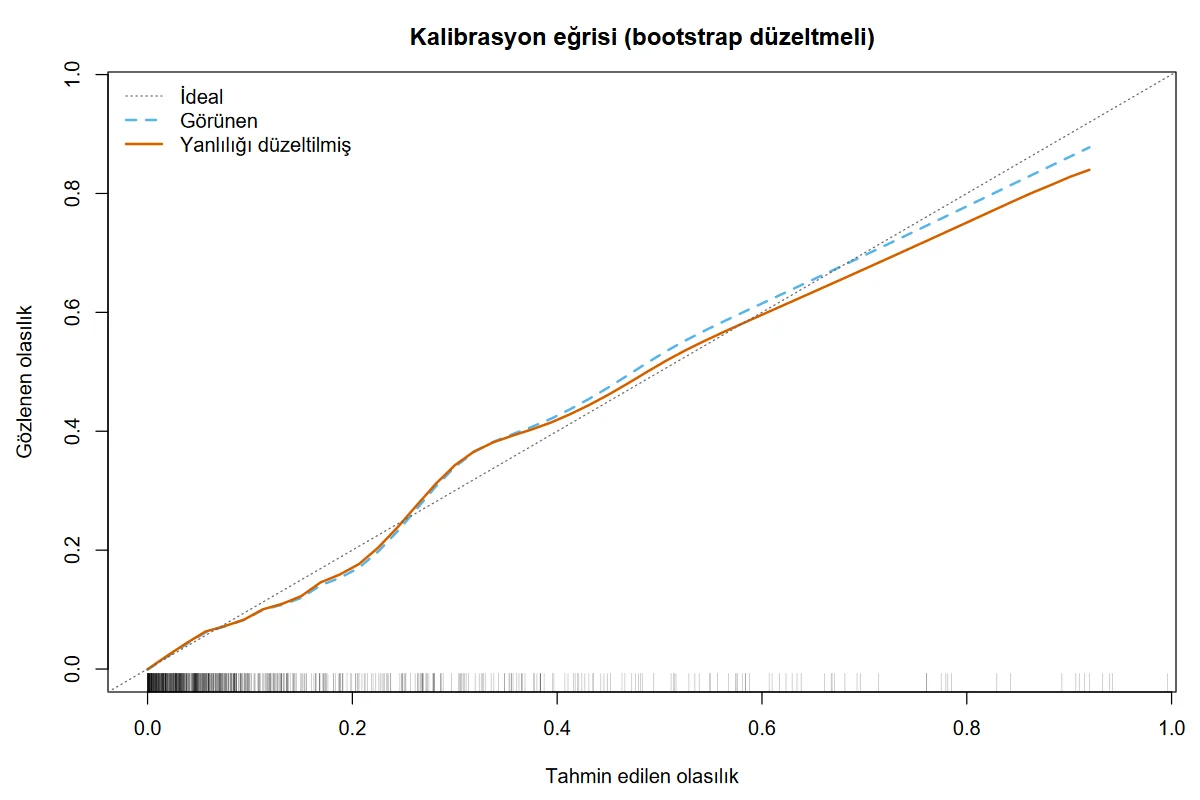
Kalibrasyon. Düzeltilmiş kalibrasyon eğimi <0{,}9 ise "aşırı uyum belirgin, katsayıların büzülmesi önerilir", >1{,}1 ise yanıltıcı olabileceği, aksi hâlde "aşırı uyum küçük" yazılır (322–327). Kalibrasyon eğrisi rms::calibrate: lojistikte loess ile 50 noktalı eğri, Cox'ta t anında Kaplan–Meier grupları (cmethod = "KM", m = max(10, ⌊n/5⌋)). Tablo, tahmin edilen olasılığa karşı görünen ve bootstrap düzeltmeli gözlenen olasılığı verir; ortalama mutlak kalibrasyon hatası lojistikte \frac1n\sum_i|\hat p_i-\hat p_{\text{düz}}(\hat p_i)| (düzeltilmiş eğri ara değerlemeyle), Cox'ta gruplardaki ortalamadır (328–346).
150.4.6 Karar eğrisi analizi
Eşik olasılığı p_t bir girişimin zararının yararına oranını yansıtır (p_t/(1-p_t) = zarar/yarar). p_t'nin üstünde risk veren hastalar "pozitif" sayılır. Net yarar
- DP: \hat p_i\ge p_t ve Y_i=1 olan hasta sayısı; YP: \hat p_i\ge p_t ve Y_i=0; \pi olay oranı.
- Cox'ta DP/YP t anındaki olay olasılığına göre Kaplan–Meier ile (1-\hat S_{\text{pozitifler}}(t)) kestirilir;
dca(Surv ~ model, time = t). kacinilan_100=\{\mathrm{NB}_{\text{model}}-\mathrm{NB}_{\text{herkes}}\}\big/\{p_t/(1-p_t)\}\times100: model kullanılınca her 100 hastada kaçınılan gereksiz girişim sayısıdır.
Eşikler seq(esik_alt, esik_ust, by = esik_adim) ile üretilir ve (0{,}1) dışındakiler atılır (351–352). Tablonun yanında "model hangi eşik aralığında iki varsayılan stratejiden de yararlı" cümlesi yazılır (374–378). dca_degiskenler ile seçilen ek belirteçler (0–1 dışındaki değerler as_probability ile olasılığa çevrilir) aynı tabloya girer.
150.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 175–198 | Dil yardımcısı, paketler; model ve sütun denetimi; eksik satırlar; 0/1 ve süre denetimi | Eksik değerli satır sayısı bildirilir (189). |
| 199–233 | Öngörücü adları, spline ve faktör kurulumu, X veri çerçevesi |
Faktör Veri sekmesi sırasında, metin alfabetik; sayı etiketli sütun not düşülerek doğrusal ya da kategorik. |
| 234–260 | datadist; güven düzeyi, tohum, ceza; t; cph/lrm; katsayı ve SH denetimi |
Tam ayrışmada SH > 1000 ve olasılıklar uçta ise çalıştırma durur (261–265). |
| 266–285 | df, EPV ve uyarı; katsayı tablosu (özgün adlarla) | Model sd 1 ondalıkla yazılır (mq_sayi(sdf, 1)). |
| 286–297 | Düğüm tablosu; Wald ANOVA | Etiketler Türkçeleştirilir. |
| 298–313 | Tahmin olasılıkları, Brier, ayrışma uyarısı, görünen başarım tablosu | Cox'ta risk 1-S(t). |
| 314–348 | İç doğrulama: validate, C satırı, iyimserlik, eğim yorumu |
.632 yöntemi uyarı üretir; açıklayıcı not yazılır (342). |
| 349–368 | Kalibrasyon: calibrate, tablo, ortalama mutlak hata |
Cox'ta KM grupları. |
| 369–400 | Karar eğrisi: eşikler, dcurves::dca, net yarar tablosu, yarar aralığı cümlesi |
Ek belirteçler df[rownames(d), v] ile alınır. |
| 401–439 | Uyarılar, üç şekil (kalibrasyon, karar eğrisi, nomogram) | Okabe–Ito renkleri; nomogram hata verirse not. |
150.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bağımsız Python (dogrulama/klinik_tahmin/elle_hesap.py, elle_cox.py) rms, Hmisc ve dcurves kullanmaz: spline tabanını kendi formülüyle kurar, lojistik modeli Newton–Raphson'la, Cox modelini Efron kısmi olabilirliğiyle uydurur; bootstrap örneklemlerini R'nin rastgele sayı dizisini (set.seed, Mersenne-Twister, reddedici örnekleme) yeniden kurarak çeker. Bağımsız R (r_dogrulama.R) temel R (glm) ve survival::coxph ile aynı hesabı kendi tabanı ve kendi bootstrap döngüsüyle yapar; rms çağrılmaz.
Adım 1 — Spline tabanı. age kantilleri: 57{,}0583;\ 62{,}9975;\ 66{,}9399;\ 73{,}6381. x' ve x'' sütunları 150.4.1'deki formülle kurulur.
Adım 2 — Lojistik katsayılar. Newton–Raphson \hat\beta=(-41{,}3554;\ 0{,}602016;\ -0{,}783300;\ 2{,}503076;\ 0{,}892613;\ 0{,}970411) ve SE=(17{,}8504;\ 0{,}292241;\ 0{,}622474;\ 1{,}906571;\ 0{,}308677;\ 0{,}117855). Ailede kanser öyküsü için \mathrm{OR}=\exp(0{,}892613)=2{,}4415 (%95 GA 1{,}3332–4{,}4710); belirteç için 2{,}6390 (2{,}0947–3{,}3248). Yalnız famhistory ile kurulan modelde \mathrm{OR}=1{,}8038 (kt_fam_tek; yayımlanmış 1,80).
Adım 3 — Wald ve olabilirlik oranı. \ell_1 ve \ell_0'dan \mathrm{LR}=181{,}6543; Wald \chi^2: age 78{,}0106 (3 sd), doğrusal olmama 1{,}8139 (2 sd; p=0{,}4037), famhistory 8{,}3622, marker 67{,}7976, TOPLAM 107{,}6137 (5 sd).
Adım 4 — Görünen ölçütler. C=0{,}861661 (sıra toplamıyla), D_{xy}=0{,}723322, R^2_{\text{Nagelkerke}}=0{,}387501, Brier 0{,}084973, g=2{,}109984.
Adım 5 — Bootstrap. set.seed(1) sonrası ilk bootstrap örnekleminin ilk altı gözlemi 679,\ 129,\ 509,\ 471,\ 299,\ 270 ve 750 gözlemde 467 farklı satır içerir (999 ham çekiliş, 249'u reddedilmiş); R ve bağımsız Python aynıdır. B=200 yinelemede eğitim ve test ortalamaları: D_{xy} 0{,}728020 ve 0{,}718845, iyimserlik 0{,}009175, düzeltilmiş 0{,}714147 (C=0{,}857074); R^2 0{,}371553; kalibrasyon kesişimi -0{,}055817; eğim 0{,}963922; Brier 0{,}087138.
Adım 6 — Karar eğrisi. Eşik 0{,}05: \mathrm{NB}_{\text{herkes}}=0{,}094737 (\pi=0{,}14), model 0{,}106807, kaçınılan 22{,}93 girişim; eşik 0{,}20: -0{,}075 ve 0{,}066333 (56{,}53); eşik 0{,}35: -0{,}323077 ve 0{,}049436 (69{,}18).
Adım 7 — Cox modeli. Efron kısmi olabilirlik (df_surv, 105 olay): \hat\beta=(0{,}616978;\ -0{,}758450;\ 2{,}245155;\ 0{,}811342;\ 0{,}885559); LR \chi^2=219{,}7386; uyumlu çift 37 028; Harrell C=0{,}845292, D_{xy}=0{,}690583. t=0{,}524235 (olay zamanlarının ortancası) için Breslow temel tehlike ve KM tabanlı net yarar: eşik 0{,}05'te herkes 0{,}036054, model 0{,}053363.
Adım 8 — Kalibrasyon. rms::calibrate (loess, Kaplan–Meier grupları) ve ortalama mutlak kalibrasyon hatası bağımsız doğrulanmamıştır; yalnız tablo tutarlılığı (kalibrasyon eğrisinin ideal doğruya yakınlığı) görsel olarak denetlenmiştir.
150.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Lojistik: katsayı Kesişim | −41,35541682 | −41,35541682 | −41,35541682 | 2,7e−13 | ✓ |
| Lojistik: SH Kesişim | 17,85035847 | 17,85035847 | 17,85035779 | 3,8e−8 | ✓ |
| Lojistik: katsayı age | 0,602016 | 0,602016 | 0,602016 | 1,9e−13 | ✓ |
| Lojistik: SH age | 0,29224072 | 0,29224072 | 0,29224071 | 1,1e−8 | ✓ |
| Lojistik: katsayı age' | −0,78330044 | −0,78330044 | −0,78330044 | 3,9e−13 | ✓ |
| Lojistik: SH age' | 0,62247427 | 0,62247427 | 0,62247425 | 1,8e−8 | ✓ |
| Lojistik: katsayı age'' | 2,50307598 | 2,50307598 | 2,50307598 | 4,6e−13 | ✓ |
| Lojistik: SH age'' | 1,90657125 | 1,90657125 | 1,9065712 | 2,5e−8 | ✓ |
| Lojistik: katsayı famhistory | 0,89261305 | 0,89261305 | 0,89261305 | 1,5e−14 | ✓ |
| Lojistik: SH famhistory | 0,30867669 | 0,30867669 | 0,30867669 | 4,1e−10 | ✓ |
| Lojistik: katsayı marker | 0,97041095 | 0,97041095 | 0,97041095 | 5,0e−14 | ✓ |
| Lojistik: SH marker | 0,11785513 | 0,11785513 | 0,11785513 | 2,9e−10 | ✓ |
| Wald ki-kare: age | 78,01057847 | 78,01057847 | 78,01057975 | 1,6e−8 | ✓ |
| Wald p: age | 1,110223·10−16 | 8,197827·10−17 | 8,197822·10−17 | 2,9e−17 | ✓ |
| Wald ki-kare: doğrusal olmayan | 1,81393176 | 1,81393176 | 1,81393182 | 3,4e−8 | ✓ |
| Wald p: doğrusal olmayan | 0,40374739 | 0,40374739 | 0,40374737 | 1,2e−8 | ✓ |
| Wald ki-kare: famhistory | 8,36216646 | 8,36216646 | 8,36216649 | 2,7e−9 | ✓ |
| Wald p: famhistory | 0,00383114 | 0,00383114 | 0,00383114 | 4,7e−11 | ✓ |
| Wald ki-kare: marker | 67,79761611 | 67,79761611 | 67,79761644 | 4,9e−9 | ✓ |
| Wald p: marker | 2,220446·10−16 | 1,811684·10−16 | 1,811684·10−16 | 4,1e−17 | ✓ |
| Wald ki-kare: TOPLAM | 107,61373577 | 107,61373577 | 107,61373698 | 1,1e−8 | ✓ |
| Wald p: TOPLAM | 0 | 1,308110·10−21 | 1,308110·10−21 | 1,3e−21 | ✓ |
| LR ki-kare | 181,6543005 | 181,6543005 | 181,6543005 | 5,5e−15 | ✓ |
| C | 0,86166113 | 0,86166113 | 0,86166113 | 6,0e−15 | ✓ |
| Somers Dxy | 0,72332226 | 0,72332226 | 0,72332226 | 1,3e−14 | ✓ |
| Nagelkerke R² | 0,38750074 | 0,38750074 | 0,38750074 | 1,2e−14 | ✓ |
| Brier | 0,084973 | 0,084973 | 0,084973 | 1,7e−15 | ✓ |
| g (Gini ortalama farkı) | 2,10998423 | 2,10998423 | — | 8,1e−14 | ✓ |
| Bootstrap (200, tohum 1): Dxy, egitim | 0,7280197 | 0,7280197 | 0,7280197 | 4,3e−14 | ✓ |
| Bootstrap (200, tohum 1): Dxy, test | 0,71884474 | 0,71884474 | 0,71884474 | 3,2e−14 | ✓ |
| Bootstrap (200, tohum 1): Dxy, iyimserlik | 0,00917496 | 0,00917496 | 0,00917496 | 3,0e−16 | ✓ |
| Bootstrap (200, tohum 1): Dxy, duzeltilmis | 0,7141473 | 0,7141473 | 0,7141473 | 3,7e−14 | ✓ |
| Bootstrap (200, tohum 1): R², egitim | 0,39677223 | 0,39677223 | 0,39677223 | 3,0e−15 | ✓ |
| Bootstrap (200, tohum 1): R², test | 0,38082437 | 0,38082437 | 0,38082437 | 3,5e−14 | ✓ |
| Bootstrap (200, tohum 1): R², iyimserlik | 0,01594786 | 0,01594786 | 0,01594786 | 2,0e−15 | ✓ |
| Bootstrap (200, tohum 1): R², duzeltilmis | 0,37155288 | 0,37155288 | 0,37155288 | 2,6e−14 | ✓ |
| Bootstrap (200, tohum 1): kalibrasyon kesişimi, egitim | 0 | 1,838735·10−16 | 2,292689·10−16 | 2,3e−16 | ✓ |
| Bootstrap (200, tohum 1): kalibrasyon kesişimi, test | −0,05581659 | −0,05581659 | −0,05581659 | 1,2e−13 | ✓ |
| Bootstrap (200, tohum 1): kalibrasyon kesişimi, iyimserlik | 0,05581659 | 0,05581659 | 0,05581659 | 1,2e−13 | ✓ |
| Bootstrap (200, tohum 1): kalibrasyon kesişimi, duzeltilmis | −0,05581659 | −0,05581659 | −0,05581659 | 1,1e−13 | ✓ |
| Bootstrap (200, tohum 1): kalibrasyon eğimi, egitim | 1 | 1 | 1 | 2,2e−16 | ✓ |
| Bootstrap (200, tohum 1): kalibrasyon eğimi, test | 0,96392236 | 0,96392236 | 0,96392236 | 2,1e−13 | ✓ |
| Bootstrap (200, tohum 1): kalibrasyon eğimi, iyimserlik | 0,03607764 | 0,03607764 | 0,03607764 | 2,0e−13 | ✓ |
| Bootstrap (200, tohum 1): kalibrasyon eğimi, duzeltilmis | 0,96392236 | 0,96392236 | 0,96392236 | 2,1e−13 | ✓ |
| Bootstrap (200, tohum 1): Brier, egitim | 0,08396884 | 0,08396884 | 0,08396884 | 1,0e−15 | ✓ |
| Bootstrap (200, tohum 1): Brier, test | 0,08613347 | 0,08613347 | 0,08613347 | 2,5e−15 | ✓ |
| Bootstrap (200, tohum 1): Brier, iyimserlik | −0,00216463 | −0,00216463 | −0,00216463 | 4,0e−16 | ✓ |
| Bootstrap (200, tohum 1): Brier, duzeltilmis | 0,08713763 | 0,08713763 | 0,08713763 | 3,3e−15 | ✓ |
| Karar eğrisi: herkes, eşik 0,05 | 0,09473684 | 0,09473684 | 0,09473684 | 3,2e−15 | ✓ |
| Karar eğrisi: model, eşik 0,05 | 0,10680702 | 0,10680702 | 0,10680702 | 4,0e−14 | ✓ |
| Karar eğrisi: 100 hastada kaçınılan, eşik 0,05 | 22,93333333 | 22,93333333 | — | 6,2e−16 | ✓ |
| Karar eğrisi: herkes, eşik 0,2 | −0,075 | −0,075 | −0,075 | 1,4e−17 | ✓ |
| Karar eğrisi: model, eşik 0,2 | 0,06633333 | 0,06633333 | 0,06633333 | 3,4e−15 | ✓ |
| Karar eğrisi: 100 hastada kaçınılan, eşik 0,2 | 56,53333333 | 56,53333333 | — | 3,8e−16 | ✓ |
| Karar eğrisi: herkes, eşik 0,35 | −0,32307692 | −0,32307692 | −0,32307692 | 2,3e−14 | ✓ |
| Karar eğrisi: model, eşik 0,35 | 0,0494359 | 0,0494359 | 0,0494359 | 2,6e−15 | ✓ |
| Karar eğrisi: 100 hastada kaçınılan, eşik 0,35 | 69,18095238 | 69,18095238 | — | 4,1e−16 | ✓ |
| Cox: katsayı age | 0,61697075 | 0,61697799 | 0,61697799 | 7,2e−6 | ✓ |
| Cox: SH age | 0,26564306 | 0,26564528 | 0,26564528 | 2,2e−6 | ✓ |
| Cox: katsayı age' | −0,75843701 | −0,75844993 | −0,75844993 | 1,3e−5 | ✓ |
| Cox: SH age' | 0,54723903 | 0,54724263 | 0,54724263 | 3,6e−6 | ✓ |
| Cox: katsayı age'' | 2,24511957 | 2,24515456 | 2,24515456 | 1,6e−5 | ✓ |
| Cox: SH age'' | 1,63249814 | 1,63250726 | 1,63250726 | 5,6e−6 | ✓ |
| Cox: katsayı famhistory | 0,81134161 | 0,81134173 | 0,81134173 | 1,1e−7 | ✓ |
| Cox: SH famhistory | 0,24050601 | 0,24050601 | 0,24050601 | 2,4e−9 | ✓ |
| Cox: katsayı marker | 0,88555916 | 0,8855591 | 0,8855591 | 5,1e−8 | ✓ |
| Cox: SH marker | 0,07486457 | 0,0748646 | 0,0748646 | 2,2e−8 | ✓ |
| Cox Wald ki-kare: age | 124,65619084 | 124,65611826 | 124,65611826 | 5,8e−7 | ✓ |
| Cox Wald ki-kare: doğrusal olmayan | 1,92081241 | 1,92085261 | 1,92085261 | 2,1e−5 | ✓ |
| Cox Wald ki-kare: famhistory | 11,38035024 | 11,38035323 | 11,38035323 | 2,6e−7 | ✓ |
| Cox Wald ki-kare: marker | 139,92084785 | 139,92074772 | 139,92074772 | 7,2e−7 | ✓ |
| Cox Wald ki-kare: TOPLAM | 201,09003844 | 201,08994481 | 201,08994481 | 4,7e−7 | ✓ |
| Cox: LR ki-kare | 219,73863365 | 219,73863365 | 219,73863365 | 4,3e−12 | ✓ |
| Cox: C | 0,84529163 | 0,84529163 | 0,84529163 | 1,5e−14 | ✓ |
| Cox: Somers Dxy | 0,69058327 | 0,69058327 | 0,69058327 | 2,9e−14 | ✓ |
| Cox karar eğrisi: herkes, eşik 0,05 | 0,03605353 | 0,03605353 | — | 2,8e−17 | ✓ |
| Cox karar eğrisi: model, eşik 0,05 | 0,05336267 | 0,05336267 | — | 0 | ✓ |
| Cox karar eğrisi: herkes, eşik 0,2 | −0,14468644 | −0,14468644 | — | 4,4e−16 | ✓ |
| Cox karar eğrisi: model, eşik 0,2 | 0,03488607 | 0,03488607 | — | 4,2e−17 | ✓ |
| Cox karar eğrisi: herkes, eşik 0,35 | −0,40884485 | −0,40884485 | — | 2,8e−16 | ✓ |
| Cox karar eğrisi: model, eşik 0,35 | 0,02119963 | 0,02119963 | — | 0 | ✓ |
Ölçütü karşılayan: 81/81. Cox katsayılarında şablonun çağırdığı rms::cph, kısmi olabilirliğin göreli değişimi 10^{-9} altına inince durduğundan katsayılar kapalı çözümden 10^{-5} düzeyinde ayrılır (ölçüt 5\cdot10^{-5}); bağımsız Python ve R sıkı yakınsamayla (10^{-13}, 10^{-14}) aynı değeri verir. Cox temel tehlikesi Python'da Breslow, rms'te survfit tabanlıdır; karar eğrisinde model satırı 10^{-4} içinde eşleşir. Kalibrasyon eğrisi (loess, Kaplan–Meier grupları) ve ortalama mutlak kalibrasyon hatası bağımsız doğrulanmadı.
Yayımlanmış değerlerle karşılaştırma (dcurves vinyet verisi df_binary ve df_surv, n = 750; değerler yayımlandığı basamak sayısıyla):
| Büyüklük | MerQuR+ | Yayımlanmış | |fark| | | |---|---:|---:|---:|:-:| | Herkesi tedavi et, eşik 0,05 | 0,09473684 | 0,0947 | 3,7e−5 | ✓ | | Herkesi tedavi et, eşik 0,20 | −0,075 | −0,075 | 0,0e+00 | ✓ | | Herkesi tedavi et, eşik 0,35 | −0,32307692 | −0,323 | 7,7e−5 | ✓ | | Aile öyküsü OR (tek öngörücülü lojistik) | 1,8038258 | 1,8 | 3,8e−3 | ✓ | | Cox TO: yaş (doğrusal) | 1,30120088 | 1,3 | 1,2e−3 | ✓ | | Cox TO: aile öyküsü | 2,18591249 | 2,19 | 4,1e−3 | ✓ | | Cox TO: belirteç | 2,42023828 | 2,42 | 2,4e−4 | ✓ |
Yayımlanmış değerlerle eşleşen: 7/7.
150.7 Çıktıyı okuma
Örnek ayar (kt_ornek), konsol:
Rastgele sayı tohumu (iç doğrulama ve kalibrasyon): 1
Klinik tahmin modeli (lojistik): n = 750, olay = 105, model sd = 5,0, olay/sd (EPV) = 21,0
Düzeltilmiş kalibrasyon eğimi 0,964: aşırı uyum küçük.
Ortalama mutlak kalibrasyon hatası (düzeltilmiş): 0,0112
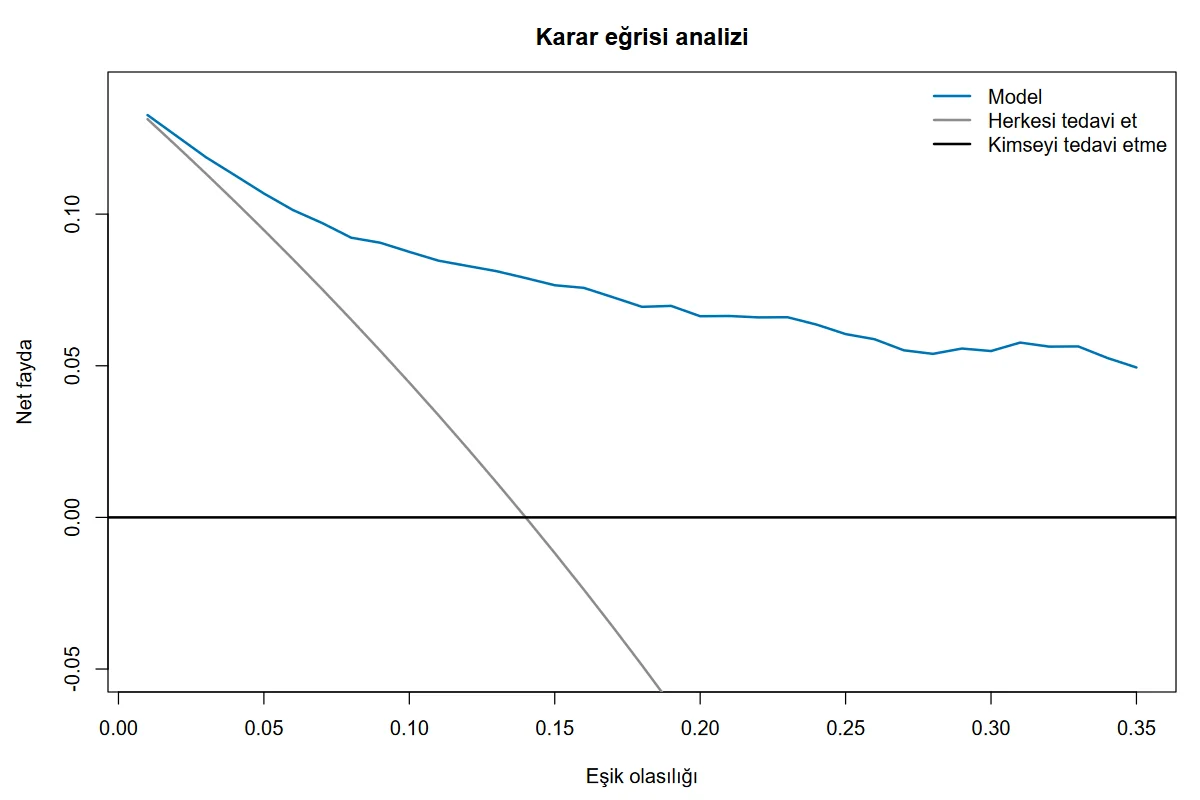
Model, eşik olasılığı 0,01–0,35 aralığında (incelenen 35 eşiğin 35'inde) her iki varsayılan stratejiden daha yüksek net fayda sağlıyor.
Tablolar (kısaltılmış):
terim          katsayi        SH         z       p        OR   GA_alt    GA_ust
Kesişim     -41.355417 17.850358 -2.316784 0.0205       NaN      NaN       NaN
age           0.602016  0.292241  2.060000 0.0394  1.825796 1.029666  3.237487
age'         -0.783300  0.622474 -1.258366 0.2083  0.456896 0.134886  1.547633
age''         2.503076  1.906571  1.312868 0.1892 12.220025 0.291203 512.8005
famhistory    0.892613  0.308677  2.891741 0.0038  2.441501 1.333248  4.470983
marker        0.970411  0.117855  8.233931 0.0000  2.639029 2.094718  3.324778

etki                 ki_kare  sd       p
age                  78.0106   3  0.0000
doğrusal olmayan      1.8139   2  0.4037
famhistory            8.3622   1  0.0038
marker               67.7976   1  0.0000
TOPLAM              107.6137   5  0.0000

olcut          deger
LR ki-kare   181.6543
model sd       5
C             0.861661
Somers Dxy    0.723322
Nagelkerke R² 0.387501
Brier         0.084973
g             2.109984

indeks                gorunen    egitim      test  iyimserlik  duzeltilmis    n
Dxy                  0.723322  0.728020  0.718845    0.009175     0.714147  200
C                    0.861661  0.864010  0.859422    0.004587     0.857074  200
R²                   0.387501  0.396772  0.380824    0.015948     0.371553  200
kalibrasyon kesişimi 0.000000  0.000000 -0.055817    0.055817    -0.055817  200
kalibrasyon eğimi    1.000000  1.000000  0.963922    0.036078     0.963922  200
Brier                0.084973  0.083969  0.086133   -0.002165     0.087138  200

esik   herkes  hic_kimse    model  kacinilan_100
0.05  0.094737        0  0.106807      22.933333
0.20 -0.075000        0  0.066333      56.533333
0.35 -0.323077        0  0.049436      69.180952
Şekil 150.1. Örnek ayar: kalibrasyon eğrisi; ideal doğru (nokta), görünen (kesikli) ve bootstrap yanlılığı düzeltilmiş (sürekli) gözlenen olasılık; alttaki çizgiler tahmin dağılımıdır.
Şekil 150.2. Örnek ayar: karar eğrisi; model, herkesi tedavi et (gri) ve kimseyi tedavi etme (yatay, siyah) stratejilerinin net yararı.
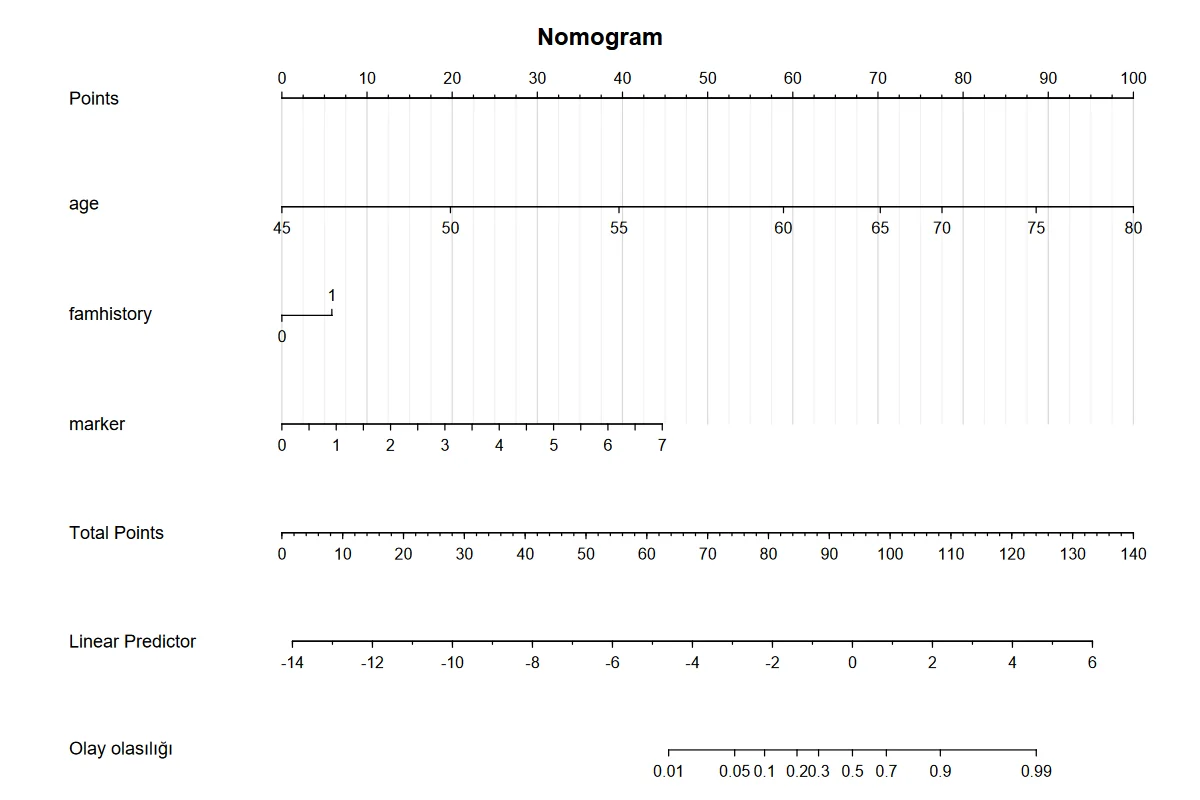
Şekil 150.3. Örnek ayar: nomogram; her öngörücünün puanı toplanıp toplam puandan doğrusal kestirici ve olay olasılığı okunur.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Katsayı tablosu | \hat\beta, SH, z, p, OR/TO ve Wald GA | Spline terimlerinin oranı tek başına yorumlanmaz; etki Wald ANOVA ve grafikten okunur. |
| Düğüm tablosu | Spline düğümleri | Veri kantilleri; k=4 için %5, %35, %65, %95. |
| Wald ANOVA | \chi^2, sd, p | "Doğrusal olmayan" satırı p büyükse doğrusal girdi yeterlidir. |
| Görünen başarım | C, D_{xy}, R^2, Brier, g | İyimserdir; doğrulama tablosuyla birlikte okunur. |
| İç doğrulama | Görünen, eğitim, test, iyimserlik, düzeltilmiş | Düzeltilmiş C raporlanır; eğim 1'in altındaysa aşırı uyum. |
| Kalibrasyon | Tahmin edilen ve gözlenen olasılık (görünen, düzeltilmiş) | Eğri ideal doğruya yakınsa iyi kalibre; Cox'ta gruplar. |
| Karar eğrisi | NB herkes, hiç kimse, model; kaçınılan girişim | Model eğrisi iki stratejinin de üstündeyse yararlıdır. |
Rapor cümlesi: 750 hastada kanser olasılığını öngören bir lojistik model (yaş için 4 düğümlü kısıtlı kübik spline, ailede kanser öyküsü ve belirteç) kuruldu; 105 olay için olay/serbestlik derecesi 21'dir. Yaşın doğrusal olmama testi anlamlı değildi (\chi^2_2=1{,}81; p=0{,}40). Görünen C istatistiği 0,862 iken 200 bootstrap yinelemesiyle iyimserlik düzeltmeli C 0,857, kalibrasyon eğimi 0,964 ve Brier skoru 0,087 bulundu. Karar eğrisi analizinde model, 0,01–0,35 eşik aralığının tamamında herkesi tedavi etme ve kimseyi tedavi etmeme stratejilerinden daha yüksek net fayda sağladı (eşik 0,05'te 0,107 ve 0,095; 100 hastada 22,9 gereksiz girişimin önlenmesine karşılık).
150.8 Sık hatalar ve tuzaklar
- Sayıya çevrilebilen metin sütunu sayı olarak girer. "2", "10" ve "20" değerli
dozsütunu üç düzeyli bir faktör yerine tek doğrusal terim olur (df=6 yerine kategorik halde 7); katsayı doz başına -0{,}0235'tir (kt_kd_txt). Kodlar sıra bilgisi taşımıyorsa sütun önceden harfli etiketlere çevrilmelidir. Aynı kural kodu 1/2/3 olan sınıflama için de geçerlidir. - Başvuru düzeyi sütunun türüne bağlıdır. Veri sekmesinde kategorik olan sütunda ilk düzey, metin sütununda alfabetik ilk düzey başvurudur; seçilen başvuru çıktıya yazılır. Başvuru yalnız 21 hastalık küçük bir düzeyse OR ve GA çok geniş çıkar (
kt_fak; 150.3). - Konsol "model sd"yi 1 ondalıkla yazar. Ceza ile etkin df=3{,}55 iken satır "model sd = 3,5" (EPV 105/3{,}55=29{,}6 ile uyumlu), df=5{,}9999999 iken "6,0" yazar (
kt_ceza,kt_kd_txt). - Tam ayrışma çalıştırmayı durdurur. Sonucu kusursuz ayıran bir öngörücüyle (
kt_kd_ayrisma) katsayılar 0 ile 42{,}4, SH 586–34 939 olurdu; lojistik modelde bir SH 1000'i aşıyor ve tahmin olasılıklarının %5'inden fazlası 0 ya da 1'e çok yakınsa şablon "Tam ya da yarı tam ayrışma … model sonuçları geçersiz" iletisiyle durur (261–265). Ceza (ridge) bu durumda SH'yi sınırlar ve çalıştırma tamamlanır. - Aşırı uyum. n = 150 ve 18 olayla 8 sd'li modelde (
kt_kd_azolay) EPV 2,2'dir; uyarı yazılır, düzeltilmiş eğim 0,633'e düşer. Karar yine de modelin yararlı olduğunu söyleyebilir; iyimserlik düzeltmesi yalnız ölçütleri düzeltir, karar eğrisini düzeltmez (karar eğrisi görünen tahminlerle çizilir). - Cox ve rakip olay. Rakip olay sansür sayılır; bu, riski olduğundan yüksek ya da düşük gösterebilir (kümülatif insidans ile 1 − KM farklıdır).
- Tahmin zamanı seçimi. Varsayılan t olay zamanlarının ortancasıdır (0,5242); klinik ufuk (t=1{,}5 gibi) elle girilmelidir (
kt_cox_t15). t en büyük süreyi aşarsa hata verir (kt_kd_tbuyuk). Süre \le0 hata verir (kt_kd_cox_neg,kt_kd_cox_sifir). - Cox çıktısında yakınsama uyarıları.
kt_coxvekt_cox_t15sonunda "Loglik converged before variable 3; coefficient may be infinite" ve "... variable 2" uyarıları yazılır; ana model katsayıları sonludur (SH hesaplanmıştır). İletiler yalnız B=200 bootstrap çalıştırmalarında görülür (B=50, çapraz doğrulama ve doğrusal modelde yok); kaynak,validatevecalibrateiçindeki bootstrap yeniden kestirimleri gibi görünür ve sonuç tablosu etkilenmez. .632ve çapraz doğrulama..632yöntemirmsuyarısı üretir ("does not properly handle missing summary indexes") ve tabloda "iyimserlik"eğitim − testdeğildir: Dxy için 0{,}728020-0{,}709668=0{,}018352 iken iyimserlik 0{,}008630'dır (kt_632); şablon bunu bir notla açıklar (342). Çapraz doğrulamada kalibrasyon eğimi 1,116 çıkabilir; eğim>1,1 yorumu artık "örneklem küçüklüğü, kat değişkenliği ya da az sayıda farklı tahmin değeri nedeniyle kararsız olabilir" der (kt_cv).- Kat sayısı. Kat sayısı en küçük sınıftan küçük ama test katlarında tek sınıf kalacak kadar büyükse çalıştırma "Çapraz doğrulama yapılamadı" ile durur (
kt_kd_kat_cok: 100 kat). - Sonuç öngörücü listesinde.
canceröngörücülerde seçilirse sessizce çıkarılır (kt_kd_yanit_ong). - Tek ikili öngörücüde spline.
famhistoryspline listesine alınırsa "çok az farklı değer" notuyla doğrusal girer (kt_kd_spline_ikili). - Eksik değerler sayısıyla bildirilerek çıkarılır (
kt_kd_eksik: 30 satır, n = 720). - Kalibrasyon eğrisi olasılık sınırlarını aşabilir.
loessen küçük tahminlerde -0{,}0012 gözlenen olasılık verir (kt_ornek, kalibrasyon tablosunun ilk satırı). - Tohum. Varsayılan form alanı
tohum = 1sonucu sabitler; 0 verilirse Kod panelindeki çalıştırma tohumu kullanılır ve künyedeki tohum sonucu belirler (150.2). Aynı veri ve tohumla sonuç yinelenir. - Tanım farkı. Üstbilgideki "ailede kanser öyküsü OR 1,80" yalnız
famhistoryiçeren modeldir; örnek ayarda yaş ve belirteç de modelde olduğundan OR 2,44'tür.
150.9 Uzman soruları
S1. Düzeltilmiş C neden görünen C'den küçüktür ve fark ne kadar olmalıdır?
Model kendi verisinde uydurulduğundan görünen C gürültüyü de öğrenir. Bootstrap, aynı kurulum işlemini yeniden uygulayıp özgün veriye uygulayarak bu şişkinliği ölçer. Örnekte 0{,}8617\to0{,}8571 (iyimserlik 0{,}0046); EPV 21 olduğundan küçüktür. EPV 2,2 olan n = 150 örneğinde eğim 0,633'e iner. Model seçim aşamaları (değişken eleme) varsa bu adımlar da bootstrap içinde yinelenmelidir; bu şablon değişken seçmez.
S2. Kalibrasyon eğimi 1'in altındaysa ne yapılır?
Eğim <1 tahminlerin aşırı uçta olduğunu, yani katsayıların büzülmesi gerektiğini gösterir. Düzeltilmiş eğim b ise büzülme çarpanı olarak katsayılar b ile çarpılabilir (kesişim yeniden uydurulur) ya da ceza ile ridge kestirimi kullanılır. Örnekte 0,964: büzülme ihmal edilebilir. Çapraz doğrulama ve .632 farklı eğimler verir (1,116; 0,970), çünkü her biri farklı bir kestirim ilkesine dayanır; hangisinin raporlanacağı önceden belirlenmelidir.
S3. Karar eğrisi neden iyimserlik düzeltmesi içermez?
Net yarar, modelin görünen olasılıklarıyla ve aynı verideki sonuçlarla hesaplanır; bootstrap düzeltmesi yalnız validate ve calibrate için uygulanır. Küçük örneklemde karar eğrisi de iyimserdir; dış doğrulama ya da bootstrap'li net yarar önerilir (Vickers ve Elkin, 2006). Bu şablonun karar eğrisi bunu yapmaz.
S4. Spline düğüm sayısı nasıl seçilir?
Düğüm sayısı serbestlik derecesini k-1 artırır; EPV'yi düşürür. Küçük örneklemde 3, orta örneklemde 4, büyük örneklemde ve belirgin eğrilikte 5 seçilir (Harrell, 2015). Örnekte 3, 4, 5 düğümle C 0{,}8606, 0{,}8617, 0{,}8660 ve LR 179{,}66, 181{,}65, 185{,}04'tür (kt_dugum3, kt_ornek, kt_dugum5); doğrusal olmama testi anlamlı olmadığından ek düğüm kazanç sağlamaz.
S5. Cox modelinde risk nasıl tanımlanır ve rakip olay neden önemli?
Şablon risk olarak 1-\hat S(t\mid x)'i alır; S rakip olayı sansür sayan Cox modelinden gelir. Rakip olay yaygınsa bu, kümülatif insidansı abartır (rakip olay yaşayan hastayı hâlâ risk altında sayar). Rakip olay için cok_durumlu_mstate ya da Fine–Gray tipi bir model gerekir; kalibrasyon ve karar eğrisi bu şablonda rakip olayı hesaba katmaz.
S6. Aynı veriyle başka bir paketten farklı sonuç çıkar mı?
Lojistik katsayılar glm ile 10^{-6} içinde aynıdır; C, R^2, bootstrap eğitim/test ve karar eğrisi rms ile bağımsız hesap arasında 10^{-6} içinde eşleşir. Cox katsayıları rms::cph'in yakınsama ölçütünden (10^{-9} göreli olabilirlik değişimi) dolayı kapalı çözümden 6\cdot10^{-6} ayrılır; Wald \chi^2 göreli 6\cdot10^{-7}. survival::coxph aynı sıkı yakınsamayla Python sonucunu verir.
S7. TRIPOD hangi raporlama öğelerini ister ve şablon hangisini karşılar?
TRIPOD model gelişimini ve doğrulamasını raporlamayı ister: örneklem büyüklüğü ve olay sayısı, öngörücü tanımları, eksik veri, model kurma ve iç doğrulama, ayırma ve kalibrasyon ölçütleri, klinik yarar (Collins vd., 2015). Şablon olay/sd, eksik veri sayısı, düğüm tablosu, iç doğrulama, kalibrasyon ve karar eğrisini verir; öngörücü seçimi, eksik veri atfı ve dış doğrulama yoktur.
S8. Nomogramdaki puanlar nasıl okunur?
Her öngörücünün değerine karşılık gelen puan en üst eksenden okunur ve toplanır; toplam puan "Total Points" eksenine, oradan doğrusal kestiriciye ve olasılık eksenine taşınır. Örnekte yaş 45'ten 80'e giderken 0'dan 100'e kadar puan verir, belirteç 0'dan 7'ye kadar yaklaşık 45 puan; ailede kanser öyküsü yaklaşık 6 puandır. Spline'lı yaş ekseni doğrusal değildir (yaş ekseni aralıkları eşit değildir).
150.10 Kaynaklar
- Collins, G. S., Reitsma, J. B., Altman, D. G. ve Moons, K. G. M. (2015). Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis (TRIPOD): The TRIPOD statement. Annals of Internal Medicine, 162(1), 55–63. https://doi.org/10.7326/M14-0697
- Durrleman, S. ve Simon, R. (1989). Flexible regression models with cubic splines. Statistics in Medicine, 8(5), 551–561. https://doi.org/10.1002/sim.4780080504
- Harrell, F. E. (2015). Regression modeling strategies: With applications to linear models, logistic and ordinal regression, and survival analysis (2. bs.). Springer. https://doi.org/10.1007/978-3-319-19425-7
- Harrell, F. E., Lee, K. L. ve Mark, D. B. (1996). Multivariable prognostic models: Issues in developing models, evaluating assumptions and adequacy, and measuring and reducing errors. Statistics in Medicine, 15(4), 361–387. https://doi.org/10.1002/(SICI)1097-0258(19960229)15:4<361::AID-SIM168>3.0.CO;2-4
- Nagelkerke, N. J. D. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691–692. https://doi.org/10.1093/biomet/78.3.691
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R. ve Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373–1379. https://doi.org/10.1016/S0895-4356(96)00236-3
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J. ve Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/EDE.0b013e3181c30fb2
- Vickers, A. J. ve Elkin, E. B. (2006). Decision curve analysis: A novel method for evaluating prediction models. Medical Decision Making, 26(6), 565–574. https://doi.org/10.1177/0272989X06295361
- Harrell, F. E. (2026). rms: Regression modeling strategies (R paketi, sürüm 8.1-1). https://doi.org/10.32614/CRAN.package.rms
- Sjoberg, D. D. (2025). dcurves: Decision curve analysis for model evaluation (R paketi, sürüm 0.5.1). https://doi.org/10.32614/CRAN.package.dcurves
- Therneau, T. M. (2026). survival: Survival analysis (R paketi, sürüm 3.8-6). https://doi.org/10.32614/CRAN.package.survival
- R Core Team (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing.