75. Genomik Seleksiyon: GBLUP, RR-BLUP ve BayesB
Şablon kimliği: genomik_seleksiyon · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/genomik_seleksiyon.R (satır 1–397; üstbilgi 1–130) · Örnek veri: _ornek/drops_gwas.csv · Paketler: rrBLUP 4.6.3, BGLR 1.1.4 (yalnız BayesB seçeneğinde)
75.1 Ne işe yarar
Şablon, "bu bireyin genetik değeri nedir ve onu yalnız markerlerinden ne kadar iyi kestirebilirim?" sorusunu cevaplar. İlişkilendirme çalışması tek tek anlamlı markerleri arar; genomik seleksiyon ise anlamlılık aramadan bütün markerleri birlikte kullanarak her bireye bir genomik kestirim değeri (GEBV, genomic estimated breeding value) verir. Üç model sunulur:
- \mathbf y: özellik değerleri; \mathbf X: kesişim ve varsa sabit etkiler; \mathbf e\sim N(\mathbf 0,\sigma^2_e\mathbf I).
- \mathbf g: bireylerin genetik değerleri; \mathbf G genomik akrabalık matrisi. GEBV, \mathbf g'nin en iyi doğrusal yansız kestirimidir (BLUP).
- \mathbf W: merkezlenmiş marker matrisi; \mathbf u: marker etkileri. RR-BLUP'ta bütün etkiler ortak varyanslı normaldir (u_j\sim N(0,\sigma^2_u)); BayesB'de etkilerin bir bölümü tam sıfır, kalanı kalın kuyruklu bir dağılımdandır. GEBV =\mathbf W\hat{\mathbf u}.
Çıktı dört parçadır: varyans bileşenleri ve genomik kalıtım derecesi; her birey için GEBV ve güvenilirlik; en büyük marker etkileri; çapraz doğrulamayla ölçülen kestirim yeteneği.
Ne zaman kullanılır? Fenotipi ölçülmüş bir eğitim popülasyonundan, yalnız genotipi bilinen adayların (genç bireyler, henüz denenmemiş hatlar) genetik değerini kestirmek için; seçilim öncesinde modelin ne kadar iyi kestireceğini çapraz doğrulamayla ölçmek için; markerlerin birlikte açıkladığı varyansı (genomik kalıtım derecesi) görmek için. Yanıtı boş bırakılan bireyler aday sayılır ve GEBV'leri akrabalık üzerinden verilir.
Ne zaman kullanılmaz?
- Amaç özellikle ilişkili bölgeleri bulmaksa:
gwas. Bu şablondaki marker etkileri büzülmüş kestirimlerdir, sınanmaz. - Soy kütüğünden akrabalık ve klasik ıslah değeri isteniyorsa:
akrabalik(soy kütüğü kipi) vekalitim_derecesi. - Tekrarlı ölçüm, çok ortam ya da deneme deseni varsa: önce
lokasyon_yil_tbd,alfa_kafesgibi bir şablonla hat ortalamaları elde edilir; bu şablon birey başına tek değer ister. - İkili ya da sıralı özellik: desteklenmez; yanıt sürekli ve normal artıklı sayılır.
- Baskınlık ya da epistasi içeren modeller, çok özellikli kestirim: yoktur.
- Seçilimin beklenen yanıtı:
seleksiyon_kazanci.
Temel programla ilişki. Temel programda karşılığı yoktur.
75.2 Şablonun girdileri
Form, üstbilgideki on altı [[param]] bloğundan kurulur (genomik_seleksiyon.R:10–129).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Özellik · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal | Yanıt; eksik olan bireyler aday olur (183–187). |
Birey / hat kimliği · birey |
kategorik sütun · Değişkenler | boş | tekil kimlikler | Tablodaki adlar; hazır matrisin eşleştirilmesi (189, 217–222). |
Marker sütunları · lokuslar |
sütunlar (sayısal) · Değişkenler | boş | 0/1/2 kodlu sütunlar | Boşsa 0/1/2 içeren sütunlar (kategorik türdekiler dahil); adı <kromozom>_<konum>_<ad> biçiminde olan sütun varsa yalnız onlar (151–176). |
Sabit etkiler / ortak değişkenler · ortak_degiskenler |
sütunlar · Değişkenler | boş | sayısal ya da kategorik | \mathbf X'e eklenir; kategorik olan gösterge sütunlarına açılır (236–241). |
Hazır akrabalık matrisi sütun öneki · akrabalik_onek |
metin · Değişkenler | boş | ör. K_ |
Bu önekle başlayan sütunlar \mathbf G olur; boşsa VanRaden \mathbf G hesaplanır (145, 216–230). |
Modeller · modeller |
seçim · Model | gblup_rr |
gblup_rr, gblup, hepsi |
Hangi modellerin kurulacağı (141). |
Çapraz doğrulama kat sayısı · kat |
tam sayı · Seçenekler | 5 | 2–20 | k (337). |
Çapraz doğrulama tekrar sayısı · tekrar |
tam sayı · Seçenekler | 2 | 0–50 | 0 ise çapraz doğrulama yapılmaz (336). |
BayesB yineleme sayısı · bayesb_iter |
tam sayı · Gelişmiş | 3000 | 500–100000 | nIter (263). Zincir tanısı ölçütü sağlanmıyorsa 12000 önerilir (alanın açıklaması; 63–72). |
BayesB ısınma sayısı · bayesb_isinma |
tam sayı · Gelişmiş | 1000 | 100–50000 | burnIn; BayesB seçiliyken yineleme sayısından küçük olmalı (144, 263). 12000 yineleme için 2000 önerilir (72–78). |
MAF eşiği · maf |
ondalık · Seçenekler | 0,01 | 0–0,49 | Küçük alel frekansı eşiğin altındaki markerler çıkarılır (199). |
En küçük marker çağrı oranı · cagri_orani |
ondalık · Seçenekler | 0,9 | 0–1 | Eksiksiz genotip payı eşiğin altındaki markerler çıkarılır (197). |
Varyans bileşeni kestirimi · vc_yontem |
seçim · Model | REML |
REML, ML |
GBLUP ve RR-BLUP'ta mixed.solve(method =) (246–252). |
BayesB önsel: etkili marker oranı · bayesb_pi |
ondalık · Gelişmiş | 0,5 | 0,001–0,999 | probIn (262). |
BayesB önsel: açıklanan varyans oranı · bayesb_R2 |
ondalık · Gelişmiş | 0,5 | 0,01–0,99 | R2; önsel ölçek parametreleri bundan türetilir (264). |
BayesB seyreltme aralığı · bayesb_seyrelt |
tam sayı · Gelişmiş | 5 | 1–1000 | thin (264). |
Örnek ayar (ornek_param, satır 9): y = verim, birey = birey, akrabalik_onek = K_. Marker listesi boş bırakılır; modeller GBLUP ve RR-BLUP, çapraz doğrulama 5 kat × 2 tekrardır.
Veri biçimi. Bölüm 76 ile aynıdır: satır başına bir birey, marker sütunlarında sayılan alelin kopya sayısı (0, 1, 2; boş = eksik), isteğe bağlı olarak aynı tabloda K_<kimlik> adlı akrabalık sütunları. Bu şablon marker adlarından harita okumaz; adların biçimi serbesttir.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 132 |
| rrBLUP kurulu değil | "Bu şablon rrBLUP paketini gerektirir." | 133 |
| Yanıt sayısal değil | "Yanıt '…' sayısal olmalı." | 140 |
| BayesB seçili, BGLR kurulu değil | "BayesB için BGLR paketi gerekli." | 141 |
| BayesB seçili ve ısınma \ge yineleme | "BayesB ısınma sayısı yineleme sayısından küçük olmalı." | 142 |
| Önek yazılmış, o önekle başlayan sütun yok | "'…' önekiyle başlayan akrabalık sütunu yok." | 144 |
| Hazır matris var, kimlik sütunu seçilmemiş | "Hazır akrabalık matrisi için birey kimliği sütunu seçilmeli" | 145 |
| Liste boş ve 0/1/2 kodlu sayısal sütun yok | "Marker sütunu bulunamadı …" | 168 |
| Marker sayısal değil ya da 0/1/2 dışında değer | "Marker '…' sayısal olmalı" / "yalnız 0/1/2 … içermeli" | 170, 170 |
| Yanıtı olan birey 20'den az | "En az 20 bireyde yanıt gerekli (şu an …)." | 183 |
| Yanıt sabit | "Yanıt sabit; genetik varyans kestirilemez." | 184 |
| Kimlik eksik ya da yinelenmiş | "Birey kimliği eksik olamaz." / "Birey kimlikleri tekil olmalı" | 188–189 |
| Süzgeçten sonra 10'dan az marker (hazır matrisle yalnız GBLUP dışında) | "Süzgeçlerden sonra 10'dan az marker kaldı" | 201–202 |
| Hazır matriste birey yok; sayısal değil; eksik; simetrik değil | ilgili dört ileti | 216, 218, 221, 222 |
| Matrisin köşegeninde sıfır ya da negatif değer | "Akrabalık matrisinin köşegeni pozitif olmalı." | 229 |
| Sabit etkiler doğrusal bağımlı | "Sabit etkiler doğrusal bağımlı (ya da tek düzeyli)." | 240 |
| Varyans kestirimi başarısız | "REML çözümü başarısız: …" | 247 |
| BGLR hata verdi | "BayesB çalıştırılamadı: …" | 263 |
| Kat sayısı >\lfloor n_f/2\rfloor | "Kat sayısı (…) fenotipli birey sayısının yarısını (…) aşamaz" | 336 |
Isınma denetimi (satır 144) yalnız BayesB seçiliyken yapılır. Notlar (durdurmaz): ortak değişkeni eksik bireyler çıkarılır (181); yanıtı eksik bireyler aday olarak tutulur (187); bütünüyle eksik ve tek biçimli markerler çıkarılır (200–201); eksik genotipler doldurulur (209); genomik varyans payı 0,01'in altındaysa uyarı yazılır (324). Adı harita biçimine uymayan 0/1/2 sütunlar marker sayılmaz ve adları yazılır (321); harita biçimli ad yoksa marker sayılan sütunların ilk adları yazılır (322). BayesB seçiliyse artık varyans zincirinin tanısı tabloya ve nota yazılır (304–314). Çapraz doğrulamada eğitim kümesinde bir sabit etki düzeyi bulunmayan kat atlanır ve atlanan kat sayısı uyarıyla bildirilir (348–355, 365).
75.3 Örnek veri
Dosya: _ornek/drops_gwas.csv (Bölüm 76.3 ile aynı dosya). DROPS mısır panelinden 246 kendilenmiş hat, tane verimi (verim), çiçeklenme zamanı (ciceklenme), 2299 SNP ve panelin tam marker kümesinden (36 624 SNP) Astle–Balding yöntemiyle hesaplanmış akrabalık matrisi (K_ sütunları). Eksik değer yoktur; bütün hatların verimi ölçülmüştür, yani örnekte aday birey yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
birey |
Birey kimliği | metin | 246 tekil hat adı. |
verim |
Yanıt | sayısal | Ortalama 7,409; standart sapma 1,589. |
ciceklenme |
İsteğe bağlı ortak değişken | sayısal | Ortalama 63,3; standart sapma 3,13. |
1_3498_SYN83 … |
SNP'ler | sayısal ya da ikili | 2299 sütun; değerler 0/1/2; 2\sum_jp_j(1-p_j)=864{,}09. |
K_11430 … |
Hazır akrabalık matrisi | sayısal | 246 sütun; köşegen ortalaması 1,972; genel ortalama 0. |
Hatlar kendilenmiş olduğundan akrabalık matrisinin köşegeni 2'ye yakındır (bireyin kendisiyle akrabalığı 1+F, F\approx1). Bu, 75.4.5'teki ölçekli kalıtım derecesinin neden gerektiğini gösteren bir örnektir.
Düzey sırası yalnız kategorik bir sabit etki seçildiğinde rol oynar: gösterge sütunları ilk düzeye göre kurulur; GEBV'ler ve varyans bileşenleri bundan etkilenmez. Satır sırası varyans bileşenlerini ve GEBV'leri değiştirmez; çapraz doğrulama katları ise satır sırasına göre atandığından aynı tohumla bile satırları karıştırılmış veride farklı katlar oluşur.
Bu bölümde kullanılan çalıştırmalar (tohum 20261117): (1) örnek ayar; (2) önek boş (VanRaden \mathbf G); (3) vc_yontem = ML; (4) ortak değişken ciceklenme; (5) kat = 10, tekrar = 3; (6) tohum 7; (7) 40 hattın verimi gizlenmiş türetilmiş veri (aday popülasyon); (8) modeller = hepsi, BayesB 1500 ve 12 000 yinelemeyle, iki tohumla; (9) türetilmiş veriler: eksik genotipler, karıştırılmış satırlar, sayısal kimlikler, marker olmayan 0/1 sütun, yalnız akrabalık sütunları.
75.4 Yöntem: formüller ve hesap adımları
75.4.1 Markerlerin hazırlanması ve VanRaden matrisi
Süzgeç ve doldurma Bölüm 76.4.1'deki gibidir; tek fark frekansların bütün bireylerden (adaylar dahil) hesaplanmasıdır (satır 194–210). Sonra markerler merkezlenir ve genomik akrabalık matrisi kurulur (211–213, 228):
- x_{ij}: i. bireyin j. markerdeki alel sayısı (doldurulmuş); p_j=\bar x_j/2.
- Payda, Hardy–Weinberg dengesindeki bir popülasyonda markerlerin toplam varyansıdır; bu ölçekle \mathbf G'nin köşegeni akrabalı olmayan bireylerde ortalama 1 olur.
- G_{ik}: iki bireyin, frekansların hesaplandığı popülasyona göre genomik akrabalığı; negatif olabilir (ortalamadan az paylaşım).
Neden merkezleme ve neden bu payda?
Merkezleme, genetik değerleri popülasyon ortalamasından sapma olarak tanımlar; kesişim ortalamayı taşır. Payda, marker etkilerinin varyansı ile genetik varyans arasındaki bağı kurar: \text{var}(\mathbf W\mathbf u)=\sigma^2_u\mathbf W\mathbf W^\top=\sigma^2_u\,2\sum pq\cdot\mathbf G, yani \sigma^2_g=\sigma^2_u\cdot2\sum pq (VanRaden, 2008; Habier ve ark., 2007). Bu eşitlik GBLUP ile RR-BLUP'un aynı model olduğunu gösterir.
Koddaki tercih
Önek verilmişse \mathbf G veriden okunur ve (\mathbf G+\mathbf G^\top)/2 ile simetrikleştirilir (satır 216–226); bu durumda GBLUP hazır matrisi, RR-BLUP ve BayesB ise tablodaki markerleri kullanır ve iki model aynı bilgiye dayanmaz. Örnek ayarda GBLUP 36 624 SNP'den gelen matrisi, RR-BLUP 2299 SNP'yi kullanır; GEBV'leri arasındaki en büyük fark 0,141'dir. Önek boşken iki model eşdeğerdir ve şablon aradaki en büyük farkı konsola yazar (331). Hazır matrisle yalnız GBLUP seçildiğinde markerler hesaba girmez, ama tabloda en az bir marker sütunu yine bulunmalıdır (170).
75.4.2 Varyans bileşenleri: REML ve ML
GBLUP'ta fenotipli n_f birey için \text{var}(\mathbf y)=\sigma^2_g(\mathbf H_0+\lambda\mathbf I), \mathbf H_0=\mathbf Z\mathbf G\mathbf Z^\top, \lambda=\sigma^2_e/\sigma^2_g. Olabilirlik, Bölüm 76.4.3'teki gibi tek bir özdeğer ayrışımıyla \lambda'nın fonksiyonu olarak yazılır ve en küçüklenen amaç fonksiyonu şudur:
- \mathbf Z: fenotipli bireyleri bütün bireylere bağlayan 0/1 matrisi; q: \mathbf X'in sütun sayısı.
- \theta_s, \mathbf q_s: \mathbf S\mathbf H_0\mathbf S'nin ilk n_f-q özdeğeri ve özvektörü, \mathbf S=\mathbf I-\mathbf X(\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top; \omega_s=\mathbf q_s^\top\mathbf y.
- \phi_s: \mathbf H_0'ın özdeğerleri (yalnız ML'de gerekir).
- RR-BLUP'ta aynı formüller \mathbf H_0=\mathbf W_f\mathbf W_f^\top ile uygulanır ve \hat\sigma^2_g yerine \hat\sigma^2_u bulunur (\mathbf W_f: fenotipli bireylerin satırları).
Neden REML varsayılan?
ML sabit etkilerin kestirilmesinde harcanan serbestlik derecesini saymaz ve artık varyansı küçümser. Örnekte REML \hat\sigma^2_e=0{,}2084, ML 0{,}1648 verir; genomik kalıtım derecesi 0,822'den 0,858'e çıkar. Sabit etki sayısı arttıkça fark büyür. ML, sabit etkileri farklı iki modelin olabilirlik oranıyla karşılaştırılması gerektiğinde seçilir.
Koddaki tercih
rrBLUP::mixed.solve(y, X, Z, K, method, SE) (satır 248–258). Fonksiyon \lambda'yı [10^{-9},\,10^{9}] aralığında R'nin optimize() yordamıyla (Brent) arar; yordamın duruş toleransı \lambda ölçeğinde yaklaşık 1{,}2\cdot10^{-4}'tür. Örnekte bulunan \hat\lambda=0{,}217274, olabilirliğin tam en büyüğü 0{,}217264'tür; varyans bileşenleri beşinci ondalıkta ayrışır (0{,}959229 ve 0{,}959236). Yakınsama durumu ayrıca bildirilmez; yordam her zaman aralık içinde bir değer döndürür. \hat\lambda aralığın ucuna giderse (\hat\sigma^2_g\to0) şablon "genomik varyans sıfıra yakın" uyarısını yazar (324). Çözüm sırasında paketin verdiği uyarılar bastırılır (suppressWarnings).
75.4.3 GBLUP: kestirim değerleri ve güvenilirlik
- \hat{\mathbf g}: bütün bireyler için GEBV; aday bireyin satırı \mathbf G\mathbf Z^\top çarpımında yer alır, yani değeri fenotipli akrabalarının artıklarından gelir.
- \mathbf c_i: \mathbf G\mathbf Z^\top'nin i. satırı (bireyin fenotipli bireylerle akrabalıkları).
- \text{PEV}_i=\text{var}(\hat g_i-g_i): kestirim hata varyansı; son terim \boldsymbol\beta'nın kestirilmesinden gelen belirsizliktir.
- r^2_i: güvenilirlik; kestirilen ile gerçek genetik değer arasındaki korelasyonun karesi. \hat\sigma^2_gG_{ii} bireyin genetik değerinin önsel varyansıdır.
Neden büzülme ve neden aday bireylerde güvenilirlik düşük?
BLUP, artığı \mathbf G\mathbf Z^\top\mathbf H^{-1} ile çarpar; \lambda büyüdükçe (kalıtım derecesi düştükçe) kestirimler sıfıra çekilir. Bu, fenotipteki rastlantısal hatanın genetik değere yazılmasını önler. Fenotipli bireyin GEBV'si hem kendi kaydından hem akrabalarından beslenir; adayınki yalnız akrabalarından. Örnekten türetilen veride 40 aday hattın ortalama güvenilirliği 0,41 (0,13–0,83), fenotipli 206 hattınki 0,86'dır.
Koddaki tercih
Standart hatalar yalnız bütün veriyle yapılan uyumda istenir (SE = TRUE, satır 289); çapraz doğrulama katlarında hesaplanmaz. Güvenilirlik negatif çıkarsa 0'a kırpılır (292). GEBV tablosu GBLUP değerine göre büyükten küçüğe sıralanır (325); RR-BLUP ve BayesB sütunları aynı sırayı izler. Güvenilirlik yalnız GBLUP için verilir.
75.4.4 RR-BLUP: marker etkileri
- \hat\lambda_u=\hat\sigma^2_e/\hat\sigma^2_u: sırt (ridge) cezası; m\gg n olduğundan cezasız çözüm yoktur.
- \hat u_j: sayılan alelin bir kopyasının etkisi; bütün markerler aynı oranda büzülür.
- Aynı çözüm Henderson'un karma model denklemleriyle de bulunur: \begin{bmatrix}\mathbf X^\top\mathbf X&\mathbf X^\top\mathbf W_f\\ \mathbf W_f^\top\mathbf X&\mathbf W_f^\top\mathbf W_f+\hat\lambda_u\mathbf I\end{bmatrix}\begin{bmatrix}\hat{\boldsymbol\beta}\\ \hat{\mathbf u}\end{bmatrix}=\begin{bmatrix}\mathbf X^\top\mathbf y\\ \mathbf W_f^\top\mathbf y\end{bmatrix}.
Neden marker etkileri bu kadar küçük?
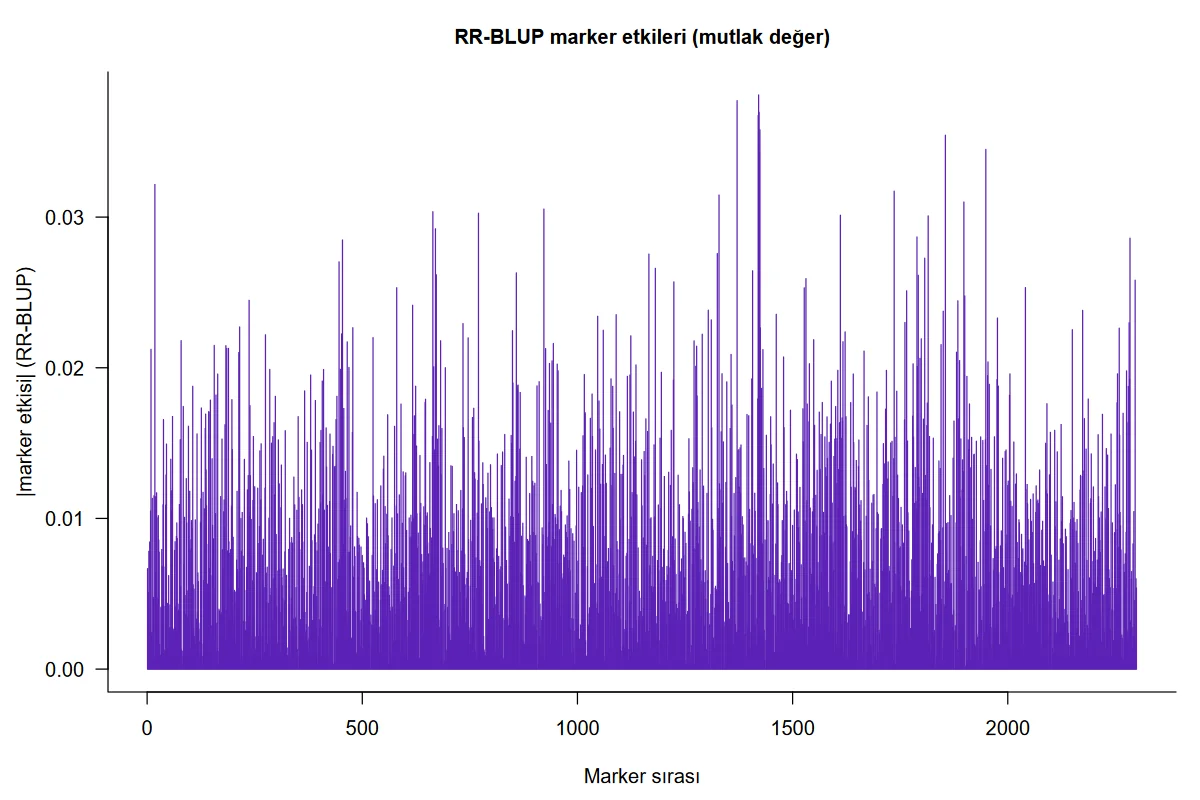
Genetik varyans 2299 markere paylaştırılır: \hat\sigma^2_u=0{,}9669/864{,}09=0{,}00112, yani bir markerin etkisinin önsel standart sapması 0,033'tür. İlişkilendirme çalışmasında kopya başına 0,53 etki gösteren marker burada 0,038 alır; bölgedeki öteki markerler aynı sinyali paylaşır. RR-BLUP etkileri tek tek yorumlanmaz; toplamları (GEBV) anlamlıdır. Tabloya mutlak etkisi en büyük 20 marker yazılır (satır 327–330).
RR-BLUP satırındaki h^2, \hat\sigma^2_u\cdot2\sum pq üzerinden hesaplanır (296); ölçekli kalıtım derecesi bu satırda verilmez.
75.4.5 Genomik kalıtım derecesi ve ölçek
- \overline{\text{diag}(\mathbf G)}: köşegen ortalaması; \overline{\mathbf G}: bütün öğelerin ortalaması.
- \hat\sigma^2_g\bar k: örneklemdeki bireylerin genetik değerlerinin beklenen örneklem varyansı (Legarra, 2016).
Neden iki kalıtım derecesi?
\sigma^2_g, \mathbf G'nin ölçeğine göre tanımlıdır: matris 2 ile çarpılırsa \hat\sigma^2_g yarıya iner, GEBV'ler değişmez. Dolayısıyla h^2 ancak \mathbf G'nin köşegeni ortalama 1 ise alışılmış anlamı taşır. Kendilenmiş hatlarda köşegen 2'ye yakındır; bu durumda \hat\sigma^2_g "akrabalı olmayan bir temel popülasyondaki" varyanstır, gözlenen hatlar arasındaki genetik varyans ise bunun yaklaşık iki katıdır. \bar k ile çarpmak varyansı örneklemdeki bireylerin ölçeğine getirir. Örnekte \bar k=1{,}972, h^2=0{,}822, h^2_{\text{ölçekli}}=0{,}901'dir; hat ortalamaları üzerinden tanımlı kalıtım derecesiyle karşılaştırılabilir olan ikincisidir.
75.4.6 BayesB
BayesB (Meuwissen ve ark., 2001), her marker etkisine "büyük olasılıkla sıfır, değilse kalın kuyruklu" bir önsel verir:
- \pi: etkisi sıfırdan farklı markerlerin oranı;
bayesb_pibunun önsel beklenen değeridir (BGLR'deprobIn), oranın kendisi de veriden öğrenilir. - \nu, S: serbestlik derecesi (BGLR varsayılanı 5) ve ölçek; ölçek, markerlerin yanıt varyansının
bayesb_R2kadarını açıklayacağı varsayımından türetilir. - Sonsal dağılım Gibbs örneklemesiyle (MCMC) yaklaşık bulunur; tabloya etkilerin sonsal ortalaması yazılır.
Neden ayrı bir model?
RR-BLUP bütün markerleri aynı oranda büzer; bu, özellik çok sayıda küçük etkili genle belirleniyorsa doğrudur. Birkaç büyük etkili gen varsa onların etkisi de küçültülür. BayesB büyük etkilere yer açar: örnekte 6. kromozomdaki en güçlü marker RR-BLUP'ta 0,038, BayesB'de (12 000 yineleme) 0,092 alır. Karşılığı, sonucun örneklemeye ve önsellere bağlı olmasıdır.
BayesB sonucu tohuma ve yineleme sayısına bağlıdır
Kod panelindeki Tohum alanı boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar; kullanılan tohumu künyeye ve betik adımına yazar (Bölüm 1.3). Aynı tohum girildiğinde ya da betik yeniden oynatıldığında sonuç birebir yinelenir. Tohum alanı boşken yeniden çalıştırmak ise yeni bir tohum demektir. Örnekte 1500 yineleme (500 ısınma) ile iki tohum arasında GEBV'lerin en büyük farkı 0,60'tır (GEBV standart sapması 1,31); en yüksek 25 hattın 22'si ortaktır. 12 000 yineleme (2000 ısınma) ile en büyük fark 0,19'a iner ve 24 hat ortaktır. Şablon artık varyans zincirinden (ısınma sonrası kayıtlar) coda tanımlarıyla Geweke z (ilk %10 ile son %50 ortalamalarının farkı) ve etkin örneklem büyüklüğünü hesaplayıp tabloya yazar; |z|>1{,}96 ya da etkin örneklem 100'ün altındaysa zincirin yakınsamamış olabileceğini uyarır. Örnekte 1500 yineleme (500 ısınma, seyreltme 5: 200 kayıt) ile z=-2{,}48 ve etkin örneklem büyüklüğü 52'dir; uyarı yazılır. Varsayılan 3000 yineleme (1000 ısınma) ile tohum 20261117'de z=-0{,}95, etkin örneklem 123'tür (ölçüt sağlanır); tohum 7'de z=-3{,}92, etkin örneklem 70'tir (uyarı yazılır); 12 000 yineleme (2000 ısınma) ile iki tohumda da ölçüt sağlanır (z=0{,}36 ve -0{,}35; etkin örneklem 738 ve 539). Tek zincirle bu bir denetimdir, yakınsamanın kanıtı değildir; sıralamaya dayalı karar verilecekse yineleme sayısı artırılır ve iki ayrı çalıştırmanın sıralamaları karşılaştırılır.
Koddaki tercih
BGLR::BGLR(y, ETA = list(sabit etkiler, list(X = W, model = "BayesB", probIn)), nIter, burnIn, thin, R2) (satır 262–264). Yanıtı eksik ve eğitim dışı bireylerin y'si eksik bırakılır; BGLR bunları örnekleyerek doldurur. Paketin iz dosyaları oturumun geçici klasörüne, rastgele adlı bir önekle yazılır (261); bu ad için de bir rastgele sayı çekilir. Artık varyansın zinciri (varE.dat, ısınma dahil her kayıt) okunur, ısınma sonrası kayıtlar zincir_tani işlevine verilir (267–284): etkin örneklem büyüklüğü N\,\text{var}(x)/S_0 ve Geweke z, S_0 otoregresif spektrumla (stats::ar, AIC ile derece) kestirilir; sonuç coda::effectiveSize ve coda::geweke.diag ile aynıdır. Varyans tablosunun BayesB satırında yalnız artık varyansın sonsal ortalaması bulunur; genetik varyans ve kalıtım derecesi boş bırakılır (302).
75.4.7 Çapraz doğrulama
Bütün veriyle hesaplanan GEBV ile gözlenen değer arasındaki korelasyon modelin uyumunu gösterir, kestirim gücünü değil. Kestirim gücü, modelin görmediği bireylerde ölçülür:
- Fenotipli n_f birey rastgele k kata ayrılır: 1{,}2,\dots,k etiketleri n_f uzunluğa yinelenip karıştırılır (satır 342); kat büyüklükleri en çok 1 farklıdır.
- Her kat için o kattaki bireylerin yanıtı gizlenir, model kalanlarla baştan kurulur (varyans bileşenleri dahil) ve gizlenen bireylerin GEBV'si hesaplanır.
- İki korelasyon tutulur:
- r_{t,f}: t. tekrarın f. katındaki korelasyon (kat tablosu); test bireyi 3'ten azsa ya da GEBV'ler sabitse boş kalır.
- r_t: t. tekrarda bütün katların kestirimleri birleştirilip n_f birey üzerinden hesaplanan tek korelasyon.
- Özet tablosu ikisinin de ortalamasını ve standart sapmasını verir:
r_ortalama_kat,r_ss_kat(k\times tekrar değer);r_ortalama_tekrar,r_ss_tekrar(tekrar sayısı kadar değer). - h^2: bütün veriyle kurulan GBLUP modelinin (ölçeksiz) kalıtım derecesi; bütün modellerin satırında aynı değer kullanılır.
Neden \sqrt{h^2}'ye bölünüyor?
r(y,\hat g) kestirim yeteneğidir: fenotiple korelasyon. Fenotip genetik değerin gürültülü bir ölçümüdür ve \text{kor}(y,g)=\sqrt{h^2}'dir; bu yüzden kusursuz bir kestirici bile \sqrt{h^2}'yi aşamaz. Bölme, gerçek genetik değerle korelasyonun (kestirim doğruluğu) yaklaşık bir kestirimini verir (Legarra ve ark., 2008). Sonuç kullanılan h^2'ye duyarlıdır ve 1'i aşabilir.
Tohum. Kat ataması rastgeledir. Şablon formunda tohum alanı yoktur; tohum Kod panelindeki Tohum alanından verilir (Bölüm 1.3). Alan boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar; kullanılan tohum künyeye ve betik adımına yazılır, betik yeniden oynatıldığında aynı tohum kullanılır (Bölüm 57). Örnekte tohum 20261117 ile GBLUP'un tekrar ortalaması 0,618, tohum 7 ile 0,625'tir; fark, r_ss_tekrar ile aynı büyüklüktedir. Tekrar sayısını artırmak bu oynaklığı azaltır.
75.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–130 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on beş parametre. | Form buradan kurulur (Bölüm 1.2). |
| 131–148 | Paket ve parametre denetimleri; yanıt, kimlik, sabit etki ve akrabalık sütunlarının belirlenmesi. | Bu sütunlar marker adayları arasından çıkarılır (148). |
| 150–176 | Marker sütunları ve 0/1/2 denetimi. | Bölüm 76 ile aynı kural. |
| 178–191 | Bireyler: ortak değişkeni eksik olan çıkar; yanıtı eksik olan aday olur; kimlik denetimleri. | En az 20 fenotipli birey (185). |
| 193–213 | Süzgeçler, doldurma, merkezleme, 2\sum pq. | Frekanslar adaylar dahil bütün bireylerden. |
| 215–232 | \mathbf G: hazır ya da VanRaden; \bar k. | Hazır matriste yalnız seçilen bireylerin satır ve sütunları alınır. |
| 234–243 | Sabit etkiler matrisi ve sıra denetimi. | Kategorik etken model.matrix ile açılır; tek düzeyli etken sessizce atlanır (239). |
| 245–285 | Üç model kurucu: gblup, rrblup, bayesb. |
Her biri eğitim bireylerinin dizinini alır; bütün veri ve katlar aynı kodu kullanır. |
| 287–332 | Bütün veriyle uyum; varyans tablosu, GEBV tablosu, marker etkileri, GBLUP ↔ RR-BLUP farkı. | Uyarı: h^2<0{,}01 (324). |
| 334–375 | Çapraz doğrulama; özet ve kat tabloları. | Kat sayısı denetimi (338). |
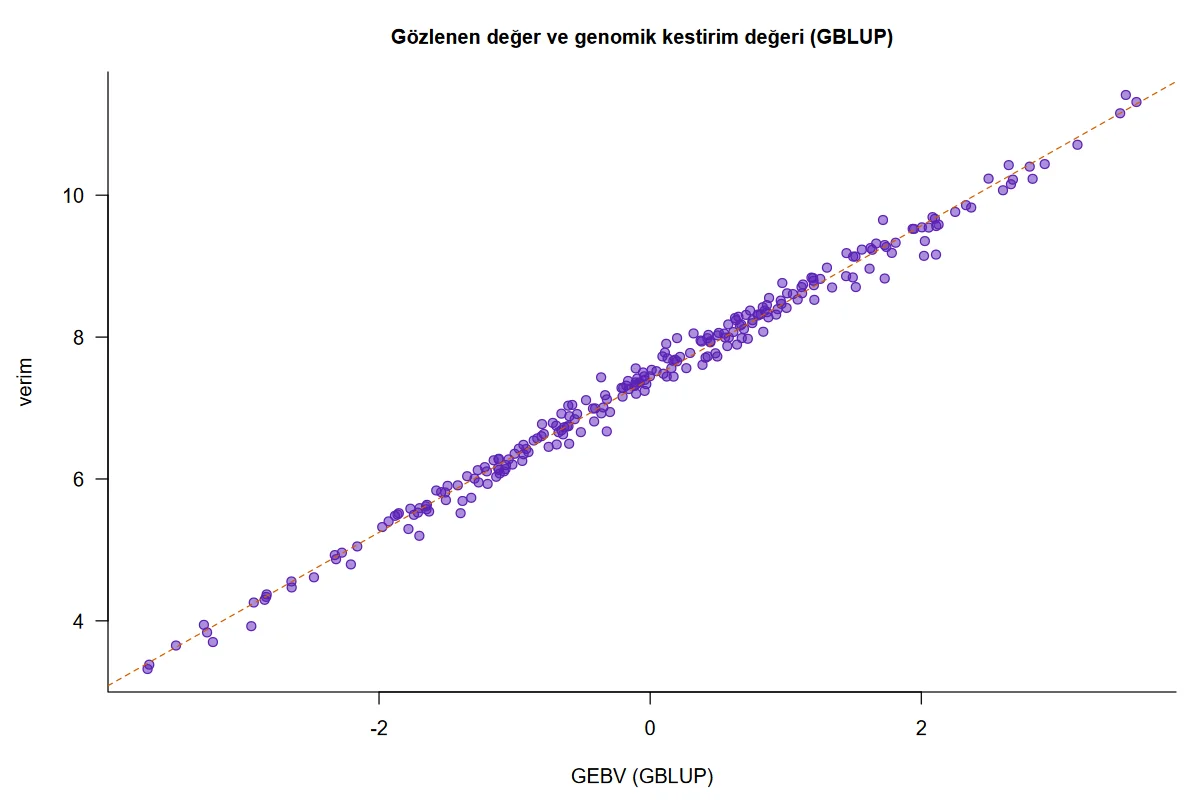
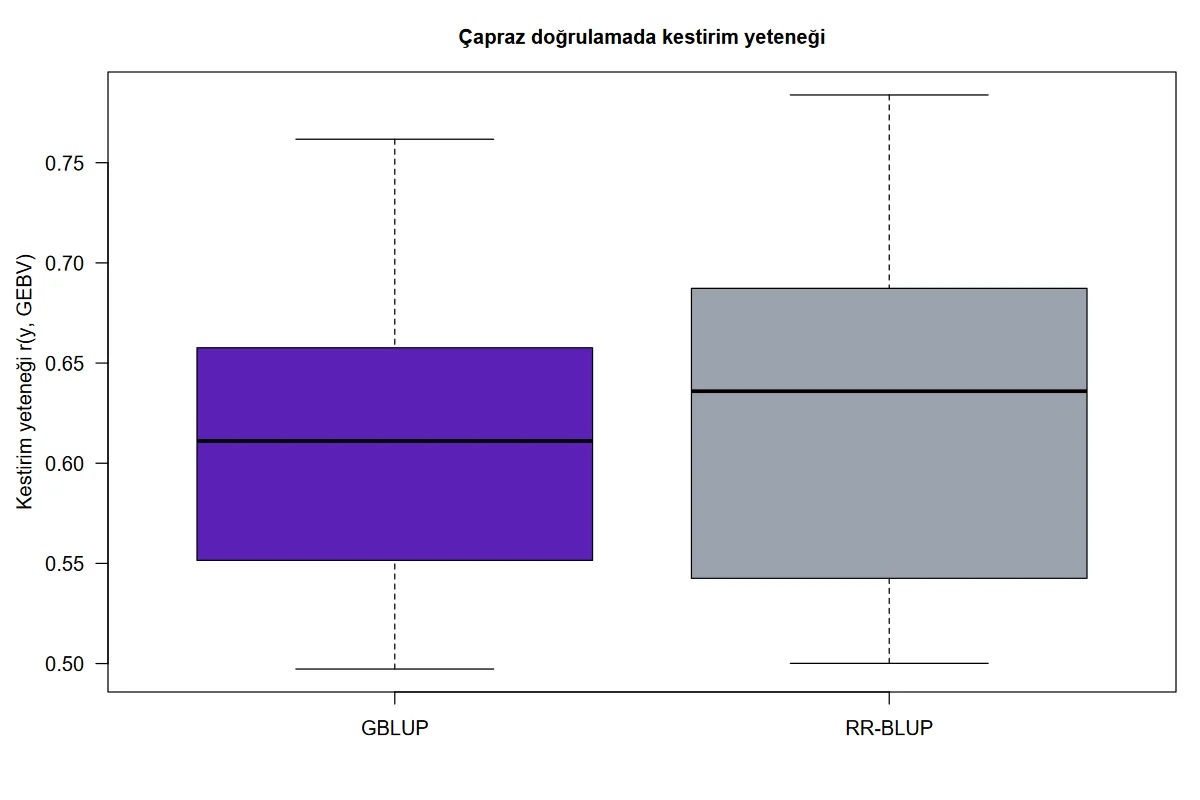
| 377–396 | Üç şekil: gözlenen–GEBV saçılımı, kat başına r kutu grafiği, RR-BLUP etkileri. | İkincisi yalnız çapraz doğrulama, üçüncüsü yalnız RR-BLUP varsa. |
p_al <- colMeans(M) / 2
W <- sweep(M, 2, 2 * p_al)
c2pq <- 2 * sum(p_al * (1 - p_al))
G <- tcrossprod(W) / c2pq; dimnames(G) <- list(ids, ids)
75.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bütün adımlar dogrulama/genomik_seleksiyon/elle_hesap.py ile, rrBLUP kullanılmadan yeniden kurulmuştur: süzgeç, VanRaden matrisi, spektral olabilirlik, R'nin optimize() yordamının Python'a aktarımı, BLUP ve kestirim hata varyansı, RR-BLUP ve çapraz doğrulama (katlar, R'nin rastgele sayı üreteci yeniden kurularak aynı sırayla). R tarafında (r_dogrulama.R) olabilirlik taban R ile yazılmış, GBLUP solve() ile, RR-BLUP 2300 bilinmeyenli karma model denklemlerinin doğrudan çözümüyle bulunmuştur.
Adım 1 — Markerler. 2299 markerin hepsi süzgeçten geçer; 2\sum p(1-p)=864{,}089. Örnek ayarda \mathbf G hazır matristir: köşegen ortalaması 1,972076, genel ortalama 0, \bar k=1{,}972076.
Adım 2 — REML. n_f=246, q=1. Amaç fonksiyonu \hat\lambda=0{,}217274'te en küçük değerini alır (f=1454{,}5289).
Adım 3 — Kalıtım derecesi.
Adım 4 — Bir bireyin GEBV'si. \hat\mu=7{,}408801. B73 hattı için y=9{,}6506, yani ortalamadan +2{,}242 sapma. GEBV 1{,}7175'tir: sapmanın bir bölümü hata sayılıp büzülmüş, bir bölümü akrabalarının bilgisiyle düzeltilmiştir. G_{ii}=2{,}0158, \text{PEV}=0{,}09102:
246 hattın güvenilirliği 0,891 ile 0,953 arasındadır (ortalama 0,908): hepsinin kendi kaydı vardır ve kalıtım derecesi yüksektir. En yüksek GEBV Lo1223 hattındadır (3{,}587; y=11{,}314).
Adım 5 — RR-BLUP. \hat\sigma^2_u=0{,}001119, \hat\sigma^2_e=0{,}235738; \hat\sigma^2_g=0{,}001119\cdot864{,}089=0{,}966926. En büyük etki PZE-106021410 markerindedir (0,038106). Lo1223 için \mathbf w^\top\hat{\mathbf u}=3{,}5538.
Adım 6 — Eşdeğerlik. Önek boş bırakılıp \mathbf G aynı 2299 markerden hesaplandığında GBLUP \hat\sigma^2_g=0{,}966916, \hat\sigma^2_e=0{,}235748 verir; RR-BLUP'un 0{,}966926 ve 0{,}235738 değerleriyle beşinci ondalıkta ayrışır. 246 GEBV'nin en büyük farkı 2{,}6\cdot10^{-5}'tir. Fark kuramsal değil sayısaldır: iki model \lambda'yı farklı ölçeklerde (0,244 ve 210,7) arar ve aynı mutlak toleransla durur.
Adım 7 — Çapraz doğrulama. Tohum 20261117 ile ilk tekrarda ilk on iki bireyin kat etiketleri 1, 2, 3, 4, 2, 3, 3, 3, 5, 1, 2, 5'tir; kat büyüklükleri 50, 49, 49, 49, 49. GBLUP için on katın korelasyonları 0,636; 0,727; 0,658; 0,584; 0,552; 0,587; 0,655; 0,541; 0,497; 0,762: ortalama 0,6198, standart sapma 0,0836. Birleşik korelasyonlar 0,6330 ve 0,6032: ortalama 0,6181, standart sapma 0,0211.
Bütün veriyle hesaplanan GEBV'lerin verimle korelasyonu ise 0,9958'dir. İki sayı arasındaki uçurum, uyum ile kestirim arasındaki farktır.
Adım 8 — Aday bireyler. Rastgele seçilen 40 hattın verimi gizlenip VanRaden \mathbf G ile çalıştırıldığında adayların GEBV'leri ile gizlenen gerçek verimleri arasındaki korelasyon 0,802'dir; aynı verinin 206 fenotipli hattıyla yapılan çapraz doğrulama 0,566 verir. Tek bir bölünme büyük oynaklık taşır; çapraz doğrulamanın tekrarlanmasının nedeni budur.
75.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle okunmuştur. "ÇD", çapraz doğrulamadır; bütün çalıştırmalar aynı tohumla (20261117; belirtilen yerde 7) yapılmıştır. "En büyük farklı" satırları ilgili tablonun bütün satırları üzerinden en kötü durumu gösterir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Örnek ayar: \hat\sigma^2_g (GBLUP) | 0,95922856 | 0,95922856 | 0,95922856 | 4,7e−12 | ✓ |
| Örnek ayar: \hat\sigma^2_e (GBLUP) | 0,20841533 | 0,20841533 | 0,20841533 | 5,0e−12 | ✓ |
| Örnek ayar: h^2 | 0,82150779 | 0,82150779 | 0,82150779 | 4,2e−12 | ✓ |
| Örnek ayar: ölçekli h^2 | 0,90075871 | 0,90075871 | 0,90075871 | 2,6e−12 | ✓ |
| Örnek ayar: \hat\sigma^2_u (marker, RR-BLUP) | 0,00111901 | 0,00111901 | 0,00111901 | 9,1e−13 | ✓ |
| Örnek ayar: \hat\sigma^2_g=\hat\sigma^2_u\cdot2\sum pq (RR-BLUP) | 0,96692601 | 0,96692601 | 0,96692601 | 7,9e−10 | ✓ |
| Örnek ayar: \hat\sigma^2_e (RR-BLUP) | 0,23573764 | 0,23573764 | 0,23573764 | 7,9e−10 | ✓ |
| Lo1223: GEBV (GBLUP) | 3,58686046 | 3,58686046 | 3,58686046 | 2,1e−12 | ✓ |
| Lo1223: güvenilirlik | 0,90053845 | 0,90053845 | — | 2,3e−12 | ✓ |
| Lo1223: GEBV (RR-BLUP) | 3,55376892 | 3,55376892 | 3,55376892 | 3,3e−10 | ✓ |
| B73: GEBV (GBLUP) | 1,71752271 | 1,71752271 | 1,71752271 | 2,9e−12 | ✓ |
| B73: güvenilirlik | 0,95292799 | 0,95292799 | — | 7,2e−13 | ✓ |
| B73: GEBV (RR-BLUP) | 1,70682539 | 1,70682539 | 1,70682539 | 3,4e−10 | ✓ |
| 246 bireyde en büyük farklı birey: GEBV (GBLUP) | 0,97458432 | 0,97458432 | — | 8,8e−12 | ✓ |
| 246 bireyde en büyük farklı birey: güvenilirlik | 0,89084832 | 0,89084832 | — | 2,7e−12 | ✓ |
| 246 bireyde en büyük farklı birey: GEBV (RR-BLUP) | −1,25827758 | −1,25827758 | — | 1,2e−9 | ✓ |
| 20 marker etkisinde en büyük farklı (RR-BLUP) | −0,03543496 | −0,03543496 | — | 3,2e−11 | ✓ |
| En büyük mutlak marker etkisi | 0,03810563 | 0,03810563 | 0,03810563 | 1,9e−11 | ✓ |
| ÇD 5 × 2, GBLUP: kat ortalaması r | 0,61976459 | 0,61976459 | 0,61976459 | 3,4e−13 | ✓ |
| ÇD 5 × 2, GBLUP: kat SS | 0,08360371 | 0,08360371 | 0,08360371 | 1,3e−13 | ✓ |
| ÇD 5 × 2, GBLUP: tekrar ortalaması r | 0,61813256 | 0,61813256 | 0,61813256 | 6,3e−13 | ✓ |
| ÇD 5 × 2, GBLUP: tekrar SS | 0,02109497 | 0,02109497 | 0,02109497 | 5,9e−13 | ✓ |
| ÇD 5 × 2, RR-BLUP: kat ortalaması r | 0,63109859 | 0,63109858 | 0,63109858 | 2,9e−10 | ✓ |
| ÇD 5 × 2, RR-BLUP: kat SS | 0,09083557 | 0,09083557 | 0,09083557 | 3,0e−10 | ✓ |
| ÇD 5 × 2, RR-BLUP: tekrar ortalaması r | 0,62716042 | 0,62716042 | 0,62716042 | 4,4e−10 | ✓ |
| ÇD 5 × 2, RR-BLUP: tekrar SS | 0,02223479 | 0,02223479 | 0,02223479 | 6,1e−10 | ✓ |
| ÇD 5 × 2, GBLUP: doğruluk r/\sqrt{h^2} | 0,68198649 | 0,68198649 | — | 1,1e−12 | ✓ |
| ÇD 5 × 2, GBLUP: 10 katta en büyük farklı kat | 0,65765256 | 0,65765256 | 0,65765256 | 1,2e−12 | ✓ |
| ÇD 5 × 2, RR-BLUP: 10 katta en büyük farklı kat | 0,6190902 | 0,6190902 | 0,6190902 | 2,0e−9 | ✓ |
| VanRaden G: \hat\sigma^2_g (GBLUP) | 0,96691559 | 0,96691559 | 0,96691559 | 1,3e−12 | ✓ |
| VanRaden G: \hat\sigma^2_e (GBLUP) | 0,23574806 | 0,23574806 | 0,23574806 | 1,3e−12 | ✓ |
| VanRaden G: h^2 | 0,8039784 | 0,8039784 | 0,8039784 | 1,1e−12 | ✓ |
| VanRaden G: ölçekli h^2 | 0,89012804 | 0,89012804 | 0,89012804 | 6,8e−13 | ✓ |
| VanRaden G: \hat\sigma^2_u (marker, RR-BLUP) | 0,00111901 | 0,00111901 | 0,00111901 | 9,1e−13 | ✓ |
| VanRaden G: \hat\sigma^2_g=\hat\sigma^2_u\cdot2\sum pq (RR-BLUP) | 0,96692601 | 0,96692601 | 0,96692601 | 7,9e−10 | ✓ |
| VanRaden G: \hat\sigma^2_e (RR-BLUP) | 0,23573764 | 0,23573764 | 0,23573764 | 7,9e−10 | ✓ |
| VanRaden G: en büyük farklı birey, GEBV (GBLUP) | −1,25825763 | −1,25825763 | — | 2,0e−12 | ✓ |
| VanRaden G, ÇD 5 × 2, GBLUP: kat ortalaması r | 0,63109856 | 0,63109856 | 0,63109856 | 3,4e−14 | ✓ |
| VanRaden G, ÇD 5 × 2, GBLUP: kat SS | 0,09083553 | 0,09083553 | 0,09083553 | 1,4e−13 | ✓ |
| VanRaden G, ÇD 5 × 2, GBLUP: tekrar ortalaması r | 0,62716024 | 0,62716024 | 0,62716024 | 6,2e−14 | ✓ |
| VanRaden G, ÇD 5 × 2, GBLUP: tekrar SS | 0,02223535 | 0,02223535 | 0,02223535 | 1,9e−13 | ✓ |
| ML: \hat\sigma^2_g (GBLUP) | 0,99634364 | 0,99634364 | — | 7,1e−14 | ✓ |
| ML: \hat\sigma^2_e (GBLUP) | 0,16479653 | 0,16479653 | — | 7,0e−14 | ✓ |
| ML, VanRaden G: \hat\sigma^2_g (GBLUP) | 0,99727195 | 0,99727195 | — | 9,4e−13 | ✓ |
| ML, VanRaden G: \hat\sigma^2_e (GBLUP) | 0,20126675 | 0,20126675 | — | 9,1e−13 | ✓ |
| Ortak değişken çiçeklenme: \hat\sigma^2_g (GBLUP) | 0,94837138 | 0,94837138 | 0,94837138 | 7,2e−12 | ✓ |
| Ortak değişken çiçeklenme: \hat\sigma^2_e (GBLUP) | 0,15321262 | 0,15321262 | 0,15321262 | 7,5e−12 | ✓ |
| Ortak değişken, ÇD 5 × 2, GBLUP: tekrar ortalaması r | 0,59914057 | 0,59914057 | 0,59914057 | 1,1e−13 | ✓ |
| ÇD 10 × 3, GBLUP: tekrar ortalaması r | 0,62520606 | 0,62520606 | — | 4,2e−14 | ✓ |
| ÇD 10 × 3, GBLUP: tekrar SS | 0,0080601 | 0,0080601 | — | 1,9e−14 | ✓ |
| ÇD 10 × 3, RR-BLUP: tekrar ortalaması r | 0,63248561 | 0,63248561 | — | 3,0e−10 | ✓ |
| ÇD 10 × 3, RR-BLUP: tekrar SS | 0,01424887 | 0,01424887 | — | 1,8e−11 | ✓ |
| ÇD 10 × 3, GBLUP: 30 katta en büyük farklı kat | 0,64050793 | 0,64050793 | — | 6,2e−13 | ✓ |
| ÇD 10 × 3, RR-BLUP: 30 katta en büyük farklı kat | 0,7627181 | 0,76271809 | — | 6,3e−9 | ✓ |
| ÇD 5 × 2, tohum 7, GBLUP: tekrar ortalaması r | 0,62461027 | 0,62461027 | — | 2,9e−14 | ✓ |
| ÇD 5 × 2, tohum 7, RR-BLUP: tekrar ortalaması r | 0,63542744 | 0,63542744 | — | 1,1e−9 | ✓ |
| 40 aday, hazır G: \hat\sigma^2_g (GBLUP) | 0,90823499 | 0,90823499 | — | 1,7e−13 | ✓ |
| 40 aday, hazır G: \hat\sigma^2_e (GBLUP) | 0,2599479 | 0,2599479 | — | 2,1e−13 | ✓ |
| 40 aday, VanRaden G: \hat\sigma^2_g (GBLUP) | 0,8823145 | 0,8823145 | 0,8823145 | 1,6e−14 | ✓ |
| 40 aday, VanRaden G: \hat\sigma^2_e (GBLUP) | 0,32667608 | 0,32667608 | 0,32667608 | 2,3e−14 | ✓ |
| Hazır G: 40 adayda en büyük farklı, GEBV | 1,88048707 | 1,88048707 | — | 1,4e−13 | ✓ |
| Hazır G: 40 adayda en büyük farklı, güvenilirlik | 0,57496805 | 0,57496805 | — | 5,4e−14 | ✓ |
| VanRaden G: 40 adayda en büyük farklı, GEBV | 1,97536276 | 1,97536276 | 1,97536276 | 2,5e−14 | ✓ |
| VanRaden G: 40 adayda en büyük farklı, güvenilirlik | 0,57612375 | 0,57612375 | — | 1,1e−14 | ✓ |
| 40 aday, ÇD 5 × 2, GBLUP: tekrar ortalaması r | 0,56646954 | 0,56646954 | 0,56646954 | 1,3e−13 | ✓ |
| 40 aday, ÇD 5 × 2, RR-BLUP: tekrar ortalaması r | 0,56646965 | 0,56646965 | 0,56646966 | 1,2e−9 | ✓ |
| MAF eşiği 0,10: \hat\sigma^2_g (GBLUP) | 0,96017964 | 0,96017964 | — | 3,5e−12 | ✓ |
| MAF eşiği 0,10: \hat\sigma^2_e (GBLUP) | 0,25413617 | 0,25413617 | — | 3,5e−12 | ✓ |
| MAF eşiği 0,10: en büyük farklı birey, GEBV (RR-BLUP) | −1,2050725 | −1,20507242 | — | 6,1e−8 | ✓ |
| Eksik genotipli veri: \hat\sigma^2_g (GBLUP) | 0,97812052 | 0,97812052 | — | 6,0e−14 | ✓ |
| Eksik genotipli veri: \hat\sigma^2_e (GBLUP) | 0,2238581 | 0,2238581 | — | 5,2e−14 | ✓ |
| Eksik genotipli veri: en büyük farklı birey, GEBV (RR-BLUP) | −1,28984484 | −1,28984492 | — | 6,2e−8 | ✓ |
| Satır sırası karıştırılmış veri ↔ özgün sıra: en büyük farklı GEBV | 0,97458432 | 0,97458432 | — | 1,7e−11 | ✓ |
| BayesB: \hat\sigma^2_e (yeniden üretim) | 0,50120814 | — | 0,50120814 | 3,3e−16 | ✓ |
| BayesB: en büyük farklı birey, GEBV (yeniden üretim) | 1,23794804 | — | 1,23794804 | 4,1e−15 | ✓ |
Ölçütü karşılayan: 75/75. Python: spektral REML/ML olabilirliği ve R'nin optimize() yordamının (Brent) Python'a aktarımı; BLUP ve kestirim hata varyansı matris formüllerinden; çapraz doğrulama katları R'nin rastgele sayı üreteci yeniden kurularak. R: aynı olabilirlik taban R ile, GBLUP solve() ile, RR-BLUP Henderson karma model denklemlerinin doğrudan çözümüyle (2300 bilinmeyen), katlar set.seed + sample ile. Son iki satır bağımsız hesap değildir: BayesB aynı tohum ve aynı ayarla BGLR::BGLR doğrudan çağrılarak yeniden üretilmiştir; şablonun veri hazırlığını ve rastgele sayı akışındaki sırayı doğrular.
75.7 Çıktıyı okuma
Örnek ayarın konsol metni:
Genomik seleksiyon: 246 birey (246 fenotipli, 0 aday), 2299 marker (girdi 2299; çağrı oranı < 0,9: 0, MAF < 0,01: 0,
tek biçimli: 0, bütünüyle eksik: 0); akrabalık: hazır (K_* sütunları); modeller: GBLUP, RR-BLUP
Not: lokus sütunları seçilmedi; 0/1/2 içeren 2299 sütun marker sayıldı.
Tablolar (kısaltılmış):
Varyans bileşenleri ve genomik kalıtım derecesi (REML; h2_olcekli: k̄ = 1,9721 ile G ölçeğine göre)
   model  sigma2_g  sigma2_e        h2  h2_olcekli  sigma2_u_marker
   GBLUP  0.959229  0.208415  0.821508    0.900759              NaN
 RR-BLUP  0.966926  0.235738  0.803987         NaN         0.001119

Genomik kestirim değerleri (GEBV; büyükten küçüğe, GBLUP'a göre)
  birey          y  GEBV_GBLUP  guvenilirlik_GBLUP  GEBV_RRBLUP
 Lo1223  11.313567    3.586860            0.900538     3.553769
 Lo1282  11.412990    3.508612            0.907170     3.531543
 Lo1087  11.154707    3.466780            0.906791     3.412938
 …
   EP72   3.320676   -3.707495            0.909326    -3.642382

Mutlak etkisi en büyük 20 marker (RR-BLUP; kodlanan alelin kopya başına etkisi)
                    marker  etki_RRBLUP
  6_18990291_PZE-106021410     0.038106
 5_198818482_PZE-105145088     0.037727
  6_18991091_PZE-106021419     0.036957
 …

Çapraz doğrulama özeti: kestirim yeteneği r(y, GEBV), 5 kat × 2 tekrar (doğruluk_r_h = r/√h², GBLUP h²'siyle)
   model  r_ortalama_kat  r_ss_kat  r_ortalama_tekrar  r_ss_tekrar  dogruluk_r_h
   GBLUP        0.619765  0.083604           0.618133     0.021095      0.681986
 RR-BLUP        0.631099  0.090836           0.627160     0.022235      0.691947

Kat başına kestirim yeteneği
 tekrar  kat  n_test   r_GBLUP  r_RR-BLUP
      1    1      50  0.635735   0.632652
      1    2      49  0.727207   0.708928
 …
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
sigma2_g, sigma2_e |
Genetik ve artık varyans | \mathbf G'nin ölçeğinde. RR-BLUP satırındaki sigma2_g, marker varyansının 2\sum pq ile çarpımıdır. |
h2 |
\hat\sigma^2_g/(\hat\sigma^2_g+\hat\sigma^2_e) | Yalnız \mathbf G'nin köşegeni ortalama 1 ise alışılmış kalıtım derecesidir. |
h2_olcekli |
\bar k ile ölçeklenmiş kalıtım derecesi | Örneklemdeki bireyler arasındaki genetik varyansın payı; raporlanacak değer çoğu kez budur. |
sigma2_u_marker |
Tek bir marker etkisinin varyansı | Etkilerin ne kadar büzüldüğünün ölçüsü. |
GEBV_* |
Genomik kestirim değeri | Ortalamadan sapma; özelliğin biriminde. Bireyin beklenen fenotipi \hat\mu+ GEBV (artı varsa sabit etkiler). Seçilim sıralaması bu sütunla yapılır. |
guvenilirlik_GBLUP |
r^2 | 1'e yakın: değer bireyin kendi kaydı ve yakın akrabalarıyla iyi belirlenmiş; düşük: yalnız uzak akrabalardan. |
etki_RRBLUP |
Büzülmüş marker etkisi | Sıralama yol gösterir; büyüklük ve işaret sınanmış bir etki değildir. |
r_ortalama_kat ± r_ss_kat |
Kat başına korelasyonların özeti | Standart sapma, test kümesi küçüldükçe büyür. |
r_ortalama_tekrar ± r_ss_tekrar |
Birleşik korelasyonların özeti | Raporlanacak kestirim yeteneği. Standart sapma, kat atamasının rastlantısından gelen oynaklıktır; kestirimin standart hatası değildir. |
dogruluk_r_h |
\bar r/\sqrt{h^2} | Gerçek genetik değerle korelasyonun yaklaşık kestirimi. |
Şekil 75.1. Şablonun çizdiği gözlenen değer–GEBV saçılımı (GBLUP, bütün veri). Noktaların doğruya bu kadar yakın olması (r=0{,}996) modelin uyumunu gösterir; kestirim gücü çapraz doğrulamadan okunur.
Şekil 75.2. Çapraz doğrulamada kat başına kestirim yeteneği (5 kat × 2 tekrar). İki modelin dağılımı örtüşür; katlar arası yayılım (0,50–0,78) modeller arası farktan büyüktür.
Şekil 75.3. RR-BLUP marker etkilerinin mutlak değeri, sütun sırasıyla. Etkiler genom boyunca yayılmıştır; en yüksek çubuklar 6. kromozomdaki ilişkilendirme tepesine denk gelir.
Rapor cümlesi (örnek ayar):
Tane verimi için genomik kestirim değerleri, 246 hat üzerinde GBLUP ile (genomik akrabalık matrisi 36 624 SNP'den; varyans bileşenleri REML) hesaplandı. Genetik ve artık varyans kestirimleri 0,959 ve 0,208, örneklem ölçeğine getirilmiş genomik kalıtım derecesi 0,90 idi. Beş katlı, iki kez tekrarlanan çapraz doğrulamada kestirim yeteneği r = 0{,}62 (tekrarlar arası SS 0,02), buna karşılık gelen doğruluk r/\sqrt{h^2} = 0{,}68 bulundu; 2299 SNP ile kurulan RR-BLUP modeli benzer sonuç verdi (r = 0{,}63).
75.8 Sık hatalar ve tuzaklar
- Bütün veriyle hesaplanan korelasyonu kestirim gücü saymak. Şekil 75.1'deki r=0{,}996 uyumdur; modelin görmediği bireylerdeki korelasyon 0,62'dir. Raporlanan değer çapraz doğrulamadan alınır.
h2sütununu \mathbf G'nin ölçeğine bakmadan raporlamak. Kendilenmiş hatlarda, poliploitlerde ya da başka bir yazılımdan alınan matrislerde köşegen 1 değildir. Tablo başlığındaki \bar k okunur; 1'den uzaksah2_olceklikullanılır. Yalnız 0/1 kodlu markerlerde şablon frekansı yine \bar x/2 sayar; hesaplanan \mathbf G'nin ölçeği kayar, GEBV'ler veh2_olceklietkilenmez.- Hazır matrisle çalışırken GBLUP ve RR-BLUP sütunlarının aynı çıkmasını beklemek. Hazır matris başka bir marker kümesinden geliyorsa iki sütun farklı bilgiye dayanır (75.4.1). Eşdeğerlik denetimi için önek boş bırakılır.
- Marker listesini boş bırakıp tabloda marker olmayan 0/1/2 sütunlar taşımak. Kendiliğinden seçim adlara da bakar: adı
<kromozom>_<konum>_<ad>biçiminde olan sütun varsa yalnız onlar marker sayılır; cinsiyet (0/1) ya da blok gibi sütunlar atlanır ve adları konsola yazılır (örnek veriyecinsiyeteklendiğinde 2299 marker kullanılır; sonuç sütunsuz veriyle aynıdır). Adları harita biçiminde olmayan veride 0/1/2 içeren her sütun marker sayılır ve ilk adları konsola yazılır; marker olmayan sütun varsa sabit etki olarak seçilir ya da markerler elle işaretlenir. Değerleri 0/1/2 olan "kategorik" türdeki sütun da marker sayılır. - BayesB'yi varsayılan yineleme sayısıyla tek kez çalıştırıp sıralamaya güvenmek. Kısa zincirde GEBV'ler tohumla değişir (75.4.6). Yineleme sayısı artırılır, iki çalıştırma karşılaştırılır; betik kaydı tohumu sakladığından raporlanan sonuç betikten yeniden üretilir. Konsoldaki Geweke ve etkin örneklem uyarısı yinelemenin yetersiz olduğunu gösterir ve "(ör. 12000 / 2000)" önerisini taşır. Varsayılan 3000/1000 aynen kalır; örnek veride tohum 7 ile 3000/1000'de artık varyans zincirinin ölçütü sağlanmazken (z=-3{,}92, etkin örneklem 70; ölçüt |z|\le 1{,}96 ve etkin örneklem \ge 100), 12000/2000'de (z=-0{,}349, etkin örneklem 539) (2000 kayıtlı örnek) Geweke z ve etkin örneklem büyüklüğü ayrı bir betikte
coda::geweke.diagveeffectiveSizeile aynı BGLR zincirinde bağımsız olarak hesaplanan değerlerle aynıdır ve ölçüt sağlanır; süre yaklaşık 2,5 kat uzar. - Çapraz doğrulamayı BayesB ile ve çok tekrarla istemek. Her kat için ayrı bir zincir çalışır: k\times tekrar \times yineleme. Varsayılan ayarla 10 zincir,
kat = 10,tekrar = 10ile 100 zincir demektir. - Kat sayısını bireye göre çok büyük seçmek. Test kümesi 3–4 bireye inerse kat başına korelasyon anlamsızlaşır: 60 bireyde
kat = 20iler_ss_kat0,53 çıkmıştır. Böyle durumdar_ortalama_tekrarokunur; test kümesinde 3'ten az birey kalan katların korelasyonu boş bırakılır ve kat ortalamasına girmez. - Kategorik sabit etkide seyrek düzey. Bir düzeyin bütün bireyleri aynı kata düşerse o katın eğitim kümesinde düzey kalmaz. Şablon bu katı atlar, o katın r değerini boş bırakır, atlanan kat sayısını uyarıyla yazar ve çapraz doğrulama özetini kalan katlardan hesaplar; bütün veriyle yapılan uyum ve tabloları etkilenmez. Çok sayıda kat atlanıyorsa seyrek düzeyler birleştirilir, kat sayısı azaltılır ya da etken modelden çıkarılır.
- Sabit etkili modelde kestirim yeteneğini yanlış okumak. Korelasyon ham y ile GEBV arasındadır; sabit etkinin açıkladığı varyans paydada kalır. Çiçeklenme zamanı ortak değişken yapıldığında r 0,618'den 0,599'a iner; bu, genomik kestirimin kötüleştiği anlamına gelmez.
- Eğitim ve aday popülasyonun farklı kökenden olması. Çapraz doğrulama, adayların eğitim kümesiyle aynı popülasyondan geldiğini varsayar. Adaylar başka bir gen havuzundansa gerçek doğruluk çapraz doğrulamanın gösterdiğinden düşüktür; adayların güvenilirlik sütunu bu konuda daha dürüst bir göstergedir.
- Aynı bireyden birden çok satır. Kimlik yinelenirse şablon durur; hat ortalamaları verilir.
- MAF ve çağrı oranı süzgeçlerinin \mathbf G'ye etkisini unutmak. VanRaden matrisi nadir alellere duyarlıdır;
maf = 0,1ile 184 marker atılır ve \hat\sigma^2_e 0,236'dan 0,254'e çıkar.
75.9 Uzman soruları
S1. GBLUP ve RR-BLUP gerçekten aynı model mi? Çıktıda neden küçük bir fark var?
\mathbf G=\mathbf W\mathbf W^\top/c (c=2\sum pq) iken \mathbf g=\mathbf W\mathbf u yazılırsa \text{var}(\mathbf g)=\sigma^2_u\mathbf W\mathbf W^\top=\sigma^2_uc\,\mathbf G olur; iki model aynı olabilirliğe ve aynı BLUP'a sahiptir. Şablonun yazdığı fark (2{,}6\cdot10^{-5}) eniyileyicinin toleransından gelir: optimize() iki modelde \lambda'yı farklı ölçeklerde arar ve mutlak 1{,}2\cdot10^{-4} toleransla durur. Aynı tolerans, kestirimleri olabilirliğin tam en büyüğünden de beşinci ondalıkta ayırır (başka bir paketle bulunan en büyük 0{,}959236 ve 0{,}208407; şablon 0{,}959229 ve 0{,}208415). Bu büyüklükte bir fark hiçbir sıralamayı değiştirmez.
S2. Güvenilirlik formülünde payda neden \sigma^2_gG_{ii}? Akrabalı bireylerde bu doğru mu?
Güvenilirlik, kestirim hata varyansının bireyin genetik değerinin önsel varyansına oranından türer; önsel varyans \sigma^2_gG_{ii}'dir ve G_{ii}=1+F_i akrabalı yetişmeyi zaten içerir. Paydaya \sigma^2_g yazmak (köşegeni 1 saymak) kendilenmiş hatlarda güvenilirliği küçümser, hatta negatif yapabilir. Şablonun tanımı bu yüzden doğrudur; negatif değerler yine de 0'a kırpılır, çünkü kestirilen varyanslarla sayısal olarak oluşabilir.
S3. Yanıtı eksik bireyler modelde "kalıyor"; varyans bileşenlerini etkiliyorlar mı?
Hayır. Olabilirlik yalnız fenotipli bireylerin \mathbf Z\mathbf G\mathbf Z^\top bloğundan hesaplanır; adayların satırları yalnız \hat{\mathbf g}=\mathbf G\mathbf Z^\top\mathbf H^{-1}(\cdot) çarpımında kullanılır. Adaylar iki yerde dolaylı etki yapar: VanRaden matrisinde alel frekansları ve \bar k bütün bireylerden hesaplanır. Aday sayısı eğitim kümesine göre çok büyükse ve adaylar farklı frekanslara sahipse \mathbf G'nin merkezi kayar; kesişim bunu büyük ölçüde karşılar.
S4. Çapraz doğrulamada varyans bileşenleri her katta yeniden mi kestiriliyor?
Evet. Her katta mixed.solve eğitim bireyleriyle baştan çağrılır; \hat\lambda kattan kata değişir. Bütün veriden kestirilen \lambda'yı katlarda sabit tutmak test bireylerinin bilgisini modele sızdırır ve kestirim yeteneğini iyimser gösterir. Buna karşılık marker süzgeçleri, doldurma ve VanRaden matrisi bütün bireylerle bir kez yapılır; bu adımlar fenotipi kullanmadığından sızıntı sayılmaz ve genomik seleksiyonun gerçek kullanımına (adayların genotipi eldedir) uygundur.
S5. `r_ss_tekrar` kestirim yeteneğinin standart hatası mıdır?
Değildir. Tekrarlar aynı bireyleri farklı katlara böler; aralarındaki yayılım yalnız bölmenin rastlantısını ölçer. Örneklemin kendisinden gelen belirsizlik (başka 246 hat alınsaydı ne olurdu) bundan çok büyüktür ve bu tabloda yer almaz; kaba bir fikir için korelasyonun Fisher dönüşümüyle standart hatası 1/\sqrt{n_f-3}\approx0{,}064 kullanılabilir. İki modelin karşılaştırılmasında ise aynı katlar kullanıldığından kat başına farklara bakılır.
S6. Doğruluk hesabında neden ölçeksiz h^2 kullanılıyor ve bunun sonucu ne?
Şablon, GBLUP satırının h2 değerini kullanır (satır 372). \mathbf G'nin köşegeni 1'den farklıysa bu değer fenotipin genetik değerle korelasyonunun karesi değildir. Örnekte ölçeksiz h^2=0{,}822 ile doğruluk 0,682, ölçekli h^2=0{,}901 ile 0{,}618/\sqrt{0{,}901}=0{,}651 olur. Hangi kalıtım derecesinin kullanıldığı raporda belirtilir; ayrıca h^2 aynı veriden kestirildiği için doğruluğun kendi belirsizliği vardır.
S7. BayesB'nin artık varyansı (0,51) neden GBLUP'unkinden (0,21) çok büyük?
İki nedenle. Birincisi, BayesB tablodaki 2299 markeri, örnek ayardaki GBLUP ise 36 624 markerden gelen matrisi kullanır; aynı 2299 markerle RR-BLUP 0,236 verir. İkincisi, önsel: bayesb_R2 = 0,5, markerlerin varyansın yarısını açıklayacağını söyler ve 246 gözlemle 2299 etkinin sonsalı önselden güçlü biçimde etkilenir. Sonsal ortalama GEBV'lerin standart sapması (1,31) RR-BLUP'unkinden (1,45) küçüktür; BayesB bu veride daha çok büzmüştür. Gerçek kalıtım derecesi yüksekse bayesb_R2 buna göre artırılır; sonuç önsele duyarlıysa bu açıkça raporlanır.
S8. BayesB sonucunu bağımsız olarak doğrulamak mümkün mü?
MCMC çıktısı, aynı rastgele sayı akışı kullanılmadıkça sayısı sayısına yinelenemez; bu bölümde BayesB için yapılan denetim bağımsız bir hesap değil, yeniden üretimdir: aynı tohumla ve aynı ayarla paket doğrudan çağrılmış, şablonun GEBV'leri ve artık varyansı birebir elde edilmiştir (75.6.1'in son iki satırı). Bu, şablonun veri hazırlığının ve rastgele sayıların çekiliş sırasının doğru olduğunu gösterir. Yöntemin kendisi için güvence, zinciri uzattıkça tohumlar arası farkın küçülmesidir (75.4.6).
S9. Marker sayısı birey sayısından çok fazlayken REML nasıl çalışıyor?
RR-BLUP'ta bilinmeyen 2299 etki vardır, ama kestirilen yalnız iki varyanstır; etkiler rastgele olduğundan olabilirlik n_f\times n_f boyutlu \mathbf W_f\mathbf W_f^\top+\lambda\mathbf I matrisi üzerinden yazılır. Hesap yükünü marker sayısı değil birey sayısı belirler. Karma model denklemlerinin doğrudan çözümü (2300\times2300) aynı sonucu verir; doğrulamanın R kolunda bu yol kullanılmıştır.
75.10 Kaynaklar
- de los Campos, G., Hickey, J. M., Pong-Wong, R., Daetwyler, H. D., & Calus, M. P. L. (2013). Whole-genome regression and prediction methods applied to plant and animal breeding. Genetics, 193(2), 327–345. https://doi.org/10.1534/genetics.112.143313
- Endelman, J. B. (2011). Ridge regression and other kernels for genomic selection with R package rrBLUP. The Plant Genome, 4(3), 250–255. https://doi.org/10.3835/plantgenome2011.08.0024
- Habier, D., Fernando, R. L., & Dekkers, J. C. M. (2007). The impact of genetic relationship information on genome-assisted breeding values. Genetics, 177(4), 2389–2397. https://doi.org/10.1534/genetics.107.081190
- Henderson, C. R. (1975). Best linear unbiased estimation and prediction under a selection model. Biometrics, 31(2), 423–447. https://doi.org/10.2307/2529430
- Kang, H. M., Zaitlen, N. A., Wade, C. M., Kirby, A., Heckerman, D., Daly, M. J., & Eskin, E. (2008). Efficient control of population structure in model organism association mapping. Genetics, 178(3), 1709–1723. https://doi.org/10.1534/genetics.107.080101
- Legarra, A. (2016). Comparing estimates of genetic variance across different relationship models. Theoretical Population Biology, 107, 26–30. https://doi.org/10.1016/j.tpb.2015.08.005
- Legarra, A., Robert-Granié, C., Manfredi, E., & Elsen, J.-M. (2008). Performance of genomic selection in mice. Genetics, 180(1), 611–618. https://doi.org/10.1534/genetics.108.088575
- Meuwissen, T. H. E., Hayes, B. J., & Goddard, M. E. (2001). Prediction of total genetic value using genome-wide dense marker maps. Genetics, 157(4), 1819–1829. https://doi.org/10.1093/genetics/157.4.1819
- Millet, E. J., Welcker, C., Kruijer, W., Negro, S., Coupel-Ledru, A., Nicolas, S. D., Laborde, J., Bauland, C., Praud, S., Ranc, N., Presterl, T., Tuberosa, R., Bedo, Z., Draye, X., Usadel, B., Charcosset, A., van Eeuwijk, F., & Tardieu, F. (2016). Genome-wide analysis of yield in Europe: Allelic effects vary with drought and heat scenarios. Plant Physiology, 172(2), 749–764. https://doi.org/10.1104/pp.16.00621
- Patterson, H. D., & Thompson, R. (1971). Recovery of inter-block information when block sizes are unequal. Biometrika, 58(3), 545–554. https://doi.org/10.1093/biomet/58.3.545
- Pérez, P., & de los Campos, G. (2014). Genome-wide regression and prediction with the BGLR statistical package. Genetics, 198(2), 483–495. https://doi.org/10.1534/genetics.114.164442
- VanRaden, P. M. (2008). Efficient methods to compute genomic predictions. Journal of Dairy Science, 91(11), 4414–4423. https://doi.org/10.3168/jds.2007-0980