33. Dört Parametreli Lojistik Doz-Yanıt (4PL) ve EC50
Şablon kimliği: dort_parametreli_lojistik · Kategori: model · Dil: Python · Dosya: pro/sablonlar/model/dort_parametreli_lojistik.py (satır 1–236; üstbilgi 1–79) · Örnek veri: _ornek/doz_yanit.csv · Paketler: numpy, pandas, scipy (optimize.curve_fit, stats.t), matplotlib
33.1 Ne işe yarar
Şablon, artan dozla sürekli bir yanıtın (canlılık yüzdesi, enzim etkinliği, büyüme, absorbans) sigmoid biçimde değiştiği deneylerde doz-yanıt eğrisini uydurur ve yanıtın iki asimptotun tam ortasına ulaştığı dozu, EC50'yi (inhibisyon deneylerinde IC50) kestirir. Cevapladığı soru şudur: "Etkinin yarısı hangi dozda ortaya çıkıyor ve bu doz ne kadar kesin biliniyor?"
- x: doz (\ge0). x=0'da \ln x=-\infty alınır.
- c: b>0 iken yüksek dozdaki, b<0 iken sıfır dozdaki asimptot. d: öteki asimptot. Şablonun başlangıç değerleri d>c olacak biçimde seçildiğinden c "alt", d "üst" asimptot diye adlandırılır.
- e: EC50; f(e)=(c+d)/2. Model \ln e değil e üzerinden kestirilir.
- b: \ln x ölçeğinde eğim. b>0: yanıt dozla azalır; b<0: artar. \lvert b\rvert büyüdükçe geçiş dikleşir.
Bu, log-lojistik dört parametreli modelin (LL.4) drc paketindeki parametrelemesidir (Ritz ve ark., 2015). Alt asimptot sabitlenirse model üç parametreli LL.3 olur.
Ne zaman kullanılır? Yanıt sürekli ve dozla tekdüze (monoton) değişiyorsa; dozlar logaritmik aralıklı ve iki platoyu da kapsıyorsa; EC50/IC50 ya da ED10, ED90 gibi etkin dozlar isteniyorsa; sıfır dozlu kontrol grubu modele katılmak isteniyorsa.
Ne zaman kullanılmaz?
- Yanıt ikili ya da sayımsa (ölen / toplam): binom olabilirlikli probit ya da logit doz-yanıt modeli gerekir; temel programdaki Probit Regresyon ya da Lojistik Regresyon.
- Birden çok eğri ortak parametrelerle karşılaştırılacaksa (göreli etkinlik, paralellik): bu şablon tek eğri uydurur;
nlme_karmaşablonu ya da kodu düzenlenmiş bir model. - Düşük dozda uyarım (hormesis) ya da tepe biçimli yanıt varsa: 4PL tekdüze olduğundan bu biçimi temsil edemez.
- Tekrarlı deneyler (plaka, gün) rastgele etki olarak modellenecekse: karma doz-yanıt modeli.
- Genel doğrusal olmayan model ya da kendi olabilirliğiniz gerekiyorsa:
ozel_olabilirlikşablonu.
Temel programla ilişki. Temel programdaki Doğrusal Olmayan Regresyon analizi kullanıcı formülüyle genel bir model uydurur. Bu şablon modeli ve parametrelemeyi sabitler, başlangıç değerlerini veriden kurar, sıfır dozu kontrol olarak kabul eder ve EC50'nin log ölçeğinde GA'sını ile göreli ED(p)'yi doğrudan verir.
33.2 Şablonun girdileri
Form, üstbilgideki dokuz [[param]] bloğundan kurulur (dort_parametreli_lojistik.py:10–78).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Doz (≥ 0) · doz |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | x (93–94). |
Yanıt · yanit |
sayısal sütun · Değişkenler | ikinci sayısal sütun | sayısal sütun | y (93–94). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | t çeyreği (184); tüm GA'lar. |
Alt asimptotu sabitle (LL.3) · sabit_alt |
onay · Model | kapalı | açık / kapalı | c kestirilmez (126–128). |
Alt asimptot değeri · alt_deger |
ondalık · Model | 0,0 | herhangi | Sabit c (121). |
Üst asimptotu sabitle · sabit_ust |
onay · Model | kapalı | açık / kapalı | d kestirilmez (126, 129–130). |
Üst asimptot değeri · ust_deger |
ondalık · Model | 100,0 | herhangi | Sabit d (122). |
Ek etkin doz yüzdeleri (ör. 10, 90) · ed_yuzdeleri |
metin · Seçenekler | boş | 0 ile 100 arasında sayılar | ED(p) tablosu (131–140, 225–235). |
EC50 güven aralığı · ec50_ga |
seçim · Seçenekler | log |
log, dogrusal |
Metindeki EC50 GA'sı ve şekildeki bant (189–192). |
En çok fonksiyon değerlendirmesi · en_cok_deneme |
tamsayı · Gelişmiş | 20000 | 100–1 000 000 | curve_fit(maxfev = …) (125). |
Örnek ayar (satır 9): doz = doz, yanit = canlilik; öteki alanlar varsayılandadır.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 89–90 |
| Doz ve yanıt aynı sütun | "farklı sütunlar olmalı" | 91–92 |
| Negatif doz | "Doz negatif olamaz." | 95–96 |
| 3'ten az farklı pozitif doz | "En az 3 farklı pozitif doz gerekli." | 97–99 |
| 6'dan az gözlem | "En az 6 gözlem gerekli." | 100–101 |
| Yanıt sabit | "Yanıt sabit." | 102–103 |
| Sabit alt ve üst asimptot eşit | "birbirinden farklı olmalı" | 123–124 |
| ED yüzdesi 0–100 dışında ya da sayı değil | "0 ile 100 arasında sayılar olmalı" | 138–140 |
| Üç başlangıçtan hiçbiri yakınsamadı | "4PL modeli yakınsamadı…" | 173–175 |
| Artık sd < 1 | "Gözlem sayısı … yetersiz." | 179–180 |
Eksik değer: iki sütun pd.to_numeric(errors="coerce") ile sayıya çevrilir ve herhangi birinde eksik olan satır atılır (satır 93). Uyarı (durdurmaz): EC50 en küçük ve en büyük pozitif doz arasında değilse "kestirim dışdeğerlemedir" (205–207).
33.3 Örnek veri
Dosya: _ornek/doz_yanit.csv. 8 doz düzeyinde 4'er tekrar, toplam 32 gözlem; eksik değer yok.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
doz |
Doz | sayısal | 0; 0,1; 0,3; 1; 3; 10; 30; 100 (sıfır doz kontrol). |
canlilik |
Yanıt | sayısal | Canlılık yüzdesi; 5,67–102,08. |
Doz ortalamaları:
| Doz | 0 | 0,1 | 0,3 | 1 | 3 | 10 | 30 | 100 |
|---|---|---|---|---|---|---|---|---|
| Ortalama canlılık | 100,588 | 93,268 | 90,700 | 81,968 | 57,305 | 25,208 | 13,248 | 9,205 |
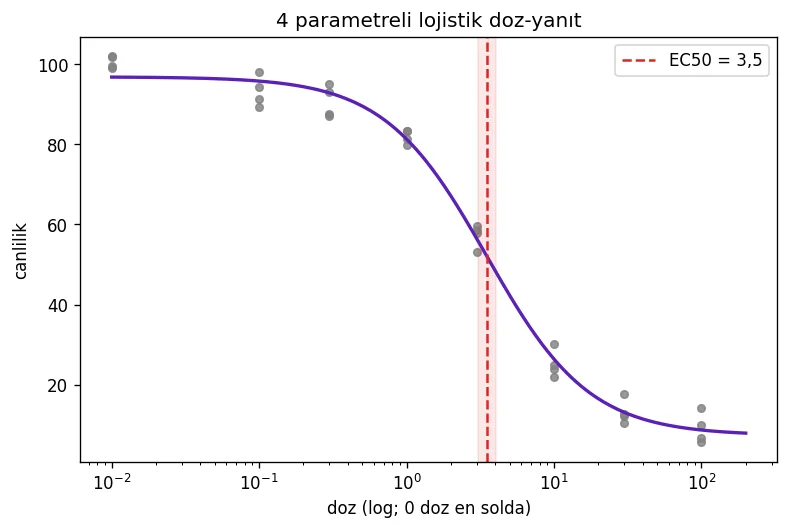
Yanıt dozla azalır, yüksek dozlarda sıfıra inmeden %9 dolayında bir platoya yaklaşır. Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) örnek ayar + ED yüzdeleri 10 90; (3) alt asimptot 0'a sabit (LL.3) + doz ölçeğinde EC50 GA'sı.
33.4 Yöntem: formüller ve hesap adımları
Şablonun hesap sırası: (1) doz ortalamalarından başlangıç değerlerini kur; (2) üç farklı başlangıç eğimiyle, sınırlı doğrusal olmayan en küçük karelerle modeli uydur ve en küçük artık kareler toplamını vereni seç; (3) kovaryans matrisinden SH, t, p ve GA'ları hesapla; (4) EC50'nin GA'sını seçilen ölçekte kur; (5) istenen ED(p)'leri delta yöntemiyle ekle; (6) metin, tablo ve şekli yaz.
33.4.1 En küçük kareler ölçütü
- n: tam gözlem sayısı; k: serbest (kestirilen) parametre sayısı (4; bir asimptot sabitse 3; ikisi sabitse 2).
- Hatalar bağımsız, ortalaması sıfır ve sabit varyanslı varsayılır; ağırlık yoktur.
33.4.2 Başlangıç değerleri ve çoklu başlangıç
Doğrusal olmayan en küçük kareler yerel bir yöntemdir; başlangıç noktası kötüyse yanlış bir yerel en küçüğe takılabilir ya da ıraksayabilir. Şablon başlangıcı verinin kendisinden kurar (satır 113–119):
- \bar y_g: g. doz düzeyindeki yanıt ortalaması; x_g: o doz.
- "Artan", en büyük dozun ortalaması en küçük dozunkinden büyükse (satır 119).
- Örnek veride c_0=9{,}205, d_0=100{,}5875; orta nokta 54{,}896'ya en yakın ortalama 57,305 (doz 3) olduğundan e_0=3; yanıt azaldığından b_0=1.
Uydurma b_0, 2b_0 ve 0{,}5\,b_0 ile üç kez denenir; kovaryansı sonlu olanlar arasından \mathrm{KT}'si en küçük olan seçilir (satır 149–172).
Neden üç başlangıç eğimi?
Eğim, LL.4'te en kötü koşullu parametredir: b çok küçükse eğri neredeyse düz, çok büyükse basamak gibidir ve iki durumda da Jacobian'ın b sütunu küçülür. Üç farklı eğimle başlamak, bu yassı bölgelerden birine düşüp orada durma olasılığını azaltır. Asimptot ve EC50 başlangıçları zaten veriye yakın olduğundan çoğaltılmaz.
33.4.3 Sınırlı Gauss–Newton ailesi: curve_fit (trf)
scipy.optimize.curve_fit, sınır verildiğinde güven bölgesi yansıtmalı (trust region reflective, trf) algoritmayı kullanır (Branch, Coleman ve Li, 1999). Her yinelemede model doğrusallaştırılır:
- \mathbf r=\mathbf y-f(\mathbf x;\boldsymbol\theta): artıklar. \mathbf J: n\times k Jacobian; J_{ij}=\partial f(x_i)/\partial\theta_j.
- \Delta: güven bölgesi yarıçapı; adım KT'yi düşürürse büyür, düşürmezse küçülür. Sınıra çarpan adım geri yansıtılır.
Jacobian'ın sütunları (u=\exp(b(\ln x-\ln e)), g=1/(1+u)):
- Sıfır dozda u=0, g=1: f=d ve yalnız \partial f/\partial d=1 sıfırdan farklıdır. Sıfır dozlu gözlemler yalnız d'yi bilgilendirir.
- curve_fit bu türevleri sonlu farklarla yaklaşık hesaplar; bağımsız hesapta (33.6) analitik biçim kullanılmıştır.
Koddaki tercih
Sınırlar (satır 157–158): b\in[-50,\ 50]; c ve d sınırsız; e\in[10^{-4}\min x^{+},\ 10^{4}\max x^{+}] (x^{+}: pozitif dozlar). e'nin alt sınırı \ln e'yi tanımlı tutar. Toleranslar ftol = xtol = gtol = 1e-12 (scipy varsayılanı 10^{-8}); en çok değerlendirme maxfev = 20000. Sıkı tolerans, kestirimlerin bağımsız yöntemlerle yedinci anlamlı basamağa kadar örtüşmesini sağlar (33.6.1). Model fonksiyonunda üs [-700,\ 700]'e kırpılır (satır 109); taşma yerine asimptot değeri döner.
33.4.4 Kovaryans, SH, t ve GA
- \mathbf J çözümde değerlendirilir. \operatorname{SH}_j=\sqrt{\hat V_{jj}}; sabitlenen parametrenin SH, t, p ve GA'sı boştur (satır 181–183).
- p=2\,P(T_{n-k}>\lvert t_j\rvert): parametrenin sıfıra eşitliğinin Wald testi. e ve d için bu sınama bilgi vermez; asıl bilgi GA'dadır.
- s: artık standart sapma; çıktıda "artık standart sapma".
Neden n − k ve t dağılımı?
s^2, k parametre kestirildikten sonra kalan n-k bağımsız bilgiden hesaplanır; n'ye bölmek varyansı küçük gösterirdi. Normal hatalar ve doğrusala yakın bir model için (\hat\theta_j-\theta_j)/\operatorname{SH}_j yaklaşık t_{n-k} dağılır (Seber ve Wild, 1989). Yaklaşıklığın kalitesi modelin parametre etkili eğriliğine bağlıdır; EC50 için bu yüzden log ölçeği önerilir (33.4.5).
33.4.5 EC50'nin güven aralığı
- q=t_{1-\alpha/2,\,n-k}. \operatorname{SH}(\ln\hat e)\approx\operatorname{SH}(\hat e)/\hat e (delta yöntemi).
- Log ölçeğindeki aralık her zaman pozitiftir ve \hat e'ye göre sağa çarpıktır.
Neden log ölçeği?
Doz etkileri çarpımsaldır: deneyler dozu katlayarak (×3, ×10) tasarlanır ve EC50'nin örnekleme dağılımı doz ölçeğinde sağa çarpıktır. \ln e'nin dağılımı normale daha yakındır; aralığı orada kurup geri dönüştürmek hem pozitifliği güvenceye alır hem de kapsama olasılığını iyileştirir. Doz ölçeğindeki Wald aralığı simetriktir ve büyük SH'de sıfırın altına inebilir.
Koddaki tercih
Parametre tablosundaki e satırının GA'sı her zaman doz ölçeğindedir (satır 188); log ölçeğindeki aralık yalnız metin satırında ve şekildeki bantta görünür (189–200, 216). Rapor için metin satırındaki aralık kullanılır.
33.4.6 Göreli etkin doz ED(p) ve delta yöntemi
ED(p), yanıtın d'den c'ye doğru yolun \%p'sini aldığı dozdur: f(\mathrm{ED}_p)=d-\frac{p}{100}(d-c). Modelden:
- \mathbf g: \mathrm{ED}_p'nin (b,c,d,e)'ye göre gradyanı; ED(p) asimptotlara bağlı olmadığından c ve d bileşenleri sıfırdır.
- p=50'de \lambda_p=0 ve \mathrm{ED}_{50}=e.
- GA: \mathrm{ED}_p\pm q\,\operatorname{SH}(\mathrm{ED}_p), doz ölçeğinde (satır 232).
Göreli ve mutlak etkin doz
ED(p) ve EC50 görelidir: kestirilen c ile d arasındaki etkiye göre tanımlanır. Örnek veride f(\hat e)=(\hat c+\hat d)/2=52{,}10'dur; yanıtın 50'ye indiği mutlak doz ise \hat e\big((\hat d-\hat c)/(50-\hat c)-1\big)^{1/\hat b}=3{,}779'dur (\hat e=3{,}504). Yanıt kuramsal bir 0–100 ölçeğindeyse ve "yüzde 50 canlılık" soruluyorsa mutlak doz istenir; şablon onu vermez. Ayrıca artan bir eğride (b<0) d yüksek doz platosudur ve ED10, EC50'den büyük çıkar: \mathrm{ED}_{10}/e=9^{1/\lvert b\rvert}.
33.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–79 | Üstbilgi: model açıklaması, örnek veri ve ayar, dokuz parametre. | Form ve varsayılanlar (Bölüm 1.2). |
| 80–103 | İçe aktarmalar; dil seçici _m; veri denetimleri; x, y dizileri. |
Liste bazında silme (93). |
| 106–110 | ll4(x, b, c, d, e): model fonksiyonu; sıfır dozda \ln x=-\infty. |
Üs kırpması taşmayı önler (109). |
| 113–130 | Başlangıç değerleri; sabit asimptot bayrakları ve değerleri; serbest maskesi. |
Sabitlenen asimptotun başlangıcı sabit değerdir (127–130). |
| 131–140 | ED yüzdelerinin ayrıştırılması. | ", " ve ";" ayırıcıdır; her parçada virgül ondalık noktaya çevrilir (135). |
| 143–146 | ll4_s: yalnız serbest parametreleri alan sarmalayıcı. |
Sabitlenen parametreler kovaryansta sıfır satır/sütun alır (164–167). |
| 149–175 | Üç başlangıçla curve_fit; en küçük KT'li ve sonlu kovaryanslı çözüm. |
Hata veren deneme sessizce atlanır (171–172). |
| 176–193 | sd, SH, t çeyreği, parametre tablosu, EC50 GA'sı, artık standart sapma. | Tablo GA'sı doz ölçeğinde (188). |
| 194–207 | Metin satırları; sabit asimptot notu; dışdeğerleme uyarısı. | "Artık standart sapma" s=\sqrt{\mathrm{KT}/\mathrm{sd}}'dir. |
| 209–236 | Şekil (log doz ekseni, sıfır doz en solda), tablolar, ED(p) tablosu. | Sıfır doz \min x^{+}/10'da çizilir (210–211). |
33.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/dort_parametreli_lojistik/elle_hesap.py ile hesaplanmıştır. Bu betik curve_fit'i ve şablon kodunu kullanmaz: analitik Jacobian'lı bir Levenberg–Marquardt yinelemesini (Marquardt, 1963) numpy ile açıkça uygular; scipy yalnız t dağılımı için kullanılır. R tarafında aynı model stats::nls ile (LL.4 için Gauss–Newton, LL.3 için port) uydurulmuştur (r_dogrulama.R).
Adım 1 — Başlangıç ve ilk yinelemeler. Başlangıç (b,c,d,e)=(1;\ 9{,}205;\ 100{,}5875;\ 3), \mathrm{KT}=627{,}701. Levenberg–Marquardt adımı \big(\mathbf J^{\top}\mathbf J+\lambda\,\mathrm{diag}(\mathbf J^{\top}\mathbf J)\big)\boldsymbol\delta=\mathbf J^{\top}\mathbf r ile:
| Yineleme | b | c | d | e | KT |
|---|---|---|---|---|---|
| 0 | 1,000000 | 9,205000 | 100,587500 | 3,000000 | 627,7010 |
| 1 | 1,146917 | 6,350728 | 97,192830 | 3,545455 | 367,9106 |
| 2 | 1,224389 | 7,265268 | 96,978929 | 3,490191 | 354,4098 |
| 3 | 1,240843 | 7,323137 | 96,872628 | 3,503307 | 353,7397 |
| son (11) | 1,245325 | 7,364237 | 96,837472 | 3,504229 | 353,7158 |
Adım 2 — Artık varyans ve kovaryans. n=32, k=4, sd =28:
\hat{\mathbf V}=s^2(\mathbf J^{\top}\mathbf J)^{-1}'in köşegeninin karekökü: \operatorname{SH}(b)=0{,}097855, \operatorname{SH}(c)=1{,}849362, \operatorname{SH}(d)=1{,}236511, \operatorname{SH}(e)=0{,}246359.
Adım 3 — EC50 GA'sı. q=t_{0{,}975;\,28}=2{,}048407; \operatorname{SH}(\ln\hat e)=0{,}246359/3{,}504229=0{,}070303:
Doz ölçeğinde: 3{,}504229\pm2{,}048407\cdot0{,}246359=[2{,}999586;\ 4{,}008872].
Adım 4 — ED10 ve delta yöntemi. \lambda_{10}=\ln(10/90)=-2{,}197225; \lambda_{10}/\hat b=-1{,}764378; e^{-1{,}764378}=0{,}171293:
\operatorname{SH}(\mathrm{ED}_{10})=\sqrt{\mathbf g^{\top}\hat{\mathbf V}\mathbf g}=0{,}083798; GA [0{,}428599;\ 0{,}771903]. Aynı yolla \mathrm{ED}_{90}=20{,}457476, SH 3,474083. ED10'da kestirilen yanıt 87,89, ED90'da 16,31'dir.
Adım 5 — LL.3 (alt asimptot 0). k=3, sd =29: \hat b=0{,}991878, \hat d=98{,}601441, \hat e=4{,}102892; \mathrm{KT}=497{,}3759, s=4{,}141364. KT, LL.4'e göre 143,66 artar; alt asimptot sıfırdan anlamlı biçimde büyüktür (\hat c=7{,}36, p=0{,}00044), bu veride c=0 kısıtı uygun değildir ve EC50'yi 3,50'den 4,10'a kaydırır.
33.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun "4PL parametreleri" ve "Göreli etkin dozlar ED(p)" tablolarından, tam hassasiyetle alınmıştır (çalıştırmalar 2 ve 3). EC50'nin log ölçeğindeki GA'sı yalnız metinde, dört anlamlı basamakla yazıldığından MerQuR+ değeri şablonun kendi tablosundaki \hat e ve \operatorname{SH}(\hat e)'den, şablonun formülüyle (satır 189–190) kurulmuştur.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| LL.4 b | 1,24532532 | 1,24532536 | 1,24532537 | 3,8e−8 | ✓ |
| LL.4 SH(b) | 0,09785547 | 0,09785547 | 0,09785547 | 3,2e−9 | ✓ |
| LL.4 p(b) | 3,679020·10−13 | 3,679017·10−13 | 3,679014·10−13 | 6,2e−19 | ✓ |
| LL.4 c | 7,36423635 | 7,3642368 | 7,36423682 | 6,4e−8 | ✓ |
| LL.4 SH(c) | 1,84936208 | 1,84936204 | 1,84936198 | 5,3e−8 | ✓ |
| LL.4 p(c) | 4,409264·10−4 | 4,409260·10−4 | 4,409259·10−4 | 5,5e−10 | ✓ |
| LL.4 d | 96,83747248 | 96,83747216 | 96,83747207 | 4,2e−9 | ✓ |
| LL.4 SH(d) | 1,23651081 | 1,23651079 | 1,23651078 | 2,7e−8 | ✓ |
| LL.4 p(d) | 2,400218·10−34 | 2,400217·10−34 | 2,400216·10−34 | 1,5e−40 | ✓ |
| LL.4 e | 3,50422875 | 3,50422875 | 3,50422876 | 3,4e−9 | ✓ |
| LL.4 SH(e) | 0,24635873 | 0,24635873 | 0,24635873 | 2,6e−9 | ✓ |
| LL.4 p(e) | 2,443947·10−14 | 2,443948·10−14 | 2,443947·10−14 | 6,3e−21 | ✓ |
| LL.4 EC50 GA alt (log Wald) | 3,03423927 | 3,03423926 | 3,03423927 | 2,4e−9 | ✓ |
| LL.4 EC50 GA üst (log Wald) | 4,04701741 | 4,04701741 | 4,04701742 | 4,3e−9 | ✓ |
| LL.4 ED10 | 0,60025091 | 0,60025094 | 0,60025095 | 4,2e−8 | ✓ |
| LL.4 SH(ED10) | 0,08379773 | 0,08379773 | 0,08379773 | 3,4e−9 | ✓ |
| LL.4 ED90 | 20,45747695 | 20,4574758 | 20,45747564 | 6,4e−8 | ✓ |
| LL.4 SH(ED90) | 3,47408286 | 3,47408255 | 3,4740824 | 1,3e−7 | ✓ |
| LL.3 b | 0,99187825 | 0,99187828 | 0,99187812 | 1,3e−7 | ✓ |
| LL.3 SH(b) | 0,05758319 | 0,05758319 | 0,05758318 | 8,5e−9 | ✓ |
| LL.3 d | 98,6014413 | 98,60144093 | 98,60144275 | 1,5e−8 | ✓ |
| LL.3 SH(d) | 1,5113398 | 1,51133978 | 1,51133987 | 5,0e−8 | ✓ |
| LL.3 e | 4,10289188 | 4,10289192 | 4,10289182 | 1,4e−8 | ✓ |
| LL.3 SH(e) | 0,29349956 | 0,29349956 | 0,29349959 | 2,8e−8 | ✓ |
| LL.3 EC50 GA alt (doz Wald) | 3,50261789 | 3,50261792 | 3,50261777 | 3,3e−8 | ✓ |
Ölçütü karşılayan: 25/25. Python: analitik Jacobian'lı Levenberg–Marquardt (numpy; curve_fit kullanılmadan). R: stats::nls (LL.4 Gauss–Newton, LL.3 port). Fark, üç yöntemin yakınsama toleransından gelir.
Üç yöntem farklı algoritmalarla (güven bölgesi yansıtmalı, Levenberg–Marquardt, Gauss–Newton) aynı en küçüğe ulaşır; kalan farklar (\le1{,}3\times10^{-7}) yakınsama toleransından gelir. Bağımsız Python ve R çözümlerinin KT'leri 10^{-9} düzeyinde aynıdır.
33.7 Çıktıyı okuma
Çalıştırma 2'nin (örnek ayar + ED10, ED90) metin çıktısı:
4PL (LL.4): canlilik ~ doz, n = 32, artık standart sapma = 3,5543 (sd = 28)
EC50 = 3,504; %95 GA (log ölçeğinde Wald) [3,034; 4,047]
Eğim b = 1,2453; alt = 7,3642; üst = 96,8375
"4PL parametreleri" tablosu (dört ondalık; p üç anlamlı basamak):
| parametre | kestirim | SH | t | p | ga_alt | ga_ust |
|---|---|---|---|---|---|---|
| b (eğim) | 1,2453 | 0,0979 | 12,726 | 3{,}68\cdot10^{-13} | 1,0449 | 1,4458 |
| c (alt asimptot) | 7,3642 | 1,8494 | 3,982 | 4{,}41\cdot10^{-4} | 3,5760 | 11,1525 |
| d (üst asimptot) | 96,8375 | 1,2365 | 78,315 | 2{,}40\cdot10^{-34} | 94,3046 | 99,3704 |
| e (EC50) | 3,5042 | 0,2464 | 14,224 | 2{,}44\cdot10^{-14} | 2,9996 | 4,0089 |
"Göreli etkin dozlar ED(p) (delta yöntemi)": yüzde 10 → ED 0,6003 (SH 0,0838; GA [0,4286; 0,7719]); yüzde 90 → ED 20,4575 (SH 3,4741; GA [13,3411; 27,5738]).
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İlk satır | Model, n, artık standart sapma (s), sd | s yanıt biriminde tipik sapmadır. Serbest parametre sayısına göre satır "LL.4", "LL.3" ya da "LL.2" yazar; sd (n-k) aynı modeli gösterir. |
| EC50 satırı | \hat e ve seçilen ölçekte GA | Rapor edilecek aralık budur. |
| Eğim satırı | \hat b, \hat c, \hat d | b>0 azalan eğri. |
| Parametre tablosu | Kestirim, SH, t, p, doz ölçeğinde GA | c satırının p'si "alt asimptot sıfır mı?" sorusunu yanıtlar. e satırının GA'sı simetrik doz ölçeği aralığıdır. |
| ED(p) tablosu | Göreli etkin doz, delta SH, doz ölçeğinde GA | ED(p) d'den c'ye doğru \%p etkiyi verir. |
| "Sabitlenen asimptot(lar)…" | Sabit parametrenin SH/t/p boş | Kısıtın kendisi test edilmez; LL.3 ve LL.4'ün KT'leri karşılaştırılır. |
| Dışdeğerleme uyarısı | EC50 doz aralığının dışında | Dozlar EC50'nin iki yanını kapsamıyor; kestirim modele dayanır. |
Şekil 33.1. Şablonun çizdiği doz-yanıt eğrisi (örnek veri). Doz ekseni logaritmiktir; sıfır doz en küçük pozitif dozun onda birinde (0,01) çizilir. Kesikli çizgi EC50, gölgeli bant log ölçeğindeki %95 GA'dır.
Rapor cümlesi:
Canlılık yüzdesi dozla sigmoid biçimde azaldı. Dört parametreli log-lojistik model (doğrusal olmayan en küçük kareler, n = 32, artık standart sapma = 3,55) EC50'yi 3,50 doz birimi (%95 GA, log ölçeğinde Wald: 3,03–4,05), eğimi b = 1{,}25 (SH 0,10) olarak kestirdi. Üst asimptot 96,84 (SH 1,24), alt asimptot 7,36 (SH 1,85) idi; ED10 ve ED90 sırasıyla 0,60 (%95 GA 0,43–0,77) ve 20,46 (%95 GA 13,34–27,57) doz birimiydi.
33.8 Sık hatalar ve tuzaklar
- Tablodaki e GA'sını rapor etmek. Tablo GA'sı simetrik doz ölçeği aralığıdır; varsayılan rapor aralığı metin satırındaki log ölçeği aralığıdır.
- Göreli EC50'yi mutlak %50 dozu sanmak. f(\hat e)=52{,}10'dur; canlılığın 50'ye indiği doz 3,78'dir. Hangisinin sorulduğu raporda yazılır.
- ED yüzdelerini bitişik yazmak. Ayırıcı ", " (virgül + boşluk), boşluk ya da ";" dir; her parça içindeki virgül ondalık sayılır.
10,90tek bir yüzde (10,9) olarak okunur ve ED(10,9) tablosu çıkar;10 90ya da10, 90yazılmalıdır. - Asimptotu gerekçesiz sabitlemek. Örnek veride c=0 kısıtı KT'yi 353,72'den 497,38'e çıkarır ve EC50'yi 3,50'den 4,10'a kaydırır. Sabitleme kuramsal bilgiye dayanmalı ve iki modelin KT'si karşılaştırılmalıdır.
- Platoları kapsamayan dozlar. En yüksek dozda yanıt hâlâ düşüyorsa c zayıf tanımlanır, SH'ler büyür, EC50 kararsızlaşır; şablon yalnız EC50 doz aralığının dışına düştüğünde uyarır.
- Oran yanıtında sabit varyans varsaymak. Canlılık yüzdesinin varyansı asimptotlara yaklaştıkça küçülebilir; en küçük kareler bu durumda SH'leri yanlış verir. Artıkların doza göre yayılımı denetlenmelidir.
- Artan eğride ED10'u küçük doz sanmak. b<0 iken d yüksek doz platosudur ve ED10 > EC50 çıkar.
33.9 Uzman soruları
S1. Neden ln e değil de e kestiriliyor; bu SH'leri etkiler mi?
Model e üzerinden kurulur ve curve_fit e'nin SH'sini verir. \ln e parametrelemesi kestirimi değiştirmez (en küçük kareler çözümü parametrelemeden bağımsızdır), yalnız Wald aralığının biçimini değiştirir. Şablon bu farkı log ölçeğindeki GA ile karşılar: \operatorname{SH}(\ln e)=\operatorname{SH}(e)/e delta yöntemiyle elde edilir ve aralık \ln e ölçeğinde simetrik kurulur.
S2. Sıfır dozlu gözlemler modele nasıl giriyor?
x=0'da \ln x=-\infty alınır; b>0 iken üs -\infty'a gider ve f(0)=d olur (satır 108–110). Bu gözlemler yalnız d'nin kestirimine katkı verir; Jacobian'da yalnız \partial f/\partial d sütunu sıfırdan farklıdır. Log doz ekseninde çizilemedikleri için şekilde \min x^{+}/10'da gösterilirler.
S3. curve_fit'in kovaryansı neden s²(JᵀJ)⁻¹?
absolute_sigma verilmediğinde curve_fit, hataların varyansını artıklardan kestirir ve (\mathbf J^{\top}\mathbf J)^{-1}'i \mathrm{KT}/(n-k) ile ölçekler. Bu, doğrusal olmayan en küçük karelerin asimptotik kovaryansıdır (Bates ve Watts, 1988); R'deki nls ile aynı tanımdır. Doğrulama tablosunda üç yöntemin SH'leri 1{,}3\times10^{-7} içinde aynıdır.
S4. Üç başlangıç farklı çözümlere giderse hangisi seçilir?
Kovaryansı sonlu olanlar arasından KT'si en küçük olan (satır 168–170). Bu, yerel en küçüklerden en iyisini seçer ama küresel en küçüğü güvenceye almaz. Örnek veride Levenberg–Marquardt yalnız b_0=1 ile başlatılmış ve aynı çözüme (KT 353,7158) ulaşmıştır.
S5. c için p = 0,00044 ne anlama gelir?
H_0:c=0'ın Wald testidir: alt asimptot sıfırdan anlamlı biçimde büyüktür, yani en yüksek dozda bile yaklaşık %7 canlılık kalır. Aynı soru iç içe modellerin F testiyle de sorulabilir: F=(497{,}3759-353{,}7158)/(353{,}7158/28)=11{,}37, sd (1, 28). Wald t^2=3{,}982^2=15{,}86'dır; doğrusal olmayan modelde iki test farklı değer verir ve küçük örneklemde F testi genellikle daha güvenilirdir.
S6. ED(p) GA'sı neden EC50'ninki gibi log ölçeğinde değil?
Şablon ED(p) için yalnız doz ölçeğinde Wald aralığı kurar (satır 232). ED50 istenirse EC50'nin doz ölçeği aralığıyla aynı sonucu verir ([2{,}9996;\ 4{,}0089]), log ölçeğindekiyle değil. Küçük p'de ve büyük SH'de doz ölçeği aralığı sıfırın altına inebilir; o durumda log ölçeğinde aralık elle kurulur: \mathrm{ED}_p\exp(\pm q\,\operatorname{SH}/\mathrm{ED}_p).
S7. Neden profil olabilirlik ya da bootstrap aralığı yok?
Şablon Wald aralıklarıyla sınırlıdır; doğrusal olmayan modelde Wald aralığı parametre etkili eğriliğe duyarlıdır. EC50 için log ölçeği bu eğriliğin büyük kısmını giderir. Daha kesin bir aralık gerekiyorsa bootstrap_ozel şablonuyla artık bootstrap'ı ya da kodda profil KT taraması uygulanır.
S8. Yanıt bir yüzde ise ağırlıksız en küçük kareler yanlı mı?
Varyans sabit değilse kestirimler tutarlı kalabilir, ama SH'ler ve GA'lar yanlış olur. Yüzde ölçeğindeki bir yanıtta varyans asimptotlara yaklaştıkça küçülebilir; bu, artıkların doza göre yayılımından görülür. Ağırlıklı en küçük kareler ya da varyans dengeleyici dönüşüm (her iki yanın da dönüştürülmesi) bu şablonda yoktur; kod düzenlenerek curve_fit(sigma = …) ile eklenebilir.
33.10 Kaynaklar
- Bates, D. M., & Watts, D. G. (1988). Nonlinear regression analysis and its applications. Wiley. https://doi.org/10.1002/9780470316757
- Branch, M. A., Coleman, T. F., & Li, Y. (1999). A subspace, interior, and conjugate gradient method for large-scale bound-constrained minimization problems. SIAM Journal on Scientific Computing, 21(1), 1–23. https://doi.org/10.1137/S1064827595289108
- Marquardt, D. W. (1963). An algorithm for least-squares estimation of nonlinear parameters. Journal of the Society for Industrial and Applied Mathematics, 11(2), 431–441. https://doi.org/10.1137/0111030
- Ritz, C. (2010). Toward a unified approach to dose–response modeling in ecotoxicology. Environmental Toxicology and Chemistry, 29(1), 220–229. https://doi.org/10.1002/etc.7
- Ritz, C., Baty, F., Streibig, J. C., & Gerhard, D. (2015). Dose-response analysis using R. PLOS ONE, 10(12), e0146021. https://doi.org/10.1371/journal.pone.0146021
- Seber, G. A. F., & Wild, C. J. (1989). Nonlinear regression. Wiley. https://doi.org/10.1002/0471725315
- Virtanen, P., Gommers, R., Oliphant, T. E., et al. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2