89. Seleksiyon Kazancı ve Seleksiyon İndeksleri
Şablon kimliği: seleksiyon_kazanci · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/seleksiyon_kazanci.R (satır 1–509; üstbilgi 1–183) · Örnek veri: _ornek/seleksiyon_kazanci_dol_denemesi.csv · Paketler: lme4 (yalnız veriden kestirimde)
89.1 Ne işe yarar
Kalıtım derecesi bir oran verir; ıslahçının asıl sorusu "en iyileri seçersem gelecek kuşak ne kadar ilerler?" sorusudur. Cevap, ıslahçı denklemidir:
- \Delta G: beklenen genetik kazanç; seçilenlerin döllerinin ortalamasının, seçim yapılmasaydı olacak ortalamadan farkı (özelliğin biriminde).
- i: seleksiyon yoğunluğu; seçilenlerin ortalamasının fenotipik standart sapma biriminde üstünlüğü. Yalnız seçilen orana bağlıdır.
- h^2: kalıtım derecesi; \sigma_P: fenotipik standart sapma.
Şablon bu denklemi bir döl denemesinin verisinden (ya da elle girilen varyanslardan) altı seçim yolu için hesaplar: bireysel, aile, aile içi, iki aşamalı, birleşik indeks ve geriye dönük ebeveyn seleksiyonu. Birden çok özellik verilirse ilişkili tepkileri, Smith–Hazel seleksiyon indeksini, kısıtlı ve istenen kazanç indekslerini; ayrıca seçilen aile sayısına göre kazanç ile genetik çeşitlilik (statü sayısı) arasındaki dengeyi verir.
Varyans bileşenleri, akrabalık katsayısı ve kalıtım derecesinin tanımları Bölüm 79.4.1'de, genetik korelasyonun toplam yöntemiyle kestirimi Bölüm 80.4.3'te anlatılmıştır; bu bölüm onların üzerine kurulan kazanç formüllerini anlatır.
Ne zaman kullanılır? Yarım ya da tam kardeş ailelerinden oluşan, bloklu ya da bloksuz tek lokasyonlu döl denemesinde seçim stratejilerini karşılaştırmak; yayımlanmış varyanslardan kazanç öngörmek; çok özellikli indeks ağırlıklarını bulmak.
Ne zaman kullanılmaz?
- Yalnız kalıtım derecesi ve standart hatası:
kalitim_derecesi(Bölüm 79). Bu şablon varyans bileşenlerinin standart hatasını vermez. - Populasyon yapısı, çok lokasyon, klon denemesi:
orijin_dol_denemesi(Bölüm 83),klon_lokasyon_genetik(Bölüm 80). Kazanç, oradan alınan bileşenlerle bu şablonun elle kipinde hesaplanabilir. - Soy kütüğü ya da belirteçlerle bireysel ıslah değeri:
kalitim_derecesi(hayvan modeli),genomik_seleksiyon. - Tohum bahçesinde gerçekleşmiş çeşitlilik:
tohum_bahcesi_cesitlilik.
Temel programla ilişki. Temel programda seleksiyon kazancı ya da seleksiyon indeksi hesaplayan bir analiz yoktur.
89.2 Şablonun girdileri
Form, üstbilgideki yirmi dört [[param]] bloğundan kurulur (seleksiyon_kazanci.R:10–182).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Varyans bileşenlerinin kaynağı · varyans_kaynagi |
seçim · Model | veri |
veri, elle |
REML ya da elle girilen değerler (229, 248, 318). |
Seleksiyon özelliği · ozellik |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Ana özellik; seleksiyon türleri bunun içindir (252, 358). |
Ek özellikler · ek_ozellikler |
sütunlar · Değişkenler | boş | sayısal sütunlar | İlişkili tepki ve indeks (252, 433). |
Aile · aile |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Rastgele aile etkisi (251, 262). |
Blok / tekrar · blok |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Sabit etki; blok × aile rastgele (263, 273–278). |
Aile tipi · aile_tipi |
seçim · Model | yarim_kardes |
yarim_kardes (r=¼), tam_kardes (r=½) |
Akrabalık katsayısı (231, 235). |
Akrabalık katsayısı r · akrabalik |
ondalık · Model | 0 | 0–0,99 | 0 değilse aile tipinin r'sini ezer (233–235). |
Seçilen oran: aileler · p_aile |
ondalık · Seçenekler | 0,2 | 0,0001–1 | Aile ve ebeveyn seleksiyonu, indeks (236, 351). |
Seçilen oran: aile içi · p_aile_ici |
ondalık · Seçenekler | 0,2 | 0,0001–1 | Aile içi; bireysel ve birleşikte toplam oran p_f\cdot p_w (236, 352–353). |
Seleksiyon yoğunluğu · yogunluk |
seçim · Seçenekler | sonsuz |
sonsuz, burrows, kesin |
i'nin hesap yolu (238, 223). Deneme verisinden çalışırken (varyans_kaynagi = veri) aday sayısı sonlu olduğundan kesin seçilebilir; seçenek veri ve elle kipte aynı çalışır, alanın açıklaması bunu söyler (74–79). |
İndekste seçim birimi · indeks_birimi |
seçim · Seçenekler | aile |
aile, ebeveyn, birey |
İndeksin \mathbf P ve \mathbf G matrisleri (240, 450–451). |
Ekonomik ağırlıklar · ekonomik_agirliklar |
metin · Seçenekler | boş | 1; 3; 20 |
Ana özellik, sonra ek özellikler sırasıyla; boşsa hepsi 1 (384–388). |
Kısıtlı indeks · kisit |
sütunlar · Seçenekler | boş | özelliklerden bir alt küme | Genetik değişimi 0 tutulacak özellikler (399–410). |
İstenen kazançlar · istenen_kazanc |
metin · Seçenekler | boş | 10; 2; 0,1 |
Pesek–Baker indeksi (411–420). |
Generasyon aralığı L · generasyon_araligi |
ondalık · Seçenekler | 0 | 0–1000 | 0'dan büyükse yıllık kazanç sütunu (242, 372). |
Anlamlılık düzeyi α · alfa |
ondalık · Seçenekler | 0,05 | 0,0001–0,5 | Aile varyansı testinin uyarı eşiği (242, 344). |
Elle: aile varyansı, hata varyansı, h² · elle_var_aile, elle_var_hata, elle_h2 |
ondalık · Gelişmiş | 0 | ≥ 0 | Elle kipin bileşenleri (319, 336). |
Elle: aile sayısı, aile büyüklüğü · elle_aile_sayisi, elle_aile_buyuklugu |
tam sayı · Gelişmiş | 50; 20 | ≥ 1; ≥ 2 | Sonlu örneklem yoğunlukları ve N (322). |
Elle: özellik ortalaması · elle_ortalama |
ondalık · Gelişmiş | 0 | herhangi | Yüzde kazanç; 0 "verilmedi" demektir (327). |
Elle: P ve G matrisleri · elle_P, elle_G |
metin · Gelişmiş | boş | 4; 1 \| 1; 2 |
Elle kipte indeks (462–471). |
Tabloda elle kipin altı sayısal alanı üç satırda, iki matris alanı tek satırda toplanmıştır (üstbilgi satır 123–182).
Örnek ayar (ornek_param, satır 9): ozellik = boy, ek_ozellikler = cap, govde, aile, blok, ekonomik_agirliklar = "1; 3; 20", kisit = govde, istenen_kazanc = "10; 2; 0,1", generasyon_araligi = 15.
Sayı listelerinin yazımı. Öğeler ; ile ayrılır; ondalık ayırıcı nokta ya da virgül olabilir (1; 0,5; 2). Virgül + boşluk da öğe ayırıcısıdır (1, 3, 20). Boşluksuz 1,3,20 okunamaz ve çalıştırma "sayı listesi okunamadı" iletisiyle durur (190–196). Matrislerde satırlar | ile ayrılır; matris kare ve simetrik olmalıdır (200–206).
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Geçersiz kaynak, aile tipi, yoğunluk yöntemi, indeks birimi | "Geçersiz …" | 229–240 |
| r 0–1 dışında; oranlar (0{,}1] dışında; L<0; \alpha (0{,}1) dışında | "… arasında olmalı" | 233, 236, 242–243 |
| Veri kipi: veri yok; özellik ya da aile seçilmemiş | "Önce … veri açın (ya da … 'Elle' seçin)." / "… seçilmeli." | 248–250 |
| Özellik, aile, blok aynı sütun; özellik sayısal değil | "birbirinden farklı olmalı" / "sayısal olmalı" | 253–254 |
| 6'dan az eksiksiz gözlem; 3'ten az aile; her aileden tek gözlem; sabit özellik | "En az 3 aile gerekli …" | 264–268 |
| Elle kip: negatif varyans; toplam sıfır; aile sayısı < 1 ya da büyüklük < 2 | "… girilmeli" | 319–322 |
| Fenotipik varyans sıfır; aile içi fenotipik varyans ≤ 0 | "hesaplanamaz" | 338, 360 |
| Ağırlık ya da istenen kazanç sayısı özellik sayısına eşit değil; hepsi sıfır | "… eşit olmalı" / "hepsi sıfır olamaz" | 386–387, 413–414 |
| \mathbf P tekil; kısıt çözülemiyor; bütün özellikler kısıtlı; \mathbf G tekil (istenen kazanç) | "tekil …" | 388, 401, 405, 415 |
| Elle matrisler: kare değil, simetrik değil, boyutları farklı, 2×2'den küçük | "kare matris olmalı" … | 202–203, 464–465 |
Notlar ve uyarılar (durdurmaz): eksik değerli satırların atılması (259); tek düzeyli blok (264); hücre başına tek gözlemde blok × aile'nin hatayla birleşmesi (274); eşit olmayan aile büyüklüğünde harmonik ortalama (275); aile varyansı anlamlı değil (344); aile varyansı sınırda, bu özellikte genetik korelasyon, ilişkili tepki ve indeks hesaplanamaz (346); h^2>1 (347); \lvert r_A\rvert>1 (440); \mathbf G pozitif tanımlı değil (390); ağırlık verilmedi (386); genetik varyansı sıfır olan özelliklerin indeksten çıkarıldığı (459) ya da indeksin hesaplanmadığı (457); kısıtlanan özellik seçili değil (400).
Eksik değer: bütün özelliklerde, ailede ve blokta eksiksiz satırlar kullanılır (257–260).
89.3 Örnek veri
seleksiyon_kazanci_dol_denemesi.csv yapay, dengeli bir yarım kardeş döl denemesidir: 60 aile × 4 blok × parsel başına 5 ağaç = 1200 satır, eksik değer yok.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
aile |
Aile | kategorik (60 düzey) | A01–A60; her aileden 20 ağaç. |
blok |
Blok | kategorik (4 düzey) | B1–B4. |
agac |
kullanılmaz | sayısal | Parsel içi sıra. |
boy |
Seleksiyon özelliği | sayısal | Ortalama 446,56. |
cap |
Ek özellik | sayısal | Ortalama 80,33. |
govde |
Ek özellik | sayısal | Gövde düzgünlüğü puanı; ortalama 3,532. |
Düzey sırası sonucu etkilemez. Özelliklerin sırası ise önemlidir: ana özellik birinci, ek özellikler seçildikleri sırayla gelir; ekonomik ağırlıklar ve istenen kazançlar bu sırayla eşlenir.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) yoğunluk burrows ve kesin; (3) indeks birimi birey ve ebeveyn; (4) tam kardeş, p_f=0{,}1, p_w=0{,}05; (5) r=1/3; (6) bloksuz, tek özellik; (7) 230 ağacı silinmiş dengesiz veri; (8) aile etkisi olmayan rastgele bir ek özellik; (9) elle kip: \sigma^2_f=25, \sigma^2_e=375, 50 aile × 20; elle h^2; elle \mathbf P ve \mathbf G; (10) satırları karıştırılmış veri; (11) hatalı yazılmış ağırlık listesi.
89.4 Yöntem: formüller ve hesap adımları
Sıra: (1) her özellik ve her özellik çiftinin toplamı için REML; aile, blok × aile ve hata (ko)varyans matrisleri; (2) türetilmiş matrisler ve kalıtım dereceleri; aile varyansının olabilirlik oranı testi; (3) seleksiyon yoğunlukları; (4) ana özellik için altı seleksiyon türü ve Lush indeksi; (5) ilişkili tepkiler; (6) çok özellikli indeksler; (7) kazanç–çeşitlilik tablosu.
89.4.1 Varyans bileşenleri ve türetilmiş büyüklükler
- b_j: blok, sabit; f_i\sim N(0,\sigma^2_f): aile; (fb)_{ij}\sim N(0,\sigma^2_{fb}): blok × aile (parsel); e: parsel içi hata.
- Parsel terimi yalnız blok × aile hücresinde birden çok gözlem varsa ayrı kestirilir (273).
- r: aile içi akrabalık katsayısı (yarım kardeş ¼, tam kardeş ½; elle verilebilir). Bölüm 79'daki çarpan k=1/r'dir.
- b: blok sayısı; N: aile büyüklüğü (aile başına birey). Eşit değilse harmonik ortalama kullanılır (270).
- h^2: bireysel dar anlamda; h^2_f: aile ortalaması kalıtım derecesi; t: sınıf içi korelasyon.
Çok özellikte aynı matrisler kovaryanslarıyla kurulur; kovaryanslar toplam yöntemiyle bulunur (298–303; Bölüm 80.4.3).
Koddaki tercih
lmer sıkı toleransla çağrılır (nloptwrap, xtol_abs = 1e-12; 278–279); uyarı ve iletiler bastırılır (283). Her özellik önce kendi standart sapmasına bölünür, bileşenler sonra geri ölçeklenir (290, 305): kovaryans üç REML çözümünün farkı olduğundan ölçekleri çok farklı özelliklerde sayısal kararlılık sağlar. Satır 331–333: SA <- Sf / r_ak, SP <- Sf + Sfb + Se, SPa <- Sf + Sfb / bsay + Se / Nh. Bu şablon bileşenlerin standart hatasını hesaplamaz.
Aile varyansının testi. H_0:\sigma^2_f=0 için REML olabilirlik oranı:
- İki modelin sabit etkileri aynıdır (blok); REML olabilirlikleri bu yüzden karşılaştırılabilir.
- ½ çarpanı: sıfır, varyansın parametre uzayının sınırındadır; \Lambda'nın dağılımı \tfrac12\chi^2_0+\tfrac12\chi^2_1 karışımıdır (Self ve Liang, 1987; Stram ve Lee, 1994).
p>\alpha ise şablon kazanç kestirimlerinin güvenilmez olduğunu uyarıyla bildirir, hesabı sürdürür (344).
89.4.2 Seleksiyon yoğunluğu
- i_\infty: sonsuz büyük bir aday kümesinden en iyi p oranı seçildiğinde seçilenlerin standart normal ortalaması; \varphi, \Phi standart normal yoğunluk ve dağılım işlevi.
- i_B: Burrows'un (1972) sonlu örneklem yaklaşımı; N aday sayısı.
- i_{n:N}: kesin değer; N adaydan en iyi n tanesinin sıra istatistiklerinin beklenen değerlerinin ortalaması.
Sonlu örneklemde yoğunluk neden daha küçük?
En iyi %20'yi seçmek, 20 adaydan en iyi 4'ü seçmek demekse, bu dördün beklenen ortalaması sonsuz bir popülasyonun en iyi %20'sinin ortalamasından düşüktür: küçük örneklemde uç değerler daha az uçtadır. Fark aday sayısı azaldıkça büyür: 60 aileden 12'si için 1,376 (sonsuz: 1,400), 20 ağaçtan 4'ü için 1,332.
Varsayılan sonsuz popülasyon değeridir
yogunluk = sonsuz iken aile içi seçimde de i_\infty kullanılır; örnek veride bu, kesin değere göre aile içi kazancı %5 yüksek gösterir. Yoğunluk tablosu üç değeri de her zaman yan yana yazar; hangisinin kullanıldığı i_kullanilan sütunundadır. Küçük ailelerde kesin seçilir. Deneme verisinde (örnek ayar, 20 adaydan 4) kesin seçildiğinde aile içi yoğunluk 1,3998'den 1,3318'e iner ve i'ye orantılı bütün kazançlar buna göre değişir: aile içi 19,743 → 18,783, aile 20,471 → 20,128, bireysel 39,743 → 39,657, ebeveyn 35,601 → 35,005, Lush indeksi 43,770 → 43,676; iki aşamalı kazanç 40,214 → 38,912'dir. Seçenek kapalıyken (sonsuz, varsayılan) sonuçlar yukarıdakilerdir; kesin yoğunluk ayrı bir Python betiğinde sıra istatistiği integralinden bağımsız hesaplanmış ve her üç yoğunluk satırında (\pm 2\cdot10^{-6}) aynı bulunmuştur.
Koddaki tercih
Kesin değer tek bir integralle hesaplanır: i=\frac Nn\int x\varphi(x)\,P\big[\text{Bin}(N-1,\,1-\Phi(x))\le n-1\big]dx (212–216); bu, yukarıdaki toplamın kapalı yazımıdır. Seçilen birey sayısı n=\max(1,\ \lfloor pN+0{,}5\rfloor)'tir (yarım yukarı yuvarlanır, 186, 217); Burrows ve kesin değerler gerçekleşen oran n/N ile, sonsuz değer girilen p ile hesaplanır (219–222). Üç aşama: aileler (N = aile sayısı), aile içi (N = yuvarlanmış aile büyüklüğü), toplam (p=p_f\,p_w, N = toplam birey) (351–353).
89.4.3 Seleksiyon türleri
Ana özellik için (Falconer ve Mackay, 1996, 13. bölüm). C_f=\sigma^2_A\big(r+\tfrac{1-r}{N}\big) aile ortalaması ile bireyin ıslah değeri arasındaki kovaryans, C_w=\sigma^2_A-C_f aile içi sapmanınki, V_w=\sigma^2_P-\operatorname{Var}(\bar P_f) aile içi sapmanın varyansı olsun.
| Yöntem | Seçim ölçütü | Kazanç | Yoğunluk |
|---|---|---|---|
| Bireysel | Bireyin kendi fenotipi | i_t\,\sigma^2_A/\sigma_P | toplam oran |
| Aile | Aile ortalaması; ailenin bütün bireyleri | i_f\,C_f/\sqrt{\operatorname{Var}(\bar P_f)} | aile oranı |
| Aile içi | Bireyin aile ortalamasından sapması | i_w\,C_w/\sqrt{V_w} | aile içi oran |
| İki aşamalı | Önce aileler, sonra içlerinden bireyler | aile + aile içi kazançlarının toplamı | i_f, i_w |
| Birleşik indeks (Lush) | I=b_w(P-\bar P_f)+b_f\bar P_f | i_t\sqrt{C_f^2/\operatorname{Var}(\bar P_f)+C_w^2/V_w} | toplam oran |
| Ebeveyn (geriye dönük) | Ebeveynin döl ortalaması | i_f\,\tfrac12\sigma^2_A/\sqrt{\operatorname{Var}(\bar P_f)} | aile oranı |
- Her kazanç "yoğunluk × (ölçüt ile ıslah değeri arasındaki kovaryans) / (ölçütün standart sapması)" biçimindedir; bu oran, ölçütün doğruluğu ile \sigma_A'nın çarpımıdır. Tablodaki
dogruluksütunu kazancın i\,\sigma_A'ya oranıdır. - b_w=C_w/V_w, b_f=C_f/\operatorname{Var}(\bar P_f): birleşik indeksin ağırlıkları (363).
goreli_etkinlik: eşit yoğunlukta bireysel seleksiyona oran (373); yoğunluk farkını değil yöntemin doğruluğunu karşılaştırır.- Ebeveyn seleksiyonu yalnız yarım kardeş tipinde yazılır (369): seçilen, döl testine giren ortak ebeveyndir ve ıslah değerinin yarısı döle geçer.
Aile ortalaması neden bazen bireysel seleksiyondan iyidir?
Aile ortalamasında çevre sapmaları birbirini götürür: N büyüdükçe \operatorname{Var}(\bar P_f) aile bileşenine yaklaşır ve ortalama, ailenin genetik değerini doğru yansıtır. Kalıtım derecesi düşükken bireyin kendi fenotipi çok gürültülüdür; aile ortalaması daha doğrudur. Buna karşılık aile seleksiyonu aile içi genetik varyansı (\sigma^2_A(1-r)) hiç kullanmaz. Birleşik indeks iki bilgi kaynağını en iyi ağırlıklarla birleştirir ve her zaman en az ötekiler kadar doğrudur.
Koddaki tercih
Blok ve parsel terimi yokken \operatorname{Var}(\bar P_f)=\sigma^2_P\,(1+(N-1)t)/N olur ve Lush'un (1947) kapalı oranı b_f/b_w=1+\dfrac{N(r-t)}{(1-r)(1+(N-1)t)} elde edilir. Şablon bu oranı değil, genel tanımı kullanır (360–363): blok × aile bileşeni varken aile ortalamasının varyansı \sigma^2_{fb}/b terimini de içerir ve iki ifade ayrılır (örnek veride kapalı oran 2,928, şablonun değeri 2,664). Elle kipte elle_h2 verilirse \sigma^2_A=h^2\sigma^2_P alınır (336); bu, aile varyansında ortak çevre payı olduğu durumlar içindir.
Yüzde kazanç 100\,\Delta G/\bar y, yıllık kazanç \Delta G/L'dir (371–372).
89.4.4 İlişkili tepki
Bir özellik (x) üzerinden seçim, onunla genetik korelasyonlu başka bir özelliği (y) de değiştirir:
- h_x, h_y: bireysel kalıtım derecelerinin karekökleri; r_A: iki özelliğin genetik korelasyonu; \sigma_{P_y}: y'nin fenotipik standart sapması.
- R_y=i\,h_y^2\,\sigma_{P_y}: y doğrudan seçilseydi kazanç. Etkinlik 1'den büyükse dolaylı seçim doğrudan seçimden iyidir.
- Yoğunluk toplam oranın yoğunluğudur (i_t); tablo bireysel seleksiyon içindir (441–447).
89.4.5 Çok özellikli seleksiyon indeksleri
Amaç, toplam genotip değeri H=\mathbf a^{\top}\mathbf g'yi en iyi öngören doğrusal ölçüt I=\mathbf b^{\top}\mathbf x'i bulmaktır:
- \mathbf x: seçim biriminde ölçülen özellikler; \mathbf P: bunların fenotipik kovaryans matrisi.
- \mathbf G: ölçülen özellikler ile seçim sonucunda aktarılacak ıslah değerleri arasındaki kovaryans; \boldsymbol\Sigma_A: ıslah değerlerinin kovaryans matrisi.
- \mathbf a: ekonomik ağırlıklar (özellik birimi başına değer); \mathbf b: indeks katsayıları (Smith, 1936; Hazel, 1943).
- \Delta H: toplam değerdeki kazanç; \Delta\mathbf G: özellik başına kazanç; r_{IH}: indeksin doğruluğu.
| Seçim birimi | \mathbf P | \mathbf G | Yoğunluk |
|---|---|---|---|
| Aile ortalaması (döl seleksiyonu) | \operatorname{Var}(\bar{\mathbf P}_f) | \boldsymbol\Sigma_A\big(r+\tfrac{1-r}{N}\big) | i_f |
| Aile ortalaması (ebeveyn seleksiyonu) | \operatorname{Var}(\bar{\mathbf P}_f) | \tfrac12\boldsymbol\Sigma_A | i_f |
| Birey | \boldsymbol\Sigma_P | \boldsymbol\Sigma_A | i_t |
Kısıtlı indeks (Kempthorne ve Nordskog, 1959): seçilen özelliklerde genetik değişim sıfır olacak biçimde en iyi indeks. \mathbf C kısıtlanan özellikleri seçen sütun matrisi olmak üzere:
İstenen kazanç indeksi (Pesek ve Baker, 1969): ekonomik ağırlık yerine özellikler arası kazanç oranları verilir:
- \mathbf d: istenen kazançlar; yalnız oranları önemlidir. Gerçekleşen kazanç \mathbf d ile orantılıdır, ama büyüklüğü yoğunluğa ve varyanslara bağlıdır; \mathbf d'nin kendisi değildir.
Genetik kovaryans matrisi pozitif tanımlı değilse
\boldsymbol\Sigma_A kestirimi üç REML çözümünün farkından geldiği için az ailede pozitif tanımlı olmayabilir (\lvert r_A\rvert>1). Şablon matrisi düzeltmez ("bükme" uygulamaz), uyarı yazar ve hesabı sürdürür (390). Bu durumda indeks katsayıları ve öngörülen kazançlar güvenilmezdir; özellik sayısı azaltılır ya da literatür değerleri elle girilir.
Koddaki tercih
Elle kipte tek özellik çözümlenir; indeks için \mathbf P ve \mathbf G doğrudan girilebilir (462–471). Bu durumda \boldsymbol\Sigma_A yerine de \mathbf G kullanılır (471): r_{IH} yalnız birim "birey" ise tam anlamıyla doğruluktur. Kısıtlı indekste kısıtlanan özelliğin kazancı tabloda tam 0 yazılır (426).
89.4.6 Kazanç–çeşitlilik dengesi
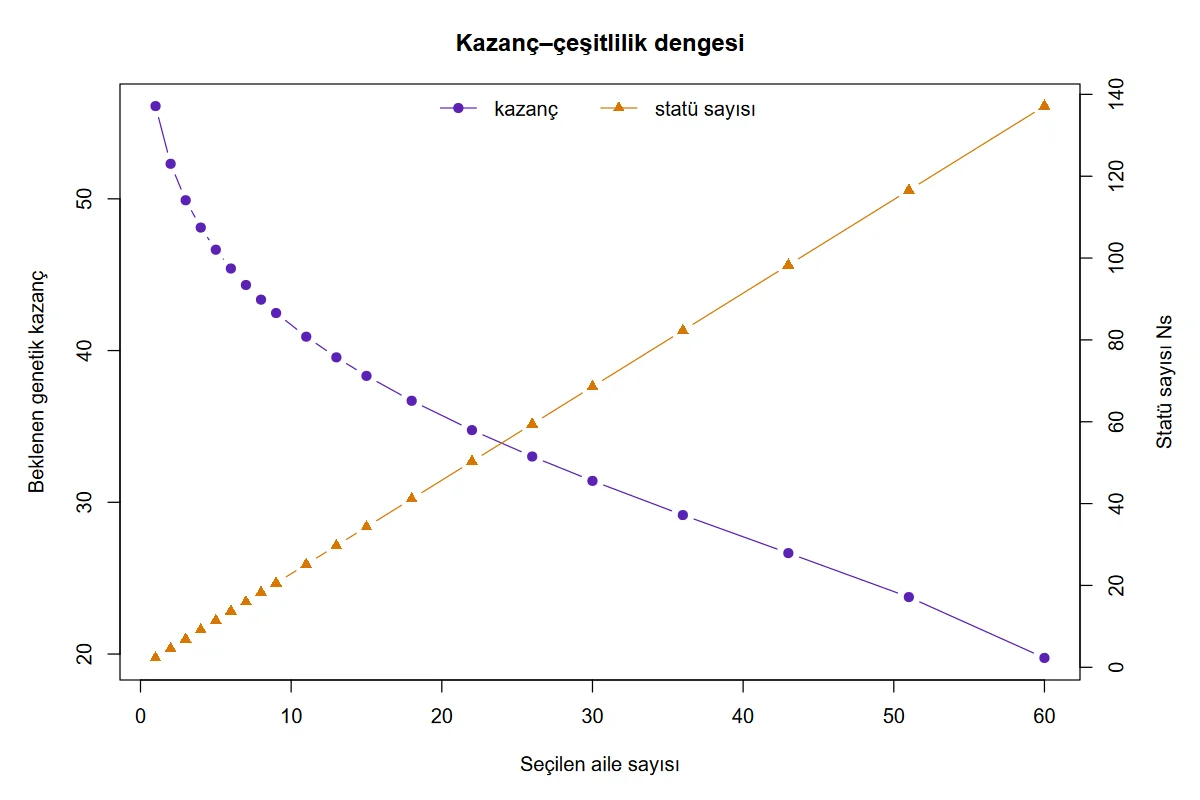
Daha az aile seçmek kazancı artırır, ama seçilenler birbirine daha akraba olur. Şablon, seçilen aile sayısı s için iki aşamalı kazancı ve statü sayısını hesaplar (Lindgren ve Mullin, 1997):
- m: her aileden seçilen birey sayısı (\max(1,\ \text{yuvarla}(p_w N)); sabit); M: seçilen toplam birey.
- \Theta: grup akrabalığı; seçilenlerden yerine koyarak çekilen iki alelin soydan özdeş olma olasılığı. Bireyin kendisiyle ortak ata katsayısı ½, aynı aileden iki bireyinki r/2, farklı ailelerden bireylerinki 0 alınır.
- N_s: statü sayısı; aynı grup akrabalığını verecek akraba olmayan, kendilenmemiş birey sayısı.
Varsayımlar: aileler birbirine akraba değildir ve kurucularda akrabalı yetişme yoktur. Aile sayısı 30'u aşarsa tablo logaritmik aralıklı yaklaşık 25 değer için yazılır (480).
89.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–183 | Üstbilgi ve yirmi dört parametre. | Bölüm 1.2. |
| 184–206 | Yardımcılar: yuvarla (yarım yukarı), sayi_listesi, matris_oku. |
R'nin round() işlevi yarımı çifte yuvarlar; burada kullanılmaz. |
| 208–226 | Üç yoğunluk işlevi ve yogunluk tablosu satırı. |
p=1 için yoğunluk 0. |
| 228–244 | Parametrelerin okunması ve denetimi; r (233–235). | akrabalik = 0 "aile tipine göre" demektir. |
| 246–317 | Veri kipi: sütunlar, eksiksiz satırlar, denetimler, model formülü, ölçekleme, tek özellik ve çift toplamı çözümleri, olabilirlik oranı. | k özellikte k+k(k-1)/2 tam model ve k kısıtlı model. |
| 318–331 | Elle kip: 1×1 matrisler. | Blok × aile bileşeni 0, blok sayısı 1. |
| 333–347 | \boldsymbol\Sigma_A, \boldsymbol\Sigma_P, \operatorname{Var}(\bar{\mathbf P}_f); bileşen tablosu; uyarılar. | |
| 349–355 | Üç aşamanın yoğunlukları. | |
| 357–378 | Seleksiyon türleri tablosu, Lush ağırlıkları, konsol satırı. | Yalnız ana özellik. |
| 380–430 | indeks_bolumu: ağırlıklar, Smith–Hazel, kısıtlı, istenen kazanç; üç tablo. |
|
| 432–476 | Korelasyon ve ilişkili tepki tabloları; indeksin çağrılması; elle matrisli kol; bilgi notları. | |
| 478–508 | Kazanç–çeşitlilik tablosu; iki şekil. |
89.6 Elle hesap: örnek veride bağımsız yeniden hesap
Hesaplar dogrulama/seleksiyon_kazanci/elle_hesap.py (numpy/scipy; Bölüm 79'daki Fisher puanlamalı REML; sıra istatistiklerinin beklenen değerleri her biri kendi yoğunluğuyla tümlenerek) ve r_dogrulama.R (manova kareler ve çarpımlar ortalamaları, integrate, açık matris formülleri) ile yapılmıştır.
Adım 1 — Bileşenler (boy). f=60, b=4, n=5; aile başına N=20.
| Kaynak | sd | KO | Beklenen KO |
|---|---|---|---|
| Aile | 59 | 9985,210 | \sigma^2_e+n\sigma^2_{fb}+nb\,\sigma^2_f |
| Blok × aile | 177 | 4302,417 | \sigma^2_e+n\sigma^2_{fb} |
| Hata | 960 | 3313,914 | \sigma^2_e |
Adım 2 — Türetilmiş büyüklükler.
Olabilirlik oranı: \Lambda=17{,}666, p=\tfrac12P(\chi^2_1>17{,}666)=1{,}3\cdot10^{-5}.
Adım 3 — Yoğunluklar.
| Aşama | p | N | n | i_\infty | i_B | i_{n:N} |
|---|---|---|---|---|---|---|
| Aile | 0,20 | 60 | 12 | 1,399810 | 1,376387 | 1,376379 |
| Aile içi | 0,20 | 20 | 4 | 1,399810 | 1,331773 | 1,331752 |
| Toplam | 0,04 | 1200 | 48 | 2,154344 | 2,149706 | 2,149719 |
i_\infty için: x_{0{,}2}=0{,}8416, \varphi(0{,}8416)=0{,}2800, 0{,}2800/0{,}2=1{,}3998. Aynı işlevler yayımlanmış tabloları verir: p=0{,}05\to2{,}063; 0{,}10\to1{,}755; 0{,}50\to0{,}798; 10 ve 20 adayın en büyüğünün beklenen değeri 1,5388 ve 1,8675 (Harter, 1961).
Adım 4 — Seleksiyon türleri (varsayılan i_\infty).
| Yöntem | Hesap | Kazanç |
|---|---|---|
| Bireysel | 2{,}154344\cdot1136{,}559/61{,}610 | 39,743 |
| Aile | 1{,}399810\cdot326{,}761/\sqrt{499{,}260} | 20,471 |
| Aile içi | 1{,}399810\cdot809{,}798/\sqrt{3296{,}494} | 19,743 |
| İki aşamalı | 20{,}471+19{,}743 | 40,214 |
| Birleşik indeks | 2{,}154344\cdot\sqrt{326{,}761^2/499{,}260+809{,}798^2/3296{,}494} | 43,770 |
| Ebeveyn | 1{,}399810\cdot568{,}279/\sqrt{499{,}260} | 35,601 |
Lush ağırlıkları: b_w=809{,}798/3296{,}494=0{,}2457, b_f=326{,}761/499{,}260=0{,}6545, b_f/b_w=2{,}664. Bireysel kazanç ortalamanın %8,90'ı, 15 yıllık kuşak aralığıyla yılda 2,650 birimdir.
Adım 5 — Korelasyonlar ve ilişkili tepki. Aile kovaryansı (boy, çap): toplam yönteminden 12,0673. \hat r_A=0{,}3021 (boy–çap), -0{,}3602 (boy–gövde), 0{,}0404 (çap–gövde); \hat r_P=0{,}5511; 0{,}0601; 0{,}0105. Çap için CR=2{,}154344\cdot\sqrt{0{,}2994}\cdot\sqrt{0{,}1462}\cdot0{,}3021\cdot\sqrt{153{,}658}=1{,}688; doğrudan kazanç 3,905; etkinlik 0,432. Gövde düzgünlüğü için CR=-0{,}150: boy için seçim gövdeyi bozar.
Adım 6 — İndeksler (birim: aile ortalaması; \mathbf a=(1,\,3,\,20); i=1{,}3998).
| boy | çap | gövde | \sigma_I | \Delta H | r_{IH} | |
|---|---|---|---|---|---|---|
| Smith–Hazel \mathbf b | 0,6340 | 0,7857 | −1,0947 | 15,648 | 21,904 | 0,4020 |
| \Delta\mathbf G | 19,628 | 1,2392 | −0,0721 | |||
| Kısıtlı \mathbf b (\Deltagövde = 0) | 0,5391 | 1,0045 | 17,984 | 14,521 | 20,327 | 0,3731 |
| \Delta\mathbf G | 16,186 | 1,3804 | 0 | |||
| İstenen kazanç \mathbf b (10:2:0{,}1) | 0,0360 | 0,2206 | 3,9034 | 1,7247 | 14,610 | 0,2682 |
| \Delta\mathbf G | 8,1164 | 1,6233 | 0,0812 |
Gövdeyi sabit tutmanın bedeli toplam kazançta %7'dir (21,90 → 20,33). İstenen kazanç indeksinde kazançlar tam 10:2:0{,}1 oranındadır (8{,}1164:1{,}6233:0{,}0812), ama toplam ekonomik kazanç üçte bir düşer. Birim "birey" seçildiğinde Smith–Hazel \Delta H'si ve katsayıları değişir; ebeveyn biriminde \mathbf b aynı oranlarda kalır.
Adım 7 — Kazanç–çeşitlilik. m=4. Altı aile seçilirse M=24, \Theta=(12+0{,}125\cdot6\cdot12)/576=0{,}03646, N_s=13{,}71; iki aşamalı kazanç 45,41. Otuz aile: N_s=68{,}57, kazanç 31,41. Bütün aileler (yalnız aile içi seçim): N_s=137{,}14, kazanç 19,74.
89.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| σ²aile (boy) | 284,13961994 | 284,13965601 | 284,13965601 | 1,3e−7 | ✓ |
| σ²aile (cap) | 5,61687462 | 5,6168749 | 5,6168749 | 5,0e−8 | ✓ |
| σ²aile (govde) | 0,03120321 | 0,03120322 | 0,03120322 | 3,4e−9 | ✓ |
| σ²blok×aile (boy) | 197,70057883 | 197,70060069 | 197,70060069 | 1,1e−7 | ✓ |
| σ²hata (boy) | 3313,91382793 | 3313,9138 | 3313,9138 | 8,4e−9 | ✓ |
| h^2 (boy) | 0,29942891 | 0,29942894 | 0,29942894 | 3,6e−8 | ✓ |
| h^2 (cap) | 0,1462175 | 0,1462175 | 0,1462175 | 7,1e−9 | ✓ |
| h^2 (govde) | 0,1569529 | 0,15695292 | 0,15695292 | 2,0e−8 | ✓ |
| h^2 aile ortalaması (boy) | 0,56912102 | 0,56912105 | 0,56912105 | 2,6e−8 | ✓ |
| Olabilirlik oranı χ² (boy) | 17,66561962 | 17,66561962 | — | 8,4e−11 | ✓ |
| Olabilirlik oranı χ² (cap) | 4,70200923 | 4,70200923 | — | 1,6e−10 | ✓ |
| Olabilirlik oranı χ² (govde) | 6,74949874 | 6,74949874 | — | 3,3e−11 | ✓ |
| Olabilirlik oranı p (cap) | 0,01506369 | 0,01506369 | — | 6,5e−12 | ✓ |
| i sonsuz (aile) | 1,3998096 | 1,3998096 | 1,3998096 | 1,3e−15 | ✓ |
| i Burrows (aile) | 1,37638721 | 1,37638721 | 1,37638721 | 2,3e−15 | ✓ |
| i kesin (aile) | 1,37637879 | 1,37637879 | 1,37637879 | 1,8e−14 | ✓ |
| i sonsuz (aile içi) | 1,3998096 | 1,3998096 | 1,3998096 | 1,3e−15 | ✓ |
| i Burrows (aile içi) | 1,33177314 | 1,33177314 | 1,33177314 | 8,3e−16 | ✓ |
| i kesin (aile içi) | 1,33175223 | 1,33175223 | 1,33175223 | 1,5e−15 | ✓ |
| i sonsuz (toplam) | 2,15434435 | 2,15434435 | 2,15434435 | 1,9e−15 | ✓ |
| i Burrows (toplam) | 2,14970643 | 2,14970643 | 2,14970643 | 1,9e−15 | ✓ |
| i kesin (toplam) | 2,14971896 | 2,14971896 | 2,14971896 | 6,8e−13 | ✓ |
| Kazanç: bireysel | 39,74274663 | 39,74275152 | 39,74275152 | 1,2e−7 | ✓ |
| Kazanç: aile | 20,47080962 | 20,47081139 | 20,47081139 | 8,7e−8 | ✓ |
| Kazanç: aile içi | 19,74328919 | 19,74329173 | 19,74329173 | 1,3e−7 | ✓ |
| Kazanç: aile + aile içi (iki aşamalı) | 40,21409881 | 40,21410312 | 40,21410312 | 1,1e−7 | ✓ |
| Kazanç: birleşik indeks (Lush) | 43,77040403 | 43,77040871 | 43,77040871 | 1,1e−7 | ✓ |
| Kazanç: ebeveyn (geriye dönük, döl testi) | 35,60140803 | 35,60141112 | 35,60141112 | 8,7e−8 | ✓ |
| Doğruluk: birleşik indeks | 0,60265608 | 0,6026561 | — | 2,6e−8 | ✓ |
| Göreli etkinlik: aile | 0,79272635 | 0,79272632 | — | 2,9e−8 | ✓ |
| Yüzde kazanç: bireysel | 8,89973689 | 8,89973798 | — | 1,2e−7 | ✓ |
| Yıllık kazanç: bireysel (L=15) | 2,64951644 | 2,64951677 | — | 1,2e−7 | ✓ |
| Lush: b_f/b_w | 2,66426883 | 2,66426861 | 2,66426861 | 8,3e−8 | ✓ |
| Lush: b_w | 0,24565433 | 0,24565436 | — | 3,2e−8 | ✓ |
| r_A (boy, cap) | 0,30206249 | 0,30206237 | 0,30206237 | 1,2e−7 | ✓ |
| r_A (boy, govde) | −0,36018485 | −0,36018517 | −0,36018517 | 3,2e−7 | ✓ |
| r_P (boy, cap) | 0,55106333 | 0,55106333 | 0,55106333 | 4,7e−9 | ✓ |
| İlişkili tepki (cap) | 1,68785889 | 1,68785839 | 1,68785839 | 3,0e−7 | ✓ |
| İlişkili tepki (govde) | −0,15000892 | −0,15000907 | −0,15000907 | 1,5e−7 | ✓ |
| Doğrudan kazanç (cap) | 3,90474031 | 3,9047405 | — | 4,9e−8 | ✓ |
| Smith–Hazel b (boy) | 0,63396116 | 0,6339611 | 0,6339611 | 5,6e−8 | ✓ |
| Smith–Hazel b (cap) | 0,78573826 | 0,78573824 | 0,78573824 | 1,8e−8 | ✓ |
| Smith–Hazel b (govde) | −1,09468768 | −1,09470316 | −1,09470316 | 1,4e−5 | ✗ |
| Kısıtlı indeks b (govde) | 17,98439103 | 17,98440121 | 17,98440121 | 5,7e−7 | ✓ |
| İstenen kazanç b (boy) | 0,03596847 | 0,03596849 | 0,03596849 | 2,0e−8 | ✓ |
| σ_I (smith–hazel) | 15,64753333 | 15,64753295 | 15,64753295 | 2,4e−8 | ✓ |
| ΔH (smith–hazel) | 21,90356741 | 21,90356688 | 21,90356688 | 2,4e−8 | ✓ |
| r_{IH} (smith–hazel) | 0,4020349 | 0,40203491 | 0,40203491 | 6,4e−9 | ✓ |
| σ_I (kisitli) | 14,52146718 | 14,52146351 | 14,52146351 | 2,5e−7 | ✓ |
| ΔH (kisitli) | 20,32728919 | 20,32728406 | 20,32728406 | 2,5e−7 | ✓ |
| r_{IH} (kisitli) | 0,37310268 | 0,3731026 | 0,3731026 | 7,9e−8 | ✓ |
| σ_I (istenen) | 1,72466997 | 1,72467049 | 1,72467049 | 3,0e−7 | ✓ |
| ΔH (istenen) | 14,60950402 | 14,6094996 | 14,6094996 | 3,0e−7 | ✓ |
| r_{IH} (istenen) | 0,26815406 | 0,26815399 | 0,26815399 | 7,0e−8 | ✓ |
| ΔG boy (Smith–Hazel) | 19,62794517 | 19,62794787 | 19,62794787 | 1,4e−7 | ✓ |
| ΔG govde (Smith–Hazel) | −0,07209408 | −0,0720942 | −0,0720942 | 1,2e−7 | ✓ |
| ΔG cap (kısıtlı) | 1,38037344 | 1,38037328 | 1,38037328 | 1,1e−7 | ✓ |
| ΔG govde (istenen kazanç) | 0,08116391 | 0,08116389 | 0,08116389 | 2,5e−8 | ✓ |
| Birim birey: Smith–Hazel b (boy) | 0,33487353 | 0,33487356 | 0,33487356 | 2,4e−8 | ✓ |
| Birim birey: ΔH (Smith–Hazel) | 42,42547933 | 42,42548172 | 42,42548172 | 5,6e−8 | ✓ |
| Birim birey: ΔH (kısıtlı) | 35,20970998 | 35,20969823 | 35,20969823 | 3,3e−7 | ✓ |
| Birim ebeveyn: Smith–Hazel b (boy) | 1,10254114 | 1,10254104 | 1,10254104 | 8,9e−8 | ✓ |
| Birim ebeveyn: ΔH (Smith–Hazel) | 38,09316071 | 38,09315978 | 38,09315978 | 2,4e−8 | ✓ |
| Birim ebeveyn: ΔH (kısıtlı) | 35,35180728 | 35,35179836 | 35,35179836 | 2,5e−7 | ✓ |
| Kazanç–çeşitlilik, 6 aile: kazanç | 45,40815773 | 45,40816249 | — | 1,0e−7 | ✓ |
| Kazanç–çeşitlilik, 6 aile: N_s | 13,71428571 | 13,71428571 | — | 1,0e−15 | ✓ |
| Kazanç–çeşitlilik, 30 aile: kazanç | 31,41154959 | 31,41155314 | — | 1,1e−7 | ✓ |
| Kazanç–çeşitlilik, 30 aile: N_s | 68,57142857 | 68,57142857 | — | 4,1e−16 | ✓ |
| Kesin yoğunluk: bireysel kazanç | 39,65741872 | 39,6574236 | — | 1,2e−7 | ✓ |
| Kesin yoğunluk: iki aşamalı kazanç | 38,91154734 | 38,9115515 | — | 1,1e−7 | ✓ |
| Burrows yoğunluğu: bireysel kazanç | 39,6571876 | 39,65719248 | — | 1,2e−7 | ✓ |
| Burrows yoğunluğu: iki aşamalı kazanç | 38,9119654 | 38,91196956 | — | 1,1e−7 | ✓ |
| Tam kardeş, p = 0,1 × 0,05: aile kazancı | 23,43314084 | 23,43314287 | — | 8,7e−8 | ✓ |
| Tam kardeş: birleşik indeks kazancı | 40,93802871 | 40,93803245 | — | 9,1e−8 | ✓ |
| Tam kardeş: i sonsuz (toplam, p = 0,005) | 2,89194861 | 2,89194861 | — | 3,4e−15 | ✓ |
| Bloksuz: aile kazancı | 23,03445131 | 23,03445059 | — | 3,1e−8 | ✓ |
| Dengesiz veri: σ²aile (boy) | 204,59764369 | 204,59773061 | — | 4,2e−7 | ✓ |
| Dengesiz veri: harmonik N ile i kesin (aile içi) | 1,34700224 | 1,34700224 | — | 1,3e−15 | ✓ |
| Dengesiz veri: birleşik indeks kazancı | 31,70472266 | 31,70473562 | — | 4,1e−7 | ✓ |
| Dengesiz veri: ebeveyn seleksiyonu kazancı | 25,42728948 | 25,42729935 | — | 3,9e−7 | ✓ |
| Elle kip: bireysel | 10,77172175 | 10,77172175 | — | 3,5e−15 | ✓ |
| Elle kip: aile | 6,08440043 | 6,08440043 | — | 1,3e−15 | ✓ |
| Elle kip: aile içi | 5,28416537 | 5,28416537 | — | 3,4e−16 | ✓ |
| Elle kip: birleşik indeks (Lush) | 12,40252453 | 12,40252453 | — | 1,7e−15 | ✓ |
| Elle kip: ebeveyn (geriye dönük, döl testi) | 10,58156597 | 10,58156597 | — | 4,7e−15 | ✓ |
| Elle P ve G: ΔH | 1,33008222 | 1,33008222 | — | 3,3e−16 | ✓ |
| Elle P ve G: r_{IH} | 0,48743613 | 0,48743613 | — | 3,3e−16 | ✓ |
| Elle P ve G: ΔG (2. özellik) | 0,42512122 | 0,42512122 | — | 5,0e−16 | ✓ |
Ölçütü karşılayan: 87/88. Python: Fisher puanlamalı REML (her özellik ve her çiftin toplamı), sıra istatistiklerinin beklenen değerlerinin toplamı, açık matris formülleri. R: manova kareler ve çarpımlar ortalamalarından kapalı biçimli (ko)varyans bileşenleri (dengeli veri), integrate ile sıra istatistikleri, açık formüller. İndeks katsayılarındaki 10⁻⁷ düzeyindeki farklar, kovaryansın üç REML çözümünün farkından hesaplanmasındandır.
89.7 Çıktıyı okuma
Örnek ayarın çıktısı (kısaltılmış; ilk tabloda ortalama, s2_P ve t_sinif_ici, ikincide kazanc_yil sütunları çıkarılmıştır):
Döl denemesi: n = 1200, 60 aile (harmonik ortalama aile büyüklüğü N = 20,0000), 4 blok (sabit), blok×aile rastgele; r = 0,2500; REML (lme4)
Bireysel seleksiyon: ΔG = i·h²·σP = 2,1543 × 0,2994 × 61,6097 = 39,7427

Varyans bileşenleri ve kalıtım dereceleri (σ²A = σ²aile/r; h²aile: aile ortalaması kalıtım derecesi; p: ½χ²₁ REML olabilirlik oranı testi)
ozellik    s2_aile  s2_aile_blok     s2_hata        s2_A       h2  h2_aile   ki_kare        p
    boy 284.139620    197.700579 3313.913828 1136.558480 0.299429 0.569121 17.665620 0.000013
    cap   5.616875     13.039062  135.002134   22.467498 0.146217 0.359440  4.702009 0.015064
  govde   0.031203      0.031931    0.732091    0.124813 0.156953 0.411704  6.749499 0.004689

Seleksiyon türlerine göre beklenen genetik kazanç: boy (goreli_etkinlik: eşit yoğunlukta bireysel seleksiyona oran)
                           yontem oran        i  dogruluk    kazanc  kazanc_yuzde  goreli_etkinlik
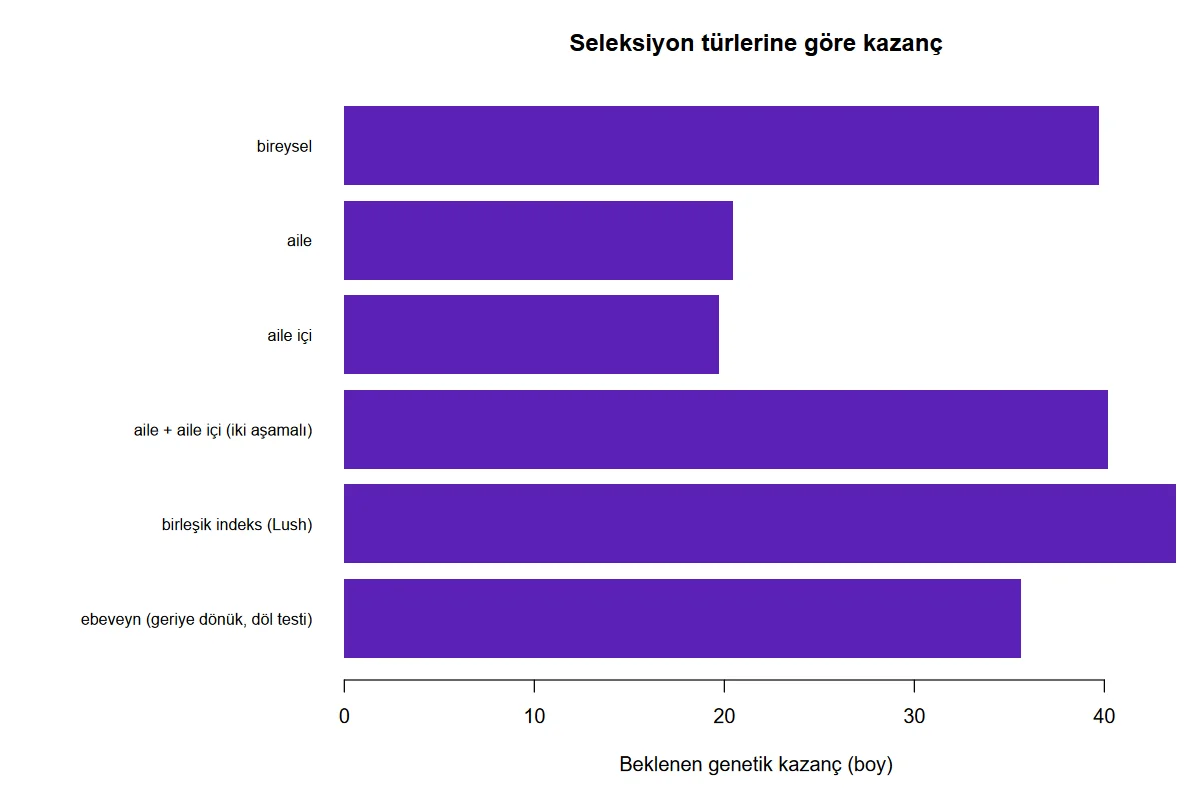
                         bireysel 0.04 2.154344  0.547201 39.742747      8.899737         1.000000
                             aile 0.20 1.399810  0.433781 20.470810      4.584102         0.792726
                         aile içi 0.20 1.399810  0.418364 19.743289      4.421186         0.764553
    aile + aile içi (iki aşamalı) 0.04      NaN       NaN 40.214099      9.005288              NaN
           birleşik indeks (Lush) 0.04 2.154344  0.602656 43.770404      9.801665         1.101343
ebeveyn (geriye dönük, döl testi) 0.20 1.399810  0.754401 35.601408      7.972352         1.378655

İndeks özeti (kazanc_H = i·Cov(I, H)/σI; r_IH: indeksin toplam genotip değeriyle korelasyonu)
                                    indeks    sigma_I         i   kazanc_H      r_IH
                               Smith–Hazel  15.647533  1.399810  21.903567  0.402035
 kısıtlı (Kempthorne–Nordskog; Δgovde = 0)  14.521467  1.399810  20.327289  0.373103
              istenen kazanç (Pesek–Baker)   1.724670  1.399810  14.609504  0.268154
| Tablo | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Varyans bileşenleri | Özellik başına ortalama, üç bileşen, \sigma^2_A, \sigma^2_P, h^2, h^2_f, t, olabilirlik oranı ve p | Aile varyansı anlamlı değilse aşağıdaki bütün kazançlar gürültüdür. |
| Seleksiyon yoğunlukları | Üç aşama için oran, N, n, gerçekleşen oran, üç yoğunluk, kullanılan | Sonsuz ile kesin arasındaki fark küçük ailelerde belirgindir. |
| Seleksiyon türleri | Yöntem başına oran, i, doğruluk, kazanç, yüzde ve yıllık kazanç, göreli etkinlik | Kazanç sütunu farklı yoğunluklar içerir; yöntemlerin kendisi goreli_etkinlik ile karşılaştırılır. İki aşamalı satırda tek bir i ve doğruluk tanımlı değildir. |
| Lush indeksi | b_w, b_f ve oranları | Oran 1'den büyükse aile ortalaması bireyin sapmasından daha çok ağırlık alır. |
| Korelasyonlar | Özellik çiftleri için r_A ve r_P | İşaret farkı (boy–gövde: -0{,}36 ve +0{,}06) fenotipik korelasyonun genetik ilişkiyi gizleyebildiğini gösterir. |
| İlişkili tepki | Ek özellikler için r_A, h, doğrudan kazanç, ilişkili tepki, yüzdesi, etkinlik | Negatif tepki istenmeyen yan etkidir. |
| İndeks katsayıları | Ekonomik ağırlıklar ve her indeksin \mathbf b vektörü | Katsayılar özelliklerin birimine bağlıdır; büyüklükleri doğrudan "önem" değildir. |
| İndeks özeti | \sigma_I, i, \Delta H, r_{IH} | Kısıtlı ve istenen kazanç indekslerinin \Delta H'si Smith–Hazel'den küçüktür; fark kısıtın bedelidir. |
| Özellik başına kazanç | Her indeks için \Delta\mathbf G ve yüzdesi | Asıl okunacak tablo: indeksin her özelliği nereye götürdüğü. |
| Kazanç–çeşitlilik | Seçilen aile sayısına göre yoğunluk, iki aşamalı kazanç, statü sayısı | İki sütun ters yönde değişir; ıslah programının hedef N_s'ine göre nokta seçilir. |
Şekil 89.1. Şablonun çizdiği seleksiyon türlerine göre beklenen kazanç (örnek veri, boy). Çubuklar farklı seleksiyon yoğunluklarını da içerir.
Şekil 89.2. Seçilen aile sayısına göre iki aşamalı kazanç (mor) ve statü sayısı (turuncu). Az aile yüksek kazanç ve düşük çeşitlilik demektir.
Rapor cümlesi:
Altmış yarım kardeş ailesinin dört bloklu döl denemesinde boy için bireysel kalıtım derecesi 0,30, aile ortalaması kalıtım derecesi 0,57 kestirildi (aile varyansı için olabilirlik oranı \chi^2=17{,}67; p<0{,}001). Ailelerin %20'si ve aile içinde bireylerin %20'si seçildiğinde beklenen genetik kazanç bireysel seleksiyonda 39,7 (%8,9), iki aşamalı seleksiyonda 40,2 (%9,0), birleşik indeks seleksiyonunda 43,8 (%9,8) birimdir (sonsuz popülasyon yoğunlukları). Boy, çap ve gövde düzgünlüğü için 1 : 3 : 20 ekonomik ağırlıklı Smith–Hazel indeksi aile ortalamaları üzerinden uygulandığında boyda 19,6, çapta 1,24 birim kazanç ve gövde düzgünlüğünde 0,07 puan kayıp öngörülür.
89.8 Sık hatalar ve tuzaklar
- Kazançları yoğunluklarına bakmadan karşılaştırmak. Bireysel ve birleşik seleksiyon toplam %4, aile ve aile içi seleksiyon %20 oranla hesaplanır. "Bireysel seleksiyon aileden iki kat iyi" sonucu yöntemden değil yoğunluktan gelir; yöntem karşılaştırması için
goreli_etkinlikokunur. - Sonsuz popülasyon yoğunluğunu küçük ailelere uygulamak. 20 ağaçtan 4'ünü seçerken i 1,400 değil 1,332'dir. Varsayılan ayar yayımlanmış tablolarla uyum içindir; gerçek bir deneme için
kesinseçilir. - Seçilen oranı ve sayıyı karıştırmak. Sayı pN'nin yuvarlanmasıyla bulunur; dengesiz veride harmonik ortalama 16,0 olduğunda %20, 3 birey (%18,75) demektir. Yoğunluk tablosundaki
n_secilenveoran_gercekdenetlenir. - Ağırlıkları ve istenen kazançları yanlış sırada vermek. Sıra: ana özellik, sonra ek özellikler formda seçildikleri sırayla. İndeks katsayıları tablosu ağırlıkları özellik adlarıyla yan yana yazar; ilk iş bu tablonun denetimidir.
- Listeyi boşluksuz virgülle yazmak.
1,3,20okunamaz;1; 3; 20yazılır.1,5; 3ise 1,5 ve 3'tür. - Aile varyansı sınırda olan bir özelliği indekse koymak. Aile varyansı sıfıra yakın kestirilen bir özellikte genetik korelasyon tanımsızdır. Şablon bu durumu kendisi ele alır: aile varyansı göreli eşiğin (10^{-8}) altında kestirilen özelliğin aile (ko)varyansları tam sıfıra alınır (307), r_A, ilişkili tepki ve etkinlik o özellik için boş (hesaplanamadı) yazılır (435–436) ve seleksiyon indeksi bu özellik olmadan, kalan özelliklerle kurulur (453–461); ekonomik ağırlık ve istenen kazanç listeleri de o özelliğin payı atılarak okunur. Bir uyarı ve bir not hangi özelliklerin dışarıda kaldığını yazar (346, 459). Ana (ilk) özellik sınırdaysa ya da geriye ikiden az özellik kalırsa indeks hesaplanmaz (457). Aynı özelliğin olabilirlik oranı testi 0'dır ve p=1 yazılır (341).
- İstenen kazanç indeksinden girilen kazançları beklemek.
10; 2; 0,1oran demektir; örnekte gerçekleşen kazançlar 8,12; 1,62; 0,08'dir. - Ekonomik ağırlığı birimden bağımsız sanmak. Ağırlık, özelliğin bir birimlik artışının değeridir; boy santimetreden metreye çevrilirse ağırlığı 100 ile çarpılmalıdır. Aksi hâlde indeks başka bir amaca hizmet eder.
- Tam kardeş ailelerinde r=½ ile dar anlamda kalıtım beklemek. Tam kardeş aile varyansı baskınlık varyansının dörtte birini de içerir; \sigma^2_A=2\sigma^2_f yukarı yanlıdır. Ortak çevre de aynı yönde etkiler; biliniyorsa elle kipte h^2 ayrıca verilir.
- Dengesiz veride sonuçları kesin saymak. Aile büyüklükleri eşit değilse formüllerde tek bir harmonik N ve blok sayısı kullanılır; şablon bunu "yaklaşık" notuyla bildirir. Çok dengesiz veride aile ortalamalarının doğruluğu aileden aileye değişir; BLUP tabanlı sıralama daha uygundur.
- Elle kipte ortalamayı 0 girmek. 0 "verilmedi" anlamına gelir; yüzde kazanç sütunu boş kalır.
- Kazanç–çeşitlilik tablosunu akraba ailelerde kullanmak. Statü sayısı aileleri akrabasız sayar; ortak ebeveynli tam kardeş aileleri ya da ileri kuşak populasyonlarında gerçek çeşitlilik daha düşüktür.
89.9 Uzman soruları
S1. Hangi kalıtım derecesi tanımları ve hangi akrabalık katsayısı kullanılıyor?
İki tanım yazılır: bireysel dar anlamda h^2=\sigma^2_A/\sigma^2_P ve aile ortalaması h^2_f=\sigma^2_f/\operatorname{Var}(\bar P_f) (satır 338). Eklemeli varyans SA <- Sf / r_ak ile bulunur (333); r_ak aile tipinden 0,25 ya da 0,5'tir (235) ya da akrabalik alanından alınır (233). Kazanç formüllerinde aynı r, aile ortalaması ile ıslah değeri arasındaki kovaryansta da görünür: Cf <- sA * (r_ak + (1 - r_ak) / Nh) (360). Ebeveyn seleksiyonunda kovaryans \tfrac12\sigma^2_A'dır (370).
S2. Aile varyansı için neden Wald değil olabilirlik oranı testi ve neden ½?
Varyans bileşeninin kestirimi sıfıra yakınken dağılımı çarpıktır; Wald z'si gücünü yitirir. Olabilirlik oranı daha güvenilirdir, ama sıfır hipotezi parametre uzayının sınırındadır: veri sıfır hipotezi altında üretilse kestirimlerin yarısı tam sıfıra düşer ve \Lambda=0 olur. Dağılım \chi^2_0 ve \chi^2_1'in eşit ağırlıklı karışımıdır; \Lambda>0 için p değeri \chi^2_1 kuyruğunun yarısıdır (341). Şablon \Lambda=0 olduğunda p=1 yazar (karışımın kuyruk olasılığı 1'dir); bu durumda aile etkisine dair hiçbir kanıt yoktur.
S3. İki aşamalı seleksiyon ile birleşik indeks neden farklı?
İki aşamalı seçim iki ayrı kesim uygular: önce en iyi aileler, sonra her birinin içinde en iyi bireyler. Birleşik indeks tek bir ölçütle bütün bireyleri sıralar; ortalama bir ailenin çok iyi bir bireyi, iyi bir ailenin ortalama bireyinin önüne geçebilir. Aynı toplam oranda birleşik indeksin beklenen kazancı en yüksektir (örnekte 43,8'e karşı 40,2). Bedeli çeşitliliktir: indeks en iyi ailelerden daha çok birey seçme eğilimindedir. İki aşamalı kazancın "toplam" olarak yazılması, iki aşamanın yaklaşık bağımsız olduğu varsayımına dayanır.
S4. Ebeveyn seleksiyonu neden döl seleksiyonundan bu kadar yüksek kazanç veriyor?
Döl testi ebeveynin ıslah değerini 20 dölün ortalamasıyla ölçer; doğruluk \tfrac12\sigma_A/\sqrt{\operatorname{Var}(\bar P_f)}=0{,}754'tür. Aile seleksiyonunda ise seçilen, dölün kendisidir; aile ortalaması dölün ıslah değerinin yalnız aileye ortak kısmını öngörür (doğruluk 0,434). Geriye dönük seçimde seçilen ebeveynlerin tohum bahçesinde yeniden çaprazlanması gerekir; kuşak aralığı ve uygulama farklıdır. Şablon iki satırı aynı yoğunlukla (i_f) yazar; karşılaştırma bu varsayımla okunur.
S5. Burrows yaklaşımı ne kadar iyi?
Çok iyidir: örnekte kesin değerle farkı 60'tan 12 için 8\cdot10^{-6}, 20'den 4 için 2\cdot10^{-5}'tir. Yaklaşım, sonsuz popülasyon değerinden seçilen ortalamanın örnekleme varyansına dayalı bir düzeltme çıkarır. Çok küçük kümelerde (N<10) ve çok küçük oranlarda hata büyür; şablon kesin değeri de verdiği için Burrows seçeneği yalnız yayımlanmış sonuçları yeniden üretmek için gereklidir.
S6. Smith–Hazel indeksinde \mathbf G neden seçim birimine göre değişiyor?
\mathbf b=\mathbf P^{-1}\mathbf G\mathbf a ifadesinde \mathbf G, ölçüt ile hedef arasındaki kovaryanstır. Ölçüt aile ortalaması, hedef aynı ailenin bir bireyinin ıslah değeri ise kovaryans \boldsymbol\Sigma_A(r+(1-r)/N)'dir; hedef ebeveynin dölüne aktaracağı değerse \tfrac12\boldsymbol\Sigma_A; ölçüt bireyin kendi fenotipiyse \boldsymbol\Sigma_A. Aile ve ebeveyn birimlerinde \mathbf G aynı matrisin katları olduğundan \mathbf b'nin yönü aynıdır, yalnız kazanç ölçeği değişir. Birey biriminde \mathbf P de değiştiği için katsayıların oranları farklıdır.
S7. Kısıtlı indeks ile ekonomik ağırlığı sıfır yapmak aynı şey mi?
Hayır. Ağırlığı sıfır yapmak "bu özelliğin değeri umurumda değil" demektir; özellik öteki özelliklerle genetik korelasyonu yüzünden yine değişir (ilişkili tepki). Kısıt "bu özellik değişmesin" der ve indeks katsayılarını buna göre ayarlar. Örnekte gövde düzgünlüğünün ağırlığı 20 iken bile Smith–Hazel indeksi onu 0,07 puan düşürür, çünkü boy ile negatif genetik korelasyonludur; kısıtlı indeks gövdeye büyük pozitif katsayı (17,98) vererek değişimi sıfırlar.
S8. Satır sırası ya da en iyileyici sonucu değiştirir mi?
Bileşenler ve kazançlar yedinci anlamlı basamağa kadar kararlıdır. İndeks katsayıları daha duyarlıdır: kovaryanslar üç REML çözümünün farkıdır ve küçük bir kovaryans büyük sayıların farkından çıkar. Satırları karıştırılmış veride indeks katsayıları altıncı basamakta değişti; gövde katsayısının kapalı biçimli çözümden farkı 1{,}4\cdot10^{-5} düzeyindedir. Raporlanan basamaklar etkilenmez.
S9. Statü sayısı etkili popülasyon büyüklüğü müdür?
Yakın ama aynı değil. Statü sayısı, seçilmiş grubun o andaki grup akrabalığını akrabasız birey sayısına çevirir; gelecek kuşakların akrabalı yetişme hızını öngören etkili büyüklükten farklı olarak yalnız bugünkü gen havuzunu özetler. Her aileden bir birey seçilirse N_s aile sayısına eşittir; aynı aileden çok birey seçmek N_s'i birey sayısından yavaş artırır (örnekte 24 birey için 13,7).
89.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Becker, W. A. (1984). Manual of quantitative genetics (4th ed.). Academic Enterprises.
- Burrows, P. M. (1972). Expected selection differentials for directional selection. Biometrics, 28(4), 1091–1100. https://doi.org/10.2307/2528642
- Falconer, D. S., & Mackay, T. F. C. (1996). Introduction to quantitative genetics (4th ed.). Longman.
- Harter, H. L. (1961). Expected values of normal order statistics. Biometrika, 48(1–2), 151–165. https://doi.org/10.1093/biomet/48.1-2.151
- Hazel, L. N. (1943). The genetic basis for constructing selection indexes. Genetics, 28(6), 476–490. https://doi.org/10.1093/genetics/28.6.476
- Kempthorne, O., & Nordskog, A. W. (1959). Restricted selection indices. Biometrics, 15(1), 10–19. https://doi.org/10.2307/2527598
- Lindgren, D., & Mullin, T. J. (1997). Balancing gain and relatedness in selection. Silvae Genetica, 46(2–3), 124–129.
- Lush, J. L. (1947). Family merit and individual merit as bases for selection. Part I. The American Naturalist, 81(799), 241–261. https://doi.org/10.1086/281520
- Pešek, J., & Baker, R. J. (1969). Desired improvement in relation to selection indices. Canadian Journal of Plant Science, 49(6), 803–804. https://doi.org/10.4141/cjps69-137
- Self, S. G., & Liang, K.-Y. (1987). Asymptotic properties of maximum likelihood estimators and likelihood ratio tests under nonstandard conditions. Journal of the American Statistical Association, 82(399), 605–610. https://doi.org/10.1080/01621459.1987.10478472
- Smith, H. F. (1936). A discriminant function for plant selection. Annals of Eugenics, 7(3), 240–250. https://doi.org/10.1111/j.1469-1809.1936.tb02143.x
- Stram, D. O., & Lee, J. W. (1994). Variance components testing in the longitudinal mixed effects model. Biometrics, 50(4), 1171–1177. https://doi.org/10.2307/2533455