69. Dizi uzaklıkları ve filogeni
Şablon kimliği: dizi_filogeni · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/dizi_filogeni.R (satır 1–396; üstbilgi 1–136) · Örnek veri: _ornek/primatlar_dna.csv · Paketler: ape 5.8-1, phangorn 2.12.1
69.1 Ne işe yarar
Şablon, hizalanmış DNA dizilerinden soy ağacı kurar ve cevapladığı soru şudur: "Bu diziler hangi dallanma sırasıyla ortak atalardan ayrılmıştır ve her dallanmayı veri ne ölçüde destekliyor?" Tek çalıştırmada dört iş yapılır: (1) dizi çiftleri arasındaki evrimsel uzaklıklar; (2) bu uzaklıklardan komşu birleştirme (NJ) ağacı ve bootstrap destekleri; (3) yerine koyma modelinin bilgi ölçütleriyle seçimi; (4) seçilen modelle en çok olabilirlik (ML) ağacı ve destekleri.
ML ağacı, verinin olabilirliğini en büyük yapan topoloji, dal uzunlukları ve model parametreleridir:
- \mathbf x_j: hizalamanın j. konumunda dizilerin taşıdığı bazlar (bir sütun).
- T: ağacın topolojisi (dallanma düzeni); \boldsymbol t: dal uzunlukları (konum başına beklenen yerine koyma sayısı); \boldsymbol\theta: yerine koyma modelinin parametreleri.
- L: hizalamadaki konum sayısı; konumlar birbirinden bağımsız ve aynı süreçle evrimleşmiş sayılır.
Ne zaman kullanılır? Aynı bölgenin hizalanmış dizileri varsa ve türlerin ya da bireylerin akrabalık ağacı isteniyorsa; Bayesçi bir çözümlemeden önce yerine koyma modeli seçilecekse; iki ayrı yöntemin (uzaklık ve olabilirlik) aynı dallanmayı verip vermediği görülecekse.
Ne zaman kullanılmaz?
- Diziler hizalanmamışsa: önce
dizi_hizalama(Bölüm 70). - Sonsal olasılıklı ağaç ve yakınsama ölçütleri isteniyorsa:
bayes_filogeni(Bölüm 67). - Tür içi, birbirine çok yakın haplotiplerin ilişkisi isteniyorsa (ağaç yerine ağ):
haplotip_agi(Bölüm 77). - Soru popülasyonların ayrışması ise:
dizi_amova(Bölüm 68); barkod dizilerinden tür sınırı ise:barkod_tur_sinirlandirma(Bölüm 66). - Veri genotip tablosuysa (mikrosatellit, SNP):
genetik_uzaklik(Bölüm 74). - Protein dizileri, kodon modelleri, genlere ayrı model (bölümlenmiş çözümleme) ya da 300'den çok dizi: şablonun kapsamı dışındadır.
Temel programla ilişki. Temel programda dizi verisi okuyan bir analiz yoktur. Temel programdaki hiyerarşik kümeleme bir uzaklık matrisinden ağaç çizer, ama evrimsel model düzeltmesi, NJ, bootstrap desteği ve olabilirlik yoktur.
69.2 Şablonun girdileri
Form, üstbilgideki on sekiz [[param]] bloğundan kurulur (dizi_filogeni.R:11–135).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Dizi sütunu (hizalanmış DNA) · dizi |
sütun · Değişkenler | ilk sütun | metin sütunu | Diziler büyük harfe çevrilir, boşluklar atılır, matrise açılır (147–150, 172). |
Tür/birey adı · kimlik |
sütun · Değişkenler | boş | boş olabilir | Ağaç uçlarının adı; boşsa S1, S2, … (151–152, 171). |
Grup/popülasyon · populasyon |
kategorik sütun · Değişkenler | boş | boş olabilir | Yalnız uç renkleri ve gösterge (153, 157–160, 197–202). |
Uzaklık modeli (NJ ağacı) · uzaklik |
seçim · Model | K80 |
raw, JC69, K80, F81, K81, F84, T92, logdet, TN93 |
ape::dist.dna(model =) (238, 246, 256). |
Uzaklıkta gama oran farklılığı · gama |
onay · Model | kapalı | açık, kapalı | Açıksa gamma = α (239–240, 247–256). |
Gama biçim parametresi α (uzaklık) · gama_alfa |
ondalık · Model | 1,0 | 0,05–100 | Yalnız gama açıkken (240). |
Model seçiminde denenecek modeller · modeller |
seçim · Model | genis |
genis, temel, yok |
Aday küme; yok ise model seçimi ve ML ağacı yapılmaz (274–279). |
Model seçim ölçütü · olcut |
seçim · Seçenekler | BIC |
BIC, AIC, AICc |
En iyi model bu sütunun en küçüğüdür (288–289). |
ML ağaç araması · arama |
seçim · Model | stokastik | stokastik, ratchet, nni |
Arama yöntemi ve destek türü; stokastik ve ratchet aramalarında birkaç bağımsız başlangıç (291–338). |
Bootstrap tekrar sayısı · B |
tamsayı · Seçenekler | 100 | 0–1000 | NJ desteği; ratchet ve NNI kipinde ML desteği de (262–271, 319–323, 334–337). |
Dış grup · dis_grup |
metin · Çıktı | boş | virgülle ayrılmış uç adları | Köklendirme; boşsa orta nokta (205–215). |
Uzaklık ağacı yöntemi · uzaklik_agaci |
seçim · Model | nj |
nj, bionj |
phangorn::NJ ya da ape::bionj (243–245, 259). |
Model seçiminde +Γ modelleri · mt_gama |
onay · Model | açık | açık, kapalı | modelTest(G =) (280). |
Model seçiminde +I modelleri · mt_degismez |
onay · Model | açık | açık, kapalı | modelTest(I =) (280). |
Model seçiminde +F · mt_frekans |
onay · Model | kapalı | açık, kapalı | Yalnız protein modelleri içindir; DNA verisinde etkisizdir, açıksa şablon bunu not olarak yazar ve modelTest'e FREQ = FALSE verir (280, 286; 69.4.6). |
ML'de taban frekanslarını olabilirlikle kestir · ml_frekans_kestir |
onay · Model | kapalı | açık | Açıkken F81, HKY ve GTR'de taban frekansları gözlenen oranlara sabitlenmez, öteki parametrelerle birlikte en çok olabilirlikle kestirilir (pml.control(statefreq = "estimate"); 276–277). Model seçimi, ML araması, bootstrap ve parametre tablosu bu kurala göre yapılır (69.4.6). |
Kesikli gama kategori sayısı (ML) · gama_kategori |
tamsayı · Gelişmiş | 4 | 2–16 | modelTest(k =); +Γ modellerde hız sınıfı sayısı (242, 280). |
Ağaçta gösterilecek en düşük destek (%) · destek_esik |
tamsayı · Çıktı | 50 | 0–100 | Şekilde bu değerin altındaki destekler yazılmaz; Newick metnini etkilemez (241, 227). |
Örnek ayar (ornek_param, satır 9): dizi = dizi, kimlik = tur, populasyon = grup, dis_grup = Mouse; öteki alanlar varsayılandadır.
Dizi sütununun biçimi. Her hücre bir dizidir; izin verilen karakterler A, C, G, T, IUPAC belirsizlik kodları (R, Y, K, M, S, W, B, D, H, V), N, ? ve -'dir. Küçük harf ve hücre içi boşluk kabul edilir. Bütün diziler aynı uzunlukta olmalıdır.
Şablonun kendi denetimleri.
| Koşul | İleti | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 132 |
| ape ya da phangorn kurulu değil | "'…' R paketi kurulu değil." | 133–134 |
| Dizi sütunu boş ya da yok | "Dizi sütunu seçilmeli." / "'…' sütunu yok." | 140–141 |
| 4'ten az dizi | "Filogenetik çözümleme için en az 4 dizi gerekli (… var)." | 155 |
| 300'den çok dizi | "… dizi var; bu şablon en çok 300 diziyle çalışır (süre sınırı). …" | 156–157 |
| DNA dışı karakter | "… dizide DNA dışı karakter var ('…'). Yalnız A, C, G, T, IUPAC belirsizlik kodları, N, ? ve - kullanılabilir." | 158–160 |
| Uzunluklar farklı | "Diziler hizalanmamış: uzunluklar farklı (… ile … arasında). …" | 161–163 |
| Bütün konumlar boşluk ya da eksik | "Bütün konumlar boşluk ya da eksik; çözümlenecek konum yok." | 167 |
| Bütün diziler aynı haplotip ya da değişken konum yok | "Bütün diziler aynı haplotip (birebir aynı ya da yalnız eksik/belirsiz konumlarla ayrışıyor); ayrışan konum olmadığından ağaç kurulamaz." | 187 |
| Bir dizi çiftinin ortak bilinen bazı yok | "'…' ile '…' dizilerinin ikisinde de bilinen baz (A, C, G, T) bulunan hiçbir konum yok; aralarındaki uzaklık tanımsız. …" | 242–248 |
| Dış grup adı dizilerde yok | "Dış grup adı dizilerde yok: …" | 200 |
| Uzaklık bir çift için hesaplanamıyor | "… uzaklığı bazı dizi çiftleri için hesaplanamadı (doygunluk: …). Daha basit bir model (p ya da JC69) seçin …" | 250–251 |
| Model seçimi ya da ML kestirimi başarısız | "Model seçimi başarısız oldu: …" / "ML ağacı kestirilemedi: …" | 276, 284 |
Şablon durmadan not yazdığı durumlar: dizisi boş satırlar atılır (155); grubu eksik diziler "belirsiz" olarak renklendirilir (158–159); yinelenen adlar _1, _2 ekiyle ayrılır (171); bütün dizilerde boşluk ya da eksik olan konumlar çıkarılır (175); birebir aynı ya da yalnız eksik/belirsiz konumlarla ayrışan diziler tek haplotip sayılır ve bildirilir (196); NJ bootstrap'ında p uzaklığına düşen tekrarların sayısı, model seçiminde etkisiz +F ve ML aramasının başlangıç sayısı ile log-olabilirlikleri not olarak yazılır (269, 280, 308, 322–324); gama düzeltmesi tanımlı olmayan uzaklıkta yok sayılır (247–248); dış grup tek soy oluşturmuyorsa orta noktadan köklendirilir (211); ML ağacında alt ya da üst sınıra dayanan dallar bildirilir (362–365).
69.3 Örnek veri
Dosya: _ornek/primatlar_dna.csv. On dört türün (on iki primat, fare ve sığır) 232 bazlık mitokondri DNA hizalaması (Hayasaka ve ark., 1988); phangorn paketindeki primates verisidir.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
tur |
Uç adı | metin | Mouse, Bovine, Lemur, Tarsier, Squir Monk, Jpn Macaq, Rhesus Mac, Crab-E.Mac, BarbMacaq, Gibbon, Orang, Gorilla, Chimp, Human. |
grup |
Grup | kategorik | Dış grup (2), Strepsirrhini (1), Tarsiiformes (1), Yeni Dünya maymunları (1), Eski Dünya maymunları (4), İnsansı maymunlar (5). |
dizi |
Dizi | metin | 232 karakter; A, C, G, T ve bir dizide tek bir -. |
232 konumun 220'sinde en az iki farklı baz vardır; on dört dizinin hepsi farklıdır. Taban bileşimi dengesizdir: A %37,5; C %40,2; G %3,9; T %18,4. Diziler birbirinden çok uzaktır: dizi çiftleri konumların ortalama %46,6'sında, en uzak çift %59,9'unda ayrışır. Bu, verinin öğretici yanıdır: uzak dış gruplarda (fare, sığır) aynı konum birden çok kez değişmiştir ve bunun sonuçları (tanımsız uzaklıklar, sınıra dayanan dallar) çıktıda görülür.
Grup düzeyleri arayüzde ilk görülme sırasıyla gelir; şablon yalnız renk atarken düzeyleri alfabetik sıralar (satır 200). Sıra hesabı etkilemez.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar (2026 tohumuyla); (2) aynı ayar, 7 tohumuyla; (3) ölçüt AIC; (4) arama ratchet; (5) arama nni; (6) temel küme, +Γ ve +I kapalı, ölçüt AIC (stokastik ve NNI); (7) +F açık; (8) model seçimi yok ve uzaklık raw, JC69, TN93, K80 + Γ; BIONJ; dış grup boş; dış grup iki uç; (9) sekiz gama sınıfı; (10) eksik veri eklenmiş, örtüşmeyen iki dizili ve yalnız N ile ayrışan dizili kopyalar.
69.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) dizileri matrise aç, bütünüyle boş konumları at, değişken konumları say; (2) seçilen modelle ikili uzaklıklar; (3) NJ (ya da BIONJ) ağacı ve tutumluluk puanı; (4) konumların yeniden örneklenmesiyle NJ bootstrap destekleri; (5) aday modellerin olabilirlikleri ve bilgi ölçütleri; (6) en iyi modelle ML ağaç araması ve destekler; (7) köklendirme ve çizim.
69.4.1 İkili uzaklıklar
İki dizi arasında, ikisinde de A, C, G ya da T bulunan L_{ij} konum karşılaştırılır. Farklı konumların oranı p'dir; farkların P oranı geçiş (A↔G, C↔T), Q oranı çapraz geçiştir (pürin↔pirimidin); p=P+Q.
- d_p: fark oranı (form: "p uzaklığı"). Aynı konumdaki yinelenen değişimleri saymadığından gerçek değişim sayısını eksik gösterir.
- d_{JC}: Jukes–Cantor; bütün yerine koymalar eşit hızda sayılır. p\ge0{,}75 iken tanımsızdır.
- d_{K80}: Kimura iki parametreli; geçiş ve çapraz geçiş hızları ayrıdır. 1-2P-Q\le0 ya da 1-2Q\le0 iken tanımsızdır.
Öteki seçenekler bunlara taban frekanslarını ekler: F81 (eşit olmayan frekanslar, tek hız), F84 ve T92 (frekanslar ve geçiş/çapraz geçiş ayrımı; T92'de yalnız G + C oranı), TN93 (iki ayrı geçiş hızı), K81 (iki ayrı çapraz geçiş hızı), LogDet (taban bileşimi soylar arasında değişirken de tutarlı kalan determinant tabanlı uzaklık). Gama düzeltmesi konumların farklı hızda evrimleştiğini varsayar; logaritmanın yerini kuvvet alır:
- \alpha: gama dağılımının biçim parametresi; küçük \alpha konumlar arasında büyük hız farkı demektir. \alpha\to\infty iken ifade d_{K80}'e iner.
- Gama düzeltmesi JC69, K80, F81 ve TN93 için tanımlıdır; K81, F84, T92, LogDet ve p uzaklığında şablon not yazarak yok sayar.
Neden varsayılan K80?
Mitokondri DNA'sında geçişler çapraz geçişlerden çok daha sıktır; tek hızlı bir model geçişlerin doygunluğunu göremez. K80 bu ayrımı tek ek parametreyle yapar ve taban frekanslarına gerek duymadığından tanımsız kalma olasılığı frekanslı modellerden düşüktür: örnek veride 91 çiftin hepsinde tanımlıdır; TN93 52 çiftte, F84 31 çiftte tanımsızdır ve şablon bu modellerle durur. Uzaklık modeli yalnız NJ ağacını etkiler; ML ağacının modeli ayrıca seçilir.
Koddaki tercih
ape::dist.dna(dna, model, gamma, pairwise.deletion = TRUE) (satır 256). İkili silme: bir konum, yalnız o çiftteki iki diziden birinde belirsizlik kodu, N, ? ya da - varsa o çiftin hesabından çıkar; her çift kendi L_{ij}'si üzerinden karşılaştırılır. Bu, Bölüm 68'deki şablonun varsayılanından (tam silme) farklıdır. İki dizinin hiç ortak konumu yoksa uzaklık tanımsızdır ve şablon aynı "hesaplanamadı" iletisiyle durur. Uzaklık matrisi 60 diziye kadar tabloya yazılır; daha çok dizide yalnız en küçük, ortanca ve en büyük değer verilir (383–384).
69.4.2 Komşu birleştirme ağacı
NJ, uzaklık matrisinden adım adım ağaç kurar. Her adımda m küme vardır; birleştirilecek çift şu ölçütü en küçük yapan çifttir:
Seçilen i ve j yeni bir düğümde (u) birleştirilir:
- d_{ij}: iki küme arasındaki uzaklık; r_i: i'nin öteki bütün kümelere uzaklıklarının toplamı.
- Q_{ij}: yalnız birbirine yakın olanı değil, ötekilerden birlikte uzak olanı seçen ölçüt; hızlı evrimleşen soyların yanlış yere çekilmesini azaltır.
- \ell_{iu}, \ell_{ju}: yeni düğüme bağlanan iki dalın uzunluğu; d_{uk}: yeni düğümün öteki kümelere uzaklığı.
- Üç küme kalınca üç dalın uzunluğu doğrudan çözülür; ağaç köksüzdür ve 2n-3 dalı vardır.
BIONJ aynı birleştirme sırasını izler, ama yeni uzaklıkları iki dalın eşit ağırlıklı ortalaması yerine uzaklıkların varyansını en küçük yapan ağırlıklarla hesaplar (Gascuel, 1997); uzak dizilerde daha kararlıdır.
Koddaki tercih
phangorn::NJ(D) ya da ape::bionj(D) (satır 245, 252). NJ, uzaklıklar tam toplanır değilse negatif dal uzunluğu üretebilir; şablon negatif dalları 0'a çeker (260). Ağacın tutumluluk puanı phangorn::parsimony ile (Fitch algoritması) hesaplanır (261).
69.4.3 Tutumluluk puanı
Bir ağacın tutumluluk (parsimony) puanı, uçlardaki dizileri o ağaç üzerinde açıklamak için gereken en az değişim sayısıdır. Fitch algoritması her konumda uçlardan köke doğru ilerler:
- S_a, S_b: bir iç düğümün iki çocuğunda olanaklı bazların kümesi; uçta dizinin o konumdaki bazı, belirsizlik kodunda kodun kapsadığı bazlar, boşluk ve eksikte dört bazın hepsi.
- Kesişim boşsa o düğümde en az bir değişim gerekir; puan bütün düğümler ve bütün konumlar üzerinden toplanır.
Puan bir uyum ölçüsüdür: aynı veri için daha düşük puanlı ağaç daha az değişim varsayar. Şablon puanı NJ ve ML ağaçları için yazar; ikisinin karşılaştırılması, iki yöntemin ne kadar farklı ağaçlara vardığını gösteren hızlı bir özet verir.
69.4.4 NJ ağacının bootstrap desteği
Hizalamanın L konumundan yerine koyarak L konum çekilir, yeni hizalamadan uzaklıklar ve ağaç yeniden kurulur; bu B kez yinelenir (Felsenstein, 1985):
- T^{*}_b: b. yeniden örneklemden kurulan ağaç; s: özgün ağacın bir iç dalının tanımladığı bölünme.
- Destek, verideki konumların o dallanmayı ne kadar tutarlı gösterdiğinin ölçüsüdür; dallanmanın doğru olma olasılığı değildir.
Koddaki tercih
phangorn::bootstrap.phyDat(pd, FUN, bs = B) ve plotBS(…, type = "n") (satır 266–268). Bir tekrarda seçilen modelin uzaklığı herhangi bir çift için tanımsız çıkarsa o tekrarın ağacı p uzaklığından kurulur (267). Örnek veride K80 ile 1000 tekrarın 16'sı böyledir; desteklere etkisi en çok 0{,}004'tür. Şablon düşen tekrarların sayısını not olarak yazar (265–271). NJ desteği Newick metnine ve şekle yüzde olarak yazılır (216, 266). Tekrarlar rastgele sayı üretecine bağlıdır: şablon formunda tohum alanı yoktur; tohum Kod panelindeki Tohum alanından verilir (Bölüm 1.3). Alan boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar; kullanılan tohumu künyeye yazar ve betik adımına kaydeder, kayıtlı adım yeniden oynatıldığında aynı destekler elde edilir.
69.4.5 Yerine koyma modelleri ve olabilirlik
Bir yerine koyma modeli, bir bazın küçük bir zaman aralığında ötekilere dönüşme hızlarını veren 4\times4 bir hız matrisidir:
- \pi_y: y bazının durağan frekansı; r_{xy}=r_{yx}: değiştirilebilirlik oranı (altı çift: a↔c, a↔g, a↔t, c↔g, c↔t, g↔t).
- \mathbf Q, ortalama hız 1 olacak biçimde ölçeklenir (-\sum_x\pi_xq_{xx}=1); böylece dal uzunluğu konum başına beklenen yerine koyma sayısıdır.
- \mathbf P(t): t uzunluğundaki bir dalın başındaki bazın sonundaki baza dönüşme olasılıkları.
| Model | Taban frekansları | Oranlar | Model parametresi |
|---|---|---|---|
| JC | eşit | hepsi eşit | 0 |
| F81 | serbest | hepsi eşit | 3 |
| K80 | eşit | geçiş / çapraz geçiş | 1 |
| HKY (Hasegawa ve ark., 1985) | serbest | geçiş / çapraz geçiş | 4 |
| SYM | eşit | altı oran | 5 |
| GTR | serbest | altı oran | 8 |
Her modele iki ek eklenebilir. +Γ: konumların hızı ortalaması 1 olan bir gama dağılımından gelir; dağılım K eşit olasılıklı dilime bölünür ve her dilim ortalamasıyla temsil edilir (Yang, 1994). +I: konumların p_{\text{inv}} oranı hiç değişmez. Bir konumun olabilirliği hız sınıfları üzerinden ortalamadır:
- \rho_c: c. gama diliminin ortalama hızı; dallar bu hızla çarpılır. K: "Kesikli gama kategori sayısı" (varsayılan 4).
- P_0: konum değişmez sayıldığında olabilirlik (bütün dizilerde aynı baz varsa o bazın frekansı, yoksa 0).
- Verilen bir hız için konum olabilirliği Felsenstein'ın (1981) budama algoritmasıyla, uçlardan köke doğru kısmi olabilirlikler çarpılarak hesaplanır; boşluk ve eksik bazlar "dört bazdan herhangi biri" sayılır.
Serbest parametre sayısı 2n-3 dal uzunluğu ile model parametrelerinin toplamıdır: on dört dizide 25 dal; JC 25, HKY + Γ 25+4+1=30, GTR + Γ + I 25+8+2=35 parametre.
Koddaki tercih
Olabilirlik phangorn::pml nesnesiyle hesaplanır. Taban frekansları F81, HKY ve GTR'de en çok olabilirlikle kestirilmez: phangorn'un varsayılanıyla (pml.control(statefreq = "empirical")) hizalamadaki gözlenen frekanslara sabitlenir. Bu üç frekans yine de parametre sayısına katılır. "ML model parametreleri" tablosundaki frekans satırları bu nedenle arama yönteminden ve tohumdan bağımsızdır; tablo başlığı bunu "taban frekansları gözlenen frekanslardır" diye söyler (378). "ML'de taban frekanslarını olabilirlikle kestir" seçeneği açıksa frekanslar kestirilir: model seçimi (modelTest), ML araması ve bootstrap aynı denetim ayarıyla çalışır, konsola "taban frekansları en çok olabilirlikle kestirildi" notu yazılır ve tablo başlığı "taban frekansları kestirimdir (F81, HKY, GTR: en çok olabilirlik; öteki modellerde eşit)" olur. Serbest parametre sayısı iki kipte de aynıdır (üç frekans sayılır). Örnek veride (GTR, NNI araması, AIC ölçütü) ML log-olabilirlik −2615,329'dan −2614,909'a çıkar; frekanslar 0,3748; 0,4016; 0,0391; 0,1845'ten 0,3896; 0,3860; 0,0398; 0,1846'ya geçer. Bu, aynı ağaç topolojisinde ayrı bir R betiğinde (optim.pml, statefreq = "estimate") bulunan en yüksek değerle uyumludur (kestirim, gözlenen frekanslardakinden yüksektir). Oran matrisi g↔t = 1 alınarak yazılır (satır 372–378); HKY ve K80'de a↔g ve c↔t satırları geçiş/çapraz geçiş oranını (\kappa) verir.
69.4.6 Model seçimi
Her aday model aynı başlangıç ağacı üzerinde (topoloji sabit; dal uzunlukları ve model parametreleri eniyilenerek) uydurulur ve üç bilgi ölçütü hesaplanır:
- \ln\mathcal L: modelin en büyük log-olabilirliği; k: serbest parametre sayısı (dallar dâhil).
- L: örneklem büyüklüğü olarak alınan konum sayısı (örnek veride 232).
- w_i: Akaike ağırlığı; aday küme içinde modelin göreli desteği. AICc ağırlıkları aynı formülle AICc'den hesaplanır.
Seçilen ölçütü en küçük yapan model "en iyi model"dir ve ML ağacı bu modelle aranır. Geniş kümede altı temel model (JC, F81, K80, HKY, SYM, GTR), temel kümede dördü (JC, K80, HKY, GTR) denenir; her biri yalın, +I, +Γ ve +Γ+I biçimleriyle (24 ya da 16 model).
Neden varsayılan BIC?
BIC parametre başına cezayı örneklem büyüklüğüyle artırır (\ln232=5{,}45; AIC'de 2) ve daha yalın modeli seçer. Kısa hizalamalarda parametresi çok modellerin kestirimleri oynaktır; yalın model ağaç topolojisi için genellikle yeterlidir. Örnek veride BIC HKY + Γ'yı (30 parametre), AIC ve AICc GTR + Γ'yı (34 parametre) seçer. İki ölçütün ayrışması olağandır ve raporda belirtilir; topoloji çoğu zaman iki modelde de aynıdır.
Koddaki tercih
phangorn::modelTest(pd, model, G, I, FREQ, k) (satır 280). Başlangıç ağacı olarak şablon NJ ağacını verir (285–286); paket kendi başlangıç ağacını kursaydı bu, rastgele bozmalı kısa bir tutumluluk araması (ratchet) olurdu ve tablodaki log-olabilirlikler tohuma göre değişirdi. Sabit başlangıçla model seçimi tohumdan bağımsızdır. "+F" seçeneği paketin amino asit modelleri içindir; DNA verisinde aday kümeyi ve sonucu değiştirmez (taban frekansları zaten gözlenen frekanslardır); açıksa şablon bunu not olarak yazar (280). Tabloya şablon iki sıra sütunu ekler (BIC_sira, AIC_sira).
69.4.7 ML ağaç araması ve destekler
En iyi modelin başlangıç ağacındaki uyumu çıkış noktasıdır; arama, olabilirliği artıran topoloji değişikliklerini dener.
| Arama | Topoloji değişikliği | Destek |
|---|---|---|
| Stokastik (varsayılan) | En yakın komşu değişimleri (NNI); yerel en iyiye varınca ağaç rastgele bozulup yeniden eniyilenir (Nguyen ve ark., 2015) | Ultra hızlı bootstrap, 1000 tekrar |
| Ratchet | NNI; bozma, konumların rastgele yeniden ağırlıklandırılmasıyla (Nixon, 1999) | Standart bootstrap, B tekrar (phangorn'un kendi düğüm etiketleri kullanılmaz; aşağıdaki uyarı) |
| NNI | Yalnız NNI; ilk yerel en iyide durur | Standart bootstrap, B tekrar |
Stokastik ve ratchet aramaları rastgele bozmalara bağlıdır ve tohuma göre farklı yerel en iyilere varabilir. Şablon bu yüzden aramayı 5 bağımsız başlangıçla (dizi sayısı 40'ı aşarsa 3, 100'ü aşarsa 2) yineler ve log-olabilirliği en yüksek ağacı alır; başlangıçların log-olabilirlikleri ve en yükseğin kaç başlangıçta bulunduğu sonuç metnine yazılır (294–311). Destek, seçilen ağaca aittir.
Ultra hızlı bootstrap (Minh ve ark., 2013), her tekrarda ağacı baştan aramaz: arama sırasında karşılaşılan ağaçların konum log-olabilirlikleri saklanır, konumlar yeniden örneklendiğinde her ağacın log-olabilirliği bu saklı değerlerin yeniden ağırlıklı toplamından elde edilir ve en iyi ağaç seçilir. Standart bootstrap her tekrarda modeli ve ağacı yeniden uydurur.
İki destek ölçüsü aynı ölçekte değildir
Standart bootstrap desteği tutucudur: %70 çoğu zaman güçlü destek sayılır. Ultra hızlı bootstrap yaklaşık yansızdır ve %95'in altı güçlü destek sayılmaz (Minh ve ark., 2013). Şablonun şekil başlığı hangi desteğin yazıldığını belirtir; iki ölçünün sayıları birbirine çevrilmez.
Ratchet aramasında destek standart bootstrap'tır
phangorn'un "ratchet" kipinde ağaca yazdığı düğüm etiketleri ultra hızlı bootstrap değerleri değildir: hemen hepsi 1'dir (örnek veride on bir iç düğümün onunda 100, birinde 55; aynı veride tohum 2026'lı stokastik arama makak türlerinin kendi içindeki dallanmalar için %49 ve %56 verir; ultra hızlı bootstrap desteği tohumla da değişir) ve kip bazı başlangıçlarda "argument is of length zero" hatasıyla durur. Şablon bu etiketleri kullanmaz: ratchet aramasının RELL bootstrap'ını kapatır, bulunan ağaç üzerinde bootstrap.pml ile B tekrarlı standart bootstrap çalıştırır ve çıktıya bunu bildiren bir not yazar; B=0 ise ML ağacına destek yazılmaz (294–327). Örnek veride (B=100) ratchet ağacının iç düğüm destekleri %20 ile %100 arasındadır.
Koddaki tercih
Stokastik ve ratchet: phangorn::pml_bb(as.pml(mt, en_iyi), model = en_iyi, rearrangement = …) beş (en çok 40 dizide; 100'e kadar 3, üstü 2) kez çağrılır ve logLik en büyük olan alınır (295–307); bir başlangıç hata verirse atlanır, hepsi verirse şablon durur. Ultra hızlı bootstrap'ın tekrar sayısı paketin sabitidir (1000) ve formdaki B'den bağımsızdır. Ratchet'te ratchet.control(rell = FALSE) verilir (299) ve destek bootstrap.pml(ml, bs = B, optNni = TRUE) ile hesaplanır (316–327). NNI: optim.pml(…, optNni = TRUE, rearrangement = "NNI") ve bootstrap.pml(ml, bs = B, optNni = TRUE) (329–337). Dal uzunlukları paketin sınırları içinde eniyilenir: alt sınır 10^{-8}, üst sınır 10 yerine koyma/konum; sınıra dayanan dal sayıları sonuç metninde not ve uyarı olarak yazılır (358–366). ML desteği Newick metnine ve şekle her aramada yüzde olarak yazılır (yuzdele, 209).
Neden arama tek bir en iyi ağacı garanti etmez?
On dört dizinin \,(2\cdot14-5)!!\approx3{,}16\times10^{11}\, köksüz topolojisi vardır; hepsi denenemez. Sezgisel arama yerel en iyide durabilir ve stokastik arama rastgele bozmalara bağlıdır. Örnek veride beş bağımsız başlangıç dört farklı yerel en iyiye (-2615{,}01; -2615{,}31; -2615{,}39; -2615{,}53) varabilir; şablon beş başlangıçtan en yükseğini alır ve iki farklı tohumla da aynı sonuca (-2615{,}0147) varır (69.6, Adım 8). Yayımlanacak bir ağaç için şablon yeni bir tohumla yinelenir ve en yüksek log-olabilirlikli sonuç alınır.
69.4.8 Köklendirme ve çizim
NJ ve ML ağaçları köksüzdür; kök, çizim ve Newick metni için sonradan konur. Dış grup verilmişse ağaç, dış grubu öteki uçlardan ayıran dalın üzerinden köklendirilir (ape::root(…, resolve.root = TRUE)); dış grup tek soy oluşturmuyorsa ya da hiç verilmemişse en uzak iki ucun tam ortasına kök konur (phangorn::midpoint; satır 208–215). Orta nokta köklendirmesi bütün soyların aynı hızda evrimleştiğini varsayar.
Şekilde uç adları gruba göre renklenir, destek eşiğinin üstündeki değerler düğümlere mor yazılır, altta ölçek çubuğu (konum başına yerine koyma) ve grup göstergesi bulunur. Newick metninde boşluklu adlar alt çizgiyle yazılır (Squir Monk → Squir_Monk); dış grup alanına ise ad sütunundaki yazım girilir.
69.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–136 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on yedi parametre. | Form buradan kurulur (Bölüm 1.2). |
| 137–144 | Dil yardımcısı, paket denetimi, en çok 300 dizi sınırı. | |
| 146–202 | Dizilerin temizlenmesi; adlar ve gruplar; boş satırların atılması; karakter ve uzunluk denetimleri; matris; bütünüyle boş konumların atılması; DNAbin ve phyDat; değişken konum, haplotip ve yinelenen dizi sayımları; renkler. |
Değişken konum yalnız A, C, G, T ile sayılır; haplotip sayımı uyumluluğa göredir: yalnız eksik/belirsiz kodla ayrışan diziler tek haplotip sayılır (181–196). |
| 204–235 | Dış grup denetimi; kokle; temiz; agac_ciz. |
Destek etiketleri yuzdele ile yüzdeye çevrilir (216); şekilde eşiğin altındakiler yazılmaz (227). |
| 237–271 | Uzaklık seçenekleri ve denetimleri; dist.dna; NJ ya da BIONJ; negatif dalların sıfırlanması; tutumluluk; NJ bootstrap. |
Tanımsız uzaklıkta şablon durur; bootstrap tekrarında durmaz, p uzaklığına geçer ve tekrar sayısını not olarak yazar. Ortak bilinen bazı olmayan çift ayrı iletiyle bildirilir (249–255). |
| 273–339 | modelTest (sabit NJ başlangıcıyla); en iyi modelin seçimi; arama yöntemine göre birkaç başlangıçlı pml_bb (ratchet'te ayrıca bootstrap.pml) ya da optim.pml + bootstrap.pml; notlar. |
Model seçimi yok ise bu blok atlanır. |
| 341–366 | Özet tablosu; başlık satırları; sınıra dayanan dalların sayımı. | "Gama biçim parametresi" satırı model adında +G aranarak doldurulur; +Γ içermeyen modellerde boş kalır (350). |
| 367–384 | Tablolar: özet, model seçimi, ML parametreleri, uzaklık matrisi. | |
| 385–396 | Köklendirme; Newick metinleri; iki ağaç şekli. |
69.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/dizi_filogeni/elle_hesap.py ile, ape ve phangorn kullanılmadan hesaplanmıştır: uzaklıklar 69.4.1'deki formüllerden, NJ ağacı 69.4.2'deki adımların doğrudan uygulamasıyla, tutumluluk Fitch algoritmasıyla, log-olabilirlik budama algoritmasıyla. R tarafında (r_dogrulama.R) phangorn kullanılmamış; uzaklıklar ve olabilirlik açık kodla, NJ başka bir uygulamayla (ape::nj) bulunmuştur. ML araması yinelemeli ve rastgele olduğundan yeniden yapılmaz; şablonun bulduğu ağaç ve parametreler girdi alınıp olabilirliği bağımsız hesaplanır.
Adım 1 — Sayımlar. 14 dizi, 232 konum; 220 konumda en az iki farklı baz var; 14 farklı dizi. Squir Monk dizisinin 155. konumu boşluktur; bu konum o dizinin ikili karşılaştırmalarından çıkar (L_{ij}=231), ötekilerde L_{ij}=232'dir.
Adım 2 — Bir çiftin uzaklığı. Chimp ile Human 232 konumun 52'sinde ayrışır: 50 geçiş, 2 çapraz geçiş. P=50/232=0{,}21552; Q=2/232=0{,}00862; p=0{,}22414.
\alpha=2{,}27 ile gama düzeltmeli K80 uzaklığı 0{,}33427'dir. 91 çiftin K80 uzaklıkları 0{,}1047 (Jpn Macaq – Rhesus Mac) ile 1{,}2889 (Lemur – Chimp) arasındadır; ortalama 0{,}805.
Adım 3 — NJ'nin ilk adımı. m=14; en küçük Q_{ij}=-16{,}591 Jpn Macaq – Rhesus Mac çiftindedir (d=0{,}10466; r=8{,}7574 ve 9{,}0899).
On bir adım sonra 25 dallı ağaç tamamlanır; dal uzunlukları toplamı 4{,}2395, en kısa dal 0{,}0170'tir (negatif dal yok).
Adım 4 — Tutumluluk. NJ ağacında 232 konumun Fitch puanları toplamı 746'dır (konum başına ortalama 3,2 değişim); ML ağacında 769.
Adım 5 — Bilgi ölçütleri. HKY + Γ, başlangıç ağacında: \ln\mathcal L=-2616{,}1611, k=30.
| Model | k | \ln\mathcal L | AIC | BIC | AIC ağırlığı |
|---|---|---|---|---|---|
| HKY + Γ | 30 | −2616,161 | 5292,32 | 5395,72 | 0,020 |
| HKY + Γ + I | 31 | −2615,914 | 5293,83 | 5400,68 | 0,009 |
| GTR + Γ | 34 | −2608,775 | 5285,55 | 5402,74 | 0,590 |
| GTR + Γ + I | 35 | −2608,225 | 5286,45 | 5407,09 | 0,376 |
| JC | 25 | −3068,417 | 6186,83 | 6273,00 | ≈ 0 |
GTR + Γ'nın dört ek parametresi log-olabilirliği 7,39 artırır; AIC'de bu, cezayı (2\times4=8) karşılar (2\times7{,}39=14{,}77>8), BIC'de karşılamaz (4\times5{,}447=21{,}79).
Adım 6 — ML ağacının log-olabilirliği. Şablonun ağacı (25 dal, Newick metninden) ve parametreleri: frekanslar 0{,}3748; 0{,}4016; 0{,}0391; 0{,}1845 (gözlenen frekanslarla on basamak aynı), \kappa=54{,}353, \alpha=2{,}2744. Dört gama diliminin ortalama hızları 0{,}3240; 0{,}6813; 1{,}0756; 1{,}9191 (ortalamaları 1). Budama algoritmasıyla 232 konumun log-olabilirlikleri toplamı -2615{,}0147'dir. Aynı ağaçta gama olmadan (tek hız) -2628{,}02 bulunur: hız farklılığı 13 log birimi kazandırır. \kappa=54 iken beklenen yerine koymaların %95,2'si geçiştir.
Adım 7 — Dal uzunlukları. ML ağacının dal uzunlukları toplamı 43{,}66 yerine koyma/konumdur; Mouse dalı üst sınırdadır (10), Tarsier 6{,}68, Lemur 5{,}96. Jpn Macaq dalı alt sınırdadır (10^{-8}). Bu büyüklükte dallar kestirim değil, doygunluk işaretidir (69.8). NJ ile ML ağaçları on bir iç dalın sekizinde aynıdır.
Adım 8 — Aramanın tekrarlanabilirliği.
| Arama | Tohum | \ln\mathcal L | \hat\alpha | \hat\kappa | Tutumluluk |
|---|---|---|---|---|---|
| Stokastik (5 başlangıç) | 2026 | −2615,0147 | 2,274 | 54,35 | 769 |
| Stokastik (5 başlangıç) | 7 | −2615,0147 | 2,274 | 54,35 | 769 |
| Ratchet (5 başlangıç) | 2026 | −2615,5287 | 2,261 | 54,17 | 751 |
| NNI | 2026 | −2615,5289 | 2,262 | 54,09 | 751 |
Stokastik arama iki tohumda da aynı ağaca varır; beş başlangıcın log-olabilirlikleri tohum 2026'da -2615{,}0147 (üç başlangıç), -2615{,}3137 ve -2615{,}5287, tohum 7'de -2615{,}0147 (üç başlangıç), -2615{,}3137 ve -2615{,}3905'tir: tek bir başlangıç yerel en iyide kalabilir, beşinin en yükseği ise kararlıdır. Ratchet ve NNI, tutumluluk puanı 751 olan aynı daha düşük yerel en iyiye varır. Farklar küçüktür (0,5 log birimi) ve desteği düşük dallarda toplanır; iyi desteklenen kladlar dört çalıştırmada da aynıdır.
69.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle, ağaçlara ilişkin değerler şablonun Newick metninden alınmıştır (çalıştırmalar 1 ve 8).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Değişken konum sayısı | 220 | 220 | 220 | 0 | ✓ |
| Ayrı haplotip sayısı | 14 | 14 | 14 | 0 | ✓ |
| K80 uzaklığı: Chimp – Human | 0,2939494 | 0,2939494 | 0,2939494 | 0 | ✓ |
| K80 uzaklığı: Mouse – Lemur | 1,03117355 | 1,03117355 | 1,03117355 | 1,9e−15 | ✓ |
| K80 uzaklık matrisi: en büyük fark (91 çift) | 0 | 4,884981·10−15 | 0 | 4,9e−15 | ✓ |
| p uzaklığı: Chimp – Human | 0,22413793 | 0,22413793 | 0,22413793 | 2,8e−16 | ✓ |
| JC69 uzaklığı: Chimp – Human | 0,26627569 | 0,26627569 | 0,26627569 | 3,3e−16 | ✓ |
| K80 + Γ (α = 2,27) uzaklığı: Chimp – Human | 0,33426631 | 0,33426631 | 0,33426631 | 3,9e−16 | ✓ |
| NJ ağacı (K80): dal uzunlukları toplamı | 4,2394864 | 4,2394864 | 4,2394864 | 8,4e−12 | ✓ |
| NJ ağacı (K80): {Chimp, Human} iç dalı | 0,08819164 | 0,08819164 | 0,08819164 | 8,6e−13 | ✓ |
| NJ ağacı (K80): Mouse uç dalı | 0,53410326 | 0,53410326 | 0,53410326 | 1,3e−11 | ✓ |
| NJ ağacı (K80): 25 dalda en büyük uzunluk farkı | 0 | 4,841870·10−11 | 4,841900·10−11 | 4,8e−11 | ✓ |
| NJ ağacı (K80): ortak bölünme sayısı (25 dal) | 25 | 25 | 25 | 0 | ✓ |
| NJ ağacı (p uzaklığı): dal uzunlukları toplamı | 2,63733426 | 2,63733426 | 2,63733426 | 5,4e−11 | ✓ |
| NJ ağacı (JC69): dal uzunlukları toplamı | 4,05558626 | 4,05558626 | 4,05558626 | 3,1e−11 | ✓ |
| NJ ağacı (K80 + Γ): dal uzunlukları toplamı | 5,44221651 | 5,44221651 | 5,44221651 | 1,5e−11 | ✓ |
| NJ ağacının tutumluluk puanı | 746 | 746 | 746 | 0 | ✓ |
| ML ağacının tutumluluk puanı | 769 | 769 | 769 | 0 | ✓ |
| ML log-olabilirlik (HKY + Γ4, şablonun ağacı ve parametreleri) | −2615,01471656 | −2615,01471656 | −2615,01471656 | 1,4e−15 | ✓ |
| JC: AIC | 6186,83435925 | 6186,83435925 | 6186,83435925 | 0 | ✓ |
| JC: AICc | 6193,14503886 | 6193,14503886 | 6193,14503886 | 1,6e−15 | ✓ |
| JC: BIC | 6273,00279354 | 6273,00279354 | 6273,00279354 | 2,9e−16 | ✓ |
| HKY+G(4): AIC | 5292,32237993 | 5292,32237993 | 5292,32237993 | 0 | ✓ |
| HKY+G(4): AICc | 5301,57611127 | 5301,57611127 | 5301,57611127 | 1,9e−15 | ✓ |
| HKY+G(4): BIC | 5395,72450108 | 5395,72450108 | 5395,72450108 | 0 | ✓ |
| GTR+G(4): AIC | 5285,54953507 | 5285,54953507 | 5285,54953507 | 1,9e−15 | ✓ |
| GTR+G(4): AICc | 5297,63075334 | 5297,63075334 | 5297,63075334 | 1,9e−15 | ✓ |
| GTR+G(4): BIC | 5402,73860571 | 5402,73860571 | 5402,73860571 | 1,9e−15 | ✓ |
| GTR+G(4): AIC ağırlığı | 0,59015953 | 0,59015953 | 0,59015953 | 2,0e−12 | ✓ |
| GTR+G(4): AICc ağırlığı | 0,61509648 | 0,61509648 | 0,61509648 | 1,6e−12 | ✓ |
| 24 model, AIC: en büyük göreli fark | 0 | 1,892791·10−15 | 1,892791·10−15 | 1,9e−15 | ✓ |
| 24 model, AICc: en büyük göreli fark | 0 | 2,574379·10−15 | 1,888475·10−15 | 2,6e−15 | ✓ |
| 24 model, BIC: en büyük göreli fark | 0 | 2,520723·10−15 | 1,852442·10−15 | 2,5e−15 | ✓ |
| 24 model, AICw: en büyük göreli fark | 0 | 1,989298·10−12 | 1,989020·10−12 | 2,0e−12 | ✓ |
| 24 model, AICcw: en büyük göreli fark | 0 | 1,642353·10−12 | 1,642020·10−12 | 1,6e−12 | ✓ |
| BIC'e göre en iyi modelin sırası (tabloda) | 15 | 15 | 15 | 0 | ✓ |
| AIC'ye göre en iyi modelin sırası (tabloda) | 23 | 23 | 23 | 0 | ✓ |
Ölçütü karşılayan: 37/37. Python: uzaklıklar açık formülle, NJ Saitou–Nei algoritmasının doğrudan uygulamasıyla, tutumluluk Fitch algoritmasıyla, olabilirlik budama algoritmasıyla (numpy). R: phangorn kullanılmadan (açık formüller, ape::nj, bit maskeli Fitch, öz ayrışımla e^{Qt}). Ağaç uzunlukları ve olabilirlik, şablonun Newick metnindeki (10 anlamlı basamak) dal uzunluklarıyla hesaplanmıştır; bilgi ölçütleri şablonun log-olabilirlik ve parametre sayılarından.
69.7 Çıktıyı okuma
Örnek ayarın konsol metni (Newick satırları kısaltılmıştır):
Not: bootstrap'in 6 / 100 tekrarında K80 uzaklığı bazı çiftler için hesaplanamadı; o tekrarların ağacı p uzaklığından kuruldu (destek değerleri iki uzaklığın karışımıdır).
Filogeni: 14 dizi, 232 konum (220 değişken); NJ uzaklığı K80
Seçilen model (BIC): HKY+G(4); ML araması: stokastik
ML araması: 5 bağımsız başlangıç; log-olabilirlikler -2615,0147, -2615,0147, -2615,0147, -2615,3137, -2615,5287; en yükseği alındı (-2615,0147; 3 başlangıçta bulundu).
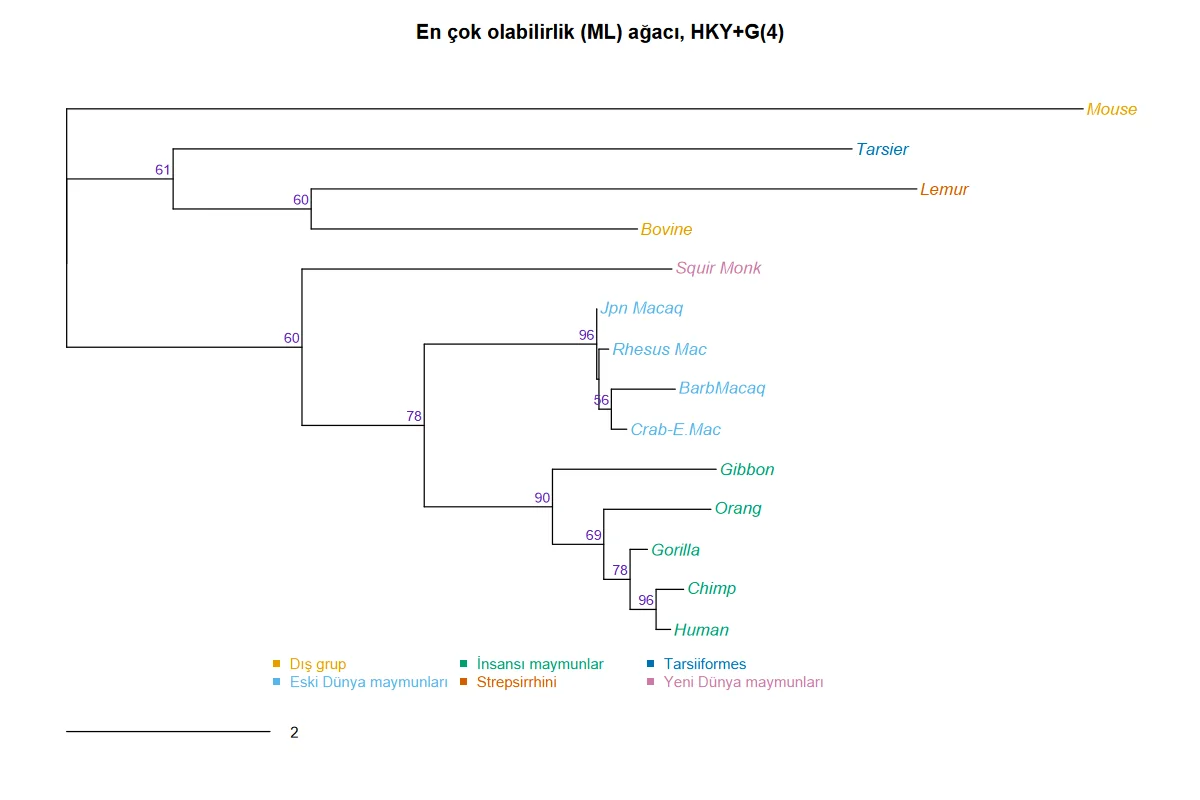
Not: ML ağacında 1 dal phangorn'un alt sınırında (1e-08 ≈ 0); bu dallar sıfır uzunluklu sayılmalıdır (diziler bu dalda ayırt edilemiyor).
Uyarı: ML ağacında 1 dal phangorn'un üst sınırında (10 ikame/konum); dizi doygunluğu nedeniyle bu dal uzunlukları kestirilemedi, yalnız alt sınır olarak okunabilir. Daha yakın bir dış grup kullanın ya da doygun konumları (ör. üçüncü kodon konumları) çıkarın.
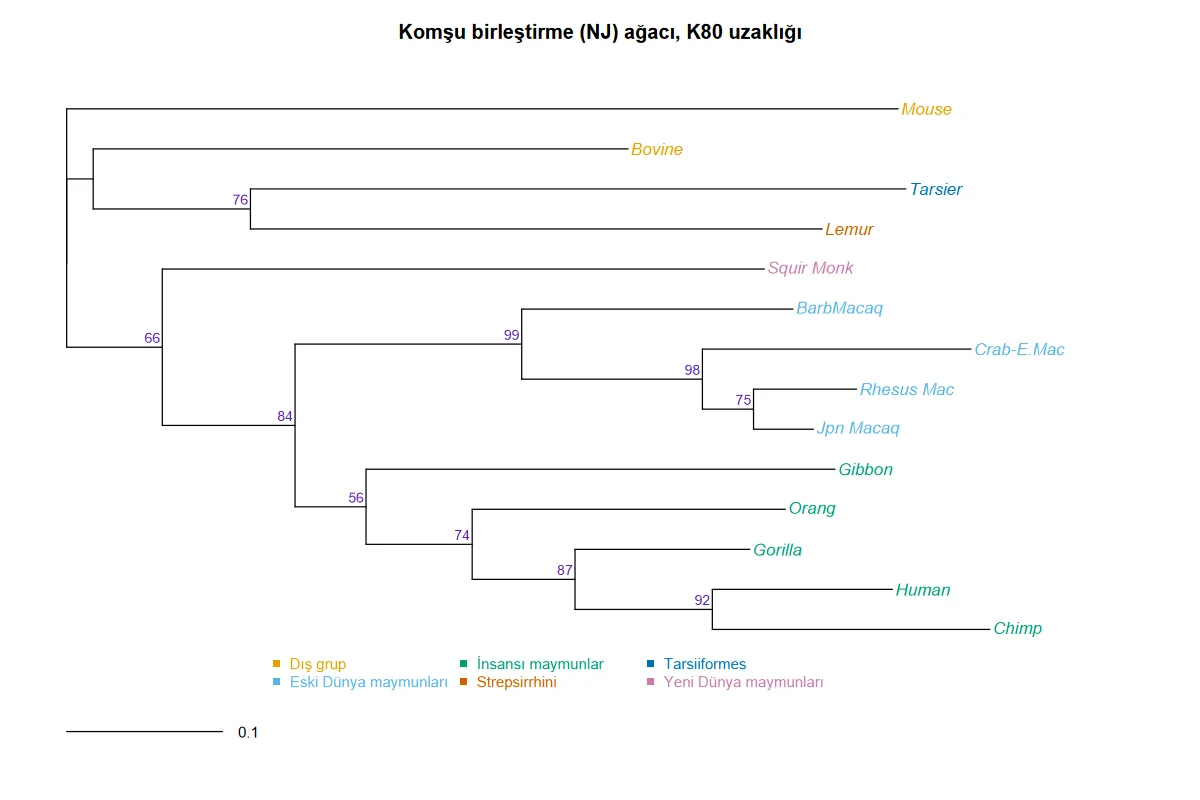
NJ ağacı (Newick): (((Bovine:0.3435576373,(Lemur:0.3672074773,Tarsier:0.420990423)76:0.1009955854)39:0.01704070725, … ,Mouse:0.5341032648)Root;
ML ağacı (Newick): (((Tarsier:6.678975451,(Bovine:3.210091832,Lemur:5.95821008)60:1.357994037)61:1.047505304, … ,Mouse:10)Root;
Tablolar (kısaltılmış):
Özet
                                           olcu       deger
                                    Dizi sayısı     14.0000
                        Konum sayısı (hizalama)    232.0000
                                 Değişken konum    220.0000
                                  Ayrı haplotip     14.0000
                   NJ ağacının tutumluluk puanı    746.0000
En iyi model (BIC): HKY+G(4); serbest parametre     30.0000
                             ML log-olabilirlik  -2615.0147
                         Gama biçim parametresi      2.2744
                           Değişmez konum oranı         NaN
                   ML ağacının tutumluluk puanı    769.0000
Model seçimi (modelTest; log-olabilirlik, AIC, AICc, BIC ve ağırlıkları)
     Model  df      logLik        AIC    AICw       AICc   AICcw        BIC  BIC_sira  AIC_sira
        JC  25  -3068.4172  6186.8344  0.0000  6193.1450  0.0000  6273.0028        23        24
       ...
       HKY  29  -2627.0753  5312.1506  0.0000  5320.7645  0.0000  5412.1060         6         8
  HKY+G(4)  30  -2616.1612  5292.3224  0.0200  5301.5761  0.0855  5395.7245         1         3
HKY+G(4)+I  31  -2615.9143  5293.8286  0.0094  5303.7486  0.0289  5400.6775         2         4
       ...
  GTR+G(4)  34  -2608.7748  5285.5495  0.5902  5297.6308  0.6151  5402.7386         3         1
GTR+G(4)+I  35  -2608.2245  5286.4490  0.3764  5299.3061  0.2662  5407.0848         4         2
ML model parametreleri (HKY+G(4); taban frekansları gözlenen frekanslardır; oran matrisi g↔t = 1'e göre)
       parametre    deger
taban frekansı A   0.3748
taban frekansı C   0.4016
taban frekansı G   0.0391
taban frekansı T   0.1845
             a↔c   1.0000
             a↔g  54.3527
             a↔t   1.0000
             c↔g   1.0000
             c↔t  54.3527
             g↔t   1.0000
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Başlık satırı | Dizi, konum ve değişken konum sayıları; NJ uzaklığı; gama ve BIONJ seçildiyse onlar | Konum sayısı, bütünüyle boş konumlar atıldıktan sonraki sayıdır. |
| Not ve uyarı satırları | Alt sınırdaki (≈ 0) ve üst sınırdaki (10) dal sayıları | Alt sınır: iki dizi o dalda ayırt edilemiyor. Üst sınır: dal uzunluğu kestirilemedi; ağacın o bölümünün uzunlukları ve ölçek çubuğu yorumlanmaz. |
Ayrı haplotip |
Birbirinden farklı haplotip sayısı | Her konumda uyumlu diziler (eksik/belirsiz kodlar çakışabilir) tek haplotip sayılır (181–196). |
| Tutumluluk puanları | NJ ve ML ağaçlarının Fitch puanı | Yalnız aynı veri üzerinde iki ağacı karşılaştırmak için. |
serbest parametre |
Dallar dâhil k | Bilgi ölçütlerindeki k. |
ML log-olabilirlik |
Aramanın vardığı ağacın \ln\mathcal L'si | Model seçimi tablosundaki aynı modelin değerinden büyüktür (topoloji de eniyilendi). |
Gama biçim parametresi, Değişmez konum oranı |
\hat\alpha, \hat p_{\text{inv}} | Modelde yoksa boştur. +Γ+I modellerinde ikisi ayrı ayrı yorumlanmaz. |
| Model seçimi tablosu | Her model için k, \ln\mathcal L, üç ölçüt, ağırlıklar, sıralar | Seçilen ölçütte 1. sıradaki model kullanılır; ağırlıklar birkaç modele dağılıyorsa seçim keskin değildir. |
| ML model parametreleri | Taban frekansları; g↔t'ye göre oranlar | Frekanslar gözlenen frekanslardır. HKY'de a↔g = c↔t = \hat\kappa. |
| İkili uzaklıklar | Seçilen modelle uzaklık matrisi | Sütun ve satır sırası verideki dizi sırasıdır; yalnız NJ'nin girdisidir. |
| Newick metinleri | Köklendirilmiş NJ ve ML ağaçları | Düğüm etiketleri yüzde olarak yazılmış destektir (NJ'de ve ML'de). Kökün yanındaki :0 dalı köklendirmenin eklediği sıfır uzunluklu daldır. |
Şekil 69.1. Şablonun birinci şekli (örnek ayar): K80 uzaklığından komşu birleştirme ağacı, Mouse ile köklendirilmiş. Düğümlerdeki sayılar 100 tekrarlı bootstrap desteğidir (%50 ve üstü).
Şekil 69.2. Şablonun ikinci şekli (örnek ayar): HKY + Γ modeliyle en çok olabilirlik ağacı. Düğümlerdeki sayılar ultra hızlı bootstrap desteğidir. Dış grup dallarının uzunluğu doygunluk nedeniyle yorumlanmaz (Mouse dalı üst sınırdadır).
Rapor cümlesi (örnek veri):
On dört türün 232 bazlık mitokondri DNA hizalamasından (220 değişken konum) Kimura iki parametreli uzaklıklarla komşu birleştirme ağacı kuruldu (100 bootstrap tekrarı). Yirmi dört yerine koyma modeli arasında Bayesçi bilgi ölçütü HKY + Γ modelini seçti (BIC = 5395,7; AIC'ye göre en iyi model GTR + Γ). Bu modelle stokastik aramayla kestirilen en çok olabilirlik ağacının log-olabilirliği −2615,01; gama biçim parametresi 2,27; geçiş/çapraz geçiş oranı 54,4 idi. İnsan–şempanze kladı (ultra hızlı bootstrap %96), insansı maymunlar (%90) ve makaklar (%96) iki ağaçta da ayrıldı. Dış grup dalları doygunluk nedeniyle kestirilemedi ve dal uzunlukları yorumlanmadı.
69.8 Sık hatalar ve tuzaklar
- Sınıra dayanmış dal uzunluklarını yorumlamak. Uyarı satırı üst sınırda dal bildiriyorsa (örnek veride Mouse: 10 yerine koyma/konum) o soyun dizileri doygundur: aynı konumlar defalarca değişmiş, uzaklık bilgisi tükenmiştir. Ağacın toplam uzunluğu (örnek veride 43,7) ve ölçek çubuğu anlam taşımaz; topoloji ve yakın türler arasındaki dallar kullanılabilir. Çözüm daha yakın bir dış grup ya da daha yavaş evrimleşen bir bölgedir.
- Aramanın sonucunu kesin saymak. Şablon stokastik aramayı 5 bağımsız başlangıçla yineler ve en yüksek log-olabilirlikli ağacı alır; yine de sezgisel bir aramadır (69.6, Adım 8). Başlangıçların log-olabilirlikleri sonuç metninde yazılır: hepsi aynıysa arama tutarlıdır; farklıysa en yüksek değerin kaç başlangıçta bulunduğuna bakılır, bir tek başlangıçta bulunmuşsa daha yüksek bir ağaç olabilir. Yayın için şablon yeni bir tohumla yinelenir ve yalnız her çalıştırmada görülen kladlar yorumlanır.
- Ratchet kipinin desteğini ultra hızlı bootstrap sanmak. Ratchet kipinin destekleri standart bootstrap'tır (şekil başlığı da öyle der) ve stokastik kipin ultra hızlı bootstrap değerleriyle aynı eşikle yorumlanmaz (69.4.7).
- Ultra hızlı bootstrap ile standart bootstrap eşiklerini karıştırmak. UFBoot için %95, standart bootstrap için %70 alışılmış eşiklerdir. NJ ağacındaki destek standart bootstrap'tır; stokastik ML ağacındaki UFBoot'tur. İki ağacın sayıları yan yana karşılaştırılmaz.
- Newick metnindeki destekleri aynı ölçekte sanmak. NJ ve NNI çıktılarında
0.92oran, stokastik ML çıktısında97yüzdedir. Metin başka bir programa aktarılmadan önce ölçek denetlenir. - Dış grubu Newick'teki yazımla girmek. Adında boşluk olan uç Newick metninde alt çizgiyle görünür; dış grup alanı ad sütunundaki yazımı (
Squir Monk) ister. Yanlış ad "Dış grup adı dizilerde yok" iletisiyle durdurur. - Çok uzak dış grup seçmek. Uzak dış grup uzun bir dalla bağlanır ve hızlı evrimleşen iç grup soylarını kendine çeker (uzun dal çekimi). Örnek veride fare ve sığır bu durumdadır; dış gruba komşu dalların desteği düşüktür (%62–63).
- Model seçimini kesin bir sonuç gibi sunmak. Seçim aday küme içindedir ve ölçüte bağlıdır (örnek veride BIC ve AIC farklı model seçer); model seçimi sabit NJ başlangıç ağacından yapıldığından tohuma bağlı değildir; başlangıç ağacı değişirse log-olabilirlikler üçüncü ondalıkta oynayabilir ve birbirine yakın iki modelin (ΔBIC < 2) sırası buna duyarlıdır.
- "+F" seçeneğinden bir şey beklemek. DNA verisinde aday kümeyi değiştirmez ve şablon bunu not olarak yazar; taban frekansları her modelde zaten gözlenen frekanslardır.
- Gamasız modelde "Gama biçim parametresi" satırını aramak. +Γ içermeyen modellerde (GTR, GTR + I, HKY …) bu satır boştur (NaN); modelde gama yoktur. Model adında
+G(…)varsa satır kestirimdir (290, 350). - Eksik verisi çok olan dizileri ağaca katmak. İkili silmede her çift farklı sayıda konumla karşılaştırılır; ortak konumu az olan çiftlerin uzaklığı oynaktır, hiç ortak konumu olmayan bir çift varsa şablon bunu açıkça söyleyen ayrı bir iletiyle durur (249–255). Yalnız N ya da boşlukla ayrışan diziler tek haplotip sayılır ve aralarındaki uzaklık sıfırdır; bütün diziler böyleyse şablon durur. Kısa ve eksik diziler önceden ayıklanır.
- Seçilen uzaklık modelinin her bootstrap tekrarında kullanıldığını varsaymak. Uzaklığı tanımsız çıkan tekrarlar p uzaklığıyla kurulur (69.4.4). Doygunluğa yakın veride daha yalın bir uzaklık (JC69) seçmek bu karışımı önler.
- Uzaklıktaki gama parametresini rastgele girmek. \alpha veriden kestirilmez; kullanıcı girer. ML çözümlemesinin bulduğu değer (örnek veride 2,27) girilirse iki ağaç tutarlı varsayımlarla kurulur; varsayılan 1,0 çoğu veri için fazla güçlü bir düzeltmedir.
- Farklı genleri uç uca ekleyip tek dizi vermek. Şablon bütün konumlara tek model uygular; hızları ve taban bileşimleri farklı bölgeler ayrı çözümlenir.
- Orta nokta köklendirmesini evrimsel kök saymak. Soylar eşit hızda evrimleşmediyse kök yanlış dala düşer. Dış grup verilmediğinde ağaç "köksüz" diye okunur.
69.9 Uzman soruları
S1. Model seçimi neden sabit bir ağaçta yapılıyor; ağaç yanlışsa seçim de yanlış olmaz mı?
Model sıralaması topolojiye şaşırtıcı ölçüde duyarsızdır: makul her ağaçta (rastgele olmayan, veriden kurulmuş) modellerin göreli uyumu aynı kalır (Posada ve Crandall, 1998; Sullivan ve Joyce, 2005). Her model için ayrı ağaç aramak hesabı 24 katına çıkarır ve sonucu ender değiştirir. Şablonun başlangıç ağacı NJ ağacıdır ve tohuma bağlı değildir; başlangıç ağacının değişmesinden doğan log-olabilirlik farkları üçüncü ondalıktadır, modeller arasındaki farklar ise onlarca birimdir. Sıra yalnız birbirine çok yakın modellerde oynayabilir.
S2. Dal uzunlukları neden parametre sayısına katılıyor?
Dal uzunlukları veriden kestirilir ve olabilirliği artırır; bilgi ölçütlerinde her kestirilen büyüklük sayılır. On dört dizide 25 dal vardır ve bütün modellerde ortaktır; modeller arası farkı değiştirmez, ama AICc'nin düzeltme terimini ve BIC'nin mutlak değerini etkiler. Örneklem büyüklüğü olarak konum sayısının alınması da bir uzlaşımdır: konumlar bağımsız değildir ve değişmeyen konumlar az bilgi taşır; etkin örneklem büyüklüğü 232'den küçüktür.
S3. Taban frekansları neden en çok olabilirlikle kestirilmiyor?
Paketin varsayılanı gözlenen frekansları kullanmaktır; uzun dizilerde ML kestirimi gözlenen frekanslara çok yakındır ve üç parametrenin eniyilenmesi aramayı yavaşlatır. Fark, taban bileşimi dengesiz ve diziler kısa olduğunda (örnek veride G %3,9) büyüyebilir. Şablon frekansları yine de üç serbest parametre sayar; bu, yaygın "+F" uzlaşımıdır. Frekansların ML ile kestirildiği bir çözümlemeyle karşılaştırırken ("ML'de taban frekanslarını olabilirlikle kestir" seçeneği) log-olabilirliklerin birkaç ondalıkta ayrışması beklenir; seçenek kapalıyken şablon gözlenen frekansları kullanır.
S4. Geçiş/çapraz geçiş oranı 54 gerçekçi mi?
\kappa hız oranıdır, gözlenen farkların oranı değil. HKY'de beklenen geçiş payı taban frekanslarına da bağlıdır; örnek veride %95,2'dir (geçiş/çapraz geçiş sayı oranı yaklaşık 20). Primat mitokondri DNA'sında yüksek oran beklenir, ama bu veride kestirim uzak dış gruplardan etkilenir: doygun dallarda geçişler silinmiş, çapraz geçişler birikmiştir ve model yakın türlerdeki geçiş fazlasını çok yüksek bir \kappa ile karşılar. GTR + Γ'da a↔g oranı 85, c↔t oranı 29'dur: tek bir \kappa bu ikisinin ortalamasıdır.
S5. +Γ ile +I birlikte neden sorun çıkarır?
İkisi de "bazı konumlar az değişir" olgusunu açıklar: küçük \alpha'lı gama dağılımının hızı sıfıra yakın bir dilimi zaten vardır. Bu yüzden \hat\alpha ile \hat p_{\text{inv}} güçlü biçimde ilişkilidir; biri artınca öteki azalır ve olabilirlik yüzeyi düz bir sırt oluşturur. Örnek veride +I eklemek HKY + Γ'nın log-olabilirliğini yalnız 0{,}25 artırır. Bilgi ölçütü +Γ+I'yı seçerse iki parametre ayrı ayrı yorumlanmaz; birçok yazar +I'sız modeli yeğler (Yang, 1994, sonrası tartışma).
S6. Kesikli gama için dört sınıf yeterli mi?
Dört sınıf alışılmış seçimdir ve çoğu veride olabilirliği sürekli gamaya yakın verir. Sınıf sayısı artınca yaklaşım incelir: örnek veride sekiz sınıfla log-olabilirlik -2614{,}38 (\hat\alpha=2{,}36), dört sınıfla -2615{,}01 (\hat\alpha=2{,}27) bulunur. Sınıf sayısı model parametresi sayılmaz, ama farklı sınıf sayılarıyla bulunan log-olabilirlikler birbiriyle bilgi ölçütü üzerinden karşılaştırılmaz; bütün aday modeller aynı sınıf sayısıyla uydurulur.
S7. NJ ve ML ağaçları farklıysa hangisine güvenilir?
ML, verinin tamamını (her konumdaki baz örüntüsünü) ve hız farklılığını kullanır; NJ veriyi önce çift uzaklıklarına indirger ve bilgi yitirir. Uzaklıklar doygunluğa yakınken NJ daha çok etkilenir. İki ağacın uyuştuğu kladlar yöntemden bağımsız destek kazanır; ayrıştıkları yerler çoğu zaman her iki ağaçta da desteği düşük dallardır. Örnek veride on bir iç dalın sekizi ortaktır; ayrışan üçünden ikisi makakların iç dallanmasına, biri Lemur, Tarsier ve Bovine'in sırasına aittir.
S8. Ultra hızlı bootstrap neden 1000 tekrar ve neden formdan değiştirilemiyor?
Yöntem tekrar başına çok ucuzdur (ağaç yeniden aranmaz) ve desteğin örnekleme hatası \sqrt{p(1-p)/1000} düzeyine iner (%95 dolayında yaklaşık 0,7 puan). Paket bu sayıyı arama denetim listesinde sabit tutar; şablon bu listeyi değiştirmez. Formdaki B yalnız NJ desteğini ve NNI kipindeki standart bootstrap'ı yönetir. Standart bootstrap'ta 100 tekrarın örnekleme hatası %70 dolayında 4,6 puandır; yayın için 1000 tekrar önerilir.
S9. LogDet uzaklığı ne zaman seçilir?
Öteki modeller taban bileşiminin bütün soylarda aynı olduğunu varsayar. Bileşim soylar arasında değişiyorsa (ör. bazı türlerde G + C zengin) benzer bileşimli türler akraba olmasalar da yan yana gelir. LogDet, iki dizinin 4\times4 baz çifti sayım matrisinin determinantına dayanır ve bileşim değişse de ağaca toplanır kalır (Lockhart ve ark., 1994). Bedeli: hız farklılığını düzeltmez ve kısa dizilerde determinant sıfıra yaklaşıp tanımsız olabilir.
69.10 Kaynaklar
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- Felsenstein, J. (1981). Evolutionary trees from DNA sequences: A maximum likelihood approach. Journal of Molecular Evolution, 17(6), 368–376. https://doi.org/10.1007/BF01734359
- Felsenstein, J. (1985). Confidence limits on phylogenies: An approach using the bootstrap. Evolution, 39(4), 783–791. https://doi.org/10.1111/j.1558-5646.1985.tb00420.x
- Fitch, W. M. (1971). Toward defining the course of evolution: Minimum change for a specific tree topology. Systematic Zoology, 20(4), 406–416. https://doi.org/10.1093/sysbio/20.4.406
- Gascuel, O. (1997). BIONJ: An improved version of the NJ algorithm based on a simple model of sequence data. Molecular Biology and Evolution, 14(7), 685–695. https://doi.org/10.1093/oxfordjournals.molbev.a025808
- Hasegawa, M., Kishino, H., & Yano, T. (1985). Dating of the human–ape splitting by a molecular clock of mitochondrial DNA. Journal of Molecular Evolution, 22(2), 160–174. https://doi.org/10.1007/BF02101694
- Hayasaka, K., Gojobori, T., & Horai, S. (1988). Molecular phylogeny and evolution of primate mitochondrial DNA. Molecular Biology and Evolution, 5(6), 626–644. https://doi.org/10.1093/oxfordjournals.molbev.a040524
- Hurvich, C. M., & Tsai, C.-L. (1989). Regression and time series model selection in small samples. Biometrika, 76(2), 297–307. https://doi.org/10.1093/biomet/76.2.297
- Jukes, T. H., & Cantor, C. R. (1969). Evolution of protein molecules. In H. N. Munro (Ed.), Mammalian protein metabolism (Vol. 3, pp. 21–132). Academic Press. https://doi.org/10.1016/B978-1-4832-3211-9.50009-7
- Kimura, M. (1980). A simple method for estimating evolutionary rates of base substitutions through comparative studies of nucleotide sequences. Journal of Molecular Evolution, 16(2), 111–120. https://doi.org/10.1007/BF01731581
- Lockhart, P. J., Steel, M. A., Hendy, M. D., & Penny, D. (1994). Recovering evolutionary trees under a more realistic model of sequence evolution. Molecular Biology and Evolution, 11(4), 605–612. https://doi.org/10.1093/oxfordjournals.molbev.a040136
- Minh, B. Q., Nguyen, M. A. T., & von Haeseler, A. (2013). Ultrafast approximation for phylogenetic bootstrap. Molecular Biology and Evolution, 30(5), 1188–1195. https://doi.org/10.1093/molbev/mst024
- Nguyen, L.-T., Schmidt, H. A., von Haeseler, A., & Minh, B. Q. (2015). IQ-TREE: A fast and effective stochastic algorithm for estimating maximum-likelihood phylogenies. Molecular Biology and Evolution, 32(1), 268–274. https://doi.org/10.1093/molbev/msu300
- Nixon, K. C. (1999). The parsimony ratchet, a new method for rapid parsimony analysis. Cladistics, 15(4), 407–414. https://doi.org/10.1111/j.1096-0031.1999.tb00277.x
- Paradis, E., & Schliep, K. (2019). ape 5.0: An environment for modern phylogenetics and evolutionary analyses in R. Bioinformatics, 35(3), 526–528. https://doi.org/10.1093/bioinformatics/bty633
- Posada, D., & Crandall, K. A. (1998). MODELTEST: Testing the model of DNA substitution. Bioinformatics, 14(9), 817–818. https://doi.org/10.1093/bioinformatics/14.9.817
- Saitou, N., & Nei, M. (1987). The neighbor-joining method: A new method for reconstructing phylogenetic trees. Molecular Biology and Evolution, 4(4), 406–425. https://doi.org/10.1093/oxfordjournals.molbev.a040454
- Schliep, K. P. (2011). phangorn: Phylogenetic analysis in R. Bioinformatics, 27(4), 592–593. https://doi.org/10.1093/bioinformatics/btq706
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
- Studier, J. A., & Keppler, K. J. (1988). A note on the neighbor-joining algorithm of Saitou and Nei. Molecular Biology and Evolution, 5(6), 729–731. https://doi.org/10.1093/oxfordjournals.molbev.a040527
- Sullivan, J., & Joyce, P. (2005). Model selection in phylogenetics. Annual Review of Ecology, Evolution, and Systematics, 36, 445–466. https://doi.org/10.1146/annurev.ecolsys.36.102003.152633
- Tamura, K., & Nei, M. (1993). Estimation of the number of nucleotide substitutions in the control region of mitochondrial DNA in humans and chimpanzees. Molecular Biology and Evolution, 10(3), 512–526. https://doi.org/10.1093/oxfordjournals.molbev.a040023
- Yang, Z. (1994). Maximum likelihood phylogenetic estimation from DNA sequences with variable rates over sites: Approximate methods. Journal of Molecular Evolution, 39(3), 306–314. https://doi.org/10.1007/BF00160154