51. Bağımlı veri için bootstrap (blok, dairesel, durağan; küme ve yabani küme bootstrap)
Şablon kimliği: bagimli_bootstrap · Kategori: yeniden_ornekleme · Dil: R · Dosya: pro/sablonlar/yeniden_ornekleme/bagimli_bootstrap.R (satır 1–208; üstbilgi 1–95) · Örnek veri: _ornek/lynx.csv (küme kipi için _ornek/petersen.csv) · Paketler: boot 1.3-32, sandwich 3.1-3, taban R (stats, graphics)
51.1 Ne işe yarar
Şablon, gözlemlerin birbirinden bağımsız olmadığı iki durumda bir kestirimin standart hatasını ve güven aralığını yeniden örneklemeyle bulur. Cevapladığı soru şudur: "Gözlemlerim birbirine bağlıyken (ardışık yıllar, aynı firmanın yılları, aynı okulun öğrencileri) hesapladığım değer, aynı süreçten yeni bir veri gelseydi ne kadar oynardı?"
Olağan bootstrap her gözlemi tek başına, yerine koyarak çeker. Bu, gözlemler bağımsızsa doğrudur. Gözlemler bağımlıysa yeniden örneklem bağımlılığı taşımaz ve standart hata çoğunlukla küçük çıkar. Çözüm, bağımlılığı taşıyan birimleri bütün olarak çekmektir:
- Zaman serisi kipi: ardışık gözlemlerden oluşan bloklar çekilir ve uç uca eklenir. Blok içinde komşuluk korunur.
- Kümelenmiş regresyon kipi: kümeler (firma, okul, parsel) bütün gözlemleriyle çekilir ya da artıklar küme düzeyinde rastgele işaretle çarpılır.
Zaman serisi kipinde istatistik \hat\theta=s(y_1,\dots,y_n)'dir (ortalama, medyan, 1. gecikme otokorelasyonu ya da AR(p) katsayıları); kümelenmiş regresyon kipinde doğrusal modelin katsayılarıdır:
- g=1,\dots,G: küme; i: küme içindeki gözlem. Toplam gözlem sayısı n.
- \varepsilon_{gi}: hata. Aynı kümenin hataları birbiriyle ilişkili olabilir; farklı kümelerin hataları ilişkisizdir.
- \beta_j: katsayılar. En küçük karelerle kestirilir; kümeleme kestirimi değil, standart hatayı değiştirir.
Ne zaman kullanılır?
- Durağan bir zaman serisinin ortalaması ya da medyanı için güven aralığı gerekiyorsa ve ardışık gözlemler ilişkiliyse.
- Bir regresyonun gözlemleri kümelerden geliyorsa ve katsayıların küme-sağlam standart hatasına bootstrap'la bakılmak isteniyorsa.
- Bağımsızlık varsayımının standart hatayı ne kadar küçülttüğü gösterilmek isteniyorsa (şablon iki değeri yan yana verir).
Ne zaman kullanılmaz?
- Gözlemler bağımsızsa: temel programdaki Bootstrap Güven Aralığı; kendi istatistiğiniz için
bootstrap_ozel(Bölüm 53). - Seride eğilim ya da birim kök varsa: blok bootstrap durağan seri ister. Önce eğilim giderilir ya da fark alınır; modelleme için temel programdaki ARIMA Tahmin.
- Kümelenmiş veride ilgi küme içi korelasyonun kendisindeyse ya da rastgele etki isteniyorsa: temel programdaki Doğrusal Karma Model (LMM) ya da GEE.
- Panel veride sabit ya da rastgele etkili model isteniyorsa: temel programdaki Panel Veri Regresyonu (kümelenmiş standart hatayı kapalı biçimde verir).
- Hipotez testi isteniyorsa:
permutasyon_ozel(Bölüm 56); çok sayıda testin birlikte düzeltilmesi içincoklu_test_yeniden_ornekleme(Bölüm 54). - Aynı yöntem Python ile isteniyorsa:
bagimli_bootstrap_py(Bölüm 52).
Temel programla ilişki. Temel programın Bootstrap Güven Aralığı analizi yalnız bağımsız gözlemler içindir; blok ve küme bootstrap'ı orada yoktur. Çoklu Doğrusal Regresyon heteroskedastisiteye sağlam (HC) standart hataları, Panel Veri Regresyonu kümelenmiş standart hataları kapalı formülle verir. Bu şablon aynı soruya yeniden örneklemeyle yaklaşır ve klasik, küme-sağlam ve bootstrap standart hatalarını tek tabloda karşılaştırır.
51.2 Şablonun girdileri
Form, üstbilgideki on iki [[param]] bloğundan kurulur (bagimli_bootstrap.R:10–94). "Bağımlılık türü" seçimi şablonu iki kipe ayırır; her alan yalnız kendi kipinde okunur, öteki kipte sessizce yok sayılır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Bağımlılık türü · tur |
seçim · Model | zaman |
zaman, kume |
Kip seçimi (111, 156). |
Seri ya da bağımlı değişken · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Zaman kipinde seri (112); küme kipinde yanıt (160, 169). |
Seriye log10 dönüşümü · log10_donusum |
onay · Seçenekler | kapalı | açık / kapalı | Zaman kipi: y\leftarrow\log_{10}y; seri pozitif olmalı (118). |
İstatistik · istatistik |
seçim · Model | ortalama |
ortalama, medyan, otokor1, ar |
Zaman kipi: yeniden örneklenen seriye uygulanan işlev (126–129). |
AR mertebesi p · p |
tamsayı · Model | 2 | 1–10 | Yalnız ar: Yule-Walker mertebesi (124, 129). |
Blok yöntemi · yontem |
seçim · Model | dairesel |
hareketli, dairesel, duragan |
tsboot'un sim ve endcorr değerleri (132–133). |
Blok uzunluğu l · l |
tamsayı · Model | 0 | 0–500 | 0 ise l=\operatorname{round}(n^{1/3}) (122). |
Açıklayıcılar · x |
sütunlar (sayısal) · Değişkenler | boş | en az 1 sayısal sütun (küme kipi) | Regresyonun sağ tarafı (158, 169). |
Küme değişkeni · kume |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | factor() ile küme kimliği (181). |
Küme bootstrap türü · kume_yontemi |
seçim · Model | xy |
xy, wild, webb |
vcovBS(type =) (172). |
Bootstrap tekrar sayısı B · B |
tamsayı · Seçenekler | 1999 | 99–20000 | Kopya sayısı (100, 134, 172). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | Yüzdelik olasılıkları ve normal kantili (101–103). |
Örnek ayar (ornek_param, satır 9): tur = zaman, y = lynx, log10_donusum = açık, istatistik = ortalama, yontem = dairesel, l = 5, B = 999. Varsayılandan farkları: log10 dönüşümü açık, l elle 5 (bu seride kural da 5 verir), B 1999 yerine 999.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 99 |
| Seride 3'ten az sayısal gözlem | "Seride yeterli sayısal gözlem yok." | 114 |
| İlk ve son geçerli gözlem arasında eksik değer | "Serinin ortasında eksik değer var; blok bootstrap ardışık gözlem ister." | 116 |
| log10 seçili ve sıfır ya da negatif değer var | "log10 dönüşümü için seri pozitif olmalı." | 118 |
| n<20 | "Blok bootstrap için en az 20 gözlem gerekli." | 120 |
| Seri sabit | "Seri sabit." | 121 |
| l\ge n/2 | "Blok uzunluğu serinin yarısından kısa olmalı." | 123 |
ar seçili ve n<10p |
"AR mertebesi seri uzunluğuna göre çok büyük." | 125 |
tsboot hata verdi |
"Bootstrap çalıştırılamadı: …" | 135 |
| Küme kipi, küme değişkeni boş | "Kümelenmiş regresyon için bir küme değişkeni seçin." | 157 |
| Yanıt ve küme çıkarılınca açıklayıcı kalmadı | "En az bir açıklayıcı seçin." | 159 |
| Küme sayısı G<10 | "Küme bootstrap'ı için en az 10 küme gerekli." | 164 |
| n<q+5 | "Gözlem sayısı çok az." | 165 |
| Yanıt ya da bir açıklayıcı sabit | "Bağımlı değişken sabit." / "'…' sabit." | 166, 167 |
| Açıklayıcılar doğrusal bağımlı | "Açıklayıcılar doğrusal bağımlı; birini çıkarın." | 171 |
vcovBS hata verdi |
"Küme bootstrap'ı çalıştırılamadı: …" | 173 |
Eksik değer kuralı kipe göre değişir. Zaman kipinde serinin başındaki ve sonundaki eksikler atılır, ilk ve son geçerli gözlem arasındaki dilim kullanılır (115–117); ortada tek bir eksik çalıştırmayı durdurur. Küme kipinde yanıtı, açıklayıcılardan biri ya da kümesi eksik olan satır atılır (161).
Seri sütununun türü "sayısal" olmalıdır
Şablon seriyi mq_sayisal(df[[y]], y) ile okur (112); küme kipinde bağımlı değişken ve açıklayıcılar da aynı işlevle sayıya çevrilir (178–179). Sütun veri sekmesinde "kategorik" türde olsa bile değerler (etiketlerin sayı karşılıkları) okunur, düzey sıra numaraları değil: örnek seri bu türle çalıştırıldığında da ortalama 2,9037'dir. Sayıya çevrilemeyen bir değer varsa (ör. "yüksek" ya da ondalık virgüllü "1,5") çalıştırma hangi sütunda kaç değerin sayı olmadığını söyleyen bir iletiyle durur; ondalık ayırıcı nokta olmalıdır.
51.3 Örnek veri
Zaman serisi kipi: _ornek/lynx.csv. Kanada'da Mackenzie Nehri bölgesinde 1821–1934 yıllarında yakalanan vaşak sayıları (Elton ve Nicholson, 1942); R'nin datasets::lynx serisi. 114 yıl, eksik değer yok.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
yil |
kullanılmaz | sayısal | 1821–1934; satırlar yıl sırasındadır. |
lynx |
Seri | sayısal | Yıllık yakalanan vaşak sayısı; 39–6991, ortalama 1538,0, medyan 771. |
Seri sağa çarpıktır ve yaklaşık on yıllık bir döngü gösterir. log10 dönüşümünden sonra değerler 1,591–3,845 arasındadır; ortalama 2,9037, standart sapma 0,5584. Dönüştürülmüş serinin otokorelasyonları döngüyü açıkça gösterir:
| Gecikme k | 1 | 2 | 3 | 4 | 5 | 6 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|
| r_k | 0,785 | 0,340 | −0,132 | −0,494 | −0,621 | −0,488 | 0,235 | 0,537 | 0,606 |
Şablon zaman değişkeni istemez: satır sırası zaman sırasıdır. Veri başka bir sütuna göre sıralanmışsa bloklar ardışık yılları içermez ve sonuç anlamını yitirir.
Kümelenmiş regresyon kipi: _ornek/petersen.csv. Petersen'in (2009) standart hata yöntemlerini karşılaştırmak için yayımladığı benzetim verisi: 500 firma × 10 yıl = 5000 gözlem, eksik değer yok.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
y |
Yanıt | sayısal | −7,84 ile 8,64 arası; ortalama 0,035. |
x |
Açıklayıcı | sayısal | −3,25 ile 3,55 arası; ortalama 0,005. |
firm |
Küme | sayısal | 1–500; her firmada 10 gözlem. |
year |
kullanılmaz | sayısal | 1–10. |
Küme değişkeni şablonda factor() ile kimliğe çevrilir; düzeylerin sırası sonucu etkilemez (küme bootstrap'ı kümeleri ad ayırmadan çeker).
Bu bölümde kullanılan çalıştırmalar (doğrulama çalıştırıcısında tohum 2026 verilerek): (1) örnek ayar; (2) yontem = hareketli; (3) yontem = duragan; (4) istatistik = medyan; (5) istatistik = otokor1; (6) istatistik = ar, p = 2; (7) l=1, 10, 20; (8) guven = 0,90; (9) B=4000 ve 20000; (10) log10 kapalı; (11) küme kipi, petersen.csv: y = y, x = x, kume = firm, B=999, üç bootstrap türü; (12) küme kipi, kume = year (10 küme).
51.4 Yöntem: formüller ve hesap adımları
Zaman serisi kipinde hesap sırası: (1) seriyi oku, uçlardaki eksikleri at, isteniyorsa log10 al, denetle; (2) blok uzunluğunu belirle; (3) istatistiği özgün seride hesapla; (4) B kez blokları çekip uç uca ekle, istatistiği her kopyada yeniden hesapla; (5) kopyalardan bootstrap ortalamasını, yanlılığı, standart hatayı, yüzdelik ve normal güven aralıklarını çıkar; (6) ortalama ve dairesel blokta ideal standart hatayı kapalı formülle hesapla. Kümelenmiş regresyon kipinde: (1) eksik satırları at, denetle; (2) modeli en küçük karelerle kur; (3) klasik ve küme-sağlam standart hataları hesapla; (4) küme ya da yabani küme bootstrap'ıyla katsayıların kovaryansını kestir; (5) normal güven aralığını ve p değerini yaz.
51.4.1 Olağan bootstrap neden yetmez
Bağımsız gözlemlerde ortalamanın bootstrap standart hatasının B\to\infty sınırı kapalı biçimdedir:
- \bar y: seri ortalaması; s: n-1 bölenli standart sapma.
- İçteki ortalama, verinin n bölenli varyansıdır: yeniden örnekleme her gözleme 1/n olasılık verdiği için bootstrap dünyasında "evren varyansı" budur.
- Şablon bu değeri "bağımsız (iid) bootstrap varsayımıyla SH" satırında yazar (satır 159); yalnız ortalama istatistiğinde hesaplanır.
Durağan ve ilişkili bir seride ortalamanın gerçek varyansı ise gecikmeli kovaryansları da içerir:
- \gamma_k=\operatorname{Kov}(y_t,y_{t+k}): k. gecikme otokovaryansı; \gamma_0 varyanstır.
- Parantez içindeki toplam "uzun dönem varyansı"dır. Gözlemler bağımsızsa yalnız \gamma_0 kalır.
- Pozitif otokorelasyon toplamı büyütür: ardışık gözlemler birbirini yineler, veri göründüğünden az bilgi taşır.
Neden bloklar?
Tek tek çekilen gözlemler birbirinden bağımsızdır; yeniden örneklemde \gamma_k (k\ge1) sıfırlanır ve varyans formülünde yalnız \gamma_0 kalır. l uzunluklu bir blok ise içindeki l-1 komşuluğu olduğu gibi taşır; blok toplamlarının varyansı l'ye kadar olan otokovaryansları kendiliğinden içerir. Bloklar arasındaki bağımlılık kaybolur; bu yüzden blok, bağımlılığın söndüğü uzaklıktan kısa olmamalıdır.
51.4.2 Blokların kurulması
Üç yöntem de aynı iskeleti kullanır: bir başlangıç noktası çek, oradan l ardışık gözlem al, n gözlem dolana dek yinele.
- b: blok sayısı; ilk b-1 blok l uzunluğunda, son blok r uzunluğundadır (r=l olabilir). Toplam uzunluk tam n'dir.
- S_1,\dots,S_b: birbirinden bağımsız, eşit olasılıklı başlangıç noktaları.
- Hareketli blok (MBB): S_j\in\{1,\dots,n-l+1\}. Blok serinin sonunu aşamaz.
- Dairesel blok (CBB): S_j\in\{1,\dots,n\}; dizinler n'yi aşınca başa döner (y_{n+1}\equiv y_1). Seri bir halka gibi sarılır.
- Durağan bootstrap: başlangıçlar yine \{1,\dots,n\}'den ve sarmalı; blok uzunlukları sabit değil, ortalaması l olan geometrik dağılımdan çekilir (L_j=1+\text{Geo}(1/l)); son blok n'yi tamamlayacak biçimde kesilir.
Neden dairesel blok varsayılan?
Hareketli blokta ilk ve son gözlemler az sayıda bloğa girebilir: y_1 yalnız 1. başlangıçtan çekilen bloğa, ortadaki bir gözlem ise l ayrı bloğa düşer. Örnek seride (n=114, l=5) bir kopyada y_1'in beklenen görülme sayısı 0,209, ortadaki bir gözleminki 1,036'dır. Uçlar eksik ağırlık aldığından yeniden örneklem ortalamasının beklenen değeri \bar y değildir (örnek seride 2,90095; \bar y=2{,}90366). Dairesel blokta her gözlem her konuma eşit olasılıkla gelir, E^{*}(\bar y^{*})=\bar y olur ve yeniden örneklem ortalamasının varyansı kapalı biçimde yazılabilir (51.4.5).
Neden durağan bootstrap?
Sabit uzunluklu bloklarla kurulan yeniden örneklem durağan değildir: bir gözlemin komşusuyla ilişkisi, blok içinde mi yoksa ek yerinde mi olduğuna bağlıdır. Blok uzunluğu rastgele (geometrik) seçilince ek yerleri rastgele konumlara dağılır ve yeniden örneklenen seri, veriye koşullu olarak durağan olur (Politis ve Romano, 1994). Karşılığında kısa bloklar da üretilir; aynı l için standart hata sabit bloktakinden çoğunlukla küçük çıkar.
Koddaki tercih
Yeniden örnekleme boot::tsboot(y, istat, R = B, l = l, sim = sim, endcorr = sarma) ile yapılır (satır 150–151; ortalama ve medyan). Otokorelasyon ve AR'de tsboot'a seri değil gecikmeli satırlar matrisi verilir (51.4.3; satır 134–148). sim = "fixed" sabit, "geom" geometrik blok uzunluğudur (132); endcorr = TRUE başlangıçları \{1,\dots,n\}'den çeker ve sarar, FALSE \{1,\dots,n-l+1\}'den çeker (133). tsboot, sim = "geom" iken endcorr'u kendisi TRUE yapar. Paket bütün başlangıçları tek çağrıda çeker (sample.int(uç, b·B, replace = TRUE), B\times b matris) ve dizinleri 1 + (i − 1) mod n ile sarar. Şablonda tohum ataması yoktur; R'nin üreteci çalıştırmanın tohumuyla yürütücüde kurulur (Bölüm 1.3). Kod panelindeki Tohum alanı boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar, doluysa o tohumu kullanır (pro/gui/kod_panel.py:552–572); kullanılan tohum sonuç kartının künyesine ve betik adımına yazılır (Bölüm 1.3). Tohum alanı boşken art arda iki çalıştırma bu nedenle Monte Carlo hatası kadar farklı sonuç verir; aynı tohum girildiğinde ya da kaydedilmiş betik yeniden oynatıldığında aynı sonuç alınır.
51.4.3 İstatistikler
Yeniden örneklenen \mathbf y^{*} serisine dört işlevden biri uygulanır (satır 126–129):
- c_k: örneklem otokovaryansı; bölen n-k değil n'dir (
stats::acftanımı). Böylece otokorelasyon matrisi her zaman pozitif tanımlıdır. - r_1: 1. gecikme otokorelasyonu (
acf(z, lag.max = 1)$acf[2]). - \phi_1,\dots,\phi_p: AR(p) modelinin y_t-\mu=\sum_j\phi_j(y_{t-j}-\mu)+a_t katsayıları. İkinci satırdaki Yule-Walker denklemleri, kuramsal otokovaryansların yerine örneklem değerleri konarak çözülür (
stats::ar.yw(aic = FALSE, order.max = p, demean = TRUE)).
Otokorelasyon ve AR katsayılarında blokların blokları
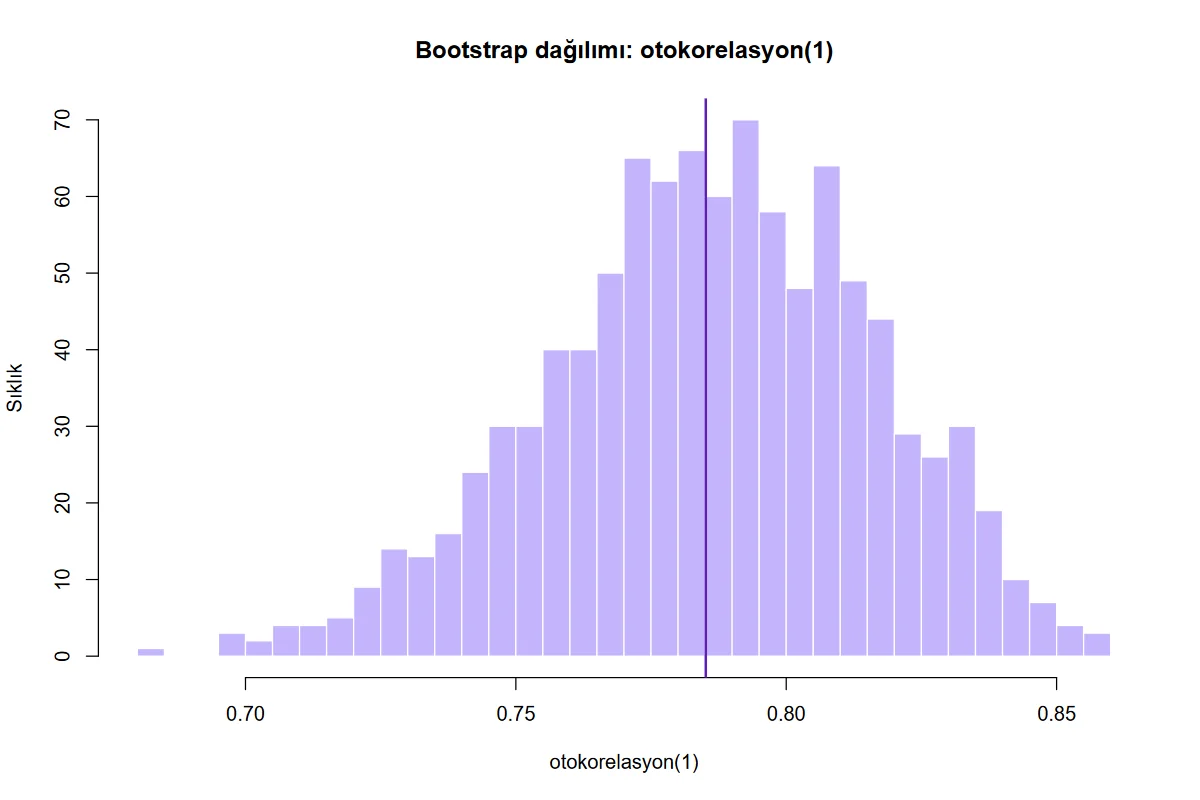
Bloklar uç uca eklendiğinde her ek yerinde birbirinden bağımsız iki gözlem komşu olur. Ortalama ve medyan bundan etkilenmez; c_1 gibi komşu çiftlere dayanan istatistikler yapay çiftlerle sıfıra çekilir (l=5'te komşu çiftlerin yaklaşık beşte biri yapaydır). Bu yüzden şablon, bu iki istatistikte seriyi değil gecikmeli satırları yeniden örnekler (Künsch, 1989; Davison ve Hinkley, 1997, §8.2.3; boot::tsboot belgesi): K=1 (otokorelasyon) ya da K=p (AR) için N=n-K satırlık \mathbf z_t=(y_t,\dots,y_{t+K}) matrisi kurulur ve bloklar bu satırlardan çekilir; çarpımlar yalnız satır içinde kurulduğundan yapay çift oluşmaz (satır 134–148). Dairesel ve durağan yöntemde bloklar satır dizisi üzerinde sarılır (seri uç uca eklenmez); hareketli blokta başlangıçlar 1,\dots,N-l+1'dir. Kopyada satırların ortak ortalaması \bar z çıkarılır; gecikme k otokovaryansı c^{*}_k, (j,\,j+k) sütun çiftlerindeki çarpımların ortalamasıdır; r_1^{*}=c_1^{*}/c_0^{*} ve AR katsayıları Yule-Walker sisteminin c^{*} ile çözümüdür. Kestirim \hat\theta özgün seriden acf ve ar.yw ile alınır (yukarıdaki tanım). Örnek seride r_1=0{,}7851 iken 999 kopyanın ortalaması 0,7859, standart hata 0,0302 ve yüzdelik aralık [0,7244; 0,8391]'dir: kestirim aralığın içindedir (Şekil 51.2).
51.4.4 Kopyalardan özetler
\hat\theta özgün serideki değer, \hat\theta^{*}_1,\dots,\hat\theta^{*}_B kopyalardaki değerler olsun (satır 104–110):
- \alpha=1-\text{güven düzeyi}; z_{1-\alpha/2}: standart normal kantil (0,95 için 1,959964).
- q^{*}_p: kopyaların p. kantili. R'nin varsayılan tanımıyla (tip 7) hesaplanır: sıralı kopyalar \hat\theta^{*}_{(1)}\le\dots\le\hat\theta^{*}_{(B)} ve h=(B-1)p için q^{*}_p=\hat\theta^{*}_{(\lfloor h\rfloor+1)}+(h-\lfloor h\rfloor)\big(\hat\theta^{*}_{(\lfloor h\rfloor+2)}-\hat\theta^{*}_{(\lfloor h\rfloor+1)}\big).
- Yanlılık, bootstrap dünyasında kestiricinin beklenen değeri ile "gerçek" değer (özgün kestirim) arasındaki farktır; istatistiğin kendisinin yanlılığı için bir kestirimdir.
Neden iki ayrı güven aralığı?
Yüzdelik aralık kopyaların dağılımını olduğu gibi kullanır: çarpıklığı taşır, ama dağılım kestirimin çevresinde değil de kaymış duruyorsa (yanlılık) aralık da kayar. Normal aralık yalnız standart hatayı kullanır ve kestirimin çevresinde simetriktir; dağılımın biçimini yok sayar. İkisi birbirine yakınsa bootstrap dağılımı yaklaşık normal ve yansızdır. Belirgin biçimde ayrışıyorlarsa önce yanlılık sütununa bakılır.
Koddaki tercih
Normal aralık \hat\theta\mp z\operatorname{SH}^{*} biçimindedir (108–109): yanlılık çıkarılmaz. boot::boot.ci(type = "norm") ise \hat\theta-\text{yanlılık}\mp z\operatorname{SH}^{*} kullanır ve yüzdelik sınırlarını (B+1)p. sıra istatistiğinden alır; şablonun sınırları boot.ci çıktısıyla bu nedenle küçük farklar gösterir. Güven düzeyi tam 0,95 ise olasılıklar 0,025 ve 0,975 olarak sabitlenir (102); kayan noktalı aritmetikte (1-0{,}95)/2 tam 0,025 vermez.
51.4.5 Dairesel blokta ortalamanın ideal standart hatası
Dairesel blokta yeniden örneklem ortalaması, bağımsız b blok toplamının n'ye bölümüdür. Her blok toplamı, n olası başlangıcın biri eşit olasılıkla seçilerek belirlenir; dolayısıyla varyansı, n başlangıç üzerinden doğrudan hesaplanabilir. B\to\infty için bootstrap varyansı tam olarak şudur:
- T_m(s): s'den başlayan m uzunluklu dairesel blok toplamı (y_{n+j}\equiv y_j).
- V_m: bu toplamın n başlangıç üzerindeki (n bölenli) varyansı; \bar T_m=m\bar y.
- b-1 tam blok (V_l) ve bir son blok (V_r) bağımsız olduğundan varyanslar toplanır.
- l=1 için V_1 verinin varyansıdır ve formül \operatorname{SH}_{\text{iid}}'ye iner.
Aynı büyüklük dairesel otokovaryanslarla da yazılabilir; bu biçim blokların neyi yakaladığını gösterir:
- \hat c^{\circ}_h: sarmalı (dairesel) örneklem otokovaryansı.
- V_l/l, uzun dönem varyansının l-1 gecikmeye kadar üçgen ağırlıklı (Bartlett) kestirimidir. Blok bootstrap bu kestirimi örtük olarak yapar.
İdeal değer neden yazılır?
Bootstrap standart hatası iki ayrı belirsizlik taşır: verinin kendisinden gelen (istatistiksel) ve sonlu B'den gelen (Monte Carlo). İdeal değer ikincisini sıfırlar. \operatorname{SH}^{*} ile karşılaştırılarak B'nin yeterli olup olmadığı görülür; bağımsızlık varsayımlı değerle karşılaştırılarak da bağımlılığın belirsizliği ne kadar büyüttüğü okunur. Şablon ideal değeri yalnız ortalama ve dairesel blok seçiliyken hesaplar (satır 143–150); öteki istatistik ve yöntemlerde kapalı biçim yoktur.
51.4.6 Blok uzunluğu
Blok uzunluğu verilmezse şablon l=\max\{1,\operatorname{round}(n^{1/3})\} alır (satır 122). l<n/2 olmalıdır (123).
Neden n^(1/3)?
Kısa blok bağımlılığı kaçırır (yanlılık), uzun blok az sayıda bağımsız parça bırakır (varyans). Varyans ya da standart hata kestiriminde bu ikisini dengeleyen blok uzunluğu C\,n^{1/3} mertebesindedir (Hall, Horowitz ve Jing, 1995); C serinin otokovaryans yapısına bağlıdır. Şablon C=1 alır: bir başlangıç değeridir, veriye uyarlanmış bir seçim değildir. Veriye dayalı seçim (Politis ve White, 2004) şablonda yoktur.
Döngüsel seride standart hata blok uzunluğuna çok duyarlıdır
Örnek seride döngü yaklaşık 9,7 yıldır. Ortalamanın ideal dairesel blok standart hatası l ile düzgün değişmez: l=1: 0,0521; l=4: 0,0808; l=5: 0,0793; l=10: 0,0595; l=20: 0,0574; l=30: 0,0465. Yarım döngü uzunluğundaki bloklar (l\approx5) hep "yüksek" ya da hep "alçak" yılları toplar ve blok toplamları en çok o zaman oynar; tam döngü uzunluğundaki bloklar (l\approx10) bir tepe ile bir çukuru birlikte içerir ve toplamları birbirine yaklaşır. Varsayılan kural bu seride 5 verir. Döngüsel serilerde sonuç birkaç l ile yinelenir ve birlikte raporlanır.
51.4.7 Kümelenmiş regresyon: üç standart hata
Model en küçük karelerle kestirilir: \hat{\boldsymbol\beta}=(\mathbf X^{\top}\mathbf X)^{-1}\mathbf X^{\top}\mathbf y, \hat e_{gi}=y_{gi}-\mathbf x_{gi}^{\top}\hat{\boldsymbol\beta}. Şablon aynı katsayılar için üç kovaryans kestirimi verir:
- k=q+1: sabit dahil katsayı sayısı.
- \mathbf u_g: kümenin skor toplamı. Küme içinde artıklar önce toplanır, sonra kareleri alınır; böylece küme içi çapraz çarpımlar (ilişki) kovaryansa girer.
- Çarpan olmadan aynı ifade CR0 olarak adlandırılır; CR1, küme sayısının ve katsayı sayısının sonlu olmasını düzeltir.
- Klasik kovaryans hataların bağımsız ve eş varyanslı olduğunu varsayar.
Koddaki tercih
Model lm ile kurulur (satır 189); klasik standart hata vcov(m), küme-sağlam standart hata sandwich::vcovCL(m, cluster = ~.kume) ile alınır (195). vcovCL'in varsayılanları type = "HC1" ve cadjust = TRUE'dur: birincisi (n-1)/(n-k), ikincisi G/(G-1) çarpanını getirir; ikisinin çarpımı yukarıdaki CR1 düzeltmesidir. Sütun adlarındaki ters tırnak (187–188) boşluk ya da özel karakter içeren değişken adlarının formülde bozulmasını önler.
51.4.8 Küme (çift) bootstrap
Her kopyada G küme, yerine koyarak çekilir; çekilen her küme bütün gözlemleriyle (yanıt ve açıklayıcılar birlikte: "çift") veriye girer, model yeniden kestirilir:
- \mathbf X^{*},\mathbf y^{*}: çekilen kümelerin satırlarının alt alta dizilmesi. Bir küme iki kez çekildiyse satırları iki kez yer alır; hiç çekilmeyen küme o kopyada yoktur. Kümeler dengesizse kopyanın gözlem sayısı n'den farklı olabilir.
- \hat{\mathbf V}_{\text{BS}}: kopya katsayılarının örneklem kovaryansı; köşegeninin karekökü bootstrap standart hatasıdır.
- Varsayım: kümeler birbirinden bağımsız ve aynı süreçten gelir; küme içi bağımlılığın biçimi serbesttir.
51.4.9 Yabani küme bootstrap
Açıklayıcılar sabit tutulur; yalnız artıklar, küme başına tek bir rastgele ağırlıkla çarpılarak yeni yanıtlar üretilir:
- v_g: kümenin ağırlığı; E(v_g)=0, E(v_g^2)=1. Kümenin bütün artıkları aynı v_g ile çarpıldığından küme içi ilişki korunur.
- İkinci eşitlik, yeniden kestirimin \hat{\boldsymbol\beta} ile skor toplamlarının rastgele işaretli toplamından ibaret olduğunu gösterir. Buradan \operatorname{Var}^{*}(\hat{\boldsymbol\beta}^{*})=(\mathbf X^{\top}\mathbf X)^{-1}\sum_g\mathbf u_g\mathbf u_g^{\top}(\mathbf X^{\top}\mathbf X)^{-1} çıkar: yabani küme bootstrap kovaryansının B\to\infty sınırı CR0'dır.
- Webb'in altı noktalı dağılımı, az kümede Rademacher'in yalnız 2^G farklı kopya üretebilmesi sorununu giderir (Webb, 2023).
Çift bootstrap mı, yabani bootstrap mı?
Çift bootstrap hiçbir model varsayımı yapmaz, ama az kümede ya da bir açıklayıcı yalnız birkaç kümede değişiyorsa kararsızdır: bazı kopyalarda o açıklayıcı neredeyse sabit kalır. Yabani bootstrap tasarım matrisini olduğu gibi korur ve az kümede daha iyi davranır (Cameron, Gelbach ve Miller, 2008). Bu çalışmaların asıl önerisi yabani bootstrap'ı t istatistiğine uygulayıp p değerini kopyalardan okumaktır; şablon yalnız standart hatayı bootstrap'tan alır, aralığı ve p değerini normal dağılımla kurar.
Koddaki tercih
Bootstrap kovaryansı sandwich::vcovBS(m, cluster = ~.kume, R = B, type = …) ile alınır (satır 191). type = "xy" çift bootstrap'tır: paket her kopyada sample(names(cli), G, replace = TRUE) ile küme adlarını çeker ve .lm.fit ile yeniden kestirir. "wild" Rademacher, "webb" Webb ağırlıklarıdır; paket yeni yanıtı kurar ve özgün modelin QR ayrışımıyla katsayıları bulur. Dönen değer kopya katsayılarının kovaryans matrisidir (cov); kopyaların kendisi dönmez. Tablodaki aralık \hat\beta\mp z\operatorname{SH}_{\text{BS}}, p_bootstrap sütunu 2\Phi(-\lvert\hat\beta/\operatorname{SH}_{\text{BS}}\rvert)'dir (197–198).
51.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–95 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on iki parametre. | Form buradan kurulur (Bölüm 1.2). |
| 96–110 | Dil yardımcısı .m; boot ve sandwich; B, güven düzeyi, yüzdelik olasılıkları pq, normal kantil zq; özet işlevi ozet_t. |
ozet_t kopya matrisinin her sütununu ayrı parametre sayar; na.rm = TRUE ile hesaplanamayan kopyalar atlanır. |
| 111–125 | Zaman kipi: seriyi oku, uçlardaki eksikleri kırp, log10, denetimler, blok uzunluğu, AR mertebesi. | Seri mq_sayisal ile okunur (112); değerler sayıya çevrilebilmelidir. Kural l=\operatorname{round}(n^{1/3}) (122). |
| 126–131 | İstatistik işlevi istat (kestirim için) ve parametre adları. |
AR'de işlev p uzunluklu vektör döndürür; tabloda ar1, ar2, … satırları olur. |
| 132–153 | sim, endcorr; otokorelasyon ve AR için gecikmeli satırlar matrisi Zg ve kopya istatistiği istat_g (134–148); tsboot çağrıları (146–147, 150–151); ozet_t(bt$t0, bt$t, adlar). |
Rastgelelik yalnız burada tüketilir; tohum çalıştırmanın tohumudur (Tohum alanı boşsa arayüz her çalıştırmaya yenisini atar). Kestirim bt$t0 her durumda özgün seriden gelir (148). |
| 154–159 | Özet satırı, bootstrap tablosu, "Ayrıntılar" tablosunun ilk dört satırı. | Bağımsızlık varsayımlı SH yalnız ortalamada; ötekilerde boş (NaN). |
| 160–168 | Ortalama + dairesel blokta ideal SH: seri iki kez art arda yazılır (yy), n başlangıcın blok toplamları, V_l ve V_r. |
pv n bölenli varyanstır (164). |
| 169–172 | Kopyaların histogramı (40 aralık) ve özgün kestirim çizgisi. | Yalnız ilk parametre çizilir (AR'de \phi_1). |
| 173–190 | Küme kipi: seçimler, sayıya çevirme, eksik satırlar, factor, denetimler, formül, lm. |
Formül yalnız ana etkilerdir; etkileşim ve kategorik açıklayıcı yoktur. |
| 191–201 | vcovBS; klasik, CR1 ve bootstrap SH; normal GA ve p; iki tablo. |
vcovBS kovaryans döndürür; yüzdelik aralık bu kipte hesaplanmaz. |
| 202–206 | Üç standart hatanın çubuk grafiği. | Her katsayı için klasik, küme-sağlam, bootstrap yan yana. |
Kritik satırlar:
sim <- if (yontem == "duragan") "geom" else "fixed"     # yontem: formdaki blok yöntemi
sarma <- yontem != "hareketli"
bt <- tryCatch(tsboot(y, istat, R = B, l = l, sim = sim, endcorr = sarma), …)   # ortalama, medyan
# otokorelasyon ve AR: tsboot(Zg, istat_g, …) — Zg gecikmeli satırlar matrisi; bt$t0 <- istat(y)
…
nb <- ceiling(n / l); r <- 1 + (n - 1) %% l
ideal <- sqrt(((nb - 1) * pv(bsum(l)) + pv(bsum(r))) / n^2)
51.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/bagimli_bootstrap/elle_hesap.py ile, tsboot, vcovBS, vcovCL ve lm kullanılmadan hesaplanmıştır. Bootstrap rastgele olduğundan bağımsız hesabın şablonla aynı sayıları vermesi için aynı çekilişler gerekir: R'nin rastgele sayı üreteci (Mersenne-Twister ve sample.int'in reddetmeli örneklemesi) Python'da yeniden kurulmuş, tohum 2026 ile aynı başlangıç noktaları üretilmiştir. R tarafında (r_dogrulama.R) aynı tohumla açık bir döngü yazılmış, istatistikler ve kovaryanslar paketsiz hesaplanmıştır.
Adım 1 — Seri ve kestirim. y_t=\log_{10}(\text{lynx}_t), n=114. \bar y=2{,}903664; c_0=0{,}309085.
Adım 2 — Blok planı. l=5: b=\lceil114/5\rceil=23, r=1+113\bmod5=4. Bir kopya 22 tam blok ve 4 gözlemlik bir son bloktan oluşur: 22\times5+4=114.
Adım 3 — İlk kopya. Tohum 2026 ile ilk kopyanın 23 başlangıç noktası: 93, 7, 90, 107, 33, 111, 102, 70, 10, 90, 27, 29, 16, 51, 59, 9, 54, 68, 30, 75, 83, 56, 14. Birinci blok y_{93},\dots,y_{97} = 3,5798; 3,4901; 3,4749; 3,5786; 2,8287 (toplam 16,9521). Altıncı blok 111'den başlar ve sarar: y_{111},y_{112},y_{113},y_{114},y_{1} = 3,0000; 3,2014; 3,4244; 3,5310; 2,4298. 114 değerin ortalaması \bar y^{*}_1=2{,}932702.
Adım 4 — 999 kopyanın özeti.
Yüzdelik alt sınır: h=998\times0{,}025=24{,}95; sıralı kopyaların 25. ve 26.'sı 2,755200 ve 2,755856; q^{*}_{0{,}025}=2{,}755200+0{,}95\times(2{,}755856-2{,}755200)=2{,}755823. Üst sınır: h=973{,}05; 974. ve 975. değerler 3,040098 ve 3,040167; q^{*}_{0{,}975}=3{,}040101.
Adım 5 — Normal aralık. 2{,}903664\mp1{,}959964\times0{,}077185=[2{,}752384;\ 3{,}054943].
Adım 6 — İdeal standart hata. 114 dairesel başlangıcın 5'li blok toplamlarının varyansı V_5=3{,}582999, 4'lü blok toplamlarının varyansı V_4=2{,}990574.
Monte Carlo değeri (0,077185) ideal değerin 0,0022 altındadır. B=999 kopyayla bir standart hatanın Monte Carlo standart hatası yaklaşık \operatorname{SH}/\sqrt{2B}=0{,}0018'dir; fark bunun 1,2 katıdır ve beklenen oynaklık içindedir. B=4000'de 0,077748, B=20000'de 0,079487 elde edilir.
Bağımsızlık varsayımına oran: 0{,}079344/0{,}052070=1{,}524. Otokorelasyon yok sayılsaydı standart hata yaklaşık üçte bir oranında küçük görünecekti.
Adım 7 — Kümelenmiş regresyon (çalıştırma 11). petersen.csv, n=5000, G=500, k=2.
| Sabit | x | |
|---|---|---|
| \hat\beta | 0,029680 | 1,034833 |
| Klasik SH | 0,028359 | 0,028583 |
| CR0 SH | 0,066939 | 0,050540 |
| CR1 SH | 0,067013 | 0,050596 |
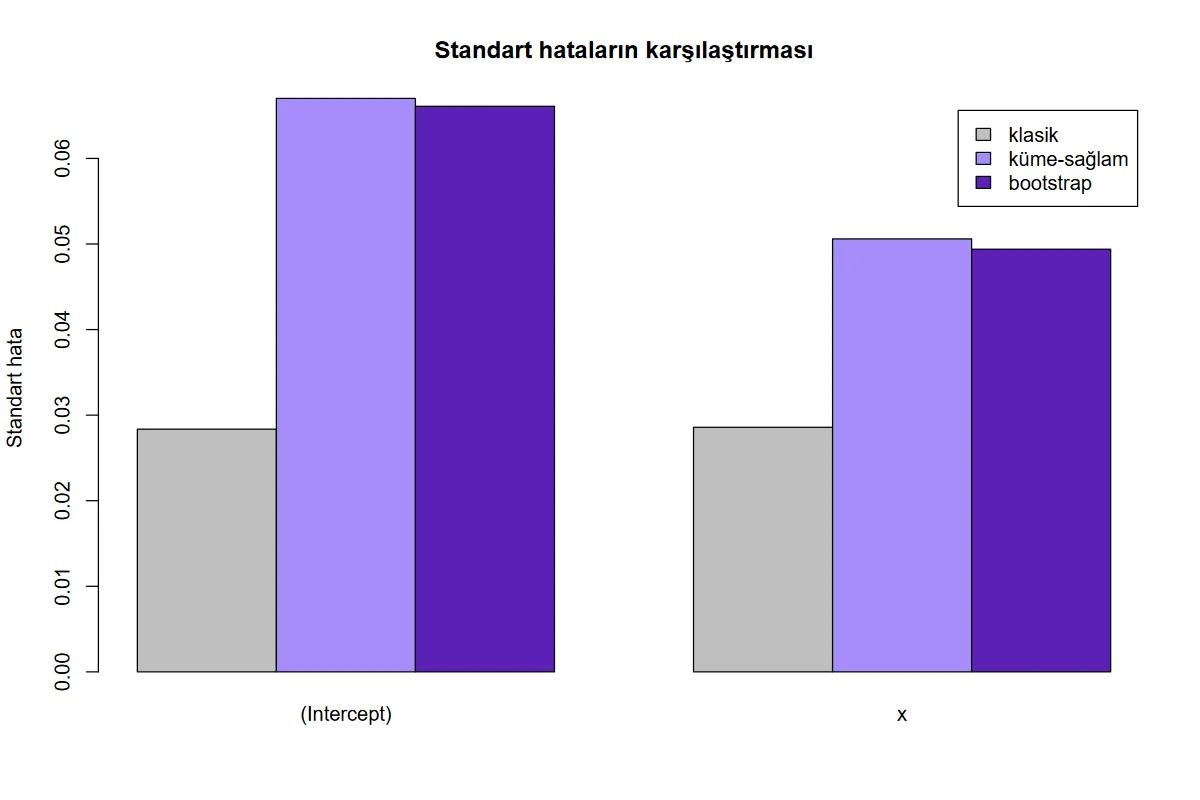
CR1 çarpanı \frac{500}{499}\cdot\frac{4999}{4998}=1{,}002204; 0{,}050540\times\sqrt{1{,}002204}=0{,}050596. Küme-sağlam standart hata x için klasik değerin 1,77 katı, sabit için 2,36 katıdır.
Adım 8 — Küme (çift) bootstrap. İlk kopyada çekilen kümeler 221, 121, 481, 294, 45, 111, 347, 108, … (500 çekiliş); bu kümelerin satırlarıyla yeniden kestirim \hat\beta^{*}_1=(-0{,}000264;\ 1{,}038308). 999 kopyanın standart sapması: sabit 0,066090, x 0,049392. x için aralık 1{,}034833\mp1{,}959964\times0{,}049392=[0{,}938028;\ 1{,}131639].
Adım 9 — Yabani küme bootstrap. Aynı tohumla Rademacher ağırlıkları: SH 0,067321 ve 0,049421; Webb ağırlıkları: 0,066592 ve 0,049872. Her ikisinin B\to\infty sınırı CR0'dır (0,066939 ve 0,050540); farklar Monte Carlo oynaklığıdır (999 kopyada yaklaşık 0,0011).
51.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–8, 10, 11; tohum 2026).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Ortalama, dairesel: kestirim | 2,90366375 | 2,90366375 | 2,90366375 | 4,6e−16 | ✓ |
| Ortalama, dairesel: bootstrap ortalaması | 2,90141697 | 2,90141697 | 2,90141697 | 1,7e−15 | ✓ |
| Ortalama, dairesel: yanlılık | −0,00224678 | −0,00224678 | −0,00224678 | 3,8e−16 | ✓ |
| Ortalama, dairesel: bootstrap SH | 0,07718493 | 0,07718493 | 0,07718493 | 4,2e−17 | ✓ |
| Ortalama, dairesel: yüzdelik GA alt | 2,75582297 | 2,75582297 | 2,75582297 | 8,1e−16 | ✓ |
| Ortalama, dairesel: yüzdelik GA üst | 3,04010131 | 3,04010131 | 3,04010131 | 1,3e−15 | ✓ |
| Ortalama, dairesel: normal GA alt | 2,75238407 | 2,75238407 | 2,75238407 | 0 | ✓ |
| Ortalama, dairesel: normal GA üst | 3,05494343 | 3,05494343 | 3,05494343 | 2,9e−16 | ✓ |
| Bağımsızlık varsayımıyla SH | 0,05206987 | 0,05206987 | 0,05206987 | 4,2e−17 | ✓ |
| İdeal dairesel blok SH'si (l=5) | 0,0793443 | 0,0793443 | 0,0793443 | 8,3e−17 | ✓ |
| İdeal dairesel blok SH'si (l=1) | 0,05206987 | 0,05206987 | 0,05206987 | 4,2e−17 | ✓ |
| İdeal dairesel blok SH'si (l=10) | 0,05949179 | 0,05949179 | 0,05949179 | 4,2e−17 | ✓ |
| İdeal dairesel blok SH'si (l=20) | 0,05740427 | 0,05740427 | 0,05740427 | 4,2e−17 | ✓ |
| Ortalama, dairesel, %90: yüzdelik GA alt | 2,77310633 | 2,77310633 | 2,77310633 | 4,8e−16 | ✓ |
| Ortalama, dairesel, %90: yüzdelik GA üst | 3,02534574 | 3,02534574 | 3,02534574 | 1,3e−15 | ✓ |
| Ortalama, dairesel, %90: normal GA alt | 2,77670584 | 2,77670584 | 2,77670584 | 1,4e−15 | ✓ |
| Ortalama, dairesel, %90: normal GA üst | 3,03062166 | 3,03062166 | 3,03062166 | 8,8e−16 | ✓ |
| Ortalama, hareketli: bootstrap ortalaması | 2,89770265 | 2,89770265 | 2,89770265 | 1,5e−16 | ✓ |
| Ortalama, hareketli: bootstrap SH | 0,08289137 | 0,08289137 | 0,08289137 | 4,2e−17 | ✓ |
| Ortalama, hareketli: yüzdelik GA alt | 2,72864063 | 2,72864063 | 2,72864063 | 4,9e−16 | ✓ |
| Ortalama, hareketli: yüzdelik GA üst | 3,05090615 | 3,05090615 | 3,05090615 | 1,2e−15 | ✓ |
| Ortalama, durağan: bootstrap ortalaması | 2,90345731 | — | 2,90345731 | 1,4e−15 | ✓ |
| Ortalama, durağan: bootstrap SH | 0,06650953 | — | 0,06650953 | 2,8e−17 | ✓ |
| Ortalama, durağan: yüzdelik GA alt | 2,77102562 | — | 2,77102562 | 1,4e−15 | ✓ |
| Ortalama, durağan: yüzdelik GA üst | 3,03206304 | — | 3,03206304 | 7,3e−16 | ✓ |
| Medyan, dairesel: kestirim | 2,88699263 | 2,88699263 | 2,88699263 | 1,4e−15 | ✓ |
| Medyan, dairesel: bootstrap SH | 0,12673577 | 0,12673577 | 0,12673577 | 8,3e−17 | ✓ |
| Medyan, dairesel: yüzdelik GA alt | 2,72097868 | 2,72097868 | 2,72097868 | 0 | ✓ |
| Medyan, dairesel: yüzdelik GA üst | 3,18512185 | 3,18512185 | 3,18512185 | 9,8e−16 | ✓ |
| Otokorelasyon(1), dairesel: kestirim | 0,78512404 | 0,78512404 | 0,78512404 | 7,8e−16 | ✓ |
| Otokorelasyon(1), dairesel: bootstrap ortalaması | 0,78585591 | 0,78585591 | 0,78585591 | 0 | ✓ |
| Otokorelasyon(1), dairesel: bootstrap SH | 0,03015184 | 0,03015184 | 0,03015184 | 4,5e−17 | ✓ |
| Otokorelasyon(1), dairesel: yüzdelik GA alt | 0,72443816 | 0,72443816 | 0,72443816 | 4,4e−16 | ✓ |
| Otokorelasyon(1), dairesel: yüzdelik GA üst | 0,83913967 | 0,83913967 | 0,83913967 | 1,1e−16 | ✓ |
| AR(2) \phi_1, dairesel: kestirim | 1,35043761 | 1,35043761 | 1,35043761 | 2,1e−15 | ✓ |
| AR(2) \phi_1, dairesel: bootstrap ortalaması | 1,36458459 | 1,36458459 | 1,36458459 | 3,7e−15 | ✓ |
| AR(2) \phi_1, dairesel: bootstrap SH | 0,07797227 | 0,07797227 | 0,07797227 | 6,9e−17 | ✓ |
| AR(2) \phi_2, dairesel: kestirim | −0,72003089 | −0,72003089 | −0,72003089 | 2,2e−15 | ✓ |
| AR(2) \phi_2, dairesel: bootstrap ortalaması | −0,7408944 | −0,7408944 | −0,7408944 | 1,1e−16 | ✓ |
| AR(2) \phi_2, dairesel: bootstrap SH | 0,04627936 | 0,04627936 | 0,04627936 | 3,5e−17 | ✓ |
| Ham seri ortalaması, dairesel: kestirim | 1538,01754386 | 1538,01754386 | 1538,01754386 | 5,9e−16 | ✓ |
| Ham seri ortalaması, dairesel: bootstrap SH | 203,86782991 | 203,86782991 | 203,86782991 | 2,8e−16 | ✓ |
| Ham seri: ideal SH (l=5) | 210,92694361 | 210,92694361 | 210,92694361 | 1,1e−15 | ✓ |
| Küme: katsayı (sabit) | 0,02967972 | 0,02967972 | 0,02967972 | 1,0e−16 | ✓ |
| Küme: klasik SH (sabit) | 0,02835932 | 0,02835932 | 0,02835932 | 1,0e−17 | ✓ |
| Küme: küme-sağlam SH, CR1 (sabit) | 0,0670127 | 0,0670127 | 0,0670127 | 1,4e−17 | ✓ |
| Küme: katsayı (x) | 1,03483344 | 1,03483344 | 1,03483344 | 7,7e−15 | ✓ |
| Küme: klasik SH (x) | 0,02858329 | 0,02858329 | 0,02858329 | 6,2e−17 | ✓ |
| Küme: küme-sağlam SH, CR1 (x) | 0,05059573 | 0,05059573 | 0,05059573 | 3,3e−16 | ✓ |
| Küme: bootstrap SH (çift; sabit) | 0,06608977 | 0,06608977 | 0,06608977 | 2,8e−17 | ✓ |
| Küme: bootstrap SH (çift; x) | 0,04939154 | 0,04939154 | 0,04939154 | 2,4e−16 | ✓ |
| Küme: GA alt (çift; x) | 0,9380278 | 0,9380278 | 0,9380278 | 4,4e−15 | ✓ |
| Küme: GA üst (çift; x) | 1,13163908 | 1,13163908 | 1,13163908 | 7,1e−15 | ✓ |
| Küme: p (çift; sabit) | 0,65337256 | 0,65337256 | 0,65337256 | 1,2e−15 | ✓ |
| Küme: bootstrap SH (yabani, Rademacher; sabit) | 0,06732087 | 0,06732087 | 0,06732087 | 1,4e−17 | ✓ |
| Küme: bootstrap SH (yabani, Rademacher; x) | 0,04942053 | 0,04942053 | 0,04942053 | 1,0e−15 | ✓ |
| Küme: bootstrap SH (yabani, Webb; sabit) | 0,06659224 | 0,06659224 | 0,06659224 | 8,3e−17 | ✓ |
| Küme: bootstrap SH (yabani, Webb; x) | 0,04987168 | 0,04987168 | 0,04987168 | 6,5e−16 | ✓ |
Ölçütü karşılayan: 58/58. Tohum 2026. Python: R'nin rastgele sayı üreteci yeniden kurularak aynı çekilişler, açık formüller (tsboot, vcovBS, vcovCL, lm kullanılmadan). R: aynı tohumla açık döngü. Durağan bootstrap'ta blok uzunlukları R'nin geometrik üretecinden geldiği için yalnız R ile karşılaştırılmıştır.
Üç yol aynı çekilişleri kullandığında bütün satırlar 10^{-14} düzeyinde örtüşür: tsboot ve vcovBS'nin yaptığı iş, 51.4'teki formüllerin doğrudan uygulamasıdır. Durağan bootstrap'ta blok uzunlukları R'nin geometrik üretecinden geldiği için karşılaştırma yalnız R'deki açık döngüyle yapılmıştır.
51.7 Çıktıyı okuma
Örnek ayarın konsol metni ve tabloları (tablolar dört ondalığa yuvarlanmış):
Blok bootstrap: n = 114, l = 5, B = 999, yöntem = dairesel, istatistik = ortalama

Blok bootstrap (dairesel, l = 5, B = 999)
parametre  kestirim  bootstrap_ort  yanlilik  SH_bootstrap
 ortalama    2.9037         2.9014   -0.0022        0.0772
GA_yuzdelik_alt  GA_yuzdelik_ust  GA_normal_alt  GA_normal_ust
         2.7558           3.0401         2.7524         3.0549

Ayrıntılar
                                   olcut    deger
                                       n 114.0000
                         blok uzunluğu l   5.0000
                                       B 999.0000
bağımsız (iid) bootstrap varsayımıyla SH   0.0521
       ideal (B → ∞) dairesel blok SH'si   0.0793
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Özet satırı | Kullanılan n, l, B, yöntem ve istatistik | n, uçlardaki eksikler atıldıktan sonraki uzunluktur. l=0 girildiyse burada kuralın verdiği değer görünür. |
kestirim |
İstatistiğin özgün serideki değeri | log10 açıksa log ölçeğindedir: 10^{2{,}9037}=801 (geometrik ortalama). |
bootstrap_ort, yanlilik |
Kopyaların ortalaması ve kestirimden farkı | Dairesel blokta ortalama için kuramsal değer sıfırdır; görülen −0,0022 Monte Carlo oynaklığıdır. Otokorelasyon ve AR'de büyük ve sistematik çıkar (51.4.3). |
SH_bootstrap |
Kopyaların standart sapması | İstatistiğin standart hatası. İdeal değerle karşılaştırılır. |
GA_yuzdelik_* |
Kopyaların \alpha/2 ve 1-\alpha/2 kantilleri | [2,7558; 3,0401]; özgün ölçekte [570;\ 1097]. |
GA_normal_* |
\hat\theta\mp z\operatorname{SH}^{*} | [2,7524; 3,0549]. Yüzdelik aralıkla yakınsa dağılım yaklaşık normaldir. |
| bağımsız (iid) … SH | Olağan bootstrap'ın ideal standart hatası | Bağımlılık yok sayılırsa elde edilecek değer (0,0521). |
| ideal … SH | Dairesel blok bootstrap varyansının tam değeri | B'den bağımsızdır; 0,0793. Oranı (1,52) bağımlılığın bedelidir. |
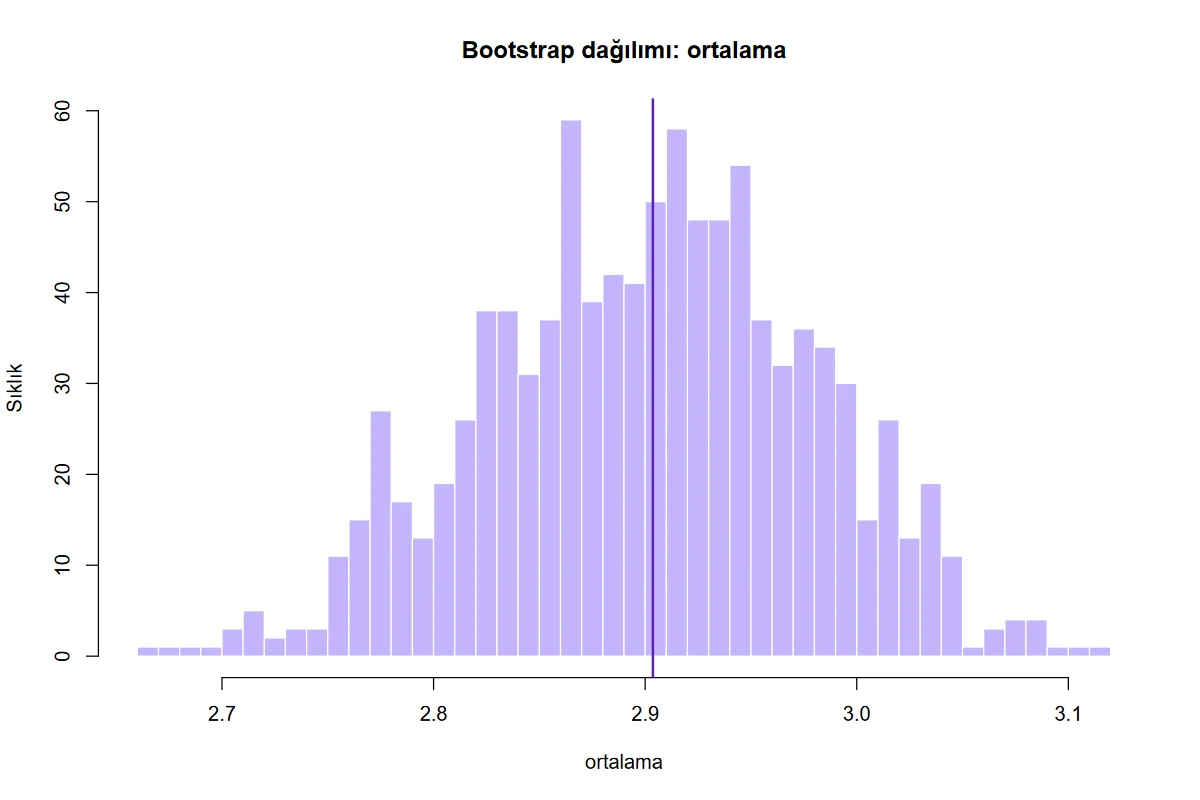
Şekil 51.1. Şablonun şekli (örnek ayar): 999 dairesel blok kopyasında ortalamanın dağılımı; dikey çizgi özgün kestirimdir (2,9037). Dağılım kestirimin çevresinde ve yaklaşık simetriktir.
Şekil 51.2. Aynı seride 1. gecikme otokorelasyonu (çalıştırma 5), blokların blokları. Kopyalar özgün kestirimin (0,785; dikey çizgi) çevresinde toplanır; yüzdelik aralık kestirimi içerir.
Yöntem ve istatistik seçeneklerinin aynı seride verdiği sonuçlar (l=5, B=999, tohum 2026):
| Çalıştırma | Kestirim | Bootstrap ort. | SH | Yüzdelik GA | Normal GA |
|---|---|---|---|---|---|
| Ortalama, dairesel | 2,9037 | 2,9014 | 0,0772 | [2,7558; 3,0401] | [2,7524; 3,0549] |
| Ortalama, hareketli | 2,9037 | 2,8977 | 0,0829 | [2,7286; 3,0509] | [2,7412; 3,0661] |
| Ortalama, durağan | 2,9037 | 2,9035 | 0,0665 | [2,7710; 3,0321] | [2,7733; 3,0340] |
| Medyan, dairesel | 2,8870 | 2,9208 | 0,1267 | [2,7210; 3,1851] | [2,6386; 3,1354] |
| Otokorelasyon(1), dairesel | 0,7851 | 0,7859 | 0,0302 | [0,7244; 0,8391] | [0,7260; 0,8442] |
| AR(2) \phi_1, dairesel | 1,3504 | 1,3646 | 0,0780 | [1,2190; 1,5193] | [1,1976; 1,5033] |
| AR(2) \phi_2, dairesel | −0,7200 | −0,7409 | 0,0463 | [−0,8346; −0,6497] | [−0,8107; −0,6293] |
Ortalamada üç blok yöntemi birbirine yakındır; durağan bootstrap aynı l ile daha küçük standart hata verir (ortalama blok uzunluğu aynı olsa da blokların çoğu 5'ten kısadır). Son üç satırda (blokların blokları, 51.4.3) bootstrap ortalaması kestirime yakındır ve yüzdelik ile normal aralık birbiriyle örtüşür; \phi_1 ve \phi_2 için bootstrap ortalamasıyla kestirim arasındaki fark küçüktür (yanlılık +0{,}014 ve -0{,}021).
Kümelenmiş regresyon kipinin çıktısı (çalıştırma 11, çift bootstrap):
Küme bootstrap: n = 5000, G = 500, B = 999, tür = xy

Kümelenmiş regresyon: xy bootstrap SH (G = 500 küme, B = 999)
  parametre  kestirim  SH_klasik  SH_kume_saglam_CR1  SH_bootstrap  GA_alt  GA_ust  p_bootstrap
(Intercept)    0.0297     0.0284              0.0670        0.0661 -0.0999  0.1592       0.6534
          x    1.0348     0.0286              0.0506        0.0494  0.9380  1.1316       0.0000

Ayrıntılar
                  olcut  deger
                      n   5000
          küme sayısı G    500
                      B    999
ortalama küme büyüklüğü     10
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
kestirim |
En küçük kareler katsayısı | Üç standart hata için aynıdır. |
SH_klasik |
Bağımsız, eş varyanslı hata varsayımıyla SH | Küme içi ilişki varsa küçük kalır. |
SH_kume_saglam_CR1 |
Kapalı formüllü küme-sağlam SH | Bootstrap değeri için karşılaştırma ölçütü. |
SH_bootstrap |
Seçilen bootstrap türünün SH'si | CR1'e yakın olmalıdır; büyük fark az küme ya da uç kümeye işaret eder. |
GA_alt, GA_ust |
\hat\beta\mp z\operatorname{SH}_{\text{bootstrap}} | Normal yaklaşımlı aralık; yüzdelik aralık değildir. |
p_bootstrap |
2\Phi(-\lvert\hat\beta/\operatorname{SH}_{\text{bootstrap}}\rvert) | Bootstrap standart hatalı Wald testi (normal dağılım). |
| ortalama küme büyüklüğü | n/G | Küme içi ilişkinin etkisi küme büyüdükçe artar. |
Üç bootstrap türü bu veride aynı sonuca varır: x için çift 0,0494, Rademacher 0,0494, Webb 0,0499; kapalı formül 0,0506.
Şekil 51.3. Küme kipinin şekli: her katsayı için klasik (gri), küme-sağlam (açık mor) ve bootstrap (koyu mor) standart hataları. Klasik değer ötekilerin yaklaşık yarısıdır.
Rapor cümlesi (örnek ayar):
Vaşak serisinin (1821–1934, n = 114) log10 ölçeğindeki ortalaması 2,904 bulundu. Ardışık yıllar arasındaki ilişki (1. gecikme otokorelasyonu 0,79) nedeniyle standart hata dairesel blok bootstrap'ıyla kestirildi (blok uzunluğu 5, B = 999): SH = 0,077; %95 yüzdelik GA [2,756; 3,040]. Blok bootstrap standart hatasının kuramsal (B → ∞) değeri 0,079, gözlemlerin bağımsız sayılması durumunda elde edilecek değer 0,052'dir. Geri dönüştürülmüş geometrik ortalama 801 (GA [570; 1097]) vaşaktır.
Petersen (2009) verisinde (5000 gözlem, 500 firma) x'in katsayısı 1,035 kestirildi. Firma düzeyinde küme (çift) bootstrap'ıyla (B = 999) standart hata 0,049 (%95 GA [0,938; 1,132]), kapalı formüllü küme-sağlam standart hata 0,051, kümelemeyi yok sayan klasik standart hata 0,029 bulundu.
51.8 Sık hatalar ve tuzaklar
- Veriyi zaman sırasında vermemek. Şablon satır sırasını zaman sırası sayar. Dosya başka bir sütuna göre sıralıysa bloklar ardışık dönemleri içermez; sonuç hatasız görünür ama anlamsızdır.
- Seride sayıya çevrilemeyen değer bırakmak. Ondalık virgüllü ("1,5") ya da metin ("yüksek") değerler çalıştırmayı durdurur (51.2); ondalık ayırıcı nokta olmalıdır.
- Otokorelasyon ya da AR katsayısında çok uzun blok seçmek. Blok uzunluğu serinin yarısına yaklaştıkça kopyalar birbirine benzer ve standart hata küçülür; l=20'de r_1 için SH 0,0179'a iner (yanlılık +0,0041). Tek bir blok uzunluğuyla yetinmeyip birkaçı denenir.
- Tek bir blok uzunluğuyla yetinmek. Döngüsel seride standart hata l'ye göre 0,047 ile 0,081 arasında değişir (51.4.6). En az üç blok uzunluğu denenir.
- Tohumu kaydetmemek. Tohum alanı boşsa her çalıştırmaya yeni bir tohum atanır; aynı ayarla iki çalıştırma farklı sonuç verir (örnek ayarda, farklı tohumlu iki çalıştırmada SH 0,0807 ve 0,0781). Sonucun yinelenebilmesi için künyedeki tohum Tohum alanına girilir ya da çalıştırma betiğe kaydedilir; iki çalıştırma arasındaki farkın Monte Carlo hatası olduğu unutulmaz.
- Eğilimli seriye blok bootstrap uygulamak. Yöntem durağanlık varsayar. Eğilim varken blok toplamlarının farkı eğilimden gelir ve standart hata şişer.
- Ortadaki eksik değeri silip seriyi kısaltmak. Aradan satır silmek, ardışık olmayan iki gözlemi komşu yapar. Şablon ortada eksik gördüğünde durur; çözüm satırı silmek değil, eksiği gerekçeli biçimde doldurmak ya da kesintisiz en uzun dilimi kullanmaktır.
- log10 ölçeğindeki aralığı aritmetik ortalamaya çevirmek. 10^{\bar y} geometrik ortalamadır (801); serinin aritmetik ortalaması 1538'dir.
- Küme kipinde
p_bootstrap'ı bootstrap p değeri sanmak. Sütun, bootstrap standart hatasıyla kurulmuş normal Wald testidir. Az kümede iyimserdir. - Az kümeyle çalışmak. Şablon 10 kümeyi kabul eder. Örnek veride yıl küme alındığında (G=10) x için klasik 0,0286, CR1 0,0334, çift bootstrap 0,0308 çıkar; bu büyüklükte hiçbiri güvenilir değildir. Yabani bootstrap'ın B\to\infty sınırı da düzeltmesiz CR0'dır; az kümede CR1'den belirgin küçük kalır.
- Yanlış düzeyde kümelemek. Küme, bağımlılığın en geniş birimidir. Öğrenciler sınıflarda, sınıflar okullardaysa ve okullar arasında bağımsızlık varsayılıyorsa küme okuldur.
51.9 Uzman soruları
S1. Monte Carlo standart hatası ideal değerden farklı; hangisi raporlanır?
İkisi aynı büyüklüğün iki kestirimidir: ideal değer sonsuz kopyanın vereceği sonuçtur, \operatorname{SH}^{*} ise B kopyadan hesaplanmış yaklaşığıdır. Ortalama ve dairesel blokta ideal değer eldeyken (0,0793) o raporlanır; Monte Carlo değeri (0,0772) yalnız B'nin yeterliliğini denetlemek içindir. Fark, \operatorname{SH}/\sqrt{2B}\approx0{,}0018 büyüklüğündeki Monte Carlo standart hatasının 1,2 katıdır. Güven aralığının yüzdelik sınırları için kapalı biçim yoktur; onlar için B büyütülür (B=20000'de aralık [2,7433; 3,0544]).
S2. Dairesel blokta "seriyi halka gibi sarmak" serinin sonuyla başını komşu yapıyor; bu bir bozulma değil mi?
Evet, her kopyada sarma noktasından geçen bloklarda y_n ile y_1 komşu olur. Bu, zaten her blok ek yerinde olan şeyin bir tane fazlasıdır ve etkisi 1/n mertebesindedir. Karşılığında her gözlem eşit ağırlık alır, E^{*}(\bar y^{*})=\bar y tam sağlanır ve varyans kapalı biçimde yazılır. Hareketli blokta uçların eksik ağırlığı ortalama için l/n mertebesinde bir kayma üretir (örnek seride beklenen değer 2,9010; kayma −0,0027).
S3. Şablonun normal aralığı neden boot.ci'nin normal aralığıyla aynı değil?
boot.ci(type = "norm") aralığı yanlılık düzeltmelidir: \hat\theta-(\bar\theta^{*}-\hat\theta)\mp z\operatorname{SH}^{*}. Şablon yanlılığı çıkarmaz (satır 108–109). Örnek ayarda fark 0,0022'dir. Otokorelasyon gibi yanlılığın büyük olduğu istatistiklerde iki tanım çok ayrışır; orada yanlılık bootstrap şemasının (ek yerlerinin) ürünüdür, istatistiğin gerçek yanlılığı değildir ve çıkarılması aralığı yanlış yöne taşır. Yüzdelik sınırlarda da tanım farkı vardır: şablon tip 7 kantil, boot.ci (B+1)p. sıra istatistiği kullanır.
S4. Otokorelasyon için blok bootstrap nasıl yapılır?
Gözlemler yerine ardışık çiftlerin (y_t,y_{t+1}) (p gecikmeli modelde p+1'lilerin) oluşturduğu çok sütunlu seri blok hâlinde yeniden örneklenir ve otokorelasyon bu satırlardan hesaplanır; şablon bunu kendisi yapar (51.4.3). Her çift gerçekten komşu iki gözlemdir; ek yerleri yalnız satırlar arasındaki bağımlılığı keser (Künsch, 1989; Davison ve Hinkley, 1997, Bölüm 8). Örnek seride (l=5, B=999) kopyaların ortalaması 0,786, standart hata 0,030 ve yüzdelik aralık [0,724; 0,839]; bağımsız bir hesapla (B=4000) 0,785; 0,030 ve [0,723; 0,837] bulunur. Blok uzunluğu büyütüldükçe standart hata küçülür (l=20'de 0,018).
S5. Blok uzunluğu için n^(1/3) kuralı ne kadar güvenilir?
Yalnız mertebeyi verir. En iyi blok uzunluğu C\,n^{1/3} biçimindedir ve C serinin otokovaryans yapısına bağlıdır: güçlü ve yavaş sönen ilişkide büyük, zayıf ilişkide küçüktür. Örnek seride ilişki sönmez, döngüseldir; ideal standart hata l ile dalgalanır ve hiçbir l için yerleşmez. Böyle bir seride ortalamanın belirsizliğini blok bootstrap'tan tek sayı olarak okumak yerine, döngüyü modelleyen bir yapı (AR(2), köklerinin verdiği dönem 9,66 yıl) üzerinden çıkarım yapmak daha savunulabilirdir.
S6. Yabani küme bootstrap standart hatası neden CR1'den küçük çıkabiliyor?
Rademacher ve Webb ağırlıklarında E(v_g^2)=1 olduğundan bootstrap kovaryansının sınırı düzeltmesiz CR0 matrisidir (51.4.9). CR1 bunu \frac{G}{G-1}\cdot\frac{n-1}{n-k} ile çarpar. 500 kümede çarpanın karekökü 1,0011'dir (0,050540 ve 0,050596); 10 kümede 1,054'tür. Az kümede yabani bootstrap'ın üstünlüğü standart hatadan değil, t istatistiğinin dağılımını kopyalardan okumaktan gelir; şablon bunu yapmaz.
S7. Küme (çift) bootstrap'ta kopyanın gözlem sayısı değişirse sorun olur mu?
Kümeler dengesizse kopyanın n'si rastgeledir. Bu, küme bootstrap'ının doğal sonucudur ve kestiricinin örnekleme dağılımını doğru taklit eder (yeni bir veride de küme büyüklükleri değişirdi). Örnek veride bütün firmalar 10 gözlemlidir; her kopya 5000 satırdır. Sorun, bir açıklayıcının yalnız birkaç kümede değiştiği tasarımlarda çıkar: bazı kopyalarda o kümeler hiç çekilmez, katsayı kestirilemez ya da çok oynar.
S8. Güven aralığı ve p için neden normal dağılım, t değil?
Şablon z kantilini kullanır (satır 103, 197–198). Kapalı formüllü küme-sağlam çıkarımda yaygın uygulama t_{G-1}'dir; 500 kümede fark yoktur (t_{499;\,0{,}975}=1{,}965), 10 kümede aralık yaklaşık %15 genişler (t_{9;\,0{,}975}=2{,}262). Az kümede şablonun aralığı elle t_{G-1} ile yeniden kurulabilir: \hat\beta\mp t_{G-1}\operatorname{SH}.
S9. Durağan bootstrap aynı l ile neden daha küçük standart hata verdi?
Geometrik dağılım çarpıktır: ortalaması 5 olsa da blokların %59'u 5'ten kısadır (1-0{,}8^4=0{,}59; medyan 4). Kısa bloklar daha az otokovaryans taşır; örnek seride ortalamanın standart hatası 0,0665'tir (dairesel 0,0772). Durağan bootstrap'ın örtük uzun dönem varyansı kestirimi, sabit bloktakinden daha hızlı sönen ağırlıklar kullanır. İki yöntemin l değerleri bu yüzden birebir karşılaştırılmaz; durağan bootstrap'ta aynı yanlılık düzeyi için daha büyük ortalama uzunluk gerekir.
51.10 Kaynaklar
- Cameron, A. C., Gelbach, J. B., & Miller, D. L. (2008). Bootstrap-based improvements for inference with clustered errors. Review of Economics and Statistics, 90(3), 414–427. https://doi.org/10.1162/rest.90.3.414
- Cameron, A. C., & Miller, D. L. (2015). A practitioner's guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32). https://doi.org/10.32614/CRAN.package.boot
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap methods and their application. Cambridge University Press. https://doi.org/10.1017/CBO9780511802843
- Elton, C., & Nicholson, M. (1942). The ten-year cycle in numbers of the lynx in Canada. Journal of Animal Ecology, 11(2), 215–244. https://doi.org/10.2307/1358
- Hall, P., Horowitz, J. L., & Jing, B.-Y. (1995). On blocking rules for the bootstrap with dependent data. Biometrika, 82(3), 561–574. https://doi.org/10.1093/biomet/82.3.561
- Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217–1241. https://doi.org/10.1214/aos/1176347265
- Lahiri, S. N. (2003). Resampling methods for dependent data. Springer. https://doi.org/10.1007/978-1-4757-3803-2
- Petersen, M. A. (2009). Estimating standard errors in finance panel data sets: Comparing approaches. Review of Financial Studies, 22(1), 435–480. https://doi.org/10.1093/rfs/hhn053
- Politis, D. N., & Romano, J. P. (1992). A circular block-resampling procedure for stationary data. In R. LePage & L. Billard (Eds.), Exploring the limits of bootstrap (pp. 263–270). Wiley.
- Politis, D. N., & Romano, J. P. (1994). The stationary bootstrap. Journal of the American Statistical Association, 89(428), 1303–1313. https://doi.org/10.1080/01621459.1994.10476870
- Politis, D. N., & White, H. (2004). Automatic block-length selection for the dependent bootstrap. Econometric Reviews, 23(1), 53–70. https://doi.org/10.1081/ETC-120028836
- R Core Team. (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Webb, M. D. (2023). Reworking wild bootstrap-based inference for clustered errors. Canadian Journal of Economics, 56(3), 839–858. https://doi.org/10.1111/caje.12661
- Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01