81. LD Budaması, IBD Kestirimi ve KING Akrabalığı
Şablon kimliği: ld_budama_ibd · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/ld_budama_ibd.R (satır 1–293; üstbilgi 1–128) · Örnek veri: _ornek/hapmap_yri_snp.csv · Paketler: SNPRelate 1.44.0, gdsfmt 1.46.0 (Bioconductor)
81.1 Ne işe yarar
Şablon, binlerce SNP ile genotiplenmiş bireylerde "hangi birey çiftleri akraba ve hangi derecede?" sorusunu cevaplar. Soy kütüğü gerekmez; akrabalık genom boyunca alel paylaşımından kestirilir. Her birey çifti için iki bağımsız kestirim verilir:
- k_0, k_1, k_2: çiftin bir lokusta sıfır, bir ya da iki aleli soydan özdeş (identity by descent, IBD) paylaşma olasılığı. Ebeveyn–yavru (0{,}1{,}0); tam kardeş (\tfrac14,\tfrac12,\tfrac14); yarım kardeş ya da büyükanne–torun (\tfrac12,\tfrac12{,}0); özdeş ikiz ya da aynı bireyin iki örneği (0{,}0{,}1); akraba olmayan (1{,}0{,}0).
- \varphi: akrabalık (kinship, ortak ata) katsayısı; Bölüm 62'deki \theta ile aynı büyüklüktür. Ebeveyn–yavru ve tam kardeşte 0,25; ikinci derecede 0,125; yinelenen örnekte 0,5.
Hesap dört aşamadır: (1) SNP'lerin kalite süzgeci; (2) birbirine bağlı (bağlantı dengesizliğinde, LD) SNP'lerin budanması; (3) PLINK'in momentler yöntemiyle k_0,k_1,k_2 ve \varphi; (4) KING kestiricisiyle \varphi ve IBS0 oranı. Sonunda her çift KING eşikleriyle bir akrabalık derecesine atanır.
Ne zaman kullanılır? Genom ölçekli çalışmalarda (ilişkilendirme, genomik seçilim, popülasyon genomiği) örnek kalite denetimi için: yinelenen örnekleri, beyan edilmemiş akrabaları ve yanlış etiketlenmiş aile üyelerini bulmak; çözümlemeden önce akraba bireyleri ayıklamak; beyan edilen soy kütüğünü doğrulamak.
Ne zaman kullanılmaz?
- Az sayıda belirteç (onlarca mikrosatellit ya da SNP) varsa:
akrabalikşablonunun genotip kipi. Bu şablondaki kestiriciler binlerce SNP ister. - Karma model için akrabalık matrisi gerekiyorsa:
akrabalik(genomik kip, VanRaden \mathbf G). - İki SNP arasındaki LD'nin kendisi, LD haritası ya da LD'nin uzaklıkla azalması soruluyorsa:
bag_dengesizligi. - Popülasyon yapısı (temel bileşenler, kümeler) isteniyorsa:
populasyon_yapisi; bu şablonun budanmış SNP kümesi o çözümleme için de uygun bir girdidir, ama küme dışa verilmez. - X kromozomu akrabalığı ve cinsiyet denetimi: yoktur; şablon yalnız 1–22 numaralı kromozomları kullanır.
- Poliploit türler ya da 0/1/2 dışı kodlama: desteklenmez.
Temel programla ilişki. Temel programda karşılığı yoktur.
81.2 Şablonun girdileri
Form, üstbilgideki on altı [[param]] bloğundan kurulur (ld_budama_ibd.R:11–127).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Birey kimliği · birey |
kategorik sütun · Değişkenler | ilk uygun sütun | tekil kimlikler | Örnek adları (134, 142–146). |
Aile · aile |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | KING'de aile içi çiftlere ayrı kestirici (208–209). |
SNP sütunları · lokuslar |
sütunlar (sayısal) · Değişkenler | boş | 0/1/2 kodlu sütunlar | Boşsa adı <kromozom>_<konum>_<ad> biçimindeki bütün sütunlar (137–139). |
IBD'den önce budama · budama |
onay · Seçenekler | açık | açık / kapalı | snpgdsLDpruning çağrılır (190–197). |
|LD| eşiği · ld_esik |
ondalık · Seçenekler | 0,2 | 0,01–0,99 | Bu değeri aşan çiftlerden biri atılır (192). |
LD ölçüsü · ld_yontem |
seçim · Model | composite |
composite, r, dprime, corr |
Budamada kullanılan LD tanımı (192). |
Kayan pencere genişliği (kb) · pencere_kb |
tam sayı · Seçenekler | 500 | 1–100000 | Yalnız bu uzaklık içindeki SNP'ler karşılaştırılır (192). |
MAF eşiği · maf |
ondalık · Seçenekler | 0,05 | 0–0,49 | En küçük alel frekansı eşiğin altındaki SNP'ler atılır; 0 ise süzgeç yok (191, 204, 210). |
En küçük çağrı oranı · cagri_orani |
ondalık · Seçenekler | 0,95 | 0,5–1 | Eksik oranı 1- çağrı oranını aşan SNP'ler atılır (181). |
Akrabalık kestirimi · yontem |
seçim · Model | hepsi |
hepsi, mom, king |
Hangi kestiricilerin hesaplanacağı (203, 207). |
Budama tohumu · tohum |
tam sayı · Gelişmiş | 1000 | 1–2147483647 | set.seed; budamanın rastgele başlangıcını belirler (189). |
Pencere en çok SNP sayısı · pencere_snp |
tam sayı · Seçenekler | 0 | 0–100000 | 0 sınırsız; değilse pencere ayrıca SNP sayısıyla sınırlanır (193). |
Budamada başlangıç SNP'si · baslangic |
seçim · Gelişmiş | random.f500 |
random.f500, random, first, last |
Her kromozomda budamanın başladığı SNP (194). |
Yalnız otozomal SNP'ler · otozom |
onay · Seçenekler | açık | açık / kapalı | SNPRelate çağrılarına autosome.only olarak geçer (194, 206, 211); 81.4.1'e bakınız. |
MoM'da geometrik kısıt · mom_kisit |
onay · Gelişmiş | kapalı | açık / kapalı | kinship.constraint (205). |
KING kestiricisi · king_tur |
seçim · Model | KING-robust |
KING-robust, KING-homo |
KING'in tabakalaşmaya dayanıklı ya da tek popülasyon varsayan biçimi (211). |
Örnek ayar (ornek_param, satır 9): birey = birey, aile = aile; SNP listesi boş bırakılır, harita taşıyan 8723 sütunun hepsi kullanılır.
Veri biçimi. Her satır bir birey, her SNP bir sütundur; hücre, sayılan alelin kopya sayısıdır (0, 1, 2; boş = eksik). Kromozom ve konum sütun adından okunur: 1_1355433_rs1695824 adı 1. kromozom, 1 355 433. baz, rs1695824 belirteci demektir (düzenli ifade satır 136). Kromozom yalnız sayı olabilir; X_… gibi adlar haritaya uymaz.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 131 |
| SNPRelate ya da gdsfmt kurulu değil | "SNPRelate ve gdsfmt paketleri (Bioconductor) gerekli" | 132–133 |
| SNP sütunu yok (liste boş ve harita biçimli ad yok) | "SNP sütunu yok. SNP'leri seçin ya da sütunları … adlandırın" | 140–141 |
| Kimlik yinelenmiş | "Birey kimlikleri tekil olmalı" | 146 |
| 3'ten az birey | "en az 3 birey gerekli" | 147 |
| SNP sütunu sayısal değil | "SNP sütunları sayısal 0/1/2 olmalı" | 150–151 |
| 0/1/2 dışında değer | "yalnız 0, 1, 2 ya da eksik olabilir" | 153–155 |
| Tek biçimliler atılınca 2'den az SNP | "en az 2 çok biçimli SNP kalmalı" | 162 |
| Budama açık, sütun adlarında harita yok | "Budama için SNP haritası gerekli … Harita yoksa budamayı kapatın." | 170–171 |
| Otozomlarda 2'den az SNP | "Otozomlarda en az 2 SNP kalmalı." | 179 |
| Süzgeç ve budamadan sonra SNP kalmadı | "MAF/çağrı oranı eşiklerini gevşetin" | 198, 219 |
| SNPRelate içinde başka bir hata | "SNPRelate hesabı başarısız oldu: …" | 220 |
Notlar (durdurmaz): kimliği eksik satırlar atılır (144); bütünüyle eksik ve tek biçimli SNP'ler atılır ve sayıları yazılır (157, 160); otozom dışı SNP'ler (onay açıkken) atılır, onay kapalıyken dahil edildiği bildirilir (176–177); harita yoksa ve budama kapalıysa SNP'ler tek kromozomda sıralı sayılır (172–173).
Eksik değer: bir bireyin eksik genotipi yalnız o SNP'de o bireyin katıldığı çiftleri etkiler; her çift, iki bireyin de gözlendiği SNP'ler üzerinden değerlendirilir.
81.3 Örnek veri
Dosya: _ornek/hapmap_yri_snp.csv. SNPRelate paketiyle dağıtılan HapMap örneğinin Yoruba (YRI) alt kümesi: 93 örnek ve 8723 SNP. Örnekler 30 ailedendir: 27 ailede anne–baba–çocuk üçlüsü, üç ailede üçlüye ek olarak bir bireyin yinelenmiş örneği (NA18859.dup, NA18862.dup, NA19238.dup) vardır. Toplam 3771 genotip eksiktir.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
birey |
Birey kimliği | metin | 93 tekil ad. |
aile |
Aile | sayısal | 30 aile numarası; 27'si 3, 3'ü 4 örnekli. |
1_1355433_rs1695824 … |
SNP'ler | sayısal ya da ikili | 8723 sütun, 22 otozom; değerler 0/1/2. |
Bu veride beklenen akrabalık yapısı bellidir: her üçlüde iki ebeveyn–yavru çifti, yinelenen örnekler ve onların ebeveyn–yavru çiftleri. Aynı aile numarasını taşıyan 99 çift vardır; 4278 çiftin büyük çoğunluğu akraba değildir.
Düzey sırası bu şablonda rol oynamaz: çiftler akrabalığa göre azalan sıralanır, kromozomlar sayısal sıradadır.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) tohum = 7; (3) budama kapalı; (4) aile boş; (5) yontem = king, king_tur = KING-homo; (6) yontem = mom, mom_kisit açık; (7) ld_yontem = r, dprime, corr; (8) baslangic = first; (9) pencere_kb = 100, pencere_snp = 5; (10) sınır durumları: X kromozomuna taşınmış sütunlar, haritasız sütun adları, eksik kimlik.
81.4 Yöntem: formüller ve hesap adımları
81.4.1 Süzgeç
Süzgeç iki katmandır. Şablonun kendi katmanı (satır 156–180): bütünüyle eksik SNP'ler ve tek biçimli SNP'ler (sayılan alelin frekansı 0 ya da 1) atılır; sütun adlarından kromozom ve konum okunur; kromozom numarası 1–22 dışında kalan SNP'ler (otozom açıkken) atılır; SNP'ler kromozom ve konuma göre sıralanır. SNPRelate katmanı (her çağrının içinde): MAF ve eksik oranı süzgeçleri uygulanır.
- p_j: j. SNP'de sayılan alelin frekansı, gözlenen genotiplerden: \sum_i g_{ij}/(2n_j); n_j genotipi gözlenen birey sayısı.
- Örnek veride 8723 SNP'nin 563'ü tek biçimlidir; kalan 8160'ın 7077'si varsayılan MAF (0,05) ve çağrı oranı (0,95) süzgeçlerinden geçer.
Neden nadir aleller atılıyor?
Momentler yöntemi beklenen paylaşımı p^2q^2 gibi terimlerle hesaplar; MAF küçükken bu terimler sıfıra yaklaşır ve frekanstaki küçük bir örnekleme hatası oranı büyük ölçüde değiştirir. 93 bireyde MAF 0,05'in altı dokuzdan az alel kopyası demektir. Düşük çağrı oranı ise çoğu kez genotipleme sorununun belirtisidir ve hatalı genotipler akrabalığı aşağı çeker.
Koddaki tercih
otozom onayı açıkken kromozom numarası 1–22 dışında kalan SNP'leri şablon kendi katmanında atar (satır 175–176) ve SNPRelate çağrılarına da autosome.only = TRUE geçer. Onay kapalıyken şablon otozom dışı SNP'leri atmaz, 23 ve üzeri numaralı kromozomlardaki SNP'ler de budamaya ve IBD kestirimine girer ve bir not bunu bildirir (176–177); momentler ve KING formülleri otozomal SNP için tanımlıdır, bu yüzden X ve Y kromozomu SNP'leriyle sonuçlar dikkatle yorumlanır. 186 SNP'si 23. kromozoma taşınmış türetilmiş veride onay açıkken "otozom dışı 186 SNP çıkarıldı", kapalıyken "otozom dışı 186 SNP … dahil edildi" notu yazılır ve kullanılan SNP sayısı 186 artar. Özet tablosunda "Tek biçimli olmayan otozomal SNP" satırı şablonun kendi katmanından sonraki sayıdır (8160); MAF ve çağrı oranı süzgecinden geçen sayı (7077) ayrı bir satırda verilir (222–226).
81.4.2 Bağlantı dengesizliği ölçüleri
İki SNP'nin alelleri bağımsız değilse aralarında bağlantı dengesizliği vardır. Faz bilinmediğinde (hangi alellerin aynı kromozomda olduğu) Weir'in (1979) bileşik ölçüsü doğrudan genotip sayılarından hesaplanır:
- n_{AABB} vb.: iki SNP'de de gözlenen n birey içinde ilgili çift genotipin sayısı; p_A, p_B: alel frekansları.
- D_A=P_{AA}-p_A^2: Hardy–Weinberg'den sapma; payda bu düzeltmeyle genotip varyansının yarısıdır.
- Bu tanımla r_{\text{bileşik}}, iki SNP'nin alel sayıları (0/1/2) arasındaki Pearson korelasyonuna eşittir.
| Seçenek | Tanım | Örnek veride kalan SNP |
|---|---|---|
composite |
Bileşik LD (yukarıdaki) | 5428 |
corr |
Alel sayılarının korelasyonu | 5428 (aynı küme) |
r |
Haplotip frekansları EM ile kestirilir; r=D/\sqrt{p_Aq_Ap_Bq_B} | 5470 |
dprime |
D'=D/D_{\max} (Lewontin, 1964) | 4070 |
Neden D' çok daha fazla SNP atıyor?
D', D'yi alel frekanslarının izin verdiği en büyük değere böler; frekansları farklı iki SNP'de korelasyon düşükken bile D' 1'e yaklaşabilir, küçük örneklemde de yukarı yanlıdır. 0,2 eşiği r ölçeği için alışılmış bir değerdir; aynı eşik D' ile çok daha sıkı bir budama anlamına gelir. Akrabalık kestirimi için amaç SNP'lerin yaklaşık bağımsız olmasıdır; bunu ölçen büyüklük korelasyondur.
81.4.3 Budama algoritması
Her kromozomda, süzgeçten geçen SNP'ler konum sırasıyla ele alınır:
- Bir başlangıç SNP'si seçilir ve tutulur. Varsayılan
random.f500seçeneğinde başlangıç, kromozomun ilk \min(m,500) SNP'si arasından rastgele çekilir. - İleri geçiş: başlangıçtan sonraki her SNP sırayla aday olur. Aday, o ana dek tutulmuş ve pencere içinde kalan SNP'lerin hepsiyle karşılaştırılır; hiçbirinde |\text{LD}| eşiği aşmıyorsa tutulur, aksi hâlde atılır.
- Geri geçiş: başlangıçtan önceki SNP'ler geriye doğru aynı kuralla ele alınır; karşılaştırma kümesine ileri geçişte tutulanlar da dahildir.
- T: o ana dek tutulmuş SNP'ler; x: baz konumu; W: pencere genişliği (
pencere_kb× 1000); \tau:ld_esik. pencere_snpsıfırdan büyükse pencere ayrıca SNP sırası farkıyla sınırlanır.- Farklı kromozomlardaki SNP'ler hiç karşılaştırılmaz.
Neden budama ve neden rastgele başlangıç?
Momentler yöntemi ve KING, SNP'leri bağımsız gözlemler gibi toplar. Yoğun genotiplemede komşu SNP'ler aynı bilgiyi taşır; budanmamış veride yoğun bölgeler orantısız ağırlık alır ve kestirimlerin varyansı küçümsenir. Budama açgözlü bir yöntemdir: hangi SNP'nin tutulacağı işlem sırasına, o da başlangıca bağlıdır. Rastgele başlangıç, sonucun tek bir keyfi seçime bağlı kalmamasını sağlar; karşılığında budanmış küme tohuma bağlı olur.
Tohum. Bu şablonda tohum bir form alanıdır (tohum, Gelişmiş sekmesi, varsayılan 1000) ve şablon onu set.seed ile kendisi ayarlar (satır 189). Bu yüzden, öteki şablonların tersine, alan değiştirilmedikçe her çalıştırma aynı budanmış kümeyi verir. Başlangıç first ya da last seçilirse rastgelelik kalmaz ve tohumun etkisi olmaz. Örnek veride tohum 1000 ile 5428, tohum 7 ile 5424, first ile 5445 SNP kalır.
Koddaki tercih
Budama SNPRelate::snpgdsLDpruning ile yapılır (satır 191–195). Şablon genotip matrisini geçici bir GDS dosyasına yazar (183–188), hesap bitince dosyayı kapatıp siler (216–217); hesap tek iş parçacığıyla çalışır (num.thread = 1). Budanmış SNP listesi tabloya yazılmaz; yalnız toplam ve kromozom başına sayılar verilir. Budama kapalıyken IBD, süzgeçten geçen bütün SNP'lerle (örnekte 7077) hesaplanır ve özet tablosunun "Budamadan sonra kalan SNP" satırı boş kalır.
81.4.4 PLINK momentler yöntemi
İki birey bir SNP'de 0, 1 ya da 2 aleli durumca özdeş (identity by state, IBS) paylaşır: zıt homozigotlar 0, aynı genotip 2, ötekiler 1. Çiftin gözlenen IBS sayıları N_0,N_1,N_2 (N=N_0+N_1+N_2) olsun. Bir SNP'de IBS durumunun olasılığı, IBD durumuna ve alel frekanslarına bağlıdır:
- I_m: çift m aleli durumca paylaşıyor; Z_m: m aleli soydan özdeş. q=1-p.
- P(I_0\mid Z_1)=P(I_0\mid Z_2)=P(I_1\mid Z_2)=0: soydan özdeş bir alel paylaşan çift zıt homozigot olamaz.
- Purcell ve ark. (2007) bu olasılıklara sonlu örneklem düzeltmesi uygular: frekanslar aynı örneklemden kestirildiğinden her terim, alellerin yerine koymadan çekilmesine karşılık gelen çarpanlarla düzeltilir. Örneğin 2p^2q^2 terimi \frac{X-1}{X}\cdot\frac{Y-1}{Y}\cdot\frac{T}{T-1}\cdot\frac{T}{T-2}\cdot\frac{T}{T-3} ile çarpılır; T=2n_j gözlenen alel sayısı, X=pT, Y=qT.
Beklenen sayılar, olasılıkların SNP'ler üzerinden ortalaması ile çiftin ortak gözlenen SNP sayısının çarpımıdır; kestirimler üç doğrusal denklemin sırayla çözümüdür:
- \overline{P(\cdot)}: çözümlemedeki bütün SNP'ler üzerinden aritmetik ortalama (çifte özgü değil).
- \hat k_0 yalnız zıt homozigot sayısından gelir: bu durum ancak hiç soydan özdeş alel paylaşılmıyorsa görülebilir.
- Her IBD durumu için olasılıklar 1'e toplandığından üç kestirimin toplamı sınırlama öncesinde tam 1'dir.
Sınırlama. Kestirimler [0{,}1] dışına düşebilir. PLINK kuralı sırayla uygulanır: biri 1'i aşarsa o 1, ötekiler 0 yapılır; biri negatifse 0 yapılır ve öteki ikisi toplamları 1 olacak biçimde yeniden ölçeklenir. Tabloya k_0, k_1, k_2=\max(0,\,1-k_0-k_1) ve \varphi=k_1/4+k_2/2 yazılır.
Neden akraba olmayan çiftlerde k_1>0 çıkıyor?
Akraba olmayan bir çiftte gerçek değer (1{,}0{,}0)'dır, yani parametre uzayının köşesidir. Örnekleme gürültüsü \hat k_0'ı 1'in altına da üstüne de düşürür; üstündeyse 1'e kırpılır, altındaysa fark k_1'e gider. Sonuç, akraba olmayan çiftlerde ortalama olarak pozitif bir k_1 ve \varphi'dir: örnekte "akraba değil" sınıfının ortalama k_0'ı 0,977, ortalama \varphi'si 0,0059'dur. Momentler yöntemi bu yüzden uzak akrabalıkta yukarı yanlıdır; küçük pozitif değerler tek başına akrabalık kanıtı sayılmaz.
Koddaki tercih
SNPRelate::snpgdsIBDMoM(…, kinship = TRUE, kinship.constraint = …) (satır 204–206). mom_kisit açıkken, sınırlamadan sonra \hat\pi=k_1/2+k_2 hesaplanır ve \hat\pi^2<k_2 ise kestirim k_0=(1-\hat\pi)^2, k_1=2\hat\pi(1-\hat\pi), k_2=\hat\pi^2 noktasına taşınır. Geçerli bölge k_1^2\ge4k_0k_2'dir (akrabalı olmayan bir çiftin sağlaması gereken koşul); kısıt bu bölgenin dışına düşen kestirimleri sınır eğrisine çeker ve \hat\pi'yi, dolayısıyla \varphi'yi değiştirmez. Örnekte 334 çift etkilenmiş, hepsinin \varphi'si aynı kalmıştır.
81.4.5 KING-robust
Momentler yöntemi alel frekanslarına dayanır; örneklem farklı kökenlerden bireyler içeriyorsa (tabakalaşma) tek bir frekans kümesi yanlıştır ve aynı kökenden akrabasız bireyler akraba görünür. Manichaikul ve ark.'nın (2010) KING-robust kestiricisi frekans kullanmaz; yalnız iki bireyin genotip sayılarına bakar:
- N_{Aa,Aa}: iki bireyin de heterozigot olduğu SNP sayısı; N_{AA,aa}: zıt homozigot oldukları SNP sayısı.
- N_{Aa}^{(i)}: i'nin heterozigot olduğu SNP sayısı; hepsi iki bireyin de gözlendiği SNP'ler üzerinden sayılır.
- İki biçim de \tfrac12-\sum(g_i-g_j)^2/(\text{payda}) olarak yazılabilir: payda aileler arasında 4\min(\cdot), aile içinde 2\big(N_{Aa}^{(i)}+N_{Aa}^{(j)}\big).
- \text{IBS0}=N_{AA,aa}/N: zıt homozigot oranı.
Neden iki ayrı biçim ve neden \min?
Bireyin heterozigotluğu, ait olduğu popülasyonun alel frekanslarını taşır; kestirici frekans yerine bunu kullanır. Aynı aileden iki birey aynı kökendendir, iki heterozigotluğun ortalaması en verimli normalleştirmedir. Farklı ailelerden iki birey farklı kökenlerden olabilir; bu durumda heterozigotluğu küçük olan bireye göre normalleştirmek kestiriciyi tabakalaşmaya karşı korur (akraba olmayanlarda sonucu aşağı, yani güvenli yöne iter). Aile sütunu verilmezse bütün çiftler "aileler arası" biçimle hesaplanır.
KING-homo seçeneği tek ve karışmamış bir popülasyon varsayar ve normalleştirmeyi alel frekanslarından yapar: \hat\varphi=\tfrac12-\sum_m(g_{im}-g_{jm})^2\big/\big(4\sum_m2p_m(1-p_m)\big). Bu seçenekte IBS0 sütunu verilmez; onun yerine KING-homo'nun k_0 ve k_1 kestirimleri tabloya k0_KING ve k1_KING sütunları olarak girer.
81.4.6 Akrabalık derecesi
Çiftler, Manichaikul ve ark.'nın eşikleriyle sınıflanır (satır 236–244). Sınıflamada kullanılan \varphi, hesaplandıysa KING'inkidir; yontem = mom ise momentler yönteminin \varphi'sidir (257).
| \varphi | Derece | Beklenen \varphi |
|---|---|---|
| >0{,}354 | özdeş ikiz / yineleme | 0,5 |
| 0{,}177–0{,}354 | 1. derece | 0,25 |
| 0{,}0884–0{,}177 | 2. derece | 0,125 |
| 0{,}0442–0{,}0884 | 3. derece | 0,0625 |
| \le0{,}0442 | akraba değil | 0 |
Neden bu sayılar?
Ardışık derecelerin beklenen \varphi değerleri ikişer kat azalır: 2^{-1},2^{-2},2^{-3},2^{-4}. Eşikler komşu değerlerin geometrik ortasıdır: 2^{-3/2}=0{,}354, 2^{-5/2}=0{,}177, 2^{-7/2}=0{,}0884, 2^{-9/2}=0{,}0442.
Birinci derece çiftler ayrıca ikiye ayrılır: IBS0 <0{,}005 ya da k_0<0{,}1 ise "ebeveyn–yavru", değilse "tam kardeş". k_0 olarak momentler yönteminin k_0'ı, o yoksa KING-homo'nun kendi k_0 kestirimi kullanılır. Ebeveyn ile yavru her lokusta bir aleli paylaşır; zıt homozigot olamazlar (k_0=0, IBS0 =0). Tam kardeşlerde lokusların dörtte birinde hiç soydan özdeş alel yoktur (k_0=0{,}25).
Ebeveyn–yavru ayrımı IBS0 ya da k_0 ister
Ayrım yalnız bu iki büyüklükten biri varsa yapılabilir; ikisi de yoksa birinci derece çift "1. derece: ayrım yapılamadı" diye etiketlenir ve ebeveyn–yavru ya da tam kardeş denmez. yontem = king ile king_tur = KING-homo birleşiminde IBS0 hesaplanmaz, ama KING-homo kendi k_0 ve k_1 kestirimlerini verir (çift tablosunda k0_KING, k1_KING); ayrım bu k_0 ile yapılır. Örnek veride bu ayarla 65 ebeveyn–yavru çiftinin hepsi (KING-homo k_0 değerleri 0,025'in altında) "ebeveyn–yavru" etiketlenir; KING-robust ile aynı sınıflama elde edilir.
81.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–128 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on altı parametre. | Form buradan kurulur (Bölüm 1.2). |
| 129–147 | Paket denetimi; SNP sütunlarının belirlenmesi; kimlik denetimleri. | Liste boşsa harita biçimli bütün sütunlar alınır; kimlik ve aile sütunu listeden çıkarılır (139). |
| 149–162 | Genotip matrisi; sayısallık ve 0/1/2 denetimi; bütünüyle eksik ve tek biçimli SNP'lerin atılması. | Frekans gözlenen genotiplerden (158). |
| 164–181 | Haritanın sütun adlarından okunması; otozom süzgeci; sıralama; eksik oranı eşiği. | Harita, kalan bütün sütun adları biçime uyuyorsa var sayılır (166). |
| 183–218 | Geçici GDS dosyası; set.seed; budama; momentler yöntemi; KING; dosyanın kapatılıp silinmesi. |
tryCatch … finally dosyanın her durumda silinmesini sağlar. Budama, MoM ve KING aynı MAF ve eksik oranı süzgecini yeniden uygular. |
| 219–234 | Hata iletileri; özet tablosu; kromozom başına budama tablosu. | "oran" = kalan / şablon katmanından sonraki SNP sayısı (232). |
| 236–270 | Derece sınıflaması; çift tablosunun birleştirilmesi ve sıralanması; derece sayımı; konsol özeti. | Çiftler \varphi'ye göre azalan sıralanır; tabloya en çok 5000 çift yazılır (265–266). |
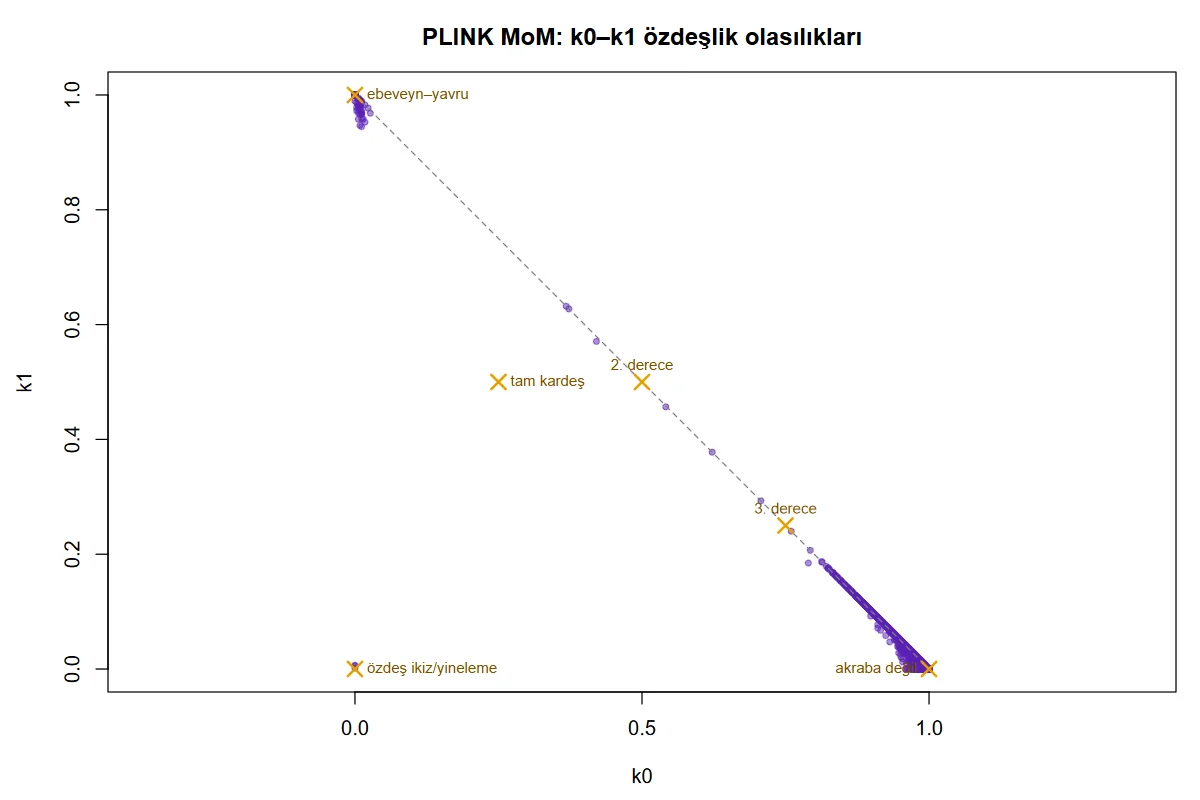
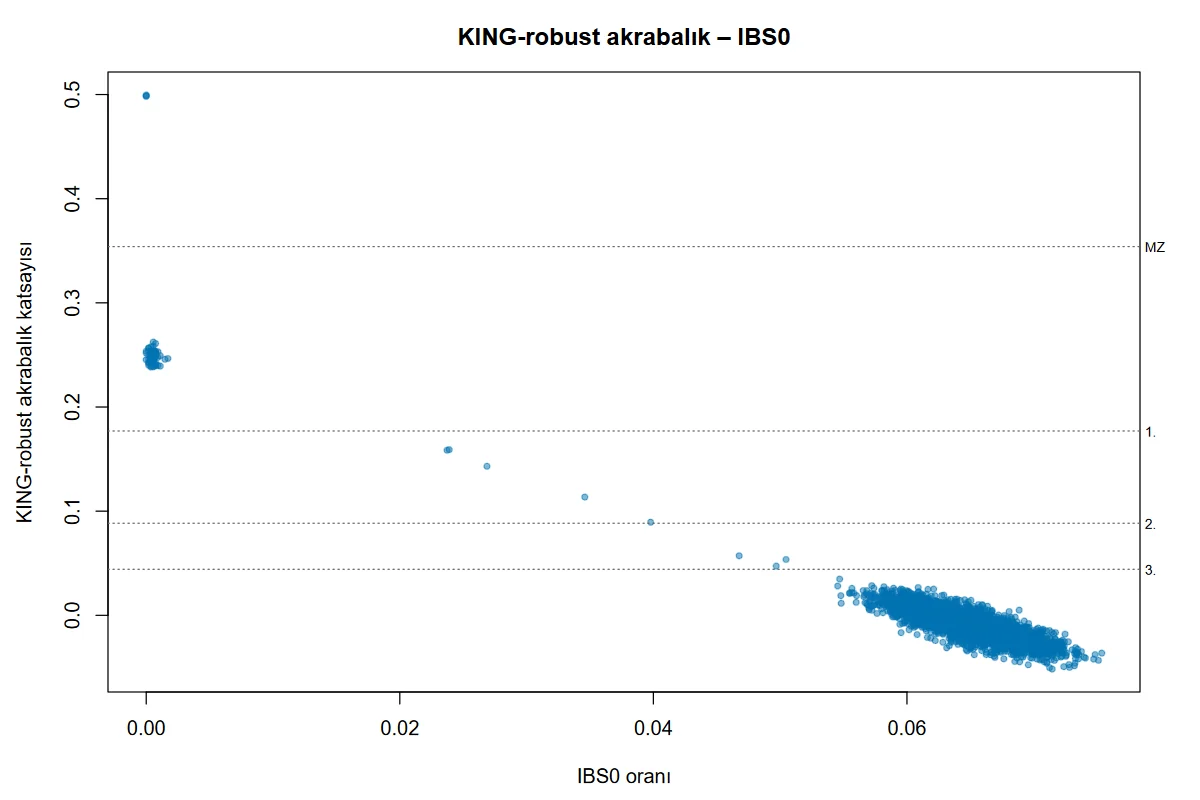
| 272–292 | İki şekil: k_0–k_1 saçılımı (beklenen noktalarla) ve IBS0–\varphi saçılımı (derece eşikleriyle). | İlki yalnız momentler yöntemi, ikincisi yalnız IBS0 hesaplandıysa çizilir. |
Konsol özetindeki "2. derece ve daha yakın … çift" sayısı \varphi>0{,}0884 olan çiftlerdir (satır 267): ikinci derece çiftler de sayıya dahildir.
81.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bütün aşamalar dogrulama/ld_budama_ibd/elle_hesap.py ile, SNPRelate kullanılmadan, numpy ile yeniden kurulmuştur: süzgeç, budama (R'nin rastgele sayı üreteci yeniden kurularak aynı başlangıç SNP'leriyle), momentler yöntemi ve KING. R tarafında (r_dogrulama.R) aynı adımlar yalnız taban R ile (set.seed, sample.int, cor, matris çarpımları) yinelenmiştir.
Adım 1 — Süzgeç. 8723 SNP → tek biçimli 563 atılır → 8160 → MAF \ge0{,}05 ve eksik oranı \le0{,}05 → 7077.
Adım 2 — Bir LD değeri. 1. kromozomun ilk iki SNP'si (rs1695824, rs13328662) için bileşik LD -0{,}157776'dır; alel sayılarının Pearson korelasyonu aynı sayıyı verir. |{-0{,}158}|<0{,}2 olduğundan bu iki SNP birbirini elemez.
Adım 3 — Budama. Tohum 1000 ile kromozom başlangıçları sırasıyla 496, 68, 299, … çekilir (1. kromozomda süzgeçten geçen SNP'lerin 496.'sı). İleri ve geri geçişten sonra 5428 SNP kalır: 1. kromozomda 446, 8.'de 280, 13.'te 217, 22.'de 67. Bağımsız hesabın tuttuğu küme, SNPRelate'in doğrudan çağrısının verdiği kümeyle SNP SNP aynıdır (snprelate_basvuru.R).
Adım 4 — Beklenen IBS olasılıkları. 5428 SNP üzerinden ortalamalar:
Adım 5 — Akraba olmayan bir çift (NA19152–NA19139; farklı aileler). Ortak gözlenen SNP N=5419; N_0=319, N_1=2327, N_2=2773.
\hat k_2<0 olduğundan sıfırlanır ve öteki ikisi toplamlarına (1{,}064260) bölünür: k_0=0{,}865725, k_1=0{,}134275, k_2=0; \varphi=0{,}134275/4=0{,}033569.
KING için aynı çiftte N_{Aa,Aa}=671, N_{AA,aa}=319, N_{Aa}^{(i)}=1873, N_{Aa}^{(j)}=1796:
İki kestirici farklı cevap verir: momentler yöntemi küçük pozitif (0,034), KING sıfır (−0,002). İkisi de "akraba değil" eşiğinin altındadır.
Adım 6 — Bir ebeveyn–yavru çifti (NA18863–NA18862.dup; aynı aile). N=5410; N_0=3, N_1=1735, N_2=3672: \hat k_0=0{,}008679, \hat k_1=0{,}947017, \hat k_2=0{,}044304; hiçbiri sınır dışında değildir; \varphi=0{,}947017/4+0{,}044304/2=0{,}258906. KING (aile içi biçim): N_{Aa,Aa}=970, N_{Aa}^{(i)}=1876, N_{Aa}^{(j)}=1799:
5410 SNP'de yalnız üç zıt homozigot vardır; bunlar genotipleme hatasıdır. \varphi>0{,}177 ve IBS0 <0{,}005: "1. derece: ebeveyn–yavru".
Adım 7 — Sınıf sayıları. 4278 çift: 3 yineleme, 65 ebeveyn–yavru, 5 ikinci derece, 3 üçüncü derece, 4202 akraba değil. Aynı aile numarasını taşıyan 99 çiftin 3'ü yineleme, 63'ü ebeveyn–yavru, 33'ü akraba değil (ebeveyn çiftleri) sınıfındadır; bu, üçlü yapısıyla uyumludur. Kalan iki ebeveyn–yavru çifti farklı aile numaralı bireyler arasındadır (NA19238 ve yinelenmiş örneği ile NA18913): aile sütununun göstermediği bir birinci derece akrabalık. İkinci ve üçüncü derece 8 çiftin hepsi de aileler arasındadır (ör. NA19238–NA18914, \varphi=0{,}159).
81.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle okunmuştur. "En büyük farklı çift" satırları, şablonun çift tablosundaki 4278 çiftin tamamı bağımsız Python hesabıyla karşılaştırıldığında farkı en büyük olan çifti gösterir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Tek biçimli olmayan otozomal SNP | 8160 | 8160 | 8160 | 0 | ✓ |
| Budamadan sonra kalan SNP (tohum 1000) | 5428 | 5428 | 5428 | 0 | ✓ |
| Kalan SNP, kromozom 1 | 446 | 446 | 446 | 0 | ✓ |
| Kalan SNP, kromozom 8 | 280 | 280 | 280 | 0 | ✓ |
| Kalan SNP, kromozom 13 | 217 | 217 | 217 | 0 | ✓ |
| Kalan SNP, kromozom 22 | 67 | 67 | 67 | 0 | ✓ |
| Budamadan sonra kalan SNP (tohum 7) | 5424 | 5424 | 5424 | 0 | ✓ |
| Kalan SNP: başlangıç ilk SNP | 5445 | 5445 | — | 0 | ✓ |
| Kalan SNP: pencere 100 kb ve 5 SNP | 6296 | 6296 | — | 0 | ✓ |
| Kalan SNP: LD ölçüsü genotip korelasyonu | 5428 | 5428 | — | 0 | ✓ |
| NA18859.dup–NA18859 (yineleme): k_0 | 0 | 0 | 0 | 0 | ✓ |
| NA18859.dup–NA18859 (yineleme): k_1 | 0,00165422 | 0,00165422 | 0,00165422 | 8,1e−17 | ✓ |
| NA18859.dup–NA18859 (yineleme): \varphi (MoM) | 0,49958645 | 0,49958645 | 0,49958645 | 2,8e−16 | ✓ |
| NA18859.dup–NA18859 (yineleme): IBS0 | 0 | 0 | 0 | 0 | ✓ |
| NA18859.dup–NA18859 (yineleme): \varphi (KING) | 0,49958506 | 0,49958506 | 0,49958506 | 1,1e−16 | ✓ |
| NA18863–NA18862.dup (ebeveyn–yavru): k_0 | 0,00867922 | 0,00867922 | 0,00867922 | 4,0e−17 | ✓ |
| NA18863–NA18862.dup (ebeveyn–yavru): k_1 | 0,94701698 | 0,94701698 | 0,94701698 | 5,0e−15 | ✓ |
| NA18863–NA18862.dup (ebeveyn–yavru): \varphi (MoM) | 0,25890615 | 0,25890615 | 0,25890615 | 2,0e−15 | ✓ |
| NA18863–NA18862.dup (ebeveyn–yavru): IBS0 | 5,545287·10−4 | 5,545287·10−4 | 5,545287·10−4 | 5,0e−17 | ✓ |
| NA18863–NA18862.dup (ebeveyn–yavru): \varphi (KING) | 0,26231293 | 0,26231293 | 0,26231293 | 5,6e−17 | ✓ |
| NA19152–NA19139 (akraba değil): k_0 | 0,86572537 | 0,86572537 | 0,86572537 | 9,0e−15 | ✓ |
| NA19152–NA19139 (akraba değil): k_1 | 0,13427463 | 0,13427463 | 0,13427463 | 9,0e−15 | ✓ |
| NA19152–NA19139 (akraba değil): \varphi (MoM) | 0,03356866 | 0,03356866 | 0,03356866 | 2,2e−15 | ✓ |
| NA19152–NA19139 (akraba değil): IBS0 | 0,05886695 | 0,05886695 | 0,05886695 | 2,1e−17 | ✓ |
| NA19152–NA19139 (akraba değil): \varphi (KING) | −0,00153118 | −0,00153118 | −0,00153118 | 1,5e−16 | ✓ |
| 4278 çiftte en büyük farklı çift, örnek ayar: k_0 | 0,98582064 | 0,98582064 | — | 1,3e−14 | ✓ |
| 4278 çiftte en büyük farklı çift, örnek ayar: k_1 | 0,00262126 | 0,00262126 | — | 1,3e−14 | ✓ |
| 4278 çiftte en büyük farklı çift, örnek ayar: \varphi (KING) | 0,25367447 | 0,25367447 | — | 5,6e−16 | ✓ |
| 4278 çiftte en büyük farklı çift, örnek ayar: IBS0 | 7,392349·10−4 | 7,392349·10−4 | — | 9,7e−17 | ✓ |
| 4278 çiftte en büyük farklı çift, tohum 7: k_0 | 0,99488711 | 0,99488711 | — | 1,3e−14 | ✓ |
| 4278 çiftte en büyük farklı çift, tohum 7: \varphi (KING) | 0,24008996 | 0,24008996 | — | 5,3e−16 | ✓ |
| 4278 çiftte en büyük farklı çift, budamasız: k_0 | 0,9904887 | 0,9904887 | — | 9,5e−15 | ✓ |
| 4278 çiftte en büyük farklı çift, budamasız: k_1 | 0,99179774 | 0,99179774 | — | 1,0e−14 | ✓ |
| 4278 çiftte en büyük farklı çift, budamasız: \varphi (KING) | 0,23942187 | 0,23942187 | — | 5,3e−16 | ✓ |
| 4278 çiftte en büyük farklı çift, aile sütunu yok: \varphi (KING) | 0,24755965 | 0,24755965 | — | 5,3e−16 | ✓ |
| 4278 çiftte en büyük farklı çift, KING-homo: \varphi | −0,01774553 | −0,01774553 | — | 2,6e−15 | ✓ |
| 4278 çiftte en büyük farklı çift, MoM geometrik kısıt: k_0 | 0,98516335 | 0,98516335 | — | 1,9e−14 | ✓ |
| 4278 çiftte en büyük farklı çift, MoM geometrik kısıt: k_1 | 0,01478121 | 0,01478121 | — | 1,8e−14 | ✓ |
| Ortalama k_0 (4278 çift) | 0,9610638 | 0,9610638 | 0,9610638 | 3,8e−15 | ✓ |
| Ortalama \varphi (KING) | −0,00347127 | −0,00347127 | −0,00347127 | 1,1e−17 | ✓ |
| \varphi > 0{,}0884 olan çift sayısı | 73 | 73 | 73 | 0 | ✓ |
| Derece sayımı: akraba değil | 4202 | 4202 | — | 0 | ✓ |
| Derece sayımı: 1. derece: ebeveyn–yavru | 65 | 65 | — | 0 | ✓ |
| Derece sayımı: özdeş ikiz/yineleme | 3 | 3 | — | 0 | ✓ |
| Derece sayımı: 2. derece | 5 | 5 | — | 0 | ✓ |
| Derece sayımı: 3. derece | 3 | 3 | — | 0 | ✓ |
| Budamasız: ortalama k_0 | 0,96271543 | 0,96271543 | 0,96271543 | 2,6e−15 | ✓ |
| Budamasız: ortalama \varphi (KING) | −0,0038131 | −0,0038131 | −0,0038131 | 9,5e−18 | ✓ |
Ölçütü karşılayan: 48/48. Python: süzgeç, budama (R'nin rastgele sayı akışı yeniden kurularak), momentler yöntemi ve KING, numpy ile açık formüllerden; "en büyük farklı çift" satırları 4278 çiftin tamamı üzerinden en kötü durumu gösterir. R: aynı adımlar yalnız taban R ile (set.seed, sample.int, cor, matris çarpımları).
81.7 Çıktıyı okuma
Örnek ayarın konsol metni:
Not: tek biçimli (monomorfik) 563 SNP çözümlemede kullanılmaz (ör. 1_4461905_rs583027).
93 birey, 4278 çift; 2. derece ve daha yakın 73 çift. Tahminler alel frekanslarına dayanır; küçük örneklemde ve tabakalaşmada
MoM yanlı olabilir, KING-robust daha dayanıklıdır.
Tablolar (kısaltılmış):
Özet (budama: kayan pencere, rastgele başlangıç; tohum parametresi)
                                                                      olcu  deger
0                                                                    Birey     93
1                                         Tek biçimli olmayan otozomal SNP   8160
2                                                Budamadan sonra kalan SNP   5428
3  MAF ≥ 0,05 ve çağrı oranı ≥ 0,95 süzgecinden geçen SNP (budamadan önce)   7077
4                                                              Birey çifti   4278

Kromozom başına budama (|LD| > 0.2, pencere 500 kb, composite)
 kromozom  snp  kalan      oran
        1  662    446  0.673716
        2  700    461  0.658571
        …
       22  106     67  0.632075

Akrabalık derecesi (KING eşikleri; ölçüt: KING-robust)
                   derece  cift_sayisi
 1. derece: ebeveyn–yavru           65
                2. derece            5
                3. derece            3
             akraba değil         4202
      özdeş ikiz/yineleme            3

Birey çiftleri (akrabalığa göre azalan; k0, k1, k2: PLINK MoM; IBS0 ve kinship_KING: KING-robust)
         ID1          ID2        k0        k1        k2  kinship_MoM      IBS0  kinship_KING                    derece
 NA18859.dup      NA18859  0.000000  0.001654  0.998346     0.499586  0.000000      0.499585       özdeş ikiz/yineleme
     NA18862  NA18862.dup  0.000000  0.005519  0.994481     0.498620  0.000000      0.498610       özdeş ikiz/yineleme
     NA19238  NA19238.dup  0.000000  0.006627  0.993373     0.498343  0.000000      0.498377       özdeş ikiz/yineleme
     NA18863  NA18862.dup  0.008679  0.947017  0.044304     0.258906  0.000555      0.262313  1. derece: ebeveyn–yavru
 …
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Özet | Birey, SNP ve çift sayıları | "Tek biçimli olmayan otozomal SNP" satırı tek biçimli ve otozom dışı SNP'ler atıldıktan sonraki sayıdır; MAF ve çağrı oranı süzgecinden geçen (budamadan önceki) SNP sayısı ayrı bir satırdadır (81.4.1). |
| Kromozom başına budama | Her kromozomda SNP sayısı, kalan sayı ve oran | Oranlar benzer olmalıdır (örnekte 0,61–0,70). Bir kromozomda çok düşük oran, yoğun genotiplenmiş ya da uzun LD bloklu bir bölgeyi gösterir. |
| Akrabalık derecesi | Sınıf başına çift sayısı | Beklenen aile yapısıyla karşılaştırılır; beklenmeyen yineleme ve birinci derece çiftler önce incelenir. |
| Birey çiftleri | k_0,k_1,k_2, iki \varphi, IBS0, derece | Bir çiftin iki \varphi'si uyuşmalıdır; uyuşmuyorsa tabakalaşma ya da düşük kaliteli örnek düşünülür. |
| Şekil 1 | k_0–k_1 düzleminde çiftler ve beklenen noktalar | Akraba olmayanlar sağ alt köşede (1{,}0), ebeveyn–yavru sol üstte (0{,}1), yinelemeler orijinde. Kesikli çizgi k_2=0 doğrusudur. |
| Şekil 2 | IBS0'a karşı KING \varphi'si, derece eşikleriyle | Ebeveyn–yavru çiftleri IBS0 \approx0'da, akraba olmayanlar sağ altta kümelenir. |
Şekil 81.1. Şablonun çizdiği k_0–k_1 saçılımı (örnek veri, 4278 çift). Turuncu çarpılar beklenen akrabalık noktalarıdır; akraba olmayan çiftler (1{,}0) köşesinden k_2=0 doğrusu boyunca yukarı yayılır.
Şekil 81.2. KING-robust akrabalık katsayısı ve IBS0 oranı. Noktalı çizgiler derece eşikleridir; üç yineleme 0,5'te, 65 ebeveyn–yavru çifti 0,25'te ve IBS0 sıfıra yakın kümelenir.
Rapor cümlesi (örnek ayar):
Tek biçimli olmayan 8160 otozomal SNP, en küçük alel frekansı 0,05 ve çağrı oranı 0,95 eşikleriyle süzüldükten sonra bağlantı dengesizliğine göre budandı (bileşik LD, eşik 0,2, pencere 500 kb); kalan 5428 SNP ile 93 örneğin 4278 çiftinde KING-robust akrabalık katsayısı ve momentler yöntemiyle IBD olasılıkları kestirildi. Üç yinelenmiş örnek (\varphi \approx 0{,}50) ve 65 ebeveyn–yavru çifti (\varphi 0,238–0,262; IBS0 < 0,002) beklenen aile yapısıyla uyumluydu; ayrıca 5 ikinci ve 3 üçüncü derece çift saptandı.
81.8 Sık hatalar ve tuzaklar
- Sütun adlarında harita olmaması. Kromozom ve konum yalnız sütun adından okunur. Adlar
snp1,rs123gibiyse SNP listesi boş bırakıldığında "SNP sütunu yok", SNP'ler elle seçildiğinde "Budama için SNP haritası gerekli" iletisi çıkar. Sütunlar<kromozom>_<konum>_<ad>biçiminde adlandırılır ya da budama kapatılır; budama kapalıyken yoğun veride kestirimlerin kesinliği olduğundan iyi görünür. - Kromozomu harfle yazmak.
X_…,chr1_…adları biçime uymaz ve tek bir uymayan sütun bütün haritayı geçersiz kılar. Cinsiyet kromozomları sayıyla (23, 24) yazılırsa şablon onları atar ve sürdürür. - Budanmış SNP sayısındaki küçük farkları sorun sanmak. Küme tohuma ve başlangıç seçeneğine bağlıdır (5424–5445). Sınıf sınırındaki çiftler bundan etkilenir: tohum 7 ile ikinci derece çift sayısı 5'ten 4'e, üçüncü derece 3'ten 4'e geçmiştir. Kesin akrabalıklar (yineleme, ebeveyn–yavru) değişmez. Raporlarda tohum ve başlangıç seçeneği yazılır.
- Momentler yönteminin küçük pozitif \varphi'lerini uzak akrabalık saymak. Akraba olmayan çiftlerde ortalama \varphi 0,006, en büyük değer 0,052'dir; aynı çiftlerde KING ortalaması -0{,}008'dir. Uzak akrabalık kararı KING'e ve her iki kestiricinin uyumuna dayandırılır.
- Küçük ya da akrabalarla dolu örneklemde momentler yöntemine güvenmek. Frekanslar aynı örneklemden kestirilir; örneklemin çoğu akraba ise frekanslar yanlı olur. KING-robust bu durumdan etkilenmez.
- KING-homo ile ebeveyn–yavru ayrımına IBS0 beklemek. Bu birleşimde IBS0 yoktur; ayrım KING-homo'nun k_0 kestirimiyle yapılır (81.4.6). IBS0–\varphi şekli yalnız IBS0 hesaplandıysa çizilir.
otozomonayını kapatıp X kromozomu SNP'lerinin sonuçları bozmayacağını sanmak. Onay kapalıyken kromozom numarası 22'den büyük SNP'ler de çözümlemeye girer; momentler ve KING formülleri otozomal SNP için tanımlıdır.- Aile sütununu yanlış doldurmak. Aile içi çiftlerde daha az tutucu bir kestirici kullanılır. Akraba olmayan bireylere aynı aile numarası verilirse \varphi'leri yukarı kayar; aile bilgisi güvenilir değilse sütun boş bırakılır. Örnekte aile sütunu çıkarıldığında aile içi 99 çiftin 97'sinde \varphi değişmiş, en büyük değişim 0,026 olmuştur.
- D' ile 0,2 eşiğini kullanmak. SNP'lerin yarısı atılır (8160'tan 4070 kalır). D' seçilecekse eşik yeniden düşünülür.
- Çağrı oranı ve MAF süzgecinin etkisini özet tablosundan okumaya çalışmak. Tablo bu süzgeçten önceki sayıyı verir; budama açıkken "kalan" sayısı süzgecin ve budamanın birleşik sonucudur.
- Çok büyük veriyle çalıştırmak. Veri, veri sekmesinden düz tablo olarak aktarılır ve bellekte yoğun matris olarak tutulur; binlerce birey ve yüz binlerce SNP bu yol için uygun değildir.
81.9 Uzman soruları
S1. Bileşik LD ile genotip korelasyonu neden aynı sonucu veriyor?
Bileşik LD'nin payı, iki SNP'nin alel sayılarının kovaryansının yarısıdır: 2n_{AABB}+n_{AABb}+n_{AaBB}+\tfrac12n_{AaBb}=\tfrac12\sum g_Ag_B. Paydadaki p_A(1-p_A)+D_A ise alel sayısının varyansının yarısıdır; Hardy–Weinberg düzeltmesi tam olarak bunu sağlar. Oran bu yüzden Pearson korelasyonudur. Örnek veride iki seçenek aynı 5428 SNP'yi tutmuş ve bütün çiftlerde aynı kestirimleri vermiştir. Haplotip tabanlı r farklıdır: EM ile faz kestirir ve Hardy–Weinberg dengesini varsayar.
S2. Budama açgözlü bir yöntem; en büyük bağımsız kümeyi buluyor mu?
Hayır. Her aday yalnız o ana dek tutulanlarla karşılaştırılır ve karar geri alınmaz; başka bir sırada daha büyük bir küme çıkabilir. Amaç en büyük kümeyi bulmak değil, çift bazında LD'si eşiğin altında bir küme elde etmektir. Tutulan iki SNP arasında, pencere içinde kaldıkça, |\text{LD}|\le\tau güvencesi vardır; pencere dışındaki uzak LD (ör. tabakalaşmadan gelen) budanmaz.
S3. Beklenen IBS olasılıkları neden çifte özgü değil de bütün SNP'lerin ortalaması?
SNPRelate, olasılıkları çözümlemedeki bütün SNP'ler üzerinden bir kez ortalar ve her çiftte bu ortalamayı çiftin ortak gözlenen SNP sayısıyla çarpar; böylece beklenen değerler her çift için yeniden toplanmaz. Öteki olası tanım, beklenen sayıları yalnız çiftin gözlendiği SNP'ler üzerinden toplamaktır. Eksik veri azken fark küçüktür: örnek çiftte k_0 iki tanımla 0,865725 ve 0,865632 çıkar. Eksik genotipi çok ve eksikliği belirli frekans sınıflarında yoğunlaşan bir örnekte fark büyür; böyle örnekler çağrı oranı süzgeciyle zaten ayıklanmalıdır.
S4. Sonlu örneklem düzeltmesi ne kadar önemli?
Düzeltme, alel frekanslarının çiftin kendisini de içeren örneklemden kestirilmesini hesaba katar: iki bireyin dört aleli, T alellik havuzdan yerine koymadan çekilmiş gibi ele alınır. T=186 (93 birey) için 2p^2q^2 teriminin çarpanı p=0{,}5'te yaklaşık 1,011'dir; nadir alelde çarpan 1'den uzaklaşır. Düzeltme yapılmazsa E_{00} küçük, \hat k_0 büyük çıkar ve akrabalık küçümsenir. Örneklem büyüdükçe çarpanlar 1'e yaklaşır.
S5. KING neden negatif \varphi veriyor?
Kestirici bir farktır ve sıfırın çevresinde simetrik gürültü taşır. Ayrıca aileler arası biçimdeki \min normalleştirmesi, heterozigotlukları farklı iki bireyde sonucu aşağı iter: farklı kökenlerden bireylerde \varphi belirgin biçimde negatif olur. Negatif değer "akraba değil" demektir; büyüklüğü tabakalaşmanın ölçüsü olarak okunabilir. Örnekte en küçük değer -0{,}052'dir; tek popülasyonlu bir örnek için olağandır.
S6. Tam kardeş ile ebeveyn–yavru aynı \varphi'ye sahip; ayrım ne kadar güvenilir?
Beklenen IBS0 ebeveyn–yavruda 0, tam kardeşte \tfrac14\cdot\overline{P(I_0\mid Z_0)}'dır; örnek veride bu yaklaşık 0{,}016'dır. 5000 SNP'de bu, 80 zıt homozigota karşılık gelir; ebeveyn–yavruda gözlenen sayı genotipleme hatası kadardır (örnekte en çok 9). İki sınıf bu SNP sayısında kesin biçimde ayrılır. 0,005 eşiği genotipleme hata oranı yüksek veride ebeveyn–yavru çiftlerini tam kardeş sınıfına düşürebilir; k_0<0{,}1 koşulu ikinci bir güvencedir.
S7. Geometrik kısıt ne zaman açılır?
Kısıt, akrabalı olmayan bir çiftin IBD olasılıklarının sağlaması gereken k_1^2\ge4k_0k_2 koşulunu dayatır; örneğin (0{,}5;\ 0;\ 0{,}5) biyolojik olarak olanaksızdır. Kestirimleri soy kütüğü ilişkilerinin bulunduğu eğriye çeker ve k_0–k_1 grafiğini düzenler, ama \varphi'yi değiştirmez. Ebeveynleri akraba olan bireyler içeren popülasyonlarda (akrabalı yetiştirme, kendileme) koşul geçerli değildir; orada kısıt açılmaz.
S8. İkinci ve üçüncü derece sınıflar ne kadar güvenilir?
Sınıf eşikleri arasındaki aralık derece arttıkça daralır (0,0884–0,177; 0,0442–0,0884), kestiricinin standart hatası ise sabit kalır. 5000 SNP ile KING'in akraba olmayan çiftlerdeki saçılımı \pm0{,}02 düzeyindedir (aralık -0{,}052 ile 0{,}035); üçüncü derece eşiği olan 0,044 bu saçılımın hemen üstündedir. Bu yüzden üçüncü derece atamaları tohumla değişebilir (81.8) ve kesin sayılmaz. Uzak akrabalık için daha çok SNP ve parça tabanlı IBD yöntemleri gerekir.
S9. Budama kapatılırsa sonuç ne kadar değişir?
Örnek veride pek değişmez: budamasız 7077 SNP ile sınıf sayıları 3, 65, 4, 3 ve 4203'tür; ortalama k_0 0,961'den 0,963'e çıkar. Bunun nedeni verinin seyrek olmasıdır (SNP başına yaklaşık 350 kb); LD'nin çoğu zaten yoktur. Yoğun dizilerde (milyonlarca SNP) budama hem hesap süresini hem de LD bloklarının kestirimlere verdiği orantısız ağırlığı azaltır ve atlanmaz.
81.10 Kaynaklar
- Hill, W. G., & Robertson, A. (1968). Linkage disequilibrium in finite populations. Theoretical and Applied Genetics, 38(6), 226–231. https://doi.org/10.1007/BF01245622
- International HapMap Consortium. (2005). A haplotype map of the human genome. Nature, 437(7063), 1299–1320. https://doi.org/10.1038/nature04226
- Lewontin, R. C. (1964). The interaction of selection and linkage. I. General considerations; heterotic models. Genetics, 49(1), 49–67. https://doi.org/10.1093/genetics/49.1.49
- Manichaikul, A., Mychaleckyj, J. C., Rich, S. S., Daly, K., Sale, M., & Chen, W.-M. (2010). Robust relationship inference in genome-wide association studies. Bioinformatics, 26(22), 2867–2873. https://doi.org/10.1093/bioinformatics/btq559
- Purcell, S., Neale, B., Todd-Brown, K., Thomas, L., Ferreira, M. A. R., Bender, D., Maller, J., Sklar, P., de Bakker, P. I. W., Daly, M. J., & Sham, P. C. (2007). PLINK: A tool set for whole-genome association and population-based linkage analyses. The American Journal of Human Genetics, 81(3), 559–575. https://doi.org/10.1086/519795
- Thompson, E. A. (1975). The estimation of pairwise relationships. Annals of Human Genetics, 39(2), 173–188. https://doi.org/10.1111/j.1469-1809.1975.tb00120.x
- Weir, B. S. (1979). Inferences about linkage disequilibrium. Biometrics, 35(1), 235–254. https://doi.org/10.2307/2529947
- Zheng, X., Levine, D., Shen, J., Gogarten, S. M., Laurie, C., & Weir, B. S. (2012). A high-performance computing toolset for relatedness and principal component analysis of SNP data. Bioinformatics, 28(24), 3326–3328. https://doi.org/10.1093/bioinformatics/bts606