88. RNA-seq diferansiyel ifade ve mikrobiyom diferansiyel bolluk
Şablon kimliği: rnaseq_mikrobiyom · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/rnaseq_mikrobiyom.R (satır 1–488; üstbilgi 1–187) · Örnek veri: _ornek/pasilla_sayim.csv · Paketler: DESeq2 1.50.2, edgeR 4.8.2, limma 3.66.0, apeglm 1.32.0, qvalue 2.42.0 (RNA-seq); ALDEx2 1.42.0, ANCOMBC 2.12.1 (mikrobiyom)
88.1 Ne işe yarar
Şablon bir sayım matrisinde (satırlar gen ya da takson, sütunlar örnek) grupları karşılaştırır ve her özellik için "bu gen ya da takson gruplar arasında farklı mı, farkın büyüklüğü ne?" sorusunu yanıtlar. İki çözümleme sunar; hangisinin çalışacağı "Çözümleme" alanıyla seçilir.
RNA-seq diferansiyel ifade. Gen i'nin örnek j'deki okuma sayısı negatif binom dağılımlıdır:
- K_{ij}: ham sayım; \mu_{ij}: beklenen değeri; varyansı \mu_{ij}+\alpha_i\mu_{ij}^2.
- s_j: örneğin boyut katsayısı; dizileme derinliği ve bileşim farkını giderir.
- q_{ij}: genin örnekteki, derinlikten arındırılmış ifade düzeyi.
- \alpha_i: genin dağılım (dispersiyon) parametresi; biyolojik değişkenliğin karesi (\sqrt{\alpha_i} biyolojik değişim katsayısıdır).
- \mathbf x_j: tasarım satırı (sabit, varsa ek faktör, grup göstergeleri); \beta_i'nin grup bileşeni \log_2 kat değişimidir.
Aynı soru üç yöntemle yanıtlanır ve sonuçlar yan yana verilir: DESeq2 (Wald testi ve olabilirlik oranı testi), edgeR (yarı olabilirlik F testi) ve limma-voom (ağırlıklı doğrusal model, ılımlı t).
Mikrobiyom diferansiyel bolluk. Dizileme, toplamı keyfî olan bileşimsel veri üretir: bir taksonun artışı ötekilerin göreli payını düşürür (Gloor ve ark., 2017). Şablon bu yapıyı gözeten iki yöntemi çalıştırır: ALDEx2 (merkezlenmiş log-oran dönüşümü ve Monte Carlo örneklemesi) ve ANCOM-BC2 (örnekleme oranı yanlılığını düzelten log-doğrusal model).
Ne zaman kullanılır? Biyolojik tekrarları olan iki ya da daha çok grubun ham okuma sayımlarıyla karşılaştırılmasında; isteğe bağlı tek bir ek faktörle (parti, kütüphane türü) düzeltme yapılarak.
Ne zaman kullanılmaz?
- Normalleştirilmiş değerler (TPM, FPKM, oran): şablon tam sayı olmayan veride durur; yöntemler ham sayımın ortalama–varyans ilişkisine dayanır.
- Grup başına tek örnek: şablon durur; dağılım kestirilemez.
- Az sayıda genin qPCR ölçümü:
qpcr_goreli(Bölüm 85). - Alfa ve beta çeşitliliği, ordinasyon: ekoloji kategorisindeki
cesitlilik_indekslerişablonu. - Sürekli ortak değişken, etkileşim, eşleştirilmiş tasarım, tekrarlı ölçüm: form tek grup faktörü ve tek kategorik ek faktör alır; daha karmaşık tasarım
bos_r(Bölüm 61) üzerinde aynı paketlerle yazılır.
Temel programla ilişki. Temel programda sayım matrisleri için gen düzeyinde ampirik Bayes yöntemleri yoktur. Her gene ayrı negatif binom regresyonu uydurmak mümkündür, ama üç–dört tekrarla gen başına dağılım kestirimi çok gürültülüdür; bu şablonun yöntemleri gücünü bütün genlerden bilgi ödünç almaktan alır.
88.2 Şablonun girdileri
Form, üstbilgideki yirmi dört [[param]] bloğundan kurulur (rnaseq_mikrobiyom.R:10–186). Alanların çoğu yalnız bir çözümlemede etkilidir.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Çözümleme · analiz |
seçim · Model | rnaseq |
rnaseq, mikrobiyom |
Hangi dalın çalışacağı (255). |
Gen / takson kimliği · ozellik |
kategorik sütun · Değişkenler | ilk uygun sütun | herhangi sütun | Satır adları; boşlar satir_<no>, yinelenenler make.unique (200–204). |
Örnek sayım sütunları · sayimlar |
sütunlar (sayısal) · Değişkenler | yok (en az 4) | negatif olmayan tam sayılar | Sayım matrisi (191–199). |
Gruplar · gruplar |
metin · Değişkenler | boş | sütun sırasıyla virgüllü liste | Boşsa grup, sütun adının sonundaki sayı atılarak bulunur (207–216). |
Referans grup · referans |
metin · Değişkenler | boş | bir grup adı | Boşsa ad sırasındaki ilk grup (217–221, 225); seçilen grup konsola yazılır (245–246). |
Ek faktör · ek_faktor |
metin · Değişkenler | boş | sütun sırasıyla virgüllü liste | Modele ~ ek + grup olarak girer (226–236). |
Karşıtlık başına ayrıntı tablosu · karsitlik_tablolari |
onay · Çıktı | kapalı | açık, kapalı | Yalnız RNA-seq çözümlemesinde ve iki ya da daha çok karşıtlık (üç ya da daha çok grup) varken: her karşıtlık için ayrı tablo, sona q_padj_kumesi sütunu (50–57, 441–451). |
YKO düzeyi · fdr |
ondalık · Seçenekler | 0,1 | 0,001–0,5 | Anlamlılık eşiği; DESeq2 bağımsız süzmesinin hedefi (241). |
Ön süzme: en az sayım · en_az_sayim |
tamsayı · Seçenekler | 10 | 0–1000 | RNA-seq ön süzgeci (349). |
Ön süzme: en az örnek · en_az_ornek |
tamsayı · Seçenekler | 0 | 0–1000; 0 = en küçük grup büyüklüğü | RNA-seq ön süzgeci (348–349). |
log2 kat değişimi küçültmesi · kucultme |
seçim · Model | apeglm |
apeglm, ashr, normal |
lfcShrink(type =) (382–400). |
DESeq2 dağılım-ortalama eğrisi · deseq_fit |
seçim · Model | parametric |
parametric, local, mean |
DESeq(fitType =) (357–359). |
DESeq2 boyut katsayısı türü · deseq_sf |
seçim · Model | ratio |
ratio, poscounts, iterate |
DESeq(sfType =) (358–359). |
DESeq2 bağımsız süzme · bagimsiz_suzme |
onay · Seçenekler | açık | açık / kapalı | results(independentFiltering =) (373). |
DESeq2 Cook uzaklığı denetimi · cook |
onay · Seçenekler | açık | açık / kapalı | Kapalıysa cooksCutoff = FALSE (374). |
edgeR/voom normalleştirme · edger_norm |
seçim · Model | TMM |
TMM, TMMwsp, RLE, upperquartile, none |
normLibSizes(method =) (377). |
limma eBayes dayanıklı kestirim · limma_robust |
onay · Gelişmiş | kapalı | açık / kapalı | eBayes(robust =) (381). |
İzlenen genler · izlenen |
metin · Çıktı | boş | virgüllü kimlik listesi | Ayrı tabloda bu genlerin satırları (431–438). |
Özet tablodaki özellik sayısı · ust_n |
tamsayı · Çıktı | 20 | 5–200 | En küçük p'li gen tablosunun satır sayısı (430). |
ALDEx2 Monte Carlo örnek sayısı · mc |
tamsayı · Seçenekler | 128 | 16–1024 | aldex(mc.samples =) (268–270, 288). |
ALDEx2 CLR paydası · aldex_payda |
seçim · Model | all |
all, iqlr, zero |
aldex(denom =) (268, 288). |
ANCOM-BC2 yaygınlık süzgeci · yayginlik |
ondalık · Seçenekler | 0,1 | 0–0,9 | ancombc2(prv_cut =) (300–302). |
ANCOM-BC2 çoklu test düzeltmesi · ancom_duzeltme |
seçim · Seçenekler | holm |
holm, BH, bonferroni |
ancombc2(p_adj_method =) (299, 302). |
ANCOM-BC2 yapısal sıfır saptama · ancom_yapisal_sifir |
onay · Gelişmiş | kapalı | açık / kapalı | ancombc2(struc_zero =) (302). |
Örnek ayar (ornek_param, satır 9): ozellik = "gen", yedi sayım sütunu, referans = "untreated"; öteki alanlar varsayılandadır. Gruplar boş bırakılmıştır ve sütun adlarından çıkarılır.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 190 |
| Kimlik sütunu sayım sütunu olarak da seçilmiş | "Kimlik sütunu sayım sütunu olarak da seçilemez." | 192 |
| Dörtten az sayım sütunu | "En az 4 örnek (sayım sütunu) gerekli." | 193 |
| Sayım sütunu sayısal değil | "'…' sayısal olmalı (ham sayım)." | 194 |
| Eksik hücre | "Sayım matrisinde … eksik hücre var …" | 196 |
| Negatif sayım | "Negatif sayım var …" | 197 |
| Tam sayı olmayan değer | "Sayımlar tam sayı olmalı; normalleştirilmiş … değerler değil …" | 198 |
| Grup listesinin uzunluğu sütun sayısına eşit değil | "Gruplar parametresinde … değer var, sayım sütunu …" | 210 |
| Gruplar sütun adlarından çıkarılamadı | "Gruplar sütun adlarından çıkarılamadı …" | 214 |
| Referans grup yok; tek grup; tek örnekli grup | ilgili iletiler | 221, 222, 224 |
| Ek faktör grupla tam karışık | "… (tasarım matrisi tam ranklı değil)." | 238 |
| Parametre sayısı örnek sayısına eşit ya da büyük | "Örnek sayısı model parametre sayısından fazla olmalı." | 239 |
| Mikrobiyom: 10'dan az sıfır olmayan takson; tümü sıfır örnek | ilgili iletiler | 259, 260 |
| RNA-seq: süzmeden sonra 20'den az gen; tümü sıfır örnek | ilgili iletiler | 353, 354 |
| ALDEx2 ya da DESeq2 çalışmadı | "… çalıştırılamadı: …" | 265, 366 |
Notlar (durdurmaz). Eksik ya da yinelenen kimlikler (202–203); tek düzeyli ek faktörün modele eklenmediği (232); bütün örneklerde sıfır olan taksonların çıkarıldığı (257); ek faktörün ALDEx2'de kullanılmadığı (261); ANCOM-BC2 çalışmazsa nedeni (305); DESeq2 dağılım eğrisi uydurulamazsa gen bazlı kestirimlerin kullanıldığı (361); küçültme paketi kurulu değilse normal önsele geçildiği (386); izlenen genlerden bulunamayanlar (436); referans boş bırakıldığında alfabetik ilk grubun referans alındığı (245–246); küçültme için katsayı adı bulunamadığında kullanılan yöntem (453–455); tablonun 5000 satırla sınırlandığı (439); kullanılan küçültme yöntemi (452).
88.3 Örnek veri
Dosya: _ornek/pasilla_sayim.csv; 14 599 satır (gen), 8 sütun. Drosophila melanogaster S2 hücrelerinde pasilla geninin RNA girişimiyle susturulduğu deneydir (Brooks ve ark., 2011); DESeq2 belgesinin örnek verisidir (Love ve ark., 2014).
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
gen |
Kimlik | metin | FlyBase kimlikleri (FBgn…). |
treated1–treated3 |
Sayım | sayısal | Susturulmuş hücreler; kütüphane büyüklükleri 18,7; 9,6; 10,3 milyon okuma (süzmeden sonra). |
untreated1–untreated4 |
Sayım | sayısal | Kontrol; 14,0; 21,9; 8,4; 9,8 milyon. |
Eksik hücre yoktur. Gruplar sütun adlarından çıkarılır: sondaki sayı atılınca treated (3 örnek) ve untreated (4 örnek) kalır.
Grup sırası ve referans. Gruplar ad sırasına dizilir (satır 217); referans verilmezse ilk sıradaki grup referans olur. Bu veride ad sırası treated, untreated'dır: referans alanı boş bırakılsaydı kontrol değil susturulmuş grup referans olur ve bütün \log_2 kat değişimlerinin işareti tersine dönerdi. Örnek ayar referansı adıyla verir. Arayüzdeki düzey sırası burada rol oynamaz, çünkü gruplar bir sütundan değil metin alanından ya da sütun adlarından gelir.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) en_az_sayim = 400, fdr = 0,05, iki izlenen gen (4555 gen kalır; sonuç tablosu bütün genleri içerir); (3) gen satırları karıştırılmış, örnek sütunları ters sırada; (4) mikrobiyom, ek veri dogrulama/rnaseq_mikrobiyom/mb_iki.csv (benzetimle üretilmiş 150 takson × 12 örnek; K ve H grupları altışar örnek; ilk 12 taksonda gerçek fark; tohum 5), referans K; (5) aynı veri, ANCOM-BC2 düzeltmesi BH, fdr = 0,05; (6) aynı verinin üç gruplu düzeni (A, B, C dörder örnek).
88.4 Yöntem: formüller ve hesap adımları
RNA-seq dalının sırası: (1) ön süzme; (2) boyut katsayıları; (3) dağılım kestirimi ve küçültme; (4) negatif binom modeli, Wald ve olabilirlik oranı testleri; (5) bağımsız süzme, Benjamini–Hochberg ve q-değerleri; (6) kat değişimi küçültmesi; (7) edgeR ve limma-voom. Mikrobiyom dalı 88.4.8–88.4.9'dadır.
88.4.1 Ön süzme
En az n_{\min} örnekte sayımı en az c_{\min} olan genler tutulur (satır 348–349): varsayılan c_{\min}=10, n_{\min} = en küçük grup büyüklüğü. Örnekte 14 599 genin 8148'i kalır.
Neden test etmeden önce gen atılıyor?
Çok düşük sayımlı genlerde hiçbir test anlamlı çıkamaz; onları tutmak yalnız çoklu test yükünü ve hesap süresini artırır. Süzgeç grup bilgisini kullanmadığından (hangi örneklerin hangi gruptan olduğuna bakmaz) testlerin düzeyini bozmaz. Eşik "en küçük grup büyüklüğü kadar örnekte" koşuluyla, yalnız bir grupta ifade edilen genleri de korur.
88.4.2 Boyut katsayıları
- Payda: genin m örnek üzerindeki geometrik ortalaması; her genin "sanal referans örnek"teki değeri.
- Ortanca, bütün örneklerde pozitif sayımı olan genler üzerinden alınır (örnekte 8148 genin 8122'si).
- s_j: örnek j'nin sanal referansa göre ölçeği. Normalleştirilmiş sayım K_{ij}/s_j'dir;
baseMeanbunların bütün örneklerdeki ortalamasıdır.
Neden toplam okuma sayısına bölünmüyor?
Toplam, birkaç çok yüksek ifadeli genin denetimindedir: bir grupta bu genler artarsa öteki bütün genlerin payı düşer ve hiç değişmedikleri hâlde "azalmış" görünürler. Oranların ortancası genlerin çoğunun değişmediğini varsayar ve uç genlere duyarsızdır (Anders ve Huber, 2010). Örnekte en derin kütüphane en sığın 2,6 katıdır; boyut katsayıları 0,646–1,791 aralığındadır.
88.4.3 Dağılımın kestirilmesi
Üç adım (Love ve ark., 2014): (1) her gen için dağılımın gen bazlı enbüyük olabilirlik kestirimi; (2) bu kestirimlerin ortalama ifadeye karşı eğrisi, parametrik biçimde \alpha_{\text{eğri}}(\bar\mu)=a_1/\bar\mu+a_0; (3) her genin kestiriminin eğriye doğru küçültülmesi: eğri değeri çevresinde log-normal bir önselle sonsal tepe değeri alınır. Eğriden çok yukarıda kalan genler (gerçekten değişken genler) küçültülmez.
Neden küçültme?
Üç ve dört tekrarla tek bir genin varyansı çok kötü kestirilir: şansla küçük çıkan dağılım yanlış pozitif, büyük çıkan yanlış negatif üretir. Benzer ifade düzeyindeki genlerin dağılımları birbirine yakındır; eğri bu ortak bilgiyi taşır. Küçültmenin gücü önselin genişliğine ve serbestlik derecesine bağlıdır ve veriden kestirilir.
Şablon son dağılım değerini dispersiyon sütununda verir (örnekte sonuç tablosundaki genlerde ortanca 0,017; biyolojik değişim katsayısı \sqrt{0{,}017}=\%13).
88.4.4 Wald ve olabilirlik oranı testleri
Dağılım sabitlendikten sonra her gen için negatif binom modeli yinelemeli ağırlıklı en küçük karelerle uydurulur. İki gruplu tasarımda \log_2 kat değişiminin standart hatası kapalı biçimde yazılır:
- T, U: iki grubun örnekleri; \hat\mu_j=s_j\hat q_{g(j)} uydurulmuş ortalama.
- w_j: örneğin bilgi ağırlığı. \alpha\to0 için w_j=\hat\mu_j (Poisson); büyük \hat\mu_j'de w_j\to1/\alpha: yüksek ifadeli genlerde kesinliği sayım değil dağılım ve tekrar sayısı sınırlar.
- z: Wald istatistiği (
stat); \Phi: standart normal dağılım fonksiyonu.
Olabilirlik oranı testi (OO; p_LRT) tam modeli grup terimi çıkarılmış modelle karşılaştırır: G^2=2(\ell_{\text{tam}}-\ell_{\text{ind}})\sim\chi^2_{g-1}. İki grupta Wald testiyle aynı hipotezi sınar ve sonuç tablosuna eklenir; ikiden çok grupta gruplar arası genel testtir ve ayrı tabloda verilir (satır 372, 405, 418–421).
Koddaki tercih
DESeq2::DESeq(dds, fitType, sfType) üç adımı (boyut katsayısı, dağılım, Wald) birlikte yapar (satır 359); karşıtlıklar results(dds, contrast = c("grup", k, referans), alpha = fdr) ile alınır (391). Eğri uydurulamazsa (genlerin dağılımları birbirine çok yakınsa) şablon gen bazlı kestirimlere düşer ve bunu not eder (360–366). Cook uzaklığı denetimi açıkken, tek bir örneğin sürüklediği genlerin p'si boş bırakılır; bu denetim grup başına en az üç tekrar olan tasarımlarda uygulanır.
88.4.5 Bağımsız süzme, düzeltilmiş p ve q-değeri
padj, Benjamini–Hochberg yöntemiyle düzeltilmiş p'dir, ama bütün genler üzerinden değil: DESeq2 önce ortalama normalleştirilmiş sayımı düşük genleri ayırır, eşiği fdr düzeyinde ret sayısını enbüyükleyecek biçimde seçer ve ayrılan genlerin padj'ını boş bırakır (Bourgon ve ark., 2010).
- p_{(1)}\le\dots\le p_{(m)}: süzgeçten geçen m genin sıralı p değerleri;
padjbunlardan kurulur. - q: Storey'nin q-değeri; m', p'si boş olmayan bütün genlerin sayısıdır (süzgeç uygulanmaz; satır 405).
- \hat\pi_0: gerçekten farksız genlerin kestirilen oranı; p değerlerinin 1'e yakın bölgedeki yoğunluğundan kestirilir (Storey ve Tibshirani, 2003). BH örtük olarak \pi_0=1 alır; \hat\pi_0<1 ise q değerleri
padj'dan o oranda küçüktür.
`padj` ile `q` aynı eşikte farklı sayıda gen verir
İkisi de yanlış keşif oranını denetler ama farklı varsayımla. Çalıştırma 2'de \hat\pi_0=0{,}7505'tir: her genin q'su padj'ının 0,7505 katıdır. Raporda hangisinin kullanıldığı yazılır; şablonun özet sayıları ve grafik renkleri padj'a göredir.
88.4.6 Kat değişiminin küçültülmesi
Düşük sayımlı genlerde \hat\beta çok gürültülüdür: 2'ye karşı 8 okuma "dört kat" görünür. Küçültme, bütün genlerin \hat\beta dağılımından kestirilen sıfır merkezli bir önselle sonsal kestirim verir: bilgisi az olan genlerin kat değişimi sıfıra çekilir, bilgisi çok olanlarınki neredeyse değişmez.
Koddaki tercih
Varsayılan DESeq2::lfcShrink(dds, coef = "grup_<k>_vs_<referans>", type = "apeglm") çağrısıdır (satır 396–398): ağır kuyruklu (Cauchy) önsel, büyük gerçek farkları normal önselden daha az küçültür (Zhu ve ark., 2019). Seçenekler ashr (Stephens, 2017) ve DESeq2'nin ilk sürümündeki normal önseldir. Küçültülmüş değer log2FC_kucultulmus sütununa yazılır ve MA grafiğinde kullanılır; stat, p ve padj küçültülmemiş kestirimden gelir. Katsayı adı grup_<k>_vs_<referans> biçiminde aranır; adın kurulabilmesi için grup adları harfle başlamalı ve yalnız harf, rakam, nokta ve alt çizgi içermelidir (88.8).
88.4.7 edgeR ve limma-voom
Aynı süzülmüş matris iki bağımsız yöntemle daha çözümlenir (satır 377–381, 395–396):
- edgeR. Normalleştirme TMM'dir (kırpılmış M değerleri ortalaması; Robinson ve Oshlack, 2010): örnek çiftleri arasında log-oranların, uçlar kırpıldıktan sonraki ağırlıklı ortalaması. Negatif binom modeli
glmQLFitile uydurulur; test yarı olabilirlik F testidir: gen bazlı yarı olabilirlik dağılımı ampirik Bayes ile küçültülür ve belirsizliği F dağılımının payda serbestlik derecesine yansır (Chen ve ark., 2025). - limma-voom. Sayımlar \log_2 milyonda okuma ölçeğine çevrilir; ortalama–varyans eğrisinden her gözleme bir kesinlik ağırlığı atanır (Law ve ark., 2014); ağırlıklı doğrusal model ve ılımlı t (varyansı ampirik Bayes ile küçültülmüş t) uygulanır (Ritchie ve ark., 2015).
Her ikisinin p değerleri bütün süzülmüş genler üzerinden Benjamini–Hochberg ile düzeltilir (edgeR_FDR, voom_FDR); bağımsız süzme yalnız DESeq2 sütunlarında vardır.
Neden üç yöntem birden?
Üçü aynı soruyu farklı varsayımlarla yanıtlar: DESeq2 ve edgeR sayım ölçeğinde negatif binom, voom log ölçeğinde normal model kurar; normalleştirme ve küçültme stratejileri ayrıdır. Güçlü sinyaller üçünde de çıkar; yalnız birinde anlamlı olan genler modele duyarlıdır. Özet tablosu üç yöntemin ortak anlamlı gen sayısını verir (örnekte 908). Bir yöntemi sonuca bakarak seçmek, çoklu çözümlemenin bilinen tuzağıdır; yöntem önceden belirlenir, ötekiler duyarlılık denetimi olarak okunur.
88.4.8 Mikrobiyom: ALDEx2
Sayımlar önce olasılığa, sonra log-orana çevrilir:
- \mathbf K_j: örnek j'nin sayım vektörü; \tfrac12 eklenmesi sıfır sayımlara pozitif olasılık verir.
- b=1,\dots,B: Monte Carlo örneği (varsayılan B=128); her biri örneğin gerçek bileşiminin sonsal dağılımından bir çekimdir. Düşük sayımlı taksonlarda çekimler geniş yayılır: sayım belirsizliği sonuca böyle taşınır.
- clr: merkezlenmiş log-oran; taksonun payının, örnekteki bütün taksonların geometrik ortalamasına oranı. Payda seçeneği
iqlrya dazeroise ortalama yalnız seçilen taksonlar üzerinden alınır.
Her Monte Carlo örneğinde her takson için Welch t ve Wilcoxon testi yapılır, p değerleri BH ile düzeltilir; tabloya B örneğin ortalaması yazılır (Wilcoxon için iki yanlı kesin p, şablonda yeniden hesaplanır; aşağıya bakın): we.ep, wi.ep beklenen p; we.eBH, wi.eBH beklenen düzeltilmiş p (Fernandes ve ark., 2014). İki grupta ayrıca etki büyüklüğü verilir: diff.btw gruplar arası clr farkının, diff.win grup içi yayılımın ortancası, effect ikisinin oranının ortancası. İkiden çok grupta Kruskal–Wallis ve genelleştirilmiş doğrusal model p'leri verilir.
Koddaki tercih
İki grupta aldex() ile aynı üç adım ayrı ayrı çağrılır: aldex.clr(sayimlar, as.character(grup), mc.samples, denom), aldex.ttest ve aldex.effect (satır 268–270); üç ya da daha çok grupta aldex(test = "kw") kullanılır (288). Paketin diff.btw ve effect işareti koşulların alfabetik sırasına bağlıdır; şablon bunu rab.win.<karşıt> − rab.win.<referans> ile karşılaştırarak denetler ve gerekirse işareti çevirir (273–274), böylece iki sütun her zaman "karşıt − referans" yönündedir ve ANCOM-BC2'nin lfc_grup<k> değeriyle aynı işareti taşır. Paketin Wilcoxon beklenen p'si tümüyle ayrışan taksonlarda 0 verebildiğinden (wilcox.fast iki yanlı p'yi tek yanlıdan kurar), şablon her Monte Carlo örneğinde sıra toplamından kesin iki yanlı p'yi (pwilcox) ve BH'yi yeniden hesaplar, ortalamasını wi.ep ve wi.eBH olarak yazar (275–286); altışar örnekte en küçük değer 2/924=0{,}0022'dir. Çağrıdan önce set.seed çalıştırmanın tohumuyla çağrılır (262): ALDEx2 sonuçları kod panelindeki Tohum alanına bağlıdır ve tohum künyede görünür.
88.4.9 Mikrobiyom: ANCOM-BC2
Gözlenen bolluğun logaritması, gerçek bolluğun logaritması ile örneğe özgü bir kaymanın toplamıdır:
- O_{ij}: gözlenen sayım; c_j: örnekleme oranı (dizilenen payın örnekteki gerçek yüke oranı); bilinmez ve örnekten örneğe değişir.
- \hat\beta_i: yanlılığı düzeltilmiş doğal logaritma ölçeğinde kat değişimi (
lfc_grup<k>); \log_2 için \ln2'ye bölünür. - W_i: test istatistiği; p değeri, taksonun sıfır olmayan örnek sayısından parametre sayısı çıkarılarak bulunan serbestlik dereceli t dağılımından alınır.
Yöntem c_j'yi ve taksona özgü yanlılığı veriden kestirip çıkarır; böylece farklar göreli pay değil mutlak bolluk ölçeğinde yorumlanır (Lin ve Peddada, 2020, 2024). Yaygınlık süzgeci, örneklerin belirlenen oranından azında gözlenen taksonları çözümleme dışı bırakır.
Koddaki tercih
Çağrı ANCOMBC::ancombc2(data, taxa_are_rows = TRUE, meta_data, fix_formula = "grup" | "ek + grup", p_adj_method, prv_cut, lib_cut = 0, struc_zero, neg_lb = FALSE, pseudo_sens = FALSE, alpha = fdr, n_cl = 1) biçimindedir (satır 300–303). Sıfır eklentisine duyarlılık çözümlemesi kapalıdır; paketin "duyarlılık denetiminden geçti" süzgeci uygulanmaz. Grup faktörünün ilk düzeyi referans gruptur; lfc_grup<k> her zaman "k − referans" yönündedir. Çalışmazsa şablon durmaz, nedeni not eder ve ALDEx2 sonuçlarını verir.
88.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–187 | Üstbilgi: yirmi üç parametre, örnek veri ve ayar. | |
| 188–204 | Sayım matrisinin kurulması ve denetimi; kimlikler. | Tam sayı denetimi normalleştirilmiş veriyi yakalar (198). |
| 206–225 | Grupların okunması ya da sütun adlarından çıkarılması; ad sırası; referans; grup faktörü. | Düzey sırası: referans, sonra ad sırasıyla ötekiler (225). |
| 226–244 | Ek faktör; tasarım; rank ve serbestlik derecesi denetimi; özet satırı. | |
| 247–253 | qdeg(): q-değeri (hata olursa \pi_0=1); grafik rengi. |
|
| 255–344 | Mikrobiyom dalı: sıfır taksonların atılması, ALDEx2, ANCOM-BC2, özet tablo, iki grafik. | Özet ve grafikler ilk karşıtlık içindir. |
| 346–375 | RNA-seq dalı: ön süzme, DESeq, boyut katsayısı tablosu, OO testi. |
|
| 376–387 | edgeR (normLibSizes, estimateDisp, glmQLFit), voom, eBayes; küçültme paketinin denetimi. |
Aynı tasarım matrisi üç yöntemde ortaktır. |
| 389–422 | Karşıtlık döngüsü: results, lfcShrink, edgeR ve limma tabloları, birleşik satırlar, özet sayıları. |
Her karşıtlık ayrı düzeltilir. |
| 423–452 | Tablolar: özet, OO (çok grup), en küçük p'li genler, izlenen genler, bütün genler; notlar. | Tablolar 5000 satırla sınırlıdır (Bölüm 1.4). |
| 456–487 | MA, volkan ve temel bileşenler grafikleri. | Temel bileşenler varyans dengeleyici dönüşümden, en değişken 500 genle. |
Grupları sütun adlarından çıkaran satır kısa ama kırılgandır:
grp <- sub("[._ -]*[0-9]+$", "", ss)
Sütun adının sonundaki rakamlar (ve önlerindeki ayırıcılar) atılır: treated1 → treated, kontrol_03 → kontrol. Adın sonunda rakam yoksa ya da tekrar numarası ortadaysa (T1_karaciger) çıkarım yapılamaz; her sütun ayrı grup olursa ya da ad boş kalırsa şablon durur ve grupların elle yazılmasını ister. Çıkarım yanlış ama tutarlı bir gruplama üretirse (ör. doz10_1, doz10_2, doz2_1 → doz10, doz10, doz2: doğru; hasta1a, hasta1b → çıkarılamaz) özet satırındaki grup büyüklükleri bunu gösterir; ilk çalıştırmada bu satır okunur.
88.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bu şablonda bağımsız yeniden hesabın kapsamı sınırlıdır ve açıkça belirtilir. dogrulama/rnaseq_mikrobiyom/elle_hesap.py ve r_dogrulama.R şunları paketler çağrılmadan yeniden üretir: ön süzme, boyut katsayıları, baseMean; seçilen genlerde, dağılım şablonun raporladığı değere sabitlenerek, negatif binom modelinin \log_2 kat değişimi, standart hatası, Wald ve OO testleri; bütün BH düzeltmeleri; q-değerleri ve \hat\pi_0; özet sayıları; ANCOM-BC2 tablosunda W, p ve düzeltilmiş p. Yeniden kurulmayanlar: dağılımın ampirik Bayes kestirimi, apeglm küçültmesi, edgeR'ın F istatistiği, voom ağırlıkları ve ılımlı t, ALDEx2'nin Monte Carlo örneklemesi ve ANCOM-BC2'nin yanlılık kestirimi. Bunlar için dayanak, şablonun DESeq2 belgesinde yayımlanmış değerleri aynen üretmesidir (aşağıda).
Adım 1 — Ön süzme. En az 3 örnekte sayımı en az 10 olan gen sayısı: 8148 (6451 gen atılır).
Adım 2 — Boyut katsayıları. 8148 genin 8122'si bütün örneklerde pozitiftir. Bir gen için hesap (FBgn0000008): sayımlar 140, 88, 70, 92, 161, 76, 70; geometrik ortalama 94,631; oranlar 1,479; 0,930; 0,740; 0,972; 1,701; 0,803; 0,740. 8122 genin oranlarının örnek bazında ortancası:
| treated1 | treated2 | treated3 | untreated1 | untreated2 | untreated3 | untreated4 | |
|---|---|---|---|---|---|---|---|
| s_j | 1,6297 | 0,7612 | 0,8303 | 1,1439 | 1,7913 | 0,6460 | 0,7507 |
Adım 3 — Bir gen: FBgn0039155. Sayımlar 70, 38, 52 (susturulmuş) ve 1527, 2220, 741, 931 (kontrol). Normalleştirilmiş değerler 42{,}95;\ 49{,}92;\ 62{,}63 ve 1334{,}90;\ 1239{,}34;\ 1147{,}07;\ 1240{,}13; baseMean =730{,}9917. Şablonun raporladığı dağılım \alpha=0{,}0115004.
Adım 4 — Negatif binom modeli. Enbüyük olabilirlik kestirimleri \hat q_U=1241{,}362, \hat q_T=50{,}589:
Uydurulmuş ortalamalar \hat\mu=s_j\hat q: 82,45; 38,51; 42,00 ve 1420,00; 2223,63; 801,91; 931,92. Ağırlıklar w_j=\hat\mu_j/(1+\alpha\hat\mu_j): 42,320; 26,688; 28,323 (toplam 97,331) ve 81,936; 83,681; 78,447; 79,533 (toplam 323,598).
p=1{,}14\times10^{-168}. Kontrol örneklerinde ağırlıklar 1/\alpha=86{,}95 sınırına yakındır: binlerce okuma olsa da her kontrol örneği yaklaşık 80 "etkin sayım" kadar bilgi taşır.
Adım 5 — Sınırdaki bir gen: FBgn0000017. baseMean =4359{,}096; \hat\beta=-0{,}2384250, \widehat{\text{SH}}=0{,}1270938, z=-1{,}875977, p=0{,}0606584; OO testi G^2=3{,}488487, p=0{,}0617970.
Adım 6 — Düzeltmeler (çalıştırma 2; 4555 gen). FBgn0000017'nin Wald p'si 0{,}0853696'dır; BH ile padj =0{,}3165002. p değerlerinden \hat\pi_0=0{,}7505034 kestirilir; q=0{,}7505034\cdot0{,}3165002=0{,}2375345. padj <0{,}05 olan gen sayısı 617'dir (314 artan, 303 azalan); edgeR'da 415, voom'da 415; üçünde ortak 405.
Adım 7 — ANCOM-BC2 (çalıştırma 4), T003. lfc =1{,}709761, SH =0{,}383959; W=4{,}452980. Takson 12 örneğin 10'unda sıfırdan farklıdır; sd =10-2=8; p=2\,P(t_8>4{,}453)=0{,}0021308. 148 taksonun p'leri üzerinde Holm ile q=0{,}3004487; BH seçildiğinde (çalıştırma 5) q=0{,}0394206.
Yayımlanmış değerlerle karşılaştırma. DESeq2 belgesi (Love ve ark., 2014; pasilla verisi) örnek ayarla aynı çözümlemeyi yapar. Şablonun örnek çalıştırması belgedeki değerleri basılı basamakların hepsinde verir: ön süzmeden sonra 8148 gen; padj <0{,}1 olan 1069 gen (533 artan, 536 azalan); FBgn0000017 için \log_2 kat değişimi -0{,}23842494, SH 0{,}127094, p=0{,}0606585, padj =0{,}289604; apeglm küçültmesiyle -0{,}18810628 (SH 0{,}120870).
88.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1, 2, 4 ve 5). Python ve R sütunlarında —, o büyüklüğün o dilde bağımsız olarak kurulmadığını gösterir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Ön süzmeden sonra gen sayısı | 8148 | 8148 | 8148 | 0 | ✓ |
| Boyut katsayısı, treated1 | 1,6297067 | 1,6297067 | 1,6297067 | 2,7e−15 | ✓ |
| Boyut katsayısı, treated2 | 0,76116225 | 0,76116225 | 0,76116225 | 4,4e−16 | ✓ |
| Boyut katsayısı, treated3 | 0,83031192 | 0,83031192 | 0,83031192 | 3,3e−16 | ✓ |
| Boyut katsayısı, untreated1 | 1,14390406 | 1,14390406 | 1,14390406 | 1,2e−15 | ✓ |
| Boyut katsayısı, untreated2 | 1,79128106 | 1,79128106 | 1,79128106 | 6,2e−16 | ✓ |
| Boyut katsayısı, untreated3 | 0,64599398 | 0,64599398 | 0,64599398 | 2,2e−16 | ✓ |
| Boyut katsayısı, untreated4 | 0,75072752 | 0,75072752 | 0,75072752 | 3,3e−16 | ✓ |
| Süzülmüş kütüphane büyüklüğü, treated1 | 18655919 | 18655919 | — | 0 | ✓ |
| Süzülmüş kütüphane büyüklüğü, untreated1 | 13965257 | 13965257 | — | 0 | ✓ |
| FBgn0039155: baseMean | 730,99168215 | 730,99168215 | 730,99168215 | 7,8e−16 | ✓ |
| FBgn0039155: \log_2KD | −4,61694955 | −4,61694978 | −4,61694978 | 5,1e−8 | ✓ |
| FBgn0039155: SH | 0,16678266 | 0,16678267 | 0,16678267 | 8,6e−9 | ✓ |
| FBgn0039155: Wald z | −27,68243096 | −27,68243095 | −27,68243097 | 4,8e−10 | ✓ |
| FBgn0039155: p | 1,136455·10−168 | 1,136455·10−168 | 1,136455·10−168 | 4,2e−175 | ✓ |
| FBgn0039155: OO testi p | 9,835562·10−168 | 9,835572·10−168 | 9,835572·10−168 | 9,6e−174 | ✓ |
| FBgn0025111: baseMean | 1504,272114 | 1504,272114 | 1504,272114 | 1,1e−15 | ✓ |
| FBgn0025111: \log_2KD | 2,90204826 | 2,90204828 | 2,90204828 | 9,3e−9 | ✓ |
| FBgn0025111: SH | 0,12619889 | 0,1261989 | 0,1261989 | 2,5e−9 | ✓ |
| FBgn0025111: Wald z | 22,99582975 | 22,99582951 | 22,9958295 | 1,1e−8 | ✓ |
| FBgn0025111: p | 5,131389·10−117 | 5,131418·10−117 | 5,131419·10−117 | 2,9e−122 | ✓ |
| FBgn0025111: OO testi p | 1,086391·10−112 | 1,086590·10−112 | 1,086590·10−112 | 2,0e−116 | ✓ |
| FBgn0000017: baseMean | 4359,09632222 | 4359,09632222 | 4359,09632222 | 4,2e−16 | ✓ |
| FBgn0000017: \log_2KD | −0,23842494 | −0,23842502 | −0,23842502 | 7,9e−8 | ✓ |
| FBgn0000017: SH | 0,12709378 | 0,12709378 | 0,12709378 | 2,4e−9 | ✓ |
| FBgn0000017: Wald z | −1,87597642 | −1,875977 | −1,875977 | 3,1e−7 | ✓ |
| FBgn0000017: p | 0,06065852 | 0,06065844 | 0,06065844 | 8,1e−8 | ✓ |
| FBgn0000017: OO testi p | 0,06179588 | 0,06179704 | 0,06179704 | 1,2e−6 | ✗ |
| Sayım ≥ 400 süzgeci — gen sayısı | 4555 | 4555 | 4555 | 0 | ✓ |
| Sayım ≥ 400 süzgeci — FBgn0039155: \log_2KD | −4,58977441 | −4,58977461 | −4,58977461 | 4,4e−8 | ✓ |
| Sayım ≥ 400 süzgeci — FBgn0039155: SH | 0,16356571 | 0,16356571 | 0,16356571 | 7,7e−9 | ✓ |
| Sayım ≥ 400 süzgeci — FBgn0039155: Wald z | −28,06073792 | −28,06073784 | −28,06073786 | 2,6e−9 | ✓ |
| Sayım ≥ 400 süzgeci — FBgn0000017: \log_2KD | −0,21370579 | −0,21370587 | −0,21370587 | 7,7e−8 | ✓ |
| Sayım ≥ 400 süzgeci — FBgn0000017: SH | 0,12422259 | 0,12422259 | 0,12422259 | 2,2e−9 | ✓ |
| Sayım ≥ 400 süzgeci — FBgn0000017: Wald z | −1,72034566 | −1,72034625 | −1,72034625 | 3,4e−7 | ✓ |
| Sayım ≥ 400 süzgeci — FBgn0000017: DESeq2 padj (BH) | 0,31650021 | 0,31650021 | 0,31650021 | 1,7e−16 | ✓ |
| Sayım ≥ 400 süzgeci — 4555 gen toplamı: DESeq2 padj (BH) | 2639,20216899 | 2639,20216899 | 2639,20216899 | 1,2e−15 | ✓ |
| Sayım ≥ 400 süzgeci — FBgn0000017: edgeR YKO (BH) | 0,345975 | 0,345975 | 0,345975 | 1,1e−15 | ✓ |
| Sayım ≥ 400 süzgeci — 4555 gen toplamı: edgeR YKO (BH) | 2526,75176962 | 2526,75176962 | 2526,75176962 | 1,3e−15 | ✓ |
| Sayım ≥ 400 süzgeci — FBgn0000017: voom YKO (BH) | 0,37867397 | 0,37867397 | 0,37867397 | 1,0e−15 | ✓ |
| Sayım ≥ 400 süzgeci — 4555 gen toplamı: voom YKO (BH) | 2512,57498093 | 2512,57498093 | 2512,57498093 | 1,3e−15 | ✓ |
| Sayım ≥ 400 süzgeci — FBgn0000017: OO testi padj (BH) | 0,32010313 | 0,32010313 | 0,32010313 | 3,3e−16 | ✓ |
| Sayım ≥ 400 süzgeci — 4555 gen toplamı: OO testi padj (BH) | 2634,28792414 | 2634,28792414 | 2634,28792414 | 1,6e−15 | ✓ |
| Sayım ≥ 400 süzgeci — FBgn0000017: Storey q | 0,23753448 | — | 0,23753448 | 0 | ✓ |
| Sayım ≥ 400 süzgeci — 4555 gen toplamı: Storey q | 1980,73016315 | — | 1980,73016315 | 2,9e−15 | ✓ |
| Sayım ≥ 400 süzgeci — \hat\pi_0 (q/padj oranı) | 0,75050339 | — | 0,75050339 | 2,2e−16 | ✓ |
| Sayım ≥ 400 süzgeci — DESeq2 Wald: YKO < 0,05 anlamlı gen sayısı | 617 | 617 | — | 0 | ✓ |
| Sayım ≥ 400 süzgeci — DESeq2 Wald: YKO < 0,05 artan gen sayısı | 314 | 314 | — | 0 | ✓ |
| Sayım ≥ 400 süzgeci — DESeq2 Wald: YKO < 0,05 azalan gen sayısı | 303 | 303 | — | 0 | ✓ |
| Sayım ≥ 400 süzgeci — edgeR QL F: YKO < 0,05 anlamlı gen sayısı | 415 | 415 | — | 0 | ✓ |
| Sayım ≥ 400 süzgeci — edgeR QL F: YKO < 0,05 artan gen sayısı | 224 | 224 | — | 0 | ✓ |
| Sayım ≥ 400 süzgeci — edgeR QL F: YKO < 0,05 azalan gen sayısı | 191 | 191 | — | 0 | ✓ |
| Sayım ≥ 400 süzgeci — limma-voom: YKO < 0,05 anlamlı gen sayısı | 415 | 415 | — | 0 | ✓ |
| Sayım ≥ 400 süzgeci — limma-voom: YKO < 0,05 artan gen sayısı | 227 | 227 | — | 0 | ✓ |
| Sayım ≥ 400 süzgeci — limma-voom: YKO < 0,05 azalan gen sayısı | 188 | 188 | — | 0 | ✓ |
| Sayım ≥ 400 süzgeci — üç yöntemde ortak anlamlı gen sayısı | 405 | 405 | — | 0 | ✓ |
| ANCOM-BC2, T001: W | 6,66723124 | 6,66723124 | 6,66723124 | 1,5e−15 | ✓ |
| ANCOM-BC2, T001: p | 5,587902·10−5 | 5,587902·10−5 | 5,587902·10−5 | 3,0e−19 | ✓ |
| ANCOM-BC2, T001: q (Holm) | 0,0082701 | 0,0082701 | 0,0082701 | 9,0e−17 | ✓ |
| ANCOM-BC2, T002: W | −2,96217717 | −2,96217717 | −2,96217717 | 3,4e−15 | ✓ |
| ANCOM-BC2, T002: p | 0,01590318 | 0,01590318 | 0,01590318 | 2,0e−16 | ✓ |
| ANCOM-BC2, T002: q (Holm) | 1 | 1 | 1 | 0 | ✓ |
| ANCOM-BC2, T003: W | 4,45298035 | 4,45298035 | 4,45298035 | 4,0e−16 | ✓ |
| ANCOM-BC2, T003: p | 0,00213084 | 0,00213084 | 0,00213084 | 3,0e−17 | ✓ |
| ANCOM-BC2, T003: q (Holm) | 0,30044874 | 0,30044874 | 0,30044874 | 1,0e−15 | ✓ |
| ANCOM-BC2, 148 takson toplamı: q (Holm) | 140,19693147 | 140,19693147 | 140,19693147 | 0 | ✓ |
| ANCOM-BC2, T001: q (BH) | 0,0082701 | 0,0082701 | 0,0082701 | 9,0e−17 | ✓ |
| ANCOM-BC2, T002: q (BH) | 0,21397004 | 0,21397004 | 0,21397004 | 2,2e−15 | ✓ |
| ANCOM-BC2, T003: q (BH) | 0,03942058 | 0,03942058 | 0,03942058 | 1,2e−16 | ✓ |
| ANCOM-BC2, 148 takson toplamı: q (BH) | 121,29183373 | 121,29183373 | 121,29183373 | 2,9e−15 | ✓ |
Ölçütü karşılayan: 69/70. Python: boyut katsayıları açık formülle; gen düzeyindeki değerler, dağılım şablonun raporladığı değere sabitlenerek kendi IRLS döngüsüyle kurulan negatif binom modelinden; düzeltmeler elle. R: glm ve MASS paketinin negative.binomial ailesi, Storey q-değeri açık kodla (smooth.spline), ANCOM-BC2 satırlarında pt ve p.adjust. DESeq2, edgeR, limma, qvalue ve ANCOMBC paketleri bağımsız hesaplarda çağrılmamıştır. Kapsam dışında kalanlar 88.6'da sayılmıştır.
Ölçütü aşan tek satır FBgn0000017'nin OO testi p'sidir (fark 1{,}2\times10^{-6}): iki bağımsız hesap birbiriyle on iki basamakta aynıdır, DESeq2'nin değeri yinelemeli uydurmasının durma ölçütü kadar ayrılır. Gen ve örnek sırası değiştirildiğinde (çalıştırma 3) DESeq2 sütunları da aynı büyüklükte (10^{-6}) oynar; edgeR ve voom sütunları 10^{-8} içinde aynı kalır.
88.7 Çıktıyı okuma
Örnek ayarın konsol metni:
14599 özellik × 7 örnek; gruplar: treated (n = 3), untreated (n = 4) (referans: untreated)
Ön süzme: en az 3 örnekte sayım ≥ 10 olan 8148 gen tutuldu (6451 gen çıkarıldı).
Not: aşağıdaki tablo en küçük p'li 5000 geni gösterir (toplam 8148 satır); belirli genler için 'İzlenen genler' parametresini kullanın.
Not: log2 kat değişimi küçültmesi 'apeglm' yöntemiyle yapıldı (log2FC_kucultulmus; testler ve padj küçültülmemiş MLE'ye dayanır).
Özet tablosu ve sonuç tablosundan iki gen (kısaltılmış):
Özet: YKO < 0.1 olan gen sayıları (üç yöntemde ortak: 908)
karsilastirma        yontem       test_edilen  anlamli  artan  azalan
treated - untreated  DESeq2 Wald         8148     1069    533     536
treated - untreated  edgeR QL F          8148      975    504     471
treated - untreated  limma-voom          8148      966    508     458

ozellik      baseMean   log2FC   lfcSE     stat          p       padj          q  log2FC_kucultulmus  dispersiyon
FBgn0039155    730.99  -4.6169  0.1668  -27.682  1.14e-168  9.26e-165  7.34e-165             -4.6047       0.0115
FBgn0000017   4359.10  -0.2384  0.1271   -1.876  6.066e-02  2.896e-01  2.295e-01             -0.1881       0.0131

ozellik      edgeR_logFC  edgeR_F    edgeR_p  edgeR_FDR  voom_logFC   voom_t     voom_p   voom_FDR      p_LRT   padj_LRT
FBgn0039155      -4.6069  1024.87  3.230e-11  2.632e-07     -4.6235  -27.830  1.625e-10  1.014e-06  9.84e-168  8.01e-164
FBgn0000017      -0.2339     3.89  7.767e-02  3.077e-01     -0.2217   -1.857  9.419e-02  3.426e-01  6.180e-02  2.928e-01
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İlk satır | Özellik ve örnek sayısı, grup büyüklükleri, referans grup | Yön "grup − referans"tır; her çalıştırmada denetlenir. |
| Ön süzme satırı | Tutulan ve atılan gen sayısı | Çoklu test yükü tutulan gen sayısıdır. |
| "DESeq2 boyut katsayıları" | Örnek başına s_j ve süzülmüş kütüphane büyüklüğü | Katsayılar 0,5–2 dışına taşıyorsa ya da kütüphane büyüklüğüyle orantısızsa örnek sorgulanır. |
baseMean |
Normalleştirilmiş sayımların bütün örneklerdeki ortalaması | İfade düzeyi; grup ortalaması değildir. |
log2FC, lfcSE |
Küçültülmemiş \log_2 kat değişimi ve standart hatası | -1 yarıya inme, +1 iki katına çıkma. |
stat, p, padj |
Wald z'si, p'si, bağımsız süzmeden sonra BH | padj boşsa gen süzülmüş ya da Cook denetimine takılmıştır. |
q |
Storey q-değeri | padj'dan \hat\pi_0 oranında küçüktür. |
log2FC_kucultulmus |
Küçültülmüş kat değişimi | Sıralama ve görselleştirme için; düşük sayımlı genlerde ham değerden belirgin küçüktür. |
dispersiyon |
Son dağılım kestirimi | Karekökü biyolojik değişim katsayısıdır. |
edgeR_*, voom_* |
Öteki iki yöntemin kat değişimi, istatistiği, p'si ve BH'si | Üç yöntemin p'leri aynı ölçekte değildir: Wald z'si serbestlik derecesi belirsizliğini içermez, F ve ılımlı t içerir. |
p_LRT, padj_LRT |
DESeq2 OO testi (iki grupta) | Wald ile yakın olmalıdır. |
| "DESeq2 LRT" tablosu | İkiden çok grupta genel test | "Herhangi iki grup farklı mı?" sorusu. |
| "İzlenen genler" | Verilen kimliklerin satırları | 5000 satır sınırının dışında kalan genlere ulaşmanın yolu. |
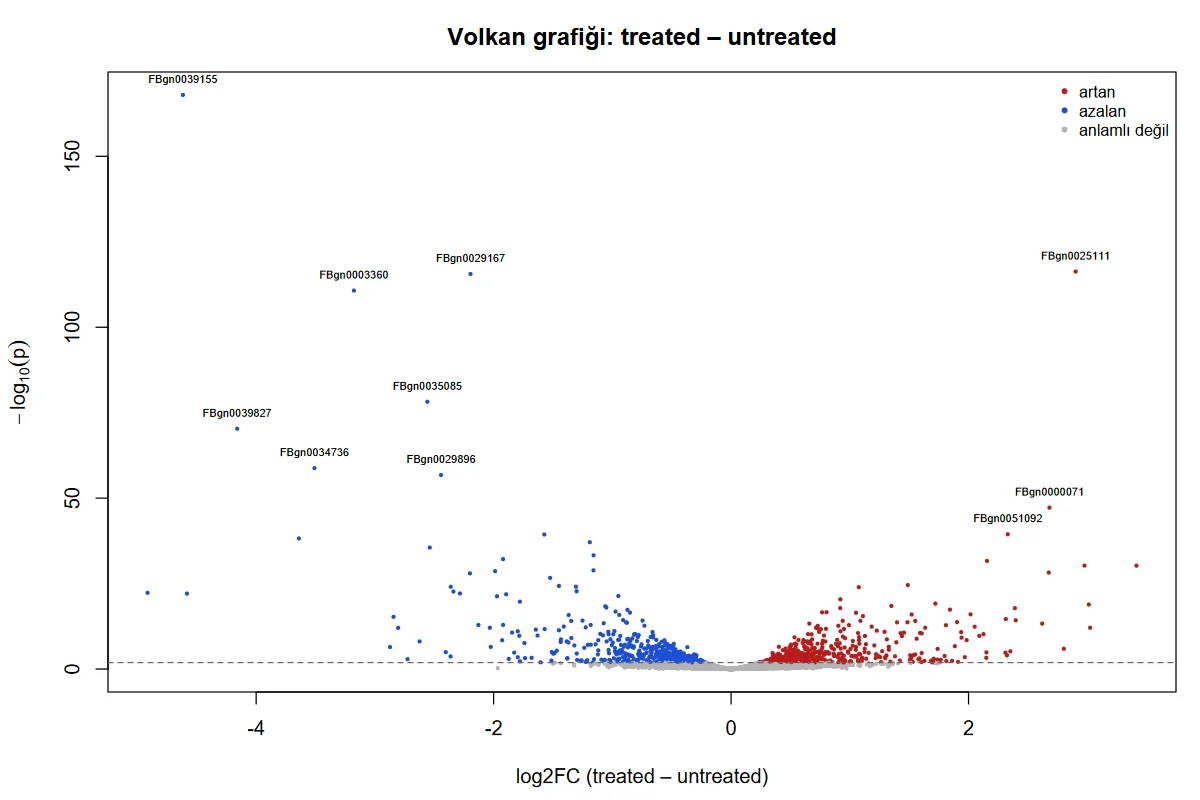
FBgn0039155'te üç yöntemin kat değişimleri aynıdır (-4{,}61, -4{,}61, -4{,}62), p değerleri ise 157 basamak ayrıdır: DESeq2 dağılımı bilinen sayıp normal dağılım kullanır; edgeR ve voom dağılımın az sayıda tekrarla kestirildiğini hesaba katar ve yedi örnekle ulaşılabilecek en küçük p'yi sınırlar. Sıralama ve padj eşiğindeki kararlar etkilenmez; çok küçük p'lerin mutlak büyüklüğü yorumlanmaz.
Şekil 88.1. Şablonun çizdiği volkan grafiği (örnek veri). Yatay eksen küçültülmemiş \log_2 kat değişimi, dikey eksen -\log_{10}p; kırmızı artan, mavi azalan genler (padj < 0,1); kesikli çizgi anlamlı sayılan en büyük p'nin düzeyidir. En küçük p'li on gen adlarıyla işaretlenir.
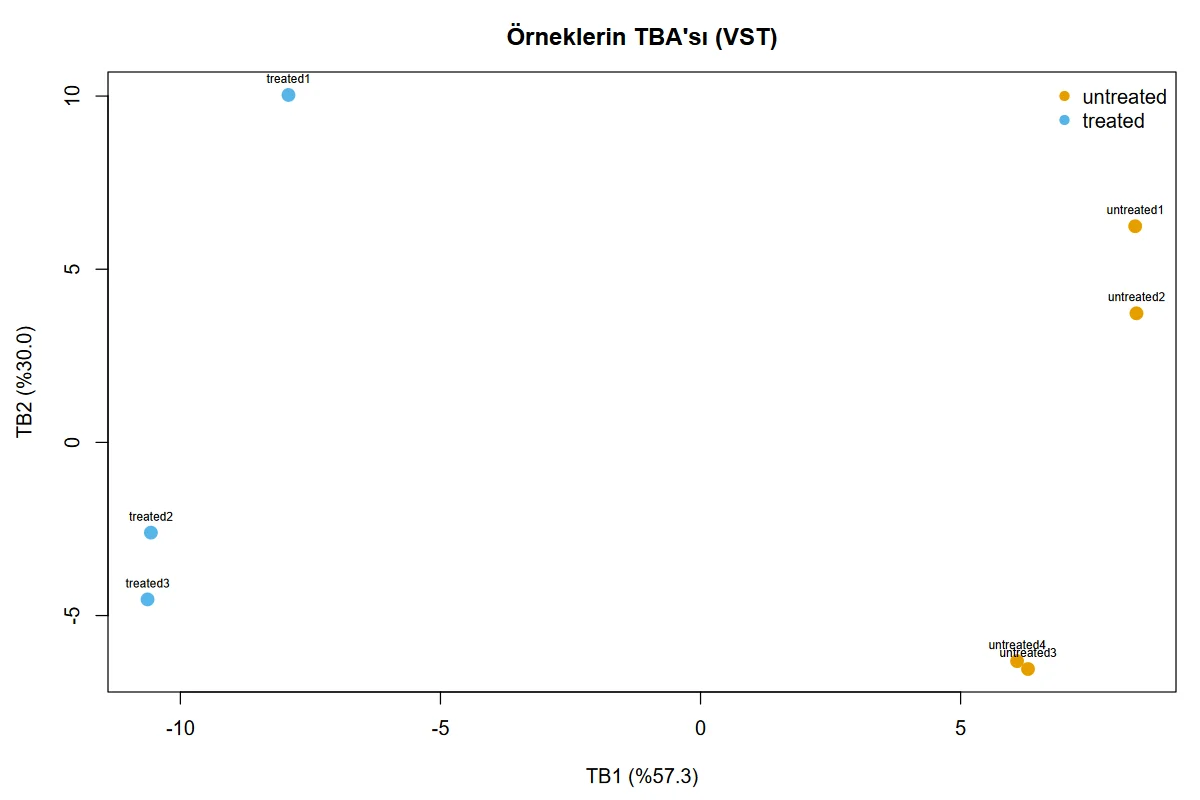
Şekil 88.2. Örneklerin temel bileşenler grafiği (varyans dengeleyici dönüşüm, en değişken 500 gen). Birinci bileşen (varyansın %57,3'ü) iki grubu ayırır; ikinci bileşen (%30,0) kütüphane türünü (tek uçlu ve çift uçlu okuma) ayırır: bu, ek faktörle düzeltilebilecek bir parti etkisidir.
Mikrobiyom çıktısı (çalıştırma 4; kısaltılmış):
150 özellik × 12 örnek; gruplar: H (n = 6), K (n = 6) (referans: K)
Not: bütün örneklerde 0 olan 1 takson çıkarıldı.

ALDEx2 (CLR, 128 Monte Carlo örneği; Welch t ve Wilcoxon beklenen p, BH; etki büyüklüğü)
takson  rab.all  rab.win.H  rab.win.K  diff.btw  diff.win   effect  overlap   we.ep  we.eBH   wi.ep  wi.eBH
T007     1.1833     0.0565     2.6668   -2.6812    1.0332  -2.6191   0.0002  0.0002  0.0223  0.0023  0.0503
T001     0.9493     1.9784    -0.7196    2.6998    0.7780   3.4476   0.0002  0.0004  0.0264  0.0022  0.0501

ANCOM-BC2 (yanlılık düzeltmeli log kat değişimi, SH, W, p, Holm q; doğal logaritma)
taxon  lfc_grupH  se_grupH  W_grupH  p_grupH  q_grupH  diff_grupH
T001      1.8825    0.2824   6.6672  0.00006  0.00827        True
T007     -1.8979    0.3456  -5.4909  0.00027  0.03871        True

Özet: YKO < 0,1 olan takson sayısı (ANCOM-BC2: her karşıtlık ayrı satır)
yontem                    test_edilen  anlamli
ALDEx2 Welch t (BH)               149        5
ALDEx2 Wilcoxon (BH)              149        9
ANCOM-BC2 (Holm; H – K)           148        5
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
rab.all, rab.win.<grup> |
Ortanca clr bolluğu: bütün örneklerde ve grup içinde | Yön buradan okunur: T001 H grubunda (1,98), T007 K grubunda (2,67) boldur. |
diff.btw, diff.win, effect |
Gruplar arası fark, grup içi yayılım, oranları (\log_2 ölçeği) | \lvert\text{effect}\rvert>1: fark grup içi yayılımı aşıyor. İşaret "karşıt − referans" yönündedir (burada H − K). |
overlap |
İki grubun clr dağılımlarının örtüşme oranı | 0'a yakın: gruplar ayrışmış. |
we.ep, we.eBH |
Welch t: beklenen p ve beklenen BH | Karar ölçütü we.eBH. |
wi.ep, wi.eBH |
Wilcoxon: beklenen p ve beklenen BH | Küçük gruplarda kesikli; altışar örnekte en küçük değer 0,0022'dir (88.8). |
lfc_grup<k>, se_, W_, p_, q_ |
ANCOM-BC2: doğal log kat değişimi (k − referans), SH, istatistik, p, düzeltilmiş p | T001: e^{1{,}88}=6{,}6 kat (H grubunda). |
diff_grup<k> |
q< fdr ise doğru |
|
| Özet | Üç ölçütle anlamlı takson sayısı | Benzetimde gerçek fark ilk 12 taksondadır. Welch ölçütü ve ANCOM-BC2 bunların beşini, Wilcoxon ölçütü sekizini yakalar; Wilcoxon ölçütündeki dokuz taksondan biri (T108) gerçekte farksızdır. Altışar örnekle güç sınırlıdır. |
Rapor cümlesi (örnek ayar, RNA-seq):
Ham okuma sayımları DESeq2 ile çözümlendi (ortanca oran normalleştirmesi; negatif binom modeli, Wald testi; yanlış keşif oranı Benjamini–Hochberg yöntemiyle %10 düzeyinde denetlendi). En az üç örnekte en az 10 okuması olan 8148 gen sınandı; pasilla susturulmasıyla 1069 genin ifadesi değişti (533 artan, 536 azalan). Bunların 908'i edgeR (yarı olabilirlik F testi) ve limma-voom çözümlemelerinde de anlamlıydı. En güçlü değişim FBgn0039155'te görüldü (\log_2 kat değişimi = -4{,}62, SH = 0{,}17; düzeltilmiş p < 0{,}001).
88.8 Sık hatalar ve tuzaklar
- Referans grubu boş bırakmak. Referans, ad sırasındaki ilk gruptur; kontrol grubu olmak zorunda değildir.
treated/untreated,hasta/kontrol,ilac/plaseboadlarında ilk sıradaki grup deney grubudur ve bütün kat değişimlerinin işareti tersine döner. Şablon hangi grubun referans alındığını ayrı bir notla yazar; referans adı yine de elle yazılır. - Grup adını rakamla başlatmak.
0h,24h,10mggibi adlarda DESeq2'nin katsayı adı grup adını olduğu gibi taşır (grup_10mg_vs_0mg); şablon adıresultsNamesiçinden bulur ve apeglm uygulanır (örnekte10mgve0mgadlarıyla vedz10/dz0adlarıyla aynı -4{,}58). Ad hiçbir adayla eşleşmezse küçültmenormalyöntemle yapılır ve konsol notu bunu söyler. - ALDEx2'de yönü yanlış okumak.
diff.btwveeffect"karşıt − referans" yönündedir ve referans grubu değiştirince işaret tersine döner (örnekte referans K iken T001 içindiff.btwpozitiftir, ANCOM-BC2'ninlfc_grupHdeğeriyle aynı işaretlidir; referans H iken negatiftir). Her iki sütundaki işaretrab.winfarkıyla da denetlenebilir. - Normalleştirilmiş veri girmek. TPM, FPKM, oran ya da yuvarlanmış normalleştirilmiş sayımlar yöntemlerin ortalama–varyans modelini bozar. Şablon tam sayı olmayan veriyi reddeder; yuvarlanmış normalleştirilmiş değerleri ayırt edemez.
- Teknik tekrarları biyolojik tekrar saymak. Aynı kütüphanenin iki şeridi ya da aynı RNA'nın iki kütüphanesi ayrı sütun olarak girilirse dağılım küçük kestirilir ve yanlış pozitifler çoğalır. Teknik tekrarların sayımları önce toplanır.
- Parti etkisini modele koymamak. Temel bileşenler grafiğinde örnekler grup dışı bir etkene göre kümeleniyorsa (örnekte kütüphane türü) o etken ek faktör olarak verilir. Ek faktör grupla tam çakışıyorsa (bütün kontroller bir partide) düzeltme olanaksızdır ve şablon durur.
- Sonuç tablosunun 5000 satırda kesildiğini gözden kaçırmak. "Bütün test edilen genler" tablosu en küçük p'li 5000 satırı gösterir; iki ve daha çok karşıtlıkta satırlar karşıtlıklar arasında paylaşılır (güçlü bir karşıtlığın satırları tabloyu doldurabilir). "Karşıtlık başına ayrıntı tablosu" seçeneği açılırsa ana tablo ve öteki tablolar aynı kalır, ardından her karşıtlık için kendi p sıralamasıyla ayrı bir tablo eklenir (her biri en çok 5000 satır; çıktıda en çok 12 tablo gösterilebildiğinden sayı sınırlıdır); tek karşıtlık varsa tablo ana tabloyla aynı olacağından yazılmaz ve bu bir notla söylenir (441–443). Bu tablolarda sona
q_padj_kumesisütunu eklenir: q (Storey), yalnız bağımsız süzmeden geçen (padj'ı boş olmayan) genler üzerinden yeniden hesaplanır, yani padj ile aynı gen kümesindedir; ana tablodakiqbütün p'si olan genler üzerindendir (444–447). Üç gruplu benzetilmiş bir veride (240 gen; B ve C, A'ya karşı) her ayrıntı tablosu ana tablonun o karşıtlığa ait satırlarıdır (aynı değerler, kendi p sırasıyla);q_padj_kumesi, aynı p'ler üzerinde ayrı bir R betiğindeqvalue::qvalueile bağımsız hesaplanan değerle aynıdır. Özet sayıları bütün genlerden hesaplanır. Belirli genler "İzlenen genler" alanıyla alınır; tam liste gerekiyorsa ön süzme sıkılaştırılır ya da karşıtlıklar ayrı çalıştırılır. padjboş olan geni "anlamsız" saymak. Boşluk iki nedenden olur: bağımsız süzme (düşük ifade) ya da Cook uzaklığı (tek örnekte uç sayım). İkincisinde gen ilginç olabilir; ham sayımlarına bakılır.- Kat değişimi eşiğini p'den sonra uygulamak. "
padj< 0,05 ve \lvert\log_2\text{KD}\rvert>1" süzgeci yanlış keşif oranını artık denetlemez. Küçültülmüş kat değişimi sıralama içindir. - Mikrobiyomda Wilcoxon sütununa güvenmek. Küçük gruplarda ulaşılabilecek en küçük p sınırlıdır (altışar örnekte 0,0022); şablon bu alt sınırın altına inen değer üretmez (tümüyle ayrışan taksonlarda
wi.ep\ge0{,}0022). Küçük gruplarda sütun kesiklidir; karar içinwe.eBHveeffectbirlikte kullanılır. - Mikrobiyomda tek yönteme dayanmak. Diferansiyel bolluk yöntemleri aynı veride belirgin farklı sonuç verir (Nearing ve ark., 2022). Şablon iki yöntemi yan yana verir; ikisinde de anlamlı taksonlar daha güvenilirdir.
- Tekrar sayısını az tutmak. Üçer tekrarla yalnız büyük farklar yakalanır; gerçek farkların çoğunu yakalamak için grup başına altı ve üzeri önerilir (Schurch ve ark., 2016).
88.9 Uzman soruları
S1. Dağılım neden gen gen kestirilmiyor da eğriye doğru küçültülüyor; bu yanlılık yaratmaz mı?
Yaratır, bilerek. Üç–dört tekrarla gen bazlı kestirimin örnekleme varyansı çok büyüktür; küçültme varyansı büyük ölçüde azaltır, karşılığında tek tek genlerde küçük bir yanlılık getirir. Toplam hata azalır ve yanlış pozitif oranı denetim altına girer. Yanlılığın en riskli olduğu yer, dağılımı gerçekten yüksek genlerdir: bunları eğriye çekmek yanlış pozitif üretir. DESeq2 bu yüzden eğrinin iki artık standart sapmasından fazla üstünde kalan genleri küçültmez (Love ve ark., 2014). Küçültmenin gücü tekrar sayısı arttıkça kendiliğinden azalır.
S2. DESeq2'nin p değerleri edgeR ve voom'dan neden çok daha küçük?
Wald testi dağılım kestirimini bilinen sabit sayar ve z'yi normal dağılıma göre değerlendirir. edgeR'ın yarı olabilirlik F testi ve limma'nın ılımlı t'si varyans kestiriminin belirsizliğini payda serbestlik derecesiyle taşır; yedi örnekle bu derece küçüktür ve kuyruk olasılıkları normal dağılıma göre çok ağırdır. FBgn0039155'te z=-27{,}7 için p=10^{-168}, F=1025 için p=10^{-11}'dir. Orta büyüklükteki etkilerde fark küçülür (FBgn0000017: 0,061; 0,078; 0,094). Az tekrarlı tasarımlarda edgeR ve voom yanlış keşif oranını daha iyi tutar; DESeq2'nin fazladan bulduğu 100 kadar gen bu farkın ürünüdür.
S3. Bağımsız süzme veriye bakarak gen atıyor; bu p değerlerini geçersiz kılmaz mı?
Süzgeç istatistiği (ortalama normalleştirilmiş sayım) sıfır hipotezi altında test istatistiğinden bağımsızsa kılmaz: grup etiketlerini kullanmaz, yalnız genin genel düzeyine bakar. Bourgon ve ark. (2010) bu koşulda süzmeden sonra BH'nin yanlış keşif oranını koruduğunu gösterdi. Eşiğin ret sayısını enbüyükleyecek biçimde seçilmesi ek bir uyarlamadır; uygulamada denetimi bozmadığı benzetimlerle gösterilmiştir. Kuşku duyulursa onay kutusu kapatılır; padj o zaman bütün genler üzerinden klasik BH'dir.
S4. Küçültülmüş kat değişimi varken neden testler küçültülmemiş değerden yapılıyor?
İkisi farklı soruya yanıt verir. Test "fark sıfırdan farklı mı" diye sorar ve enbüyük olabilirlik kestirimiyle onun standart hatasına dayanır; önsel katmak testin frekansçı düzeyini değiştirir. Küçültme "farkın büyüklüğü için en iyi tahmin ne" diye sorar ve genleri sıralamak, görselleştirmek, etki büyüklüğü raporlamak içindir. apeglm ile sonsal olasılığa dayalı çıkarım (belirli bir eşiği aşma olasılığı) da yapılabilir; şablon yalnız nokta kestirimini ve sonsal standart sapmayı verir.
S5. Mikrobiyom verisinde neden DESeq2 ya da edgeR kullanılmıyor?
İki sorun vardır. (1) Bileşimsellik: dizileme derinliği örnekteki toplam mikrobiyal yükle ilgisizdir; yalnız göreli paylar gözlenir. Bir taksonun büyük artışı, öteki bütün taksonların payını düşürür ve onları "azalmış" gösterir. RNA-seq normalleştirmeleri "özelliklerin çoğu değişmez" varsayımıyla bunu giderir; birkaç baskın taksonun olduğu topluluklarda varsayım tutmaz. (2) Sıfır fazlalığı: taksonların çoğu örneklerin çoğunda yoktur. ALDEx2 log-oranlarla çalışarak, ANCOM-BC2 örnekleme oranını kestirerek birinci sorunu ele alır; ikisi de sıfırları farklı işler (Dirichlet önseli; yaygınlık süzgeci). Yine de hiçbiri "doğru" yöntem değildir (Nearing ve ark., 2022).
S6. clr dönüşümünün paydası sonucu nasıl etkiler?
clr, her taksonu örnekteki geometrik ortalamaya oranlar; bu ortalama "değişmeyen referans" rolündedir. Taksonların büyük bölümü bir yönde değişiyorsa referans da kayar ve değişmeyen taksonlar ters yönde değişmiş görünür. iqlr seçeneği paydayı yalnız varyansı orta çeyreklerde olan taksonlardan kurar (uç değişkenleri dışlar); zero seçeneği bir grupta hiç bulunmayan taksonları dışlar. Asimetrik değişim beklenen verilerde iqlr daha güvenlidir. ANCOM-BC2 aynı sorunu örnekleme oranı kestirimiyle çözer; iki yöntemin uyuşması referans seçimine duyarsızlığın işaretidir.
S7. ALDEx2'nin "beklenen" p değeri ne anlama gelir?
Her Monte Carlo örneği, sayımlardan çıkarılabilecek olası bir bileşimdir; her birinde test yapılır ve 128 p değerinin ortalaması raporlanır. Yüksek sayımlı taksonlarda örnekler birbirine çok benzer ve beklenen p tek bir testin p'sine yakındır; düşük sayımlı taksonlarda örnekler dağınıktır, p'ler 0 ile 1 arasında savrulur ve ortalama büyür. Böylece sayım belirsizliği anlamlılığı kendiliğinden düşürür. Beklenen BH de aynı biçimde her örnekte ayrı düzeltilip ortalanır; bu yüzden we.eBH, we.ep sütununa BH uygulanarak elde edilemez.
S8. Üç RNA-seq yönteminden hangisi raporlanmalı?
Çözümleme planında belirlenen. Alanda üçü de kabul görür; farklar çoğu veride küçüktür. Kaba bir kılavuz: çok az tekrar (2–3) ve değişken veride edgeR ya da voom daha tutucudur; tekrar sayısı arttıkça (6 ve üzeri) üçü yakınsar; çok sayıda örnekte (onlarca) voom hızlıdır ve dayanıklı seçeneklere sahiptir. Örnekte üç yöntem 1069, 975 ve 966 gen bulur, 908'i ortaktır: sonuç yöntem seçimine dayanıklıdır. Yalnız bir yöntemde anlamlı genler bağımsız doğrulama (qPCR) olmadan öne çıkarılmaz.
S9. Çok küçük p değerleri ve `padj` =0 nasıl raporlanır?
Çift duyarlıklı sayıların alt sınırı yaklaşık 10^{-308}'dir; daha küçük p'ler 0 olarak saklanır (çalıştırma 2'de en küçük p 3\times10^{-173}'tür, sıfıra inmemiştir). Bu büyüklükteki sayıların gerçek anlamı yoktur: model varsayımlarındaki en küçük sapma onlarca basamak oynatır (S2). Raporda "p<0{,}001" ya da "p<10^{-10}" yazılır; volkan grafiğinde şablon p'yi 10^{-300}'de keser.
88.10 Kaynaklar
- Anders, S., & Huber, W. (2010). Differential expression analysis for sequence count data. Genome Biology, 11(10), R106. https://doi.org/10.1186/gb-2010-11-10-r106
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B, 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Bourgon, R., Gentleman, R., & Huber, W. (2010). Independent filtering increases detection power for high-throughput experiments. Proceedings of the National Academy of Sciences, 107(21), 9546–9551. https://doi.org/10.1073/pnas.0914005107
- Brooks, A. N., Yang, L., Duff, M. O., Hansen, K. D., Park, J. W., Dudoit, S., Brenner, S. E., & Graveley, B. R. (2011). Conservation of an RNA regulatory map between Drosophila and mammals. Genome Research, 21(2), 193–202. https://doi.org/10.1101/gr.108662.110
- Chen, Y., Chen, L., Lun, A. T. L., Baldoni, P. L., & Smyth, G. K. (2025). edgeR v4: Powerful differential analysis of sequencing data with expanded functionality and improved support for small counts and larger datasets. Nucleic Acids Research, 53(2), gkaf018. https://doi.org/10.1093/nar/gkaf018
- Fernandes, A. D., Reid, J. N. S., Macklaim, J. M., McMurrough, T. A., Edgell, D. R., & Gloor, G. B. (2014). Unifying the analysis of high-throughput sequencing datasets: Characterizing RNA-seq, 16S rRNA gene sequencing and selective growth experiments by compositional data analysis. Microbiome, 2, 15. https://doi.org/10.1186/2049-2618-2-15
- Gloor, G. B., Macklaim, J. M., Pawlowsky-Glahn, V., & Egozcue, J. J. (2017). Microbiome datasets are compositional: And this is not optional. Frontiers in Microbiology, 8, 2224. https://doi.org/10.3389/fmicb.2017.02224
- Law, C. W., Chen, Y., Shi, W., & Smyth, G. K. (2014). voom: Precision weights unlock linear model analysis tools for RNA-seq read counts. Genome Biology, 15(2), R29. https://doi.org/10.1186/gb-2014-15-2-r29
- Lin, H., & Peddada, S. D. (2020). Analysis of compositions of microbiomes with bias correction. Nature Communications, 11, 3514. https://doi.org/10.1038/s41467-020-17041-7
- Lin, H., & Peddada, S. D. (2024). Multigroup analysis of compositions of microbiomes with covariate adjustments and repeated measures. Nature Methods, 21(1), 83–91. https://doi.org/10.1038/s41592-023-02092-7
- Love, M. I., Huber, W., & Anders, S. (2014). Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biology, 15(12), 550. https://doi.org/10.1186/s13059-014-0550-8
- Nearing, J. T., Douglas, G. M., Hayes, M. G., MacDonald, J., Desai, D. K., Allward, N., Jones, C. M. A., Wright, R. J., Dhanani, A. S., Comeau, A. M., & Langille, M. G. I. (2022). Microbiome differential abundance methods produce different results across 38 datasets. Nature Communications, 13, 342. https://doi.org/10.1038/s41467-022-28034-z
- Ritchie, M. E., Phipson, B., Wu, D., Hu, Y., Law, C. W., Shi, W., & Smyth, G. K. (2015). limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Research, 43(7), e47. https://doi.org/10.1093/nar/gkv007
- Robinson, M. D., & Oshlack, A. (2010). A scaling normalization method for differential expression analysis of RNA-seq data. Genome Biology, 11(3), R25. https://doi.org/10.1186/gb-2010-11-3-r25
- Schurch, N. J., Schofield, P., Gierliński, M., Cole, C., Sherstnev, A., Singh, V., Wrobel, N., Gharbi, K., Simpson, G. G., Owen-Hughes, T., Blaxter, M., & Barton, G. J. (2016). How many biological replicates are needed in an RNA-seq experiment and which differential expression tool should you use? RNA, 22(6), 839–851. https://doi.org/10.1261/rna.053959.115
- Stephens, M. (2017). False discovery rates: A new deal. Biostatistics, 18(2), 275–294. https://doi.org/10.1093/biostatistics/kxw041
- Storey, J. D., & Tibshirani, R. (2003). Statistical significance for genomewide studies. Proceedings of the National Academy of Sciences, 100(16), 9440–9445. https://doi.org/10.1073/pnas.1530509100
- Zhu, A., Ibrahim, J. G., & Love, M. I. (2019). Heavy-tailed prior distributions for sequence count data: Removing the noise and preserving large differences. Bioinformatics, 35(12), 2084–2092. https://doi.org/10.1093/bioinformatics/bty895