48. Genelleştirilmiş toplamsal karma model ve ileri düzgünleştiriciler (mgcv)
Şablon kimliği: gamm_mgcv · Kategori: duzgunlestirme · Dil: R · Dosya: pro/sablonlar/duzgunlestirme/gamm_mgcv.R (satır 1–251; üstbilgi 1–113) · Örnek veri: _ornek/sleepstudy.csv · Paketler: mgcv 1.9-4 (ilişkili kesişim + eğim yapısında nlme 3.1-168 üzerinden)
48.1 Ne işe yarar
Şablon, biçimi önceden bilinmeyen (doğrusal olmayabilen) etkileri düzgünleştiricilerle, kümelenmiş verinin yapısını rastgele etkilerle aynı modelde kestirir. Cevapladığı soru şudur: "Kümeler (denek, parsel, istasyon) arasındaki farklar hesaba katıldığında yanıt, sürekli bir açıklayıcıyla nasıl bir eğri boyunca değişiyor; kümeler bu eğriden ne kadar sapıyor?"
- g: bağlantı fonksiyonu; Gauss ailesinde özdeşlik, binomda lojit, Poisson'da logaritma.
- \mathbf x_i^{\top}\boldsymbol\beta: doğrusal (parametrik) terimler ve sabit.
- f_j: düzgün fonksiyonlar; her biri cezalı bir regresyon spline'ıdır (
s()), iki değişkenli yüzey için tensör çarpımı (te()). - \mathbf z_i^{\top}\mathbf b: rastgele etkiler (kesişim, eğim ya da gruba özgü eğri); \boldsymbol\psi kovaryans matrisleri.
Düzgün terim seçilmezse şablon rastgele kesişimli ve eğimli doğrusal karma modele iner; gruplama faktörü seçilmezse rastgele etkisiz toplamsal modeldir.
Ne zaman kullanılır? Aynı birimden yinelenen ölçümler ya da kümelenmiş gözlemler varsa ve en az bir sürekli açıklayıcının etkisinin doğrusal olduğu varsayılmak istenmiyorsa; mevsimsel (döngüsel) örüntü, iki sürekli değişkenin ortak yüzeyi ya da gruba özgü eğriler gerekiyorsa.
Ne zaman kullanılmaz?
- Küme yapısı yoksa ve yalnız düzgün ortalama eğrisi isteniyorsa: temel programdaki GAM (Genelleştirilmiş Toplamsal Model).
- Etkiler doğrusal kabul ediliyorsa: temel programdaki LMM (Doğrusal Karma Modeller) ve GLMM (Genelleştirilmiş Doğrusal Karma Modeller); çapraz ya da iç içe rastgele etkiler ve ileri seçenekler için
glmer_ileri(Bölüm 19). - İlişkili kesişim + eğim binom ya da Poisson yanıtla gerekiyorsa: şablon bu yapıyı yalnız Gauss ailesinde sunar;
glmer_ileri(Bölüm 19). - Artıklarda özilişki ya da gruba göre değişen varyans modellenecekse:
lme_varyans_yapilari(Bölüm 23),lme_uzamsal_korelasyon(Bölüm 22). - Eğrinin biçimi bilinen bir büyüme ya da doz-yanıt fonksiyonuysa:
nlme_karma(Bölüm 24). - Aşırı yayılımlı ya da sıfır şişkin sayım varsa:
glmmtmb_aileler(Bölüm 20),r_glmmtmb_nb(Bölüm 27). - Yayılım ya da dağılımın biçimi de açıklayıcıya bağlanacaksa (persentil eğrileri):
gamlss(Bölüm 47).
Temel programla ilişki. Temel programın GAM analizi aynı tanımları (düzeltilmiş R^2, etkin serbestlik derecesi, k-indeksi) kullanır, ama rastgele etki, tensör çarpımı ve faktör-düzgünleştirici içermez; LMM ve GLMM analizleri ise düzgün terim içermez. Bu şablon ikisini birleştirir ve dört rastgele etki yapısı sunar.
48.2 Şablonun girdileri
Form, üstbilgideki on beş [[param]] bloğundan kurulur (gamm_mgcv.R:10–119).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal; binomda 0/1, Poisson'da sayım | Formülün sol yanı (142–145, 179). |
Dağılım ailesi · aile |
seçim · Model | gaussian |
gaussian, binomial, poisson |
gam(family =) (180). |
Doğrusal terimler · dogrusal |
sütunlar · Değişkenler | boş | herhangi | Parametrik terimler (130, 146–151, 169). |
Düzgünleştirilecek değişkenler · duzgun |
sütunlar (sayısal) · Değişkenler | boş | en az 4 farklı değer | Her biri için s(x, bs, k) (131, 152–161, 169). |
Düzgünleştirici tabanı · bs |
seçim · Model | tp |
tp, cr, cc, ps |
Bütün s() terimlerinin tabanı (169). |
Taban boyutu k · k |
tamsayı · Model | 10 | 3–50 | Üst sınır; farklı değer sayısına göre küçültülür (152–161, 169). |
Tensör çarpım için iki değişken · tensor |
sütunlar (sayısal) · Değişkenler | boş | tam iki sütun ya da boş | te(x1, x2, k) (128–129, 169). |
Faktör sayılacak sayısal sütunlar · faktor |
sütunlar · Değişkenler | boş | herhangi | Yalnız doğrusal terimler arasındaysa faktöre çevrilir (146). |
Gruplama faktörü · grup |
kategorik sütun · Değişkenler | boş | en az 3 düzey | Rastgele etkilerin kümesi (126, 162–166). |
Rastgele etki yapısı · rastgele |
seçim · Model | kesisim |
kesisim, kesisim_egim, faktor_duzgun, iliskili |
Formüle eklenen terimler ya da gamm çağrısı (171–177, 185–197). |
Faktör-düzgünleştiricide ayrı rastgele kesişim ekleme · fs_kesisimsiz |
onay · Model | kapalı | açık/kapalı | Yalnız faktor_duzgun: açıkken s(g, bs = "re") eklenmez (173–174). |
Rastgele eğim değişkeni · egim |
sayısal sütun · Değişkenler | boş | sayısal, sabit değil | Eğim ya da gruba özgü eğri değişkeni (127, 132–134, 165). |
Düzgünleştirme parametresi seçimi · yontem |
seçim · Model | REML |
REML, ML, GCV.Cp |
method = (188, 192). |
Düzgün terimlere ek ceza · secim_cezasi |
onay · Model | kapalı | açık / kapalı | select = TRUE (193); ilişkili yapıda kullanılmaz. |
Düzgünlük şişirme çarpanı γ · gama |
ondalık · Gelişmiş | 1,0 | 0,1–10 | gamma = (194); ilişkili yapıda kullanılmaz. |
Varyans bileşeni güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | gam.vcomp(conf.lev =) (217); ilişkili yapıda etkisizdir. |
Örnek ayar (ornek_param, satır 9): y = Reaction, duzgun = Days, k = 5, grup = Subject, rastgele = iliskili, egim = Days. Varsayılandan farkı: taban boyutu 10 yerine 5, yapı rastgele kesişim yerine ilişkili kesişim + eğim.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 118 |
| Tensör için iki dışında sayıda değişken | "Tensör çarpım için tam iki değişken seçin." | 122 |
| Eğim isteyen yapı, eğim değişkeni yok | "Bu rastgele etki yapısı için eğim değişkeni seçin." | 126 |
| Eğim değişkeni yanıt ya da grup | "Eğim değişkeni yanıt ya da grup olamaz." | 127 |
| İlişkili yapı ve GCV | "… GCV ile kestirilemez; REML ya da ML seçin." | 128 |
| İlişkili yapı ve Gauss dışı aile | "… yalnız Gauss ailesiyle sunulur." | 129 |
| Hiç terim ve grup yok | "En az bir terim … seçin." | 130 |
| Tam satır sayısı < 15 | "Eksiksiz en az 15 satır gerekli." | 134 |
| Yanıt sayısal değil ya da sabit | "Yanıt sayısal ve değişken olmalı." | 136 |
| Binomda 0/1 dışı değer | "Binom ailesinde yanıt 0/1 olmalı." | 137 |
| Poisson'da negatif ya da tam olmayan değer | "… negatif olmayan tamsayı olmalı." | 138 |
| Doğrusal terim tek düzeyli ya da sabit | "'…' tek düzeyli / sabit; modelden çıkarın." | 142, 143 |
| Düzgün ya da tensör değişkeninde < 4 farklı değer | "'…' en az 4 farklı değer almalı" | 148 |
| Grup < 3 düzey | "Gruplama faktörü en az 3 düzey içermeli." | 153 |
| Eğim değişkeni sayısal değil ya da sabit | "Eğim değişkeni sayısal ve değişken olmalı." | 154 |
| Kestirim hatası | "Model kurulamadı: …" | 171 |
| Özet alınamadı | "Model özeti alınamadı: …" | 186 |
| İlişkili yapıda kovaryans okunamadı | "Rastgele etki kovaryansı alınamadı." | 199 |
Seçimlerin ayıklanması (128–131): yanıt ve grup, terim listelerinden çıkarılır; doğrusal terimlerde de seçilmiş bir değişken düzgün terimlerden çıkarılır (doğrusal sayılır). Kullanılan sütunlardan biri eksik olan satırlar atılır (140). Kestirim sırasındaki uyarılar çalıştırmayı durdurmaz; sonda "Kestirim uyarıları:" satırında yazılır (184, 236).
48.3 Örnek veri
Dosya: _ornek/sleepstudy.csv. Belenky ve arkadaşlarının (2003) uyku kısıtlaması çalışmasından, lme4 paketiyle dağıtılan veri: 18 deneğin 10 gün boyunca (0–9) günlük ortalama tepki süresi. 180 satır, eksik değer yok, tasarım dengelidir (her denekte 10 gözlem).
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
Reaction |
Yanıt | sayısal | Tepki süresi (ms); 194,33–466,35; ortalama 298,51. |
Days |
Düzgün terim ve rastgele eğim | sayısal | Uyku kısıtlaması günü; 0–9, 10 farklı değer. |
Subject |
Gruplama faktörü | kategorik | 18 denek (S308 … S372). |
Subject düzeyleri verideki ilk görülme sırasındadır (S308, S309, S310, S330, …); bu şablonda grup düzeylerinin sırası hiçbir sonucu etkilemez (rastgele etkiler düzey sırasına göre simetriktir). Günlük ortalamalar 256,7 ms'den (gün 0) 350,9 ms'ye (gün 9) yükselir; denekler arasında hem başlangıç düzeyi hem artış hızı belirgin biçimde farklıdır.
Bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) dogrusal = Days, düzgün terim yok (yayımlanmış modelle karşılaştırma); (3) rastgele = kesisim_egim; (4) rastgele = kesisim; (5) rastgele = faktor_duzgun; (6) yontem = ML; (7) k = 10; (8) grup boş (rastgele etkisiz model); (9) binom ve Poisson aileleri, tensör çarpımı ve iki düzgün terim için örnek veriden türetilmiş yardımcı sütunlar (dogrulama/gamm_mgcv/sleep_ek.csv).
48.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) seçimleri ayıkla, veriyi denetle; (2) taban boyutunu sınırla ve model formülünü kur; (3) yapıya göre gam() ya da gamm() ile kestir; (4) summary() ile parametrik ve düzgün terim tablolarını al; (5) varyans bileşenlerini yaz; (6) uyum ölçütlerini hesapla; (7) taban boyutu denetimini yap; (8) düzgün terimleri çiz.
48.4.1 Düzgün terim: cezalı regresyon spline'ı
- b_m: taban fonksiyonları; sayıları taban boyutu k'dır.
- \mathbf S: ceza matrisi; \boldsymbol\beta^{\top}\mathbf S\boldsymbol\beta eğrinin toplam eğriliğini ölçer.
- \lambda: düzgünleştirme parametresi. \lambda\to\infty iken eğri doğruya iner (doğrunun eğriliği sıfırdır, cezalandırılmaz); \lambda\to0 iken k parametreli cezasız spline elde edilir.
- Etkin serbestlik derecesi (edf): \operatorname{iz}\big[(\mathbf X^{\top}\mathbf W\mathbf X+\mathbf S_\lambda)^{-1}\mathbf X^{\top}\mathbf W\mathbf X\big]'nin terime düşen köşegen toplamı. edf ≈ 1 doğrusal ilişkiye, büyük edf kıvrımlı eğriye işaret eder; en çok k-1 olabilir.
Neden k "üst sınır" ve neden k − 1?
Her düzgün terim, sabit terimle karışmaması için "veri üzerindeki toplamı sıfır" kısıtıyla kurulur; bu kısıt bir serbestlik derecesi alır ve terimin en çok k-1 serbestlik derecesi kalır. Gerçek esnekliği \lambda belirler; k yalnız eğrinin ulaşabileceği en büyük karmaşıklıktır. k gereğinden büyük seçilirse sonuç pek değişmez (ceza fazlalığı bastırır), küçük seçilirse eğri gerçek biçime ulaşamaz; bu yüzden k bol tutulur ve yeterliliği ayrıca denetlenir (48.4.8).
Koddaki tercih
Şablon k'yı her terim için o değişkenin farklı değer sayısına göre sınırlar (satır 152–161): k_v=\min(k,\ n_v-1); burada n_v, düzgün ve tensör değişkenlerinden v'nin farklı değer sayısıdır. Her s() terimi kendi k_v değeriyle kurulur (169); sınırlama k'yı küçülttüğünde çıktıya "'x' için taban boyutu k = 9 iken 5'e düşürüldü" biçiminde not yazılır (158–160). Örnek veride Days 10 farklı değer aldığından varsayılan k=10 kendiliğinden 9'a iner; iki düzgün değişkenden biri 6 farklı değer alıyorsa yalnız o değişkenin terimi k=5 ile kurulur, Days'inki 9'da kalır. Kullanılan k, konsoldaki formülde ve taban boyutu denetimi tablosunun k sütununda (k-1 olarak) görülür. Tensör çarpımında her yön için \min(5,k_{v_1},k_{v_2}), faktör-düzgünleştiricide \min(5,\ n_{\text{eğim}}-1) alınır (170, 176).
48.4.2 Tabanlar
| Seçenek | Taban | Özelliği | Ne zaman |
|---|---|---|---|
tp |
İnce levha regresyon spline'ı | Düğüm yeri seçimi gerektirmez; verilen k için en iyi yaklaşık tabandır (Wood, 2003). | Varsayılan; genel amaçlı. |
cr |
Kübik regresyon spline'ı | Düğümler x'in niceliklerinde; katsayılar düğümlerdeki fonksiyon değerleridir. | Büyük veri; hızlı. |
cc |
Döngüsel kübik spline | Eğrinin iki ucu değer, birinci ve ikinci türev bakımından birleşir. | Ay, saat, yön açısı gibi döngüsel değişkenler. |
ps |
P-spline | Eşit aralıklı B-spline tabanı ve katsayı farkı cezası (Eilers ve Marx, 1996). | Eşit aralıklı x; cezanın derecesi denetlenmek istendiğinde. |
İnce levha tabanı tek değişkende şöyle kurulur (şablonun örnek ayarı): x'in farklı değerleri x_1,\dots,x_q için
- \mathbf E: E_{ij}=\lvert x_i-x_j\rvert^{3} öğeli q\times q matris; \mathbf T=[\mathbf 1,\ \mathbf x].
- Kısıt \mathbf T^{\top}\boldsymbol\delta=\mathbf 0 ile f doğal kübik spline'dır; \alpha_0+\alpha_1x cezalandırılmayan doğrusal kısımdır.
- Regresyon spline'ı: \mathbf E=\mathbf U\mathbf D\mathbf U^{\top} özayrışımından mutlak değerce en büyük k özdeğer tutulur (\boldsymbol\delta=\mathbf U_k\boldsymbol\delta_k); kısıt 2 boyut alır, doğrusal kısım 2 boyut ekler: toplam boyut k.
Tensör çarpımı te(x1, x2) iki tek değişkenli tabanın çarpımıdır ve her yön için ayrı bir düzgünleştirme parametresi kestirir; değişkenlerin birimleri farklıyken (sıcaklık ve nem, gün ve saat) uygundur (Wood, 2006). Şablon tensör terimini mgcv'nin varsayılan kenar tabanıyla (kübik regresyon) kurar; "Düzgünleştirici tabanı" seçimi yalnız s() terimlerine uygulanır.
48.4.3 Düzgün terim bir rastgele etkidir
Cezalı uyum, karma model olarak yeniden yazılabilir. Düzgün terimin tabanı, cezalandırılmayan (doğrusal) ve cezalandırılan (kıvrımlı) kısma ayrılır:
- \mathbf X_F\boldsymbol\beta_F: sabit etki olarak kalan doğrusal kısım.
- \mathbf Z_s\mathbf b_s: kıvrımlı kısım; katsayıları ortak varyanslı rastgele etkilerdir.
- \sigma^2: artık varyansı (Gauss dışı ailelerde ölçek parametresi). \sigma_s^2\to0 (\lambda\to\infty) iken eğri doğrudur.
Bu eşdeğerlik neden önemli?
Düzgünleştirme parametresini seçmek, bir varyans bileşenini kestirmekle aynı iş olur; bunun için karma modellerin ölçütü (REML ya da ML) kullanılır. Aynı çerçeve, "gerçek" rastgele etkileri (denek kesişimi, eğimi) düzgünleştiricilerle tek modelde birleştirir: hepsi, kendi ceza matrisi olan terimlerdir. Şablonun dört rastgele etki yapısından üçü tam olarak bu yolla (gam() içinde), dördüncüsü modelin tümü karma model yazılımına aktarılarak (gamm() → nlme::lme) kestirilir.
48.4.4 Rastgele etki yapıları
| Seçenek | Formüle eklenen | Model | Kestirim |
|---|---|---|---|
kesisim |
s(g, bs = "re") |
b_{0g}\sim N(0,\sigma_0^2) | gam() |
kesisim_egim |
s(g, bs = "re") + s(x, g, bs = "re") |
b_{0g}\sim N(0,\sigma_0^2), b_{1g}\sim N(0,\sigma_1^2), bağımsız | gam() |
faktor_duzgun |
s(g, bs = "re") + s(x, g, bs = "fs", k) |
Her grup için ortak düzgünlük parametreli ayrı eğri | gam() |
iliskili |
random = list(g = ~ 1 + x) |
(b_{0g},b_{1g})\sim N(\mathbf 0,\mathbf G), \mathbf G yapılandırılmamış 2\times2 | gamm() |
bs = "re" tabanında ceza matrisi birim matristir: katsayılar ortak varyanslı bağımsız normal rastgele etkilerdir ve varyansları düzgünleştirme parametresinden bulunur, \sigma_b^2=\sigma^2/\lambda. gam.vcomp bu standart sapmaları ve log ölçeğinde kurulup geri çevrilen güven aralıklarını verir (satır 217–223).
İlişkisiz eğim modeli x'in sıfır noktasına bağlıdır
kesisim_egim yapısında kesişim ile eğim bağımsız varsayılır. Kesişim, eğim değişkeninin sıfır olduğu noktadaki grup sapmasıdır; değişken ötelenirse (ör. gün yerine merkezlenmiş gün) kesişimin anlamı değişir ve "bağımsızlık" başka bir modele dönüşür: uyum ve varyans bileşenleri farklı çıkar. İlişkili yapı bu ötelemeye karşı değişmezdir. Örnek veride korelasyon 0,065 olduğundan iki yapı hemen hemen aynı sonucu verir (48.7); korelasyonun büyük olduğu veride (ör. yüksek başlayanın yavaş arttığı büyüme verisi) ilişkisiz yapı yanıltıcıdır.
Faktör-düzgünleştirici kendi rastgele kesişimini taşır
fs tabanı, her grubun eğrisinin sabit ve doğrusal kısmını da cezalandırır; yani grup düzeyinde rastgele kesişim ve eğim bu terimin içindedir. Şablon bu yapıda s(g, bs = "re") terimini de eklediğinden iki rastgele kesişim birlikte kestirilir ve varyansın ikisi arasındaki paylaşımı belirsizdir (örnek veride bileşenlerden birinin güven aralığı 10^{-35} ile 10^{34} arasındadır). Bu yapıda grup eğrilerinin toplam uyumu ve ortak düzgün terim yorumlanır; tek tek kesişim varyansları yorumlanmaz. "Faktör-düzgünleştiricide ayrı rastgele kesişim ekleme" seçeneği (varsayılan kapalı) açılırsa s(g, bs = "re") eklenmez; grup kesişimi yalnız fs tabanındadır. Örnek veride (sleepstudy) REML ölçütü 866,942'den 867,241'e, açıklanan sapma %90,32'den %90,33'e geçer; varyans bileşenleri tablosunda s(Subject) satırı kalkar ve kesişim bileşeni s(Days,Subject)2 olarak 37,64 çıkar (önceki 37,66 s(Subject) ve 0,85 s(Days,Subject)2). Ölçütler bağımsız mgcv::gam çağrılarıyla aynıdır.
48.4.5 Düzgünlük seçimi: REML, ML, GCV
Gauss ailesinde, bütün ceza ve rastgele etki terimleri \mathbf V kovaryans matrisine toplandığında kısıtlanmış log-olabilirlik:
- \mathbf X: cezalandırılmayan (sabit) sütunlar; p sayıları.
- \mathbf V=\sigma^2\mathbf I+\sum_k\sigma_k^2\mathbf Z_k\mathbf Z_k^{\top}: artık, rastgele etkiler ve düzgün terimlerin kıvrımlı kısımları.
- REML, sabit etkilerin kestiriminde harcanan serbestlik derecesini hesaba katar (\ln\lvert\mathbf X^{\top}\mathbf V^{-1}\mathbf X\rvert terimi); ML bu terimi içermez.
Neden varsayılan REML?
GCV, kestirim hatasını en küçüklemeye çalışır; ölçüt yüzeyi çoğu kez düzdür ve zaman zaman belirgin biçimde aşırı uyan (küçük \lambda) çözümler seçer. REML ve ML ölçütleri \lambda'da daha keskin bir en iyi nokta verir ve aşırı uyuma daha dirençlidir (Wood, 2011). REML varyans bileşenlerini yansıza yakın kestirir; ML ise sabit etkileri farklı modellerin olabilirlik oranıyla karşılaştırılması gerektiğinde seçilir (REML ölçütleri yalnız sabit kısmı aynı olan modeller arasında karşılaştırılır).
Koddaki tercih
gam(formula, family, data, method = yontem) (satır 192–195); secim_cezasi açıksa select = TRUE, γ ≠ 1 ise gamma = γ eklenir. select = TRUE her düzgün terimin cezalandırılmayan (doğrusal) kısmına da ikinci bir ceza koyar; terim tümüyle sıfıra büzülebilir (Marra ve Wood, 2011). γ > 1, ölçütte etkin serbestlik derecesini pahalılaştırır ve daha düzgün eğriler seçtirir. İlişkili yapıda çağrı gamm(formula, random = list(g = ~ 1 + x), data, method = yontem) biçimindedir (186–188); aile Gauss'tur, select ve gamma geçirilmez, yöntem REML ya da ML olabilir.
48.4.6 Çıkarım: katsayılar, düzgün terim testi
Kestirimden sonra bütün katsayıların (sabit, düzgün terim, gam() yolunda rastgele etkiler) Bayesçi kovaryans matrisi kurulur:
- \mathbf X_a: bütün model sütunları (sabit, düzgün terimlerin tabanı).
- \mathbf V_o: bu katsayıların dışında kalan değişkenlik;
gam()yolunda \sigma^2\mathbf I,gamm()yolunda \sigma^2\mathbf I artı grup rastgele etkilerinin kovaryansı. - \mathbf S_\lambda: düzgünleştirme parametreleriyle ağırlıklandırılmış ceza matrislerinin toplamı.
Parametrik terimler: t=\hat\beta/\operatorname{SH}, \operatorname{SH}=\sqrt{[\mathbf V_p]_{jj}}; Gauss ailesinde p değeri n-\sum\text{edf} serbestlik dereceli t dağılımından, binom ve Poisson'da standart normalden.
Düzgün terimli modelde sabit, x = 0'daki değer değildir
Her düzgün terim veri üzerinde toplamı sıfır olacak biçimde kurulduğundan sabit terim, düzgün değişkenlerin gözlenen değerleri üzerinden ortalama düzeydir. Örnek ayarda sabit 298,51 ms'dir (yanıtın genel ortalaması); Days doğrusal terim olarak girildiğinde sabit 251,41 ms'dir (gün 0'daki düzey). Standart hataları da farklıdır (9,05 ve 6,82): gün 4,5'teki düzeyin belirsizliği rastgele eğimin katkısını içerir. İki sayı aynı modelin iki ayrı noktasıdır.
Düzgün terimler: her terim için "fonksiyon her yerde sıfırdır" hipotezi Wood'un (2013) Wald türü istatistiğiyle sınanır:
- \hat{\mathbf f}: terimin gözlem noktalarındaki kestirilen değerleri; \mathbf V_f: onların \mathbf V_p'den gelen kovaryansı.
- \mathbf V_f^{\,r-}: r ranklı genelleştirilmiş ters. r tamsayı değilse en büyük \lfloor r\rfloor özyön tam, bir sonraki özyön kesirli ağırlıkla girer.
- Gauss ailesinde (ölçek kestirildiğinde) F istatistiği, öteki ailelerde T_r (\chi^2) yazılır.
gam()yolunda Ref.df, edf'den biraz büyüktür (2\,\text{edf}-\operatorname{iz}(\mathbf F\mathbf F) düzeltmesi);gamm()yolunda edf'ye eşittir. bs = "re"terimlerinin satırı, o rastgele etkinin varyansının sıfır olup olmadığını sınar.
Kesirli rankta istatistiğin değeri, son iki özyönün çapraz teriminin işaretine bağlıdır ve işaret, parametrelemenin bir ayrıntısıdır; mgcv iki işaretin p değerlerinin ortalamasını alır, tabloya ise istatistiklerden birini yazar. Çok küçük olasılıklarda p tam 0 olarak döner; tabloda 0 görülmesi "p<0{,}001" demektir.
48.4.7 Uyum ölçütleri
- \hat y_i:
gamnesnesinin uyumu.gam()yolunda rastgele etkiler modelin katsayısı olduğundan uyuma dahildir;gamm()yolundagamnesnesi yalnız sabit kısmı ve düzgün terimi taşır, grup rastgele etkileri uyuma dahil değildir. - \sum\text{edf}:
gamnesnesindeki toplam etkin serbestlik derecesi.
"Model uyumu" satırları iki yapıda farklı büyüklükleri ölçer
İlişkili yapıda logLik ve AIC, lme nesnesinden gelir: rastgele etkiler üzerinden integrali alınmış (marjinal) REML olabilirliği ve varyans parametreleri dahil parametre sayısı (örnek ayarda 7). Öteki yapılarda gam nesnesinden gelir: rastgele etkiler cezalı katsayı sayılır (koşullu olabilirlik) ve serbestlik derecesi etkin sd'dir. R^2_{\text{düz}} de aynı biçimde ayrışır. Şablon satır adlarına olabilirliğin kaynağını yazar ("logLik (marjinal, lme)", "AIC (marjinal, lme)", "R2_duz (sabit kısım ve düzgün terimler)" ya da "logLik (koşullu, gam)", "AIC (koşullu, gam)", "R2_duz (rastgele etkiler dahil)") ve tablodan sonra bu satırların yapılar arasında karşılaştırılamayacağını söyleyen bir not yazar (230–235). Örnek veride, hemen hemen aynı iki model için ilişkili yapı \text{logLik}=-870{,}74, \text{AIC}=1755{,}48, R^2=0{,}28; ilişkisiz yapı -822{,}43; 1712{,}21; 0{,}79 yazar. Bu satırlar yapılar arasında karşılaştırılmaz. Karşılaştırılabilir büyüklük REML (ya da ML) ölçütüdür: tablonun "REML ölçütü" satırı gam() yolunda gcv.ubre, ilişkili yapıda -\text{logLik} olarak yazılır (örnek veride 870,739 ve 870,759; GCV/UBRE seçilmişse ilişkili yapıda satır boştur). İlişkili yapıda "Açıklanan sapma" satırı boştur.
48.4.8 Taban boyutu denetimi
k.check, artıkların düzgün değişkene göre komşu gözlemler arasında örüntü taşıyıp taşımadığına bakar:
- e_i: (ortalaması çıkarılmış) artıklar; i': i'nin düzgün değişkene göre en yakın komşuları (ortalama komşular üzerinden alınır).
- Artıklar örüntüsüzse komşu farkının yarı kareler ortalaması artık varyansına eşittir ve indeks 1'e yakındır; eğri yetersiz esnekse komşu artıklar benzeşir ve indeks 1'in altına düşer.
- p değeri, artıkların 400 rastgele yeniden sıralamasında indeksin gözlenenden küçük çıkma oranıdır.
Karar kuralı: indeks 1'in belirgin altında, p küçük ve edf, k-1'e yakınsa k artırılır. edf, k-1'in çok altındaysa düşük indeks taban yetersizliğini değil, modelde olmayan başka bir yapıyı (eksik değişken, özilişki) gösterir. p benzetimle hesaplandığından çalıştırmadan çalıştırmaya biraz değişir (örnek ayarda 0,90–0,94 arası değerler görülür); arayüzün her çalıştırmaya atadığı tohum kaydedilir ve betikten yinelemede aynı p elde edilir. bs = "re" terimleri için indeks hesaplanmaz (NaN).
48.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–113 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on beş parametre. | Form buradan kurulur (Bölüm 1.2). |
| 114–130 | mgcv yüklenir; seçimler okunur ve ayıklanır; yapıya bağlı ön denetimler. |
Boş alanlar bos() ile tanınır (124). |
| 131–159 | Kullanılan sütunlar, tam satırlar; yanıt, aile, doğrusal terim, düzgün değişken ve grup denetimleri; k_{\max}. | faktor listesi yalnız doğrusal terimlere uygulanır (146). |
| 161–172 | Terimlerin metni ve model formülü; aile nesnesi. | Sütun adları ters tırnakla korunur (168). |
| 173–189 | yakala(): uyarıları toplar, hatayı şablon iletisine çevirir. İlişkili yapıda gamm(), ötekilerde gam(). |
gamm sonucu iki nesnedir: $gam (özet, çizim) ve $lme (varyanslar, olabilirlik). |
| 190–200 | summary() konsola yazılır; parametrik ve düzgün terim tabloları. |
Düzgün terim yoksa ikinci tablo üretilmez. |
| 201–217 | Varyans bileşenleri: ilişkili yapıda lme'nin kovaryans yapısından, ötekilerde gam.vcomp'tan. |
gam.vcomp yalnız REML ve ML ile çalışır; GCV'de tablo üretilmez. |
| 218–228 | Model uyumu tablosu; kestirim uyarıları. | 48.4.7. |
| 229–232 | Taban boyutu denetimi. | Yalnız düzgün ya da tensör terimi varsa. |
| 233–242 | Çizim: düzgün terimler (tek sayfa) ya da gözlenen–kestirilen saçılımı. | Bant seWithMean = TRUE ile sabitin belirsizliğini de içerir; düzey %95'tir. |
İlişkili yapıda varyans bileşenleri şöyle okunur (210–214):
G <- as.matrix(lm_$modelStruct$reStruct[[grup]]) * lm_$sigma^2
deger = c(sqrt(G[1, 1]), sqrt(G[2, 2]), lm_$sigma, G[1, 2] / sqrt(G[1, 1] * G[2, 2]))
lme rastgele etki kovaryansını artık varyansına oranlı tutar; \sigma^2 ile çarpım mutlak ölçeğe çevirir. Tablo yalnız grup düzeyindeki bileşenleri verir; düzgün terimin kıvrımlı kısmının varyansı bu tabloda yer almaz.
48.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/gamm_mgcv/elle_hesap.py ile, mgcv, nlme ve şablon kodu kullanılmadan hesaplanmıştır. İki model ele alınır: (A) Days'in doğrusal olduğu model; dengeli veride REML kestirimi kapalı biçimdedir ve yayımlanmış sonuçlarla karşılaştırılır; (B) örnek ayar; ince levha tabanı baştan kurulur ve REML olabilirliği sayısal olarak en büyüklenir. R tarafında (r_dogrulama.R) iki model de lme4 ile, B'de aynı taban lme4'ün modüler arayüzüne yerleştirilerek kurulmuştur.
Adım 1 — Denek başına doğrular (A). Her denek için 10 gözleme en küçük karelerle doğru uydurulur. İlk denek (S308): 244{,}193+21{,}765\,t. Denek içi artık kareler toplamı (18 denek) \mathrm{KT}_{\text{iç}}=94311{,}508.
Adım 2 — Artık varyansı. Her denekte 10-2=8 serbestlik derecesi kalır:
Adım 3 — Sabit etkiler. Dengeli veride genelleştirilmiş en küçük kareler kestirimi, denek katsayılarının ortalamasıdır: \hat\beta_0=251{,}4051, \hat\beta_1=10{,}4673.
Adım 4 — Rastgele etki kovaryansı. Denek katsayılarının örneklem kovaryansı \mathbf S_b (bölen 17) hem gerçek değişkenliği hem kestirim hatasını içerir; kestirim hatası \hat\sigma^2(\mathbf Z^{\top}\mathbf Z)^{-1} çıkarılır (\mathbf Z=[\mathbf 1,\ t], t=0,\dots,9):
Standart sapmalar \sqrt{612{,}090}=24{,}7405 ve \sqrt{35{,}072}=5{,}9221; korelasyon 9{,}604/\sqrt{612{,}090\times35{,}072}=0{,}0656.
Adım 5 — Standart hatalar ve olabilirlik. \operatorname{Var}(\hat{\boldsymbol\beta})=\mathbf S_b/18: \operatorname{SH}(\hat\beta_0)=\sqrt{838{,}342/18}=6{,}8246, \operatorname{SH}(\hat\beta_1)=\sqrt{43{,}010/18}=1{,}5458; t=10{,}4673/1{,}5458=6{,}7715. Bu kestirimlerle \ell_R=-871{,}814136 ve \mathrm{AIC}=-2\ell_R+2\times6=1755{,}628272. Değerler Bates ve arkadaşlarının (2015) aynı model için bildirdikleriyle örtüşür (katsayılar 251,41 ve 10,47; standart hatalar 6,82 ve 1,55; standart sapmalar 24,7407; 5,9221 ve 25,5918; korelasyon 0,0656).
Adım 6 — İnce levha tabanı (B). Merkezlenmiş günler -4{,}5,\dots,4{,}5 için \mathbf E'nin (E_{ij}=\lvert x_i-x_j\rvert^3) özdeğerleri: 1330,46; −1272,95; −120,85; 44,03; 13,58; 2,98; 1,42; 0,66; 0,40; 0,28. Mutlak değerce en büyük beşi tutulur; [\mathbf 1,\mathbf x] kısıtı 2 boyut alır ve 3 boyutlu kıvrımlı kısım kalır (ceza matrisinin özdeğerleri 7,53; 29,84; 232,11). Doğrusal sütun (t-4{,}5)/\sqrt{8{,}25} olarak ölçeklenir (mgcv'nin kuralı; REML olabilirliğinin sabitini belirler).
Adım 7 — REML (B). Sabit sütunlar [\mathbf 1,\ \text{doğrusal}]; rastgele kısım: 3 kıvrım katsayısı (tek varyans), denek kesişimi ve eğimi (2×2 kovaryans). Profillenmiş REML olabilirliği dört parametrede en büyüklenir; durma noktasında en büyük gradyan öğesi 2\times10^{-9}'dur.
| Kesişim SS | Eğim SS | Korelasyon | Artık SS | \ell_R | |
|---|---|---|---|---|---|
| A (Days doğrusal) | 24,74045 | 5,92213 | 0,06555 | 25,59182 | −871,814136 |
| B (s(Days), k = 5) | 24,75097 | 5,92368 | 0,06495 | 25,56236 | −870,738958 |
Adım 8 — Düzgün terim (B). Katsayı başına etkin serbestlik dereceleri: sabit 1; üç kıvrım katsayısı 0,2042; 0,0348; 0,0237; doğrusal kısım 1. Düzgün terimin edf'si 0{,}2042+0{,}0348+0{,}0237+1=1{,}2627; artık sd 180-2{,}2627=177{,}7373. Sabit 298{,}5079, \operatorname{SH}=9{,}0499, t=32{,}9845. Düzgün terimin günlere göre kestirilen düzeyi: 252,23; 262,17; 272,20; 282,37; 292,70; 303,18; 313,80; 324,56; 335,45; 346,40 ms. Günlük artış 9,9 ms'den 11,0 ms'ye çıkar: eğri hafifçe yukarı bükülür.
Adım 9 — Düzgün terimin testi (B). \mathbf V_f'nin en büyük iki özdeğeri yönünde standartlaştırılmış bileşenler u_1=-9{,}0657/\sqrt{1{,}7924}=-6{,}7715 ve u_2=0{,}2630/\sqrt{0{,}2188}=0{,}5621; r=1{,}2627 için kesir \nu=0{,}2627 ve çapraz ağırlık \sqrt{\nu(1-\nu)/2}=0{,}3112:
Artı işaretiyle T_r=48{,}305, F=48{,}305/1{,}2627=38{,}255; eksi işaretiyle F=34{,}502. Şablonun tablosu birincisini yazar. F dağılımından yaklaşık p değerleri 1{,}2\times10^{-10} ve 8{,}3\times10^{-10}'dur.
Adım 10 — Uyum. R^2_{\text{düz}}=1-\operatorname{var}(e)\times179/(\operatorname{var}(y)\times177{,}7373)=0{,}282091 (yalnız sabit kısım ve düzgün terimle); \mathrm{AIC}=-2\times(-870{,}738958)+2\times7=1755{,}477916.
48.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 2 ve 1).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| A: kesişim | 251,40510485 | 251,40510485 | 251,40510485 | 6,8e−16 | ✓ |
| A: Days eğimi | 10,46728596 | 10,46728596 | 10,46728596 | 3,8e−14 | ✓ |
| A: SH kesişim | 6,82455339 | 6,82455653 | 6,82455676 | 4,9e−7 | ✓ |
| A: SH Days | 1,54578888 | 1,5457889 | 1,54578897 | 5,9e−8 | ✓ |
| A: t Days | 6,77148482 | 6,77148476 | 6,77148442 | 5,9e−8 | ✓ |
| A: p Days | 1,787244·10−10 | 1,787244·10−10 | — | 5,6e−17 | ✓ |
| A: SS kesişim | 24,74043538 | 24,74045146 | 24,74045266 | 7,0e−7 | ✓ |
| A: SS eğim | 5,92213297 | 5,9221331 | 5,92213348 | 8,6e−8 | ✓ |
| A: SS artık | 25,59181703 | 25,59181563 | 25,5918154 | 6,4e−8 | ✓ |
| A: korelasyon (kesişim, eğim) | 0,06555152 | 0,06555132 | 0,06555122 | 3,0e−7 | ✓ |
| A: REML log-olabilirliği | −871,81413598 | −871,81413598 | −871,81413598 | 4,8e−15 | ✓ |
| A: AIC | 1755,62827196 | 1755,62827196 | 1755,62827196 | 5,8e−15 | ✓ |
| A: R^2_{\text{düz}} | 0,28246281 | 0,28246281 | — | 1,7e−16 | ✓ |
| B: kesişim | 298,50789167 | 298,50789167 | 298,50789167 | 1,4e−14 | ✓ |
| B: SH kesişim | 9,04992923 | 9,0499364 | — | 7,9e−7 | ✓ |
| B: t kesişim | 32,98455536 | 32,98452922 | — | 7,9e−7 | ✓ |
| B: s(Days) etkin sd | 1,26267252 | 1,26272755 | — | 4,4e−5 | ✗ |
| B: s(Days) F | 38,25596806 | 38,2546713 | — | 3,4e−5 | ✗ |
| B: SS kesişim | 24,75097412 | 24,75096875 | 24,750968 | 2,5e−7 | ✓ |
| B: SS eğim | 5,92367785 | 5,92367544 | 5,92367444 | 5,8e−7 | ✓ |
| B: SS artık | 25,56236588 | 25,56236083 | 25,56236126 | 2,0e−7 | ✓ |
| B: korelasyon (kesişim, eğim) | 0,06494336 | 0,06494584 | 0,06494599 | 2,6e−6 | ✗ |
| B: REML log-olabilirliği | −870,73895789 | −870,73895789 | −870,73895789 | 1,2e−12 | ✓ |
| B: AIC | 1755,47791578 | 1755,47791578 | 1755,47791578 | 1,1e−12 | ✓ |
| B: R^2_{\text{düz}} | 0,2820914 | 0,28209131 | — | 9,8e−8 | ✓ |
Ölçütü karşılayan: 22/25. A: Reaction ~ Days, ilişkili rastgele kesişim ve eğim; B: örnek ayar. Python: A'da dengeli veride kapalı biçimli REML (denek başına doğrular), B'de ince levha tabanının açık kurulumu ve profillenmiş REML olabilirliğinin sayısal en büyüklenmesi (mgcv ve nlme kullanılmadan). R: lme4 (A'da lmer; B'de aynı taban, lme4'ün modüler arayüzüyle).
Model A'da kapalı biçimli çözüm, şablon (nlme) ve lme4 bütün büyüklüklerde ölçütün içindedir; en büyük fark kesişim standart sapmasındadır (7\times10^{-7} göreli) ve yinelemeli iki yazılımın durma noktasından gelir: kapalı biçim 24,740451, şablon 24,740435, lme4 24,740453.
Ölçütü karşılamayan üç satır örnek ayara (B) aittir ve tek bir nedene dayanır: REML olabilirliği düzgün terimin varyansı yönünde çok düzdür (eğri neredeyse doğrusaldır; bu varyans veriden zayıf belirlenir). Şablonun arkasındaki eniyileyici bu yönde kendi toleransında durur; log-olabilirlik 10^{-9} içinde aynıyken düzgün terimin etkin serbestlik derecesi beşinci basamakta (1,262673 ve 1,262728), ona bağlı F istatistiği dördüncü basamakta, korelasyon altıncı basamakta ayrışır. Python ve R (lme4) çözümleri birbirleriyle 10^{-7} içinde aynıdır. F satırında Python sütunu, Adım 9'daki iki işaretten şablonla aynı kuralı izleyenidir.
48.7 Çıktıyı okuma
Örnek ayarın konsol metni (mgcv özeti):
Family: gaussian
Link function: identity

Formula:
Reaction ~ s(Days, bs = "tp", k = 5)

Parametric coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   298.51       9.05   32.98   <2e-16 ***

Approximate significance of smooth terms:
          edf Ref.df     F p-value
s(Days) 1.263  1.263 38.26  <2e-16 ***

R-sq.(adj) =  0.282
  Scale est. = 653.43    n = 180
Tablolar (dört ondalığa yuvarlanmış):
Parametrik (doğrusal) terimler
      terim  kestirim     SH  istatistik      p
(Intercept)  298.5079 9.0499     32.9846 0.0000

Düzgün terimler (etkin serbestlik derecesi)
  terim    edf  Ref_df  istatistik  p
s(Days) 1.2627  1.2627     38.2560  0

Varyans bileşenleri (lme)
                   bilesen   deger olcek
      Subject: (Intercept) 24.7510    SS
             Subject: Days  5.9237    SS
                     Artık 25.5624    SS
Korelasyon (kesişim, eğim)  0.0649     r

Model uyumu
              olcut     deger
                  n  180.0000
Açıklanan sapma (%)       NaN
R2_duz (sabit kısım ve düzgün terimler)    0.2821
        REML ölçütü  870.7390
 logLik (marjinal, lme) -870.7390
  AIC (marjinal, lme) 1755.4779

Taban boyutu denetimi (k-indeksi < 1 ve küçük p: k'yı artırın)
  terim  k    edf  k_indeksi      p
s(Days)  4 1.2627     1.1109 0.9250
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Formül | Kurulan gam formülü |
Kullanılan taban ve k burada görünür; ilişkili yapıda rastgele kısım formülde yer almaz. |
(Intercept) |
Sabit, SH, t, p | Gözlenen günler üzerinden ortalama tepki süresi (298,5 ms); gün 0 düzeyi değildir (48.4.6). |
s(Days) satırı |
edf, Ref.df, F, p | edf 1,26: eğri doğruya çok yakın. p sütunundaki 0, çok küçük bir olasılığın gösterimidir. Test "Days'in hiçbir etkisi yok" hipotezini sınar, "etki doğrusaldır" hipotezini değil. |
| Varyans bileşenleri | Grup kesişimi, eğim, artık (SS) ve korelasyon | Deneklerin gün 0 düzeyleri ortalamanın çevresinde 24,8 ms, günlük artış hızları 5,9 ms standart sapmayla dağılır; ikisi ilişkisizdir (0,06). |
R2_duz (…) |
Düzeltilmiş R^2 | İlişkili yapıda yalnız ortak eğrinin açıkladığı pay (0,28); denekler arası fark bu sayıya girmez. |
logLik (marjinal, lme), AIC (marjinal, lme) |
lme'nin REML log-olabilirliği ve AIC'si |
Yalnız başka bir ilişkili yapı çalıştırmasıyla ve sabit kısmı aynı modelle karşılaştırılır. |
| Taban boyutu denetimi | k-1, edf, k-indeksi, p | İndeks 1,11 ve edf, 4'ün çok altında: k=5 yeterlidir. |
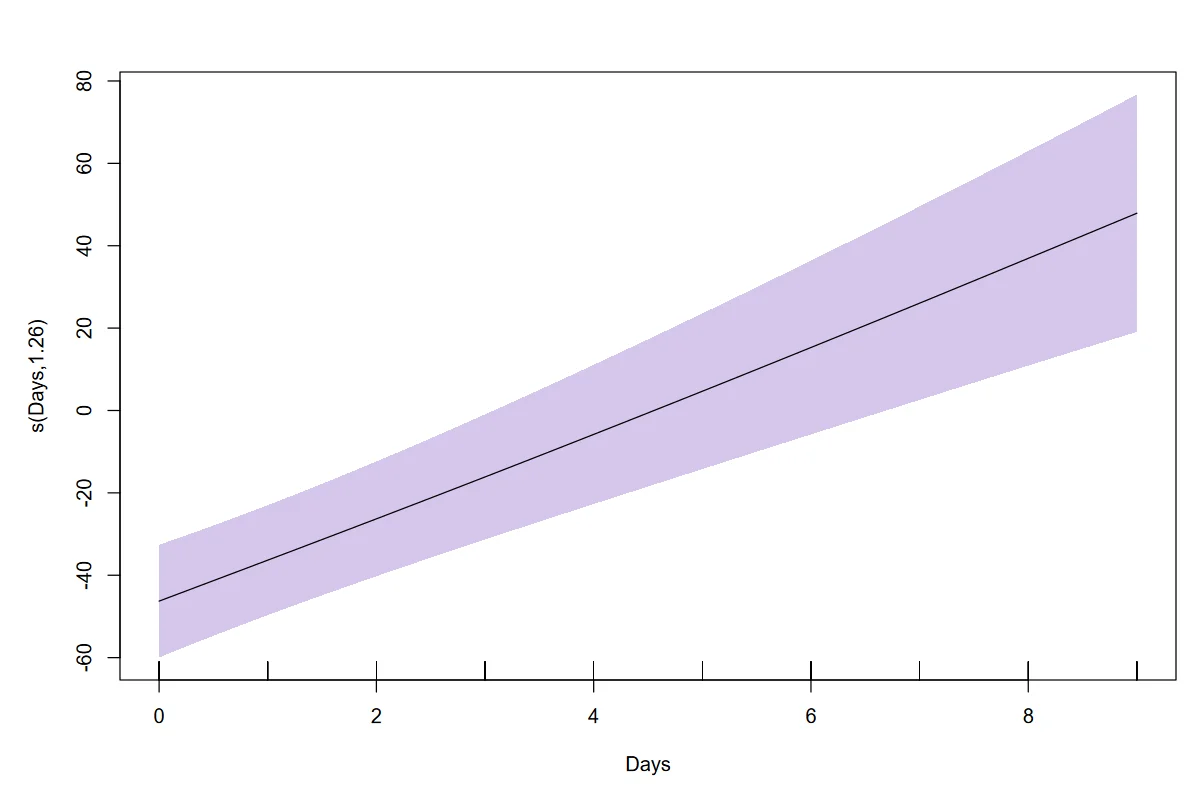
Şekil 48.1. Şablonun şekli (örnek ayar): s(Days) düzgün terimi ve %95 güven bandı. Dikey eksen, genel ortalamadan (298,5 ms) sapmadır; bant sabitin belirsizliğini de içerir. Eksen etiketindeki 1,26 terimin etkin serbestlik derecesidir.
Dört yapı yan yana (aynı düzgün terim, REML; çalıştırmalar 1, 3, 4, 5):
| Yapı | REML ölçütü | s(Days) edf | Kesişim SS | Eğim SS | Artık SS |
|---|---|---|---|---|---|
| Rastgele kesişim | 892,177 | 1,000 | 37,124 | — | 30,991 |
| Kesişim + ilişkisiz eğim | 870,759 | 1,270 | 25,059 | 5,989 | 25,535 |
| İlişkili kesişim + eğim | 870,739 | 1,263 | 24,751 | 5,924 | 25,562 |
| Faktör-düzgünleştirici | 866,942 | 1,000 | — | — | 21,055 |
İlişkili yapının REML ölçütü tabloda -\text{logLik} olarak alınmıştır. Yalnız kesişimden kesişim + eğime geçiş ölçütü 21,4 birim düşürür: deneklerin artış hızları gerçekten farklıdır. Korelasyon parametresi ölçütü yalnız 0,02 birim düşürür: ilişkisiz yapı bu veride yeterlidir. Faktör-düzgünleştirici ölçütü 3,8 birim daha düşürür; karşılığında her deneğe ayrı bir eğri kestirilir (etkin serbestlik derecesi 37,5).
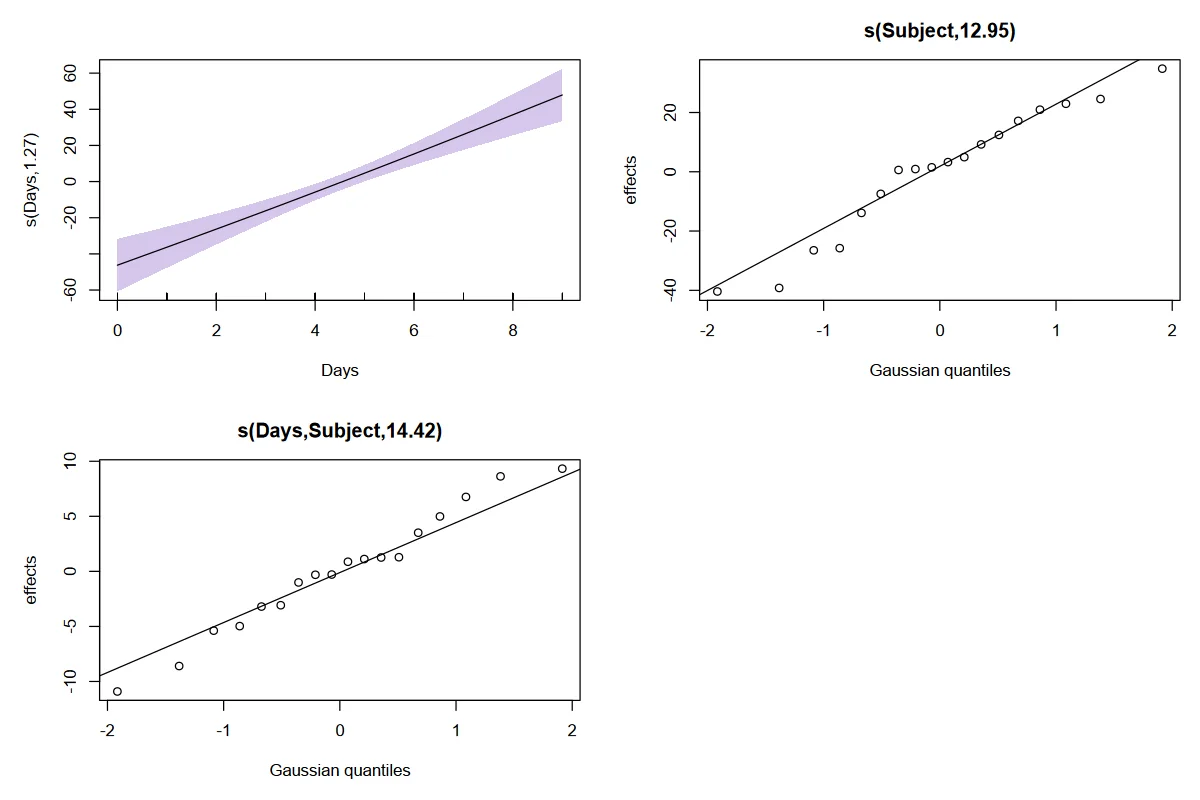
Şekil 48.2. Kesişim + ilişkisiz eğim yapısında şablonun şekli: s(Days) düzgün terimi ile iki rastgele etki teriminin (denek kesişimleri ve eğimleri) normal olasılık grafikleri. Noktaların doğru boyunca dizilmesi rastgele etkilerin normal dağılım varsayımıyla uyumludur.
Rapor cümlesi (örnek ayar):
Tepki süresinin uyku kısıtlaması gününe göre değişimi, gün için ince levha regresyon spline'ı (k = 5) ve denek düzeyinde ilişkili rastgele kesişim ve eğim içeren toplamsal karma modelle REML ile kestirildi (18 denek, 180 gözlem). Günün etkisi anlamlıydı (edf = 1,26; F = 38,26; p < 0,001) ve doğruya çok yakındı: kestirilen ortalama tepki süresi gün 0'da 252,2 ms'den gün 9'da 346,4 ms'ye yükseldi. Denekler arası standart sapma başlangıç düzeyinde 24,8 ms, günlük artış hızında 5,9 ms idi (korelasyon 0,06); artık standart sapma 25,6 ms bulundu. Taban boyutu yeterliydi (k-indeksi = 1,11).
48.8 Sık hatalar ve tuzaklar
- Yapıları AIC ya da R^2 ile karşılaştırmak. İlişkili yapının
logLik,AICveR2_duzsatırları öteki yapılardakilerle aynı tanımda değildir; satır adlarındaki "marjinal, lme" ve "koşullu, gam" ekleri bunu gösterir (48.4.7). Yapı seçimi REML ölçütüyle (ilişkili yapıda -\text{logLik}) yapılır. - REML ölçütüyle sabit kısmı farklı modelleri karşılaştırmak. REML ölçütü yalnız cezalandırılmayan kısmı aynı olan modeller arasında anlamlıdır. Bir doğrusal terimin ya da düzgün terimin eklenip çıkarılması
MLile karşılaştırılır. - Düzgün terimin p değerini "doğrusal değil" diye okumak. Test etkinin tümünü sınar. Doğrusallıktan sapma edf'den (1'e yakınlık) ve doğrusal modelle ML karşılaştırmasından anlaşılır: örnek veride ML ile düzgün terim doğruya iner (edf 1,000) ve log-olabilirlik Days'in doğrusal girdiği modelinkiyle aynıdır (−875,9697); AIC fazladan varyans parametresi yüzünden 2 birim büyüktür (1765,94 ve 1763,94).
- Düzgün terimli ve doğrusal terimli modelin REML ölçütlerini karşılaştırmak. Days doğrusal terimken \ell_R=-871{,}814, düzgün terimken -870{,}739'dur; farkın neredeyse tümü modelden değil, sabit sütunun ölçeğinden gelir: mgcv düzgün terimin doğrusal kısmını \sqrt{8{,}25}'e bölerek kurar ve REML olabilirliği \ln\sqrt{8{,}25}=1{,}055 kadar kayar. REML olabilirliği sabit sütunların ölçeğine bağlıdır; ML bağlı değildir.
- Sabiti x = 0 düzeyi sanmak. Düzgün terimli modelde sabit, genel ortalama düzeydir (48.4.6).
- Birden çok düzgün değişkende k'nın küçülmesi. Az farklı değer alan bir değişken (ör. 6 düzeyli bir ölçüm) yalnız kendi teriminin tabanını küçültür (k_v=\min(k,n_v-1)) ve çıktıya bir not yazılır. Kullanılan k formülden ve denetim tablosundan okunur; az değerli değişken doğrusal terim ya da faktör olarak girilir.
- k-indeksi düşük diye k'yı artırmaya çalışmak. edf, k-1'in çok altındaysa sorun taban boyutu değildir. k, farklı değer sayısıyla sınırlıysa alan büyütülse de değişmez.
- Gruplama faktörünü sayısal bırakmak.
grupalanı kategorik sütun ister; denek numaraları sayısal sütundaysa önce veri sekmesinde türü kategorik yapılır. Sayısal kodlu bir etken doğrusal terimse "Faktör olarak ele alınacak sayısal sütunlar" listesine de eklenir; bu liste yalnız doğrusal terimleri etkiler. - Döngüsel değişkende
tpkullanmak. Ay ya da saat içinccseçilmezse eğrinin iki ucu birleşmez (aralık ile ocak arasında sıçrama). Tensör teriminde döngüsel taban uygulanmaz; döngüsel değişkens()terimi olarak girilir. - Az gruplu veride rastgele etki varyansına güvenmek. Üç–beş grupla varyans bileşeni çok belirsiz kestirilir;
gam.vcomparalıkları bunu gösterir. Güven aralığının alt ve üst sınırı arasında onlarca basamak fark varsa bileşen veriden belirlenememiştir (çoğunlukla edf ≈ 1 olan düzgün terimde ya da sıfıra yakın varyansta). - Faktör-düzgünleştiricide kesişim varyansını yorumlamak. Bu yapıda iki rastgele kesişim birlikte bulunur (48.4.4).
- Sayısal sütunun türünü "kategorik" bırakmak. Yanıt ya da eğim değişkeni kategorik türdeyse şablon açık iletiyle durur; düzgünleştirilen değişken kategorik türdeyse model kurulamaz. Sütun türü sayısal yapılır.
48.9 Uzman soruları
S1. Düzgün terim neden hem "sabit" hem "rastgele" parçaya ayrılıyor?
İkinci türev cezası doğrusal fonksiyonları cezalandırmaz; taban, cezanın sıfır uzayı (sabit ve doğrusal) ile cezalı uzaya ayrılır. Sıfır uzayı için önsel bilgi yoktur, katsayıları sabit etkidir. Cezalı uzayın katsayıları ise "küçük olmaları beklenen" büyüklüklerdir; \lambda\boldsymbol\beta^{\top}\mathbf S\boldsymbol\beta cezası, bu katsayılara N(\mathbf 0,\sigma^2\mathbf S^{-}/\lambda) önseli koymakla aynı olabilirliği verir. Karma model yazılımı bu önseli rastgele etki dağılımı olarak okur. Bağımsız hesapta örnek modelin beş katsayısının etkin serbestlik dereceleri bu ayrımı gösterir: sabit ve doğrusal kısım tam 1, üç kıvrım katsayısı toplam 0,26.
S2. gam() içindeki "re" terimleriyle gamm() arasında sonuç farkı var mı?
Aynı model için yoktur. Days doğrusal ve rastgele etkiler ilişkisizken iki yol da aynı REML olabilirliğini en büyükler. Fark sunulan yapılardadır: bs = "re" terimleri bağımsız rastgele etkiler kurar, kesişim ile eğim arasında korelasyon kestiremez; gamm() yapılandırılmamış kovaryansı kestirir ama Gauss dışı ailelerde cezalı yarı-olabilirliğe dayanır ve şablonda yalnız Gauss ailesiyle sunulur. Örnek veride ilişkili yapı -\ell_R=870{,}739, ilişkisiz yapı 870,759 verir; korelasyon 0,065'tir.
S3. İlişkisiz eğim modeli neden zaman ekseninin başlangıcına duyarlı?
b_{0g}+b_{1g}t modelinde t yerine t-c yazılırsa yeni kesişim b_{0g}+c\,b_{1g} olur; eski kesişim ile eğim bağımsızsa yeni kesişim ile eğim arasındaki kovaryans c\,\sigma_1^2'dir, sıfır değildir. Yani "bağımsız" kısıtı yalnız seçilen başlangıç noktasında geçerlidir ve her öteleme başka bir model tanımlar. Yapılandırılmamış kovaryans bu dönüşüm altında kapalıdır. İlişkisiz yapı kullanılacaksa zaman değişkeninin sıfırı anlamlı bir noktaya (başlangıç ya da ortalama) konur ve seçim raporlanır.
S4. Kesirli serbestlik dereceli F testi nasıl tanımlanıyor; p neden 0?
Wood (2013) testi, terimin kestirilen değerlerinin kovaryans matrisini r=\text{edf} (ya da Ref.df) rankına indirir: en büyük \lfloor r\rfloor özyön tam ağırlıkla, sonraki özyön kesirli ağırlıkla ve bir çapraz terimle girer. Çapraz terimin işareti özvektör işaret kuralına bağlı olduğundan mgcv iki işaretin p değerlerinin ortalamasını alır. Sıfır hipotezi altındaki dağılım, ağırlıklı ki-karelerin toplamıdır (ölçek kestirildiğinde bir ki-kare payda ile); kuyruk olasılığı sayısal olarak hesaplanır ve çok küçük değerlerde tam 0 döner. Örnek veride iki işaret F=38{,}26 ve 34{,}50 verir; yaklaşık p değerleri 10^{-10} düzeyindedir. Test, düzgünleştirme parametresinin belirsizliğini içermez ve p değerleri 0,05 yakınında yaklaşık kabul edilir.
S5. Şekildeki güven bandı neden bu kadar geniş?
Şablon seWithMean = TRUE ile çizer: bant yalnız merkezlenmiş eğrinin değil, sabitin belirsizliğini de taşır. Örnek ayarda sabitin standart hatası 9,05 ms'dir (denekler arası farklar yüzünden) ve bant gün 0'da yaklaşık ±14 ms'den gün 9'da ±29 ms'ye genişler (rastgele eğim nedeniyle belirsizlik günle büyür). Bu bant "ortalama tepki süresi eğrisinin" belirsizliğidir. Sabit çıkarıldığında kalan eğrinin (ortalamadan sapmanın) belirsizliği çok daha dardır; terimin anlamlılığı (F = 38,26) o dar belirsizliğe dayanır. Bantlar noktasaldır; eğrinin tümü için eşzamanlı kapsama vermez.
S6. REML ile ML örnek veride neden farklı eğri veriyor?
REML ile s(Days) edf'si 1,263, ML ile 1,000'dir: ML düzgün terimin varyansını sınıra (sıfır) çeker ve eğriyi doğruya indirir. Varyans bileşenlerinde ML aşağı yanlıdır; sıfıra yakın bir varyansta bu yanlılık kestirimi sınıra oturtmaya yeter. Grup standart sapmaları da ML ile küçüktür (kesişim 23,78 ve 24,75; eğim 5,72 ve 5,92). Varyans bileşenleri ve eğrinin biçimi REML ile raporlanır; ML yalnız sabit kısımları farklı modellerin karşılaştırılması için kullanılır.
S7. Düzgünleştirme parametresi yönünde olabilirlik düzse sonuçlar güvenilir mi?
Düz olan, eğrinin ne kadar kıvrıldığıdır; eğrinin kendisi, sabit etkiler ve grup varyansları iyi belirlenmiştir. Doğrulama tablosunda log-olabilirlik 10^{-9}, grup standart sapmaları 10^{-7} içinde aynıyken edf beşinci basamakta oynar; F istatistiği buna bağlı olarak dördüncü basamakta değişir. Uygulamada sonuç değişmez. Düzlüğün asıl anlamı şudur: veri, "doğru" ile "hafif eğri" arasında güçlü bir ayrım yapmamaktadır; gam.vcomp'un düzgün terim için verdiği çok geniş aralık (ilişkisiz yapıda 0,003–184) aynı şeyi söyler.
S8. k.check'in p değeri neden her çalıştırmada biraz farklı?
p, artıkların 400 rastgele yeniden sıralamasından benzetimle hesaplanır; k-indeksinin kendisi belirlidir (1,1109). Tohum sabitlenirse p de sabitlenir. Tohum alanı boşsa arayüz her çalıştırmaya yeni bir tohum atar; kullanılan tohumu künyeye ve betik adımına yazar (Bölüm 1.3). Örnek modelin ayrı çalıştırmalarında 0,895 ile 0,925 görülmüştür. Karar eşiğine yakın p değerlerinde (0,03–0,08) tek bir çalıştırmaya dayanılmaz; indeksin 1'e uzaklığı ve edf'nin k-1'e yakınlığı birlikte değerlendirilir.
S9. Yayımlanmış lme4 sonucuyla kesişim standart sapması neden dördüncü ondalıkta ayrışıyor?
Bates ve arkadaşları (2015) 24,7407 bildirir; şablon 24,7404, kapalı biçimli REML çözümü 24,74045 verir. Tasarım dengeli olduğundan REML kestirimi kapalı biçimdedir (48.6, Adım 4) ve doğru değer 24,74045'tir; yayımlanmış sayı, o sürümdeki eniyileyicinin durma noktasıdır. Olabilirlik bu yönde düzdür: 3\times10^{-4}'lük fark log-olabilirliği ölçülemeyecek kadar az değiştirir. Güncel lme4, sıkı toleransla 24,740453 verir.
48.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Belenky, G., Wesensten, N. J., Thorne, D. R., Thomas, M. L., Sing, H. C., Redmond, D. P., Russo, M. B., & Balkin, T. J. (2003). Patterns of performance degradation and restoration during sleep restriction and subsequent recovery: A sleep dose-response study. Journal of Sleep Research, 12(1), 1–12. https://doi.org/10.1046/j.1365-2869.2003.00337.x
- Eilers, P. H. C., & Marx, B. D. (1996). Flexible smoothing with B-splines and penalties. Statistical Science, 11(2), 89–121. https://doi.org/10.1214/ss/1038425655
- Lin, X., & Zhang, D. (1999). Inference in generalized additive mixed models by using smoothing splines. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 61(2), 381–400. https://doi.org/10.1111/1467-9868.00183
- Marra, G., & Wood, S. N. (2011). Practical variable selection for generalized additive models. Computational Statistics & Data Analysis, 55(7), 2372–2387. https://doi.org/10.1016/j.csda.2011.02.004
- Pedersen, E. J., Miller, D. L., Simpson, G. L., & Ross, N. (2019). Hierarchical generalized additive models in ecology: An introduction with mgcv. PeerJ, 7, e6876. https://doi.org/10.7717/peerj.6876
- Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer. https://doi.org/10.1007/b98882
- Wood, S. N. (2003). Thin plate regression splines. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 65(1), 95–114. https://doi.org/10.1111/1467-9868.00374
- Wood, S. N. (2006). Low-rank scale-invariant tensor product smooths for generalized additive mixed models. Biometrics, 62(4), 1025–1036. https://doi.org/10.1111/j.1541-0420.2006.00574.x
- Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x
- Wood, S. N. (2013). On p-values for smooth components of an extended generalized additive model. Biometrika, 100(1), 221–228. https://doi.org/10.1093/biomet/ass048
- Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279
- Wood, S. N., Pya, N., & Säfken, B. (2016). Smoothing parameter and model selection for general smooth models. Journal of the American Statistical Association, 111(516), 1548–1563. https://doi.org/10.1080/01621459.2016.1180986