34. İki değişkenli ve özyineli probit
Şablon kimliği: iki_degiskenli_probit · Kategori: model · Dil: R · Dosya: pro/sablonlar/model/iki_degiskenli_probit.R (satır 1–211; üstbilgi 1–76) · Örnek veri: _ornek/school.csv · Paketler: pbivnorm 0.6.0
34.1 Ne işe yarar
Aynı birimde gözlenen iki ikili sonuç çoğu kez gözlenmeyen ortak etkenlerle birbirine bağlıdır: çocuğunu özel okula gönderen hane okul bütçesine nasıl oy verir, sigortası olan kişi sağlık hizmetini daha çok kullanır mı. Şablon iki probit denklemini, hata terimlerinin korelasyonuna izin vererek birlikte kestirir (Ashford ve Sowden 1970; Greene 2018). Cevapladığı soru: "Açıklayıcılar hesaba katıldıktan sonra iki sonucu birlikte iten gözlenmeyen bir bağ (\rho) var mı; ve birinci sonuç ikincisini etkiliyorsa bu etki, o bağdan arındırıldığında ne kadardır?"
- y_{ji}^\ast: gözlenmeyen (gizil) eğilim; yalnız işareti gözlenir. \mathbb 1(\cdot) koşul doğruysa 1, değilse 0.
- \boldsymbol\beta_1, \boldsymbol\beta_2: iki denklemin katsayıları; açıklayıcı kümeleri aynı ya da farklı olabilir. Sabit terim her denkleme kendiliğinden eklenir.
- \gamma: yalnız özyineli seçenekte vardır; birinci sonucun ikinci denklemdeki katsayısıdır. Seçenek kapalıyken \gamma=0 sayılır ve model iki değişkenli (görünüşte ilişkisiz) probittir.
- \rho: iki hatanın korelasyonu. Varyanslar 1'e sabitlenir, çünkü ikili yanıtta gizil ölçek tanımlı değildir.
Ne zaman kullanılır? İki ikili sonuç aynı birimlerde gözlenmişse ve ortak olasılıklar (ikisi birden, yalnız biri) isteniyorsa; iki denklemin hataları ilişkili olabilecekse; ikili bir açıklayıcının (tedavi, üyelik, sigorta) kendisi de gözlenmeyen etkenlerle sonuca bağlıysa (içsellik) ve onu açıklayan, sonuç denkleminde yer almayan en az bir değişken varsa.
Ne zaman kullanılmaz?
- Tek bir ikili sonuç varsa: temel programdaki Probit Regresyon ya da Lojistik Regresyon.
- İçsel açıklayıcı sürekliyse ya da sonuç sürekliyse: araç değişkenli doğrusal modeller ve seçim modelleri gerekir; ikinci sonucun yalnız birinci sonuç 1 iken gözlendiği durum (örneklem seçimi) bu şablonun modeli değildir.
- Üç ya da daha çok ikili sonuç: çok değişkenli probit benzetimli olabilirlik ister; şablon iki sonuçla sınırlıdır.
- Aynı birimden tekrarlı ölçümler (panel): hatalar birimler arasında bağımsız sayılır; kümelenmiş veride
glmer_ileriya da temel programdaki genelleştirilmiş karma modeller kullanılır.
Temel programla ilişki. Temel programın Probit Regresyon analizi tek denklem kestirir. \rho=0 iken bu şablonun olabilirliği iki ayrı probitin olabilirliklerinin çarpımına eşittir; şablon iki tek değişkenli probiti başlangıç değeri ve olabilirlik oranı testinin kısıtlı modeli olarak kendisi kurar (satır 119–124).
34.2 Şablonun girdileri
Form dokuz [[param]] bloğundan kurulur (iki_degiskenli_probit.R:10–75).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Birinci ikili sonuç (0/1) · y1 |
sütun · Değişkenler | ilk sütun | tam iki değerli sütun | y_1; özyineli seçenekte ikinci denkleme girer (94, 110). |
İkinci ikili sonuç (0/1) · y2 |
sütun · Değişkenler | ilk sütun | tam iki değerli sütun | y_2 (94). |
Birinci denklemin açıklayıcıları · x1 |
sütunlar · Değişkenler | — | en az bir sütun | \mathbf x_1; kategorik sütun gösterge değişkenlere açılır (96–109). |
İkinci denklemin açıklayıcıları · x2 |
sütunlar · Değişkenler | — | en az bir sütun | \mathbf x_2 (109). |
Özyineli · ozyineli |
onay · Model | kapalı | açık / kapalı | y_1 sütunu \mathbf X_2'ye eklenir (110); ortak olasılıklar hücrenin kendi y_1 değeriyle kurulur (197–202). |
Kovaryans matrisi · kovaryans |
seçim · Seçenekler | gozlenen |
gozlenen, sandvic, opg |
Standart hataların kaynağı (158–166). |
Güven düzeyi (%) · guven |
ondalık · Seçenekler | 95 | 50–99,9 | z çarpanı (174). Yüzde olarak girilir. |
En çok BFGS yinelemesi · en_cok_yineleme |
tamsayı · Gelişmiş | 2000 | 10–100000 | optim(maxit =) (153). |
Yakınsama toleransı (göreli) · tolerans |
ondalık · Gelişmiş | 10^{-14} | 10^{-16} – 10^{-4} | optim(reltol =); inceltmede onda biri (153, 156). |
BFGS sonrası nlminb ile incelt · nlminb_incelt |
onay · Gelişmiş | açık | açık / kapalı | İkinci en büyükleme adımı (156–157). |
Örnek ayar (ornek_param, satır 9): y1 = private, y2 = vote, x1 = x2 = [years, logptax, loginc], ozyineli = false. Öteki alanlar varsayılandadır.
Şablonun kendi denetimleri:
| Koşul | İleti (özet) | Satır |
|---|---|---|
| İki sonuç aynı sütun | "İki sonuç farklı sütunlar olmalı." | 81 |
| Bir denklemde sonuçlar dışında açıklayıcı kalmıyor | "Her denkleme sonuçlardan farklı en az bir açıklayıcı seçin." | 83 |
| Tam satır sayısı 20'den az | "En az 20 tam satır gerekli." | 87 |
| Sonuç tam iki değer almıyor | "'…' tam iki değer almalı (ikili sonuç)." | 91 |
| Açıklayıcı sabit ya da tek düzeyli | "'…' sabit (tek düzeyli); açıklayıcılardan çıkarın." | 101–102 |
| Tasarım matrisi tam ranklı değil | "Açıklayıcılar doğrusal bağımlı…"; "İkinci denklemin tasarım matrisi tam ranklı değil." | 106, 111 |
Tek değişkenli probit ya da optim hata verdi |
"Tek değişkenli probit kurulamadı: …"; "Model kurulamadı: …" | 119–120, 153–154 |
| Hessian tersinir değil ya da köşegeni pozitif değil | "Bilgi matrisi tekil; model tanımlanamıyor…" | 160 |
| Sandviç/OPG matrisi hesaplanamadı | "Seçilen kovaryans matrisi hesaplanamadı…" | 165 |
Yukarıdaki koşullar çalıştırmayı durdurur. İki koşul ise durdurmaz; sonuçlar yazılır, konsolda tabloların üstünde uyarı çıkar:
| Koşul | Uyarı (özet) | Satır |
|---|---|---|
| Kestirim noktasında ölçeklenmiş gradyan \mathbf g'\mathbf V\mathbf g>10^{-6} ya da sonlu değil | "UYARI: en büyükleme YAKINSAMADI (ölçeklenmiş gradyan g'Vg = …; yakınsamada 0'a yakın olmalı). Sonuçlar en çok olabilirlik kestirimi değildir; yineleme sınırını artırın ya da modeli sadeleştirin." | 161, 170–171 |
| \lvert\hat\rho\rvert>0{,}99 | "UYARI: ρ kestirimi sınıra (±1) dayandı. Olabilirlik ρ yönünde düzleşmiştir; ρ, güven aralığı ve katsayılar (özyineli modelde özellikle birinci sonucun katsayısı) güvenilir değildir…" | 172–173 |
Sonuç sütunları açıklayıcı listelerinden kendiliğinden çıkarılır (82). Eksik değer: seçilen sütunlardan birinde eksik olan satır atılır (85). Kestirim sırasında çıkan R uyarıları toplanır ve çıktının sonunda "Uyarılar:" satırında yazılır (121, 155, 206).
Hangi değer "1" sayılır?
Sonuç sütunu sayısalsa küçük değer 0, büyük değer 1 alınır; metin ya da kategorik sütunda ikinci düzey 1 alınır (satır 90–92): metin sütununda alfabetik sırada ikinci, kategorik türde arayüzün düzey sırasında ikinci (Bölüm 1.3). "evet/hayır" kodlu bir sütunda modellenen olay "hayır" olur; bütün katsayıların ve sonuçlardan yalnız biri çevrildiyse \rho'nun işareti ters okunur. Konsolun ikinci satırı iki sonuçta 1 alınan düzeyi yazar (95, 169): "1 olarak modellenen düzey: private = '1'; vote = '1'". Katsayılar okunmadan önce bu satıra bakılır; istenen olay 1 alınmamışsa sonuç çözümlemeden önce 0/1 kodlanır.
34.3 Örnek veri
Dosya: _ornek/school.csv. Pindyck ve Rubinfeld'in (1998) okul bütçesi oylaması verisidir: 95 hane, eksik değer yok.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
private |
Birinci sonuç y_1 | ikili | 1 = çocuk özel okulda; 10 hane (%10,5) |
vote |
İkinci sonuç y_2 | ikili | 1 = vergi artışına evet; 59 hane (%62,1) |
years |
Açıklayıcı | sayısal | Toplulukta yaşanan yıl; 1–49, ortalama 8,5 |
logptax |
Açıklayıcı | sayısal | Log emlak vergisi; 5,99–7,50 |
loginc |
Açıklayıcı | sayısal | Log gelir; 8,29–10,82 |
obs, pub12, pub34, pub5, school, logeduc |
Kullanılmıyor | sayısal / ikili | — |
İki sonucun çapraz tablosu:
vote = 0 |
vote = 1 |
|
|---|---|---|
private = 0 |
31 | 54 |
private = 1 |
5 | 5 |
Özel okul hücreleri çok küçüktür (5 ve 5 hane); bu, \rho'nın ne kadar kesin kestirilebileceğini baştan sınırlar. Sonuçlar 0/1 kodlu olduğundan düzey sırası sorunu yoktur.
Özyineli seçenek için örnek veri uygun değildir (34.8). Bu seçenek, gerçek parametreleri bilinen bir benzetim verisiyle gösterilmiştir (dogrulama/iki_degiskenli_probit/ozyineli_benzetim.csv, n=1500, tohum sabit): tedavi^\ast=-0{,}3+0{,}5x+0{,}9\,\text{arac}+\varepsilon_1, sonuc^\ast=0{,}2+0{,}6x+0{,}8\,\text{tedavi}+\varepsilon_2, \rho=-0{,}5. arac yalnız birinci denklemdedir.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) aynısı, sandviç kovaryans; (3) aynısı, OPG kovaryans; (4) benzetim verisi, özyineli (x1 = [x, arac], x2 = [x]); (5) örnek veri, özyineli, x2 = [years, logptax] (sınır çözümü örneği); (6) örnek veri, özyineli, x1 = x2 (dışlama kısıtsız model). Sütun türleri veri sekmesinin algıladığı gibidir.
34.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) sonuçları 0/1'e, açıklayıcıları tasarım matrislerine çevir; (2) iki tek değişkenli probit kur (başlangıç ve kısıtlı model); (3) iki değişkenli olabilirliği \operatorname{atanh}\rho parametresiyle en büyükle; (4) kovaryans matrisini seçilen türde kur; (5) \rho'yu, testleri ve ortak olasılıkları hesapla.
34.4.1 Olabilirlik
Dört olası sonuç çifti tek bir ifadeyle yazılır. q_{ji}=2y_{ji}-1 (sonuç 1 ise +1, 0 ise -1) ile:
- \Phi_2: standart iki değişkenli normal dağılım fonksiyonu. P(y_1=1,y_2=1)=\Phi_2(\mathbf x_1'\boldsymbol\beta_1,\mathbf x_2'\boldsymbol\beta_2;\rho)'dur; öteki üç hücre, ilgili hatanın işareti çevrilerek aynı fonksiyonla yazılır. q çarpanları bu işaret çevirmesini yapar; yalnız bir sonuç 0 ise korelasyonun işareti de döner (\rho^\ast=-\rho).
- \boldsymbol\theta=(\boldsymbol\beta_1,\boldsymbol\beta_2,a), a=\operatorname{atanh}\rho. Özyineli seçenekte \mathbf x_2'nin son sütunu y_1, \boldsymbol\beta_2'nin son öğesi \gamma'dır.
- \rho=0 iken \Phi_2(a,b;0)=\Phi(a)\Phi(b): olabilirlik iki tek değişkenli probitin toplamına iner.
Neden ρ yerine atanh ρ?
\rho yalnız (-1{,}1) aralığında tanımlıdır; kısıtsız bir en büyükleme algoritması aralığın dışına adım atabilir. a=\operatorname{atanh}\rho=\tfrac12\ln\frac{1+\rho}{1-\rho} bütün gerçek eksende serbestçe gezer ve \rho=\tanh a her zaman aralığın içinde kalır. Güven aralığı da bu ölçekte kurulup geri dönüştürülür; böylece aralık \pm1'i aşmaz ve küçük örneklemde \rho'nın çarpık dağılımını daha iyi yansıtır.
Neden özyineli modelde ayrı bir olabilirlik gerekmiyor?
y_1 ikinci denkleme girdiğinde sistem "üçgen" yapıdadır: y_1 yalnız kendi denkleminden, y_2 ise y_1 verildiğinde kendi denkleminden belirlenir. Ortak olasılık P(y_1,y_2\mid\mathbf x) yine iki hatanın bir dikdörtgene düşme olasılığıdır; yalnız ikinci eşik y_1'in gözlenen değerine bağlıdır. Bu yüzden y_1'i \mathbf x_2'ye sıradan bir sütun gibi eklemek tam bilgi olabilirliğini doğru verir (Maddala 1983; Wilde 2000). İçsellik \rho ile yakalanır: \rho\ne0 ise tek denklemli probit \gamma'yı tutarsız kestirir.
Koddaki tercih
\Phi_2, pbivnorm::pbivnorm(a, b, rho) ile hesaplanır (satır 126); bu fonksiyon Genz'in (2004) çift duyarlıklı algoritmasının vektörleştirilmiş çağrısıdır. Logaritma alınmadan önce değer 10^{-300} ile alttan sınırlanır (126): çok uç gözlemlerde olabilirlik -\infty olmaz, yaklaşık -690'lık sonlu bir ceza alır.
34.4.2 Gradyan ve en büyükleme
- \phi, \Phi: tek değişkenli standart normal yoğunluk ve dağılım fonksiyonu. \phi_2: iki değişkenli normal yoğunluk.
- g_{1i}: \Phi_2'nin birinci değişkene göre türevi; birinci hatanın eşikte olma yoğunluğu ile ikinci hatanın, birinci verildiğinde, eşiğin altında kalma olasılığının çarpımı. \boldsymbol\beta_2 için ifade simetriktir.
- Son türev Plackett'in (1954) özdeşliğinden gelir: \partial\Phi_2/\partial\rho=\phi_2. (1-\rho^2) çarpanı d\rho/da'dır.
Koddaki tercih
Başlangıç: iki tek değişkenli probitin katsayıları ve a=0 (satır 151). En büyükleme iki aşamalıdır: optim(method = "BFGS", reltol = tolerans) (153), ardından nlminb ile inceltme (156); inceltmenin sonucu yalnız amaç fonksiyonunu kötüleştirmiyorsa kabul edilir (157). Varsayılan tolerans 10^{-14} çok sıkıdır; amaç, yayımlanmış sonuçlarla yedi sekiz basamak tutacak kestirimdir. Yakınsama, varılan noktada ölçeklenmiş gradyanla denetlenir: \mathbf g'\mathbf V_{\text{göz}}\,\mathbf g (\mathbf g gradyan, \mathbf V_{\text{göz}} gözlenen bilginin tersi; satır 161) en büyük noktada sıfıra yakındır; 10^{-6}'yı aşıyorsa konsola "en büyükleme YAKINSAMADI" uyarısı yazılır (170–171) ve sonuçlar en çok olabilirlik kestirimi sayılmaz.
34.4.3 Kovaryans matrisi
- \mathbf H: gözlenen bilgi (eksi Hessian), kestirim noktasında. \mathbf s_i: i. gözlemin skoru (log-olabilirlik katkısının gradyanı). \mathbf B: skorların dış çarpımları toplamı.
- Model doğru belirlenmişse üçü de aynı matrisi kestirir; büyük örneklemde yakınsarlar. Sandviç (Huber–White), dağılım varsayımı tam tutmasa da skor denklemleri doğruysa geçerli kalır (White 1982); yalnız standart hataları düzeltir, katsayıları değil.
Koddaki tercih
\mathbf H, optimHess(th, negll, grad, control = list(ndeps = …)) ile, analitik gradyanın sayısal türevinden alınır (satır 158); türev adımı her parametre için 10^{-5}'tir. Koşul sayısı kötü olan örnek veride de (sabit terimin SH'si 4,8) bu adımla standart hatalar, Hessian'ı başka şemalarla alan iki bağımsız hesapla yedi anlamlı basamakta aynıdır (34.6.1). \mathbf B analitik skorlardan kurulur, sayısal türev içermez (162–164); sandviç matrisinin iki yanındaki \mathbf H^{-1} aynı sayısal Hessian'dan gelir.
34.4.4 ρ, testler ve ortak olasılıklar
- \ell_1, \ell_2: iki tek değişkenli probitin log-olabilirlikleri; toplamları \rho=0 kısıtlı modelin log-olabilirliğidir. Özyineli seçenekte ikinci probit y_1'i açıklayıcı olarak içerir; bu durumda LR, y_1'in dışsallığının testidir.
- \hat{\boldsymbol\beta}_e: iki denklemin sabit terimleri dışındaki bütün katsayıları (özyineli seçenekte \gamma dahil); k_e sayıları. W, "hiçbir açıklayıcının etkisi yok" hipotezinin ortak Wald testidir ve seçilen kovaryans türüyle hesaplanır (satır 185–186).
- z ve p sütunları her katsayı için \hat\theta/\operatorname{SH} ve iki yanlı normal olasılıktır (177).
Ortak olasılıklar tablosu dört hücre için gözlemler üzerinden ortalama kestirilen olasılığı gözlenen sıklıkla yan yana verir (satır 193–205). Özyineli olmayan modelde (194–196):
Özyineli modelde ikinci denklemin indeksi hücrenin kendi y_1 değerine bağlıdır; dört hücre ayrı ayrı yazılır (197–202):
- \tilde e_{2i}: ikinci denklemin y_1 sütunu dışındaki açıklayıcılarla kurulan indeksi (\mathbf X_2'den y_1 sütunu, \hat{\boldsymbol\beta}_2'den \hat\gamma çıkarılır). y_1=1 hücrelerinde \hat\gamma eklenir, y_1=0 hücrelerinde eklenmez.
- Tabloya her hücrenin gözlemler üzerinden ortalaması girer; dört ortalamanın toplamı 1'dir.
Koddaki tercih
Özyineli seçenekte ikinci indeks y_{1i}'nin gözlenen değeriyle değil, hücrenin tanımladığı y_1 değeriyle kurulur (satır 199); böylece tablo ve şekil iki seçenekte de modelin hücre olasılıklarını gösterir ve gözlenen sıklıklarla doğrudan karşılaştırılır. Benzetim verisinde ortalama olasılıklar 0,3296 / 0,1008 / 0,3575 / 0,2121, gözlenen sıklıklar 0,3287 / 0,1013 / 0,3580 / 0,2120'dir; iki bağımsız hesap aynı değerleri verir (34.6.1).
34.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–76 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, 9 parametre. | Form buradan kurulur (Bölüm 1.2). |
| 77–87 | pbivnorm yüklenir; sütun denetimleri; eksiksiz satırlar. | Sonuç sütunları açıklayıcılardan çıkarılır (82). |
| 88–95 | ikili(): sonucu 0/1'e çevirir; 1 alınan düzeyin adını saklar. |
İkinci değer/düzey 1 alınır (92); iki sonucun düzey adları konsol satırı için tutulur (95). |
| 96–111 | tasarim(): model.matrix ile tasarım matrisi, sabitlik ve rank denetimi; özyineli seçenekte y_1 eklenir. |
Kategorik açıklayıcı gösterge değişkenlere açılır; ilk düzey referanstır. |
| 112–124 | Seçenekler; iki tek değişkenli probit (glm.fit), toplam log-olabilirlik. |
epsilon = 1e-12 ile sıkı yakınsama (119). |
| 125–150 | Olabilirlik (negll), analitik gradyan (grad), gözlem başına skor (skor). |
Üçü de aynı w, \rho^\ast tanımlarını kullanır. |
| 151–161 | BFGS, nlminb inceltmesi, optimHess (adım 10^{-5}), ters matris ve tekillik denetimi, yakınsama ölçütü. |
Köşegende pozitif olmayan varyans → durur (160). Ölçüt \mathbf g'\mathbf V\mathbf g'dir; \mathbf V burada gözlenen bilginin tersidir (161). |
| 162–168 | Sandviç/OPG, standart hatalar, log-olabilirlik; konsolun ilk satırı. | Sandviç ve OPG seçilince \mathbf V değişir; yakınsama ölçütü bundan önce hesaplanır. |
| 169–173 | "1 olarak modellenen düzey" satırı; yakınsama ve sınır uyarıları. | Uyarılar çalıştırmayı durdurmaz; ölçüt 10^{-6} (170), \lvert\hat\rho\rvert>0{,}99 (172). |
| 174–182 | z çarpanı, katsayı tablosu. | Tablonun son satırı \operatorname{atanh}\rho'dur, \rho değil. |
| 183–192 | \rho ve model testleri tablosu: delta SH, dönüştürülmüş GA, LR, Wald, AIC. | AIC =-2\ell+2(k_1+k_2+1). |
| 193–205 | Ortak olasılıklar: özyineli olmayan modelin hücreleri (194–196), özyineli modelin hücre olasılıkları (197–202), gözlenen sıklıklar ve tablo (203–205). | Özyineli seçenekte ikinci indeks hücrenin kendi y_1 değeriyle kurulur (199). |
| 206–211 | R uyarıları satırı, çubuk grafik. | Mor çubuk model, gri çubuk gözlenen. |
34.6 Elle hesap: örnek veride bağımsız yeniden hesap
Değerler dogrulama/iki_degiskenli_probit/elle_hesap.py ile, pbivnorm ve optim kullanılmadan hesaplanmıştır. \Phi_2 Plackett özdeşliğinden tek boyutlu integral olarak yazılmış ve 96 düğümlü Gauss–Legendre karelemesiyle alınmıştır:
En büyükleme, analitik gradyan ve gradyanın merkezî farkından (h=10^{-5}) alınan Hessian ile Newton–Raphson'dur. R tarafında (r_dogrulama.R) \Phi_2 mvtnorm::pmvnorm ile, Hessian analitik gradyanın numDeriv (Richardson) türeviyle hesaplanmış; katsayılar ayrıca VGAM::vglm(binom2.rho) (Yee 2015) ile denetlenmiştir.
Adım 1 — Tek değişkenli probitler. private: \ell_1=-31{,}448958; vote: \ell_2=-58{,}497288; toplam -89{,}946246. Bu, \rho=0 noktasında iki değişkenli log-olabilirliğin değeridir.
Adım 2 — Tek gözlemin katkısı. İlk hane: private = 0, vote = 1; kestirim noktasında \mathbf x'\hat{\boldsymbol\beta}_1=-1{,}380009, \mathbf x'\hat{\boldsymbol\beta}_2=-0{,}033527. q_1=-1, q_2=+1 olduğundan w_1=1{,}380009, w_2=-0{,}033527, \rho^\ast=-\hat\rho=0{,}269619:
Bağımsızlık altında aynı olasılık \Phi(1{,}380009)\,\Phi(-0{,}033527)=0{,}445852 olurdu; negatif \rho "özel okula göndermeyip evet oyu verme" hücresini büyütür.
Adım 3 — En büyükleme. Newton–Raphson beş yinelemede yakınsar; en büyük skor bileşeni 2\times10^{-13}'tür.
| Terim | private denklemi |
vote denklemi |
|---|---|---|
| Sabit | −4,184694 | −0,536057 |
years |
−0,011888 | −0,016856 |
logptax |
−0,106696 | −1,288707 |
loginc |
0,376204 | 0,998286 |
\hat a=-0{,}276453, \ell=-89{,}254028.
Adım 4 — ρ. \hat\rho=\tanh(-0{,}276453)=-0{,}269619. \operatorname{SH}(\hat a)=0{,}241210; delta yöntemiyle \operatorname{SH}(\hat\rho)=(1-0{,}269619^2)\cdot0{,}241210=0{,}223675. %95 aralık: \tanh(-0{,}276453\pm1{,}959964\cdot0{,}241210)=[-0{,}634681;\ 0{,}193827].
Adım 5 — Testler. \text{LR}=2\,(-89{,}254028+89{,}946246)=1{,}384437, p=0{,}239347. Altı eğimin ortak Wald istatistiği gözlenen bilgiyle 9{,}587699 (p=0{,}1431), sandviçle 14{,}134315, OPG ile 7{,}446828'dir: 95 gözlemde üç kovaryans kestirimi birbirinden hayli uzaktır.
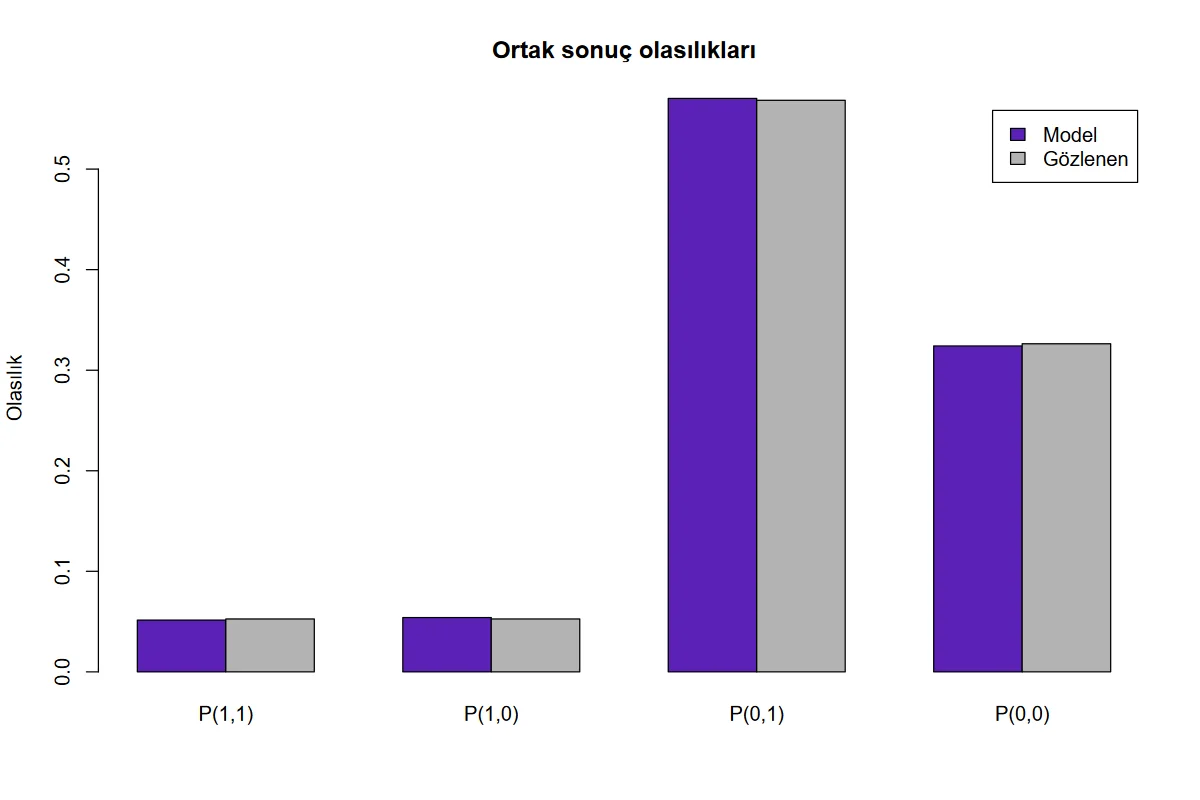
Adım 6 — Ortak olasılıklar. Ortalama kestirilen olasılıklar 0,051496 / 0,054034 / 0,570317 / 0,324152; gözlenen sıklıklar 5/95, 5/95, 54/95, 31/95 = 0,0526 / 0,0526 / 0,5684 / 0,3263.
Adım 7 — Özyineli model (benzetim verisi). Aynı kod \mathbf X_2=[1,\ x,\ \text{tedavi}] ile çalıştırılır. Kestirimler (gerçek değerler parantezde): birinci denklem -0{,}3274 (-0{,}3), 0{,}4474 (0{,}5), 1{,}0132 (0{,}9); ikinci denklem 0{,}2872 (0{,}2), 0{,}6266 (0{,}6), \hat\gamma=0{,}6138 (0{,}8; SH 0,1237); \hat\rho=-0{,}4296 (-0{,}5; %95 GA [-0{,}580;\ -0{,}251]). \ell=-1459{,}1749; kısıtlı model -1469{,}8805; \text{LR}=21{,}41, p=3{,}7\times10^{-6}: tedavi dışsal değildir. Hücrenin kendi y_1 değeriyle kurulan ortalama hücre olasılıkları (34.4.4) 0,329649 / 0,100782 / 0,357491 / 0,212078; gözlenen sıklıklar 0,3287 / 0,1013 / 0,3580 / 0,2120. Dışsallık varsayan tek denklemli probit aynı veride \gamma'yı 0{,}118 kestirir; gerçek etkinin yedide biridir.
34.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–4).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| private: sabit | −4,18469381 | −4,1846938 | −4,1846938 | 7,7e−10 | ✓ |
| private: years | −0,01188841 | −0,01188841 | −0,01188841 | 6,5e−10 | ✓ |
| private: logptax | −0,1066962 | −0,1066962 | −0,1066962 | 4,1e−9 | ✓ |
| private: loginc | 0,37620367 | 0,37620367 | 0,37620367 | 3,0e−9 | ✓ |
| vote: sabit | −0,53605721 | −0,5360572 | −0,5360572 | 4,1e−9 | ✓ |
| vote: years | −0,01685607 | −0,01685607 | −0,01685607 | 5,6e−10 | ✓ |
| vote: logptax | −1,28870724 | −1,28870725 | −1,28870725 | 2,1e−9 | ✓ |
| vote: loginc | 0,99828597 | 0,99828597 | 0,99828597 | 1,6e−9 | ✓ |
| atanh(\rho) | −0,27645254 | −0,27645254 | −0,27645254 | 2,9e−10 | ✓ |
| SH (gözlenen bilgi) private: sabit | 4,83781677 | 4,83781676 | 4,83781676 | 3,8e−9 | ✓ |
| SH (gözlenen bilgi) private: years | 0,02567778 | 0,02567778 | 0,02567778 | 3,3e−10 | ✓ |
| SH (gözlenen bilgi) private: logptax | 0,66697815 | 0,66697815 | 0,66697815 | 2,4e−9 | ✓ |
| SH (gözlenen bilgi) private: loginc | 0,53064836 | 0,53064836 | 0,53064836 | 2,4e−9 | ✓ |
| SH (gözlenen bilgi) vote: sabit | 4,06850877 | 4,06850877 | 4,06850876 | 5,0e−10 | ✓ |
| SH (gözlenen bilgi) vote: years | 0,01478336 | 0,01478336 | 0,01478336 | 2,3e−11 | ✓ |
| SH (gözlenen bilgi) vote: logptax | 0,57522655 | 0,57522655 | 0,57522655 | 9,3e−10 | ✓ |
| SH (gözlenen bilgi) vote: loginc | 0,44035648 | 0,44035648 | 0,44035648 | 2,5e−10 | ✓ |
| SH (gözlenen bilgi) atanh(\rho) | 0,24120991 | 0,24120991 | 0,24120992 | 3,2e−10 | ✓ |
| SH (sandviç) vote: logptax | 0,50569757 | 0,50569757 | 0,50569757 | 2,0e−9 | ✓ |
| SH (sandviç) vote: loginc | 0,41143271 | 0,41143271 | 0,41143272 | 1,3e−9 | ✓ |
| SH (sandviç) atanh(\rho) | 0,22904958 | 0,22904958 | 0,22904958 | 5,2e−10 | ✓ |
| SH (OPG) vote: logptax | 0,74714109 | 0,74714109 | 0,74714109 | 1,1e−9 | ✓ |
| SH (OPG) vote: loginc | 0,51273143 | 0,51273143 | 0,51273143 | 1,0e−9 | ✓ |
| SH (OPG) atanh(\rho) | 0,32997869 | 0,32997869 | 0,32997869 | 1,0e−9 | ✓ |
| log-olabilirlik | −89,25402761 | −89,25402761 | −89,25402761 | 3,2e−16 | ✓ |
| tek değişkenli probitlerin toplam log-olabilirliği | −89,94624601 | −89,94624601 | −89,94624601 | 1,0e−14 | ✓ |
| LR (\rho=0) | 1,38443679 | 1,38443679 | 1,38443679 | 1,3e−12 | ✓ |
| LR p | 0,23934684 | 0,23934684 | 0,23934684 | 3,1e−13 | ✓ |
| \hat\rho | −0,26961866 | −0,26961866 | −0,26961866 | 2,7e−10 | ✓ |
| \hat\rho SH (delta) | 0,22367535 | 0,22367535 | 0,22367535 | 3,4e−10 | ✓ |
| \rho GA alt | −0,63468057 | −0,63468057 | −0,63468057 | 2,1e−10 | ✓ |
| \rho GA üst | 0,1938267 | 0,1938267 | 0,1938267 | 8,9e−10 | ✓ |
| Eğimler Wald \chi^2 (gözlenen bilgi) | 9,58769912 | 9,58769901 | 9,58769901 | 1,1e−8 | ✓ |
| Eğimler Wald \chi^2 (sandviç) | 14,13431452 | 14,13431451 | 14,13431445 | 4,8e−9 | ✓ |
| Eğimler Wald \chi^2 (OPG) | 7,44682853 | 7,44682835 | 7,44682835 | 2,4e−8 | ✓ |
| AIC | 196,50805522 | 196,50805522 | 196,50805522 | 8,7e−16 | ✓ |
| Ortalama ortak olasılık P(1,1) | 0,05149649 | 0,05149649 | 0,05149649 | 1,0e−9 | ✓ |
| Ortalama ortak olasılık P(1,0) | 0,05403426 | 0,05403427 | 0,05403427 | 5,2e−10 | ✓ |
| Ortalama ortak olasılık P(0,1) | 0,570317 | 0,57031701 | 0,57031701 | 1,3e−9 | ✓ |
| Ortalama ortak olasılık P(0,0) | 0,32415224 | 0,32415223 | 0,32415223 | 2,9e−9 | ✓ |
| Özyineli · tedavi: sabit | −0,32743178 | −0,32743178 | −0,32743178 | 3,1e−10 | ✓ |
| Özyineli · tedavi: x | 0,44736224 | 0,44736224 | 0,44736224 | 6,3e−10 | ✓ |
| Özyineli · tedavi: arac | 1,0131961 | 1,0131961 | 1,0131961 | 4,2e−10 | ✓ |
| Özyineli · sonuc: sabit | 0,28717351 | 0,28717351 | 0,28717351 | 8,3e−10 | ✓ |
| Özyineli · sonuc: x | 0,62659365 | 0,62659365 | 0,62659365 | 6,1e−10 | ✓ |
| Özyineli · sonuc: tedavi (\gamma) | 0,61381598 | 0,61381599 | 0,61381599 | 4,0e−10 | ✓ |
| Özyineli · atanh(\rho) | −0,45944595 | −0,45944595 | −0,45944595 | 6,7e−10 | ✓ |
| Özyineli · SH sonuc: tedavi (\gamma) | 0,12374002 | 0,12374002 | 0,12374002 | 1,2e−10 | ✓ |
| Özyineli · SH atanh(\rho) | 0,10365088 | 0,10365088 | 0,10365088 | 1,5e−10 | ✓ |
| Özyineli · log-olabilirlik | −1459,17490665 | −1459,17490665 | −1459,17490665 | 3,3e−15 | ✓ |
| Özyineli · LR (\rho=0) | 21,41119674 | 21,41119674 | 21,41119674 | 6,3e−14 | ✓ |
| Özyineli · \hat\rho | −0,42963254 | −0,42963254 | −0,42963254 | 5,5e−10 | ✓ |
| Özyineli · ortalama ortak olasılık P(1,1) | 0,32964919 | 0,32964919 | 0,32964919 | 2,2e−10 | ✓ |
| Özyineli · ortalama ortak olasılık P(1,0) | 0,10078208 | 0,10078208 | 0,10078208 | 1,3e−10 | ✓ |
| Özyineli · ortalama ortak olasılık P(0,1) | 0,3574911 | 0,3574911 | 0,3574911 | 1,2e−10 | ✓ |
| Özyineli · ortalama ortak olasılık P(0,0) | 0,21207763 | 0,21207763 | 0,21207763 | 2,1e−10 | ✓ |
Ölçütü karşılayan: 56/56. Python: Plackett özdeşliğiyle \Phi_2 (96 düğümlü Gauss–Legendre), analitik gradyan ve gradyanın merkezî farkından Hessian ile Newton–Raphson. R: mvtnorm::pmvnorm (TVPACK) ile \Phi_2, optim ve numDeriv (Richardson) Hessian'ı. Özyineli modelin ortak olasılıkları iki bağımsız hesapta hücrenin kendi y_1 değeriyle kurulmuştur (34.4.4).
34.7 Çıktıyı okuma
Örnek ayarın konsol satırı ve tabloları (kısaltılmış):
İki değişkenli probit: n = 95, logLik = -89,254028
1 olarak modellenen düzey: private = '1'; vote = '1'

İki değişkenli probit katsayıları (gözlenen bilgi SH)
denklem        terim  kestirim      SH        z       p    GA_alt   GA_ust
private  (Intercept)   -4.1847  4.8378  -0.8650  0.3870  -13.6666   5.2973
private        years   -0.0119  0.0257  -0.4630  0.6434   -0.0622   0.0384
private      logptax   -0.1067  0.6670  -0.1600  0.8729   -1.4139   1.2006
private       loginc    0.3762  0.5306   0.7090  0.4784   -0.6638   1.4163
   vote  (Intercept)   -0.5361  4.0685  -0.1318  0.8952   -8.5102   7.4381
   vote        years   -0.0169  0.0148  -1.1402  0.2542   -0.0458   0.0121
   vote      logptax   -1.2887  0.5752  -2.2403  0.0251   -2.4161  -0.1613
   vote       loginc    0.9983  0.4404   2.2670  0.0234    0.1352   1.8614
      ρ     atanh(ρ)   -0.2765  0.2412  -1.1461  0.2518   -0.7492   0.1963

Hata korelasyonu ρ ve model testleri
ρ -0.2696 · ρ SH (delta) 0.2237 · ρ GA alt -0.6347 · ρ GA üst 0.1938 · n 95
logLik -89.2540 · tek değişkenli probitlerin toplam logLik -89.9462 · LR (ρ = 0) 1.3844 · LR p 0.2393
eğimler Wald χ² 9.5877 · Wald sd 6 · Wald p 0.1431 · AIC 196.5081

Ortak olasılıklar (private, vote)
 hucre  ortalama_kestirim  gozlenen
P(1,1)             0.0515    0.0526
P(1,0)             0.0540    0.0526
P(0,1)             0.5703    0.5684
P(0,0)             0.3242    0.3263
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
1 olarak modellenen düzey |
İki sonuçta 1 (olay) alınan düzey | Katsayıların ve \rho'nun yönü bu düzeylere göre okunur (34.2). |
UYARI: satırları (varsa) |
En büyüklemenin yakınsamadığı ya da \hat\rho'nın sınıra dayandığı | Uyarı varken katsayılar, standart hatalar ve testler raporlanmaz (34.2, 34.8). |
| Katsayı tablosu | Her denklemin katsayıları, SH, z, p, GA; tablo başlığı SH'nin türünü yazar | Katsayılar gizil ölçektedir: işaret ve anlamlılık okunur; olasılık üzerindeki etki ayrıca hesaplanır. |
Son satır atanh(ρ) |
\hat a ve SH'si | z ve p değeri H_0{:}\ \rho=0 için Wald testidir; LR testiyle aynı soruyu sorar. |
ρ, ρ SH (delta), ρ GA |
Geri dönüştürülmüş korelasyon | Aralık \hat\rho çevresinde simetrik değildir; 0'ı içeriyorsa ortak modele gerek yoktur. |
LR (ρ = 0), LR p |
İki ayrı probite karşı olabilirlik oranı testi | Özyineli seçenekte y_1'in dışsallık testi. |
eğimler Wald χ² |
Sabitler dışındaki bütün katsayıların ortak testi | Kovaryans seçeneğine göre değişir. |
| Ortak olasılıklar | Dört hücrenin ortalama kestirilen ve gözlenen olasılığı | Yakınlık, modelin iki sonucun ortak dağılımını yakaladığını gösterir; özyineli seçenekte de modelin hücre olasılıklarıdır (34.4.4). |
Örnek veride vote denkleminde emlak vergisi evet oyu eğilimini azaltır, gelir artırır; private denkleminde hiçbir açıklayıcı anlamlı değildir. \hat\rho negatiftir ama aralığı 0'ı içerir: iki ayrı probit bu veri için yeterlidir.
Şekil 34.1. Şablonun şekli (örnek ayar): dört sonuç çiftinin ortalama kestirilen (mor) ve gözlenen (gri) olasılıkları.
Rapor cümlesi (örnek ayar):
Özel okul tercihi ile vergi artışına evet oyu, yaşanan yıl, log emlak vergisi ve log gelirin açıklayıcı olduğu iki değişkenli probit modeliyle birlikte kestirildi (n = 95; log-olabilirlik −89,25). Oy denkleminde log emlak vergisinin katsayısı −1,29 (SH 0,58; p = 0{,}025), log gelirin katsayısı 1,00 (SH 0,44; p = 0{,}023) bulundu. Hata korelasyonu \hat\rho = -0{,}27 (%95 GA [−0,63; 0,19]) sıfırdan farklı değildi (olabilirlik oranı \chi^2_1 = 1{,}38; p = 0{,}239).
34.8 Sık hatalar ve tuzaklar
- Sonucun hangi değerinin 1 sayıldığını denetlememek. Metin etiketli sonuçta ikinci düzey olay sayılır (34.2).
votesütunu "evet/hayir" olarak yeniden kodlanıp (oy) çalıştırıldığında konsolun ikinci satırıoy = 'hayir'yazar;logptaxkatsayısı +1{,}289, \hat\rho=+0{,}270 çıkar: model aynıdır, okunan yön terstir. "1 olarak modellenen düzey" satırı her çalıştırmada okunur. - Özyineli modeli dışlama kısıtı olmadan kurmak. Kuramsal olarak model, iki denklemde aynı açıklayıcılar olsa da normallik varsayımıyla tanımlıdır; uygulamada \gamma ile \rho birbirinden ayrışmaz. Örnek veride
x1 = x2ile özyineli seçenek açıldığında şablon sonuç verir, ama \hat\rho=-0{,}99999, \operatorname{SH}(\hat a)=211{,}5 ve GA [-1;\ 1] çıkar; konsola "ρ kestirimi sınıra (±1) dayandı" uyarısı yazılır.privatekatsayısı 1{,}36 (z=5{,}04) görünse de bu çalıştırmanın sonuçları kullanılmaz. Birinci denklemde, ikinci sonucu doğrudan etkilemeyen en az bir değişken bulunmalıdır. - Sınıra giden ρ'yu sonuç saymak. Örnek veride
x2 = [years, logptax]ile özyineli model \hat\rho=-0{,}998, \operatorname{SH}(\hat a)=129 ve GA [-1;\ 1] verir;privatekatsayısı 1{,}36 ve "anlamlı" görünür. |\hat\rho|'nın 1'e dayanması, \operatorname{atanh}\rho'nın SH'sinin kendisinden kat kat büyük olması ve \rho aralığının bütün (-1{,}1)'i kaplaması, olabilirliğin o yönde düz olduğunu gösterir. Şablon |\hat\rho|>0{,}99 olduğunda bunu konsolda sınır uyarısıyla bildirir (34.2); uyarı çıkan bir çalıştırmanın katsayıları raporlanmaz. Yalnız on hanenin özel okulda olduğu bu veri özyineli modeli taşımaz. - Güven düzeyini oran olarak girmek. Bu şablonda düzey yüzdedir (95); 0,95 girilirse form 50'nin altını kabul etmez.
- Küçük hücrelerle ρ yorumlamak. \rho'yı belirleyen bilgi dört hücrenin dengesindedir; örnekte iki hücre beşer gözlemlidir ve aralık [-0{,}63;\ 0{,}19] kadar geniştir. \rho'nın anlamsız çıkması bağın yokluğunu göstermez.
- Kovaryans türünü sonuca bakarak seçmek. Örnek veride eğimlerin ortak Wald testi gözlenen bilgiyle p=0{,}143, sandviçle p=0{,}028, OPG ile p=0{,}281 verir. Küçük örneklemde üçü ayrışır; tür çözümlemeden önce belirlenir ve raporda yazılır. Sandviç, onlarca gözlemde gözlenen bilgiden daha güvenilir değildir.
- Katsayıyı olasılık etkisi diye okumak. \hat\gamma=0{,}61 "tedavi olasılığı 0,61 artırır" demek değildir; gizil ölçekte bir kaymadır. Benzetim verisinde ortalama etki, \Phi(\mathbf x_2'\hat{\boldsymbol\beta}_2+\hat\gamma)-\Phi(\mathbf x_2'\hat{\boldsymbol\beta}_2)'nin ortalaması olarak 0{,}179'dur (gerçek değer 0{,}233; tek denklemli probitle 0{,}034).
- Sayısal açıklayıcıyı kategorik türde bırakmak. Kategorik türdeki açıklayıcı gösterge değişkenlere açılır; çok düzeyli bir sayısal sütun (ör.
years) onlarca parametre üretir ve çalıştırma "Bilgi matrisi tekil" iletisiyle durur. Sürekli açıklayıcılar veri sekmesinde sayısal olmalıdır.
34.9 Uzman soruları
S1. ρ = 0 için Wald testi mi, olabilirlik oranı testi mi raporlanmalı?
İkisi de çıktıdadır: katsayı tablosunun son satırı Wald testidir (z=-1{,}146, p=0{,}252), ikinci tablo LR testini verir (\chi^2_1=1{,}384, p=0{,}239). Büyük örneklemde eşdeğerdirler. Küçük örneklemde ve \rho sınıra yakınken Wald testi güvenilmezdir, çünkü \operatorname{atanh}\rho'nın standart hatası olabilirliğin eğriliğine dayanır ve sınırda eğrilik kaybolur. LR testi yeniden parametrelemeden etkilenmez ve bu durumda tercih edilir (Monfardini ve Radice 2008).
S2. Aynı açıklayıcılarla iki değişkenli probit, iki ayrı probitten farklı katsayı verir mi?
Verir, ama az. Doğrusal görünüşte ilişkisiz regresyonda açıklayıcılar aynıysa birlikte kestirim tek tek kestirimle özdeştir; probit doğrusal olmadığı için bu özdeşlik tutmaz. Örnek veride vote denkleminde logptax katsayısı tek denklemde -1{,}2652, iki değişkenli modelde -1{,}2887'dir. Fark \rho büyüdükçe artar; asıl kazanç katsayılarda değil, ortak ve koşullu olasılıklardadır.
S3. Özyineli modelde tanımlama neye dayanıyor?
İki kaynağa: dışlama kısıtına ve fonksiyonel biçime. Wilde (2000), her denklemde değişen en az bir açıklayıcı varsa modelin dışlama kısıtı olmadan da tanımlı olduğunu göstermiştir; bu tanımlama bütünüyle iki değişkenli normallik varsayımından gelir ve kırılgandır. Birinci denklemde yer alıp ikinci denklemden dışlanan bir değişken (benzetim verisindeki arac) \gamma'yı \rho'dan veri aracılığıyla ayırır. Şablon dışlama kısıtını zorunlu tutmaz; tasarım matrislerinin rankını ve bilgi matrisinin tersinirliğini denetler, \hat\rho sınıra dayandığında uyarır (34.8).
S4. Standart hatalar hangi bilgi matrisinden geliyor; başka yazılımlarla neden son basamaklarda ayrışabilir?
Varsayılan, kestirim noktasındaki gözlenen bilginin tersidir; Hessian analitik gradyanın sayısal türevidir (adım 10^{-5}; 34.4.3). Sayısal türevin adımı ve şeması yazılımdan yazılıma değişir; örnek veride şablonun SH'leri, Hessian'ı merkezî farkla ve Richardson türeviyle alan iki bağımsız hesapla yedi anlamlı basamakta aynıdır (34.6.1), kaba adımlı ya da tek yanlı farklı bir uygulama daha erken basamaklarda ayrışabilir. Beklenen (Fisher) bilgiyi kullanan uygulamalar (ör. VGAM::vglm) aynı katsayıları verir; SH'leri küçük örneklemde biraz farklı olabilir. Katsayılar ve log-olabilirlik yedi sekiz basamak tutar.
S5. Neden ρ'nun GA'sı delta SH'siyle değil de atanh ölçeğinde kuruluyor?
Delta yöntemiyle \hat\rho\pm z\cdot\operatorname{SH}(\hat\rho) simetrik bir aralık verir ve \hat\rho uca yakınken \pm1'i aşabilir. \operatorname{atanh} ölçeğinde dağılım normale daha yakındır (Fisher dönüşümünün mantığı) ve geri dönüşüm aralığı (-1{,}1) içinde tutar. Örnekte delta aralığı [-0{,}708;\ 0{,}169], dönüştürülmüş aralık [-0{,}635;\ 0{,}194]'tür. Tablodaki delta SH yalnız bilgi içindir.
S6. Koşullu olasılık P(y₂ = 1 | y₁ = 1) çıktıdan nasıl elde edilir?
Tabloda yoktur; ortak olasılıklardan oranla bulunur. Ortalama düzeyde \bar P_{11}/(\bar P_{11}+\bar P_{10})=0{,}0515/0{,}1055=0{,}488; yani model, özel okul hanelerinde evet oyu oranını yaklaşık yarı yarıya öngörür (gözlenen 5/10). Belirli bir açıklayıcı profili için \Phi_2(e_1,e_2;\hat\rho)/\Phi(e_1) hesaplanır; bunun için katsayı tablosu yeterlidir.
S7. Olabilirliğin 10⁻³⁰⁰ ile alttan sınırlanması kestirimi etkiler mi?
Olağan veride hayır: sınır yalnız \Phi_2 sayısal olarak sıfıra indiğinde devreye girer; bu, bir gözlemin kestirilen modele göre 10^{-300}'den küçük olasılıklı olması demektir. Tam ayrışmaya yakın veride ya da en büyüklemenin erken adımlarında görülebilir. O durumda gradyan o gözlem için anlamsızlaşır; şablon çoğunlukla tekil bilgi matrisiyle durur.
S8. BFGS'den sonra nlminb inceltmesi ne kazandırır?
BFGS göreli amaç fonksiyonu değişimine bakarak durur ve düz bir tepede gradyan tam sıfırlanmadan bitebilir. nlminb (port yordamları) aynı noktadan, daha sıkı toleransla bir kez daha çalışır; sonuç daha kötü değilse alınır. Örnek veride iki aşamanın sonunda katsayılar bağımsız Newton–Raphson çözümüyle 10^{-8} içinde aynıdır. Seçenek, yayımlanmış tablolarla son basamağa kadar karşılaştırma içindir.
34.10 Kaynaklar
- Ashford, J. R., & Sowden, R. R. (1970). Multi-variate probit analysis. Biometrics, 26(3), 535–546. https://doi.org/10.2307/2529107
- Genz, A. (2004). Numerical computation of rectangular bivariate and trivariate normal and t probabilities. Statistics and Computing, 14(3), 251–260. https://doi.org/10.1023/B:STCO.0000035304.20635.31
- Genz, A., Bretz, F., Miwa, T., Mi, X., & Hothorn, T. (2026). mvtnorm: Multivariate normal and t distributions (R package version 1.4-1). https://doi.org/10.32614/CRAN.package.mvtnorm
- Greene, W. H. (2018). Econometric analysis (8th ed.). Pearson.
- Kenkel, B. (2015). pbivnorm: Vectorized bivariate normal CDF (R package version 0.6.0; Fortran code by A. Genz). https://doi.org/10.32614/CRAN.package.pbivnorm
- Maddala, G. S. (1983). Limited-dependent and qualitative variables in econometrics. Cambridge University Press. https://doi.org/10.1017/CBO9780511810176
- Monfardini, C., & Radice, R. (2008). Testing exogeneity in the bivariate probit model: A Monte Carlo study. Oxford Bulletin of Economics and Statistics, 70(2), 271–282. https://doi.org/10.1111/j.1468-0084.2007.00486.x
- Pindyck, R. S., & Rubinfeld, D. L. (1998). Econometric models and economic forecasts (4th ed.). McGraw-Hill.
- Plackett, R. L. (1954). A reduction formula for normal multivariate integrals. Biometrika, 41(3–4), 351–360. https://doi.org/10.1093/biomet/41.3-4.351
- White, H. (1982). Maximum likelihood estimation of misspecified models. Econometrica, 50(1), 1–25. https://doi.org/10.2307/1912526
- Wilde, J. (2000). Identification of multiple equation probit models with endogenous dummy regressors. Economics Letters, 69(3), 309–312. https://doi.org/10.1016/S0165-1765(00)00320-7
- Yee, T. W. (2015). Vector generalized linear and additive models: With an implementation in R. Springer. https://doi.org/10.1007/978-1-4939-2818-7