179. Çok düzeyli doğrulayıcı faktör analizi / YEM (iki düzeyli)
Şablon kimliği: cok_duzeyli_cfa · Kategori: yapısal eşitlik / gizil değişken · Dil: R · Dosya: pro/sablonlar/yem/cok_duzeyli_cfa.R (satır 1–179; üstbilgi 1–81) · Örnek veri: _ornek/demo_twolevel.csv · Paketler: lavaan 0.7-2, R 4.5.3
179.1 Ne işe yarar
Şablon, kümelenmiş veride (öğrenci–okul, çalışan–kurum) ölçme modelini düzey içi ve düzeyler arası için ayrı ayrı kurar ve iki düzeyli en çok olabilirlikle (Muthén, 1994) kestirir. Her düzeyde bir ya da iki faktör vardır; düzey içi faktörleri birey düzeyi ortak değişkenler, düzeyler arası faktörleri küme düzeyi ortak değişkenler yordayabilir. Göstergelerin sınıf içi korelasyonları (ICC) raporlanır. Kestirim lavaan ile yapılır (Rosseel, 2012).
- \mathbf y_{ji}: j. kümedeki i. bireyin göstergeleri; \boldsymbol\nu: gösterge ortalamaları (düzeyler arası düzeyde kestirilir).
- \boldsymbol\eta_{W}, \boldsymbol\eta_{B}: düzey içi ve düzeyler arası faktörler; \boldsymbol\Lambda_W,\boldsymbol\Lambda_B: yükler; \boldsymbol\Psi: faktör (artık) varyansları; \boldsymbol\Theta: gösterge artık varyansları.
- \boldsymbol\Sigma_W, \boldsymbol\Sigma_B: düzey içi ve düzeyler arası model kovaryansları; toplam kovaryans \boldsymbol\Sigma_W+\boldsymbol\Sigma_B.
Ne zaman kullanılır? Veri kümelenmişse ve ölçme modelinin her düzeyde ayrı sınanması gerekiyorsa (ör. okul düzeyinde iklim, öğrenci düzeyinde tutum). Küme sayısı en az 10, gözlem en az 30 olmalıdır (şablon alt sınırı); güvenilir sonuç için küme sayısı çok daha büyük olmalıdır (en az yüzlerce gözlem, onlarca küme).
Ne zaman kullanılmaz?
- Küme yoksa (bağımsız gözlemler): temel programın CFA/SEM analizi ya da
bayes_yem(Bölüm 177). Kümelenmeyi yok saymak SH'leri küçültür. - Göstergeler sıralı ise:
sirali_cfa_wlsmv(Bölüm 185); bu şablon sürekli normal varsayar. - Boylamsal ölçümler (zaman içinde yinelenen ölçüm) kümelenme olarak ele alınmak isteniyorsa ve zaman yapısı önemliyse:
gizil_buyume(Bölüm 181) ya dari_clpm(Bölüm 184). - Çok az gösterge ya da faktör başına üçten az gösterge: şablon durur (179.2).
- Kümeler arası varyans çok küçükse (ICC \approx0): düzeyler arası model kestirilemez; tek düzeyli model yeterlidir (179.8).
Temel programla ilişki. Temel programda iki düzeyli ölçme modeli yoktur; tek düzeyli CFA/SEM kümelenmeyi hesaba katmaz. Bu şablon lavaan'ın cluster bağımsız değişkenli iki düzeyli ML'sini kullanır ve düzey içi ile arası kovaryans yapılarını birlikte kestirir.
179.2 Şablonun girdileri
Form, üstbilgideki 10 [[param]] bloğundan kurulur (cok_duzeyli_cfa.R:11–80). Türlerin anlamı ve formun ortak denetimi Bölüm 1.2'dedir. Göstergeler ve ortak değişkenler sutunlar türünde ve sayisal = true'dur: sayısal roldür, Veri sekmesinde "kategorik" olsa da R'ye sayı gider (Bölüm 1.3). Küme kategorik_sutun'dur: sayısal ya da metin olabilir.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Faktör 1 göstergeleri · gosterge1 |
sütunlar (sayısal, en az 3) · Değişkenler | boş | \ge3 sütun | Birinci faktör (11–17, 86–88). |
Faktör 2 göstergeleri · gosterge2 |
sütunlar (isteğe bağlı) · Değişkenler | boş | boş ya da \ge3 sütun | İkinci faktör; gosterge1'dekiler çıkarılır (18–24, 87–89). |
Küme (düzey 2) değişkeni · kume |
kategorik sütun · Değişkenler | uygun ilk sütun | sütun | Küme kimliği (25–29, 93, 100–103). |
Düzey içi ortak değişkenler · ic_kovaryat |
sütunlar (isteğe bağlı) · Değişkenler | boş | sayısal sütunlar | fw ~ x (30–36, 91, 133). |
Düzeyler arası ortak değişkenler · ara_kovaryat |
sütunlar (isteğe bağlı) · Değişkenler | boş | küme içinde sabit sütunlar | fb ~ w (37–43, 92, 105–109, 134). |
Yükler düzeyler arasında eşit · esit_yuk |
onay · Model | kapalı | açık/kapalı | Yük etiketleri a2, a3 (44–49, 129–130). |
Kestirici · kestirici |
seçim · Model | ML |
ML, MLR |
estimator (50–56, 144). |
Gizil varyansları 1'e sabitle · std_lv |
onay · Model | kapalı | açık/kapalı | std.lv (57–63, 141). |
Optimizasyon algoritması · optim_yontemi |
seçim · Gelişmiş | nlminb |
nlminb, em |
optim.method (64–71, 141). |
En çok yineleme · maks_yineleme |
tamsayı · Gelişmiş | 10 000 | 10–1 000 000 | iter.max ya da em.args (72–80, 142). |
Örnek ayar (ornek_param, satır 10): gosterge1 = [y1, y2, y3], kume = cluster, ic_kovaryat = [x1, x2, x3], ara_kovaryat = [w1, w2]; öteki varsayılan.
Tohum. Hesap belirlenimcidir; rastgele adım yoktur. Kod panelindeki Tohum alanı (Bölüm 1.3) sonucu etkilemez.
Şablonun kendi denetimleri (mq_hata):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 85 |
| Faktör 1 için <3 gösterge | "Faktör 1 için en az 3 gösterge seçin." | 88 |
| Faktör 2 seçili ama <3 | "Faktör 2 için en az 3 gösterge seçin (ya da boş bırakın)." | 89 |
| Küme gösterge ya da ortak değişken | "Küme değişkeni gösterge ya da ortak değişken olamaz." | 93 |
| Gösterge ya da ortak değişken sayıya çevrilemiyor | "'…' sütunu sayıya çevrilemedi: … değer sayı değil …" (ortak yardımcı) | 95 |
| Gözlem <30 ya da küme <10 | "İki düzeyli model için en az 30 gözlem ve 10 küme gerekli." | 102 |
| Kümelerin yarıdan fazlası tek gözlemli | "Kümelerin çoğunda tek gözlem var; düzey içi model kestirilemez." | 103 |
| Gösterge ya da düzey içi ortak değişken sabit | "'…' sabit." | 104 |
| Düzeyler arası ortak değişken küme içinde değişiyor | "'…' küme içinde değişiyor; düzeyler arası ortak değişken küme düzeyinde sabit olmalı." | 107 |
| Düzeyler arası ortak değişken kümeler arasında sabit | "'…' kümeler arasında sabit." | 108 |
| Bütün göstergelerde ICC <0{,}02 | "Göstergelerde kümeler arası varyans payı çok küçük (en büyük ICC = … < 0,02); iki düzeyli model gerekmez ya da kestirilemez." | 117 |
| Model kurulamadı | "Model kurulamadı: …" | 145 |
| Yakınsamadı | "Kestirim yakınsamadı; gösterge sayısını, küme sayısını ya da ortak değişkenleri gözden geçirin." | 147 |
Faktör 2'nin göstergeleri, faktör 1 ile ortak olanlar çıkarıldıktan sonra sayılır (90). Eksik değerli satırlar complete.cases ile atılır (97) ve sayısı konsola yazılır (96–98): "55 satır eksik değer nedeniyle çıkarıldı (n = 2500 → 2445)". 40 ve 15 eksik hücre ile 2500 satırdan 55 satır atılır ve n=2445 yazılır. Tek gözlemli kümeler yarıdan fazlaysa şablon durur (103); en büyük ICC 0{,}02'nin altındaysa durur, 0{,}05'in altındaysa uyarı verir (117–118).
179.3 Örnek veri
demo_twolevel.csv, lavaan eğitiminin Demo.twolevel verisidir: 2500 gözlem, 200 küme (küme başına 5–20, ortalama 12,5), eksik değer yok.
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
y1, y2, y3 |
faktör 1 göstergeleri | sayısal | ortalama \approx0, sd 1{,}4–1{,}7 |
y4, y5, y6 |
(örnekte yok; ikinci faktör denemesinde) | sayısal | |
x1, x2, x3 |
düzey içi ortak değişkenler | sayısal | sd \approx1 |
w1, w2 |
düzeyler arası ortak değişkenler | sayısal | küme içinde sabit |
cluster |
küme | sayısal | 1–200 |
Kategorik düzey sırası bu şablonda ilgisizdir: küme yalnız grup kimliğidir; metin etiketli küme (K001…) ile aynı sonuç elde edilir.
Bu bölümde kullanılan çalıştırmalar (ayrıntı dogrulama/cok_duzeyli_cfa/calistir.sh):
| Ad | Ayar |
|---|---|
p8_cfa_ornek |
örnek ayar |
p8_cfa_esit, p8_cfa_mlr, p8_cfa_stdlv, p8_cfa_em |
esit_yuk; kestirici = MLR; std_lv; optim_yontemi = em |
p8_cfa_iki, p8_cfa_kovaryatsiz, p8_cfa_tek_ara |
iki faktör (y_1–y_3, y_4–y_6); ortak değişkensiz; x1 ve w1 |
p8_cfa_eksik, p8_cfa_tek, p8_cfa_tek90, p8_cfa_kume8, p8_cfa_w_degisen, p8_cfa_icc0, p8_cfa_x_icc, p8_cfa_dengesiz, p8_cfa_heywood, p8_cfa_kume_metin, p8_cfa_kat |
benzetim türevleri (veri_uret.py): eksik hücre; her kümede tek gözlem; %90 tek gözlemli küme; 8 küme; w1 küme içinde değişiyor; kümesiz varyans; x1'de kümeler arası değişim; dengesiz küme büyüklükleri; Heywood; metin küme; Veri sekmesinde kategorik tür |
179.4 Yöntem: formüller ve hesap adımları
Şablon verileri doğrular, gösterge ve ortak değişken adlarını geçici adlara (v1, v2, …) çevirir, iki düzeyli lavaan sözdizimini üretir, sem(…, cluster = ) ile kestirir, uyum ölçütlerini, parametre tablosunu ve ICC'yi yazar.
179.4.1 Üretilen model
Örnek ayarda şablon şu sözdizimini üretir ve konsola yazar (139):
level: 1
fw1 =~ y1 + y2 + y3
fw1 ~ x1 + x2 + x3
level: 2
fb1 =~ y1 + y2 + y3
fb1 ~ w1 + w2
Her düzeyde ilk yük 1'e sabitlenir (std_lv kapalıyken) ve öteki yükler serbesttir. İkinci faktör varsa fw2, fb2 benzer biçimde eklenir. esit_yuk açıkken yükler iki düzeyde aynı etiketi taşır (a2, a3; ilk yük 1): \boldsymbol\Lambda_W=\boldsymbol\Lambda_B (düzeyler arası ölçüm eşdeğerliği sınaması).
fw1,fb1: düzey içi ve düzeyler arası faktör;level: 1,level: 2lavaan'ın düzey blokları.- Göstergelerin kesişimleri düzeyler arası düzeyde kestirilir (lavaan iki düzeyli modelde ortalama yapısını otomatik ekler); örnek modelde 3 kesişim.
- Ortak değişkenler sabit sayılır (
fixed.x): varyansları, kovaryansları ve ortalamaları serbest parametre değildir.
Örnek modelde serbest parametre sayısı: düzey içi 2 yük + 3 regresyon + 3 artık varyans + 1 faktör artık varyansı =9; düzeyler arası 2+2+3+1=8; kesişimler 3; toplam q=20. Sabit x ve w yüzünden gözlenen moment sayısı 30'dur (15 düzey içi, 12 düzeyler arası, 3 ortalama) ve \mathrm{sd}=30-20=10.
179.4.2 İki düzeyli olabilirlik
Küme j (n_j birey, \mathbf r_{ji}=\mathbf y_{ji}-\mathbf m_{ji} modelin koşullu ortalamasından artıklar, \bar{\mathbf r}_j küme ortalaması) için, bireyleri ayrıştırılmış düzey içi ve arası bileşenlere ayıran log-olabilirlik (Muthén, 1994; Rosseel, 2021):
- \mathbf A_j: kümedeki düzey içi artık kare ve çarpımlar toplamı; (n_j-1) düzey içi serbestlik derecesini verir.
- \boldsymbol\Sigma_W+n_j\boldsymbol\Sigma_B: küme ortalamasının varyansının n_j katı. Küme büyüklükleri eşit olmadığında her küme farklı bir \boldsymbol\Sigma_W+n_j\boldsymbol\Sigma_B taşır; bu, dengesiz veriyi de kapsar.
- \ell=\sum_j\ell_j;
loglbudur. \mathbf m_{ji}=\boldsymbol\nu+\boldsymbol\Lambda_W\boldsymbol\gamma_W^{\top}\mathbf x_{ji}+\boldsymbol\Lambda_B\boldsymbol\gamma_B^{\top}\mathbf w_j.
Bu, \mathbf V_j=\mathbf I_{n_j}\otimes\boldsymbol\Sigma_W+\mathbf 1\mathbf 1^{\top}\otimes\boldsymbol\Sigma_B kovaryanslı yığılmış normal yoğunluğa eşdeğerdir; bağımsız R hesabı bu yığılmış biçimi, Python ise yukarıdaki ayrıştırmayı kullanır (179.6). Bir kümede tek gözlem varsa düzey içi bilgisi yoktur (n_j-1=0) ve yalnız düzeyler arası terim kalır; kümelerin çoğu tek gözlemliyse düzey içi parametreler zayıf tanımlanır.
Koddaki tercih
sem(model, data = d, cluster = "v…", estimator = ML|MLR, [std.lv], [optim.method = "em", em.args = list(max_iter)] ya da control = list(iter.max)) (141–146). Sabit x: lavaan'ın varsayılanı (fixed.x = TRUE) geçerlidir; log-olabilirlik x ve w için koşulludur. Örnek ayarda logl -12076{,}565980, bağımsız koşullu olabilirlik -12076{,}565979'dur.
179.4.3 Uyum ölçütleri
- \ell_{\text{doymuş}}: aynı koşullu yapıda \boldsymbol\Sigma_W ve \boldsymbol\Sigma_B'nin kısıtsız olduğu (30 parametreli) model; m=30 moment.
- N: gözlem sayısı (2500; küme sayısı değil). Örnekte \mathrm{BIC}=24\,153{,}13+20\ln2500=24\,309{,}61.
- CFI, TLI, RMSEA lavaan'ın standart tanımlarıdır (bağımsızlık modeline karşı). SRMR iki düzey için ayrı hesaplanır:
srmr_withinvesrmr_between.
Hu ve Bentler (1999) ölçütleri (CFI \ge0{,}95, RMSEA \le0{,}06, SRMR \le0{,}08) tek düzeyli veri için önerilmiştir; çok düzeyli modelde düzey-bazlı SRMR'nin ayrı yorumlanması önerilir (Ryu ve West, 2009): örnekte \mathrm{SRMR}_W=0{,}004, \mathrm{SRMR}_B=0{,}034. MLR seçildiğinde tablonun sonuna chisq.scaled, pvalue.scaled ile cfi, tli, rmsea için ölçekli (.scaled) ve sağlam (.robust) karşılıkları eklenir (152–156); üstteki cfi, tli, rmsea ve srmr satırları ML ifadeleri olarak kalır, SRMR'nin ölçekli karşılığı yoktur ve bu konsola not olarak yazılır (179.8). Örnek veride kestirici = MLR: cfi.scaled 1{,}000, tli.scaled 1{,}0016, rmsea.scaled 0{,}000 (tli.robust 1{,}0015).
179.4.4 Parametre tablosu ve standartlaştırma
parameterEstimates(fit, standardized = TRUE) ile =~, ~ ve ~~ işlemleri alınır; gözlenen göstergelerin kendisi dışındaki ~~ satırları (ortak değişken varyansları vb.) elenir (161). Tablo: duzey (içi/arası), sol, islem, sag, kestirim, SH, z, p, std_all. std_all her düzeyin kendi değişkenlerine göre tam standartlaştırmadır (düzeyin göstergelerinin ve faktörünün standart sapmasıyla). Sabitlenen ilk yük için SH, z, p boştur.
179.4.5 ICC
Şablon ön denetimde ANOVA ICC'sini hesaplar (110–116):
- \mathrm{MS}_B, \mathrm{MS}_W: kümeler arası ve içi ortalama kareler; J: küme sayısı; n_0: dengesiz veri için ortalama küme büyüklüğü.
- Bu değer yalnız ön denetimlerde kullanılır: en büyük gösterge ICC'si <0{,}02 ise çalıştırma durur, <0{,}05 ise uyarı yazılır; düzey içi ortak değişkenin ICC'si >0{,}1 ise bağlamsal etki uyarısı yazılır (119–122). Tabloya yazılan ICC
lavInspect(fit, "icc")değeridir.
Çıktıdaki ICC sütunu lavaan'ın iki düzeyli doymuş modelden hesapladığı \boldsymbol\Sigma_{B,jj}/(\boldsymbol\Sigma_{B,jj}+\boldsymbol\Sigma_{W,jj})'dir. Ortak değişken varken doymuş model x ve w'yu da içerir; bu yüzden örnek ayardaki ICC (0{,}3315; 0{,}2631; 0{,}2315) ANOVA ICC'sinden (0{,}3313; 0{,}2626; 0{,}2285) biraz ayrışır. Kovaryatsız modelde (p8_cfa_kovaryatsiz) lavaan ICC'si, yalnız y için iki düzeyli doymuş modelin ML çözümüyle (0{,}3214; 0{,}2560; 0{,}2234) 10^{-5} içinde aynıdır.
179.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 82–83 | .m() yardımcısı; lavaan yüklenir. |
|
| 85–93 | Gösterge listeleri, ortak değişkenler, küme değişkeni denetimi. | g2 içinden g1 çıkarılır. |
| 94–109 | Veri seçimi; mq_sayisal (95); complete.cases ve eksik satır bildirimi (96–98); uyarı listesi (99); küme ve gözlem sayısı; "çoğunda tek gözlem" denetimi (103); sabitlik; düzeyler arası ortak değişkenin küme içi sabitliği. |
Yarıdan fazlası tek gözlemli kümelerde durur. |
| 110–122 | ANOVA ICC işlevi; en büyük ICC <0{,}02 ise hata (117), <0{,}05 ise uyarı (118); düzey içi ortak değişken ICC >0{,}1 ise uyarı (119–122). | Uyarılar Kestirim uyarıları: satırına düşer. |
| 124–127 | Geçici adlar v1…; q() ve geri() eşlemeleri. |
Adlardaki özel karakterler ve boşluklar sorun çıkarmaz. |
| 128–135 | Düzey 1 ve düzey 2 satırları; yük etiketleri; regresyonlar; model metni. |
esit_yuk etiketleri a2, a3. |
| 136–139 | Kullanıcıya gösterilecek model (geçici adlar gerçek adlara). | |
| 141–147 | lav_ek seçenekleri; sem(…, cluster, estimator); uyarılar toplanır; yakınsama denetimi. |
Yalnız converged okunur. |
| 149–157 | Uyum ölçütleri tablosu; MLR'de ölçekli ve sağlam CFI, TLI, RMSEA ile not (152–156). |
|
| 160–168 | Parametre tablosu; negatif varyans (Heywood) denetimi (166–168). | Negatif varyans bulunan satırlar uyarıda adlandırılır. |
| 169–172 | ICC tablosu; uyarı satırı. | |
| 174–178 | ICC çubuk grafiği. |
179.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/cok_duzeyli_cfa/elle_hesap.py (numpy/scipy; lavaan ve şablon çağrılmaz; düzey içi/arası ayrıştırma formülü) ve r_dogrulama.R (yalnız temel R; her küme için yığılmış \mathbf V_j ve Cholesky) ile hesaplanmıştır. İkisi de modeli kendi başına kurar ve BFGS ile Newton adımlarıyla en büyükler.
Adım 1 — Olabilirlik ve kestirimler. \ell=-12076{,}565979 (Python), -12076{,}57 (R, aynı değer) ve şablon -12076{,}565980. Düzey içi yükler \hat\lambda_{y2}=0{,}7742, \hat\lambda_{y3}=0{,}7336, regresyonlar 0{,}5100; 0{,}4073; 0{,}2050; düzeyler arası yükler 0{,}7167; 0{,}5869, regresyonlar 0{,}1647; 0{,}1310. Kestirimler şablonla 10^{-4} içinde aynıdır (lavaan'ın durma ölçütü).
Adım 2 — Ki-kare. Doymuş koşullu model (30 parametre) \ell=-12072{,}519905; \chi^2=2(-12072{,}519905+12076{,}565979)=8{,}092149, \mathrm{sd}=10, p=0{,}6198. Şablon 8{,}092152.
Adım 3 — SH. Olabilirliğin gözlenen Hessian'ı (merkezî fark) ters çevrilir; örneğin düzey içi y2 yük SH'si 0{,}0341 (şablon 0{,}0342). SH'ler 2\cdot10^{-3} içinde uyuşur.
Adım 4 — ICC. Python iki düzeyli ML'si ve ANOVA tanımı ile iki yoldan (179.4.5).
179.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | Ölçüt | |
|---|---|---|---|---|---|---|
| kestirim, fw=~y2 | 0,77421529 | 0,77420822 | 0,77420822 | 7,1e−6 | 1e−4 | ✓ |
| kestirim, fw=~y3 | 0,73357555 | 0,73357749 | 0,73357749 | 1,9e−6 | 1e−4 | ✓ |
| kestirim, fw~x1 | 0,50996878 | 0,50997013 | 0,50997013 | 1,4e−6 | 1e−4 | ✓ |
| kestirim, fw~x2 | 0,40728803 | 0,40728889 | 0,40728889 | 8,6e−7 | 1e−4 | ✓ |
| kestirim, fw~x3 | 0,20499801 | 0,20499861 | 0,20499861 | 6,0e−7 | 1e−4 | ✓ |
| kestirim, y1~~y1(w) | 0,98591011 | 0,98590802 | 0,98590802 | 2,1e−6 | 1e−4 | ✓ |
| kestirim, y2~~y2(w) | 1,06639947 | 1,0664081 | 1,0664081 | 8,1e−6 | 1e−4 | ✓ |
| kestirim, y3~~y3(w) | 1,01104789 | 1,01103366 | 1,01103366 | 1,4e−5 | 1e−4 | ✓ |
| kestirim, fw~~fw | 0,54649152 | 0,54649705 | 0,54649705 | 5,5e−6 | 1e−4 | ✓ |
| kestirim, fb=~y2 | 0,71667098 | 0,71668261 | 0,71668261 | 1,2e−5 | 1e−4 | ✓ |
| kestirim, fb=~y3 | 0,58689664 | 0,58690777 | 0,58690777 | 1,1e−5 | 1e−4 | ✓ |
| kestirim, fb~w1 | 0,16470406 | 0,16471547 | 0,16471547 | 1,1e−5 | 1e−4 | ✓ |
| kestirim, fb~w2 | 0,13099872 | 0,1309544 | 0,1309544 | 4,4e−5 | 1e−4 | ✓ |
| kestirim, y1~~y1(b) | 0,05758152 | 0,05759534 | 0,05759535 | 1,4e−5 | 1e−4 | ✓ |
| kestirim, y2~~y2(b) | 0,12006688 | 0,12005649 | 0,12005649 | 1,0e−5 | 1e−4 | ✓ |
| kestirim, y3~~y3(b) | 0,14876265 | 0,14875645 | 0,14875644 | 6,2e−6 | 1e−4 | ✓ |
| kestirim, fb~~fb | 0,89886204 | 0,89887236 | 0,89887234 | 1,0e−5 | 1e−4 | ✓ |
| SH, fw=~y2 | 0,03415032 | 0,03414981 | 0,03414981 | 5,1e−7 | 2e−3 | ✓ |
| SH, fw=~y3 | 0,03281519 | 0,03281493 | 0,03281493 | 2,6e−7 | 2e−3 | ✓ |
| SH, fw~x1 | 0,02314147 | 0,02314146 | 0,02314146 | 9,1e−9 | 2e−3 | ✓ |
| SH, fw~x2 | 0,02228864 | 0,02228865 | 0,02228865 | 1,1e−8 | 2e−3 | ✓ |
| SH, fw~x3 | 0,02104738 | 0,02104743 | 0,02104743 | 4,8e−8 | 2e−3 | ✓ |
| SH, y1~~y1(w) | 0,04566301 | 0,04566255 | 0,04566255 | 4,6e−7 | 2e−3 | ✓ |
| SH, y2~~y2(w) | 0,03910442 | 0,0391044 | 0,0391044 | 1,8e−8 | 2e−3 | ✓ |
| SH, y3~~y3(w) | 0,03655043 | 0,03654945 | 0,03654945 | 9,8e−7 | 2e−3 | ✓ |
| SH, fw~~fw | 0,04036294 | 0,04036236 | 0,04036236 | 5,8e−7 | 2e−3 | ✓ |
| SH, fb=~y2 | 0,05184411 | 0,05184402 | 0,05184402 | 9,9e−8 | 2e−3 | ✓ |
| SH, fb=~y3 | 0,04760296 | 0,04760267 | 0,04760267 | 2,9e−7 | 2e−3 | ✓ |
| SH, fb~w1 | 0,07869038 | 0,07869092 | 0,07869092 | 5,3e−7 | 2e−3 | ✓ |
| SH, fb~w2 | 0,07638414 | 0,07638464 | 0,07638464 | 5,0e−7 | 2e−3 | ✓ |
| SH, y1~~y1(b) | 0,04746678 | 0,04746004 | 0,04746004 | 6,7e−6 | 2e−3 | ✓ |
| SH, y2~~y2(b) | 0,03139083 | 0,031383 | 0,031383 | 7,8e−6 | 2e−3 | ✓ |
| SH, y3~~y3(b) | 0,0279695 | 0,02796262 | 0,02796262 | 6,9e−6 | 2e−3 | ✓ |
| SH, fb~~fb | 0,11840191 | 0,11840504 | 0,11840504 | 3,1e−6 | 2e−3 | ✓ |
| log-olabilirlik | −12076,56598047 | −12076,56597903 | −12076,56597903 | 1,2e−10 | 1e−6 | ✓ |
| ki-kare | 8,09215188 | 8,092149 | — | 3,6e−7 | 1e−6 | ✓ |
| sd | 10 | 10 | — | 0 | 1e−6 | ✓ |
| p | 0,61983602 | 0,6198363 | — | 2,8e−7 | 1e−6 | ✓ |
| parametre sayısı | 20 | 20 | 20 | 0 | 1e−6 | ✓ |
| AIC | 24193,13196094 | 24193,13195805 | 24193,13195805 | 1,2e−10 | 1e−6 | ✓ |
| BIC (ln ngözlem) | 24309,61288115 | 24309,61287827 | 24309,61287827 | 1,2e−10 | 1e−6 | ✓ |
| ICC y1 (kovaryatsız model; ML iki düzeyli doymuş) | 0,32136961 | 0,32136917 | — | 4,5e−7 | 1e−5 | ✓ |
| ICC y2 (kovaryatsız model; ML iki düzeyli doymuş) | 0,25598018 | 0,25597972 | — | 4,6e−7 | 1e−5 | ✓ |
| ICC y3 (kovaryatsız model; ML iki düzeyli doymuş) | 0,22343722 | 0,22343692 | — | 3,0e−7 | 1e−5 | ✓ |
| ICC y1, şablonun ANOVA ön denetimi ile (ölçüt 5e−3) | 0,33145148 | 0,33134046 | 0,33134046 | 1,1e−4 | 5e−3 | ✓ |
| ICC y2, şablonun ANOVA ön denetimi ile (ölçüt 5e−3) | 0,26310492 | 0,2626068 | 0,2626068 | 5,0e−4 | 5e−3 | ✓ |
| ICC y3, şablonun ANOVA ön denetimi ile (ölçüt 5e−3) | 0,23150438 | 0,22848573 | 0,22848573 | 3,0e−3 | 5e−3 | ✓ |
Ölçütü karşılayan: 47/47. Python düzey içi/arası ayrıştırma formülüyle, R her küme için yığılmış çok değişkenli normal yoğunlukla aynı koşullu (x ve w sabit) olabilirliği en büyükler; ki-kare doymuş koşullu modelle (30 parametre) bulunur. lavaan'ın kestirimleri durma ölçütü nedeniyle 1e−4 içinde, SH 2e−3 içinde uyuşur. ICC: kovaryatlı modelde lavaan ICC'yi x ve w ile birlikte doymuş modelden alır, bu yüzden ANOVA ile yalnız yaklaşık (5e−3) uyuşur.
179.7 Çıktıyı okuma
Örnek ayarın tabloları (p8_cfa_ornek; sütunlar kısaltılmıştır):
Model uyumu (n = 2500, küme = 200)
 npar 20   chisq 8.092152   df 10   pvalue 0.619836   cfi 1.0   tli 1.001799   rmsea 0.0
 srmr_within 0.003575   srmr_between 0.033932   logl -12076.565980   aic 24193.131961   bic 24309.612881

Parametre kestirimleri (düzey içi ve arası)
 duzey sol islem sag  kestirim      SH        z        p  std_all
   içi fw1    =~  y1  1.000000  0.0000      NaN      NaN   0.7121
   içi fw1    =~  y2  0.774215  0.0342  22.6708   0.0000   0.6026
   içi fw1     ~  x1  0.509969  0.0231  22.0370   0.0000   0.5019
 arası fb1    =~  y2  0.716671  0.0518  13.8236   0.0000   0.8942
 arası fb1     ~  w1  0.164704  0.0787   2.0931   0.0363   0.1591
 arası fb1     ~  w2  0.130999  0.0764   1.7150   0.0863   0.1308
 arası  y1    ~~  y1  0.057582  0.0475   1.2131   0.2251   0.0581

Göstergelerin sınıf içi korelasyonu (ICC)
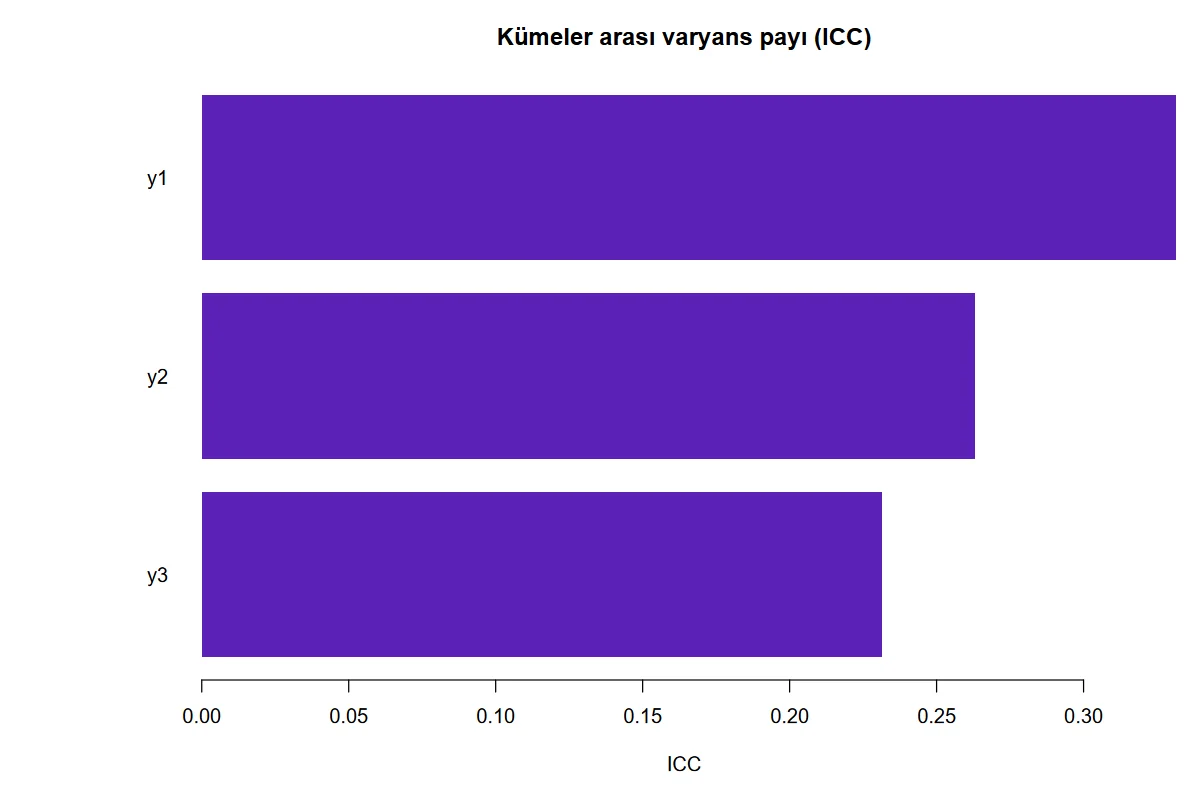
 y1 0.3315   y2 0.2631   y3 0.2315
Şekil 179.1. Şablonun çizdiği ICC çubuk grafiği (örnek veri): her göstergenin toplam varyansındaki kümeler arası pay. En büyük pay `y1`'dedir (0{,}33).
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
chisq, df, pvalue |
Model ile doymuş model arası uyumsuzluk | p=0{,}62: model reddedilmez. Büyük örneklemde küçük sapmalara da duyarlıdır. |
cfi, tli, rmsea |
Göreli ve mutlak uyum | \mathrm{CFI}=1{,}00, \mathrm{RMSEA}=0{,}00: çok iyi uyum. Küçük \chi^2 ve \mathrm{sd} ile ölçütler üst sınırda kalır. |
srmr_within, srmr_between |
Düzey-bazlı standartlaştırılmış artık | 0{,}004 ve 0{,}034; ikisi de 0{,}08'in altında. |
logl, aic, bic |
Olabilirlik ve bilgi ölçütleri | Model karşılaştırma içindir (ör. esit_yuk kapalı ve açık). BIC gözlem sayısıyla cezalıdır. |
kestirim, SH, z, p |
Yük, regresyon, varyans | Düzey içi y2 yükü 0{,}77 (SH 0{,}034). Düzeyler arası fb1 ~ w1 0{,}16 (p=0{,}036), w2 0{,}13 (p=0{,}086). |
std_all |
Tam standartlaştırılmış | Yükün karesi, göstergenin o düzeydeki açıklanan varyans payıdır: düzey içi y1 0{,}71^2=0{,}51; düzeyler arası y1 0{,}97^2=0{,}94. |
y1 ~~ y1 (düzeyler arası) |
Küme düzeyi artık varyansı | 0{,}058 (p=0{,}23): sıfırdan ayırt edilemez; küme düzeyi y1 farkı faktörle tamamen açıklanır. |
ICC |
Kümeler arası varyans payı | 0{,}33: y1 varyansının üçte biri kümeler arasındadır. \ge0{,}05–0{,}10 iki düzeyli modelin gerekçesidir. |
Rapor cümlesi. 200 kümede 2500 gözlemle iki düzeyli doğrulayıcı faktör analizi uygulanmıştır (lavaan, ML). Üç gösterge her düzeyde tek faktörle açıklanmış, düzey içi faktör üç birey düzeyi, düzeyler arası faktör iki küme düzeyi ortak değişkenle yordanmıştır. Model veriyle uyumludur (\chi^2(10)=8{,}09, p=0{,}62; CFI =1{,}00; RMSEA =0{,}00; \mathrm{SRMR}_W=0{,}004, \mathrm{SRMR}_B=0{,}034). Göstergelerin sınıf içi korelasyonları 0{,}23–0{,}33'tür. Düzey içi yükler 0{,}73–1{,}00 (referans yük 1'e sabit), düzeyler arası yükler 0{,}59–1{,}00'dır.
179.8 Sık hatalar ve tuzaklar
- Eksik satırlar. 55 satır atıldığında "55 satır eksik değer nedeniyle çıkarıldı (n = 2500 → 2445)" yazılır (B1). Eksik oranının sonucu nasıl etkileyeceğini yine de kendiniz değerlendirin.
MLR'de ölçekli ölçütler tablonun sonundadır.kestirici = MLRölçekli \chi^2 (8{,}3524; p=0{,}5945) ve CFI, TLI, RMSEA'nın ölçekli/sağlam karşılıklarını ekler; üsttekicfi,tli,rmsea,srmrsatırları ML ile aynıdır (SRMR ölçeklenmez) ve konsolda bu belirtilir; SH'ler sağlam SH'dir (y2düzey içi yük SH'si 0{,}0342\to0{,}0371) (B2). Sağlam kestirici için.scaled/.robustsatırlarını raporlayın.- ICC eşiği. Bütün göstergelerde ICC <0{,}02 ise çalıştırma durur (0{,}013, 0{,}003, 0{,}006 olan veride durur); <0{,}05 ise küme düzeyi modelinin zayıf tanımlı olduğu uyarısı yazılır (B3). Düzeyler arası modeli yorumlamadan önce ICC'ye yine de bakın.
- "Çoğunda tek gözlem" denetimi. Kümelerin yarıdan fazlası tek gözlemliyse çalıştırma durur; kümelerin %90'ı tek gözlemli veride bu ileti çıkar (B4). Tek gözlemli kümeler azınlıktaysa düzey içi parametreler yine de zayıf tanımlanabilir.
- Düzey içi ortak değişkenin bağlamsal etkisi. Düzey içi ortak değişkenin ICC'si 0{,}1'i aşarsa şablon uyarır:
x1'e küme düzeyinde değişim eklenince düzey içi katsayı 0{,}510\to0{,}468 ve düzeyler arası faktör varyansı 0{,}90\to1{,}17 olur (B5). Küme ortalamasını düzeyler arası ortak değişken olarak da ekleyin. - Düzeyler arası ortak değişken küme içinde değişiyorsa durur.
w1'e bireysel gürültü eklenince "'w1' küme içinde değişiyor …" iletisi gelir; küme ortalamasını alıp yeniden verin. - Negatif varyans (Heywood). Dengesiz küme büyüklüklerinde ve çok yüksek ICC'de lavaan "some estimated ov variances are negative" uyarısı verir; şablon durmaz, ama negatif varyanslı parametreleri adlandırıp "çözüm geçersizdir" uyarısı yazar (B7). Küçük küme sayısı (<50) ve az gösterge bu sorunu artırır.
- Küme sayısı. Şablon en az 10 küme ister; 8 kümede durur. Güvenilir düzeyler arası kestirim için pratikte en az 50–100 küme gerekir (düzeyler arası SH'ler 0{,}03–0{,}08 gibi büyük).
- Yük eşitliği.
esit_yukaçıkken parametre sayısı 20\to18, \chi^2(12)=14{,}16 (p=0{,}29), \mathrm{BIC}=24\,300{,}0 (24\,309{,}6'dan küçük); lavaan "level-specific fit measures are not available" uyarısı verir ve tabloda yine SRMR yazılır (B6). Düzeyler arası ölçüm eşdeğerliği tek çözümlemeyle kanıtlanmaz. std_lvyalnız ölçek seçimidir. Eşit yük kapalıyken uyum aynıdır (\chi^2=8{,}0921); eşit yük açıkken etkisizdir (ilk yük zaten 1).- EM ve
nlminb. EM biraz gevşek durur (\chi^2 8{,}0924 karşı 8{,}0922; B8). - İki faktör. Faktör 2'nin göstergeleri faktör 1'dekilerle çakışmamalıdır; örnekte y_1–y_3 ve y_4–y_6 ile 42 parametre, \chi^2(36)=27{,}78.
- Kategorik tür. Göstergeler ve ortak değişkenler sayısal roldür; Veri sekmesinde kategorik olsalar da sayı olarak gelir ve sonuç değişmez (
p8_cfa_kat).
179.9 Uzman soruları
S1. Neden bir kümedeki bireyler için tek bir yoğunluk yerine düzey içi ve arası ayrışmış olabilirlik kullanılıyor?
Bireyler küme etkisi \boldsymbol\eta_B nedeniyle bağımlıdır; toplam kovaryans \mathbf I\otimes\boldsymbol\Sigma_W+\mathbf 1\mathbf 1^\top\otimes\boldsymbol\Sigma_B'dir. Ayrıştırma bu n_j p\times n_jp matrisin tersini ve determinantını p\times p matrislerle verir ve eşdeğerdir: bağımsız R yığılmış biçimiyle, Python ayrıştırmayla -12076{,}566'yı 10^{-6} içinde yeniden üretir.
S2. \chi^2 nasıl hesaplanıyor ve neden sd 10?
Doymuş model aynı koşullu yapıda \boldsymbol\Sigma_W ve \boldsymbol\Sigma_B'yi kısıtsız bırakır (6+6), regresyonlar da serbesttir (9+6) ve kesişimler 3'tür: 30 parametre. Model 20 parametre kestirir, \mathrm{sd}=10. Ortak değişkenlerin kendi varyansları sabit olduğundan sayıma girmez; sabit olmasaydı hem moment hem parametre artar ve sd değişmezdi, ama olabilirlik birleşik olurdu.
S3. Neden `std_all` düzeyler arası `y1` için 0{,}97?
Düzeyler arası düzeyde y1 artık varyansı 0{,}058, faktör payı 0{,}94'tür: küme farkları büyük ölçüde faktörle açıklanır. Bu standartlaştırma küme düzeyi varyans içindir (toplam değil); toplam varyansa göre açıklanan pay ICC ile çarpılarak bulunur.
S4. Yük eşitliği (`esit_yuk`) neyi sınar?
\boldsymbol\Lambda_W=\boldsymbol\Lambda_B: aynı faktörün iki düzeyde aynı ölçekte ölçülüp ölçülmediği (küme yanlılığının yokluğu). Örnekte \Delta\chi^2=14{,}16-8{,}09=6{,}07 (\Delta\mathrm{sd}=2, p=0{,}048 olağan varsayımla); BIC eşit yükü destekler (24\,300{,}0 karşı 24\,309{,}6). İkisi çelişirse küme sayısı küçük olduğunda sınamanın gücü düşük olduğu hatırlanmalıdır.
S5. MLR neden SH'yi değiştirir ama CFI'yı değiştirmez?
estimator = MLR SH'leri sağlam (Huber–White) SH ile ve \chi^2 için Satorra–Bentler ölçeklemesiyle verir. Tablonun üst bölümündeki cfi, tli, rmsea standart ifadelerdir ve MLR'de de ML değeridir; ölçekli karşılıkları (cfi.scaled, rmsea.scaled) ile sağlam karşılıkları (.robust) tablonun sonuna eklenir (B2).
S6. Küme ortalaması yerine düzey içi ortak değişkeni neden ayrıca küme ortalamasıyla yordamak gerekebilir?
Düzey içi ortak değişken (x) küme düzeyinde de değişiyorsa, düzey içi katsayı birey ve bağlam etkisinin karışımıdır. Şablon bunu denetlemez (B5). x'in küme ortalamasını ara_kovaryat olarak ekleyip x'i küme ortalamasından sapma olarak vermek iki etkiyi ayırır.
S7. Dengesiz küme büyüklüklerinde SH'ler nasıl etkilenir?
Olabilirlik küme başına \boldsymbol\Sigma_W+n_j\boldsymbol\Sigma_B ile n_j'yi içerir, bu yüzden dengesizlik doğru ele alınır; ama büyük kümeler düzeyler arası parametrelerde çok bilgi taşımaz (küme sayısı bilgidir). Çok sayıda tek gözlemli küme düzey içi bilgiyi azaltır (B4).
S8. Neden iki bağımsız hesap şablondan 10^{-4} ayrılıyor, birbirleriyle 10^{-8}?
Python ve R, gradyanı 10^{-9}'a indirir (Newton cilası); lavaan nlminb daha gevşek durur. Fark yöntemin farkı değil durma ölçütüdür.
179.10 Kaynaklar
- Dyer, N. G., Hanges, P. J., & Hall, R. J. (2005). Applying multilevel confirmatory factor analysis techniques to the study of leadership. The Leadership Quarterly, 16(1), 149–167. https://doi.org/10.1016/j.leaqua.2004.09.009
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Liang, J., & Bentler, P. M. (2004). An EM algorithm for fitting two-level structural equation models. Psychometrika, 69(1), 101–122. https://doi.org/10.1007/BF02295842
- Muthén, B. O. (1994). Multilevel covariance structure analysis. Sociological Methods & Research, 22(3), 376–398. https://doi.org/10.1177/0049124194022003006
- Muthén, B. O., & Satorra, A. (1995). Complex sample data in structural equation modeling. Sociological Methodology, 25, 267–316. https://doi.org/10.2307/271070
- R Core Team (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing.
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- Rosseel, Y. (2021). Evaluating the observed log-likelihood function in two-level structural equation modeling with missing data: From formulas to R code. Psych, 3(2), 197–232. https://doi.org/10.3390/psych3020017
- Ryu, E., & West, S. G. (2009). Level-specific evaluation of model fit in multilevel structural equation modeling. Structural Equation Modeling, 16(4), 583–601. https://doi.org/10.1080/10705510903203466
- Yuan, K.-H., & Bentler, P. M. (2007). Multilevel covariance structure analysis by fitting multiple single-level models. Sociological Methodology, 37(1), 53–82. https://doi.org/10.1111/j.1467-9531.2007.00182.x