180. Açımlayıcı yapısal eşitlik modeli (ESEM)
Şablon kimliği: esem · Kategori: yem · Dil: R · Dosya: pro/sablonlar/yem/esem.R (satır 1–195; üstbilgi 1–80) · Örnek veri: _ornek/holzinger.csv · Paketler: lavaan 0.7-2
180.1 Ne işe yarar
Şablon, her göstergenin her faktöre yüklenebildiği bir ölçme modelini (çapraz yüklere izin veren açımlayıcı faktör çözümü) yapısal eşitlik modelinin içinde kestirir, çözümü seçilen ölçütle döndürür ve istenirse faktörleri ortak değişkenlerle yordar. Cevapladığı soru şudur: "Maddelerim başka yapılara da küçük ama sıfırdan farklı yükler taşıyorsa, doğrulayıcı faktör çözümünün 'her madde tek faktöre' kısıtını bırakıp faktörleri ve aralarındaki ilişkileri uyum ölçütleri ve standart hatalarla birlikte nasıl kestiririm?"
Model, p gözlenen gösterge \mathbf x ve k faktör \mathbf f için
biçimindedir; \boldsymbol\Lambda (p\times k) bütün öğeleri serbest yük matrisidir. İsteğe bağlı ortak değişkenler \mathbf c faktörleri yordar: \mathbf f=\boldsymbol\Gamma\mathbf c+\boldsymbol\zeta (ESEM-MIMIC).
Ne zaman kullanılır?
- Doğrulayıcı faktör çözümünde çapraz yüklerin sıfıra zorlanması uyumu bozuyor ya da faktör korelasyonlarını şişiriyorsa (kişilik, tutum, zekâ ve klinik ölçeklerde sık görülür).
- Döndürülmüş faktörlerin ortak değişkenlerle (yaş, cinsiyet, grup göstergesi) ilişkisini tek modelde ve doğru standart hatalarla kestirmek için.
- Faktör sayısını sabitleyip k=1{,}2{,}3,\dots için uyum ölçütlerini yan yana görmek için (şablonu her k için ayrı çalıştırmak).
Ne zaman kullanılmaz?
- Yük yapısını önceden biliyorsanız ve kısıtlı yapıyı sınamak istiyorsanız:
sirali_cfa_wlsmv(sıralı maddeler için) ya da temel programdaki doğrulayıcı faktör analizi menüsü. - Maddeler sıralı (Likert, 0/1) ve kategori sayıları az ise: bu şablon göstergeleri sürekli sayar (
estimator = ML | MLR,orderedyoktur); eşikli çözüm içinsirali_cfa_wlsmv. - Gözlemler iç içe (öğrenci–okul) ise:
cok_duzeyli_cfa. Bu şablon tek düzeylidir. - Yalnız açımlayıcı faktör sayısı ve yük örüntüsü isteniyorsa ve uyum ölçütü ya da yapısal yol gerekmiyorsa: temel programdaki faktör analizi. Orada standart hata ve ortak değişken yolu yoktur; bu şablon ikisini de verir.
- Birden çok grubun ölçme eşdeğerliğini sınamak için: şablonda grup yapısı yoktur.
Temel programla ilişki. Temel programda açımlayıcı faktör analizi ve doğrulayıcı faktör analizi ayrı analizlerdir; döndürülmüş açımlayıcı çözüm yapısal bir modelin içine girmez ve faktörlerin ortak değişkenlerle ilişkisi aynı modelde kestirilmez. Bu şablon ikisini birleştirir: ölçme modeli açımlayıcıdır, yapısal yol ve uyum ölçütleri aynı \chi^2 çerçevesinden gelir. Aynı ML çözümü başka bir yerde bulunsa bile bu şablonun eğik döndürmelerde Kaiser normalleştirmesi yapmadığı (180.4.3) ve \chi^2 çarpanının N olduğu (180.4.2) unutulmamalıdır.
180.2 Şablonun girdileri
Form, üstbilgideki dokuz [[param]] bloğundan kurulur (esem.R:10–79). Türlerin ve formun ortak denetiminin anlamı Bölüm 1.2'de anlatılmıştır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Göstergeler (maddeler) · gostergeler |
sütunlar (yalnız sayısal, en az 3) · Değişkenler | yok | sayısal sütunlar | Ölçme modelinin göstergeleri; yinelenenler atılır (85, 10–16). |
Faktör sayısı · faktor_sayisi |
tamsayı · Model | 2 | 1–8 | k; efa("efa")*f1 + … + fk bloğunu kurar (89, 119; 17–24). |
Döndürme · dondurme |
seçim · Model | geomin |
geomin, oblimin, quartimin, varimax |
sem(…, rotation = ) (123; 25–31). |
Faktörleri yordayan ortak değişkenler · ortak |
sütunlar (sayısal, isteğe bağlı) · Değişkenler | boş | sayısal sütunlar | Doluysa f1 + … + fk ~ c1 + … satırı eklenir (86–88, 120; 32–38). |
Kestirici · kestirici |
seçim · Model | ML |
ML, MLR |
estimator = (123, 148; 39–45). |
Döndürme rastgele başlangıç sayısı · rastgele_baslangic |
tamsayı · Gelişmiş | 30 | 0–1000 | rotation.args$rstarts (124; 46–54); 5'ten küçükse uyarı yazılır (106–110). |
Geomin ε · geomin_eps |
ondalık · Gelişmiş | 0,001 | 0,000001–0,1 | rotation.args$geomin.epsilon; yalnız geomin döndürmede etkilidir (124; 55–63). |
Döndürme algoritması · dondurme_algoritmasi |
seçim · Gelişmiş | gpa |
gpa, pairwise |
rotation.args$algorithm (124; 64–71). |
Döndürmede satır ağırlıkları · satir_agirligi |
seçim · Gelişmiş | default |
default, kaiser, none |
default dışında rotation.args$row.weights (125; 72–79). |
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 84 |
| 3'ten az gösterge | "En az 3 gösterge seçin." | 91 |
| \mathrm{sd}=((p-k)^2-(p+k))/2<0 | "… gösterge için … faktör çok fazla (serbestlik derecesi negatif); faktör sayısını azaltın." | 92–93 |
| Tam gözlem sayısı <\max(30,\,2p) | "Gözlem sayısı gösterge sayısına göre çok az (en az 30 ve göstergelerin iki katı)." | 111 |
| Gösterge ya da ortak değişkenin standart sapması 0 | "'…' sabit; çıkarın." | 112 |
sem() hata verirse |
"Model kurulamadı: …" + lavaan iletisi | 126 |
| Yakınsama yok | "Model yakınsamadı; faktör sayısını azaltmayı deneyin." | 128 |
| Uygunsuz (Heywood) çözüm: negatif özgül varyans ya da 1'i aşan ortak varyans | Çalıştırma durmaz; "UYARI: uygunsuz (Heywood) çözüm …" satırı ve özet cümlesinden sonra bir çıktı notu yazılır | 129–145, 184 |
Eksik değerli satırlar complete.cases ile silinir (96); kestirimde kullanılan ve atılan satır sayısı "Gözlem: … satırın … tanesi kestirimde kullanıldı; eksik değer nedeniyle atılan satır: …" satırıyla yazılır (98–99). Hem gösterge hem ortak değişken seçilen sütun ortak değişken listesinden çıkarılır (86–88) ve çıkarılan sütun adı bir not satırıyla bildirilir (102–104). Göstergelerin standart sapmaları arasındaki oran 100'ü aşıyorsa göstergeler kendi standart sapmalarına bölünür ve çıktıya bir not düşülür (113–117, 185); standartlaştırılmış çözüm bundan etkilenmez.
Örnek ayar (ornek_param, satır 9): gostergeler = [x1 … x9], faktor_sayisi = 3, dondurme = geomin, kestirici = ML; öteki alanlar varsayılandadır.
Tohum. Şablonun formunda tohum alanı yoktur; ama döndürmenin rastgele başlangıçları rastgele sayı kullanır ve R süreci her çalıştırmada kullanıcı kodundan önce set.seed(mq_tohum) çağırır (Bölüm 1.3). Kod panelindeki Tohum alanı doluysa sonuç yinelenir; boşsa her çalıştırmaya yeni tohum atanır ve künyeye yazılır. Başlangıç sayısı yeterliyse (180.4.8) sonuç tohumdan bağımsızdır.
180.3 Örnek veri
holzinger.csv: Holzinger ve Swineford'un (1939) iki okulda (Pasteur ve Grant-White) 7. ve 8. sınıf 301 öğrenciye uyguladığı zihinsel yetenek testlerinin sonuçları. Beş sütun açıklayıcıdır (id, sex, ageyr, agemo, school, grade); dokuz test puanı x_1,\dots,x_9 göstergelerdir. Eksik değer yoktur; n=301.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
x1 Görsel algı |
gösterge (f1) | sayısal | ort. 4,936; sd 1,167 |
x2 Küp testi |
gösterge (f1) | sayısal | ort. 6,088; sd 1,177 |
x3 Şekil dizisi |
gösterge (f1) | sayısal | ort. 2,250; sd 1,131 |
x4 Paragraf anlama |
gösterge (f2) | sayısal | ort. 3,061; sd 1,164 |
x5 Cümle tamamlama |
gösterge (f2) | sayısal | ort. 4,341; sd 1,290 |
x6 Sözcük anlamı |
gösterge (f2) | sayısal | ort. 2,186; sd 1,096 |
x7 Hızlı toplama |
gösterge (f3) | sayısal | ort. 4,186; sd 1,090 |
x8 Hızlı sayı sayma |
gösterge (f3) | sayısal | ort. 5,527; sd 1,013 |
x9 Hızlı şekil ayırt etme |
gösterge (f3) | sayısal | ort. 5,374; sd 1,009 |
ageyr, agemo |
ortak değişken adayı | sayısal | yaş (yıl, ay) |
sex |
ortak değişken adayı | ikili (1, 2 kodlu sayı) | 1 ve 2 |
school, grade |
kullanılmıyor | ikili | okul (metin), sınıf |
Gösterge sütunları sayisal = true rolündedir; Veri sekmesindeki türleri ne olursa olsun R'ye sayı olarak gider (Bölüm 1.3). Kategorik sütunun düzey sırası bu şablonda kullanılmaz: sex ortak değişken olarak seçilirse 1 ve 2 değerleriyle sayısal girer ve katsayı "bir birim artış" (1'den 2'ye) içindir. Metin türündeki school ortak değişken olarak seçilemez (sayısal rol).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) oblimin; (3) quartimin; (4) varimax; (5) kestirici = MLR ve ortak = [ageyr, sex]; (6) k=1; (7) k=2; (8) k=4; (9) rastgele_baslangic = 0; (10) dondurme_algoritmasi = pairwise; (11) satir_agirligi = kaiser; (12) geomin_eps = 0,01; (13) 4 gösterge ve k=2 (hata).
180.4 Yöntem: formüller ve hesap adımları
Hesap şu sırayla yürür: (i) göstergeler ve ortak değişkenler alınır, eksik satırlar silinir ve sayıları bildirilir, adlar g1…gp, c1… biçiminde güvenli adlara çevrilir (94–117); (ii) lavaan sözdizimi kurulur ve sem() ile kestirilir (Rosseel, 2012; 118–128); (iii) lavaan önce döndürülmemiş ML çözümünü bulur, sonra yükleri döndürür ve standart hataları döndürülmüş parametreler için hesaplar; (iv) çözümün uygunluğu (Heywood) denetlenir (129–145); uyum ölçütleri, standartlaştırılmış yükler, faktör korelasyonları ve yapısal katsayılar tablolara yazılır (147–170); (v) özet cümlesi ve yük matrisi şekli üretilir (171–195).
180.4.1 Ölçme modeli ve kimliklendirme
Kısıtsız bir faktör modelinde \boldsymbol\Lambda bir dönüşümle çarpılsa (\boldsymbol\Lambda\mathbf T^{-\top}, \boldsymbol\Psi\to\mathbf T^{\top}\boldsymbol\Psi\mathbf T) \boldsymbol\Sigma değişmez; model bu dönüşüme kadar belirsizdir. Açımlayıcı çözüm şu kimliklendirmeyle kurulur: faktörler birim varyanslı ve dik (\boldsymbol\Psi=\mathbf I) alınır ve \boldsymbol\Lambda^{\top}\boldsymbol\Theta^{-1}\boldsymbol\Lambda köşegen yapılır; bu k(k-1)/2 kısıt getirir. Serbest parametre sayısı pk+p-k(k-1)/2, bilgi sayısı p(p+1)/2 olduğundan serbestlik derecesi
olur ve döndürmeden bağımsızdır. Örnek veride p=9, k=3: \mathrm{sd}=(36-12)/2=12.
- p: gösterge sayısı; k: faktör sayısı.
- \boldsymbol\Lambda: yük matrisi (p\times k), tüm öğeleri serbest.
- \boldsymbol\Psi: faktör kovaryans matrisi; döndürülmüş çözümde köşegeni 1'dir (eğik döndürmede köşegen dışı korelasyonlardır).
- \boldsymbol\Theta: köşegen artık (özgül) varyans matrisi.
Koddaki tercih
sd < 0 ise şablon sem()'i çağırmadan durur (92–93). Sınır k değeri \mathrm{sd}\ge0 koşulundan gelir: 9 gösterge için k=4 (\mathrm{sd}=6; çalıştırıldı) ve k=5 (\mathrm{sd}=(16-14)/2=1) serbestlik derecesi bakımından kabul edilir, k=6 (\mathrm{sd}=(9-15)/2<0) durur. Faktör sayısı yukarı çıktıkça sd küçüldüğünden uyum ölçütleri kendiliğinden iyileşir; k seçimi yalnız uyumla yapılmaz (180.8).
180.4.2 ML uyum fonksiyonu ve \chi^2
Örneklem kovaryans matrisi \mathbf S (n değil N=n ile bölünmüş) ve modelin ima ettiği \boldsymbol\Sigma için
- N: tam gözlem sayısı (örnek veride 301). lavaan'ın normal kuramlı olabilirlikte kullandığı çarpan N'dir, N-1 değil; bu yüzden \chi^2 klasik faktör analizi yazılımlarının "Bartlett düzeltmesiz" değerinin N/(N-1) katıdır.
- F_{\mathrm{ML}}: uyum fonksiyonu; model kusursuzsa 0.
\boldsymbol\Psi=\mathbf I iken ML çözümü kapalı biçimde bulunur (Jöreskog, 1967): özgül varyanslar \boldsymbol\Theta=\operatorname{diag}(\psi_1,\dots,\psi_p) verildiğinde \boldsymbol\Theta^{-1/2}\mathbf R\,\boldsymbol\Theta^{-1/2}'nin (\mathbf R korelasyon matrisi) özdeğerleri \vartheta_1\ge\dots\ge\vartheta_p ise
ve \boldsymbol\Lambda=\boldsymbol\Theta^{1/2}\mathbf V_k(\boldsymbol\vartheta_k-\mathbf I)^{1/2}'dir. Eniyileme yalnız p özgül varyans üzerindedir. Ölçekten bağımsızlık sayesinde kovaryans ya da korelasyon matrisiyle çalışmak aynı \chi^2'yi verir.
Neden N ve neden döndürmeden bağımsız?
Döndürme \boldsymbol\Sigma=\boldsymbol\Lambda\boldsymbol\Psi\boldsymbol\Lambda^{\top}+\boldsymbol\Theta'yı değiştirmez; yalnız onu bölüştürme biçimini seçer. Bu yüzden \chi^2, sd, CFI, TLI, RMSEA, SRMR, AIC, BIC ve ortak varyanslar dört döndürme seçeneğinde de birebir aynıdır (180.7). Döndürme yalnız yükleri ve faktör korelasyonlarını (ve onlarla birlikte standart hatalarını) değiştirir. Yapısal katsayılar da döndürmeye bağlıdır, çünkü faktörlerin kendisi döndürülür.
180.4.3 Döndürme ölçütleri
Döndürme, \mathbf T (k\times k, sütunları birim uzunluklu) dönüşümünü bir ölçütü en küçükleyecek biçimde seçer:
Şablonun sunduğu ölçütler:
- Geomin (Browne, 2001): \displaystyle f_{\text{geomin}}(\boldsymbol\Lambda)=\sum_{i=1}^{p}\Bigl(\prod_{j=1}^{k}(\lambda_{ij}^2+\varepsilon)\Bigr)^{1/k}. Her satırdaki kare yüklerin (\varepsilon eklenmiş) geometrik ortalamasını en küçükler: her gösterge birkaç faktörde sıfıra yakın yük almaya zorlanır. Eğik (faktörler ilişkili).
- Quartimin: \displaystyle f_{\text{quartimin}}=\sum_{i}\sum_{j<l}\lambda_{ij}^2\lambda_{il}^2; eğik. Oblimin (şablonda ayrı bir seçenek olarak) lavaan'da \gamma=0 ile çağrılır ve quartimin ile aynı ölçüttür; iki seçenek yinelemeli sonuçta 2\times10^{-6} içinde aynı yükleri verir (180.7).
- Varimax: yükü dik dönüşümlerle, her faktör içindeki kare yükler varyansını en büyükleyecek biçimde döndürür; \boldsymbol\Psi=\mathbf I kalır (dik).
- \lambda_{ij}: i. göstergenin j. faktördeki döndürülmüş yükü.
- \varepsilon: geomin'de küçük pozitif sabit (formda "Geomin ε", varsayılan 0,001). Çarpımın sıfır yük yüzünden 0 olmasını önler.
Neden ε = 0,001?
Geomin ölçütü \varepsilon\to0'da yük örüntüsünü en çok sadeleştirir; ama ölçütün yüzeyi çok sayıda yerel en küçükle doludur ve \varepsilon çok küçükken sonuç kararsızlaşır. \varepsilon ölçütün bir parçasıdır ve sonucu etkiler (Browne, 2001): lavaan varsayılanı 0,001'dir ve şablon bu değeri korur. Örnek veride \varepsilon=0{,}01 yükleri en çok 0,105 değiştirir (180.8).
Koddaki tercih
Algoritma rotation.args$algorithm ile gpa (gradyan izdüşüm; Bernaards ve Jennrich, 2005) ya da pairwise (ikili) seçilir (64–71, 124). Örnek veride ikisi 1{,}4\times10^{-5} içinde aynı çözümü verir. Satır ağırlığı default seçiliyken şablon row.weights argümanını hiç geçirmez (125), lavaan'ın varsayılanı geçerli olur; lavaan eğik döndürmelerde Kaiser normalleştirmesi uygulamaz (şablonun yan dosyasındaki karşılaştırma notu da böyle der); default bu nedenle none ile aynı sonucu verir. kaiser seçilirse yükler satır uzunluklarına bölünerek döndürülür ve geri çarpılır: bu başka bir ölçüt yüzeyidir ve örnek veride yükler 0,249'a kadar değişir.
180.4.4 Standart hatalar
Döndürülmüş yüklerin standart hataları, döndürülmemiş çözümün asimptotik kovaryansından, döndürme işleminin Jakobiyeni üzerinden delta yöntemiyle hesaplanır (Asparouhov ve Muthén, 2009). Bu hesabı lavaan yapar; şablon parameterEstimates() çıktısındaki p değerini, yükü değerlendirme cümlesinde kullanır (172). kestirici = MLR seçilirse standart hatalar Huber–White sandviç kestiricisiyle, test istatistiği Yuan–Bentler ölçeklenmiş biçimde hesaplanır (Yuan ve Bentler, 2000); uyum tablosunda chisq.scaled, pvalue.scaled, cfi.robust, tli.robust ve rmsea.robust satırları bu istatistiklerdir. Özet cümlesi de MLR'de bu ölçeklenmiş \chi^2 ve p ile sağlam CFI ve RMSEA'yı yazar ve bunu "(MLR: ölçeklenmiş χ² ve p, sağlam CFI ve RMSEA)" ibaresiyle belirtir (173–182).
180.4.5 Yapısal kısım (ESEM-MIMIC)
ortak doluysa modele \mathbf f=\boldsymbol\Gamma\mathbf c+\boldsymbol\zeta eklenir. Faktörler artık \boldsymbol\Psi=\operatorname{Var}(\boldsymbol\zeta) ile "ortak değişkenler denetlendikten sonra" faktör varyanslarıdır; şablon bu durumda tabloyu "Faktör artık korelasyonları" diye adlandırır (158–162). Standartlaştırılmış yapısal katsayı (std_kestirim) lavaan'ın std.all değeridir: hem faktör hem ortak değişken standartlaştırılmıştır.
Ortak değişken eklenince χ² ve sd modelin tamamınındır
Ortak değişkenler modele dışsal gözlenen değişken olarak girer ve gösterge üzerindeki doğrudan etkilerinin sıfır olduğu varsayımı da sınanır. Örnek veride ortak = [ageyr, sex] ile p=9 yerine 11 gözlenen değişken vardır ve sd 12 yerine 24 olur. Özet cümlesi yine "χ²(24) = …" yazar (180–182). Ölçme modelinin uyumunu ortak değişkensiz çalıştırmadan okuyun.
180.4.6 Uyum ölçütleri
Taban (bağımsızlık) modeli, \chi^2_b=N\{\sum\ln s_{jj}-\ln|\mathbf S|\}=N(-\ln|\mathbf R|) ve \mathrm{sd}_b=p(p-1)/2 ile tanımlıdır; bununla CFI (Bentler, 1990), TLI ve RMSEA şöyle hesaplanır:
RMSEA'nın %90 aralığı, \chi^2'nin merkezsiz \chi^2_{\mathrm{sd}}(\lambda) dağılımında P(\chi^2_{\mathrm{sd}}(\lambda)\le\chi^2_{\text{gözlenen}})=0{,}95 ve 0{,}05 veren merkezsizlik parametrelerinden \sqrt{\lambda/(N\,\mathrm{sd})} ile bulunur. SRMR, artık korelasyon matrisinin (köşegen dahil) alt üçgeninin karekök ortalama karesidir. AIC =-2\ell+2q, BIC =-2\ell+q\ln N; q serbest parametre sayısı (pk+p-k(k-1)/2=33), \ell ortalama yapısı doygun alınan normal log-olabilirliktir.
- \chi^2_b, \mathrm{sd}_b: taban modelinin ki-karesi ve serbestlik derecesi (örnek veride 918,852 ve 36).
- \ell: -\tfrac N2\{p\ln(2\pi)+\ln|\boldsymbol\Sigma|+\operatorname{tr}(\boldsymbol\Sigma^{-1}\mathbf S)\}.
Eşik değerler kural değil, yönergedir
Hu ve Bentler (1999) CFI/TLI ≥ 0,95, RMSEA ≤ 0,06, SRMR ≤ 0,08 önerir. Bu eşikler benzetimde, kısıtlı doğrulayıcı modeller için ve belirli koşullarda türetilmiştir; açımlayıcı çözüm daha esnek olduğundan uyumu kendiliğinden daha iyi görünür. Şablon eşik uygulamaz; yalnız \chi^2, CFI ve RMSEA'yı cümleye yazar.
180.4.7 Ölçek ve standartlaştırma
Şablon yalnız göstergeleri, en büyük ve en küçük standart sapma oranı 100'ü aşarsa kendi standart sapmalarına böler (116–117). ML çözümü ölçekten bağımsız olduğundan sonuçları değiştirmez; yalnız sayısal eniyilemeyi korur. Tabloya giren yükler lavInspect(fit, "std") ile (tam standartlaştırılmış) alınır (152–155): yük matrisi, faktör varyansı 1 ve gösterge varyansı 1 ölçeğindedir. Ortak varyans h_i^2=1-\theta_{ii}^{\text{std}} (özgül varyansın tümleyeni) olarak yazılır (155).
180.4.8 Yerel en küçükler ve rastgele başlangıçlar
Geomin ölçütü çok sayıda yerel en küçüğe sahiptir. lavaan, rstarts kadar rastgele başlangıç dönüşümüyle de döndürmeyi yineleyip en küçük ölçütlü çözümü seçer. Örnek verinin dönüşümsüz çözümünden 40 rastgele başlangıçla (Python, elle_hesap.py) iki en küçük bulunur: küresel f=0{,}188389 (24 başlangıçta) ve yerel f=0{,}190004 (16 başlangıçta). Yerel çözümde f1–f3 korelasyonu 0,103'tür (küresel çözümde 0,432) ve x8'in f1 yükü 0,251'dir (küresel çözümde 0,011).
rastgele_baslangic = 0 ve 1 örnek veride yerel çözüme düşer
Form rastgele_baslangic için 0'ı kabul eder. lavaan'da (tohum 1, 2, 3) rstarts = 0 ve (tohum 1, 2) rstarts = 1 yerel çözümü verir; rstarts = 5 ve üzeri her tohumda küresel çözümü bulur (en büyük sütun farkı 7\times10^{-7}). Yerel ve küresel çözümde \chi^2, CFI, RMSEA ve ortak varyanslar aynı olduğundan özet cümlesi ikisini ayırt etmez. Şablon başlangıç sayısı 5'ten küçükse bir UYARI satırı yazar (106–110); varsayılan 30'u küçültmeyin ve sonucu raporlamadan önce iki farklı tohumla yineleyip yüklerin aynı kaldığını denetleyin.
180.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 81–83 | Dil yardımcısı .m(); lavaan'ı yükler. |
Arayüz dili Türkçe dışındaysa İngilizce iletiler (mq_dil). |
| 84–96 | Veri ve parametre denetimi: gösterge (yinelenmeyen), ortak değişken (göstergelerden ayrı), k, p\ge3, sd, eksik satırların silinmesi. | Yalnız complete.cases kullanılır; eksik veri yöntemi seçeneği yoktur. |
| 97–110 | Kullanılan ve atılan gözlem sayısını yazar (98–99); gösterge olduğu için ortak değişken listesinden çıkarılan sütunu bildirir (102–104); başlangıç sayısı 5'ten küçükse uyarır (106–110). | Atılan satır sayısı ve çıkarılan ortak değişken artık çıktıda görünür. |
| 111–112 | n eşiği ve sabit sütun denetimi. | |
| 113–117 | Sütunları g1…, c1… adlarına çevirir; ölçek oranı 100'ü aşarsa göstergeleri standart sapmasına böler. |
lavaan sözdizimi özel karakterli adları kabul etmez; ters tırnak yerine güvenli ad kullanılır. |
| 118–120 | efa("efa")*f1 + … + fk =~ g1 + … + gp; ortak değişken varsa f1 + … + fk ~ c1 + …. |
Aynı "efa" etiketi bloğu tek açımlayıcı küme yapar: bütün yükler serbest, döndürme birlikte. |
| 121–128 | sem() çağrısı: rotation, estimator, rotation.args (rstarts, algorithm, geomin.epsilon, isteğe bağlı row.weights). Uyarılar toplanır; converged değilse durur. |
Yakınsama durumu denetlenir. |
| 129–145 | Uygunsuz (Heywood) çözüm denetimi: kestirilmiş ve standartlaştırılmış özgül varyans ile faktör varyansı negatif mi? Öyleyse çevrilmiş UYARI satırı yazılır, lavaan'ın İngilizce post_check uyarısı uyarı listesinden çıkarılır. |
Çalıştırma durmaz; yakınsama bu durumu dışlamaz (180.8). |
| 147–150 | Uyum ölçütleri tablosu: chisq, df, pvalue, cfi, tli, rmsea, rmsea.ci.lower, rmsea.ci.upper, srmr, aic, bic (MLR'de ayrıca chisq.scaled, pvalue.scaled, cfi.robust, tli.robust, rmsea.robust). |
MLR'de sağlam değerler yalnız bu tablodadır. |
| 152–163 | Tam standartlaştırılmış yük matrisi, ortak ve özgül varyans; k>1 ise faktör (artık) korelasyon tablosu. | Ortak değişken varsa korelasyon artık kovaryanstan (\operatorname{cov2cor}) türetilir. |
| 164–170 | Ortak değişkenli modelde yapısal katsayı tablosu (~ satırları): kestirim, SH, z, p, standartlaştırılmış. |
Kestirimler, gerçek ortak değişken ölçeğindedir (standartlaştırılmamış). |
| 171–187 | Özet cümlesi: n, p, k, \chi^2, sd, p, CFI, RMSEA ve |yük|\ge0{,}30 ile p<0{,}01 olan yük sayısı ile bunlardan çapraz yük sayısı; Heywood notu; ölçek notu; uyarılar. | MLR'de cümle ölçeklenmiş \chi^2 ve p ile sağlam CFI ve RMSEA'yı yazar ve bunu belirtir (173–182). |
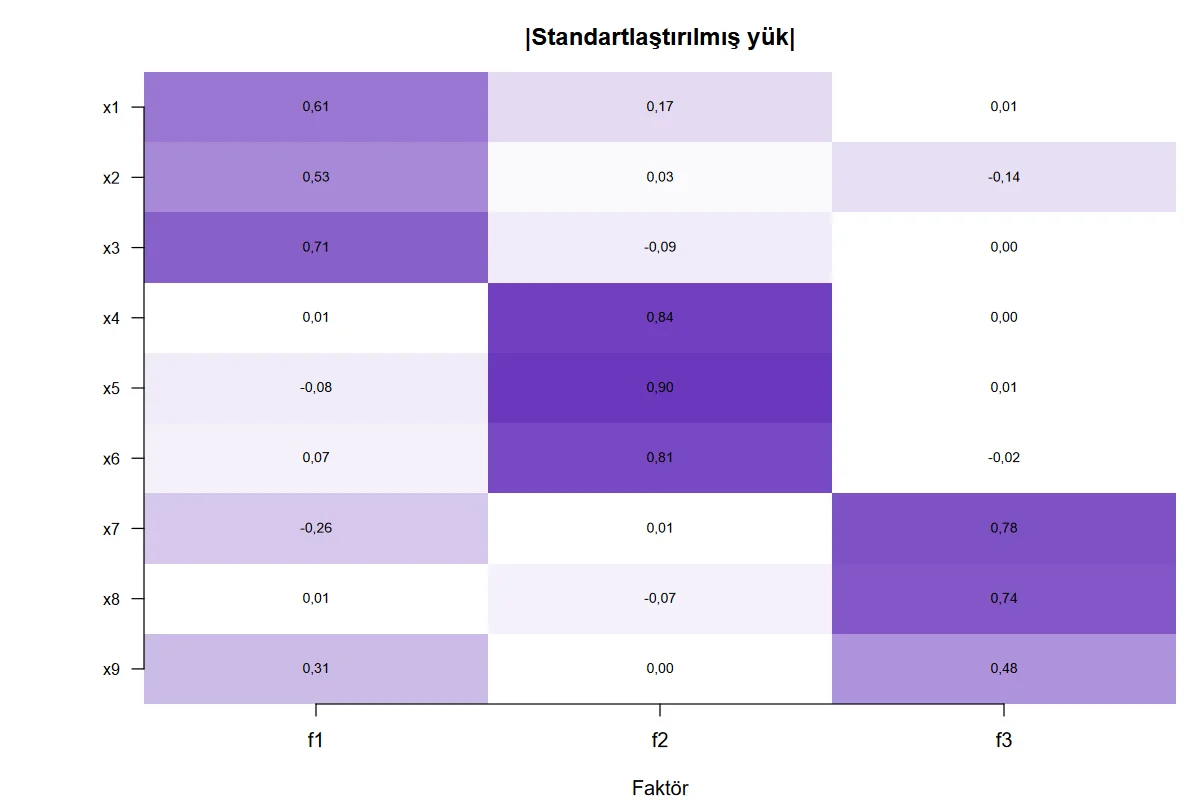
| 188–195 | Mutlak standartlaştırılmış yük ısı haritası (beyazdan mora), hücrelere yük yazılır. | Şekil tek panel; renk skalası 0–1 sabit. |
Özet cümlesindeki "çapraz yük" sayısı, ölçütü geçen yük sayısından, ölçütü geçen yükü olan farklı gösterge sayısını çıkararak bulunur (183). Yani bir göstergenin ikinci geçen yükü çapraz yük sayılır; hiç yükü ölçütü geçmeyen gösterge hiçbir şeye katkı yapmaz.
180.6 Elle hesap: örnek veride bağımsız yeniden hesap
Hesap dogrulama/esem/elle_hesap.py (numpy/scipy; lavaan ya da şablon çağrılmaz) ve dogrulama/esem/r_dogrulama.R (factanal ve GPArotation::GPFoblq) ile yapılmıştır.
Adım 1 — Korelasyon matrisi. N=301, \mathbf S (böleni N) ve \mathbf R; örneğin r_{x4,x5}=0{,}733, r_{x4,x6}=0{,}704, r_{x5,x6}=0{,}720, r_{x7,x8}=0{,}487, r_{x1,x3}=0{,}441. \mathbf R'nin özdeğerleri 3,2163; 1,6387; 1,3652; 0,6989; 0,5843; 0,4997; 0,4731; 0,2860; 0,2377 (üçü 1'den büyük).
Adım 2 — ML özgül varyanslar. F(\boldsymbol\Theta) sınırlı eniyilemeyle en küçüklenir (\psi_j\in[0{,}005;1]):
ve F_{\mathrm{ML}}=0{,}0760689; dolayısıyla \chi^2=301\times0{,}0760689=22{,}896735, sd =12, p=0{,}028616.
Adım 3 — Döndürülmemiş yükler. \boldsymbol\Lambda=\boldsymbol\Theta^{1/2}\mathbf V_3(\boldsymbol\vartheta_3-\mathbf I)^{1/2} ilk sütunu (-0{,}488;\ -0{,}245;\ -0{,}272;\ -0{,}835;\ -0{,}839;\ -0{,}823;\ -0{,}229;\ -0{,}270;\ -0{,}377)'dir. Ortak varyanslar satır kare toplamlarıdır: h^2=(0{,}4875;\ 0{,}2513;\ 0{,}4572;\ 0{,}7208;\ 0{,}7571;\ 0{,}6948;\ 0{,}4978;\ 0{,}5315;\ 0{,}4568).
Adım 4 — Taban modeli ve uyum ölçütleri. \chi^2_b=301\times(-\ln|\mathbf R|)=918{,}8516, \mathrm{sd}_b=36.
SRMR =0{,}017213; \ell=-3706{,}5405, q=33, AIC =7479{,}0811, BIC =7601{,}4157.
Adım 5 — Geomin döndürme. Dönüşümsüz yükten Bernaards–Jennrich gradyan izdüşümüyle (\varepsilon=0{,}001, 12 başlangıç) ölçüt en küçüklenir: f=0{,}188389. Döndürülmüş yükler (sütun sırası: en büyük yükün göstergesine göre; işaret: sütun toplamı pozitif):
| f1 | f2 | f3 | |
|---|---|---|---|
| x1 | 0,610596 | 0,170265 | 0,012451 |
| x2 | 0,533859 | 0,033235 | −0,141216 |
| x3 | 0,705076 | −0,094309 | 0,001540 |
| x4 | 0,009161 | 0,844403 | 0,003653 |
| x5 | −0,083363 | 0,895295 | 0,008969 |
| x6 | 0,069062 | 0,810298 | −0,015460 |
| x7 | −0,255154 | 0,010044 | 0,775022 |
| x8 | 0,011392 | −0,074101 | 0,743556 |
| x9 | 0,311642 | −0,002185 | 0,480881 |
Faktör korelasyonları \boldsymbol\Psi^{*}=\mathbf T^{\top}\mathbf T: r_{12}=0{,}373355, r_{13}=0{,}432175, r_{23}=0{,}306157. Bunlar, şablonun yük ve faktör korelasyon tablolarıyla 10⁻⁵ içinde örtüşür.
180.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun "Uyum ölçütleri", "Standartlaştırılmış yükler" ve "Faktör korelasyonları" tablolarından tam hassasiyetle alınmıştır. R sütunu lavaan kullanmaz: factanal ML çözümünü, GPArotation::GPFoblq geomin döndürmesini verir; taban modeli ve uyum ölçütleri açık formüllerle hesaplanmıştır.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | Ölçüt | |
|---|---|---|---|---|---|---|
| chisq | 22,89673461 | 22,89673461 | 22,89673461 | 9,6e−14 | 1e−6 | ✓ |
| df | 12 | 12 | 12 | 0 | 1e−6 | ✓ |
| cfi | 0,98765734 | 0,98765734 | 0,98765734 | 1,1e−14 | 1e−6 | ✓ |
| tli | 0,96297203 | 0,96297203 | 0,96297203 | 3,3e−14 | 1e−6 | ✓ |
| rmsea | 0,05492554 | 0,05492554 | 0,05492554 | 9,1e−15 | 1e−6 | ✓ |
| srmr | 0,0172135 | 0,0172135 | 0,0172135 | 8,9e−11 | 1e−6 | ✓ |
| p (χ²) | 0,02861554 | 0,02861554 | — | 7,1e−15 | 1e−6 | ✓ |
| RMSEA GA alt | 0,01737585 | 0,01737585 | — | 2,1e−9 | 1e−6 | ✓ |
| RMSEA GA üst | 0,08878318 | 0,08878318 | — | 2,8e−12 | 1e−6 | ✓ |
| AIC | 7479,08106609 | 7479,08106609 | — | 2,4e−16 | 1e−6 | ✓ |
| BIC | 7601,41570483 | 7601,41570483 | — | 6,0e−16 | 1e−6 | ✓ |
| ortak varyans x1 | 0,48747194 | 0,48747194 | 0,48747196 | 2,1e−8 | 1e−6 | ✓ |
| ortak varyans x2 | 0,25126421 | 0,25126422 | 0,25126419 | 2,8e−8 | 1e−6 | ✓ |
| ortak varyans x3 | 0,45722564 | 0,45722565 | 0,45722563 | 1,1e−8 | 1e−6 | ✓ |
| ortak varyans x4 | 0,72080696 | 0,72080696 | 0,72080696 | 3,2e−9 | 1e−6 | ✓ |
| ortak varyans x5 | 0,7571227 | 0,7571227 | 0,7571227 | 6,4e−9 | 1e−6 | ✓ |
| ortak varyans x6 | 0,69478419 | 0,6947842 | 0,69478419 | 3,1e−9 | 1e−6 | ✓ |
| ortak varyans x7 | 0,49779143 | 0,49779143 | 0,49779144 | 1,7e−8 | 1e−6 | ✓ |
| ortak varyans x8 | 0,53145042 | 0,53145041 | 0,53145039 | 2,2e−8 | 1e−6 | ✓ |
| ortak varyans x9 | 0,45675328 | 0,45675328 | 0,45675329 | 1,1e−8 | 1e−6 | ✓ |
| geomin yük x1·f1 | 0,61059518 | 0,61059562 | 0,61059565 | 4,7e−7 | 1e−5 | ✓ |
| geomin yük x1·f2 | 0,17026556 | 0,17026491 | 0,1702649 | 6,6e−7 | 1e−5 | ✓ |
| geomin yük x1·f3 | 0,01245134 | 0,01245135 | 0,01245134 | 1,3e−8 | 1e−5 | ✓ |
| geomin yük x2·f1 | 0,533859 | 0,53385921 | 0,53385917 | 2,1e−7 | 1e−5 | ✓ |
| geomin yük x2·f2 | 0,03323548 | 0,03323499 | 0,033235 | 5,0e−7 | 1e−5 | ✓ |
| geomin yük x2·f3 | −0,14121579 | −0,14121582 | −0,1412158 | 2,4e−8 | 1e−5 | ✓ |
| geomin yük x3·f1 | 0,70507592 | 0,70507608 | 0,70507606 | 1,5e−7 | 1e−5 | ✓ |
| geomin yük x3·f2 | −0,0943087 | −0,09430928 | −0,09430927 | 5,8e−7 | 1e−5 | ✓ |
| geomin yük x3·f3 | 0,00153972 | 0,00153962 | 0,00153963 | 1,0e−7 | 1e−5 | ✓ |
| geomin yük x4·f1 | 0,00915947 | 0,00916053 | 0,00916055 | 1,1e−6 | 1e−5 | ✓ |
| geomin yük x4·f2 | 0,84440338 | 0,84440288 | 0,84440287 | 5,1e−7 | 1e−5 | ✓ |
| geomin yük x4·f3 | 0,00365243 | 0,00365276 | 0,00365277 | 3,4e−7 | 1e−5 | ✓ |
| geomin yük x5·f1 | −0,08336422 | −0,08336314 | −0,08336312 | 1,1e−6 | 1e−5 | ✓ |
| geomin yük x5·f2 | 0,89529517 | 0,89529472 | 0,89529472 | 4,5e−7 | 1e−5 | ✓ |
| geomin yük x5·f3 | 0,00896866 | 0,00896902 | 0,00896903 | 3,7e−7 | 1e−5 | ✓ |
| geomin yük x6·f1 | 0,06906091 | 0,06906194 | 0,06906195 | 1,0e−6 | 1e−5 | ✓ |
| geomin yük x6·f2 | 0,81029854 | 0,81029801 | 0,810298 | 5,4e−7 | 1e−5 | ✓ |
| geomin yük x6·f3 | −0,01546071 | −0,01546039 | −0,01546039 | 3,2e−7 | 1e−5 | ✓ |
| geomin yük x7·f1 | −0,2551543 | −0,25515416 | −0,25515416 | 1,4e−7 | 1e−5 | ✓ |
| geomin yük x7·f2 | 0,01004431 | 0,01004449 | 0,01004449 | 1,9e−7 | 1e−5 | ✓ |
| geomin yük x7·f3 | 0,77502227 | 0,77502221 | 0,77502222 | 5,4e−8 | 1e−5 | ✓ |
| geomin yük x8·f1 | 0,0113914 | 0,01139153 | 0,01139153 | 1,3e−7 | 1e−5 | ✓ |
| geomin yük x8·f2 | −0,07410055 | −0,07410055 | −0,07410055 | 4,2e−9 | 1e−5 | ✓ |
| geomin yük x8·f3 | 0,74355649 | 0,74355638 | 0,74355636 | 1,3e−7 | 1e−5 | ✓ |
| geomin yük x9·f1 | 0,31164128 | 0,31164153 | 0,31164154 | 2,6e−7 | 1e−5 | ✓ |
| geomin yük x9·f2 | −0,00218436 | −0,00218467 | −0,00218467 | 3,0e−7 | 1e−5 | ✓ |
| geomin yük x9·f3 | 0,48088062 | 0,48088054 | 0,48088054 | 7,9e−8 | 1e−5 | ✓ |
| faktör korelasyonu f1–f2 | 0,37335529 | 0,37335488 | 0,37335487 | 4,3e−7 | 1e−5 | ✓ |
| faktör korelasyonu f1–f3 | 0,43217541 | 0,43217538 | 0,43217538 | 2,6e−8 | 1e−5 | ✓ |
| faktör korelasyonu f2–f3 | 0,30615821 | 0,30615743 | 0,30615742 | 8,0e−7 | 1e−5 | ✓ |
Ölçütü karşılayan: 50/50. Döndürülmüş değerler yinelemeli döndürmenin yakınsama toleransından dolayı 10⁻⁵ ölçütüyle karşılaştırılmıştır; χ², uyum ölçütleri ve ortak varyanslar döndürmeden bağımsızdır ve 10⁻⁶ ölçütüyle karşılaştırılmıştır.
Döndürülmüş yüklerde ve faktör korelasyonlarında ölçüt 10^{-5}'tir: döndürme yinelemelidir ve lavaan, GPArotation ve Python'daki gradyan izdüşüm uygulamaları kendi yakınsama toleranslarında durur (en büyük fark 6\times10^{-6}). Ortak varyanslar ve \chi^2 döndürmeden bağımsız kapalı çözümdür; ölçüt 10^{-6}'dir. Üstbilgideki öğretici değerleri de (χ² = 22,897, sd = 12) örtüşür.
180.7 Çıktıyı okuma
Örnek ayar çıktısı (tablolar tam hassasiyetle saklanır; burada altı anlamlı basamak):
Gözlem: 301 satırın 301 tanesi kestirimde kullanıldı; eksik değer nedeniyle atılan satır: 0 (liste boyu silme).
n = 301; 9 gösterge, 3 faktör; χ²(12) = 22,897; p = 0,0286; CFI = 0,988; RMSEA = 0,055. |yük| ≥ 0,30 ve p < 0,01 olan yük sayısı: 10 (bunlardan çapraz yük: 1).

Uyum ölçütleri
chisq 22.8967   df 12   pvalue 0.0286155   cfi 0.987657   tli 0.962972
rmsea 0.0549255 [0.0173758, 0.0887832]    srmr 0.0172135   aic 7479.08   bic 7601.42

Standartlaştırılmış yükler (döndürme: geomin) ve ortak varyanslar
gosterge        f1          f2          f3  ortak_varyans  ozgul_varyans
x1        0.610595    0.170266   0.0124513       0.487472       0.512528
x2        0.533859   0.0332355   -0.141216       0.251264       0.748736
x3        0.705076  -0.0943087  0.00153972       0.457226       0.542774
x4      0.00915947    0.844403  0.00365243       0.720807       0.279193
x5      -0.0833642    0.895295  0.00896866       0.757123       0.242877
x6       0.0690609    0.810299  -0.0154607       0.694784       0.305216
x7       -0.255154   0.0100443    0.775022       0.497791       0.502209
x8       0.0113914  -0.0741006    0.743556        0.53145        0.46855
x9        0.311641 -0.00218436    0.480881       0.456753       0.543247

Faktör korelasyonları
faktor       f1       f2       f3
f1            1 0.373355 0.432175
f2     0.373355        1 0.306158
f3     0.432175 0.306158        1
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Özet cümlesi | n, p, k, \chi^2, sd, p, CFI, RMSEA (MLR'de ölçeklenmiş \chi^2 ve p, sağlam CFI ve RMSEA); ölçütü geçen yük sayısı ve çapraz yük sayısı | Örnekte 9 göstergenin hepsinin ana yükü var (9 yük) ve x9'un f1'deki yükü (0,312) ölçütü geçen tek çapraz yüktür. \chi^2 anlamlıdır (p=0{,}029): kesin uyum reddedilir; CFI ve RMSEA yaklaşık uyumu gösterir. |
| Uyum ölçütleri | chisq…bic |
Dört döndürmede de aynıdır; faktör sayısı değiştikçe sd ve ölçütler değişir. AIC ve BIC yalnız aynı veride k karşılaştırır (örnekte k=4: 7473,58 / 7618,15; k=3: 7479,08 / 7601,42; BIC k=3'ü seçer). |
| Yükler | tam standartlaştırılmış, döndürülmüş | Bir gösterge ile faktör arasındaki, öteki faktörler sabit tutulduğundaki standartlaştırılmış kısmi ilişki. Eğik çözümde yük korelasyon değil, örüntü katsayısıdır; faktörler ilişkili olduğundan yük kareleri toplanmaz. |
ortak_varyans, ozgul_varyans |
h^2 ve 1-h^2 | x2'nin ortak varyansı 0,251: dört test x2 varyansının dörtte birini ortak faktörlere bağlar. |
| Faktör korelasyonları | \boldsymbol\Psi^{*} | Eğik döndürmede kestirilen; varimax'ta 0. Ortak değişkenli modelde "artık" korelasyondur. |
| Yapısal katsayılar | kestirim, SH, z, p, std_kestirim |
Ortak değişkenin bir birimlik artışının, öteki ortak değişkenler sabitken faktör puanını kaç birim değiştirdiği (faktörün varyansı 1 ölçeğinde). |
| Yük ısı haritası | mutlak standartlaştırılmış yük | Koyu hücre büyük yük; sütun başına en az bir koyu kümenin görünmesi beklenir. |
Şekil 180.1. Şablonun çizdiği mutlak standartlaştırılmış yük matrisi (örnek ayar, geomin). Satırlar göstergeler, sütunlar faktörlerdir.
Faktör sayısı ve döndürme karşılaştırması (aynı veri):
| Çalıştırma | \chi^2 (sd) | CFI | RMSEA | f1–f2 | f1–f3 | f2–f3 |
|---|---|---|---|---|---|---|
| k=1 | 312,264 (27) | 0,677 | 0,187 | |||
| k=2 | 130,306 (19) | 0,874 | 0,140 | |||
| k=3, geomin | 22,897 (12) | 0,988 | 0,055 | 0,373 | 0,432 | 0,306 |
| k=3, oblimin (= quartimin) | 22,897 (12) | 0,988 | 0,055 | 0,326 | 0,270 | 0,216 |
| k=3, varimax | 22,897 (12) | 0,988 | 0,055 | 0 | 0 | 0 |
| k=4 (uygunsuz çözüm) | 5,392 (6) | 1,000 | 0,000 |
Oblimin ve quartimin'in yükleri 1{,}6\times10^{-6} içinde aynıdır. Geomin yükleri x7'nin f1'e −0,255 (geomin) ve −0,152 (oblimin) yüklediğini gösterir: aynı verinin eğik döndürmeleri çapraz yükleri farklı biçimde dağıtır.
Rapor cümlesi. Holzinger ve Swineford (1939) verisinde (n = 301) dokuz test için üç faktörlü açımlayıcı yapısal eşitlik modeli (ML kestirimi, geomin döndürmesi, ε = 0,001) kestirildi. Model kesin uyumu reddetti, χ²(12) = 22,897, p = 0,029, ancak yaklaşık uyum yeterliydi (CFI = 0,988; TLI = 0,963; RMSEA = 0,055, %90 GA [0,017; 0,089]; SRMR = 0,017). Görsel testler f1'e (0,534–0,705), sözel testler f2'ye (0,810–0,895), hız testleri f3'e (0,481–0,775) yüklendi; x9'un f1'deki çapraz yükü 0,312 idi. Faktörler orta düzeyde ilişkiliydi (r = 0,31–0,43).
180.8 Sık hatalar ve tuzaklar
- Yerel çözüme düşmek.
rastgele_baslangic = 0ya da 1 yerel çözüm verebilir; \chi^2 aynı kaldığından fark özet satırından anlaşılmaz (180.4.8). Şablon 5'ten küçük değerde UYARI satırı yazar. Yükler ve faktör korelasyonları yalnız çok başlangıçla güvenilirdir. - Heywood (uygunsuz) çözüm. k=4'te x4'ün ortak varyansı 1,070 (özgül varyans −0,070), x5'in ki 1,700'dür (yük 1,304); TLI 1,004'tür. Model sayısal olarak yakınsar, ama çözüm geçerli değildir. Şablon yakınsamanın yanında negatif özgül varyansı da denetler (129–145): "UYARI: uygunsuz (Heywood) çözüm …" satırını (hangi göstergelerin etkilendiğiyle birlikte) ve özet cümlesinden sonra bir çıktı notunu yazar; tablolar yine üretilir, ama uyum ölçütleri güvenilir değildir. Çok sayıda faktör, küçük örneklem ya da az gösterge bu duruma yol açar (Dillon, Kumar ve Mulani, 1987). Uygunsuz çözümde yük tablosu raporlanmaz; faktör sayısı azaltılır.
- MLR'de hangi istatistik raporlanır.
kestirici = MLRseçilince özet cümlesi ölçeklenmiş \chi^2 ve p ile sağlam CFI ve RMSEA'yı yazar (173–182); ortak değişkenli örnekte \chi^2(24)=42{,}967 (p=0{,}0100), CFI 0,980, RMSEA 0,051. Uyum tablosunda ölçeklenmemişchisq(42,042; p=0{,}0128),cfi(0,981) vermsea(0,050) satırları da durur; MLR'de raporda ölçeklenmiş ve sağlam satırlar kullanılır. - Faktör sayısını yalnız uyumla seçmek. k arttıkça sd düşer ve \chi^2 kendiliğinden küçülür (k=2: CFI 0,874; k=3: 0,988; k=4: uygunsuz). Kuramsal gerekçe, yorumlanabilir yük örüntüsü ve (varsa) paralel analiz birlikte kullanılır.
- Sıralı ya da ikili maddeler. Şablon göstergeleri sürekli sayar. 5'ten az kategorili maddeler için Pearson korelasyonları yükleri aşağı çeker;
sirali_cfa_wlsmvkullanın. İkili bir sütunsayisal = truerolünde gösterge olarak seçilebilir ve uyarı verilmez. - Döndürme yönünün işaret ve sütun sırası. Faktör sırası ve işareti lavaan'dan gelir (sütun işareti, sütun toplamını pozitif yapacak biçimde); farklı yazılımlarla karşılaştırırken sütunları yükleriyle eşleyin.
- Eksik değer. Eksik değerli satır silinir (liste boyu silme); kullanılan ve atılan satır sayısı "Gözlem: …" satırında yazılır. Çok eksik değer varsa önce bu sayıyı denetleyin; ortak değişkenli modelde ortak değişkendeki eksik, gösterge verisi tam olan gözlemi de atar.
- Ortak değişken eklemek \chi^2'yi değiştirir. Ölçme modelinin uyumu ortak değişkensiz çalıştırmadan okunur (180.4.5).
- Gösterge ve ortak değişken aynı sütun. Ortak değişken listesinden çıkarılır (86–88) ve çıkarılan sütun adı bir not satırıyla bildirilir (102–104).
- Oblimin ile quartimin aynıdır. İki seçenek farklı sonuç beklenerek seçilmemelidir.
- Kaiser normalleştirmesi.
satir_agirligi = kaiserbaşka bir ölçüt yüzeyidir; örnek veridedefault'tan en çok 0,249 farklı yük verir. Yayımlanmış sonuçla karşılaştırırken hangi normalleştirmenin kullanıldığı öğrenilmelidir. - Geomin ε. \varepsilon=0{,}01 yükleri en çok 0,105 değiştirir; ε değeri raporda yazılır.
180.9 Uzman soruları
S1. ESEM ile doğrulayıcı faktör analizi ne zaman farklı bir sonuç verir ve hangisini raporlamalıyım?
Doğrulayıcı çözüm, çapraz yükleri sıfıra zorlar; gerçek çapraz yükler varsa bu kısıt yükleri ve faktör korelasyonlarını şişirir ve uyumu bozar. ESEM çapraz yükleri serbest bırakır; örnek veride x9'un f1 yükü 0,312'dir. Karar iki modelin uyumu, faktör korelasyonlarının farkı ve kuramsal beklentiyle verilir (Marsh ve ark., 2014); ESEM'in serbest parametre sayısı daha büyük olduğundan uyumu yapısal olarak daha iyidir ve bu tek başına ESEM'i seçmek için gerekçe değildir.
S2. χ² neden dört döndürmede aynı, yüklerse farklı?
Döndürme \boldsymbol\Sigma'yı değiştirmez; yalnız \boldsymbol\Lambda\boldsymbol\Psi\boldsymbol\Lambda^{\top}'in nasıl bölüştürüldüğünü seçer. \chi^2, sd, CFI, TLI, RMSEA, SRMR, AIC, BIC ve ortak varyanslar yalnız \boldsymbol\Sigma'ya bağlıdır (180.4.2). Yükler, faktör korelasyonları ve yapısal katsayılar seçilen ölçüte bağlıdır.
S3. Geomin'in yerel en küçükleri sonucu değiştirir mi ve nasıl denetlenir?
Evet. Örnek veride yerel çözüm f1–f3 korelasyonunu 0,432 yerine 0,103 verir. Başlangıç sayısı 30'dur; her başlangıçta aynı en küçük ölçütün bulunup bulunmadığı çıktıya yazılmaz, bu yüzden sonucu iki farklı tohumla yinelemek ve ölçüt yüzeyinin düz olmadığından emin olmak gerekir. \varepsilon'yu büyütmek (0{,}01) yüzeyi düzleştirir ve yerel en küçükleri azaltır, fakat sonucu değiştirir.
S4. Başka bir faktör analizi uygulamasıyla ne kadarı karşılaştırılabilir?
Ölçme kısmı için ML çözümü, ortak varyanslar ve \chi^2 kapalı çözümdür; bir ML faktör analizi uygulamasının sonucuyla (\chi^2 çarpanı N-1 ve N farkı gözetilerek) aynıdır. Geomin döndürme ve ortak değişkenden faktöre yol ise döndürülmüş faktörlerin yapısal modelin içinde kestirilmesini gerektirir; bunlar yalnız bu tür modelleri kuran araçlarda vardır. Bu nedenle bölümün doğrulaması \chi^2 ve ortak varyanslar için kapalı çözümle, döndürme için bağımsız gradyan izdüşümüyle yapılmıştır (180.6).
S5. Eğik döndürmede neden Kaiser normalleştirmesi yok?
lavaan eğik döndürmelerde satır ağırlığı varsayılanını "yok" alır; şablon satir_agirligi = default iken argümanı geçirmez ve lavaan'ın varsayılanını kullanır (125). Başka yazılımlarda aynı ölçütün varsayılanı Kaiser normalleştirmesidir; bu, yükleri 0,249'a kadar değiştirir. Yayımlanmış bir çözümü yinelemek için kaiser ya da none açıkça seçilir.
S6. k=4'te CFI = 1,000 ve RMSEA = 0,000 çıkıyor; model iyi mi?
Hayır. Aynı çözümde x5'in ortak varyansı 1,700 ve özgül varyansı −0,700'dür; TLI 1'i aşar. Bunlar Heywood çözümünün işaretleridir ve uyum ölçütleri anlamsızdır. Şablon bu çözümü "uygunsuz (Heywood)" diye uyarıyla işaretler ve özet cümlesinden sonra çıktı notu yazar (129–145, 184; 180.8).
S7. MLR'de hangi istatistiği raporlayacağım?
Ölçeklenmiş \chi^2 ve sağlam CFI, TLI, RMSEA uyum tablosunda chisq.scaled, pvalue.scaled, cfi.robust, tli.robust, rmsea.robust satırlarındadır; özet cümlesindeki \chi^2, p, CFI ve RMSEA da MLR'de bu ölçeklenmiş ve sağlam değerlerdir ve cümle bunu belirtir. Raporda bu değerler kullanılır.
S8. Faktör sayısına nasıl karar vereceğim ve şablon bunda yardımcı olur mu?
Şablon yalnız seçilen k için uyum verir. Örnekte k=1 (CFI 0,677) ve k=2 (0,874) açıkça yetersiz, k=3 (0,988) iyi, k=4 uygunsuz. Karar, \mathbf R'nin özdeğerlerine (3,22; 1,64; 1,37; 0,70, …: üç özdeğer 1'in üzerinde), paralel analize ve yorumlanabilirliğe de dayanır; paralel analiz bu şablonda yoktur.
180.10 Kaynaklar
- Asparouhov, T., & Muthén, B. (2009). Exploratory structural equation modeling. Structural Equation Modeling: A Multidisciplinary Journal, 16(3), 397–438. https://doi.org/10.1080/10705510903008204
- Bentler, P. M. (1990). Comparative fit indexes in structural models. Psychological Bulletin, 107(2), 238–246. https://doi.org/10.1037/0033-2909.107.2.238
- Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- Browne, M. W. (2001). An overview of analytic rotation in exploratory factor analysis. Multivariate Behavioral Research, 36(1), 111–150. https://doi.org/10.1207/S15327906MBR3601_05
- Dillon, W. R., Kumar, A., & Mulani, N. (1987). Offending estimates in covariance structure analysis: Comments on the causes of and solutions to Heywood cases. Psychological Bulletin, 101(1), 126–135. https://doi.org/10.1037/0033-2909.101.1.126
- Holzinger, K. J., & Swineford, F. (1939). A study in factor analysis: The stability of a bi-factor solution (Supplementary Educational Monographs, No. 48). University of Chicago.
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Jöreskog, K. G. (1967). Some contributions to maximum likelihood factor analysis. Psychometrika, 32(4), 443–482. https://doi.org/10.1007/BF02289658
- Marsh, H. W., Morin, A. J. S., Parker, P. D., & Kaur, G. (2014). Exploratory structural equation modeling: An integration of the best features of exploratory and confirmatory factor analysis. Annual Review of Clinical Psychology, 10, 85–110. https://doi.org/10.1146/annurev-clinpsy-032813-153700
- R Core Team (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- Rosseel, Y., Jorgensen, T., & De Wilde, L. (2026). lavaan: Latent variable analysis (R paketi, sürüm 0.7-2). https://CRAN.R-project.org/package=lavaan
- Yuan, K.-H., & Bentler, P. M. (2000). Three likelihood-based methods for mean and covariance structure analysis with nonnormal missing data. Sociological Methodology, 30(1), 165–200. https://doi.org/10.1111/0081-1750.00078