160. Gizli Markov modeli
Şablon kimliği: gizli_markov · Kategori: çok değişkenli · Dil: R · Dosya: pro/sablonlar/cok_degiskenli/gizli_markov.R (satır 1–247; üstbilgi 1–97) · Örnek veri: _ornek/speed.csv · Paketler: depmixS4 1.5-4 (R 4.5.3)
160.1 Ne işe yarar
Şablon, doğrudan gözlenemeyen bir durum dizisinin arkasındaki gözlemleri modeller. Gözlenen bir ya da birkaç yanıt dizisinin (tepki süresi, doğru/yanlış, sayım) her anda ikiden beşe kadar gizli durumdan birine bağlı olduğu varsayılır; durumlar bir Markov zinciri izler ve geçiş olasılıkları isteğe bağlı ortak değişkenlere (ör. görevin hız ya da doğruluk vurgusu) bağlanabilir. Cevapladığı sorular şunlardır: kaç durum, durumların yanıt dağılımları nedir, bir durumdan ötekine geçiş olasılığı nedir, hangi gözlem hangi durumdadır?
Ne zaman kullanılır?
- Gözlemler zamanda ardışıksa ve ortalama ya da dağılım zaman içinde anahtar atar gibi değişiyorsa (dikkat ve strateji dönüşleri, rejim değişimleri).
- Durumların kimliği önceden bilinmiyor, ama yanıt dağılımlarının farklı olacağı beklenen az sayıda durum varsa.
- Geçiş olasılıklarının bir ortak değişkenle (görev koşulu, zaman) değişip değişmediği soruluyorsa.
Ne zaman kullanılmaz?
- Rejimlerin bir zaman serisinin ortalaması ve değişkenliğindeki kaymalar olduğu, ardışık bağımlılık ve ARMA yapısının da modellenmesi gerektiği durumda:
markov_rejimşablonu (zaman serisi kategorisi). - Durumlar gözlenebiliyorsa (örneğin bir kategorik zaman serisi): sıradan Markov zinciri; gizli durum gerekmez.
- Gözlemler arasında ardışıklık yok, yalnız bilinmeyen alt grupların varlığı soruluyorsa: temel programdaki sonlu karışım ya da kümeleme analizi, MerQuR+'ta
sonlu_karisim_regresyon(Bölüm 165). - Çok kısa diziler (n<10k) için; şablon bu durumda durur (160.2).
Temel programla ilişki. Temel programda gizli Markov modeli yoktur. Sonlu karışım modeli yalnız \pi_i ağırlıklı durumlar varsayar ve durumlar arası geçişi modellemez; gizli Markov modeli, karışımın bir genellemesidir (a_{ij}=\pi_j olduğunda ikisi aynıdır).
160.2 Şablonun girdileri
Form, üstbilgideki 12 [[param]] bloğundan kurulur (gizli_markov.R:11–96). Türlerin ve ortak denetimin anlamı Bölüm 1.2'de anlatılmıştır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıtlar · yanitlar |
sütunlar (en az 1) · Değişkenler | yok | herhangi bir sütun | Sayısal sütun durum içinde normal (ya da Poisson), metin/kategorik sütun çok terimlidir (11–16, 112–128). |
Durum sayısı · k |
tamsayı · Model | 2 | 2–5 | Gizli durum sayısı (17–24, 106). |
Geçiş ortak değişkenleri · gecis_ortak |
sütunlar (sayısal) · Değişkenler | boş | sayısal sütunlar | Geçiş olasılığını belirleyen değişkenler (25–31, 104, 129–132, 139). |
Standartlaştır · olcekle |
onay · Seçenekler | açık | açık/kapalı | Ortak değişkenler (x-\bar x)/s yapılır (32–37, 131). |
Dizi kimliği · seri |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Ardışık satırlardaki dizileri ayırır (38–43, 102, 133–138). |
Rastgele başlangıç sayısı · baslangic |
tamsayı · Gelişmiş | 10 | 1–100 | EM'in tekrarlanma sayısı (44–51, 145–157). |
Sayısal yanıtların dağılımı · sayisal_aile |
seçim · Model | gaussian | gaussian, poisson |
Sayısal yanıtın dağılımı (52–59, 117–120). |
EM durum ataması · siniflama |
seçim · Model | soft | soft, hard |
Olağan EM ya da Viterbi eğitimi (60–66, 147). |
En çok EM yinelemesi · en_cok_yineleme |
tamsayı · Gelişmiş | 500 | 10–100000 | EM yineleme üst sınırı (67–74, 147). |
Yakınsama toleransı · tolerans |
ondalık · Gelişmiş | 10^{-8} | 10^{-14}–0,01 | EM durma eşiği (75–82, 147). |
Yakınsama ölçütü · olcut |
seçim · Gelişmiş | relative | relative, absolute |
Göreli ya da mutlak log-olabilirlik değişimi (83–89, 147). |
Yüksek duyarlık · duyarlik |
onay · Gelişmiş | kapalı | açık/kapalı | Açıkken tolerans en çok 10^{-10}, yineleme sınırı en az 2000 alınır (90–96, 143–144). |
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 101 |
| Yanıt seçilmemiş (dizi kimliği çıkarıldıktan sonra) | "En az bir yanıt seçin." | 105 |
| Dizi kimliğinde eksik | "Dizi kimliğinde eksik değer var." | 108 |
| Yanıtlarda ya da ortak değişkenlerde eksik | "Yanıtlarda ya da ortak değişkenlerde eksik değer var; … ardışık, tam gözlem ister." | 109 |
| n<10k | "… durum için en az … gözlem gerekli." (örnek: "2 durum için en az 20 gözlem gerekli.") | 111 |
| Sabit sayısal yanıt | "'…' sabit." | 116 |
| Poisson ve negatif ya da tamsayı olmayan değer | "Poisson dağılımı için '…' negatif olmayan tamsayı olmalı." | 118 |
| Tek düzeyli kategorik yanıt | "'…' tek düzeyli." | 124 |
| Sabit geçiş ortak değişkeni | "Geçiş ortak değişkeni '…' sabit." | 130 |
| Dizi kimliği bölünmüş | "Her dizinin satırları ardışık olmalı." | 135 |
| Dizi 2 gözlemden kısa | "Her dizide en az 2 gözlem olmalı." | 138 |
| Model kurulamadı | "Model kurulamadı: …" | 141 |
| Hiçbir başlangıç sonuç vermedi | "Hiçbir başlangıçtan çözüm elde edilemedi; …" (sayısal 0/1 yanıtın normal sayıldığı da belirtilir) | 158 |
Hiçbir başlangıç yakınsamadıysa ya da bir kısmı yakınsamadıysa çalıştırma durmaz, konsola uyarı ya da not yazılır (159–169; 160.4.3). Eksik hücreler atılmaz: çalıştırma durur (109). Gizli Markov modeli ardışık gözlem istediğinden satır atmak diziyi bozar; şablon bu nedenle durur.
Örnek ayar (ornek_param, satır 9): yanitlar = [rt, corr], k = 2, gecis_ortak = [Pacc], olcekle = açık, baslangic = 5; seri boştur, yani 439 satırın tamamı tek dizi sayılır.
Tohum. Her başlangıç kendi tohumunu kullanır: set.seed(b), b=1,\dots, baslangic (146). Kod panelindeki Tohum alanı (Bölüm 1.3) bu şablonun sonucunu değiştirmez: tohum 7 ile ve 2026 ile örnek ayar tablolarının hepsi birebir aynıdır (fark 0). Başlangıç sayısı artırılırsa yeni tohumlar eklenir.
160.3 Örnek veri
speed.csv, bir hız–doğruluk ödünleşimi deneyinin ardışık denemelerini içerir (Dutilh ve ark., 2011; depmixS4 paketindeki speed verisi). Dosya 439 satırdır; eksik hücre yoktur.
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
seri |
dizi kimliği (örnek ayarda kullanılmaz) | sayısal | 3 dizi: 168, 134, 137 satır |
rt |
yanıt | sayısal | log tepki süresi; 4,66–7,20, ortalama 6,03 |
corr |
yanıt | ikili (metin) | cor 327, inc 112 |
Pacc |
geçiş ortak değişkeni | sayısal | doğruluğa verilen vurgu, 0–1; 23 farklı değer |
prev |
kullanılmaz | ikili (metin) | önceki yanıtın doğruluğu |
corr veri sekmesinde "ikili" sayılan iki düzeyli bir metin sütunudur; R'ye metin gider ve şablon onu factor(as.character(x)) ile alfabetik düzeyli yapar (123): düzeyler cor, inc sırasındadır ve tablolarda P(cor), P(inc) bu sırayla görünür (Bölüm 1.3). Sütun veri sekmesinde "kategorik" yapılsa da aynı çıktı alınır, çünkü şablon önce as.character uygular.
Bu bölümde şu çalıştırmalar kullanılmıştır (tohum 2026, aksi belirtilmedikçe baslangic = 5): (1) örnek ayar; (2) yalnız rt; (3) örnek ayar, seri = seri; (4) yalnız rt, k=3, Pacc ile; (5) Poisson: sayim =\lfloor 5(rt-4)\rfloor, k=2, Pacc ile; (6) örnek ayar, siniflama = hard; (7) örnek ayar, en_cok_yineleme = 10; (8) örnek ayar, olcekle kapalı; (9) örnek ayar, tohum 7; (10) geçiş ortak değişkensiz çalıştırma (k=2 ve k=3); (11) 15 satırlık veri; (12) tek hücresi eksik rt; (13) dizi kimliği bölünmüş veri; (14) ikili inc01 \in\{0{,}1\} sayısal sütun yanıt olarak.
160.4 Yöntem: formüller ve hesap adımları
Hesap şu sırayladır: veri ve roller denetlenir; yanıtların ailesi seçilir; geçiş ortak değişkenleri (isteğe bağlı) standartlaştırılır; depmixS4 modeli kurulur; EM baslangic kez rastgele başlangıçla çalıştırılır; en yüksek log-olabilirlikli çözüm alınır; durumlar ilk sayısal yanıtın ortalamasına göre sıralanır; geçiş katsayıları bu sıraya göre 1. duruma göre yeniden ifade edilir; tablolar ve Viterbi özeti yazılır.
160.4.1 Model
s_t\in\{1,\dots,k\} gizli durum, y_t=(y_{t1},\dots,y_{tR}) t anındaki yanıtlar, x_t ortak değişkenler ve \tilde x_t=(1,x_t')' olsun.
Bu ifadede \pi_i ilk durum olasılığı (dizilerde ortak, ortak değişkensiz), a_{ij}(x_t) geçiş olasılığı, \gamma_{ij} geçiş katsayı vektörü (kesişim + ortak değişkenler), b_i koşullu yanıt yoğunluğudur. Yanıtlar durum verildiğinde koşullu bağımsızdır. \gamma_{i1}=0 taban belirler: çıktıdaki katsayılar j\ge2 için 1. duruma karşı lojit farkıdır.
Ortak değişken kalkış anındadır
t anından t+1 anına geçişi belirleyen ortak değişken x_t'dir (kalkış anı), x_{t+1} değil. Örnek veride bu zaman hizalamasıyla olabilirlik −255,5337'dir; varış anındaki ortak değişkenle −257,6232 çıkar (160.6, Adım 1). Şablonun metni de aynı kuralı söyler (üstbilgi, satır 6).
Yanıt yoğunlukları: sayısal yanıt normal N(\mu_{ir},\sigma_{ir}^2) (ya da poisson seçildiyse Poisson(\lambda_{ir}), \lambda=\exp(\text{doğrusal terim})); kategorik yanıt çok terimli \mathrm{Mult}(p_{ir1},\dots,p_{irL}). Şablon normal dağılımın standart sapmasını \hat\sigma^2=\sum\gamma_t(y_t-\hat\mu)^2/\sum\gamma_t (en çok olabilirlik, bölen ağırlık toplamı) olarak yazar; Poisson'da kesişim terimi \exp'tan geçirilerek ortalama (λ) olarak yazılır (210).
Koddaki tercih
depmix(fl, data = d, nstates = k, family = unname(aile), transition = tf, ntimes = ntimes) (140). Her yanıt için formül `v` ~ 1 (123–127): yanıtın durum içinde yalnız sabit ortalaması vardır, durum içi ortak değişken etkisi yoktur. Geçiş formülü ~ Pacc + … (139). İlk durum olasılıkları ortak değişkensizdir. Yanıt ailesi: sayısal gaussian() ya da poisson(), kategorik multinomial("identity") (119–125).
160.4.2 Olabilirlik ve ileri özyineleme
Bir dizinin olabilirliği ileri özyinelemeyle bulunur:
Bu ifadede \alpha_t(i) t anına kadar gözlenen yanıtların ve s_t=i durumunun ortak olasılığı, L bütün dizilerin olabilirliğidir. Ölçekleme gerekliliği nedeniyle uygulamada log uzayında hesaplanır.
Serbest parametre sayısı p=(k-1)+k(k-1)q+\sum_r k\cdot m_r'dir: q=1+ ortak değişken sayısı; m_r=2 (normal: ortalama, sd), 1 (Poisson) ya da L_r-1 (çok terimli). Örnek ayarda p=1+4+2\,(2+1)=11. Bilgi ölçütleri \mathrm{AIC}=-2\ln L+2p, \mathrm{BIC}=-2\ln L+p\ln n (n toplam gözlem sayısı; 439).
160.4.3 EM algoritması
Kestirim Baum–Welch (EM) ile yapılır. E adımında yumuşatılmış olasılıklar
hesaplanır; M adımında \pi_i ilk gözlemlerdeki \gamma_1(i) ortalamasıdır, geçiş katsayıları \xi_t(i,j) ağırlıklı çok terimli lojit regresyonla, yanıt parametreleri \gamma_t(i) ağırlıklı en çok olabilirlikle bulunur. Yineleme, göreli |\ln L^{(m)}-\ln L^{(m-1)}|/|\ln L^{(m-1)}|<\tau (\tau= tolerans) ya da en_cok_yineleme ile sona erer (olcut = absolute ise bölen yoktur).
Yakınsama durumu okunur
Her başlangıcın EM iletisi (fm@message) okunur (150–153): "converged" içeren ve "without convergence" içermeyen ileti yakınsama sayılır; en_cok_yineleme sınırına ulaşan başlangıç yakınsamamıştır. Hiçbiri yakınsamadıysa konsola "UYARI: N başlangıcın hiçbiri yakınsamadı …" yazılır (159–163); bir kısmı yakınsamadıysa not düşülür (164–168) ve sonuç yakınsayanların en iyisidir. Tablodaki başlangıç (yakınsayan) bu sayıdır.
Durma ölçütü ve yüksek duyarlık
Varsayılan \tau=10^{-8} göreli değişim, log-olabilirliği 10^{-5} yakınlıkta durdurur ama katsayıları üçüncü basamakta belirsiz bırakır (160.8). duyarlik açıkken tolerans \min(\tau,10^{-10}) ve yineleme sınırı \max(\text{en\_cok\_yineleme},2000) olur (143–144); örnek ayarda Pacc katsayısı (1→2) 1,59855'ten 1,59766'ya iner (bağımsız en çok olabilirlik 1,59763).
Sert atama (`hard`)
siniflama = hard seçilince EM'in E adımı Viterbi yoluyla her gözlemi tek bir duruma atar (Viterbi eğitimi). Bu algoritma olağan olabilirliği değil sınıflama olabilirliğini eniyiler; tabloya yazılan logLik, AIC ve BIC bu değerdir ve yumuşak EM'in değerleriyle karşılaştırılamaz. Örnek veride sert atamayla logLik −157,96 yazılır (yumuşakta −255,53); sert çözümün katsayıları yakındır (Pacc katsayısı 1,213 ve 3,682).
Çoklu başlangıç
EM yalnız yerel en büyüğe ulaşır. Şablon baslangic kez, her biri kendi tohumuyla, rastgele başlangıç değerleriyle çalıştırır; en yüksek log-olabilirlik alınır; yakınsayan başlangıç varsa seçim yakınsayanlar arasından yapılır (154–155, 170). Yakınsayan başlangıç sayısı, en iyi değere ulaşanların sayısı ve çalışan (hata vermeyen) başlangıç sayısı "Model uyumu" tablosunda yazılır; ikincisi küçükse çözüm yerel en büyüklere duyarlıdır. 3 durumlu örnekte 5 başlangıcın yalnız 1'i en iyi değere ulaşır.
160.4.4 Durum sırası, katsayıların yeniden ifadesi, Viterbi
EM'in etiketleri keyfidir. Şablon durumları, ilk yanıtın durum ortalamasına göre küçükten büyüğe sıralar (175–176): sayısal yanıtta ortalama, kategorik yanıtta ilk düzeyin olasılığı. Bu sıraya göre geçiş katsayıları 1. duruma karşı yeniden ifade edilir (193):
Bu ifadede (j) sıralı j. durumun özgün numarası, \gamma^{*}_{ij} çıktıdaki i\to j geçiş katsayısıdır. Geçiş olasılıkları tablosu ortak değişkenler 0'da (\texttt{olcekle} açıksa ortalamada) a_{ij}=\exp(\gamma^*_{ij,0})/\sum_l\exp(\gamma^*_{il,0}) olarak hesaplanır (196).
Viterbi en olası durum dizisi \hat s=\arg\max_s P(s_{1:T}\mid y_{1:T}), dinamik programlamayla bulunur. Şablon bu diziyi kendi mq_viterbi işleviyle bulur (216–233) ve tablodaki gözlem sayıları ile oranları bundan yazar; bu işlev depmixS4'ün viterbi işleviyle aynı dinamik programlamadır, tek farkla: t\to t+1 geçişinde olabilirlik ve EM'deki gibi t anının ortak değişkenini (kalkış anı) kullanır. İşlev hata verirse depmixS4'ün posterior(type = "viterbi") sonucu yedek olarak alınır (233).
Viterbi'de ortak değişkenin zaman hizası
depmixS4'ün Viterbi işlevi geçiş olasılığını varış anının ortak değişkeniyle alır (A[tt, j, ], t varış), oysa olabilirlik, EM ve yumuşatma kalkış anınınkiyle çalışır. Geçiş ortak değişkeni varsa depmixS4'ün Viterbi durumlarının sayısı bu nedenle kesin Viterbi'den birkaç gözlem farklı çıkar (örnek ayarda 183/256 ve 184/255). Şablon kalkış anı hizalı kendi Viterbi işlevini kullandığı için örnek ayarda 184/255 yazar; aynı hizalama yalnız rt, dizi kimlikli, Poisson ve 3 durumlu çalıştırmalarda da kesin Viterbi'ye uyar (160.6.1). Ortak değişkensiz modelde iki kural aynı sayıyı verir.
160.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 99–111 | Paketi yükler; veri, yanıt ve n\ge10k denetimi. | Eksik hücre varsa durur (109). n<10k iletisinde sayılar doğru sırada (111). |
| 112–128 | Her yanıt için aile ve formül: sayısal → gaussian/poisson, metin → factor + multinomial. |
Sayısal sütun sabitse ve Poisson'da tamsayı değilse durur (116–118). Sayısal 0/1 kodlu bir sütun normal dağılımlı sayılır (160.8). |
| 129–132 | Ortak değişkenleri denetler, olcekle açıksa scale. |
Sabit ortak değişken durur (130). |
| 133–138 | Dizi uzunlukları (ntimes): rle ile; kimlik bölünmüşse durur. |
Her dizi \ge2 gözlem (138). |
| 139–141 | Geçiş formülü ve depmix modeli. |
Ortak değişken yoksa ~1. |
| 142–158 | duyarlik ayarı; baslangic kez set.seed(b) + fit(em.control(rand = TRUE, …)); çıktı bastırılır, hata NULL. Her başlangıcın yakınsama durumu ileti metninden okunur. |
Yakınsayan en iyi model seçilir; hiçbiri yakınsamadıysa en iyi model uyarıyla alınır (150–155, 170). |
| 159–181 | Yakınsama uyarısı/notu; özet satırı; durum sırası; "Model uyumu" tablosu. | Başlangıç sayıları sum(yak), |lls − ll| < 10⁻³ ve length(lls) ile (180). |
| 182–202 | Geçiş katsayıları, taban 1. durum; geçiş olasılıkları tablosu. | Ortak değişken yoksa depmixS4 katsayı yerine olasılıkları verir; doğrudan okunur ve katsayı tablosu yazılmaz (186–189). |
| 203–215 | İlk durum olasılıkları ve yanıt parametreleri. | Poisson'da \exp ile (210). |
| 216–246 | Kendi Viterbi işlevi; Viterbi özeti ve sonsal olasılık grafiği (yalnız ilk dizi). | Grafikte yalnız son durumun (k) sonsal olasılığı çizilir (241–243). |
Çıktı tabloları: Model uyumu; geçiş katsayıları (yalnız ortak değişken varsa); geçiş olasılıkları; durum başına yanıt parametreleri; Viterbi özeti.
160.6 Elle hesap: örnek veride bağımsız yeniden hesap
Doğrulama depmixS4 ve şablon kullanılmadan yapılmıştır: dogrulama/gizli_markov/elle_hesap.py (numpy, scipy; ileri/geri özyineleme log uzayında, Newton) ve r_dogrulama.R (taban R; ölçekli özyineleme, optim).
Adım 1 — Olabilirlik, şablonun kestirimlerinde. Şablonun yazdığı kestirimler (\hat\gamma, durum ortalamaları ve sd'ler, P(\text{inc})) tablolardan okunur; \hat s_1 en olası durum olan 2. durumda sabitlenir (\hat\pi=(0,\,1)). Ortak değişken kalkış anında alındığında log-olabilirlik -255{,}5337104294 çıkar; şablon -255{,}5337104294 yazar (fark 10^{-12}). Varış anındaki ortak değişkenle -257{,}6232 bulunur: hizalama 160.4.1'deki gibidir. AIC =533{,}0674 ve BIC =577{,}9969 aynı değerden ve p=11'den çıkar.
Adım 2 — Ortak değişkenin standartlaştırılması. \texttt{Pacc} için \bar x=0{,}3647 ve s=0{,}2334 (n-1 bölenli); modelde yalnız z=(x-\bar x)/s kullanılır.
Adım 3 — Bağımsız en çok olabilirlik. Şablonun kestirimlerinden ve 12 rastgele başlangıçtan Newton/L-BFGS ile eniyileme yapıldığında hepsi aynı en büyüğe ulaşır: \ln L=-255{,}533708 (şablondan 2{,}6\times10^{-6} yüksek). Bağımsız Python ve R sonuçları 10^{-9} içinde birbirine eşittir. Geçiş katsayıları (kesişim ve \mathrm{Pacc}, 1\to2): -0{,}92675 ve 1{,}59763; şablonda -0{,}92647 ve 1{,}59855. Bu 3\times10^{-4}–6\times10^{-4} fark EM'in durma ölçütünden gelir (160.8); duyarlik açıkken şablon -0{,}92675 ve 1{,}59766 yazar (2\times10^{-5} içinde).
Adım 4 — Yayımlanmış değerlerle karşılaştırma. Yalnız rt çalıştırmasında şablon \ln L=-44{,}1995 ve \hat\gamma=(-0{,}9518;\;1{,}3924;\;2{,}4715;\;3{,}5812) yazar; Visser ve Speekenbrink'in (2010) Bölüm 3.3 değerleri -44{,}2 ve (-0{,}9518;\;1{,}3924;\;2{,}472;\;3{,}581)'dir.
Adım 5 — Viterbi. Kalkış anı hizalı kesin Viterbi durum 1 için 184 gözlem verir ve şablon 184 yazar; depmixS4'ün varış anı kuralını uygulayan bağımsız yol 183 verir (depmixS4'ün kendi işlevi de 183'tür).
160.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Örnek ayar (rt + corr, Pacc): logLik (şablon kestiriminde) | −255,53371043 | −255,53371043 | −255,53371043 | 3,3e−16 | ✓ |
| Örnek ayar (rt + corr, Pacc): AIC (şablon kestiriminde) | 533,06742086 | 533,06742086 | 533,06742086 | 1,7e−15 | ✓ |
| Örnek ayar (rt + corr, Pacc): BIC (şablon kestiriminde) | 577,9969144 | 577,9969144 | 577,9969144 | 1,6e−15 | ✓ |
| Örnek ayar (rt + corr, Pacc): serbest parametre | 11 | 11 | 11 | 0 | ✓ |
| Örnek ayar (rt + corr, Pacc): Viterbi, durum 1 gözlem sayısı (kalkış anı ortak değişkeni) | 184 | 184 | — | 0 | ✓ |
| Yalnız rt: logLik (şablon kestiriminde) | −44,19947949 | −44,19947949 | −44,19947949 | 2,3e−15 | ✓ |
| Yalnız rt: AIC (şablon kestiriminde) | 106,39895898 | 106,39895898 | 106,39895898 | 2,1e−15 | ✓ |
| Yalnız rt: BIC (şablon kestiriminde) | 143,1594537 | 143,1594537 | 143,1594537 | 1,6e−15 | ✓ |
| Yalnız rt: serbest parametre | 9 | 9 | 9 | 0 | ✓ |
| Yalnız rt: Viterbi, durum 1 gözlem sayısı (kalkış anı ortak değişkeni) | 181 | 181 | — | 0 | ✓ |
| Dizi kimlikli (3 dizi): logLik (şablon kestiriminde) | −248,97220523 | −248,97220523 | −248,97220523 | 4,0e−15 | ✓ |
| Dizi kimlikli (3 dizi): AIC (şablon kestiriminde) | 519,94441046 | 519,94441046 | 519,94441046 | 2,2e−16 | ✓ |
| Dizi kimlikli (3 dizi): BIC (şablon kestiriminde) | 564,873904 | 564,873904 | 564,873904 | 0 | ✓ |
| Dizi kimlikli (3 dizi): serbest parametre | 11 | 11 | 11 | 0 | ✓ |
| Dizi kimlikli (3 dizi): Viterbi, durum 1 gözlem sayısı (kalkış anı ortak değişkeni) | 185 | 185 | — | 0 | ✓ |
| Poisson sayım: logLik (şablon kestiriminde) | −968,28120856 | −968,28120856 | — | 2,8e−15 | ✓ |
| Poisson sayım: AIC (şablon kestiriminde) | 1950,56241712 | 1950,56241712 | — | 1,7e−15 | ✓ |
| Poisson sayım: BIC (şablon kestiriminde) | 1979,15391301 | 1979,15391301 | — | 4,8e−15 | ✓ |
| Poisson sayım: serbest parametre | 7 | 7 | — | 0 | ✓ |
| Poisson sayım: Viterbi, durum 1 gözlem sayısı (kalkış anı ortak değişkeni) | 195 | 195 | — | 0 | ✓ |
| 3 durum: logLik (şablon kestiriminde) | −13,43941419 | −13,43941419 | −13,43941419 | 1,1e−15 | ✓ |
| 3 durum: AIC (şablon kestiriminde) | 66,87882837 | 66,87882837 | 66,87882837 | 1,5e−15 | ✓ |
| 3 durum: BIC (şablon kestiriminde) | 148,56881663 | 148,56881663 | 148,56881663 | 0 | ✓ |
| 3 durum: serbest parametre | 20 | 20 | 20 | 0 | ✓ |
| 3 durum: Viterbi, durum 1 gözlem sayısı (kalkış anı ortak değişkeni) | 144 | 144 | — | 0 | ✓ |
| Örnek ayar (rt + corr, Pacc): logLik (bağımsız en çok olabilirlik) | −255,53371043 | −255,53370785 | −255,53370785 | 1,0e−8 | ✓ |
| Örnek ayar (rt + corr, Pacc): geçiş katsayısı, durum 1→2, kesişim | −0,92647348 | −0,92675459 | −0,92675459 | 2,8e−4 | ✗ |
| Örnek ayar (rt + corr, Pacc): geçiş katsayısı, durum 1→2, Pacc | 1,5985533 | 1,59762593 | 1,5976258 | 5,8e−4 | ✗ |
| Örnek ayar (rt + corr, Pacc): geçiş katsayısı, durum 2→2, kesişim | 2,40212922 | 2,40223952 | 2,40224 | 4,6e−5 | ✗ |
| Örnek ayar (rt + corr, Pacc): geçiş katsayısı, durum 2→2, Pacc | 3,72230058 | 3,72280195 | 3,72280236 | 1,3e−4 | ✗ |
| Örnek ayar (rt + corr, Pacc): rt ortalaması, durum 1 | 5,51696173 | 5,51694451 | 5,5169444 | 3,1e−6 | ✗ |
| Örnek ayar (rt + corr, Pacc): rt ortalaması, durum 2 | 6,39130825 | 6,39129887 | 6,3912989 | 1,5e−6 | ✗ |
| Örnek ayar (rt + corr, Pacc): rt sd, durum 1 | 0,19737738 | 0,197358 | 0,19735801 | 1,9e−5 | ✗ |
| Örnek ayar (rt + corr, Pacc): rt sd, durum 2 | 0,23858706 | 0,23859221 | 0,23859228 | 5,2e−6 | ✗ |
| Yalnız rt: logLik (bağımsız en çok olabilirlik) | −44,19947949 | −44,19947931 | −44,19947931 | 4,2e−9 | ✓ |
| Yalnız rt: geçiş katsayısı, durum 1→2, kesişim | −0,95182048 | −0,95190547 | −0,95190542 | 8,5e−5 | ✗ |
| Yalnız rt: geçiş katsayısı, durum 1→2, Pacc | 1,39235781 | 1,3922049 | 1,39220317 | 1,1e−4 | ✗ |
| Yalnız rt: geçiş katsayısı, durum 2→2, kesişim | 2,47152604 | 2,47150348 | 2,47150365 | 9,1e−6 | ✗ |
| Yalnız rt: geçiş katsayısı, durum 2→2, Pacc | 3,58115844 | 3,58110307 | 3,58110294 | 1,5e−5 | ✗ |
| Yalnız rt: rt ortalaması, durum 1 | 5,50732988 | 5,50732356 | 5,50732342 | 1,2e−6 | ✗ |
| Yalnız rt: rt ortalaması, durum 2 | 6,38565595 | 6,38565213 | 6,38565203 | 6,1e−7 | ✓ |
| Yalnız rt: rt sd, durum 1 | 0,18675214 | 0,18674517 | 0,18674508 | 7,1e−6 | ✗ |
| Yalnız rt: rt sd, durum 2 | 0,24189731 | 0,24189958 | 0,24189968 | 2,4e−6 | ✗ |
| Dizi kimlikli (3 dizi): logLik (bağımsız en çok olabilirlik) | −248,97220523 | −248,97220153 | −248,97220153 | 1,5e−8 | ✓ |
| Dizi kimlikli (3 dizi): geçiş katsayısı, durum 1→2, kesişim | −0,8922391 | −0,89255287 | −0,89255302 | 3,1e−4 | ✗ |
| Dizi kimlikli (3 dizi): geçiş katsayısı, durum 1→2, Pacc | 2,13030306 | 2,12874266 | 2,12874227 | 7,3e−4 | ✗ |
| Dizi kimlikli (3 dizi): geçiş katsayısı, durum 2→2, kesişim | 2,39044952 | 2,39050158 | 2,3905016 | 2,2e−5 | ✗ |
| Dizi kimlikli (3 dizi): geçiş katsayısı, durum 2→2, Pacc | 3,69075481 | 3,69098147 | 3,69098173 | 6,1e−5 | ✗ |
| Dizi kimlikli (3 dizi): rt ortalaması, durum 1 | 5,52170135 | 5,52168154 | 5,52168144 | 3,6e−6 | ✗ |
| Dizi kimlikli (3 dizi): rt ortalaması, durum 2 | 6,39369557 | 6,39368596 | 6,39368598 | 1,5e−6 | ✗ |
| Dizi kimlikli (3 dizi): rt sd, durum 1 | 0,20289969 | 0,20287637 | 0,20287637 | 2,3e−5 | ✗ |
| Dizi kimlikli (3 dizi): rt sd, durum 2 | 0,23736216 | 0,23736696 | 0,23736704 | 4,9e−6 | ✗ |
| Poisson sayım: logLik (bağımsız en çok olabilirlik) | −968,28120856 | −968,26004006 | — | 2,2e−5 | ✗ |
| 3 durum: logLik (bağımsız en çok olabilirlik) | −13,43941419 | −13,43936033 | — | 4,0e−6 | ✗ |
| Yüksek duyarlık: logLik (bağımsız en çok olabilirlik) | −255,53370787 | −255,53370785 | −255,53370785 | 9,7e−11 | ✓ |
| Yüksek duyarlık: geçiş katsayısı, durum 1→2, kesişim | −0,92674839 | −0,92675459 | −0,92675459 | 6,2e−6 | ✗ |
| Yüksek duyarlık: geçiş katsayısı, durum 1→2, Pacc | 1,59765782 | 1,59762593 | 1,5976258 | 2,0e−5 | ✗ |
| Yüksek duyarlık: geçiş katsayısı, durum 2→2, kesişim | 2,40221592 | 2,40223952 | 2,40224 | 1,0e−5 | ✗ |
| Yüksek duyarlık: geçiş katsayısı, durum 2→2, Pacc | 3,72265932 | 3,72280195 | 3,72280236 | 3,8e−5 | ✗ |
Ölçütü karşılayan: 30/59. Python: ileri/geri özyineleme ve Newton (analitik gradyan, sonlu fark Hessian), çok başlangıçlı en çok olabilirlik; R: aynı olabilirlik taban R ile, optim(BFGS). depmixS4 çağrılmamıştır. 'Şablon kestiriminde' satırları olabilirlik formülünü, 'bağımsız en çok olabilirlik' satırları şablonun EM sonucunu (yakınsama ölçütü 10−8 göreli log-olabilirlik değişimi) sınar; EM ölçütüyle durduğundan katsayılar tam en çok olabilirlik değerinden 10^{-4}–10^{-3} kadar ayrılır (Bölüm 160.8). Viterbi sayısı satırı: şablon kendi Viterbi işlevini kalkış anı hizasıyla çalıştırır (Bölüm 160.4.4). 'Yüksek duyarlık' satırları tolerans 10−10 ile çalıştırılan örnek ayarı sınar (Bölüm 160.8).
Olabilirlik, AIC, BIC ve parametre sayısı satırlarının hepsi şablonun kestirimlerinde 10^{-10} içinde örtüşür (beş çalıştırma). Şablonun katsayıları bağımsız en çok olabilirlik değerinden 10^{-6}–10^{-3} ayrılır; bu, EM'in tolerans ölçütünden gelen sapmadır ve tablodaki ✗'lerin nedenidir; duyarlik açıkken sapma 2\times10^{-5}–4\times10^{-5}'e iner (✗ kalır, ölçüt 10^{-6}). Viterbi sayısı satırı (kalkış anı hizalı) ✓'dir.
160.7 Çıktıyı okuma
Örnek ayarın konsol çıktısı (gerçek):
Gizli Markov modeli: 2 durum, 2 yanıt, 1 dizi, n = 439; logLik = -255,5337
Model uyumu ve geçiş katsayıları:
 olcut                                       deger
 logLik                                -255.5337104
 AIC                                    533.0674209
 BIC                                    577.9969144
 serbest parametre                              11
 n                                              439
 dizi sayısı                                      1
 başlangıç (yakınsayan)                           5
 en iyi log-olabilirliğe ulaşan başlangıç         5
 başlangıç (çalışan)                              5

 kaynak_durum hedef_durum terim         katsayi
            1           2 (Intercept) -0.9264735
            1           2 Pacc         1.5985533
            2           2 (Intercept)  2.4021292
            2           2 Pacc         3.7223006
Geçiş olasılıkları (ortak değişken ortalamada) ve durum başına yanıt parametreleri:
 kaynak_durum  durum_1    durum_2
            1  0.7163593  0.2836407
            2  0.0830105  0.9169895

 durum yanit parametre   deger
     1    rt  ortalama   5.5169617
     1    rt  sd         0.1973774
     1  corr  P(cor)     0.5252717
     1  corr  P(inc)     0.4747283
     2    rt  ortalama   6.3913082
     2    rt  sd         0.2385871
     2  corr  P(cor)     0.9020976
     2  corr  P(inc)     0.0979024

 durum ilk_durum_olasiligi viterbi_gozlem viterbi_oran
     1                   0            184    0.4191344
     2                   1            255    0.5808656
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
logLik, AIC, BIC |
Model uyumu | Karşılaştırma yalnız aynı verideki, aynı yanıt kümeli ve aynı siniflama'lı modeller arasında anlamlıdır. |
serbest parametre |
p | k-1 ilk durum, k(k-1)q geçiş, yanıt parametreleri. |
başlangıç (yakınsayan), başlangıç (çalışan) |
EM'i yakınsayan ve hata vermeden bir sonuç döndüren başlangıç sayıları | Yakınsayan sayı çalışandan küçükse konsolda not ya da uyarı vardır (160.4.3). |
en iyi log-olabilirliğe ulaşan başlangıç |
En iyi \ln L'nin 10^{-3} içindeki başlangıçlar | Küçükse yerel en büyükler var demektir; k büyüdükçe artar. |
| geçiş katsayıları | 1. duruma karşı lojit farkı, ortak değişken başına | Pacc katsayıları pozitif: doğruluk vurgusu arttıkça (standartlaştırılmış) 2. duruma (yavaş, doğru) geçiş olasılığı artar. |
| geçiş olasılıkları | \exp(\text{kesişim})/\sum | Ortak değişken ortalamadayken: durum 1'de kalış 0,716, durum 2'de kalış 0,917. |
| yanıt parametreleri | Durum başına ortalama, sd, olasılık | Durum 1: hızlı (\bar{rt}=5{,}517), yanıtların %52,5'i doğru. Durum 2: yavaş (6,391), %90,2 doğru. |
ilk_durum_olasiligi |
\hat\pi | Tek dizide uç değerlerde (0 ve 1) olması beklenir; bir dizinin ilk durumu için tek gözlem vardır. |
viterbi_gozlem, viterbi_oran |
En olası dizideki durum sayıları | Durum 1: 184 gözlem (%41,9), durum 2: 255 (%58,1). |
Şekil 160.1. İlk dizinin durum 2 için sonsal olasılığı (eğri) ve Viterbi durumu (dikey çizgiler).
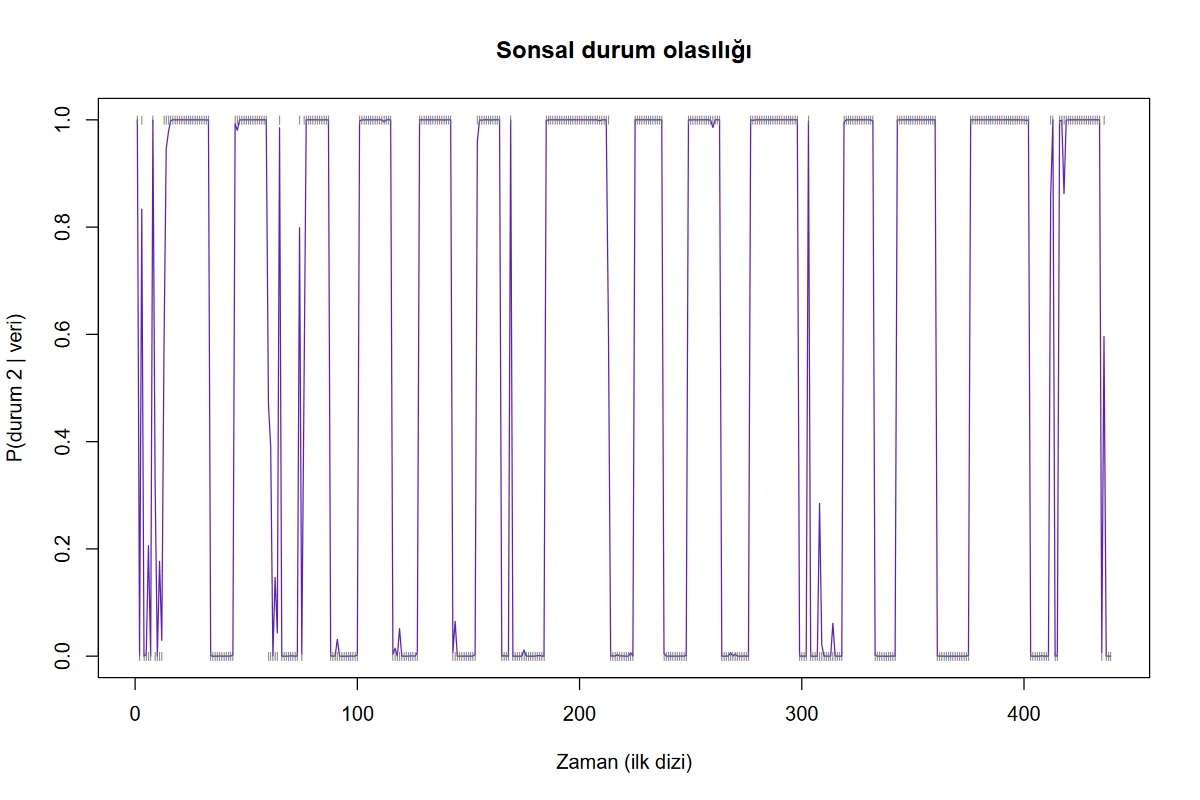
İki durumlu bir gizli Markov modeli, n=439 ardışık denemenin log tepki süresi ve doğruluğuna uyduruldu (\ln L=-255{,}53; AIC =533{,}07; BIC =578{,}00, p=11). Hızlı durumda ortalama log tepki süresi 5,52 ve doğru yanıt oranı 0,53, yavaş durumda 6,39 ve 0,90 bulundu. Ortak değişken ortalamadayken durumda kalma olasılıkları 0,72 ve 0,92'dir; doğruluk vurgusu arttıkça yavaş duruma geçiş olasılığı artar (kesişim ve eğim, standartlaştırılmış \mathrm{Pacc} için -0{,}93, 1{,}60 ve 2{,}40, 3{,}72).
160.8 Sık hatalar ve tuzaklar
- Geçiş ortak değişkeni seçilmeden de çalışır. Ortak değişkensiz modelde (yalnız sabit geçiş olasılıkları) depmixS4 katsayı değil olasılık verir; şablon bunları doğrudan okur (186–189): k=2 için geçiş olasılıkları 0,8835/0,1165 ve 0,0843/0,9157 (yalnız
rt). Bu durumda geçiş katsayıları tablosu yazılmaz, "Geçiş olasılıkları" tablosu yazılır. - Eksik hücre satır atılarak çözülmez. Çalıştırma durur (109); ardışıklık bozulacağı için eksik satırları çıkarmak yerine doldurmak ya da diziyi bölmek gerekir (bölmek için
seri). - Örnek ayar üç diziyi tek dizi sayar.
seriboşken 439 satır uzun bir dizidir.seri = seriseçilincelogLik−248,97 olur (3 dizi, ilk durum olasılığı ortak). Bu fark, dizi sınırlarında yanlışlıkla durum geçişi varsaymanın bedelidir. - "Yakınsayan" gerçek yakınsamadır. Tabloda
başlangıç (yakınsayan)EM iletisinden okunur.en_cok_yineleme = 10ile 5 başlangıcın hiçbiri yakınsamaz, konsola "UYARI: 5 başlangıcın hiçbiri yakınsamadı …" yazılır ve \ln L -255{,}69'da kalır; yineleme sınırı artırılmalıdır. - EM'in tolerans ölçütü 3. basamağı belirsiz bırakır. Varsayılan \tau=10^{-8} göreli değişim, log-olabilirliği en çok olabilirlik değerine 10^{-5} yakınlıkta durdurur; katsayılar bağımsız en çok olabilirlik değerinden 10^{-4}–10^{-3} ayrılır (160.6). Rapor için dört basamağa güvenilir; daha fazlası için
duyarlikaçılır (örnek ayarda sapma 5{,}8\times10^{-4}'ten 2\times10^{-5}'e iner) ya datoleransküçültülür. - Yerel en büyükler. 3 durumlu örnekte 5 başlangıcın yalnız 1'i en iyi değere ulaşır ve \hat\sigma_1=0{,}102 küçük bir durum bulunur. k büyüdükçe başlangıç sayısını artırmak gerekir; kaç başlangıcın en iyiye ulaştığına tablodan bakılır.
- Sayısal 0/1 sütun normal dağılımlı sayılır. İkili yanıtı
inc01\in\{0{,}1\} sayısal sütun olarak vermek çok terimli yerine normal model kurar; olabilirlik bozulur ve çalıştırma "Hiçbir başlangıçtan çözüm elde edilemedi" ile durur; ileti sayısal 0/1 yanıtın normal sayıldığını ve ikili yanıtın kategorik yapılması gerektiğini de söyler. - Viterbi bir nokta kestirimidir. Şablonun Viterbi dizisi olabilirlikle aynı zaman hizasındadır (160.4.4); yine de karar için sonsal olasılıklara (grafik) bakmak daha tutarlıdır.
- Sert atamada AIC/BIC karşılaştırılamaz (160.4.3).
- Durum sırası yanıtın ilk sayısal sütununa bağlıdır.
yanitlarlistesinin sırası değişirse durum numaraları değişebilir (ilk yanıtcorrise durumlar P(\text{cor})'a göre sıralanır). - Kısa veri. n<10k ise çalıştırma durur; 15 satırlık veride ileti "2 durum için en az 20 gözlem gerekli" yazar.
- Grafik yalnız ilk diziyi gösterir (240). Çok dizili veride diğer dizilerin durum yolları Viterbi tablosunda toplam olarak vardır, ayrı grafik yoktur.
160.9 Uzman soruları
S1. Etiket değişimi (label switching) nasıl önleniyor?
Durumlar, ilk sayısal yanıtın durum ortalamasına göre küçükten büyüğe sıralanır (175–176); geçiş katsayıları ve parametre tabloları bu sıraya göre yeniden yazılır. Ortalamaları çakışan durumlarda (ya da ilk yanıt kategorikse ilk düzeyin olasılıkları yakınsa) sıra belirsizleşir.
S2. Neden ilk durum olasılığı 0 ve 1?
Tek dizide \pi için tek gözlem vardır; olabilirlik \pi'de doğrusaldır ve en büyüğü köşede (en olası ilk durumda) bulunur. Birden çok dizide \pi içsel bir değer alır (üç dizili çalıştırmada da \hat\pi=(10^{-21},\,1) çıkar).
S3. Kalkış anı mı varış anı mı?
Olabilirlik, EM ve yumuşatma kalkış anının ortak değişkenini kullanır; bağımsız ileri özyineleme bunu 10^{-12} içinde doğrular (160.6). depmixS4'ün Viterbi işlevi ise varış anınınkini kullanır (160.4.4); şablon bu yüzden kendi Viterbi işlevini kalkış anıyla çalıştırır ve Viterbi çıktısı modelin tanımıyla uyumludur.
S4. Durum sayısı nasıl seçilir?
Şablon k seçmez. k=2{,}3{,}4 için ayrı çalıştırma yapıp BIC karşılaştırılır; örnek veride k=3 için \ln L=-13{,}44, BIC =148{,}57, p=20 iken k=2 ve yalnız rt için BIC =143{,}16 (p=9): daha küçük BIC iki durumu tercih eder. k=3 çözümü küçük bir durum (\hat\sigma_1=0{,}102) içerir ve yalnız 1 başlangıç en iyiye ulaşmıştır.
S5. Yumuşak ve sert EM arasında hangi fark vardır?
Yumuşak EM olağan olabilirliği büyütür ve kestirimler tutarlıdır. Sert EM (Viterbi eğitimi) gözlemleri tek bir duruma atar ve sınıflama olabilirliğini büyütür; \ln L yapay olarak yüksektir (-157{,}96, -255{,}53 yerine). Kestirimler genellikle yakın ama yanlıdır.
S6. Standartlaştırma sonucu nasıl değiştirir?
olcekle kapalıyken Pacc \in[0{,}1] ham kullanılır: kesişim Pacc =0'daki geçişi gösterir, eğim ise standartlaştırılmış eğimin 1/s katıdır (s=0{,}2334): 1→2 için eğim 6,85 (=1{,}5986/0{,}2334), kesişim -3{,}43. Olabilirlik aynıdır (-255{,}5337); doğrusal dönüşüm modeli değiştirmez, EM'in izlediği yol ve durma noktasındaki küçük sapma değişir.
S7. Ortak değişken yanıt dağılımına neden girmiyor?
Şablonda yalnız geçişler ortak değişkenle değişir; yanıt formülleri ~ 1'dir (123–127). Durum içi ortak değişken etkisi (ör. yanıt regresyonu) şablonda yoktur; depmixS4 bunu destekler ama şablon sunmaz.
S8. Poisson yanıt neden \exp ile yazılıyor?
depmixS4 Poisson yanıtı \log\lambda üzerinden kestirir; tablo \exp(\text{kesişim})'i ortalama (λ) olarak verir (210). Örnek sayımda \hat\lambda=7{,}71 ve 11{,}24 bulunur; bağımsız en çok olabilirlik değeri \ln L -968{,}26 iken şablon -968{,}28 yazar (2\times10^{-5} göreli).
160.10 Kaynaklar
Baum, L. E., Petrie, T., Soules, G., & Weiss, N. (1970). A maximization technique occurring in the statistical analysis of probabilistic functions of Markov chains. The Annals of Mathematical Statistics, 41(1), 164–171. https://doi.org/10.1214/aoms/1177697196
Dempster, A. P., Laird, N. M., & Rubin, D. B. (1977). Maximum likelihood from incomplete data via the EM algorithm. Journal of the Royal Statistical Society: Series B, 39(1), 1–22. https://doi.org/10.1111/j.2517-6161.1977.tb01600.x
Dutilh, G., Wagenmakers, E.-J., Visser, I., & van der Maas, H. L. J. (2011). A phase transition model for the speed-accuracy trade-off in response time experiments. Cognitive Science, 35(2), 211–250. https://doi.org/10.1111/j.1551-6709.2010.01147.x
Rabiner, L. R. (1989). A tutorial on hidden Markov models and selected applications in speech recognition. Proceedings of the IEEE, 77(2), 257–286. https://doi.org/10.1109/5.18626
Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
Viterbi, A. J. (1967). Error bounds for convolutional codes and an asymptotically optimum decoding algorithm. IEEE Transactions on Information Theory, 13(2), 260–269. https://doi.org/10.1109/TIT.1967.1054010
Visser, I., & Speekenbrink, M. (2010). depmixS4: An R package for hidden Markov models. Journal of Statistical Software, 36(7), 1–21. https://doi.org/10.18637/jss.v036.i07
Zucchini, W., MacDonald, I. L., & Langrock, R. (2016). Hidden Markov models for time series: An introduction using R (2. bs.). CRC Press. https://doi.org/10.1201/b20790
R Core Team. (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/