98. Dinamik koşullu korelasyon: DCC-GARCH ve aDCC
Şablon kimliği: dcc_garch · Kategori: zaman serisi · Dil: R · Dosya: pro/sablonlar/zaman_serisi/dcc_garch.R (satır 1–231; üstbilgi 1–125) · Örnek veri: _ornek/dji30retw.csv · Paketler: rmgarch 1.4-3, rugarch 1.5-6
98.1 Ne işe yarar
Şablon, 2–10 getiri serisinin koşullu varyanslarını ve aralarındaki koşullu korelasyonları zamanla değişen biçimde kestirir. Cevapladığı soru şudur: "Bu varlıkların oynaklığı kümelenerek değişirken birbirleriyle korelasyonları sabit mi, yoksa zamanla (özellikle kriz dönemlerinde) artıp azalıyor mu?" Model, Engle'nin (2002) iki aşamalı DCC modelidir: önce her seri için tek değişkenli bir GARCH ailesi modeli kestirilir; ardından standartlaştırılmış artıklardan, korelasyon hedeflemeli DCC(a,b) ya da asimetrik aDCC (Cappiello ve ark., 2006) korelasyon dinamiği kestirilir. Sonuç, her dönem için bir korelasyon matrisi \mathbf R_t ve her seri için bir koşullu standart sapma \sigma_{it}'dir; kovaryans \mathbf H_t=\mathbf D_t\mathbf R_t\mathbf D_t ile kurulur.
Ne zaman kullanılır?
- Portföy riski, riske maruz değer ya da korunma oranı için zamana göre değişen korelasyon gerektiğinde.
- Yayılma (bulaşma) sorusunda: kriz dönemlerinde korelasyonun yükselip yükselmediğini görmek için.
- Seri sayısı küçük (en çok 10) ve her seri için bir GARCH modeli makul olduğunda.
Ne zaman kullanılmaz?
- Tek serinin oynaklığı için:
garch_genisşablonu (GARCH-M, IGARCH, TGARCH, NAGARCH, ARMA ortalama, dışsal açıklayıcı, model karşılaştırması içerir) ya da temel programdaki "GARCH (Volatility Model)" analizi. - Oynaklık yayılması (bir serinin varyansının ötekilere aktarımı) soruluyorsa: bu model yalnız korelasyonu dinamik yapar; varyanslar birbirinden bağımsız tek değişkenli GARCH'lardır.
- Seri sayısı çok büyükse (onlarca): korelasyon hedeflemeli DCC'de iki parametre (a,b) bütün çiftleri aynı dinamikle sürer; şablon 10 seriyle sınırlıdır.
- Getiri yerine fiyat düzeyi veriliyorsa: şablon büyük değerler için uyarı verir (156); getiriye (yüzde ya da log) çevrilmelidir. Zaman sütunu azalan sırada görünüyorsa da uyarı yazılır (144–151).
- Seriler arası doğrusal ortalama ilişkisi (VAR, hata düzeltme) soruluyorsa: temel programdaki "VAR (Vector Autoregression)" ve "Cointegration (Johansen / Engle-Granger)" analizleri; bu şablonun ortalama denklemi her seride kendi içindedir.
Temel programla ilişki. Temel programdaki "GARCH (Volatility Model)" analizi tek serilidir (standart GARCH, EGARCH ve GJR-GARCH; sabit ya da ARMA(1,1) ortalama; normal ya da Student t) ve aynı rugarch kurallarıyla (başlangıç varyansı, bilgi ölçütlerinin gözlem başına yazımı) çalışır. Bu şablonun birinci aşaması o modellerin çok serili ve IGARCH ile APARCH'ı da kapsayan karşılığıdır; ikinci aşama (DCC) temel programda yoktur.
98.2 Şablonun girdileri
Form, üstbilgideki 15 [[param]] bloğundan kurulur (dcc_garch.R:10–124). Türlerin ve formun ortak denetiminin anlamı Bölüm 1.2'de anlatılmıştır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Getiri serileri · getiri |
sütunlar (sayısal, ≥2) · Değişkenler | yok | 2–10 sayısal sütun | Modelin serileri (10–16, 133–137). |
Zaman etiketi · zaman |
sütun (isteğe bağlı) · Değişkenler | boş | herhangi sütun | Yalnız etiket; sıralama yapılmaz (17–22, 132, 138). |
Ortalama denklemi · ortalama |
seçim · Model | sabit |
sabit, sifir, ar1 |
Her seride ortalama: sabit; sıfır; AR(1)+sabit (23–29, 159–160). |
Tek değişkenli varyans modeli · tek_degiskenli |
seçim · Model | sGARCH |
sGARCH, gjrGARCH, eGARCH, iGARCH, apARCH |
1. aşama varyans denklemi (30–37, 168). iGARCH seçilirse şablon iletiyle durur (158). |
Korelasyon dinamiği · dcc_model |
seçim · Model | DCC |
DCC, aDCC |
2. aşama (38–44, 169). |
Çok değişkenli dağılım · dagilim |
seçim · Model | mvnorm |
mvnorm, mvt, mvlaplace |
2. aşama dağılımı (45–51, 169). |
ARCH terimi sayısı · garch_p |
tamsayı · Model | 1 | 0–3 | garchOrder[1], her seri için (52–60, 161). |
GARCH terimi sayısı · garch_q |
tamsayı · Model | 1 | 0–3 | garchOrder[2] (61–69, 161). |
Tek değişkenli yenilik dağılımı · tek_dagilim |
seçim · Model | norm |
norm, std, ged, snorm, sstd |
1. aşama dağılımı (70–76, 163). |
DCC yenilik terimi sayısı · dcc_a |
tamsayı · Model | 1 | 1–3 | dccOrder[1] (78–86, 164). |
DCC kalıcılık terimi sayısı · dcc_b |
tamsayı · Model | 1 | 1–3 | dccOrder[2] (87–95, 164). |
Çözücü · cozucu |
seçim · Gelişmiş | solnp |
solnp, nlminb, lbfgs, gosolnp |
dccfit(solver=) (96–103, 165). |
Göreli tolerans · tol |
ondalık · Gelişmiş | 10^{-10} | 10^{-15}–10^{-3} | Yalnız solnp ve gosolnp (104–111, 166, 173). |
Sayısal türev adımı · delta |
ondalık · Gelişmiş | 10^{-9} | 10^{-15}–10^{-3} | Yalnız solnp ve gosolnp (112–119, 166, 173). |
Standart hataları hesapla · sh_hesapla |
onay · Gelişmiş | açık | açık/kapalı | eval.se; kapalıysa SH, z ve p boş kalır (120–126, 167, 172). |
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 131 |
| 2'den az farklı seri | "En az iki farklı getiri serisi seçin." | 134 |
| 10'dan çok seri | "En çok 10 seri seçilebilir." | 135 |
| Tam gözlem sayısı 100'den az | "DCC-GARCH için en az 100 tam gözlem gerekli (şu an …)." | 154 |
| Bir seri sabit | "'…' serisi sabit." | 155 |
| ARCH ve GARCH mertebesi ikisi birden 0 | "ARCH ve GARCH mertebelerinin ikisi birden 0 olamaz." | 162 |
| Kestirim hatası | "Model kestirilemedi: …" | 174 |
| Çözücü yakınsamadı ya da SH matrisi yok | "Model yakınsamadı; daha az seri ya da daha yalın bir model deneyin." | 176–177 |
iGARCH seçilirse şablon "IGARCH bu şablonda desteklenmez" iletisiyle durur (158); serilerin ortasında eksik değer varsa da durur (142). Bir mutlak getiri 5'i aşarsa şablon durmaz, "getiriler çok büyük görünüyor; yüzde ya da log getiri olarak verildiğinden emin olun" uyarısını yazar (156). Paket uyarıları kestirim sırasında toplanır ve sonda "Uyarılar:" satırı olarak yazılır (170–175, 221).
Örnek ayar (ornek_param, satır 9): getiri = [AA, IBM, T], zaman = tarih, ortalama = sabit, tek_degiskenli = sGARCH, dcc_model = DCC, dagilim = mvnorm; öteki alanlar varsayılandadır (GARCH(1,1), DCC(1,1), norm, solnp).
98.3 Örnek veri
dji30retw.csv: rmgarch paketinin Dow Jones 30 haftalık getiri verisi. 1141 haftalık gözlem (1987-03-27–2009-01-30), yedi hisse (AA, AXP, BA, GE, HPQ, IBM, T), eksik değer yok; getiriler ondalık (yüzde değil) basit getirilerdir. Örnek ayar üç seriyi kullanır.
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
tarih |
zaman etiketi | metin | 1987-03-27 … 2009-01-30 |
AA |
getiri | sayısal | ortalama 0,00073; s.s. 0,05225; aralık −0,5364 … 0,2429 |
IBM |
getiri | sayısal | ortalama 0,00117; s.s. 0,03970; aralık −0,1942 … 0,1770 |
T |
getiri | sayısal | ortalama 0,00159; s.s. 0,03707; aralık −0,2106 … 0,2513 |
Ham getirilerin ikili korelasyonları: AA–IBM 0,3406; AA–T 0,2428; IBM–T 0,2315. Serilerin sırası, çıktı tablolarındaki sütun sırasını (AA, IBM, T) ve çiftlerin adlandırmasını belirler (AA~IBM, AA~T, IBM~T).
Bölümde kullanılan çalıştırmalar:
- Örnek ayar (
dcc_ornek): GARCH(1,1), DCC(1,1),mvnorm. - aDCC (
dcc_adcc):dcc_model = aDCC. - GJR-GARCH +
mvt+ Student t (dcc_mvt) ve AR(1) ortalamalı dört seri (dcc_ar1, AA, IBM, T, BA). - Çözücü ve dağılım denemeleri:
nlminb,gosolnp, DCC(2,1),mvlaplace, tek değişkenliged/sstd. - Bozuk veri denemeleri: ortada eksik, azalan sıra, yüzde ölçeği, aynı iki seri.
98.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) seriler seçilir, eksik gözlemli satırlar atılır; (2) her seri için tek değişkenli GARCH kestirilir ve standartlaştırılmış artıklar \mathbf z_t bulunur; (3) \bar{\mathbf Q} (ve aDCC'de \bar{\mathbf N}) bu artıklardan hesaplanır; (4) (a,b) (aDCC'de (a,b,g)) ikinci aşama olabilirliğiyle kestirilir; (5) \mathbf Q_t, \mathbf R_t ve \mathbf H_t kurulur; (6) iki aşamalı kestirimin sandviç standart hataları bulunur; (7) tablolar ve şekil.
Koddaki tercih
Şablon bütün modellemeyi rmgarch'a bırakır: ugarchspec (tek değişkenli spesifikasyon, her seri için aynı), multispec(replicate(k, us)), dccspec(..., dccOrder, model, distribution) ve dccfit(sp, data, solver, fit.control = list(eval.se), solver.control). Çıktılar rcor(fit) (koşullu korelasyonlar), sigma(fit) (koşullu s.s.), fit@mfit$Qbar, likelihood(fit) ve infocriteria(fit) ile alınır. Bütün seriler aynı spesifikasyonu (ortalama, varyans modeli, mertebe, dağılım) paylaşır; seri başına ayrı model kurulamaz.
98.4.1 Veri hazırlığı
Seçilen sütunlar sayısala çevrilir; bütün serilerin sonlu olduğu ilk ve son satır bulunur (139–141) ve bu aralık kullanılır:
- Aralığın ortasında eksik ya da sonlu olmayan değer varsa şablon durur (142): satır atmak zaman ekseninde boşluk bırakır ve GARCH özyinelemesini bozar. Eksikler doldurulmalı ya da örneklem kısaltılmalıdır.
- Baştaki ve sondaki eksik satırlar kırpılır ve atılan satır sayısı bir not satırıyla yazılır (143, 152).
- Zaman sütunu seçiliyse ve değerleri (sayı ya da tarih) çoğunlukla azalıyorsa şablon uyarı yazar; model zamanın tersine kestirilmesin diye veri eskiden yeniye sıralanmalıdır (144–151).
- n<100 ise şablon durur (154).
98.4.2 Birinci aşama: tek değişkenli GARCH
Her seri için ortalama ve koşullu varyans denklemleri ayrı kestirilir. Ortalama denklemi ortalama seçimine göre
ve varyans denklemi (garch_p =p, garch_q =q; varsayılan (1{,}1)) için standart GARCH
- \omega_i>0, \alpha_{il},\beta_{il}\ge0; kalıcılık \sum\alpha+\sum\beta<1 olmalıdır (rugarch standart GARCH'ta bu kısıtı koyar).
- GJR-GARCH, EGARCH, IGARCH ve APARCH denklemleri Bölüm 102'de verilmiştir; burada yalnız seçim sunulur.
- z_{it}: standartlaştırılmış yenilik; dağılımı
tek_dagilim(normal, Student t, GED, çarpık normal, çarpık Student t; Fernández ve Steel, 1998 çarpıklığı).
rugarch varyans özyinelemesini ilk gözlemde \sigma_{i1}^2=\tfrac1n\sum_t\varepsilon_{it}^2 (artık karelerinin örneklem ortalaması) ile başlatır ve t=2'den sürdürür. Birinci aşama olabilirliği tek değişkenli log-olabilirliklerin toplamıdır: \ell_1=\sum_i\sum_t\{-\tfrac12(\ln2\pi+\ln\sigma_{it}^2+\varepsilon_{it}^2/\sigma_{it}^2)\} (normal dağılım için).
98.4.3 Standartlaştırılmış artıklar ve \bar{\mathbf Q}
- \bar{\mathbf Q}: standartlaştırılmış artıkların örneklem kovaryans matrisidir (
cov(stdresid); 143 kaynaklıfit@mfit$Qbar). Köşegeni tam 1 değildir (örnekte 0{,}9987;\ 0{,}9970;\ 1{,}0015). - \bar{\mathbf R}: \bar{\mathbf Q}'nun korelasyona ölçeklenmişidir; şablonun "Koşulsuz korelasyon" tablosu budur (208–210).
- "Hedefleme": uzun dönem korelasyon \bar{\mathbf R}'dan gelir, (a,b) onun etrafındaki dinamiği belirler.
98.4.4 DCC ve aDCC özyinelemesi
DCC(1{,}1) (varsayılan) için \mathbf Q_t yarı-tanımlı bir ara matristir:
- a\ge0: yenilik (şok) katsayısı; b\ge0: kalıcılık; a+b<1.
- \mathbf R_t: dönem t koşullu korelasyon matrisi; \mathbf H_t=\mathbf D_t\mathbf R_t\mathbf D_t, \mathbf D_t=\operatorname{diag}(\sigma_{1t},\dots,\sigma_{kt}).
- Başlangıç: rmgarch \mathbf Q_0=\bar{\mathbf Q} ve öncül şok vektörü \mathbf z_0=(1,\dots,1)' alır; yani \mathbf Q_1=(1-a)\bar{\mathbf Q}+a\,\mathbf 1\mathbf 1'. Bu nedenle ilk dönem korelasyonu \bar{\mathbf R}'dan farklıdır (örnek: AA–IBM için 0{,}3402 ve 0{,}3269).
dcc_avedcc_b1'den büyükse toplamlar \sum_{j}a_j\mathbf z_{t-j}\mathbf z_{t-j}' ve \sum_jb_j\mathbf Q_{t-j} olur.
Asimetrik aDCC'de negatif şoklar ayrıca ağırlıklandırılır:
- g: asimetri katsayısı; \bar{\mathbf N}=\widehat{\mathrm{Cov}}(\mathbf n) (kovaryans, merkezlenmiş).
- Başlangıçta \mathbf n_0=(1,\dots,1)' da alınır (negatif kısma kırpılmaz); bu, bağımsız hesapta aDCC log-olabilirliğini (6384{,}914) yeniden üreten tek tanımdır.
Kovaryans ve ikinci moment
Cappiello ve ark. (2006) \bar{\mathbf N} için E[\mathbf n\mathbf n']'yi (merkezlenmemiş ikinci moment) tanımlar; rmgarch ve dolayısıyla bu şablon cov() (merkezlenmiş) kullanır. Aynı olabilirlik \bar{\mathbf N}=E[\mathbf n\mathbf n'] ile yaklaşık 0{,}4 birim daha büyük çıkar (örnekte 6385{,}36 ve 6384{,}91); parametre kestirimleri buna göre kayar.
98.4.5 İkinci aşama olabilirliği ve ortak log-olabilirlik
mvnorm altında ikinci aşama olabilirliği, \mathbf z_t'nin korelasyon yapısından gelen kısımdır:
- (a,b) yalnız \ell_2'de yer alır; \ell_1 birinci aşama parametrelerinin sabit olduğu bir sabit gibi davranır (iki aşamalı kestirim).
likelihood(fit)(rapordaki "logLik") \ell=-\tfrac12\sum_t\{k\ln2\pi+\ln|\mathbf H_t|+\boldsymbol\varepsilon_t'\mathbf H_t^{-1}\boldsymbol\varepsilon_t\} çok değişkenli normal log-olabilirliğidir.- "Model uyumu" tablosunun son satırı "logLik_birinci_asama", kestirilen tek değişkenli parametrelerle her serinin kendi log-olabilirliğinin toplamıdır, yani \ell_1 (örnekte 6260{,}28; 189–197).
Tek değişkenli dağılım ve ortak log-olabilirlik
dagilim = mvnorm iken ortak log-olabilirlik, tek değişkenli yenilik dağılımı (tek_dagilim) Student t ya da GED olsa bile yukarıdaki Gauss formülüyle hesaplanır (örnekte GED için 6383{,}01, Student t için 6380{,}18; normal için 6383{,}73; üçü de aynı Gauss formülünden). Bu nedenle bu log-olabilirlik ve ondan türeyen bilgi ölçütleri, tek değişkenli yenilik dağılımları arasında seçim için kullanılamaz; bu seçim için "logLik_birinci_asama" satırı kullanılır (Student t için 6363{,}90, GED için 6340{,}37, normal için 6260{,}28).
98.4.6 Standart hatalar ve bilgi ölçütleri
Standart hatalar iki aşamalı kestirimin sandviç tahmincisidir: \widehat{\mathrm{Var}}(\hat{\boldsymbol\theta})=\mathbf A^{-1}\mathbf B\mathbf A^{-1}/n. \mathbf A'nın birinci aşama blokları her serinin kendi kovaryans matrisinin tersidir, DCC satırları sayısal Hessian'dan gelir; \mathbf B birinci aşama skorları ile DCC skorlarının (sayısal türevle) örneklem kovaryansıdır (rmgarch dccfit). Tablodaki z=\hat\theta/\widehat{\mathrm{SH}} ve p=2\Phi(-|z|)'dir (183, 186). sh_hesapla kapalıysa bu hesap atlanır.
Bilgi ölçütleri rugarch tanımıyla gözlem başına yazılır:
- r: parametre sayısı. rmgarch bunu birinci aşama parametreleri, DCC parametreleri ve kestirilen k(k-1)/2 koşulsuz korelasyonun toplamı olarak sayar (örnek: 12+2+3=17).
- "Model uyumu" tablosu r'yi göstermez; log-olabilirlik, dört ölçüt, n ve birinci aşama log-olabilirliği yazılır (205).
98.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–125 | Üstbilgi: 15 parametre, örnek veri ve ayar. | |
| 128–129 | Dil yardımcısı .m; rugarch ve rmgarch yüklenir. |
|
| 131–156 | Veri denetimleri; sayısal matris X; eksik satırların atılması; n, k; n<100, sabit seri ve büyük getiri denetimleri. |
Ortada eksik hata (142); baştaki ve sondaki eksik kırpılır (143, 152); azalan zaman sırası uyarısı (144–151); IGARCH hata (158). |
| 159–167 | Ayarların okunması: ortalama, mertebeler, dağılımlar, çözücü, tolerans, SH bayrağı. | garch_p + garch_q = 0 hata. |
| 168–169 | ugarchspec ve dccspec: tek spesifikasyon bütün serilere kopyalanır. |
|
| 170–177 | dccfit, hata ve uyarı yakalama; yakınsama denetimi. |
fit@mfit$convergence != 0 ya da SH matrisi yoksa durur (176). |
| 178–186 | Katsayı tablolarının ayrıştırılması: "[Seri].parametre" adları; "[Joint]" öneki olan satırlar DCC parametreleridir. | z, p normal dağılımdan. |
| 187–205 | Ortak log-olabilirlik, bilgi ölçütleri, konsol satırı, ilk üç tablo. | |
| 206–212 | \bar{\mathbf R} ve son dönem \mathbf R_n tabloları. | \bar{\mathbf Q}'dan \bar{\mathbf R} elle ölçeklenir (207–208). |
| 213–220 | Koşullu korelasyon ve koşullu s.s. serisi tablosu (çift başına bir sütun). | AA~IBM biçiminde adlar. |
| 194 | Toplanan paket uyarıları. | |
| 223–231 | Şekil: ilk altı çiftin koşullu korelasyonu. | Çift sayısı 6'dan çoksa yalnız ilk 6 çizilir (223). |
Kritik bölüm, kestirim ve yakınsama denetimidir:
fit <- withCallingHandlers(
  tryCatch(dccfit(sp, data = X, solver = coz, fit.control = list(eval.se = ese),
                  solver.control = if (coz %in% c("solnp", "gosolnp")) list(tol = tol, delta = dlt, trace = 0) else list(trace = 0)),
           error = function(e) mq_hata(...)),
  warning = function(w) { uyari <<- c(uyari, conditionMessage(w)); invokeRestart("muffleWarning") })
if (!inherits(fit, "DCCfit") || is.null(fit@mfit$matcoef) || fit@mfit$convergence != 0) mq_hata(...)
Çözücü uyarıları durdurulmadan toplanır; şablonun tek yakınsama denetimi ikinci aşamanın yakınsama koduyla SH matrisinin varlığıdır. Birinci aşama kestirimlerinin kalitesi ya da çözücünün bulduğu noktanın en iyi olup olmadığı ayrıca denetlenmez (98.8).
98.6 Elle hesap: örnek veride bağımsız yeniden hesap
Hesap dogrulama/dcc_garch/elle_hesap.py ile yapılmıştır: yalnız numpy ve scipy kullanılmış, rugarch ve rmgarch çağrılmamıştır (birinci aşama \to \bar{\mathbf Q} \to \mathbf Q_t \to \mathbf R_t \to ortak olabilirlik; en iyilemeyi Nelder–Mead yapar). r_dogrulama.R aynı hesabı düz R ile ve optim ile yeniden yapar; rmgarch yalnız nlminb çözücüsünün tutarlılığı için sonda çağrılır. İki doğrulama düzeyi vardır: (i) şablonun kestirdiği parametrelerde bütün türetilmiş büyüklükler 10^{-6} içinde yeniden hesaplanır; (ii) kestirimin kendisi sıfırdan yinelenir ve parametreler karşılaştırılır.
Adım 1 — Birinci aşama. Her seri için normal GARCH(1,1), \sigma_1^2=\overline{\varepsilon^2} başlangıcıyla en çok olabilirlikle kestirilir. AA: \hat\mu=0{,}00268002, \hat\omega=6{,}78097\cdot10^{-5}, \hat\alpha=0{,}116375, \hat\beta=0{,}867510; IBM: 0{,}00112339; 2{,}81056\cdot10^{-5}; 0{,}0645510; 0{,}920173; T: 0{,}00294423; 1{,}50992\cdot10^{-5}; 0{,}0657501; 0{,}925611.
Adım 2 — Standartlaştırılmış artıklar ve \bar{\mathbf Q}. \bar{\mathbf Q} köşegeni 0{,}998712;\ 0{,}996967;\ 1{,}001490, dışı köşegenleri 0{,}326208 (AA–IBM), 0{,}202005 (AA–T), 0{,}202735 (IBM–T). Ölçeklenince \bar{\mathbf R}: 0{,}326915;\ 0{,}201984;\ 0{,}202892.
Adım 3 — İlk dönem. \mathbf Q_1=(1-a)\bar{\mathbf Q}+a\,\mathbf 1\mathbf 1' ile a=0{,}0197477: AA–IBM 0{,}340235, AA–T 0{,}217742, IBM–T 0{,}218645.
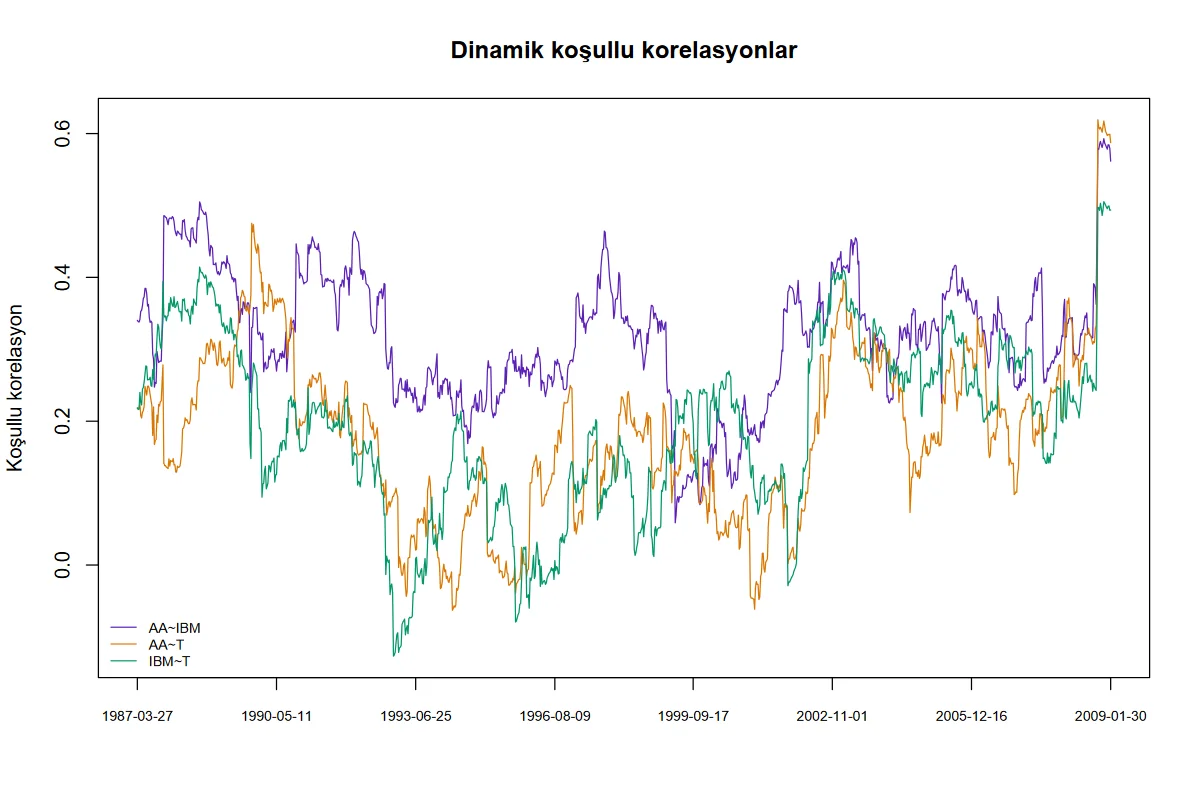
Adım 4 — Özyineleme. n=1141 döneme uygulanır; son dönem (2009-01-30) korelasyonları AA–IBM 0{,}561647, AA–T 0{,}587343, IBM–T 0{,}493704. Son dönem koşullu standart sapmalar 0{,}159951;\ 0{,}0568219;\ 0{,}0601437 (ilk dönem 0{,}0522623;\ 0{,}0396815;\ 0{,}0370790).
Adım 5 — Ortak log-olabilirlik. \ell_1=6260{,}2792, \ell_2=123{,}4549, toplam \ell=6383{,}7342. Parametre sayısı r=12+2+3=17; Akaike -11{,}15992, Bayes -11{,}08483, Shibata -11{,}16035, Hannan–Quinn -11{,}13156.
Adım 6 — Kestirimin yinelenmesi. Sıfırdan en iyileme: birinci aşama parametreleri şablonunkilerle 10^{-5} göreli içinde; ikinci aşamada (\hat a,\hat b)=(0{,}0197065;\ 0{,}968945), şablon (0{,}0197477;\ 0{,}968812). İkinci aşama olabilirliği bu düzlükte çok düzdür: bağımsız optimum \ell_2'yi 10^{-4} kadar büyütür; çıplak bir dccfit(solver = "nlminb") çağrısı şablonun solnp sonucunu yineler (şablonun kendi nlminb ayarındaki sapma için 98.8).
Adım 7 — aDCC. Şablon (\hat a,\hat b,\hat g)=(0{,}0162013;\ 0{,}970874;\ 0{,}00709705), \ell=6384{,}914. Bu parametrelerde bağımsız hesap aynı log-olabilirliği (6384{,}914) ve son dönem korelasyonlarını (0{,}5861;\ 0{,}6201;\ 0{,}5192) verir; sıfırdan yineleme (0{,}0161819;\ 0{,}970989;\ 0{,}00701546) bulur.
Adım 8 — Standart hatalar (bilgi). Yalnız ikinci aşama Hessian'ından (birinci aşama belirsizliği yok sayılarak) saf SH: a için 0{,}00465, b için 0{,}00981. Şablonun sandviç SH'leri 0{,}00584 ve 0{,}01167'dir: aynı büyüklük düzeyinde, sandviç daha geniş. Sandviç SH'ler bu bölümde bağımsız yeniden hesaplanmamıştır.
98.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu "Model uyumu", "Koşulsuz korelasyon", "Son dönemdeki koşullu korelasyon" ve "Koşullu korelasyonlar ve koşullu standart sapmalar" tablolarından tam hassasiyetle alınmıştır. Python ve R sütunları şablonun kestirdiği parametrelerde bağımsız olarak değerlendirilmiş büyüklüklerdir; zaman serilerinde 1141 dönemin en büyük farkı verilmiştir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| log-olabilirlik (ortak) | 6383,73415614 | 6383,73415614 | 6383,73415614 | 1,1e−15 | ✓ |
| Akaike (gözlem başına) | −11,15991964 | −11,15991964 | −11,15991964 | 6,4e−16 | ✓ |
| Bayes (gözlem başına) | −11,08483268 | −11,08483268 | −11,08483268 | 2,2e−15 | ✓ |
| Shibata (gözlem başına) | −11,16035499 | −11,16035499 | −11,16035499 | 1,6e−15 | ✓ |
| Hannan–Quinn (gözlem başına) | −11,13156466 | −11,13156466 | −11,13156466 | 5,6e−15 | ✓ |
| Koşulsuz korelasyon \bar R: AA~IBM | 0,32691475 | 0,32691475 | 0,32691475 | 2,2e−16 | ✓ |
| Koşulsuz korelasyon \bar R: AA~T | 0,20198432 | 0,20198432 | 0,20198432 | 8,3e−17 | ✓ |
| Koşulsuz korelasyon \bar R: IBM~T | 0,20289192 | 0,20289192 | 0,20289192 | 1,1e−16 | ✓ |
| Son dönem koşullu korelasyon: AA~IBM | 0,56164718 | 0,56164718 | 0,56164718 | 1,1e−16 | ✓ |
| Son dönem koşullu korelasyon: AA~T | 0,58734336 | 0,58734336 | 0,58734336 | 1,1e−15 | ✓ |
| Son dönem koşullu korelasyon: IBM~T | 0,49370447 | 0,49370447 | 0,49370447 | 1,0e−15 | ✓ |
| İlk dönem koşullu korelasyon: AA~IBM | 0,34023488 | 0,34023488 | 0,34023488 | 2,2e−16 | ✓ |
| İlk dönem koşullu korelasyon: AA~T | 0,21774177 | 0,21774177 | 0,21774177 | 2,5e−16 | ✓ |
| İlk dönem koşullu korelasyon: IBM~T | 0,21864495 | 0,21864495 | 0,21864495 | 1,9e−16 | ✓ |
| Son dönem koşullu s.s.: AA | 0,15995064 | 0,15995064 | 0,15995064 | 2,8e−17 | ✓ |
| Son dönem koşullu s.s.: IBM | 0,05682191 | 0,05682191 | 0,05682191 | 9,7e−17 | ✓ |
| Son dönem koşullu s.s.: T | 0,06014369 | 0,06014369 | 0,06014369 | 1,3e−16 | ✓ |
| Koşullu korelasyon serisi AA~IBM: 1141 dönemin en büyük farkı | 0,56164718 | 0,56164718 | — | 1,3e−15 | ✓ |
| Koşullu korelasyon serisi AA~T: 1141 dönemin en büyük farkı | 0,58734336 | 0,58734336 | — | 1,8e−15 | ✓ |
| Koşullu korelasyon serisi IBM~T: 1141 dönemin en büyük farkı | 0,49370447 | 0,49370447 | — | 1,6e−15 | ✓ |
| Koşullu s.s. serileri: 3×1141 değerin en büyük farkı | 0,15995064 | 0,15995064 | — | 9,4e−16 | ✓ |
| aDCC: log-olabilirlik | 6384,9139841 | 6384,9139841 | 6384,9139841 | 8,5e−16 | ✓ |
| aDCC: son dönem koşullu korelasyon AA~IBM | 0,5861245 | 0,5861245 | 0,5861245 | 2,0e−15 | ✓ |
| aDCC: son dönem koşullu korelasyon AA~T | 0,62012747 | 0,62012747 | 0,62012747 | 2,1e−15 | ✓ |
| aDCC: son dönem koşullu korelasyon IBM~T | 0,51920277 | 0,51920277 | 0,51920277 | 2,0e−15 | ✓ |
Ölçütü karşılayan: 25/25. Bu satırlar şablonun kestirdiği parametrelerde bağımsız olarak değerlendirilmiş büyüklüklerdir (kestirimin kendisi aşağıda).
Kestirimin bağımsız yinelenmesi (Python ve R'de Nelder–Mead ile sıfırdan; ölçüt: 1. aşama parametrelerinde 5\cdot10^{-4}, 2. aşama (a,b) için 5\cdot10^{-3} göreli; 2. aşama olabilirliği çok düz):
| Parametre | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| AA: mu | 0,00268002 | 0,00268002 | 0,00268002 | 2,5e−7 | ✓ |
| AA: omega | 6,781014·10−5 | 6,780970·10−5 | 6,780970·10−5 | 6,6e−6 | ✓ |
| AA: alpha1 | 0,11637462 | 0,11637465 | 0,11637466 | 3,4e−7 | ✓ |
| AA: beta1 | 0,86750972 | 0,86750992 | 0,86750992 | 2,4e−7 | ✓ |
| IBM: mu | 0,00112338 | 0,00112339 | 0,00112339 | 1,4e−5 | ✓ |
| IBM: omega | 2,810553·10−5 | 2,810564·10−5 | 2,810562·10−5 | 3,8e−6 | ✓ |
| IBM: alpha1 | 0,06455074 | 0,06455097 | 0,06455097 | 3,6e−6 | ✓ |
| IBM: beta1 | 0,92017305 | 0,92017279 | 0,92017281 | 2,9e−7 | ✓ |
| T: mu | 0,00294426 | 0,00294423 | 0,00294423 | 1,0e−5 | ✓ |
| T: omega | 1,509934·10−5 | 1,509923·10−5 | 1,509923·10−5 | 7,4e−6 | ✓ |
| T: alpha1 | 0,06575048 | 0,0657501 | 0,06575009 | 5,9e−6 | ✓ |
| T: beta1 | 0,92561041 | 0,92561083 | 0,92561084 | 4,6e−7 | ✓ |
| dcca1 | 0,01974774 | 0,0197065 | 0,0197065 | 2,1e−3 | ✓ |
| dccb1 | 0,96881211 | 0,96894464 | 0,96894465 | 1,4e−4 | ✓ |
Ölçütü karşılayan: 14/14. 2. aşama olabilirliği düzdür: bağımsız en iyileme (a,b)=(0{,}0197065;\,0{,}96894464) noktasında şablonunkinden 10^{-4} kadar daha büyük bir olabilirliğe ulaşır. Aynı veride rmgarch'ın nlminb çözücüsü şablonun solnp çözümünü yineler (a=0{,}01974779, b=0{,}96881192).
Standart hatalar. Şablonun SH'si rmgarch'ın iki aşamalı sandviç tahmincisidir; bu bölümde ayrıca yeniden hesaplanmamıştır. Yalnız 2. aşama Hessian'ından (1. aşama belirsizliği yok sayılarak) saf SH: a için 0,00465181, b için 0,00980772; şablonun sandviç SH'si 0,00584273 ve 0,01166591 (aynı büyüklük düzeni, sandviç daha geniş).
98.7 Çıktıyı okuma
Örnek ayarın konsol metni:
n = 1141 dönem, 3 seri; sGARCH + DCC(1,1), mvnorm dağılım; log-olabilirlik = 6383,7342
Tablolar (kısaltılmış; ondalık nokta olduğu gibi):
Tek değişkenli GARCH parametreleri (SH: iki aşamalı kestirimin ortak sandviç SH'si)
 seri  parametre   kestirim     SH          z        p
 AA    mu          0.00268002   0.00128017  2.09348  0.0363061
 AA    omega       6.78101e-05  5.32701e-05 1.27295  0.203036
 AA    alpha1      0.116375     0.0543078   2.14287  0.0321236
 AA    beta1       0.86751      0.0601821   14.4147  4.1801e-47
 IBM   ...   T   ...  (toplam 12 satır)

DCC parametreleri (a: yenilik, b: kalıcılık; g: asimetri)
 parametre  kestirim   SH         z        p
 dcca1      0.0197477  0.00584273 3.37988  0.000725165
 dccb1      0.968812   0.0116659  83.0464  0

Model uyumu (bilgi ölçütleri gözlem başına)
 logLik 6383.73  Akaike -11.1599  Bayes -11.0848  Shibata -11.1604  Hannan-Quinn -11.1316  n 1141  logLik_birinci_asama 6260.28

Koşulsuz korelasyon (Q̄, standartlaştırılmış artıklardan)
       AA        IBM       T
 AA    1         0.326915  0.201984
 IBM   0.326915  1         0.202892
 T     0.201984  0.202892  1

Son dönemdeki koşullu korelasyon (2009-01-30)
 AA    1         0.561647  0.587343
 IBM   0.561647  1         0.493704
 T     0.587343  0.493704  1
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Tek değişkenli parametreler | \mu, \omega, \alpha_1, \beta_1 (ve modele göre \gamma_1, \delta, şekil) her seri için | \alpha_1+\beta_1 kalıcılıktır; örnekte AA 0{,}984, IBM 0{,}985, T 0{,}991. |
| DCC parametreleri | a (dcca1), b (dccb1), aDCC'de g (dccg1), mvt için mshape |
a+b=0{,}9886: korelasyon şoklardan sonra yavaş (yarı ömür \approx60 hafta) uzun dönem düzeyine döner. a ve b birlikte anlamlıdır; b'nin z'si büyüktür ama a=0 altında b tanımsız olduğundan yalnız a'ya bakarak sabit korelasyonu reddetmek tek başına yeterli değildir (98.9, S8). |
| Model uyumu | Ortak log-olabilirlik, gözlem başına Akaike, Bayes, Shibata, Hannan–Quinn, n, birinci aşama log-olabilirliği | Yalnız aynı veride, aynı dağılımla, DCC ve aDCC gibi modelleri karşılaştırır; tek değişkenli dağılım seçimi için kullanılmaz (98.4.5). |
| Koşulsuz korelasyon | \bar{\mathbf R} | Uzun dönem hedefi; ham korelasyonlardan (0{,}3406;\ 0{,}2428;\ 0{,}2315) farklıdır, çünkü standartlaştırılmış artıklardan hesaplanır. |
| Son dönemdeki koşullu korelasyon | \mathbf R_n | Örnek sonunda (2008 krizi) üç korelasyon da hedefin çok üstündedir. |
| Koşullu korelasyonlar ve s.s. | \rho_{ij,t} ve \sigma_{it} serileri | Şekil ve dış kullanım içindir. |
Şekil 98.1. Şablonun çizdiği grafik (örnek veri): üç çiftin koşullu korelasyonu. 2008–2009 krizinde üç çift de birlikte 0{,}5–0{,}6 düzeyine çıkar.
aDCC örneği (dcc_model = aDCC): a=0{,}0162 (SH 0{,}0051), b=0{,}9709 (SH 0{,}0110), g=0{,}00710 (SH 0{,}00552, z=1{,}285, p=0{,}199); log-olabilirlik 6384{,}914 (DCC için 6383{,}734), parametre sayısı bir artar (r=18). Asimetri anlamlı değildir ve olabilirlik artışı (1{,}18) tek parametre için \chi^2_1 ile yaklaşık p=0{,}12'dir.
mvt ve GJR-GARCH örneği (tek_degiskenli = gjrGARCH, dagilim = mvt, tek_dagilim = std): a=0{,}0173, b=0{,}9673, çok değişkenli t'nin serbestlik derecesi mshape =8{,}18 (SH 0{,}90); log-olabilirlik 6480{,}7355. Bu log-olabilirlik mvt olabilirliğidir ve mvnorm çalıştırmalarının log-olabilirliğiyle karşılaştırılamaz.
Rapor cümlesi (örnek ayar):
AA, IBM ve T haftalık getirilerine (1987-03-27–2009-01-30, n=1141) iki aşamalı DCC-GARCH uygulanmıştır. Her seri için sabit ortalamalı normal GARCH(1,1) kestirilmiş (AA için \hat\alpha_1=0{,}116, \hat\beta_1=0{,}868), standartlaştırılmış artıklardan DCC(1,1) parametreleri \hat a=0{,}0197 (SH 0{,}0058) ve \hat b=0{,}9688 (SH 0{,}0117) bulunmuştur. Uzun dönem korelasyonlar AA–IBM için 0{,}327, AA–T için 0{,}202 ve IBM–T için 0{,}203'tür; örnek sonunda koşullu korelasyonlar 0{,}562, 0{,}587 ve 0{,}494'e yükselmiştir.
98.8 Sık hatalar ve tuzaklar
- IGARCH seçeneğini DCC'de kullanmak.
tek_degiskenli = iGARCHseçildiğinde şablon iletiyle durur: rmgarch çok serili kestirimde \beta=1-\alpha kısıtını tanımaz ("Unrecognized Parameter in Fixed Values: beta1 … Ignored") ve anlamsız parametreler üretirdi. Tek serili IGARCH için Bölüm 102'deki şablon vardır. - Eksik gözlem. Bir serinin ortasındaki eksik hücre çalıştırmayı durdurur ("Serilerin ortasında eksik değer var"); eksikler doldurulmalı ya da örneklem kısaltılmalıdır. Baştaki ve sondaki eksik satırlar kırpılır ve bir not satırıyla bildirilir.
- Sıra. Tarih sütunu etikettir ve sıralama yapılmaz; ama değerleri azalan sıradaysa şablon uyarı yazar (örnekte tarih sırası tersine çevrildiğinde log-olabilirlik 6402{,}70 olur). Kronolojik sıra kullanıcının sorumluluğundadır.
- Ölçek. Yüzde (\times100) getirilerle de çalışır, ama varyans parametreleri (ve log-olabilirlik) ölçeğe bağlıdır (\ell=-9379{,}76); bir mutlak değer 5'i aştığında uyarı da çıkar. Aynı çalıştırmada getiri biçimini değiştirmeyin.
- Aynı ya da neredeyse aynı iki seri. Korelasyon matrisi tekilleşir; örnekte AA'yı iki kez vermek "Model yakınsamadı" ile durur.
- Çözücü seçimi sonucu değiştirir.
nlminbseçildiğinde örnek veride T serisinin birinci aşama parametreleri daha düşük bir olabilirlik noktasında kalır (\hat\omega=3{,}6\cdot10^{-6}, \hat\beta=0{,}959 yerine 1{,}5\cdot10^{-5}, 0{,}926) ve ortak log-olabilirlik 6377{,}67 olur (\texttt{solnp}: 6383{,}73). Şablonsolnpdışındaki bir çözücüde birinci aşama log-olabilirliğini her serinin bağımsızsolnpçözümüyle karşılaştırır; fark 0{,}5'ten büyükse "Uyarılar" satırına "Birinci aşama log-olabilirliği (6254,92) solnp çözümünden (6260,28) düşük" uyarısını yazar (198–199). Çözücüler arasında sonuç tutarsızsasolnp'ye dönün ya datolvedelta'yı küçültün. - Tek değişkenli dağılım ve log-olabilirlik.
mvnormile Student t ya da GED yenilikli birinci aşama seçildiğinde ortak log-olabilirlik Gauss'tur (98.4.5); dağılımlar bu ölçütle karşılaştırılamaz; birinci aşama log-olabilirliği ("logLik_birinci_asama") kullanılır. - DCC(2,1). İkinci yenilik terimi anlamlı değilse (\hat a_2\approx6\cdot10^{-8}) log-olabilirlik DCC(1,1) ile aynıdır ama SH'ler şişer (a_1 için 0{,}0147 yerine 0{,}0058) ve r arttığı için bilgi ölçütleri kötüleşir.
- Kestirim süresi. 3 seri için yaklaşık 6 s, 4 seri için 7 s; SH hesabı bunun büyük bölümüdür (
sh_hesaplakapalıysa hızlanır). - Seri sayısı. Korelasyon hedeflemeli DCC iki parametreyle k(k-1)/2 korelasyonu sürer; seri sayısı arttıkça bu kısıt sıkılaşır.
98.9 Uzman soruları
S1. \bar{\mathbf Q} neden korelasyon değil de kovaryans, ve köşegeni neden 1 değil?
rmgarch hedefi cov(stdresid) olarak alır. Standartlaştırılmış artıkların varyansı örneklemde tam 1 değildir (örnekte 0{,}9987;\ 0{,}9970;\ 1{,}0015), bu yüzden \bar{\mathbf Q}'nun köşegeni 1'e eşit değildir. \mathbf R_t her dönem \mathbf Q_t'nun köşegeniyle yeniden ölçeklendiğinden bu bir sorun değildir; şablon "Koşulsuz korelasyon" tablosunda \bar{\mathbf Q}'yu ölçekleyerek \bar{\mathbf R}'yu verir. Merkezlenmemiş ikinci moment (\tfrac1n\mathbf z'\mathbf z) kullanılsaydı köşegen ve a,b biraz değişirdi.
S2. İlk dönem korelasyonu neden \bar{\mathbf R}'ya eşit değil?
rmgarch özyinelemeyi \mathbf Q_0=\bar{\mathbf Q} ve öncül şok vektörü \mathbf z_0=(1,\dots,1)' ile başlatır; dolayısıyla \mathbf Q_1=(1-a)\bar{\mathbf Q}+a\mathbf 1\mathbf 1' olur ve ilk korelasyon \bar{\mathbf R}'nın biraz üstündedir (AA–IBM: 0{,}3402 ve 0{,}3269). Etki b^t ile söner (yarı ömür \approx22 hafta). Bu başlangıç tanımı bağımsız hesapta log-olabilirliği yazılan basamaklar içinde yeniden üreten tek tanımdır: aDCC örneğinde \mathbf z_0=(1,\dots,1)' ile 6384{,}914, \mathbf z_0=\mathbf 0 ile 6384{,}852 çıkar.
S3. Neden "logLik" ile tek değişkenli log-olabilirliklerin toplamı aynı değil?
Ortak log-olabilirlik \ell=\ell_1+\ell_2'dir; \ell_1 (6260,28) tek değişkenli log-olabilirliklerin toplamı, \ell_2 (123,45) korelasyon yapısının katkısıdır. \ell_2 pozitiftir çünkü \mathbf z_t'\mathbf R_t^{-1}\mathbf z_t ile \mathbf z_t'\mathbf z_t arasındaki fark korelasyonun varlığını ödüllendirir.
S4. Bilgi ölçütlerindeki parametre sayısı neden 17?
rmgarch parametre sayısını birinci aşama (4 parametre \times 3 seri = 12), DCC (2) ve hedeflenen 3\cdot2/2=3 koşulsuz korelasyonun toplamı olarak sayar. Şablon r'yi tabloya yazmaz; Akaike'yi yeniden hesaplamak için r=12+2+3 kullanılmalıdır. Hedeflenen korelasyonları saymamak Akaike'yi -11{,}1652'e (yani rapordakinden küçük) çıkarır.
S5. Çözücüler neden farklı (a,b) veriyor?
İkinci aşama olabilirliği (a,b) yönünde çok düzdür: örnekte şablonun (0{,}0197477;\ 0{,}968812) ile bağımsız en iyilemenin (0{,}0197065;\ 0{,}968945) noktaları arasında \ell_2 yalnız 10^{-4} farklıdır. solnp ve çıplak dccfit(solver = "nlminb") çağrısı aynı noktayı (0{,}019748;\ 0{,}968812) bulur; Nelder–Mead biraz ötede durur (şablonun nlminb ayarında ise 98.8'deki sapma görülür). Parametrelerin altıncı basamağı çözücüye bağlıdır, ama koşullu korelasyonlar 10^{-3} içinde aynıdır.
S6. Standart hatalar neden "ortak sandviç"?
İkinci aşama olabilirliği birinci aşama parametrelerini sabit alır; (a,b)'nin saf Hessian SH'si (0{,}00465; 0{,}00981) birinci aşama belirsizliğini yok sayar. rmgarch iki aşamayı birlikte ele alan bir sandviç tahmincisi kullanır (0{,}00584; 0{,}01167). Bunun yan etkisi: aynı birinci aşama parametrelerinin SH'si DCC ya da aDCC seçimine göre değişir (örnekte AA \mu için 0{,}00128017 ve 0{,}00128213).
S7. aDCC'de g anlamlı değilse DCC'ye mi dönülür?
g için Wald testi (z=1{,}285, p=0{,}199) ve olabilirlik oranı (\Delta\ell=1{,}18) asimetriyi desteklemez; bilgi ölçütleri de DCC'yi tercih eder (Bayes -11{,}0848 ve -11{,}0807). DCC seçilir. \bar{\mathbf N} tanımı Cappiello ve ark.'ndan (E[\mathbf n\mathbf n']) farklı olduğu için olabilirlik ve g burada yayımlı tanımla bire bir karşılaştırılmamalıdır.
S8. Sabit korelasyona karşı DCC nasıl sınanır?
H_0:a=b=0 altında \mathbf R_t=\bar{\mathbf R} sabittir ve b tanımsızdır (Davies sorunu); b'nin z istatistiği (83{,}0) bu yüzden sabit korelasyonun reddi için geçerli bir sınama değildir. Şablonda yalnız a'nın z'si (3{,}38) bilgi verir; resmi bir sabit korelasyon sınaması şablonda yoktur. Pratikte DCC ve sabit korelasyonlu (a=b=0) modelin log-olabilirliklerini (ikincisi \ell_1+\ell_2(0{,}0)) karşılaştırmak daha güvenlidir.
98.10 Kaynaklar
- Bollerslev, T. (1986). Generalized autoregressive conditional heteroskedasticity. Journal of Econometrics, 31(3), 307–327. https://doi.org/10.1016/0304-4076(86)90063-1
- Bollerslev, T., & Wooldridge, J. M. (1992). Quasi-maximum likelihood estimation and inference in dynamic models with time-varying covariances. Econometric Reviews, 11(2), 143–172. https://doi.org/10.1080/07474939208800229
- Cappiello, L., Engle, R. F., & Sheppard, K. (2006). Asymmetric dynamics in the correlations of global equity and bond returns. Journal of Financial Econometrics, 4(4), 537–572. https://doi.org/10.1093/jjfinec/nbl005
- Engle, R. (2002). Dynamic conditional correlation: A simple class of multivariate generalized autoregressive conditional heteroskedasticity models. Journal of Business & Economic Statistics, 20(3), 339–350. https://doi.org/10.1198/073500102288618487
- Engle, R. F., & Sheppard, K. (2001). Theoretical and empirical properties of dynamic conditional correlation multivariate GARCH (NBER Working Paper No. 8554). https://doi.org/10.3386/w8554
- Fernández, C., & Steel, M. F. J. (1998). On Bayesian modeling of fat tails and skewness. Journal of the American Statistical Association, 93(441), 359–371. https://doi.org/10.1080/01621459.1998.10474117
- Galanos, A. (2026). rmgarch: Multivariate GARCH models (R package version 1.4-3). https://github.com/alexiosg/rmgarch
- Galanos, A. (2026). rugarch: Univariate GARCH models (R package version 1.5-6). https://CRAN.R-project.org/package=rugarch