6. Bitki ıslahı: Griffing ve Hayman dialeli, çizgi × test, artırılmış blok ve Latin kare
Şablon kimliği: dialel_cizgi_test · Kategori: deney tasarımı · Dil: R · Dosya: pro/sablonlar/deney_tasarimi/dialel_cizgi_test.R (satır 1–734; üstbilgi 1–125) · Örnek veri: _ornek/dialel_cizgi_test_hayman54.csv (öteki kipler için beş dosya daha) · Paketler: yalnız taban R 4.5.3 (stats, graphics)
6.1 Ne işe yarar
Şablon, bitki ıslahı denemelerinin beş klasik çözümlemesini tek formda toplar. "Çözümleme" alanındaki seçim (kip) hangisinin çalışacağını belirler; her kip kendi sorusunu cevaplar:
| Kip | Soru | Model |
|---|---|---|
| Griffing dialeli | Ebeveynlerin genel (GCA) ve melezlerin özel (SCA) uyuşma yeteneği ne kadar; ana–baba yönü önemli mi? | x_{ij}=\mu+g_i+g_j+s_{ij}+r_{ij}+e_{ij} |
| Hayman dialeli | Eklemeli ve dominans etkiler nasıl ayrışıyor; eklemeli-dominans modeli veriye uyuyor mu? | a,\ b_1,\ b_2,\ b_3,\ c,\ d ayrışımı ve W_r–V_r grafiği |
| Çizgi × test | Çizgilerin ve testlerin GCA'sı, melezlerin SCA'sı nedir? | y_{ijk}=\mu+g_i+g_j+s_{ij}+\rho_k+e_{ijk} |
| Artırılmış blok | Tekrarsız yeni genotipler, yinelenen kontroller üzerinden blok etkisinden arındırılınca nasıl sıralanır? | y_{ij}=\mu+\beta_j+\tau_i+e_{ij} |
| Latin kare | İki yönlü (satır, sütun) tarla değişkenliği ayıklanınca muameleler farklı mı? | y_{ijk}=\mu+\rho_i+\gamma_j+\tau_k+e_{ijk} |
- x_{ij}: ana ebeveyni i, baba ebeveyni j olan melezin (ya da i=j ise ebeveynin kendisinin) hücre ortalaması; p ebeveyn.
- g_i: genel uyuşma yeteneği (general combining ability, GCA): ebeveynin bütün melezlerine taşıdığı ortalama katkı. s_{ij}=s_{ji}: özel uyuşma yeteneği (SCA): belirli bir melezin, iki ebeveynin GCA'larından beklenenden sapması. r_{ij}=-r_{ji}: karşılıklı (reciprocal) etki: aynı iki ebeveynin ana–baba yönü değişince ortaya çıkan fark.
- \rho, \gamma, \beta: tekrar/satır, sütun ve blok etkileri; \tau: muamele (genotip) etkisi; e: hata.
Ne zaman kullanılır? Dialel kipleri: p\ge3 ebeveynin bütün ikili melezleri (ve tasarıma göre ebeveynlerin kendileri ile karşılıklı melezler) yetiştirilmişse. Çizgi × test: bir küme çizgi, bir küme testle tam çaprazlanmış ve deneme tekrarlıysa. Artırılmış blok: tohum azlığından yalnız kontroller yinelenebiliyorsa. Latin kare: muamele sayısı kadar satır ve sütun varsa.
Ne zaman kullanılmaz?
- Dialel tablosunda eksik melez varsa: şablon tam tablo ister (satır 225–232). Eksik hücreli dialel için karma model gerekir; MerQuR+'ta
r_emmeans_kontrastile aynı aileden karma model şablonları ya da temel programdaki Doğrusal Karma Model (LMM) kullanılır. - Dialel birden çok çevrede yinelenmişse (genotip × çevre): şablon çevre etkenini almaz; çevre başına ayrı çözümleme ya da
lokasyon_yil_tbdşablonu. - Çok bloklu, eksik bloklu çeşit denemelerinde (alfa kafes):
alfa_kafes. - Artırılmış denemede kontroller her blokta tam bir kez bulunmuyorsa (satır 607–608): temel programdaki Doğrusal Karma Model (LMM) ile blok rastgele etkili çözümleme.
- Yalnız tek yönlü bloklama varsa (tesadüf blokları): temel programdaki İki Yönlü ANOVA (muamele ve blok) ya da blok rastgele etkili Doğrusal Karma Model (LMM).
Temel programla ilişki. Temel programda bu beş çözümlemenin hazır karşılığı yoktur; en yakın araçlar İki Yönlü ANOVA ve Doğrusal Karma Model (LMM) analizleridir. Şablon, ıslah denemelerine özgü ayrışımları (GCA, SCA, karşılıklı etki, Hayman maddeleri, Federer'in fark hataları) taban R'nin lm fonksiyonu üzerine kurar; Latin kare kipinde muamele ortalamalarını ve karşılaştırmalarını tam olmayan karede de en küçük kareler ortalaması olarak verir (satır 696–714).
6.2 Şablonun girdileri
Form on altı [[param]] bloğundan kurulur (dialel_cizgi_test.R:10–124). Hangi alanın kullanıldığı kipe bağlıdır; kullanılmayan alanlar yok sayılır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Çözümleme · kip |
seçim · Model | griffing |
griffing, hayman, cizgi_test, artirilmis, latin |
Çalışacak kod bölümü (satır 234, 388, 479, 590, 676). |
Yanıt (özellik) · yanit |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Bağımlı değişken (145–149). |
Ana ebeveyn / çizgi · ebeveyn1 |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Dialelde ana, çizgi × testte çizgi (179, 480). |
Baba ebeveyn / test · ebeveyn2 |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Dialelde baba, çizgi × testte test (179, 480). |
Blok / tekrar · blok |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Dialelde isteğe bağlı; çizgi × test ve artırılmış blokta zorunlu; Latin karede satır (182, 480, 591, 677). |
Sütun etkeni · sutun_etkeni |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Yalnız Latin kare (677). |
Muamele / genotip · muamele |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Artırılmış blok ve Latin kare (591, 677). |
Griffing yöntemi · griffing_yontem |
seçim · Model | otomatik |
otomatik, 1, 2, 3, 4 |
Yöntem seçimi ve satır eleme (239–254). |
Genetik etkiler · etki_modeli |
seçim · Model | sabit |
sabit, rastgele, ikisi |
Etki tabloları (322) ve varyans bileşenleri (349). |
Dış hata kareler ortalaması · hata_ko |
ondalık · Seçenekler | 0 | \ge 0 | 0'dan büyükse kalıntı yerine kullanılır (206–210, 498). |
Dış hata serbestlik derecesi · hata_sd |
tamsayı · Seçenekler | 0 | 0–1000000 | Dış hatanın sd'si (135, 209). |
Kontrol genotipler · kontroller |
metin · Seçenekler | boş | virgülle ayrılmış adlar | Boşsa birden çok kez görülen genotipler kontrol sayılır (599). |
Ortalama karşılaştırması · karsilastirma |
seçim · Seçenekler | lsd |
lsd, tukey, yok |
Artırılmış blok ve Latin karede ikili testler (574–587). |
Anlamlılık düzeyi · alfa |
ondalık · Seçenekler | 0,05 | 0,001–0,5 | GA'lar, EKF ve "anlamlı" sütunu (173, 323, 582, 641, 708). |
Etki tablolarını göster · etki_tablolari |
onay · Çıktı | açık | açık / kapalı | GCA, SCA, karşılıklı ve ortalama tabloları (175). |
Grafikleri çiz · grafik |
onay · Çıktı | açık | açık / kapalı | Şekil (174). |
Örnek ayar (ornek_param, satır 9): kip = griffing, yanit = cicek_zamani, ebeveyn1 = ana, ebeveyn2 = baba, blok = blok. Öteki alanlar varsayılandadır; yöntem veri yapısından Yöntem 1 olarak seçilir.
Şablonun kendi denetimleri (biçimsel denetimden sonra, Bölüm 1.2):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 129 |
| Dış hata KO > 0 ama sd < 1 | "serbestlik derecesi de (≥ 1) girilmeli" | 135–136 |
| Kipin istediği sütun boş | "Bu çözümleme için '…' sütunu seçilmeli." | 137–140 |
| Yanıtta sayı yok; 3'ten az tam gözlem; yanıt sabit | "sayısal değer yok"; "çok az"; "Yanıt sabit" | 147, 151–152 |
| Dialel: ana ve baba aynı sütun; 3'ten az ebeveyn | "farklı sütunlar olmalı"; "en az 3 ebeveyn" | 180, 188 |
| Yöntem 1/2 istenmiş, kendileme yok; Yöntem 1/3 istenmiş, karşılıklı yok | "ebeveyn … satırları gerektirir"; "karşılıklı melezler gerektirir" | 242–245 |
| Yöntem 3/4 ve p<4 | "en az 4 ebeveyn gerekli" | 254 |
| Yöntemin istediği hücre yok | "… melez/ebeveyn eksik (ör. A × B)" | 229–231, 258 |
| Kalıntı sd'si yok, dış hata verilmemiş | "Kalıntı serbestlik derecesi yok (tekrarsız veri)…" | 211–212 |
| Hayman: kendileme satırı yok | "ebeveyn (kendileme) satırları gerektirir" | 390 |
| Çizgi × test: 2'den az çizgi ya da test; 2'den az tekrar; eksik melez | "En az 2 çizgi ve 2 test"; "En az 2 tekrar"; "… melezi eksik" | 488–492 |
| Artırılmış: tek blok; blok = muamele; kontrol veride yok; 2'den az kontrol; artırılmış yok; artırılmış yineleniyor; kontrol bir blokta eksik ya da çift | ilgili ileti | 592–608 |
| Latin kare: üç sütun ayrı değil; 3'ten az muamele | "farklı sütunlar olmalı"; "en az 3 muamele" | 678, 683 |
| Hata sd'si yok (çizgi × test, artırılmış, Latin) | "Hata serbestlik derecesi yok." | 500, 614, 690 |
Eksik değer: her kipte ilgili sütunlarda eksik olan satır atılır; dialelde atılan satır sayısı konsola yazılır (184). Uyarılar (durdurmaz): eşit olmayan tekrar (219, 493), tek düzeyli blok (263), Yöntem 3/4 için atılan ebeveyn satırları (248), birleştirilen karşılıklılar (252), negatif varyans bileşeni (359), tam olmayan Latin kare (686).
6.3 Örnek veri
Şablonla altı dosya gelir. Formdaki "Örnek veriyi aç" düğmesi ilkini açar; ötekiler _ornek klasöründedir ve ilgili kip için elle açılır.
| Dosya | Kip | İçerik | Kaynak |
|---|---|---|---|
…_hayman54.csv |
Griffing 1, 3; Hayman | 8 tütün hattının tam dialeli, 2 blok; 128 satır; çiçeklenme zamanı | Hayman (1954a) |
…_griffing56.csv |
Griffing 4 | 9 mısır hattının F1'leri; 36 satır (ortalama); dış hata KO 21,05, sd 2558 | Griffing (1956) |
…_lonnquist61.csv |
Griffing 2 | 6 mısır çeşidi, ebeveynler + F1; 21 satır (ortalama); dış hata KO 7,10, sd 60 | Lonnquist ve Gardner (1961) |
…_heterosis.csv |
Çizgi × test | 8 çizgi × 3 test + 11 ebeveyn, 3 tekrar; 105 satır; yumru verimi | agricolae paketi |
…_artirilmis.csv |
Artırılmış blok | 3 blok, 4 kontrol (A–D), 8 artırılmış (e–l); 20 satır | agricolae paketi |
…_latin.csv |
Latin kare | 5 × 5 roket yakıtı karesi (kodlanmış yanma hızı); 25 satır | Montgomery (2017), Örnek 4.3 |
Ana örnek verinin değişkenleri (eksik değer yok):
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
cicek_zamani |
Yanıt | sayısal | 128 gözlem; genel ortalama 162,898. |
ana |
Ana ebeveyn | kategorik (8 düzey) | A–H; her düzey 16 satır. |
baba |
Baba ebeveyn | kategorik (8 düzey) | A–H; her düzey 16 satır. |
blok |
Blok | ikili (2 düzey) | 1, 2; her blokta 64 hücrenin tamamı. |
Tasarım tam dialeldir: 8 kendileme (ana = baba), 28 melez ve bunların 28 karşılığı, her hücre iki blokta birer kez. Ebeveyn değerleri (kendileme ortalamaları): A 289,0; B 170,5; C 388,0; D 241,0; E 166,0; F 170,0; G 53,0; H 154,0.
Düzey sırası bu şablonda alfabetik ya da sayısaldır
Şablon ebeveyn, blok ve muamele sütunlarını metne çevirir ve düzeyleri kendisi dizer (dizi, satır 144): etiketlerin hepsi sayıya çevrilebiliyorsa sayısal sırayla, değilse alfabetik sırayla. Veri sekmesinin ilk görülme sırası (Bölüm 1.3) burada kullanılmaz. Sıra hiçbir sonucu değiştirmez; yalnız tabloların satır sırasını ve "A × B" gibi adlarda hangi ebeveynin önce yazıldığını belirler. Karşılıklı etkinin işareti bu sıraya bağlıdır: r_{AB}=(x_{AB}-x_{BA})/2, sırada önce gelen ebeveyn ana iken alınan değer eksi öteki yön.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar + etki_modeli = ikisi (Griffing 1); (2) kip = hayman; (3) griffing_yontem = 3; (4) griffing56, dış hata 21,05 / 2558 (Yöntem 4); (5) lonnquist61, dış hata 7,10 / 60 (Yöntem 2); (6) heterosis, kip = cizgi_test; (7) artirilmis, kip = artirilmis; (8) latin, kip = latin, karsilastirma = tukey.
6.4 Yöntem: formüller ve hesap adımları
Her kipte hesap sırası aynıdır: (1) eksik satırları at, düzeyleri diz; (2) tasarımı denetle; (3) lm ile sıralı kareler toplamlarını al; (4) hücre ortalamalarından etkileri ve standart hatalarını hesapla; (5) seçiliyse varyans bileşenlerini ya da ikili karşılaştırmaları ekle; (6) tabloları ve şekli yaz.
6.4.1 Griffing'in dört yöntemi ve kareler toplamları
Griffing (1956) dialel tablosunun hangi bölümünün yetiştirildiğine göre dört yöntem tanımlar. Şablon yöntemi veriden seçer (satır 236–241): kendileme ve karşılıklı melez varsa 1, yalnız kendileme varsa 2, yalnız karşılıklı varsa 3, ikisi de yoksa 4.
| Yöntem | Hücreler | Hücre sayısı | Etkiler |
|---|---|---|---|
| 1 | ebeveynler + F1 + karşılıklılar | p^2 | g, s (köşegen dahil), r |
| 2 | ebeveynler + F1 | p(p+1)/2 | g, s (köşegen dahil) |
| 3 | F1 + karşılıklılar | p(p-1) | g, s, r |
| 4 | yalnız F1 | p(p-1)/2 | g, s |
Kareler toplamları genel doğrusal modelde sıralı olarak alınır: önce blok, sonra GCA, sonra SCA, sonra karşılıklı etki.
- \mathrm{AKT}(\cdot): parantezdeki terimleri içeren modelin artık kareler toplamı.
- B: blok göstergeleri. G: p sütunlu GCA matrisi; k. sütun, gözlemin ana ebeveyni k ise 1, baba ebeveyni k ise 1 daha alır (kendilemede 2) (satır 201). C: sırasız çift sınıfı (i–j ile j–i aynı düzey; satır 202). H: sıralı hücre sınıfı (ana ve baba ayrı).
- Çıktıda Yöntem 1 ve 2'de SCA satırı "tSCA" (toplam SCA: kendilemelerin s_{ii} etkileri dahil), Yöntem 3 ve 4'te "SCA" adını alır (satır 272).
Dengeli tam dialelde (Yöntem 1) aynı toplamlar Griffing'in kapalı formülleriyle yazılır; hücre ortalamaları üzerinden hesaplanıp tekrar sayısı r ile çarpılır:
- X_{i.}, X_{.i}: i. ebeveynin ana ve baba olduğu hücrelerin toplamı; X_{..}: bütün hücrelerin toplamı.
- sd: GCA p-1; SCA Yöntem 1 ve 2'de p(p-1)/2, Yöntem 3 ve 4'te p(p-3)/2; karşılıklı p(p-1)/2.
Neden sıralı kareler toplamı?
GCA, SCA ve karşılıklı etki birbirinin içine yuvalanmış alt uzaylardır: SCA sütunları GCA sütunlarını, hücre sınıfı da SCA sınıfını kapsar. Sıralı ayrışım, her terimi kendinden öncekiler ayıklandıktan sonra ölçer ve dengeli tabloda Griffing'in kapalı formülleriyle aynı sonucu verir (6.6). Bu çerçeve Onofri ve ark. (2021) tarafından ayrıntılandırılmıştır. Hücre başına tekrar eşit değilse sıra önemlidir; şablonun sırası blok → GCA → SCA → karşılıklıdır.
Koddaki tercih
Model tek bir stats::lm çağrısıdır: Yöntem 1 ve 3'te y ~ B + G + cift + giris, Yöntem 2 ve 4'te y ~ B + G + cift (satır 266–270). G bir matristir; lm onu tek terim olarak alır ve doğrusal bağımlı sütununu kendiliğinden düşürür, böylece anova() çıktısında GCA tek satırdır. Tablo anova_tablo yardımcısıyla kurulur (156–172); bütün F değerleri hata kareler ortalamasına karşıdır (sabit model). Yöntem 3/4 seçildiğinde ebeveyn satırları atılır (246–249); Yöntem 2/4'te karşılıklı melezler aynı hücrede birleştirilir (250–253).
6.4.2 Griffing etkileri ve standart hataları (Model I)
Etkiler hücre ortalamalarının doğrusal işlevleridir. Yöntem 1 için (satır 290–294):
- X_{i.}, X_{.i}, X_{..}: 6.4.1'deki satır, sütun ve genel toplamlar (hücre ortalamaları üzerinden).
- \hat g_i: i. ebeveynin yer aldığı 2p hücrenin ortalamasının genel ortalamadan sapması. \hat s_{ij}: iki yönün ortalamasının, \hat\mu+\hat g_i+\hat g_j beklentisinden sapması; i=j için ebeveynin kendi değerinin sapmasıdır. \hat r_{ij}: iki yönün farkının yarısı; \hat r_{ji}=-\hat r_{ij}.
- Kısıtlar: \sum_i\hat g_i=0 ve her i için \sum_j\hat s_{ij}=0.
Öteki yöntemlerde yalnız katsayılar değişir. A_i, i. ebeveynin yer aldığı hücrelerin toplamı ve T kullanılan hücrelerin toplamı olmak üzere:
| Yöntem | \hat g_i | \hat s_{ij} | Satır |
|---|---|---|---|
| 2 (A_i=X_{i.}+x_{ii}) | \dfrac{A_i-2T/p}{p+2} | x_{ij}-\dfrac{A_i+A_j}{p+2}+\dfrac{2T}{(p+1)(p+2)} | 295–299 |
| 3 (A_i=X_{i.}+X_{.i}) | \dfrac{pA_i-2T}{2p(p-2)} | \dfrac{x_{ij}+x_{ji}}{2}-\dfrac{A_i+A_j}{2(p-2)}+\dfrac{T}{(p-1)(p-2)} | 300–304 |
| 4 (A_i=X_{i.}) | \dfrac{pA_i-2T}{p(p-2)} | x_{ij}-\dfrac{A_i+A_j}{p-2}+\dfrac{2T}{(p-1)(p-2)} | 305–309 |
Her etkinin varyansı \sigma'^2=\mathrm{KO}_h/r (hücre ortalamasının hata varyansı) ile bir katsayının çarpımıdır. Yöntem 1'de:
- \mathrm{KO}_h: hata kareler ortalaması (gözlem ölçeği); r: hücre başına tekrar. Dış hata verilmişse \mathrm{KO}_h ve sd'si kullanıcının girdiğidir.
- Fark varyansları: \operatorname{Var}(\hat g_i-\hat g_j)=\sigma'^2/p; \operatorname{Var}(\hat s_{ii}-\hat s_{jj})=2(p-2)\sigma'^2/p; \operatorname{Var}(\hat s_{ii}-\hat s_{ij})=(3p-2)\sigma'^2/(2p); \operatorname{Var}(\hat s_{ij}-\hat s_{ik})=(p-1)\sigma'^2/p; \operatorname{Var}(\hat s_{ij}-\hat s_{kl})=(p-2)\sigma'^2/p; \operatorname{Var}(\hat r_{ij}-\hat r_{kl})=\sigma'^2.
- Test: t=\text{kestirim}/\text{SH}, sd hata sd'si; GA \text{kestirim}\pm t_{1-\alpha/2}\,\text{SH}.
Koddaki tercih
Şablon bu katsayıları yöntem başına ayrı ayrı yazmaz. Etkileri veren griff fonksiyonunu her hücreye sırayla 1, ötekilere 0 koyarak çağırır ve böylece etkilerin hücrelere göre Jacobian matrisini \mathbf J kurar (satır 316–318). Hücre ortalamaları bağımsız ve eşit varyanslı olduğundan bir etkinin varyansı \sigma'^2\sum_h J_{eh}^2, bir farkın varyansı \sigma'^2\sum_h (J_{eh}-J_{fh})^2'dir (320–321). Dört yöntemde de kesin sonucu verir; yukarıdaki kapalı katsayılarla eşitliği 6.6.1'de gösterilmiştir. Hücre başına tekrar eşit değilse r yerine harmonik ortalama alınır ve sonuç yaklaşıktır (215–224).
6.4.3 Varyans bileşenleri (Model II)
Ebeveynler bir popülasyondan rastgele örnekse g, s, r rastgele etkilerdir ve varyansları beklenen kareler ortalamalarından kestirilir. Kareler ortalamaları ortalama ölçeğine çekilir: M_g=\mathrm{KO}_{\text{GCA}}/r, M_s=\mathrm{KO}_{\text{SCA}}/r, M_r=\mathrm{KO}_{\text{REC}}/r, M_e=\mathrm{KO}_h/r (satır 281–285).
| Yöntem | \hat\sigma^2_{g} | \hat\sigma^2_{s} | \hat\sigma^2_{r} |
|---|---|---|---|
| 1 | \dfrac{M_g-M_s}{2p} | \dfrac{p^2\,(M_s-M_e)}{2(p^2-p+1)} | \dfrac{M_r-M_e}{2} |
| 2 | \dfrac{M_g-M_s}{p+2} | M_s-M_e | — |
| 3 | \dfrac{M_g-M_s}{2(p-2)} | \dfrac{M_s-M_e}{2} | \dfrac{M_r-M_e}{2} |
| 4 | \dfrac{M_g-M_s}{p-2} | M_s-M_e | — |
Tabloya ayrıca Baker (1978) oranı 2\hat\sigma^2_g/(2\hat\sigma^2_g+\hat\sigma^2_s) ve genetik varyanslar yazılır: kendilenmiş ebeveynlerde (F=1) \sigma^2_A=2\sigma^2_g, \sigma^2_D=\sigma^2_s (satır 354–356).
Neden Yöntem 1 ve 2'de ayrı bir uyarı yazılır?
Kendilemeler tabloya girince GCA ve SCA izdüşümlerinin beklenen kareler ortalamalarında \sigma^2_s'nin katsayıları eşitlenmez. Yöntem 1'de E(M_g)=\sigma'^2+\frac{2(p-1)}{p}\sigma^2_s+2p\,\sigma^2_g ve E(M_s)=\sigma'^2+\frac{2(p^2-p+1)}{p^2}\sigma^2_s'dir; p=8 için katsayılar 1{,}75 ve 1{,}78125. Şablonun kullandığı (M_g-M_s)/(2p) farkı bu yüzden \sigma^2_g-\sigma^2_s/p^3'ü kestirir; örnek veride fark 1{,}77'dir (1125{,}70 yerine tam çözüm 1127{,}47). Olabilirlik temelli (REML) kestirimler de bu yöntemlerde kareler ortalaması kestiricilerinden ayrışır; şablon bunu konsol notuyla bildirir (satır 362–363). Kendilemesiz yöntemlerde (3, 4) dengeli veride iki yaklaşım aynı sonucu verir.
6.4.4 Hayman varyans analizi
Hayman (1954a) aynı tam dialel tablosunu altı maddeye ayırır. Şablon bunu, Griffing modelinin SCA terimini üçe, karşılıklı terimini ikiye bölen sıralı bir modelle kurar (satır 400–404):
| Madde | Anlamı | Tasarım sütunu | sd |
|---|---|---|---|
| a | eklemeli etki (GCA) | G | p-1 |
| b_1 | ortalama yönlü dominans: ebeveynler ortalaması ile melezler ortalaması farkı | kendi (kendileme göstergesi) |
1 |
| b_2 | ebeveyne özgü dominans sapması | D (ebeveyn başına kendileme göstergesi) |
p-1 |
| b_3 | kalan dominans (kendilemesiz SCA) | cift |
p(p-3)/2 |
| c | ortalama anaç etkisi (karşılıklı GCA) | RG: [\text{ana}=k]-[\text{baba}=k] |
p-1 |
| d | kalan karşılıklı farklar | giris |
(p-1)(p-2)/2 |
- a maddesi Griffing'in GCA satırıyla, b_3 maddesi Yöntem 3'ün SCA satırıyla aynı kareler toplamını verir.
- Bütün F değerleri hata kareler ortalamasına karşıdır (sabit model). Karşılıklı melez yoksa c ve d hesaplanmaz (satır 412).
6.4.5 Hayman W_r–V_r çözümlemesi ve genetik bileşenler
Karşılıklı melezlerin ortalaması alınarak simetrik bir tablo kurulur (satır 414–416). r. ebeveynin dizisi (array), o ebeveynin kendisi ve bütün melezleridir (tablonun r. satırı).
- V_r: dizinin p girdisinin örneklem varyansı (payda p-1). W_r: aynı girdilerin, karşılarındaki ebeveynlerin kendi değerleriyle (köşegen) kovaryansı.
- Eklemeli-dominans modeli geçerliyse (epistasi yok, genler ebeveynlerde bağımsız dağılmış) noktalar eğimi 1 olan bir doğruya düşer. Şablon b=0 ve b=1 için t testlerini verir; sd p-2 (satır 428–436). Sınır parabolü W_r^2=V_P\,V_r'dir (V_P: ebeveyn değerlerinin varyansı).
- Doğru üzerinde orijine yakın diziler dominant alelleri, uzak diziler çekinik alelleri çok taşır. Kesişim a>0 kısmi dominansı, a<0 üstün dominansı gösterir.
Genetik bileşenler (Hayman 1954b; satır 438–445), n=p ile:
- \bar V_r, \bar W_r: V_r ve W_r'nin ortalaması; V_{\bar r}: dizi ortalamalarının varyansı; \bar x_F: simetrik tablonun genel ortalaması; \bar x_P: ebeveyn değerlerinin ortalaması.
- D: eklemeli varyans bileşeni. H_1, H_2: dominans bileşenleri; alel sıklıkları eşitse H_1=H_2. F: dominant ve çekinik alellerin ebeveynlerdeki göreli sıklığı (pozitifse dominantlar çok). h^2: dominans etkilerinin lokuslar üzerinden toplamı (kalıtım derecesi değildir).
- Oranlar (satır 450–456): ortalama dominans derecesi \sqrt{H_1/D}; H_2/(4H_1) (alel sıklıkları eşitse 0{,}25); dominant/çekinik oran (\sqrt{4DH_1}+F)/(\sqrt{4DH_1}-F); etkin gen grubu sayısı h^2/H_2; dar anlamda kalıtım (\frac12D+\frac12H_1-\frac12H_2-\frac12F)\,/\,(\frac12D+\frac12H_1-\frac14H_2-\frac12F+E); geniş anlamda kalıtımda payda aynıdır, pay \frac12D+\frac12H_1-\frac14H_2-\frac12F'dir.
Neden E'nin katsayıları (n-2)/n, (3n-2)/n gibi?
Simetrik tabloda köşegen (ebeveyn) girdisinin hata varyansı E, köşegen dışı girdinin ise iki karşılıklı melezin ortalaması olduğu için E/2'dir. Bir dizinin varyansına hatanın katkısı ortalama olarak [E+(n-1)E/2]/n=(n+1)E/(2n), ebeveynlerle kovaryansına katkısı E/n'dir. H_1=V_P-4\bar W_r+4\bar V_r birleşiminde hata payı E-4E/n+2(n+1)E/n=(3n-2)E/n olur; öteki katsayılar aynı yoldan çıkar. Katsayılar bu nedenle karşılıklı melezleri içeren tam dialele özgüdür.
6.4.6 Çizgi × test
l çizgi, t test, r tekrar. Önce ebeveynler ve melezler birlikte "giriş" sayılarak tesadüf blokları ANOVA'sı yapılır; hata buradan gelir (satır 495–497). Giriş kareler toplamı ebeveynler, melezler ve "ebeveynler – melezler" (1 sd) olarak; melez kareler toplamı da çizgi, test ve çizgi × test olarak bölünür (501–504).
- Ortalamalar yalnız melezler üzerindendir. M_l, M_t, M_{lt}: çizgi, test ve çizgi × test kareler ortalamaları.
- \operatorname{Kov}_{\text{YK}}: yarım kardeş kovaryansı (ortalama). F: ebeveynlerin akrabalı yetiştirme katsayısı; şablon F=0 ve F=1 için iki değeri de yazar (\sigma^2_A: 4 ve 2 çarpanı; \sigma^2_D: 2(M_{lt}-\mathrm{KO}_h)/r ve (M_{lt}-\mathrm{KO}_h)/r; satır 553).
- Katkı yüzdeleri: çizgi, test ve çizgi × test kareler toplamlarının melez kareler toplamına oranı.
- SH'lerin farkları için \sqrt2 çarpanı kullanılır (satır 542).
Koddaki tercih
Çizgi ve test kareler ortalamalarının F testi hata yerine çizgi × test kareler ortalamasına karşı yapılır (sd (l-1)(t-1); satır 515–516); çizgi × test ise hataya karşı test edilir. Bu, çizgi ve testleri rastgele örnek sayan Kempthorne (1957) düzenidir. Melezlerin alt çözümlemesi tekrar terimi olmadan lm(y ~ c * t) ile yapılır (504); tasarım dengeli olduğunda kareler toplamları tekrar etkisinden bağımsızdır. Tam kardeş kovaryansı Singh ve Chaudhary'nin (1985) iki terimli formülüyle hesaplanır (547).
6.4.7 Artırılmış blok tasarımı
b blokta c kontrol her blokta birer kez, v yeni genotip ise yalnız birer kez yer alır (Federer 1956). Hata, yalnız kontrollerin blok × kontrol tablosundan gelir: sd (b-1)(c-1).
- \bar y^{(K)}_{.j}: j. bloktaki kontrollerin ortalaması; \bar y^{(K)}_{..}: bütün kontrol gözlemlerinin ortalaması (satır 643–649).
- İki ANOVA tablosu verilir: bloklar önce (muamele düzeltilmiş) ve muameleler önce (blok düzeltilmiş). Muamele kareler toplamı kontroller, artırılmışlar ve "kontroller – artırılmışlar" (1 sd) olarak bölünür (611–633).
Düzeltilmiş ortalamanın standart hatası (satır 650):
- Kontrolün ortalaması b gözlemin ortalamasıdır. Artırılmış genotipte tek gözlemin varyansına (\sigma^2) blok etkisi kestiriminin varyansı eklenir: \operatorname{Var}(\hat\beta_j)=\sigma^2/c-\sigma^2/(bc).
- Grafikteki güven aralıkları bu standart hatalarla çizilir (664–667). Değerler
verim ~ blok + genotipmodelinin en küçük kareler ortalamalarının standart hatalarıyla aynıdır.
Fark standart hataları (satır 638–640):
- b: blok sayısı; c: kontrol sayısı; \mathrm{KO}_h: kontrollerden gelen hata kareler ortalaması, sd (b-1)(c-1).
- Her satırın en küçük önemli farkı (EKF) t_{1-\alpha/2}\cdot\text{SH}'dir (satır 641).
Neden dört ayrı fark hatası var?
Artırılmış genotipin düzeltilmiş ortalaması blok etkisinin kestirimini taşır. Aynı bloktaki iki artırılmışın farkında bu kestirim götürür; kalan iki tek gözlemin farkıdır (2\sigma^2). Farklı bloklarda iki ayrı blok etkisi kestirimi girer; her biri c kontrolün ortalamasına dayandığından varyans 2\sigma^2/c kadar büyür. Kontrol ortalaması ise b gözlemin ortalamasıdır. En küçük önemli fark (EKF) her satır için t_{1-\alpha/2}\cdot\text{SH}'dir (satır 641).
6.4.8 Latin kare ve ikili karşılaştırmalar
k muamele, k satır ve k sütunda her satır ve sütunda birer kez. Hata sd'si (k-1)(k-2). Model lm(y ~ satır + sütun + muamele); muamele kareler toplamı satır ve sütundan sonra alınır (satır 689–692). Muamele ortalamaları, satır ve sütun etkilerinin ortalaması üzerinden en küçük kareler ortalamasıdır; tam karede ham ortalamaya eşittir ve SH'si \sqrt{\mathrm{KO}_h/k}'dir.
İkili karşılaştırmalar artırılmış blok ve Latin kare kiplerinde ortaktır (satır 574–587):
- \nu: hata sd'si; Q_{k,\nu}: k ortalamalı çalışmalı aralık dağılımı. c=t_{1-\alpha/2,\nu} (EKF) ya da q_{1-\alpha;k,\nu}/\sqrt2 (Tukey).
- \operatorname{SH}_{ij} çifte özgüdür: artırılmış blokta 6.4.7'deki dört değerden biri, Latin karede \sqrt{2\mathrm{KO}_h/k}.
EKF düzeltmesizdir; Tukey artırılmış blokta yaklaşıktır
Varsayılan "EKF (LSD)" çoklu karşılaştırma düzeltmesi yapmaz: 12 genotipte 66 testin her biri \alpha düzeyindedir. Tukey seçildiğinde artırılmış blokta fark standart hataları eşit olmadığından test Tukey–Kramer türü bir yaklaşıktır; ortalama sayısı k bütün genotiplerin (kontrol + artırılmış) sayısıdır (satır 660).
6.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–125 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, 16 parametre. | Form buradan kurulur (Bölüm 1.2). |
| 126–175 | Yardımcılar: ileti dili, boşluk denetimi, metin/sayi dönüşümleri, dizi (düzey sırası), anova_tablo, anlamli. |
metin düzey adlarını mq_kimlik ile okur ve "NA", "nan", "None" yazılarını eksik sayar (141); sayi yanıtı mq_sayisal ile okur (142; Bölüm 1.5). |
| 177–232 | Dialel yardımcıları: dialel_veri (temizleme, ebeveyn listesi), hucre_tablosu, tasarim_sutunlari, hata_secimi, tekrar_sayisi, eksik_hucre_hatasi. |
Ebeveyn listesi ana ve baba sütunlarının birleşimidir (187). |
| 234–386 | Griffing: yöntem seçimi, satır eleme, lm, ANOVA tablosu, griff etkileri, Jacobian ile SH, Model II bileşenleri, GCA çubuk grafiği ve SCA ısı haritası. |
Etki tabloları yalnız Model I ya da "ikisi" seçiliyse (322); bileşenler Model II ya da "ikisi" seçiliyse (349). |
| 388–476 | Hayman: altı maddeli ANOVA, simetrik tablo, V_r, W_r, regresyon, bileşenler, oranlar, W_r–V_r grafiği. | E=\mathrm{KO}_h/r (418); D ya da H_1\le0 ise not (460). |
| 479–571 | Çizgi × test: giriş ANOVA'sı, alt ayrışımlar, GCA/SCA etkileri ve SH'leri, kovaryanslar, katkı yüzdeleri, grafik. | Ebeveyn satırları: çizgi ya da test sütunlarından biri boş (484–486). |
| 574–587 | ikili: ikili karşılaştırma tablosu. |
Fark varyans matrisi çağıran kipten gelir. |
| 590–673 | Artırılmış blok: tasarım denetimi, iki ANOVA, fark SH'leri ve EKF, düzeltilmiş ortalamalar ve SH'leri, karşılaştırmalar, grafik. | Düzeltilmiş ortalamalar tablosu büyükten küçüğe sıralıdır (653). Artırılmış genotipin SH'si blok düzeltmesinin belirsizliğini içerir (650). |
| 676–733 | Latin kare: tamlık denetimi, ANOVA, EKK ortalamaları, karşılaştırmalar, yerleşim haritası ve ortalama grafiği. | Tam kare değilse not yazılır, çözümleme sürer (686). |
Kritik satır, etkilerin standart hatasını her yöntem için tek kalıpla veren Jacobian'dır:
J <- sapply(seq_len(nrow(hucreler)), function(h) {
  U <- matrix(0, p, p); U[hucreler[h, , drop = FALSE]] <- 1; vek(griff(U)) })
var_i <- function(ix) s2 * rowSums(J[ix, , drop = FALSE]^2)
6.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/dialel_cizgi_test/elle_hesap.py ile, lm ve şablon kodu kullanılmadan, kapalı formüllerden hesaplanmıştır. R tarafında (r_dogrulama.R) aynı büyüklükler lmDiallel, agricolae ve emmeans paketleriyle yeniden kurulmuştur.
Adım 1 — Hücre ortalamaları ve toplamlar. p=8, r=2, N=128. Hücre ortalamalarının toplamı X_{..}=10425{,}5; \hat\mu=10425{,}5/64=162{,}8984. A ebeveyni için X_{A.}+X_{.A}=3345{,}5.
Adım 2 — Griffing Yöntem 1 kareler toplamları (kapalı formül × r):
| Kaynak | sd | KT | KO | F | p |
|---|---|---|---|---|---|
| Blok | 1 | 142,383 | 142,383 | 0,342 | 0,561 |
| GCA | 7 | 277716,734 | 39673,819 | 95,180 | 4{,}9\times10^{-31} |
| tSCA | 28 | 102238,445 | 3651,373 | 8,760 | 6{,}7\times10^{-13} |
| Karşılıklı | 28 | 19112,000 | 682,571 | 1,638 | 0,0537 |
| Hata | 63 | 26260,117 | 416,827 |
Hata sd'si (r-1)(p^2-1)=63'tür.
Adım 3 — Etkiler. \hat g_A=3345{,}5/16-162{,}8984=46{,}1953. x_{AA}=289{,}0 ile \hat s_{AA}=289{,}0-2\cdot3345{,}5/16+162{,}8984=33{,}7109. \hat r_{AB}=(x_{AB}-x_{BA})/2=14{,}00.
Adım 4 — Standart hatalar. \sigma'^2=416{,}827/2=208{,}414.
\operatorname{SH}(\hat\mu)=1{,}8046; \operatorname{SH}(\hat r)=10{,}2082; \operatorname{SH}(\hat g_i-\hat g_j)=\sqrt{208{,}414/8}=5{,}1041. t_A=46{,}1953/3{,}3760=13{,}683; %95 GA [39{,}449;\ 52{,}942] (sd 63).
Adım 5 — Model II. M_g=19836{,}910, M_s=1825{,}687, M_r=341{,}286, M_e=208{,}414.
Baker oranı 2\cdot1125{,}701/(2\cdot1125{,}701+907{,}943)=0{,}7126.
Adım 6 — Hayman maddeleri. a=277716{,}734 (GCA ile aynı). Dik izdüşümle b_1=30796{,}885, b_2=34152{,}703, b_3=37288{,}857; toplamları 102238{,}445=\mathrm{KT}_{\text{tSCA}}. c=6739{,}125, d=19112{,}000-6739{,}125=12372{,}875. F değerleri: 73,884; 11,705; 4,473; 2,310; 1,413.
Adım 7 — W_r, V_r ve bileşenler. A dizisi için V_r=3076{,}892, W_r=4002{,}150. V_P=10210{,}460, \bar V_r=2152{,}650, \bar W_r=3335{,}020, V_{\bar r}=1239{,}807, E=208{,}414. Regresyon W_r=1330{,}737+0{,}9311\,V_r; \operatorname{SH}(b)=0{,}0874; b=1 için t=0{,}788, p=0{,}461.
\bar x_P=203{,}9375, \bar x_F=162{,}8984: h^2=4\cdot(-41{,}0391)^2-\frac{28}{64}\cdot208{,}414=6645{,}638. Oranlar: \sqrt{H_1/D}=0{,}700; H_2/(4H_1)=0{,}165; dar anlamda kalıtım 0{,}707; geniş anlamda 0{,}940.
Adım 8 — Öteki kipler. Çizgi × test (heterosis verisi): M_l=0{,}71079, M_t=0{,}32469, M_{lt}=0{,}19572, \mathrm{KO}_h=0{,}026487 (sd 68); F_{\text{çizgi}}=0{,}71079/0{,}19572=3{,}632; \operatorname{SH}(\hat g_{\text{çizgi}})=\sqrt{0{,}026487/9}=0{,}0542. Artırılmış blok: \mathrm{KO}_h=26{,}972 (sd 6); blok etkileri -3{,}25; 0{,}75; 2{,}50; III. bloktaki h genotipi 96-2{,}5=93{,}5; artırılmış – kontrol fark SH'si \sqrt{26{,}972\cdot(1+\frac13+\frac14-\frac1{12})}=6{,}3607; düzeltilmiş ortalamanın SH'si kontrolde \sqrt{26{,}972/3}=2{,}9985, artırılmış genotipte \sqrt{26{,}972\cdot(1+\frac14-\frac1{12})}=5{,}6096. Latin kare: KT satır 68, sütun 150, muamele 330, hata 128 (sd 12); F=82{,}5/10{,}667=7{,}734, p=0{,}0025; fark SH'si \sqrt{2\cdot10{,}667/5}=2{,}0656.
6.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–3 ve 6–8). R sütununda Griffing ve Hayman satırları lmDiallel::lm.diallel çıktısıdır; artırılmış bloktaki düzeltilmiş ortalamalar emmeans, fark standart hataları agricolae::DAU.test, Latin karedeki Tukey değerleri TukeyHSD sonucudur.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Griffing 1: KT GCA | 2,777167·105 | 2,777167·105 | 2,777167·105 | 3,6e−15 | ✓ |
| Griffing 1: F GCA | 95,18048193 | 95,18048193 | 95,18048193 | 2,1e−15 | ✓ |
| Griffing 1: KT tSCA | 1,022384·105 | 1,022384·105 | 1,022384·105 | 0 | ✓ |
| Griffing 1: F tSCA | 8,75991909 | 8,75991909 | 8,75991909 | 2,2e−15 | ✓ |
| Griffing 1: KT REC | 19112 | 19112 | 19112 | 5,1e−15 | ✓ |
| Griffing 1: F REC | 1,63754029 | 1,63754029 | 1,63754029 | 1,1e−15 | ✓ |
| Griffing 1: KT hata | 26260,1171875 | 26260,1171875 | 26260,1171875 | 3,7e−15 | ✓ |
| Griffing 1: p REC | 0,0536861 | 0,0536861 | 0,0536861 | 1,2e−15 | ✓ |
| Griffing 1: \hat\mu | 162,8984375 | 162,8984375 | 162,8984375 | 0 | ✓ |
| Griffing 1: SH(\hat\mu) | 1,80456725 | 1,80456725 | 1,80456725 | 5,5e−15 | ✓ |
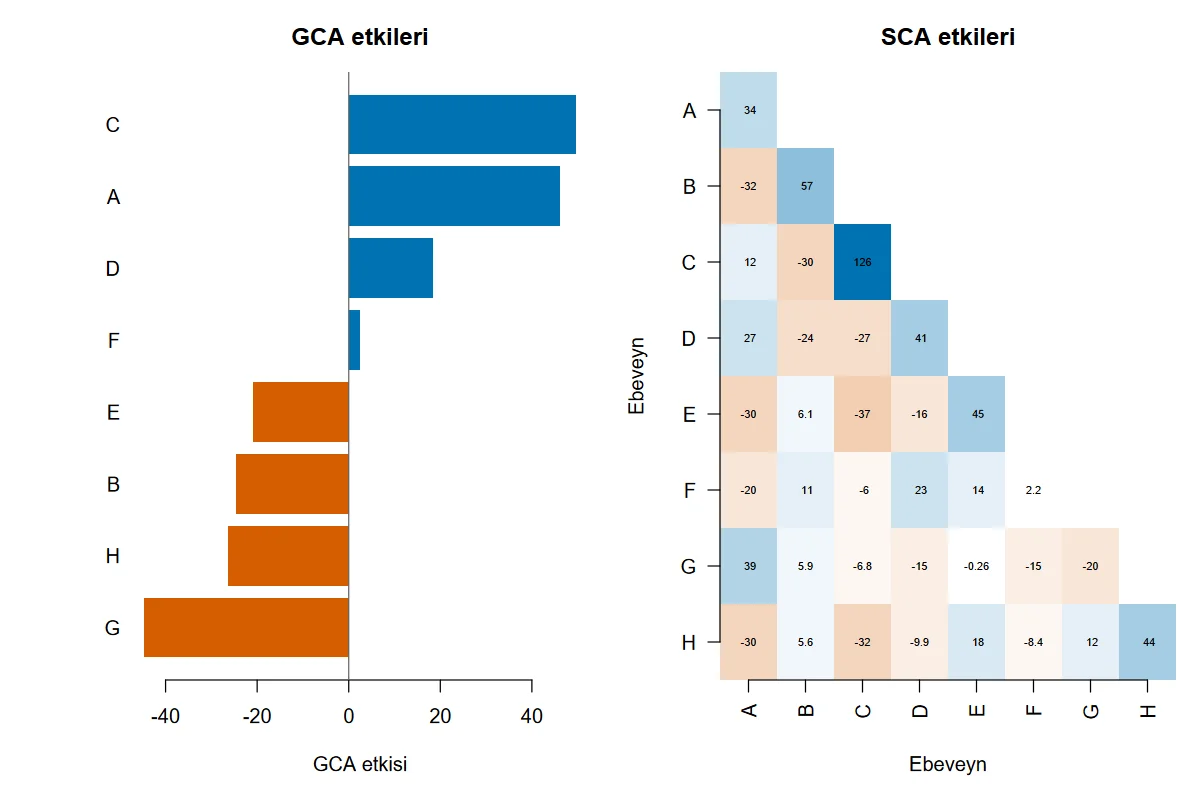
| Griffing 1: \hat g_A | 46,1953125 | 46,1953125 | 46,1953125 | 2,2e−15 | ✓ |
| Griffing 1: \hat g_C | 49,6328125 | 49,6328125 | 49,6328125 | 0 | ✓ |
| Griffing 1: \hat g_G | −44,7109375 | −44,7109375 | −44,7109375 | 0 | ✓ |
| Griffing 1: SH(\hat g_i) | 3,37603618 | 3,37603618 | 3,37603618 | 6,6e−16 | ✓ |
| Griffing 1: p(g_A) | 1,558468·10−20 | 1,558468·10−20 | 1,558468·10−20 | 2,7e−33 | ✓ |
| Griffing 1: g_A GA alt | 39,44884252 | 39,44884252 | — | 5,4e−16 | ✓ |
| Griffing 1: \hat s_{AA} | 33,7109375 | 33,7109375 | 33,7109375 | 1,5e−14 | ✓ |
| Griffing 1: SH(\hat s_{ii}) | 12,63197072 | 12,63197072 | 12,63197072 | 2,7e−15 | ✓ |
| Griffing 1: \hat s_{AB} | −31,5078125 | −31,5078125 | −31,5078125 | 0 | ✓ |
| Griffing 1: SH(\hat s_{ij}) | 9,02283623 | 9,02283623 | 9,02283623 | 9,8e−16 | ✓ |
| Griffing 1: \hat r_{AB} | 14 | 14 | 14 | 0 | ✓ |
| Griffing 1: SH(\hat r_{ij}) | 10,20817389 | 10,20817389 | 10,20817389 | 7,0e−16 | ✓ |
| Griffing 1: SH(g_i − g_j) | 5,10408695 | 5,10408695 | — | 7,0e−16 | ✓ |
| Griffing 1: SH(s_ii − s_jj) | 17,68107584 | 17,68107584 | — | 4,0e−16 | ✓ |
| Griffing 1: SH(s_ii − s_ij) | 16,9283413 | 16,9283413 | — | 2,3e−15 | ✓ |
| Griffing 1: SH(s_ij − s_ik) | 13,50414473 | 13,50414473 | — | 7,9e−16 | ✓ |
| Griffing 1: SH(s_ij − s_kl) | 12,50240862 | 12,50240862 | — | 4,1e−15 | ✓ |
| Griffing 1: SH(r_ij − r_kl) | 14,43653797 | 14,43653797 | — | 6,2e−16 | ✓ |
| Griffing 1 Model II: σ²GCA | 1125,70144217 | 1125,70144217 | — | 8,1e−16 | ✓ |
| Griffing 1 Model II: σ²SCA | 907,94267788 | 907,94267788 | — | 7,5e−16 | ✓ |
| Griffing 1 Model II: σ²r | 66,43604291 | 66,43604291 | — | 7,9e−15 | ✓ |
| Griffing 1 Model II: Baker oranı | 0,71261685 | 0,71261685 | — | 2,2e−16 | ✓ |
| Griffing 3 Model II: σ²GCA | 927,80892857 | — | 927,80892857 | 0 | ✓ |
| Griffing 3 Model II: σ²SCA | 367,77045455 | — | 367,77045455 | 2,6e−15 | ✓ |
| Griffing 3 Model II: σ²r | 72,3025974 | — | 72,3025974 | 1,4e−15 | ✓ |
| Hayman: KT b1 | 30796,88504464 | 30796,88504464 | 30796,88504464 | 3,7e−14 | ✓ |
| Hayman: F b1 | 73,88404796 | 73,88404796 | 73,88404796 | 3,4e−14 | ✓ |
| Hayman: KT b2 | 34152,703125 | 34152,703125 | 34152,703125 | 7,4e−14 | ✓ |
| Hayman: F b2 | 11,70498692 | 11,70498692 | 11,70498692 | 7,4e−14 | ✓ |
| Hayman: KT b3 | 37288,85714286 | 37288,85714286 | 37288,85714286 | 5,5e−15 | ✓ |
| Hayman: F b3 | 4,47293891 | 4,47293891 | 4,47293891 | 7,1e−15 | ✓ |
| Hayman: KT c | 6739,125 | 6739,125 | 6739,125 | 0 | ✓ |
| Hayman: F c | 2,30966696 | 2,30966696 | 2,30966696 | 1,7e−15 | ✓ |
| Hayman: KT d | 12372,875 | 12372,875 | 12372,875 | 0 | ✓ |
| Hayman: F d | 1,41349807 | 1,41349807 | 1,41349807 | 7,1e−15 | ✓ |
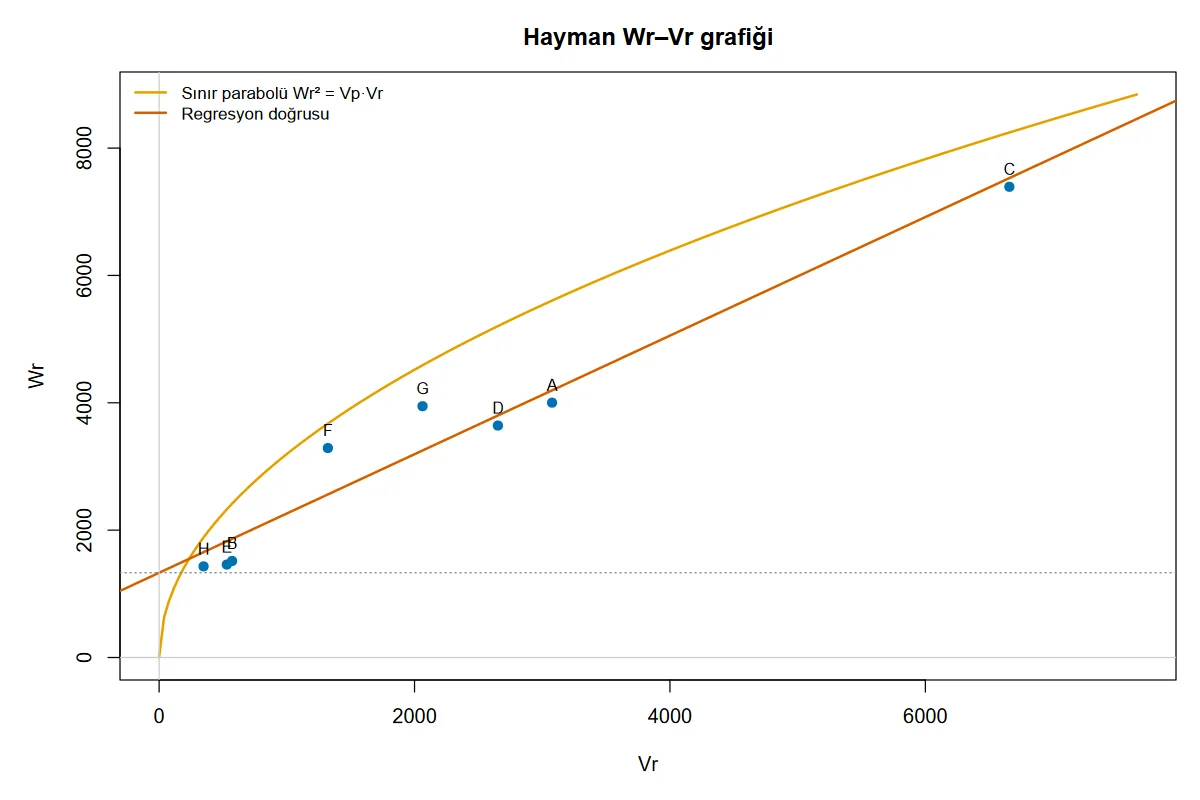
| Hayman: V_r (A) | 3076,89174107 | 3076,89174107 | 3076,89174107 | 4,4e−16 | ✓ |
| Hayman: W_r (A) | 4002,14955357 | 4002,14955357 | 4002,14955357 | 3,4e−16 | ✓ |
| Hayman: V_r (C) | 6657,72209821 | 6657,72209821 | 6657,72209821 | 6,8e−16 | ✓ |
| Hayman: W_r (C) | 7392,43080357 | 7392,43080357 | 7392,43080357 | 2,5e−16 | ✓ |
| Hayman: V_r (H) | 348,14285714 | 348,14285714 | 348,14285714 | 4,9e−16 | ✓ |
| Hayman: W_r (H) | 1430,85714286 | 1430,85714286 | 1430,85714286 | 2,1e−15 | ✓ |
| Hayman: regresyon kesişimi | 1330,73730937 | 1330,73730937 | 1330,73730937 | 3,2e−15 | ✓ |
| Hayman: regresyon eğimi b | 0,93107663 | 0,93107663 | 0,93107663 | 1,1e−16 | ✓ |
| Hayman: SH(b) | 0,08744062 | 0,08744062 | 0,08744062 | 2,8e−17 | ✓ |
| Hayman: t (b=1) | 0,78823051 | 0,78823051 | 0,78823051 | 6,0e−15 | ✓ |
| Hayman: p (b=1) | 0,46056035 | 0,46056035 | — | 3,5e−15 | ✓ |
| Hayman: D | 10002,04619296 | 10002,04619296 | 10002,04619296 | 4,7e−15 | ✓ |
| Hayman: H_1 | 4907,84466456 | 4907,84466456 | 4907,84466456 | 3,7e−16 | ✓ |
| Hayman: H_2 | 3234,54578993 | 3234,54578993 | 3234,54578993 | 2,0e−15 | ✓ |
| Hayman: F | 6768,22107515 | 6768,22107515 | 6768,22107515 | 2,7e−16 | ✓ |
| Hayman: h^2 | 6645,63764106 | 6645,63764106 | 6645,63764106 | 4,1e−16 | ✓ |
| Hayman: E | 208,41362847 | 208,41362847 | 208,41362847 | 3,7e−15 | ✓ |
| Hayman: \sqrt{H_1/D} | 0,70048845 | 0,70048845 | — | 1,1e−16 | ✓ |
| Hayman: H_2/(4H_1) | 0,16476407 | 0,16476407 | — | 2,8e−16 | ✓ |
| Hayman: dominant/çekinik oran | 2,86853501 | 2,86853501 | — | 1,1e−15 | ✓ |
| Hayman: h^2/H_2 | 2,05458141 | 2,05458141 | — | 2,2e−16 | ✓ |
| Hayman: dar anlamda kalıtım | 0,70695369 | 0,70695369 | — | 3,3e−16 | ✓ |
| Hayman: geniş anlamda kalıtım | 0,93994903 | 0,93994903 | — | 4,4e−16 | ✓ |
| Çizgi × test: KT Tekrar | 0,51919048 | 0,51919048 | 0,51919048 | 2,2e−13 | ✓ |
| Çizgi × test: KT Giris | 16,10160571 | 16,10160571 | 16,10160571 | 1,2e−14 | ✓ |
| Çizgi × test: KT Ebeveyn | 7,73149091 | 7,73149091 | 7,73149091 | 5,3e−15 | ✓ |
| Çizgi × test: KT EbMel | 0,00508286 | 0,00508286 | 0,00508286 | 8,5e−14 | ✓ |
| Çizgi × test: KT Melez | 8,36503194 | 8,36503194 | 8,36503194 | 1,7e−14 | ✓ |
| Çizgi × test: KT Cizgi | 4,97554306 | 4,97554306 | 4,97554306 | 3,8e−14 | ✓ |
| Çizgi × test: KT Test | 0,64938611 | 0,64938611 | 0,64938611 | 2,0e−13 | ✓ |
| Çizgi × test: KT CxT | 2,74010278 | 2,74010278 | 2,74010278 | 7,7e−14 | ✓ |
| Çizgi × test: KT Hata | 1,80114286 | 1,80114286 | 1,80114286 | 1,3e−13 | ✓ |
| Çizgi × test: F çizgi | 3,63164703 | 3,63164703 | 3,63164703 | 1,1e−13 | ✓ |
| Çizgi × test: F çizgi × test | 7,38923655 | 7,38923655 | 7,38923655 | 7,7e−14 | ✓ |
| Çizgi × test: GCA LT-8 | −0,33791667 | −0,33791667 | −0,33791667 | 5,6e−16 | ✓ |
| Çizgi × test: GCA TPS-25 | 0,41430556 | 0,41430556 | 0,41430556 | 5,6e−17 | ✓ |
| Çizgi × test: SCA LT-8 × TPS-67 | 0,51875 | 0,51875 | — | 2,2e−16 | ✓ |
| Çizgi × test: SH(çizgi GCA) | 0,05424983 | 0,05424983 | 0,05424983 | 3,5e−15 | ✓ |
| Çizgi × test: SH(test GCA) | 0,0332211 | 0,0332211 | 0,0332211 | 2,2e−15 | ✓ |
| Çizgi × test: SH(SCA) | 0,09396346 | 0,09396346 | 0,09396346 | 6,0e−15 | ✓ |
| Çizgi × test: Kov(yarım kardeş, çizgi) | 0,05723003 | 0,05723003 | 0,05723003 | 4,1e−15 | ✓ |
| Çizgi × test: Kov(yarım kardeş, test) | 0,00537381 | 0,00537381 | 0,00537381 | 4,8e−15 | ✓ |
| Çizgi × test: Kov(yarım kardeş, ort.) | 0,0038673 | 0,0038673 | 0,0038673 | 5,5e−16 | ✓ |
| Çizgi × test: Kov(tam kardeş, ort.) | 0,12152609 | 0,12152609 | — | 3,9e−15 | ✓ |
| Çizgi × test: \sigma^2_A (F=0) | 0,01546921 | 0,01546921 | 0,01546921 | 2,0e−15 | ✓ |
| Çizgi × test: \sigma^2_D (F=0) | 0,11282282 | 0,11282282 | 0,11282282 | 8,0e−15 | ✓ |
| Çizgi × test: çizgi katkısı (%) | 59,48026366 | 59,48026366 | 59,48026366 | 2,9e−14 | ✓ |
| Artırılmış: KT muamele (düzeltilmiş) | 285,0952381 | 285,0952381 | 285,0952381 | 1,0e−15 | ✓ |
| Artırılmış: KT kontroller | 52,91666667 | 52,91666667 | — | 1,9e−13 | ✓ |
| Artırılmış: KT blok (düzeltilmiş) | 69,5 | 69,5 | 69,5 | 4,3e−15 | ✓ |
| Artırılmış: KT artırılmışlar | 505,875 | 505,875 | — | 2,0e−15 | ✓ |
| Artırılmış: KT kontrol – artırılmış | 16,875 | 16,875 | — | 0 | ✓ |
| Artırılmış: hata KO | 26,97222222 | 26,97222222 | 26,97222222 | 6,1e−14 | ✓ |
| Artırılmış: F artırılmışlar | 2,67934383 | 2,67934383 | — | 5,9e−14 | ✓ |
| Artırılmış: fark SH (iki kontrol) | 4,2404577 | 4,2404577 | 4,2404577 | 3,1e−14 | ✓ |
| Artırılmış: fark SH (aynı blokta iki artırılmış) | 7,34468818 | 7,34468818 | 7,34468818 | 3,1e−14 | ✓ |
| Artırılmış: fark SH (farklı bloklarda iki artırılmış) | 8,21161102 | 8,21161102 | 8,21161102 | 3,1e−14 | ✓ |
| Artırılmış: fark SH (artırılmış – kontrol) | 6,36068655 | 6,36068655 | 6,36068655 | 3,1e−14 | ✓ |
| Artırılmış: EKF (artırılmış – kontrol) | 15,56403929 | 15,56403929 | — | 3,1e−14 | ✓ |
| Artırılmış: düzeltilmiş ortalama h | 93,5 | 93,5 | 93,5 | 0 | ✓ |
| Artırılmış: düzeltilmiş ortalama g | 73,25 | 73,25 | 73,25 | 0 | ✓ |
| Artırılmış: düzeltilmiş ortalama e | 78,25 | 78,25 | 78,25 | 0 | ✓ |
| Artırılmış: düzeltilmiş ortalama A | 84,66666667 | 84,66666667 | 84,66666667 | 1,2e−15 | ✓ |
| Artırılmış: düzeltilmiş ortalamanın SH'si (artırılmış e) | 5,60959826 | 5,60959826 | 5,60959826 | 3,1e−14 | ✓ |
| Artırılmış: düzeltilmiş ortalamanın SH'si (kontrol A) | 2,99845639 | 2,99845639 | 2,99845639 | 3,0e−14 | ✓ |
| Artırılmış: A − e t | 1,00880096 | 1,00880096 | 1,00880096 | 3,2e−14 | ✓ |
| Artırılmış: A − e p (EKF) | 0,35200722 | 0,35200722 | 0,35200722 | 1,3e−14 | ✓ |
| Latin kare: KT Satir | 68 | 68 | 68 | 1,5e−15 | ✓ |
| Latin kare: KT Sutun | 150 | 150 | 150 | 1,9e−16 | ✓ |
| Latin kare: KT Muamele | 330 | 330 | 330 | 0 | ✓ |
| Latin kare: KT Hata | 128 | 128 | 128 | 0 | ✓ |
| Latin kare: F muamele | 7,734375 | 7,734375 | 7,734375 | 1,3e−15 | ✓ |
| Latin kare: p muamele | 0,0025365 | 0,0025365 | 0,0025365 | 9,3e−17 | ✓ |
| Latin kare: ortalama A | 3,6 | 3,6 | 3,6 | 0 | ✓ |
| Latin kare: SH(ortalama) | 1,46059349 | 1,46059349 | — | 2,0e−15 | ✓ |
| Latin kare: A ortalaması GA alt | 0,41764017 | 0,41764017 | — | 5,6e−12 | ✓ |
| Latin kare: SH(fark) | 2,06559112 | 2,06559112 | — | 6,4e−16 | ✓ |
| Latin kare: Tukey p (A − B) | 0,01108267 | 0,01108267 | 0,01108267 | 4,3e−13 | ✓ |
| Latin kare: Tukey p (A − D) | 0,97543802 | 0,97543802 | 0,97543802 | 3,0e−12 | ✓ |
| Latin kare: Tukey GA üst (A − B) | 14,98393175 | — | 14,98393175 | 0 | ✓ |
Ölçütü karşılayan: 125/125. Python: Griffing'in (1956) kapalı kareler toplamı, etki ve varyans formülleri; Hayman b1–b3 dik izdüşümle, c ve d kapalı biçimle; öteki kipler toplamlardan. R: lmDiallel::lm.diallel (Griffing 1, Griffing 3, Hayman 2), agricolae::DAU.test, emmeans, aov + TukeyHSD; çizgi × test ve W_r/V_r açık formülle.
Yayımlanmış değerlerle de karşılaştırma yapılmıştır: Yöntem 4 (Griffing 1956 mısır verisi) GCA KT 18605,98, F=110{,}487; SCA KT 9164,85, F=16{,}125. Yöntem 2 (Lonnquist ve Gardner 1961) GCA KT 234,23, F=6{,}598; tSCA KT 238,94, F=2{,}244; \hat\sigma^2_g=3{,}8646. Bu değerler Onofri ve ark.'nın (2021) aynı veriler için verdiği sonuçlarla basılı basamaklarda aynıdır.
6.7 Çıktıyı okuma
Örnek ayarın (Model II eklenmiş) konsol metni:
Griffing Yöntem 1 · 8 ebeveyn · hücre başına tekrar r = 2 · 128 gözlem
Not: ebeveynli yöntemlerde (1, 2) Griffing'in KO kestiricileri kullanıldı; kendilemeler
GCA/SCA izdüşümlerinin dikliğini bozduğundan REML kestirimleri farklı olabilir.
Model II: σ²A ve σ²D, kendilenmiş (F = 1) ebeveynler için 2σ²GCA ve σ²SCA'dır; F = 0'da
σ²A = 4σ²GCA, σ²D = 4σ²SCA.
Tablolar (kısaltılmış; tam hassasiyetli değerlerin ilk ondalıkları):
Griffing Yöntem 1 varyans analizi (Model I, gözlem ölçeği)
          kaynak  sd           KT          KO        F         p
            Blok   1     142.3828    142.3828   0.3416  5.61e-01
             GCA   7  277716.7344  39673.8192  95.1805  4.85e-31
            tSCA  28  102238.4453   3651.3730   8.7599  6.66e-13
Karşılıklı (REC)  28   19112.0000    682.5714   1.6375  5.37e-02
            Hata  63   26260.1172    416.8273

Genel uyuşma yeteneği (GCA) etkileri
          etki duzey  kestirim      SH        t  sd         p    GA_alt    GA_ust
Genel ortalama     μ  162.8984  1.8046  90.2701  63  2.38e-68  159.2923  166.5046
           GCA     A   46.1953  3.3760  13.6833  63  1.56e-20   39.4488   52.9418
           GCA     B  -24.5859  3.3760  -7.2825  63  6.42e-10  -31.3324  -17.8395
           GCA     C   49.6328  3.3760  14.7015  63  4.90e-22   42.8863   56.3793
           GCA     G  -44.7109  3.3760 -13.2436  63  7.23e-20  -51.4574  -37.9645

Varyans bileşenleri (Model II, beklenen kareler ortalamasından)
σ²GCA 1125.7014 · σ²SCA 907.9427 · σ²r 66.4360 · σ²e (r) 208.4136
2σ²GCA / (2σ²GCA + σ²SCA) (Baker 1978) 0.7126 · σ²A (F = 1) 2251.4029 · σ²D (F = 1) 907.9427
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Varyans analizi | Blok, GCA, tSCA/SCA, karşılıklı ve hata satırları; F hataya karşı | GCA anlamlıysa eklemeli, SCA anlamlıysa eklemeli olmayan (dominans, epistasi) etkiler vardır. Karşılıklı satırı anaç etkisini sınar. |
| GCA etkileri | \hat\mu ve her ebeveynin \hat g_i'si, SH, t, p, GA | Toplamı sıfırdır. İşaretin "iyi" yönü özelliğe bağlıdır: erken çiçeklenme isteniyorsa negatif GCA (G, H, B, E) tercih edilir. |
| SCA etkileri | Köşegen (\hat s_{ii}) ve köşegen dışı etkiler | Yöntem 1 ve 2'de \hat s_{ii} ebeveynin kendi melezlerinin ortalamasından sapmasıdır; hepsinin aynı işaretli olması yönlü dominansı gösterir. |
| Karşılıklı etkiler | \hat r_{ij} (i<j) | İşaret düzey sırasına bağlıdır (6.3). |
| Etki farklarının SH'leri | Altı fark türü için tek değer | İki GCA'nın farkı \pm t\cdot5{,}104 ile karşılaştırılır. |
| Varyans bileşenleri | \hat\sigma^2_g, \hat\sigma^2_s, \hat\sigma^2_r, M_e, Baker oranı, \sigma^2_A, \sigma^2_D | Baker oranı 1'e yakınsa melez başarısı GCA'dan öngörülebilir. Negatif kestirimde not yazılır. |
| Hayman ANOVA | a, b_1, b_2, b_3, c, d | b_1 ortalama heterosis yönünü, c anaç etkisini sınar. |
| W_r–V_r regresyonu | a, b, SH, b=0 ve b=1 testleri, R^2, ebeveyn değeri ile W_r+V_r korelasyonu | b=1 reddedilmiyorsa model yeterlidir. Korelasyon pozitifse çekinik aleller özelliği artırır. |
| Çizgi × test tabloları | ANOVA, GCA, SCA, SH'ler, kovaryans ve katkı yüzdeleri | Çizgi ve test F'leri etkileşime karşıdır; sd'leri küçüktür. |
| Artırılmış blok tabloları | İki ANOVA, fark SH'leri ve EKF, düzeltilmiş ortalamalar ve SH'leri, ikili testler | Genotip karşılaştırmasında çiftin türüne uyan fark SH'si kullanılır. |
| Latin kare tabloları | ANOVA, ortalamalar ve GA, ikili testler | Satır ve sütun F'leri bloklamanın yararını gösterir. |
Şekil 6.1. Griffing kipinin şekli: solda GCA etkileri (küçükten büyüğe), sağda SCA etkilerinin ısı haritası (örnek veri, Yöntem 1). Köşegen, ebeveynlerin \hat s_{ii} etkileridir.
Şekil 6.2. Hayman kipinin W_r–V_r grafiği: noktalar ebeveyn dizileri, düz çizgi regresyon doğrusu, eğri sınır parabolü W_r^2=V_P V_r (örnek veri).
Rapor cümlesi (örnek ayar ve Hayman kipi):
Sekiz tütün hattının tam dialelinde (Griffing Yöntem 1, sabit model) çiçeklenme zamanı için genel uyuşma yeteneği, F(7,\ 63) = 95{,}18, p < 0{,}001, ve özel uyuşma yeteneği, F(28,\ 63) = 8{,}76, p < 0{,}001, anlamlı bulundu; karşılıklı etkiler anlamlı değildi, F(28,\ 63) = 1{,}64, p = 0{,}054. En yüksek GCA etkileri C (49,63) ve A (46,20), en düşük etki G (−44,71) hatlarındaydı (SH 3,38). W_r–V_r regresyonunun eğimi 1'den farklı değildi (b = 0{,}931, SH 0,087; t(6) = 0{,}79, p = 0{,}461); ortalama dominans derecesi 0,70 ile kısmi dominansı gösterdi; dar anlamda kalıtım derecesi 0,71 olarak kestirildi.
6.8 Sık hatalar ve tuzaklar
- Ortalama verisini dış hatasız çalıştırmak. Her hücrede tek satır varsa kalıntı sd'si kalmaz ve şablon durur (satır 211). Hücre ortalamaları girilmişse, ortalamanın hata kareler ortalaması (bireysel gözlemin KO'su bölü tekrar sayısı) ve sd'si formdan verilir. Griffing (1956) verisi için 21,05 ve 2558; Lonnquist ve Gardner (1961) için 7,10 ve 60.
- Dış hatayı yanlış ölçekte girmek. Şablon dış hatayı verideki satırların ölçeğinde kabul eder ve hücre başına tekrar sayısına böler (satır 281). Satırlar ortalamaysa r=1'dir ve girilen değer olduğu gibi kullanılır; gözlem ölçeğindeki KO girilirse bütün F değerleri tekrar sayısı kadar küçülür.
- Yöntemi otomatiğe bırakıp ebeveynsiz çözümleme beklemek. Veride kendileme satırları varsa otomatik seçim Yöntem 1 ya da 2'dir. Ebeveynsiz çözümleme için Yöntem 3 ya da 4 açıkça seçilir; şablon ebeveyn satırlarını atar ve bunu not eder. Örnek veride Yöntem 3: GCA F=61{,}35, SCA F=4{,}74 (sd 20), hata sd 55.
- Karşılıklı melezleri olan veride Yöntem 2 ya da 4 seçmek. Karşılıklılar aynı hücrede birleşir; köşegen dışı hücreler köşegenin iki katı gözlem taşır. Şablon harmonik ortalama tekrarla yaklaşık SH verir ve not yazar (satır 219).
- Model II'yi seçilmiş ebeveynlere uygulamak. Varyans bileşenleri, ebeveynler bir popülasyonun rastgele örneğiyse anlamlıdır. Islahçının bilerek seçtiği hatlarda Model I (etkiler ve SH'leri) yorumlanır.
- Hayman'ın h^2 bileşenini kalıtım derecesi sanmak. Bileşenler tablosundaki h^2 dominans etkilerinin toplamına ilişkin bir büyüklüktür; kalıtım dereceleri oranlar tablosunun son iki satırındadır.
- W_r–V_r çözümlemesini karşılıklı melezsiz veride aynı katsayılarla yorumlamak. Hata düzeltmesinin katsayıları karşılıklı melezlerin ortalaması alınmış tam tabloya göredir (6.4.5). Yarım dialelde köşegen dışı girdinin hata varyansı E/2 değil E'dir; E küçük değilse bileşenler buna göre yeniden değerlendirilir.
- Çizgi × testte ebeveyn satırlarını yanlış kodlamak. Ebeveyn satırında öteki sütun boş bırakılır: çizgi ebeveyninde test boş, test ebeveyninde çizgi boş. İki sütunu da dolu olan her satır melez sayılır.
- Artırılmış blokta kontrolleri şablonun bulmasına güvenmek. Kontrol alanı boşsa birden çok kez görülen her genotip kontrol sayılır (satır 599). Yanlışlıkla iki kez yazılmış bir yeni genotip kontrol olur ve "her kontrol her blokta tam bir kez" denetimine takılır; kontroller adlarıyla yazılırsa hata iletisi daha açıktır.
- Düzeltilmiş ortalamalar tablosundaki SH ile genotip karşılaştırmak. O sütun tek bir düzeltilmiş ortalamanın hatasıdır: kontrolde \sqrt{\mathrm{KO}_h/b}, artırılmış genotipte \sqrt{\mathrm{KO}_h(1+1/c-1/(bc))}. İki genotipin farkının hatası bu ikisinden türetilemez, çünkü düzeltilmiş ortalamalar aynı blok etkisi kestirimlerini paylaşır; iki genotip, fark SH tablosundaki uygun satırla ya da ikili karşılaştırma tablosuyla karşılaştırılır.
- Kodlanmış veride değişkenlik katsayısına bakmak. DK 100\sqrt{\mathrm{KO}_h}/\lvert\bar y\rvert'dir. Örnek Latin karede yanıt bir sabit çıkarılarak kodlandığından ortalama 0,4'tür ve DK %816,50 çıkar; bu sayı denemenin duyarlığı hakkında bilgi vermez.
- Tam olmayan Latin karede ham ortalamaları kullanmak. Eksik hücre varsa şablon not yazar; muamele kareler toplamı ve ortalamalar satır ve sütuna göre düzeltilmiştir. Tablodaki "ortalama" ham, "EKK_ortalama" düzeltilmiş değerdir.
6.9 Uzman soruları
S1. Griffing ANOVA'sında F testleri neden hep hataya karşı; rastgele modelde payda değişmez mi?
ANOVA tablosu başlığında da yazdığı gibi Model I (sabit) içindir: GCA, SCA ve karşılıklı etki hata kareler ortalamasına bölünür (satır 165, 280). Rastgele modelde (Model II) GCA'nın uygun paydası SCA kareler ortalamasıdır; örnek veride bu oran 39673{,}8/3651{,}4=10{,}87 olur (sd 7 ve 28). Şablon Model II seçildiğinde F tablosunu yeniden kurmaz; varyans bileşenlerini beklenen kareler ortalamalarından verir. Rastgele model testi isteniyorsa oran tablodaki kareler ortalamalarından elle alınır.
S2. Standart hatalar Griffing'in tablolarındaki katsayılarla aynı mı?
Evet. Şablon katsayıları elle yazmak yerine etkilerin hücre ortalamalarına göre Jacobian'ını kurar; bağımsız ve eşit varyanslı hücrelerde bu, varyansın kesin değeridir. Doğrulama tablosunda Yöntem 1'in on bir standart hatası, (p-1)/(2p^2), (p-1)^2/p^2, (p^2-2p+2)/(2p^2) gibi kapalı katsayılardan hesaplanan değerlerle aynıdır; lmDiallel'in model matrisinden hesapladığı değerlerle de eşleşir.
S3. Yöntem 1'de σ²GCA kestirimi neden REML'den farklı çıkabilir?
İki neden vardır. Birincisi, kendilemeler s_{ii} etkilerini tabloya sokar ve E(M_g) ile E(M_s)'te \sigma^2_s'nin katsayıları eşit olmaz (2(p-1)/p ve 2(p^2-p+1)/p^2). (M_g-M_s)/(2p) farkı bu yüzden \sigma^2_g'yi \sigma^2_s/p^3 kadar düşük kestirir: örnek veride 1125{,}70, iki denklemin tam çözümü 1127{,}47. İkincisi, REML bütün kareler ortalamalarındaki bilgiyi ağırlıklı kullanır ve negatif olmama kısıtı koyar. Kendilemesiz Yöntem 3'te dengeli veride bu ayrışma yoktur: \hat\sigma^2_g=927{,}81, \hat\sigma^2_s=367{,}77, \hat\sigma^2_r=72{,}30 (doğrulama tablosu).
S4. Hayman'ın a maddesi ile Griffing'in GCA'sı, b maddesi ile SCA'sı aynı şey mi?
Kareler toplamı olarak evet: a=\mathrm{KT}_{\text{GCA}}=277716{,}73 ve b_1+b_2+b_3=\mathrm{KT}_{\text{tSCA}}=102238{,}45; c+d=\mathrm{KT}_{\text{REC}}=19112. Hayman'ın katkısı, SCA'yı genetik yoruma açılan üç parçaya ayırmasıdır: b_1 ebeveynlerle melezlerin ortalama farkı (1 sd; yönlü dominans), b_2 bu farkın ebeveynden ebeveyne değişimi (alel sıklıklarının eşitsizliği), b_3 belirli melezlere özgü kalan. Örnek veride üçü de anlamlıdır (F=73{,}88; 11{,}70; 4{,}47).
S5. Wr–Vr eğiminin 1 olması testi neden yalnız 6 sd'li ve bu yeterli mi?
Regresyon p=8 nokta üzerindendir; sd p-2=6. Test bu yüzden güçsüzdür: eğimin 1'den farklı bulunmaması modelin doğruluğunu kanıtlamaz. Hayman'ın özgün uygunluk ölçütü W_r-V_r'nin diziler arasında sabit olmasıdır; şablon bu farkı dizi tablosunda verir (örnek veride 735 ile 1968 arasında) ama bloklar üzerinden ayrı bir varyans analizi yapmaz. F ve G dizilerindeki yüksek fark, modelden sapmanın bu iki ebeveynde aranması gerektiğini gösterir.
S6. Tekrar sayıları eşit değilse sonuçlar ne kadar güvenilir?
Kareler toplamları lm ile hesaplandığından doğrudur, ama sıralıdır ve terim sırasına (blok → GCA → SCA → karşılıklı) bağlıdır. Etkiler ağırlıksız hücre ortalamalarından, standart hatalar harmonik ortalama tekrar sayısıyla hesaplanır; bu ikisi yaklaşıktır ve konsol notu bunu söyler (satır 219). Eksik hücre hiç kabul edilmez. Dengesizlik büyükse karma model yaklaşımı gerekir.
S7. Çizgi × testte çizgi ve test etkileri neden etkileşime karşı test ediliyor?
Çizgiler ve testler rastgele örnek sayıldığında çizgi kareler ortalamasının beklenen değeri çizgi × test varyansını da içerir; uygun payda etkileşim kareler ortalamasıdır. Örnek veride F_{\text{çizgi}}=3{,}63 (sd 7 ve 14, p=0{,}019), F_{\text{test}}=1{,}66 (sd 2 ve 14, p=0{,}226). Hataya karşı test edilselerdi oranlar 26{,}8 ve 12{,}3 olurdu. GCA etkilerinin tek tek t testleri ise hata kareler ortalamasına dayanır (satır 530–531); iki sonuç bu yüzden farklı sorulara cevap verir.
S8. Artırılmış blokta hata yalnız 6 sd; bu karşılaştırmalar için yeterli mi?
Hata, 3 blok × 4 kontrol tablosunun etkileşimidir: (3-1)(4-1)=6. Artırılmış genotipler hataya sd vermez, çünkü her biri kendi etkisiyle tam uyulur. t_{0{,}975;\,6}=2{,}447 olduğundan EKF'ler geniştir: artırılmış – kontrol için 15{,}56. Güç, kontrol sayısı ve blok sayısıyla artar; tasarım aşamasında hata sd'sinin en az 10–12 olması hedeflenir.
S9. Latin karede Tukey ile EKF aynı çift için ne kadar ayrışıyor?
Örnek veride A − D farkı -1{,}2, SH 2{,}066, t=-0{,}581: EKF p=0{,}572, Tukey p=0{,}975. A − B farkı 8{,}4, t=4{,}067: Tukey p=0{,}011. Tukey GA çarpanı q_{0{,}95;\,5{,}12}/\sqrt2=3{,}187, EKF çarpanı t_{0{,}975;\,12}=2{,}179'dur. Beş muamelede on karşılaştırma yapıldığından ailece hata oranını koruyan Tukey önerilir; EKF yalnız önceden planlanmış az sayıda karşılaştırma için uygundur.
6.10 Kaynaklar
- Baker, R. J. (1978). Issues in diallel analysis. Crop Science, 18(4), 533–536. https://doi.org/10.2135/cropsci1978.0011183X001800040001x
- de Mendiburu, F. (2023). agricolae: Statistical procedures for agricultural research (R package version 1.3-7). https://doi.org/10.32614/CRAN.package.agricolae
- Federer, W. T. (1956). Augmented (or hoonuiaku) designs. Hawaiian Planters' Record, 55, 191–208.
- Federer, W. T., & Raghavarao, D. (1975). On augmented designs. Biometrics, 31(1), 29–35. https://doi.org/10.2307/2529707
- Griffing, B. (1956). Concept of general and specific combining ability in relation to diallel crossing systems. Australian Journal of Biological Sciences, 9(4), 463–493. https://doi.org/10.1071/BI9560463
- Hayman, B. I. (1954a). The analysis of variance of diallel tables. Biometrics, 10(2), 235–244. https://doi.org/10.2307/3001877
- Hayman, B. I. (1954b). The theory and analysis of diallel crosses. Genetics, 39(6), 789–809. https://doi.org/10.1093/genetics/39.6.789
- Kempthorne, O. (1957). An introduction to genetic statistics. John Wiley & Sons.
- Lonnquist, J. H., & Gardner, C. O. (1961). Heterosis in intervarietal crosses in maize and its implication in breeding procedures. Crop Science, 1(3), 179–183. https://doi.org/10.2135/cropsci1961.0011183X000100030007x
- Montgomery, D. C. (2017). Design and analysis of experiments (9th ed.). John Wiley & Sons.
- Onofri, A., Terzaroli, N., & Russi, L. (2021). Linear models for diallel crosses: A review with R functions. Theoretical and Applied Genetics, 134(2), 585–601. https://doi.org/10.1007/s00122-020-03716-8
- R Core Team. (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Singh, R. K., & Chaudhary, B. D. (1985). Biometrical methods in quantitative genetic analysis. Kalyani Publishers.