24. Doğrusal olmayan karma model (nlme)
Şablon kimliği: nlme_karma · Kategori: karma model · Dil: R · Dosya: pro/sablonlar/karma_model/nlme_karma.R (satır 1–261; üstbilgi 1–148) · Örnek veri: _ornek/orange.csv · Paketler: nlme 3.1-168; Laplace motorunda lme4 2.0-6
24.1 Ne işe yarar
Şablon, her bireyin (ağaç, hayvan, hasta, parsel) zaman ya da doz boyunca doğrusal olmayan bir eğri izlediği tekrarlı ölçümlü verilerde eğrinin parametrelerini kestirir ve bu parametrelerin bireyler arasında ne kadar değiştiğini rastgele etkilerle ölçer. Cevapladığı soru şudur: "Popülasyonun tipik eğrisi nedir ve bireylerin eğrileri bu tipik eğriden hangi parametrede, ne kadar ayrılıyor?"
- y_{ij}: i. bireyin j. ölçümü; x_{ij}: açıklayıcı değişken (yaş, zaman, doz).
- f: seçilen eğri (lojistik, Gompertz, asimptotik üstel, Michaelis–Menten); \boldsymbol\phi_i: bireyin parametreleri.
- \boldsymbol\beta: sabit etkiler (popülasyon parametreleri). \mathbf b_i: rastgele etkiler; \mathbf B, hangi parametrelerin rastgele etki aldığını seçen 0–1 matrisidir.
- \boldsymbol\Psi: rastgele etkilerin kovaryansı (köşegen ya da genel); \sigma^2: artık varyans.
Örnek ayardaki model, üç parametreli lojistik eğride yalnız asimptota rastgele etki verir:
Ne zaman kullanılır? Aynı bireyden çok sayıda ölçüm varsa ve yanıt, parametreleri yorumlanabilen doğrusal olmayan bir eğri izliyorsa (büyüme, farmakokinetik, enzim kinetiği, doz-yanıt); ilgi hem tipik eğride hem bireyler arası değişkenliktedir (Davidian ve Giltinan, 2003).
Ne zaman kullanılmaz?
- Tek bir eğri varsa (gruplama yok) ya da kendi formülünüzle bir model uyduracaksanız: temel programdaki Doğrusal Olmayan Regresyon.
- Tek eğride dört parametreli log-lojistik doz-yanıt, EC50 ve etkin dozlar isteniyorsa:
dort_parametreli_lojistikşablonu. - Yanıt açıklayıcı değişkenle doğrusal ilişkiliyse ya da dönüşümle doğrusallaşıyorsa: temel programdaki LMM (Doğrusal Karma Modeller).
- Hazır beş eğriden başka bir model, açıklayıcı değişkenli parametreler (ör. tedaviye göre farklı asimptot) ya da normal olmayan yanıt gerekiyorsa: şablon kodu düzenlenir ya da
ozel_olabilirlikşablonu kullanılır. - Grup sayısı 3'ten azsa şablon çalışmaz; 5–6 grupla varyans bileşenleri çok belirsizdir.
Temel programla ilişki. Temel programdaki Doğrusal Olmayan Regresyon bütün gözlemleri bağımsız sayar ve tek bir parametre kümesi kestirir. Bu şablon aynı eğriyi, parametreleri bireyden bireye değişen bir karma modelin içinde kestirir; başlangıç değerleri için o "havuzlanmış" uyumu kendisi yapar.
24.2 Şablonun girdileri
Form, üstbilgideki 18 [[param]] bloğundan kurulur (nlme_karma.R:10–147).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal | y (155). |
Açıklayıcı değişken (zaman, doz) · x |
sayısal sütun · Değişkenler | — | sayısal | x (155). |
Gruplama faktörü (birey) · grup |
kategorik sütun · Değişkenler | — | herhangi bir sütun | Rastgele etkinin düzeyi (158). |
Model · model |
seçim · Model | lojistik3 |
lojistik3, lojistik4, gompertz, asimptotik, michaelis |
Eğri ve parametre adları (166–171). |
Rastgele etkili parametreler (virgülle; boşsa ilk parametre) · rastgele |
metin · Model | boş | modelin parametre adları | Rastgele etki alan parametreler (172–177). |
Kestirim motoru · motor |
seçim · Model | nlme |
nlme, nlmer |
Lindstrom–Bates (183–199) ya da Laplace (200–217). |
Kestirim yöntemi · yontem |
seçim · Model | ML |
ML, REML |
nlme(method = …) (188); Laplace motorunda yalnız ML (181). Form açıklaması nlme'de REML'in sabit etkileri değiştirmediğini, varyansları N/(N-p) ile ölçeklediğini söyler (51; 24.4.4). |
Rastgele etki kovaryans yapısı · re_kov |
seçim · Model | pdDiag |
pdDiag, pdSymm |
Köşegen ya da genel \boldsymbol\Psi (187, 202). |
Sabit etki güven aralıkları tablosu · guven_araliklari |
onay · Çıktı | kapalı | açık / kapalı | Ek tablo: kestirim ± t × SH, sabit etkiler tablosundaki SH ile (219–228). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | Güven aralıkları tablosunun düzeyi (220–221). |
Optimizasyon algoritması · optimizer |
seçim · Gelişmiş | nlminb |
nlminb, nlm |
nlmeControl(opt = …) (191); Laplace motorunda kullanılmaz. |
En çok dış yineleme · maks_yineleme |
tamsayı · Gelişmiş | 200 | 5–10 000 | maxIter (189). |
En çok optimizasyon yinelemesi · maks_ic_yineleme |
tamsayı · Gelişmiş | 10 000 | 5–100 000 | msMaxIter (189); Laplace: maxfun (205). |
Yakınsama toleransı · tolerans |
ondalık · Gelişmiş | 0,00001 | 10^{-12}–0,01 | tolerance (190); Laplace: FtolAbs (205); Laplace motorunda sonucu çoğunlukla değiştirmez. |
Optimizasyon toleransı · ic_tolerans |
ondalık · Gelişmiş | 0,0000001 | 10^{-12}–0,01 | msTol (191); Laplace: FtolRel (206); Laplace motorunda sonucu çoğunlukla değiştirmez. |
Başlangıç EM yinelemesi · em_yineleme |
tamsayı · Gelişmiş | 25 | 0–1000 | niterEM (191). |
En çok PNLS yinelemesi · pnls_yineleme |
tamsayı · Gelişmiş | 20 | 1–1000 | pnlsMaxIter (190). |
PNLS toleransı · pnls_tol |
ondalık · Gelişmiş | 0,001 | 10^{-10}–0,5 | pnlsTol (190). |
Örnek ayar (satır 9): y = circumference, x = age, grup = Tree, model = lojistik3, rastgele = Asym.
Hazır eğriler ve parametreleri (R'nin kendiliğinden başlangıç değeri üreten model işlevleri):
model |
Eğri f(x) | Parametreler |
|---|---|---|
lojistik3 |
\dfrac{\text{Asym}}{1+e^{(\text{xmid}-x)/\text{scal}}} | Asym: üst asimptot; xmid: yarı yüksekliğe ulaşılan x; scal: ölçek |
lojistik4 |
A+\dfrac{B-A}{1+e^{(\text{xmid}-x)/\text{scal}}} | A, B: alt ve üst asimptot; xmid; scal |
gompertz |
\text{Asym}\cdot\exp(-b_2\,b_3^{\,x}) | Asym; b2: x=0'daki konum; b3: büyüme oranı (0<b_3<1) |
asimptotik |
\text{Asym}+(R_0-\text{Asym})\,e^{-e^{\text{lrc}}x} | Asym; R0: x=0'daki yanıt; lrc: hız sabitinin doğal logaritması |
michaelis |
\dfrac{V_m\,x}{K+x} | Vm: en büyük hız; K: yarı doygunluk sabiti |
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 152 |
| Yanıt ve açıklayıcı aynı sütun | "farklı olmalı" | 153 |
| Gruplama sütunu yanıt ya da açıklayıcı | "yanıt ya da açıklayıcı değişken olamaz" | 154 |
| Yanıt ya da açıklayıcı sayısal değil | "sayısal olmalı" | 157 |
| Eksiksiz satır < 10 | "Eksiksiz en az 10 satır gerekli." | 160 |
| Grup düzeyi < 3 | "en az 3 düzey içermeli" | 161 |
| Yanıt ya da açıklayıcı sabit | "sabit" | 162 |
| Açıklayıcının farklı değeri < 4 | "en az 4 farklı değer almalı" | 163 |
| Rastgele listesinde modelde olmayan ad | "Bilinmeyen parametre: … Bu modelin parametreleri: …" | 175–177 |
| Havuzlanmış başlangıç uyumu başarısız | "Havuzlanmış nls uyumu … başarısız: …" | 178–179 |
| Laplace motoru + REML | "yalnız ML kestirimi yapar" | 181 |
| Kestirim hata verdi | "Model yakınsamadı: …" | 192, 207 |
Eksik değer: üç sütundan herhangi biri eksik olan satır atılır (156). Laplace motorunun uyarıları toplanıp "Kestirim uyarıları:" satırında yazılır (208, 242).
24.3 Örnek veri
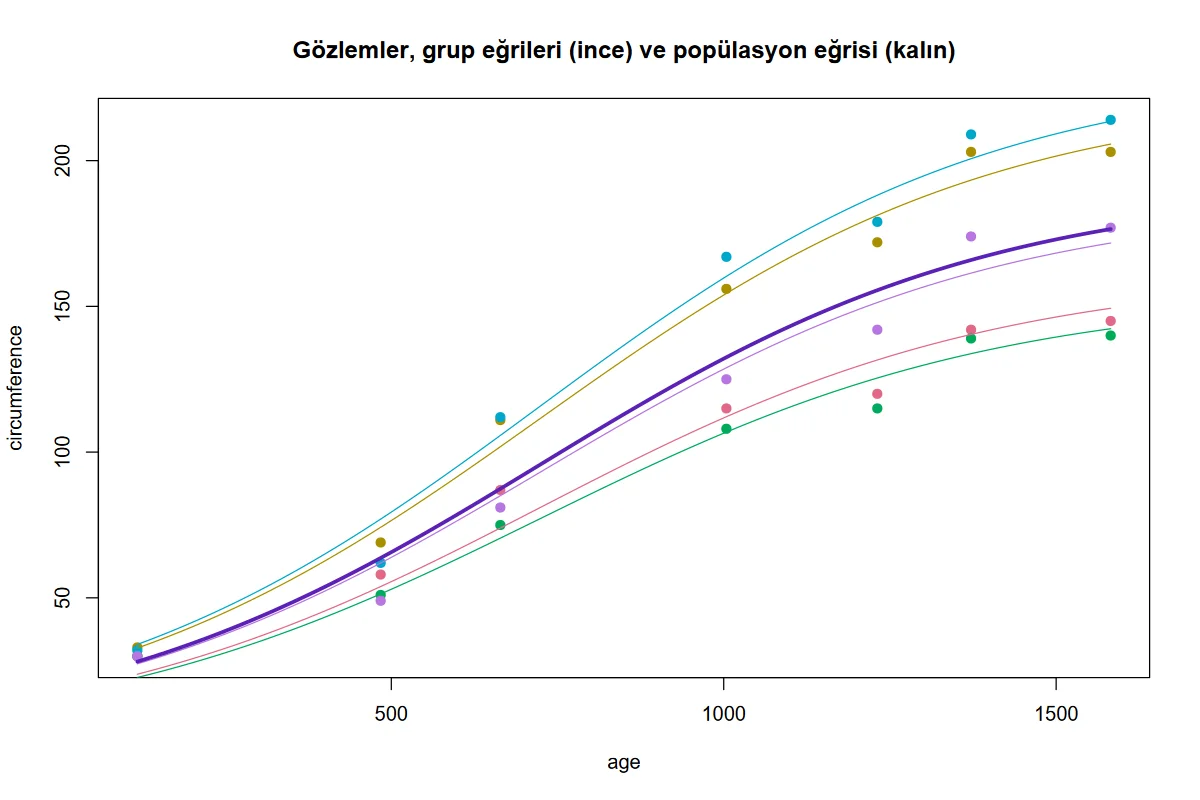
Dosya: _ornek/orange.csv: beş portakal ağacının yedi yaşta ölçülen gövde çevresi (Draper ve Smith, 1998; Pinheiro ve Bates, 2000). 35 satır, eksik değer yok, tasarım dengeli.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
Tree |
Gruplama | kategorik | 5 düzey; arayüz sırası T1, T2, T3, T4, T5. |
age |
Açıklayıcı | sayısal | Gün: 118, 484, 664, 1004, 1231, 1372, 1582. |
circumference |
Yanıt | sayısal | Gövde çevresi (mm): 30–214. |
| Yaş (gün) | 118 | 484 | 664 | 1004 | 1231 | 1372 | 1582 |
|---|---|---|---|---|---|---|---|
| T1 | 30 | 58 | 87 | 115 | 120 | 142 | 145 |
| T2 | 33 | 69 | 111 | 156 | 172 | 203 | 203 |
| T3 | 30 | 51 | 75 | 108 | 115 | 139 | 140 |
| T4 | 32 | 62 | 112 | 167 | 179 | 209 | 214 |
| T5 | 30 | 49 | 81 | 125 | 142 | 174 | 177 |
Ağaçlar aynı noktadan (yaklaşık 30 mm) başlar ve zamanla açılır: farkın asimptotta toplandığı gözle görülür; rastgele etkinin yalnız Asym'e verilmesinin gerekçesi budur. Grup düzeylerinin sırası kestirimi etkilemez; yalnız grafikteki renk sırasını belirler.
Çalıştırmalar: (1) örnek ayar; (2) örnek ayar + sıkı toleranslar (tolerans = 1e-10, ic_tolerans = 1e-12, pnls_tol = 1e-9, pnls_yineleme = 200) + güven aralıkları tablosu; (3) aynı sıkı toleranslarla REML; (4) Laplace motoru (motor = nlmer) + güven aralıkları; (5) iki rastgele parametre (rastgele = Asym, xmid, genel kovaryans).
24.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) havuzlanmış doğrusal olmayan en küçük karelerle başlangıç değerleri; (2) seçilen motorla karma modelin kestirimi; (3) sabit etkiler tablosu (kestirim, SH, sd ya da z, p); (4) istenirse güven aralıkları; (5) varyans bileşenleri; (6) logLik, AIC, BIC; (7) gözlemler, birey eğrileri ve popülasyon eğrisi.
24.4.1 Başlangıç: havuzlanmış uyum
- Gruplama yok sayılır; bütün gözlemlere tek eğri uydurulur (
stats::nls; satır 178). - Model işlevleri (
SSlogis,SSfpl,SSgompertz,SSasymp,SSmicmen) kendi başlangıç değerlerini veriden üretir; kullanıcı başlangıç değeri girmez.
Neden havuzlanmış uyum?
Karma modelin kestirimi yinelemelidir ve iyi bir başlangıca gereksinir. Bireyler aynı eğri ailesini izlediğinden, hepsine uydurulan tek eğri popülasyon parametrelerine yakındır. Bu adım başarısızsa (model veriye uymuyorsa) karma model de kurulamaz; şablon o durumda açık bir iletiyle durur.
24.4.2 nlme motoru: Lindstrom–Bates dönüşümlü algoritması
Rastgele etkiler modele doğrusal olmayan biçimde girdiğinde marjinal olabilirlik kapalı biçimli değildir. Lindstrom ve Bates (1990) iki adımı yakınsayana dek dönüşümlü uygular.
Cezalı doğrusal olmayan en küçük kareler (PNLS) adımı. Varyans parametreleri sabitken \boldsymbol\beta ve \mathbf b_i birlikte kestirilir:
Doğrusal karma model (LME) adımı. Model, bulunan noktada birinci derece Taylor açılımıyla doğrusallaştırılır ve çalışma yanıtına doğrusal karma model uydurularak varyans parametreleri güncellenir:
- \hat{\mathbf X}_i=\partial\mathbf f_i/\partial\boldsymbol\beta^{\top}, \hat{\mathbf Z}_i=\partial\mathbf f_i/\partial\mathbf b_i^{\top}: (\hat{\boldsymbol\beta},\hat{\mathbf b}_i) noktasındaki türev matrisleri.
- Tek rastgele etkide ceza \lambda\sum_ib_i^2 biçimindedir; \lambda=\sigma^2/\sigma_b^2.
- Örnek modelde \mathbf f_i=(\text{Asym}+b_i)\,\mathbf g_i, \mathbf g_i=\big[1+e^{(\text{xmid}-x_{ij})/\text{scal}}\big]^{-1}: \hat{\mathbf Z}_i=\mathbf g_i ve \hat{\mathbf X}_i=\big[\mathbf g_i,\ (\text{Asym}+\hat b_i)\,\partial\mathbf g_i/\partial\text{xmid},\ (\text{Asym}+\hat b_i)\,\partial\mathbf g_i/\partial\text{scal}\big].
LME adımında \lambda için profil log-olabilirlik en büyük yapılır:
- \hat{\mathbf r}_i=\hat{\mathbf w}_i-\hat{\mathbf X}_i\hat{\boldsymbol\beta}_{\text{GEKK}}(\lambda): genelleştirilmiş en küçük kareler artığı; N: toplam gözlem sayısı.
- Yakınsamada bildirilen logLik, bu doğrusallaştırılmış modelin log-olabilirliğidir.
Neden doğrusallaştırma ve bunun bedeli ne?
Doğrusal karma modelin olabilirliği kapalı biçimlidir; doğrusallaştırma, doğrusal olmayan sorunu bir dizi doğrusal soruna çevirir ve hızlıdır. Bedeli: PNLS adımı \boldsymbol\beta'yı cezalı artık kareler toplamından kestirir ve olabilirlikteki \ln\lvert\mathbf V_i\rvert teriminin \boldsymbol\beta'ya bağlılığını hesaba katmaz. Bu yüzden algoritmanın sabit noktası marjinal olabilirliğin tam en büyüğü değildir. Örnek veride sabit noktadaki kesin log-olabilirlik −131,5846, tam en büyük −131,5719'dur; Asym %0,5, xmid %0,7, scal %1,1 farklıdır (24.6).
Koddaki tercih
nlme(model, fixed = Asym + xmid + scal ~ 1, random = list(g = pdDiag(Asym ~ 1)), start = …, method = …, control = nlmeControl(…)) (satır 187–191). Rastgele etki yapısı köşegen (pdDiag) ya da genel (pdSymm) seçilir. Şablonun denetim değerlerinden dördü paket varsayılanından farklıdır: dış yineleme sınırı 200 (pakette 50), optimizasyon yinelemesi 10 000 (pakette 50), PNLS yinelemesi 20 (pakette 7), optimizasyon toleransı 10^{-7} (pakette 10^{-6}). Yakınsama toleransı (10^{-5}) ve PNLS toleransı (10^{-3}) paket varsayılanıdır.
24.4.3 Standart hata, serbestlik derecesi, t ve p
- p: sabit etki sayısı; M: grup sayısı. Örnek veride \nu=35-5-2=28.
- \sqrt{N/(N-p)}: ML'de artık standart sapmayı serbestlik derecesine göre düzelten çarpan; yalnız sabit etkiler tablosundaki SH'ye uygulanır (nlme'nin
summaryyöntemi). REML'de çarpan yoktur. - p_j=2\,P(T_\nu>\lvert t_j\rvert).
Neden N/(N − p) düzeltmesi?
ML, \sigma^2'yi N'ye bölerek kestirir ve p parametrenin kestirilmesinin tükettiği bilgiyi saymaz; standart hatalar bu yüzden küçük çıkar. Çarpan, \sigma^2'yi N-p bölenli kestirime çevirir. Örnek veride \sqrt{35/32}=1{,}0458: Asym'in SH'si 15,446'dan 16,154'e çıkar.
Güven aralıkları neden sabit etkiler tablosundaki standart hatayla kurulur?
"Sabit etki güven aralıkları tablosu" sabit etkiler tablosundaki kestirim, SH ve serbestlik derecesinden kurulur (satır 220–222): \hat\beta_j\pm t_{1-\alpha/2,\nu}\operatorname{SH}(\hat\beta_j). Böylece aynı çıktıda p değeri ile aralık aynı standart hataya dayanır: aralık sıfırı dışlıyorsa p<\alpha'dır. ML ile kestirilen modelde bu SH, \sqrt{N/(N-p)} ile çarpılmış olandır; şablon tablonun altına çarpanı yazan bir not ekler: "ML'de sabit etkiler tablosundaki SH √(N/(N − p)) = 1,04583 ile çarpılmıştır (nlme özet tanımı); güven aralıkları bu SH ile kurulur. Çarpansız SH = SH / çarpan." (satır 225–228). Örnek veride Asym için 191{,}05\pm2{,}0484\cdot16{,}154=[157{,}96;\ 224{,}14]. nlme paketinin intervals yöntemi ML'de çarpansız standart hatayı kullanır ve aynı model için [159,41; 222,69] verir; başka bir yazılımın ML aralığıyla karşılaştırma yapılacaksa nottaki çarpanla çarpansız SH elde edilir. REML'de çarpan yoktur ve iki hesap aynıdır.
24.4.4 REML seçeneği
nlme motorunda "REML" seçildiğinde, bu bölümde denenen bütün tek rastgele etkili modellerde (lojistik, Gompertz, Michaelis–Menten) sabit etkiler ML sonucuyla aynı kalır; varyans bileşenleri ML kestirimlerinin N/(N-p) katıdır (şablon REML seçildiğinde çıktıya bunu söyleyen bir not ekler, satır 230–232; aynı açıklama formda "Kestirim yöntemi" alanının altında da yer alır):
- Oran \lambda=\sigma^2/\sigma_b^2 ML ile aynıdır; yalnız ölçek değişir. Sabit etkilerin SH'leri de ML tablosundaki (düzeltilmiş) SH'lerle aynıdır.
- Bildirilen logLik, kısıtlı olabilirlik ölçütünün bu noktadaki değeridir: \ell_R=-\tfrac{N-p}{2}\ln(2\pi\hat\sigma^2_{\text{REML}})-\tfrac12\sum_i\ln\lvert\mathbf V_i\rvert-\tfrac12\ln\big\lvert\sum_i\hat{\mathbf X}_i^{\top}\mathbf V_i^{-1}\hat{\mathbf X}_i\big\rvert-\tfrac{N-p}{2}.
- BIC'de örneklem büyüklüğü N-p alınır.
Bu, doğrusallaştırılmış modelin REML eniyisi değildir
Doğrusallaştırılmış modelde kısıtlı olabilirlik \lambda'ya göre ayrıca en büyük yapılır ve dönüşümlü algoritma onunla yinelenirse farklı bir sabit noktaya ulaşılır: örnek veride \lambda=0{,}0529 (ML'de 0,0621), Asym 191,19, \sigma_b^2=1245{,}6, \sigma^2=65{,}94. Şablonun REML çıktısı ise Asym 191,05, \sigma_b^2=1084{,}1, \sigma^2=67{,}34'tür. İki tanım arasındaki fark en çok rastgele etki varyansında görülür. Doğrusal olmayan karma modelde REML'in kendisi bir yaklaşıklıktır (Pinheiro ve Bates, 2000); model karşılaştırması ve raporlama için ML önerilir.
24.4.5 Laplace motoru (nlmer)
motor = nlmer seçilirse marjinal olabilirlik Laplace yaklaşımıyla hesaplanır ve doğrudan en büyük yapılır:
- İntegrand, \mathbf b'ye göre en büyüğü çevresinde ikinci derece açılımla (normal yoğunlukla) yaklaşık hesaplanır (Wolfinger, 1993; Pinheiro ve Bates, 1995).
- Rastgele etki modele doğrusal giriyorsa (örnek ayarda olduğu gibi: (\text{Asym}+b_i)\,g) integrand zaten normaldir ve Laplace yaklaşımı kesindir: \mathbf y_i\sim N\big(\text{Asym}\,\mathbf g_i,\ \sigma^2\mathbf I+\sigma_b^2\,\mathbf g_i\mathbf g_i^{\top}\big).
- Standart hatalar \hat\sigma^2\big(\sum_i\hat{\mathbf X}_i^{\top}\mathbf V_i^{-1}\hat{\mathbf X}_i\big)^{-1}'den, düzeltme çarpanı olmadan; test istatistiği z=\hat\beta/\operatorname{SH}, p standart normalden (satır 212); güven aralığı \hat\beta\pm z_{1-\alpha/2}\operatorname{SH} (220).
Koddaki tercih
nlmer(y ~ SSlogis(x, Asym, xmid, scal) ~ (Asym | g), start = …, control = nlmerControl(optCtrl = list(maxfun, FtolAbs, FtolRel))) (satır 202–206). Birden çok rastgele parametrede köşegen yapı ayrı terimlerle ((Asym | g) + (xmid | g)), genel yapı tek terimle ((Asym + xmid | g)) kurulur. Eniyileme Nelder–Mead'dir; "Optimizasyon algoritması", "En çok dış yineleme", "Başlangıç EM yinelemesi" ve PNLS alanları bu motorda kullanılmaz.
24.4.6 Uyum ölçüleri
- k: sabit etkiler + kovaryans parametreleri + 1 (örnek ayarda 3+1+1=5).
- N^{*}=N (ML); nlme motorunda REML seçilmişse N-p.
24.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–148 | Üstbilgi: açıklama, örnek veri ve ayar, 18 parametre. | Form ve varsayılanlar (Bölüm 1.2). |
| 149–164 | Paket; denetimler; d veri çerçevesi (y, x, g); gruba ve x'e göre sıralama. |
Yanıt ve açıklayıcı mq_sayisal ile, Veri sekmesindeki türünden bağımsız olarak değerleriyle okunur; sayı olmayan değer çalıştırmayı durdurur (155). |
| 166–177 | Model tanımı; rastgele parametre listesinin ayrıştırılması ve denetimi. | Adlar büyük-küçük harfe duyarlıdır; boş liste = ilk parametre. |
| 178–181 | Havuzlanmış nls ile başlangıç; motor ve yöntem uyumu. |
Başlangıç başarısızsa hata. |
| 183–199 | nlme motoru: formüller, nlme çağrısı, özet, sabit etkiler tablosu, varyanslar. |
do.call formülleri değer olarak saklar; predict yeniden değerlendirebilir (186). |
| 200–217 | Laplace motoru: üç parçalı formül, nlmer, özet, z ve p, varyanslar. |
Uyarılar toplanır (208). |
| 218–235 | Sabit etkiler tablosu; güven aralıkları (kestirim ± çeyrek × tablodaki SH; 220–224) ve ML'de SH'nin çarpanını söyleyen not (225–228); REML notu (230–232); varyans bileşenleri tablosu. | Genel kovaryans seçilse de tabloya yalnız varyanslar yazılır; korelasyon metin çıktısındadır. |
| 236–242 | Model uyumu tablosu (n, grup sayısı, logLik, AIC, BIC, yöntem). | Değerler altı ondalığa yuvarlanmış metindir. |
| 244–261 | Grafik: gözlemler, birey eğrileri, popülasyon eğrisi. | Laplace motorunda birey eğrileri yalnız gözlem noktalarını birleştirir (255–256). |
24.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/nlme_karma/elle_hesap.py ile hesaplanmıştır. Betik R'yi, nlme'yi ve lme4'ü kullanmaz: Lindstrom–Bates sabit noktasını, kendi Gauss–Newton adımıyla cezalı en küçük kareler ile doğrusallaştırılmış modelde profil olabilirliğin tek değişkenli eniyilemesini dönüşümlü uygulayarak bulur; Laplace motoru için kesin marjinal olabilirliği doğrudan en büyük yapar. R tarafında (r_dogrulama.R) aynı sabit nokta, doğrusal adım nlme::lme ile çözülerek; kesin olabilirlik optim ve nlminb ile bulunmuştur. nlme() ve nlmer() çağrılmamıştır.
Adım 1 — Havuzlanmış başlangıç. \boldsymbol\beta^{(0)}=(\text{Asym};\ \text{xmid};\ \text{scal})=(192{,}6876;\ 728{,}7564;\ 353{,}5337).
Adım 2 — Dönüşümlü yinelemeler. \lambda=1 ile başlanır; her satır bir PNLS + LME çiftidir:
| Yineleme | Asym | xmid | scal | \lambda |
|---|---|---|---|---|
| 1 | 184,860760 | 688,615991 | 319,621847 | 0,06330102 |
| 2 | 191,031631 | 722,462364 | 344,095413 | 0,06211310 |
| 3 | 191,049004 | 722,555997 | 344,162394 | 0,06211332 |
| 4 | 191,049001 | 722,555980 | 344,162382 | 0,06211332 |
Adım 3 — Rastgele etkiler ve varyanslar. Sabit noktada \hat b=(-29{,}404;\ 31{,}565;\ -37{,}000;\ 40{,}018;\ -5{,}179) (T1–T5); \hat\lambda=0{,}0621133.
Adım 4 — Standart hatalar ve t. \sqrt{\operatorname{diag}\widehat{\operatorname{Var}}(\hat{\boldsymbol\beta})}=(15{,}446207;\ 33{,}610615;\ 25{,}957868); ML çarpanı \sqrt{35/32}=1{,}045825:
Adım 5 — Uyum. \ell=-131{,}584579; \mathrm{AIC}=263{,}169158+10=273{,}169158; \mathrm{BIC}=263{,}169158+5\ln35=280{,}945899.
Adım 6 — Güven aralığı. t_{0{,}975;\,28}=2{,}048407. Tablodaki SH ile Asym: 191{,}049001\pm2{,}048407\cdot16{,}154030=[157{,}958973;\ 224{,}139029] (çarpansız SH 15,446207 ile aralık [159,408881; 222,689121] olurdu).
Adım 7 — REML seçeneği. N/(N-p)=35/32=1{,}09375: \hat\sigma^2=61{,}563709\cdot1{,}09375=67{,}335307, \hat\sigma_b^2=991{,}151486\cdot1{,}09375=1084{,}071937; sabit etkiler ve SH'ler Adım 2 ve 4'teki değerlerdir. Kısıtlı ölçüt bu noktada \ell_R=-119{,}757453; \mathrm{BIC}=239{,}514905+5\ln32=256{,}843585.
Adım 8 — Kesin marjinal olabilirlik (Laplace motorunun başvurusu). \mathbf y_i\sim N(\text{Asym}\,\mathbf g_i,\ \sigma^2\mathbf I+\sigma_b^2\mathbf g_i\mathbf g_i^{\top}) olabilirliği beş parametreye göre doğrudan en büyük yapılır:
| Asym | xmid | scal | \sigma_b^2 | \sigma^2 | \ell | |
|---|---|---|---|---|---|---|
| Kesin en büyük (bağımsız) | 192,053149 | 727,906328 | 348,073047 | 1001,488392 | 61,512836 | −131,571885 |
| Şablon, Laplace motoru | 192,052792 | 727,904473 | 348,072134 | 1001,489802 | 61,512791 | −131,571877 |
| Şablon, nlme motoru (ML, sıkı) | 191,049001 | 722,555980 | 344,162382 | 991,151450 | 61,563710 | −131,584579 |
Lindstrom–Bates sabit noktasında kesin log-olabilirlik de -131{,}584579'dur (rastgele etki doğrusal girdiği için doğrusallaştırılmış ve kesin olabilirlik o noktada çakışır); tam en büyüğün 0,0127 altındadır. Yani nlme motorunun bu modeldeki farkı, olabilirliğin yaklaşık hesaplanmasından değil, sabit etkilerin cezalı en küçük karelerle kestirilmesinden gelir.
24.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından alınmıştır (çalıştırmalar 1–4). nlme motorunun varyans bileşenleri tabloya sekiz anlamlı basamakla, uyum ölçüleri altı ondalıkla yazılır.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| nlme ML (sıkı): Asym | 191,04900087 | 191,04900086 | 191,04900082 | 2,7e−10 | ✓ |
| nlme ML (sıkı): xmid | 722,55597988 | 722,55597988 | 722,55597977 | 1,5e−10 | ✓ |
| nlme ML (sıkı): scal | 344,16238205 | 344,16238195 | 344,16238165 | 1,2e−9 | ✓ |
| nlme ML (sıkı): SH(Asym) | 16,15402941 | 16,15402966 | 16,15402956 | 1,5e−8 | ✓ |
| nlme ML (sıkı): SH(xmid) | 35,15082315 | 35,15082303 | 35,15082301 | 4,0e−9 | ✓ |
| nlme ML (sıkı): SH(scal) | 27,1473879 | 27,14738781 | 27,14738781 | 3,5e−9 | ✓ |
| nlme ML (sıkı): sd | 28 | 28 | — | 0 | ✓ |
| nlme ML (sıkı): t(Asym) | 11,82670874 | 11,82670856 | 11,82670863 | 1,5e−8 | ✓ |
| nlme ML (sıkı): p(scal) | 4,032937·10−13 | 4,032936·10−13 | — | 3,1e−20 | ✓ |
| nlme ML (sıkı): \sigma_b^2 | 991,15145 | 991,15148563 | 991,15147 | 3,6e−8 | ✓ |
| nlme ML (sıkı): \sigma^2 | 61,56371 | 61,56370908 | 61,56370923 | 1,5e−8 | ✓ |
| nlme ML (sıkı): logLik | −131,584579 | −131,58457911 | −131,58457911 | 8,2e−10 | ✓ |
| nlme ML (sıkı): AIC | 273,169158 | 273,16915821 | 273,16915822 | 7,9e−10 | ✓ |
| nlme ML (sıkı): BIC | 280,945899 | 280,94589852 | 280,94589852 | 1,7e−9 | ✓ |
| nlme ML (sıkı): Asym %95 GA alt | 157,95897165 | 157,95897114 | — | 3,3e−9 | ✓ |
| nlme ML (sıkı): Asym %95 GA üst | 224,13903008 | 224,13903058 | — | 2,2e−9 | ✓ |
| nlme ML (sıkı): scal %95 GA alt | 288,55347879 | 288,55347888 | — | 3,3e−10 | ✓ |
| nlme ML (örnek ayar): Asym | 191,04993173 | 191,04900086 | 191,04900082 | 4,9e−6 | ✗ |
| nlme ML (örnek ayar): xmid | 722,55897573 | 722,55597988 | 722,55597977 | 4,1e−6 | ✗ |
| nlme ML (örnek ayar): scal | 344,1680981 | 344,16238195 | 344,16238165 | 1,7e−5 | ✗ |
| nlme ML (örnek ayar): \sigma_b^2 | 991,15123 | 991,15148563 | 991,15147 | 2,6e−7 | ✓ |
| nlme ML (örnek ayar): \sigma^2 | 61,56371 | 61,56370908 | 61,56370923 | 1,5e−8 | ✓ |
| nlme ML (örnek ayar): logLik | −131,584556 | −131,58457911 | −131,58457911 | 1,8e−7 | ✓ |
| nlme ML (örnek ayar): AIC | 273,169112 | 273,16915821 | 273,16915822 | 1,7e−7 | ✓ |
| nlme REML: Asym | 191,04900087 | 191,04900086 | 191,04900082 | 2,7e−10 | ✓ |
| nlme REML: SH(Asym) | 16,15402941 | 16,15402966 | 16,15402956 | 1,5e−8 | ✓ |
| nlme REML: \sigma_b^2 | 1084,0719 | 1084,07193741 | 1084,07192031 | 3,5e−8 | ✓ |
| nlme REML: \sigma^2 | 67,33531 | 67,33530681 | 67,33530698 | 4,7e−8 | ✓ |
| nlme REML: logLik | −119,757453 | −119,75745274 | — | 2,2e−9 | ✓ |
| nlme REML: BIC | 256,843585 | 256,84358499 | — | 4,0e−11 | ✓ |
| nlme REML: Asym %95 GA alt | 157,95897165 | 157,95897114 | — | 3,3e−9 | ✓ |
| nlmer: Asym | 192,05279189 | 192,05314909 | 192,05315104 | 1,9e−6 | ✗ |
| nlmer: xmid | 727,90447334 | 727,90632819 | 727,90632853 | 2,5e−6 | ✗ |
| nlmer: scal | 348,07213398 | 348,07304691 | 348,07304673 | 2,6e−6 | ✗ |
| nlmer: SH(Asym) | 15,58385079 | 15,58386276 | 15,58386267 | 7,7e−7 | ✓ |
| nlmer: SH(xmid) | 34,43847495 | 34,43870007 | 34,43870075 | 6,6e−6 | ✗ |
| nlmer: SH(scal) | 26,30812135 | 26,30820347 | 26,30820398 | 3,1e−6 | ✗ |
| nlmer: \sigma_b^2 | 1001,4898015 | 1001,48839223 | 1001,48836923 | 1,4e−6 | ✗ |
| nlmer: \sigma^2 | 61,51279074 | 61,51283582 | 61,51283839 | 7,7e−7 | ✓ |
| nlmer: logLik | −131,571877 | −131,5718851 | −131,5718851 | 6,2e−8 | ✓ |
| nlmer: AIC | 273,143755 | 273,1437702 | — | 5,6e−8 | ✓ |
Ölçütü karşılayan: 32/41. Python: Lindstrom–Bates sabit noktası (kendi Gauss–Newton adımıyla cezalı en küçük kareler ↔ doğrusallaştırılmış modelde profil olabilirliğin tek değişkenli eniyilemesi) ve kesin marjinal olabilirliğin doğrudan eniyilemesi. R: aynı sabit nokta, doğrusal adım nlme::lme ile; kesin olabilirlik optim + nlminb ile. nlme() ve nlmer() çağrılmamıştır. ✗ satırlarının gerekçesi metindedir.
✗ satırlarının iki kaynağı vardır. (1) Örnek ayar, nlme motoru: varsayılan yakınsama toleransı 10^{-5}'tir; algoritma sabit noktaya beş–altı anlamlı basamak kala durur (en büyük göreli fark 1{,}7\cdot10^{-5}). Toleranslar sıkılaştırıldığında ("sıkı" satırları) aynı büyüklükler 10^{-8} içinde örtüşür. (2) Laplace motoru: kestirimler kesin en büyükten en çok 6{,}6\cdot10^{-6} göreli farkla ayrılır; log-olabilirlikler 6\cdot10^{-8} içinde aynıdır. Olabilirlik en büyüğün çevresinde çok yassıdır (bu iki nokta arasında kesin log-olabilirlik 1{,}5\cdot10^{-9} değişir) ve formdaki toleransları sıkılaştırmak Laplace motorunun sonucunu değiştirmez. İki durumda da fark dördüncü–beşinci anlamlı basamaktan sonradır ve yorumu etkilemez.
24.7 Çıktıyı okuma
Örnek ayarın metin çıktısı (nlme'nin kendi özeti; kısaltılmış):
Nonlinear mixed-effects model fit by maximum likelihood
  Model: y ~ SSlogis(x, Asym, xmid, scal)
  Data: d
       AIC      BIC    logLik
  273.1691 280.9459 -131.5846

Random effects:
 Formula: Asym ~ 1 | g
            Asym Residual
StdDev: 31.48255 7.846255

Fixed effects:  Asym + xmid + scal ~ 1
        Value Std.Error DF  t-value p-value
Asym 191.0499  16.15411 28 11.82671       0
xmid 722.5590  35.15195 28 20.55530       0
scal 344.1681  27.14801 28 12.67747       0
 Correlation:
     Asym  xmid
xmid 0.375
scal 0.354 0.755
"Sabit etkiler (popülasyon parametreleri)" tablosu:
| parametre | kestirim | SH | sd | t | p |
|---|---|---|---|---|---|
| Asym | 191,0499 | 16,1541 | 28 | 11,8267 | 2{,}10\cdot10^{-12} |
| xmid | 722,5590 | 35,1520 | 28 | 20,5553 | 1{,}98\cdot10^{-18} |
| scal | 344,1681 | 27,1480 | 28 | 12,6775 | 4{,}03\cdot10^{-13} |
"Varyans bileşenleri" tablosu: Asym (Tree): varyans 991,1512, SS 31,4826; Artık: varyans 61,5637, SS 7,8463. "Model uyumu" tablosu: n 35; grup sayısı 5; logLik −131,584556; AIC 273,169112; BIC 280,945852; yöntem ML (nlme).
Pinheiro ve Bates'in (2000) aynı model için verdiği değerler: Asym 191,05; xmid 722,56; scal 344,17; rastgele etki standart sapması 31,48; artık standart sapma 7,846; logLik −131,58.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Asym | Tipik ağacın (rastgele etkisi sıfır) ulaşacağı gövde çevresi | 191 mm; ağaçtan ağaca standart sapması 31,5 mm. |
| xmid | Çevrenin asimptotun yarısına ulaştığı yaş | 723 gün; büyümenin en hızlı olduğu an. |
| scal | Eğrinin yayvanlığı (gün) | Asimptotun yaklaşık %27'sinden %73'üne geçiş 2\,\text{scal} sürer. |
| SH, sd, t, p | Yaklaşık (doğrusallaştırmaya dayalı) çıkarım | H_0:\beta=0 bu parametrelerde anlamlı bir soru değildir; SH ve GA okunur. |
| Güven aralıkları tablosu | Kestirim ± t × SH (Laplace motorunda normal çeyrek) | Sabit etkiler tablosundaki SH'ye dayanır; p ile tutarlıdır (24.4.3). |
| Varyans bileşenleri | Her rastgele parametrenin varyansı ve SS'si; artık | Rastgele etki SS'si parametreyle aynı birimdedir. |
| logLik, AIC, BIC | Doğrusallaştırılmış (nlme) ya da Laplace (nlmer) log-olabilirliği | Aynı motor ve aynı yöntemle uydurulan modeller arasında karşılaştırılır. |
| "Kestirim uyarıları:" | Laplace motorunun uyarıları | Yakınsama ya da tekillik uyarısı varsa model sadeleştirilir. |
Şekil 24.1. Şablonun grafiği (örnek veri): gözlemler (ağaca göre renkli), her ağacın kestirilen eğrisi (ince) ve popülasyon eğrisi (kalın, mor). Ağaç eğrileri yalnız asimptotta ayrışır; xmid ve scal ortaktır.
Rapor cümlesi:
Gövde çevresinin yaşa göre değişimi, asimptotu ağaçlar arasında rastgele değişen üç parametreli lojistik karma modelle kestirildi (en çok olabilirlik, Lindstrom–Bates algoritması; 5 ağaç, 35 gözlem). Tipik asimptot 191,0 mm (SH 16,2), yarı yüksekliğe ulaşma yaşı 722,6 gün (SH 35,2), ölçek 344,2 gün (SH 27,1) bulundu. Asimptotun ağaçlar arası standart sapması 31,5 mm, artık standart sapma 7,8 mm idi (logLik = −131,58; AIC = 273,17).
24.8 Sık hatalar ve tuzaklar
- İki motorun sonuçlarını aynı tabloya koymak. nlme motoru ile Laplace motoru aynı veride farklı kestirim verir (Asym 191,05 ve 192,05; xmid 722,56 ve 727,90). Fark yöntemin tanımından gelir; model karşılaştırması aynı motorla yapılır ve raporda motor belirtilir.
- ML aralığını başka bir yazılımın ML aralığıyla doğrudan karşılaştırmak. Şablonun aralığı \sqrt{N/(N-p)} ile düzeltilmiş SH'ye dayanır; çarpansız SH kullanan bir çıktının aralığı %4,4 dardır (\sqrt{32/35}). Çarpan tablonun altındaki notta yazılıdır.
- REML'i ML'den bağımsız bir kestirim sanmak. nlme motorunda REML sabit etkileri değiştirmez; varyans bileşenlerini N/(N-p) ile ölçekler (24.4.4). İki yöntemin log-olabilirlikleri ve AIC'leri birbiriyle karşılaştırılmaz.
- Az sayıda grupla çok rastgele parametre. Beş ağaçla iki rastgele parametre ve korelasyonları kestirilebilir (çalıştırma 5: Asym SS 34,35; xmid SS 38,34; korelasyon 0,771; logLik −130,90), ama AIC 273,17'den 275,80'e yükselir: ek iki parametre uyumu yeterince iyileştirmez. Yakınsama sorunu ya da sıfıra yapışan varyans, modelin veriye göre zengin olduğunu gösterir.
- Veriye uymayan eğri seçmek. Dört parametreli lojistik ve asimptotik üstel bu veride kurulamaz; çalıştırma "Model yakınsamadı: …" iletisiyle durur. Veri S biçimlidir: asimptotik üstel eğrinin büküm noktası yoktur, dört parametreli lojistiğin alt asimptotu ise gözlem aralığından belirlenemez. Model, verinin biçimine göre seçilir.
- Rastgele parametre adını yanlış yazmak. Adlar modelin parametre adlarıyla birebir aynı olmalıdır (
Asym,xmid,scal;asymkabul edilmez). İleti geçerli adları listeler. - Popülasyon eğrisini ortalama eğri sanmak. Kalın eğri, rastgele etkisi sıfır olan tipik bireyin eğrisidir. Rastgele etki doğrusal olmayan biçimde giriyorsa (ör. xmid'de) birey eğrilerinin ortalaması bu eğriyle çakışmaz.
- Varsayılan toleransla altıncı basamağı okumak. Örnek ayarda kestirimler sabit noktaya göre beşinci anlamlı basamakta oynar. Başka bir yazılımla basamak basamak karşılaştırma yapılacaksa Gelişmiş sekmesindeki toleranslar küçültülür.
- Laplace motorunda p değerlerini nlme'ninkilerle karşılaştırmak. Laplace motoru z (normal), nlme motoru t_\nu kullanır; beş grupla normal yaklaşım iyimserdir.
24.9 Uzman soruları
S1. nlme motoru neden marjinal olabilirliğin tam en büyüğünü vermiyor?
Dönüşümlü algoritma sabit etkileri PNLS adımında, cezalı artık kareler toplamını en küçük yaparak kestirir. Marjinal olabilirlikte ise \boldsymbol\beta hem artıklara hem \ln\lvert\mathbf V_i(\boldsymbol\beta)\rvert terimine girer; PNLS ikincisini görmez. Örnek modelde bu açıkça ölçülebilir, çünkü marjinal olabilirlik kapalı biçimlidir: tam en büyük -131{,}571885, algoritmanın sabit noktasında -131{,}584579. Fark küçüktür ama sıfır değildir; birey başına gözlem sayısı arttıkça azalır (Pinheiro ve Bates, 1995).
S2. Laplace yaklaşımı bu modelde gerçekten kesin mi?
Evet. Rastgele etki yalnız Asym'e eklendiğinden yanıt b_i'ye göre doğrusaldır; \mathbf y_i ile b_i'nin ortak dağılımı normaldir ve b_i üzerinden integral kapalı biçimlidir. Laplace yaklaşımı normal integranda uygulandığında hata içermez. Rastgele etki xmid ya da scal'e verilirse integrand normal değildir; Laplace bir yaklaşıklık olur ve uyarlamalı kareleme ile küçük farklar görülebilir.
S3. Serbestlik derecesi neden 28?
nlme, sabit etkinin hangi düzeyde değiştiğine göre "içerme" kuralını uygular: bu modelde üç parametre de birey içi düzeyde kestirilir ve \nu=N-M-(p-1)=35-5-2=28 olur. Michaelis–Menten modelinde (p=2) aynı kural 29 verir. Bu, Satterthwaite ya da Kenward–Roger gibi veriden kestirilen bir serbestlik derecesi değildir; beş gruplu bir veride asimptotun belirsizliğini iyimser gösterebilir, çünkü asimptot hakkındaki bilgi esas olarak ağaç sayısından gelir.
S4. Rastgele etki hangi parametrelere verilmeli?
Bireylerin gözle ayrıştığı parametrelere. Bu veride ağaçlar aynı yerden başlayıp farklı düzeylere ulaşır: fark asimptottadır. Her parametreye rastgele etki verip köşegen yapıyla başlamak, sıfıra yakın çıkan varyansları eleyip gerekirse korelasyon eklemek yaygın bir yoldur (Pinheiro ve Bates, 2000). İç içe modeller aynı motorda ML ile uydurulup olabilirlik oranı ya da AIC ile karşılaştırılır; varyansın sıfır olduğu yokluk hipotezi parametre uzayının sınırında olduğundan olabilirlik oranı testinin p'si tutucudur.
S5. Standart hatalar hangi yaklaşıklığa dayanıyor?
Doğrusallaştırılmış modelin genelleştirilmiş en küçük kareler kovaryansına: \hat\sigma^2(\sum_i\hat{\mathbf X}_i^{\top}\mathbf V_i^{-1}\hat{\mathbf X}_i)^{-1}. Varyans parametrelerinin kestirilmiş olmasının belirsizliği bu kovaryansa girmez. Kesin olabilirliğin sayısal Hessian'ından hesaplanan standart hatalar örnek veride 15,66; 35,25; 27,08'dir; Laplace motorunun bildirdiği 15,58; 34,44; 26,31'den %0,5–3 büyüktür.
S6. nlme'nin REML'i neden ML ile aynı sabit etkileri veriyor?
Doğrusal karma modelde REML, sabit etkileri olabilirlikten integre eder ve varyans oranını değiştirir; sabit etkiler de buna bağlı olarak değişir. nlme'nin doğrusal olmayan modeldeki çıktısı ise ML'nin varyans oranını korur ve ölçeği N/(N-p) ile düzeltir: örnek veride \sigma^2/\sigma_b^2 iki yöntemde de 0,0621133'tür. Doğrusallaştırılmış modelin kısıtlı olabilirliği ayrıca en büyük yapılsaydı oran 0,0529 olurdu (24.4.4). Bu ayrım bağımsız hesapta hem Python hem R (lme ile) tarafında gösterilmiştir.
S7. Artıkların varyansı yaşla artıyorsa ya da ardışık ölçümler ilişkiliyse?
Şablon artıkları bağımsız ve sabit varyanslı varsayar. nlme paketi varyans işlevlerini (weights = varPower()) ve korelasyon yapılarını (correlation = corAR1()) destekler, ama şablon bu seçenekleri forma taşımaz; gerekiyorsa kod düzenlenerek nlme çağrısına eklenir. Büyüme verisinde artıkların kestirilen değere göre yayılımı ve bireye göre artık sıra grafiği denetlenmelidir.
S8. Beş ağaçla rastgele etki varyansı ne kadar güvenilir?
Az. \sigma_b^2, beş \hat b_i'nin yayılımından kestirilir; dört serbestlik dereceli bir varyans kestiriminin %95 güven aralığı, kestirimin yaklaşık 0,36 ile 8,3 katı arasındadır. ML ayrıca varyansı aşağı yanlı kestirir: REML ölçeği (\times35/32) bu yanlılığın yalnız sabit etki sayısından gelen kısmını düzeltir. Şablon varyans bileşenleri için güven aralığı vermez.
24.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Davidian, M., & Giltinan, D. M. (2003). Nonlinear models for repeated measurement data: An overview and update. Journal of Agricultural, Biological, and Environmental Statistics, 8(4), 387–419. https://doi.org/10.1198/1085711032697
- Draper, N. R., & Smith, H. (1998). Applied regression analysis (3. baskı). Wiley. https://doi.org/10.1002/9781118625590
- Lindstrom, M. J., & Bates, D. M. (1990). Nonlinear mixed effects models for repeated measures data. Biometrics, 46(3), 673–687. https://doi.org/10.2307/2532087
- Pinheiro, J. C., & Bates, D. M. (1995). Approximations to the log-likelihood function in the nonlinear mixed-effects model. Journal of Computational and Graphical Statistics, 4(1), 12–35. https://doi.org/10.1080/10618600.1995.10474663
- Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer. https://doi.org/10.1007/b98882
- Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models (R paketi, sürüm 3.1-168). https://doi.org/10.32614/CRAN.package.nlme
- Wolfinger, R. (1993). Laplace's approximation for nonlinear mixed models. Biometrika, 80(4), 791–795. https://doi.org/10.1093/biomet/80.4.791