76. Genom Boyu İlişkilendirme Çalışması (GWAS)
Şablon kimliği: gwas · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/gwas.R (satır 1–375; üstbilgi 1–124) · Örnek veri: _ornek/drops_gwas.csv · Paketler: statgenGWAS 1.0.14, qvalue 2.42.0 (isteğe bağlı), sommer 4.5.12 (varsayılan varyans bileşeni çözücüsü)
76.1 Ne işe yarar
Şablon, "genomun hangi bölgeleri bu özellikle ilişkili?" sorusunu cevaplar. Genom boyunca dağılmış binlerce SNP'nin her biri sırayla tek bir regresyon modeline konur ve etkisi sınanır. Bireyler arasındaki akrabalık ve popülasyon yapısı hesaba katılmazsa, özellikle ilgisi olmayan pek çok marker yalnız bu yapı yüzünden anlamlı çıkar; şablon bunu bir karma modelle önler:
- \mathbf y: n bireyin özellik değerleri; \mathbf X: kesişim ve varsa ortak değişkenler ile temel bileşenler.
- \mathbf x_j: j. markerde sayılan alelin kopya sayısı (0, 1, 2); a_j: bu alelin bir kopyasının etkisi. Sınanan hipotez H_0\colon a_j=0.
- \mathbf g: genomun geri kalanındaki çok sayıda küçük etkili genin toplam katkısı (poligenik etki); \mathbf K akrabalık matrisi, akraba bireylerin g değerlerinin benzer olmasını sağlar.
- \sigma^2_g, \sigma^2_e: genetik ve artık varyans.
Hesap üç aşamadır: (1) markersiz (poligenik) modelde \sigma^2_g ve \sigma^2_e bir kez kestirilir; (2) bu iki değer sabit tutularak her marker genelleştirilmiş en küçük karelerle (GLS) sınanır; (3) p değerleri çoklu test için değerlendirilir ve iki grafikle özetlenir.
Ne zaman kullanılır? Akraba olmayan ya da akrabalığı markerlerden ölçülebilen bireylerden oluşan bir panelde (çeşit koleksiyonu, doğal popülasyon örneği, ıslah hatları) sürekli bir özelliğin genetik mimarisi aranırken; her bireyin tek bir özellik değeri (hat ortalaması, düzeltilmiş ortalama) olduğunda.
Ne zaman kullanılmaz?
- İkili özellik (hasta / sağlıklı):
vaka_kontrol_genetik. Bu şablon yanıtı sürekli ve normal artıklı sayar. - Deneysel çaprazlama (geri melez, F2, rekombinant kendilenmiş hat):
qtl_haritalama. Orada markerler arası konumlar da sınanır ve eşik permütasyonla bulunur. - Aile temelli örneklem (anne–baba–çocuk üçlüleri):
tdt. - Amaç tek tek markerleri bulmak değil, bireylerin genetik değerini kestirmekse:
genomik_seleksiyon. - Yalnız genomik kalıtım derecesi isteniyorsa:
genomik_seleksiyon(GBLUP) ya dakalitim_derecesi. - Tekrarlı ölçümler ya da çok ortamlı deneme: önce karma modelle hat ortalamaları elde edilir (
lokasyon_yil_tbd,alfa_kafes), sonra bu şablon çalıştırılır; birey kimliği yinelenirse şablon durur. - Genotipler harflerle (AA/AG/GG) kodluysa: önce 0/1/2'ye çevrilir.
Temel programla ilişki. Temel programda karşılığı yoktur.
76.2 Şablonun girdileri
Form, üstbilgideki on altı [[param]] bloğundan kurulur (gwas.R:10–123).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Özellik (yanıt) · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal | \mathbf y; eksik olan bireyler çıkarılır (131, 168). |
Birey / hat kimliği · birey |
kategorik sütun · Değişkenler | boş | tekil kimlikler | Satır adları; hazır akrabalık matrisinin eşleştirilmesi (175, 219–225). |
Marker sütunları · lokuslar |
sütunlar (sayısal) · Değişkenler | boş | 0/1/2 kodlu sütunlar | Boşsa 0/1/2 içeren sütunlar (kategorik türdekiler dahil); adı <kromozom>_<konum>_<ad> biçiminde olan sütun varsa yalnız onlar (142–165). |
Ortak değişkenler · ortak_degiskenler |
sütunlar · Değişkenler | boş | sayısal sütunlar | \mathbf X'e eklenir (240–243). |
Hazır akrabalık matrisi sütun öneki · akrabalik_onek |
metin · Değişkenler | boş | ör. K_ |
Adı bu önekle başlayan sütunlar \mathbf K olur (136, 218–229). |
Akrabalık matrisi (hesaplanırsa) · akrabalik_yontemi |
seçim · Model | astle |
astle, vanRaden, IBS |
Önek boşken markerlerden \mathbf K (232). |
Temel bileşen sayısı · tb_sayisi |
tam sayı · Model | 0 | 0–10 | \mathbf K'nın ilk özvektörleri ortak değişken olur (244–249). |
MAF eşiği · maf |
ondalık · Seçenekler | 0,01 | 0–0,49 | Küçük alel frekansı eşiğin altındaki markerler çıkarılır (191, 272). |
En küçük marker çağrı oranı · cagri_orani |
ondalık · Seçenekler | 0,9 | 0–1 | Eksiksiz genotip payı eşiğin altındaki markerler çıkarılır (189). |
Anlamlılık düzeyi · alfa |
ondalık · Seçenekler | 0,05 | 0,0001–0,2 | Bonferroni eşiği \alpha/m ve q<\alpha (305–309). |
Genomik kontrol düzeltmesi · genomik_kontrol |
onay · Seçenekler | kapalı | açık / kapalı | \lambda_{GC}>1 ise F değerleri \lambda_{GC}'ye bölünür (288–298). |
En güçlü marker sayısı · ust_sayi |
tam sayı · Çıktı | 10 | 1–5000 | İlişki tablosunun satır sayısı (328). |
Varyans bileşeni algoritması · reml_algo |
seçim · Gelişmiş | NR |
NR, EMMA |
Poligenik modelin çözücüsü; NR seçiliyken sommer kurulu değilse EMMA'ya düşer ve uyarı yazar (255–261). |
Akrabalık düzeni · gls_yontem |
seçim · Model | single |
single, multi |
Tek matris ya da kromozoma özgü (LOCO) (262–268). |
MAF yerine MAC süzgeci · mac_kullan |
onay · Seçenekler | kapalı | açık / kapalı | Taramada eşik küçük alel sayısıyla verilir (272). |
MAC eşiği · mac |
tam sayı · Seçenekler | 10 | 1–100000 | Yalnız mac_kullan açıkken (273). |
Örnek ayar (ornek_param, satır 9): y = verim, birey = birey, akrabalik_onek = K_. Öteki alanlar varsayılandadır; marker listesi boş bırakılır.
Veri biçimi. Her satır bir birey ya da hattır. Marker sütunlarında hücre, sayılan alelin kopya sayısıdır (0, 1, 2; boş = eksik). Kromozom ve konum sütun adından okunur: 6_18990291_PZE-106021410 adı 6. kromozom, 18 990 291. baz, PZE-106021410 belirteci demektir. Kabul edilen biçim <kromozom>_<konum>_<ad> ya da <kromozom>:<konum>'dur; kromozom bir sayı, X ya da Y olabilir ve başına chr gelebilir (düzenli ifade satır 205). Hazır akrabalık matrisi aynı tabloda taşınır: K_A3 sütunu, her satırdaki bireyin A3 bireyiyle akrabalığını tutar.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 128 |
| statgenGWAS kurulu değil | "Bu şablon statgenGWAS paketini gerektirir." | 129 |
| Yanıt sayısal değil | "Yanıt '…' sayısal olmalı." | 135 |
| Önek yazılmış, o önekle başlayan sütun yok | "'…' önekiyle başlayan akrabalık sütunu yok." | 137 |
| Hazır matris var, kimlik sütunu seçilmemiş | "Hazır akrabalık matrisi için birey kimliği sütunu seçilmeli" | 138 |
| Liste boş ve 0/1/2 kodlu sütun yok | "Marker sütunu bulunamadı …" | 159 |
| Seçilen marker sayısal değil | "Marker '…' sayısal olmalı (0/1/2)." | 161 |
| 0/1/2 dışında değer | "yalnız 0/1/2 (alel kopya sayısı) içermeli; ör. … bulundu" | 161 |
| Yanıtı olan birey 20'den az | "En az 20 bireyde yanıt gerekli (şu an …)." | 173 |
| Yanıt sabit | "Yanıt sabit; ilişkilendirme yapılamaz." | 174 |
| Kimlik eksik ya da yinelenmiş | "Birey kimliği eksik olamaz." / "Birey kimlikleri tekil olmalı … hat ortalamasını kullanın." | 176–177 |
| Süzgeçlerden sonra marker kalmadı | "Süzgeçlerden sonra sınanacak marker kalmadı" | 195 |
| Matriste bulunmayan birey | "Akrabalık matrisinde bulunmayan birey var (ör. '…')" | 220 |
| Matris sayısal değil, eksik değerli ya da simetrik değil | "Akrabalık sütunları sayısal olmalı." / "… eksik değer var." / "… simetrik değil." | 222, 226, 227 |
| Matris hesaplanacak, 10'dan az marker | "Akrabalık matrisini hesaplamak için en az 10 marker gerekli." | 231 |
| Köşegeninde sıfır ya da negatif değer | "Akrabalık matrisinin köşegeni pozitif olmalı." | 235 |
| Ortak değişken sayısal değil | "Ortak değişken '…' sayısal olmalı (kategorikse 0/1 göstergelere çevirin)." | 241 |
| Temel bileşen sayısı \ge n-2 | "Temel bileşen sayısı birey sayısından çok küçük olmalı." | 246 |
| Ortak değişkenler (ve temel bileşenler) kesişimle doğrusal bağımlı ya da sabit | "Ortak değişkenler … doğrusal bağımlı ya da sabit; … sütunu çıkarın." | 252–253 |
| LOCO ile hazır matris | "Kromozoma özgü akrabalık hazır akrabalık matrisiyle kullanılamaz" | 265 |
| LOCO, adlarda en az iki kromozom yok | "… marker adlarında en az iki kromozom bilgisi gerekli" | 267 |
| statgenGWAS içinde başka bir hata | "Karma model taraması çalıştırılamadı: …" | 275 |
| Hiçbir markere p verilemedi | "Hiçbir marker sınanamadı." | 282 |
Notlar (durdurmaz): yanıtı ya da ortak değişkeni eksik bireyler çıkarılır (170); bütünüyle eksik ve tek biçimli markerler çıkarılır (192–193); kalan eksik genotipler doldurulur (201); adlarda harita yoksa markerler sütun sırasıyla tek eksende çizilir (213); marker listesi boşsa kaç sütunun marker sayıldığı yazılır (315). Marker listesi boşken adı harita biçimine uymayan 0/1/2 sütunlar marker sayılmaz ve adları yazılır (316); harita biçimli ad yoksa marker sayılan sütunların ilk adları yazılır (317). Genotipler yalnız 0/1 kodluysa 0/2 ölçeğine çevrildiği ve etkinin ne anlama geldiği yazılır (318). Newton–Raphson seçiliyken sommer kurulu değilse varyans bileşenleri EMMA ile kestirilir ve bu uyarıyla bildirilir (257–261). Her çalıştırmada hangi çözücünün kullanıldığı özet tablosunun altına yazılır (322–323).
76.3 Örnek veri
Dosya: _ornek/drops_gwas.csv. DROPS mısır panelinin (Millet ve ark., 2016) statgenGWAS paketiyle dağıtılan alt kümesi: 246 kendilenmiş hat ve 2548 sütun: kimlik, iki özellik, 2299 SNP ve 246 akrabalık sütunu. Özellikler tek bir denemenin (Mur13W) hat ortalamalarıdır. Akrabalık matrisi, panelin tam marker kümesinden (36 624 SNP) Astle–Balding yöntemiyle önceden hesaplanmıştır; 2299 SNP bu kümenin seyreltilmiş bir örneğidir. Eksik değer yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
birey |
Birey kimliği | metin | 246 tekil hat adı (A3, B73, 11430 …). |
verim |
Yanıt | sayısal | Tane verimi; ortalama 7,41, standart sapma 1,59. |
ciceklenme |
İkinci özellik / ortak değişken | sayısal | Çiçeklenme zamanı; ortalama 63,3, standart sapma 3,13. |
1_3498_SYN83 … |
SNP'ler | sayısal ya da ikili | 2299 sütun, 10 kromozom (kromozom başına 158–377); değerler 0/1/2. |
K_11430 … K_Wf9 |
Akrabalık matrisi | sayısal | 246 sütun; köşegen ortalaması 1,972, bütün öğelerin ortalaması 0. |
Hatlar kendilenmiş olduğundan genotiplerin %99,1'i homozigottur (0 ya da 2); heterozigot hücre 5258'dir. En küçük alel frekansı en düşük markerde 0,051'dir; varsayılan süzgeçler hiçbir markeri atmaz.
Düzey sırası bu şablonda rol oynamaz: bütün sütunlar sayısaldır, bireyler kimlikle eşleştirilir ve sonuç satır sırasından bağımsızdır (satırları karıştırılmış veride aynı sonuç alınmıştır).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) ust_sayi = 5000 (bütün markerlerin tablosu); (3) tb_sayisi = 3; (4) ortak değişken ciceklenme; (5) y = ciceklenme; (6) önek boş, akrabalık astle, vanRaden, IBS; (7) gls_yontem = multi, genomik kontrol açık ve kapalı; (8) reml_algo = EMMA (ızgara çözücüsü; ana çalıştırmalar karşılaştırma için bu çözücüyle de alınmıştır) ve varsayılan Newton–Raphson; (9) mac_kullan açık, mac = 40; maf = 0,1; (10) türetilmiş veriler: eksik genotipler, yalnız 0/1 kodlu markerler, karıştırılmış satırlar, sayısal kimlikler, marker olmayan 0/1 sütunlar.
76.4 Yöntem: formüller ve hesap adımları
76.4.1 Süzgeç ve doldurma
Yanıtı ya da ortak değişkeni eksik bireyler çıkarıldıktan sonra her marker için çağrı oranı ve alel frekansı hesaplanır (satır 180–191):
- n_j: j. markerde genotipi gözlenen birey sayısı; c_j: çağrı oranı.
- Marker sırayla şu sınıflardan ilkine düşerse çıkarılır: bütünüyle eksik (c_j=0); düşük çağrı oranı (c_j<
cagri_orani); tek biçimli (\text{MAF}_j=0); düşük frekans (\text{MAF}_j<maf). - Kalan eksik hücreler marker ortalamasıyla (2p_j) doldurulur; doldurulan hücre sayısı konsola yazılır.
Neden ortalama ile doldurma?
Karma model taraması eksiksiz bir marker matrisi ister. Eksik hücreye 2p_j yazmak, o bireyin o markerde ortalamadan sapmasını sıfır saymaktır: birey markerin etki kestirimine katkı yapmaz, ama modelde kalır. Eksik oranı yüksek markerde bu, etkiyi sıfıra çeker ve gücü düşürür; çağrı oranı süzgeci bu yüzden vardır. Bağlantı dengesizliğine dayalı doldurma daha doğrudur ve şablondan önce yapılmalıdır.
Koddaki tercih
Tarama statgenGWAS::runSingleTraitGwas ile yapılır ve bu fonksiyon kendi frekans süzgecini ayrıca uygular (satır 272): frekansı (\texttt{maf},\,1-\texttt{maf}) açık aralığının dışında kalan markere p değeri verilmez. Paketin eşiği açık aralık olduğundan şablon pakete eşikten 10^{-9} küçük bir değer verir (satır 272); küçük alel frekansı eşiğe tam eşit olan marker de taranır (ör. eksik genotipli örnekte maf = 0,25 ile 17 marker). Ön süzgeç ile tarama aynı kuralı uygular; konsoldaki sınanan marker sayısı ön süzgeçten geçen sayıdır. mac_kullan açıkken paketin eşiği \texttt{mac}/(2n)-10^{-5} olur; ön süzgeçteki maf eşiği yine uygulanır. Örnekte mac = 40 ile eşik 40/492-10^{-5}=0{,}0813'tür ve 2299 markerin 2201'i sınanır.
76.4.2 Akrabalık matrisi
Önek verilmişse matris veriden okunur, bireylerin sırasına göre dizilir ve simetrikleştirilir: \mathbf K\leftarrow(\mathbf K+\mathbf K^\top)/2 (satır 219–228). Önek boşsa, süzgeçten geçmiş ve doldurulmuş marker matrisinden hesaplanır (232):
- m: marker sayısı; p_j=\sum_ix_{ij}/(2n).
- Astle–Balding: her marker kendi beklenen varyansıyla ölçeklenir; nadir aleli paylaşmak daha çok sayılır.
- VanRaden: markerler ölçeklenmeden toplanır ve toplam beklenen varyansa bölünür; yaygın aleller daha çok ağırlık alır.
- IBS: paketin tanımı x'i 0–1 ölçeğinde bir alel paylaşım ölçüsü gibi kullanır; şablon 0/1/2 ölçeğindeki matrisi verir.
Neden üç seçenek ve hangisi?
Astle–Balding ve VanRaden, alel frekanslarının kestirildiği temel popülasyona göre "beklenenden fazla paylaşımı" ölçer; karma modelde \sigma^2_g bu ölçekte yorumlanır. Astle–Balding insan genetiğinde, VanRaden hayvan ve bitki ıslahında yaygındır. IBS matrisi merkezlenmemiştir; ama modelde kesişim bulunduğundan yalnız merkezlenmiş kısmı etkilidir ve bu kısım \tfrac2m\sum_j(x_{ij}-\bar x_j)(x_{kj}-\bar x_j)'dir: VanRaden matrisinin bir sabitle çarpımı. Bu yüzden IBS ve VanRaden seçenekleri aynı modeli tanımlar; yalnız \sigma^2_g'nin ölçeği değişir. Örnekte REML'in tam en büyüğünde iki seçenek aynı \sigma^2_e=0{,}2357 değerini verir.
Hazır matris ile hesaplanan matris aynı sonucu vermez
Örnek verideki hazır matris 36 624 SNP'den, hesaplanan matris 2299 SNP'den gelir. Az markerle kurulan matris akrabalığı daha gürültülü ölçer: aynı Astle–Balding tanımıyla Bonferroni eşiğini geçen marker sayısı hazır matrisle 5, hesaplanan matrisle 1'dir. Tam marker kümesi elde varsa akrabalık ondan hesaplanıp K_ sütunlarıyla verilir.
76.4.3 Poligenik model ve REML
Markersiz modelde \text{var}(\mathbf y)=\sigma^2_g(\mathbf K+\delta\mathbf I), \delta=\sigma^2_e/\sigma^2_g. Kang ve ark. (2008), kısıtlı olabilirliği tek bir özdeğer ayrışımıyla \delta'nın fonksiyonu olarak yazar:
- q: \mathbf X'in sütun sayısı; \mathbf S=\mathbf I-\mathbf X(\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top.
- \lambda_s ve \mathbf u_s: \mathbf S\mathbf K\mathbf S matrisinin sıfırdan farklı n-q özdeğeri ve özvektörü; \eta_s=\mathbf u_s^\top\mathbf y.
- \sigma^2_g kapalı biçimde çözülür (profil olabilirliği); geriye tek değişkenli bir en büyükleme kalır.
Neden REML ve neden bir kez?
En çok olabilirlik, sabit etkilerin kestirilmesinde harcanan serbestlik derecelerini saymaz ve varyansları küçümser; REML yalnız \mathbf X'e dik n-q karşıtlığın olabilirliğini kullanır. Varyansların her marker için yeniden kestirilmesi m ayrı yinelemeli çözüm ister. Tek bir markerin açıkladığı varyans küçük olduğundan \delta markerden markere pek değişmez; poligenik modelin \hat\delta'sını bütün markerlerde kullanmak (Kang ve ark., 2010; Zhang ve ark., 2010) hesabı m doğrusal regresyona indirir. Karşılığı, büyük etkili bir markerde gücün bir miktar düşmesidir.
Koddaki tercih
reml_algo = NR (varsayılan), sommer::mmer ile Newton–Raphson yinelemesi yapar ve kısıtlı olabilirliğin tam en büyüğüne yakınsar; rrBLUP::mixed.solve ve Brent aramasıyla aynı sonucu verir (göreli fark 2\cdot10^{-5} düzeyinde, yinelemenin yakınsama toleransı). sommer kurulu değilse şablon EMMA'ya düşer ve uyarı yazar. reml_algo = EMMA paketin kendi çözücüsünü çağırır: \ln\delta eksenini [-10,\,10] aralığında 100 eşit parçaya böler (adım 0,2), türevin işaret değiştirdiği parçayı bulur ve bu parçanın içinde bir nokta döndürür. Dönen nokta çoğunlukla parçanın sol ucundan 0{,}382\times0{,}2=0{,}0764 ileridedir; olabilirlik sol uca doğru artıyorsa sol uca yakın bir noktadır. Sonuç, \ln\delta'yı en çok yaklaşık 0,12 hatayla veren bir yaklaşımdır. Örnek ayarda EMMA'nın döndürdüğü değer \ln\hat\delta=-1{,}5236, olabilirliğin tam en büyüğü -1{,}5266'dır; öteki çalıştırmalarda fark 0,11'e kadar çıkmıştır (76.8). EMMA seçildiğinde konsol notu çözücünün yaklaşık olduğunu söyler. LOCO düzeninde her kromozomun kendi matrisi için ayrı kestirim yapılır; özet tablosuna kromozomların ortalaması yazılır (satır 278).
76.4.4 Her marker için GLS sınaması
\hat{\mathbf V}=\hat\sigma^2_g\mathbf K+\hat\sigma^2_e\mathbf I sabit tutulur. \hat{\mathbf V}=\mathbf L\mathbf L^\top Cholesky ayrışımıyla veriler beyazlatılır (\tilde{\mathbf y}=\mathbf L^{-1}\mathbf y, \tilde{\mathbf X}=\mathbf L^{-1}\mathbf X, \tilde{\mathbf x}_j=\mathbf L^{-1}\mathbf x_j); beyazlatılmış veride sıradan en küçük kareler GLS'ye eşittir.
- \perp: beyazlatılmış \tilde{\mathbf X}'in sütun uzayına dik bileşen (kesişim ve ortak değişkenler çıkarılmış).
- \text{KT}_0, \text{KT}_j: markersiz ve markerli modelin beyazlatılmış artık kareler toplamı.
- R^2_{LR}: olabilirlik oranına dayalı açıklanan varyans (Sun ve ark., 2010).
- LOD burada p değerinin eksi logaritmasıdır; bağlantı çözümlemesindeki olabilirlik oranı LOD'u değildir (Bölüm 87).
Neden standart hata ile p değeri aynı varyanstan gelmiyor?
Standart hata, \hat{\mathbf V}'nin doğru olduğu varsayımıyla (\mathbf x^\top\hat{\mathbf V}^{-1}\mathbf x)'in dik bileşeninden hesaplanır; artık varyans yeniden kestirilmez. F istatistiği ise iki kareler toplamının oranıdır ve ölçekten bağımsızdır. REML \text{KT}_0=n-q olacak biçimde ölçek seçtiğinden markerli modelde \text{KT}_j/(n-q-1) 1'den biraz küçüktür; bu yüzden (\hat a_j/\text{SH})^2, F_j'den küçük kalır. Tablodaki p, F'den gelir; etki ve standart hatadan elle hesaplanan Wald p'si daha büyük çıkar (76.6, Adım 4).
Koddaki tercih
statgenGWAS::runSingleTraitGwas(…, GLSMethod, remlAlgo, useMAF, MAF, MAC, genomicControl = FALSE, thrType = "bonf") (satır 270–274). Paketin kendi genomik kontrolü kapalı tutulur; düzeltmeyi şablon yapar (76.4.6). Paket, bütün markerlerde yalnız iki ardışık değer bulunuyorsa (en büyük ile en küçük genotip değerinin farkı 1; ör. yalnız 0 ve 1 kodlu veri) etki ve standart hatayı ikiye böler ve alel frekansını 0/2 ölçeği varsayarak hesaplar. Şablon bu durumu kendisi ayırt eder: en büyük genotip değeri 1 ise genotipleri 2 ile çarparak 0/2 ölçeğine çevirir (satır 182–184), taramadan sonra etkiyi ve SH'yi 2 ile çarpar (280) ve bunu konsola yazar (318). Böylece 0/1 kodlu veride (geri melez, haploit, 1 = tek kopya) tablodaki etki, 1 kodlu sınıf ile 0 kodlu sınıf arasındaki ortalama farkıdır; alel frekansı 1 kodlu sınıfın oranıdır; p değerleri değişmez.
76.4.5 Popülasyon yapısı: temel bileşenler ve LOCO
Q+K modeli. tb_sayisi =k>0 ise \mathbf K'nın en büyük k özdeğerine karşılık gelen özvektörler \mathbf X'e sütun olarak eklenir (satır 247–248). Akrabalık matrisi ince yapıyı (aile ilişkileri), temel bileşenler kaba yapıyı (alt popülasyonlar) yakalar. Özvektörlerin işareti keyfidir ve sonucu etkilemez.
LOCO. Sınanan marker akrabalık matrisinin hesabına da girmişse etkisinin bir bölümü \mathbf g'ye yazılır ve güç düşer. gls_yontem = multi seçildiğinde c kromozomundaki markerler, öteki kromozomların markerlerinden hesaplanan matrisle sınanır:
- \mathbf Z_{c'}: c' kromozomunun merkezlenmiş (Astle–Balding'de ayrıca ölçeklenmiş) marker matrisi; m_{(-c)}: c dışındaki marker sayısı.
- Her kromozom için ayrı \hat\sigma^2_g, \hat\sigma^2_e kestirilir.
- VanRaden seçeneğinde de payda marker sayısıdır (2\sum p(1-p) değil); \sigma^2_g bu yüzden tek matrisli düzendekinden farklı ölçektedir. Sınamalar ölçekten etkilenmez.
LOCO şişmeyi artırabilir
Örnekte 2299 markerden hesaplanan Astle–Balding matrisiyle \lambda tek matrisli düzende 0,912, LOCO'da 1,122'dir ve şablon \lambda>1{,}1 uyarısını yazar. Bir kromozomu dışarıda bırakmak akrabalık düzeltmesini zayıflatır; marker sayısı azken bu belirginleşir. LOCO sonuçları temel bileşenlerle ya da genomik kontrolle birlikte değerlendirilir.
76.4.6 Şişme katsayısı ve genomik kontrol
- Q^{-1}_{\chi^2_1}(p): 1 serbestlik dereceli ki-kare dağılımının üst kuyruk olasılığı p olan değeri; 0{,}4549 bu dağılımın ortancasıdır.
- \lambda özet tablosuna yazılır ve her zaman düzeltme öncesi p değerlerinden hesaplanır (satır 284–285).
- \lambda_{GC}, aynı büyüklüğün F ölçeğindeki karşılığıdır; düzeltmede kullanılır (289–293). İki sayı pratikte aynıdır (örnekte 0,985211 ve 0,985198).
Neden ortanca ve neden yalnız \lambda_{GC}>1 iken?
Markerlerin büyük çoğunluğu özellikle ilişkisizdir; istatistiklerinin dağılımı sıfır hipotezi altındaki dağılım olmalıdır. Ortanca, az sayıdaki gerçek ilişkiden etkilenmez. \lambda>1, bütün istatistiklerin ortak bir çarpanla şiştiğini gösterir (Devlin ve Roeder, 1999); istatistikleri bu çarpana bölmek ortancayı beklenen değere getirir. \lambda\le1 iken bölmek istatistikleri büyütür ve yanlış pozitifleri artırır; şablon bu durumda düzeltme yapmaz ve bunu konsola yazar.
Genomik kontrol bir onarımdır, model değildir: bütün markerleri aynı oranda cezalandırır. \lambda belirgin biçimde 1'den büyükse önce akrabalık matrisi ve temel bileşenler gözden geçirilir.
76.4.7 Çoklu test
- m: p değeri verilen marker sayısı; p_{(1)}\le\dots\le p_{(m)} sıralı p değerleri.
- q (Benjamini–Hochberg): markerin anlamlı sayıldığı en küçük yanlış keşif oranı; \min işlemi sıralamayı tekdüze yapar.
- \hat\pi_0: gerçekten ilişkisiz markerlerin oranı; p değerlerinin 1'e yakın kısmının yoğunluğundan kestirilir (Storey ve Tibshirani, 2003).
Neden iki eşik?
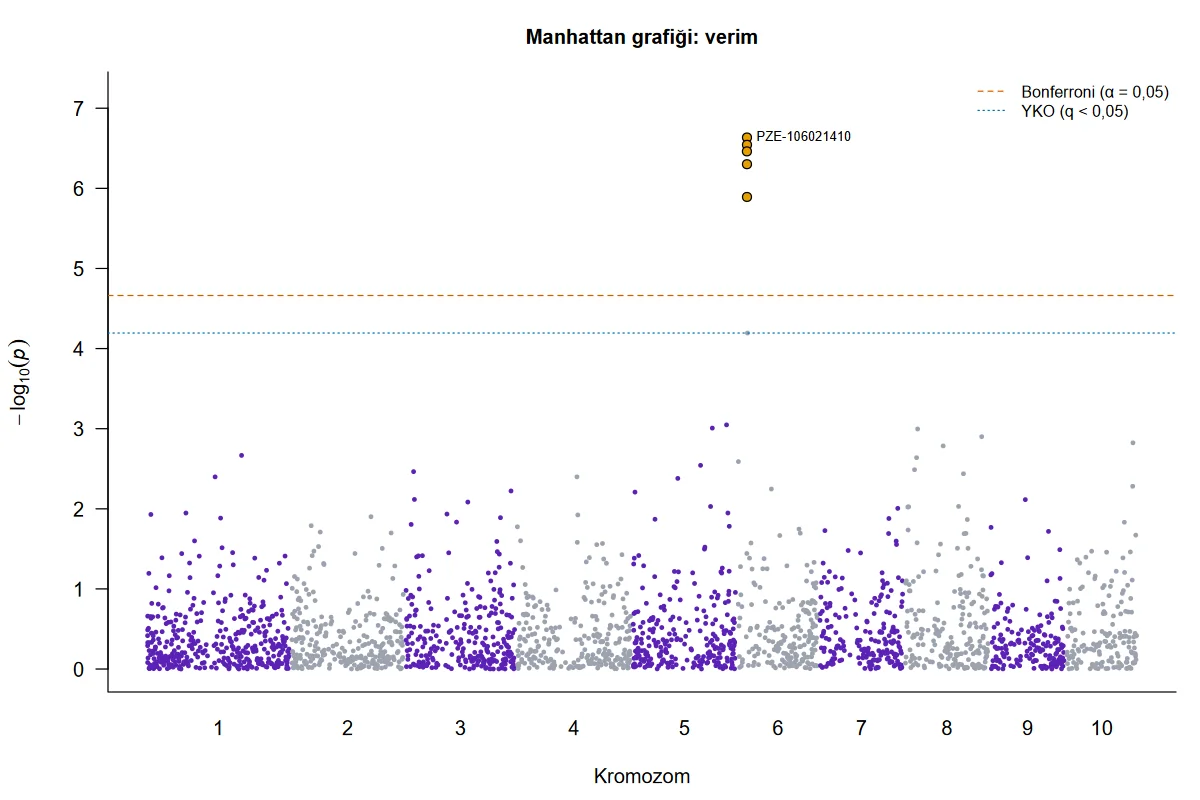
Bonferroni, tek bir yanlış pozitifin olasılığını \alpha ile sınırlar; markerler bağlantı dengesizliği yüzünden bağımsız olmadığından tutucudur. Yanlış keşif oranı, anlamlı ilan edilenler içindeki yanlışların beklenen payını sınırlar; aday bölge listesi çıkarmak için daha uygundur. Şablon ikisini de verir ve Manhattan grafiğinde iki çizgi çizer: Bonferroni eşiği ve q<\alpha olan en büyük p değeri.
Koddaki tercih
q değerleri stats::p.adjust(p, "BH") ile hesaplanır (satır 299); genomik kontrol uygulandıysa düzeltilmiş p değerlerinden. Storey q değerleri yalnız m\ge100 ise ve qvalue paketi kuruluysa verilir (301–304); aksi hâlde sütun boş kalır. Örnek veride \hat\pi_0 kestirimi 1'i aşar (1,114) ve 1'e kırpılır; iki q sütunu aynıdır. Bonferroni karşılaştırması kesin eşitsizliktir (p<\alpha/m, satır 307).
76.4.8 Grafikler
Manhattan grafiği (satır 335–361): yatay eksende markerler kromozom ve konum sırasıyla, dikey eksende -\log_{10}p. Kromozomlar ardışık iki renkle ayrılır; kesikli çizgi Bonferroni, noktalı çizgi yanlış keşif oranı eşiğidir. En küçük p değerli \max(\text{Bonferroni ile anlamlı sayısı},\,3) marker turuncu işaretlenir; birbirine eksen genişliğinin %3'ünden yakın olmayan en çok beş tanesine adı yazılır.
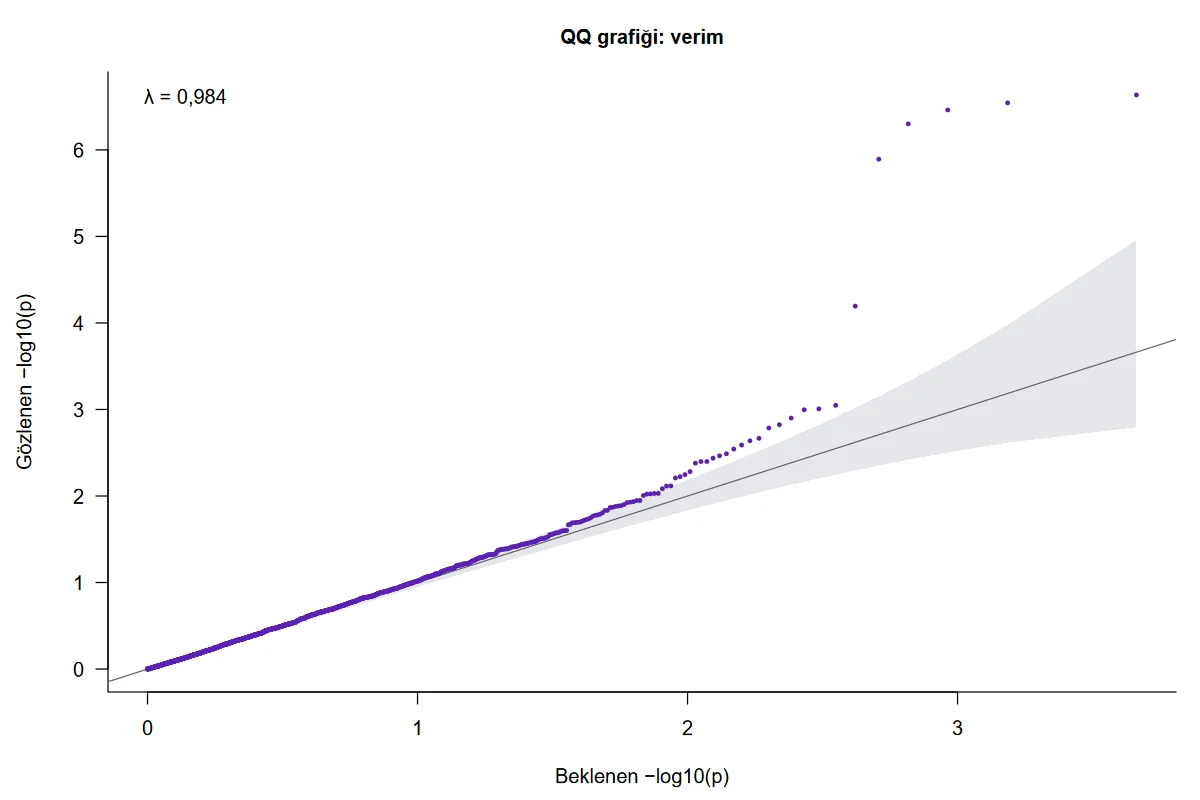
QQ grafiği (364–374): sıralı gözlenen -\log_{10}p değerleri, tekdüze dağılım altında beklenenlere karşı çizilir.
- r: sıra (en küçük p için 1).
- Sıfır hipotezi altında r. en küçük p değeri \text{Beta}(r,\,m-r+1) dağılır; gri kuşak bu dağılımın %95'lik aralığıdır ve her nokta için ayrı ayrı (noktasal) geçerlidir.
Noktalar köşegen üzerinde kalıp yalnız sağ uçta yukarı ayrılıyorsa testler iyi ayarlanmıştır ve az sayıda gerçek ilişki vardır. Noktaların baştan itibaren köşegenin üstünde seyretmesi şişmeyi, altında seyretmesi aşırı düzeltmeyi gösterir.
76.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–124 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on altı parametre. | Form buradan kurulur (Bölüm 1.2). |
| 125–139 | Paket denetimi; yanıt, kimlik, ortak değişken ve akrabalık sütunlarının belirlenmesi. | Bu sütunlar marker adayları arasından çıkarılır (139). |
| 141–165 | Marker sütunları: seçilenler ya da kendiliğinden bulunanlar; sayısallık ve 0/1/2 denetimi. | Liste boşken ölçüt: sayısallaştırılabilen, değerleri 0/1/2 olan sütunlar; adı <kromozom>_<konum>_<ad> olan varsa yalnız onlar (147–158). |
| 167–177 | Bireylerin süzülmesi; kimlik denetimleri. | Kimlik sütunu yoksa B0001, B0002 … adları verilir (175). |
| 179–202 | Marker süzgeçleri ve ortalama ile doldurma. | Frekans, yanıtı olan bireylerden hesaplanır. |
| 204–215 | Haritanın sütun adlarından okunması. | Harita, süzgeçten geçen bütün adlar biçime uyuyorsa var sayılır (206). |
| 217–235 | Akrabalık matrisi: hazır ya da hesaplanan. | Hazır matriste satırlar kimlik sütunuyla, sütunlar adın önekten sonraki kısmıyla eşleştirilir. |
| 237–249 | Ortak değişkenler ve temel bileşenler. | Ortak değişkenler pakete kv1, kv2 … adlarıyla geçer. |
| 251–282 | Tarama: createGData, runSingleTraitGwas; sonuç tablosu ve varyans bileşenleri. |
p değeri verilmeyen markerler düşer (279); m kalan sayıdır. |
| 283–309 | \lambda; genomik kontrol; q değerleri; eşikler ve anlamlı sayıları. | Sıra önemlidir: \lambda düzeltmeden önce, q düzeltmeden sonra. |
| 311–332 | Konsol özeti, özet tablosu, uyarı, en güçlü ilişkiler tablosu. | \lambda>1{,}1 ise uyarı (324). |
| 334–374 | Manhattan ve QQ grafikleri. | Kromozomlar arasına en büyük konumun %2'si kadar boşluk konur (340). |
aday <- names(df)[vapply(names(df), function(cn) {
  if (cn %in% dislanan || is.logical(df[[cn]])) return(FALSE)
  v <- tryCatch(mq_sayisal(df[[cn]], cn), error = function(e) NULL)
  if (is.null(v)) return(FALSE)
  w <- v[!is.na(v)]
  if (!length(w)) return(is.numeric(df[[cn]]))
  all(w %in% c(0, 1, 2))
}, TRUE)]
harita_gibi <- grepl(rx, aday, perl = TRUE)
if (any(harita_gibi) && !all(harita_gibi)) { marker_disi <- aday[!harita_gibi]; aday <- aday[harita_gibi] }
76.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bütün adımlar dogrulama/gwas/elle_hesap.py ile, statgenGWAS kullanılmadan, numpy ve scipy ile yeniden kurulmuştur: süzgeç, akrabalık formülleri, spektral REML olabilirliği (paketin ızgara ve daraltma kuralı ile birlikte), Cholesky ile beyazlatma, marker başına sınama, şişme katsayısı ve çoklu test. R tarafında (r_dogrulama.R) aynı adımlar taban R ile (eigen, chol, her marker için lm.fit, pf) yinelenmiş; REML'in tam en büyüğü ayrıca rrBLUP::mixed.solve ile hesaplanmıştır.
Adım 1 — Süzgeç. 246 bireyin hepsinde yanıt vardır. 2299 markerin çağrı oranı 1, en küçük MAF 0,0508'dir; hiçbiri atılmaz, doldurulacak hücre yoktur.
Adım 2 — Özdeğer ayrışımı. q=1 (yalnız kesişim). \mathbf S\mathbf K\mathbf S'nin sıfırdan farklı 245 özdeğeri 0,1164 ile 31,385 arasındadır.
Adım 3 — REML. Olabilirliğin tam en büyüğü tek boyutlu Brent aramasıyla \ln\hat\delta=-1{,}52664'te bulunur (\ell_R=-401{,}000284); olabilirlik bu noktanın çevresinde düzdür (\ell_R(-1{,}6)=-401{,}00527, \ell_R(-1{,}4)=-401{,}01654).
rrBLUP::mixed.solve 0,959229 ve 0,208415, şablonun varsayılan Newton–Raphson çözücüsü 0,959250 ve 0,208393 verir (göreli fark 1{,}5\cdot10^{-5}: yinelemenin yakınsama toleransı). reml_algo = EMMA seçilirse paketin ızgara kuralı \ln\hat\delta=-1{,}52361 noktasını döndürür (\hat\sigma^2_g=0{,}958744, \hat\sigma^2_e=0{,}208934; 76.4.3). Genomik kalıtım derecesi 0{,}959236/(0{,}959236+0{,}208407)=0{,}8215'tir (bu ölçeğin yorumu için Bölüm 75.4).
Adım 4 — Bir markerin sınanması. En güçlü marker PZE-106021410'da (6. kromozom) 71 hat 0, 4 hat 1, 171 hat 2 taşır; sayılan alelin frekansı (4+342)/492=0{,}7033'tür. İki homozigot sınıfın ham verim ortalaması 6,501 ve 7,800'dür; akrabalık hesaba katılmadan yapılan sıradan regresyon kopya başına 0,652 verir (p=1{,}7\cdot10^{-9}). GLS ile:
\text{KT}_0=n-q=245 olması rastlantı değildir: REML, \hat\sigma^2_g'yi tam bu eşitliği sağlayacak biçimde seçer. Akrabalık düzeltmesi etkiyi 0,652'den 0,527'ye indirmiştir: ham farkın bir bölümü, bu aleli taşıyan hatların birbirine akraba olmasından gelir. Etki ve standart hatadan hesaplanan Wald istatistiği (0{,}526585/0{,}104312)^2=25{,}484'dir ve ki-kare ile p=4{,}46\cdot10^{-7} verir; tablodaki p bundan küçüktür, çünkü F oranı artık varyansı \text{KT}_j/244=0{,}8997 olarak yeniden ölçekler (25{,}484/0{,}8997=28{,}33).
Adım 5 — Şişme katsayısı. 2299 p değerinin ki-kare karşılıklarının ortancası 0,44820'dir: \lambda=0{,}44820/0{,}45494=0{,}985183. Testler iyi ayarlanmıştır.
Adım 6 — Bonferroni. 0{,}05/2299=2{,}1749\cdot10^{-5} (-\log_{10}=4{,}6626). Beş marker eşiği geçer; hepsi 6. kromozomda 18,85–18,99 Mb arasındadır.
Adım 7 — Benjamini–Hochberg. Altıncı sıradaki marker (PZE-106021557, p=6{,}4038\cdot10^{-5}): q=6{,}4038\cdot10^{-5}\cdot2299/6=0{,}024537<0{,}05. Yedinci sıradaki (p=8{,}9783\cdot10^{-4}): 2299p/7=0{,}2949; ama dokuzuncu sıradaki marker daha küçük bir değer verdiğinden (2299\cdot1{,}0088\cdot10^{-3}/9=0{,}25768) yedinci, sekizinci ve dokuzuncu markerlerin q değeri 0,25768'dir. Altı marker q<0{,}05 koşulunu sağlar; yanlış keşif oranı çizgisi altıncı markerin p değerindedir.
Adım 8 — Storey. p değerlerinin 0,95'in üstünde kalan payından düzleştirilerek bulunan \hat\pi_0=1{,}111'tür; 1'e kırpılır ve Storey q değerleri Benjamini–Hochberg değerleriyle aynı olur.
76.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle okunmuştur. "En büyük farklı marker" satırları, ust_sayi = 5000 ile alınan ve bütün markerleri içeren tablo bağımsız Python hesabıyla marker marker karşılaştırıldığında farkı en büyük olan markeri gösterir; LOD satırlarında fark -\log_{10}p ölçeğindedir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Birey sayısı | 246 | 246 | 246 | 0 | ✓ |
| Sınanan marker sayısı | 2299 | 2299 | 2299 | 0 | ✓ |
| \hat\sigma^2_g (ızgara + daraltma kuralı) | 0,95874441 | 0,95874441 | 0,95874441 | 7,7e−15 | ✓ |
| \hat\sigma^2_e (ızgara + daraltma kuralı) | 0,20893386 | 0,20893386 | 0,20893386 | 1,6e−15 | ✓ |
| Şişme katsayısı \lambda | 0,98417637 | 0,98417637 | 0,98417637 | 6,6e−14 | ✓ |
| Bonferroni p eşiği | 2,174859·10−5 | 2,174859·10−5 | 2,174859·10−5 | 2,0e−20 | ✓ |
| Bonferroni LOD eşiği | 4,66256897 | 4,66256897 | 4,66256897 | 0 | ✓ |
| Bonferroni ile anlamlı marker | 5 | 5 | 5 | 0 | ✓ |
| BH ile anlamlı marker (q<0{,}05) | 6 | 6 | 6 | 0 | ✓ |
| BH p eşiği | 6,397040·10−5 | 6,397040·10−5 | 6,397040·10−5 | 7,6e−18 | ✓ |
| PZE-106021410: etki | 0,52660248 | 0,52660248 | 0,52660248 | 3,0e−14 | ✓ |
| PZE-106021410: SH | 0,10430961 | 0,10430961 | 0,10430961 | 5,0e−16 | ✓ |
| PZE-106021410: LOD | 6,63493504 | 6,63493504 | 6,63493504 | 6,4e−15 | ✓ |
| PZE-106021410: q (BH) | 2,647947·10−4 | 2,647947·10−4 | 2,647947·10−4 | 3,7e−17 | ✓ |
| PZE-106021410: R^2_{LR} | 0,09841894 | 0,09841894 | 0,09841894 | 1,1e−15 | ✓ |
| PZE-106021419: etki | 0,52501324 | 0,52501324 | 0,52501324 | 1,1e−14 | ✓ |
| PZE-106021419: SH | 0,10475189 | 0,10475189 | 0,10475189 | 1,9e−15 | ✓ |
| PZE-106021419: LOD | 6,54347045 | 6,54347045 | 6,54347045 | 8,4e−15 | ✓ |
| PZE-106021419: q (BH) | 2,647947·10−4 | 2,647947·10−4 | 2,647947·10−4 | 3,7e−17 | ✓ |
| PZE-106021419: R^2_{LR} | 0,09707262 | 0,09707262 | 0,09707262 | 1,5e−15 | ✓ |
| PZE-106021363: etki | 0,52166313 | 0,52166313 | 0,52166313 | 3,1e−14 | ✓ |
| PZE-106021363: SH | 0,10477249 | 0,10477249 | 0,10477249 | 1,4e−15 | ✓ |
| PZE-106021363: LOD | 6,46150836 | 6,46150836 | 6,46150836 | 1,0e−14 | ✓ |
| PZE-106021363: q (BH) | 2,647947·10−4 | 2,647947·10−4 | 2,647947·10−4 | 3,7e−17 | ✓ |
| PZE-106021363: R^2_{LR} | 0,09586311 | 0,09586311 | 0,09586311 | 1,6e−15 | ✓ |
| En küçük Storey q değeri (\hat\pi_0=1) | 2,647947·10−4 | 2,647947·10−4 | 2,647947·10−4 | 3,7e−17 | ✓ |
| 2299 markerde en büyük farklı marker: etki | −0,16571458 | −0,16571458 | — | 6,7e−13 | ✓ |
| 2299 markerde en büyük farklı marker: SH | 0,20972001 | 0,20972001 | — | 2,8e−14 | ✓ |
| 2299 markerde en büyük farklı marker: LOD | 1,694946·10−4 | 1,694946·10−4 | — | 1,6e−11 | ✓ |
| 2299 markerde en büyük farklı marker: q (BH) | 0,9996098 | 0,9996098 | — | 3,7e−11 | ✓ |
| 2299 markerde en büyük farklı marker: R^2_{LR} | 0,09586311 | 0,09586311 | — | 1,6e−15 | ✓ |
| 2299 markerde en büyük farklı marker: alel frekansı | 0,69715447 | 0,69715447 | — | 4,4e−16 | ✓ |
| Q+K (3 temel bileşen): \hat\sigma^2_g | 0,87071071 | 0,87071071 | 0,87071071 | 8,2e−15 | ✓ |
| Q+K (3 temel bileşen): \hat\sigma^2_e | 0,26226491 | 0,26226491 | 0,26226491 | 2,1e−15 | ✓ |
| Q+K (3 temel bileşen): \lambda | 0,95756384 | 0,95756384 | 0,95756384 | 2,5e−13 | ✓ |
| Q+K (3 temel bileşen): Bonferroni ile anlamlı | 5 | 5 | 5 | 0 | ✓ |
| Q+K (3 temel bileşen): en büyük farklı marker, LOD | 1,622439·10−4 | 1,622438·10−4 | — | 4,7e−11 | ✓ |
| Q+K (3 temel bileşen): en büyük farklı marker, etki | 0,13875607 | 0,13875607 | — | 6,2e−13 | ✓ |
| ortak değişken çiçeklenme: \hat\sigma^2_g | 0,96079512 | 0,96079512 | 0,96079512 | 1,3e−14 | ✓ |
| ortak değişken çiçeklenme: \hat\sigma^2_e | 0,14035212 | 0,14035212 | 0,14035212 | 1,7e−15 | ✓ |
| ortak değişken çiçeklenme: \lambda | 0,9788408 | 0,9788408 | 0,9788408 | 2,3e−13 | ✓ |
| ortak değişken çiçeklenme: Bonferroni ile anlamlı | 5 | 5 | 5 | 0 | ✓ |
| ortak değişken çiçeklenme: en büyük farklı marker, LOD | 3,023801·10−4 | 3,023801·10−4 | — | 2,0e−11 | ✓ |
| ortak değişken çiçeklenme: en büyük farklı marker, etki | −0,58117087 | −0,58117087 | — | 2,9e−9 | ✓ |
| özellik çiçeklenme: \hat\sigma^2_g | 3,96952864 | 3,96952864 | 3,96952864 | 1,9e−14 | ✓ |
| özellik çiçeklenme: \hat\sigma^2_e | 0,86505738 | 0,86505738 | 0,86505738 | 1,7e−14 | ✓ |
| özellik çiçeklenme: \lambda | 0,93146964 | 0,93146964 | 0,93146964 | 1,3e−13 | ✓ |
| özellik çiçeklenme: Bonferroni ile anlamlı | 1 | 1 | 1 | 0 | ✓ |
| özellik çiçeklenme: en büyük farklı marker, LOD | 7,403620·10−5 | 7,403626·10−5 | — | 6,4e−11 | ✓ |
| özellik çiçeklenme: en büyük farklı marker, etki | −0,84092354 | −0,84092354 | — | 4,6e−12 | ✓ |
| Astle–Balding akrabalığı (hesaplanan): \hat\sigma^2_g | 0,97373017 | 0,97373017 | 0,97373017 | 1,1e−14 | ✓ |
| Astle–Balding akrabalığı (hesaplanan): \hat\sigma^2_e | 0,21219962 | 0,21219962 | 0,21219962 | 2,2e−15 | ✓ |
| Astle–Balding akrabalığı (hesaplanan): \lambda | 0,90781212 | 0,90781212 | 0,90781212 | 3,2e−13 | ✓ |
| Astle–Balding akrabalığı (hesaplanan): Bonferroni ile anlamlı | 1 | 1 | 1 | 0 | ✓ |
| Astle–Balding akrabalığı (hesaplanan): en büyük farklı marker, LOD | 8,326104·10−5 | 8,326087·10−5 | — | 1,7e−10 | ✓ |
| Astle–Balding akrabalığı (hesaplanan): en büyük farklı marker, etki | 0,31132988 | 0,31132988 | — | 9,2e−13 | ✓ |
| VanRaden akrabalığı: \hat\sigma^2_g | 0,98770393 | 0,98770393 | — | 5,3e−15 | ✓ |
| VanRaden akrabalığı: \hat\sigma^2_e | 0,21524484 | 0,21524484 | — | 1,1e−15 | ✓ |
| VanRaden akrabalığı: \lambda | 0,9117058 | 0,9117058 | — | 2,9e−13 | ✓ |
| VanRaden akrabalığı: Bonferroni ile anlamlı | 1 | 1 | — | 0 | ✓ |
| VanRaden akrabalığı: en büyük farklı marker, LOD | 1,652654·10−5 | 1,652602·10−5 | — | 5,2e−10 | ✓ |
| VanRaden akrabalığı: en büyük farklı marker, etki | −0,09121899 | −0,09121899 | — | 9,8e−13 | ✓ |
| IBS akrabalığı: \hat\sigma^2_g | 1,29302635 | 1,29302635 | — | 1,2e−14 | ✓ |
| IBS akrabalığı: \hat\sigma^2_e | 0,23070364 | 0,23070364 | — | 3,3e−15 | ✓ |
| IBS akrabalığı: \lambda | 0,9115269 | 0,9115269 | — | 1,0e−13 | ✓ |
| IBS akrabalığı: Bonferroni ile anlamlı | 2 | 2 | — | 0 | ✓ |
| IBS akrabalığı: en büyük farklı marker, LOD | 5,203154·10−5 | 5,203156·10−5 | — | 2,1e−11 | ✓ |
| IBS akrabalığı: en büyük farklı marker, etki | −0,0921596 | −0,0921596 | — | 7,4e−15 | ✓ |
| LOCO (Astle–Balding): \hat\sigma^2_g | 0,96284816 | 0,96284816 | 0,96284816 | 4,3e−15 | ✓ |
| LOCO (Astle–Balding): \hat\sigma^2_e | 0,24635534 | 0,24635534 | 0,24635534 | 6,7e−16 | ✓ |
| LOCO (Astle–Balding): \lambda | 1,12538573 | 1,12538573 | 1,12538573 | 9,0e−14 | ✓ |
| LOCO (Astle–Balding): Bonferroni ile anlamlı | 6 | 6 | 6 | 0 | ✓ |
| LOCO (Astle–Balding): en büyük farklı marker, LOD | 9,045785·10−5 | 9,045798·10−5 | — | 1,3e−10 | ✓ |
| LOCO (Astle–Balding): en büyük farklı marker, etki | −0,20231217 | −0,20231217 | — | 5,7e−13 | ✓ |
| LOCO + genomik kontrol: Bonferroni ile anlamlı | 5 | 5 | 5 | 0 | ✓ |
| LOCO + genomik kontrol: BH ile anlamlı | 6 | 6 | 6 | 0 | ✓ |
| LOCO + genomik kontrol: en büyük farklı marker, LOD | 7,52307111 | 7,52307248 | — | 1,8e−7 | ✓ |
| MAC eşiği 40: sınanan marker | 2201 | 2201 | — | 0 | ✓ |
| MAC eşiği 40: en büyük farklı marker, etki | −0,02888516 | −0,02888516 | — | 3,8e−13 | ✓ |
| MAF eşiği 0,10: sınanan marker | 2115 | 2115 | — | 0 | ✓ |
| MAF eşiği 0,10: en büyük farklı marker, etki | −0,02888516 | −0,02888516 | — | 3,8e−13 | ✓ |
| eksik genotipli veri: sınanan marker | 2297 | 2297 | — | 0 | ✓ |
| eksik genotipli veri: en büyük farklı marker, etki | −0,07512531 | −0,07512531 | — | 4,1e−13 | ✓ |
| eksik genotipli veri, MAF eşiği 0,25: sınanan marker | 1358 | 1358 | — | 0 | ✓ |
| eksik genotipli veri, MAF eşiği 0,25: en büyük farklı marker, etki | −0,00387709 | −0,00387709 | — | 1,5e−13 | ✓ |
| 0/1 kodlu veri: sınanan marker | 2298 | 2298 | — | 0 | ✓ |
| 0/1 kodlu veri (etki = 1 kodlu sınıf farkı): en büyük farklı marker, etki | 1,02491134 | 1,02491134 | — | 2,2e−13 | ✓ |
| Eksik genotipli veri: birey | 240 | 240 | — | 0 | ✓ |
| Eksik genotipli veri: \hat\sigma^2_g | 0,97593989 | 0,97593989 | — | 1,0e−14 | ✓ |
| Satır sırası karıştırılmış veri: \lambda | 0,98417637 | 0,98417637 | 0,98417637 | 5,9e−13 | ✓ |
| Newton–Raphson: \hat\sigma^2_g ↔ REML'in tam en büyüğü | 0,95924977 | 0,95923615 | 0,95922856 | 2,1e−5 | ✓ |
| Newton–Raphson: \hat\sigma^2_e ↔ REML'in tam en büyüğü | 0,20839262 | 0,20840721 | 0,20841533 | 2,3e−5 | ✓ |
| Varsayılan çözücü (Newton–Raphson), VanRaden akrabalığı: \hat\sigma^2_g ↔ REML'in tam en büyüğü | 0,96692605 | 0,96692601 | — | 3,8e−8 | ✓ |
| Varsayılan çözücü, VanRaden akrabalığı: \hat\sigma^2_e ↔ REML'in tam en büyüğü | 0,23573761 | 0,23573764 | — | 3,8e−8 | ✓ |
| Varsayılan çözücü, VanRaden akrabalığı: Bonferroni ile anlamlı ↔ tam REML | 3 | 3 | — | 0 | ✓ |
| Örnek ayar (varsayılan çözücü): \hat\sigma^2_g ↔ REML'in tam en büyüğü | 0,95924977 | 0,95923615 | 0,95922856 | 2,1e−5 | ✓ |
| Örnek ayar (varsayılan çözücü): şişme katsayısı \lambda ↔ tam REML | 0,98521134 | 0,98518344 | — | 2,8e−5 | ✓ |
Ölçütü karşılayan: 97/97. Satırlar, reml_algo = EMMA seçilerek alınan çalıştırmalarla paketin ızgara çözücüsünü doğrular; "varsayılan çözücü" ve Newton–Raphson satırları (ölçüt 10^{-4}) varsayılan çözücüyü REML'in tam en büyüğüyle karşılaştırır. Python: REML için Kang ve ark. (2008) spektral olabilirliği, 100 aralıklı ızgara ve paketin aralık daraltma kuralı numpy ile yeniden yazılmıştır; her marker Cholesky ile beyazlatılmış veride Frisch–Waugh formülleriyle sınanır; BH elle. "En büyük farklı marker" satırları şablonun bütün markerleri içeren tablosu (ust_sayi = 5000) üzerinden en kötü durumu gösterir. R: aynı olabilirlik taban R ile, her marker için ayrı lm.fit, pf; Storey \hat\pi_0 smooth.spline ile açık formülden. Son iki satırda Python sütunu REML olabilirliğinin tam en büyüğü (Brent), R sütunu rrBLUP::mixed.solve sonucudur; Newton–Raphson seçeneği bu değere yinelemeli çözücünün toleransı kadar yaklaşır.
76.7 Çıktıyı okuma
Örnek ayarın konsol metni:
GWAS: 246 birey, 2299 marker sınandı (girdi 2299; çağrı oranı < 0,9: 0, MAF < 0,01: 0, tek biçimli: 0, bütünüyle eksik: 0);
akrabalık hazır (K_* sütunları); ortak değişken: yok
Not: lokus sütunları seçilmedi; 0/1/2 içeren 2299 sütun marker sayıldı.
Varyans bileşeni çözücüsü: Newton–Raphson (sommer); kısıtlı olabilirliğin en büyüğü.
Tablolar (kısaltılmış):
Özet: varyans bileşenleri (poligenik model, REML), şişme katsayısı λ ve eşikler
                 olcu        deger
              n_birey   246.000000
             m_marker  2299.000000
                   Vg     0.959250
                   Ve     0.208393
               lambda     0.985211
   bonferroni_p_esigi     0.000022
 bonferroni_LOD_esigi     4.662569
   anlamli_bonferroni     5.000000
           anlamli_BH     6.000000
           BH_p_esigi     0.000064

En güçlü 10 ilişki (etki: kodlanan alelin kopya başına etkisi; LOD = −log10 p)
            ad  krom      konum  alel_frek      etki        SH             p       LOD      q_BH     R2_LR  bonferroni_anlamli
 PZE-106021410     6   18990291   0.703252  0.526585  0.104313  2.321974e-07  6.634143  0.000265  0.098407                True
 PZE-106021419     6   18991091   0.739837  0.524993  0.104754  2.865920e-07  6.542736  0.000265  0.097062                True
 PZE-106021363     6   18846283   0.697154  0.521646  0.104775  3.461256e-07  6.460766  0.000265  0.095852                True
 PZE-106021424     6   18991481   0.741870  0.515369  0.104886  5.003975e-07  6.300685  0.000288  0.093481                True
 PZE-106021420     6   18991117   0.703252  0.495393  0.104454  1.282368e-06  5.891987  0.000590  0.087380                True
 PZE-106021557     6   19980743   0.788618  0.433556  0.109906  6.403961e-05  4.193551  0.024538  0.061298               False
 PZE-105145088     5  198818482   0.546748  0.291348  0.088460  8.978812e-04  3.046781  0.257682  0.043137               False
 …
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
Vg, Ve |
Poligenik modelin varyans bileşenleri | \text{Vg}/(\text{Vg}+\text{Ve}) akrabalık matrisinin ölçeğinde genomik kalıtım derecesidir. Vg sıfıra yakınsa akrabalık özelliği açıklamıyor demektir ve tarama sıradan regresyona yaklaşır. |
lambda |
Şişme katsayısı | 0,95–1,05 arası iyi ayar; 1,1'in üstü yetersiz düzeltme (uyarı yazılır); 0,9'un altı aşırı düzeltme ya da az marker. |
bonferroni_p_esigi, bonferroni_LOD_esigi |
\alpha/m ve eksi logaritması | Manhattan grafiğindeki kesikli çizgi. |
anlamli_bonferroni, anlamli_BH |
İki ölçüte göre anlamlı marker sayısı | Aynı bölgedeki markerler bağlantı dengesizliği yüzünden birlikte anlamlı çıkar; sayı bağımsız lokus sayısı değildir. |
BH_p_esigi |
q<\alpha olan en büyük p | Hiçbir marker anlamlı değilse boş kalır. |
alel_frek |
Sayılan alelin frekansı | Küçük alel frekansı değil; 0,5'ten büyük olabilir. Yalnız 0/1 kodlu veride 1 kodlu sınıfın oranıdır. |
etki, SH |
Sayılan alelin bir kopyasının etkisi ve standart hatası (yalnız 0/1 kodlu veride: 1 kodlu sınıf ile 0 kodlu sınıf farkı) | İşaret sayılan alele bağlıdır; hangi alelin sayıldığı veriyi hazırlayanın kodlamasından gelir. |
p, LOD |
F sınamasının p değeri ve -\log_{10}p | Genomik kontrol uygulandıysa düzeltilmiş değerler. |
q_BH, q_Storey |
Yanlış keşif oranı q değerleri | q=0{,}0245: bu marker ve daha güçlüleri anlamlı sayılırsa beklenen yanlış payı %2,5. |
R2_LR |
Markerin açıkladığı varyans payı | Seçilmiş en güçlü markerlerde yukarı yanlıdır ("kazananın laneti"). |
Şekil 76.1. Şablonun çizdiği Manhattan grafiği (örnek veri, tane verimi). Kesikli çizgi Bonferroni eşiği (-\log_{10}p=4{,}66), noktalı çizgi yanlış keşif oranı eşiğidir; beş turuncu nokta 6. kromozomda 18,85–18,99 Mb bölgesindeki anlamlı markerlerdir.
Şekil 76.2. QQ grafiği. Noktalar köşegeni izler (\lambda=0{,}985) ve yalnız sağ uçta, 6. kromozomdaki markerlerle yukarı ayrılır; gri kuşak %95'lik noktasal aralıktır.
Rapor cümlesi (örnek ayar):
Tane verimi için genom boyu ilişkilendirme, 246 hat ve 2299 SNP ile, akrabalığı Astle–Balding matrisiyle (36 624 SNP) hesaba katan karma modelle yapıldı; varyans bileşenleri poligenik modelde REML ile bir kez kestirildi (\hat\sigma^2_g = 0{,}959; \hat\sigma^2_e = 0{,}208) ve her marker GLS ile sınandı. Şişme katsayısı 0,99 idi. Bonferroni eşiğini (p < 2{,}17 \times 10^{-5}) 6. kromozomda 18,85–18,99 Mb arasındaki beş SNP geçti; en güçlü ilişki PZE-106021410 belirtecindeydi (kopya başına etki 0,53; SH 0,10; p = 2{,}3 \times 10^{-7}; R^2_{LR} = 0{,}098).
76.8 Sık hatalar ve tuzaklar
- Marker listesini boş bırakıp tabloda marker olmayan 0/1/2 sütunlar taşımak. Kendiliğinden seçim değerlere ve adlara bakar: adı
<kromozom>_<konum>_<ad>biçiminde olan sütun varsa yalnız onlar marker sayılır; cinsiyet (0/1), blok (1/2), yıl göstergesi gibi sütunlar atlanır ve konsola adları yazılır (örnek veriyecinsiyetveblokeklendiğinde 2299 marker sınanır, harita ve Manhattan grafiği değişmez). Adları harita biçiminde olmayan veride ölçüt yalnız değerlerdir: 0/1/2 içeren her sütun marker sayılır ve ilk adları konsola yazılır; marker olmayan sütun varsa markerler elle işaretlenir ya da o sütun ortak değişken olarak seçilir. - Marker sütununun veri sekmesinde "kategorik" türde kalması. Değerleri 0/1/2 olan kategorik türdeki sütun da marker sayılır (kendiliğinden seçimde ve elle seçimde); değerleri sayıya çevrilemeyen sütun atlanır ya da elle seçilmişse hata verir. Konsoldaki "… sütun marker sayıldı" sayısı beklenen marker sayısıyla karşılaştırılır.
reml_algo = EMMAseçip varyans bileşenlerini kesin REML kestirimi saymak. EMMA seçeneği \ln\delta'yı 0,2 adımlı bir ızgaraya bağlı olarak verir (76.4.3); şablonun varsayılanı (Newton–Raphson) tam en büyüğü verir. Fark çoğu kez önemsizdir (örnek ayarda en büyük göreli p farkı %0,3), ama eşiğe yakın markerlerde kararı değiştirebilir: 2299 markerden hesaplanan VanRaden matrisiyle EMMA Bonferroni eşiğini geçen 1 marker, tam en büyük 3 marker verir; p değerleri %10'a kadar ayrışır. EMMA seçildiğinde çıktı bunu not eder; sonuç eşiğe yakınsa ya da \hat\sigma^2_g, \hat\sigma^2_e raporlanacaksa varsayılan çözücü kullanılır.- Yalnız 0 ve 1 kodlu veride etkiyi "kopya başına" okumak. Şablon bu kodlamayı 0/2 ölçeğine çevirip tarar ve konsola yazar; tablodaki etki ve SH, 1 kodlu sınıf ile 0 kodlu sınıf arasındaki farktır (örnekte
PZE-106021410için 1,015 ve 0,207; aynı veride 0/2 kodlamasının kopya başına etkisi 0,527 ve 0,104'tür). Kendilenmiş hatlar 0/2 ile kodlandığında etki kopya başınadır; kodlamayı raporda belirtin. - Az markerle akrabalık hesaplamak. Birkaç yüz ya da birkaç bin marker akrabalığı kaba ölçer; düzeltme hem yetersiz hem gürültülü olur. Tam marker kümesinden hesaplanmış bir matris
K_sütunlarıyla verilir. - \lambda>1{,}1 uyarısını yalnız genomik kontrolle gidermek. Genomik kontrol bütün markerleri aynı oranda küçültür; yapının markerden markere değişen etkisini düzeltmez. Önce temel bileşen eklenir (3–5) ve \lambda yeniden okunur.
- Genomik kontrolü açıp \lambda'nın 1'e inmesini beklemek. Özet tablosundaki \lambda her zaman düzeltme öncesidir; düzeltmenin yapıldığı konsol notundan ve QQ grafiğinin açıklamasından anlaşılır. \lambda_{GC}\le1 ise düzeltme hiç yapılmaz.
- Aynı bölgedeki beş anlamlı markeri beş ayrı lokus saymak. Örnekteki beş marker 150 kb içindedir ve tek bir tepe oluşturur. Bağımsız lokus sayısı için tepeler bağlantı dengesizliğine göre gruplanır (
bag_dengesizligi). - Tekrarlı gözlemleri satır satır vermek. Kimlik yinelenirse şablon durur. Hat ortalamaları ya da karma modelden elde edilen düzeltilmiş ortalamalar verilir; tekrar sayısı hatlar arasında çok farklıysa bu şablon ağırlık tanımadığından sonuç yaklaşık kalır.
- Kategorik ortak değişken. Ortak değişkenler sayısal olmalıdır; kategorik bir etken (deneme, alt popülasyon) 0/1 gösterge sütunlarına çevrilir. Sabit bir sütun (ya da başka sütunların birleşimi olan bir sütun) ortak değişken seçilirse çalıştırma, ortak değişkenlerin doğrusal bağımlı olduğunu söyleyen bir iletiyle durur.
- Hazır matrisle LOCO istemek. Kromozoma özgü düzen matrisi markerlerden kendisi kurar; hazır matrisle birlikte seçilemez (ileti, satır 265).
- Etkinin işaretini alel adına bağlamadan raporlamak. Tabloda sayılan alelin kimliği yoktur. Hangi alelin 2 ile kodlandığı veri hazırlama aşamasından alınır ve raporda belirtilir.
76.9 Uzman soruları
S1. Varyans bileşenleri her marker için yeniden kestirilmiyor; bu ne kadar hata getirir?
Yaklaşım, markerin açıkladığı varyans küçükken iyidir: \hat\delta markersiz modeldekiyle neredeyse aynı kalır. Büyük etkili bir markerde poligenik modelin \hat\sigma^2_g'si o markerin varyansını da içerir; marker modele girdiğinde gerçek \sigma^2_g daha küçük olmalıdır. Sabit tutulan büyük \hat\sigma^2_g sınamayı tutucu yapar, yani güç kaybedilir; yanlış pozitif artmaz. Örnekte en güçlü markerin R^2_{LR}'si 0,098'dir; bu düzeyde kayıp küçüktür. Tek tek markerlerde tam çözüm gerekiyorsa marker ortak değişken olarak eklenip poligenik model yeniden kestirilebilir.
S2. `reml_algo = EMMA` seçersem döndürdüğü \hat\delta neden olabilirliğin tam en büyüğü değil ve bunu nasıl anlarım?
Paketin EMMA çözücüsü türevin işaret değiştirdiği 0,2 genişliğindeki parçayı bulduktan sonra içinde tam bir tek boyutlu arama yapmaz; parçanın 0,382'sindeki noktayı ya da sol ucuna yakın bir noktayı döndürür. Dönen \ln\hat\delta değerlerinin kesir kısmı bunu ele verir: EMMA ile alınan örnek çalıştırmalarda -1{,}52361, -1{,}72361, -1{,}92361, -2{,}52361. Olabilirlik en büyüğün çevresinde düz olduğundan \ell_R kaybı küçüktür (örnekte 9\cdot10^{-6} ile 0,015 arası), ama \hat\sigma^2_e %10'a kadar kayabilir (ortak değişkenli çalıştırmada 0,1404 ve 0,1532). Şablonun varsayılan çözücüsü Newton–Raphson'dur ve bu sorunu taşımaz; denetim için aynı ayar iki çözücüyle yinelenir.
S3. Serbestlik derecesi neden n-q-1? Akrabalık serbestlik derecesini azaltmaz mı?
F sınaması beyazlatılmış veride yapılır; \hat{\mathbf V} biliniyor sayıldığında beyazlatılmış artıklar bağımsızdır ve paydanın serbestlik derecesi gözlem sayısı eksi sabit etki sayısıdır. Gerçekte \hat{\mathbf V} kestirilmiştir ve bu belirsizlik hesaba katılmaz; yüzlerce birey varken etkisi önemsizdir, küçük örneklemde p değerleri bir miktar iyimser olur. Şablonun en az 20 birey koşulu bir alt sınırdır, öneri değildir.
S4. Astle–Balding ile VanRaden arasında sonuç neden değişiyor?
İki matris markerleri farklı ağırlıklar: Astle–Balding her markeri 1/\big(2p(1-p)\big) ile, VanRaden eşit ağırlıkla toplar. Nadir alellerin çok olduğu veride fark büyür. Örnekte hesaplanan iki matrisle \lambda 0,912 ve 0,915, Bonferroni ile anlamlı marker sayısı 1 ve 3'tür; en güçlü markerler aynıdır, fark üçüncü anlamlı markerin eşiği geçip geçmemesindedir. Hangi matrisin "doğru" olduğu, nedensel varyantların etkilerinin frekansla nasıl değiştiğine ilişkin varsayıma bağlıdır; pratikte seçim sonucu belirlememelidir, belirliyorsa bulgu sağlam değildir.
S5. IBS seçeneği gerçekten durumca özdeşlik payını mı hesaplıyor?
Hayır. Formül x 0–1 ölçeğindeyken iki bireyin alel paylaşımını verir; şablon 0/1/2 ölçeğindeki matrisi geçirdiğinden öğeler pay değildir (iki bireyin de 2 taşıdığı marker 5, ikisinin de 0 taşıdığı marker 1, zıt homozigotlar -1 katkı yapar). Karma model açısından bu fark önemsizdir: kesişimli modelde matrisin yalnız merkezlenmiş kısmı etkilidir ve bu kısım VanRaden matrisiyle orantılıdır (76.4.2). Sayılan alelin değiştirilmesi de sonucu etkilemez; her ikinci markerin kodu çevrilmiş veride aynı p değerleri alınmıştır. Matrisin kendisi akrabalık katsayısı olarak okunmaz.
S6. Kaç temel bileşen eklenmeli?
Kural yoktur; ölçüt \lambda ve QQ grafiğidir. Bileşen eklemek yapıyı düzeltir, ama yapıyla ilişkili gerçek etkileri de siler ve her bileşen bir serbestlik derecesi harcar. Örnekte üç bileşen \lambda'yı 0,985'ten 0,959'a indirir ve Bonferroni ile anlamlı marker sayısını değiştirmez: akrabalık matrisi yapıyı zaten karşılamıştır. \lambda 1'in altına iniyorsa bileşen sayısı azaltılır.
S7. Bonferroni eşiğinde m sınanan marker sayısı; bağlantı dengesizliği varken bu çok tutucu değil mi?
Tutucudur. Etkin bağımsız test sayısı m'den küçüktür ve onu marker korelasyon matrisinin özdeğerlerinden kestiren yöntemler vardır; şablon bunları uygulamaz. Seyrek marker kümesinde (örnekte kromozom başına ortalama 230) markerler arası korelasyon düşüktür ve fark küçüktür; yoğun dizilerde eşik belirgin biçimde gevşetilebilir. Yanlış keşif oranı çizgisi bu soruna duyarsızdır ve aday listesi için daha uygundur.
S8. q değerleri gerçekten düzeltilmiş mi, yoksa ham p mi?
Düzeltilmiştir. q_BH sütunu Benjamini–Hochberg yükselen yordamının düzeltilmiş p değeridir; bağımsız hesapla 2299 markerin hepsinde aynı değerler bulunmuştur (76.6.1). q_Storey buna \hat\pi_0 çarpanını uygular; \hat\pi_0=1 iken iki sütun aynıdır. Genomik kontrol açıksa her ikisi de düzeltilmiş p değerlerinden hesaplanır. bonferroni_anlamli sütunu ise düzeltilmiş bir p değil, ham p'nin \alpha/m ile karşılaştırmasıdır.
S9. QQ grafiğinde noktalar kuşağın dışına çıktı; bu şişme midir?
Kuşak noktasaldır: 2299 noktanın yaklaşık %5'inin rastlantıyla dışarıda kalması beklenir. Şişmenin göstergesi tek tek noktalar değil, eğrinin baştan itibaren köşegenden sistemli ayrılmasıdır ve \lambda bunu ölçer. Yalnız en sağdaki birkaç noktanın kuşağın üstüne çıkması, az sayıda gerçek ilişkinin beklenen görüntüsüdür.
76.10 Kaynaklar
- Astle, W., & Balding, D. J. (2009). Population structure and cryptic relatedness in genetic association studies. Statistical Science, 24(4), 451–471. https://doi.org/10.1214/09-STS307
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B, 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Devlin, B., & Roeder, K. (1999). Genomic control for association studies. Biometrics, 55(4), 997–1004. https://doi.org/10.1111/j.0006-341X.1999.00997.x
- Kang, H. M., Sul, J. H., Service, S. K., Zaitlen, N. A., Kong, S.-Y., Freimer, N. B., Sabatti, C., & Eskin, E. (2010). Variance component model to account for sample structure in genome-wide association studies. Nature Genetics, 42(4), 348–354. https://doi.org/10.1038/ng.548
- Kang, H. M., Zaitlen, N. A., Wade, C. M., Kirby, A., Heckerman, D., Daly, M. J., & Eskin, E. (2008). Efficient control of population structure in model organism association mapping. Genetics, 178(3), 1709–1723. https://doi.org/10.1534/genetics.107.080101
- Millet, E. J., Welcker, C., Kruijer, W., Negro, S., Coupel-Ledru, A., Nicolas, S. D., Laborde, J., Bauland, C., Praud, S., Ranc, N., Presterl, T., Tuberosa, R., Bedo, Z., Draye, X., Usadel, B., Charcosset, A., van Eeuwijk, F., & Tardieu, F. (2016). Genome-wide analysis of yield in Europe: Allelic effects vary with drought and heat scenarios. Plant Physiology, 172(2), 749–764. https://doi.org/10.1104/pp.16.00621
- Price, A. L., Patterson, N. J., Plenge, R. M., Weinblatt, M. E., Shadick, N. A., & Reich, D. (2006). Principal components analysis corrects for stratification in genome-wide association studies. Nature Genetics, 38(8), 904–909. https://doi.org/10.1038/ng1847
- Storey, J. D., & Tibshirani, R. (2003). Statistical significance for genomewide studies. Proceedings of the National Academy of Sciences, 100(16), 9440–9445. https://doi.org/10.1073/pnas.1530509100
- Sun, G., Zhu, C., Kramer, M. H., Yang, S.-S., Song, W., Piepho, H.-P., & Yu, J. (2010). Variation explained in mixed-model association mapping. Heredity, 105(4), 333–340. https://doi.org/10.1038/hdy.2010.11
- VanRaden, P. M. (2008). Efficient methods to compute genomic predictions. Journal of Dairy Science, 91(11), 4414–4423. https://doi.org/10.3168/jds.2007-0980
- van Rossum, B.-J., & Kruijer, W. (2026). statgenGWAS: Genome wide association studies (R paketi, sürüm 1.0.14). Comprehensive R Archive Network.
- Yang, J., Zaitlen, N. A., Goddard, M. E., Visscher, P. M., & Price, A. L. (2014). Advantages and pitfalls in the application of mixed-model association methods. Nature Genetics, 46(2), 100–106. https://doi.org/10.1038/ng.2876
- Yu, J., Pressoir, G., Briggs, W. H., Vroh Bi, I., Yamasaki, M., Doebley, J. F., McMullen, M. D., Gaut, B. S., Nielsen, D. M., Holland, J. B., Kresovich, S., & Buckler, E. S. (2006). A unified mixed-model method for association mapping that accounts for multiple levels of relatedness. Nature Genetics, 38(2), 203–208. https://doi.org/10.1038/ng1702
- Zhang, Z., Ersoz, E., Lai, C.-Q., Todhunter, R. J., Tiwari, H. K., Gore, M. A., Bradbury, P. J., Yu, J., Arnett, D. K., Ordovas, J. M., & Buckler, E. S. (2010). Mixed linear model approach adapted for genome-wide association studies. Nature Genetics, 42(4), 355–360. https://doi.org/10.1038/ng.546