21. Doğrusal kantil karma model (lqmm)
Şablon kimliği: karma_kantil · Kategori: karma model · Dil: R · Dosya: pro/sablonlar/karma_model/karma_kantil.R (satır 1–262; üstbilgi 1–161) · Örnek veri: _ornek/orthodont_kiz.csv · Paketler: lqmm 1.5.8
21.1 Ne işe yarar
Şablon, aynı kümeden (denek, okul, parsel) birden çok ölçüm alınan verilerde yanıtın koşullu kantilini (ortanca, alt ya da üst çeyrek, kuyruklar) açıklayıcı değişkenlerin doğrusal işlevi olarak kestirir ve kümeler arası farkı rastgele etkiyle hesaba katar. Cevapladığı soru şudur: "Açıklayıcı değişken, yanıt dağılımının ortasını değil de seçilen bir kantilini nasıl kaydırıyor ve bu etki kümeler arasındaki bağımlılık gözetildiğinde ne kadar kesin?"
- y_{ij}: i. kümenin j. gözlemi; Q_\tau(\cdot\mid\mathbf u_i): rastgele etki verildiğinde \tau. koşullu kantil (0<\tau<1).
- \boldsymbol\beta_\tau: \tau'ya özgü sabit etkiler. Her \tau için ayrı bir model uydurulur; katsayılar \tau ile değişebilir.
- \mathbf u_i: kümeye özgü rastgele kesişim (ve seçilirse rastgele eğim); \boldsymbol\Psi_\tau: kovaryans matrisi. Yalnız rastgele kesişim varsa tek bir varyanstır: \psi^2.
Model, Geraci ve Bottai'nin (2007, 2014) doğrusal kantil karma modelidir; kestirim asimetrik Laplace olabilirliğine dayanır ve rastgele etkiler sayısal karelemeyle bütünleştirilir.
Ne zaman kullanılır? Tekrarlı ölçümlü ya da kümelenmiş veride ilgi ortalamada değil dağılımın belirli bir yerindeyse (büyüme eğrisinde alt %10, maruz kalımda üst %90); yanıt çarpık ya da aykırı değerliyse ve ortancaya dayalı sağlam bir özet isteniyorsa; açıklayıcı değişkenin etkisinin dağılım boyunca değişip değişmediği sorulacaksa (kantil süreci).
Ne zaman kullanılmaz?
- Gözlemler bağımsızsa (küme yok): temel programdaki Kantil Regresyon.
- İlgi koşullu ortalamadaysa ve artıklar yaklaşık normalse: temel programdaki LMM (Doğrusal Karma Modeller).
- Yanıt sağdan sansürlü bir süreyse ya da doğrusal olmayan (düzgünleştirilmiş) bir kantil eğrisi gerekiyorsa:
kantil_ilerişablonu. - Yanıt sayım, ikili ya da sıralı ise: asimetrik Laplace olabilirliği sürekli yanıt içindir; temel programdaki GLMM (Genelleştirilmiş Doğrusal Karma Modeller).
- Küme sayısı çok azsa (şablon en az 3 ister, ama rastgele etki varyansı ve küme bootstrap'ı için onlarca küme gerekir).
Temel programla ilişki. Temel programdaki Kantil Regresyon bağımsız gözlemler için doğrusal programlamayla kesin çözüm verir ve rastgele etki içermez. Bu şablon aynı denetim işlevini bir olabilirliğin içine yerleştirir, kümeye özgü rastgele etkileri ekler ve standart hataları küme bootstrap'ıyla verir.
21.2 Şablonun girdileri
Form, üstbilgideki 20 [[param]] bloğundan kurulur (karma_kantil.R:11–160).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal | Modelin sol yanı (187). |
Sabit etkiler · x |
sütunlar · Değişkenler | — | en az 1 sütun | Sağ yan; metin ve mantıksal sütunlar faktöre çevrilir (179–184). |
Küme (rastgele etki grubu) · grup |
kategorik sütun · Değişkenler | — | herhangi bir sütun | group = .grup (176, 206). |
Kantil düzeyi τ · tau |
ondalık · Model | 0,5 | 0,01–0,99 | Ana modelin kantili (210). |
Rastgele eğim değişkeni (isteğe bağlı) · egim |
sayısal sütun · Değişkenler | boş | sayısal | random = ~ egim; boşsa ~ 1 (191). mq_sayisal ile okunur (172). |
Rastgele etki kovaryansı · kovaryans |
seçim · Model | pdDiag |
pdDiag, pdIdent, pdSymm |
Yalnız rastgele eğim varken kullanılır; yoksa pdIdent (189). |
Kareleme düğüm sayısı · nK |
tamsayı · Gelişmiş | 7 | 3–15 | Her rastgele etki boyutunda düğüm sayısı (206). Form açıklaması sonucun düğüm sayısına duyarlı olabileceğini ve 9, 11, 15 ile yinelenmesini söyler (56; 21.8). |
Gradyan arama yakınsama eşiği · yakinsama |
seçim · Gelişmiş | paket |
paket (1e-5), siki (1e-7) |
LP_tol_ll (190–191). |
Küme bootstrap yineleme sayısı (SH için) · B |
tamsayı · Seçenekler | 200 | 20–2000 | summary(m, R = B) (215). |
Beş kantilde (0,1-0,9) katsayıları karşılaştır · kantil_sureci |
onay · Çıktı | açık | açık / kapalı | Kantil süreci tablosu ve grafiği (251–260). |
Rastgele etki dağılımı · re_dagilim |
seçim · Model | normal |
normal, robust |
type: normal (Gauss–Hermite) ya da Laplace (Gauss–Laguerre) (206). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | alpha = 1 − guven (215). |
Bootstrap tohumu · boot_tohum |
tamsayı · Gelişmiş | 1 | 1–2 147 483 647 | seed (215). |
Kantil süreci için τ değerleri · kantiller |
metin · Çıktı | 0.1, 0.25, 0.5, 0.75, 0.9 |
(0, 1) içinde en az iki sayı | Süreç tablosunun satırları (199–202). |
Kestirim algoritması · yontem |
seçim · Gelişmiş | gs |
gs, df |
Gradyan araması ya da Nelder–Mead (193). |
En çok yineleme (alt düzey) · maks_yineleme |
tamsayı · Gelişmiş | 1000 | 10–100 000 | LP_max_iter (191–192). |
Katsayı değişim toleransı · tol_theta |
ondalık · Gelişmiş | 0,00001 | 10^{-12}–0,1 | LP_tol_theta (194). |
En çok yineleme (ölçek döngüsü) · ust_maks_yineleme |
tamsayı · Gelişmiş | 20 | 1–10 000 | UP_max_iter (196). |
Ölçek değişim toleransı · ust_tol |
ondalık · Gelişmiş | 0,0001 | 10^{-12}–0,1 | UP_tol (195). |
Başlangıç değeri: kantil regresyonu · qr_baslangic |
onay · Gelişmiş | kapalı | açık / kapalı | startQR = TRUE (197); kapalıyken en küçük kareler. |
Örnek ayar (satır 9): y = distance, x = [age_c], grup = Subject, tau = 0,5, B = 50 (varsayılan 200'den farklı); öteki alanlar varsayılandadır.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 165 |
| Yanıt ve küme dışında sabit etki kalmadı | "en az bir sabit etki seçin" | 167–168 |
| Rastgele eğim değişkeni yanıtın kendisi | "yanıttan farklı olmalı" | 169 |
| Tam satır sayısı < 10 | "En az 10 tam satır gerekli." | 174 |
| Yanıt sabit | "Yanıt sabit." | 175 |
| Küme düzeyi < 3 | "Kümede en az 3 düzey gerekli." | 177 |
| Gözlem sayısı ≤ küme sayısı | "Kümelerde tekrarlı gözlem yok" | 178 |
| Bir sabit etki sabit ya da tek düzeyli | "sabit (tek düzeyli); sabit etkilerden çıkarın" | 182–183 |
| Rastgele eğim değişkeni sabit | "Rastgele eğim değişkeni sabit." | 185 |
| Yanıtta ya da rastgele eğim değişkeninde sayı olmayan değer | "… sütunu sayıya çevrilemedi …" (Bölüm 1.5) | 171–172 |
| Süreç için τ listesi geçersiz | "0 ile 1 arasında en az iki sayı olmalı" | 200–201 |
lqmm hata verdi |
"Model kurulamadı: …" | 208 |
| Katsayılar sonlu değil | "model yakınsamadı" | 214 |
Eksik değer: seçilen sütunlardan herhangi biri eksik olan satır atılır (173). lqmm'in yakınsama uyarıları durdurmaz; toplanıp çıktının sonunda "Uyarılar:" satırında yazılır (209, 261).
21.3 Örnek veri
Dosya: _ornek/orthodont_kiz.csv: Potthoff ve Roy'un (1964) diş hekimliği büyüme verisinin 11 kız çocuğundan oluşan alt kümesi; Geraci'nin (2014) lqmm örneğinde kullanılan veridir. Her çocukta 8, 10, 12 ve 14 yaşlarında hipofiz ile pterigomaksiller yarık arasındaki uzaklık (mm) ölçülmüştür. 44 satır, eksik değer yok.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
distance |
Yanıt | sayısal | 16,5–28,0 mm; ortanca 22,75. |
age |
— | sayısal | 8, 10, 12, 14. |
Subject |
Küme | kategorik | 11 düzey; arayüz sırası F01, F02, …, F11 (ilk görülme). |
Sex |
— | kategorik | Tek düzey (Female). |
age_c |
Sabit etki | sayısal | age − 11: −3, −1, 1, 3. |
Yaşa göre ortanca uzaklık 21,0; 22,5; 23,0; 24,0 mm'dir. age_c merkezlenmiş olduğundan kesişim, 11 yaşındaki koşullu kantildir. Küme düzeylerinin sırası kestirimleri etkilemez; yalnız bootstrap'ın hangi kümeleri çektiğini belirler.
Çalıştırmalar: (1) örnek ayar (kantil süreci açık); (2) \tau=0{,}75, süreç kapalı; (3) sıkı yakınsama eşiği; (4) Nelder–Mead algoritması; (5) düğüm sayısı 9, 11 ve 15; (6) rastgele eğim (egim = age_c).
21.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) veri ve formül kurulur; (2) seçilen \tau için model uydurulur: sabit etkiler ve rastgele etki varyansı iç döngüde, ölçek parametresi dış döngüde güncellenir; (3) küme bootstrap'ıyla standart hata, güven aralığı ve p hesaplanır; (4) varyans bileşenleri, sınıf içi korelasyon ve uyum ölçüleri yazılır; (5) istenirse aynı model bir dizi \tau için yeniden uydurulur.
21.4.1 Denetim işlevi ve asimetrik Laplace dağılımı
- \rho_\tau: denetim (check) işlevi; pozitif artığı \tau, negatif artığı 1-\tau ile ağırlıklandırır. \tau=0{,}5'te \rho_\tau(r)=\lvert r\rvert/2'dir.
- f: konum \mu, ölçek \sigma>0 ve çarpıklık \tau parametreli asimetrik Laplace (AL) yoğunluğu. P(y\le\mu)=\tau'dur: \mu, dağılımın \tau. kantilidir.
Neden asimetrik Laplace?
\sum\rho_\tau(y_i-\mu_i)'yi en küçük yapmak kantil regresyonun tanımıdır (Koenker ve Bassett, 1978); bu toplam ile AL olabilirliği arasındaki bağı Yu ve Moyeed (2001) kurmuştur. AL yoğunluğunun logaritması bu toplamın eksi işaretlisidir; yani AL olabilirliğini en büyük yapmak ile denetim işlevi toplamını en küçük yapmak aynı \boldsymbol\beta'yı verir. Olabilirlik biçimi, rastgele etkileri eklemeyi ve bütünleştirmeyi mümkün kılar. AL bir çalışma olabilirliğidir: verinin gerçekten AL dağıldığı varsayılmaz, bu yüzden standart hatalar olabilirlikten değil bootstrap'tan alınır.
21.4.2 Marjinal olabilirlik ve Gauss–Hermite karelemesi
Rastgele kesişimli modelde i. kümenin olabilirliğe katkısı, rastgele etki üzerinden bir integraldir ve K düğümlü karelemeyle yaklaşık hesaplanır:
- \phi: standart normal yoğunluk; \psi=\sqrt{\psi^2}: rastgele kesişimin standart sapması.
- (v_k,w_k): standart normal ağırlıklı Gauss–Hermite düğümleri ve ağırlıkları; \sum_kw_k=1. K=7 için düğümler 0;\ \pm1{,}154405;\ \pm2{,}366759;\ \pm3{,}750440, ağırlıklar 0{,}457143;\ 0{,}240123;\ 0{,}030757;\ 0{,}000548.
- M: küme sayısı; n_i: i. kümedeki gözlem sayısı. İki rastgele etki varsa düğümler çarpım ızgarasıdır (K^2 nokta).
Koddaki tercih
lqmm(fixed, random, group, tau, nK = P$nK, type = P$re_dagilim, covariance = kov, …) (satır 206–207). Kareleme uyarlamalı değildir: düğümler her küme için aynı yerdedir ve \psi ile ölçeklenir. Düğüm sayısının sonuca etkisi 21.8'de sayılarla gösterilmiştir.
21.4.3 Kestirim algoritması
Parametreler iki öbekte güncellenir. İç döngü \sigma sabitken \boldsymbol\theta=(\boldsymbol\beta,\psi^2) üzerinde gradyan araması yapar: olabilirliğin (alt)gradyanı yönünde bir adım atılır; adım olabilirliği artırmazsa adım boyu yarıya indirilir. Döngü, log-olabilirlikteki değişim "yakınsama eşiği"nin ya da adım "katsayı değişim toleransı"nın altına düşünce durur. Dış döngü bulunan \boldsymbol\theta'da \sigma'yı tek değişkenli arama ile günceller ve \lvert\sigma^{(r+1)}-\sigma^{(r)}\rvert "ölçek değişim toleransı"ndan küçük olunca biter.
Başlangıç değerleri (kantil regresyonu başlangıcı kapalıyken):
- \hat{\boldsymbol\beta}_{\text{EKK}}: rastgele etkisiz en küçük kareler katsayıları; \overline{r^2}: onun artık kareleri ortalaması.
- 8: \tau=0{,}5'te AL varyansının \sigma^2'ye oranı (21.4.4); başlangıç ölçeği, artık varyansını ortanca AL dağılımının varyansına eşitler.
Paketin varsayılanı ile şablonun tercihi
lqmmControl'ün iç döngü yineleme sınırı paket varsayılanında 500'dür; şablon 1000 verir (satır 191). Öteki denetim değerleri (eşik 10^{-5}, katsayı toleransı 10^{-5}, ölçek toleransı 10^{-4}, dış döngü sınırı 20) paket varsayılanıdır ve yalnız formda değiştirilince çağrıya eklenir (192–197). Böylece çağrı, yayımlanmış örneğin çağrısıyla aynı sayıları üretir.
Neden iki ayrı algoritma seçeneği var?
Log-olabilirlik \boldsymbol\beta'da parçalı doğrusal terimlerin üstel toplamıdır; pürüzsüz değildir ve birden çok yerel en büyüğü olabilir. Gradyan araması hızlıdır ama bir yerel en büyüğün yakınında, eşiğe ulaşınca durur. Nelder–Mead (Nelder ve Mead, 1965) türev kullanmaz, daha yavaştır ve aynı başlangıçtan farklı bir noktaya gidebilir. İki algoritmanın sonuçlarını karşılaştırmak, kestirimin başlangıca ve algoritmaya ne kadar duyarlı olduğunu gösterir (21.6, Adım 6).
21.4.4 Hata standart sapması ve sınıf içi korelasyon
- \operatorname{Var}_{AL}: ölçeği \sigma olan AL dağılımının varyansı (
varAL; satır 228). \tau=0{,}5'te 8\sigma^2, \tau=0{,}75'te 17{,}78\,\sigma^2'dir. - SKK: sınıf içi korelasyon; toplam değişkenliğin kümeler arası payı (satır 232–233).
Neden σ doğrudan hata standart sapması değil?
\sigma, AL yoğunluğunun ölçek parametresidir ve dağılımın yayılımını \tau'ya bağlı bir çarpanla belirler. İki farklı \tau'nın \sigma'ları karşılaştırılamaz; karşılaştırılabilir büyüklük \sqrt{\operatorname{Var}_{AL}}'dir. Şablon bu yüzden ikisini de yazar. SKK de AL çalışma modeline göre hesaplanır; normal kuramlı karma modelin SKK'sıyla aynı büyüklük değildir.
21.4.5 Küme bootstrap'ı: standart hata, güven aralığı, p
- \hat\beta_j^{*b}: b. bootstrap örnekleminde yeniden kestirilen katsayı. Her örneklemde M küme yerine koyarak çekilir; çekilen kümenin bütün gözlemleri birlikte gelir (küme ağırlığı = çekilme sayısı).
- B: yineleme sayısı; t dağılımının serbestlik derecesi B-1'dir. Yeniden uydurması başarısız olan yinelemeler hesaba katılmaz.
- Aralık yüzdelik aralık değildir: bootstrap yalnız standart hatayı verir, aralık t çeyreğiyle simetrik kurulur.
Neden küme bootstrap'ı ve neden t(B − 1)?
Aynı kümenin gözlemleri bağımlıdır; gözlemleri tek tek yeniden örneklemek bu bağımlılığı bozar ve standart hatayı küçültür. Kümeyi bütün olarak çekmek bağımlılık yapısını korur. Serbestlik derecesi veriden değil yineleme sayısından gelir: bu, lqmm paketinin summary yönteminin tanımıdır. B büyüdükçe t çeyreği normal çeyreğe yaklaşır; aralığın genişliğini asıl belirleyen küme sayısıdır, B değil.
Koddaki tercih
summary(m, R = P$B, seed = P$boot_tohum, alpha = 1 − P$guven) (satır 215). Tohum formdaki "Bootstrap tohumu" alanından gelir; aynı tohum aynı sonucu verir. Bootstrap uydurmaları ana modelin kestirimlerinden değil, ağırlıklı en küçük kareler başlangıcından başlar. summary hata verirse SH, GA ve p sütunları boş bırakılır (216–223).
21.4.6 Kantil süreci
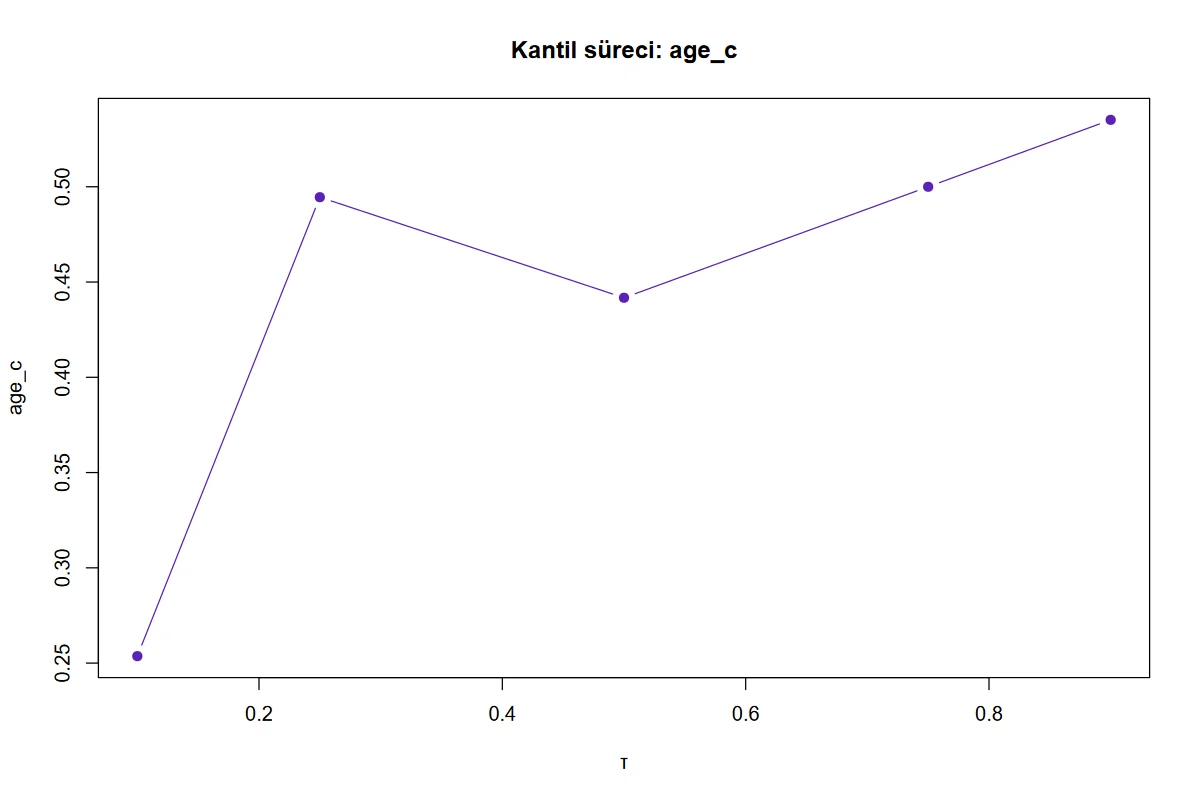
"Beş kantilde katsayıları karşılaştır" açıkken model, listedeki her \tau için baştan uydurulur (satır 252); tabloya katsayılar, ilk rastgele etki varyansı (psi), \sigma ve log-olabilirlik yazılır. Bu satırlar için bootstrap yapılmaz. Grafik, kesişimden sonraki ilk katsayının \tau'ya göre değişimini gösterir (255–259).
Log-olabilirlikler τ'lar arasında karşılaştırılmaz
Her \tau farklı bir çalışma dağılımı (farklı çarpıklıkta AL) kullanır. Süreç tablosundaki logLik sütunu bir kantilin ötekinden "daha iyi uyduğunu" göstermez; aynı \tau'da iki farklı sabit etki kümesini karşılaştırmak için kullanılabilir.
21.4.7 Rastgele eğim, kovaryans yapısı ve rastgele etki dağılımı
Rastgele eğim değişkeni verilirse \mathbf z_{ij}=(1,\ z_{ij})^{\top} olur ve \boldsymbol\Psi 2×2'dir: "köşegen" iki ayrı varyans, "özdeşin katı" tek ortak varyans, "genel" iki varyans ve bir kovaryans kestirir. Kareleme K^2 noktalı çarpım ızgarasına geçer. Rastgele etki dağılımı "sağlam" seçilirse normal yerine Laplace dağılımı varsayılır ve Gauss–Laguerre karelemesi kullanılır; bu seçenek yalnız köşegen ve özdeşin katı yapılarla çalışır. Bu bölümdeki bağımsız yeniden hesap normal rastgele kesişimli modeli kapsar.
21.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–161 | Üstbilgi: açıklama, örnek veri ve ayar, 20 parametre. | Form ve varsayılanlar (Bölüm 1.2). |
| 162–178 | Paket; yanıtın ve rastgele eğim değişkeninin mq_sayisal ile okunması; veri denetimleri; küme faktörü .grup. |
Yanıt ve rastgele eğim değişkeni Veri sekmesindeki türünden bağımsız olarak değerleriyle okunur; sayı olmayan değer çalıştırmayı durdurur (171–172). |
| 179–185 | Sabit etkilerin hazırlanması: metin → faktör, boş düzeyler atılır, sabit değişken denetimi. | Kategorik bir sabit etki kukla değişkenlerle girer; ilk düzey referanstır. |
| 186–189 | Formüller: sabit kısım, rastgele kısım; kovaryans adı. | Rastgele eğim yoksa kovaryans her zaman pdIdent (189). |
| 190–197 | Denetim listesi: eşik, yineleme sınırı ve formda değiştirilen öteki değerler. | Varsayılandan farklı olmayan değerler çağrıya eklenmez. |
| 198–203 | Süreç için \tau listesinin ayrıştırılması. | Ayırıcı virgül ya da noktalı virgül; ondalık ayırıcı nokta olmalıdır (199). |
| 204–214 | kur(tau): uyarı toplayarak lqmm; ana model; print(m); sonluluk denetimi. |
Paketin kendi özeti metin çıktısının başına yazılır. |
| 215–224 | Bootstrap özeti ve "Sabit etkiler" tablosu. | SH, GA ve p bootstrap'tandır. |
| 225–249 | Varyans bileşenleri, \sigma, AL standart sapması, SKK, logLik, AIC; rastgele eğim varsa iki denetim (236–248). | AIC'nin parametre sayısı: sabit etkiler + kovaryans parametreleri + 1 (\sigma). Rastgele eğimli modelde aynı veri yalnız rastgele kesişimle bir kez daha uydurulur; log-olabilirlik ondan küçükse uyarı yazılır. |
| 251–262 | Kantil süreci tablosu ve grafiği; uyarılar. | Her \tau için ayrı uydurma. |
21.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/karma_kantil/elle_hesap.py ve tam_integral.py ile hesaplanmıştır. Betikler lqmm'i kullanmaz: Gauss–Hermite düğümleri Jacobi matrisinin özdeğerlerinden (Golub ve Welsch, 1969) üretilir, log-olabilirlik 21.4.2'deki toplamla açıkça yazılır. R tarafında aynı log-olabilirlik ayrıca kodlanmıştır (r_dogrulama.R). lqmm'in gradyan araması bir eşikte durduğu için, bağımsız hesap şablonun kestirdiği noktada log-olabilirliği yeniden hesaplar; ayrıca aynı işlevi kendi eniyileyicisiyle en büyük yapar.
Adım 1 — Başlangıç. En küçük kareler: \boldsymbol\beta^{(0)}=(22{,}6477;\ 0{,}4795); \overline{r^2}=4{,}4704, \sigma^{(0)}=\sqrt{4{,}4704/8}=0{,}7475; \psi^{2(0)}=1. Bu noktada \ell=-85{,}5890.
Adım 2 — Şablonun kestirimi. \hat{\boldsymbol\beta}=(22{,}941047;\ 0{,}441738), \hat\psi^2=2{,}340926, \hat\sigma=0{,}296895.
Adım 3 — Bir kümenin katkısı (F01). Gözlemler 21; 20; 21,5; 23. Kestirilen ortancalar 22{,}941047+0{,}441738\cdot(-3;-1;1;3)=21{,}6158;\ 22{,}4993;\ 23{,}3828;\ 24{,}2663; artıklar -0{,}6158;\ -2{,}4993;\ -1{,}8828;\ -1{,}2663. \hat\psi=1{,}530009. Her düğümde u_k=\hat\psi v_k, S_k=\sum_j\rho_{0{,}5}(r_j-u_k) ve \ln\prod_jf=4\ln\big(0{,}25/\hat\sigma\big)-S_k/\hat\sigma:
| k | v_k | u_k | w_k | S_k | \ln\prod_jf | w_k\prod_jf |
|---|---|---|---|---|---|---|
| 1 | −3,750440 | −5,738205 | 0,000548 | 8,344316 | −28,792957 | 1{,}72\cdot10^{-16} |
| 2 | −2,366759 | −3,621162 | 0,030757 | 4,110230 | −14,531729 | 1{,}50\cdot10^{-8} |
| 3 | −1,154405 | −1,766250 | 0,240123 | 1,250000 | −4,897913 | 1{,}7918\cdot10^{-3} |
| 4 | 0 | 0 | 0,457143 | 3,132094 | −11,237175 | 6{,}02\cdot10^{-6} |
| 5 | 1,154405 | 1,766250 | 0,240123 | 6,664595 | −23,135328 | 2{,}15\cdot10^{-11} |
| 6 | 2,366759 | 3,621162 | 0,030757 | 10,374419 | −35,630741 | 1{,}03\cdot10^{-17} |
| 7 | 3,750440 | 5,738205 | 0,000548 | 14,608505 | −49,891970 | 1{,}18\cdot10^{-25} |
Toplamın %99,7'si tek bir düğümden (3.) gelir; bu, 21.8'deki kareleme uyarısının sayısal dayanağıdır.
Adım 4 — Log-olabilirlik ve AIC. On bir kümenin katkıları toplanınca \ell=-68{,}193446; lqmm'in bildirdiği değer -68{,}193446'dır. Parametre sayısı 2+1+1=4: \mathrm{AIC}=2\cdot68{,}193446+8=144{,}386891.
Adım 5 — Türetilen büyüklükler. \operatorname{Var}_{AL}=8\cdot0{,}296895^2=0{,}705173; hata standart sapması 0{,}839746; \text{SKK}=2{,}340926/(2{,}340926+0{,}705173)=0{,}768500.
Adım 6 — Aynı işlevin bağımsız eniyilemesi. Şablonun noktasından başlatılan Nelder–Mead araması (yeniden başlatmalı), aynı yedi düğümlü log-olabilirliği -68{,}193446'dan -68{,}159519'a çıkarır:
| kesişim | age_c |
\psi^2 | \sigma | \ell | |
|---|---|---|---|---|---|
| Şablon, gradyan araması (örnek ayar) | 22,941047 | 0,441738 | 2,340926 | 0,296895 | −68,193446 |
| Şablon, sıkı eşik | 22,941098 | 0,441653 | 2,340415 | 0,296889 | −68,192956 |
| Şablon, Nelder–Mead | 22,937499 | 0,437501 | 2,298049 | 0,296330 | −68,159521 |
| Bağımsız Nelder–Mead (şablonun noktasından) | 22,937500 | 0,437500 | 2,298050 | 0,296333 | −68,159519 |
| Bağımsız Nelder–Mead (en küçük kareler başlangıcından) | 23,000000 | 0,500000 | 1,688363 | 0,271419 | −68,021974 |
Şablonun türevsiz algoritması ile bağımsız eniyileme aynı yerel en büyüğe ulaşır. Gradyan araması ona yakın bir noktada, eşiğe ulaşınca durmuştur; katsayı farkı 0,004 düzeyindedir. En küçük kareler başlangıcından başlayan arama ise başka ve daha yüksek bir yerel en büyüğe gider. Yedi düğümlü yaklaşık olabilirlik çok tepelidir; kestirim algoritmaya ve başlangıca bağlıdır.
Adım 7 — Bootstrap özeti. B=50 yinelemenin katsayıları lqmm::boot ile aynı tohumla alınmış, özet ondan açık formülle hesaplanmıştır. Standart sapmalar: kesişim 0,661234, age_c 0,083528. t_{0{,}975;\,49}=2{,}009575:
age_c için t=0{,}441738/0{,}083528=5{,}2885, p=2{,}86\cdot10^{-6}.
21.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–4).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| τ = 0,5: logLik (şablonun kestirim noktasında) | −68,1934456 | −68,1934456 | −68,1934456 | 4,8e−11 | ✓ |
| τ = 0,5: AIC | 144,38689121 | 144,3868912 | 144,3868912 | 4,5e−11 | ✓ |
| τ = 0,5: hata standart sapması (AL) | 0,83974552 | 0,83974552 | 0,83974552 | 7,8e−16 | ✓ |
| τ = 0,5: sınıf içi korelasyon | 0,7684998 | 0,7684998 | 0,7684998 | 8,9e−16 | ✓ |
| τ = 0,5: bootstrap SH (kesişim) | 0,66123401 | 0,66123401 | 0,66123401 | 4,4e−16 | ✓ |
| τ = 0,5: GA alt (kesişim) | 21,61224769 | 21,61224769 | 21,61224769 | 1,5e−15 | ✓ |
| τ = 0,5: GA üst (kesişim) | 24,26984669 | 24,26984669 | 24,26984669 | 4,4e−16 | ✓ |
| τ = 0,5: p (kesişim) | 3,763103·10−36 | 3,763103·10−36 | 3,763103·10−36 | 6,7e−52 | ✓ |
| τ = 0,5: bootstrap SH (age_c) | 0,08352799 | 0,08352799 | 0,08352799 | 5,6e−17 | ✓ |
| τ = 0,5: GA alt (age_c) | 0,27388195 | 0,27388195 | 0,27388195 | 3,9e−16 | ✓ |
| τ = 0,5: GA üst (age_c) | 0,60959352 | 0,60959352 | 0,60959352 | 3,3e−16 | ✓ |
| τ = 0,5: p (age_c) | 2,856070·10−6 | 2,856070·10−6 | 2,856070·10−6 | 1,9e−20 | ✓ |
| τ = 0,75: logLik (şablonun kestirim noktasında) | −68,06177258 | −68,0617726 | −68,0617726 | 2,4e−10 | ✓ |
| τ = 0,75: AIC | 144,12354516 | 144,12354519 | 144,12354519 | 2,3e−10 | ✓ |
| τ = 0,75: hata standart sapması (AL) | 0,941628 | 0,941628 | 0,941628 | 4,4e−16 | ✓ |
| τ = 0,75: sınıf içi korelasyon | 0,71342666 | 0,71342666 | 0,71342666 | 6,7e−16 | ✓ |
| τ = 0,75: bootstrap SH (kesişim) | 0,66923303 | 0,66923303 | 0,66923303 | 4,4e−16 | ✓ |
| τ = 0,75: GA alt (kesişim) | 21,87024517 | 21,87024517 | 21,87024517 | 4,9e−16 | ✓ |
| τ = 0,75: GA üst (kesişim) | 24,55999341 | 24,55999341 | 24,55999341 | 1,6e−15 | ✓ |
| τ = 0,75: p (kesişim) | 3,789530·10−36 | 3,789530·10−36 | 3,789530·10−36 | 1,3e−51 | ✓ |
| τ = 0,75: bootstrap SH (age_c) | 0,10739407 | 0,10739407 | 0,10739407 | 3,2e−16 | ✓ |
| τ = 0,75: GA alt (age_c) | 0,28418327 | 0,28418327 | 0,28418327 | 2,2e−16 | ✓ |
| τ = 0,75: GA üst (age_c) | 0,71581621 | 0,71581621 | 0,71581621 | 2,2e−16 | ✓ |
| τ = 0,75: p (age_c) | 2,491028·10−5 | 2,491028·10−5 | 2,491028·10−5 | 3,0e−20 | ✓ |
| τ = 0,5, sıkı eşik: logLik | −68,19295557 | −68,19295557 | −68,19295557 | 4,6e−11 | ✓ |
| τ = 0,5, sıkı eşik: sınıf içi korelasyon | 0,7684681 | 0,7684681 | 0,7684681 | 1,1e−16 | ✓ |
| Kantil süreci τ = 0,1: logLik | −83,86218973 | −83,86218738 | −83,86218739 | 2,8e−8 | ✓ |
| Kantil süreci τ = 0,25: logLik | −78,3120939 | −78,31209392 | −78,31209392 | 2,6e−10 | ✓ |
| Kantil süreci τ = 0,5: logLik | −68,1934456 | −68,1934456 | −68,1934456 | 4,8e−11 | ✓ |
| Kantil süreci τ = 0,75: logLik | −68,06177258 | −68,0617726 | −68,0617726 | 2,4e−10 | ✓ |
| Kantil süreci τ = 0,9: logLik | −71,38095608 | −71,38095578 | −71,38095576 | 4,5e−9 | ✓ |
| Nelder–Mead: kesişim | 22,93749869 | 22,9375 | 22,9375 | 5,7e−8 | ✓ |
| Nelder–Mead: age_c | 0,43750051 | 0,4375 | 0,4375 | 5,1e−7 | ✓ |
| Nelder–Mead: \psi^2 | 2,29804906 | 2,29804962 | 2,29804962 | 2,4e−7 | ✓ |
| Nelder–Mead: \sigma | 0,29633048 | 0,29633274 | 0,2963526 | 2,2e−5 | ✗ |
| Nelder–Mead: logLik | −68,15952088 | −68,15951902 | −68,15951912 | 2,7e−8 | ✓ |
Ölçütü karşılayan: 35/36. Python ve R: asimetrik Laplace olabilirliğinin yedi düğümlü Gauss–Hermite karelemesi açık formülle (düğümler Golub–Welsch özdeğer yöntemiyle); logLik satırlarında şablonun kestirdiği (\hat\beta,\hat\psi^2,\hat\sigma) noktasında değerlendirilmiştir. Bootstrap satırlarında yineleme matrisi lqmm::boot ile aynı tohumla alınmış, SH, aralık ve p ondan açık formülle hesaplanmıştır. Nelder–Mead satırlarında bağımsız sütunlar aynı log-olabilirliğin kendi eniyilemesidir (şablon: türevsiz algoritma seçeneği).
Tek ✗ satırı ölçek parametresidir: dış döngü \sigma'yı 10^{-4} toleranslı tek değişkenli aramayla bulur; aynı noktada log-olabilirlik \sigma'ya göre çok yassıdır ve üç yolun \sigma'ları 2\cdot10^{-5} içinde, log-olabilirlikleri 3\cdot10^{-8} içinde aynıdır.
21.7 Çıktıyı okuma
Örnek ayarın metin çıktısı (lqmm'in kendi özeti):
Quantile 0.5

Fixed effects:
(Intercept)        age_c
    22.9410       0.4417

Covariance matrix of the random effects:
(Intercept)
      2.341

Residual scale parameter: 0.2969 (standard deviation 0.8397)
Log-likelihood: -68.19

Number of observations: 44
Number of groups: 11
"Sabit etkiler, τ = 0,50 (küme bootstrap SH, %95 GA)" tablosu:
| terim | kestirim | SH_bootstrap | GA_alt | GA_ust | p |
|---|---|---|---|---|---|
| (Intercept) | 22,9410 | 0,6612 | 21,6122 | 24,2698 | 3{,}76\cdot10^{-36} |
| age_c | 0,4417 | 0,0835 | 0,2739 | 0,6096 | 2{,}86\cdot10^{-6} |
"Rastgele etkiler ve model uyumu" tablosu: n=44; küme sayısı 11; tau 0,5; rastgele kesişim varyansı \psi^2 2,3409; asimetrik Laplace ölçeği \sigma 0,2969; hata standart sapması (AL) 0,8397; sınıf içi korelasyon 0,7685; logLik −68,1934; AIC 144,3869.
"Kantillere göre katsayılar ve varyans bileşenleri" tablosu:
| tau | (Intercept) | age_c | psi | sigma | logLik |
|---|---|---|---|---|---|
| 0,10 | 20,7609 | 0,2536 | 11,6680 | 0,1754 | −83,8622 |
| 0,25 | 21,4836 | 0,4945 | 9,1923 | 0,3222 | −78,3121 |
| 0,50 | 22,9410 | 0,4417 | 2,3409 | 0,2969 | −68,1934 |
| 0,75 | 23,2151 | 0,5000 | 2,2074 | 0,2233 | −68,0618 |
| 0,90 | 23,5264 | 0,5351 | 2,7691 | 0,1154 | −71,3810 |
Yayımlanmış örnekteki değerler (Geraci, 2014): \tau=0{,}5'te 22,941 ve 0,4417; rastgele etki varyansı 2,341; ölçek 0,2969; log-olabilirlik −68,19.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| (Intercept) | age_c = 0'da (11 yaş) koşullu \tau. kantil |
Tipik bir kümenin (rastgele etkisi sıfır) ortancası 22,94 mm. |
age_c |
Yaş bir yıl arttığında koşullu kantildeki değişim | Ortanca uzaklık yılda 0,44 mm artar. |
SH_bootstrap, GA, p |
Küme bootstrap standart hatası; t_{B-1} aralığı; H_0:\beta=0 | Kesişimin p'si bilgi taşımaz. B ve tohum raporda belirtilir. |
| \psi^2 | Rastgele kesişim varyansı | Kümelerin kendi kantil düzeylerinin yayılımı; düğüm sayısına duyarlıdır (21.8). |
| \sigma; hata SS (AL) | AL ölçeği; \sqrt{\operatorname{Var}_{AL}} | Küme içi yayılım için ikincisi okunur. |
| Sınıf içi korelasyon | \psi^2/(\psi^2+\operatorname{Var}_{AL}) | AL çalışma modeline göre küme payı. |
| logLik, AIC | Kareleme yaklaşık log-olabilirliği | Aynı \tau ve aynı düğüm sayısındaki modeller arasında karşılaştırılır. |
Süreç tablosu, psi |
Her \tau'da ilk rastgele etki varyansı | Sütun adı psi olsa da değer varyanstır (\psi^2). |
| "Uyarılar:" | lqmm'in yakınsama iletileri | "Lower loop did not converge" çıkarsa yineleme sınırı artırılır ya da eşik gevşetilir. |
Şekil 21.1. Kantil süreci: age_c katsayısının τ'ya göre değişimi (örnek veri). Noktalar ayrı ayrı uydurulan beş modelin katsayılarıdır; güven bandı çizilmez.
Rapor cümlesi:
Uzaklığın koşullu ortancası, denek rastgele kesişimli doğrusal kantil karma modelle (\tau = 0{,}5; asimetrik Laplace olabilirliği, 7 düğümlü Gauss–Hermite karelemesi) kestirildi. Ortanca uzaklık 11 yaşta 22,94 mm (küme bootstrap SH 0,66; %95 GA 21,61–24,27) olup yılda 0,44 mm arttı (SH 0,08; %95 GA 0,27–0,61; 50 küme bootstrap yinelemesi). Denekler arası varyans 2,34, hata standart sapması 0,84 mm idi.
21.8 Sık hatalar ve tuzaklar
- Düğüm sayısını sonuçtan bağımsız sanmak. Kareleme uyarlamalı değildir; küme içi yayılım kümeler arası yayılıma göre küçükse (bu veride \sqrt{\operatorname{Var}_{AL}}=0{,}84, \psi=1{,}53) integral dar bir tepeye sıkışır ve birkaç düğüm onu iyi yakalayamaz. Örnek ayarın kestirim noktasında log-olabilirlik 7 düğümle −68,19, 9 düğümle −68,03, 11 düğümle −68,70, 15 düğümle −73,66'dır; çok sık bir sayısal integralle "tam" değer −71,14'tür. Şablon 9, 11 ve 15 düğümle çalıştırıldığında \hat\psi^2 sırasıyla 2,92; 3,53; 3,02, kesişim 22,92; 22,90; 22,75 çıkar. Tam integralli olabilirliğin en büyüğünde \psi^2=3{,}93, kesişim 22,66, eğim 0,459'dur. Sabit etkiler görece kararlıdır; varyans bileşeni ve log-olabilirlik düğüm sayısıyla birlikte raporlanmalı, duyarlılık birkaç değerle denenmelidir.
- Daha geniş modelin daha kötü log-olabilirlik vermesi. Rastgele eğim eklendiğinde (çalıştırma 6) log-olabilirlik −68,19'dan −81,89'a düşer, kesişim varyansı 6,63, eğim varyansı sıfıra yakın çıkar. İç içe modelde bu, kestirimin bir yerel en büyükte ya da kareleme hatasında takıldığını gösterir. Şablon rastgele eğim seçildiğinde aynı veriyi yalnız rastgele kesişimle de uydurur (satır 240–243) ve eğimli modelin log-olabilirliği daha küçükse iki değeri yazan bir uyarı verir: "… kestirim yerel bir noktada ya da kareleme hatasında kalmıştır; bu çalıştırmanın katsayıları, varyansları ve standart hataları güvenilir değildir." Uyarı çıkan sonuç yorumlanmamalı, düğüm sayısı ve algoritma değiştirilerek yinelenmelidir.
- Rastgele eğim değişkenini sabit etkilere eklememek. Şablon rastgele eğim değişkeninin sabit etkilerde bulunmasını zorunlu tutmaz; eklenmemişse uyarı yazar (satır 237–238). Bu durumda eğimin ortalaması sıfır varsayılır; çoğu zaman istenen model değildir.
- Sayısal bir sabit etkiyi "kategorik" türde bırakmak. Yanıt ve rastgele eğim değişkeni türünden bağımsız olarak değerleriyle okunur. Sabit etkilerde ise tür belirleyicidir: kategorik türdeki sayısal değişken kukla değişkenlerle girer ve model değişir (
age_ciçin tek eğim yerine üç düzey farkı). - Aralığı yüzdelik bootstrap aralığı sanmak. Aralık \hat\beta\pm t_{B-1}\operatorname{SH}'dir; simetriktir ve serbestlik derecesi yineleme sayısından gelir. Örnek ayardaki B=50 gösterim içindir; rapor için formun varsayılanı 200 ya da daha çoğu kullanılır.
- Kantilleri ayrı ayrı uydurup çakışmayı gözden kaçırmak. Her \tau bağımsız kestirilir; kestirilen kantil doğruları kesişebilir ve katsayılar \tau ile düzgün değişmeyebilir (süreç tablosunda
age_c: 0,25; 0,49; 0,44; 0,50; 0,54). Küçük örneklemde uç kantiller (\tau=0{,}1; 0,9) özellikle kararsızdır: kümede dört gözlem varken %10'luk kantil veriden zor ayırt edilir. - Süreç için τ listesini ondalık virgülle yazmak. Liste virgülle ayrılır ve ondalık ayırıcı noktadır:
0.1, 0.9.0,1; 0,9yazılırsa virgüller ayırıcı sayılır ve 0 ile 1 arasında olmayan parçalar yüzünden çalıştırma durur. - Sıkı eşikte uyarıyı görmemek. Örnek veride sıkı eşik (10^{-7}) 1000 yinelemede yakınsamaz; sonuç yine yazılır, uyarı çıktının sonundadır. "En çok yineleme (alt düzey)" artırılmalıdır.
21.9 Uzman soruları
S1. Asimetrik Laplace varsayımı yanlışsa kestirim geçersiz mi?
AL bir çalışma olabilirliğidir. Rastgele etkisiz modelde AL en çok olabilirlik kestirimi, kantil regresyonun dağılımdan bağımsız kestirimiyle aynıdır. Karma modelde bu eşdeğerlik koşulludur: rastgele etki verildiğinde konum parametresi \tau. kantildir, ama marjinal olabilirlik AL biçimine ve rastgele etki dağılımına dayanır. Bu yüzden varyans bileşenleri modele bağlı okunur, standart hatalar da olabilirlik eğriliğinden değil küme bootstrap'ından alınır.
S2. Katsayılar koşullu mu, marjinal mi yorumlanır?
Koşullu. \beta_\tau, aynı kümenin (aynı \mathbf u_i) \tau. kantilinin açıklayıcı değişkenle nasıl değiştiğini verir. Kantil doğrusal bir işlemci olmadığından, rastgele etkiler üzerinden ortalama almak popülasyonun marjinal \tau. kantilini vermez; doğrusal karma modeldeki "koşullu = marjinal" eşitliği burada yoktur.
S3. Bootstrap ortalaması kestirimden neden uzak olabilir?
Örnek ayarda 50 yinelemenin kesişim ortalaması 22,53, kestirim 22,94'tür. Bootstrap uydurmaları ana modelin kestirim noktasından değil, yeniden örneklenen verinin ağırlıklı en küçük kareler çözümünden başlar ve tepeli olabilirlikte farklı yerel en büyüklere gidebilir. Standart hata böylece örnekleme değişkenliğine ek olarak algoritmanın değişkenliğini de içerir. Aynı yeniden örneklemelerde her uydurma kendi Nelder–Mead eniyilemesiyle yapıldığında standart hatalar 0,600 ve 0,114 çıkar (şablon: 0,661 ve 0,084); büyüklük düzeni aynıdır, ikinci basamak algoritmaya bağlıdır.
S4. p değeri neden t(B − 1) dağılımından?
lqmm'in summary yöntemi bootstrap kovaryansından standart hatayı alır ve \hat\beta/\operatorname{SH}'yi B-1 serbestlik dereceli t ile karşılaştırır. Bu, küme sayısına dayalı bir serbestlik derecesi değildir; 11 kümeli bir veride B=2000 seçmek aralığı normal çeyreğe yaklaştırır ama bilgiyi artırmaz. Az kümede aralık iyimser olabilir; küme sayısı raporda verilmelidir.
S5. Gradyan araması ile Nelder–Mead farklı sonuç verirse hangisi alınır?
Aynı düğüm sayısında log-olabilirliği daha yüksek olan. Örnek veride Nelder–Mead −68,1595, gradyan araması −68,1934 verir; katsayılar 0,004 içinde aynıdır. Bağımsız eniyileme Nelder–Mead sonucunu doğrular. Fark büyükse sorun algoritmada değil olabilirlik yüzeyindedir: başlangıç (kantil regresyonu başlangıcı), düğüm sayısı ve eşik değiştirilerek kestirimin kararlılığı gösterilmelidir.
S6. Paketin varsayılanı 7 düğüm yeterli mi?
Küme içi yayılım kümeler arası yayılıma yakınsa yeterlidir; küme içi yayılım çok küçükse değildir. Örnek veride F01 kümesinin olabilirlik katkısının %99,7'si tek düğümden gelir (21.6, Adım 3): integrand iki düğüm arasında kalan dar bir tepedir. Yayımlanmış sonuçlar 7 düğümle elde edildiğinden şablon aynı varsayılanı korur ve aynı sayıları üretir; ama \psi^2'nin 2,34 (7 düğüm) ile 3,93 (tam integral) arasında değişmesi, bu büyüklüğün yöntem ayrıntısına bağlı olduğunu gösterir.
S7. Sınıf içi korelasyon normal karma modeldekiyle karşılaştırılabilir mi?
Doğrudan hayır. Payda AL varyansıdır ve \tau ile değişir: aynı veride \tau=0{,}5'te 0,768, \tau=0{,}75'te 0,713'tür. Normal kuramlı sınıf içi korelasyon tek bir sayıdır ve ortalama modelinin artık varyansına dayanır. Buradaki oran, seçilen kantilin çalışma modelinde kümelenmenin göreli büyüklüğünü özetler.
S8. Rastgele etki dağılımı "sağlam" seçilince ne değişir?
Rastgele etkiler normal yerine Laplace dağılımlı varsayılır ve bütünleştirme Gauss–Laguerre karelemesiyle yapılır; ağır kuyruklu küme etkilerine karşı daha dayanıklıdır. Varyans parametresinin ölçeği ve log-olabilirlik normal seçenektekiyle karşılaştırılamaz (örnek veride varyans 25,39, log-olabilirlik −63,85). Bu seçeneğin sonuçları bu bölümde bağımsız olarak yeniden hesaplanmamıştır.
21.10 Kaynaklar
- Geraci, M. (2014). Linear quantile mixed models: The lqmm package for Laplace quantile regression. Journal of Statistical Software, 57(13), 1–29. https://doi.org/10.18637/jss.v057.i13
- Geraci, M., & Bottai, M. (2007). Quantile regression for longitudinal data using the asymmetric Laplace distribution. Biostatistics, 8(1), 140–154. https://doi.org/10.1093/biostatistics/kxj039
- Geraci, M., & Bottai, M. (2014). Linear quantile mixed models. Statistics and Computing, 24(3), 461–479. https://doi.org/10.1007/s11222-013-9381-9
- Golub, G. H., & Welsch, J. H. (1969). Calculation of Gauss quadrature rules. Mathematics of Computation, 23(106), 221–230. https://doi.org/10.1090/S0025-5718-69-99647-1
- Koenker, R., & Bassett, G. (1978). Regression quantiles. Econometrica, 46(1), 33–50. https://doi.org/10.2307/1913643
- Nelder, J. A., & Mead, R. (1965). A simplex method for function minimization. The Computer Journal, 7(4), 308–313. https://doi.org/10.1093/comjnl/7.4.308
- Potthoff, R. F., & Roy, S. N. (1964). A generalized multivariate analysis of variance model useful especially for growth curve problems. Biometrika, 51(3–4), 313–326. https://doi.org/10.1093/biomet/51.3-4.313
- Yu, K., & Moyeed, R. A. (2001). Bayesian quantile regression. Statistics & Probability Letters, 54(4), 437–447. https://doi.org/10.1016/S0167-7152(01)00124-9