56. Tabakalı / bloklu permütasyon testi
Şablon kimliği: permutasyon_ozel · Kategori: yeniden_ornekleme · Dil: Python · Dosya: pro/sablonlar/yeniden_ornekleme/permutasyon_ozel.py (satır 1–216; üstbilgi 1–56) · Örnek veri: _ornek/gruplu_verim.csv · Paketler: numpy 2.4.6, pandas 2.3.3, matplotlib 3.10.9
56.1 Ne işe yarar
Şablon, grupların bir yanıt bakımından farklı olup olmadığını dağılım varsayımı yapmadan sınar. Cevapladığı soru: "Grup etiketleri birimlere rastgele dağıtılmış olsaydı, gözlenen kadar büyük bir fark ne sıklıkla ortaya çıkardı?" Sıfır hipotezi, etiketlerin yanıtla ilgisiz olduğudur; bu durumda etiketleri karıştırmak verinin olasılığını değiştirmez ve karıştırılmış her düzen, gözlenen düzen kadar olasıdır.
- T_{\text{göz}}: gözlenen veriden hesaplanan test istatistiği (ortalama farkı, medyan farkı ya da F).
- T^{*}_r: etiketlerin r. rastgele karıştırılmasından hesaplanan aynı istatistik (r=1,\dots,B).
- "Uç": seçenek hipotezin yönüne göre büyük, küçük ya da mutlak değerce büyük.
- Paydaki ve paydadaki 1: gözlenen düzenin kendisi; o da olası düzenlerden biridir.
Şablonun ayırt edici yanı blok (tabaka) seçeneğidir. Deneme bloklar hâlinde kurulmuşsa (tekerrür, parti, gün, tarla, merkez) rastgele atama her bloğun içinde yapılmıştır; sıfır hipotezi altında değiştirilebilir olan da yalnız aynı bloktaki birimlerdir. Blok sütunu verildiğinde etiketler yalnız blok içinde karıştırılır; F istatistiği de blok etkisinden arındırılarak hesaplanır.
Ne zaman kullanılır? Gruplar rastgele atamayla oluşturulmuşsa; yanıtın dağılımı normalden uzaksa ya da örneklem, t ve F dağılımlarına güvenilemeyecek kadar küçükse; deneme bloklu ya da tabakalıysa ve sınamanın bu yapıya uyması isteniyorsa; test istatistiği olarak medyan farkı gibi kapalı dağılımı olmayan bir ölçü seçilecekse.
Ne zaman kullanılmaz?
- Aynı birimin iki koşuldaki ölçümleri karşılaştırılacaksa (eşleştirilmiş tasarım): temel programdaki Permütasyon Testi (eşleştirilmiş seçenek). Her birim bir blok olarak tanımlanıp F seçilerek de sınanabilir (56.9, S6).
- Olası düzenlemelerin tamamı sayılarak kesin p değeri isteniyorsa (çok küçük örneklem): temel programdaki Permütasyon Testi (kesin yöntem); iki grupta sıra tabanlı test için Mann-Whitney U.
- Çok sayıda yanıt aynı anda sınanacak ve p değerleri aile boyu hata oranına göre düzeltilecekse:
coklu_test_yeniden_ornekleme(Bölüm 54). - Güven aralığı isteniyorsa (permütasyon testi yalnız p değeri verir):
bootstrap_ozel(Bölüm 53) ya da temel programdaki Bootstrap Güven Aralığı. - Gruplar blok düzeyinde atanmışsa (bütün blok tek grup): blok içinde karıştırılacak etiket yoktur; analiz birimi bloktur ve blok ortalamaları üzerinden bloksuz test yapılır.
- Gözlemler bağımsız değilse ve bağımlılık blokla açıklanmıyorsa (zaman serisi):
bagimli_bootstrap(Bölüm 51).
Temel programla ilişki. Temel programdaki Permütasyon Testi iki bağımsız grubu (ortalama, medyan ya da Welch t), ikiden çok grubu (F) ve eşleştirilmiş ölçümleri sınar; iki grupta kesin sayım seçeneği vardır. Blok ya da tabaka içinde kısıtlı permütasyon ve blok etkisinden arındırılmış F temel programda yoktur; bu şablon onu ekler. Test istatistiği kodda açık bir işlev olduğundan (56.5) kullanıcı kendi istatistiğini de yazabilir.
56.2 Şablonun girdileri
Form, üstbilgideki yedi [[param]] bloğundan kurulur (permutasyon_ozel.py:10–55).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt değişkeni · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Yanıt vektörü (71–73). |
Grup · grup |
kategorik sütun · Değişkenler | ilk sütun | herhangi bir sütun; en az 2 düzey | Metne çevrilir, düzeyler sıralanır, kodlanır (74–77, 90). |
Blok / tabaka (isteğe bağlı) · blok |
kategorik sütun · Değişkenler | boş | herhangi bir sütun; boş olabilir | Karıştırmanın yapılacağı kümeler (75, 93–96); F'nin blok düzeltmesi (100–120). |
Test istatistiği · istatistik |
seçim · Model | F |
ortalama_farki, medyan_farki, F |
istatistik() işlevinin dalı (123–152). |
Alternatif hipotez (fark için) · alternatif |
seçim · Seçenekler | iki_yonlu |
iki_yonlu, buyuk, kucuk |
Uçluk sayımının yönü (157–164); F'de yok sayılır. |
Permütasyon sayısı · B |
tamsayı · Seçenekler | 4999 | 99–200000 | Rastgele karıştırma sayısı (78, 92). |
Permütasyon p değeri hesabı · p_yontemi |
seçim · Gelişmiş | arti_bir |
arti_bir, oran |
(b+1)/(B+1) ya da b/B (165). |
Örnek ayar (ornek_param, satır 9): y = verim, grup = grup, blok = blok, istatistik = F, B = 1999 (varsayılan 4999 yerine).
Şablonun kendi denetimleri.
| Koşul | İleti | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 65 |
| Yanıt, grup ve bloktan ikisi aynı sütun | "Yanıt, grup ve blok farklı sütunlar olmalı." | 69 |
| Grupta 2'den az düzey | "Grup sütununda en az iki düzey gerekli." | 80 |
| Fark istatistiği seçili, düzey sayısı 2 değil | "Fark istatistikleri tam iki grup ister; … grup var. F istatistiğini seçin." | 82–83 |
| Bir grupta 2'den az gözlem | "Her grupta en az 2 gözlem gerekli." | 86 |
| Yanıt sabit | "Yanıt değişkeni sabit." | 110 |
| Bloklu F: n-b-k+1\le0 | "Blok ve grup sayısına göre gözlem yetersiz (hata serbestlik derecesi ≤ 0)." | 141–144 |
| Blok varken grup blokla iç içe (bütün istatistikler) | "Grup blokla iç içe (blok içinde grup karşılaştırması yok); blok içi permütasyonla sınanamaz." | 137–139 |
Satır temizliği (91–94): yanıt pd.to_numeric(errors="coerce") ile sayıya çevrilir; yanıtı sayıya çevrilemeyen ya da yanıtı, grubu, bloğu eksik olan satırlar atılır. Yanıt sütununun veri sekmesindeki türü "kategorik" olsa da değerler doğru okunur. Kullanılan gözlem sayısı sonuç tablosunun n sütunundadır.
"1. grup" hangisidir?
Grup düzeyleri metne çevrilir (tam sayı değerli ondalık etiket "2.0" değil "2" yazılır) ve MerQuR+ düzey sırasıyla dizilir (satır 64–83, 98): kullanıcının tanımladığı sıra varsa o; yoksa etiketlerin hepsi sayıysa sayısal sıra; değilse verideki ilk görülme. Alfabetik ya da karakter kodu sırası kullanılmaz. Fark istatistikleri sıradaki ilk düzey eksi ikinci düzey olarak hesaplanır ve formdaki "1. grup > 2. grup" seçeneği bu sıraya göre işler. Fare verisinde ilk satırlar tedavi olduğundan birinci grup tedavi'dir ("Ortalama farkı (tedavi − kontrol)"); sayı kodlu gruplarda "2" düzeyi "10"dan önce gelir. Hangi farkın hesaplandığı çıktının ilk satırında parantez içinde yazılır; tek yönlü sınamada yön seçilmeden önce bu satıra bakılır.
56.3 Örnek veri
Dosya: _ornek/gruplu_verim.csv. Rastgele tam bloklar düzeninde bir verim denemesi biçiminde hazırlanmış örnek veri: 3 uygulama × 5 blok × blok başına 4 parsel = 60 gözlem; dosyada ve üstbilgide kaynak belirtilmemiştir. Eksik değer yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
verim |
Yanıt | sayısal | 2,31–15,27; ortalama 6,9945; standart sapma 2,551. |
grup |
Grup | kategorik | Kontrol, Gübre_A, Gübre_B; her biri 20 parsel. |
blok |
Blok | kategorik | B1–B5; her biri 12 parsel (her gruptan 4). |
parsel |
kullanılmaz | metin | P01–P60. |
Arayüzdeki düzey sırası (ilk görülme) Kontrol, Gübre_A, Gübre_B'dir; şablonun kullandığı sıra Gübre_A, Gübre_B, Kontrol'dür. F istatistiği sıradan etkilenmez.
Blok × grup ortalamaları:
| Blok | Gübre_A | Gübre_B | Kontrol | Blok ortalaması |
|---|---|---|---|---|
| B1 | 5,545 | 5,100 | 4,055 | 4,900 |
| B2 | 8,528 | 10,445 | 5,797 | 8,257 |
| B3 | 9,535 | 10,450 | 6,225 | 8,737 |
| B4 | 6,255 | 9,582 | 6,970 | 7,603 |
| B5 | 6,102 | 6,512 | 3,815 | 5,477 |
| Grup ortalaması | 7,193 | 8,418 | 5,373 | 6,995 |
Bloklar arasındaki fark (4,90–8,74) gruplar arasındaki fark (5,37–8,42) kadar büyüktür. Blok gözetilmezse bu değişkenlik hata terimine karışır; 56.6'da iki F yan yana hesaplanır.
Fark istatistikleri iki grup istediğinden bölümde ikinci bir veri de kullanılır: Efron ve Tibshirani'nin (1993, Tablo 2.1) fare verisi (_ornek/bootstrap_ozel_fare.csv; 7 tedavi ve 9 kontrol faresinin yaşama süresi, gün).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) blok boş (serbest permütasyon); (3) p_yontemi = oran; (4) fare verisi, ortalama farkı, üç alternatif (B=4999); (5) fare verisi, medyan farkı; (6) fare verisi, F; (7) örnek verinin Kontrol ve Gübre_A satırları (40 gözlem), blok içinde ortalama farkı; (8) grupların bloklara eşit dağılmadığı kurgusal bir veri (56.8).
56.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) satırları temizle, düzeyleri sırala ve kodla; (2) etiket vektörünü B kez, blok verilmişse her blok içinde ayrı ayrı karıştır; (3) gözlenen düzen ve B karıştırılmış düzen için test istatistiğini hesapla; (4) gözlenen değer kadar ya da daha uç olan karıştırmaları say; (5) p değerini kur; (6) sıfır dağılımının histogramını gözlenen değerle birlikte çiz.
56.4.1 Karıştırma: serbest ve blok içinde
- \pi_r: r. karıştırma; i. birime \pi_r(i). birimin etiketi verilir.
- Koşul: bir birim yalnız kendi bloğundaki bir birimin etiketini alabilir. Blok verilmemişse koşul yoktur (bütün veri tek blok sayılır).
- Her blokta her gruptan kaç birim bulunduğu karıştırmada değişmez.
Neden blok içinde?
Permütasyon testinin geçerliliği, karıştırmanın deneydeki rastgele atamayı taklit etmesine bağlıdır. Rastgele tam bloklar düzeninde uygulamalar her bloğun içinde ayrı ayrı dağıtılmıştır; bir B1 parseline B3 parselinin etiketi hiçbir atamada gelemezdi. Serbest karıştırma, gerçekte olanaksız düzenleri de sayar ve blokların yarattığı değişkenliği sıfır dağılımına karıştırır. Blok içi karıştırmada blok farkları her düzende aynen korunur; sıfır dağılımı yalnız uygulamaların bloklar içindeki dağılımından doğan değişkenliği yansıtır.
Koddaki tercih
Etiket vektörü B satırlı bir matrise çoğaltılır (np.tile, satır 114); her blok için o bloğun sütunları rng.permuted(…, axis=1) ile satır satır bağımsız karıştırılır (115–118). Tek gözlemli blok karıştırılmaz. Gözlenen etiketler matrisin başına eklenir (119); istatistik B+1 satırın hepsi için tek çağrıda hesaplanır ve ilk değer gözlenen, kalanlar sıfır dağılımıdır (182–183). Karıştırmalar rastgele çekilir; olası düzen sayısı küçük olsa da tam sayım yapılmaz.
Rastgele sayı üreteci çalıştırmanın tohumuyla kurulur (satır 87). Şablon formunda tohum alanı yoktur; tohum Kod panelindeki Tohum alanından verilir (Bölüm 1.3). Alan boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar; kullanılan tohumu künyeye yazar ve çalıştırma kaydında saklar; kayıtlı adım yeniden oynatıldığında aynı p değeri elde edilir, yeni bir çalıştırmada p Monte Carlo hatası kadar değişir (56.4.4). Bu bölümdeki sayılar, tohum verilmediğinde kodun kullandığı değerle (2026) elde edilmiştir.
56.4.2 Fark istatistikleri
- (1), (2): düzey sırasındaki birinci ve ikinci grup (56.2).
- \bar y_{(g)}: grubun ortalaması; \operatorname{med}: ortanca.
- İki istatistik de yanıtın birimindedir ve ham gruplar üzerinden hesaplanır; blok verilmiş olsa da blok düzeltmesi içermez. Blok yalnız karıştırmayı kısıtlar.
Neden ortalama farkı t yerine yeterlidir?
Serbest permütasyonda grup büyüklükleri ve bütün verinin toplamı ile kareler toplamı her düzende aynıdır. Bu durumda eşit varyanslı t istatistiği ve iki grup için F, ortalama farkının (mutlak değerinin) tekdüze artan fonksiyonlarıdır: aynı düzenleri "uç" sayarlar ve aynı p değerini verirler. Fare verisinde ortalama farkının iki yönlü p değeri ile iki gruplu F'nin p değeri bu yüzden birebir aynıdır (0,2726; 56.6). Standartlaştırma permütasyon testine güç katmaz; yalnız dağılım tablosuyla karşılaştırma gerektiğinde işe yarar.
56.4.3 F istatistiği
Blok yokken tek yönlü varyans çözümlemesinin F'sidir:
Blok varken model y\sim\text{blok}+\text{grup}'tur ve grubun bloktan sonraki kareler toplamı kullanılır:
- k: grup sayısı; b: blok sayısı; n_j, \bar y_j: j. grubun büyüklüğü ve ortalaması; \bar y: genel ortalama.
- \tilde y_i: yanıtın kendi blok ortalamasından sapması; \tilde{\mathbf y}^{\top}\tilde{\mathbf y} blok içi toplam kareler toplamıdır.
- \tilde{\mathbf D}: (k-1)\times n matris; her satırı bir grubun 0/1 göstergesinin blok ortalamasından sapmasıdır (ilk grup dışarıda bırakılır).
- \mathrm{KT}_{\text{grup}\mid\text{blok}}: \tilde{\mathbf y}'nin \tilde{\mathbf D}'nin satır uzayına izdüşümünün uzunluğunun karesi; blok modeline grup eklendiğinde artık kareler toplamındaki azalmaya eşittir.
- n-b-k+1: hata serbestlik derecesi (n eksi sabit, b-1 blok ve k-1 grup parametresi).
Neden blok etkisi istatistikten de çıkarılır?
Blok içi karıştırma testi geçerli kılar; istatistiğin blok etkisinden arındırılması ise testi güçlü kılar. Blok farkları paydada kalırsa F küçülür ve gözlenen değer, sıfır dağılımı içinde daha az uç görünür. Blok ortalamaları karıştırmada değişmediği için arındırma her düzende aynı sayıları çıkarır; yalnız grup göstergelerinin arındırılması düzenden düzene yeniden yapılır. Anderson ve ter Braak (2003) bloklu tasarımda bu yolu (blok içinde kısıtlı permütasyon ve blok etkisi çıkarılmış istatistik) önerir. F her zaman üst kuyruktan sınanır; "Alternatif hipotez" alanı F seçiliyken etkisizdir (satır 157).
Koddaki tercih
Bloklu dal satır 124–147'de hazırlanır (birden çok blok varsa, bütün istatistikler için): blok ortalaması alma işlemi bir ağırlık matrisiyle (_Bort) yazılır, yanıt bir kez arındırılır, grubun blokla iç içe olup olmadığı arındırılmış göstergelerin rankından denetlenir (137). istatistik() içinde düzenler 1000'erlik öbeklerle işlenir; her öbekte (\tilde{\mathbf D}\tilde{\mathbf D}^{\top}) sistemi np.linalg.solve ile çözülür (153–160). Payda sıfıra inerse 10^{-300} ile sınırlanır (160, 173).
56.4.4 p değeri
Uçluk koşulu alternatife göre: iki yönlü \lvert T^{*}_r\rvert\ge\lvert T_{\text{göz}}\rvert; "1. grup > 2. grup" T^{*}_r\ge T_{\text{göz}}; "1. grup < 2. grup" T^{*}_r\le T_{\text{göz}}; F'de F^{*}_r\ge F_{\text{göz}}.
- b: gözlenen kadar ya da daha uç sıfır değeri sayısı.
- Karşılaştırmada 10^{-12}\max(1,\lvert T_{\text{göz}}\rvert) kadar tolerans bırakılır (satır 185): matematiksel olarak eşit olan değerler yuvarlama yüzünden "küçük" sayılmasın diye.
Neden (b + 1)/(B + 1)?
Rastgele çekilen B düzen ve gözlenen düzen, sıfır hipotezi altında aynı dağılımdan B+1 çekiliştir; gözlenenin bunlar arasındaki sırası tekdüze dağılır. (b+1)/(B+1) bu sıranın oranıdır ve P(p\le\alpha)\le\alpha eşitsizliğini her B için sağlar. b/B ise gözleneni saymaz; hiç uç değer çıkmadığında p=0 verir, ki hiçbir sonlu sayıda karıştırma bunu kanıtlayamaz, ve birinci tür hatayı adlandırılan düzeyin biraz üstüne taşır (Phipson ve Smyth, 2010). b/B seçeneği, bu tanımı kullanan eski çıktılarla karşılaştırma içindir.
p değerinin iki sınırı vardır. En küçük değer 1/(B+1)'dir: B=1999 ile 0{,}0005, B=4999 ile 0{,}0002. Monte Carlo hatası yaklaşık \sqrt{p(1-p)/B}'dir: B=4999 ve p=0{,}05 için 0{,}003. Eşiğe yakın bir p değeri raporlanacaksa B büyütülür.
Bloklu tasarımda fark istatistikleri blok etkisinden arındırılır
İki yönlü sayım \lvert T^{*}\rvert\ge\lvert T_{\text{göz}}\rvert biçimindedir. Blok verildiğinde ortalama ve medyan farkı, yanıtın blok ortalamalarından sapmaları \tilde y_i=y_i-\bar y_{\text{blok}(i)} üzerinden hesaplanır (satır 124–147; F ile aynı arındırma). Böylece grupların bloklardaki payı eşit olmasa da blok düzeyi farkları grup farkıyla karışmaz ve blok içi permütasyon dağılımının ortalaması ortalama farkında sıfırdır. Çıktıda istatistiğin adı "…, blok etkisi çıkarılmış" diye yazılır. Blok verilmediğinde ya da tek bloklu veride fark ham gruplardan hesaplanır. Medyan farkının sıfır dağılımı kesikli ve çoğu zaman asimetriktir; iki yönlü p yine mutlak değer tanımıyla verilir. Sayısal örnek 56.8'dedir.
56.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–56 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, yedi parametre. | Form buradan kurulur (Bölüm 1.2). |
| 57–98 | İçe aktarma, dil yardımcısı, etiket ve düzey sırası işlevleri (_et, _duzey_sirasi), üreteç, sütun denetimi, sayıya çevirme ve eksik satırların atılması, grup ve blok vektörleri, düzeylerin sıralanması. |
Blok boşsa bütün veri tek blok ("0") sayılır. |
| 99–110 | Düzey sayısı, grup büyüklüğü ve sabit yanıt denetimleri. | Grup büyüklüğü denetimi blok içinde değil, toplamdadır. |
| 112–119 | Düzeylerin kodlanması; B\times n etiket matrisi; blok içi karıştırma; gözlenen satırın eklenmesi. | Bütün düzenler bellekte tutulur; B\times n büyükse bellek gereksinimi artar. |
| 122–147 | Bloklu tasarım için hazırlık: blok kodları, arındırma işlevi, iç içelik denetimi; F için hata serbestlik derecesi; fark istatistikleri için arındırılmış yanıt. | Yalnız birden çok blok varsa çalışır; iç içelik denetimi bütün istatistikler için geçerlidir. |
| 150–179 | istatistik(L): bloklu F, tek yönlü F, ortalama farkı, medyan farkı (bloklu tasarımda arındırılmış yanıt üzerinde). |
Her dal bütün düzenleri vektörleştirilmiş hesaplar. |
| 182–192 | Gözlenen ve sıfır değerlerinin ayrılması, uçluk sayımı, p değeri. | F'de alternatif "üst kuyruk" olarak sabitlenir. |
| 194–216 | Etiketler, metin satırları, sonuç tablosu, histogram. | Bloklu F'de istatistiğin adı "F (blok etkisi çıkarılmış)" olur. |
Kendi istatistiğinizi yazmak. istatistik(L) işlevi (B+1)\times n boyutlu etiket matrisini alır ve her satır için bir sayı döndürür. Yeni bir istatistik eklemek için işleve bir dal yazmak yeterlidir; örneğin iki grubun budanmış ortalamalarının farkı ya da varyanslarının oranı. Dikkat edilecek üç nokta: (1) istatistik "büyük = daha uç" olacak biçimde tanımlanır ya da alternatif buna göre seçilir; (2) iki yönlü sayım mutlak değere bakar, sıfır dağılımı sıfır çevresinde simetrik değilse (ör. varyans oranı) istatistik buna göre dönüştürülür (oranın logaritması); (3) blok verilmişse ve tasarım dengesizse istatistik blok etkisinden arındırılmış yanıt üzerinden yazılır.
56.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/permutasyon_ozel/elle_hesap.py ile, şablonun istatistik() işlevi ve izdüşüm formülü kullanılmadan hesaplanmıştır: F, blok modelinin ve tam modelin artık kareler toplamlarından (kukla değişkenli en küçük kareler); p değerleri şablonla aynı rastgele düzenler üzerinde ayrı bir sayımla; küçük tasarımlarda ayrıca bütün düzenler sayılarak. R tarafında (r_dogrulama.R) F anova(lm()) ve vegan::adonis2 ile, kesin p değerleri combn ve coin::oneway_test ile bulunmuştur.
Adım 1 — Kareler toplamları. n=60, k=3, b=5; genel ortalama 6{,}9945.
| Kaynak | Kareler toplamı | sd | Kareler ortalaması |
|---|---|---|---|
| Blok | 140,263460 | 4 | 35,065865 |
| Grup (bloktan sonra) | 93,932770 | 2 | 46,966385 |
| Hata | 149,872855 | 53 | 2,827790 |
| Toplam | 384,069085 | 59 |
Tasarım dengeli olduğundan grubun kareler toplamı blok modelde olsa da olmasa da aynıdır (93{,}932770); değişen yalnız paydadır.
Adım 2 — İki F. Pay iki istatistikte aynıdır (93{,}932770/2=46{,}966385); payda blok modelinde hata kareler ortalaması, tek yönlü çözümlemede grup içi kareler ortalamasıdır (\mathrm{KT}_{\text{grup içi}}=384{,}069085-93{,}932770=290{,}136315, sd 57):
Blok değişkenliği (140{,}26) tek yönlü çözümlemede hata terimindedir ve hata kareler ortalamasını 2{,}83'ten 5{,}09'a çıkarır.
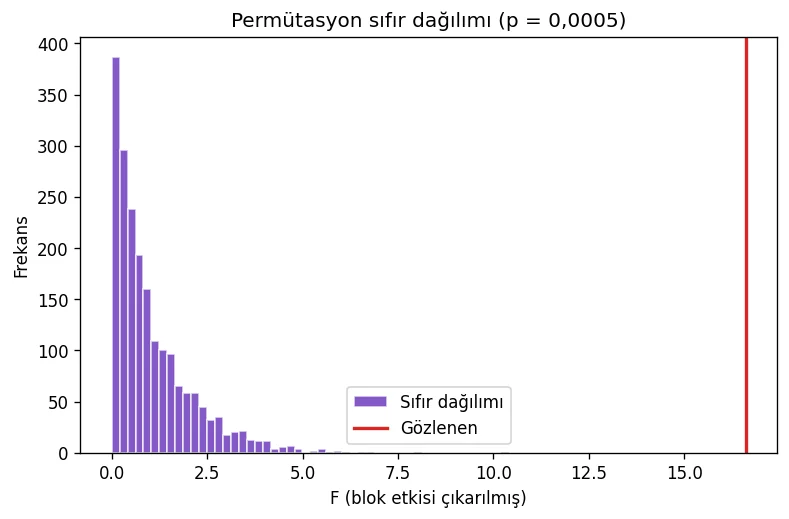
Adım 3 — Sıfır dağılımı (blok içinde, B=1999). Olası blok içi düzen sayısı \big(12!/(4!\,4!\,4!)\big)^5=34650^5\approx5{,}0\times10^{22}'dir; tam sayım olanaksızdır. 1999 rastgele düzenin F değerleri: ortalama 1{,}051; %95 yüzdeliği 3{,}250 (F_{2,\,53} dağılımınınki 3{,}172); %99 yüzdeliği 4{,}725; en büyük değer 10{,}413. İlk üç düzenin F değerleri 4{,}0800; 0{,}5198; 0{,}4266.
Adım 4 — p değeri. Gözlenen 16{,}609'a ulaşan düzen yoktur: b=0.
Bu, B=1999 ile yazılabilecek en küçük değerdir; "p\le0{,}0005" olarak okunur. Karşılaştırma için normal kuram F_{2,\,53} dağılımından p=2{,}5\times10^{-6} verir. p_yontemi = oran ile aynı çalıştırma b/B=0 yazar.
Adım 5 — Serbest permütasyon (çalıştırma 2). Blok verilmezse gözlenen istatistik 9{,}227'dir; 1999 serbest düzenin en büyük F değeri 7{,}145, b=0 ve yine p=0{,}0005. Bu veride etki çok güçlü olduğu için iki yol aynı p değerine varır; fark, gözlenen değerin sıfır dağılımına göre konumundadır (16{,}6'ya karşı en büyük 10{,}4; 9{,}2'ye karşı en büyük 7{,}1). Daha zayıf bir etkide blok gözetmemek anlamlılığı yitirmek demektir.
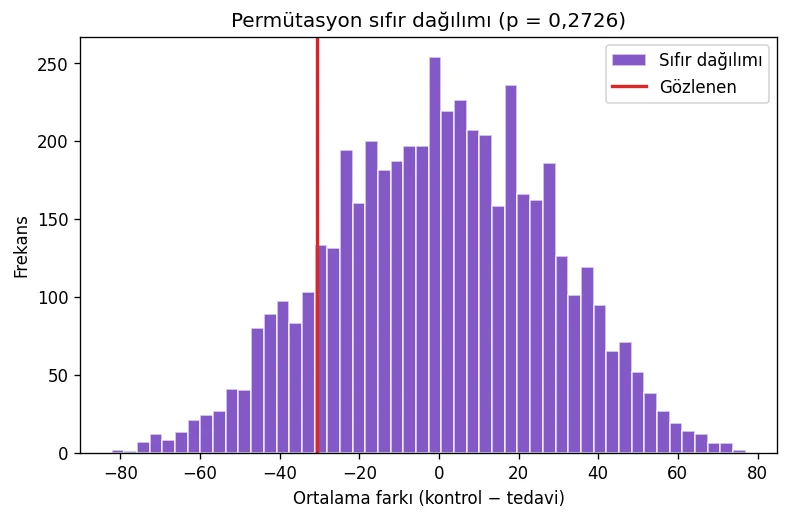
Adım 6 — Fare verisi: ortalama farkı ve kesin p. Tedavi (n=7) ortalaması 86{,}857, kontrol (n=9) ortalaması 56{,}222; T_{\text{ort}}=86{,}857-56{,}222=30{,}635. 16 fareden 7'sini "tedavi" sayan \binom{16}{7}=11440 düzenin hepsi sayıldığında:
| Alternatif | Uç düzen sayısı | Kesin p | Şablon (B=4999) | b |
|---|---|---|---|---|
| İki yönlü | 3184 | 0,278322 | 0,2726 | 1362 |
| 1. grup > 2. grup (tedavi > kontrol) | 1613 | 0,140997 | 0,1352 | 675 |
| 1. grup < 2. grup (tedavi < kontrol) | 9853 | 0,861276 | 0,8672 | 4335 |
Şablonun değerleri kesin değerlerden 0{,}006 ayrılır; B=4999 ve p\approx0{,}28 için Monte Carlo standart hatası \sqrt{0{,}28\times0{,}72/4999}=0{,}0063'tür. Kesin iki yönlü değer coin::oneway_test(distribution = "exact") ile de 0{,}278322 bulunur. Eşit varyanslı t sınaması aynı veride p=0{,}2812 verir.
Adım 7 — Medyan farkı ve iki gruplu F. Ortancalar: tedavi 94, kontrol 46; T_{\text{med}}=48. Şablon iki yönlü p=0{,}3022 (b=1510); kesin değer 0{,}302448. Aynı veride iki gruplu F=1{,}256294 ve p=0{,}2726: ortalama farkının iki yönlü p değeriyle aynı (56.4.2).
Adım 8 — İki grup, blok içinde (çalıştırma 7). Kontrol ve Gübre_A satırlarında (n=40; ilk görülen düzey Kontrol) T_{\text{ort}}=5{,}3725-7{,}193=-1{,}8205 (Kontrol − Gübre_A); tasarım dengeli olduğundan blok etkisi çıkarılmış değer ham farkla aynıdır. Blok içinde 4999 düzenin ikisi bu değere ulaşır: iki yönlü p=3/5000=0{,}0006; "1. grup < 2. grup" (Kontrol < Gübre_A) için de p=3/5000=0{,}0006, "1. grup > 2. grup" için p=4998/5000=0{,}9996. Tasarım dengelidir; sıfır dağılımının ortalaması -0{,}008'dir (kuramsal değeri 0).
56.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablosundan tam hassasiyetle alınmıştır (çalıştırmalar 1–7).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Örnek ayar: F (blok etkisi çıkarılmış) | 16,6088676 | 16,6088676 | 16,6088676 | 1,1e−15 | ✓ |
| Örnek ayar: p (blok içinde, B=1999) | 5,000000·10−4 | 5,000000·10−4 | 5,000000·10−4 | 0 | ✓ |
| Örnek ayar: p (b/B seçeneği) | 0 | 0 | 0 | 0 | ✓ |
| Bloksuz: tek yönlü F | 9,22698679 | 9,22698679 | 9,22698679 | 5,8e−16 | ✓ |
| Bloksuz: p (serbest permütasyon) | 5,000000·10−4 | 5,000000·10−4 | 5,000000·10−4 | 0 | ✓ |
| Fare verisi: ortalama farkı (tedavi − kontrol) | 30,63492063 | 30,63492063 | 30,63492063 | 0 | ✓ |
| Fare verisi: p iki yönlü (B=4999) | 0,2726 | 0,2726 | 0,2726 | 0 | ✓ |
| Fare verisi: p üst kuyruk | 0,1352 | 0,1352 | 0,1352 | 0 | ✓ |
| Fare verisi: p alt kuyruk | 0,8672 | 0,8672 | 0,8672 | 0 | ✓ |
| Fare verisi: medyan farkı (tedavi − kontrol) | 48 | 48 | 48 | 0 | ✓ |
| Fare verisi: medyan farkı p iki yönlü | 0,3022 | 0,3022 | 0,3022 | 0 | ✓ |
| Fare verisi: F (iki grup) | 1,25629441 | 1,25629441 | — | 0 | ✓ |
| Fare verisi: F için p | 0,2726 | 0,2726 | — | 0 | ✓ |
| İki grup + blok: ortalama farkı (Kontrol − Gübre_A) | −1,8205 | −1,8205 | −1,8205 | 0 | ✓ |
| İki grup + blok: p iki yönlü (B=4999) | 6,000000·10−4 | 6,000000·10−4 | 6,000000·10−4 | 0 | ✓ |
| İki grup + blok: p alt kuyruk | 6,000000·10−4 | 6,000000·10−4 | — | 0 | ✓ |
| Dengesiz bloklu veri: blok etkisi çıkarılmış ortalama farkı (A − B) | −1,99666667 | −1,99666667 | — | 7,8e−16 | ✓ |
| Dengesiz bloklu veri: p iki yönlü (şablon B=4999; kesin 2/48400) | 2,000000·10−4 | 2,000000·10−4 | — | 0 | ✓ |
Ölçütü karşılayan: 18/18. Python: F, blok modelinin ve tam modelin artık kareler toplamlarından (kukla değişkenli en küçük kareler, QR); R: anova(lm()), gözlenen F ayrıca vegan::adonis2. Permütasyon p değerlerinde üç hesap aynı etiket düzenlemelerini kullanır (şablonun tohumsuz çalıştırmadaki akışı, default_rng(2026)); istatistik ve sayım kodu bağımsızdır. Bütün düzenlemelerin sayımıyla bulunan kesin p değerleri 56.6'da verilmiştir.
p değerlerindeki eşitlik aynı rastgele düzenlerin kullanılmasına dayanır; düzenler bir kez üretilmiş, istatistik ve sayım üç ayrı kodla yapılmıştır. Şablonun rastgele permütasyonunun kesin değere yakınsadığı Adım 6 ve 7'de gösterilmiştir.
56.7 Çıktıyı okuma
Örnek ayarın konsol metni:
Test istatistiği: F (blok etkisi çıkarılmış) = 16,6089
Permütasyon p = 0,0005 (üst kuyruk; B = 1999; blok içinde: blok)
Gruplar: Kontrol (n = 20), Gübre_A (n = 20), Gübre_B (n = 20)
Sonuç tablosu:
Permütasyon testi
                istatistik  gozlenen  p_permutasyon     B  alternatif  blok   n  grup_sayisi
F (blok etkisi çıkarılmış)   16.6089         0.0005  1999  üst kuyruk  blok  60            3
Fare verisinde ortalama farkı (çalıştırma 4, iki yönlü):
Test istatistiği: Ortalama farkı (tedavi − kontrol) = 30,6349
Permütasyon p = 0,2726 (iki yönlü; B = 4999; serbest permütasyon)
Gruplar: tedavi (n = 7), kontrol (n = 9)
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
istatistik |
İstatistiğin adı; fark istatistiklerinde yönü | "(tedavi − kontrol)": birinci eksi ikinci grup. Blok verildiğinde fark istatistiklerinde ve F'de "blok etkisi çıkarılmış". |
gozlenen |
Gözlenen veride istatistiğin değeri | Fark istatistikleri yanıtın birimindedir (blok verildiğinde blok ortalamalarından arındırılmış yanıtın grup farkı, blok yokken ham fark); F birimsizdir. |
p_permutasyon |
Seçilen tanıma göre p değeri | En küçük değeri 1/(B+1)'dir; bu değer görülüyorsa "p\le1/(B+1)" olarak raporlanır. |
B |
Rastgele karıştırma sayısı | Monte Carlo hatasını belirler. |
alternatif |
iki yönlü, üst kuyruk ya da alt kuyruk | F'de her zaman "üst kuyruk". Üst kuyruk "birinci grup büyük" demektir. |
blok |
Blok sütununun adı ya da "-" | "-" ise karıştırma serbesttir. |
n, grup_sayisi |
Kullanılan gözlem ve düzey sayısı | Eksik satırlar atıldıktan sonraki sayılardır. |
| "Gruplar" satırı | Düzeyler ve büyüklükleri | MerQuR+ düzey sırasındadır: ilk yazılan "1. grup"tur. |
Şekil 56.1. Şablonun şekli (örnek ayar): blok içinde 1999 karıştırmadan elde edilen F değerlerinin dağılımı ve gözlenen değer (dikey çizgi). Sıfır dağılımı 0–10 arasında toplanır; gözlenen 16,61 bütün düzenlerin ötesindedir.
Şekil 56.2. Fare verisinde ortalama farkının (tedavi − kontrol) serbest permütasyon dağılımı (B=4999) ve gözlenen değer 30,63. Dağılım sıfır çevresinde simetriktir; gözlenen değer dağılımın gövdesinde kalır (iki yönlü p = 0,27).
Rapor cümlesi (örnek ayar):
Gübre uygulamalarının verime etkisi, rastgele tam bloklar düzenine uygun olarak grup etiketlerinin blok içinde karıştırıldığı permütasyon testiyle sınandı (3 uygulama, 5 blok, n = 60; 1999 rastgele permütasyon). Blok etkisinden arındırılmış F istatistiği 16,61 bulundu; karıştırılmış düzenlerin hiçbiri bu değere ulaşmadı (p ≤ 0,0005). Uygulama ortalamaları Kontrol 5,37, Gübre A 7,19 ve Gübre B 8,42 idi.
56.8 Sık hatalar ve tuzaklar
- Bloklu denemeyi serbest karıştırmak. Blok sütunu boş bırakılırsa karıştırma tasarımı taklit etmez ve F blok değişkenliğini paydasında taşır (örnek veride 16,61 yerine 9,23). Rastgele tam bloklar, tabakalı örnekleme, çok merkezli çalışma ve gün ya da parti içinde yürütülen deneylerde blok sütunu verilir.
- Dengesiz bloklu veride fark istatistiğinin iki yönlü p değerini yorumlamak. Fark istatistikleri ham ortalamalardan hesaplanır. Grupların bloklardaki payı farklıysa ham fark blok farklarıyla karışır. Kurgusal bir örnek: iki blok (düzeyleri yaklaşık 20 ve 10), birincide 9 A ve 3 B, ikincide 3 A ve 9 B gözlemi; her iki blokta A, B'den düşüktür (blok içi farklar -2{,}74 ve -2{,}58). Ham fark ise A − B =+2{,}35 çıkar, çünkü A gözlemlerinin çoğu yüksek düzeyli bloktadır. Blok içi permütasyon dağılımı 4{,}35 çevresinde toplanır (en küçük 2{,}27, en büyük 6{,}06): gözlenen 2{,}35 dağılımın alt ucundadır, ama çekilen 4999 düzenin hepsinde fark mutlak değerce gözlenenden büyük olduğu için iki yönlü p=1{,}0000 yazılır. Aynı veride alt kuyruk p=0{,}0002 ve blok etkisi çıkarılmış F=29{,}40, p=0{,}0002'dir. Dengesiz bloklu tasarımda F seçilir; yön önemliyse blok içi farkların işaretine bakılır.
- "1. grup"u yanlış varsaymak. Birinci grup MerQuR+ düzey sırasındaki ilk düzeydir: kullanıcının tanımladığı sıra, yoksa sayısal sıra, yoksa verideki ilk görülme (56.2). Tek yönlü sınamadan önce çıktının ilk satırındaki "(… − …)" ifadesi okunur; yön ters ise öteki tek yönlü seçenek seçilir.
- p = 1/(B + 1) değerini kesin p gibi raporlamak. 0{,}0005, "hiçbir düzen gözlenene ulaşmadı" demektir; gerçek p daha küçük olabilir. Daha küçük bir sınır gerekiyorsa B artırılır (B=199999 ile 5\times10^{-6}).
- Küçük B ile eşik çevresinde karar vermek. B=999 ve p\approx0{,}05 için Monte Carlo standart hatası 0{,}007'dir; 0{,}045 ile 0{,}055 ayırt edilemez. Karar eşiğe yakınsa B en az 10 000 seçilir. Her çalıştırma yeni tohum kullandığından p değeri de çalıştırmadan çalıştırmaya bu kadar oynar.
- Çok küçük örneklemde anlamlılık beklemek. Olası düzen sayısı azsa p değerinin alabileceği en küçük değer büyüktür: 3'e 3 iki grupta 20 düzen vardır ve kesin iki yönlü p en az 2/20=0{,}10'dur; B'yi büyütmek bunu değiştirmez.
- Grupların bloklara eşit dağılmadığı tasarım. İki blok, A/B sayıları 9/3 ve 3/9 olan 24 gözlemlik bir veride (blok düzeyleri çok farklı; blok içi A − B farkları −2,74 ve −2,58) ham fark 2,3533'tür ve işareti blok içi farkın tersidir: A'nın çoğu yüksek düzeyli blokta, B'nin çoğu alçak düzeyli blokta yer alır. Şablon blok verildiğinde farkı blok ortalamalarından arındırdığı için gözlenen değer −1,9967 olur; \binom{12}{3}^{2}=48400 blok içi düzenin hepsi sayıldığında sıfır dağılımının ortalaması 0 ve iki yönlü p =2/48400=0{,}0000413'tür; şablon (B=4999) p=1/5000=0{,}0002 yazar (çalıştırma 8). Blok etkisi çıkarılmış F (29{,}40) de aynı p'yi verir. Blok verilmezse fark ham gruplardan hesaplanır ve blok düzeyleriyle karışır.
- Grubun blokla iç içe olduğu veride blok vermek. Her blok tek bir gruptan oluşuyorsa blok içinde karıştırılacak etiket yoktur. Şablon bunu hangi istatistik seçilirse seçilsin "Grup blokla iç içe" iletisiyle bildirir ve durur. Bu durumda analiz birimi bloktur.
- Permütasyon testini varyans eşitsizliğine karşı güvence saymak. Test, sıfır hipotezi altında grupların bütün dağılımının aynı olduğunu varsayar. Ortalamalar eşit ama varyanslar farklıysa ve grup büyüklükleri de farklıysa ortalama farkı testi adlandırılan düzeyi tutmayabilir. Rastgele atamalı deneyde bu varsayım tasarımdan gelir; gözlemsel veride ayrıca düşünülür.
- Gözlemsel veride blok içi değiştirilebilirliği sorgulamamak. Etiketler rastgele atanmamışsa (ör. cinsiyet, tür) karıştırma bir düşünce deneyidir; sonuç "gruplar aynı dağılımdan gelmiyor" biçiminde yorumlanır, nedensel etki olarak değil.
56.9 Uzman soruları
S1. Blok içi permütasyon ile blok etkisini istatistikten çıkarmak aynı şey mi?
Hayır; biri sıfır dağılımını, öteki istatistiği ilgilendirir ve ikisi birbirinin yerine geçmez. Blok içi karıştırma, sıfır dağılımının tasarımdaki rastgele atamayı yansıtmasını sağlar: test geçerli olur. İstatistiğin blok etkisinden arındırılması, gözlenen değerin bu dağılım içinde ne kadar uçta duracağını belirler: test güçlü olur. Şablon F için ikisini birlikte yapar (Anderson ve ter Braak, 2003). Fark istatistiklerinde yalnız birincisi yapılır; dengeli tasarımda bu yeterlidir, çünkü blok etkileri iki grubun ortalamasına eşit ağırlıkla girer ve farkta sadeleşir.
S2. Blok verilmiş F neden yalnız "bloktan sonraki" kareler toplamını kullanıyor; sıra önemli mi?
Karıştırma blok içinde yapıldığı için blok terimi sınanan şey değildir; her düzende aynı kalır ve modelde ilk sırada yer alır. Grubun katkısı bloktan arta kalan değişkenlik üzerinden ölçülür (ardışık, Tip I kareler toplamı; iki ana etkili modelde grubun kısmi kareler toplamıyla aynıdır). Dengeli tasarımda sıra hiçbir şeyi değiştirmez: grubun kareler toplamı tek yönlü çözümlemedekiyle aynıdır (örnek veride ikisi de 93{,}9328). Dengesiz tasarımda fark ortaya çıkar ve doğru olan, blok düzeltmeli kareler toplamıdır. anova(lm(verim ~ blok + grup)) ve vegan::adonis2(…, by = "terms") aynı F'yi verir (16{,}6088676).
S3. Gözlenen düzen neden sayıya katılıyor; p hiç sıfır olamaz mı?
Sıfır hipotezi altında gözlenen düzen, olası düzenlerden rastgele biridir. B rastgele düzenle birlikte B+1 değerlik bir küme oluşur ve gözlenen değerin bu kümedeki sırası tekdüze dağılır; (b+1)/(B+1) bu sıradır. Tam sayımda da gözlenen düzen sayılır ve kesin p en az 1/(\text{düzen sayısı})'dır. p=0 ancak sonsuz sayıda düzen sayılarak ileri sürülebilecek bir iddiadır; b/B tanımı bunu sonlu B ile yazabilir. Phipson ve Smyth (2010) b/B'nin birinci tür hatayı aştığını ve çoklu test düzeltmelerini bozduğunu gösterir.
S4. Rastgele permütasyon yerine tam sayım daha iyi olmaz mı?
Olanaklıysa evet: tam sayımda Monte Carlo hatası yoktur. Fare verisinde 11440 düzenin tamamı sayıldığında iki yönlü p 0{,}2783'tür; şablonun 4999 rastgele düzenle verdiği 0{,}2726 bunun bir Monte Carlo standart hatası (0{,}0063) içindedir. Düzen sayısı hızla büyür: örnek veride 5\times10^{22}. Şablon her durumda rastgele çeker; düzen sayısı B'den küçük olduğunda aynı düzen birçok kez çekilir ve p değeri kesin değerin gürültülü bir kestirimi olur. Çok küçük iki gruplu tasarımda kesin değer için temel programdaki Permütasyon Testi kullanılır.
S5. Medyan farkı testi neyi sınar; Mann-Whitney U'dan farkı ne?
Sıfır hipotezi iki testte de aynıdır: iki grubun dağılımı aynıdır. Fark, hangi sapmaya duyarlı olduklarındadır. Medyan farkı istatistiği ortancaların ayrışmasına, Mann-Whitney U ise bir gruptan çekilen değerin ötekinden büyük olma olasılığının 0,5'ten sapmasına duyarlıdır. Medyan farkının sıfır dağılımı kesikli ve çoğu zaman asimetriktir (fare verisinde ortalaması -2{,}13'tür, sıfır değil): grup büyüklükleri farklıyken tek sayıda ve çift sayıda gözlemin ortancası farklı davranır. Fare verisinde iki yönlü p 0{,}30'dur (kesin 0{,}3024); ortalama farkı için 0{,}28.
S6. Eşleştirilmiş veri bu şablonla sınanabilir mi?
Evet: her çift (ya da her denek) bir blok olarak tanımlanır, koşul grup sütunudur. Blok içi karıştırma iki ölçümün etiketlerini yarı olasılıkla yer değiştirir; bu, eşleştirilmiş permütasyon testindeki işaret değiştirmeyle aynı düzen kümesidir. İstatistik olarak F seçilirse blok (denek) etkisi çıkarılır ve F, eşleştirilmiş t'nin karesine eşittir; ortalama farkı seçilirse de tasarım dengeli olduğundan aynı p değeri elde edilir. Her grupta en az iki gözlem ve n-b-k+1>0 koşulları en az iki çifti gerektirir.
S7. Permütasyon F'sinin p değeri ile normal kuram F'sinin p değeri ne zaman ayrışır?
Hatalar yaklaşık normal ve varyanslar benzerse iki p değeri yakındır: örnek veride sıfır dağılımının %95 yüzdeliği 3{,}250, F_{2,\,53} dağılımınınki 3{,}172'dir. Ayrışma uç değerlerde, çarpık dağılımlarda ve küçük bloklarda görülür. Permütasyon p değerinin alt sınırı 1/(B+1) olduğundan çok küçük p değerlerinde (2{,}5\times10^{-6} gibi) normal kuram daha ayrıntılı bir sayı verir, ama o sayı varsayımlara bağlıdır; permütasyon sonucu "en çok 0{,}0005" der ve tasarımdan başka bir şeye dayanmaz.
S8. İki yönlü p değeri neden iki tek yönlü değerin küçüğünün iki katı değil?
Şablon iki yönlü p'yi mutlak değerden hesaplar: \lvert T^{*}\rvert\ge\lvert T_{\text{göz}}\rvert. Sıfır dağılımı simetrikse bu, küçük kuyruğun iki katına eşittir; simetrik değilse (farklı grup büyüklükleri, çarpık yanıt) iki tanım ayrışır. Fare verisinde kesin değerler: küçük kuyruk 0{,}1410, iki katı 0{,}2820; mutlak değer tanımı 0{,}2783. Bloklu tasarımda fark istatistiği blok etkisinden arındırıldığı için sıfır dağılımı (ortalama farkında) sıfır çevresinde toplanır (56.8).
56.10 Kaynaklar
- Anderson, M. J., & ter Braak, C. J. F. (2003). Permutation tests for multi-factorial analysis of variance. Journal of Statistical Computation and Simulation, 73(2), 85–113. https://doi.org/10.1080/00949650215733
- Edgington, E. S., & Onghena, P. (2007). Randomization tests (4th ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9781420011814
- Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall. https://doi.org/10.1201/9780429246593
- Ernst, M. D. (2004). Permutation methods: A basis for exact inference. Statistical Science, 19(4), 676–685. https://doi.org/10.1214/088342304000000396
- Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
- Good, P. (2005). Permutation, parametric and bootstrap tests of hypotheses (3rd ed.). Springer. https://doi.org/10.1007/b138696
- Harris, C. R., Millman, K. J., van der Walt, S. J., et al. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2008). Implementing a class of permutation tests: The coin package. Journal of Statistical Software, 28(8), 1–23. https://doi.org/10.18637/jss.v028.i08
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. Proceedings of the 9th Python in Science Conference, 56–61. https://doi.org/10.25080/Majora-92bf1922-00a
- Oksanen, J., Simpson, G. L., Blanchet, F. G., et al. (2026). vegan: Community ecology package (R package version 2.7-6). https://doi.org/10.32614/CRAN.package.vegan
- Phipson, B., & Smyth, G. K. (2010). Permutation P-values should never be zero: Calculating exact P-values when permutations are randomly drawn. Statistical Applications in Genetics and Molecular Biology, 9(1), Article 39. https://doi.org/10.2202/1544-6115.1585
- Pitman, E. J. G. (1937). Significance tests which may be applied to samples from any populations. Supplement to the Journal of the Royal Statistical Society, 4(1), 119–130. https://doi.org/10.2307/2984124
- Welch, W. J. (1990). Construction of permutation tests. Journal of the American Statistical Association, 85(411), 693–698. https://doi.org/10.1080/01621459.1990.10474929