63. Moleküler varyans analizi (AMOVA)
Şablon kimliği: amova · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/amova.R (satır 1–484; üstbilgi 1–131) · Örnek veri: _ornek/aeut_aflp.csv · Paketler: poppr 2.9.8, ade4 1.7-24, adegenet 2.1.11, pegas 1.4
63.1 Ne işe yarar
Şablon, bireyler arasındaki genetik farklılığın ne kadarının popülasyonlar arasında, ne kadarının popülasyonların içindeki alt popülasyonlar arasında, ne kadarının da alt popülasyonların içinde kaldığını ölçer. Cevapladığı soru: "Bu belirteçlerde gözlenen toplam genetik çeşitliliğin yüzde kaçı örnekleme hiyerarşisinin hangi düzeyinden geliyor ve bu pay rastlantıyla açıklanabilir mi?" Yöntem, Excoffier, Smouse ve Quattro'nun (1992) moleküler varyans analizidir: varyans çözümlemesinin kareler toplamları tek bir ölçüm yerine birey çiftleri arasındaki genetik uzaklık karelerinden kurulur.
- \sigma^2_a: popülasyonlar arası varyans bileşeni; \sigma^2_b: popülasyon içinde alt popülasyonlar arası; \sigma^2_c: alt popülasyon içi (bireyler arası).
- \sigma^2_T: toplam varyans; bileşenlerin toplamıdır.
- \Phi_{CT}: popülasyonların toplam içindeki ayrışması; \Phi_{SC}: alt popülasyonların kendi popülasyonları içindeki ayrışması; \Phi_{ST}: alt popülasyonların toplam içindeki ayrışması.
- Sıfır hipotezi her düzey için ayrıdır: o düzeydeki birimler bir üst düzeyin içinde rastgele dağılmıştır (\sigma^2=0).
Şablon iki belirteç türünü kabul eder: iki alelin ayrı ayrı okunduğu kodominant belirteçler (mikrosatellit, SNP) ve yalnız bandın varlığının okunduğu dominant belirteçler (AFLP, RAPD, ISSR). Kodominant diploit veride hiyerarşiye bir de birey içi düzey eklenebilir; o zaman en alt bileşen bireyin iki aleli arasındaki farklılıktır ve \Phi istatistikleri F_{IS}, F_{ST} ve F_{IT}'nin karşılıklarıdır (63.4.5).
Ne zaman kullanılır? Örnekleme iç içe bir hiyerarşiyle yapılmışsa (bölge / popülasyon, popülasyon / tarla, tür / meşcere); çok lokuslu genotip ya da bant verisi varsa; farklılaşmanın hem büyüklüğü (yüzde, \Phi) hem de anlamlılığı dağılım varsayımı olmadan isteniyorsa; klonal üreyen bir organizmada yinelenen genotiplerin sonuca etkisi denetlenecekse.
Ne zaman kullanılmaz?
- Veri hizalanmış DNA dizisiyse (mtDNA, kloroplast bölgesi):
dizi_amova(Bölüm 68); uzaklık orada dizilerden hesaplanır. - Yalnız iki düzey (popülasyon / birey) ve lokus bazında F_{IS}, F_{ST}, F_{IT} ile güven aralıkları isteniyorsa:
f_istatistikleri(Bölüm 71). - Popülasyonlar önceden bilinmiyor, veriden kümelenecekse:
populasyon_yapisi(Bölüm 84). - Farklılaşmanın coğrafi uzaklıkla ilişkisi soruluyorsa:
uzaklikla_yalitim(Bölüm 92). - Hiyerarşi çapraz ise (her yıl her tarlada örnek; yıl tarlanın içinde değil): AMOVA iç içe tasarım ister. Çapraz etkenlerin her biri ayrı bir tek düzeyli çözümlemeyle incelenir ya da
bos_rşablonunda (Bölüm 61) uzaklık matrisi üzerindevegan::adonis2çağrılır. - Haploit ya da poliploit genotip verisi: şablonun genotip ayrıştırıcısı yalnız diploit genotip kabul eder (63.2).
Temel programla ilişki. Temel programda genotip verisinden uzaklık kuran ya da uzaklık matrisinden varyans ayrıştıran bir analiz yoktur; oradaki Varyans Bileşenleri Analizi ve İç İçe LMM tek bir ölçüm sütununun varyansını iç içe düzeylere ayırır, çok lokuslu genetik uzaklığı kullanamaz. MerQuR+'ta uzaklık matrisinden kareler toplamı ayrıştıran öteki şablon permanova_mantel'dir (ekoloji kategorisi; tür bolluğu tablosundan uzaklık kurar, tek etken için sözde F ve R^2 verir). AMOVA aynı tür kareler toplamlarından başlar, ancak iç içe hiyerarşinin varyans bileşenlerini (dengesiz örneklem için n katsayılarıyla), \Phi istatistiklerini ve her düzeye özgü permütasyon düzenini ekler; uzaklığı genotip tablosundan kendisi kurar, klon düzeltmesi ve birey içi düzey gibi genetiğe özgü seçenekleri vardır.
63.2 Şablonun girdileri
Form, üstbilgideki on altı [[param]] bloğundan kurulur (amova.R:11–123).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Lokus sütunları · lokuslar |
sütunlar · Değişkenler | yok | en az 1 sütun | Genotip ya da 0/1 tablosu (224, 257–302). |
Popülasyon (üst düzey) · populasyon |
kategorik sütun · Değişkenler | ilk sütun | herhangi bir sütun; en az 2 düzey | Hiyerarşinin üst düzeyi (225–226, 234, 241). |
Popülasyon içinde alt popülasyon / örnek · alt_populasyon |
kategorik sütun · Değişkenler | boş | boş olabilir | Verilirse ~Pop/Subpop, verilmezse ~Pop (227, 235, 242–246, 307). |
Belirteç türü · veri_turu |
seçim · Model | kodominant |
kodominant, dominant |
Veri nesnesinin türü ve uzaklık tablosu (230, 257, 285, 301). |
Alel ayırıcısı (kodominant) · ayirici |
metin · Değişkenler | / |
boş olmayan metin | Genotip metninin bölünmesi (231, 290). |
Eksik genotip kodları · eksik_kodlar |
metin · Değişkenler | boş | virgülle ayrılmış kodlar | Boşsa varsayılan liste (boş hücre, NA, 0, 00, 000, ?, -, ., -9) eksik sayılır; doluysa alandaki kodlar bu listenin yerine geçer (boş hücre ve NA her zaman eksik); baş ve son boşluk kırpılır, boş kodlar atılır (satır 136–137; Bölüm 1.5). |
Birey içi düzeyi ekle · birey_ici |
onay · Model | açık | açık, kapalı | Yalnız kodominantta etkili; within (251, 337). |
Klon düzeltmesi · klon_duzeltme |
onay · Seçenekler | kapalı | açık, kapalı | clonecorrect (323, 337); not satırları (466–469). |
AMOVA uygulaması · yontem |
seçim · Model | ade4 |
ade4, pegas |
Varyans bileşenlerini hesaplayan fonksiyon; çıktının okunduğu dal (311, 340–341, 352–370). p değerleri iki seçenekte de şablonun kendi testinden gelir. |
Permütasyon sayısı · B |
tamsayı · Seçenekler | 199 | 0–9999 | 0 ise test yok (232, 376–404). |
Eksik veri işlemi · eksik_yontem |
seçim · Seçenekler | loci |
loci, geno, mean, zero, ignore |
missing (248–249, 337); dominant veride lokus çıkarma şablonda (275–284). |
Eksik oranı eşiği · eksik_esik |
ondalık · Seçenekler | 0,05 | 0–1 | cutoff; yalnız loci ve geno'da (250, 278–282, 337). |
Öklid olmayan uzaklık düzeltmesi · oklid_duzeltme |
seçim · Gelişmiş | yarı Öklid | quasieuclid, lingoes, cailliez |
correction (312–313, 337). |
Alel sayılarını frekansa çevir · frekans |
onay · Gelişmiş | açık | açık, kapalı | freq; yalnız birey içi düzey yokken (338). |
Çok lokuslu genotipleri uzaklıkla süz · mlg_filtre |
onay · Gelişmiş | kapalı | açık, kapalı | filter; birey içi düzey varken kapatılır (314, 318–322, 338). |
MLG ayrım eşiği · mlg_esik |
ondalık · Gelişmiş | 0 | 0–1000 | threshold (317, 338). |
MLG kümeleme algoritması · mlg_algoritma |
seçim · Gelişmiş | en uzak komşu | en uzak, ortalama, en yakın komşu | algorithm (315–316, 338). |
Örnek ayar (ornek_param, satır 9): lokuslar = L01…L56, populasyon = Pop, alt_populasyon = Subpop, veri_turu = dominant (varsayılan kodominant yerine). Öteki alanlar varsayılandadır; permütasyon sayısı 199'dur.
Hücrelerin biçimi. Kodominant lokusta hücre 152/156 gibi iki alel ve ayırıcıdan oluşur ya da 0, 1, 2 sayısıdır (ikinci alelin kopya sayısı; ayrıştırıcı bunları A/A, A/B, B/B yapar). Genotipleri bütün genetik şablonlarının ortak ayrıştırıcısı okur (satır 136–137; Bölüm 1.5): boş hücre, NA, 0, 00, 000, ?, -, . ve -9 eksik sayılır; iki alel de eksik kodu olmalıdır (0/0). Alellerinden yalnız biri eksik kodu olan genotip (0/152) çalıştırmayı durdurur; 0 verideki gerçek bir alelin adıysa o alel başka bir adla yeniden kodlanır. Eksik sayılan genotiplerin dökümü özet satırından önce yazılır (295). Dominant lokusta hücre 0 ya da 1'dir; boş hücre eksiktir. "Eksik genotip kodları" alanı doluysa bu liste yerine alandaki kodlar eksik sayılır (boş hücre ve NA her zaman eksik) ve yarı eksik genotip için durma kuralı yeni listeyle işler; VCF tarzı 0/1 kodlu veride alana yalnız . yazılınca 0 gerçek bir alel olarak okunur (satır 136–137). AMOVA'da 0 gerçek alel olduğunda poppr bu aleli eksik sayacağından alel adlarının başına a eklenir (satır 291).
Şablonun kendi denetimleri.
| Koşul | İleti | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 223 |
| Popülasyon sütunu boş | "AMOVA için popülasyon sütunu gerekli." | 226 |
| Popülasyon ya da alt popülasyon lokuslar arasında | "Popülasyon sütunları lokus olarak da seçilemez." | 228 |
| Alt popülasyon ile popülasyon aynı sütun | "Alt popülasyon sütunu popülasyon sütunuyla aynı olamaz." | 229 |
| Popülasyonu bilinen 3'ten az birey | "AMOVA için popülasyonu bilinen en az 3 birey gerekli." | 239 |
| Tek popülasyon | "AMOVA için en az iki popülasyon gerekli (popülasyon sütunu tek düzeyli)." | 241 |
| Alt popülasyon sayısı popülasyon sayısını aşmıyor | "Alt popülasyon düzeyi popülasyonlardan fazla düzey içermeli …" | 244–245 |
| Birey içi düzey açık, eksik veri işlemi "Ortalama" ya da "Sıfır ile doldur" | "Birey içi düzey açıkken eksik genotipler ortalama ya da sıfır ile doldurulamaz …" | 252–253 |
| Dominant lokusta 0/1 dışında değer | "… dominant lokusunda 0/1 dışında değer var …" | 264–269 |
| Dominant lokusta hiç veri yok | "… lokusunda hiç veri yok (bütün değerler eksik)." | 270 |
| Dominant veride bütün lokusların eksik oranı eşiğin üstünde | "Bütün lokusların eksik oranı eşiği (…) aşıyor; lokus kalmadı. …" | 280–281 |
| Kodominant lokusta hiç genotip yok | "… lokusunda hiç genotip yok (bütün değerler eksik)." | ortak ayrıştırıcı |
| Sayısal kodominant lokusta 0/1/2 dışında değer | "… sayısal genotip yalnız 0/1/2 (B alelinin sayısı) olabilir …" | ortak ayrıştırıcı |
| Ayırıcı boş | "Alel ayırıcısı boş olamaz." | ortak ayrıştırıcı |
| Genotipte ayırıcı yok (haploit) | "… ayırıcı ('/') içermeyen genotip var …" | ortak ayrıştırıcı |
| Genotipte ikiden çok alel | "… ikiden çok alelli genotip var …; yalnız diploit veri desteklenir." | ortak ayrıştırıcı |
| Genotipin alellerinden yalnız biri eksik kodu | "… genotipte alellerden yalnız biri eksik kodu …" | ortak ayrıştırıcı |
| Bütün lokuslar tek biçimli | "Bütün lokuslar tek biçimli (monomorfik); … AMOVA yapılamaz." | 304–305 |
| Hesap sırasında paket hatası | "AMOVA hesaplanamadı (…). Ayrıntı: …" | 342–344 |
Popülasyon ya da alt popülasyon bilgisi boş olan bireyler çıkarılır ve sayıları not olarak yazılır (236–237). Tek biçimli lokuslar çıkarılmaz; uzaklığa katkıları sıfırdır ve adları not olarak yazılır (303). Belirteç türü kodominant seçiliyken bütün lokuslar yalnız 0 ve 1 içeriyorsa şablon verinin dominant olabileceğini bir uyarıyla bildirir (297–299).
Alt popülasyon adları popülasyonla birleştirilir
Alt popülasyon etiketi, popülasyon adıyla alt çizgiyle birleştirilerek kullanılır (satır 243): Athena popülasyonundaki 1 numaralı tarla Athena_1, Mt. Vernon'daki 1 numaralı tarla Mt. Vernon_1 olur. Böylece farklı popülasyonlarda aynı adı taşıyan alt birimler ayrı sayılır ve hiyerarşi her zaman iç içedir. Bunun karşılığı şudur: aynı alt birim gerçekten iki popülasyonda birden yer alıyorsa (çapraz tasarım) şablon bunu iki ayrı alt popülasyon olarak işler ve uyarı vermez.
63.3 Örnek veri
Dosya: _ornek/aeut_aflp.csv. Bezelyede kök çürüklüğü etmeni Aphanomyces euteiches'in AFLP verisi (Grünwald ve Hoheisel, 2006); poppr paketindeki Aeut veri kümesinin düz tablo biçimidir. 187 izolat, 56 AFLP lokusu (bant var = 1, yok = 0), eksik değer yok. İzolatlar iki bölgeden (Athena, Oregon ve Mt. Vernon, Washington) ve bu bölgelerin içindeki 18 tarladan toplanmıştır.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
birey |
kullanılmaz | sayısal | 001–187. |
Pop |
Popülasyon | ikili | Athena (97 izolat), Mt. Vernon (90 izolat). |
Subpop |
Alt popülasyon | sayısal | Athena'da 1–10, Mt. Vernon'da 1–8; tarla başına 5–17 izolat. |
L01–L56 |
Lokus | ikili | 0/1; 56 lokusun hepsi çok biçimli. |
Arayüzdeki düzey sırası (ilk görülme) Athena, Mt. Vernon'dur; AMOVA'nın hiçbir sonucu düzey sırasına bağlı değildir. Tarla numaraları iki bölgede aynı olduğundan (1, 2, 3 …) 63.2'deki birleştirme kuralı burada iş görür: 18 ayrı alt popülasyon oluşur.
Veri klonal bir organizmadan gelir: 187 izolatta 119 farklı çok lokuslu genotip (56 lokusun hepsinde aynı bant örüntüsü) vardır; aynı tarlada yinelenen genotiplerden biri tutulduğunda 141 izolat kalır (63.6, Adım 6).
Kodominant veri ve birey içi düzey için bölümde ikinci bir veri kullanılır: adegenet paketindeki nancycats (Nancy kentindeki 17 kedi kolonisinden 237 kedi, 9 mikrosatellit lokusu). Kesin karşılaştırma için dokuz lokusun hepsi okunmuş 199 kedi (16 koloni) ayrıca alınmıştır.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) klon düzeltmesi açık; (3) alt popülasyon boş (tek düzey); (4) yontem = pegas; (5) B=999; (6) eksiksiz kedi verisi, kodominant, birey içi düzey açık; (7) aynı veri, birey içi düzey kapalı; (8) frekans dönüşümü kapalı; (9) kedi verisinin tamamı (eksik değerli), eksik veri seçenekleriyle; (10) kedi verisi üç keyfî bölgeye ayrılarak üç düzeyli hiyerarşi; (11) örnek verinin iki lokusuna eksik değer yerleştirilmiş kopyası.
63.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) genotip tablosunu kur, istenmişse klon düzeltmesi ve eksik veri işlemi uygula; (2) birey (ya da haplotip) çiftleri arasındaki Öklid uzaklığını hesapla, uzaklık Öklid özelliği taşımıyorsa düzelt; (3) uzaklık karelerinden kareler toplamlarını çıkar; (4) kareler ortalamalarını beklenen değerlerine eşitleyerek varyans bileşenlerini çöz; (5) \Phi istatistiklerini kur; (6) her bileşeni kendi permütasyon düzeniyle sına.
63.4.1 Uzaklık
- x_{im}: i. birimin tablodaki m. sütun değeri. Dominant veride sütun bir lokustur ve değer 0 ya da 1'dir. Kodominant veride sütun bir aleldir; değer, birey içi düzey varken haplotipte o alelin bulunup bulunmadığı (0/1), birey içi düzey yokken bireydeki alel frekansıdır (0; 0,5; 1).
- M: sütun sayısı (dominantta lokus, kodominantta bütün lokusların alel sayıları toplamı).
- \delta^2_{ij}: Öklid uzaklığının karesi.
Dominant veride \delta^2_{ij} iki bireyin farklı olduğu bant sayısıdır: iki izolat 5 lokusta ayrışıyorsa \delta^2=5. Haplotipler arasında (kodominant, birey içi düzey açık) alellerin farklı olduğu her lokus \delta^2'ye 2 ekler, çünkü iki gösterge sütunu birden değişir.
Neden Öklid uzaklığının karesi?
Varyans çözümlemesindeki kareler toplamı, gözlemlerin ortalamadan sapmaları yerine gözlem çiftleri arasındaki farkların kareleriyle de yazılabilir: \sum_i(x_i-\bar x)^2=\frac{1}{N}\sum_{i<j}(x_i-x_j)^2. AMOVA bu özdeşliği çok sütunlu veriye taşır. Uzaklık Öklid ise AMOVA'nın kareler toplamları, her sütun için ayrı ayrı yapılan iç içe varyans çözümlemelerinin kareler toplamlarının toplamına birebir eşittir (63.6, Adım 2). Yöntemin "moleküler" yanı, sütunların alel ya da bant göstergeleri olmasından ibarettir.
Koddaki tercih
Uzaklığı şablon değil, poppr::poppr.amova kurar (satır 337–341): dist(tab(x, freq = …)), yani tablo satırları arasındaki Öklid uzaklığı. ade4 uygulamasında uzaklık yalnız farklı çok lokuslu genotipler arasında hesaplanır ve her genotipin hangi alt popülasyonda kaç kez görüldüğü ayrı bir sayım tablosuyla verilir; pegas uygulamasında uzaklık bütün bireyler arasındadır. İki yol aynı kareler toplamlarını verir. ade4::amova uzaklığın kendisini alır ve içeride karesini kullanır; uzaklık matrisi Öklid değilse çalışmaz, bu yüzden önce düzeltme uygulanır (63.4.7).
63.4.2 Kareler toplamları
- N: birim sayısı; n_g: g grubundaki birim sayısı.
- \mathrm{KT}_{\text{iç}}(\mathcal G): \mathcal G gruplamasının (popülasyonlar ya da alt popülasyonlar) grup içi kareler toplamı; her grubun kendi içindeki çiftlerin \delta^2 toplamı grubun büyüklüğüne bölünür.
- \mathrm{KT}_a, \mathrm{KT}_b, \mathrm{KT}_c: popülasyonlar arası, popülasyon içinde alt popülasyonlar arası, alt popülasyon içi.
- Serbestlik dereceleri: P-1, S-P, N-S (P popülasyon, S alt popülasyon sayısı); kareler ortalaması \mathrm{KO}=\mathrm{KT}/\mathrm{sd}.
63.4.3 Varyans bileşenleri
Kareler ortalamalarının beklenen değerleri, dengesiz iç içe tasarımdaki gibidir:
- n_s: s alt popülasyonundaki birim sayısı; N_p: p popülasyonundaki birim sayısı.
- n, n', n'': bir kareler ortalamasında her varyans bileşeninin kaç kez sayıldığını gösteren katsayılar. Bütün alt popülasyonlar eşit büyüklükteyse n=n' alt popülasyon büyüklüğüne, n'' popülasyon büyüklüğüne eşittir.
- Tek düzeyde (alt popülasyon yok) yalnız \sigma^2_a=(\mathrm{KO}_a-\mathrm{KO}_b)/n_0 ve \sigma^2_b=\mathrm{KO}_b vardır; n_0=(N-\sum_p N_p^2/N)/(P-1).
Neden ortalama grup büyüklüğü değil de bu katsayılar?
Gruplar eşit büyüklükte değilse bir kareler ortalaması, alttaki varyans bileşenini grup büyüklüklerinin basit ortalaması kadar değil, büyüklüklerin kareleriyle ağırlıklı bir sayı kadar içerir. Katsayılar bu sayılardır; yerlerine basit ortalama konursa kestirici yanlı olur. Örnek veride tarla başına izolat sayısı 5 ile 17 arasında değişir: basit ortalama 187/18=10{,}39, katsayılar ise n=10{,}296 ve n'=11{,}169'dur.
Kestiriciler momentler yöntemine dayanır ve yansızdır; bu yüzden gerçek değeri sıfıra yakın bir bileşenin kestirimi eksi çıkabilir. Şablon bu durumda bir not yazar (satır 477) ve grafikte eksi payı sıfır olarak çizer (481).
63.4.4 Φ istatistikleri
İki düzeyli hiyerarşide üç oran vardır (63.1'deki denklem). Çıktıdaki adları ile yaygın adları şöyle eşleşir:
| Çıktıdaki ad | Tanım | Yaygın adı |
|---|---|---|
| Phi-alt popülasyon-toplam | (\sigma^2_a+\sigma^2_b)/\sigma^2_T | \Phi_{ST} |
| Phi-alt popülasyon-popülasyon | \sigma^2_b/(\sigma^2_b+\sigma^2_c) | \Phi_{SC} |
| Phi-popülasyon-toplam | \sigma^2_a/\sigma^2_T | \Phi_{CT} |
Üçü birbirine (1-\Phi_{ST})=(1-\Phi_{SC})(1-\Phi_{CT}) ile bağlıdır. Tek düzeyde yalnız Phi-popülasyon-toplam =\sigma^2_a/(\sigma^2_a+\sigma^2_b) yazılır; bu, F_{ST}'nin uzaklıkla hesaplanan karşılığıdır.
Neden F değil Φ?
F istatistikleri alel frekanslarının varyansından tanımlanır. \Phi istatistikleri aynı oranları genetik uzaklık karelerinden kurar; uzaklık yalnız "aynı alel mi, farklı mı" bilgisini taşıyorsa \Phi ile F aynı sayıya iner (63.4.5), uzaklık aleller arasındaki mutasyon adımlarını da sayıyorsa (dizi verisi, Bölüm 68) \Phi ek bilgi taşır. Excoffier ve ark. (1992) bu ayrımı belirtmek için ayrı bir simge kullanmıştır.
63.4.5 Birey içi düzey (kodominant diploit)
Birey içi düzey açıkken her birey iki haplotipe (iki alel takımına) bölünür; birim sayısı 2N olur ve hiyerarşinin en altına "birey" eklenir: popülasyon / (alt popülasyon /) birey / haplotip. En alttaki bileşen bir bireyin iki haplotipi arasındaki farklılıktır.
- h_{i1}, h_{i2}: i. bireyin iki haplotipi; hangi alelin hangi haplotipe yazıldığı sonucu değiştirmez, çünkü kareler toplamları her lokusta yalnız grubun alel bileşimine bağlıdır.
- Heterozigot bir lokusta iki haplotip arasındaki \delta^2 2'dir; yarısı o bireyin katkısıdır.
Tek popülasyon düzeyli hiyerarşide üç bileşen ve üç oran çıkar; bunlar Weir ve Cockerham'ın (1984) F istatistiklerinin çok lokuslu (lokuslar üzerinden toplam oranı) kestirimleriyle aynıdır:
| Çıktıdaki ad | Tanım | Karşılığı |
|---|---|---|
| Phi-popülasyon-toplam | \sigma^2_{\text{pop}}/\sigma^2_T | F_{ST} |
| Phi-birey-popülasyon | \sigma^2_{\text{birey}}/(\sigma^2_{\text{birey}}+\sigma^2_{\text{iç}}) | F_{IS} |
| Phi-birey-toplam | (\sigma^2_{\text{pop}}+\sigma^2_{\text{birey}})/\sigma^2_T | F_{IT} |
Eksiksiz kedi verisinde üç değer hierfstat paketinin varyans bileşenleriyle on basamak aynıdır (63.6, Adım 8). "Bireyler arası" bileşenin eksi çıkması heterozigot fazlasını (F_{IS}<0) gösterir.
Birey içi düzey kapatılınca Φ değeri F_{ST} ile karşılaştırılamaz
Birey içi düzey kapalıyken birim bireydir ve uzaklık bireylerin alel frekans vektörleri arasındadır. Bu durumda popülasyon içi kareler ortalaması birey içi varyansın yalnız yarısını içerir: \Phi=\sigma^2_{\text{pop}}/(\sigma^2_{\text{pop}}+\sigma^2_{\text{birey}}+\sigma^2_{\text{iç}}/2). Eksiksiz kedi verisinde birey içi düzeyle \Phi_{\text{pop–toplam}}=0{,}0857 (F_{ST}), birey içi düzey kapalıyken 0{,}1437'dir; popülasyonlar arası bileşen iki çalıştırmada aynıdır (0{,}6030), değişen paydadır. Başka çalışmaların F_{ST} değerleriyle karşılaştırma yapılacaksa birey içi düzey açık bırakılır.
Koddaki tercih
birey_ici, yalnız veri_turu = kodominant iken etkilidir (satır 251); dominant veride heterozigot ayırt edilemediği için düzey eklenmez. poppr.amova(within = TRUE) bireyleri haplotiplere böler ve formüle Individual düzeyini ekler. Bu durumda frekans seçeneği etkisizdir (haplotip tablosu zaten 0/1'dir) ve MLG süzgeci uygulanmaz: paket bu birleşimde süzgeci değil birey içi düzeyi kapatacağından şablon süzgeci kendisi kapatır ve bunu not olarak yazar (satır 318–322). pegas dalında bireyler arası satır "… içinde bireyler arası", hata satırı "Birey içi (hata)" adını alır (430–431). Birey içi düzey kapalıyken frekans kapatılırsa uzaklık alel sayıları (0, 1, 2) üzerinden hesaplanır: bütün kareler toplamları ve varyans bileşenleri 4 katına çıkar, yüzdeler ve \Phi değişmez.
63.4.6 Permütasyon testi
Her varyans bileşeni, sıfır hipotezinin değiştirilebilir kıldığı birimler karıştırılarak sınanır (Excoffier ve ark., 1992):
| Sınanan bileşen | Karıştırılan | Kısıt | Yön |
|---|---|---|---|
| \sigma^2_c (alt popülasyon içi) | bireyler | yok: bütün alt popülasyonlar arasında | küçük |
| \sigma^2_b (alt popülasyonlar arası) | bireyler | yalnız kendi popülasyonunun alt popülasyonları arasında | büyük |
| \sigma^2_a (popülasyonlar arası) | alt popülasyonlar (bütün hâlinde) | popülasyonlar arasında | büyük |
Kural bütün hiyerarşilerde aynıdır: en alt bileşen için birimler bütün veride karıştırılır; bir düzeyin bileşeni için bir alt düzeyin birimleri, o düzeyin bir üst birimi içinde (en üst düzeyde bütün veride) karıştırılır. Birey içi düzey açıkken birim haplotiptir: birey içi bileşen için haplotipler bütün veride, bireyler arası bileşen için haplotipler kendi popülasyonlarının (alt popülasyon varsa alt popülasyonlarının) bireyleri arasında, alt popülasyonlar arası bileşen için bireyler bütün olarak kendi popülasyonlarının alt popülasyonları arasında, popülasyonlar arası bileşen için alt popülasyonlar bütün olarak popülasyonlar arasında yer değiştirir. Tek düzeyde (yalnız popülasyon) tek test vardır: bireyler popülasyonlar arasında karıştırılır.
- \sigma^{2*}_r: r. karıştırmadan sonra yeniden hesaplanan bileşen; B: permütasyon sayısı.
- "Küçük" yön: alt popülasyon içi varyansın, bireyler rastgele dağıtıldığında beklenenden küçük olması yapıyı gösterir; öteki iki bileşende "büyük" yöne bakılır.
- Gözlenene eşit değer veren düzenler de sayılır; karşılaştırma toplam varyansın 10^{-9} katı kadar bir toleransla yapılır, çünkü aynı bölünmenin iki ayrı hesabı son basamaklarda ayrışabilir.
- D: olanaklı farklı düzen sayısı. D\le B ise düzenler rastgele çekilmez, hepsi sayılır (tam sayım); b_{\text{tüm}} gözlenen düzeni de içerir ve p değeri kesindir. Tablonun
sayilan_duzensütunu sayılan düzen sayısını (B ya da D) verir. - Rastgele çekilen düzenlerde en küçük olanaklı değer 1/(B+1)'dir: B=199 için 0{,}005, B=999 için 0{,}001. Tam sayımda en küçük değer, gözlenenle aynı bölünmeyi veren düzenlerin oranıdır.
Neden her düzeyin karıştırma düzeni farklı?
Bir bileşen sınanırken üstündeki ve altındaki yapının bozulmaması gerekir. Popülasyonlar arası bileşen sınanırken bireyler tek tek karıştırılırsa alt popülasyonların iç tutarlılığı da yok edilir ve sıfır dağılımı gereğinden dar çıkar; alt popülasyonlar bütün olarak taşınırsa yalnız "hangi tarla hangi bölgede" bilgisi rastgele olur. Bunun bir sonucu vardır: popülasyon düzeyindeki testin gücünü birey sayısı değil alt popülasyon sayısı belirler. İki popülasyon ve 18 tarlada tarlaların iki bölgeye dağıtılma sayısı büyüktür; iki bölge ve dört tarlada (2 + 2) yalnız altı düzen vardır, bunların ikisi gözlenen bölünmenin kendisidir ve p değeri 2/6'nın altına inemez (Fitzpatrick, 2009). Şablon bu durumda altı düzenin hepsini sayar.
Koddaki tercih
Permütasyon testini paketler değil şablon yapar (satır 139–221 ve 373–404); poppr.amova iki uygulamada da permütasyonsuz çağrılır (nperm = 0, satır 337). Uzaklık kareleri ve hiyerarşi ade4 nesnesinden alınır (distances, samples, structures; 373–379): farklı genotipler arasındaki matris, sayım tablosuyla birim düzeyine açılır. yontem = pegas seçiliyken aynı nesne ikinci bir ade4 çağrısıyla kurulur (378); bu yüzden iki uygulama aynı tohumla aynı sıfır dağılımını ve aynı p değerlerini verir. Her düzen için varyans bileşenleri 63.4.3'teki katsayılarla yeniden çözülür (.am_sigma, 142–169); grup büyüklükleri değiştiği için katsayılar da her düzende yeniden hesaplanır. Olanaklı düzen sayısı çokterimli katsayılardan bulunur (184, 205); B'yi aşmıyorsa düzenlerin hepsi üretilir (178–183, 206–211), aşıyorsa B düzen rastgele çekilir (212–213). Çıktı tablosundaki std_gozlenen, gözlenen değerin sıfır dağılımının ortalamasından standart sapma cinsinden uzaklığıdır; gozlenen sütunu testin kendi hesabıdır ve ade4 uygulamasının bileşenine eşittir (Öklid düzeltmesi devredeyken pegas dalının bileşeninden dördüncü basamakta ayrılabilir; 63.9, S9).
Test paketlere bırakılmaz, çünkü ikisi de bu adımda yanlış sonuç verir. ade4::randtest gözlenen bileşeni R'de, karıştırılmış bileşenleri C'de hesaplar; gözlenenle aynı bölünmeyi veren bir düzenin değeri gözlenenden 10^{-15} düzeyinde ayrılır ve sayılmaz, alt popülasyon sayısı azken p değeri olanaklı en küçük değerin altına iner. pegas::amova ikiden çok düzeyli hiyerarşide ara düzeyi sınarken uzaklık matrisi ile grup etiketlerini aynı sırayla karıştırır (bileşen değişmez, p değeri B/(B+1) çıkar), üst düzeyi bir önceki döngüden kalan karıştırılmış matrisle sınar ve gözlenen düzeni saymadığı için güçlü yapıda 0 yazar.
Rastgele sayı üreteci çalıştırmanın tohumuyla kurulur. Şablon formunda tohum alanı yoktur; tohum Kod panelindeki Tohum alanından verilir (Bölüm 1.3). Alan boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar; kullanılan tohumu künyeye yazar ve betik adımına kaydeder; kayıtlı adım yeniden oynatıldığında aynı p değerleri elde edilir, yeni bir çalıştırmada p değerleri ve std_gozlenen Monte Carlo hatası kadar değişir. Bu bölümdeki sayılar 2026 tohumuyla elde edilmiştir.
63.4.7 Klon düzeltmesi, eksik veri ve Öklid düzeltmesi
Klon düzeltmesi. Açıkken hiyerarşinin en alt düzeyinde (alt popülasyon verilmişse her alt popülasyonun, verilmemişse her popülasyonun içinde) aynı çok lokuslu genotipin yalnız bir kopyası tutulur (clonecorrect(strata = hiyerarşi)). Aynı klonun çok kez örneklenmesi grup içi uzaklıkları sıfıra çeker ve grup içi varyansı küçültür; düzeltme bunu giderir. Klonal organizmalarda düzeltmeli ve düzeltmesiz sonuçlar birlikte raporlanır.
MLG süzgeci. Açıkken, aralarındaki Öklid uzaklığı eşiği aşmayan genotipler tek genotip sayılır (genotipleme hatasına tolerans); klon düzeltmesi bu birleştirilmiş genotipler üzerinden yapılır. Eşik uzaklığın kendisiyle (karesiyle değil) aynı birimdedir: dominant veride 1{,}5 eşiği en çok iki bantta ayrışan genotipleri birleştirir (\sqrt2=1{,}41). Süzgeç klon düzeltmesi kapalıyken de uzaklık matrisini değiştirir (şablon bunu not olarak yazar, satır 324–325); yalnız klon düzeltmesiyle birlikte kullanılır.
Eksik veri. eksik_yontem, poppr::missingno'nun türüdür ve klon düzeltmesinden sonra uygulanır. Tek ayrıcalık dominant veride lokus çıkarmadır: paketin işlevi var/yok tablosunda tek bir eksik hücrede bütün lokusları çıkardığından, eksik oranı eşiği aşan lokusları şablon aynı kuralla (oran > eşik) kendisi, veri nesnesi kurulmadan önce çıkarır (satır 275–284). Çıkarılan lokusların adları ve çözümlemeye giren birey sayısı çıktıya yazılır (456–468).
| Seçenek | Ne yapar |
|---|---|
Eşiği aşan lokusları çıkar (loci) |
Eksik oranı eşiği aşan lokuslar atılır; kalan eksikler yerinde kalır. |
Eşiği aşan bireyleri çıkar (geno) |
Eksik oranı eşiği aşan bireyler atılır. |
Ortalama ile doldur (mean) |
Eksik hücre sütun ortalamasıyla doldurulur. Birey içi düzey açıkken kullanılamaz. |
Sıfır ile doldur (zero) |
Eksik hücreye 0 yazılır. Birey içi düzey açıkken kullanılamaz. |
Dokunma (ignore) |
Hiçbir şey yapılmaz. |
Tabloda kalan eksik hücreler uzaklıkta şöyle ele alınır: iki satırın uzaklığı yalnız ikisinde de dolu olan sütunlardan hesaplanır ve toplam, sütun sayısı oranında büyütülür (stats::dist kuralı). Böyle kurulan bir matris çoğu zaman Öklid özelliğini yitirir.
Öklid düzeltmesi sonuçları değiştirir
Uzaklık matrisi Öklid değilse seçilen düzeltme uygulanır. Yarı Öklid (quasieuclid) matrisin eksi özdeğerlerini atar ve uzaklıkları kalan eksenlerden yeniden kurar; değişiklik küçüktür. Lingoes ve Cailliez bütün uzaklıklara (ya da karelerine) bir sabit ekler; sabit her çifte eşit eklendiği için grup içi uzaklıklar görece daha çok büyür ve \Phi küçülür. Kedi verisinin tamamında (eksik değerli) \Phi_{\text{pop–toplam}} yarı Öklid düzeltmesiyle 0{,}0829, Lingoes ile 0{,}0420, Cailliez ile 0{,}0358'dir. Düzeltme uygulandığında özet satırına ("uzaklık: Öklid, yarı Öklid düzeltmesi uygulandı") ve ayrı bir not satırına yazılır (satır 349–350, 450–457). Eksik değeri olmayan veride matris Öklid'dir ve bu seçenek etkisizdir.
63.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–131 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on altı parametre. | Form buradan kurulur (Bölüm 1.2). |
| 132–137 | Dil yardımcısı; genotip ayrıştırıcısının ve eksik kodlarının ortak yardımcılara bağlanması. | Ayrıştırıcı genetik şablonlarında ortaktır (Bölüm 1.5); yalnız diploit genotip kabul eder. |
| 139–221 | Permütasyon motoru: düzey kodları (.am_kod), varyans bileşenleri (.am_sigma), bütün dizilişlerin üretilmesi ve sayısı (.am_dizilis, .am_dizilis_say), düzenlerin uygulanması (.am_perm), p değeri (.am_p). |
Aynı motor dizi_amova şablonunda da vardır (Bölüm 68). |
| 223–246 | Parametrelerin okunması; hiyerarşi tablosu st (Pop, Subpop); eksik etiketli bireylerin atılması; düzey sayısı denetimleri; alt popülasyon adının popülasyonla birleştirilmesi. |
Etiketler metne çevrilir ve baş–son boşlukları atılır. |
| 248–255 | Eksik veri seçeneklerinin okunması; birey içi düzey ile doldurma seçeneklerinin birleşiminde durma. | Denetim paket çağrılmadan önce yapılır. |
| 256–305 | Veri nesnesi: dominantta 0/1 matrisinden genind(type = "PA"), kodominantta df2genind(ploidy = 2); tek biçimli lokusların saptanması. |
Dominant dalda "0" eksik sayılmaz (262) ve eşiği aşan lokuslar burada çıkarılır (275–284); kodominant dalda genotip dökümü ve 0/1 uyarısı yazılır (295–299). |
| 306–325 | Hiyerarşinin nesneye yazılması, formül (~Pop ya da ~Pop/Subpop), seçeneklerin okunması ve denetimi; library(ade4); MLG süzgeci notları. |
ade4 arama yoluna eklenir, çünkü poppr düzeltme işlevini adıyla arar (309–310). |
| 326–335 | Eksik veri işleminin çıkardığı lokus ve bireylerin belirlenmesi: paketin adımları (klon düzeltmesi, sonra missingno) aynı sırayla yinelenir. |
Yalnız bildirim içindir; hesabı etkilemez. |
| 336–350 | poppr.amova çağrısı; hatalar tek iletiye, uyarılar ve iletiler listeye toplanır; Öklid düzeltmesinin uygulanıp uygulanmadığı saptanır. |
Paketin standart çıktıya yazdığı Lingoes ve Cailliez sabitleri yakalanır, konsola düşmez. |
| 352–371 | Sonuçların tablolara dökülmesi: ade4 dalında kareler toplamları, bileşenler ve \Phi; pegas dalında aynı tablolar ve bileşenlerden hesaplanan \Phi. |
pegas dalında \Phi'leri şablon ade4 tanımıyla hesaplar: ara oranlar \sigma^2_{\text{düzey}} bölü o düzeyin ve altındaki bütün bileşenlerin toplamıdır (366–369). |
| 373–404 | Permütasyon testi: birim düzeyinde uzaklık kareleri ve hiyerarşi, her bileşen için düzenler, tablo ve not satırları. | İki uygulamada da aynı kod çalışır. |
| 405–445 | Paketlerin İngilizce düzey adlarının arayüz diline çevrilmesi. | samples, en alt birimin adıyla değiştirilir (409). |
| 446–484 | Çözümlemeye giren lokus, birey ve popülasyon sayıları; özet satırı ve notlar; dört tablo; negatif bileşen notu; yüzde çubuk grafiği. | Sayılar AMOVA tablosunun serbestlik derecelerinden ve çıkarılan lokuslardan hesaplanır (446–449). |
63.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/amova/elle_hesap.py ile, poppr, ade4 ve pegas kullanılmadan hesaplanmıştır: uzaklık kareleri bant farklarının sayımından, kareler toplamları 63.4.2'deki çift toplamlarından, bileşenler 63.4.3'teki katsayılardan. R tarafında (r_dogrulama.R) kareler toplamları 56 lokusun iç içe varyans çözümlemesinden (lm.fit), kodominant verinin bileşenleri hierfstat::varcomp.glob ile bulunmuştur.
Adım 1 — Uzaklık kareleri. 187 izolat 187\times186/2=17391 çift oluşturur. İlk iki izolat 3 bantta ayrışır (\delta^2=3); birinci ile üçüncü 8 bantta; birinci izolat ile 101. izolat (öteki bölgeden) 37 bantta. Bütün çiftlerin ortalaması 20{,}4430'dur.
Adım 2 — Kareler toplamları.
Popülasyon içi çiftlerden \mathrm{KT}_{\text{iç}}(\text{pop})=849{,}9633, alt popülasyon içi çiftlerden \mathrm{KT}_{\text{iç}}(\text{alt})=576{,}5059 bulunur.
| Kaynak | Kareler toplamı | sd | Kareler ortalaması |
|---|---|---|---|
| Popülasyonlar arası | 1051,2345 | 1 | 1051,2345 |
| Popülasyon içinde alt popülasyonlar arası | 273,4575 | 16 | 17,0911 |
| Alt popülasyon içi | 576,5059 | 169 | 3,4113 |
| Toplam | 1901,1979 | 186 |
Aynı üç kareler toplamı ikinci bir yoldan, her lokusun 0/1 sütununa ayrı ayrı iç içe varyans çözümlemesi uygulanıp 56 lokus üzerinden toplanarak da elde edilir: 1051{,}2345; 273{,}4575; 576{,}5059. Uzaklık matrisi üzerinden hesap ile sütunlar üzerinden hesap aynı şeydir (63.4.1).
Adım 3 — Katsayılar. Tarla büyüklükleri eşit olmadığından:
Adım 4 — Varyans bileşenleri.
Toplam 15{,}8034; paylar %70,01, %8,41 ve %21,59.
Adım 5 — Φ istatistikleri.
Denetim: (1-0{,}2803)(1-0{,}7001)=0{,}2159=1-0{,}7841. Bu değerler, poppr öğreticisinde aynı veri için yayımlanan değerlerdir (\sigma^2: 11,063446; 1,328667; 3,411277; \Phi: 0,7841427; 0,2803128; 0,7000679).
Adım 6 — Klon düzeltmesi (çalıştırma 2). Aynı tarlada yinelenen genotiplerden biri tutulunca 141 izolat kalır. Serbestlik dereceleri 1, 16 ve 123; bileşenler 10{,}4132; 0{,}9521; 4{,}2286 (toplam 15{,}5938); \Phi_{CT}=0{,}6678, \Phi_{SC}=0{,}1838, \Phi_{ST}=0{,}7288. Tarla içi varyans 3{,}41'den 4{,}23'e çıkar (özdeş izolatların sıfır uzaklıkları ayıklanmıştır) ve tarlalar arası farklılaşma 0{,}28'den 0{,}18'e iner: düzeltmesiz sonuçtaki tarla ayrışmasının bir bölümü aynı klonun aynı tarladan birden çok kez toplanmasından gelmektedir. Bölgeler arası ayrışma güçlü kalır.
Adım 7 — Permütasyon sıfır dağılımları. Üç düzen (63.4.6) ayrı bir kodla 999'ar kez uygulanmıştır:
| Bileşen | Gözlenen | Sıfır dağılımının ortalaması | Standart sapması | En uç sıfır değeri | p |
|---|---|---|---|---|---|
| \sigma^2_c (küçük) | 3,4113 | 10,2202 | 0,2189 | 9,3466 (en küçük) | 0,001 |
| \sigma^2_b (büyük) | 1,3287 | 0,0037 | 0,0663 | 0,2667 (en büyük) | 0,001 |
| \sigma^2_a (büyük) | 11,0634 | 0,0604 | 1,1184 | 5,8939 (en büyük) | 0,001 |
Aynı düzenleri izleyen ade4::randtest aynı veride 9999 permütasyonla ortalamaları 10{,}2200; 0{,}0021; 0{,}0378 ve standart sapmaları 0{,}2128; 0{,}0658; 1{,}1177 verir; üç sıfır dağılımı bağımsız kodla da paketle de aynıdır. Bireyler bütün tarlalara rastgele dağıtıldığında tarla içi varyans toplam kareler ortalamasına (10{,}22) yaklaşır; gözlenen 3{,}41 bunun 31 standart sapma altındadır. Bölge düzeyinde sıfır dağılımı çok daha geniştir (standart sapma 1{,}12), çünkü 18 tarlanın iki bölgeye dağıtılması az sayıda büyük parçayı yer değiştirir; şablonun std_gozlenen değerinin bu satırda çalıştırmadan çalıştırmaya en çok oynaması (199 permütasyonla 8{,}0; başka bir tohumla 11{,}1) bundandır.
Adım 8 — Kodominant veri, birey içi düzey (çalıştırma 6). Eksiksiz kedi verisinde 199 kedi 398 haplotipe bölünür. Dokuz lokusta heterozigot lokus–birey çifti sayısı 1130'dur; bu sayı doğrudan birey içi kareler toplamıdır.
| Kaynak | Kareler toplamı | sd | \hat\sigma^2 | % |
|---|---|---|---|---|
| Popülasyonlar arası | 331,1252 | 15 | 0,6030 | 8,57 |
| Popülasyon içinde bireyler arası | 1314,8547 | 183 | 0,7533 | 10,71 |
| Birey içi | 1130,0000 | 199 | 5,6784 | 80,72 |
Katsayılar n=n'=2 (her bireyde iki haplotip) ve n''=24{,}6915'tir. \Phi değerleri: popülasyon–toplam 0{,}0857 (F_{ST}); birey–popülasyon 0{,}1171 (F_{IS}); birey–toplam 0{,}1928 (F_{IT}). hierfstat::varcomp.glob aynı veride varyans bileşenlerini 0{,}6030431; 0{,}7533033; 5{,}6783920 ve F_{ST}=0{,}0857236, F_{IS}=0{,}1171236 olarak verir.
Adım 9 — Birey içi düzey kapalı (çalıştırma 7 ve 8). Uzaklık bireylerin alel frekans vektörleri arasında hesaplanır: \hat\sigma^2_a=0{,}6030 (aynı), \hat\sigma^2_b=3{,}5925 ve \Phi=0{,}1437. 3{,}5925=0{,}7533+5{,}6784/2'dir (63.4.5). Frekans dönüşümü kapatılırsa bileşenler dört katına çıkar (2{,}4122 ve 14{,}3700), \Phi değişmez.
63.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–4 ve 6–8).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Örnek: KT popülasyonlar arası | 1051,23451617 | 1051,23451617 | 1051,23451617 | 2,2e−16 | ✓ |
| Örnek: KT alt popülasyonlar arası | 273,45745101 | 273,45745101 | 273,45745101 | 3,5e−15 | ✓ |
| Örnek: KT alt popülasyon içi | 576,50589378 | 576,50589378 | 576,50589378 | 3,9e−16 | ✓ |
| Örnek: KT toplam | 1901,19786096 | 1901,19786096 | 1901,19786096 | 1,7e−15 | ✓ |
| Örnek: KO popülasyonlar arası | 1051,23451617 | 1051,23451617 | 1051,23451617 | 2,2e−16 | ✓ |
| Örnek: KO alt popülasyonlar arası | 17,09109069 | 17,09109069 | 17,09109069 | 6,2e−16 | ✓ |
| Örnek: KO alt popülasyon içi | 3,41127748 | 3,41127748 | 3,41127748 | 7,8e−16 | ✓ |
| Örnek: \sigma^2_a | 11,06344585 | 11,06344585 | 11,06344585 | 6,4e−16 | ✓ |
| Örnek: \sigma^2_b | 1,3286673 | 1,3286673 | 1,3286673 | 2,2e−15 | ✓ |
| Örnek: \sigma^2_c | 3,41127748 | 3,41127748 | 3,41127748 | 7,8e−16 | ✓ |
| Örnek: \sigma^2_T | 15,80339063 | 15,80339063 | 15,80339063 | 2,8e−15 | ✓ |
| Örnek: % popülasyonlar arası | 70,00678593 | 70,00678593 | 70,00678593 | 1,4e−15 | ✓ |
| Örnek: % alt popülasyonlar arası | 8,40748251 | 8,40748251 | 8,40748251 | 4,6e−15 | ✓ |
| Örnek: % alt popülasyon içi | 21,58573156 | 21,58573156 | 21,58573156 | 4,6e−15 | ✓ |
| Örnek: \Phi_{ST} (alt popülasyon–toplam) | 0,78414268 | 0,78414268 | 0,78414268 | 1,0e−15 | ✓ |
| Örnek: \Phi_{SC} (alt popülasyon–popülasyon) | 0,28031282 | 0,28031282 | 0,28031282 | 1,0e−15 | ✓ |
| Örnek: \Phi_{CT} (popülasyon–toplam) | 0,70006786 | 0,70006786 | 0,70006786 | 1,0e−15 | ✓ |
| Klon düzeltmeli: \sigma^2_a | 10,41315253 | 10,41315253 | 10,41315253 | 3,2e−15 | ✓ |
| Klon düzeltmeli: \sigma^2_b | 0,95205445 | 0,95205445 | 0,95205445 | 8,9e−16 | ✓ |
| Klon düzeltmeli: \sigma^2_c | 4,228555 | 4,228555 | 4,228555 | 2,3e−15 | ✓ |
| Klon düzeltmeli: \Phi_{ST} | 0,72883035 | 0,72883035 | 0,72883035 | 2,2e−16 | ✓ |
| Klon düzeltmeli: \Phi_{SC} | 0,18377267 | 0,18377267 | 0,18377267 | 1,0e−15 | ✓ |
| Klon düzeltmeli: \Phi_{CT} | 0,6677768 | 0,6677768 | 0,6677768 | 1,1e−16 | ✓ |
| Tek düzey: \sigma^2_a | 11,2097195 | 11,2097195 | 11,2097195 | 3,0e−15 | ✓ |
| Tek düzey: \sigma^2_b | 4,59439646 | 4,59439646 | 4,59439646 | 7,7e−16 | ✓ |
| Tek düzey: \Phi_{ST} | 0,70929114 | 0,70929114 | 0,70929114 | 1,1e−16 | ✓ |
| İkinci uygulama (pegas): \sigma^2_a | 11,06344585 | 11,06344585 | 11,06344585 | 6,4e−16 | ✓ |
| İkinci uygulama (pegas): \Phi_{SC} | 0,28031282 | 0,28031282 | 0,28031282 | 1,0e−15 | ✓ |
| Kodominant, birey içi düzeyli: KT popülasyonlar arası | 331,12516148 | 331,12516148 | — | 6,9e−16 | ✓ |
| Kodominant, birey içi düzeyli: KT bireyler arası | 1314,85473802 | 1314,85473802 | — | 2,1e−15 | ✓ |
| Kodominant, birey içi düzeyli: KT birey içi | 1130 | 1130 | — | 1,8e−14 | ✓ |
| Kodominant, birey içi düzeyli: \sigma^2 popülasyonlar arası | 0,60304307 | 0,60304307 | 0,60304307 | 1,6e−15 | ✓ |
| Kodominant, birey içi düzeyli: \sigma^2 bireyler arası | 0,7533033 | 0,7533033 | 0,7533033 | 5,4e−14 | ✓ |
| Kodominant, birey içi düzeyli: \sigma^2 birey içi | 5,67839196 | 5,67839196 | 5,67839196 | 1,8e−14 | ✓ |
| Kodominant: \Phi birey–toplam (F_{IT}) | 0,19280694 | 0,19280694 | 0,19280694 | 9,0e−15 | ✓ |
| Kodominant: \Phi birey–popülasyon (F_{IS}) | 0,1171236 | 0,1171236 | 0,1171236 | 9,0e−15 | ✓ |
| Kodominant: \Phi popülasyon–toplam (F_{ST}) | 0,0857236 | 0,0857236 | 0,0857236 | 4,0e−16 | ✓ |
| Kodominant, birey içi düzeysiz: \sigma^2_a | 0,60304307 | 0,60304307 | 0,60304307 | 1,0e−15 | ✓ |
| Kodominant, birey içi düzeysiz: \sigma^2_b | 3,59249928 | 3,59249928 | 3,59249928 | 3,0e−15 | ✓ |
| Kodominant, birey içi düzeysiz: \Phi_{ST} | 0,14373423 | 0,14373423 | 0,14373423 | 1,1e−16 | ✓ |
| Aynı, alel sayılarıyla (frekans kapalı): \sigma^2_a | 2,41217228 | 2,41217228 | — | 5,5e−16 | ✓ |
Ölçütü karşılayan: 41/41. Python: ikili uzaklık karelerinden Excoffier ve ark. (1992) formülleri (numpy). R: çok değişkenli iç içe varyans çözümlemesinin kareler toplamları (lm.fit) ve açık katsayı formülleri; kodominant veride hierfstat::varcomp.glob. KT: kareler toplamı; KO: kareler ortalaması.
Permütasyon p değerleri bu tabloda yoktur; iki ayrı yoldan denetlenmiştir. Rastgele çekilen düzenlerde sıfır dağılımlarının bağımsız kodla aynı ortalama ve yayılımı verdiği Adım 7'de gösterilmiştir. Tam sayımda p değeri kesindir ve bağımsız sayımla karşılaştırılabilir: fare dizilerinin 0/1 kodlanmış konumlarından kurulan dört popülasyonluk örnekte (iki grup, 2 + 2) şablon iki uygulamada da popülasyonlar arası bileşen için p=2/6=0{,}3333, sekiz popülasyonluk kurgusal örnekte (4 + 4) p=6/70=0{,}0857 yazar; bütün düzenlerin ayrı kodla sayımı aynı değerleri verir (dogrulama/dizi_amova/elle_hesap.py).
63.7 Çıktıyı okuma
Örnek ayarın konsol metni ve tabloları:
AMOVA (ade4; dominant belirteç, 56 lokus, 187 birey, 2 popülasyon, 18 alt popülasyon; uzaklık: Öklid; birey içi düzey yok)

AMOVA tablosu (serbestlik derecesi, kareler toplamı, kareler ortalaması)
                                   kaynak  sd  kareler_toplami  kareler_ortalamasi
                      Popülasyonlar arası   1        1051.2345           1051.2345
Popülasyon içinde alt popülasyonlar arası  16         273.4575             17.0911
                       Alt popülasyon içi 169         576.5059              3.4113
                                   Toplam 186        1901.1979             10.2215

Varyans bileşenleri (σ² ve toplam varyanstaki %)
                                  bilesen   sigma2     yuzde
                      Popülasyonlar arası  11.0634   70.0068
Popülasyon içinde alt popülasyonlar arası   1.3287    8.4075
                       Alt popülasyon içi   3.4113   21.5857
                                   Toplam  15.8034  100.0000

Φ istatistikleri
                   istatistik     Phi
    Phi-alt popülasyon-toplam  0.7841
Phi-alt popülasyon-popülasyon  0.2803
        Phi-popülasyon-toplam  0.7001

Permütasyon testi (199 permütasyon)
                   test  gozlenen  std_gozlenen    yon      p  sayilan_duzen
     Alt popülasyon içi    3.4113      -34.0155  küçük  0.005            199
Alt popülasyonlar arası    1.3287       19.3294  büyük  0.005            199
    Popülasyonlar arası   11.0634        7.9864  büyük  0.005            199

Not: p değerleri paketin permütasyon testinden alınmaz; şablonun kendi permütasyon düzeniyle hesaplanır (Excoffier, Smouse ve Quattro 1992): …
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Özet satırı | Uygulama, belirteç türü, lokus, birey, popülasyon ve alt popülasyon sayıları, birey içi düzeyin durumu | Sayılar çözümlemeye giren lokus, birey ve popülasyon sayılarıdır (eksik veri işleminden ve klon düzeltmesinden sonra). Lokus çıkarılmışsa adları, birey sayısı azalmışsa nedeni ayrı not satırlarında yazılır; Öklid düzeltmesi uygulanmışsa "uzaklık: Öklid" ifadesinin yanında belirtilir. |
| AMOVA tablosu | Her kaynağın serbestlik derecesi, kareler toplamı ve ortalaması | "Toplam" satırındaki kareler ortalaması bir bileşen değildir; karşılaştırma için verilir. |
sigma2 |
Varyans bileşeni | Uzaklık karesi birimindedir (dominantta "bant farkı"). Eksi değer, o düzeyde yapı olmadığını gösterir. |
yuzde |
Bileşenin toplam içindeki payı | Raporlanan asıl büyüklük budur; eksi bileşen varsa yüzdeler 100'ü aşan ve eksi değerler içerir. |
| Φ istatistikleri | Üç oran (63.4.4) | 0 ayrışma yok, 1 tam ayrışma. Birey içi düzey açıkken dört düzeyde dört oran yazılır. |
gozlenen |
Sınanan varyans bileşeni | Varyans bileşenleri tablosundaki değerle aynıdır (pegas uygulamasında Öklid düzeltmesi devredeyken dördüncü basamakta ayrılabilir). |
std_gozlenen |
(gözlenen − sıfır ortalaması) / sıfır standart sapması | Büyüklüğü etkinin sıfır dağılımına göre konumunu verir; p değerinin taban değerine ulaştığı durumda ayırt edici bilgi budur. |
yon |
Sınamanın yönü | En alt bileşen "küçük", ötekiler "büyük" yönde sınanır. |
p |
(b+1)/(B+1); tam sayımda b_{\text{tüm}}/D | 1/(B+1) görülüyorsa "p\le1/(B+1)" olarak raporlanır. Tam sayımın p değeri kesindir ve olduğu gibi yazılır. |
sayilan_duzen |
Testte sayılan düzen sayısı | B'ye eşitse düzenler rastgele çekilmiştir; B'den küçükse olanaklı bütün düzenler sayılmıştır ve ayrı bir not satırı bunu bildirir. |
Şekil 63.1. Şablonun şekli (örnek ayar): varyans bileşenlerinin toplam içindeki payları. Farklılığın %70'i iki bölge arasındadır; tarlalar arası pay %8, tarla içi pay %22'dir.
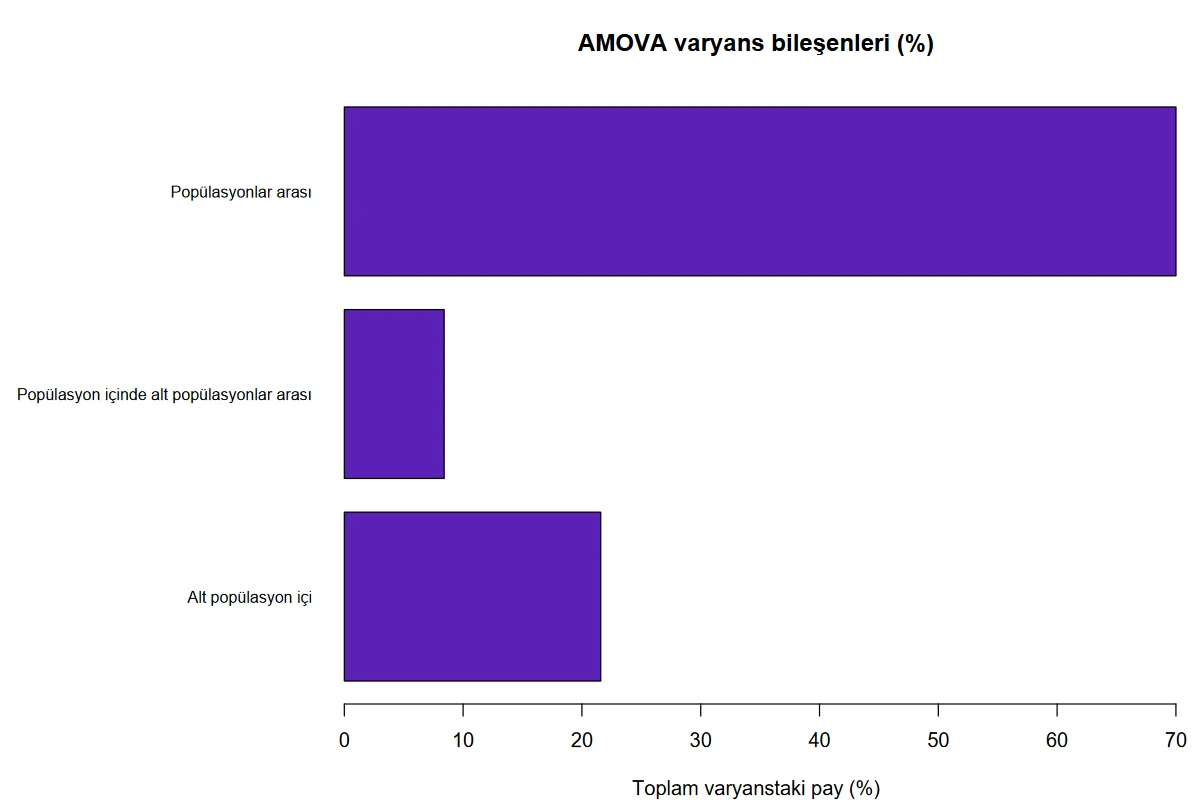
Kodominant veride (çalıştırma 6) özet satırı ve \Phi tablosu şöyledir:
AMOVA (ade4; kodominant belirteç, 9 lokus, 199 birey, 16 popülasyon; uzaklık: Öklid; birey içi düzey eklendi)

Φ istatistikleri
           istatistik     Phi
     Phi-birey-toplam  0.1928
 Phi-birey-popülasyon  0.1171
Phi-popülasyon-toplam  0.0857
Rapor cümlesi (örnek ayar):
Aphanomyces euteiches izolatlarının 56 AFLP lokusundaki genetik farklılığı moleküler varyans analiziyle bölge, bölge içinde tarla ve tarla içi düzeylerine ayrıldı (187 izolat, 2 bölge, 18 tarla; bant farkı sayısına dayalı Öklid uzaklığı; 999 permütasyon). Toplam varyansın %70,0'ı bölgeler arasında (\Phi_{CT} = 0,700; p ≤ 0,001), %8,4'ü bölge içinde tarlalar arasında (\Phi_{SC} = 0,280; p ≤ 0,001), %21,6'sı tarlaların içinde bulundu (\Phi_{ST} = 0,784). Aynı tarlada yinelenen çok lokuslu genotipler ayıklandığında (141 izolat) oranlar sırasıyla 0,668; 0,184 ve 0,729 oldu.
63.8 Sık hatalar ve tuzaklar
- Dominant 0/1 veriyi kodominant olarak işaretlemek. Belirteç türü varsayılanda kodominanttır. 0/1 sütunları sayısal genotip (0 ve 1 kopya) olarak okunur, birey içi düzey eklenir ve anlamsız bir tablo çıkar: örnek veride popülasyonlar arası pay %70 yerine %29, "bireyler arası" bileşen -9{,}75 olur. Şablon bütün lokuslar yalnız 0 ve 1 içerdiğinde bir uyarı yazar, ama çalıştırmayı durdurmaz. AFLP, RAPD ve ISSR verisinde belirteç türü "Dominant 0/1" seçilir.
- Eksik veri işleminin neyi çıkardığına bakmamak. "Eşiği aşan lokusları çıkar" yalnız eşiğin üstündeki lokusları atar; eşiğin altında kalan eksik hücreler tabloda kalır ve yarı Öklid düzeltmesini devreye sokar. Örnek verinin iki lokusuna eksik değer yerleştirilmiş kopyasında (bir lokusta %10,7, ötekinde %2,7) ilk lokus çıkarılır, çözümleme 55 lokusla yapılır ve özet satırı düzeltmenin uygulandığını yazar.
- Birey içi düzey açıkken "Ortalama" ya da "Sıfır ile doldur" seçmek. Doldurulmuş tablo tam sayı olmaktan çıkar ve haplotiplere bölünemez; şablon bu birleşimi hesaptan önce açık bir iletiyle durdurur. Kodominant veride doldurma seçenekleri yalnız birey içi düzey kapalıyken kullanılabilir.
- Raporda girdideki lokus ve birey sayısını yazmak. Kedi verisinin tamamında (237 kedi, 9 lokus) varsayılan ayar iki lokusu (eksik oranı %8,4 ve %8,9) çıkarır; özet satırı "7 lokus" yazar ve çıkarılan lokusların adlarını bir not satırında verir. "Eşiği aşan bireyleri çıkar" seçeneğinde 38 kedi ve bir koloni çözümlemeden çıkar; özet satırı "199 birey, 16 popülasyon" yazar. Rapora bu sayılar girer.
- İki uygulamanın farklı p değeri vermesini beklemek. p değerleri iki uygulamada da şablonun kendi testinden gelir ve aynı tohumla birebir aynıdır;
pegasseçeneği yalnız kareler toplamlarını ve varyans bileşenlerini ikinci bir uygulamayla denetler. Kedi verisi üç keyfî bölgeye ayrıldığında (çalıştırma 10) koloniler arası bileşen iki uygulamada da p=0{,}01, bölgeler arası bileşen p=0{,}31 çıkar. pegasuygulamasında "(hata)" satırını ayrı bir bileşen sanmak.pegasen alt bileşeni "hata" olarak adlandırır: birey içi düzey açıkken "Birey içi (hata)", kapalıyken "Popülasyon içi (hata)" ya da "Alt popülasyon içi (hata)". Bu satırade4tablosundaki en alt satırla aynı bileşendir. \Phi oranları iki uygulamada aynı tanımla hesaplanır; kedi verisinin üç bölgeli hiyerarşisinde "Phi-alt popülasyon-popülasyon"ade4ile 0{,}0815,pegasile 0{,}0808'dir (fark Öklid düzeltmesinden gelir; 63.9, S9).- Birey içi düzey kapalıyken Φ'yi F_{ST} diye raporlamak. Payda birey içi varyansın yarısını içerir; değer F_{ST}'den büyüktür (63.4.5).
- Az sayıda alt popülasyonla popülasyon düzeyinde küçük bir p değeri beklemek. Popülasyonlar arası bileşen alt popülasyonların yer değiştirmesiyle sınanır; S alt popülasyonun S_1'i birinci popülasyondaysa \binom{S}{S_1} düzen vardır ve gözlenen bölünmeyi veren düzenler de bunların içindedir. Dört alt popülasyonda (2 + 2) altı düzenin ikisi gözlenenin kendisidir; p değeri en az 0{,}333'tür ve permütasyon sayısı artırılarak küçültülemez. Fare dizilerinin 0/1 kodlanmış konumlarından kurulan dört popülasyonluk bir örnekte (iki grup; \Phi_{CT}=0{,}026) şablon altı düzeni sayar ve p=0{,}3333 yazar; sekiz alt popülasyonlu (4 + 4) kurgusal örnekte 70 düzenden p=0{,}0857 çıkar. Bu düzeyde anlamlılık isteniyorsa çözüm daha çok alt popülasyon örneklemektir (Fitzpatrick, 2009).
- Her popülasyonda tek alt popülasyon. Alt düzey popülasyondan ayrılamaz; şablon bunu iletiyle durdurur. Alt popülasyon alanı boş bırakılır.
- Çapraz yapıyı iç içe sanmak. Aynı adlı alt birimler her popülasyonda ayrı sayılır (63.2). Örnekleme yılı gibi çapraz bir etken alt popülasyon olarak verilirse yıl etkisi her popülasyonun içinde ayrı ayrı kestirilir.
- Klonal türde tek sonuç raporlamak. Düzeltmesiz sonuç klonların çoğalmasını, düzeltmeli sonuç genotipler arası farklılaşmayı yansıtır; ikisi farklı sorulara cevap verir.
- Eksi varyans bileşenini hesap hatası sanmak. Yansız kestirici, gerçek değeri sıfır olan bileşende yaklaşık yarı yarıya eksi değer verir. Eksi bileşen sıfır kabul edilir; öteki bileşenlerin yüzdeleri buna göre okunur.
- Lingoes ya da Cailliez düzeltmesini gerekçesiz seçmek. İki düzeltme uzaklıklara sabit ekler ve \Phi'yi belirgin biçimde küçültür (63.4.7).
- Permütasyon sayısını çok küçük girmek. Rastgele çekilen düzenlerde p değeri 1/(B+1)'in altına inemez: B=1 ile en küçük değer 0{,}5, B=19 ile 0{,}05'tir. Test istenmiyorsa 0, isteniyorsa en az 199 girilir.
63.9 Uzman soruları
S1. AMOVA'nın kareler toplamları ile lokus bazında varyans çözümlemesinin ilişkisi nedir?
Uzaklık Öklid olduğunda ikisi aynıdır. Her tablo sütunu (bant ya da alel göstergesi) için ayrı ayrı iç içe varyans çözümlemesi yapılıp kareler toplamları sütunlar üzerinden toplanırsa AMOVA tablosu elde edilir; örnek veride iki yol on basamak aynı sonucu verir (63.6, Adım 2). Bu yüzden AMOVA'nın varyans bileşenleri lokusların varyans bileşenlerinin toplamıdır ve \Phi, lokuslar üzerinden "toplamların oranı"dır; lokus bazındaki oranların ortalaması değildir. Çok değişken lokuslar sonuca daha çok ağırlık verir.
S2. Birey içi düzeyli Φ değerleri neden Weir ve Cockerham'ın F istatistiklerine eşit?
Haplotip düzeyinde alel göstergeleriyle kurulan iç içe varyans çözümlemesi, Weir ve Cockerham'ın (1984) a, b, c bileşenlerini veren çözümlemenin kendisidir: popülasyonlar arası, popülasyon içinde bireyler arası ve birey içi (gametler arası). Katsayılar da aynıdır (n=n'=2; n'', iki katına çıkarılmış n_c). Michalakis ve Excoffier (1996) bu eşdeğerliği göstermiştir. Eksiksiz veride sonuçlar birebir aynıdır; eksik genotip varsa iki yol eksikleri farklı işlediğinden (lokus bazında dışlama ile uzaklığın ölçeklenmesi) küçük farklar oluşur. Mikrosatellit gibi çok alelli belirteçlerde popülasyon içi çeşitlilik yüksekken bu oranlar tam ayrışmada bile 1'e ulaşamaz; belirteçler ya da türler arası karşılaştırma için standartlaştırılmış bir ölçü önerilmiştir (Meirmans, 2006).
S3. Dominant veride \Phi_{ST}, F_{ST}'nin kestirimi sayılabilir mi?
Dolaylı olarak. Dominant belirteçte heterozigot ile baskın homozigot ayırt edilemez; uzaklık bant fenotipleri arasındadır, alel frekansları arasında değil. \Phi_{ST} bu durumda fenotipik farklılaşmanın ölçüsüdür ve alel frekansına dayalı F_{ST} ile ancak ek varsayımlarla (Hardy–Weinberg dengesi ya da bilinen bir kendileme oranı) ilişkilendirilebilir. Uygulamada dominant belirteçlerde \Phi raporlanır ve "bant fenotiplerine dayalı" olduğu belirtilir (Peakall ve ark., 1995). Haploit ya da tümüyle klonal organizmalarda bant örüntüsü genotipin kendisidir ve bu sakınca ortadan kalkar.
S4. Popülasyon düzeyindeki test neden alt popülasyonları bütün olarak taşıyor?
Sıfır hipotezi "alt popülasyonların popülasyonlara dağılımı rastlantısaldır" biçimindedir; alt popülasyonların kendi aralarındaki farklılık bu hipotezde serbesttir. Bireyler tek tek karıştırılırsa bu farklılık da silinir, sıfır dağılımı daralır ve popülasyon etkisi olduğundan anlamlı görünür: klasik iç içe varyans çözümlemesinde üst düzeyi artık kareler ortalamasına bölmekle aynı yanlıştır. Doğru hata terimi alt popülasyonlar arası değişkenliktir; permütasyon karşılığı da alt popülasyonların bütün olarak yer değiştirmesidir. Örnek veride bu yüzden bölge düzeyindeki sıfır dağılımının standart sapması (1{,}12) tarla düzeyindekinin (0{,}07) on yedi katıdır.
S5. p değeri 0,005'te kalıyor; daha küçük bir değer nasıl raporlanır?
1/(B+1) bir alt sınırdır: 199 permütasyonun hiçbiri gözlenene ulaşmamıştır. Daha keskin bir sınır için permütasyon sayısı artırılır (999 ile 0{,}001; 9999 ile 0{,}0001). Etkinin büyüklüğü std_gozlenen ile ve asıl olarak varyans yüzdesi ve \Phi ile anlatılır; p değeri "p\le0{,}001" biçiminde yazılır. Gözlenen düzen sayıma katıldığı için p değeri hiçbir zaman 0 yazılmaz (Phipson ve Smyth, 2010).
S6. Klon düzeltmesi hangi düzeyde yapılıyor ve neden önemli?
Hiyerarşinin en alt düzeyinde: alt popülasyon verilmişse aynı alt popülasyonda yinelenen genotiplerden biri tutulur; aynı genotip başka bir alt popülasyonda da varsa orada da bir kopyası kalır. Düzeltme düzeyi sonucu etkiler: bütün veri üzerinde tek kopya tutulsaydı alt popülasyonlar arasında paylaşılan klonlar da silinir ve farklılaşma yapay olarak büyürdü. Örnek veride 187 izolattan 141'i kalır (farklı genotip sayısı 119'dur; 18 genotip birden çok tarlada, biri iki bölgede birden bulunur).
S7. Eksik veri işleminin seçimi sonucu ne kadar değiştirir?
Kedi verisinin tamamında (237 kedi; iki lokusta %8–9 eksik) birey içi düzeyle \Phi_{\text{pop–toplam}}: lokusları çıkarınca 0{,}0829 (7 lokus), bireyleri çıkarınca 0{,}0857 (199 kedi), dokunulmayınca 0{,}0839'dur. Farklar bu veride küçüktür, ama üç çalıştırma farklı lokus ve birey kümeleri üzerindedir. Raporda eksik veri işlemi ve sonuçta kalan lokus ve birey sayısı (özet satırından) açıkça yazılır.
S8. Uzaklık matrisi ne zaman Öklid olmaktan çıkar?
Tam tabloda satırlar arası Öklid uzaklığı tanımı gereği Öklid'dir. Özellik iki durumda bozulur: tabloda eksik hücre kaldığında (her çift farklı sütunlardan hesaplanır ve ölçeklenir) ve MLG süzgeci genotipleri birleştirip uzaklıkları yeniden kurduğunda. Öklid olmayan matriste bazı "kareler toplamları" eksi çıkabilir; ade4::amova böyle bir matrisi kabul etmez. Yarı Öklid düzeltmesi matrisi en yakın Öklid yapıya indirger (Gower ve Legendre, 1986); eksik değer azsa etkisi dördüncü basamaktadır.
S9. Aynı veri `ade4` ve `pegas` uygulamalarında farklı kareler toplamı verebilir mi?
Tam veride hayır: örnek veride iki uygulamanın kareler toplamları, bileşenleri ve \Phi değerleri on basamak aynıdır. Öklid düzeltmesi devreye girdiğinde küçük bir fark oluşur, çünkü ade4 yolunda düzeltme farklı genotiplerin matrisine, pegas yolunda bütün birimlerin matrisine uygulanır: kedi verisinin tamamında popülasyonlar arası kareler toplamı 288{,}4946 ve 288{,}5187'dir. Permütasyon testi iki uygulamada da ade4 yolunun matrisiyle yapılır; p değerleri bu yüzden aynıdır.
63.10 Kaynaklar
- Cailliez, F. (1983). The analytical solution of the additive constant problem. Psychometrika, 48(2), 305–308. https://doi.org/10.1007/BF02294026
- Dray, S., & Dufour, A.-B. (2007). The ade4 package: Implementing the duality diagram for ecologists. Journal of Statistical Software, 22(4), 1–20. https://doi.org/10.18637/jss.v022.i04
- Excoffier, L., Smouse, P. E., & Quattro, J. M. (1992). Analysis of molecular variance inferred from metric distances among DNA haplotypes: Application to human mitochondrial DNA restriction data. Genetics, 131(2), 479–491. https://doi.org/10.1093/genetics/131.2.479
- Fitzpatrick, B. M. (2009). Power and sample size for nested analysis of molecular variance. Molecular Ecology, 18(19), 3961–3966. https://doi.org/10.1111/j.1365-294X.2009.04314.x
- Goudet, J. (2005). hierfstat, a package for R to compute and test hierarchical F-statistics. Molecular Ecology Notes, 5(1), 184–186. https://doi.org/10.1111/j.1471-8286.2004.00828.x
- Gower, J. C., & Legendre, P. (1986). Metric and Euclidean properties of dissimilarity coefficients. Journal of Classification, 3(1), 5–48. https://doi.org/10.1007/BF01896809
- Grünwald, N. J., & Hoheisel, G.-A. (2006). Hierarchical analysis of diversity, selfing, and genetic differentiation in populations of the oomycete Aphanomyces euteiches. Phytopathology, 96(10), 1134–1141. https://doi.org/10.1094/PHYTO-96-1134
- Jombart, T. (2008). adegenet: A R package for the multivariate analysis of genetic markers. Bioinformatics, 24(11), 1403–1405. https://doi.org/10.1093/bioinformatics/btn129
- Kamvar, Z. N., Brooks, J. C., & Grünwald, N. J. (2015). Novel R tools for analysis of genome-wide population genetic data with emphasis on clonality. Frontiers in Genetics, 6, Article 208. https://doi.org/10.3389/fgene.2015.00208
- Kamvar, Z. N., Tabima, J. F., & Grünwald, N. J. (2014). Poppr: An R package for genetic analysis of populations with clonal, partially clonal, and/or sexual reproduction. PeerJ, 2, e281. https://doi.org/10.7717/peerj.281
- Lingoes, J. C. (1971). Some boundary conditions for a monotone analysis of symmetric matrices. Psychometrika, 36(2), 195–203. https://doi.org/10.1007/BF02291398
- Meirmans, P. G. (2006). Using the AMOVA framework to estimate a standardized genetic differentiation measure. Evolution, 60(11), 2399–2402. https://doi.org/10.1111/j.0014-3820.2006.tb01874.x
- Michalakis, Y., & Excoffier, L. (1996). A generic estimation of population subdivision using distances between alleles with special reference for microsatellite loci. Genetics, 142(3), 1061–1064. https://doi.org/10.1093/genetics/142.3.1061
- Paradis, E. (2010). pegas: An R package for population genetics with an integrated–modular approach. Bioinformatics, 26(3), 419–420. https://doi.org/10.1093/bioinformatics/btp696
- Peakall, R., Smouse, P. E., & Huff, D. R. (1995). Evolutionary implications of allozyme and RAPD variation in diploid populations of dioecious buffalograss Buchloë dactyloides. Molecular Ecology, 4(2), 135–148. https://doi.org/10.1111/j.1365-294X.1995.tb00203.x
- Phipson, B., & Smyth, G. K. (2010). Permutation P-values should never be zero: Calculating exact P-values when permutations are randomly drawn. Statistical Applications in Genetics and Molecular Biology, 9(1), Article 39. https://doi.org/10.2202/1544-6115.1585
- Weir, B. S., & Cockerham, C. C. (1984). Estimating F-statistics for the analysis of population structure. Evolution, 38(6), 1358–1370. https://doi.org/10.1111/j.1558-5646.1984.tb05657.x