68. DNA dizileriyle AMOVA
Şablon kimliği: dizi_amova · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/dizi_amova.R (satır 1–398; üstbilgi 1–92) · Örnek veri: _ornek/dizi_amova_woodmouse.csv · Paketler: ape 5.8-1, pegas 1.4
68.1 Ne işe yarar
Şablon, hizalanmış DNA dizilerinden (mitokondri COI, sitokrom b, kontrol bölgesi, kloroplast bölgeleri) popülasyonların ve popülasyon gruplarının genetik olarak ayrışıp ayrışmadığını sınar. Cevapladığı soru: "Diziler arasındaki farklılığın ne kadarı gruplar arasında, ne kadarı grupların içindeki popülasyonlar arasında, ne kadarı popülasyonların içindedir?" Yöntem moleküler varyans analizidir ve Bölüm 63'te baştan sona anlatılmıştır; bu bölüm yöntemi yinelemez, dizi verisine özgü olanı anlatır: uzaklığın dizilerden nasıl hesaplandığını, şablonun kullandığı permütasyon düzenini ve AMOVA'ya eklenen çıktıları (ikili \Phi_{ST} matrisi, Hudson'ın K_{ST}, K_{ST}^{*} ve S_{nn} istatistikleri).
- \sigma^2_a: gruplar arası; \sigma^2_b: grup içinde popülasyonlar arası; \sigma^2_c: popülasyon içi varyans bileşeni.
- Grup verilmezse hiyerarşi tek düzeylidir: \sigma^2_a popülasyonlar arası, \sigma^2_b popülasyon içi bileşendir ve yalnız \Phi_{ST}=\sigma^2_a/(\sigma^2_a+\sigma^2_b) hesaplanır.
Düzey adları Bölüm 63'tekinden bir basamak kayıktır
Bölüm 63'teki şablonda üst düzey "popülasyon", alt düzey "alt popülasyon"dur. Bu şablonda üst düzey grup, alt düzey popülasyondur. Formüller aynıdır: Bölüm 63'teki \Phi "popülasyon–toplam" buradaki \Phi_{CT}'ye, "alt popülasyon–popülasyon" \Phi_{SC}'ye, "alt popülasyon–toplam" \Phi_{ST}'ye karşılık gelir.
Ne zaman kullanılır? Her bireyden aynı bölgenin dizisi varsa ve diziler hizalanmışsa; farklılaşma yalnız haplotip sıklıklarıyla değil, haplotipler arasındaki mutasyon sayısıyla da ölçülecekse; bir gruplama hipotezi (iki buzul sığınağı, iki havza) \Phi_{CT} ile sınanacaksa; hangi popülasyon çiftlerinin ayrıştığı sorulacaksa.
Ne zaman kullanılmaz?
- Veri mikrosatellit, SNP ya da AFLP genotipiyse:
amova(Bölüm 63). - Diziler hizalanmamışsa (uzunluklar farklı): önce
dizi_hizalama(Bölüm 70). - Haplotipler arasındaki ilişki ağ olarak görülecekse:
haplotip_agi(Bölüm 77). - Soru seçilim ya da demografik genişleme ise (Tajima D, Fu F_S):
notralite_testleri(Bölüm 82). - Yerine koyma modeli ve gama parametresi veriden seçilecekse ya da ağaç kurulacaksa:
dizi_filogeni(Bölüm 69). - Diploit çekirdek dizilerinde iki alel ayrıştırılmamışsa (heterozigot konumlar belirsizlik koduyla yazılmışsa): bu konumlar çözümlemeden silinir; önce haplotipler ayrıştırılır.
Temel programla ilişki. Temel programda dizi verisi okuyan bir analiz yoktur. MerQuR+ içinde aynı yöntem iki şablonda bulunur; farkları şudur:
amova (Bölüm 63) |
dizi_amova (bu bölüm) |
|
|---|---|---|
| Girdi | genotip ya da bant tablosu | hizalanmış dizi sütunu |
| Uzaklık | tablo satırları arasında Öklid | dizi uzaklığı (beş seçenek) |
| Düzeyler | popülasyon / alt popülasyon (/ birey içi) | grup / popülasyon |
| Kareler toplamları ve varyans bileşenleri | ade4 (varsayılan) ya da pegas |
pegas |
| Permütasyon testi | şablonun kendi düzeni (63.4.6) | aynı düzen (68.4.3) |
| Ek çıktı | klon düzeltmesi, eksik veri seçenekleri | n katsayıları, ikili \Phi_{ST}, Hudson istatistikleri |
68.2 Şablonun girdileri
Form, üstbilgideki on bir [[param]] bloğundan kurulur (dizi_amova.R:11–91).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Dizi sütunu (hizalanmış DNA) · dizi |
sütun · Değişkenler | ilk sütun | metin sütunu | Diziler büyük harfe çevrilir, boşluklar atılır, matrise açılır (109–110, 122–128, 142–144). |
Birey adı · kimlik |
sütun · Değişkenler | boş | boş olabilir | Satır adları; boşsa S1, S2, … (113–114, 129). Hesabı etkilemez. |
Popülasyon · populasyon |
kategorik sütun · Değişkenler | ilk sütun | en az 2 düzey | AMOVA'nın alt düzeyi (111, 130–133). |
Grup / bölge · grup |
kategorik sütun · Değişkenler | boş | boş olabilir | Verilirse iki düzeyli AMOVA (112, 134–141). |
Dizi uzaklığı · uzaklik |
seçim · Model | N |
N, raw, JC69, K80, TN93 |
ape::dist.dna(model =) (146, 153). |
Gama oran farklılığı α · gama_alfa |
ondalık · Gelişmiş | 0 | 0–100 | 0'dan büyükse gamma =; yalnız JC69, K80, TN93 (151–153). |
Belirsiz/eksik konumlar · silme |
seçim · Model | tam |
tam, ikili |
pairwise.deletion (145, 147–150, 153, 372). |
Uzaklığın karesini al · kare_al |
onay · Gelişmiş | kapalı | açık, kapalı | pegas::amova(is.squared = !kare) (158, 257); permütasyon testine giden matris de aynı seçime uyar (266). |
Permütasyon sayısı · B |
tamsayı · Seçenekler | 999 | 0–10000 | AMOVA, ikili \Phi_{ST} ve Hudson testleri (159, 281–286, 340, 391–394). 0 ise test yapılmaz. |
İkili popülasyon ΦST matrisi · ikili |
onay · Çıktı | açık | açık, kapalı | Her çift için tek düzeyli AMOVA, tablo ve ısı haritası (327–368). |
Hudson KST, KST* ve Snn · hudson |
onay · Çıktı | açık | açık, kapalı | Üç istatistik ve permütasyon p değerleri (371–397). |
Örnek ayar (ornek_param, satır 9): dizi = dizi, kimlik = birey, populasyon = populasyon, grup = grup, uzaklik = N, B = 999; hepsi varsayılanla aynıdır.
Dizi sütununun biçimi. Her hücre bir bireyin dizisidir. İzin verilen karakterler A, C, G, T (ve U; T'ye çevrilir, satır 125), IUPAC belirsizlik kodları (R, Y, K, M, S, W, B, D, H, V), N, ? ve -'dir; küçük harf ve hücre içi boşluk kabul edilir. Bütün diziler aynı uzunlukta olmalıdır.
Şablonun kendi denetimleri.
| Koşul | İleti | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 95 |
| ape ya da pegas kurulu değil | "'…' R paketi kurulu değil." | 96–97 |
| Dizi ya da popülasyon sütunu boş | "Dizi sütunu seçilmeli." / "AMOVA için popülasyon sütunu gerekli." | 104–105 |
| Grup ile popülasyon aynı sütun | "Grup sütunu popülasyon sütunuyla aynı olamaz." | 107 |
| Dizi ile popülasyon aynı sütun | "Dizi sütunu popülasyon olarak da seçilemez." | 108 |
| 4'ten az dizi | "AMOVA için en az 4 dizi gerekli (… var)." | 120 |
| 2000'den çok dizi | "… dizi var; bu şablon en çok 2000 diziyle çalışır." | 121 |
| DNA dışı karakter | "… dizide DNA dışı karakter var ('…') …" | 122–124 |
| Uzunluklar farklı | "Diziler hizalanmamış: uzunluklar farklı (… ile … arasında) …" | 127–128 |
| Tek popülasyon | "AMOVA için en az iki popülasyon gerekli …" | 131 |
| Her popülasyonda tek dizi | "Her popülasyonda tek dizi var; popülasyon içi varyans kestirilemez …" | 132–133 |
| Bir popülasyon birden çok grupta | "Popülasyonlar gruplara iç içe olmalı: '…' popülasyonu birden çok grupta." | 137 |
| Tam silmede konum kalmadı | "Her konumda en az bir dizide belirsiz baz ya da boşluk var … 'İkili silme' seçin." | 149–150 |
| Uzaklık tanımsız (doygunluk) | "'…' modelinde bazı uzaklıklar tanımsız … Ham fark sayısı ya da p uzaklığını seçin." | 155–156 |
| Bütün diziler aynı | "Bütün diziler aynı (tek haplotip) … AMOVA yapılamaz." | 157 |
Dizisi, popülasyonu ya da (verilmişse) grubu boş olan satırlar atılır ve sayıları not olarak yazılır (115–117). Grup sütunu tek düzeyliyse ya da her grupta tek popülasyon varsa şablon durmaz; not yazarak tek düzeyli AMOVA yapar (139–140). Gama parametresi ham fark sayısı ve p uzaklığında yok sayılır ve bu not olarak yazılır (152).
68.3 Örnek veri
Dosya: _ornek/dizi_amova_woodmouse.csv. ape paketindeki woodmouse veri kümesi: orman faresinin (Apodemus sylvaticus) 15 bireyine ait 965 bazlık sitokrom b dizileri (Michaux ve ark., 2003). Popülasyon ve grup etiketleri gerçek örnekleme yerlerini göstermez; pegas paketinin AMOVA örneğindeki gibi satır sırasına göre atanmıştır.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
birey |
Birey adı | metin | No305, No304, … (15 ad). |
grup |
Grup | ikili | A (7 dizi), B (8 dizi). |
populasyon |
Popülasyon | kategorik | P1 (3), P2 (4) → A; P3 (4), P4 (4) → B. |
dizi |
Dizi | metin | 965 karakter; A, C, G, T ve N. |
965 konumun 55'inde en az bir dizide belirsiz baz (N) vardır; tam silmeyle 910 konum kalır. Bu 910 konumda 15 dizinin hepsi farklı haplotiptir; dizi çiftleri 2–20 konumda ayrışır (ortalama 11,78). Etiketler keyfî olduğundan gerçek bir yapı beklenmez; örnek veri hesabın adımlarını göstermek içindir ve bütün \Phi değerleri sıfır çevresindedir.
Güçlü yapının çıktısını göstermek için bölümde kurgusal ikinci bir veri kullanılır (sim8.csv; dogrulama/dizi_amova/ klasöründe): sekiz popülasyon, popülasyon başına beş dizi, 300 baz; her popülasyonun 12 konumda kendine özgü bazı vardır, gruplar popülasyonlara rastgele atanmıştır (gerçek grup etkisi yok).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) grup boş (tek düzey); (3) uzaklik = raw, JC69, K80, TN93; (4) TN93 ve \alpha=0{,}5; (5) kare_al açık (fark sayısı ve K80); (6) silme = ikili; (7) aynı veri, gruplar (P1, P3) ve (P2, P4); (8) kurgusal veri; (9) bir dizinin tek başına beşinci popülasyon yapıldığı kopya; (10) aynı kopyada o dizinin tek başına üçüncü grup yapıldığı durum.
68.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) dizileri matrise aç, belirsiz konumları say; (2) seçilen modelle dizi çiftleri arasındaki uzaklığı hesapla; (3) uzaklığı \delta^2 olarak (ya da karesini alarak) AMOVA'ya ver: kareler toplamları, n katsayıları, varyans bileşenleri, \Phi (Bölüm 63.4.2–63.4.4); (4) permütasyon p değerleri; (5) her popülasyon çifti için tek düzeyli AMOVA; (6) Hudson istatistikleri.
68.4.1 Dizi uzaklıkları
İki dizi arasında karşılaştırılan L konumdan d tanesi farklıysa p=d/L'dir. Farkların P oranı geçiş (A↔G, C↔T), Q oranı çapraz geçiştir (pürin↔pirimidin); p=P+Q.
- d_N: farklı konum sayısı (form: "Ham fark sayısı"). d_p: fark oranı (p uzaklığı).
- d_{JC}: Jukes–Cantor (1969); bütün yerine koymalar eşit hızda sayılır ve aynı konumdaki yinelenen değişimler düzeltilir.
- d_{K80}: Kimura (1980) iki parametreli; geçiş ve çapraz geçiş hızları ayrıdır.
- Tamura–Nei (1993; TN93) uzaklığı buna baz frekanslarını ve iki ayrı geçiş hızını ekler; baz frekansları bütün hizalamadan (silmeden önce) hesaplanır.
Gama düzeltmesi (\alpha>0) konumların farklı hızda evrimleştiğini varsayar; logaritmalar yerine \alpha\,[(\cdot)^{-1/\alpha}-1] biçimli terimler gelir ve uzaklıklar büyür. Örnek veride birinci ve ikinci dizi 13 konumda ayrışır: d_N=13; d_p=13/910=0{,}014286; d_{JC}=0{,}014424; d_{K80}=0{,}014494; d_{TN93}=0{,}014512. Yakın akraba dizilerde düzeltmeler küçüktür.
Neden varsayılan ham fark sayısı?
AMOVA'nın özgün tanımında (Excoffier ve ark., 1992) haplotipler arasındaki uzaklık karesi, iki haplotipin ayrıştığı mutasyon sayısıdır. Fark sayısı tam silmede bir Öklid uzaklığının karesidir (her konum–baz çifti bir gösterge sütunu sayılırsa), bu yüzden kareler toplamları eksi olamaz ve varyans yorumu geçerlidir. Tür içi veride yinelenen değişim ender olduğundan model düzeltmesi sonucu az değiştirir: örnek veride \Phi_{ST} fark sayısıyla -0{,}01906, K80 ile -0{,}01945'tir. Model tabanlı uzaklıklar, diziler arasındaki farkın %5–10'u aştığı karşılaştırmalarda anlam kazanır.
Koddaki tercih
Uzaklık ape::dist.dna(dna, model, pairwise.deletion = !tam, gamma = …) ile hesaplanır (satır 153). Tam silme: en az bir dizide A, C, G, T dışında karakter (belirsizlik kodu, N, ?, -) taşıyan konumlar bütün dizilerden çıkarılır; kullanılan konum sayısı özet satırında yazar. İkili silme: bir konum yalnız o çiftteki iki diziden birinde belirsizse o çiftin hesabından çıkar; her çift farklı sayıda konum üzerinden karşılaştırılır. Fark sayısı ile p uzaklığı tam silmede aynı \Phi değerlerini verir (biri ötekinin L katıdır); ikili silmede ayrışırlar. Herhangi bir uzaklık sonsuz ya da tanımsız çıkarsa şablon durur (155–156).
68.4.2 Uzaklığın AMOVA'ya verilişi
- d_{ij}: seçilen modelin dizi uzaklığı.
- \delta^2_{ij}: Bölüm 63.4.2'deki kareler toplamlarına giren büyüklük.
Kareler toplamları, serbestlik dereceleri, n, n', n'' katsayıları, varyans bileşenleri ve \Phi istatistikleri Bölüm 63.4.2–63.4.4'teki formüllerle hesaplanır (popülasyon yerine grup, alt popülasyon yerine popülasyon okunarak). Bu şablon katsayıları ayrı bir tabloda da verir.
Paketin varsayılanı ile şablonun tercihi farklıdır
pegas::amova varsayılanda verilen uzaklığın karesini alır (is.squared = FALSE). Şablon uzaklığı doğrudan \delta^2 sayar (is.squared = TRUE, satır 257); bu, Excoffier ve ark.'nın (1992) tanımıdır. "Uzaklığın karesini al" açılırsa paketin varsayılanına dönülür ve sonuçlar değişir: örnek veride \Phi_{ST} -0{,}0191 yerine -0{,}0448, \Phi_{SC} 0{,}0065 yerine -0{,}0350 olur. Fark sayısının karesi büyük farkları orantısız ağırlıklandırır ve bir Öklid uzaklığının karesi değildir; seçenek yalnız paketin belgelerindeki örnekleri yinelemek ya da karesi alınması gereken bir uzaklık için açılır.
68.4.3 Permütasyon p değerleri
Permütasyon testini paket değil şablon yapar. Düzen Bölüm 63.4.6'da anlatılan düzendir (Excoffier ve ark., 1992); bu şablonun düzey adlarıyla:
| Çıktıdaki p | Sınanan bileşen | Karıştırılan | Kısıt | Yön |
|---|---|---|---|---|
| p(\Phi_{ST}) | \sigma^2_c (popülasyon içi) | bireyler | yok: bütün popülasyonlar arasında | küçük |
| p(\Phi_{SC})=p(\sigma^2_b) | \sigma^2_b (grup içinde popülasyonlar arası) | bireyler | yalnız kendi grubunun popülasyonları arasında | büyük |
| p(\Phi_{CT})=p(\sigma^2_a) | \sigma^2_a (gruplar arası) | popülasyonlar (bütün hâlinde) | gruplar arasında | büyük |
| Tek düzeyde p(\Phi_{ST})=p(\sigma^2_a) | \sigma^2_a (popülasyonlar arası) | bireyler | yok: popülasyonlar arasında | büyük |
- \sigma^{2*}_r: r. karıştırmadan sonra yeniden hesaplanan bileşen; B: permütasyon sayısı.
- "Küçük" yön: iki düzeyli çözümlemede \Phi_{ST} için sınanan büyüklük aynı çözümlemenin popülasyon içi bileşenidir; bireyler rastgele dağıtıldığında beklenenden küçük bir \sigma^2_c yapıyı gösterir ve \sigma^{2*}_c\le\sigma^2_c olan düzenler sayılır. Bu p değeri \Phi tablosunda \Phi_{ST} satırında yazılır; varyans bileşenleri tablosunda \sigma^2_c satırının p hücresi boştur. Öteki testlerde "büyük" yöne bakılır.
- Gözlenene eşit değer veren düzenler de sayılır; karşılaştırma toplam varyansın 10^{-9} katı kadar bir toleransla yapılır.
- D: olanaklı farklı düzen sayısı. D\le B ise düzenler rastgele çekilmez, hepsi sayılır (tam sayım); b_{\text{tüm}} gözlenen düzeni de içerir ve p değeri kesindir.
- Rastgele çekilen düzenlerde en küçük olanaklı değer 1/(B+1)'dir (B=999 için 0{,}001); p değeri hiçbir zaman 0 yazılmaz (Phipson ve Smyth, 2010). Tam sayımda en küçük değer, gözlenenle aynı bölünmeyi veren düzenlerin oranıdır.
Düzen sayısı çokterimli katsayıdır: G gruba ayrılmış popülasyonlar için popülasyon sayısının faktöriyeli, grupların popülasyon sayılarının faktöriyellerine bölünür (dört popülasyon, 2 + 2: 6; sekiz popülasyon, 4 + 4: 70); bireylerin karıştırıldığı testlerde aynı hesap dizi sayılarıyla yapılır ve grup içi testte grupların düzen sayıları çarpılır. Örnek veride \Phi_{CT} için D=6'dır ve test tam sayımla yapılır; \Phi_{SC} için D=35\times70=2450, \Phi_{ST} için D=15!/(3!\,4!\,4!\,4!) olduğundan bu iki testte 999 düzen rastgele çekilir.
Şablon her çalıştırmada iki not yazar. Birincisi düzeni bildirir: "Not: p değerleri paketin permütasyon testinden alınmaz; şablonun kendi permütasyon düzeniyle hesaplanır (Excoffier, Smouse ve Quattro 1992): …". İkincisi yalnız tam sayım yapılan test varsa yazılır ve testleri düzen sayılarıyla sayar: "Not: olanaklı düzen sayısı permütasyon sayısını aşmayan testlerde bütün düzenler sayıldı (tam sayım; p = sayım/düzen sayısı): PhiCT (6)."; ikili testler için aynı not çift adlarıyla ("P1–P2 (35), …") ikili tablodan sonra gelir ve sekizden çok test varsa ilk sekizi ile toplam sayıyı verir.
Koddaki tercih
pegas::amova permütasyonsuz çağrılır (nperm = 0, satır 257); kareler toplamları, n katsayıları ve varyans bileşenleri ondan alınır, p değerlerini şablonun kendi motoru hesaplar (satır 166–248; çağrılar 268–273, 281–286 ve 340). Hiyerarşi düzey kodlarına çevrilir (.am_kod, 169–174); popülasyon çiftleri arasındaki uzaklık kareleri toplamı bir kez kurulur ve her düzen için varyans bileşenleri Bölüm 63.4.3'teki katsayılarla yeniden çözülür (.am_sigma, 176–203). Grup düzeyinde popülasyonlar bütün olarak yer değiştirir ve kareler toplamları özgün uzaklık matrisinden hesaplanır (229–230); bireylerin karıştırıldığı testlerde matris yeni etiketlerle yeniden toplanır (228). Düzen sayısı 232. satırda bulunur (.am_dizilis_say, 211); B'yi aşmıyorsa düzenlerin hepsi üretilir (.am_dizilis, 205–210; 233–238), aşıyorsa B düzen rastgele çekilir (239–241). Tek birimli bir kapsayıcı (tek dizili grup) karıştırılmaz (240); böyle bir grup hesabı bozmaz: son dizinin tek başına üçüncü grup yapıldığı kopyada (çalıştırma 10; B=99) p(\Phi_{SC})=0{,}08 ve p(\Phi_{CT})=16/30=0{,}533, aynı dizi B grubunun içinde tek başına popülasyonken (çalıştırma 9) 0{,}19 ve 8/10=0{,}80 bulunur. p değeri .am_p ile hesaplanır (244–248); tam sayım yapılan testler perm_notu ile bildirilir (307–317, 347).
Test pakete bırakılmaz, çünkü paketin testi bu adımda yanlış sonuç verir: grup düzeyini, bir önceki döngüden (bireylerin grup içinde karıştırılması) kalan karıştırılmış matrisle sınar; tek dizili bir grup varken grup içi karıştırma bozulur; gözlenen düzeni saymadığı için güçlü yapıda 0 yazar.
Rastgele sayı üreteci çalıştırmanın tohumuyla kurulur. Şablon formunda tohum alanı yoktur; tohum Kod panelindeki Tohum alanından verilir (Bölüm 1.3). Alan boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar; kullanılan tohumu künyeye yazar ve betik adımına kaydeder; kayıtlı adım yeniden oynatıldığında aynı p değerleri elde edilir, yeni bir çalıştırmada değişir. Tam sayımla bulunan p değerleri tohumdan bağımsızdır (örnek ayarda \Phi_{CT} ve altı ikili p değeri); rastgele çekilen düzenlere dayananlar Monte Carlo hatası kadar değişir (örnek ayarda \Phi_{ST} ve \Phi_{SC} için 2026 tohumuyla 0{,}542 ve 0{,}427; 7 tohumuyla 0{,}532 ve 0{,}434). Bu bölümdeki sayılar, aksi belirtilmedikçe, 2026 tohumuyla elde edilmiştir.
68.4.4 İkili \Phi_{ST}
Her popülasyon çifti için yalnız o iki popülasyonun dizileriyle tek düzeyli bir AMOVA yapılır:
- \Phi_{ST}^{(kl)}: k ve l popülasyonları arasındaki farklılaşma; uzaklıklar ana çözümlemedekilerle aynıdır (alt matris).
- M_{kl}: Slatkin'in (1995) doğrusallaştırılmış değeri; sütun adı
Slatkin_dogrusal. Ayrışma süresiyle yaklaşık doğrusal artar ve uzaklıkla yalıtım çözümlemelerinde genetik uzaklık olarak kullanılır (Bölüm 92). - p değeri: 68.4.3'teki tek düzeyli test, yalnız o iki popülasyonun dizileriyle (bireyler iki popülasyon arasında karıştırılır; "büyük" yön; satır 340). Toplam m dizinin n_k ve n_l'ye olanaklı bölünme sayısı \binom{m}{n_k} permütasyon sayısını aşmıyorsa bölünmelerin hepsi sayılır; hangi çiftlerde tam sayım yapıldığı ve düzen sayıları tablodan sonra bir not satırında yazılır (347).
İki popülasyonun toplamı iki dizi ya da daha azsa çift atlanır; iki popülasyonun bütün dizileri aynıysa \Phi_{ST}=0 yazılır ve test yapılmaz (333–335). p değerleri çoklu karşılaştırma için düzeltilmez; ısı haritasındaki yıldız düzeltilmemiş p<0{,}05'i gösterir. On ikiden çok popülasyonda ısı haritasında sayılar yerine yalnız yıldızlar yazılır.
68.4.5 Hudson'ın dizi tabanlı istatistikleri
- K_k: k popülasyonunun içindeki dizi çiftlerinin ortalama fark sayısı; K_T: bütün örneklemdeki çiftlerin ortalama fark sayısı.
- w_k: popülasyonun örneklemdeki payı. Tek dizili popülasyonun K_k'si ve K_k^{*}'si tanımsızdır; toplamdan çıkarılır ve ağırlıklar yeniden 1'e tamamlanır.
- K_k^{*}, K_T^{*}: aynı ortalamalar, her dizi çiftinin fark sayısı d_{ij} yerine \ln(1+d_{ij}) konarak (Hudson, Boos ve Kaplan, 1992; satır 373, 380–383, 387). Logaritma ortalamaya değil her çifte uygulanır.
- X_i: i. dizinin en yakın komşusu (en az farkla ayrıştığı dizi) kendi popülasyonundaysa 1; birden çok dizi aynı en küçük uzaklıktaysa aralarında kendi popülasyonundan olanların oranı.
- Üç istatistik her zaman ham fark sayısıyla hesaplanır (seçilen uzaklık modeli ne olursa olsun; silme seçeneği uygulanır) ve grup düzeyini kullanmaz.
p değerleri birey etiketlerinin karıştırılmasıyla, üst kuyruktan ve (b+1)/(B+1) tanımıyla hesaplanır (satır 392–393). Bu testte düzenler her zaman rastgele çekilir; tam sayım yapılmaz.
Neden AMOVA'nın yanında bu üç istatistik?
K_{ST}, \Phi_{ST} ile aynı bilgiyi (popülasyon içi çeşitliliğin toplamdan küçüklüğü) varyans bileşeni kestirmeden ölçer. K_{ST}^{*} büyük fark sayılarının ağırlığını logaritmayla azaltır. S_{nn} uzaklıkların büyüklüğünü değil, yalnız "en yakın dizi kimde" bilgisini kullanır; çeşitliliğin yüksek, örneklemin küçük olduğu durumda ötekilerden daha güçlüdür (Hudson, 2000). Popülasyonlar arasında fark yokken S_{nn}'nin beklenen değeri yaklaşık \sum_k w_k(n_k-1)/(N-1)'dir (örnek veride 0{,}20); tam ayrışmada 1'dir.
68.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–92 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on bir parametre. | Form buradan kurulur (Bölüm 1.2). |
| 93–101 | Dil yardımcısı, paket denetimi, en çok 2000 dizi sınırı, renk paleti. | |
| 103–141 | Dizilerin temizlenmesi; etiketlerin metne çevrilmesi; eksik satırların atılması; karakter, uzunluk ve düzey denetimleri; iç içelik denetimi; tek düzeye düşme. | Popülasyon adları metin olarak sıralanır (130): P10, P2'den önce gelir. Yalnız tabloların ve ısı haritasının sırası etkilenir. |
| 142–164 | Dizi matrisi ve DNAbin; belirsiz konum sayımı; dist.dna; tanımsız ve sıfır uzaklık denetimleri; özet satırı. |
Özet satırındaki "kullanılan konum" tam silmede temiz konum sayısı, ikili silmede dizi uzunluğudur. |
| 166–248 | Permütasyon motoru: düzey kodları (.am_kod), bir düzenin varyans bileşenleri (.am_sigma), bütün düzenlerin üretimi ve sayısı (.am_dizilis, .am_dizilis_say), sıfır dağılımı (.am_perm), p değeri (.am_p). |
Düzen sayısı B'yi aşmıyorsa tam sayım (233–238); eşitlikler toleransla sayılır (245–246). |
| 250–260 | amova_yap: formülü ve ortamını kurup pegas::amova'yı permütasyonsuz çağıran yardımcı; bileşen okuyucu. |
Hata olursa "AMOVA hesaplanamadı: …" iletisiyle durur. |
| 261–273 | Teste giden uzaklık kareleri matrisi (266); perm_p: bir testi çalıştırıp p değerini döndüren ve tam sayım yapılan testi kaydeden yardımcı. |
\Phi_{ST} testinde (test = 0) "küçük", ötekilerde "büyük" yön (272). |
| 274–306 | Ana AMOVA; AMOVA tablosu, varyans bileşenleri ve p değerleri (281–286), katsayılar, \Phi tablosu; negatif bileşen notu; \Phi satırları. | \Phi'leri şablon bileşenlerden hesaplar (295, 300). Testlerin sırası: \Phi_{CT}, \Phi_{SC}, \Phi_{ST} (284). |
| 307–317 | Permütasyon notları: düzenin açıklaması ve tam sayım yapılan testler. | B=0 ise yazılmaz. |
| 319–324 | Varyans yüzdeleri çubuk grafiği. | Eksi yüzde sıfır olarak çizilir. |
| 326–368 | İkili \Phi_{ST}: çift döngüsü, matris, uzun tablo, tam sayım notu, ısı haritası. | Çift sayısı k(k-1)/2; her çiftte B permütasyon ya da bütün bölünmeler (340). |
| 370–397 | Hudson istatistikleri ve permütasyon testi. | Ham fark sayısı matrisi yeniden hesaplanır (372); \ln(1+d) matrisi 373. satırdadır. |
68.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/dizi_amova/elle_hesap.py ile, ape ve pegas kullanılmadan hesaplanmıştır: uzaklıklar 68.4.1'deki formüllerden, AMOVA Bölüm 63.4'teki çift toplamlarından. R tarafında (r_dogrulama.R) uzaklıklar yine açık formülle, örnek ayarın varyans bileşenleri ve \Phi değerleri başka bir paketle (ade4::amova) bulunmuştur. Permütasyon p değerleri için şablonun düzeni (68.4.3) iki ayrı kodla uygulanmıştır: rastgele düzenlerde aynı tohumla ve aynı sırayla üretilen çekilişler kullanılmış, tam sayımda bütün düzenler üretilmiş; istatistikler her kodda yeniden hesaplanıp sayılmıştır.
Adım 1 — Konumlar ve uzaklıklar. 965 konumdan 910'u bütün dizilerde A, C, G ya da T'dir. 105 dizi çiftinin fark sayıları 2 ile 20 arasındadır; ortalama K_T=11{,}7810. Popülasyon içi ortalamalar: P1 9{,}333; P2 11{,}833; P3 9{,}667; P4 15{,}833.
Adım 2 — Kareler toplamları. Toplam: 105\times11{,}7810/15=82{,}4667. Popülasyon içi: \frac{3\times9{,}333}{3}+\frac{6\times11{,}833}{4}+\frac{6\times9{,}667}{4}+\frac{6\times15{,}833}{4}=65{,}3333. Grup içi çiftlerden 77{,}5000.
| Kaynak | SSD | sd | MSD |
|---|---|---|---|
| Gruplar arası | 4,9667 | 1 | 4,9667 |
| Gruplar içinde popülasyonlar arası | 12,1667 | 2 | 6,0833 |
| Popülasyonlar içi | 65,3333 | 11 | 5,9394 |
| Toplam | 82,4667 | 14 | 5,8905 |
Adım 3 — Katsayılar. \sum_g\sum_{k\in g}n_k^2/N_g=\frac{3^2+4^2}{7}+\frac{4^2+4^2}{8}=7{,}5714.
Adım 4 — Varyans bileşenleri.
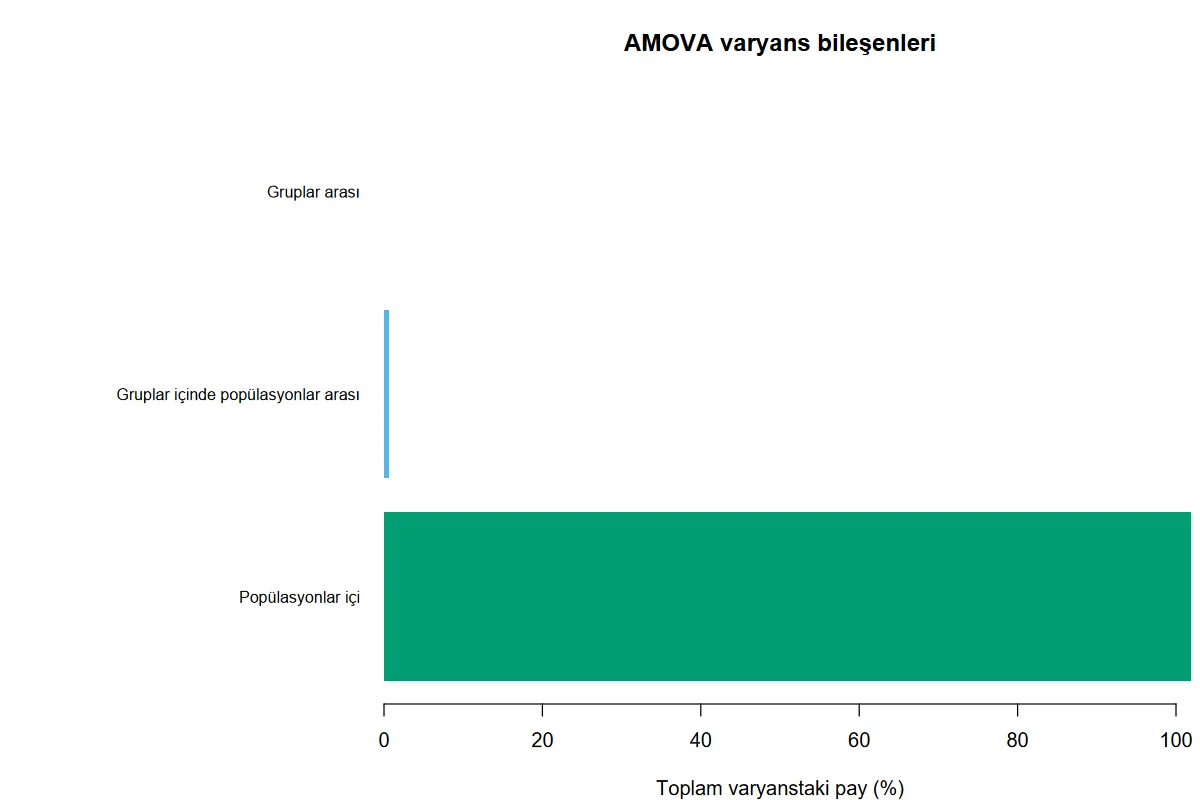
Toplam 5{,}8283; paylar -2{,}57; 0{,}66 ve 101{,}91'dir (yüzde). Gruplar arası kareler ortalaması (4{,}97) popülasyon içi kareler ortalamasından (5{,}94) küçük olduğundan bileşen eksi çıkar.
Adım 5 — Φ istatistikleri.
Adım 6 — p değerleri (rastgele düzenler). \Phi_{SC}: bireyler kendi gruplarının popülasyonları arasında karıştırılır; olanaklı düzen sayısı 35\times70=2450'dir ve 999'u aştığından düzenler rastgele çekilir. 999 düzenin 426'sında \sigma^2_b gözlenen 0{,}0388'e ulaşır: p=(426+1)/1000=0{,}427. \Phi_{ST}: bireyler dört popülasyon arasında karıştırılır; 999 düzenin 541'inde \sigma^2_c gözlenen 5{,}9394'e eşit ya da ondan küçüktür: p=(541+1)/1000=0{,}542. Grup düzeyinde olanaklı düzen sayısı 6'dır; test tam sayımla yapılır (Adım 7).
Adım 7 — Grup düzeyinde bütün düzenler (tam sayım). Dört popülasyon iki gruba (2 + 2) altı biçimde atanabilir; bunlar üç farklı bölünmedir ve her bölünme iki kez sayılır:
| Bölünme | \hat\sigma^2_a |
|---|---|
| (P1, P2) ile (P3, P4): gözlenen | −0,1499 |
| (P1, P4) ile (P2, P3) | −0,0669 |
| (P1, P3) ile (P2, P4) | 0,1530 |
Gözlenen bölünme en küçük değeri verir; altı düzenin hepsinde bileşen gözlenene eşit ya da ondan büyüktür: p(\Phi_{CT})=6/6=1{,}000. Şablon bunu "PhiCT (6)" notuyla bildirir. Gruplar (P1, P3) ve (P2, P4) olarak kurulursa (çalıştırma 7; \Phi_{CT}=0{,}0258) gözlenen bölünme en büyük değeri verir ve p=2/6=0{,}333'tür: dört popülasyonla \Phi_{CT} hiçbir zaman %5 düzeyinde anlamlı bulunamaz. Kurgusal sekiz popülasyonlu veride \binom84=70 düzenin 6'sı gözlenen \hat\sigma^2_a=0{,}0421'e ulaşır: p=6/70=0{,}086. Üç değer de tohumdan bağımsızdır.
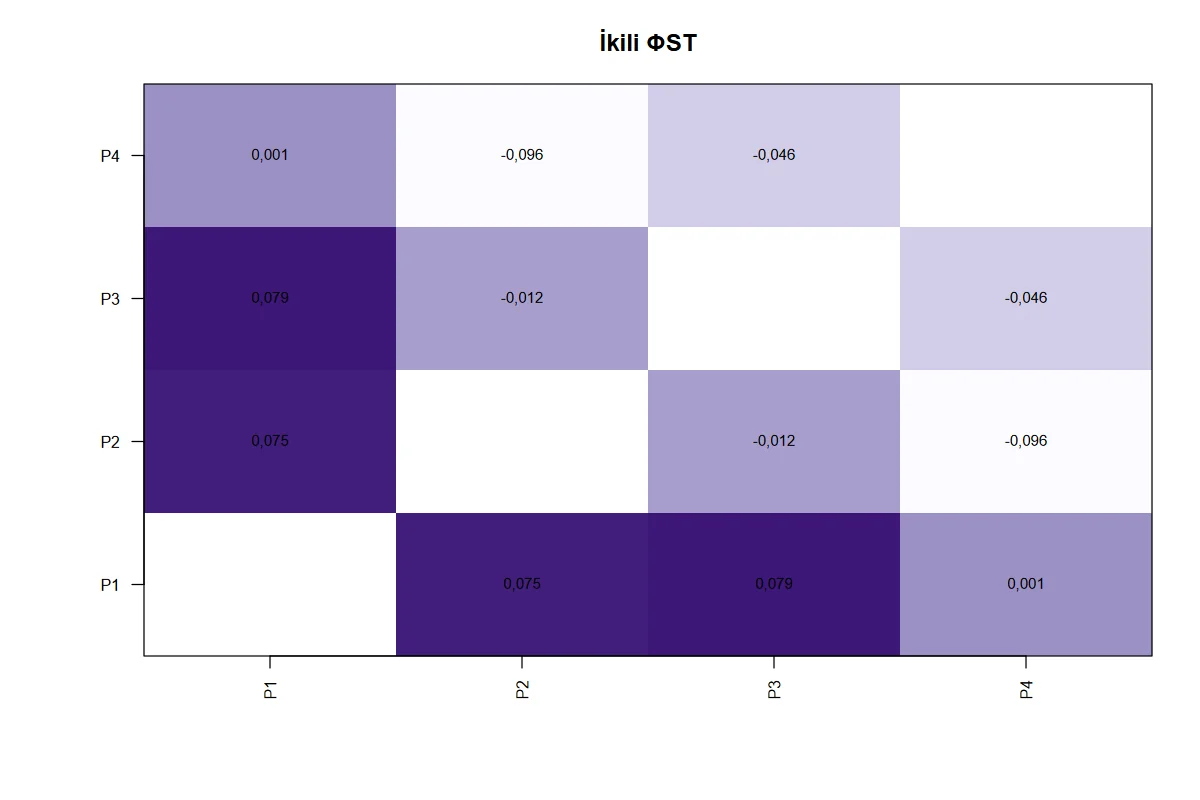
Adım 8 — İkili \Phi_{ST}. P1 ve P2 (7 dizi): toplam SSD 34{,}0000; popülasyon içi 27{,}0833; n_0=3{,}4286; \hat\sigma^2_a=0{,}4375; \hat\sigma^2_b=5{,}4167; \Phi_{ST}=0{,}4375/5{,}8542=0{,}0747; Slatkin değeri 0{,}0747/0{,}9253=0{,}0808. Yedi dizinin 3'e 4 bölünmesi 35 biçimde yapılabilir; şablon hepsini sayar. Bölünmelerin 4'ünde \hat\sigma^2_a gözlenenden büyük, 2'sinde gözlenene eşittir (biri gözlenen bölünmenin kendisidir): p=6/35=0{,}171. Öteki çiftlerde: P1–P3 7/35=0{,}200; P1–P4 17/35=0{,}486; P2–P3 42/70=0{,}600; P2–P4 52/70=0{,}743; P3–P4 42/70=0{,}600.
Adım 9 — Hudson istatistikleri.
Aynı hesap 105 çiftin \ln(1+d_{ij}) değerleriyle yinelendiğinde K_{ST}^{*}=1-K_S^{*}/K_T^{*}=0{,}0034 bulunur. En yakın komşu sayımı: 15 dizinin X_i toplamı 4{,}5; S_{nn}=0{,}300 (beklenen yaklaşık 0{,}20). Etiket karıştırmalarıyla p değerleri 0{,}510; 0{,}435 ve 0{,}189.
Adım 10 — Uzaklık seçeneklerinin etkisi.
| Uzaklık | \hat\sigma^2_a | \Phi_{ST} | \Phi_{SC} | \Phi_{CT} |
|---|---|---|---|---|
| Fark sayısı (varsayılan) | −0,14985 | −0,01906 | 0,00648 | −0,02571 |
| p uzaklığı | −0,00016467 | −0,01906 | 0,00648 | −0,02571 |
| JC69 | −0,00016524 | −0,01932 | 0,00608 | −0,02555 |
| K80 | −0,00016589 | −0,01945 | 0,00595 | −0,02556 |
| TN93 | −0,00016825 | −0,01946 | 0,00625 | −0,02587 |
| TN93, \alpha=0{,}5 | −0,00017558 | −0,02027 | 0,00575 | −0,02618 |
| Fark sayısı, ikili silme | −0,16540 | −0,03566 | −0,00864 | −0,02679 |
| Fark sayısının karesi | −0,73583 | −0,04483 | −0,03497 | −0,00953 |
Varyans bileşenleri uzaklığın birimini taşır (fark sayısında "konum", ötekilerde "konum başına yerine koyma"); \Phi birimsizdir. İkili silmede 965 konumun hepsi kullanılır ve N içeren 55 konumdaki farklar da sayılır; sonuç bu yüzden değişir.
68.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–6).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Örnek: SSD gruplar arası | 4,96666667 | 4,96666667 | 4,96666667 | 3,6e−16 | ✓ |
| Örnek: SSD gruplar içinde popülasyonlar arası | 12,16666667 | 12,16666667 | 12,16666667 | 3,5e−15 | ✓ |
| Örnek: SSD popülasyonlar içi | 65,33333333 | 65,33333333 | 65,33333333 | 6,5e−16 | ✓ |
| Örnek: SSD toplam | 82,46666667 | 82,46666667 | 82,46666667 | 3,4e−16 | ✓ |
| Örnek: n | 3,71428571 | 3,71428571 | 3,71428571 | 1,2e−15 | ✓ |
| Örnek: n' | 3,77142857 | 3,77142857 | 3,77142857 | 3,5e−16 | ✓ |
| Örnek: n'' | 7,46666667 | 7,46666667 | 7,46666667 | 4,8e−16 | ✓ |
| Örnek: \sigma^2_a | −0,14985015 | −0,14985015 | −0,14985015 | 1,1e−15 | ✓ |
| Örnek: \sigma^2_b | 0,03875291 | 0,03875291 | 0,03875291 | 2,4e−15 | ✓ |
| Örnek: \sigma^2_c | 5,93939394 | 5,93939394 | 5,93939394 | 0 | ✓ |
| Örnek: \Phi_{ST} | −0,0190617 | −0,0190617 | −0,0190617 | 3,0e−16 | ✓ |
| Örnek: \Phi_{SC} | 0,00648243 | 0,00648243 | 0,00648243 | 3,8e−16 | ✓ |
| Örnek: \Phi_{CT} | −0,0257108 | −0,0257108 | −0,0257108 | 1,2e−16 | ✓ |
| Örnek: p(\Phi_{ST}) | 0,542 | 0,542 | 0,542 | 0 | ✓ |
| Örnek: p(\Phi_{SC}), p(\sigma^2_b) | 0,427 | 0,427 | 0,427 | 0 | ✓ |
| Örnek: p(\Phi_{CT}), p(\sigma^2_a) (6 düzenin tam sayımı) | 1 | 1 | 1 | 0 | ✓ |
| İkili \Phi_{ST} P1–P2 | 0,0747331 | 0,0747331 | 0,0747331 | 2,1e−16 | ✓ |
| İkili p P1–P2 | 0,17142857 | 0,17142857 | 0,17142857 | 4,2e−16 | ✓ |
| İkili \Phi_{ST} P1–P3 | 0,07890499 | 0,07890499 | 0,07890499 | 2,9e−16 | ✓ |
| İkili p P1–P3 | 0,2 | 0,2 | 0,2 | 0 | ✓ |
| İkili \Phi_{ST} P1–P4 | 6,293266·10−4 | 6,293266·10−4 | 6,293266·10−4 | 6,7e−17 | ✓ |
| İkili p P1–P4 | 0,48571429 | 0,48571429 | 0,48571429 | 2,8e−16 | ✓ |
| İkili \Phi_{ST} P2–P3 | −0,01176471 | −0,01176471 | −0,01176471 | 4,2e−17 | ✓ |
| İkili p P2–P3 | 0,6 | 0,6 | 0,6 | 0 | ✓ |
| İkili \Phi_{ST} P2–P4 | −0,09570957 | −0,09570957 | −0,09570957 | 1,4e−17 | ✓ |
| İkili p P2–P4 | 0,74285714 | 0,74285714 | 0,74285714 | 1,1e−16 | ✓ |
| İkili \Phi_{ST} P3–P4 | −0,04615385 | −0,04615385 | −0,04615385 | 4,2e−17 | ✓ |
| İkili p P3–P4 | 0,6 | 0,6 | 0,6 | 0 | ✓ |
| Slatkin \Phi_{ST}/(1-\Phi_{ST}) P1–P2 | 0,08076923 | 0,08076923 | 0,08076923 | 3,1e−16 | ✓ |
| Hudson K_{ST} | −0,0035031 | −0,0035031 | −0,0035031 | 3,0e−17 | ✓ |
| Hudson p K_{ST} | 0,51 | 0,51 | 0,51 | 0 | ✓ |
| Hudson K_{ST}^{*} | 0,00343835 | 0,00343835 | 0,00343835 | 2,1e−16 | ✓ |
| Hudson p K_{ST}^{*} | 0,435 | 0,435 | 0,435 | 0 | ✓ |
| Hudson S_{nn} | 0,3 | 0,3 | 0,3 | 0 | ✓ |
| Hudson p S_{nn} | 0,189 | 0,189 | 0,189 | 0 | ✓ |
| Tek düzey: \sigma^2_a | −0,06114719 | −0,06114719 | −0,06114719 | 1,7e−15 | ✓ |
| Tek düzey: \Phi_{ST} | −0,01040228 | −0,01040228 | −0,01040228 | 3,3e−16 | ✓ |
| K80: \sigma^2_c | 0,00661742 | 0,00661742 | 0,00661742 | 1,6e−17 | ✓ |
| K80: \Phi_{ST} | −0,01945335 | −0,01945335 | −0,01945335 | 3,0e−16 | ✓ |
| K80: \Phi_{SC} | 0,00595105 | 0,00595105 | 0,00595105 | 7,6e−17 | ✓ |
| K80: \Phi_{CT} | −0,02555649 | −0,02555649 | −0,02555649 | 3,0e−16 | ✓ |
| K80, karesi alınmış: \sigma^2_c | 1,003938·10−4 | 1,003938·10−4 | 1,003938·10−4 | 8,3e−17 | ✓ |
| K80, karesi alınmış: \Phi_{ST} | −0,04562482 | −0,04562482 | −0,04562482 | 9,0e−17 | ✓ |
| K80, karesi alınmış: \Phi_{SC} | −0,03660776 | −0,03660776 | −0,03660776 | 2,1e−17 | ✓ |
| K80, karesi alınmış: \Phi_{CT} | −0,00869862 | −0,00869862 | −0,00869862 | 1,4e−16 | ✓ |
| p uzaklığı: \sigma^2_a | −1,646705·10−4 | −1,646705·10−4 | — | 2,4e−17 | ✓ |
| p uzaklığı: \Phi_{ST} | −0,0190617 | −0,0190617 | — | 3,5e−17 | ✓ |
| JC69: \sigma^2_a | −1,652421·10−4 | −1,652421·10−4 | — | 3,1e−17 | ✓ |
| JC69: \Phi_{ST} | −0,01931703 | −0,01931703 | — | 6,9e−18 | ✓ |
| TN93: \sigma^2_a | −1,682515·10−4 | −1,682515·10−4 | — | 1,5e−17 | ✓ |
| TN93: \Phi_{ST} | −0,01946112 | −0,01946112 | — | 1,7e−16 | ✓ |
| TN93, \alpha=0{,}5: \sigma^2_a | −1,755776·10−4 | −1,755776·10−4 | — | 4,6e−17 | ✓ |
| TN93, \alpha=0{,}5: \Phi_{ST} | −0,02027437 | −0,02027437 | — | 2,8e−16 | ✓ |
| Fark sayısı, karesi alınmış: \sigma^2_a | −0,73582667 | −0,73582667 | — | 7,4e−15 | ✓ |
| Fark sayısı, karesi alınmış: \Phi_{ST} | −0,04482639 | −0,04482639 | — | 1,7e−16 | ✓ |
| İkili silme, fark sayısı: \sigma^2_a | −0,1653971 | −0,1653971 | — | 2,2e−15 | ✓ |
| İkili silme, fark sayısı: \Phi_{ST} | −0,03566312 | −0,03566312 | — | 3,1e−16 | ✓ |
| İkili silme, p uzaklığı: \sigma^2_a | −1,708912·10−4 | −1,708912·10−4 | — | 1,1e−18 | ✓ |
| İkili silme, p uzaklığı: \Phi_{ST} | −0,03554466 | −0,03554466 | — | 2,6e−16 | ✓ |
| İkili silme: Hudson K_{ST} | −0,01850444 | −0,01850444 | — | 4,2e−17 | ✓ |
| İkili silme: Hudson S_{nn} | 0,2 | 0,2 | — | 0 | ✓ |
Ölçütü karşılayan: 61/61. Python: uzaklıklar ve AMOVA açık formülle (numpy). R: uzaklıklar açık formülle; örnek ayarın varyans bileşenleri ve \Phi değerleri ade4::amova ile, ötekiler açık formülle. p değerleri: şablonun permütasyon düzeni iki ayrı kodla; rastgele düzenlerde aynı tohumla (2026) aynı sırada üretilen çekilişler, tam sayımda bütün düzenler.
Rastgele düzenlere dayanan p değerlerindeki eşitlik aynı çekilişlerin kullanılmasına dayanır: çekilişler R'de şablonla aynı tohum ve aynı sırayla bir kez üretilmiş, varyans bileşenleri ve sayım Python ve R'de ayrı kodla yapılmıştır. Tam sayımla bulunan p değerlerinde (\Phi_{CT} ve altı ikili test) çekiliş yoktur; her kod bütün düzenleri kendisi üretir.
68.7 Çıktıyı okuma
Örnek ayarın konsol metni:
DNA dizileriyle AMOVA: 15 dizi, 4 popülasyon, 2 grup; uzunluk 965 bp, kullanılan konum 910 (tam silme); uzaklık: N (δ² olarak); 999 permütasyon
Not: negatif varyans bileşeni, o düzeyde gerçek varyansın sıfıra yakın olduğunu gösterir (yansız kestirici eksi çıkabilir); Φ değeri de eksi olabilir.
PhiST = -0,01906 (p = 0,5420)
PhiSC = 0,00648 (p = 0,4270)
PhiCT = -0,02571 (p = 1,0000)
Not: p değerleri paketin permütasyon testinden alınmaz; şablonun kendi permütasyon düzeniyle hesaplanır (Excoffier, Smouse ve Quattro 1992): ΦST için bireyler bütün popülasyonlar arasında, ΦSC için bireyler grubun içinde popülasyonlar arasında, ΦCT için popülasyonlar bütün olarak gruplar arasında karıştırılır. Gözlenene eşit düzenler de sayılır; p = (sayım + 1)/(B + 1).
Not: olanaklı düzen sayısı permütasyon sayısını aşmayan testlerde bütün düzenler sayıldı (tam sayım; p = sayım/düzen sayısı): PhiCT (6).
Not: olanaklı düzen sayısı permütasyon sayısını aşmayan testlerde bütün düzenler sayıldı (tam sayım; p = sayım/düzen sayısı): P1–P2 (35), P1–P3 (35), P1–P4 (35), P2–P3 (70), P2–P4 (70), P3–P4 (70).
Tablolar (kısaltılmış):
AMOVA tablosu
                            kaynak  sd      SSD     MSD
                     Gruplar arası   1   4.9667  4.9667
Gruplar içinde popülasyonlar arası   2  12.1667  6.0833
                 Popülasyonlar içi  11  65.3333  5.9394
                            Toplam  14  82.4667  5.8905

Varyans bileşenleri (σ², toplam varyanstaki %, permütasyon p)
                            kaynak   bilesen   sigma2     yuzde      p
                     Gruplar arası  sigma2_a  -0.1499   -2.5711  1.000
Gruplar içinde popülasyonlar arası  sigma2_b   0.0388    0.6649  0.427
                 Popülasyonlar içi  sigma2_c   5.9394  101.9062    NaN

Varyans katsayıları (Excoffier ve ark. 1992)
katsayi   deger
      n  3.7143
     n'  3.7714
    n''  7.4667

Φ istatistikleri
istatistik      Phi      p
     PhiST  -0.0191  0.542
     PhiSC   0.0065  0.427
     PhiCT  -0.0257  1.000

İkili ΦST, doğrusallaştırılmış ΦST/(1 − ΦST) ve permütasyon p değerleri
populasyon_1 populasyon_2    PhiST  Slatkin_dogrusal       p
          P1           P2   0.0747            0.0808  0.1714
          P1           P3   0.0789            0.0857  0.2000
          P1           P4   0.0006            0.0006  0.4857
          P2           P3  -0.0118           -0.0116  0.6000
          P2           P4  -0.0957           -0.0873  0.7429
          P3           P4  -0.0462           -0.0441  0.6000

Hudson'ın dizi tabanlı farklılaşma istatistikleri (ham fark sayısıyla; permütasyon p)
istatistik    deger      p
       KST  -0.0035  0.510
      KST*   0.0034  0.435
       Snn   0.3000  0.189
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Özet satırı | Dizi, popülasyon ve grup sayıları; uzunluk; kullanılan konum; silme türü; uzaklık; \delta^2 ya da kare; permütasyon sayısı | Tek düzeye düşüldüyse grup sayısı yazmaz. "Kullanılan konum" ikili silmede dizi uzunluğudur. |
SSD, MSD |
Kareler toplamı ve ortalaması | Bölüm 63'teki "kareler toplamı" ile aynı büyüklükler. |
sigma2 |
\sigma^2_a, \sigma^2_b, \sigma^2_c | Uzaklık birimindedir. Eksi bileşen "bu düzeyde yapı yok" demektir. |
yuzde |
Bileşenin toplam içindeki payı | Eksi bileşen varsa 100'ü aşan değerler görülür. |
Varyans bileşenleri tablosundaki p |
\sigma^2_a ve \sigma^2_b testleri | \Phi_{CT} ve \Phi_{SC}'nin p değerleriyle aynıdır. Son satır boştur: popülasyon içi bileşenin testi \Phi_{ST} satırında yazılır (68.4.3). |
n, n', n'' |
Dengesiz tasarım katsayıları | Tek düzeyde yalnız n yazılır. Raporlanmaz; hesabın denetimi içindir. |
| Φ istatistikleri tablosu | \Phi_{ST}, \Phi_{SC}, \Phi_{CT} ve p değerleri | Rastgele düzenlerde en küçük p 1/(B+1)'dir (B=999 için 0{,}001); bu değer "999 düzenin hiçbiri gözlenene ulaşmadı" demektir. Tam sayım yapılan testte p, düzenlerin kesin oranıdır. |
| Not satırları | Permütasyon düzeni; tam sayım yapılan testler ve düzen sayıları | Notta adı geçen testin p değeri tohuma ve permütasyon sayısına bağlı değildir; düzen sayısı aynı zamanda olanaklı en küçük p değerinin paydasıdır. |
İkili tablodaki p |
Her çiftin tek düzeyli testi | Küçük çiftlerde tam sayımdır (örnek veride altı çiftin hepsi). Düzeltilmemiştir. |
| İkili ΦST matrisi | Simetrik matris; köşegen 0 | Hesaplanamayan çift boş kalır. |
Slatkin_dogrusal |
\Phi_{ST}/(1-\Phi_{ST}) | Eksi \Phi_{ST} eksi değer verir; sıfır kabul edilir. |
| Hudson tablosu | K_{ST}, K_{ST}^{*}, S_{nn} ve p değerleri | En küçük p 1/(B+1)'dir. K_{ST}^{*} logaritmik ölçektedir; büyüklüğü K_{ST} ile karşılaştırılmaz. |
Şekil 68.1. Şablonun birinci şekli (örnek ayar): varyans bileşenlerinin payları. Keyfî etiketlerle farklılığın tamamı popülasyonların içindedir; eksi paylar sıfır olarak çizilir.
Şekil 68.2. Şablonun ikinci şekli (örnek ayar): ikili \Phi_{ST} ısı haritası. Koyu hücre daha büyük değerdir; hiçbir çiftte yıldız yoktur (düzeltilmemiş p<0{,}05 yok).
Güçlü yapıda (kurgusal veri, çalıştırma 8) konsol metni şöyledir:
DNA dizileriyle AMOVA: 40 dizi, 8 popülasyon, 2 grup; uzunluk 300 bp, kullanılan konum 300 (tam silme); uzaklık: N (δ² olarak); 999 permütasyon
PhiST = 0,85485 (p = 0,0010)
PhiSC = 0,85440 (p = 0,0010)
PhiCT = 0,00305 (p = 0,0857)
Not: p değerleri paketin permütasyon testinden alınmaz; şablonun kendi permütasyon düzeniyle hesaplanır (Excoffier, Smouse ve Quattro 1992): ΦST için bireyler bütün popülasyonlar arasında, ΦSC için bireyler grubun içinde popülasyonlar arasında, ΦCT için popülasyonlar bütün olarak gruplar arasında karıştırılır. Gözlenene eşit düzenler de sayılır; p = (sayım + 1)/(B + 1).
Not: olanaklı düzen sayısı permütasyon sayısını aşmayan testlerde bütün düzenler sayıldı (tam sayım; p = sayım/düzen sayısı): PhiCT (70).
Not: olanaklı düzen sayısı permütasyon sayısını aşmayan testlerde bütün düzenler sayıldı (tam sayım; p = sayım/düzen sayısı): Q1–Q2 (252), Q1–Q3 (252), Q1–Q4 (252), Q1–Q5 (252), Q1–Q6 (252), Q1–Q7 (252), Q1–Q8 (252), Q2–Q3 (252), … (toplam 28 test).
Farklılığın %85'i grupların içindeki popülasyonlar arasındadır; grupların payı %0,3'tür. \Phi_{ST} ve \Phi_{SC} için 999 rastgele düzenin hiçbiri gözlenene ulaşmaz (p=1/1000); \Phi_{CT} için 70 düzenin 6'sı ulaşır (p=6/70). Yirmi sekiz ikili testin hepsinde p=2/252=0{,}0079'dur; bu, 5'e 5 bölünmede olanaklı en küçük değerdir. K_{ST}=0{,}841; K_{ST}^{*}=0{,}493 ve S_{nn}=1{,}000'dır (her dizinin en yakın komşusu kendi popülasyonundadır); üçünün p değeri 0{,}001'dir.
Rapor cümlesi (kurgusal veri):
Sekiz popülasyondan 40 bireyin 300 bazlık dizileri moleküler varyans analiziyle incelendi (ham fark sayısı; tam silme; 999 permütasyon). Farklılığın %85,2'si grupların içindeki popülasyonlar arasında, %14,5'i popülasyonların içinde bulundu (\Phi_{ST} = 0,855; \Phi_{SC} = 0,854; ikisi için p = 0,001). Popülasyonların iki gruba ayrılması farklılığın yalnız %0,3'ünü açıkladı (\Phi_{CT} = 0,003; popülasyonların gruplara 70 olanaklı atamasının tam sayımında 6'sı aynı ya da daha büyük değer verdi, p = 0,086). Hudson'ın K_{ST} değeri 0,841, S_{nn} değeri 1,000 idi (ikisi için p = 0,001).
68.8 Sık hatalar ve tuzaklar
- Az popülasyonla \Phi_{CT}'den anlamlılık beklemek. Grup düzeyi popülasyonların gruplar arasında yer değiştirmesiyle sınanır ve olanaklı düzen sayısı popülasyon sayısıyla sınırlıdır: G gruba ayrılmış P popülasyonun düzen sayısı çokterimli katsayıdır (dört popülasyon, 2 + 2: 6; sekiz popülasyon, 4 + 4: 70). Düzen sayısı permütasyon sayısını aşmıyorsa şablon bütün düzenleri sayar ve bunu not satırında düzen sayısıyla birlikte yazar ("PhiCT (6)"); p değeri kesindir, ama altı düzenle 2/6'nın altına inemez. Düzen sayısı azken p değeri kaba bir ölçüdür; \Phi_{CT}'nin büyüklüğü, gruplar arası payın yüzdesi ve düzen sayısı birlikte raporlanır.
- Tam sayım yapılan testte permütasyon sayısını artırmak. Notta adı geçen testin p değeri bütün düzenlerin sayımıdır; B'yi büyütmek ya da tohumu değiştirmek bu değeri değiştirmez. Daha küçük bir p değeri ancak daha çok popülasyonla (grup düzeyi) ya da daha çok diziyle (ikili testler) elde edilebilir.
- p = 0,001'i kesin değer sanmak. Rastgele çekilen düzenlerde 1/(B+1) olanaklı en küçük değerdir; "999 düzenin hiçbiri gözlenene ulaşmadı" demektir ve permütasyon sayısıyla birlikte raporlanır.
- "Uzaklığın karesini al" seçeneğini açık bırakmak. Fark sayısının karesi AMOVA'nın tanımındaki büyüklük değildir; \Phi değerleri değişir (68.4.2).
- İkili silmede ham fark sayısı kullanmak. Her çift farklı sayıda konum üzerinden karşılaştırılır; eksik konumu çok olan diziler herkese "yakın" görünür. İkili silme seçilecekse p uzaklığı ya da model tabanlı bir uzaklık seçilir. Hudson istatistikleri ikili silmede de ham fark sayısıyla hesaplanır ve aynı sakıncayı taşır.
- Eksik veriyi N yerine boşlukla ya da kısa diziyle bırakmak. Uzunlukları eşit olmayan diziler reddedilir. Bir bireyin dizisinin başı ya da sonu okunamadıysa o konumlar N ile doldurulur; tam silme bu konumları bütün dizilerden çıkarır. Tek bir kısa dizi kullanılabilir konum sayısını çok düşürebilir; özet satırındaki "kullanılan konum" denetlenir.
- Hizalama boşluklarının (indel) sayıldığını sanmak.
-karakteri belirsiz sayılır ve konum silinir; eklenme–silinme farkları hiçbir uzaklık seçeneğinde sayılmaz. - İkili \Phi_{ST} p değerlerini düzeltmeden yorumlamak. k popülasyonda k(k-1)/2 test yapılır (sekiz popülasyonda 28). Yıldızlar düzeltilmemiş p değerlerine göredir; raporda Holm ya da Benjamini–Hochberg düzeltmesi tablo dışında uygulanır.
- Küçük popülasyon çiftlerinde ikili testten anlamlılık beklemek. İki popülasyonun toplam m dizisi n_1 ve n_2'ye \binom{m}{n_1} biçimde bölünebilir; 3'e 4'te 35 bölünme vardır ve p değeri 1/35=0{,}029'un altına inemez; 3'e 3'te sınır 2/20=0{,}10'dur. Bölünme sayısı permütasyon sayısını aşmıyorsa şablon bölünmelerin hepsini sayar ve çiftleri düzen sayılarıyla not satırında yazar; p değeri kesindir, sınır aynı kalır.
- Eksi Φ değerini hata saymak. Yansız kestirici, yapı yokken yaklaşık yarı yarıya eksi değer verir. Eksi \Phi sıfır kabul edilir.
- Popülasyon adlarını sayıyla vermek. Adlar metin olarak sıralanır;
10,2'den önce gelir. Sonuçlar değişmez, matrisin ve ısı haritasının sırası beklenenden farklı olur. - Gruplamayı veriye bakarak seçmek. \Phi_{CT}'yi en büyük yapan gruplama aranıp aynı veriyle sınanırsa p değeri geçersizdir; gruplama coğrafya ya da önceki bilgiyle önceden belirlenir.
68.9 Uzman soruları
S1. Dizi verisinde \Phi_{ST} ile haplotip sıklığına dayalı F_{ST} arasındaki fark nedir?
F_{ST} haplotipleri yalnız "aynı" ya da "farklı" sayar; iki popülasyon hiçbir haplotipi paylaşmıyorsa, haplotipler birbirinden bir mutasyonla da ayrılsa yirmi mutasyonla da, aynı değeri verir. \Phi_{ST} haplotipler arasındaki fark sayısını da kullanır: popülasyonların haplotipleri birbirinden uzak soylara aitse \Phi_{ST} büyür. Bütün uzaklıklar 0/1 alınırsa (aynı haplotip 0, farklı 1) \Phi_{ST} haplotip sıklığına dayalı F_{ST}'ye iner (Holsinger ve Weir, 2009). Örnek veride 15 dizinin hepsi farklı haplotip olduğundan sıklık tabanlı bir ölçü hiçbir bilgi taşımaz; fark sayıları taşır.
S2. Fark sayısı ile p uzaklığı neden aynı Φ değerlerini veriyor, ama varyans bileşenleri farklı?
Tam silmede p uzaklığı fark sayısının L'ye (910) bölünmüşüdür. Kareler toplamları ve varyans bileşenleri uzaklıkla doğrusal ölçeklenir (-0{,}14985/910=-0{,}00016467); oranlar olan \Phi değerleri değişmez. İkili silmede her çiftin paydası farklıdır, iki uzaklık orantılı olmaktan çıkar ve \Phi değerleri ayrışır (-0{,}03566 ve -0{,}03554).
S3. Model tabanlı bir uzaklık (K80, TN93) AMOVA için "doğru" seçim mi?
İki bakış vardır. Varyans yorumu açısından \delta^2'nin bir Öklid uzaklığının karesi olması istenir; fark sayısı bunu sağlar, logaritmik düzeltmeli uzaklıklar genel olarak sağlamaz. Evrimsel açıdan uzak diziler arasında yinelenen değişimler fark sayısını olduğundan küçük gösterir ve düzeltme anlamlıdır. Tür içi veride (farklar %1–2) iki seçim aynı sonuca varır; örnek veride \Phi değerleri üçüncü basamakta ayrışır. Türler arası ya da çok eski soylar içeren veride model tabanlı uzaklık seçilir ve model başka bir çözümlemeyle (Bölüm 69) belirlenir; gama parametresi tahmin edilmeden girilmez.
S4. İki düzeyli çözümlemede \Phi_{ST} neden popülasyon içi bileşen üzerinden ve "küçük" yönde sınanıyor?
\Phi_{ST}=(\sigma^2_a+\sigma^2_b)/\sigma^2_T=1-\sigma^2_c/\sigma^2_T olduğundan büyük bir \Phi_{ST}, toplam içinde küçük bir popülasyon içi bileşen demektir. Sıfır hipotezi bireylerin popülasyonlara dağılımının rastlantısal olduğudur; bu hipotez altında değiştirilebilir birim bireydir ve grup gözetilmeden bütün popülasyonlar arasında karıştırılır (Excoffier ve ark., 1992). Her düzende aynı iki düzeyli çözümleme yinelenir ve \sigma^2_c'nin gözlenene eşit ya da ondan küçük çıktığı düzenler sayılır. Grup verilmeden yapılan tek düzeyli çözümleme aynı sıfır hipotezini popülasyonlar arası bileşen üzerinden ("büyük" yön) sınar; iki çözümlemenin \Phi_{ST} değerleri aynı sayı değildir (örnek veride -0{,}0191 ve -0{,}0104; p değerleri 0{,}542 ve 0{,}505).
S5. Grup düzeyindeki test neden az popülasyonla hiç anlamlı çıkamaz?
Test popülasyonları bütün olarak gruplara yeniden dağıtır; olası düzen sayısı popülasyon sayısıyla sınırlıdır ve gözlenen düzen de bunlardan biridir. Dört popülasyon iki gruba altı biçimde ayrılır; grup büyüklükleri eşitse her bölünme iki kez sayılır ve en küçük p değeri 2/6'dır. %5 düzeyi için en az \binom{P}{P/2}/2\ge20, yani altı popülasyon (3 + 3: 20 düzen, en küçük p 0{,}10) yetmez; sekiz popülasyon (4 + 4: 70 düzen, en küçük p 0{,}029) gerekir (Fitzpatrick, 2009). Birey sayısını ya da permütasyon sayısını artırmak bu sınırı değiştirmez; şablon bu durumlarda düzenlerin hepsini sayar ve düzen sayısını not satırında yazar.
S6. K_{ST} ile \Phi_{ST} neden farklı sayılar veriyor?
İkisi de popülasyon içi çeşitliliği toplamla karşılaştırır, ama farklı kestiricilerdir. K_{ST}=1-K_S/K_T ortalama fark sayılarının doğrudan oranıdır; K_T popülasyon içi çiftleri de içerdiğinden değer yanlıdır ve yapı yokken hafifçe eksiye kayar. \Phi_{ST} serbestlik derecelerini ve dengesizlik katsayısını hesaba katan varyans bileşenlerinden kurulur. Kurgusal veride K_{ST}=0{,}841, \Phi_{ST}=0{,}855'tir. Anlamlılık açısından ikisi aynı permütasyon düzenini kullanır ve çoğu zaman aynı karara varır.
S7. S_{nn}'de eşit uzaklıktaki komşular nasıl sayılıyor?
Bir dizinin en küçük uzaklıkta birden çok komşusu varsa X_i, bu komşular arasında kendi popülasyonundan olanların oranıdır (Hudson, 2000). Aynı haplotipi taşıyan diziler birbirinin sıfır uzaklıktaki komşusudur; haplotip çeşitliliği düşük veride eşitlikler çoktur ve S_{nn} haplotip paylaşımına duyarlı hâle gelir. Örnek veride bütün haplotipler farklıdır; 15 dizinin X_i toplamı 4{,}5'tir.
S8. K_{ST}^{*} neden K_{ST}'den çok farklı bir sayı veriyor?
İki istatistik aynı oranı farklı ölçekte kurar. K_{ST}^{*}'de her dizi çiftinin fark sayısı d yerine \ln(1+d) konur (Hudson, Boos ve Kaplan, 1992); logaritma büyük fark sayılarını sıkıştırdığından popülasyonlar arası çiftlerin toplam ortalamayı büyütme etkisi azalır ve oran küçülür. Kurgusal veride K_{ST}=0{,}841, K_{ST}^{*}=0{,}493; örnek veride -0{,}0035 ve 0{,}0034 bulunur. Logaritma ortalamaya değil her çifte uygulandığından, birkaç çok uzak dizi çifti istatistiğe egemen olamaz. K_{ST}^{*}'nin büyüklüğü bir varyans payı olarak yorumlanmaz ve K_{ST} ya da \Phi_{ST} ile karşılaştırılmaz; anlamlılığı kendi sıfır dağılımına göre, etiket karıştırmalarıyla değerlendirilir.
68.10 Kaynaklar
- Dray, S., & Dufour, A.-B. (2007). The ade4 package: Implementing the duality diagram for ecologists. Journal of Statistical Software, 22(4), 1–20. https://doi.org/10.18637/jss.v022.i04
- Excoffier, L., Smouse, P. E., & Quattro, J. M. (1992). Analysis of molecular variance inferred from metric distances among DNA haplotypes: Application to human mitochondrial DNA restriction data. Genetics, 131(2), 479–491. https://doi.org/10.1093/genetics/131.2.479
- Fitzpatrick, B. M. (2009). Power and sample size for nested analysis of molecular variance. Molecular Ecology, 18(19), 3961–3966. https://doi.org/10.1111/j.1365-294X.2009.04314.x
- Holsinger, K. E., & Weir, B. S. (2009). Genetics in geographically structured populations: Defining, estimating and interpreting F_{ST}. Nature Reviews Genetics, 10(9), 639–650. https://doi.org/10.1038/nrg2611
- Hudson, R. R. (2000). A new statistic for detecting genetic differentiation. Genetics, 155(4), 2011–2014. https://doi.org/10.1093/genetics/155.4.2011
- Hudson, R. R., Boos, D. D., & Kaplan, N. L. (1992). A statistical test for detecting geographic subdivision. Molecular Biology and Evolution, 9(1), 138–151. https://doi.org/10.1093/oxfordjournals.molbev.a040703
- Jukes, T. H., & Cantor, C. R. (1969). Evolution of protein molecules. In H. N. Munro (Ed.), Mammalian protein metabolism (Vol. 3, pp. 21–132). Academic Press. https://doi.org/10.1016/B978-1-4832-3211-9.50009-7
- Kimura, M. (1980). A simple method for estimating evolutionary rates of base substitutions through comparative studies of nucleotide sequences. Journal of Molecular Evolution, 16(2), 111–120. https://doi.org/10.1007/BF01731581
- Michaux, J. R., Magnanou, E., Paradis, E., Nieberding, C., & Libois, R. (2003). Mitochondrial phylogeography of the woodmouse (Apodemus sylvaticus) in the Western Palearctic region. Molecular Ecology, 12(3), 685–697. https://doi.org/10.1046/j.1365-294X.2003.01752.x
- Paradis, E. (2010). pegas: An R package for population genetics with an integrated–modular approach. Bioinformatics, 26(3), 419–420. https://doi.org/10.1093/bioinformatics/btp696
- Paradis, E., & Schliep, K. (2019). ape 5.0: An environment for modern phylogenetics and evolutionary analyses in R. Bioinformatics, 35(3), 526–528. https://doi.org/10.1093/bioinformatics/bty633
- Phipson, B., & Smyth, G. K. (2010). Permutation P-values should never be zero: Calculating exact P-values when permutations are randomly drawn. Statistical Applications in Genetics and Molecular Biology, 9(1), Article 39. https://doi.org/10.2202/1544-6115.1585
- Slatkin, M. (1995). A measure of population subdivision based on microsatellite allele frequencies. Genetics, 139(1), 457–462. https://doi.org/10.1093/genetics/139.1.457
- Tamura, K., & Nei, M. (1993). Estimation of the number of nucleotide substitutions in the control region of mitochondrial DNA in humans and chimpanzees. Molecular Biology and Evolution, 10(3), 512–526. https://doi.org/10.1093/oxfordjournals.molbev.a040023