53. Kullanıcı tanımlı istatistik için bootstrap GA
Şablon kimliği: bootstrap_ozel · Kategori: yeniden_ornekleme · Dil: Python · Dosya: pro/sablonlar/yeniden_ornekleme/bootstrap_ozel.py (satır 1–215; üstbilgi 1–80) · Örnek veri: _ornek/gruplu_verim.csv · Paketler: SciPy 1.16.3 (stats.bootstrap, stats.trim_mean), NumPy 2.4.6, pandas 2.3.3, Matplotlib 3.10.9
53.1 Ne işe yarar
Şablon, örnekleme dağılımı için hazır bir formülü olmayan bir istatistiğe bootstrap ile güven aralığı kurar. Cevapladığı soru şudur: "Verimden hesapladığım bu sayı (bir değişim katsayısı, iki medyanın farkı, iki ortalamanın oranı), aynı evrenden yeni bir örneklem çekilseydi ne kadar değişirdi ve gerçek değer hangi aralıkta olabilir?"
- s(\cdot): seçilen istatistik. Tek örneklemli olanlar bir sütunun bütün değerlerinden, iki örneklemli olanlar iki grubun değerlerinden hesaplanır.
- \hat\theta: istatistiğin veride aldığı değer (nokta kestirimi).
- Hipotez testi yoktur; çıktı kestirim, bootstrap standart hatası, yanlılık ve bir güven aralığıdır.
Hazır altı istatistik vardır: ortalama, medyan, değişim katsayısı (SS/ortalama), kırpılmış ortalama, iki grup medyan farkı ve iki grup ortalama oranı. İstatistik işlevleri kodun başında açıkça tanımlıdır (satır 97–110); Kod sekmesinde bir işlevin gövdesi değiştirilerek aynı bootstrap altyapısı başka bir istatistiğe uygulanabilir. Şablonun adı buradan gelir.
Ne zaman kullanılır?
- İstatistiğin standart hatası için kapalı formül yoksa ya da formül şüpheli bir dağılım varsayımına dayanıyorsa (değişim katsayısı, kırpılmış ortalama, medyan farkı).
- Oran gibi çarpık dağılımlı bir istatistikte simetrik olmayan bir aralık isteniyorsa.
- Gözlemler bağımsızsa ve örneklem çok küçük değilse (grup başına kabaca 15–20 ve üzeri).
Ne zaman kullanılmaz?
- Gözlemler bağımlıysa (zaman serisi, kümelenmiş veri):
bagimli_bootstrap(Bölüm 51) ya dabagimli_bootstrap_py(Bölüm 52). Bu şablon her gözlemi tek başına çeker ve bağımlı veride standart hatayı küçük kestirir. - Ölçümler eşleştirilmişse (aynı birimde önce/sonra): iki grup bağımsız çekildiği için eşleşme bozulur. Farklar tek sütuna hesaplanıp tek örneklemli istatistik kullanılır ya da temel programdaki Bootstrap Güven Aralığı.
- Hipotez testi ve p değeri isteniyorsa:
permutasyon_ozel(Bölüm 56) ya da temel programdaki Permütasyon Testi. - İstatistik, kestirilmiş parametrelerin düzgün bir fonksiyonuysa ve hızlı bir yaklaşık aralık yetiyorsa:
delta_yontemi(Bölüm 55). - En büyük ya da en küçük değer gibi sınır istatistiklerinde: bootstrap bunlarda tutarlı değildir.
Temel programla ilişki. Temel programın Bootstrap Güven Aralığı analizi yerleşik bir istatistik listesi için (ortalama, medyan, standart sapma, oran, korelasyon, iki grup farkı) birkaç aralık tanımını birlikte verir. Bu şablon üç noktada ayrılır: (1) değişim katsayısı, kırpılmış ortalama, medyan farkı ve ortalama oranı hazırdır ve istatistik işlevi kullanıcı tarafından değiştirilebilir; (2) hesap scipy.stats.bootstrap işlevine bırakılmıştır, aralık tanımları (özellikle iki örneklemde BCa ivmesi) SciPy'nin tanımlarıdır; (3) tek yanlı aralık seçilebilir.
53.2 Şablonun girdileri
Form, üstbilgideki on [[param]] bloğundan kurulur (bootstrap_ozel.py:10–79).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Değişken · hedef |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | İstatistiğin hesaplandığı değerler (138). |
İstatistik · istatistik |
seçim · Model | cv |
ortalama, medyan, cv, kirpilmis, medyan_farki, ortalama_orani |
ISLEV sözlüğünden işlev seçimi (93, 174); son ikisi iki örneklemlidir (94). |
Grup · grup |
kategorik sütun · Değişkenler | boş | herhangi bir sütun; boş olabilir | Yalnız iki örneklemli istatistiklerde okunur (139–145). |
1. düzey · duzey1 |
metin · Seçenekler | boş | grup sütunundaki bir düzey | Farkta çıkarılan, oranda pay (146, 154). |
2. düzey · duzey2 |
metin · Seçenekler | boş | grup sütunundaki başka bir düzey | Farkta çıkan, oranda payda (147, 154). |
GA yöntemi · yontem |
seçim · Model | BCa |
BCa, percentile, basic |
stats.bootstrap(method =) (184). |
Bootstrap sayısı · B |
tamsayı · Seçenekler | 5000 | 200–100000 | n_resamples (183). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | confidence_level (183). |
Güven aralığı türü · alternatif |
seçim · Seçenekler | two-sided |
two-sided, less, greater |
İki yanlı ya da tek yanlı sınır (185, 189). |
Kırpma oranı · kirpma |
ondalık · Seçenekler | 0,1 | 0–0,45 | Yalnız kırpılmış ortalamada: her uçtan atılan oran (124, 129). |
Örnek ayar (ornek_param, satır 9): hedef = verim, grup = grup, istatistik = medyan_farki, duzey1 = Gübre_B, duzey2 = Kontrol, B = 1999. Varsayılandan farkları: istatistik (varsayılan değişim katsayısı) ve B (varsayılan 5000).
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 91 |
| İki örneklemli istatistik, grup sütunu boş | "Bu istatistik için bir grup sütunu seçin." | 118 |
| Yazılan düzey grup sütununda yok | "Grup düzeyi bulunamadı: '…'. Düzeyler: …" | 127 |
| İki düzey aynı | "İki farklı grup düzeyi seçin." | 130 |
| Bir grupta 3'ten az gözlem | "Her grupta en az 3 gözlem gerekli." | 133 |
| Ortalama oranı, payda grubunun ortalaması sıfır | "Payda grubunun ortalaması sıfır; oran tanımsız." | 135 |
| Tek örneklemde 5'ten az gözlem | "En az 5 gözlem gerekli." | 141 |
| Değişim katsayısı, ortalama sıfır | "Ortalama sıfır; değişim katsayısı tanımsız." | 143 |
| Bütün değerler aynı | "Değişkenin tüm değerleri aynı; bootstrap dağılımı tek noktadır." | 148 |
stats.bootstrap hata verdi |
"Bootstrap hesaplanamadı: …" | 160 |
| Sınırlardan biri hesaplanamadı | "Güven aralığı hesaplanamadı (bootstrap dağılımı yozlaşmış). Yüzdelik yöntemi deneyin." | 164 |
Değişken pd.to_numeric(…, errors="coerce") ile okunur (138); sayıya çevrilemeyen hücreler ve eksikler atılır. Sütunun veri sekmesindeki türü "kategorik" olsa da değerler doğru alınır. İki örneklemli istatistikte değeri ya da grubu eksik olan satır atılır (143–144).
Düzey alanları boşsa hangi iki grup karşılaştırılır?
Alanlar boş bırakılırsa şablon grup düzeylerini MerQuR+ düzey sırasına dizer ve ilk ikisini alır (satır 91–109, 145–148): kullanıcının tanımladığı sıra varsa o; yoksa etiketlerin hepsi sayıysa sayısal sıra; değilse verideki ilk görülme (Bölüm 1.3). Örnek veride ilk görülen düzeyler Kontrol ve Gübre_A'dır ve boş alanlarla "Medyan farkı (Kontrol − Gübre_A)" = 5,61 − 7,15 = −1,54 hesaplanır. Sayı biçimli düzeyler sayısal sıraya girer: 2, 5 ve 10 düzeyleri bu sırada dizilir ve fark "2 − 5" olarak kurulur. Tam sayı kodlu sütunda eksik hücre varsa düzey etiketleri yine "2", "5", "10" biçimindedir ("2.0" değil). Farkın yönü ve oranın payı/paydası bu sıraya bağlı olduğundan iki düzey yine de açıkça yazılması önerilir; çıktının ilk satırı hangi düzeylerin kullanıldığını gösterir.
53.3 Örnek veri
Dosya: _ornek/gruplu_verim.csv. Üç gruplu bir verim denemesi: 60 parsel, eksik değer yok.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
verim |
Değişken | sayısal | 2,31–15,27; ortalama 6,9945; medyan 6,65; SS 2,5514. |
grup |
Grup | kategorik | Kontrol, Gübre_A, Gübre_B; her birinde 20 parsel. |
parsel |
kullanılmaz | metin | P01–P60. |
blok |
kullanılmaz | kategorik | B1–B5. |
| Grup | n | Ortalama | Medyan | SS |
|---|---|---|---|---|
| Kontrol | 20 | 5,3725 | 5,61 | 1,7082 |
| Gübre_A | 20 | 7,1930 | 7,15 | 2,0070 |
| Gübre_B | 20 | 8,4180 | 7,68 | 2,8852 |
Düzey sırası. Verideki ilk görülme sırası Kontrol, Gübre_A, Gübre_B'dir; şablon boş alanlarda bu sırayı kullanır. Örnek ayar iki düzeyi açıkça verir: fark Gübre_B − Kontrol yönündedir.
Gübre_B grubu sağa çarpıktır (ortalama 8,42; medyan 7,68; en büyük değer 15,27). Bu yüzden ortalamalar yerine medyanların karşılaştırılması ve çarpıklığı taşıyan bir aralık yöntemi anlamlıdır.
Bu bölümde kullanılan çalıştırmalar (doğrulama çalıştırıcısında tohum 2026 verilerek; tohum hiç verilmezse şablonun kullandığı değer de budur): (1) örnek ayar; (2) yontem = percentile; (3) yontem = basic; (4) guven = 0,90; (5) alternatif = greater ve less; (6) istatistik = ortalama_orani, üç yöntem; (7) tek örneklemli dört istatistik (verim sütununun 60 değeri); (8) varsayılan ayar (değişim katsayısı, B=5000); (9) düzey alanları boş; (10) tohum 7; (11) Efron ve Tibshirani'nin (1993) fare verisi (_ornek/bootstrap_ozel_fare.csv).
53.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) değişkeni sayıya çevir, eksikleri at, iki örneklemliyse iki grubu ayır; (2) istatistiği veride hesapla (\hat\theta); (3) B kez yeniden örnekle ve istatistiği her kopyada hesapla; (4) kopyalardan standart hatayı ve yanlılığı çıkar; (5) seçilen yöntemle (BCa, yüzdelik ya da temel) güven sınırlarını kur; (6) tabloyu, metni ve histogramı yaz.
53.4.1 Yeniden örnekleme
- Her kopya, verinin kendisinden aynı büyüklükte ve yerine koyarak çekilmiş bir örneklemdir; bir gözlem birkaç kez gelebilir, bazıları hiç gelmez.
- İki örneklemli istatistikte gruplar ayrı ayrı ve birbirinden bağımsız çekilir; her grup kendi büyüklüğünü (n_1, n_2) korur.
- \hat\theta^{*}_1,\dots,\hat\theta^{*}_B: bootstrap dağılımı. İstatistiğin örnekleme dağılımının verideki taklididir.
Neden gruplar ayrı çekilir?
Deneyde grup büyüklükleri tasarımla sabittir: yeni bir denemede de 20 kontrol ve 20 gübre parseli olurdu. Bütün satırlar birlikte çekilseydi kopyalardaki grup büyüklükleri rastgele olur, hatta bir grup hiç çıkmayabilirdi. Ayrı çekmek tasarımı korur. Bunun bedeli, iki grup arasında eşleşme varsa (aynı blok, aynı birey) onun yok sayılmasıdır.
Koddaki tercih
Yeniden örnekleme scipy.stats.bootstrap(veri, islev, n_resamples = B, confidence_level = guven, method = yontem, vectorized = True, paired = False, rng = rng, alternative = …) çağrısıyla (SciPy 1.15'ten eski sürümde anahtar sözcük random_state'tir; şablon inspect.signature ile hangisinin geçerli olduğunu seçer, satır 178) yapılır (satır 156–158). veri tek örneklemde (x,), iki örneklemde (a, b) demetidir; paired = False her örneklemin ayrı çekilmesini sağlar. SciPy her örneklem için B\times n boyutlu bir dizin matrisini tek çağrıda çeker (iki örneklemde önce 1. düzeyin, sonra 2. düzeyin matrisi) ve istatistiği bütün kopyalara birden uygular; vectorized = True bunun içindir. rng bağımsız değişkeni SciPy 1.15 ve sonrasında vardır.
53.4.2 İstatistikler
- \mathrm{DK}: değişim katsayısı; standart sapmanın ortalamaya oranı (n-1 bölenli SS; satır 98–99).
- \bar x_\gamma: kırpılmış ortalama; x_{(1)}\le\dots\le x_{(n)} sıralı değerler, \gamma kırpma oranı. Her uçtan k gözlem atılır (
scipy.stats.trim_mean, 129). - \Delta: 1. düzeyin medyanı eksi 2. düzeyin medyanı; \rho: 1. düzeyin ortalaması bölü 2. düzeyin ortalaması (130–131).
Kırpma oranı tam gözlem sayısına aşağı yuvarlanır
Atılan gözlem sayısı k=\lfloor\gamma n\rfloor'dir. n=60, \gamma=0{,}1 için k=6'dır ve ortalama ortadaki 48 değerden alınır (6,8256). \gamma n<1 ise hiç gözlem atılmaz: n=60, \gamma=0{,}01'de sonuç olağan ortalamadır (6,9945); çıktıdaki ad "%1 kırpılmış ortalama" olarak kalır ve şablon "her uçtan hiç gözlem atılmadı" notunu yazar (satır 169–171). Küçük gruplarda istenen oran ile fiilen uygulanan oran ayrışabilir (n=12, \gamma=0{,}1: her uçtan 1 gözlem, yani %8,3).
53.4.3 Standart hata ve yanlılık
- \operatorname{SH}^{*}: kopyaların standart sapması; istatistiğin standart hatasının bootstrap kestirimi (SciPy'nin
standard_erroralanı). - Yanlılık: kopyaların ortalamasının kestirimden farkı (satır 196). Pozitifse kopyalar ortalamada kestirimin üstündedir.
53.4.4 Yüzdelik aralık
- q^{*}_p: kopyaların p. kantili (
np.percentile, doğrusal ara değerleme): sıralı kopyalar \hat\theta^{*}_{(1)}\le\dots\le\hat\theta^{*}_{(B)} ve h=(B-1)p için q^{*}_p=\hat\theta^{*}_{(\lfloor h\rfloor+1)}+(h-\lfloor h\rfloor)\big(\hat\theta^{*}_{(\lfloor h\rfloor+2)}-\hat\theta^{*}_{(\lfloor h\rfloor+1)}\big). - \alpha=1-\text{güven düzeyi}.
Yüzdelik aralık bootstrap dağılımının ortadaki %95'idir. Tekdüze dönüşümlere karşı değişmezdir (\ln\rho için aralık, \rho aralığının logaritmasıdır). Zayıf yanı: bootstrap dağılımı kestirimin çevresinde değil de kaymış duruyorsa aralık da kayar.
53.4.5 Temel aralık
- Yüzdelik aralığın \hat\theta çevresinde yansıtılmış hâlidir.
Neden yansıtma?
Temel aralık şu benzetmeye dayanır: gerçek dünyada \hat\theta-\theta farkının dağılımı, bootstrap dünyasında \hat\theta^{*}-\hat\theta farkının dağılımıyla aynıdır. P\big(q^{*}_{\alpha/2}-\hat\theta\le\hat\theta-\theta\le q^{*}_{1-\alpha/2}-\hat\theta\big)\approx1-\alpha eşitsizliği \theta için çözülünce uçlar yer değiştirir. Bootstrap dağılımı sağa çarpıksa temel aralık sola uzar; yüzdelik aralık sağa uzar. İki yöntem çarpık dağılımda ters yönde ayrışır; simetrik dağılımda çakışır.
53.4.6 BCa aralığı
BCa (yanlılık düzeltmeli ve hızlandırılmış; Efron, 1987) yine bootstrap dağılımının kantillerini kullanır, ama \alpha/2 ve 1-\alpha/2 yerine veriden hesaplanan iki düzeltilmiş olasılığı alır:
- \hat z_0: yanlılık düzeltmesi. Kopyaların kestirimden küçük olanlarının oranının normal kantili; kestirime tam eşit kopyalar yarım sayılır. Kopyaların yarısı kestirimin altındaysa \hat z_0=0'dır.
- \hat a: ivme. İstatistiğin standart hatasının parametrenin değerine göre ne hızla değiştiğini ölçer; birini dışarıda bırak (jackknife) kestirimlerinden hesaplanır.
- j: örneklem (tek örneklemde 1; iki örneklemde 1 ve 2); \hat\theta_{j(i)}: j. örneklemin i. gözlemi çıkarılıp öteki örneklem olduğu gibi bırakılarak hesaplanan istatistik; \hat\theta_{j(\cdot)}: bunların ortalaması.
- z_p: standart normal kantil; \Phi: standart normal dağılım fonksiyonu.
- \hat z_0=0 ve \hat a=0 ise \alpha_1=\alpha/2, \alpha_2=1-\alpha/2: BCa yüzdelik aralığa iner.
Neden iki düzeltme?
Yüzdelik aralık iki varsayım altında tam doğrudur: istatistik (uygun bir dönüşümden sonra) yansızdır ve standart hatası parametreye bağlı değildir. \hat z_0 birincinin, \hat a ikincinin bozulmasını düzeltir. Değişim katsayısı, varyans ve oran gibi istatistiklerde standart hata parametreyle birlikte büyür; ivme sıfırdan farklıdır ve aralık, kestirimin büyük değerlerine doğru kayar. BCa sınırlarının tek yanlı kapsama hatası 1/n mertebesindedir; yüzdelik ve temel sınırlarınki 1/\sqrt n mertebesindedir (DiCiccio ve Efron, 1996).
Medyana dayalı istatistiklerde ivme sıfır ya da sıfıra çok yakın çıkar
Medyan, tek bir gözlemin çıkarılmasına yalnız iki değerle tepki verir: örnek veride medyan farkının 40 birini dışarıda bırak kestirimi 2,06 ya da 2,08'dir ve ikisi eşit sayıdadır. U_{ji} değerleri simetriktir, küplerinin toplamı sıfırdır ve \hat a=0 olur. Grup büyüklüğü çiftken medyan, medyan farkı ve benzeri sıra istatistiklerinde BCa aralığı fiilen yalnız yanlılık düzeltmeli (\hat z_0) aralıktır. Bu istatistiklerde bootstrap dağılımı da basamaklıdır (1999 kopyada 590 farklı değer); güven sınırları iki gözlem değerinin ortalamaları arasında sıçrar ve tohuma duyarlıdır (53.9, S6).
53.4.7 Tek yanlı aralıklar
"Güven aralığı türü" tek yanlı seçilirse \alpha/2 yerine \alpha kullanılır ve sınırlardan biri sonsuz yapılır: greater için [L,\infty), less için (-\infty,U]. Buradaki L ve U, 1-2\alpha düzeyli iki yanlı aralığın sınırlarıdır: %95 tek yanlı alt sınır, %90 iki yanlı aralığın alt sınırına eşittir (örnek veride ikisi de 0,6877).
53.4.8 Tohum ve kopya sayısı
Koddaki tercih
Rastgele sayı üreteci np.random.default_rng(mq.seed if mq.seed is not None else 2026) ile kurulur (satır 114): üreteç çalıştırmanın tohumuyla kurulur. Aynı tohum ve aynı ayarla sonuç son basamağa kadar yinelenir. Kod panelindeki Tohum alanı boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar, doluysa o tohumu kullanır (pro/gui/kod_panel.py:552–572); kullanılan tohum sonuç kartının künyesine ve betik adımına yazılır (Bölüm 1.3). Tohum alanı boşken art arda iki çalıştırma bu nedenle Monte Carlo hatası kadar farklı sonuç verir; aynı tohum girildiğinde ya da kaydedilmiş betik yeniden oynatıldığında aynı sonuç alınır. Tohum hiç verilmezse şablon 2026 değerini kullanır; arayüzden çalıştırmada bu yedek devreye girmez. Kullanılan tohum çıktıya yazılmaz.
Kopya sayısı standart hatayı hızla, uç kantilleri yavaş kararlı kılar. Standart hatanın Monte Carlo göreli hatası yaklaşık 1/\sqrt{2B}'dir (B=1999: %1,6). %95 aralığın sınırları ise her uçta kopyaların yalnız %2,5'ine dayanır; BCa'da düzeltilmiş olasılık daha da uca gidebilir (örnek veride \alpha_1=0{,}0079: 1999 kopyanın 16'sı). BCa için B\ge2000 alt sınır sayılır; şablonun varsayılanı 5000'dir.
53.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–80 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on parametre. | Form buradan kurulur (Bölüm 1.2). |
| 81–116 | İçe aktarmalar, dil yardımcısı, grup etiketi ve düzey sırası işlevleri (_et, _duzey_sirasi), üreteç (114), istatistik kimliği, iki örneklem bayrağı. |
np ve pd ad alanında hazırdır (Bölüm 1.3). |
| 119–135 | İstatistik işlevleri: cv, ISLEV sözlüğü, çıktı adları ADLAR. |
Her işlev axis bağımsız değişkeni alır; kendi istatistiğiniz buraya yazılır. |
| 138–160 | İki örneklem: grup sütunu, eksik satırlar, düzeyler, iki dizi a ve b, etiket. |
Düzeyler MerQuR+ sırasına dizilir (145); grup değerleri metne çevrilir (141). |
| 161–171 | Tek örneklem: eksikler atılır, en az 5 gözlem, etiket; kırpma oranı × n<1 ise not. | Grup sütunu seçili olsa da okunmaz; bütün satırlar kullanılır. |
| 174–176 | Bütün değerler aynıysa dur. | İki örneklemde yalnız iki grup da sabitse durur. |
| 178–192 | Anahtar sözcük seçimi (178), kestirim, stats.bootstrap çağrısı, hata ve yozlaşma denetimi. |
Uyarılar bastırılır (180–181); sınır NaN ise ileti (191). |
| 194–200 | Bootstrap dağılımı, tablo satırı, iki metin satırı. | Yanlılık şablonda hesaplanır (196); SH SciPy'den gelir. |
| 202–215 | Histogram (50 aralık), kestirim ve sınır çizgileri; tablo ve şekil çıktısı. | Tek yanlı aralıkta sonsuz sınırın çizgisi görünmez. |
Kritik satırlar:
ISLEV = {…, "cv": cv, "kirpilmis": lambda x, axis=-1: stats.trim_mean(x, KIRP, axis=axis),
         "medyan_farki": lambda a, b, axis=-1: np.median(a, axis=axis) - np.median(b, axis=axis), …}
…
r = stats.bootstrap(veri, islev, n_resamples=P["B"], confidence_level=P["guven"],
                    method=P["yontem"], vectorized=True, paired=False, **{_rng_anahtar: rng},
                    alternative=P.get("alternatif", "two-sided"))
Kendi istatistiğinizi eklemek. En kısa yol, formda bulunan bir istatistiğin işlevini Kod sekmesinde değiştirmektir; örneğin cv işlevinin gövdesi yerine çeyrekler arası genişlik yazılır ve formdan "Değişim katsayısı" seçilir (çıktıdaki ad ADLAR sözlüğünden düzeltilir). İşlev üç koşulu sağlamalıdır: (1) son eksen boyunca hesap yapmalı ve axis bağımsız değişkenini kabul etmelidir, çünkü SciPy işlevi B\times n boyutlu dizilerle çağırır; (2) iki örneklemli ise iki dizi almalı ve birbirine yayınlanabilir (broadcast) sonuç döndürmelidir; (3) her kopya için tek bir sayı döndürmelidir. Koşul (1) sağlanamıyorsa çağrıdaki vectorized=True değeri False yapılır; SciPy o zaman işlevi her kopya için ayrı çağırır (daha yavaş).
53.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/bootstrap_ozel/elle_hesap.py ile, scipy.stats.bootstrap ve trim_mean kullanılmadan hesaplanmıştır. Aynı kopyaların elde edilmesi için şablonun rastgele sayı akışı (NumPy PCG64, tohum 2026) aynı sırayla yeniden üretilmiş; medyanlar, kantiller, \hat z_0, birini dışarıda bırak kestirimleri, ivme ve düzeltilmiş olasılıklar açık formülle hesaplanmıştır. R tarafında (r_dogrulama.R) aynı yeniden örnekleme dizinleri dosyadan okunmuş ve bütün büyüklükler taban R ile (median, quantile, qnorm, pnorm) yeniden hesaplanmıştır.
Adım 1 — Kestirim. Gübre_B'nin sıralı 20 değerinin 10. ve 11.'si 7,67 ve 7,69: medyan 7,68. Kontrol'ün 10. ve 11. değerleri 5,60 ve 5,62: medyan 5,61.
Adım 2 — İlk kopya. Gübre_B için çekilen 20 dizin (grubun dosyadaki sırasına göre): 18, 4, 1, 13, 8, 10, 2, 8, 13, 8, 17, 16, 15, 19, 15, 4, 18, 14, 2, 6; bu değerlerin medyanı 7,54. Kontrol için ayrıca çekilen 20 dizinin medyanı 5,63. \hat\Delta^{*}_1=7{,}54-5{,}63=1{,}91.
Adım 3 — 1999 kopyanın özeti.
Kopyalar ortalamada kestirimin 0,60 üstündedir: Gübre_B'nin medyanı çevresindeki değerler seyrek (7,69'dan sonra 9,32) olduğundan yeniden örneklem medyanı kolayca yukarı sıçrar.
Adım 4 — Yüzdelik aralık. h=1998\times0{,}025=49{,}95; sıralı kopyaların 50. ve 51.'si 0,755 ve 0,765: q^{*}_{0{,}025}=0{,}755+0{,}95\times0{,}010=0{,}7645. h=1998\times0{,}975=1948{,}05; 1949. ve 1950. değerler 5,160 ve 5,165: q^{*}_{0{,}975}=5{,}16025.
Adım 5 — Temel aralık. [\,2\times2{,}07-5{,}16025;\ 2\times2{,}07-0{,}7645\,]=[-1{,}02025;\ 3{,}3755].
Adım 6 — Yanlılık düzeltmesi. 808 kopya kestirimden küçük, 832 kopya küçük ya da eşittir:
Adım 7 — İvme. Gübre_B'den bir gözlem çıkarıldığında medyan farkı 10 kez 2,08, 10 kez 2,06 olur; Kontrol için de aynıdır. U değerleri \mp0{,}19 çiftleridir, küplerinin toplamı sıfırdır: \hat a=0.
Adım 8 — Düzeltilmiş olasılıklar ve BCa sınırları.
Alt sınır: h=1998\times0{,}007889=15{,}7627; 16. ve 17. değerler 0,475 ve 0,515: 0{,}475+0{,}7627\times0{,}040=0{,}505509. Üst sınır: h=1998\times0{,}933957=1866{,}0467; 1867. ve 1868. değerler 4,665 ve 4,675: 4{,}665+0{,}0467\times0{,}010=4{,}665467.
Kopyalar kestirimin üstünde toplandığı için (\hat z_0<0) BCa, yüzdelik aralığın iki ucunu da aşağı çeker: 0,7645 → 0,5055 ve 5,1603 → 4,6655.
Adım 9 — İvmenin sıfır olmadığı bir örnek: değişim katsayısı (çalıştırma 7). \bar x=6{,}9945, s=2{,}551401, \mathrm{DK}=0{,}364772. 1999 kopyada \operatorname{SH}^{*}=0{,}033685, yanlılık -0{,}004143; 1115 kopya kestirimden küçüktür: \hat z_0=\Phi^{-1}(1115/1999)=0{,}145340. Birini dışarıda bırak kestirimleri 0,3397 (en büyük değer 15,27 çıkarıldığında) ile 0,3683 arasındadır ve çarpıktır: \hat a=0{,}065142.
BCa aralığı kopyaların %7,0 ve %99,5 kantilleridir: [0,311594; 0,447587]. Yüzdelik aralık [0,296844; 0,428956]'dır; BCa iki ucu da yukarı taşır, çünkü değişim katsayısının kestirimi aşağı yanlıdır ve standart hatası değerle birlikte büyür.
53.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablosundan tam hassasiyetle alınmıştır (çalıştırmalar 1–8, 10, 11).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Medyan farkı: kestirim | 2,07 | 2,07 | 2,07 | 2,1e−16 | ✓ |
| Medyan farkı: bootstrap SH | 1,18044664 | 1,18044664 | 1,18044664 | 5,6e−16 | ✓ |
| Medyan farkı: yanlılık | 0,59532016 | 0,59532016 | 0,59532016 | 0 | ✓ |
| Medyan farkı: BCa GA alt | 0,50550943 | 0,50550943 | 0,50550943 | 1,0e−15 | ✓ |
| Medyan farkı: BCa GA üst | 4,66546727 | 4,66546727 | 4,66546727 | 5,7e−16 | ✓ |
| Medyan farkı: yüzdelik GA alt | 0,7645 | 0,7645 | 0,7645 | 0 | ✓ |
| Medyan farkı: yüzdelik GA üst | 5,16025 | 5,16025 | 5,16025 | 0 | ✓ |
| Medyan farkı: temel GA alt | −1,02025 | −1,02025 | −1,02025 | 0 | ✓ |
| Medyan farkı: temel GA üst | 3,3755 | 3,3755 | 3,3755 | 1,3e−16 | ✓ |
| Medyan farkı, %90: BCa GA alt | 0,68768181 | 0,68768181 | 0,68768181 | 2,6e−15 | ✓ |
| Medyan farkı, %90: BCa GA üst | 4,265 | 4,265 | 4,265 | 0 | ✓ |
| Medyan farkı, tek yanlı: BCa GA alt | 0,68768181 | 0,68768181 | 0,68768181 | 2,2e−15 | ✓ |
| Medyan farkı, tohum 7: bootstrap SH | 1,16467926 | 1,16467926 | — | 0 | ✓ |
| Medyan farkı, tohum 7: BCa GA alt | 0,49892416 | 0,49892416 | — | 0 | ✓ |
| Medyan farkı, tohum 7: BCa GA üst | 4,61 | 4,61 | — | 0 | ✓ |
| Ortalama oranı: kestirim | 1,56686831 | 1,56686831 | 1,56686831 | 1,4e−16 | ✓ |
| Ortalama oranı: bootstrap SH | 0,16684607 | 0,16684607 | 0,16684607 | 0 | ✓ |
| Ortalama oranı: yanlılık | 0,00932349 | 0,00932349 | 0,00932349 | 1,4e−16 | ✓ |
| Ortalama oranı: BCa GA alt | 1,27651548 | 1,27651548 | 1,27651548 | 3,5e−16 | ✓ |
| Ortalama oranı: BCa GA üst | 1,92699952 | 1,92699952 | 1,92699952 | 9,2e−16 | ✓ |
| Ortalama oranı: yüzdelik GA alt | 1,2759449 | 1,2759449 | 1,2759449 | 0 | ✓ |
| Ortalama oranı: yüzdelik GA üst | 1,92605133 | 1,92605133 | 1,92605133 | 4,6e−16 | ✓ |
| Ortalama oranı: temel GA alt | 1,20768529 | 1,20768529 | 1,20768529 | 9,2e−16 | ✓ |
| Ortalama oranı: temel GA üst | 1,85779172 | 1,85779172 | 1,85779172 | 1,2e−16 | ✓ |
| Değişim katsayısı: kestirim | 0,36477242 | 0,36477242 | 0,36477242 | 5,6e−17 | ✓ |
| Değişim katsayısı: bootstrap SH | 0,03368465 | 0,03368465 | 0,03368465 | 4,9e−17 | ✓ |
| Değişim katsayısı: yanlılık | −0,00414257 | −0,00414257 | −0,00414257 | 8,2e−17 | ✓ |
| Değişim katsayısı: BCa GA alt | 0,311594 | 0,311594 | 0,311594 | 1,1e−16 | ✓ |
| Değişim katsayısı: BCa GA üst | 0,44758729 | 0,44758729 | 0,44758729 | 0 | ✓ |
| Değişim katsayısı, B=5000: bootstrap SH | 0,03315522 | 0,03315522 | — | 6,9e−17 | ✓ |
| Değişim katsayısı, B=5000: BCa GA alt | 0,31250236 | 0,31250236 | — | 5,6e−17 | ✓ |
| Değişim katsayısı, B=5000: BCa GA üst | 0,44922272 | 0,44922272 | — | 5,6e−17 | ✓ |
| Ortalama: kestirim | 6,9945 | 6,9945 | 6,9945 | 0 | ✓ |
| Ortalama: bootstrap SH | 0,33320216 | 0,33320216 | 0,33320216 | 1,1e−16 | ✓ |
| Ortalama: BCa GA alt | 6,38338378 | 6,38338378 | 6,38338378 | 1,4e−16 | ✓ |
| Ortalama: BCa GA üst | 7,70370745 | 7,70370745 | 7,70370745 | 3,5e−16 | ✓ |
| Medyan: kestirim | 6,65 | 6,65 | 6,65 | 0 | ✓ |
| Medyan: bootstrap SH | 0,38875425 | 0,38875425 | 0,38875425 | 0 | ✓ |
| Medyan: BCa GA alt | 5,785 | 5,785 | 5,785 | 0 | ✓ |
| Medyan: BCa GA üst | 7,43374522 | 7,43374522 | 7,43374522 | 0 | ✓ |
| %10 kırpılmış ortalama: kestirim | 6,825625 | 6,825625 | 6,825625 | 0 | ✓ |
| %10 kırpılmış ortalama: bootstrap SH | 0,34354522 | 0,34354522 | 0,34354522 | 0 | ✓ |
| %10 kırpılmış ortalama: BCa GA alt | 6,20528316 | 6,20528316 | 6,20528316 | 1,4e−16 | ✓ |
| %10 kırpılmış ortalama: BCa GA üst | 7,53625563 | 7,53625563 | 7,53625563 | 1,2e−16 | ✓ |
| Fare verisi, medyan farkı: kestirim | 48 | 48 | — | 0 | ✓ |
| Fare verisi, medyan farkı: bootstrap SH | 40,18358349 | 40,18358349 | — | 0 | ✓ |
| Fare verisi, medyan farkı: BCa GA alt | −28 | −28 | — | 0 | ✓ |
| Fare verisi, medyan farkı: BCa GA üst | 111 | 111 | — | 0 | ✓ |
| Fare verisi, ortalama oranı: kestirim | 1,54488989 | 1,54488989 | — | 0 | ✓ |
| Fare verisi, ortalama oranı: bootstrap SH | 0,62960277 | 0,62960277 | — | 0 | ✓ |
| Fare verisi, ortalama oranı: BCa GA alt | 0,67519505 | 0,67519505 | — | 0 | ✓ |
| Fare verisi, ortalama oranı: BCa GA üst | 3,05555023 | 3,05555023 | — | 1,5e−16 | ✓ |
Ölçütü karşılayan: 52/52. Tohum 2026 (şablonun tohumsuz varsayılanı). Python: aynı numpy akışıyla, scipy.stats.bootstrap ve trim_mean kullanılmadan açık formüller. R: Python'un yazdığı yeniden örnekleme dizinleriyle taban R (median, quantile, qnorm, pnorm, birini dışarıda bırak ivmesi); dizin dosyası olmayan çalıştırmalarda R sütunu boştur.
Üç yol aynı kopyaları kullandığında bütün satırlar 10^{-13} düzeyinde örtüşür. R'nin kendi rastgele sayı akışıyla ve boot paketinin kendi BCa tanımıyla (tabakalı yeniden örnekleme, B=1999, tohum 2026) elde edilen sonuçlar ise yalnız Monte Carlo düzeyinde yakındır: medyan farkı için SH 1,1945 ve BCa [0,457; 4,690]; ortalama oranı için [1,2711; 1,9166]; değişim katsayısı için [0,3092; 0,4521].
53.7 Çıktıyı okuma
Örnek ayarın konsol metni ve tablosu (tablo dört ondalığa yuvarlanmış):
Medyan farkı (Gübre_B − Kontrol) = 2,0700
%95 BCa GA: [0,5055; 4,6655]   (bootstrap SH = 1,1804; B = 1999)

Bootstrap GA
                      istatistik  tahmin  bootstrap_SH  yanlilik  ga_alt  ga_ust yontem    B  guven
Medyan farkı (Gübre_B − Kontrol)  2.0700        1.1804    0.5953  0.5055  4.6655    BCa 1999 0.9500
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
istatistik |
İstatistiğin adı ve (iki örneklemde) düzeyler: "1. düzey − 2. düzey" ya da "1. düzey / 2. düzey" | Farkın yönü ve oranın payı buradan denetlenir. |
tahmin |
İstatistiğin verideki değeri | Gübre_B'nin verim medyanı Kontrol'ünkinden 2,07 birim yüksektir. |
bootstrap_SH |
Kopyaların standart sapması | Kestirimin standart hatası. |
yanlilik |
Kopyaların ortalaması eksi kestirim | 0,60: bootstrap dağılımı kestirimin üstünde toplanmıştır; yüzdelik aralık bu kaymayı taşır, BCa düzeltir. |
ga_alt, ga_ust |
Seçilen yöntemin sınırları | Aralık sıfırı içermiyorsa fark seçilen düzeyde sıfırdan ayrılır. Tek yanlı aralıkta bir sınır sonsuzdur. |
yontem, B, guven |
Kullanılan ayarlar | Raporda yöntem ve B birlikte verilir. |
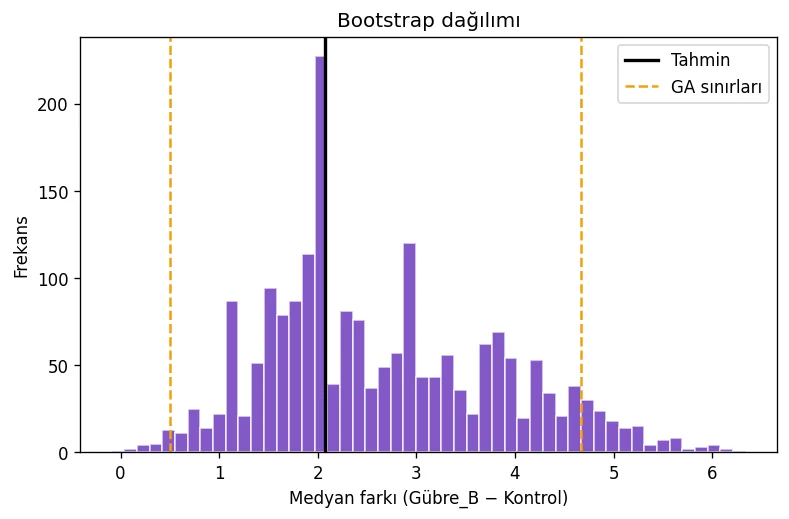
Şekil 53.1. Şablonun şekli (örnek ayar): medyan farkının 1999 kopyadaki dağılımı. Siyah çizgi kestirim (2,07), kesikli çizgiler BCa sınırlarıdır. Dağılım basamaklıdır (medyanlar yalnız gözlem değerlerinin ortalamalarını alabilir) ve sağa çarpıktır.
Üç yöntemin aynı kopyalardan kurduğu aralıklar:
| İstatistik | Kestirim | SH | Yüzdelik | Temel | BCa |
|---|---|---|---|---|---|
| Medyan farkı (Gübre_B − Kontrol) | 2,0700 | 1,1804 | [0,7645; 5,1603] | [−1,0203; 3,3755] | [0,5055; 4,6655] |
| Ortalama oranı (Gübre_B / Kontrol) | 1,5669 | 0,1668 | [1,2759; 1,9261] | [1,2077; 1,8578] | [1,2765; 1,9270] |
| Değişim katsayısı (60 parsel) | 0,3648 | 0,0337 | [0,2968; 0,4290] | [0,3006; 0,4327] | [0,3116; 0,4476] |
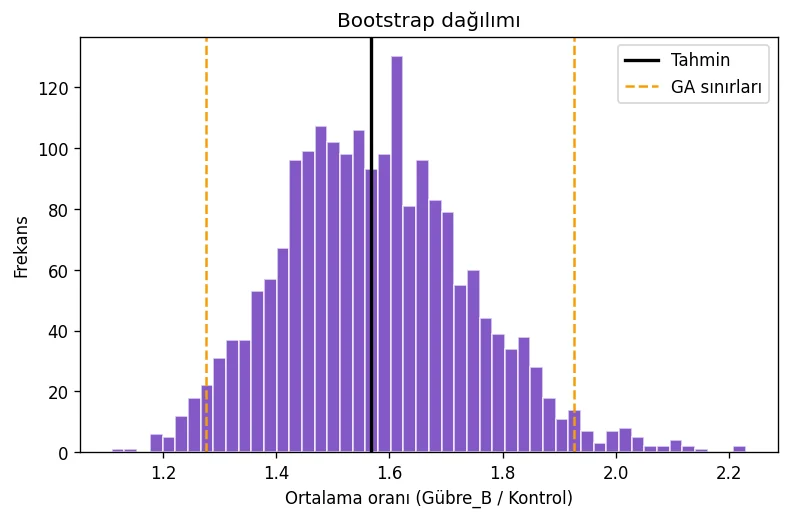
Medyan farkında üç yöntem farklı sonuca götürür: temel aralık sıfırı içerir, öteki ikisi içermez. Bu ayrışma, bootstrap dağılımının kaymış ve çarpık olmasının sonucudur; böyle bir tabloda tek bir yöntemin sonucu yerine dağılımın biçimi (Şekil 53.1) ve yanlılık birlikte raporlanır. Ortalama oranında dağılım düzgündür ve yüzdelik ile BCa neredeyse aynıdır.
Şekil 53.2. Ortalama oranının (Gübre_B / Kontrol) bootstrap dağılımı (çalıştırma 6). Dağılım düzgün ve yaklaşık simetriktir; BCa ve yüzdelik sınırları çakışır.
Tek örneklemli öteki istatistikler (verim, 60 parsel; BCa, B=1999): ortalama 6,9945, GA [6,3834; 7,7037]; medyan 6,65, GA [5,7850; 7,4337]; %10 kırpılmış ortalama 6,8256, GA [6,2053; 7,5363]. Varsayılan ayarda (B=5000) değişim katsayısının aralığı [0,3125; 0,4492]'dir.
Rapor cümlesi (örnek ayar):
Gübre_B parsellerinin verim medyanı (7,68) Kontrol parsellerininkinden (5,61) 2,07 birim yüksek bulundu. Medyan farkı için gruplar ayrı ayrı yeniden örneklenerek (B = 1999) kurulan %95 BCa bootstrap güven aralığı [0,51; 4,67], bootstrap standart hatası 1,18'dir. Bootstrap dağılımı sağa çarpık ve basamaklıdır (yanlılık 0,60); yüzdelik aralık [0,76; 5,16], temel aralık [−1,02; 3,38] bulundu. İki grubun ortalamalarının oranı 1,57'dir (%95 BCa GA [1,28; 1,93]).
53.8 Sık hatalar ve tuzaklar
- Düzey alanlarını boş bırakıp sırayı denetlememek. Şablon düzeyleri MerQuR+ sırasına (kullanıcı sırası, sayısal sıra, ilk görülme) dizip ilk ikisini alır; karşılaştırılan gruplar ve farkın yönü beklenenden farklı olabilir (53.2). İki düzey yazılır ve çıktının ilk satırından denetlenir.
- Düzey adını farklı yazmak. Karşılaştırma harfi harfine yapılır: "gübre_b" bulunamaz; ileti var olan düzeyleri listeler. Sayı kodlu grup sütununda eksik hücre olsa da düzeyler "2", "10" biçimindedir.
- Tek örneklemli istatistikte grup beklemek. Ortalama, medyan, değişim katsayısı ve kırpılmış ortalama seçiliyken grup sütunu ve düzeyler dolu olsa da bütün satırlar kullanılır. Tek bir grubun değişim katsayısı isteniyorsa veri önce o gruba süzülür.
- Eşleştirilmiş veriyi iki grup gibi vermek. Gruplar bağımsız çekilir; eşleşmeden gelen kazanç kaybolur ve aralık gereğinden geniş çıkar.
- Bağımlı gözlemler. Aynı parselin yinelenen ölçümleri ya da ardışık yıllar tek tek çekilirse standart hata küçük kalır (Bölüm 51).
- Medyanlarda BCa'nın "hızlandırılmış" olduğunu sanmak. İvme sıfırdır; aralık yalnız yanlılık düzeltmelidir ve sınırlar tohuma duyarlıdır. Birkaç kez çalıştırmak ya da B'yi büyütmek gerekir.
- Kırpma oranının küçük örneklemde uygulanmadığını görmemek. \lfloor\gamma n\rfloor=0 ise sonuç olağan ortalamadır; ad yine "kırpılmış" yazar, ama şablon "her uçtan hiç gözlem atılmadı" notunu düşer (53.4.2).
- Tohumu kaydetmemek. Tohum alanı boşsa her çalıştırmaya yeni bir tohum atanır; aynı ayarla iki çalıştırma farklı sınırlar verir. Sonucun yinelenebilmesi için künyedeki tohum Tohum alanına girilir ya da çalıştırma betiğe kaydedilir; raporda B yazılır ve iki çalıştırma arasındaki farkın Monte Carlo hatası olduğu unutulmaz.
- Küçük örneklemde aralığa güvenmek. Şablon tek örneklemde 5, grup başına 3 gözlemle çalışır. Beş gözlemde medyanın %95 BCa aralığı verinin en küçük ve en büyük değeridir; bootstrap küçük örneklemde kapsama güvencesi vermez.
- Payda grubunun ortalaması sıfıra yakınken oran. Bazı kopyalarda payda sıfıra çok yaklaşır, oran patlar ve standart hata anlamsız büyür. Şablon yalnız tam sıfırı denetler.
- Yüzdelik ile temel aralığı birbirinin yerine kullanmak. Çarpık dağılımda ters yönlere uzarlar; hangisinin kullanıldığı belirtilir.
53.9 Uzman soruları
S1. BCa aralığı neden bazen yüzdelik aralıktan belirgin biçimde kayıyor?
İki nedenle. \hat z_0\ne0 ise kopyaların yarısından azı (ya da çoğu) kestirimin altındadır; BCa kantil olasılıklarını 2\hat z_0 kadar kaydırır. Örnek veride \hat z_0=-0{,}227 ve olasılıklar 0,025/0,975'ten 0,0079/0,934'e iner. \hat a\ne0 ise standart hata parametreyle değişir; değişim katsayısında \hat a=0{,}065 olasılıkları 0,070/0,995'e çıkarır. İki düzeltme de veriden kestirilir ve küçük örneklemde gürültülüdür; \lvert\hat z_0\rvert büyükse (kabaca 0,25'in üstü) bootstrap dağılımının kendisi sorgulanır.
S2. Medyanda ivme neden sıfır ve bu bir sorun mu?
Birini dışarıda bırak yöntemi düzgün olmayan istatistiklerde çalışmaz: medyan, hangi gözlemin çıkarıldığına göre yalnız iki komşu değerden birini alır. n çiftken bu iki değer eşit sayıda görülür, U değerleri simetriktir ve ivme tam sıfırdır; n tekken üç değer görülür ve ivme küçük ama sıfırdan farklı olabilir (fare verisinde, n_1=7 ve n_2=9 ile, -0{,}017). Dolayısıyla medyan için "BCa", yanlılık düzeltmeli (BC) aralıktır. Sorun aralığın geçersiz olması değil, adının vaat ettiği ikinci mertebe doğruluğun medyan için geçerli olmamasıdır. Medyanlarda düzgünleştirilmiş bootstrap ya da sıra istatistiklerine dayalı kesin aralıklar seçenektir; şablonda yoktur.
S3. İki örneklemde ivme nasıl birleştiriliyor?
SciPy her örneklem için ayrı birini dışarıda bırak kestirimi yapar (öteki örneklem sabit), U_{ji} değerlerinin küp ve kare toplamlarını n_j^3 ve n_j^2 ile bölerek örneklemler üzerinden toplar (53.4.6). Bu, Efron ve Tibshirani'nin (1993) çok örneklemli tanımıdır. Ortalama oranı örneğinde \hat a=0{,}0073, \hat z_0=-0{,}0056: ikisi de sıfıra yakındır ve BCa yüzdelik aralıkla çakışır.
S4. Sonuçlar boot paketinin boot.ci çıktısıyla neden birebir aynı değil?
Üç fark vardır. (1) Rastgele sayı akışı: R ve NumPy farklı üreteçler kullanır. (2) Kantil tanımı: SciPy doğrusal ara değerlemeyle (B-1)p konumunu, boot.ci (B+1)p. sıra istatistiğini (normal ölçekte ara değerleme) kullanır. (3) İvme: boot.ci deneysel etki değerlerini varsayılan olarak regresyonla kestirir, SciPy birini dışarıda bırak yöntemiyle. Örnek veride boot ile (tabakalı, B=1999) medyan farkı için BCa [0,457; 4,690], şablonla [0,506; 4,665] bulunur; fark, tek bir şablonun farklı tohumlarla gösterdiği oynaklığın içindedir (S6).
S5. Yüzdelik mi, temel mi, BCa mı?
Düzgün istatistiklerde (ortalama, oran, değişim katsayısı, kırpılmış ortalama) ve orta büyüklükte örneklemde BCa: ikinci mertebeden doğrudur ve dönüşüme karşı değişmezdir. Sıra istatistiklerinde (medyan, medyan farkı) BCa'nın üstünlüğü yoktur; yüzdelik aralık daha yalın ve daha kararlıdır. Temel aralık, bootstrap dağılımı kaymış ve çarpıkken parametre uzayının dışına taşabilir (örnek veride alt sınır −1,02; fare verisinde ortalama oranının temel aralığı negatif alt sınır verir) ve çoğu durumda en zayıf seçenektir. Hiçbiri küçük örneklemde kapsama güvencesi vermez.
S6. Sınırlar tohuma ne kadar duyarlı?
Örnek ayar 200 farklı tohumla (B=1999) bağımsız olarak yeniden hesaplandığında BCa alt sınırı 0,15 ile 0,63 arasında (ortalama 0,457; standart sapma 0,088), üst sınırı 4,44 ile 4,80 arasında (standart sapma 0,059) değişir; standart hata 1,175 ∓ 0,015'tir. Alt sınır hiçbir tohumda sıfırın altına inmemiştir, yani karar (aralık sıfırı içermiyor) kararlıdır; ama ikinci ondalık raporlanacak kadar kararlı değildir. Oynaklık medyanın basamaklı dağılımından ve \alpha_1'in uçta olmasından gelir. Ortalama oranı gibi düzgün istatistiklerde sınırlar çok daha kararlıdır.
S7. Kestirime tam eşit kopyalar z₀'ı nasıl etkiler?
Bağlar yarım sayılır: oran (\#\{<\}+\#\{\le\})/2B'dir. Sürekli istatistiklerde bağ olmaz. Medyan farkında çok olur: örnek veride 26 kopya matematiksel olarak tam 2,07'dir. Karşılaştırma kayan noktalı sayılarla yapıldığından, 7{,}68-5{,}61 işleminin son basamaktaki yuvarlaması bu 26 kopyadan 2'sini "eşit değil" sayar (küçük-eşit sayısı 834 yerine 832). \hat z_0 dördüncü ondalıkta, sınırlar üçüncü ondalıkta değişir ([0,5100; 4,6721] yerine [0,5055; 4,6655]); bu, tohumdan gelen oynaklığın çok altındadır.
S8. Tek yanlı aralık hangi hipoteze karşılık gelir?
greater ile elde edilen [L,\infty) aralığı, "\theta\le\theta_0" hipotezinin \alpha düzeyinde reddedildiği \theta_0 değerlerinin tümleyenidir: L>0 ise fark tek yanlı olarak sıfırdan büyüktür. Örnek veride %95 tek yanlı alt sınır 0,6877'dir ve %90 iki yanlı aralığın alt sınırıyla aynıdır. Yön veriye bakmadan seçilmelidir; iki yanlı aralık sıfırı içerdiği için tek yanlıya geçmek hata oranını iki katına çıkarır.
S9. Bootstrap standart hatasıyla normal aralık neden verilmiyor?
\hat\theta\mp z\operatorname{SH}^{*} aralığı bootstrap dağılımının yalnız genişliğini kullanır, biçimini atar. Bu şablonun hedefi olan çarpık ve yanlı istatistiklerde (oran, değişim katsayısı, medyan farkı) simetrik aralık en zayıf seçenektir. Standart hata tabloda vardır; istenirse aralık elle kurulur (örnek veride 2{,}07\mp1{,}96\times1{,}1804=[-0{,}24;\ 4{,}38]) ve kantile dayalı aralıklardan belirgin biçimde ayrıştığı görülür.
53.10 Kaynaklar
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap methods and their application. Cambridge University Press. https://doi.org/10.1017/CBO9780511802843
- DiCiccio, T. J., & Efron, B. (1996). Bootstrap confidence intervals. Statistical Science, 11(3), 189–228. https://doi.org/10.1214/ss/1032280214
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Efron, B. (1987). Better bootstrap confidence intervals. Journal of the American Statistical Association, 82(397), 171–185. https://doi.org/10.1080/01621459.1987.10478410
- Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall. https://doi.org/10.1201/9780429246593
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., Wieser, E., Taylor, J., Berg, S., Smith, N. J., Kern, R., Picus, M., Hoyer, S., van Kerkwijk, M. H., Brett, M., Haldane, A., del Río, J. F., Wiebe, M., Peterson, P., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hesterberg, T. C. (2015). What teachers should know about the bootstrap: Resampling in the undergraduate statistics curriculum. The American Statistician, 69(4), 371–386. https://doi.org/10.1080/00031305.2015.1089789
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. Proceedings of the 9th Python in Science Conference, 56–61. https://doi.org/10.25080/Majora-92bf1922-00a
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2