156. Bayes ağları: yapı öğrenme ve olasılık çıkarımı
Şablon kimliği: bayes_ag · Kategori: çok değişkenli · Dil: R · Dosya: pro/sablonlar/cok_degiskenli/bayes_ag.R (satır 1–384; üstbilgi 1–170) · Örnek veri: _ornek/gaussian_test.csv (kesikli örnek: _ornek/learning_test.csv) · Paketler: bnlearn 5.2.1 (R 4.5.3)
156.1 Ne işe yarar
Şablon, birkaç değişken arasındaki koşullu bağımlılık yapısını veriden öğrenir ve yönlü dönüşsüz bir çizge (DAG) olarak gösterir: hangi değişken hangisini doğrudan etkiliyor görünüyor, hangileri ancak aracılar üzerinden ilişkili? Yapı öğrenildikten sonra her düğümün parametreleri kestirilir ve istenirse bir hedef düğümün, verilen kanıt altındaki koşullu dağılımı hesaplanır (ör. "A=1{,}5 ve D=9 iken F'nin dağılımı nedir?").
- X_j: j. düğüm (seçilen j. sütun).
- \mathrm{Pa}(X_j): X_j'nin ebeveynleri; çizgede X_j'ye ok gönderen düğümler.
- P(X_j\mid\mathrm{Pa}(X_j)): düğümün yerel modeli. Gauss düğümde ebeveynlere doğrusal regresyon, kesikli düğümde koşullu olasılık tablosu (CPT).
Veri türü kendiliğinden belirlenir: bütün değişkenler sayısalsa Gauss ağı, bütünü kategorikse kesikli (çok terimli) ağ, karışıksa koşullu Gauss ağı. Dört yapı öğrenme algoritması vardır: tepe tırmanma (hc, varsayılan), tabu araması, PC-stable ve MMHC; puan BIC (varsayılan), AIC ya da (yalnız kesikli ağda) BDe'dir. İsteğe bağlı bootstrap her yayın gücünü ve yön olasılığını verir ve bir ortalama ağ kurar.
Ne zaman kullanılır?
- Çok sayıda değişken arasında keşifsel bir bağımlılık haritası gerekiyorsa ve ikili korelasyon tabloları yetersizse (korelasyon dolaylı ve doğrudan ilişkiyi ayırmaz).
- Bir değişken grubu gözlendiğinde bir hedefin dağılımının nasıl değiştiğini ("senaryo çözümlemesi") tabloya dökmek isteniyorsa.
- Alan bilgisi bazı yayları yasaklıyor ya da zorunlu kılıyorsa (kara ve beyaz liste).
Ne zaman kullanılmaz?
- Yönlerin nedensel okunması isteniyorsa: yapı yalnız koşullu bağımsızlıkları kodlar, denk yapılarda yön veriden belirlenemez (156.8). Nedensel çizge için Bölüm 135
nedensel_cizge. - Tek bir bağımlı değişkenli doğrusal ilişki aranıyorsa: ilgili model şablonları ya da temel programdaki Çoklu Regresyon.
- Değişkenlerin tümü sıfır ve toplamı sabit bileşimlerse: Bölüm 157
bilesimsel_veri. - Çok az gözlem varsa (n < 20 şablon tarafından reddedilir) ve kesikli değişkenlerde düzey sayısı çoksa: CPT'ler seyrek kalır.
Temel programla ilişki. Temel programda Bayes ağı yoktur; yakın analiz Pearson/Spearman korelasyon matrisi ve kısmi korelasyondur. Kısmi korelasyonun sıfır olması Gauss ağında iki düğüm arasında yay olmamasıyla aynı bilgiyi verir; şablon bunu yönlü bir çizge ve parametrelerle birleştirir.
156.2 Şablonun girdileri
Form, üstbilgideki 20 [[param]] bloğundan kurulur (bayes_ag.R:10–169). Türlerin anlamı ve formun ortak denetimi Bölüm 1.2'dedir. degiskenler alanı sayısal rol değildir (sayisal = true yok): hem sayısal hem kategorik sütun kabul eder ve Veri sekmesinde türü "kategorik" olan sütun kategorik düğüm olur (156.3, 156.8).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Değişkenler (düğümler) · degiskenler |
sütunlar · Değişkenler | boş | en az 3 sütun | Düğümler (10–15, 185–188). |
Yapı öğrenme algoritması · algoritma |
seçim · Model | hc |
hc, tabu, pc.stable, mmhc |
Öğrenme işlevi (16–22, 270–271). |
Puan · puan |
seçim · Model | bic |
bic, aic, bde |
Puan tabanlı aramada puan; bde yalnız kesikli ağda (23–29, 237–238). |
Bootstrap yineleme sayısı · bootstrap |
tamsayı · Seçenekler | 0 | 0–2000 | >0 iken yay gücü ve ortalama ağ (30–37, 290–300). |
Çıkarım hedefi · hedef |
sütun (isteğe bağlı) · Değişkenler | boş | seçilen değişkenlerden biri | Boş değilse koşullu dağılım (38–43, 331–370). |
Kanıt · kanit |
metin · Seçenekler | boş | A=1.5; B=b |
Hedefin koşullandığı değerler (44–49, 334–344). |
Koşullu bağımsızlık testi · test |
seçim · Model | varsayilan |
varsayilan, mi, x2, cor, zf, mi-g, mi-cg |
PC-stable ve MMHC'nin kısıt aşaması (50–57, 258–262). |
Anlamlılık düzeyi · alfa |
ondalık · Seçenekler | 0,05 | 0,0001–0,5 | PC-stable ve MMHC testlerinin \alpha'sı (58–66, 268). |
Yasak yaylar · kara_liste |
metin · Model | boş | A->B; C->D |
Ağa girmeyen yönlü yaylar (67–73, 242–254). |
Zorunlu yaylar · beyaz_liste |
metin · Model | boş | A->B; C->D |
Ağda kesin yer alan yaylar (74–80, 242–255). |
Düğüm başına en çok ebeveyn · en_cok_ebeveyn |
tamsayı · Gelişmiş | 0 | 0–59 (0 = sınırsız) | maxp (81–89, 263–264). |
En çok arama yinelemesi · en_cok_yineleme |
tamsayı · Gelişmiş | 0 | 0–100000 (0 = sınırsız) | max.iter (90–98, 263–264). |
Rastgele yeniden başlatma · yeniden_baslat |
tamsayı · Gelişmiş | 0 | 0–100 | Yalnız hc: restart (99–107, 266). |
Yeniden başlatmada değiştirilen yay · bozma |
tamsayı · Gelişmiş | 1 | 1–100 | Yalnız hc: perturb (108–116, 266). |
Tabu listesi uzunluğu · tabu_uzunluk |
tamsayı · Gelişmiş | 10 | 1–1000 | Yalnız tabu: tabu (117–125, 267). |
BDe hayali örneklem büyüklüğü · iss |
ondalık · Gelişmiş | 1 | 0,01–1000 | Yalnız BDe: iss (126–134, 265). |
Ortalama ağ eşiği · esik |
ondalık · Seçenekler | 0,5 | 0,05–1 | averaged.network(threshold) (135–143, 295). |
Çıkarım için örnek sayısı · ornek_sayisi |
tamsayı · Gelişmiş | 100000 | 1000–10 000 000 | Kesikli ve karışık ağda cpdist(n =) (144–152, 358). |
Koşullu dağılım aralığı düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | Gauss ağda hedefin aralığı (153–161, 355). |
İki değerli sayısal sütunlar · ikili_sayisal |
seçim · Model | gauss |
gauss, kategorik |
Sayısal kalan 0/1 gibi sütunun Gauss düğümü mü, iki düzeyli kesikli düğüm mü olacağı (162–169, 204–215). |
Şablonun kendi denetimleri (mq_hata):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 184 |
| Benzersiz değişken sayısı <3 ya da >60 | "En az 3 değişken seçin." / "En çok 60 değişken desteklenir." | 186–187 |
| Tam gözlem sayısı <20 | "En az 20 tam gözlem gerekli." | 193 |
| İki sayısal değişken birbirinin doğrusal işlevi (|r|>1-10^{-8}) | "'A' ve 'A2' birbirinin doğrusal işlevi (|r| = 1); … Birini değişkenlerden çıkarın." | 225–231 |
| Sayısal değişken sabit | "'…' sabit; değişkenlerden çıkarın." | 219 |
| Kategorik değişken tek düzeyli | "'…' tek düzeyli; değişkenlerden çıkarın." | 222 |
puan = bde ve ağ kesikli değil |
"BDe puanı yalnız kesikli (tümü kategorik) ağlar içindir." | 237 |
Yay listesinde -> yok, değişken seçilenlerde değil ya da yay kendine |
"… 'A->B' biçiminde olmalı" / "… seçilenler arasında değil" / "bir değişken kendine yay veremez" | 246–249 |
| Aynı yay hem kara hem beyaz listede | "Aynı yay hem yasak hem zorunlu olamaz." | 256–257 |
| Seçilen test ağ türüne uymuyor (yalnız PC-stable ve MMHC) | "'…' testi bu ağ türüne uygun değil; geçerli: …" | 259–262 |
| Öğrenme ya da çıkarım sırasında bnlearn hatası | "Bayes ağı öğrenilemedi (bnlearn iletisi, İngilizce): …" | 240–241 |
| Hedef seçilen değişkenlerde değil | "Çıkarım hedefi seçilen değişkenler arasında olmalı." | 333 |
Kanıt değişken=değer biçiminde değil, değişken ağda yok, aynı değişken birden çok kez verilmiş, hedef kanıtta, kategorik düzey geçersiz, sayısal değer sayı değil |
ilgili ileti ("birden çok kez verilmiş" ve "ondalık ayırıcı nokta olmalıdır, ör. 1.5" dahil) | 337–346 |
Seçilen değişkenlerden herhangi birinde eksik değer olan satır atılır (191); atılan satır sayısı, kalan ve toplam satır, atılan oran ve değişken başına eksik değer sayısı çıktıya yazılır, satırların %10'u ya da daha fazlası atılmışsa ayrıca uyarı eklenir (194–203); en az 20 koşulu atıldıktan sonraki sayıya uygulanır. Tohum: şablonda tohum alanı yoktur; bootstrap, hc yeniden başlatması ve kesikli/karışık ağdaki olabilirlik ağırlıklı örnekleme çalıştırmanın tohumunu kullanır (Bölüm 1.3: Kod panelindeki Tohum alanı ya da sonuç kartındaki "Tohum" satırı). Gauss ağında çıkarım kesindir ve yapı öğrenme (yeniden başlatmasız hc, tabu, pc.stable, mmhc) belirlenimcidir; bu durumlarda tohum sonucu etkilemez.
Örnek ayar (ornek_param, satır 9): degiskenler = [A … G], algoritma = hc, puan = bic, bootstrap = 0, hedef = F, kanit = "A=1.5; D=9"; öteki alanlar varsayılandadır.
156.3 Örnek veri
gaussian_test.csv, bnlearn'ın gaussian.test verisidir: n=5000, yedi sayısal sütun, eksik değer yok. Üretici ağ [A][B][E][G][C\mid A{:}B][D\mid B][F\mid A{:}D{:}E{:}G]'dir (Scutari ve Denis, 2021). Kesikli örnek learning_test.csv (learning.test): n=5000, altı kategorik sütun, üretici ağ [A][C][F][B\mid A][D\mid A{:}C][E\mid B{:}F].
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
A |
düğüm | sayısal | ort. 1,0075; sd 1,0042 |
B |
düğüm | sayısal | ort. 2,0395; sd 3,0341 |
C |
düğüm | sayısal | ort. 8,0891; sd 6,3586 |
D |
düğüm | sayısal | ort. 9,0510; sd 4,5582 |
E |
düğüm | sayısal | ort. 3,4939; sd 1,9899 |
F |
düğüm, hedef | sayısal | ort. 22,1225; sd 6,1897 |
G |
düğüm | sayısal | ort. 5,0281; sd 1,9836 |
learning_test.csv düzeyleri: A, B, C, D, E üç düzeyli (a, b, c), F iki düzeyli (a, b). Düzey sırası: Veri sekmesi bu sütunları ilk görülme sırasıyla sıralar (A: b, a, c; D: a, c, b; Bölüm 1.3). Şablon etken (kategorik) sütunun bu sırasını korur (droplevels); metin sütunda sıra .siral işleviyle kurulur: tüm etiketler sayıysa sayısal sıra (1, 2, 10), değilse harf (kod noktası) sırası (175–183, 221). Düzey sırası hesabı etkilemez; yalnız çıktı satırlarının sırasını belirler. Aynı kural bilesimsel_veri ve bilesimsel_veri_py şablonlarında da geçerlidir (Bölüm 157, 158).
Bu bölümde kullanılan çalıştırmalar (p1_ba_…, tohum 1; adı geçen dışında ayarlar varsayılandır): ornek; kesikli (learning_test, hedef = D, kanit = "A=a; C=b"; ayrıca tohum 2: kesikli_s2), kesikli_bde, kesikli_aic, kesikli_sade (hedef = E, kanıtsız); tabu, pc, mmhc, aic (Gauss, hedefsiz); pc_kesikli; boot_s1, boot_s2 (kesikli, 40 yineleme, tohum 1 ve 2), boot_gauss (20 yineleme); kara_beyaz (B->D yasak, G->A zorunlu); karisik, karisik_kat, karisik_pc (Gauss ve kategorik sütunların karışımı, n = 800); eksik (40 hücre eksik), sayi_duzey, ikili_num, ikili_kat, ozdes, sabit, n19, n20, adli ve hata çalıştırmaları (h_*).
156.4 Yöntem: formüller ve hesap adımları
Hesap sırası: veri hazırlanır, eksik satırlar sayılır, iki değerli sütunlar ve doğrusal bağımlı sütun çiftleri denetlenir ve ağ türü belirlenir (184–238); kara ve beyaz listeler ayrıştırılır (242–257); öğrenme işlevi ve bağımsızlık testi kurulur (258–271); yapı öğrenilir (272), yineleme ve ebeveyn sınırı denetlenir (273–285), yönsüz yaylar varsa tutarlı bir yönlendirme seçilir (286–289); bootstrap istenmişse ortalama ağ alınır (290–300); parametreler kestirilir ve özet yazılır (301–330); hedef verilmişse çıkarım yapılır (331–370); şekil çizilir (373–383).
156.4.1 Ağ türü, puan ve parametre sayısı
Bir sütun sayısal sayılır ise is.numeric doğru ve is.logical yanlıştır (204); öteki sütunlar .siral ile düzey sırası kurulan etkene çevrilir (221). Sayısal sütunun yalnız iki ayrı değeri varsa (0/1 gibi) çıktıya Gauss düğümü notu düşülür; ikili_sayisal = kategorik seçilirse sütun iki düzeyli kesikli düğüm olur (205–215). Sayısal sütunlar arasında |r|>1-10^{-8} olan çift varsa çalıştırma durur (225–231): bir sütun ötekinin kopyasıysa Gauss düğümünün artık sd'si sıfıra gider ve olabilirlik tanımsızlaşır. Ağ türü g (hepsi sayısal), d (hiçbiri sayısal değil) ya da cg'dir (232). Puan adı türe göre kurulur: bic-g, bic-cg, bic ve benzerleri (237–238). Sütun adları make.names ile R adına çevrilir ve çıktıda özgün adlara geri çevrilir (233–236).
Koddaki tercih
bic ve aic puanları bnlearn'ın "büyük iyi" tanımıdır: \mathrm{BIC}=\ell-\tfrac{k}{2}\ln n, \mathrm{AIC}=\ell-k; \ell log-olabilirlik, k parametre sayısı, n gözlem sayısı. Şablon özetteki "BIC (log-olabilirlik − k/2·log n)" satırını bu tanımla yazar (304, 317–320); -2\ell+k\ln n biçiminin yarısı ve ters işaretlisidir. Karşılaştırma yaparken büyük değer iyidir.
Parametre sayıları. Gauss düğümde p ebeveyn için p+2 (kesişim, p eğim, artık sd). Kesikli düğümde (r-1)\prod_{i\in\mathrm{Pa}}r_i, r düğümün düzey sayısı. Koşullu Gauss düğümde kesikli ebeveynlerin her düzey birleşimi için ayrı bir regresyon vardır: c\,(p_g+2), c birleşim sayısı, p_g sürekli ebeveyn sayısı (nparams, 239).
156.4.2 Gauss ağı
Her düğüm ebeveynlerine doğrusal regresyonla bağlanır:
- \beta_{j0}, \beta_{jk}: kesişim ve eğimler; en küçük kareler (en çok olabilirlik ile aynı) kestirimi.
- \sigma_j^2: artık varyans.
bn.fit(ag, d) kestirimi yapar (301). Artık sd'si bnlearn tanımıyla \hat\sigma_j=\sqrt{\mathrm{SSE}_j/(n-p_j)}'dir; p_j kesişim dâhil katsayı sayısıdır ve ebeveynsiz düğümde n-1 olur. Log-olabilirlik bu \hat\sigma_j ile hesaplanır (238, logLik(f, d)):
Neden n-p paydası ve ne farkı var
En çok olabilirlik \sigma^2=\mathrm{SSE}/n verir; bnlearn'ın bn.fit'i serbestlik derecesine göre düzeltilmiş \mathrm{SSE}/(n-p) kullanır. Örnek veride log-olabilirlik -53131{,}9173 ile -53131{,}9152 arasında 0{,}0021 farklıdır; BIC sıralaması ve yapı seçimi etkilenmez. Şablonun yazdığı değerler bnlearn'ınkilerdir (156.6).
Koşullu dağılım (kesin). Gauss ağında ortak dağılım çok değişkenli normaldir. Düğümleri topolojik sırayla \mathbf X=\mathbf B\mathbf X+\boldsymbol\mu_0+\boldsymbol\varepsilon yazarsak (\mathbf B: eğim matrisi, \boldsymbol\mu_0: kesişimler, \mathbf D=\mathrm{diag}(\hat\sigma_j^2)):
Şablon bu matrisleri gbn2mvnorm(f) ile alır (346–347). Hedef h, kanıt kümesi e ve kanıt değerleri \mathbf x_e için:
Aralık \mu_{h\mid e}\pm z_{(1+g)/2}\,\sigma_{h\mid e}'dir; g guven değeridir (349–355). Kanıt yoksa koşulsuz \mu_h ve \sigma_{hh}^{1/2} verilir (353).
- \boldsymbol\Sigma_{he}: hedefin kanıt değişkenleriyle kovaryansı; \boldsymbol\Sigma_{ee}: kanıt değişkenlerinin kovaryans matrisi.
- z_{(1+g)/2}: standart normal dağılımın (1+g)/2 kantili (
qnorm); g=0{,}95 için 1{,}96.
156.4.3 Kesikli ağ
Her düğümün CPT'si en çok olabilirlikle sayımdan kestirilir: \hat\theta_{ijk}=n_{ijk}/n_{ij\cdot} (i: düğümün düzeyi, j: ebeveyn birleşimi, k eleman). Log-olabilirlik
ve k=\sum_j(r_j-1)q_j'dir. BDe puanı (Heckerman ve ark., 1995), Dirichlet önselli Bayesçi yerel puanın eşdeğer örneklem büyüklüğü \mathrm{iss} ile kurulmuş biçimidir:
- r: düğümün düzey sayısı; q: ebeveyn birleşimi sayısı; n_{ik}: k. ebeveyn birleşiminde i. düzeyin sayısı; n_{\cdot k}=\sum_in_{ik}.
- \mathrm{iss}: hayali örneklem büyüklüğü (
iss, varsayılan 1).
Çıkarım (olabilirlik ağırlıklı örnekleme). Kesikli ve karışık ağda hedefin koşullu dağılımı cpdist(f, nodes = hedef, evidence = kanit, method = "lw", n = ornek_sayisi) ile elde edilir (358). Kanıt düğümleri sabitlenir, öteki düğümler topolojik sırayla ebeveynlerinden örneklenir ve her örnek, kanıt değerlerinin kendi ebeveynleri altındaki olabilirliğiyle ağırlıklandırılır; hedefin ağırlıklı oranları (kategorikte) ya da ağırlıklı ortalama ve sd'si (sayısalda) yazılır (360–369). Kanıt yoksa koşulsuz örnekleme yapılır. Kanıt düğümleri kökse ağırlıklar eşittir ve yöntem ileri örneklemeye dönüşür; Monte Carlo hatası yaklaşık \sqrt{\hat p(1-\hat p)/n}'dir (156.6).
156.4.4 Yapı öğrenme algoritmaları
Tepe tırmanma (hc) boş çizgeden başlar; her adımda bir yay ekleme, silme ya da çevirme hamlesinden puanı en çok artıranı uygular ve hiçbir hamle puanı artırmayana dek sürer. Puanlar düğüm başına ayrışır; her hamle yalnız etkilenen düğümlerin puanını yeniden hesaplar. yeniden_baslat >0 ise bulunan ağ bozma kadar rastgele hamleyle bozulur ve arama yinelenir; en iyi puanlı ağ saklanır (restart, perturb: 218). Tabu araması (Glover, 1986) aynı hamle kümesini kullanır ama son tabu_uzunluk yapıyı yasaklı listeye alıp puan düşse de en iyi izinli hamleyi uygulayarak yerel en iyiden kaçmaya çalışır (267). PC-stable (kısıt tabanlı) tüm düğümler arasında tam bir iskeletle başlar, koşullu bağımsızlık testleri (\alpha= alfa) bağımsız çıkan çiftlerin yayını siler, sonra v-yapılarını yönlendirir; sonuç genellikle kısmen yönlü bir çizgedir (denklik sınıfı). MMHC (melez; Tsamardinos ve ark., 2006) önce kısıt aşamasıyla her düğüm için aday ebeveyn kümesini daraltır, sonra bu kümelerle sınırlı bir tepe tırmanma yapar. Kara ve beyaz listeler her algoritmaya aktarılır (269–271).
Koşullu bağımsızlık testleri (yalnız PC-stable ve MMHC): mi karşılıklı bilgi (G^2), x2 Pearson \chi^2 (yalnız kesikli); cor Pearson korelasyonu t testi, zf Fisher z, mi-g Gauss karşılıklı bilgi (yalnız Gauss); mi-cg koşullu Gauss karşılıklı bilgi (yalnız karışık). varsayilan seçeneği türe göre mi, cor ya da mi-cg'yi bnlearn'a bırakır (258–262).
Denklik sınıfı. Aynı koşullu bağımsızlıkları kodlayan yapılar (ör. A\to B ile B\to A) aynı puanı alır. Yönsüz yay kalırsa cextend tutarlı bir tam yönlendirme seçer ve konsola not düşer (286–289); hc ve tabu her zaman tam yönlü bir ağ döndürdüğünden bu not onlarda çıkmaz. en_cok_yineleme sınırı konmuşsa ve arama bu sınırda durmuşsa (bir yineleme daha ağı değiştiriyorsa) uyarı yazılır; en_cok_ebeveyn sınırına ulaşan düğümler not edilir (273–285).
156.4.5 Bootstrap ve ortalama ağ
bootstrap =R>0 ise boot.strength(d, R = B, algorithm, algorithm.args) veriyi R kez yerine koyarak yeniden örnekler, her seferinde aynı algoritmayı çalıştırır ve her (a,b) çifti için güç (yayın, yönüne bakmadan görülme oranı) ve yön olasılığı (a\to b görüldüğünde a\to b yönünün oranı) verir (293–294). Ortalama ağ averaged.network(guc, threshold = esik) ile kurulur; yönsüz yay içermiyor ve döngüsüzse tek-ağ sonucunun yerine geçer ve çıktı bunu yazar; aksi hâlde ilk (tek) ağ korunur ve bu da yazılır (295–299). Yay tablosuna guc ve yon_olasiligi sütunları eklenir; yön olasılığı 0,45 ile 0,55 arasında olan yaylar not edilir (307–312).
156.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–170 | Üstbilgi: 20 parametre. | Üstbilgideki yan dosya alanı kitap dışıdır (Bölüm 1.1). |
| 171–203 | .m ve .m3 dil yardımcıları; bnlearn yüklenir; düzey sırası yardımcısı .siral (175–183); değişken kümesi, eksik satırların atılması ve sayısı, en az 20 tam gözlem denetimi. |
Atılan satır sayısı ve değişken başına eksik sayısı yazılır (194–203). |
| 204–232 | Sayısal ve kategorik değişkenler ayrılır; iki değerli sayısal sütun notu ya da kategorik ele alma; sabit ve tek düzeyli sütunlar reddedilir; doğrusal bağımlı çift denetimi; ağ türü belirlenir. | Sayısal olup is.logical olmayan sütun Gauss düğümdür; 0/1 sayısal sütun da böyledir, çıktıda not düşülür (156.8). |
| 233–241 | Adlar make.names ile çevrilir; puan adı kurulur; kos hata ve uyarıları yakalar. |
Uyarılar toplanır ve sona yazılır; iletinin bnlearn'dan geldiği ve İngilizce olduğu belirtilir (372). |
| 242–262 | Kara/beyaz liste ve bağımsızlık testi denetimi. | Ayırıcı ;, yay ->; ondalık virgül yoktur. |
| 263–285 | Algoritma argümanları ve öğrenme; yineleme ve ebeveyn sınırı denetimi. | 0 = sınırsız (Inf); sınıra ulaşılması bildirilir. |
| 286–300 | Yönsüz yaylar için cextend; bootstrap ve ortalama ağ. |
Ortalama ağ uygunsa tek-ağ sonucunun yerine geçer; hangisinin raporlandığı yazılır. |
| 301–320 | bn.fit, log-olabilirlik, parametre sayısı, BIC; yay ve özet tabloları; yön olasılığı belirsiz yaylar notu. |
\ell-k/2\ln n büyük iyi. |
| 321–330 | Gauss ağda düğüm parametreleri; kesikli ya da karışıkta düğüm–ebeveyn–parametre tablosu. | Gauss tablosu kesişim, eğim ve artık sd içerir. |
| 331–371 | Hedef ve kanıt ayrıştırması; Gauss ağda kesin, öteki ağlarda cpdist(lw) çıkarımı. |
Kanıt değişkeni sayısalsa sayı, kategorikse düzey olmalıdır. |
| 372–384 | Uyarı notu; dairesel yerleşimli ağ şekli. | Düğümler çemberde değişken sırasıyla; oklar düğüm kenarında biter. |
Süre: örnek ayarda çalıştırma 2,85 s sürmüştür.
156.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/bayes_ag/elle_hesap.py (numpy/scipy; bnlearn ve şablon işlevi çağrılmaz) ve r_dogrulama.R (taban R lm, table, lgamma; bnlearn yalnız score() çapraz kontrolü) ile hesaplanmıştır.
Adım 1 — Yapı. Kendi tepe tırmanma kodum (ekle/sil/çevir, yerel puan önbellekli, 60 rastgele bozmalı yeniden başlatma) \mathrm{BIC}'i en büyükleyen yapı olarak yedi yaylı bir DAG bulur: A\to C, B\to C, D\to B, A\to F, D\to F, E\to F, G\to F. İskelet şablonunkiyle ve belgelenen üretici ağla aynıdır; tek fark B–D yayının yönüdür (şablonda B\to D): iki yön Markov denktir ve puanları aynıdır. Bu yapının hiçbir tek-yay komşusu (ekleme, silme, çevirme) puanı artırmaz (en iyi komşu: eşit, çevirme). Üretici ağın BIC'i aynı değerdir; yani şablonun bulduğu yapı bilinen gerçek yapıyla aynı puana sahiptir.
Adım 2 — Düğüm regresyonları. F düğümü için en küçük kareler \hat\beta=(-0{,}006047;\ 1{,}994853;\ 1{,}005637;\ 1{,}002577;\ 1{,}494373) (A,D,E,G sırasıyla), \hat\sigma_F=\sqrt{\mathrm{SSE}/(n-5)}=0{,}996147; şablonun tablosuyla 10^{-14} içinde aynıdır. Öteki düğümlerde artık sd: A 1,004233; B 3,034111; C 0,508977; D 0,328667; E 1,989860; G 1,983631.
Adım 3 — Log-olabilirlik, parametre sayısı, BIC. Parametre sayısı 21 (yedi kesişim, yedi eğim, yedi sd). n-p paydalı tanımla \ell=-53131{,}917260, \mathrm{BIC}=-53221{,}347788; şablon aynı değerleri verir. \sigma^2=\mathrm{SSE}/n tanımıyla \ell=-53131{,}915159 ve \mathrm{BIC}=-53221{,}345687'dir (fark 0{,}0021). Ortalama Markov örtüsü boyu 4{,}0.
Adım 4 — Koşullu dağılım. \boldsymbol\Sigma=(\mathbf I-\mathbf B)^{-1}\mathbf D(\mathbf I-\mathbf B)^{-\top} kurulur; F\mid A=1{,}5,\,D=9 için \mu_{h\mid e}=23{,}053697, \sigma_{h\mid e}=3{,}709349, %95 aralık [15{,}783506;\ 30{,}323887]; şablon ve R ile 10^{-14} içinde aynıdır. Kanıtsız F: ortalama 22{,}122517, sd 6{,}227697.
Adım 5 — Kesikli ağ. learning_test için kendi tepe tırmanmam BIC, BDe ve AIC ile aynı beş yaylı iskeleti bulur (A\to B, A\to D, C\to D, B\to E, F\to E). Sayımdan \ell=-23832{,}131772, parametre sayısı 41 (2+6+2+18+12+1), \mathrm{BIC}=-24006{,}734232; BDe puanı (\mathrm{iss}=1) -24028{,}094778 (bnlearn score ile aynı; şablon BDe puanını yazmaz). Kesin çıkarım: D'nin ebeveynleri A,C kanıtta olduğundan P(D\mid A=a,C=b) doğrudan CPT satırıdır: (0{,}180791;\ 0{,}132768;\ 0{,}686441). Şablonun olabilirlik ağırlıklı sonucu tohum 1'de (0{,}18135;\ 0{,}13343;\ 0{,}68522), tohum 2'de (0{,}18159;\ 0{,}13396;\ 0{,}68445)'dir; en büyük fark 2{,}0\times10^{-3} ve \sqrt{0{,}18\cdot0{,}82/10^5}=1{,}2\times10^{-3} düzeyindeki Monte Carlo hatasıyla uyumludur (ölçüt bu satırlarda 5\times10^{-3}).
156.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | Ölçüt | |
|---|---|---|---|---|---|---|
| Gauss: yay sayısı (belgelenen gerçek ağ: 7) | 7 | 7 | 7 | 0 | 1e−6 | ✓ |
| Gauss: iskelet bağımsız aramayla aynı mı (1 = evet) | 1 | 1 | 1 | 0 | 1e−6 | ✓ |
| Gauss: parametre sayısı | 21 | 21 | 21 | 0 | 1e−6 | ✓ |
| Gauss: log-olabilirlik (\sigma^2=\mathrm{SSE}/(n-p)) | −53131,91725992 | −53131,91725992 | −53131,91725992 | 8,2e−16 | 1e−6 | ✓ |
| Gauss: BIC | −53221,34778843 | −53221,34778843 | −53221,34778843 | 1,4e−16 | 1e−6 | ✓ |
| Gauss: BIC, bağımsız aramanın bulduğu yapı (R: \sigma^2=\mathrm{SSE}/n tanımı) | −53221,34778843 | −53221,34778843 | −53221,34568733 | 3,9e−8 | 1e−6 | ✓ |
| Gauss: ortalama Markov örtüsü boyu | 4 | 4 | 4 | 0 | 1e−6 | ✓ |
| Gauss: artık sd, A | 1,00423286 | 1,00423286 | 1,00423286 | 2,0e−15 | 1e−6 | ✓ |
| Gauss: artık sd, B | 3,03411076 | 3,03411076 | 3,03411076 | 0 | 1e−6 | ✓ |
| Gauss: artık sd, C | 0,5089772 | 0,5089772 | 0,5089772 | 0 | 1e−6 | ✓ |
| Gauss: artık sd, D | 0,32866716 | 0,32866716 | 0,32866716 | 1,0e−15 | 1e−6 | ✓ |
| Gauss: artık sd, E | 1,98985985 | 1,98985985 | 1,98985985 | 6,7e−16 | 1e−6 | ✓ |
| Gauss: artık sd, F | 0,99614749 | 0,99614749 | 0,99614749 | 7,8e−16 | 1e−6 | ✓ |
| Gauss: artık sd, G | 1,98363082 | 1,98363082 | 1,98363082 | 1,5e−15 | 1e−6 | ✓ |
| Gauss: F katsayısı, kesişim | −0,00604732 | −0,00604732 | −0,00604732 | 2,3e−14 | 1e−6 | ✓ |
| Gauss: F katsayısı, A | 1,99485304 | 1,99485304 | 1,99485304 | 1,8e−15 | 1e−6 | ✓ |
| Gauss: F katsayısı, D | 1,00563691 | 1,00563691 | 1,00563691 | 3,1e−15 | 1e−6 | ✓ |
| Gauss: F katsayısı, E | 1,002577 | 1,002577 | 1,002577 | 1,3e−15 | 1e−6 | ✓ |
| Gauss: F katsayısı, G | 1,49437327 | 1,49437327 | 1,49437327 | 1,0e−15 | 1e−6 | ✓ |
| Gauss: C katsayısı, kesişim | 2,00108316 | 2,00108316 | — | 2,4e−15 | 1e−6 | ✓ |
| Gauss: C katsayısı, A | 1,99590141 | 1,99590141 | — | 1,8e−15 | 1e−6 | ✓ |
| Gauss: C katsayısı, B | 1,99910773 | 1,99910773 | — | 3,0e−15 | 1e−6 | ✓ |
| Gauss: F\mid A=1{,}5,D=9, ort | 23,05369659 | 23,05369659 | 23,05369659 | 4,3e−15 | 1e−6 | ✓ |
| Gauss: F\mid A=1{,}5,D=9, sd | 3,70934908 | 3,70934908 | 3,70934908 | 1,9e−15 | 1e−6 | ✓ |
| Gauss: F\mid A=1{,}5,D=9, alt | 15,78350598 | 15,78350598 | 15,78350598 | 3,2e−15 | 1e−6 | ✓ |
| Gauss: F\mid A=1{,}5,D=9, ust | 30,32388721 | 30,32388721 | 30,32388721 | 5,9e−16 | 1e−6 | ✓ |
| Gauss: F koşulsuz ortalama (kanıt yok) | 22,12251667 | 22,12251667 | — | 3,9e−15 | 1e−6 | ✓ |
| Gauss: F koşulsuz sd (kanıt yok) | 6,22769677 | 6,22769677 | — | 8,6e−16 | 1e−6 | ✓ |
| Gauss, tabu: iskelet hc ile aynı mı (1 = evet) | 1 | 1 | — | 0 | 1e−6 | ✓ |
| Gauss, PC-stable: iskelet hc ile aynı mı (1 = evet) | 1 | 1 | — | 0 | 1e−6 | ✓ |
| Gauss, MMHC: iskelet hc ile aynı mı (1 = evet) | 1 | 1 | — | 0 | 1e−6 | ✓ |
| Gauss, ortalama ağ (bootstrap 20): iskelet hc ile aynı mı (1 = evet) | 1 | 1 | — | 0 | 1e−6 | ✓ |
| Gauss, AIC: yay sayısı | 9 | 9 | — | 0 | 1e−6 | ✓ |
| Gauss, AIC: iskelet bağımsız aramayla aynı mı (1 = evet) | 1 | 1 | — | 0 | 1e−6 | ✓ |
| Eksik veri: kullanılan gözlem sayısı (satır silme) | 560 | 560 | 560 | 0 | 1e−6 | ✓ |
| Kesikli: yay sayısı (belgelenen gerçek ağ: 5) | 5 | 5 | 5 | 0 | 1e−6 | ✓ |
| Kesikli: iskelet bağımsız aramayla aynı mı (1 = evet) | 1 | 1 | 1 | 0 | 1e−6 | ✓ |
| Kesikli: parametre sayısı | 41 | 41 | 41 | 0 | 1e−6 | ✓ |
| Kesikli: parametre sayısı (düğüm tablosunun toplamı) | 41 | 41 | 41 | 0 | 1e−6 | ✓ |
| Kesikli: log-olabilirlik | −23832,13177207 | −23832,13177207 | −23832,13177207 | 1,1e−15 | 1e−6 | ✓ |
| Kesikli: BIC | −24006,7342325 | −24006,7342325 | −24006,7342325 | 1,7e−15 | 1e−6 | ✓ |
| Kesikli: ortalama Markov örtüsü boyu | 2,33333333 | 2,33333333 | — | 1,5e−15 | 1e−6 | ✓ |
| Kesikli: P(D=a\mid A=a,C=b), tohum 1 (örnekleme) | 0,18135 | 0,18079096 | 0,18079096 | 5,6e−4 | 5e−3 | ✓ |
| Kesikli: P(D=b\mid A=a,C=b), tohum 1 (örnekleme) | 0,13343 | 0,13276836 | 0,13276836 | 6,6e−4 | 5e−3 | ✓ |
| Kesikli: P(D=c\mid A=a,C=b), tohum 1 (örnekleme) | 0,68522 | 0,68644068 | 0,68644068 | 1,2e−3 | 5e−3 | ✓ |
| Kesikli: P(D=a\mid A=a,C=b), tohum 2 (örnekleme) | 0,18159 | 0,18079096 | 0,18079096 | 8,0e−4 | 5e−3 | ✓ |
| Kesikli: P(D=b\mid A=a,C=b), tohum 2 (örnekleme) | 0,13396 | 0,13276836 | 0,13276836 | 1,2e−3 | 5e−3 | ✓ |
| Kesikli: P(D=c\mid A=a,C=b), tohum 2 (örnekleme) | 0,68445 | 0,68644068 | 0,68644068 | 2,0e−3 | 5e−3 | ✓ |
| Kesikli: P(E=a), kanıt yok (örnekleme) | 0,38976 | 0,38861402 | — | 1,1e−3 | 5e−3 | ✓ |
| Kesikli: P(E=b), kanıt yok (örnekleme) | 0,2974 | 0,29773713 | — | 3,4e−4 | 5e−3 | ✓ |
| Kesikli: P(E=c), kanıt yok (örnekleme) | 0,31284 | 0,31364885 | — | 8,1e−4 | 5e−3 | ✓ |
| Kesikli: BDe yapısı, yay sayısı | 5 | 5 | — | 0 | 1e−6 | ✓ |
| Kesikli: AIC yapısı, yay sayısı | 5 | 5 | — | 0 | 1e−6 | ✓ |
| Kesikli, PC-stable: yay sayısı (gerçek 5) | 5 | 5 | — | 0 | 1e−6 | ✓ |
Ölçütü karşılayan: 54/54. Bağımsız Python: kendi tepe tırmanma (BIC, BDe, AIC; 60 rastgele yeniden başlatma), EKK, çok değişkenli normal koşullandırması, sayımla kesin çıkarım. Bağımsız R: lm, table, açık formül; bnlearn yalnız score() ile çapraz kontrol. BDe puanı (iss = 1) şablonun çıktısında yoktur; bağımsız Python ve bnlearn score(type = bde) -24028{,}09477835 ile aynıdır.
Ek denetimler: Gauss ağında tabu, PC-stable, MMHC ve bootstrap ortalama ağı tepe tırmanmayla aynı iskeleti verir; AIC dokuz yay verir ve bağımsız aramayla aynıdır. eksik.csv (600 gözlem, 40 satırda eksik değer) için şablon 560 gözlem kullanır ve "40 satır atıldı" notunu yazar.
156.7 Çıktıyı okuma
Örnek ayarın konsol satırları ve tabloları (p1_ba_ornek):
n = 5000, düğüm = 7; ağ türü: Gauss; algoritma: hc; puan: bic-g
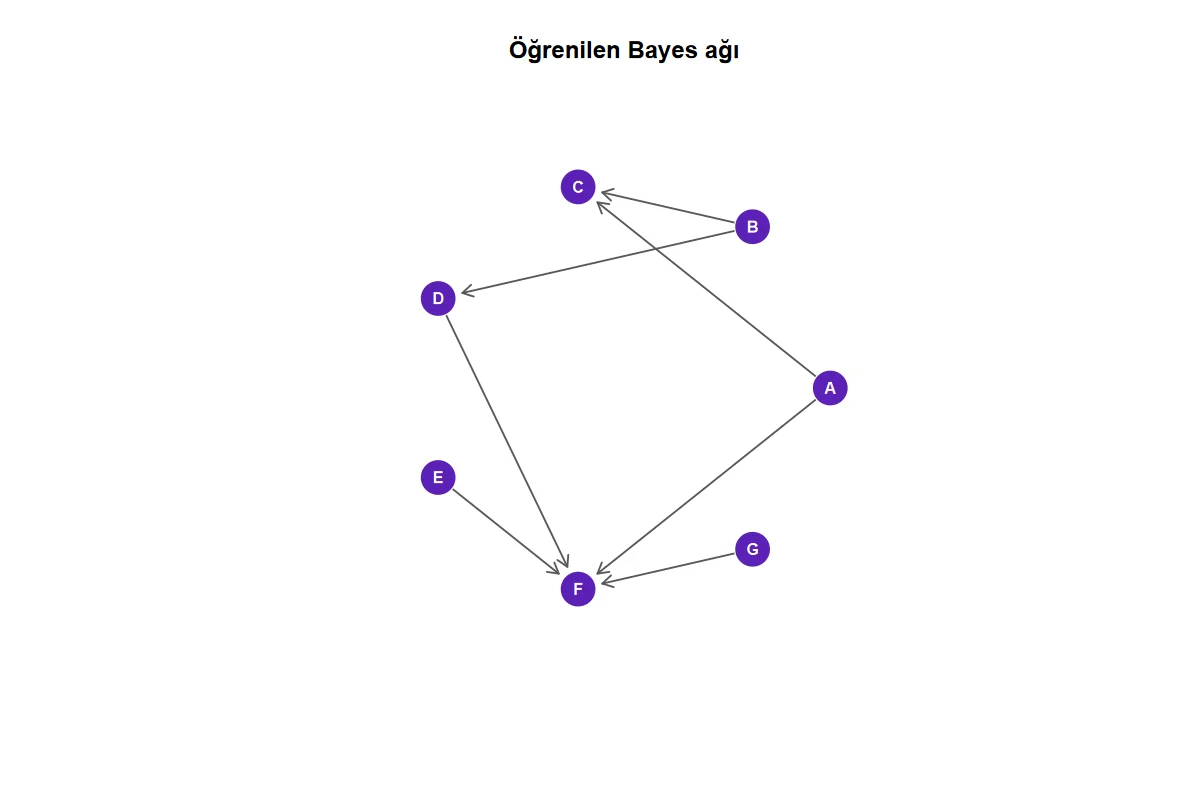
Model dizgesi: [A][B][E][G][C|A:B][D|B][F|A:D:E:G]

Öğrenilen yaylar
kaynak hedef
B      D
B      C
A      C
G      F
E      F
A      F
D      F

Ağ özeti
olcut                                deger
düğüm                                7
yay                                  7
parametre sayısı                     21
log-olabilirlik                      -53131.91726
BIC (log-olabilirlik − k/2·log n)    -53221.34779
ortalama Markov örtüsü boyu          4

Düğüm parametreleri (kısaltılmış)
dugum terim      katsayi      artik_sd
A     (kesişim)   1.00749343   1.00423286
C     A           1.99590141   0.50897720
C     B           1.99910773   0.50897720
D     B           1.49839537   0.32866716
F     A           1.99485304   0.99614749
F     D           1.00563691   0.99614749
F     E           1.00257700   0.99614749
F     G           1.49437327   0.99614749

Koşullu dağılım (çok değişkenli normal, kesin)
hedef kanit           kosullu_ortalama kosullu_sd  GA_alt     GA_ust
F     A = 1.5; D = 9  23.05369659      3.70934908  15.78350598 30.32388721
Şekil 156.1. Şablonun çizdiği ağ (örnek veri): düğümler çembere değişken sırasıyla yerleşir; oklar B\to C, B\to D, A\to C, A\to F, D\to F, E\to F, G\to F yaylarıdır.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
Model dizgesi |
Ağı [düğüm\|ebeveynler] biçiminde yazar. |
[C\mid A{:}B]: C'nin ebeveynleri A ve B. Ebeveyni olmayan düğümler yalnız köşeli parantez içindedir. |
| Öğrenilen yaylar | Yönlü yaylar; bootstrap açıksa guc ve yon_olasiligi. |
guc yayın yönüne bakmadan görülme oranıdır; yon_olasiligi 0,45–0,55 ise yay not edilir: yön veriden belirlenemiyor demektir (156.8). |
| Ağ özeti | Düğüm, yay, parametre sayısı, log-olabilirlik, BIC, ortalama Markov örtüsü boyu. | BIC'te büyük değer iyidir; aynı veride farklı yapıları bu sayıyla karşılaştırın. |
| Düğüm parametreleri (Gauss) | Her düğümün kesişim, eğim ve artık sd'si. | F=-0{,}006+1{,}995A+1{,}006D+1{,}003E+1{,}494G+\varepsilon, \hat\sigma_F=0{,}996. |
| Düğümler ve ebeveynleri (kesikli ya da karışık) | Her düğümün ebeveynleri ve parametre sayısı. | Parametre sayısı CPT ya da regresyon sayısına göredir (156.4.1). |
| Koşullu dağılım | Gauss ağda ortalama, sd ve aralık; kesikli ağda düzey olasılıkları; karışıkta sayısal hedefte ağırlıklı ortalama ve sd. | Kanıt altında hedefin dağılımıdır; nedensel müdahale değil, gözlemsel koşullandırmadır. |
Kesikli çıktı (kesikli, tohum 1; hedef = D, kanit = "A=a; C=b"):
n = 5000, düğüm = 6; ağ türü: kesikli; algoritma: hc; puan: bic
Model dizgesi: [A][C][F][B|A][D|A:C][E|B:F]

olcut                             deger
parametre sayısı                  41
log-olabilirlik                   -23832.13177
BIC (log-olabilirlik − k/2·log n) -24006.73423

hedef duzey olasilik
D     a     0.18135
D     b     0.13343
D     c     0.68522
Karışık ağ (karisik; A, B, C, F sayısal, Dk, Gk kategorik; n = 800): ağ türü "koşullu Gauss", model dizgesi [A][Dk][Gk][B|Dk][C|A:B][F|A:C:Gk], 25 parametre; F, Dk = yuksek ve A = 1 kanıtı altında ağırlıklı ortalama 25,406, sd 4,673 olur.
Rapor cümlesi (örnek ayar): "Yedi sayısal değişken (n=5000) için puan tabanlı tepe tırmanma ve BIC ile yedi yaylı bir Gauss Bayes ağı öğrenilmiştir (bnlearn 5.2.1); F düğümünün ebeveynleri A, D, E ve G'dir. A=1{,}5 ve D=9 kanıtı altında F'nin koşullu dağılımı normaldir (ortalama 23{,}05, sd 3{,}71; %95 aralık 15{,}78–30{,}32). Yön, aynı koşullu bağımsızlıkları kodlayan denk yapılar içinde veriden belirlenemez."
156.8 Sık hatalar ve tuzaklar
- Yönleri nedensel okumak. Yapı öğrenme yalnız koşullu bağımsızlık yapısını bulur. A\to B ile B\to A aynı puanı alır; yalnız v-yapıları (A\to C\leftarrow B) yönü belirler. Örnek veride B–D yönü böyledir: şablon B\to D verir, bağımsız aramam D\to B bulur (puan aynı).
hcvetabubu belirsizliği kendiliğinden bildirmez; bootstrap açıksayon_olasiligi0,45–0,55 olan yaylar çıktıda not edilir (kesikli örnekte A\to B: 0,5000). - 0/1 sayısal sütun Gauss düğümdür. Veri sekmesi 0/1 sütunu "ikili" sayar ama sayı olarak bırakırsa şablon onu sürekli kabul eder ve koşullu dağılımın aralığı [0;1] dışına taşabilir (
ikili_num: Y\mid A=1 için ortalama 0,501, aralık [-0{,}461;\ 1{,}463]). Şablon bu durumda çıktıya "Gauss düğümü olarak ele alınıyor" notu düşer. Olasılık istiyorsanız sütunun türünü Veri sekmesinde "kategorik" yapın ya da "İki değerli sayısal sütunlar" alanındakategorikseçin (ikili_kat: P(Y=0)=0{,}492). - Eksik değerli satırlar atılır. Atılan satır sayısı, değişken başına eksik sayısı ve satırların %10'u aşılırsa uyarı çıktıya yazılır; yine de eksik değerin rastgele olup olmadığını ayrıca düşünün.
- Birebir aynı ya da tam doğrusal bağımlı sütunlar. Çalıştırma "birbirinin doğrusal işlevi" iletisiyle durur (
ozdes:AveA2); sütunlardan birini çıkarın. Üç ya da daha çok sütunun doğrusal birleşimi (yalnız çiftler değil) denetlenmez. - Yakınsama ve sınırlar.
en_cok_yinelemeküçükse arama yarım kalmış bir ağ döndürür; şablon sınırda durup durmadığını bir yineleme fazlasıyla yeniden arayarak denetler ve uyarı yazar (en_cok_yineleme = 2: iki yaylı ağ ve uyarı).en_cok_ebeveynsınırına ulaşan düğümler "sınır sonucu kısıtlamış olabilir" notuyla sayılır. Denetim yalnızhc(yeniden başlatmasız) vetabuiçin yapılır. - Düzey sırası. Etken sütunda Veri sekmesinin sırası, metin sütunda tüm etiketler sayıysa sayısal sıra (1, 2, 10), değilse harf sırası kullanılır; sonuçların değil, tablo satırlarının sırasını etkiler.
- Sütun adları. Boşluklu ya da özel karakterli adlar R adına çevrilir (
alan ha→alan.ha) ama tablolarda özgün adla görünür; kanıt ve yay listelerinde özgün ad yazılır (adli:alan ha=1). - Ondalık virgül.
A=1,5hata verir ("'A' için sayı gerekli (ondalık ayırıcı nokta olmalıdır, ör. 1.5)"); nokta kullanın. Yay ve kanıt listelerinde ayırıcı;dir. - Kanıtta tekrar. Aynı değişken iki kez yazılırsa çalıştırma "birden çok kez verilmiş" iletisiyle durur.
- bnlearn iletileri çevrilmez. "all weights are zero, the evidence has probability zero" (olanaksız kanıt) gibi iletiler İngilizce kalır; şablon bunları "(bnlearn iletisi, İngilizce)" ön ekiyle verir.
- Bootstrap süresi ve tohum. Süre yineleme sayısıyla doğrusal artar; yön olasılığı ve güç tohuma bağlıdır (tohum 1 ve 2'de A\to D yön olasılığı 0,8375 ve 0,7875).
- BDe yalnız kesikli ağda. Karışık ağda BDe seçilirse şablon durur.
156.9 Uzman soruları
S1. Gauss ağında log-olabilirlik neden en çok olabilirlik değeri değil?
bn.fit Gauss düğümlerinin artık varyansını \mathrm{SSE}/(n-p) ile kestirir ve logLik bu varyansla hesaplanır; en çok olabilirlik \mathrm{SSE}/n verirdi. Örnek veride fark 0{,}0021'dir ve yapı seçimini etkilemez. Şablonun yazdığı BIC bnlearn tanımıdır (\ell-\tfrac k2\ln n); ML tanımıyla -53221{,}3457 yerine -53221{,}3478 görünür (156.6).
S2. BIC ile AIC aynı veride neden farklı yapı verir?
AIC parametre başına 1, BIC \tfrac12\ln n=4{,}26 (n=5000) ceza koyar. AIC daha zayıf ceza verdiğinden gerçek ağa iki yay ekler (aic: toplam dokuz yay; A–B ve C–F gereksizdir); BIC yedi yaylı gerçek yapıyı bulur. Büyük örneklemde BIC tutarlıdır, AIC aşırı uyum eğilimindedir.
S3. PC-stable ile hc aynı iskeleti bulduğunda yönler neden farklı olabilir?
İkisi de iskelet ve v-yapılarını doğru bulur; geriye kalan yaylar denk sınıftadır. PC-stable bunları yönsüz bırakır ve cextend rastgele olmayan ama keyfi bir uzantı seçer (286–289); hc arama sırasının uzantısını verir. Örnek veride PC-stable D\to B yönünü seçer, hc B\to D. İki ağın log-olabilirliği aynıdır (-53131{,}9173).
S4. Karışık ağda BDe neden seçilemiyor?
BDe, kesikli ağ için Dirichlet–çok terimli eşlenikliğe dayanan bir puandır (156.4.3) ve bnlearn'da yalnız kesikli ağlar için tanımlıdır. puan = bde ile kesikli olmayan bir ağ seçilirse şablon durur (237).
S5. Bootstrap `guc` değeri neden çoğu yay için 1,0000?
Güç yayın yönüne bakmadan görülme oranıdır; 5000 gözlemde güçlü ilişkiler her yeniden örneklemede bulunur. Belirsiz olan yön, yon_olasiligi sütunundadır (kesikli örnekte 0,5000–0,9500).
S6. Olabilirlik ağırlıklı örnekleme ne zaman yetersiz kalır?
Kanıt nadir bir olay ise (ağırlıkların çoğu sıfıra yakın), etkin örnek sayısı küçülür ve tahmin gürültülü olur; kanıtın olasılığı sıfırsa bnlearn "all weights are zero" hatasını verir. Bu şablonda kanıt kök düğümdeyse ağırlıklar eşittir ve hata 1/\sqrt n ile küçülür; ornek_sayisi artırılarak azaltılabilir.
S7. Gauss ağda çıkarım neden kesin, kesikli ağda neden yaklaşık?
Çok değişkenli normal dağılım koşullandırma altında kapalıdır (156.4.2); kesikli ağda kesin çıkarım ağ yapısının genişliğine üssel bağlıdır ve şablon basit bir örnekleme yöntemini seçmiştir. Örnek veride kesin sonuç (0{,}180791; 0{,}132768; 0{,}686441) ile örnekleme arasındaki en büyük fark 2\times10^{-3}'tür.
S8. Hangi tanım ya da paket farkı sonucu değiştirir?
Yapı öğrenme algoritmasının kendisi: PC-stable bağımsızlık testlerine (\alpha ve test türü), hc puana dayanır; aynı veride farklı iskelet çıkabilir. Başka bir Bayes ağı yazılımı BIC'i -2\ell+k\ln n ya da MDL tanımıyla verebilir; işaret ve kat farkı sıralamayı değil sayıyı değiştirir.
156.10 Kaynaklar
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- Glover, F. (1986). Future paths for integer programming and links to artificial intelligence. Computers & Operations Research, 13(5), 533–549. https://doi.org/10.1016/0305-0548(86)90048-1
- Heckerman, D., Geiger, D., & Chickering, D. M. (1995). Learning Bayesian networks: The combination of knowledge and statistical data. Machine Learning, 20(3), 197–243. https://doi.org/10.1007/BF00994016
- Lauritzen, S. L., & Wermuth, N. (1989). Graphical models for associations between variables, some of which are qualitative and some quantitative. The Annals of Statistics, 17(1), 31–57. https://doi.org/10.1214/aos/1176347003
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2. baskı). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
- Scutari, M. (2010). Learning Bayesian networks with the bnlearn R package. Journal of Statistical Software, 35(3), 1–22. https://doi.org/10.18637/jss.v035.i03
- Scutari, M., & Denis, J.-B. (2021). Bayesian networks: With examples in R (2. baskı). Chapman and Hall/CRC. https://doi.org/10.1201/9780429347436
- Scutari, M., Vitolo, C., & Tucker, A. (2019). Learning Bayesian networks from big data with greedy search: Computational complexity and efficient implementation. Statistics and Computing, 29(5), 1095–1108. https://doi.org/10.1007/s11222-019-09857-1
- Tsamardinos, I., Brown, L. E., & Aliferis, C. F. (2006). The max-min hill-climbing Bayesian network structure learning algorithm. Machine Learning, 65(1), 31–78. https://doi.org/10.1007/s10994-006-6889-7