174. Çok boyutlu MTK ve bifaktör modeli
Şablon kimliği: mirt_cok_boyutlu · Kategori: psikometri · Dil: R · Dosya: pro/sablonlar/psikometri/mirt_cok_boyutlu.R (satır 1–228; üstbilgi 1–109) · Örnek veri: _ornek/lsat7.csv · Paketler: mirt 1.47 (R 4.5.3)
174.1 Ne işe yarar
Test maddelerine verilen yanıtlar tek bir gizil yetenekle açıklanamıyorsa, maddelerin birkaç gizil boyuta nasıl yüklendiğini kestirmek gerekir. Şablon şu soruyu cevaplar: "Bu maddeler kaç boyutu ölçüyor, maddeler hangi boyuta yükleniyor ve genel bir yeteneğin yanında alt testlere özgü ikinci düzey boyutlar var mı?" Üç model sunar: açımlayıcı (kendiliğinden belirlenen k faktör, döndürmeli), doğrulayıcı (madde grupları ilişkili faktörlere atanır) ve bifaktör (her madde genel faktöre ve en çok bir özel faktöre yüklenir; faktörler dik). Tam bilgi marjinal en çok olabilirlik (Bock ve Aitkin, 1981) kullanılır; ikili maddelerde iki parametreli lojistik (2PL), çok kategorili maddelerde aşamalı tepki modeli (Samejima, 1969) uydurulur.
Ne zaman kullanılır?
- Ölçeğin boyut sayısı ve madde–boyut ilişkisi sorgulanıyorsa; ikili ya da sıralı maddelerle.
- Alt testlerin (okuma parçası, ortak yönerge) yerel bağımlılık yarattığından kuşku duyulan bir testte genel faktör gücünü ve özel faktör payını ayırmak için (bifaktör; ECV).
- Çok boyutlu ve tek boyutlu modelleri olabilirlik oranıyla karşılaştırmak için.
Ne zaman kullanılmaz?
- Tek boyutlu bir ölçeğin madde parametreleri isteniyorsa: tek faktörlü açımlayıcı model aynı sonucu verir (174.7); ancak parametrik olmayan bir ölçeklenebilirlik sorusu için bu kitabın
mokkenşablonu (Bölüm 175) uygundur. - İki test formunu ortak ölçeğe taşımak için:
irt_baglamaşablonu (Bölüm 173). - Bir madde 10'dan çok kategori içeriyorsa ya da yanıtlar sürekliyse: şablon durur (174.2); sürekli göstergeler için temel programdaki faktör analizi kullanılır.
- Standart hata ya da güven aralığı isteniyorsa: şablon
SE = FALSEile uydurur (açımlayıcı ve doğrulayıcı), standart hata vermez.
Temel programla ilişki. Temel programdaki faktör analizi sürekli göstergeler için çizgisel modeli kullanır; bu şablon ikili ve sıralı maddelerin olasılıksal modelini uydurur ve kareleme üzerinden bütün yanıt örüntülerini kullanır.
174.2 Şablonun girdileri
Alanlar üstbilgideki [[param]] bloklarından gelir. Türlerin anlamı ve formun denetimi Bölüm 1.2'de anlatılmıştır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Maddeler · maddeler |
sütunlar (sayısal, en az 4) · Değişkenler | — | sayısal sütunlar | Analize giren maddeler (114, 10–16). |
Model türü · tur |
seçim · Model | kesifsel |
kesifsel, dogrulayici, bifaktor |
Modelin kurulumu (162–175, 17–23). |
Faktör sayısı · nfact |
tamsayı · Model | 2 | 1–5 | Yalnız açımlayıcı model (163, 24–31). |
Döndürme · rotasyon |
seçim · Seçenekler | oblimin |
oblimin, geominQ, varimax |
Yalnız açımlayıcı ve k>1 (196, 32–38). |
Faktör/özel faktör 1, 2, 3 maddeleri · grup1, grup2, grup3 |
sütunlar (sayısal) · Değişkenler | boş | maddeler içinden |
Doğrulayıcı: faktörler; bifaktör: özel faktörler (139–141, 39–59). |
Madde modeli · madde_modeli |
seçim · Model | otomatik |
otomatik, Rasch, gpcm |
itemtype (134–137, 60–66). |
Sabit alt asimptot · tahmin |
ondalık · Model | 0 | 0–0,5 | 0/1 maddelerde sabit şans (138, 67–74). |
Kestirim algoritması · kestirim_yontemi |
seçim · Model | EM |
EM, QMCEM, MHRM |
Açımlayıcı ve doğrulayıcıda (161, 75–82). |
Boyut başına kuadratür · kuadratur |
tamsayı · Gelişmiş | 0 | 0–201 | 0: paketin varsayılanı (159, 83–91). |
En çok yineleme · en_cok_yineleme |
tamsayı · Gelişmiş | 0 | 0–100000 | 0: EM'de 500 döngü (160, 92–100). |
Yakınsama toleransı · tolerans |
ondalık · Gelişmiş | 10^{-6} | 10^{-10}–10^{-2} | TOL (158, 101–108). |
Şablona özgü denetimler, hepsi mq_hata ile çalışmayı durdurur:
- Veri açık değilse "Önce Veri sekmesinde bir veri açın." (113); seçilen (tekrarsız) madde sayısı 4'ten azsa "En az 4 madde seçin." (115).
- En az bir madde yanıtı olan satırlar kalır (118); sayıları 50'den azsa "En az 50 yanıtlayıcı gerekli." (120).
- Her maddede negatif ya da tamsayı olmayan değer varsa "'…' negatif olmayan tamsayı kodlu olmalı." (123); tek kategorili madde "'…' tek kategorili; çıkarın." (124); 10'dan çok kategori "'…' 10'dan çok kategori içeriyor." (125).
- Doğrulayıcı ve bifaktörde en az iki grup tanımlanmalı (143); bir madde birden çok grupta olamaz (144); doğrulayıcıda her madde bir gruba atanmalı (145) ve her faktörde en az 2 madde olmalı (146); bifaktörde her özel faktörde en az 2 madde olmalı (147).
Raschmadde modeli açımlayıcı çok boyutlu modelde (k>1) tanımsızdır (149); k\ge madde sayısı -1 ise "Faktör sayısı madde sayısına göre çok yüksek." (150).- Model kurulamazsa "Model kurulamadı: …" ve paketin iletisi (155).
Örnek ayar varsayılandan şu noktalarda ayrılır: maddeler = madde1…madde5, tur = kesifsel, nfact = 2, en_cok_yineleme = 5000 (varsayılan 0).
174.3 Örnek veri
lsat7.csv, Bock ve Lieberman (1970) LSAT bölüm 7 verisidir: 1000 öğrenci, 5 ikili madde (0 = yanlış, 1 = doğru), eksik yanıt yok. Aynı veri Chalmers (2012) mirt makalesinin ana örneğidir. Veri sekmesi beş sütunu "ikili" (binary) olarak algılar.
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
madde1…madde5 |
madde | ikili | Doğru yanıt oranları: 0,828; 0,658; 0,772; 0,606; 0,843 |
Kategorik değişken yoktur; düzey sırası konusu çıkmaz. Ancak "sayısal sütunlar" rolü sayı aktarır (Bölüm 1.3): madde sütunu "kategorik" yapılsa da 0/1 değerleri korunur.
Bölümde kullanılan çalıştırmalar:
- Örnek ayar: açımlayıcı, 2 faktör, oblimin,
en_cok_yineleme= 5000. - Aynı veri, 1 faktör.
- Sentetik aşamalı veri (
dogrulama/mirt_cok_boyutlu/asamali6.csv; n=1000, 6 madde, 4 kategori, iki ilişkili faktör, gerçek korelasyon 0,5): doğrulayıcı model, ilk üç madde faktör 1, son üç madde faktör 2. - Sentetik bifaktör veri (
bifaktor9.csv; n=1200, 9 ikili madde, 3 özel faktör): bifaktör modeli. - Kenar durumlar: 1/2 kodlu ikili maddeler, sabit alt asimptot, kategori boşluğu, eksik yanıt, yakınsama ve kestirim algoritması seçenekleri (174.8).
174.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) madde sütunları alınır, madde türü ve itemtype belirlenir; (2) seçilen modele göre mirt (açımlayıcı, doğrulayıcı) ya da bfactor (bifaktör) uydurulur; (3) uyum ölçütleri ve M_2 yazılır; (4) madde parametreleri ve standartlaştırılmış yükler yazılır; (5) çok boyutluysa tek boyutlu modelle olabilirlik oranı testi yapılır; (6) yük ısı haritası çizilir.
174.4.1 Madde modelleri
İki kategorili madde (y=0{,}1) için, \boldsymbol\theta m boyutlu gizil vektör, paketin eğim–kesişim biçimiyle
- \mathbf a_j: j. maddenin eğim (ayırt edicilik) vektörü; faktör sayısı kadar eleman.
- d_j: kesişim (kolaylık); güçlük b_j=-d_j/a_j (tek boyutta).
- c_j: sabit alt asimptot (şans);
tahmin> 0 ise 0/1 maddelerde bu değere sabitlenir, aksi hâlde 0.
Çok kategorili maddede (y=0,\dots,K) aşamalı tepki modeli:
- d_{j1}>d_{j2}>\dots>d_{jK}: eşik kesişimleri.
- P(y_j\ge0)=1 ve P(y_j\ge K+1)=0.
Koddaki tercih
madde_modeli = otomatik: 0/1 maddeler 2PL, diğerleri graded (134–135). Rasch: tüm maddeler Rasch (ikili: tek parametreli, çok kategorili: kısmi puan; eğimler sabit 1). gpcm: ikili 2PL, diğerleri genelleştirilmiş kısmi puan (136–137). Madde "ikili" yalnız değerleri \{0{,}1\} (ve eksik) ise sayılır (133); 1/2 kodlu iki kategorili bir madde graded olur ve tahmin bu madde için hiçbir etki yapmaz (174.8).
174.4.2 Marjinal olabilirlik ve kareleme
Yanıt örüntülerine göre log marjinal olabilirlik
- r: farklı yanıt örüntüsü; n_r: örüntüsü gözlenen kişi sayısı.
- \phi_m(\cdot;\boldsymbol\Sigma): m boyutlu normal yoğunluk; açımlayıcı ve bifaktörde \boldsymbol\Sigma=\mathbf I, doğrulayıcıda faktör korelasyonu serbest kestirilen korelasyon matrisi.
- Eksik yanıtlı maddeler örüntü olasılığına girmez.
Tümlev sabit, eşit aralıklı düğümlerle hesaplanır: boyut başına q nokta, \theta\in[-6{,}6], ağırlıklar normal yoğunluk ve toplamı 1'e normlanır (1 boyutta q=61, 2 boyutta 31, 3'te 15; kuadratur > 0 ise bu değer). Bağımsız hesapta bu düğümlerle şablonun bildirdiği parametrelerde log olabilirlik 10^{-9} içinde yeniden üretilmiştir (174.6). Kestirim EM algoritmasıdır (Bock ve Aitkin, 1981); toleransın TOL olarak verilmesi parametre değişimi ölçütüne karşılık gelir.
Koddaki tercih
Açımlayıcı ve doğrulayıcı model mirt(…, SE = FALSE); standart hata hesaplanmaz. Bifaktör bfactor(…) ile boyut indirgemeli EM'dir ve kestirim_yontemi seçeneğini kullanmaz (174). kuadratur > 0 ise bifaktörde de kullanılır (159).
174.4.3 Bifaktör ve boyut indirgeme
Bifaktör modelinde her madde genel faktör \theta_g ve ait olduğu özel faktör \theta_s üzerinden yüklenir; maddeler özel faktörler verildiğinde koşullu bağımsızdır, bu yüzden m=1+S boyutlu tümlev iki boyutlu tümlevler çarpımına iner (Gibbons ve Hedeker, 1992):
- S: özel faktör sayısı (en çok 3); özel faktörlerin her biri yalnız kendi gruplarındaki maddeleri yükler.
- Bir gruba atanmayan madde yalnız genel faktöre yüklenir (
NAgrup, 163–164).
Genel faktörün gücü açıklanan ortak varyans (ECV) ile özetlenir (Reise, 2012; Rodriguez ve ark., 2016):
- \lambda_{jG}: j. maddenin genel faktördeki standartlaştırılmış yükü.
- \lambda_{jS(j)}: aynı maddenin özel faktördeki yükü.
Koddaki tercih
ecv <- sum(L[, 1]^2) / sum(L^2) (204); L yük tablosudur ve ilk sütun genel faktördür. Çıktıda 4 ondalıkla yazılır.
174.4.4 Standartlaştırılmış yükler ve döndürme
Şablonun yük tablosu summary() çıktısıdır. Normal ojive metriğine çevrilmiş standartlaştırılmış yük
- 1{,}702: lojistik ile normal ojive arasındaki ölçek sabiti.
- h_j^2: ortaklık; faktörler ilişkiliyse h_j^2=\boldsymbol\lambda_j^{\top}\boldsymbol\Phi\boldsymbol\lambda_j.
Bağımsız hesapta 1{,}702'li bu bağıntı 5 maddelik tek faktörlü modelde ve diğer üç modelde şablonun yük ve h^2 değerlerini 10^{-6} içinde yeniden üretmiştir (174.6.1).
Açımlayıcı modelde (k>1) yükler seçilen ölçütle döndürülür: oblimin (eğik; \gamma=0; Browne, 2001), geomin (eğik) ya da varimax (dik); tek faktörlü modelde döndürme yoktur (196). Faktör korelasyonları döndürme sonrası yazılır.
Madde parametreleri döndürülmemiştir, yükler döndürülmüştür
Madde parametreleri tablosu coef() çıktısıdır: açımlayıcı modelde döndürülmemiş eğimlerdir ve işaretleri keyfidir (örnek veride madde1 için a_1=-2{,}054, a_2=0{,}918). Yük tablosu ise seçilen döndürmeyle verilir (madde1: 0{,}802 ve -0{,}011). İki tabloyu doğrudan karşılaştırmayın.
174.4.5 Uyum ölçütleri ve olabilirlik oranı
- k: kestirilen parametre sayısı (
nest). - n: yanıtlayıcı sayısı.
Tek boyutlu modele göre olabilirlik oranı: \chi^2=2(\ell_{m}-\ell_1), sd=k_m-k_1, p=\Pr(\chi^2_{sd}\ge\chi^2) (207–216). Tek boyutlu model aynı itemtype ve guess ile EM uydurulur. M_2 (Maydeu-Olivares ve Joe, 2006) sınırlı bilgi uyum istatistiği ve RMSEA, hesaplanabilirse M2() ile eklenir; hesaplanamazsa satırlar sessizce yazılmaz (174.8).
174.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 110–118 | Çevirici, mirt'i yükler; veri ve madde sayısı; en az bir yanıtlı satırlar; n\ge50 | Tüm maddesi boş satırlar atılır ve sayısı not edilir; n konsol başlığında görünür. |
| 119–125 | Her madde için tamsayı, negatif olmama, kategori sayısı denetimi; ikili bayrağı |
Yalnız 0/1 kodlu madde ikilidir. |
| 126–133 | itemtype, sabit şans, grupların maddeler ile kesişimi |
Grup dışı madde adları sessizce yok sayılır. |
| 134–142 | Doğrulayıcı/bifaktör grup denetimleri; Rasch ve faktör sayısı denetimi | Doğrulayıcıda tüm maddeler atanmalıdır; bifaktörde atanmayan madde yalnız genel faktöre yüklenir. |
| 143–153 | Madde adları i1…'e çevrilir; TOL, kuadratür, NCYCLES; yöntem |
kestirim_yontemi EM dışındaysa method verilir. |
| 154–167 | Üç model dalı: mirt (keşifsel, nf faktör), mirt + mirt.model (doğrulayıcı), bfactor |
Doğrulayıcıda COV = F1*F2*… ile faktörler ilişkilendirilir. |
| 168–170 | Yakınsama denetimi ve başlık satırı | Yakınsama olmazsa konsola uyarı yazılır; hesap yine tamamlanır. |
| 172–178 | Uyum tablosu: log olabilirlik, AIC, BIC, SABIC, parametre sayısı, M_2 | M2 hata verirse tablo bu satırlar olmadan kalır ve gerekçe yazılır. |
| 180–182 | Madde parametreleri (coef(simplify = TRUE)) |
Döndürülmemiş, lojistik ölçek. |
| 184–190 | Yük tablosu ve faktör korelasyonları | Döndürme yalnız açımlayıcıda. |
| 191–194 | ECV (yalnız bifaktör) | Genel faktör ilk sütun. |
| 195–206 | Tek boyutlu karşılaştırma ve olabilirlik oranı | Kestirim yöntemi EM'dir (ek_m kullanılmaz); p asimptotik. |
| 207–215 | Kestirim uyarıları, yük ısı haritası | Uyarılar tek satırda İngilizce görünür. |
174.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/mirt_cok_boyutlu/elle_hesap.py (numpy, scipy; mirt ve şablon kullanılmadan) ve dogrulama/mirt_cok_boyutlu/r_dogrulama.R (taban R; mirt yok) ile hesaplanmıştır. Girdi: şablonun bildirdiği madde parametreleri ve veri.
Adım 1 — Log olabilirlik (tek faktör). 61 düğüm (\theta\in[-6{,}6]), normal ağırlık; 32 farklı yanıt örüntüsü üzerinden: \ell=-2658{,}805114 (şablon -2658{,}805114). k=10: AIC =5337{,}610227, BIC =5386{,}687780 (\ln1000), SABIC =5354{,}927222 (\ln(1002/24)).
Adım 2 — Yükler. \lambda=a/\sqrt{1{,}702^2+a^2}: madde1 için 0{,}98755/\sqrt{2{,}896804+0{,}975250}=0{,}50187 ve h^2=0{,}25187; madde3 0{,}70824.
Adım 3 — Sıfırdan yeniden kestirim. Marjinal olabilirlik 10 parametre üzerinde L-BFGS-B ile (Python) ve BFGS ile (R) tepe noktasına kadar en büyüklenir: \ell=-2658{,}805114 ve \hat a=(0{,}98755;\ 1{,}08084;\ 1{,}70746;\ 0{,}76499;\ 0{,}73567), \hat d=(1{,}85586;\ 0{,}80797;\ 1{,}80520;\ 0{,}48600;\ 1{,}85446). Şablonla fark 10^{-5} düzeyindedir (EM durdurma ölçütü).
Adım 4 — İki faktör, kareleme 31×31. k=5\cdot3-1=14; \ell=-2653{,}517970, AIC =5335{,}035940. Bağımsız oblimin (gradyan izdüşümü, gradyan normu 10^{-8}) döndürülmüş yükleri 10^{-5} içinde yeniden üretir; h^2=\mathrm{diag}(\boldsymbol\Lambda\boldsymbol\Phi\boldsymbol\Lambda^{\top}) döndürmeden bağımsız ve şablonla aynıdır. Olabilirlik oranı: \chi^2=2(-2653{,}517970+2658{,}805114)=10{,}574287, sd=14-10=4, p=0{,}031789.
Adım 5 — Doğrulayıcı aşamalı model. İki faktör arasındaki korelasyon 0,540731 olan ikili normal ağırlıkla 31×31 kareleme: \ell=-7649{,}174650 (şablon -7649{,}174650); k=6+18+1=25.
Adım 6 — Bifaktör. Üç iç ve bir dış tümlev (31 nokta) ile boyut indirgemeli olabilirlik: \ell=-6523{,}699006; k=27 (9 genel + 9 özel eğim + 9 kesişim). ECV =\sum\lambda_G^2/\sum\lambda^2=0{,}682873 (şablon 0,6829).
174.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| LSAT7 tek faktör: log olabilirlik | −2658,80511363 | −2658,80511363 | −2658,80511363 | 1,4e−15 | ✓ |
| LSAT7 tek faktör: AIC | 5337,61022727 | 5337,61022727 | — | 5,1e−16 | ✓ |
| LSAT7 tek faktör: BIC | 5386,68778006 | 5386,68778006 | — | 6,8e−16 | ✓ |
| LSAT7 tek faktör: SABIC | 5354,92722178 | 5354,92722178 | — | 1,7e−16 | ✓ |
| LSAT7 tek faktör: parametre sayısı | 10 | 10 | — | 0 | ✓ |
| LSAT7 tek faktör: standartlaştırılmış yük (5 madde) | 0,50186617 … 0,39676298 | 0,50186617 … 0,39676298 | — | 2,0e−15 | ✓ |
| LSAT7 tek faktör: h² (5 madde) | 0,25186966 … 0,15742086 | 0,25186966 … 0,15742086 | — | 1,6e−15 | ✓ |
| LSAT7 tek faktör: sıfırdan yeniden kestirim, log olabilirlik | −2658,80511363 | −2658,80511363 | −2658,80511363 | 4,6e−13 | ✓ |
| LSAT7 tek faktör: sıfırdan yeniden kestirim, eğim a (5 madde) | 0,98754944 … 0,73567389 | 0,98754527 … 0,73567199 | 0,98754607 … 0,73567278 | 9,7e−6 | ✗ |
| LSAT7 tek faktör: sıfırdan yeniden kestirim, kesişim d (5 madde) | 1,85585754 … 1,8544581 | 1,85585575 … 1,85445716 | 1,85585583 … 1,85445773 | 5,6e−6 | ✗ |
| LSAT7 iki faktör (oblimin): log olabilirlik | −2653,51797006 | −2653,51797006 | −2653,51797006 | 1,7e−16 | ✓ |
| LSAT7 iki faktör (oblimin): AIC | 5335,03594012 | 5335,03594012 | — | 1,7e−16 | ✓ |
| LSAT7 iki faktör (oblimin): BIC | 5403,74451402 | 5403,74451402 | — | 0 | ✓ |
| LSAT7 iki faktör (oblimin): SABIC | 5359,27973244 | 5359,27973244 | — | 8,5e−16 | ✓ |
| LSAT7 iki faktör (oblimin): parametre sayısı | 14 | 14 | — | 0 | ✓ |
| LSAT7 iki faktör: h² (5 madde) | 0,63604609 … 0,16380463 | 0,63604609 … 0,16380463 | — | 5,6e−16 | ✓ |
| LSAT7 iki faktör: oblimin döndürülmüş yükler (10 değer) | 0,80227192 … 0,18023723 | 0,80227497 … 0,1802347 | — | 6,8e−6 | ✗ |
| LSAT7 iki faktör: faktör korelasyonu | 0,45320875 | 0,45321462 | — | 5,9e−6 | ✗ |
| LSAT7 iki faktör: olabilirlik oranı χ² | 10,57428715 | 10,57428715 | — | 8,6e−14 | ✓ |
| LSAT7 iki faktör: olabilirlik oranı p | 0,03178894 | 0,03178894 | 0,03178894 | 2,4e−14 | ✓ |
| Doğrulayıcı aşamalı (2 faktör): log olabilirlik | −7649,17464968 | −7649,17464968 | −7649,17464968 | 0 | ✓ |
| Doğrulayıcı aşamalı (2 faktör): AIC | 15348,34929935 | 15348,34929935 | — | 2,6e−15 | ✓ |
| Doğrulayıcı aşamalı (2 faktör): BIC | 15471,04318133 | 15471,04318133 | — | 3,5e−16 | ✓ |
| Doğrulayıcı aşamalı (2 faktör): SABIC | 15391,64178563 | 15391,64178563 | — | 2,4e−15 | ✓ |
| Doğrulayıcı aşamalı (2 faktör): parametre sayısı | 25 | 25 | — | 0 | ✓ |
| Doğrulayıcı aşamalı: standartlaştırılmış yük (12 değer) | 0,70974378 … 0,64071303 | 0,70974378 … 0,64071303 | — | 1,1e−15 | ✓ |
| Doğrulayıcı aşamalı: h² (6 madde) | 0,50373623 … 0,41051318 | 0,50373623 … 0,41051318 | — | 1,8e−15 | ✓ |
| Bifaktör (genel + 3 özel): log olabilirlik | −6523,69900602 | −6523,69900602 | −6523,69900602 | 0 | ✓ |
| Bifaktör (genel + 3 özel): AIC | 13101,39801203 | 13101,39801203 | — | 3,1e−15 | ✓ |
| Bifaktör (genel + 3 özel): BIC | 13238,8300866 | 13238,8300866 | — | 2,7e−16 | ✓ |
| Bifaktör (genel + 3 özel): SABIC | 13153,06759572 | 13153,06759572 | — | 1,2e−15 | ✓ |
| Bifaktör (genel + 3 özel): parametre sayısı | 27 | 27 | — | 0 | ✓ |
| Bifaktör: standartlaştırılmış yük (36 değer) | 0,42839933 … 0,30903341 | 0,42839933 … 0,30903341 | — | 1,3e−15 | ✓ |
| Bifaktör: h² (9 madde) | 0,43050245 … 0,50794238 | 0,43050245 … 0,50794238 | — | 1,3e−15 | ✓ |
| Bifaktör: ECV (stdout'ta 4 ondalık) | 0,6829 | 0,6829 | 0,6829 | 0 | ✓ |
| Bifaktör: sıfırdan yeniden kestirim, log olabilirlik | −6523,69900602 | −6523,69900599 | — | 3,1e−12 | ✓ |
| Bifaktör: sıfırdan yeniden kestirim, genel eğim (9 madde) | 0,96618972 … 1,55823283 | 0,9661968 … 1,55822003 | — | 1,0e−4 | ✗ |
| Bifaktör: sıfırdan yeniden kestirim, kesişim d (9 madde) | 0,34379227 … 0,47042981 | 0,34379654 … 0,47042377 | — | 4,0e−5 | ✗ |
| Bifaktör: sıfırdan yeniden kestirim, özel eğim (9 madde) | 1,1208343 … 0,74981999 | 1,12087218 … 0,74973448 | — | 1,9e−4 | ✗ |
Ölçütü karşılayan: 32/39. Vektör satırlarında ilk ve son değer gösterilir; fark tüm öğeler üzerinden en büyüğüdür. Ölçütü karşılamayan satırlar iki gruptur: (1) açımlayıcı modelin döndürülmüş yükleri ve faktör korelasyonu, döndürme algoritmasının durdurma ölçütünden (GPArotation varsayılanı 10^{-5}) gelir; bağımsız oblimin uygulaması gradyan normunu 10^{-8}'e indirir. (2) 'Sıfırdan yeniden kestirim' satırları EM algoritmasının durdurma ölçütünden (tolerans = 10^{-6}, parametre değişimi) gelir: log olabilirlik tepe noktasında yassı olduğundan 10^{-9} düzeyinde uyuşur, parametreler 10^{-4}–10^{-5} düzeyinde ayrılır.
174.7 Çıktıyı okuma
Örnek ayarın (Çalıştırma 1) konsol çıktısı:
n = 1000, madde = 5, model = kesifsel, madde modeli = 2PL
Model uyumu:
              olcut        deger
0            logLik -2653.517970
1               AIC  5335.035940
2               BIC  5403.744514
3             SABIC  5359.279732
4  parametre sayısı    14.000000
5                M2     0.620063
6             M2_sd     1.000000
7              M2_p     0.431024
8             RMSEA     0.000000
Madde parametreleri (eğim a_1,a_2; kesişim d; g: sabit alt asimptot; u: üst asimptot) ve standartlaştırılmış yükler (oblimin):
    madde        a1        a2         d  g  u
0  madde1 -2.054389  0.917574  2.695466  0  1
1  madde2 -0.846430 -0.508444  0.785540  0  1
2  madde3 -2.226493 -1.896674  2.544444  0  1
...
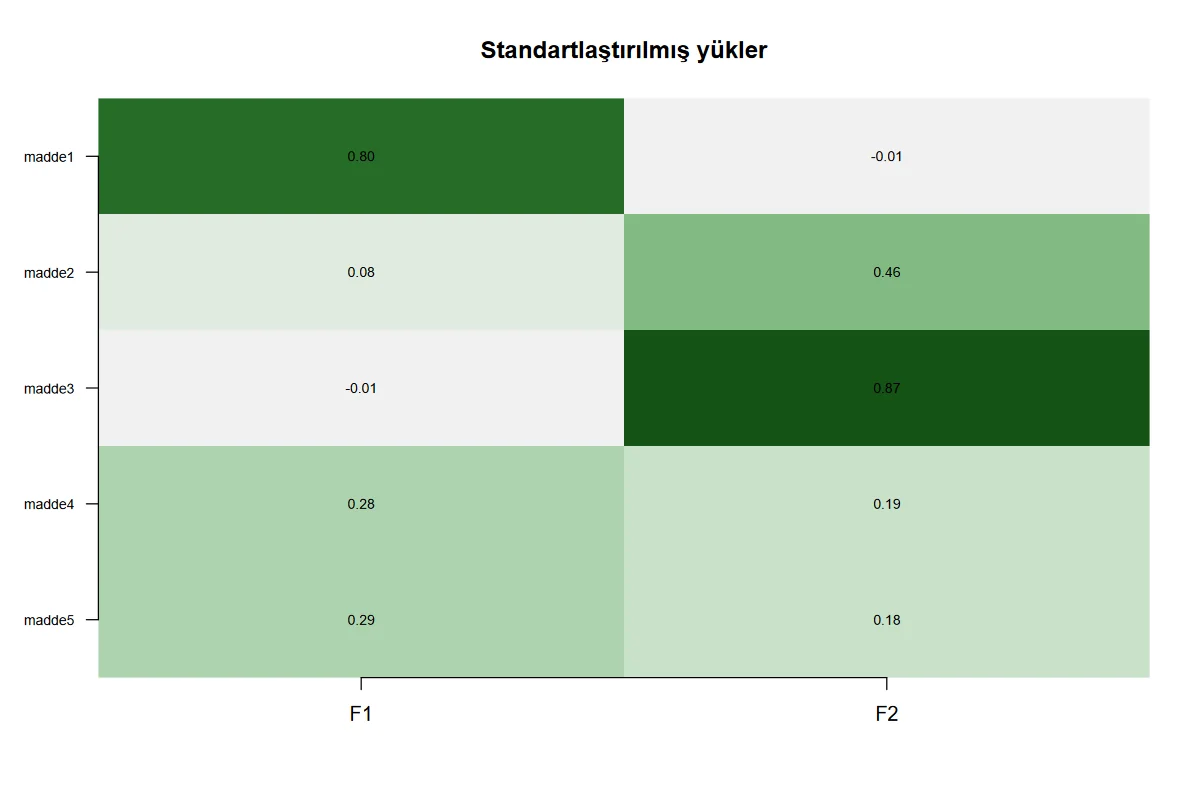
    madde        F1        F2        h2
0  madde1  0.802272 -0.010598  0.636046
1  madde2  0.084846  0.457624  0.251813
2  madde3 -0.012947  0.870103  0.747036
3  madde4  0.277235  0.193899  0.163181
4  madde5  0.289787  0.180237  0.163805
  faktor        F1        F2
0     F1  1.000000  0.453209
1     F2  0.453209  1.000000
Tek boyutlu modele göre olabilirlik oranı:
         model       logLik          AIC          BIC  LR_ki_kare   sd         p
0  Tek boyutlu -2658.805114  5337.610227  5386.687780         NaN  NaN       NaN
1     kesifsel -2653.517970  5335.035940  5403.744514   10.574287  4.0  0.031789
Şekil 174.1. Standartlaştırılmış yüklerin ısı haritası (örnek ayar: LSAT7, iki faktör, oblimin). Hücre değerleri yüklerdir; satırlar maddeler, sütunlar faktörlerdir.
Bifaktör çalıştırmasından (Çalıştırma 4) ECV satırı ve yükler:
Açıklanan ortak varyans (ECV, genel faktör) = 0.6829
  madde        G       S1       S2       S3       h2
0    b1  0.42840  0.49697  0.00000  0.00000  0.43050
1    b2  0.56764  0.32610  0.00000  0.00000  0.42855
...
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
logLik, AIC, BIC, SABIC |
Uyum ve cezalı uyum | Yalnız aynı verideki modeller karşılaştırılır; küçük AIC/BIC iyidir. |
M_2, M2_sd, M2_p, RMSEA |
Sınırlı bilgi uyum | p küçük ve RMSEA büyükse model uyumsuzdur; örnek veride iki faktörlü modelde df=1 ve uyum iyi. |
a1, a2, …, d |
Döndürülmemiş eğim ve kesişim | Lojistik ölçekte; yük değil. Eğim sıfır = madde o faktöre yüklenmiyor (doğrulayıcı ve bifaktörde kısıt). |
| Yük tablosu (F, G, S) | Standartlaştırılmış yük ve h^2 | Yük \ge0{,}3 anlamlı sayılır (ölçüt şablonda yok). Bifaktörde G genel faktördür. |
| Faktör korelasyonları | Döndürülmüş (açımlayıcı) ya da serbest (doğrulayıcı) korelasyon | Bifaktörde birim matristir (faktörler dik tanımlıdır). |
| ECV | Genel faktörün ortak varyanstaki payı | Yüksekse çok boyutluluk "küçük" bir sapmadır ve tek boyutlu model kabul edilebilir. |
| Olabilirlik oranı | Tek boyutlu modele göre | Küçük p çok boyutlu modeli destekler; p asimptotiktir. |
Rapor cümlesi: LSAT7'nin beş maddesi (n = 1000) için iki faktörlü açımlayıcı model (oblimin) tek boyutlu modele göre uyumu anlamlı biçimde iyileştirmiştir (\chi^2(4)=10{,}57, p=0{,}032; AIC 5335,04 ve 5337,61), ancak BIC tek boyutlu modeli seçer (5386,69 ve 5403,74). Faktörler arası korelasyon 0,453'tür.
174.8 Sık hatalar ve tuzaklar
- İki kategorili maddeler 0/1'e çevrilir. Değerleri \{0{,}1\} olmayan iki kategorili madde (ör. LSAT7 1/2 kodlu) şablonca 0/1 olarak yeniden kodlanır ve çıktıya "iki kategorili (kodlar 1 ve 2); 0/1 olarak yeniden kodlandı" notu yazılır; madde ikili sayılır,
dparametresi vetahmin(sabit alt asimptot) uygulanır:tahmin= 0,2 ile log olabilirlik -2659{,}3346, g=0{,}2 (0/1 kodlu veriyle aynı). - Kategori boşluğu çalıştırmayı durdurur. Aşamalı verinin
g1maddesinde kategori 2 hiç yoksa (değerler 0, 1, 3) şablon "'g1' maddesinin kategorileri ardışık değil (olmayan kategori: 2)" iletisiyle durur; kategorileri önceden ardışık tamsayılara kodlayın. - Eksik yanıtlar tam olabilirlik içinde işlenir; tüm satırı boş olanlar atılır. Madde başına %5 rastgele eksikli bifaktör verisinde 1200 satır korunur; yalnız hiç yanıtı olmayan satırlar atılır ve çıktı "hiçbir maddeye yanıtı olmayan N satır çözümlemeden çıkarıldı" notunu yazar.
- Yakınsama durumu yazılır; sonuçlar yine de verilir. Bifaktör eksik veri örneğinde ve Rasch bifaktörde 500 yineleme yetmedi: konsolun başına "Uyarı: EM algoritması yakınsamadı (MHRM'de yöntem adı MHRM yazılır); sonuçları dikkatle yorumlayın." ve "EM cycles terminated after 500 iterations." satırları eklenir, tablolar yine yazılır.
en_cok_yinelemeartırılmalıdır; bu denetim EM yöntemine göre kurulmuştur (aşağıya bakın). - MHRM yakınsamazsa log olabilirlik, AIC, BIC ve olabilirlik oranı hesaplanamaz.
kestirim_yontemi = MHRMile doğrulayıcı üç faktörlü model (sentetik bifaktör verisi, n=1200, 72 s) 2000 yinelemede yakınsamayınca uyum tablosunda log olabilirlik, AIC, BIC ve SABICNaN'dır (M_2=43{,}456, sd=24 yazılır), olabilirlik oranı tablosunda daNaNvardır. Şablon "Uyarı: MHRM ile log olabilirlik, AIC, BIC ve SABIC hesaplanamadı (NaN)" ve "Uyarı: MHRM algoritması yakınsamadı" iletilerini yazar. Olabilirlik gereken karşılaştırmalar için EM kullanın ya da yineleme sayısını artırın. - Tohum MHRM sonucunu değiştirmez.
mirther uydurmada kendi tohumunu 12345'e kurar (paket kaynağımakeopts) ve şablonunset.seed(mq_tohum)çağrısı (Bölüm 1.3) bunu değiştiremez; Kestirim algoritması alanının açıklaması bunu söyler. Tohum 11 ve 22 ile aynı MHRM çalıştırması tüm parametrelerde birebir aynı çıktı verdi (en büyük fark 0). - M_2 hesaplanamazsa gerekçe yazılır. Aşamalı doğrulayıcı modelde (n=1000, 6 madde, 4 kategori) uyum tablosu yalnız log olabilirlik ve bilgi ölçütlerini içerir; M_2,
M2_sd,M2_p, RMSEA satırları yoktur ve çıktı "M2 uyum istatistiği hesaplanamadı (Statistic cannot be calculated (too few degrees of freedom))" notunu yazar. - Rasch bifaktörde eğimler sabit görünür, yükler görünmez.
madde_modeli = Raschve bifaktörde tüm eğimler 1 yazılır (a1…a4tablosu), ancak yük tablosu özel faktör varyanslarının kestirimini yansıtır (örnekte genel yük 0,542–0,582, özel yük 0,283–0,449). Parametre tablosu ile yük tablosu doğrudan karşılaştırılamaz. - Açımlayıcı modelde madde parametreleri döndürülmemiştir (174.4.4); işaretler keyfidir.
- Faktör sayısı ve kimliklendirme. 5 maddelik veride 2 faktörlü açımlayıcı model yalnız df=1 ile M_2 verir ve olabilirlik oranı testi sd=4'tür; böyle az maddeyle iki faktör zorlanmaktadır. Şablon k\ge madde sayısı -1 iken durur (150).
- Sütun türü ve ondalık virgül. Madde sütunları sayısal rolde olduğundan veri sekmesinde "kategorik" olsalar da sayı olarak aktarılır; ondalık virgüllü kodlama gerekmez.
174.9 Uzman soruları
S1. Eğim–kesişim ile klasik a–b parametreleri arasındaki ilişki nedir ve neden 1{,}702?
Eğim–kesişim biçiminde a_j\theta+d_j doğrusaldır; klasik güçlük b_j=-d_j/a_j'dir (tek boyutta). Standartlaştırılmış yükte 1{,}702 lojistik metriği normal ojive metriğine çevirir: \lambda=a/\sqrt{1{,}702^2+a^2} (D=1{,}702 ile \mathrm{logit}\approx1{,}702\,\Phi^{-1}). Şablonun yük tablosu bu çeviriyi yapar, parametre tablosu yapmaz.
S2. Açımlayıcı çok boyutlu modelde eğimler hangi kısıtla kimliklendirilir?
Faktörler \mathbf I kovaryansla dik tutulur ve eğim matrisinde k(k-1)/2 eğim sıfıra sabitlenir (örnek veride son maddenin ikinci eğimi 0; 5\cdot3-1=14 parametre). Döndürme bu çözümün üzerine uygulanır ve olabilirliği değiştirmez. Bu yüzden döndürülmüş yük sayıları bağımsız olarak yeniden üretilirken log olabilirlik döndürmeden bağımsızdır.
S3. Bifaktörde özel faktörler neden dik ve genel faktörle ilişkisizdir?
Bu klasik bifaktör kimliklendirmesidir (Gibbons ve Hedeker, 1992): genel ve özel faktörler arasında kovaryans yoktur ve her madde en çok bir özel faktörü yükler. Bu iki kısıt olmadan model kimliklendirilemez. Doğrulayıcı modelde ise faktörler ilişkilidir ve genel faktör yoktur; ikisi farklı kuramsal yapıları temsil eder.
S4. ECV neyi söyler, neyi söylemez?
ECV genel faktörün ortak varyanstaki payıdır (örnekte 0,683). Tek başına tek boyutluluğu kanıtlamaz: Rodriguez ve ark. (2016) ECV'nin yanında madde düzeyinde ECV ve ortak varyansın benzer güvenirlik katsayılarını da önerir. Şablon yalnız toplam ECV'yi verir; ikinci derece göstergeler Kod sekmesinde yük tablosundan hesaplanabilir.
S5. Kareleme düğüm sayısı sonucu ne kadar etkiler?
Bu bölümdeki bağımsız hesapta 1 boyutta 61 nokta (\theta\in[-6{,}6]) log olabilirliği -2658{,}805114 verir; 41 nokta [-4{,}4] aralığında -2658{,}806967 (fark 1{,}9\cdot10^{-3}). İki boyutta 31 nokta [-6{,}6] ile -2653{,}517970 ve [-5{,}5] ile -2653{,}517984 bulundu. Şablonun varsayılan düğümleri yeterlidir; çok boyutta düğüm sayısı üssel büyür ve süre uzar.
S6. Olabilirlik oranı testi açımlayıcı modelde neden dikkatle yorumlanmalıdır?
Test \chi^2 dağılımını asimptotik olarak kullanır ve tek boyutlu modelle iç içe modelleri karşılaştırır; açımlayıcı çok boyutlu modelde ek kısıtlamaların sayısı sd yalnız parametre sayısı farkıdır. Örnekte \chi^2(4)=10{,}57, p=0{,}032 iken BIC tek boyutlu modeli tercih eder. Seyrek ikili veri ve az maddeyle \chi^2 yaklaşımı zayıftır; şablon bootstrap ya da düzeltmeli test sunmaz.
S7. Madde sayısı ve örneklem büyüklüğü için şablon ne denetler?
Yalnız en az 4 madde ve en az 50 yanıtlayıcı (115, 120). Bu yalnız çalıştırmayı mümkün kılar; çok boyutlu modeller için gereken büyüklük model karmaşıklığına, kategori sayısına ve yüklerin büyüklüğüne bağlıdır. Her özel faktörde en az 2 madde koşulu kimliklendirmenin asgarisidir.
S8. Başka bir yazılımla fark nerede çıkar?
Aynı model, aynı kareleme ve aynı kimliklendirmeyle log olabilirlik 10^{-9} içinde yeniden üretilir (174.6.1). Fark döndürmeden (algoritmanın durdurma ölçütü 10^{-5}), EM durdurma ölçütünden (parametrelerde 10^{-5}–10^{-4}) ve MHRM'de rastgelelikten gelir; log olabilirliği hesaplamayan MHRM sonuçları AIC ile karşılaştırılamaz.
174.10 Kaynaklar
- Bock, R. D., & Aitkin, M. (1981). Marginal maximum likelihood estimation of item parameters: Application of an EM algorithm. Psychometrika, 46(4), 443–459. https://doi.org/10.1007/BF02293801
- Bock, R. D., & Lieberman, M. (1970). Fitting a response model for n dichotomously scored items. Psychometrika, 35(2), 179–197. https://doi.org/10.1007/BF02291262
- Browne, M. W. (2001). An overview of analytic rotation in exploratory factor analysis. Multivariate Behavioral Research, 36(1), 111–150. https://doi.org/10.1207/S15327906MBR3601_05
- Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06
- Gibbons, R. D., & Hedeker, D. R. (1992). Full-information item bi-factor analysis. Psychometrika, 57(3), 423–436. https://doi.org/10.1007/BF02295430
- Maydeu-Olivares, A., & Joe, H. (2006). Limited information goodness-of-fit testing in multidimensional contingency tables. Psychometrika, 71(4), 713–732. https://doi.org/10.1007/s11336-005-1295-9
- Reise, S. P. (2012). The rediscovery of bifactor measurement models. Multivariate Behavioral Research, 47(5), 667–696. https://doi.org/10.1080/00273171.2012.715555
- Rodriguez, A., Reise, S. P., & Haviland, M. G. (2016). Evaluating bifactor models: Calculating and interpreting statistical indices. Psychological Methods, 21(2), 137–150. https://doi.org/10.1037/met0000045
- Samejima, F. (1969). Estimation of latent ability using a response pattern of graded scores. Psychometrika, 34(S1), 1–97. https://doi.org/10.1007/BF03372160
- R Core Team (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/