185. Sıralı göstergelerle DFA (WLSMV) ve kategorik ölçme değişmezliği
Şablon kimliği: sirali_cfa_wlsmv · Kategori: yapısal eşitlik ve gizil model · Dil: R · Dosya: pro/sablonlar/yem/sirali_cfa_wlsmv.R (satır 1–226; üstbilgi 1–56) · Örnek veri: _ornek/bfi_ac.csv · Paketler: lavaan 0.7-2, semTools 0.5-9 (R 4.5.3)
185.1 Ne işe yarar
Likert türü maddeler (1–5, 1–6 gibi) sürekli değil sıralı (ordinal) ölçümlerdir. Her madde, doğrudan gözlenemeyen sürekli bir gizil yanıt y^*'nin eşiklerle kesilmiş hâlidir; faktör modeli bu gizil yanıtlar üzerine kurulur. Şablon, bu modeli polikorik korelasyonlar ve eşikler üzerinden, köşegen ağırlıklı en küçük kareler ile (WLSMV; isteğe bağlı olarak ağırlıksız ULSMV) kestirir. Çıktıda ölçeklenmiş ve kaydırılmış ki-kare, sağlam CFI/TLI/RMSEA, SRMR, standartlaştırılmış yükler, eşikler ve polikorik korelasyon matrisi vardır. Bir grup değişkeni verilirse biçimsel, eşik ve eşik + yük ölçme değişmezliği modelleri (Wu ve Estabrook, 2016) kurulup ölçeklenmiş ki-kare farkıyla karşılaştırılır.
Ne zaman kullanılır?
- Maddeler 2–10 kategorili sıralı ölçümlerse ve kategoriler arası uzaklıklar eşit varsayılamıyorsa; özellikle az kategorili (\le5) ve çarpık dağılımlı maddelerde (Flora ve Curran, 2004; Li, 2016).
- Grupların (cinsiyet, ülke, uygulama) aynı faktör yapısını ve eşikleri paylaşıp paylaşmadığı soruluyorsa.
- Faktörler arası korelasyonlar ve yükler, ölçüm hatasından arındırılmış istenirse.
Ne zaman kullanılmaz?
- Maddeler \ge5 kategorili ve yaklaşık simetrikse ve n büyükse: sürekli gibi ele alıp temel programdaki DFA (ML, MLM ya da MLR) yeterli olabilir; temel program polikorik/WLSMV seçeneği sunmaz.
- Faktörler arasında çapraz yüklere izin verilecekse (açıklayıcı/yarı-doğrulayıcı):
esem(Bölüm 180); bu şablonda her madde tek faktöre yüklenir. - Çok düzeyli (kümelenmiş) veri varsa:
cok_duzeyli_cfa(Bölüm 179). - Madde parametreleri (ayırt edicilik, güçlük) ve kişi parametreleri istenirse:
mirt_cok_boyutlu(Bölüm 174); ordinal DFA ile probit türü tek boyutlu IRT matematiksel olarak ilişkilidir ama çıktı parametreleştirmesi farklıdır. - Çok az gözlem (n<50 tam satır) ya da grup başına <30: şablon durur.
Temel programla ilişki. Temel programdaki DFA'da ML, MLM ve MLR kestiricileri ile FIML ve ölçme değişmezliği vardır; göstergeler sürekli kabul edilir. Bu şablon yalnız sıralı gösterge ve köşegen ağırlıklı kestirim içindir; eksik veri liste boyu silinir (FIML yok).
185.2 Şablonun girdileri
Form, üstbilgideki 7 [[param]] bloğundan kurulur (sirali_cfa_wlsmv.R:10–55). Türlerin ve ortak denetimin anlamı Bölüm 1.2'de anlatılmıştır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Faktör 1 maddeleri · gosterge1 |
sütunlar (en az 3) · Değişkenler | yok | herhangi sütunlar | Birinci faktörün göstergeleri (64, 74). |
Faktör 2 maddeleri · gosterge2 |
sütunlar, zorunlu değil · Değişkenler | boş | en az 3 madde | İkinci faktör (64–75). |
Faktör 3 maddeleri · gosterge3 |
sütunlar, zorunlu değil · Değişkenler | boş | en az 3 madde | Üçüncü faktör (64–75). |
Kestirici · kestirici |
seçim · Model | WLSMV |
WLSMV, ULSMV |
cfa(estimator =) (140). |
Grup · grup |
kategorik sütun, zorunlu değil · Değişkenler | boş | madde olmayan sütun | Değişmezlik modellerini açar (77, 124–). |
Parametreleştirme · parametrelestirme |
seçim · Model | delta |
delta, theta |
parameterization = (140, 180–181). |
Faktör varyanslarını 1'e sabitle · std_lv |
onay · Model | açık | açık/kapalı | std.lv (140). |
Şablona özgü denetimler (mq_hata), sırasıyla:
- Veri açık değil (63). Aynı madde birden çok faktör listesinde seçilmişse: "'A5' maddesi birden çok faktör listesinde seçilmiş; bu şablon çapraz yüklü madde kurmaz. Maddeyi tek faktörde bırakın." (65–71).
- Faktör 1 için 3'ten az madde (74); herhangi bir faktörde 3'ten az madde (75).
- Grup değişkeni maddelerden biri (78).
- Madde ve grup sütunları üzerinden tam satır sayısı 50'den az: "WLSMV için en az 50 tam satır gerekli." (84). Eksik değer nedeniyle atılan satır sayısı ve oranı bir not satırıyla yazılır (79–88).
- Sayısal bir madde tamsayı değil (100); tek kategorili madde (103); 10'dan fazla farklı değer (104). Maddelerin kategori sırası ve metin etiketli maddeler için uyarı çıktıya yazılır (108–123).
- Grup 2 düzeyden az (126); herhangi bir grup 30 gözlemden az (127). Bir grupta madde kategorilerinin bir kısmı hiç yoksa yalnız bir not yazılır (128–129).
cfahata verirse "Model kurulamadı: …" (141); yakınsamazsa "Kestirim yakınsamadı." (144). Değişmezlik modelleri kurulamazsa not (191), semTools yoksa not (174).
Örnek ayar (ornek_param, 9. satır): gosterge1 = A1…A5, gosterge2 = C1…C5; geri kalanı varsayılan.
Tohum. Kestirim deterministiktir (kod rastgelelik içermez); kod panelindeki Tohum alanı (Bölüm 1.3) sonucu değiştirmez.
185.3 Örnek veri
bfi_ac.csv: psych::bfi verisinden uyumluluk (A1–A5) ve sorumluluk (C1–C5) maddeleri ve cinsiyet; 2800 satır, maddelerde 211 eksik hücre; tam satır sayısı 2632. Maddeler 6 kategorili (1 = tamamen yanlış, …, 6 = tamamen doğru). A1 ve C4, C5 ters yönlü maddelerdir (ham puan, ters çevrilmemiş).
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
A1…A5 |
Faktör 1 (uyumluluk) | sayısal | 1–6; A1 ters yönlü |
C1…C5 |
Faktör 2 (sorumluluk) | sayısal | 1–6; C4, C5 ters yönlü |
gender |
grup (değişmezlik) | ikili | 2800 satırda erkek 919, kadin 1881 |
Maddeler veri sekmesinde "sayısal" algılanır; kategori sırası sayısal artan sıradır (1<\dots<6). Genel kural (89–107): madde etken (kategorik) bir sütunsa Veri sekmesindeki düzey sırası; değerlerin hepsi sayıya çevrilebiliyorsa ("1", "2", …) sayısal sıra; değilse harf sırasıdır (sort(method = "radix")). Kullanılan sıra çıktıya yazılır; metin etiketli maddelerde etiketlerin ölçek sırasıyla uyuştuğunu denetlemeniz gerektiğini söyleyen bir uyarı verilir (185.8). Grup sütunu factor() ile alfabetik düzeylere çevrilir (erkek birinci); değişmezlik modellerinde başvuru grup birinci düzeydir (125).
Bölümde kullanılan çalıştırmalar:
| Ad | Ayar |
|---|---|
ornek |
örnek ayar (WLSMV, delta, std_lv açık) |
ulsmv |
kestirici = ULSMV |
theta |
parametrelestirme = theta |
markor |
std_lv kapalı |
tek |
yalnız gosterge1 (A1–A5) |
grup |
grup = gender |
metin, eksik, virgul |
metin kodlu, eksik değerli, virgüllü ondalıklı madde (185.8) |
n40, sabit, kat12, kesirli, bos_kategori, ortak_madde_grup |
denetim ve uç durumlar (185.8) |
185.4 Yöntem: formüller ve hesap adımları
Hesap şu sırayladır: maddeler seçilir ve tam satırlar alınır; her madde sıralı etken (ordered) yapılır; lavaan cfa() modeli kurulur; lavaan iki aşamada kestirir (eşikler → polikorik korelasyonlar → DWLS ya da ULS ile yük ve faktör korelasyonları); uyum, yükler, faktör korelasyonları, eşikler ve polikorik matris tablolara yazılır; grup verilmişse semTools ile üç değişmezlik modeli kurulup karşılaştırılır; standartlaştırılmış yükler çizilir.
185.4.1 Model
j=1,\dots,p madde, c_j kategori sayısı; y_j gözlenen sıralı yanıt, y_j^* gizil yanıt olsun:
Bu ifadede \boldsymbol\eta faktörler (F1, F2, …), \boldsymbol\lambda_j yük vektörü (şablonda her madde tek faktörde sıfırdan farklı), \varepsilon_j ölçüm hatası, \tau_{j,c} eşikler (c_j-1 tane). Delta parametreleştirmesinde P(y_j\le c)=\Phi(\tau_{j,c}); \Phi standart normal dağılım işlevidir.
Delta parametreleştirmesi (varsayılan) gizil yanıtın toplam varyansını 1 sabitler: \mathrm{Var}(y^*_j)=\boldsymbol\lambda_j'\boldsymbol\Psi\boldsymbol\lambda_j+\theta_{jj}=1, yani \theta_{jj}=1-\boldsymbol\lambda_j'\boldsymbol\Psi\boldsymbol\lambda_j; tek faktörlü maddede yük \lambda_j doğrudan y^*_j ile faktör arasındaki korelasyondur ve std_all ile özdeştir. Teta parametreleştirmesi artık varyansı 1 sabitler (\theta_{jj}=1); yük ve eşikler 1/\sqrt{1-\lambda_j^2} ile ölçeklenir:
Bu ifadede \lambda^\delta,\tau^\delta delta, \lambda^\theta,\tau^\theta teta parametreleştirmesindeki yük ve eşiktir (faktör varyansı 1 iken). Örnek veride A1: \lambda^\delta=0{,}408169, \lambda^\theta=0{,}447109; \tau^\delta_{1}=-0{,}439452, \tau^\theta_{1}=-0{,}481377 (bu bölümde bağımsız doğrulandı, 185.6). std_all iki parametreleştirmede de aynıdır (0,408169), ham yük ve eşik farklıdır; eşik tablosu parametreleştirmeye bağlıdır.
Koddaki tercih
cfa(model, data = d, ordered = q(mad), estimator = P$kestirici, std.lv = isTRUE(P$std_lv), parameterization = P$parametrelestirme) (139–142). Model sözdizimi her faktör için F1 =~ v1 + v2 + … (135–136); tüm faktörlerin birbiriyle korelasyonu serbesttir (lavaan'ın varsayılanı), artıkların korelasyonu 0'dır. Eksik veri complete.cases ile liste boyu silinir ve atılan satır sayısı yazılır (80–88); missing seçeneği yoktur.
185.4.2 Kestirimin iki aşaması
Aşama 1: eşikler ve polikorik korelasyonlar. Her madde için eşikler marjinallerden bulunur:
Her madde çifti (j,k) için polikorik korelasyon \rho_{jk}, eşikler sabitken iki değişkenli normal hücre olasılıkları üzerinden log-olabilirliği enbüyükler (Olsson, 1979):
Bu ifadede n_{ab} iki maddenin çapraz tablosundaki hücre sayısı, \Phi_2(\cdot,\cdot;\rho) korelasyonu \rho olan standart iki değişkenli normal dağılım işlevidir. Bu iki aşamalı kestirimdir (eşikler önce, \rho sonra); çift başına eşik ve \rho'yu birlikte kestiren tam ML polikorik yönteminden küçük farklarla ayrılır (örnek veride \le3{,}5\times10^{-3}, A1–A2 çiftinde).
Aşama 2: yapısal parametreler. \mathbf s=(\hat{\boldsymbol\tau}',\hat{\boldsymbol\rho}')' ve model-ima edilen \boldsymbol\sigma(\boldsymbol\theta) için
enküçültülür. WLSMV'de \mathbf W=\mathrm{diag}(\hat{\boldsymbol\Gamma})^{-1}, \hat{\boldsymbol\Gamma} \mathbf s'nin asimptotik kovaryans matrisidir (köşegen ağırlıklı); ULSMV'de \mathbf W=\mathbf I (ağırlıksız). Eşikler doymuş olduğundan yapısal parametreler yalnızca korelasyonlara bağlıdır; ULSMV'de bu, köşegen dışı r_{jk}-\sigma_{jk}(\boldsymbol\theta) artıklarının kareler toplamıdır.
Bu ifadede \mathbf s eşik ve polikorik kestirimlerinin vektörü, \boldsymbol\sigma(\boldsymbol\theta) modelin ima ettiği karşılıkları, \mathbf W ağırlık matrisidir. ULSMV'de F=\sum_{j>k}(r_{jk}-\sigma_{jk})^2 ve ölçeklenmemiş ki-kare T=(n-1)\,F (n=2632); örnek veride F=0{,}138194, T=363{,}588 (bağımsız hesapla doğrulandı, 185.6).
Standart hatalar ve testler Muthén'in (1984) çerçevesinde sağlam kestirilir: SH'ler tam \hat{\boldsymbol\Gamma} ile sandviç biçiminde; ki-kare ölçeklenmiş ve kaydırılmış (Asparouhov ve Muthén, 2010):
Bu ifadede d modelin serbestlik derecesi, \boldsymbol\Delta=\partial\boldsymbol\sigma/\partial\boldsymbol\theta' Jacobien, \mathbf U\boldsymbol\Gamma izleri T'nin asimptotik dağılımının momentlerini verir. Şablonun yazdığı chisq.scaled bu istatistiktir ve d serbestlik derecesiyle (34) değerlendirilir; ham (ölçeklenmemiş) T ayrıca chisq olarak yazılır. Örnek veride T_{\mathrm{ms}}=593{,}496, T=449{,}278.
Sağlam CFI/TLI/RMSEA (cfi.robust, tli.robust, rmsea.robust) ve ölçeklenmiş karşılıkları (.scaled) lavaan'dan aynen alınır (148–150). Standartlaştırılmış yük std_all: \lambda_j\,\mathrm{sd}(\eta)/\mathrm{sd}(y^*_j).
Yük işareti (`std.lv`)
std_lv açıkken faktör ölçeği faktör varyansı =1 ile belirlenir; faktörün işareti belirsizdir; lavaan'ın başlangıç değerleri nedeniyle örnek veride her faktörün ilk maddesi pozitif yükle çıkar. A1 (ters yönlü madde) ilk madde olduğundan \lambda_{A1}=+0{,}408, öteki A maddeleri negatiftir; faktör korelasyonu -0{,}371 çıkar. İlk maddenin yönü, yüklerin ve faktör korelasyonunun işaretini belirler (işaret kuralı bağımsız hesapta "ilk maddenin yükü pozitif" alınmıştır).
185.4.3 Ölçme değişmezliği
grup verilirse (172–215) semTools::measEq.syntax(configural.model = model, ordered = ., parameterization = ., ID.fac = "std.lv", ID.cat = "Wu.Estabrook.2016", group = ., group.equal = .) ile üç model üretilir (176–181): configural (kısıt yok), esik (group.equal = "thresholds"), esik_yuk ("thresholds" ve "loadings"). Her model cfa() ile grup sütunlu kestirilir (183–187). Kısıtlı modeller iç içedir; sonuncu model bir öncekiyle lavTestLRT ile (ölçeklenmiş fark) karşılaştırılır (200–203).
Wu ve Estabrook (2016) kimliklendirmesi
Sıralı göstergelerde grupları kıyaslamak için ölçek (delta ya da teta) ve eşik kimliklendirmesi kurala bağlanmalıdır; aksi hâlde "biçimsel" model bile grup başına farklı ölçeklerle tanımsız kalır. ID.cat = "Wu.Estabrook.2016" bu kuralı uygular: biçimsel modelde eşikler ve yükler gruplar arasında serbesttir, kimlik için gerekli minimum kısıt konur; eşik değişmezliğinde eşikler gruplar arasında eşitlenir; yük değişmezliğinde yükler de.
Her satırdaki ki-kare ayrı ayrı ölçeklenmiştir
Tablodaki ki_kare değerleri her modelin kendi ölçeklenmiş-kaydırılmış istatistiğidir; birbirinden çıkarılamaz. Örnek veride "Eşikler eşit" 734{,}47 (d=98), "Eşikler + yükler eşit" 689{,}25 (d=106): daha kısıtlı modelin ki-karesi küçüktür. Karşılaştırma yalnız fark_ki_kare, fark_sd, fark_p sütunlarında yapılır (örnekte 34{,}37/30/0{,}266 ve 21{,}01/8/0{,}0071).
Şablon \Delta\mathrm{CFI} ya da \Delta\mathrm{RMSEA} yazmaz; tablodaki CFI ve RMSEA sütunları ölçeklenmiş değerlerdir (0{,}942, 0{,}936, 0{,}942 ve 0{,}080, 0{,}070, 0{,}065). Chen (2007) ölçütü (\Delta\mathrm{CFI}\le-0{,}01) bu değerlerden elle uygulanır.
185.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 57–78 | Paketi yükler; madde listelerini kurar, 3 madde, grup denetimleri. | Aynı madde iki faktörde seçilmişse durur (65–71). |
| 79–88 | Tam satırlar; n\ge50; atılan satır sayısı bildirilir. | Eksik değer liste boyu silinir (80–88). |
| 89–123 | Her madde için kategori sırası (etken: Veri sekmesi sırası; sayıya çevrilebilen: sayısal sıra; değilse harf sırası), tamsayı ve kategori sayısı (2–10) denetimi; maddeyi ordered() yapar; sırayı çıktıya yazar. |
Metin etiketli maddede uyarı (118–123); tamsayılık yalnız sayısal sütunda sınanır (100). |
| 124–130 | Grup: düzey sayısı, n\ge30, boş kategori notu. | |
| 131–136 | Sütun adlarını v1… olarak yeniden adlandırır (ad_map), model dizesini kurar. |
Maddeler 89–107'de sıralı etken yapılmıştır. |
| 138–144 | kur() ile cfa(); uyarılar toplanır; yakınsama sınanır. |
Uyarılar yalnız sona yazılır (216); converged doğruysa devam. |
| 145–151 | Özet satırı; uyum ölçütleri (ölçeklenmiş-kaydırılmış, sağlam, SRMR, ham ki-kare). | fitMeasures hata verirse yalnız ki-kare satırları (150). |
| 152–171 | Yük (başlık belirteç maddeyi yazar, 155–163), faktör korelasyonu, eşik (başlık parametreleştirmeyi yazar, 166) ve polikorik matris tabloları. | sampstat$cov (= polikorik matris, 167–169). |
| 172–215 | Değişmezlik modelleri ve fark testi tablosu. | Kurulamayan model notla bildirilir; fark satırı karşılaştırılan modeli karsilastirilan_model sütununda yazar (206–214). |
| 216–226 | Uyarılar ve standartlaştırılmış yük çubuk grafiği. |
Çıktı tabloları: Model uyumu; faktör yükleri; (birden çok faktör varsa) faktörler arası korelasyonlar; eşikler; polikorik korelasyon matrisi; (grup ile) ölçme değişmezliği. Bir şekil.
185.6 Elle hesap: örnek veride bağımsız yeniden hesap
Doğrulama lavaan, psych ve şablon kullanılmadan yapılmıştır: dogrulama/sirali_cfa_wlsmv/elle_hesap.py (numpy, scipy; eşikler Gauss–Legendre ile hesaplanan \Phi_2 üzerinden polikorik ML ve ULS) ve r_dogrulama.R (psych polychoric (correct = 0) ve taban R optim).
Adım 1 — Eşikler. n=2632 tam satırda A1'in kümülatif oranı 869/2632=0{,}330167; \hat\tau_{A1{,}1}=\Phi^{-1}(0{,}330167)=-0{,}439452 (şablon -0{,}439452). 50 eşiğin hepsi şablonla 5\times10^{-15} içinde örtüşür.
Adım 2 — Polikorik korelasyonlar. 45 çiftin hepsi bağımsız Python ile 3{,}6\times10^{-8}, psych ile 2{,}0\times10^{-5} içinde örtüşür. Örnekler: A1–A2: şablon -0{,}410178, Python -0{,}410178, psych -0{,}410189; A2–A3: 0{,}560810, 0{,}560810, 0{,}560797; C4–C5: 0{,}534662, 0{,}534662, 0{,}534677.
Adım 3 — ULSMV yükleri. Ağırlıksız en küçük kareler, Python'da F=0{,}13819396 ve yükler (+0{,}391718;\,-0{,}729833;\,-0{,}768712;\,-0{,}581143;\,-0{,}663749), (0{,}577633;\,0{,}650559;\,0{,}600565;\,-0{,}721797;\,-0{,}637894), \hat\phi_{12}=-0{,}377146; şablon (ulsmv) 0{,}391718, -0{,}729833, … ve -0{,}377146 yazar (10^{-6} içinde).
Adım 4 — ULSMV ölçeklenmemiş ki-kare. T=(n-1)F=2631\times0{,}13819396=363{,}58830; şablon 363{,}58836 (1{,}7\times10^{-7} göreli fark), d=34.
Adım 5 — Teta ile delta ilişkisi. WLSMV delta çözümünden \lambda^\theta_{A1}=0{,}408169/\sqrt{1-0{,}408169^2}=0{,}447109 (şablon theta 0{,}447109); \tau^\theta_{A1{,}1}=-0{,}439452/\sqrt{1-0{,}408169^2}=-0{,}481376 (şablon -0{,}481377).
Bağımsız hesaplanmayanlar. WLSMV'nin ağırlık matrisinin köşegeni \mathrm{diag}(\hat{\boldsymbol\Gamma})^{-1}, ölçeklenmiş-kaydırılmış ki-kare, sağlam SH'ler ve değişmezlik ki-kare farkları bağımsız yeniden kurulmadı: tutarlı asimptotik kovaryansın köşegeni için eşik ve polikorik kestirimlerin etki işlevleri gerekir. Bu nedenle WLSMV yükleri bu bölümde yalnız şablonun çıktısı olarak sunulur; ULSMV'de aynı yapısal parametrelerin ağırlıksız karşılığı doğrulanmıştır.
185.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | Ölçüt | |
|---|---|---|---|---|---|---|
| polikorik A2–A1 | −0,41017778 | −0,41017777 | −0,41018941 | 1,2e−5 | 1e−4 | ✓ |
| polikorik A3–A2 | 0,56080963 | 0,56080963 | 0,56079706 | 1,3e−5 | 1e−4 | ✓ |
| polikorik A5–A4 | 0,36057323 | 0,36057324 | 0,36059001 | 1,7e−5 | 1e−4 | ✓ |
| polikorik C1–A1 | −0,00565035 | −0,00565036 | −0,00565036 | 1,6e−8 | 1e−4 | ✓ |
| polikorik C2–C1 | 0,49097547 | 0,49097546 | 0,49097829 | 2,8e−6 | 1e−4 | ✓ |
| polikorik C4–C2 | −0,44399138 | −0,44399137 | −0,44398732 | 4,1e−6 | 1e−4 | ✓ |
| polikorik C5–C4 | 0,5346617 | 0,53466167 | 0,53467674 | 1,5e−5 | 1e−4 | ✓ |
| polikorik C5–A1 | 0,05517178 | 0,05517179 | 0,05517399 | 2,2e−6 | 1e−4 | ✓ |
| eşik A1 t1 | −0,4394516 | −0,4394516 | −0,4394516 | 3,3e−16 | 1e−6 | ✓ |
| eşik A2 t3 | −1,17848873 | −1,17848873 | −1,17848873 | 3,4e−15 | 1e−6 | ✓ |
| eşik A5 t5 | 0,68528976 | 0,68528976 | 0,68528976 | 2,2e−16 | 1e−6 | ✓ |
| eşik C3 t1 | −1,86952253 | −1,86952253 | −1,86952253 | 1,7e−15 | 1e−6 | ✓ |
| eşik C5 t5 | 1,26272805 | 1,26272805 | 1,26272805 | 1,9e−15 | 1e−6 | ✓ |
| ULSMV yük A1 | 0,39171763 | 0,39171758 | 0,39172344 | 5,8e−6 | 5e−5 | ✓ |
| ULSMV yük A2 | −0,72983308 | −0,72983315 | −0,72983619 | 3,1e−6 | 5e−5 | ✓ |
| ULSMV yük A3 | −0,76871208 | −0,76871209 | −0,76870377 | 8,3e−6 | 5e−5 | ✓ |
| ULSMV yük A4 | −0,58114337 | −0,5811435 | −0,58116081 | 1,7e−5 | 5e−5 | ✓ |
| ULSMV yük A5 | −0,66374932 | −0,66374914 | −0,66375182 | 2,5e−6 | 5e−5 | ✓ |
| ULSMV yük C1 | 0,57763244 | 0,57763259 | 0,5776382 | 5,8e−6 | 5e−5 | ✓ |
| ULSMV yük C2 | 0,65055951 | 0,65055944 | 0,65057021 | 1,1e−5 | 5e−5 | ✓ |
| ULSMV yük C3 | 0,60056458 | 0,60056463 | 0,60057442 | 9,8e−6 | 5e−5 | ✓ |
| ULSMV yük C4 | −0,7217974 | −0,72179732 | −0,72179627 | 1,1e−6 | 5e−5 | ✓ |
| ULSMV yük C5 | −0,63789391 | −0,63789381 | −0,63789632 | 2,4e−6 | 5e−5 | ✓ |
| ULSMV faktör korelasyonu (işaret: ilk madde yükü +) | −0,37714574 | −0,37714573 | −0,37714043 | 5,3e−6 | 5e−5 | ✓ |
| ULSMV ölçeklenmemiş ki-kare = (n − 1)·F | 363,58836374 | 363,5883024 | — | 1,7e−7 | 1e−5 | ✓ |
| ULSMV sd | 34 | 34 | — | 0 | 1e−6 | ✓ |
| teta yükü A1 (WLSMV delta yükünden) | 0,4471088 | 0,44710886 | — | 5,9e−8 | 1e−5 | ✓ |
| teta yükü A3 (WLSMV delta yükünden) | −1,27478855 | −1,2747892 | — | 5,1e−7 | 1e−5 | ✓ |
| teta yükü C5 (WLSMV delta yükünden) | −0,84100969 | −0,84100984 | — | 1,5e−7 | 1e−5 | ✓ |
| teta eşiği A1 t1 (delta eşiğinden) | −0,48137672 | −0,48137632 | — | 4,1e−7 | 1e−5 | ✓ |
| teta eşiği A2 t1 (delta eşiğinden) | −3,03646694 | −3,03646715 | — | 7,0e−8 | 1e−5 | ✓ |
| teta eşiği C4 t1 (delta eşiğinden) | −0,86526836 | −0,86526871 | — | 3,5e−7 | 1e−5 | ✓ |
Ölçütü karşılayan: 32/32. 45 polikorik korelasyonun en büyük mutlak farkı: bağımsız Python 3,6e−8, psych 2,0e−5; 50 eşiğin en büyük mutlak farkı: Python 5,1e-15, R 5,1e-15. WLSMV'nin köşegen ağırlıkları, ölçeklenmiş-kaydırılmış ki-kare, standart hatalar ve değişmezlik ki-kare farkları bağımsız hesaplanmadı (Bölüm 185.6): ağırlık matrisi ve tutarlı asimptotik kovaryans köşegeni yeniden kurulmadı.
Aşama 1'in tamamı (eşikler ve polikorik matris, psych dahil) ve ULSMV yapısal aşaması 10^{-6}–10^{-4} içinde örtüşür; polikorik satırlarında psych için ölçüt 10^{-4}'tür (psych'ın sayısal tümlev tamlığı). Tablo yalnız doğrulanan büyüklükleri içerir (185.6 son paragraf).
185.7 Çıktıyı okuma
Konsol çıktısı (ornek), olduğu gibi:
Not: maddelerde ya da grup değişkeninde eksik değer bulunan 168 satır (%6,0) atıldı; çözümlemede 2632 satır kaldı. Eksikliğin rastgele olduğu varsayılır.
Kategori sırası (A1, A2, A3, A4, A5, C1, C2, C3, C4, C5): sayısal sıra; sıra: 1 < 2 < 3 < 4 < 5 < 6.
Model: F1 =~ A1 + A2 + A3 + A4 + A5; F2 =~ C1 + C2 + C3 + C4 + C5 (n = 2632, WLSMV)
Model uyumu (ölçeklenmiş ve kaydırılmış)
| olcut | deger |
|---|---|
| chisq.scaled | 593.495678 |
| df.scaled | 34 |
| pvalue.scaled | 0.000000 |
| cfi.scaled | 0.946458 |
| tli.scaled | 0.929135 |
| rmsea.scaled | 0.079086 |
| cfi.robust | 0.905207 |
| tli.robust | 0.874539 |
| rmsea.robust | 0.086639 |
| srmr | 0.050617 |
| chisq | 449.277791 |
| df | 34 |
Faktör yükleri (faktör varyansı 1)
| faktor | madde | yuk | SH | z | p | std_all |
|---|---|---|---|---|---|---|
| F1 | A1 | 0.408169 | 0.018570 | 21.98 | 0 | 0.408169 |
| F1 | A2 | −0.722235 | 0.013299 | −54.31 | 0 | −0.722235 |
| F1 | A3 | −0.786804 | 0.012099 | −65.03 | 0 | −0.786804 |
| F1 | A4 | −0.569990 | 0.017057 | −33.42 | 0 | −0.569990 |
| F1 | A5 | −0.675675 | 0.013589 | −49.72 | 0 | −0.675675 |
| F2 | C1 | 0.594801 | 0.015615 | 38.09 | 0 | 0.594801 |
| F2 | C2 | 0.663599 | 0.014467 | 45.87 | 0 | 0.663599 |
| F2 | C3 | 0.592876 | 0.015148 | 39.14 | 0 | 0.592876 |
| F2 | C4 | −0.722002 | 0.013967 | −51.69 | 0 | −0.722002 |
| F2 | C5 | −0.643645 | 0.014322 | −44.94 | 0 | −0.643645 |
Faktörler arası korelasyonlar
| faktor1 | faktor2 | korelasyon | SH | p |
|---|---|---|---|---|
| F1 | F2 | −0.370665 | 0.022049 | 0 |
Eşikler (delta parametreleştirmesi) (ilk madde; 50 satırın kısaltması)
| madde | esik | kestirim | SH |
|---|---|---|---|
| A1 | t1 | −0.439452 | 0.025311 |
| A1 | t2 | 0.321647 | 0.024899 |
| A1 | t3 | 0.734300 | 0.026986 |
| A1 | t4 | 1.229605 | 0.032489 |
| A1 | t5 | 1.880570 | 0.048869 |
Polikorik korelasyon matrisi (ilk üç satır, ilk beş sütun)
| madde | A1 | A2 | A3 | A4 | A5 |
|---|---|---|---|---|---|
| A1 | 1.0000 | −0.4102 | −0.3239 | −0.1734 | −0.2295 |
| A2 | −0.4102 | 1.0000 | 0.5608 | 0.3958 | 0.4465 |
| A3 | −0.3239 | 0.5608 | 1.0000 | 0.4141 | 0.5744 |
Ölçme değişmezliği (grup = gender)
| model | ki_kare | sd | CFI | RMSEA | fark_ki_kare | fark_sd | fark_p | karsilastirilan_model |
|---|---|---|---|---|---|---|---|---|
| Biçimsel | 644.080876 | 68 | 0.942364 | 0.080265 | ||||
| Eşikler eşit | 734.474079 | 98 | 0.936322 | 0.070277 | 34.370844 | 30 | 0.266251 | Biçimsel |
| Eşikler + yükler eşit | 689.252731 | 106 | 0.941647 | 0.064686 | 21.013966 | 8 | 0.007110 | Eşikler eşit |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
chisq.scaled, df.scaled, pvalue.scaled |
Ölçeklenmiş-kaydırılmış ki-kare | Modelin tam uyum sınaması; büyük n'de hep reddedilir. Örnekte 593{,}5 (d=34): tam uyum reddedilir. |
cfi.scaled, tli.scaled, rmsea.scaled |
Ölçeklenmiş indeksler | Hu ve Bentler (1999) ölçütleri: CFI, TLI \ge0{,}95, RMSEA \le0{,}06. Örnekte CFI 0{,}946, RMSEA 0{,}079: sınırda/zayıf. |
cfi.robust, tli.robust, rmsea.robust |
Sağlam indeksler | Ölçeklenmiş indekslerden daha tutucudur (CFI 0{,}905, RMSEA 0{,}087): iki faktörlü model bu veride yeterince uymaz. |
srmr |
Standartlaştırılmış artık | \le0{,}08 kabul edilir; 0{,}051. |
| Yükler | \hat\lambda_j ve std_all |
Delta'da std_all yüke eşittir. İşaret: ters yönlü maddeler (A2…A5 negatif, çünkü A1 ilk madde). |
| Eşikler | \hat\tau_{j,c} | Delta'da kümülatif oranın probit değeri; teta'da yüke göre ölçeklenir (185.4.1); tablo başlığı parametreleştirmeyi yazar. |
| Polikorik matris | \hat\rho_{jk} | Doğrudan inceleme için (eksi/artı kümeleri maddelerin yönünü gösterir). |
| Değişmezlik tablosu | Üç modelin uyumu ve ardışık fark | fark_p >0{,}05: eşik eşitliği reddedilmez; 0{,}007: yük eşitliği reddedilir (cinsiyete göre yük değişmezliği sağlanmaz). |
Şekil 185.1. Standartlaştırılmış faktör yükleri (mor F1, turkuaz F2).
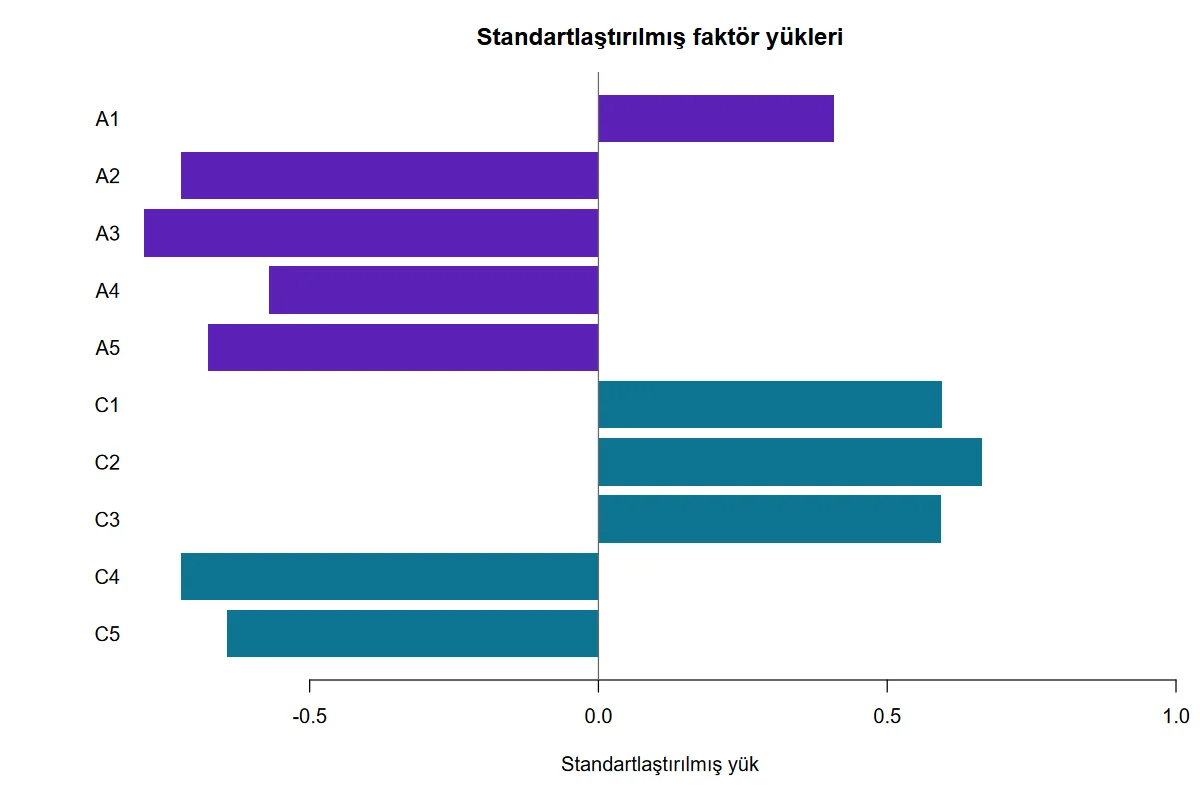
Ek çalıştırmalar: ULSMV'de yükler 0{,}392, -0{,}730, … , \chi^2_{\mathrm{ms}}=520{,}17, CFI 0{,}935, RMSEA 0{,}074, faktör korelasyonu -0{,}377. Yalnız A maddeleriyle (tek, n=2709) tek faktörlü model: \chi^2_{\mathrm{ms}}=143{,}54 (d=5), CFI 0{,}975, RMSEA 0{,}101.
Rapor cümlesi. Uyumluluk ve sorumluluk maddeleri (2632 tam satır) için iki faktörlü sıralı DFA WLSMV ile kestirildi (delta parametreleştirmesi, faktör varyansı 1). Ölçeklenmiş-kaydırılmış ki-kare 593,50 (sd = 34, p < 0,001); ölçeklenmiş CFI = 0,946, TLI = 0,929, RMSEA = 0,079; sağlam CFI = 0,905, RMSEA = 0,087; SRMR = 0,051. Standartlaştırılmış yükler 0,41 ile 0,79 arasındaydı (mutlak değer) ve faktörler arası korelasyon −0,37'ydi. Cinsiyete göre eşik eşitliği reddedilmedi (Δχ² = 34,37, sd = 30, p = 0,27), yük eşitliği reddedildi (Δχ² = 21,01, sd = 8, p = 0,007).
185.8 Sık hatalar ve tuzaklar
- Metin kodlu maddelerde kategori sırası ölçek sırası olmalıdır. Maddeler "hic, az, biraz, orta, cok, tam" gibi metin etiketleriyse model, etiketlerin kendi sırasını (etken sütunda Veri sekmesindeki düzey sırası, düz metinde harf sırası) kullanır; bu sıra ölçeğin 1<\dots<6 sırasıyla uyuşmazsa polikorik korelasyonlar ve eşikler yanlış sıraya göre hesaplanır, yükler anlamsız değerlere (-0{,}31 ile +0{,}47) varır ve uyum iyi görünür (\chi^2_{\mathrm{ms}}=69{,}06, CFI 0{,}963, RMSEA 0{,}020). Şablon kullanılan sırayı çıktıya yazar ve metin etiketli her madde için uyarır (108–123). Doğru kurulum: maddeleri sayıyla kodlayın ya da Veri sekmesinde düzey sırasını ölçek sırasına getirin; o zaman sonuç sayısal kodlu verinin sonucuyla özdeştir (\chi^2_{\mathrm{ms}}=593{,}50, CFI 0{,}946).
- Eksik veri liste boyu silinir. Tam satır alınır (80–88); atılan satır sayısı ve oranı çıktıya yazılır (%1 rastgele eksikte n=2401 kalır). Eksikliğin rastgele olduğu varsayılır; FIML ya da çoklu atama yoktur.
- İlk madde ters yönlüyse işaretler tersine döner.
std_lvaçıkken A1 (+) ve A2…A5 (-) ya da tersi; faktör korelasyonunun işareti de buna bağlıdır (185.4.2). Ters maddeleri veri sekmesinde ters çevirin ya da ilk maddeyi doğru yönlüden seçin. std_lvkapalıyken her faktörün belirteç maddesinin yükü 1'e sabitlenir; lavaan zayıf bir ilk maddeyi başka bir belirteçle değiştirebilir ("ilk gösterge zayıf, belirteç değiştirildi") ve "optimizasyon çözümü bulamadı" uyarısı verebilir; tablo başlığı yükü 1'e sabitlenen belirteç maddeyi yazar (155–163), lavaan uyarıları sonda "Kestirim uyarıları" altında verilir.- Değişmezlik ki-kare tablosunu satır satır kıyaslamayın (185.4.3). Kurulamayan bir model tablodan çıkar ve bir notla bildirilir; fark satırı o durumda bir önceki kurulabilen modele göredir ve hangi modele göre olduğu
karsilastirilan_modelsütununda yazılır (206–214). - Boş kategori. Bir grupta bir madde kategorisi hiç yoksa yalnız not yazılır ve değişmezlik modelleri kurulamaz ("Değişmezlik modelleri kurulamadı"); A1'in erkeklerde 6., kadınlarda 1. kategorisi silindiğinde bu çıktı alındı (
bos_kategori). Kategorileri birleştirin. - Sayısal olmayan madde türünde tamsayılık sınanmaz.
kesirlidenemesinde 3{,}5 gibi değerler iletiyle reddedilir (100); metin etiketleri ise ölçek sırasıyla yazılan sırayla işlenir (yukarıdaki ilk madde). - Örneklem ve ölçüt. n\ge50 ve grup başına \ge30 yalnız teknik alt sınırdır; WLSMV'nin kararlı olması için çok daha büyük örneklem gerekir (Flora ve Curran, 2004; Forero ve ark., 2009).
- Aynı madde iki faktörde seçilirse çalıştırma durur (65–71): bu şablon çapraz yüklü madde kurmaz; çapraz yükler için
esem(Bölüm 180).
185.9 Uzman soruları
S1. Neden polikorik korelasyon, Pearson korelasyonu değil?
Sıralı maddelerde Pearson korelasyonu, kategori sayısı az ve dağılım çarpıksa, gizil yanıtlar arasındaki korelasyonu aşağı çeker ve yapay faktörler (zorluk faktörleri) üretebilir; polikorik korelasyon gizil normal y^* varsayımıyla kategorileştirmeyi telafi eder (Olsson, 1979). Örnek veride A1–A2 polikoriği -0{,}410'dur.
S2. WLSMV ile ULSMV arasında ne fark vardır?
İkisi de polikorik/eşik vektörüne uyar. WLSMV köşegen ağırlıkla (\mathrm{diag}(\Gamma)^{-1}) daha verimlidir; ULSMV ağırlıksızdır, küçük örneklemde ve karmaşık modellerde daha kararlı olabilir (Forero ve ark., 2009). Örnekte yük farkı 2\times10^{-2} içindedir (A1: 0{,}408 ve 0{,}392) ve ULSMV'nin ölçeklenmemiş ki-karesi (n-1)F ile yeniden üretilir (185.6, Adım 4).
S3. Delta ile teta parametreleştirmesi sonuçları değiştirir mi?
Uyum ölçütleri ve std_all aynıdır (örnekte chisq.scaled 593{,}4957 ve 593{,}4957); ham yükler, eşikler ve artık varyanslar farklı ölçektedir (185.4.1). Teta'da artık varyansı 1 sabit olduğundan yükler 1'i aşabilir (\lambda^\theta_{A3}=-1{,}275). Gruplar arası eşitlemelerde hangisi kullanılırsa kimlik kuralı değişir; şablon değişmezlik modellerini de seçilen parametreleştirmeyle kurar (180).
S4. Neden `chisq.scaled`'in sd'si tam sayı (34)?
Ölçeklenmiş-kaydırılmış istatistiğin (185.4.2) sd'si modelin nominal sd'sidir; ortalama-varyans düzeltmeli test ise kesirli sd verirdi. \chi^2_{\mathrm{ms}} doğrudan \chi^2_{34} ile değerlendirilir.
S5. Değişmezlik adımlarında neden ardışık model karşılaştırılıyor?
İç içe modeller (biçimsel \supset eşik \supset eşik+yük) olduğundan ardışık fark testi (200–203) kullanılır: önce eşiklerin, sonra yüklerin eşitliği. Eşik eşitliği reddedilirse yük eşitliğini sınamak anlamsızdır (Wu ve Estabrook, 2016). Şablon yalnız bu iki adımı kurar; kısmi değişmezlik, artık varyans ve ortalama değişmezliği yoktur.
S6. Sınır durumu: bir maddede bir kategori hiç işaretlenmemişse?
Tüm veride hiç işaretlenmeyen kategori etkenin düzeyi olmaz; o madde bir eşik eksik kestirilir. Yalnız bir grupta işaretlenmeyen kategori ise o grupta eşiği kestirilemez kılar: değişmezlik modelleri kurulamaz (not 83–84; "Değişmezlik modelleri kurulamadı", bos_kategori). Doğrusu kategorileri birleştirmektir.
S7. Başka bir paketle fark: Mplus ve psych'ın polikorik tanımı.
psych polychoric ve lavaan'ın ilk aşaması eşikleri marjinallerden sabitler (iki aşamalı); bazı programlar çift başına eşik ve \rho'yu birlikte kestirir (tam ML). Fark küçüktür: şablonun başlığındaki SAS karşılığı A1–A2 için 0{,}0035 ayrılır ve bu bölümdeki bağımsız hesap iki aşamalı tanımı yeniden üretir (3{,}6\times10^{-8}). psych polychoric'in varsayılan correct = 0.5 boş hücrelere 0{,}5 ekler; bu bölümde correct = 0 kullanılmıştır.
S8. SAS'ta karşılık var mı?
sirali_cfa_wlsmv.sas: yalnız ilk aşamayı (probit eşikler, PROC CORR POLYCHORIC) yeniden üretir; WLSMV SAS/STAT'ta yoktur (SAS dosyasının başlık yorumu). Bu bölümde SAS karşılaştırması yapılmamıştır.
185.10 Kaynaklar
Asparouhov, T., & Muthén, B. (2010). Simple second order chi-square correction [Teknik belge]. Mplus Web Notes. statmodel.com.
Chen, F. F. (2007). Sensitivity of goodness of fit indexes to lack of measurement invariance. Structural Equation Modeling, 14(3), 464–504. https://doi.org/10.1080/10705510701301834
Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466–491. https://doi.org/10.1037/1082-989X.9.4.466
Forero, C. G., Maydeu-Olivares, A., & Gallardo-Pujol, D. (2009). Factor analysis with ordinal indicators: A Monte Carlo study comparing DWLS and ULS estimation. Structural Equation Modeling, 16(4), 625–641. https://doi.org/10.1080/10705510903203573
Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
Li, C.-H. (2016). Confirmatory factor analysis with ordinal data: Comparing robust maximum likelihood and diagonally weighted least squares. Behavior Research Methods, 48(3), 936–949. https://doi.org/10.3758/s13428-015-0619-7
Muthén, B. (1984). A general structural equation model with dichotomous, ordered categorical, and continuous latent variable indicators. Psychometrika, 49(1), 115–132. https://doi.org/10.1007/BF02294210
Olsson, U. (1979). Maximum likelihood estimation of the polychoric correlation coefficient. Psychometrika, 44(4), 443–460. https://doi.org/10.1007/BF02296207
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
Wu, H., & Estabrook, R. (2016). Identification of confirmatory factor analysis models of different levels of invariance for ordered categorical outcomes. Psychometrika, 81(4), 1014–1045. https://doi.org/10.1007/s11336-016-9506-0