84. Popülasyon Yapısı: Genotip TBA, DAPC ve sNMF
Şablon kimliği: populasyon_yapisi · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/populasyon_yapisi.R (satır 1–416; üstbilgi 1–159) · Örnek veri: _ornek/abies_cilicica.csv · Paketler: ade4 1.7-24, adegenet 2.1.11, LEA 3.22.0
84.1 Ne işe yarar
Şablon, çok lokuslu genotiplerden "bu bireyler genetik olarak kaç gruba ayrılıyor ve hangi birey hangi gruba yakın?" sorusunu üç tamamlayıcı yoldan inceler. Üçü de bireylerin alel sayıları tablosundan başlar: her birey için her alelin kaç kopyasını taşıdığını (0, 1, 2) gösteren sayısal tablo.
| Adım | Ne yapar | Varsayımı |
|---|---|---|
| Temel bileşenler analizi (TBA) | Bireyleri, alel sayılarındaki değişkenliğin en büyük olduğu eksenlere yansıtır. | Yok; yalnız geometrik özet. |
| Kümeleme ve DAPC | k-ortalamalarla küme arar, küme sayısını BIC ile seçer; verilen grupları en iyi ayıran doğrusal bileşimleri (ayırma fonksiyonları) bulur ve bireyleri gruplara geri atar. | Grup içi dağılım, tutulan temel bileşenlerde benzer biçimli. |
| sNMF | Her bireyi K atasal popülasyonun karışımı olarak modeller; soy katsayılarını (Q) kestirir, K'yı çapraz entropiyle seçer. | Karışım modeli; Hardy–Weinberg ve bağlantı dengesi varsayılmaz. |
Ne zaman kullanılır? Popülasyon sınırları bilinmiyorsa ya da örnekleme birimlerinin (yöre, meşcere, koloni) genetik gruplarla örtüşüp örtüşmediği sorulacaksa; karışmış (melez kökenli) bireyler aranıyorsa; sonraki çözümlemeler (ilişkilendirme, seçilim taraması) için yapı düzeltmesi gerekiyorsa.
Ne zaman kullanılmaz?
- Popülasyonlar önceden tanımlıysa ve farklılaşmanın büyüklüğü isteniyorsa:
f_istatistikleri(Bölüm 71); hiyerarşik varyans ayrıştırması içinamova(Bölüm 63). - Popülasyonlar arası uzaklık matrisi ve ağaç isteniyorsa:
genetik_uzaklik(Bölüm 74); farklılaşmanın coğrafi uzaklıkla ilişkisi içinuzaklikla_yalitim(Bölüm 92). - Bireyler arası akrabalık soruluyorsa:
akrabalik(Bölüm 62). Yakın akrabaların (aynı ailenin döllerinin) çok sayıda örneklenmesi bu şablonda yapay kümeler üretir. - Veri DNA dizisiyse:
haplotip_agiya dadizi_filogeni. - Baskın belirteçler (AFLP, RAPD) ya da poliploit türler: şablonun ayrıştırıcısı yalnız diploit, iki alelli genotip yazımını kabul eder.
Temel programla ilişki. Temel programın temel bileşenler, kümeleme ve ayırma (diskriminant) analizleri sayısal değişkenlerle çalışır; genotip sütunlarını alel sayılarına çevirmez, küme sayısını BIC eğrisiyle ya da temel bileşen sayısını çapraz doğrulamayla seçmez ve karışım modeli kestirmez. Bu şablon o adımları genotip verisi için tek akışta birleştirir.
84.2 Şablonun girdileri
Form, üstbilgideki on sekiz [[param]] bloğundan kurulur (populasyon_yapisi.R:10–144).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Lokus sütunları · lokuslar |
sütunlar · Değişkenler | yok | en az 2 sütun | Alel sayıları tablosu (182–191). |
Popülasyon · populasyon |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Renkler, çapraz tablo ve varsayılan DAPC grupları (177, 279). |
Alel ayırıcısı · ayirici |
metin · Değişkenler | / |
boş olmayan metin | Metin genotipini iki alele böler (165). |
Eksik genotip kodları · eksik_kodlar |
metin · Değişkenler | boş | virgülle ayrılmış kodlar | Boşsa varsayılan liste (boş hücre, NA, 0, 00, 000, ?, -, ., -9) eksik sayılır; doluysa alandaki kodlar bu listenin yerine geçer (boş hücre ve NA her zaman eksik); baş ve son boşluk kırpılır, boş kodlar atılır (satır 164–165; Bölüm 1.5). |
Birey kimliği sütunu · birey_kimlik |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Boşsa veride birey adlı bir sütun varsa kimlik oradan, yoksa satır numarasıdır; doluysa seçilen sütun kimlik olarak kullanılır (mq_kimlik: sayısal kimlikte 1e+05 olmaz) ve Birey TB puanları, DAPC üyelik ve sNMF soy tablolarında görünür (satır 171, 222). |
DAPC grupları · dapc_grup |
seçim · Model | otomatik |
otomatik, kume |
Popülasyon sütunu ya da bulunan kümeler (277–284). |
Küme sayısı ölçütü · kriter |
seçim · Model | diffNgroup |
diffNgroup, min, goodfit |
BIC eğrisinden K seçme kuralı (235–238). |
En büyük küme / soy sayısı · K_maks |
tam sayı · Seçenekler | 10 | 2–50 | Kümelemede ve sNMF'de denenen en büyük K; n-1 ile sınırlanır (237, 358). |
DAPC'de tutulacak TB sayısı · n_pca |
tam sayı · Model | 0 | 0–1000 | 0 ise çapraz doğrulamayla seçilir (291–302). |
Çapraz doğrulama tekrar sayısı · cv_tekrar |
tam sayı · Seçenekler | 30 | 3–200 | Her TB sayısı için eğitim/sınama bölmesi sayısı (297). |
sNMF soy katsayılarını hesapla · snmf |
onay · Seçenekler | açık | açık / kapalı | Üçüncü adım (348). |
Her K için sNMF çalıştırma sayısı · snmf_tekrar |
tam sayı · Seçenekler | 5 | 1–50 | Her K için bağımsız başlangıç sayısı (362). |
Alel sütunlarını ölçekle · olcekle |
onay · Model | kapalı | açık / kapalı | Kümelemede ve DAPC'de sütunlar birim varyansa getirilir (239, 294, 296). |
k-ortalamalar rastgele başlangıç sayısı · fc_n_start |
tam sayı · Gelişmiş | 100 | 1–1000 | kmeans(nstart =) (239). |
k-ortalamalar en çok yineleme · fc_n_iter |
tam sayı · Gelişmiş | 100000 | 10–10 000 000 | kmeans(iter.max =) (239). |
Çapraz doğrulama eğitim oranı · xval_egitim |
ondalık · Seçenekler | 0,9 | 0,5–0,95 | Her gruptan eğitime ayrılan pay (296). |
Çapraz doğrulamada en çok TB · xval_npca_maks |
tam sayı · Gelişmiş | 300 | 2–5000 | Denenen TB sayılarının üst sınırı (296). |
sNMF düzenlileştirme α · snmf_alfa |
ondalık · Gelişmiş | 10 | 0–10000 | Q matrisinin seyrekliğini artıran ceza (363). |
sNMF en çok yineleme · snmf_iterasyon |
tam sayı · Gelişmiş | 200 | 10–10000 | Her çalıştırmanın yineleme sınırı (363). |
sNMF yakınsama toleransı · snmf_tolerans |
ondalık · Gelişmiş | 0,00001 | 10^{-9}–0,01 | Durma ölçütü (363). |
Örnek ayar (ornek_param, satır 9): on lokus (NFF3, NFF7, NFH15, NFH3, SF1, SF333, SF50, SF78, SFb4, SFb5) ve populasyon = pop. Öteki alanlar varsayılandadır.
Genotip yazımı Bölüm 71'deki ortak ayrıştırıcıyla aynıdır (satır 164–165): metin genotip alel1/alel2, SNP için sayısal 0/1/2. Boş hücre, NA, na, 0, 00, 000, ?, -, ., -9 eksik genotip sayılır; iki alel de eksik kodu olmalıdır (0/0, -9/-9). Alellerinden yalnız biri eksik kodu olan genotip (0/1) çalıştırmayı durdurur: 0 adlı gerçek bir alel varsa yeniden kodlanır (84.8). Atılan genotiplerin dökümü konsola yazılır (192). "Eksik genotip kodları" alanı doluysa bu liste yerine alandaki kodlar eksik sayılır (boş hücre ve NA her zaman eksik) ve yarı eksik genotip için durma kuralı yeni listeyle işler; VCF tarzı 0/1 kodlu veride alana yalnız . yazılınca 0 gerçek bir alel olarak okunur (satır 164–165).
Birey kimliği. "Birey kimliği sütunu" alanı boşsa veride adı birey olan bir sütun varsa tablolardaki birey adları oradan alınır; yoksa satır numarası yazılır (222). Alan doluysa seçilen sütun kimliktir (171, 222); sütun veride yoksa çalıştırma durur.
Şablonun kendi denetimleri (çalıştırmayı durdurur).
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 167 |
| Lokus bütünüyle eksik | "lokusunda hiç genotip yok" | 165, 165, 165 |
| Sayısal lokusta 0/1/2 dışında değer | "sayısal genotip yalnız 0/1/2 olabilir" | 165–165 |
| Ayırıcı boş; ayırıcı içermeyen genotip; ikiden çok alelli genotip | ilgili ileti | 151, 151–151 |
| İkiden az lokus seçilmiş | "En az iki lokus seçin." | 169 |
| Popülasyon sütunu lokus olarak da seçilmiş | "Popülasyon sütunu lokus olarak da seçilemez." | 172 |
| Çok biçimli lokus sayısı 2'den az | "en az iki polimorfik lokus gerekli" | 194–195 |
| Birey sayısı 4'ten az | "en az 4 birey gerekli" | 202 |
Notlar (durdurmaz): tek biçimli lokuslar çıkarılır (193); hiç genotipi olmayan bireyler ve popülasyonu eksik bireyler çıkarılır (197, 199); küme sayısı belirlenemezse (240), DAPC hesaplanamazsa (303) ya da sNMF çalıştırılamazsa (365) paketin iletisi not olarak yazılır ve öteki adımlar sürer; popülasyon tek düzeyliyse DAPC bulunan kümelerle yapılır (283); iki grup yoksa ya da bir grupta tek birey varsa DAPC atlanır (286, 288); dirsek ve en küçük BIC farklı K veriyorsa (257) ve sNMF'de birden çok K ayırt edilemiyorsa (374) uyarı notu yazılır.
84.3 Örnek veri
Dosya: _ornek/abies_cilicica.csv. Lübnan'daki 15 Toros göknarı (Abies cilicica) popülasyonundan 351 ağacın 10 çekirdek mikrosatellit lokusundaki genotipleri (Awad ve ark., 2014). Aynı veri Bölüm 71 ve 73'te ayrıntılı tanıtılmıştır; burada yalnız bu şablon için gerekenler yinelenir.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
birey |
Birey adı (kendiliğinden) | metin | KCHB_01 … EHDN_19. |
pop |
Popülasyon | kategorik (15 düzey) | Popülasyon büyüklükleri 11–30. |
NFF3 … SFb5 |
Lokuslar | kategorik (metin genotip) | Lokus başına 3–27 alel, toplam 109 alel. |
boylam, enlem |
kullanılmaz | coğrafi | Popülasyon koordinatları. |
Eksik genotip: SF1 1, SF50 3, SF78 1, SFb4 12, SFb5 55 birey (3510 genotipin 72'si, %2,05). Hiçbir bireyin bütün lokusları eksik değildir. Bu veride yapı zayıftır: F_{ST}=0{,}054 (Bölüm 71); kaynak makale karışım modeliyle iki küme bildirmiştir. Zayıf yapı, küme sayısı seçiminin kararsız olacağı anlamına gelir ve bu bölümde bilerek öne çıkarılmıştır.
Şablon popülasyon düzeylerini ada göre (metin sırası) sıralar; tablolardaki sıra BTJF, CHIR, EHDN, … QJRN'dir. Adlar 1, 2, …, 15 ise sıra 1, 10, 11, …, 2 olur; sıra hesabı etkilemez.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2, 3) aynı ayar, iki başka çalıştırma tohumu; (4) n_pca = 80 ve (5) n_pca = 30, sNMF kapalı; (6) kriter = min, dapc_grup = kume; (7) kriter = goodfit; (8) olcekle açık, çapraz doğrulamalı; (9) olcekle açık, n_pca = 80 ve 90; (10) xval_egitim = 0,7; (11) popülasyon sütunu boş; (12) satırları karıştırılmış aynı veri; (13) belirgin yapılı yapay SNP verisi (üç ada, 120 birey, 40 SNP, 0/1/2 kodlu) ve aynı verinin metin genotipli biçimi; (14) yazım denemeleri (-9/-9 eksik kodu, 0 adlı alel, birey sütunu olmayan veri).
84.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) genotipler alel sayıları tablosuna çevrilir, eksikler doldurulur; (2) TBA; (3) K=1,\dots,K_{maks} için k-ortalamalar, BIC eğrisi ve küme sayısı; (4) DAPC'ye girecek temel bileşen sayısının çapraz doğrulaması ya da sabit değeri; (5) DAPC: ayırma fonksiyonları, sonsal üyelikler, yeniden atama; (6) sNMF: K başına birden çok çalıştırma, çapraz entropi, en iyi çalıştırmanın Q matrisi.
84.4.1 Alel sayıları tablosu ve eksik genotipler
Bir lokusun her aleli bir sütun olur; hücre, bireyin o alelden taşıdığı kopya sayısıdır:
- g_{i\ell,1}, g_{i\ell,2}: i. bireyin \ell. lokustaki iki aleli; \mathbb 1[\cdot] gösterge fonksiyonu.
- \bar x_{(\ell,a)}: alel sütununun gözlenen bireyler üzerindeki ortalaması (alel frekansının iki katı).
- Bir lokusun sütunlarının toplamı her bireyde 2'dir; 0/1/2 kodlu sayısal sütun iki sütuna açılır (
A: 2-v,B: v).
Neden ortalamayla doldurma?
TBA ve k-ortalamalar eksik hücre kabul etmez. Ortalama ile doldurulan hücre merkezlemeden sonra sıfır olur: eksik genotip o lokusta bireyi hiçbir yöne çekmez. Bedeli, çok eksiği olan bireylerin grafiğin merkezine doğru kaymasıdır; merkezde toplanan bireylerin eksik oranına bakılır. Şablonda başka bir doldurma yöntemi yoktur.
Koddaki tercih
Tablo satır 182–191'da kurulur; tek alelli (tek biçimli) lokuslar atılır. Doldurmadan sonra varyansı sıfır olan sütunlar da atılır (206). Konsoldaki "eksik genotip oranı", birey × lokus genotiplerinin eksik olanlarının oranıdır (203); örnek veride 3510 genotipin 72'si eksiktir (%2,05, konsolda %2,1). Alel sütunu hücrelerinin oranı (38 259 hücrenin 360'ı, %0,9) çok alelli lokuslar daha çok sütun taşıdığından bu sayıdan farklıdır ve yazılmaz. sNMF'ye giden tabloda eksikler doldurulmaz, 9 ile kodlanır (354).
84.4.2 Genotip TBA
- \mathbf Z: sütunları merkezlenmiş alel sayıları tablosu (n\times p); ölçekleme yapılmaz.
- \lambda_k: k. özdeğer, o eksen üzerindeki puanların varyansı (n bölenli); \mathbf T birey puanları.
- \%_k: eksenin açıkladığı varyans yüzdesi.
Neden ölçeklenmiyor?
Bütün sütunlar aynı birimdedir (alel kopya sayısı). Birim varyansa ölçekleme, bir iki bireyde görülen nadir alellere sık alellerle aynı ağırlığı verir ve gürültüyü büyütür. Ölçeklenmemiş tabloda bir alelin katkısı varyansıyla, yani 2p(1-p) ile orantılıdır; orta frekanslı aleller ağır basar. olcekle seçeneği TBA tablosunu ve grafiğini değiştirmez; yalnız kümeleme ve DAPC adımlarına uygulanır.
Koddaki tercih
ade4::dudi.pca(center = TRUE, scale = FALSE, scannf = FALSE, nf = min(10, p, n − 1)) (satır 218). ade4 özdeğerleri n bölenle verir; prcomp ya da n-1 bölenli yazılımlarla karşılaştırırken özdeğerler (n-1)/n ile çarpılır. Tabloya ilk 20 özdeğer, ilk üç eksenin puanları yazılır (221–224). Eksenlerin işareti keyfidir.
84.4.3 Küme sayısı: k-ortalamalar ve BIC
Bireyler, bütün temel bileşenler tutularak (yani bilgi kaybı olmadan) K kümeye ayrılır; k-ortalamalar küme içi kareler toplamını küçültür. Her K için
- \mathbf t_i: bireyin temel bileşen puanları; \bar{\mathbf t}_c küme merkezi.
- WSS_K: küme içi kareler toplamı; K arttıkça azalır. K\ln n fazla küme için cezadır.
- K=1 için kümeleme gerekmez: WSS_1 toplam kareler toplamıdır.
BIC eğrisinden K üç kuraldan biriyle seçilir; şablon üçünü de hesaplayıp ayrı bir tabloda yan yana verir, DAPC'de ve çapraz tabloda kriter ile seçilen kullanılır.
| Ölçüt | Kural |
|---|---|
Dirsek (diffNgroup, varsayılan) |
Ardışık BIC farkları d_K=BIC_{K+1}-BIC_K hiyerarşik kümelemeyle (Ward) iki gruba ayrılır; ortalaması küçük olan ("büyük düşüşler") grubun son farkının vardığı K seçilir. |
En küçük BIC (min) |
\arg\min_K BIC_K. |
İyi uyum (goodfit) |
Eşik \min BIC+0{,}1(\max BIC-\min BIC); BIC'i eşiğin altına inen ilk K'nın bir eksiği. |
Neden varsayılan "en küçük BIC" değil?
Gerçek küme sayısına ulaşıldıktan sonra BIC eğrisi çoğu kez düzleşir ve küçük dalgalanmalarla inip çıkar; en küçük değer bu düzlükte rastlantıyla belirlenir ve genellikle fazla küme seçer. Dirsek kuralı, eğrinin dik indiği bölümün bittiği yeri arar. İki sınırı vardır: en az 2 küme döndürür (K=1 sonucu veremez) ve eğri hiç inmiyorsa bile bir K seçer (84.8).
Koddaki tercih
adegenet::find.clusters(Xi, n.pca = min(n − 1, p), max.n.clust = min(K_maks, n − 1), choose.n.clust = FALSE, criterion = kriter, n.start, n.iter, scale = olcekle) (satır 238–239). Paket her K için stats::kmeans'i (Hartigan–Wong) nstart rastgele başlangıçla çağırır, ardından seçilen K için k-ortalamaları yeniden çalıştırır; çapraz tablodaki kümeler bu son çalıştırmadandır ve BIC eğrisindeki değeri veren bölmeyle aynı olmayabilir. Üç ölçütün K'sı şablonda aynı kurallarla yeniden hesaplanır (245–250). k-ortalamalar yerel en iyiye yakınsar; bu yüzden varsayılan 100 rastgele başlangıç kullanılır (örnek veride 10 başlangıç K\ge3 için en iyi çözümü her zaman bulmuyordu; 84.6) ve BIC tablosunun başlığı başlangıç sayısını yazar (236, 252).
84.4.4 DAPC: temel bileşenlerde ayırma analizi
Doğrusal ayırma analizi, değişken sayısı birey sayısına yaklaştığında ve değişkenler ilişkiliyken (alel sütunları öyledir) kurulamaz. DAPC önce veriyi ilk m temel bileşene indirger, ayırma analizini bu ilişkisiz puanlarda yapar (Jombart ve ark., 2010).
- \mathbf t_i: bireyin ilk m temel bileşendeki puanları; G grup sayısı, n_g grup büyüklüğü.
- \mathbf W, \mathbf B: grup içi ve gruplar arası kovaryans; \mathbf a_k k. ayırma fonksiyonu, \delta_k özdeğeri (o eksende gruplar arası varyansın grup içi varyansa oranı; bir F istatistiği). En çok \min(G-1,\,m) fonksiyon vardır.
- P(g\mid\mathbf t_i): bireyin g grubuna sonsal üyelik olasılığı; \pi_g önsel olasılık (grup oranı). Birey, sonsal olasılığı en büyük gruba atanır.
Yeniden atama başarısı, bireylerin kendi gruplarına atanma oranıdır (grup başına ve genel). Modeli kuran bireylerle hesaplandığı için iyimserdir ve m büyüdükçe yapay olarak yükselir; ayırt etme gücünün dürüst ölçüsü çapraz doğrulamadaki başarıdır (84.4.5).
Gruplar. dapc_grup = otomatik iken popülasyon sütunu (en az iki düzeyi varsa) kullanılır; sütun yoksa, tek düzeyliyse ya da kume seçilmişse 84.4.3'te bulunan kümeler kullanılır. Bulunan kümelerle DAPC'de yeniden atama başarısı zorunlu olarak yüksektir: kümeler zaten aynı puanlardaki uzaklıklara göre kurulmuştur. Bu durumda başarı oranı yapının kanıtı değildir.
Koddaki tercih
Sabit n_pca > 0 ile adegenet::dapc(Xi, grp, n.pca = min(n_pca, n − 1, p), n.da = G − 1, center = TRUE, scale = olcekle) (satır 294). Paket ayırma analizini MASS::lda ile yapar, önsel olasılık olarak grup oranlarını alır ve bütün ayırma fonksiyonlarını tutar. n_pca = 0 iken DAPC, çapraz doğrulamanın seçtiği bileşen sayısıyla kurulur: olcekle kapalıyken çapraz doğrulama fonksiyonunun döndürdüğü nesne, açıkken şablonun aynı bileşen sayısıyla ölçekli yeniden kurduğu nesne kullanılır (282–285; 84.4.5). Sonsal tabloya her bireyin önsel grubu, atandığı grup ve en büyük sonsal olasılığı yazılır (326).
84.4.5 Temel bileşen sayısının çapraz doğrulaması
Az bileşen grupları ayıran bilgiyi atar; çok bileşen ayırma fonksiyonlarını eğitim verisinin gürültüsüne uydurur. n_pca = 0 iken sayı çapraz doğrulamayla seçilir:
- r=1,\dots,R: tekrarlar (
cv_tekrar); her tekrarda her gruptanxval_egitimoranında birey eğitime, kalanı sınamaya ayrılır. - s_{m,r}: m bileşenle eğitim kümesinde kurulan DAPC'nin sınama bireylerini doğru gruba atama oranı, grup ortalaması olarak.
- RMSE_m: başarının 1'den (kusursuz atama) uzaklığı; en küçük olduğu m seçilir, eşitlikte en büyük m.
Neden grup ortalaması ve neden rastgele şans?
Genel doğru atama oranı büyük gruplara ağırlık verir; herkesi en büyük gruba atayan bir kural bile yüksek görünebilir. Grup ortalaması her gruba eşit ağırlık verir. Başarının anlamlı olup olmadığını görmek için grup etiketleri 300 kez karıştırılır ve "rastgele atamada" aynı ölçünün ortancası ile %95 aralığı hesaplanır; G grupta beklenen değer 1/G'dir. Tablo başlığındaki bu değer, başarı sütununun karşılaştırılacağı tabandır.
Koddaki tercih
adegenet::xvalDapc(Xi, grp, n.pca.max = xval_npca_maks, training.set = xval_egitim, result = "groupMean", center = TRUE, scale = olcekle, n.pca = NULL, n.rep = cv_tekrar) (satır 296–297). Başlıktaki eğitim oranı uygulanan orandır: xval_egitim ile (n_{min}-1)/n_{min}'in küçüğü yazılır, paket oranı indirdiyse bir not eklenir (311–312). Denenen değerler bir ızgaradır: üst sınır m_{maks}=\min(\texttt{xval\_npca\_maks},\ \text{rank},\ n_{eğitim}-1) alınır, 1,\dots,m_{maks} aralığı yaklaşık on "yuvarlak" değere bölünür ve m_{maks}'tan küçük olanlar denenir. Örnek veride rank 99'dur ve denenen değerler 10, 20, …, 90'dır; 80 ile 90 arasındaki bir sayı seçilemez; seçilen en büyük değer 90'dır. Temel bileşen eksenleri bütün bireylerle bir kez hesaplanır, eğitim/sınama ayrımı yalnız ayırma analizinde yapılır. En küçük grubun büyüklüğü n_{min} ise eğitim oranı en çok (n_{min}-1)/n_{min} olabilir; daha büyük bir oran paket tarafından buna indirilir.
Ölçekleme ile çapraz doğrulama birlikte
olcekle açıkken çapraz doğrulama ölçeklenmiş sütunlarla yapılır. Paketin çapraz doğrulama fonksiyonu sonda DAPC'yi seçilen bileşen sayısıyla ölçeklenmemiş sütunlardan kurduğundan şablon bu DAPC'yi aynı bileşen sayısıyla ölçekli olarak yeniden kurar (300); yeniden atama, ayırma özdeğerleri ve sonsal tablolar ölçekli çözümlemeye aittir ve n_pca alanına aynı sayı yazılmış bir çalıştırmayla özdeştir. Örnek veride ölçek açık ve n_pca = 0 iken 30 bileşen seçilir; genel yeniden atama oranı 0,5983'tür. Ölçekli 90 bileşenli DAPC'de ilk ayırma özdeğeri 48,000 ve genel oran 0,7464'tür (n_pca = 90); ölçeksiz 90 bileşenli DAPC'de 48,130 ve 0,7578.
84.4.6 sNMF: soy katsayıları ve çapraz entropi
sNMF (Frichot ve ark., 2014), her genotipi atasal popülasyonların genotip frekanslarının karışımı olarak yazar:
- q_{ik}: i. bireyin k. atasal popülasyondan gelen soy payı (Q matrisi); g_{kj}(c): k. atasal popülasyonda j. sütunda c genotipinin frekansı (G matrisi).
- \mathcal M: çalıştırmadan önce gizlenen (maskelenen) genotipler; hücrelerin %5'i.
- CE_K: çapraz entropi; modelin gizlenen genotiplere verdiği olasılığın eksi logaritmasının ortalaması. Küçük olan iyidir.
Q ve G, gözlenen genotip gösterge matrisine en küçük kareler anlamında en yakın, negatif olmayan çarpanlar olarak bulunur; snmf_alfa Q'nun seyrekliğini artıran düzenlileştirmedir. Olabilirlik eniyilemesi yapılmaz; yöntem bu yüzden hızlıdır ve Hardy–Weinberg dengesini varsaymaz.
Neden çapraz entropi ve neden birden çok çalıştırma?
K büyüdükçe model veriye her zaman daha iyi uyar; uyumun kendisi K'yı seçemez. Gizlenen genotiplerin öngörüsü ise fazla K'da kötüleşir. Çarpanlara ayırma rastgele başlangıçtan yinelemeyle çözülür ve farklı başlangıçlar farklı çözümlere varabilir; her K için snmf_tekrar çalıştırma yapılır, ölçüt ortalamayla, Q matrisi en küçük çapraz entropili çalıştırmayla verilir.
Koddaki tercih
Girdi tablosu: çok alelli lokusların her aleli ayrı bir 0/1/2 sütunu, iki alelli lokusların tek sütunu (ikinci alel) olur (satır 190, 349). LEA::snmf(dosya, K = 1:min(K_maks, n − 1), entropy = TRUE, repetitions, project = "new", seed, CPU = 1, alpha, iterations, tolerance) (362–363). Her çalıştırma (tekrar) kendi tohumunu ve kendi maskesini alır; aynı tekrarın bütün K değerleri aynı maskeyi paylaşır. Seçilen K, ortalama çapraz entropisi en küçük olandır (368). Şablon ayrıca en iyi K'daki çalıştırmalar arası standart hatayı hesaplar; ortalaması en küçük değerden bu kadar bile ayrılmayan başka K'lar varsa "K seçimi belirsizdir" notunu yazar ve bu K'ları sıralar (370–376). Paketin ilerleme çıktısı yakalanır ve gösterilmez; bir çalıştırmanın yineleme sınırına ulaşıp ulaşmadığı çıktıda yer almaz. Geçici dosyalar oturumun geçici klasöründe açılır ve silinir (355, 413).
Mikrosatellitlerde her alelin ayrı bir "SNP" gibi verilmesi, aynı lokusun alelleri arasındaki bağımlılığı (toplamları 2'dir) yok sayar; sNMF bu veride kaba bir yaklaşımdır ve asıl kullanım alanı çok sayıda iki alelli SNP'dir.
Tohum. Kümeleme, çapraz doğrulama ve sNMF rastgele sayı kullanır. Şablon formunda tohum alanı yoktur; tohum Kod panelindeki Tohum alanından verilir (Bölüm 1.3). Alan boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar; kullanılan tohumu künyeye yazar ve betik adımına kaydeder; betik yeniden oynatıldığında aynı tohum kullanılır ve aynı sonuç çıkar (Bölüm 57). sNMF'nin tohumu bu akıştan çekilen bir sayıdır (359). Zayıf yapılı veride seçilen K ve bileşen sayısı tohumdan tohuma değişir (84.6, 84.8). Bu bölümdeki sayılar, yürütücüye sabit tohum (2026) verilerek üretilmiştir.
84.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–159 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on sekiz parametre. | Form buradan kurulur (Bölüm 1.2). |
| 160–165 | .m() ileti seçici; ortak genotip ayrıştırıcısı. |
Eksik sayılan yazımlar 150. satırdadır. |
| 167–178 | Parametreler; popülasyon sütunu metne çevrilir, boşlar eksik sayılır. | |
| 180–209 | Alel sayıları tablosu; tek biçimli lokusların, genotipsiz ve popülasyonsuz bireylerin atılması; ortalamayla doldurma; konsol özeti. | Doldurulmuş tablo Xi, eksikli tablo X (sNMF için) ayrı tutulur. |
| 210–232 | Renkler; TBA, iki tablo ve TB1–TB2 grafiği. | En çok 8 grupta Okabe–Ito, daha çoğunda viridis renkleri; 20'den çok grupta lejant çizilmez. |
| 234–276 | find.clusters; BIC tablosu; üç ölçütün K'sı; popülasyon × küme çapraz tablosu; BIC grafiği. |
Hata olursa not yazılır ve DAPC popülasyon sütunuyla sürer (240). |
| 277–345 | DAPC grupları; sabit ya da çapraz doğrulamalı bileşen sayısı; çapraz doğrulama, yeniden atama, özdeğer ve sonsal tabloları; saçılım grafiği. | Tek ayırma fonksiyonu varsa yoğunluk grafiği çizilir (337–343). |
| 347–415 | sNMF: girdi dosyası, çalıştırmalar, çapraz entropi tablosu ve grafiği, Q tablosu ve soy çubuk grafiği. | Çubuk grafikte bireyler popülasyona, popülasyon içinde baskın soya göre sıralanır (394). |
84.6 Elle hesap: örnek veride bağımsız yeniden hesap
Python tarafında (dogrulama/populasyon_yapisi/elle_hesap.py) alel tablosu kendi ayrıştırıcısıyla kurulmuş, TBA tekil değer ayrışımıyla, ayırma analizi 84.4.4'teki genelleştirilmiş özdeğer problemiyle ve sonsal olasılıklar açık formülle hesaplanmıştır. R tarafında (r_dogrulama.R) TBA prcomp, BIC kmeans ve açık formül, ayırma analizi MASS::lda ile kurulmuş; ayrıca bağımsız bir çapraz doğrulama döngüsü yazılmıştır. ade4, adegenet ve LEA kullanılmamıştır.
Adım 1 — Alel sayıları. KCHB_01 ağacının NFF3 genotipi 105/105'tir: NFF3.105 sütununda 2, lokusun öteki üç sütununda 0. Sütun ortalaması 1{,}6638'dir (alel frekansı 0{,}8319'un iki katı). SFb5'te genotipi eksik 55 ağacın üç SFb5 sütununa sütun ortalamaları yazılır. Tablo 351\times109'dur.
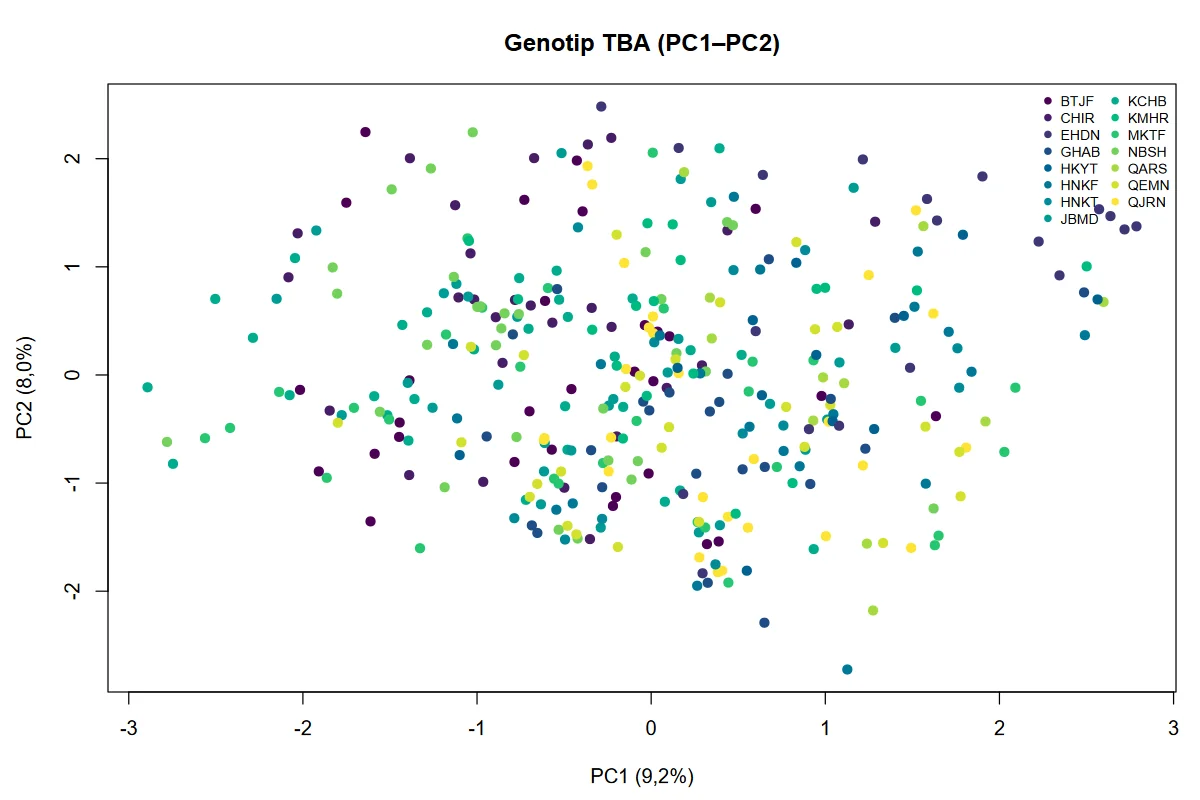
Adım 2 — TBA. Toplam varyans \sum_j\lambda_j=13{,}296013; sıfırdan farklı 99 özdeğer vardır (109 sütun, 10 lokusun her biri bir doğrusal bağımlılık getirir). İlk üç özdeğer 1{,}227315; 1{,}061263; 1{,}042347:
İlk on eksen birlikte %58,69'u açıklar; tek bir baskın eksen yoktur.
Adım 3 — BIC, K=1 ve K=2.
K=2'de k-ortalamalar küme içi kareler toplamını 4666{,}90'dan 4378{,}57'ye indirir; BIC_2=351\ln(4378{,}57/351)+2\ln351=897{,}5370.
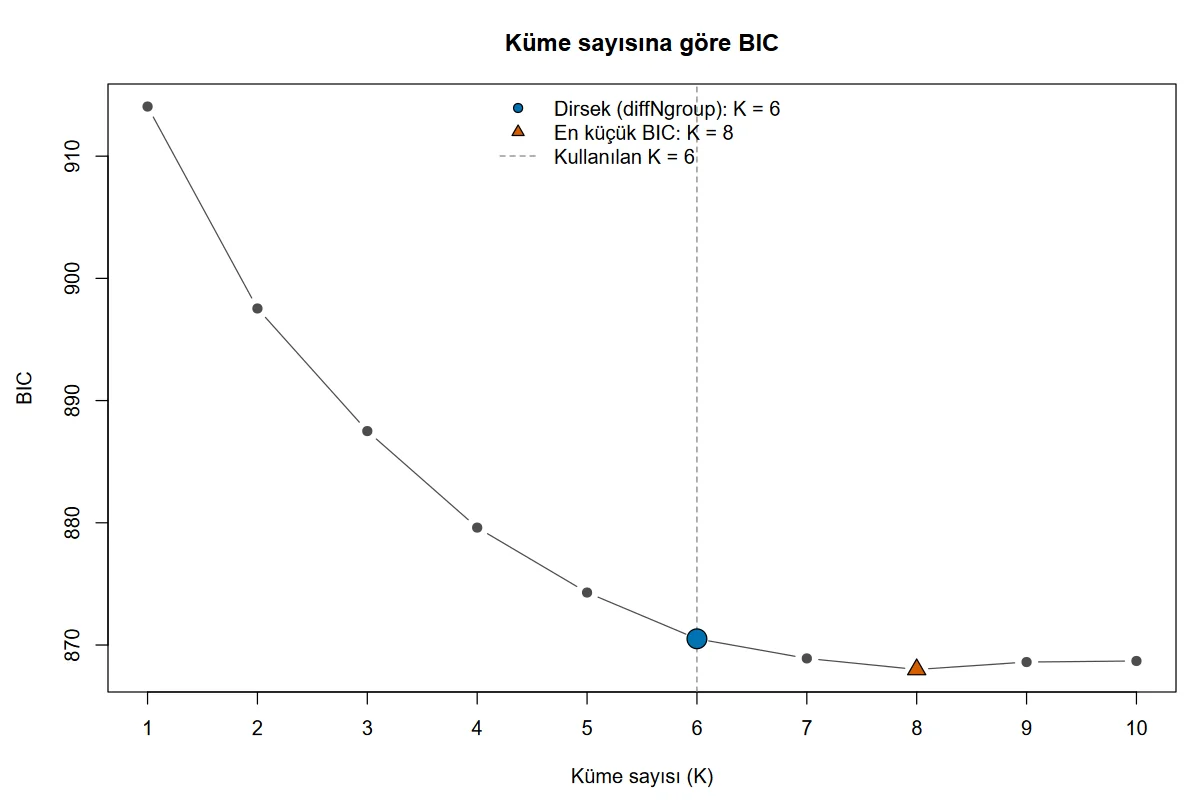
Adım 4 — Ölçüt kuralları. Şablonun BIC eğrisi (tohum 2026, 100 başlangıç): 914,06; 897,54; 887,50; 879,61; 874,29; 870,51; 868,90; 868,00; 868,61; 868,69. Ardışık farklar: -16{,}52; -10{,}03; -7{,}90; -5{,}31; -3{,}78; -1{,}60; -0{,}91; 0{,}61; 0{,}09. Ward kümelemesi farkları ilk beş (ortalama -8{,}71) ve son dört olarak ayırır; "büyük düşüşler" grubunun son farkı beşincidir ve K=6'ya varır: dirsek K=6. En küçük değer sekizincidir: K=8. İyi uyum eşiği 867{,}9985+0{,}1\cdot46{,}06=872{,}60; altına inen ilk değer K=6 (870{,}51), bir eksiği K=5.
Adım 5 — k-ortalamaların kararlılığı. K\ge3 için BIC değerleri rastgele başlangıçlara bağlıdır. R'de 200 başlangıçla bulunan en iyi değerler: 887,505; 879,607; 874,294; 870,509; 868,903; 868,170; 868,556; 868,637 (K=3,\dots,10). Şablonun 100 başlangıçlı eğrisi K=3–6 için bu değerlerle aynıdır (887,505; 879,607; 874,294; 870,509) ve K=8'de 867,999 ile 200 başlangıçlı değerden bile küçüktür; 10 başlangıçla K=3'te 0,14, K=8'de 1,35 daha yüksek değerler çıkıyor ve en küçük BIC K=10'a kayıyordu. 100 başlangıçla dört çalıştırmada (tohum 2026, 7, 11 ve satırları karıştırılmış kopya) dirsek 6, en küçük BIC 8, iyi uyum 5 çıkmıştır.
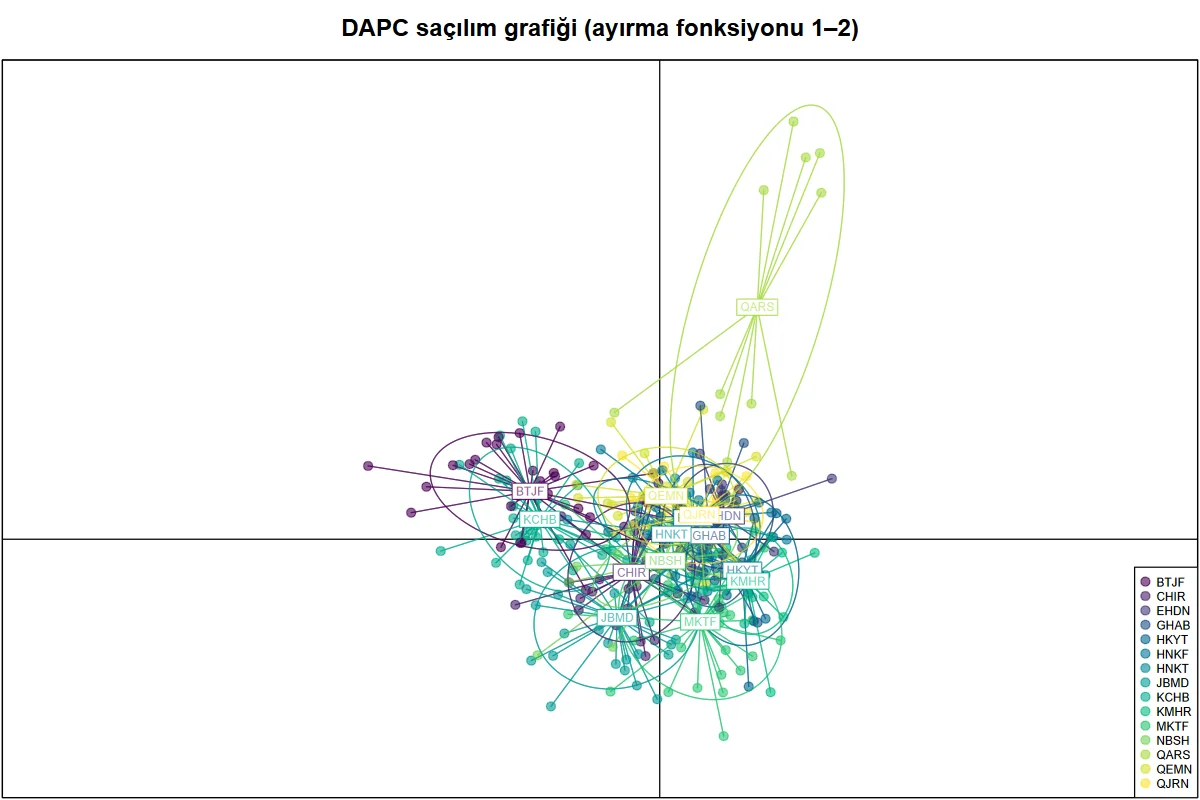
Adım 6 — DAPC, 80 bileşen (n_pca = 80), gruplar popülasyon. İlk üç ayırma özdeğeri 44{,}6077; 34{,}8227; 30{,}1954 (toplamın %16,9; %13,2; %11,4'ü). 351 ağacın 260'ı kendi popülasyonuna atanır: genel oran 0{,}7407. Popülasyon başına oran 0,567 (JBMD) ile 0,917 (HKYT) arasındadır. KCHB_09 için en büyük sonsal olasılık 0{,}4651'dir: ağaç kendi popülasyonuna atanır, ama atama zayıftır; 19 ağaçta en büyük sonsal olasılık 0,5'in altındadır.
Adım 7 — Çapraz doğrulama. Şablonun rastgele bölmeleri bağımsız hesapla yinelenmemiş, onun yerine R'de ayrı bir döngü yazılmıştır (her popülasyondan %90 eğitim, 200 tekrar, temel bileşenler yalnız eğitim bireyleriyle). Ortalama sınama başarısı: 10 bileşende 0,254; 30 bileşende 0,330; 80 bileşende 0,415 (standart hata 0,006). Şablonun değerleri (30 tekrar) 0,250; 0,347 ve 0,402'dir ve Monte Carlo oynaması içinde aynıdır (şablon 90 bileşeni seçer: 0,403; 80 ile fark oynama içindedir). Rastgele şans: 2000 karıştırmayla ortanca 0,0657 (%95 aralık 0,0415–0,0946); şablon 300 karıştırmayla 0,0656 (0,0432–0,0933) verir; beklenen değer 1/15=0{,}0667'dir.
Adım 8 — Belirgin yapıda denetim. Üç adalı yapay SNP verisinde (ada başına 40 birey, 40 SNP) ilk iki özdeğer 8,767 ve 6,705, üçüncüsü 1,550'dir; BIC K=3'te en küçüktür (403,79) ve üç ölçütten ikisi K=3 verir (iyi uyum kuralı tanımı gereği 2). Bulunan kümeler adalarla birebir örtüşür; çapraz doğrulama bütün bileşen sayılarında kusursuzdur; sNMF K=3 seçer ve her bireyin baskın soyu kendi adasıdır (120/120). İki ayrı tohum aynı K'yı verir.
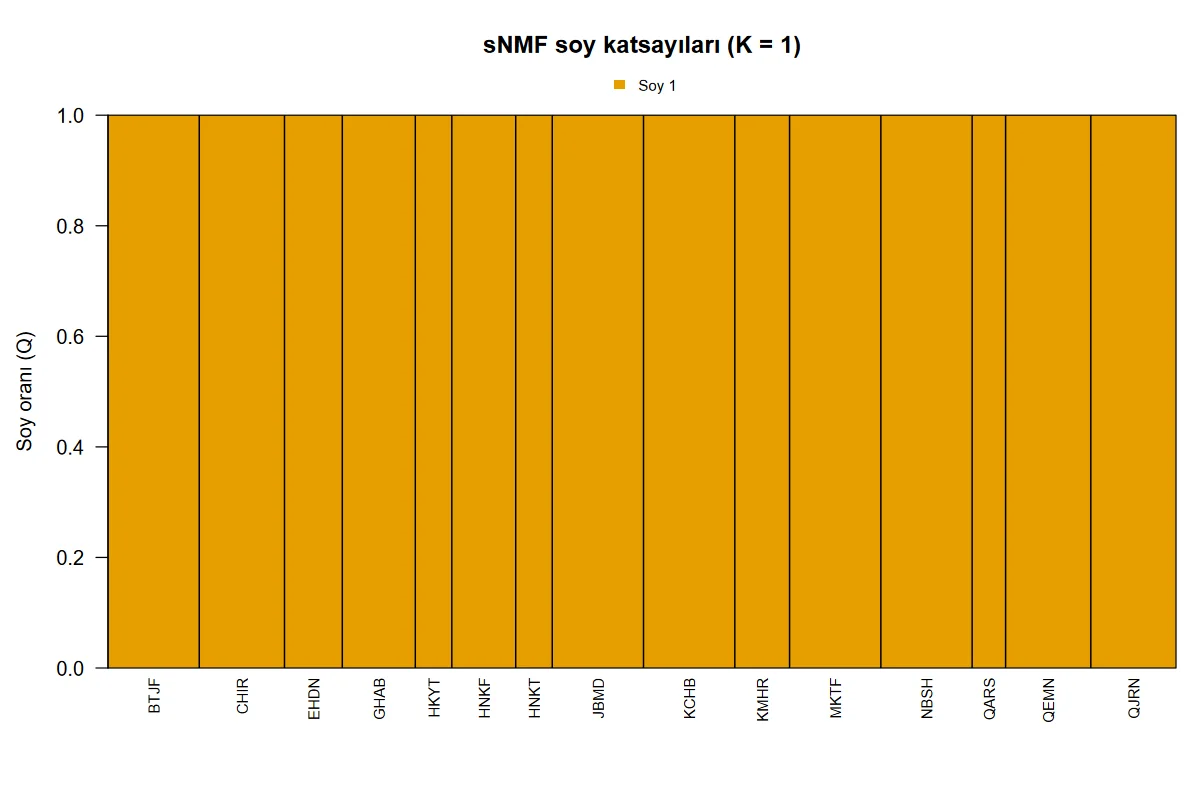
Adım 9 — sNMF. Q matrisi bağımsız bir uygulamayla yeniden hesaplanmamıştır: sNMF'nin çözümü başlangıca bağlıdır ve makinede eşdeğer ikinci bir uygulama yoktur. Denetlenenler: Q'nun satır toplamları 1'dir (en büyük sapma 5\cdot10^{-7}; değerler altı ondalıkla yazılır); seçilen K tablodaki en küçük ortalamadır; yapay veride soy katsayıları bilinen yapıyı geri verir (Adım 8). Örnek veride ortalama çapraz entropi K=1'de 0,3118, K=2'de 0,3144'tür; fark çalıştırmalar arası standart hatadan (0,0075) küçüktür ve en küçük ortalama K=1'dedir.
84.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle okunmuştur (çalıştırmalar 1, 2, 4, 5, 8, 9, 11 ve 13). "Ölçüt kuralı" satırlarında kural, şablonun yazdığı BIC eğrisine bağımsız kodla uygulanmıştır.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| TBA özdeğeri 1 | 1,22731507 | 1,22731507 | 1,22731507 | 5,1e−15 | ✓ |
| TBA özdeğeri 2 | 1,06126315 | 1,06126315 | 1,06126315 | 3,3e−15 | ✓ |
| TBA özdeğeri 3 | 1,04234712 | 1,04234712 | 1,04234712 | 3,4e−15 | ✓ |
| TBA özdeğeri 4 | 0,88395456 | 0,88395456 | 0,88395456 | 3,3e−16 | ✓ |
| TBA özdeğeri 5 | 0,71234784 | 0,71234784 | 0,71234784 | 1,0e−15 | ✓ |
| TB1 varyans yüzdesi | 9,23070032 | 9,23070032 | 9,23070032 | 1,2e−15 | ✓ |
| İlk 10 eksen birikimli yüzde | 58,68995209 | 58,68995209 | 58,68995209 | 1,7e−15 | ✓ |
| KCHB_01: | TB1 puanı | 0,71933663 | 0,71933663 | 0,71933663 | |
| KCHB_01: | TB2 puanı | 1,15488298 | 1,15488298 | 1,15488298 | |
| EHDN_19: | TB1 puanı | 0,90623754 | 0,90623754 | 0,90623754 | |
| EHDN_19: | TB2 puanı | 0,50145557 | 0,50145557 | 0,50145557 | |
| BIC, K=1 | 914,0607141 | 914,0607141 | 914,0607141 | 0 | ✓ |
| BIC, K=2 | 897,53696437 | — | 897,53696437 | 0 | ✓ |
| Ölçüt kuralı (örnek): dirsek K | 6 | 6 | — | 0 | ✓ |
| Ölçüt kuralı (örnek): en küçük BIC K | 8 | 8 | — | 0 | ✓ |
| Ölçüt kuralı (örnek): iyi uyum K | 5 | 5 | — | 0 | ✓ |
| Ölçüt kuralı (tohum 7): dirsek K | 6 | 6 | — | 0 | ✓ |
| Ölçüt kuralı (tohum 7): en küçük BIC K | 8 | 8 | — | 0 | ✓ |
| Ölçüt kuralı (tohum 7): iyi uyum K | 5 | 5 | — | 0 | ✓ |
| Ölçüt kuralı (ölçekli): dirsek K | 2 | 2 | — | 0 | ✓ |
| Ölçüt kuralı (ölçekli): en küçük BIC K | 2 | 2 | — | 0 | ✓ |
| Ölçüt kuralı (ölçekli): iyi uyum K | 1 | 1 | — | 0 | ✓ |
| DAPC 80 TB: genel yeniden atama oranı | 0,74074074 | 0,74074074 | 0,74074074 | 3,3e−16 | ✓ |
| DAPC 80 TB: BTJF atama başarısı | 0,73333333 | 0,73333333 | 0,73333333 | 3,3e−16 | ✓ |
| DAPC 80 TB: QARS atama başarısı | 0,63636364 | 0,63636364 | 0,63636364 | 3,3e−16 | ✓ |
| DAPC 80 TB: ayırma özdeğeri 1 | 44,60774998 | 44,60774998 | 44,60774998 | 1,3e−14 | ✓ |
| DAPC 80 TB: ayırma özdeğeri 2 | 34,82273801 | 34,82273801 | 34,82273801 | 8,2e−16 | ✓ |
| DAPC 80 TB: ayırma özdeğeri 3 | 30,19535834 | 30,19535834 | 30,19535834 | 2,2e−15 | ✓ |
| DAPC 80 TB: ayırma özdeğeri 14 | 4,61103373 | 4,61103373 | 4,61103373 | 6,0e−15 | ✓ |
| DAPC 80 TB: KCHB_01 en büyük sonsal | 0,94583196 | 0,94583196 | 0,94583196 | 1,1e−14 | ✓ |
| DAPC 80 TB: KCHB_09 en büyük sonsal | 0,46513864 | 0,46513864 | 0,46513864 | 4,6e−14 | ✓ |
| DAPC 80 TB: KCHB_17 en büyük sonsal | 0,49372603 | 0,49372603 | 0,49372603 | 9,4e−14 | ✓ |
| DAPC 30 TB: genel yeniden atama oranı | 0,56125356 | 0,56125356 | 0,56125356 | 3,3e−16 | ✓ |
| DAPC 30 TB: GHAB atama başarısı | 0,375 | 0,375 | 0,375 | 0 | ✓ |
| DAPC 30 TB: ayırma özdeğeri 1 | 25,61078473 | 25,61078473 | 25,61078473 | 4,9e−15 | ✓ |
| DAPC 80 TB (tohum 7): genel yeniden atama oranı | 0,74074074 | 0,74074074 | 0,74074074 | 3,3e−16 | ✓ |
| DAPC 80 TB (tohum 7): ayırma özdeğeri 1 | 44,60774998 | 44,60774998 | 44,60774998 | 1,3e−14 | ✓ |
| Bulunan 6 küme, 30 TB: genel yeniden atama oranı | 0,96581197 | 0,96581197 | — | 0 | ✓ |
| Bulunan 6 küme, 30 TB: ayırma özdeğeri 1 | 137,18388729 | 137,18388729 | — | 2,1e−15 | ✓ |
| Ölçekli: BIC, K=1 | 1652,52389289 | 1652,52389289 | 1652,52389289 | 3,0e−15 | ✓ |
| Ölçekli DAPC, 80 TB sabit: genel yeniden atama oranı | 0,70940171 | 0,70940171 | 0,70940171 | 4,4e−16 | ✓ |
| Ölçekli DAPC, 80 TB sabit: ayırma özdeğeri 1 | 45,82091529 | 45,82091529 | 45,82091529 | 6,2e−16 | ✓ |
| Ölçek açık + çapraz doğrulama (30 TB seçildi): özdeğer 1 (ölçekli DAPC) | 27,37526989 | 27,37526989 | — | 1,2e−15 | ✓ |
| SNP verisi: TBA özdeğeri 1 | 8,76668843 | 8,76668843 | 8,76668843 | 2,2e−15 | ✓ |
| SNP verisi: BIC, K=1 | 447,19942512 | 447,19942512 | 447,19942512 | 1,0e−15 | ✓ |
| SNP verisi: BIC, K=3 | 403,78954725 | — | 403,78954725 | 0 | ✓ |
| SNP verisi: dirsek K | 3 | 3 | 3 | 0 | ✓ |
| SNP verisi, DAPC 35 TB: genel yeniden atama oranı | 1 | 1 | 1 | 0 | ✓ |
| SNP verisi, DAPC 35 TB: ayırma özdeğeri 1 | 1343,56070768 | 1343,56070768 | 1343,56070768 | 3,9e−15 | ✓ |
| SNP verisi, DAPC 35 TB: ayırma özdeğeri 2 | 1020,20267535 | 1020,20267535 | 1020,20267535 | 3,1e−15 | ✓ |
Ölçütü karşılayan: 50/50. Python: tekil değer ayrışımı, genelleştirilmiş özdeğer problemiyle doğrusal ayırma analizi, ölçüt kuralları şablonun BIC eğrisine açık kuralla uygulanarak. R: prcomp, kmeans + BIC formülü, MASS::lda. K\ge3 için BIC, k-ortalamaların rastgele başlangıçlarına bağlı olduğundan tabloya alınmamıştır (84.6).
Tabloya girmeyenler: K\ge3 için BIC değerleri (k-ortalamaların rastgele başlangıçlarına ve kayan nokta ayrıntısına bağlıdır; Adım 5; ölçüt kuralları tabloda şablonun yazdığı eğriye uygulanır), çapraz doğrulama başarıları ve rastgele şans aralığı (Adım 7) ile sNMF çıktıları (Adım 9). Bunlar tohumdan bağımsız olarak 10^{-6} duyarlıkla yinelenemez; karşılaştırmaları yukarıdaki adımlarda Monte Carlo oynaması içinde yapılmıştır.
84.7 Çıktıyı okuma
Örnek ayarın konsol metni:
Genotip okuma: 10 lokusta 3510 genotipin 72 tanesi eksik sayıldı (boş hücre: 72; eksik kodu: 0;
alellerinden yalnız biri eksik kodu: 0; başka neden: 0).
Popülasyon yapısı: 351 birey, 10 lokus, 109 alel sütunu (eksik genotip oranı %2,1; alel ortalamasıyla
dolduruldu)
Not: BIC eğrisinin dirseği K = 6, en küçük BIC K = 8 veriyor; eğri düzse aradaki çözümleri birlikte
yorumlayın.
Not: K = 1, 2 için ortalama çapraz entropiler en küçük değerden, çalıştırmalar arası standart
hatadan (0,0075) daha az farklı; K seçimi belirsizdir ve rastgele tohuma göre değişebilir. Bu K
değerlerini birlikte yorumlayın (tutumluluk için en küçüğü: K = 1).
Tablolar (kısaltılmış: ilk satırlar, yuvarlanmış sayılar; tablolarda tam hassasiyet saklanır):
Genotip TBA özdeğerleri (merkezlenmiş alel sayıları; bölen n)
 eksen   ozdeger  varyans_yuzde  birikimli_yuzde
     1  1.227315         9.2307           9.2307
     2  1.061263         7.9818          17.2125
     3  1.042347         7.8395          25.0521
     …
k-ortalamalar ve BIC (find.clusters; 100 rastgele başlangıç; ölçüt: diffNgroup; seçilen K = 6)
  K       BIC  secilen
  1  914.0607
  2  897.5370
  3  887.5048
  4  879.6073
  5  874.2937
  6  870.5087        *
  7  868.9039
  8  867.9985
  9  868.6069
 10  868.6940

Küme sayısı ölçütlerine göre K (aynı BIC eğrisi)
                              olcut         kod   K       BIC  kullanilan
 BIC eğrisinin dirseği (diffNgroup)  diffNgroup   6  870.5087           *
                       En küçük BIC         min   8  867.9985
                 İyi uyum (goodfit)     goodfit   5  874.2937
DAPC çapraz doğrulaması (xvalDapc; eğitim %90, 30 tekrar; rastgele şans ortancası 0,0656
[0,0432; 0,0933])
 n_pca  ortalama_basari    RMSE  secilen
    10           0.2496  0.7533
    30           0.3474  0.6564
    50           0.3648  0.6430
    70           0.3904  0.6153
    80           0.4019  0.6028
    90           0.4026  0.6018        *
DAPC yeniden atama başarısı (gruplar: popülasyon; 90 TB, 14 ayırma fonksiyonu; genel oran 0,7578)
 grup   n  atama_basarisi
 BTJF  30          0.8000
 CHIR  28          0.7500
 EHDN  19          0.8947
 …

sNMF çapraz entropi ölçütü (5 çalıştırma/K; seçilen K = 1)
  K  ortalama_capraz_entropi  en_kucuk  en_buyuk  secilen
  1                   0.3118    0.2977    0.3380        *
  2                   0.3144    0.2967    0.3449
  3                   0.3210    0.2936    0.3496
  …
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| TBA özdeğerleri; birey puanları | İlk 20 eksenin özdeğeri ve yüzdeleri; ilk üç eksende puanlar | Belirgin yapıda ilk bir iki özdeğer ötekilerden kopar (yapay veride 8,8 ve 6,7'ye karşı 1,5). Örnekte özdeğerler yavaşça azalır: baskın bir eksen yoktur. |
| BIC tablosu; ölçüt tablosu | Her K için BIC; üç kuralın K'sı ve kullanılan | Üç kural aynı K'da buluşuyorsa seçim sağlamdır. Örnekte 5, 6 ve 8: eğri K=6'dan sonra düzdür. |
| Popülasyon × küme tablosu | Her popülasyonun bireylerinin kümelere dağılımı | Popülasyonlar kümelerle örtüşmüyorsa (örnekte her popülasyon 4–6 kümeye dağılır) kümeler örnekleme birimlerini yansıtmaz. |
| Çapraz doğrulama tablosu | Denenen bileşen sayılarında sınama başarısı ve RMSE | Başarı, başlıktaki rastgele şansla karşılaştırılır: 0,403'e karşı 0,066. |
| Yeniden atama; ayırma özdeğerleri; sonsal üyelik | Grup başına ve genel doğru atama; her fonksiyonun özdeğeri ve payı; her bireyin atanması | Genel oran (0,758) çapraz doğrulama başarısından (0,403) çok yüksektir; fark aşırı uyumun ölçüsüdür. |
| sNMF çapraz entropi; Q tablosu | Her K için ortalama, en küçük, en büyük; her bireyin soy payları | Ortalama eğrisi düzse ve aralıklar örtüşüyorsa K seçilemez; şablon bunu not olarak yazar. |
| Şekiller | TB1–TB2 saçılımı; BIC eğrisi; DAPC saçılımı; çapraz entropi eğrisi; soy çubuk grafiği | Aşağıda. |
Şekil 84.1. Şablonun çizdiği genotip TBA grafiği (örnek veri). Popülasyonlar iç içedir; ayrı bulutlar oluşmaz.
Şekil 84.2. Küme sayısına göre BIC. Mavi daire dirsek kuralının, turuncu üçgen en küçük BIC'in seçtiği K'dır; eğri K=6 civarında düzleşir; en küçük BIC K=8'dedir.
Şekil 84.3. DAPC saçılım grafiği (90 temel bileşen, gruplar popülasyon). Gruplar önceden verildiğinde ayırma fonksiyonları onları en iyi ayıran yönleri arar; grafik, TBA'dakinden daha ayrışmış görünür.
Şekil 84.4. sNMF soy katsayıları, örnek veri (seçilen K=1): tek atasal grup vardır, bütün çubuklar tek renklidir; yapı zayıf olduğundan çapraz entropi K=1 ile K=2 arasında ayırt edilemez.
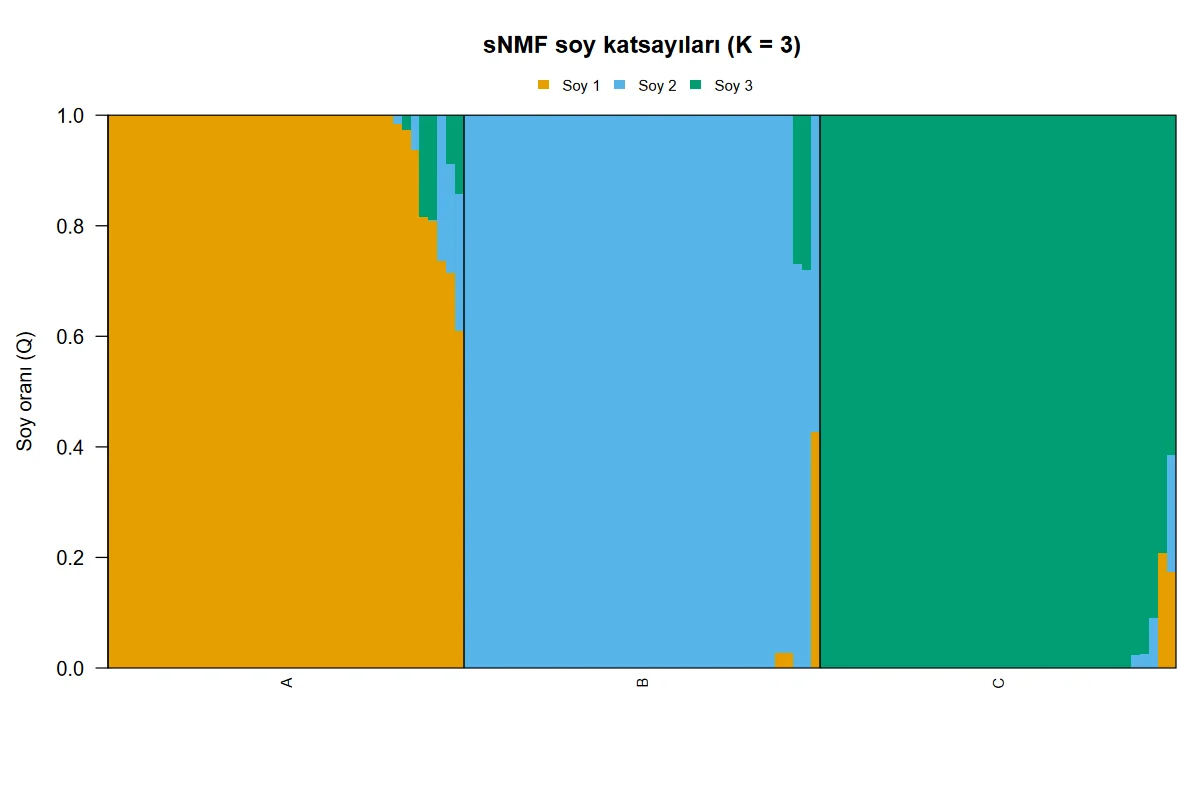
Şekil 84.5. Aynı grafik, üç adalı yapay SNP verisinde (K=3): her ada tek bir renge karşılık gelir.
Rapor cümlesi (örnek ayar):
On mikrosatellit lokusunun alel sayıları tablosunda (351 ağaç, 109 alel) ilk iki temel bileşen varyansın %9,2 ve %8,0'ını açıkladı; belirgin bir kümelenme görülmedi. k-ortalamalar ve BIC ile küme sayısı kararsızdı (dirsek ölçütü K = 6, en küçük BIC K = 8) ve kümeler örnekleme popülasyonlarıyla örtüşmedi. Popülasyonlar grup alınarak yapılan DAPC'de çapraz doğrulamayla 90 temel bileşen seçildi; sınama bireylerinin %40'ı doğru popülasyona atandı (rastgele atamada ortanca %6,6), yeniden atama oranı %76'ydı. sNMF'de çapraz entropi K = 1 ile K = 2 arasında ayırt edilemedi. Bulgular, popülasyonlar arasında zayıf ama rastlantının üstünde bir farklılaşmayla uyumludur.
84.8 Sık hatalar ve tuzaklar
- Tek çalıştırmanın sonucunu raporlamak. Zayıf yapıda çapraz doğrulamanın bileşen sayısı ve sNMF'nin K'sı tohuma bağlıdır. Örnek veride 100 başlangıçla dört çalıştırmada (tohum 2026, 7, 11 ve satırları karıştırılmış kopya) k-ortalamalarda dirsek 6, en küçük BIC 8 ve iyi uyum 5 değişmemiştir; çapraz doğrulama 90, 80, 90 ve 80 bileşen seçmiştir; sNMF dördünde de K=1 vermiştir, ama K=2 ile ayırt edilemez. Şablon en az üç kez çalıştırılır;
cv_tekrar100'e,snmf_tekrar10–20'ye çıkarılır ve değişmeyen sonuç raporlanır.fc_n_startvarsayılan 100'dür; 10'a indirilirse BIC değerleri (K\ge3) tohuma göre oynar ve en küçük BIC'in K'sı değişebilir. - Dirsek ölçütünün her zaman bir K verdiğini unutmak. Varsayılan ölçüt en az 2 küme döndürür.
olcekleaçıkken örnek verinin BIC eğrisi K=2'den sonra sürekli yükselir (1652,5; 1651,7; 1652,0; …; 1660,7); dirsek K=2, en küçük BIC K=2, iyi uyum K=1 verir. Dirsek K=1'in BIC'inden küçük olmayan bir K seçerse şablon "BIC kümelenmeyi desteklemiyor" notu yazar (259–260); not görüldüğünde bulunan kümeler yalnız betimleyici yorumlanır. - Yeniden atama oranını ayırt etme gücü sanmak. Oran, modeli kuran bireylerle hesaplanır: 30 bileşenle 0,561, 80 bileşenle 0,741, 90 bileşenle 0,758. Aynı bileşen sayılarında sınama başarısı 0,335; 0,424 ve 0,374'tür. Raporlanacak sayı çapraz doğrulama başarısıdır.
- Bulunan kümelerle DAPC'yi kanıt saymak. Kümeler aynı veriden k-ortalamalarla kurulduğunda DAPC onları neredeyse kusursuz geri atar (örnekte altı kümeyle 0,966; sekiz kümeyle 0,977). Bu, yapının varlığını göstermez; rastgele veride de olur.
- Ölçekleme açıkken bileşen sayısını ölçeksiz seçilmiş sanmak. Bileşen sayısı ölçekli sütunlarla çapraz doğrulanır ve DAPC aynı sayıyla ölçekli kurulur (84.4.5); ölçekli ve ölçeksiz seçilen bileşen sayıları farklı olabilir (örnekte 30 ve 90).
- Çapraz doğrulama tablosunun başlığındaki eğitim oranı. Başlık uygulanan oranı yazar (
xval_egitim = 0,7iken "eğitim %70"); en küçük grup küçükse paket oranı (n_{min}-1)/n_{min}'e indirir ve bir not bunu söyler. - Eksik genotipi
-9ile kodlamak.-9/-9ve-9eksik genotip sayılır; örnek verinin eksikleri böyle kodlandığında sonuçlar boş hücreyle özdeştir (109 alel sütunu, ilk özdeğer 1,2273, dirsek K=6) ve döküm "eksik kodu: 72" yazar. Başka bir eksik kodu (ör.999) gerçek alel sayılır; eksikler boş bırakılır ya daNAyazılır. - Alel adı olarak 0 kullanmak.
0eksik kodudur; alellerinden yalnız biri0olan genotip (0/143) çalıştırmayı durdurur ve iletide kaç genotipin bu durumda olduğu yazılır (NFF3'ün en sık aleli 0 diye adlandırıldığında 100 genotip). Gerçek bir alel0adını taşıyorsa başka bir adla yeniden kodlanır (Bölüm 71.8). - 0/1/2 kodlu SNP sütununun türü. Sayısal kodlama yalnız sütun veri sekmesinde "sayısal" türdeyken tanınır; "kategorik" yapılmışsa "ayırıcı içermeyen genotip" iletisiyle durur.
- Çok eksikli bireyleri merkezde ayrı bir grup sanmak. Ortalamayla doldurma, eksikleri çok olan bireyleri TBA'nın merkezine çeker ve k-ortalamalar onları bir araya toplayabilir.
- Akraba bireyleri ve dengesiz örneklemi unutmak. Aynı ailenin dölleri kendi kümesini kurar; büyük gruplar ayırma fonksiyonlarını ve önsel olasılıkları kendine çeker. Uzaklıkla yalıtım altındaki kesintisiz değişim de kümeleme yöntemlerinde yapay sınırlar üretir.
- Küme ve soy numaralarını çalıştırmalar arasında eşleştirmek. Numaralar ve renkler keyfidir; iki çalıştırmada "küme 1" aynı grup değildir.
- Birey kimliği sütununu seçmemek. Alan boşken birey adları yalnız sütunun adı
bireyise okunur; başka adlı kimlik sütunu için "Birey kimliği sütunu" alanını doldurun, yoksa tablolarda satır numarası görünür.
84.9 Uzman soruları
S1. Bu BIC, model seçimindeki olağan BIC ile aynı mı?
Biçimi aynıdır, kuramsal dayanağı daha zayıftır. Olağan BIC -2\ln L+q\ln n'dir. Burada n\ln(WSS/n), küresel ve eşit varyanslı normal kümeler varsayımıyla olabilirliğin yerine geçer; ceza teriminde ise parametre sayısı olarak yalnız K alınır (küme merkezlerinin boyutu sayılmaz). Sonuç, mutlak değeri yorumlanamayan ama K'lar arasında karşılaştırılabilen bir göstergedir. Jombart ve ark. (2010) benzetimlerde eğrinin dirseğinin gerçek küme sayısını iyi yakaladığını, en küçük değerin fazla küme seçmeye yatkın olduğunu göstermiştir.
S2. Kümeleme neden bütün temel bileşenlerle, DAPC neden daha azıyla yapılıyor?
Kümelemede bütün bileşenler tutulduğunda puanlar arasındaki Öklid uzaklıkları özgün tablodakilerle aynıdır; indirgeme yalnız hesabı kolaylaştırır, bilgi atmaz. Ayırma analizinde ise her ek bileşen, grup içi kovaryans matrisinin tersinde kestirilecek yeni öğeler demektir; grup büyüklüklerine yaklaşan bileşen sayısında fonksiyonlar gürültüye uyar. Örnekte en küçük popülasyon 11 ağaçtır ve 80 bileşen seçilmiştir: yeniden atama ile sınama başarısı arasındaki fark (0,74 ve 0,42) bunun bedelidir.
S3. Çapraz doğrulama neden 90 seçti; 85 daha iyi olabilir mi?
Olabilir, ama denenmedi: paket yalnız 10, 20, …, 90'ı sınar. RMSE 70'te 0,615, 80'de 0,603, 90'da 0,602'dir; 80 ile 90 arasındaki fark 30 tekrarın Monte Carlo oynamasından küçüktür ve başka iki çalıştırmada 80 seçilmiştir. Belirli bir aralık daha ince taranacaksa n_pca ile sabit değerler denenir; ancak sabit değerde çapraz doğrulama tablosu yazılmaz. Pratikte 80 ile 90 arasındaki seçim sonucu çok değiştirmez (yeniden atama 0,741 ve 0,758).
S4. Önsel olasılıklar neden grup oranları; eşit önsel daha adil olmaz mı?
MASS::lda varsayılanı grup oranlarıdır ve paket bunu değiştirmez. Büyük gruplar, iki gruba eşit uzaklıktaki bir bireyi kendine çeker; küçük grupların yeniden atama oranı bu yüzden düşebilir (örnekte 11 ağaçlık QARS 0,636). Grup büyüklükleri örnekleme çabasını yansıtıyorsa, gerçek sıklığı değil, eşit önsel daha uygun olurdu; şablonda bu seçenek yoktur. Dengesiz örneklemde grup başına oranlar birlikte okunur ve çapraz doğrulamada grup ortalaması kullanıldığı hatırlanır.
S5. sNMF ile olabilirlik tabanlı karışım modelleri (Pritchard ve ark., 2000) aynı Q'yu verir mi?
Aynı modeli (\mathbf Q\mathbf G çarpımı) başka bir ölçütle kestirirler. Olabilirlik tabanlı yöntemler popülasyon içinde Hardy–Weinberg ve bağlantı dengesi varsayar; sNMF en küçük kareler çözümü olduğundan varsaymaz ve akrabalı çiftleşen türlerde daha sağlamdır (Frichot ve ark., 2014). Çok sayıda SNP ve belirgin yapıda sonuçlar birbirine çok yakındır. Az sayıda mikrosatellitte, bu bölümdeki gibi, ikisi de belirsizdir; kaynak makalenin iki kümesi ile buradaki "K = 1 ile 3 ayırt edilemiyor" sonucu çelişmez.
S6. Çapraz entropi çalıştırmalar arasında neden bu kadar oynuyor?
Her çalıştırma hücrelerin %5'ini rastgele gizler. Örnek veride sNMF tablosu 351\times109 hücredir; gizlenen yaklaşık 1900 hücrenin hangi aleller olduğu ölçütü belirgin biçimde değiştirir (K=2'de 0,291–0,335). K'lar arasındaki farklar (0,001–0,02) bu oynamanın içindedir. Binlerce SNP'de gizlenen hücre sayısı büyür ve ölçüt kararlılaşır. Şablonun "en küçük değerden standart hatadan az farklı K'lar" notu bu durumu yakalar.
S7. İki alelli lokus TBA'da iki sütunla, sNMF'de tek sütunla temsil ediliyor; bu bir tutarsızlık mı?
Hayır, iki adımın gereksinimi farklıdır. TBA'da iki sütun birbirinin tam tersidir (x_A=2-x_B) ve lokusun varyansa katkısı tek sütunlu kodlamanın iki katı olur; bütün lokuslar iki alelliyse özdeğerler iki katına çıkar, yüzdeler ve puanların biçimi değişmez. Çok alelli lokuslarla karışık veride bu, her lokusun katkısını alel sayısından bağımsız, heterozigotluğuyla orantılı kılar. sNMF ise her sütunu ayrı bir SNP sayar; aynı bilgiyi iki kez vermek ölçütü çarpıtırdı.
S8. K=1 sonucu nasıl okunur?
sNMF'de K=1 en küçük çapraz entropiyi veriyorsa Q tablosu bütün bireylerde 1'dir ve çubuk grafik tek renklidir: veri, karışım modeliyle ayırt edilebilir bir yapı taşımıyor demektir. Kümeleme tarafında dirsek ölçütü K=1 veremez; "yapı yok" sonucu için en küçük BIC'in K=1 olması ya da eğrinin K=1'den sonra inmemesi aranır. DAPC'nin sınama başarısı rastgele şansın üstündeyse (örnekte öyledir) popülasyonlar arasında fark vardır, ama bu fark bireyleri kümelere ayıracak kadar büyük değildir.
S9. Aynı betik yeniden oynatıldığında sonuç aynı çıkıyor; yine de neden birkaç kez çalıştırmalı?
Yeniden oynatma aynı tohumu kullanır; elde edilen yinelenebilirliktir, kararlılık değil. Bir sonucun tohuma bağlı olup olmadığı ancak başka tohumlarla görülür. Ayrıca k-ortalamalar kayan nokta ayrıntısına da duyarlıdır: 10 başlangıçla, aynı tohum ve aynı veriyle, yalnız temel bileşen puanlarının hesaplanma yolu değiştiğinde K=3 için 887,65; 887,74 ve 887,51 BIC değerleri elde edilmişti. Kararlı sonuç için başlangıç sayısı artırılır; şablonun varsayılanı bu yüzden 100'dür.
84.10 Kaynaklar
- Awad, L., Fady, B., Khater, C., Roig, A., & Cheddadi, R. (2014). Genetic structure and diversity of the endangered fir tree of Lebanon (Abies cilicica Carr.): Implications for conservation. PLoS ONE, 9(2), e90086. https://doi.org/10.1371/journal.pone.0090086
- Dray, S., & Dufour, A.-B. (2007). The ade4 package: Implementing the duality diagram for ecologists. Journal of Statistical Software, 22(4), 1–20. https://doi.org/10.18637/jss.v022.i04
- Fisher, R. A. (1936). The use of multiple measurements in taxonomic problems. Annals of Eugenics, 7(2), 179–188. https://doi.org/10.1111/j.1469-1809.1936.tb02137.x
- Frichot, E., & François, O. (2015). LEA: An R package for landscape and ecological association studies. Methods in Ecology and Evolution, 6(8), 925–929. https://doi.org/10.1111/2041-210X.12382
- Frichot, E., Mathieu, F., Trouillon, T., Bouchard, G., & François, O. (2014). Fast and efficient estimation of individual ancestry coefficients. Genetics, 196(4), 973–983. https://doi.org/10.1534/genetics.113.160572
- Hartigan, J. A., & Wong, M. A. (1979). Algorithm AS 136: A k-means clustering algorithm. Applied Statistics, 28(1), 100–108. https://doi.org/10.2307/2346830
- Jombart, T. (2008). adegenet: A R package for the multivariate analysis of genetic markers. Bioinformatics, 24(11), 1403–1405. https://doi.org/10.1093/bioinformatics/btn129
- Jombart, T., Devillard, S., & Balloux, F. (2010). Discriminant analysis of principal components: A new method for the analysis of genetically structured populations. BMC Genetics, 11, 94. https://doi.org/10.1186/1471-2156-11-94
- Patterson, N., Price, A. L., & Reich, D. (2006). Population structure and eigenanalysis. PLoS Genetics, 2(12), e190. https://doi.org/10.1371/journal.pgen.0020190
- Pritchard, J. K., Stephens, M., & Donnelly, P. (2000). Inference of population structure using multilocus genotype data. Genetics, 155(2), 945–959. https://doi.org/10.1093/genetics/155.2.945
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
- Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2