124. Çift/yansız makine öğrenmesi (DML): kısmi doğrusal ve etkileşimli modeller
Şablon kimliği: cift_makine_ogrenmesi · Kategori: nedensel çıkarım · Dil: R · Dosya: pro/sablonlar/nedensel/cift_makine_ogrenmesi.R (satır 1–292; üstbilgi 1–164) · Örnek veri: _ornek/k401.csv · Paketler: DoubleML 1.0.2, mlr3 1.8.0, mlr3learners 0.16.0, ranger 0.18.0, data.table 1.18.4, lgr 0.5.2; lasso seçeneğinde glmnet 5.1 (R 4.5.3)
124.1 Ne işe yarar
Şablon tek bir nedensel parametreyi, çok sayıda karıştırıcı olduğunda ve karıştırıcıların sonuçla ve tedaviyle ilişkisini doğrusal varsaymak istemediğimizde kestirir: 401(k) emeklilik planına uygunluk, hanenin net finansal varlıklarını ortalamada ne kadar değiştirir? Karıştırıcıların etkisi makine öğrenmesiyle (rastgele orman, lasso, ya da doğrusal/lojistik regresyon) kestirilir; ama bu kestirimin yanlılığı hedef parametreye sızmasın diye Neyman dikliği taşıyan bir skor ve çapraz uydurma kullanılır (Chernozhukov ve ark., 2018). Sonuç, geçerli bir standart hata ve güven aralığıyla gelir.
İki model sunulur.
Kısmi doğrusal regresyonda (PLR) tedavi etkisi \theta karıştırıcılardan bağımsız tek bir sayıdır; tedavi sürekli de ikili de olabilir. Etkileşimli regresyon modelinde (IRM) tedavi ikilidir ve etki karıştırıcılara göre değişebilir; şablon ortalama tedavi etkisini (ATE) ya da tedavi görenlerdeki ortalama etkiyi (ATTE) kestirir. Her iki modelde hedef, "tedavi, karıştırıcılar verildiğinde sonuçtan bağımsızdır" (örtülü, gözlenen karıştırıcılar yeterlidir) varsayımı altında tanımlıdır.
- Y: sonuç; D: tedavi; X: karıştırıcılar; \theta: PLR'deki tedavi katsayısı.
- g,\ m: bilinmeyen "yardımcı" (nuisance) fonksiyonlar; m(X)=\mathrm{E}[D\mid X] (eğilim); \ell(X)=\mathrm{E}[Y\mid X] (PLR'de sonuç yardımcı fonksiyonu); IRM'de g_d(X)=\mathrm{E}[Y\mid D=d,X].
Ne zaman kullanılır?
- Karıştırıcı sayısı fazlaysa ya da sonuç ve tedaviye bağlılıkları doğrusal olmayan, etkileşimli bir biçimdeyse.
- Esnek bir öğrenici kullanıp yine de güven aralığı istendiğinde.
- Doğrusal düzeltmeyle (EKK) aynı soruyu esnek bir yöntemle yanıtlayıp sonucun kararlılığını sınamak için.
Ne zaman kullanılmaz?
- Karıştırıcı sayısı azsa ve parametrik eğilim ile sonuç modelleri savunulabiliyorsa, daha yalın olan çift sağlam kestirici daha açıktır: Bölüm 125
cift_saglam_aipw. - Ağırlıklı dengeleme ve denge tanısı (standartlaştırılmış fark) istendiğinde: Bölüm 127
dengeleme_agirliklari; tedavi eğilimi ile sonuç modelinin hedefli güncellemesi için Bölüm 139tmle. - Gözlenmeyen karıştırıcı kuşkusu varsa DML tek başına çözüm değildir; duyarlılık çözümlemesi için Bölüm 131
ihmal_duyarlilik, araç değişken varsa Bölüm 140zayif_arac_saglam. - Tedavi zamanla değişiyorsa: Bölüm 134
msm_ipw. - Örnek büyüklüğü çok küçükse (birkaç yüz gözlem altı, özellikle IRM'de) çapraz uydurma kararsız kalır (124.8).
Temel programla ilişki. Temel programdaki Propensity Score Analysis (eğilim skoru) paneli parametrik lojistik eğilim skoruyla eşleştirme, ters olasılık ağırlıklandırma ve tabakalama yapar. Çapraz uydurma, makine öğrenmesi yardımcı fonksiyonları ve Neyman dik skorlar yalnız bu şablondadır.
124.2 Şablonun girdileri
Form, üstbilgideki 20 [[param]] bloğundan kurulur (cift_makine_ogrenmesi.R:11–163). Türlerin anlamı ve formun ortak denetimi Bölüm 1.2'dedir.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Sonuç Y · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Sonuç (11–15, 173, 177, 200). |
Tedavi D (IRM için 0/1) · d |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Tedavi (16–20, 177–182). |
Karıştırıcılar X · x |
sütunlar · Değişkenler | yok | en az 1 sütun | X matrisi; metin ya da mantıksal sütun gösterge değişkenlere açılır (21–26, 183–198). |
Model · model |
seçim · Model | plr |
plr, irm |
Kısmi doğrusal ya da etkileşimli model (27–33, 178, 235–237). |
Yardımcı fonksiyon öğrenicisi · ogrenici |
seçim · Model | ranger |
ranger, lasso, lm |
Öğrenici (34–40, 213–226). |
Çapraz uydurma kat sayısı K · kat |
tamsayı · Seçenekler | 5 | 2–20 | Kat sayısı (41–48, 175, 233). |
Bölme tekrarı · tekrar |
tamsayı · Seçenekler | 1 | 1–100 | Rastgele bölme sayısı; ortanca ile birleşir (49–56, 233). |
Çapraz uydurma · capraz |
onay · Gelişmiş | açık | açık/kapalı | Kapalıysa tüm örneklemde uydurur (57–62, 227, 233). |
Ağaç sayısı · agac |
tamsayı · Gelişmiş | 500 | 50–5000 | ranger ağaç sayısı (63–70, 202, 215). |
IRM eğilim kırpma eşiği · kirpma |
ondalık · Gelişmiş | 0,01 | 0–0,2 | \hat m bu eşikle [t,1-t] aralığına çekilir (71–78, 235). |
Rastgele sayı tohumu (0 = çalıştırmanın tohumu) · tohum |
tamsayı · Gelişmiş | 1 | 0–1000000 | set.seed(tohum_); 0 ise kod panelinin çalıştırma tohumu (79–87, 229–231). |
PLR skor fonksiyonu · skor_plr |
seçim · Model | partialling out |
partialling out, IV-type |
Skor türü; yalnız PLR (88–95, 236–237). |
IRM hedef parametresi · skor_irm |
seçim · Model | ATE |
ATE, ATTE |
Yalnız IRM (96–103, 235). |
DML birleştirme yordamı · dml_yontemi |
seçim · Gelişmiş | dml2 |
dml2, dml1 |
Kat skorlarının birleşimi (104–111, 210, 234). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | GA (112–119, 211, 244). |
Ağaç derinliği · derinlik |
tamsayı · Gelişmiş | 5 | 0–100 (0 = sınırsız) | Yalnız ranger (120–128, 203, 216). |
En küçük düğüm · min_dugum |
tamsayı · Gelişmiş | 2 | 1–1000 | Yalnız ranger (129–137, 204, 215). |
mtry · mtry |
tamsayı · Gelişmiş | 0 | 0–1000 (0 = \lfloor\sqrt p\rfloor) | Yalnız ranger (138–146, 205, 212, 217). |
Lasso \lambda kuralı · lambda_kurali |
seçim · Gelişmiş | lambda.min |
lambda.min, lambda.1se |
Yalnız lasso (147–154, 206, 221). |
Karışım oranı \alpha · alfa |
ondalık · Gelişmiş | 1 | 0–1 | Yalnız lasso (155–163, 207, 222). |
Şablonun kendi denetimleri (mq_hata):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 168 |
| Sonuç ve tedavi aynı sütun | "Sonuç ve tedavi farklı olmalı." | 169 |
| Sonuç ve tedaviden farklı karıştırıcı yok | "… en az bir karıştırıcı seçin." | 170–171 |
| Tam satır sayısı <\max(30{,}5K) | "En az … tam satır gerekli." | 175 |
| Sonuç ya da tedavi sayısal değil ya da sabit | "'…' sayısal ve değişken olmalı." | 176 |
| IRM'de tedavi 0/1 değil | "IRM için tedavi 0/1 olmalı." | 179 |
| IRM'de bir tedavi grubunda <2K gözlem | "Her tedavi grubunda kat sayısının en az iki katı gözlem gerekli." | 180 |
| Kategorik karıştırıcı tek düzeyli ya da sayısal karıştırıcı sabit | "'…' sabit; karıştırıcılardan çıkarın." | 188, 192 |
lm öğrenicisinde eş doğrusallık |
"Karıştırıcılar ve tedavi doğrusal bağımlı." | 198 |
ranger ve mtry > sütun sayısı |
"mtry (…) karıştırıcı sütun sayısını (…) aşamaz." | 211 |
| DoubleML hata verir | "DML kestirimi yapılamadı: …" | 237 |
| Kestirim ya da SH sonlu değil | "Kestirim ya da standart hata sonlu değil." | 240 |
Veriye ilişkin üç davranış önemlidir. Eksik değerli satırlar sessizce atılır (173–174): çıktıdaki n atıldıktan sonraki sayıdır. Karıştırıcı listesinde sonuç ya da tedavi sütunu varsa çıkarılır (171); bu bir hata ya da uyarı doğurmaz. Metin ve mantıksal karıştırıcılar factor yapılır, model.matrix ile ilk düzey dışındaki düzeyler gösterge sütunlara açılır (184–198); tedavi ve sonuç sayısal roldedir ve Veri sekmesindeki türünden bağımsız sayı olarak gelir (Bölüm 1.3).
Tohum. Kat bölmesi ve rastgele orman tohum alanındaki değerle kurulur (varsayılan 1; 229–231). Alan 0 verilirse kod panelinin çalıştırma tohumu kullanılır (Bölüm 1.3; o da yoksa 1) ve sonuç kartının künyesindeki "Tohum" sonucu belirler. Kullanılan tohum ve kaynağı ("tohum alanından" ya da "çalıştırma tohumundan") çıktı notunda yazılır (284). Aynı tohum, aynı veri ve ayarla sonuç yinelenir; ranger tek iş parçacığıyla çalıştırılır (215).
Örnek ayar (ornek_param, satır 9): y = net_tfa, d = e401, x = age, inc, educ, fsize, marr, twoearn, db, pira, hown, model = plr, ogrenici = ranger, kat = 5, tekrar = 1, agac = 500; öteki alanlar varsayılandadır.
124.3 Örnek veri
k401.csv: Chernozhukov ve Hansen'ın (2004) 401(k) verisi (DoubleML paketindeki fetch_401k() ile aynı veri), 9915 hane, 11 sütun, eksik değer yok. Tedavi e401 (401(k) planına uygunluk, hanelerin %37,1'i); sonuç net_tfa (net finansal varlık, dolar). Veri sekmesinin algıladığı türlerle:
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
net_tfa |
sonuç | sayısal | ortalama 18051{,}54; sd 63522{,}50; en küçük -502302, ortanca 1499, en büyük 1536798 |
e401 |
tedavi | ikili | 0/1; ortalama 0{,}371 (3682 uygun, 6233 uygun değil) |
age |
karıştırıcı | sayısal | ortalama 41{,}06 (25–64) |
inc |
karıştırıcı | sayısal | ortalama 37200{,}6 (en küçük -2652) |
educ |
karıştırıcı | sayısal | ortalama 13{,}21 (1–18) |
fsize |
karıştırıcı | sayısal | ortalama 2{,}87 (1–13) |
marr, twoearn, db, pira, hown |
karıştırıcı | ikili | evli 0{,}605; iki gelirli 0{,}381; tanımlanmış fayda planı 0{,}271; bireysel emeklilik hesabı 0{,}242; ev sahibi 0{,}635 |
Kategorik değişken yoktur; ikili sütunlar sayısal 0/1 olarak gelir ve doğrudan karıştırıcı sütunudur. Bir sütunu Veri sekmesinde "kategorik" yaparsanız ilk düzey dışındaki düzeyler gösterge sütunlara açılır (184–196): educ ve fsize kategorik yapıldığında doğrusal öğrenicili PLR \hat\theta=5980{,}39 olur (örnek ayarda doğrusal öğrenicide 5940{,}64).
Bu bölümde kullanılan çalıştırmalar (örnek ayara eklenen ayarlarla; dogrulama/cift_makine_ogrenmesi/kos.sh, kos2.sh): dml_ornek (örnek ayar), dml_irm (model = irm), dml_fwl (ogrenici = lm, capraz = kapalı), dml_lm5 (ogrenici = lm), dml_lm5_tohum2 (tohum = 2), dml_lm_tekrar3 (tekrar = 3), dml_dml1_lm (dml_yontemi = dml1), dml_irm_lm, dml_irm_atte_lm, dml_irm_kirpma02 (kirpma = 0,2), dml_iv_lm (skor_plr = IV-type), dml_lasso, dml_lasso_1se, dml_irm_atte_rf, dml_ranger_derin0 (derinlik = 0), dml_rf_p2, dml_rf_p3 (tohum = 2 ve 3), dml_rf_tekrar5 (tekrar = 5), dml_capraz_kapali_rf, ve sınır durumları (dml_kat1, dml_mtry99, dml_d12, dml_eksik, dml_sabit, dml_kucuk, …).
124.4 Yöntem: formüller ve hesap adımları
Hesap sırası: veri hazırlanır ve karıştırıcı matrisi kurulur (169–201); DoubleMLData nesnesi yapılır (200–201); tohum kurulur (231); DoubleML nesnesi çapraz uydurmayla kestirir (232–241); \hat\theta, SH, t, p ve güven aralığı yazılır (242–248); yardımcı modellerin dış kat RMSE'leri ve karşılaştırma tablosu yazılır (249–282); uyarılar ve şekil (283–291).
124.4.1 Neden düz makine öğrenmesi yetmez; Neyman dikliği ve çapraz uydurma
\theta'yı kestirmek için g(X)'i bir öğrenicisiyle uydurup Y-\hat g(X)'i D'ye regres etmek yanlıdır: düzenlileştirme ve aşırı uyum \hat g'ye yanlılık katar ve bu yanlılık \hat\theta'ya n^{-1/2}'den yavaş bir hızla sızar. Chernozhukov ve ark. (2018) iki ilke önerir: (1) Neyman dik skor: skor, yardımcı fonksiyonlardaki küçük hatalara birinci dereceden duyarsız olacak biçimde kurulur; (2) çapraz uydurma: bir gözlemin yardımcı tahmini, o gözlemin hiç kullanılmadığı katlardan öğrenilen modelden alınır; böylece aşırı uyum yanlılığı ortadan kalkar. İkisi birlikte \hat\theta'nın n^{-1/2} hızında ve asimptotik normal olmasını, yardımcı fonksiyonların yalnız yeterince hızlı (n^{-1/4}) kestirilmesi koşuluyla sağlar.
124.4.2 Kısmi doğrusal model: kısmileştirme skoru
Kısmileştirme (partialling out; Robinson, 1988) skorunda \ell(X)=\mathrm{E}[Y\mid X] ve m(X) çapraz uydurmayla kestirilir; \hat u_i=Y_i-\hat\ell(X_i), \hat v_i=D_i-\hat m(X_i) olmak üzere
- \hat u_i,\ \hat v_i: çapraz uydurmalı (dış kat) artıklar; sonuç ve tedavi, karıştırıcıların etkisinden arındırılmıştır.
- \hat\psi_i: etki (influence) fonksiyonu; \hat J: skorun \theta'ya göre türevinin ortalaması (DoubleML'de
psi_a'nın ortalaması). - n bölenlidir (n-1 değil):
var_scaling_factor=n (DoubleMLvar_est).
Neden \sum\hat v\hat u/\sum\hat v^2
Çapraz uydurmasız ve doğrusal öğrenicili durumda bu oran, Y'nin D ve X'e EKK regresyonundaki D katsayısıdır (Frisch–Waugh–Lovell; Lovell, 1963); SH ise EKK katsayısının HC0 sandviç SH'sidir. Şablonun doğrulaması bu özdeşliğe dayanır (124.6, Adım 1).
IV-tipi skor (skor_plr = IV-type) ek bir g(X)=\mathrm{E}[Y-D\theta\mid X] öğrenicisi uydurur: önce kısmileştirme ile bir \theta_0 bulunur, g bu \theta_0 ile Y-\theta_0D'ye uydurulur, skor \hat\psi_a=-\hat v_iD_i, \hat\psi_b=\hat v_i(Y_i-\hat g_i) olur (DoubleMLPLR nuisance_est). Örnek veride doğrusal öğrenicilerle \hat\theta kısmileştirmeyle aynıdır (5940{,}64), SH 1523{,}81 (1522{,}09 değil; dml_iv_lm).
124.4.3 Etkileşimli model: AIPW skoru
İkili D için yardımcı fonksiyonlar g_0,g_1 (her tedavi grubunda sonuç) ve m(X)=\Pr(D=1\mid X)'dir. g_d yalnız D=d olan, eğitim katlarındaki gözlemlerle uydurulur; m tüm eğitim gözlemleriyle. \hat m önce [t,\,1-t] aralığına çekilir (t = kirpma, DoubleML trimming_threshold):
ATTE için \hat p (ilgili test katındaki tedavi oranı) ile
SH, kısmileştirmeyle aynı yoldan \hat J ve \hat\psi_i ile hesaplanır: ATE'de \hat J=-1, \hat\psi_i=\hat\psi_{b,i}-\hat\theta olduğundan \mathrm{SH}=\sqrt{\tfrac1n\cdot\tfrac1n\sum\hat\psi_i^2}.
- \hat g_d(X_i),\ \hat m(X_i): gözlem i'nin bulunduğu katın dışındaki katlarda eğitilmiş modelin tahmini.
- t: eğilim kırpma eşiği (örtüşme sorununda örneklem kırpma önerisi için Crump ve ark., 2009). Eğilim skoru 0 ya da 1'e yaklaştıkça 1/\hat m ve 1/(1-\hat m) ağırlıkları patlar; t bu ağırlıkları 1/t ile sınırlar.
- AIPW skoru çift sağlamdır: g ya da m den biri doğru kestirilirse tutarlıdır; DML'de ikisi de yeterince hızlı kestirildiğinde hem tutarlı hem asimptotik normaldir.
124.4.4 Çapraz uydurma, DML1 ve DML2, bölme tekrarı
Örneklem K eşit katlara rastgele bölünür. DML2 (varsayılan) skor denklemini bütün katlar için birlikte çözer: yukarıdaki toplamlar tüm n gözlem üzerindendir. DML1 her katta ayrı \hat\theta_k bulur ve ortalamasını alır (\hat\theta=K^{-1}\sum_k\hat\theta_k); SH yine tüm gözlemlerin birleşik skorundan hesaplanır. Bölme rastgele olduğundan sonuç bölmeye bağlıdır; tekrar R>1 iken her bölme (r=1,\dots,R) için \hat\theta_r ve \mathrm{SH}_r bulunur ve
olur (DoubleML agg_cross_fit). İkinci terim bölmeler arası değişkenliği SH'ye katar.
124.4.5 Öğreniciler
Koddaki tercih
Öğreniciler mlr3 (Lang ve ark., 2019) üzerinden kurulur. ranger (Wright ve Ziegler, 2017): regr.ranger ya da classif.ranger; num.trees = agac (500), min.node.size = min_dugum (2), max.depth = derinlik (5; 0 ise sınırsız), mtry verilmişse o (0 ise paket varsayılanı \lfloor\sqrt p\rfloor), num.threads = 1 (215–218). lasso (glmnet, Friedman ve ark., 2010): regr.cv_glmnet ya da classif.cv_glmnet; s = lambda_kurali, \alpha\ne1 ise alpha = alfa (221–223); cv.glmnet kendi içinde 10 katlı çapraz doğrulama yapar. lm: regr.lm ve ikili tedavide classif.log_reg (225). İkili tedavide m(X) sınıflandırma öğrenicisiyle (olasılık tahmini), PLR'de ise tedavi ikili olsa bile regr öğrenicisiyle kestirilir (236–237).
Karıştırıcıların kodlanması
Metin, mantıksal ve "kategorik" türdeki karıştırıcı sütunlar ilk düzeyi başvuru yapan gösterge sütunlara açılır (190); düzey sırası Bölüm 1.3'teki kurala göredir. Doğrusal öğrenicide başvuru düzeyi seçimi sonucu değiştirmez; lasso cezalı olduğundan gösterge sütunları ceza altındadır (düzey sırası ve sütunların ölçeği cezalı kestirimi etkiler), rastgele ormanda ise gösterge dönüşümü bölünme noktalarını etkiler. Aşırı çok düzeyli bir sütun yüzlerce gösterge sütunu üretir.
124.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–164 | Üstbilgi: 20 parametre, örnek veri ve ayar. | Üstbilgideki açıklama doğrulama değerlerini içerir (124.6). |
| 165–167 | .m dil yardımcısı; DoubleML, mlr3, mlr3learners, data.table yüklenir; mlr3 günlüğü yalnız hata düzeyine çekilir. |
Paket yoksa şablon çalışmaz. |
| 169–182 | Veri, sonuç/tedavi ve karıştırıcı denetimi; tam satır ve tedavi grubu büyüklüğü; IRM'de 0/1 denetimi. | Eksik satırlar çıkarılır (173–174); n<\max(30{,}5K) durdurur (176). |
| 183–199 | Karıştırıcı matrisi X: gösterge kodlama, sabit sütun denetimi, lm için eş doğrusallık. |
make.names sütun adlarını güvenli yapar (191, 198). |
| 200–212 | DoubleMLData (.y, .d, X sütunları); ayar değişkenleri ve mtry denetimi. |
Eski sürümlerden gelen boş alanlar için varsayılanlar (203–211). |
| 213–226 | ogr(tur): öğrenici kurucu (ranger, lasso, lm). |
tur = "r" regresyon, "c" sınıflandırma. |
| 227–241 | Tohum (tohum_, set.seed), DoubleMLPLR$new / DoubleMLIRM$new, fit(store_predictions = TRUE); uyarılar toplanır. |
capraz = kapalı iken n_folds = 1, apply_cross_fitting = FALSE (233). |
| 242–248 | \hat\theta, SH, t, p, GA; sonuç tablosu. | Başlık kat sayısını ve bölme tekrarını yazar (247–248). |
| 249–264 | Yardımcı modellerin RMSE tablosu (başlığı çapraz uydurma ve bölme tekrarına göre yazılır: 262–264). | Tahminler ilk bölmedendir (251); ATTE'de g yalnız kontrol grubundandır ve satır adı bunu söyler (253–255). |
| 265–279 | IRM'de örtüşme tanısı: eğilim skoru aralığı, ağırlıklar, etkin n, kırpılan gözlem; kırpılan oran %5'i aşarsa uyarı. | Kırpılan sayı \hat m<t ya da \hat m>1-t olan gözlemlerdir (t = kirpma). |
| 280–282 | Naif EKK katsayısı ve veri özeti. | EKK, (1,D,X) üzerine lm.fit; karşılaştırma içindir. |
| 283–285 | Çapraz uydurma kapalıysa uyarı; tohum ve kararlılık notu; DoubleML/mlr3 uyarıları. | Uyarılar Uyarılar: satırında yinelenenler atılarak yazılır. |
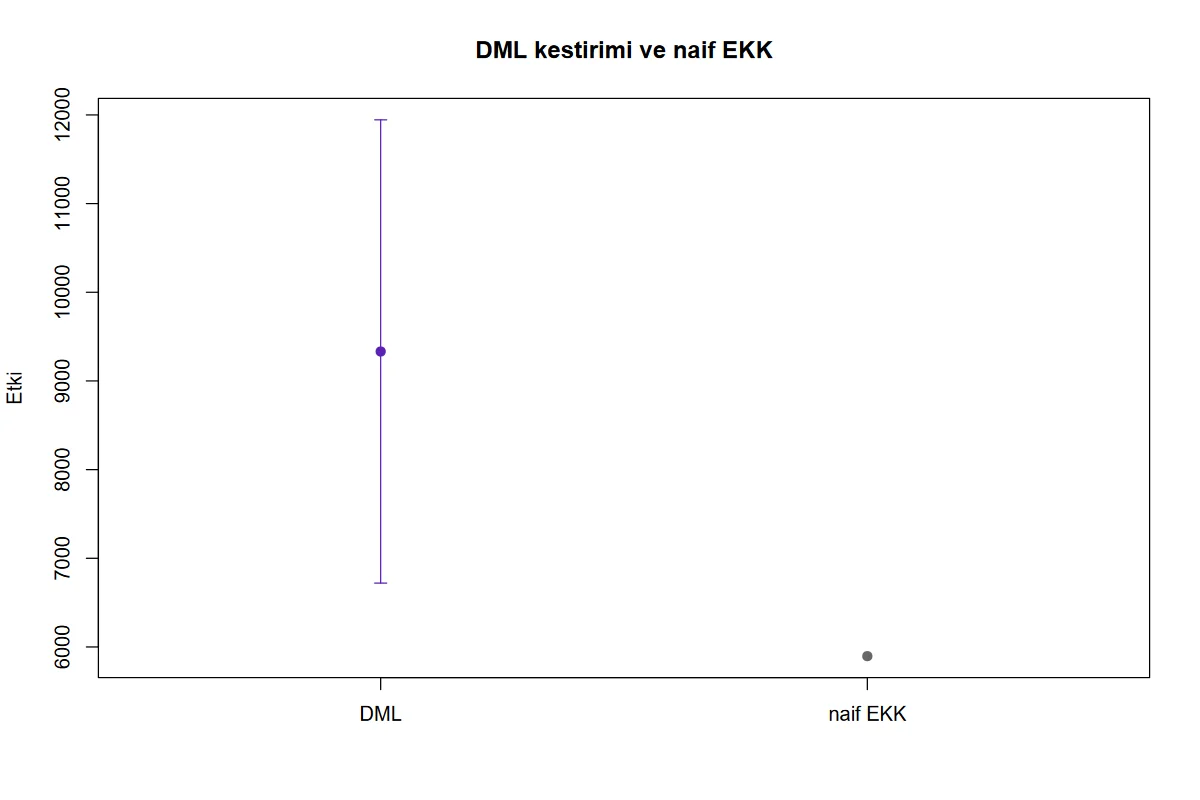
| 286–291 | \hat\theta (güven aralığıyla) ve naif EKK noktası. | Şekil 124.1. |
Süre: örnek ayarda çalıştırma 14,68 s (rastgele orman, 5 kat); IRM 18,41 s; doğrusal öğrenicilerle 5,97 s; lasso 8,89 s; tekrar = 5 iken 70,74 s. |
124.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bağımsız hesap iki yoldan yapıldı: dogrulama/cift_makine_ogrenmesi/elle_hesap.py (yalnız numpy; EKK ve lojistik regresyon elle yazılmış, Fisher puanlama) ve r_dogrulama.R (taban R lm, glm.fit, sandwich::vcovHC). İkisi de DoubleML'in kestirim işlevlerini çağırmaz; yalnız kat bölmelerini DoubleML nesnesinin smpls alanından alır (bölmeyi yeniden üretmek için tohum ve çağrı sırası kullanılır), skor ve birleştirme formüllerini açık yazar. Rastgele orman ve lasso için bağımsız yeniden hesap yoktur (bu öğreniciler rastgeledir ya da iç çapraz doğrulama kullanır); onlar 124.6.2'de yayımlanmış değerlerle karşılaştırılır.
Adım 1 — Frisch–Waugh–Lovell. Çapraz uydurmasız doğrusal öğrenicili PLR: y'nin (1,D,X) üzerine EKK'sinde D katsayısı 5896{,}198421, HC0 sandviç SH'si 1523{,}188020. Şablon (dml_fwl) aynı değerleri verir (10^{-13} içinde).
Adım 2 — Kat bölmesi. tohum = 1 ile 5 kat, her biri 1983 gözlem (toplam 9915).
Adım 3 — Çapraz uydurmalı artıklar. Her katta öteki dört katla \ell(X) ve m(X) EKK ile uydurulup test katında tahmin edilir; \hat u=Y-\hat\ell, \hat v=D-\hat m. Dış kat RMSE'ler: \ell için 55880{,}6466, m için 0{,}448158 (şablon tablosuyla aynı).
Adım 4 — PLR kestirimi (DML2). \sum\hat v\hat u=11830113{,}143, \sum\hat v^2=1991{,}3855; \hat\theta=5940{,}644538. \hat J=-0{,}200846, n^{-1}\sum\hat\psi^2=9{,}26615\times10^{8}, \hat\sigma^2=2{,}29707\times10^{10}, \mathrm{SH}=\sqrt{\hat\sigma^2/9915}=1522{,}091434. DML1 için ilk katın \hat\theta_1=8602{,}92 (5 katın ortalaması 5955{,}176; SH 1522{,}096).
Adım 5 — Bölme tekrarı. tekrar = 3: üç bölmenin \hat\theta_r değerlerinin ortancası 5793{,}354017; \mathrm{SH}=1526{,}342084 (ortanca formülüyle).
Adım 6 — IRM. g_0,g_1 EKK (yalnız ilgili tedavi grubunda), m lojistik regresyon; \hat m en küçük 0{,}0911, en büyük 0{,}9738 (kırpma 0,01'de kırpılan yok). n^{-1}\sum(\hat g_1-\hat g_0)=4669{,}94 ve AIPW düzeltme terimi ortalaması -2883{,}98: ATE 1785{,}967; n^{-1}\sum\hat\psi^2=1{,}40204\times10^{11}, \mathrm{SH}=3760{,}405. ATTE -1044{,}408 (SH 9157{,}685); eşik 0{,}2 için ATE 4760{,}863 (SH 1485{,}720).
124.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Çapraz uydurmasız doğrusal PLR: \hat\theta (EKK katsayısı) | 5896,19842116 | 5896,19842116 | 5896,19842116 | 2,2e−13 | ✓ |
| Çapraz uydurmasız doğrusal PLR: SH (HC0 sandviç) | 1523,1880199 | 1523,1880199 | 1523,1880199 | 1,6e−13 | ✓ |
| PLR, DML2, 5 kat, tohum 1: kestirim | 5940,64453755 | 5940,64453755 | 5940,64453755 | 2,9e−14 | ✓ |
| PLR, DML2, 5 kat, tohum 1: SH | 1522,09143381 | 1522,09143381 | 1522,09143381 | 6,4e−15 | ✓ |
| PLR, DML2, 5 kat, tohum 2: kestirim | 5879,80360509 | 5879,80360509 | 5879,80360509 | 2,2e−14 | ✓ |
| PLR, DML2, 5 kat, tohum 2: SH | 1521,38459509 | 1521,38459509 | 1521,38459509 | 6,6e−15 | ✓ |
| PLR, DML1, 5 kat, tohum 1: kestirim | 5955,17634942 | 5955,17634942 | 5955,17634942 | 2,9e−14 | ✓ |
| PLR, DML1, 5 kat, tohum 1: SH | 1522,09590411 | 1522,09590411 | 1522,09590411 | 6,6e−15 | ✓ |
| PLR, DML2, 5 kat, 3 bölme ortancası: kestirim | 5793,35401741 | 5793,35401741 | 5793,35401741 | 5,2e−15 | ✓ |
| PLR, DML2, 5 kat, 3 bölme ortancası: SH | 1526,34208415 | 1526,34208415 | 1526,34208415 | 2,0e−14 | ✓ |
| IRM (ATE), 5 kat: kestirim | 1785,96697939 | 1785,96697939 | 1785,96697939 | 1,3e−13 | ✓ |
| IRM (ATE), 5 kat: SH | 3760,40454348 | 3760,40454348 | 3760,40454348 | 4,6e−14 | ✓ |
| IRM (ATTE), 5 kat: kestirim | −1044,40789528 | −1044,40789528 | −1044,40789528 | 1,8e−13 | ✓ |
| IRM (ATTE), 5 kat: SH | 9157,68533411 | 9157,68533411 | 9157,68533411 | 5,1e−14 | ✓ |
| IRM (ATE), kırpma 0,2: kestirim | 4760,86280418 | 4760,86280418 | 4760,86280418 | 6,4e−14 | ✓ |
| IRM (ATE), kırpma 0,2: SH | 1485,71962945 | 1485,71962945 | 1485,71962945 | 7,0e−15 | ✓ |
| PLR: \ell(X) dış kat RMSE | 55880,64661881 | 55880,64661881 | 55880,64661881 | 6,5e−16 | ✓ |
| PLR: m(X) dış kat RMSE | 0,44815816 | 0,44815816 | 0,44815816 | 2,8e−16 | ✓ |
| IRM (ATE): g(D,X) dış kat RMSE | 55769,26028683 | 55769,26028683 | 55769,26028683 | 7,8e−16 | ✓ |
| IRM (ATE): m(X) dış kat RMSE | 0,44860726 | 0,44860726 | 0,44860726 | 4,4e−16 | ✓ |
| IRM (ATTE): g(D,X) RMSE (yalnız kontrol grubu) | 49260,85335874 | 49260,85335874 | 49260,85335874 | 3,1e−15 | ✓ |
Ölçütü karşılayan: 21/21. Doğrusal ve lojistik yardımcı fonksiyonlarda kat bölmesi dışında rastgelelik yoktur; bağımsız iki hesap, DoubleML nesnesinin çektiği kat bölmelerini (r_dogrulama.json) kullanır, skor ve birleştirme formüllerini açık yazar. Rastgele orman ve lasso için bağımsız bir yeniden hesap yoktur: onlar yayımlanmış değerlerle karşılaştırılır (bölüm 124.6).
124.6.2 Yayımlanmış değerlerle karşılaştırma
Chernozhukov ve ark. (2018), Tablo 2: 401(k) uygunluğunun net finansal varlığa etkisi, rastgele orman, 5 katlı çapraz uydurma (yayımlanan değer 100 bölmenin ortancasıdır).
| Model | Yayımlanan \hat\theta (SH) | Şablon, tek bölme, tohum = 1 |
Fark | Yarım SH |
|---|---|---|---|---|
| PLR | 9247 (1295) | 9332{,}26 (1332{,}85) | 85{,}3 | 647{,}5 |
| IRM (ATE) | 8105 (1242) | 8472{,}02 (1106{,}45) | 367{,}0 | 621{,}0 |
Şablonun tek bölmeli sonucu yayımlanan değerlerden yarım SH içinde farklıdır; bölmeden bölmeye değişkenlik 124.7'de gösterilmiştir.
124.7 Çıktıyı okuma
Örnek ayarda şablonun üç tablosu ve konsol notu (dml_ornek; sayılar olduğu gibi):
e401'nin net_tfa üzerindeki etkisi (DML, 5 kat)
  parametre   kestirim         SH          t              p      GA_alt      GA_ust
  θ (PLR)     9332.2555   1332.8505   7.001727  2.528260e-12   6719.9166  11944.5945

Yardımcı modellerin dış kat RMSE'leri
  yardimci          RMSE
  l(X) = E[Y | X]   54962.998
  m(X) = E[D | X]   0.4431954

Veri ve karşılaştırma
  olcut                                 deger
  n                                      9915
  karıştırıcı sütunu                        9
  naif EKK katsayısı (karşılaştırma)  5896.1984

Sonuçlar kat bölmesine ve öğrenicinin rastgeleliğine bağlıdır (kullanılan tohum 1, tohum alanından). Kararlılık için bölme tekrarını artırın.
Şekil 124.1. Şablonun şekli: DML kestirimi (mor nokta ve %95 güven aralığı) ile naif EKK katsayısı (gri nokta). Aralık yalnız DML için çizilir.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
kestirim (\hat\theta) |
PLR'de tedavi katsayısı; IRM'de ATE ya da ATTE. | Sonuç biriminde etki: e401 uygunluğu ortalamada 9332{,}26 dolar fazla net finansal varlıkla ilişkilidir. |
SH |
Etki fonksiyonundan, n bölenli. | Örneklem belirsizliği; bölme ve öğrenici rastgeleliğini yalnız tekrar >1 iken yansıtır (124.4.4). |
t, p |
\hat\theta/\mathrm{SH} ve iki yönlü p. | İkisi de standart normal dağılıma göredir (sütunun adı t olsa da); küçük örneklemde iyimser olabilir. |
GA_alt, GA_ust |
\hat\theta\pm z_{(1+g)/2}\,\mathrm{SH} (m$confint). |
Normal yaklaşıma dayalı aralık. |
l(X) ve m(X) RMSE |
Yardımcı modellerin dış kat tahmin hataları (PLR). | m'nin RMSE'si ikili tedavi için 0{,}443: eğilim skoru zayıf ayırır (tedavi oranından \sqrt{0{,}371\cdot0{,}629}=0{,}483 ile karşılaştırın); \ell için 54963, Y'nin sd'sine (63523) yakındır: karıştırıcılar sonucu az açıklar. |
naif EKK katsayısı |
Y'nin (1,D,X) üzerine EKK'si; PLR'nin doğrusal karşılığı. | DML'den (9332) küçüktür (5896): doğrusal düzeltme bu veride etkiyi hafife alır ya da karıştırıcı doğrusal değildir. |
IRM'de ikinci tablo "g(D, X): sonuç modeli" ve "m(X): eğilim skoru" RMSE'lerini yazar. ATTE'de g_1 uydurulmaz; satır "g0(X): sonuç modeli (yalnız kontrol grubu)" adıyla yalnız kontrol grubundan hesaplanır (253–255). Çapraz uydurma kapalıysa tablo başlığı "örneklem içi RMSE'leri (çapraz uydurma kapalı)", tekrar >1 iken "(yalnız ilk bölme)" ekini taşır (262–264).
IRM'de ek bir tablo, "Örtüşme tanısı (eğilim skoru, ağırlıklar ve kırpma)", tedavi ve kontrol grubu için gözlem sayısını, \hat m'nin en küçük ve en büyük değerini, en büyük ters olasılık ağırlığını, etkin örneklem büyüklüğünü ((\sum w)^2/\sum w^2) ve kırpılan gözlem sayısını yazar (265–279; ATTE'de ağırlıklar tedavilide 1, kontrolde \hat m/(1-\hat m)). Örnek veride (ogrenici = lm, IRM): \hat m en küçük 0{,}0911, en büyük 0{,}9738; en büyük ağırlıklar 8{,}673 (tedavili) ve 28{,}307 (kontrol); etkin n 3020{,}26 ve 4625{,}61; kirpma = 0,01 iken kırpılan yok, kirpma = 0,2 iken 2105 gözlem (358 tedavili, 1747 kontrol). Kırpılan gözlem varsa "Eğilim skoru kırpma: N gözlem (%x) ... dışındaydı ve sınıra çekildi" notu, oran %5'i aşıyorsa ayrıca uyarı yazılır.
401(k) planına uygunluğun net finansal varlıklar üzerindeki etkisi, dokuz karıştırıcı ve rastgele orman yardımcı fonksiyonlarıyla, 5 katlı çapraz uydurmalı kısmi doğrusal çift/yansız makine öğrenmesiyle (tek bölme, tohum 1) 9332{,}26 dolar olarak kestirilmiştir (SH 1332{,}85; %95 GA 6719{,}92–11944{,}59; z=7{,}00; p<0{,}001). Doğrusal EKK düzeltmesi 5896{,}20 vermiştir.
124.8 Sık hatalar ve tuzaklar
- Tek bölmenin sonucuna güvenmek. Rastgele ormanlı PLR'de
tohum1, 2, 3 için \hat\theta=9332{,}26;\ 9484{,}09;\ 9336{,}67 (SH \approx1330): bölmeler arası değişim SH'nin onda biri kadardır ama sonucun üçüncü basamağını değiştirir.tekrar = 5ortancası 9299{,}15 (SH 1337{,}88) verir ve 70{,}7 s sürer (tek bölmenin beş katı). Rapor ederken kullanılantohumvetekraryazılmalıdır. - Panelin Tohum alanını
tohumalanıyla karıştırmak.tohumalanı doluyken (varsayılan 1) kat bölmesini ve ormanı o belirler; panel tohumunu değiştirmek sonucu değiştirmez. Panel tohumunun sonucu belirlemesi içintohumalanını 0 yapın (tohum 2 ile 9484{,}09; çıktı notu hangi tohumun kullanıldığını yazar). - Çapraz uydurmayı kapatmak.
capraz = kapalıdoğrulama içindir. Esnek öğrenicide aşırı uyum yanlılığı doğar ve tablodaki RMSE de örneklem içidir (tablo başlığı bunu söyler) (\ell için 50468{,}91; çapraz uydurmalıda 54962{,}998): aşırı uyum tam bu farkta görünür. Doğrusal öğrenicide fark sıfıra yakındır (FWL özdeşliği). - IRM'de ağırlık patlaması ve kırpma. Doğrusal ve lojistik öğrenicilerle IRM-ATE 1785{,}97 (SH 3760{,}40) çıkar; aynı veride kırpma 0{,}2 iken 4760{,}86 (SH 1485{,}72): \hat m 0,2'nin altında ve 0,8'in üstünde olan 2105 gözlem kırpılır. Örtüşme tanısı tablosu eğilim skoru aralığını ve kırpılan sayıyı yazar ve oran %5'i aşınca uyarır; yine de eşiği değiştirip sonucun nasıl oynadığına bakın. Bu veride Y'nin ağır kuyrukluluğu (\mathrm{sd}\approx63500) ve doğrusal g'nin zayıflığı birleşince SH büyür.
- ATTE satırının RMSE'si. ATTE'de yalnız g_0 uydurulur; RMSE tablosundaki "g0(X): sonuç modeli (yalnız kontrol grubu)" satırı yalnız kontrol grubundadır (49260{,}85; ATE'de 55769{,}26) ve ATE'dekiyle karşılaştırılmamalıdır.
- Tedavi kodlaması. IRM'de tedavi 0/1 olmalıdır; 1/2 kodlu tedavi hata verir (
dml_d12). PLR'de 1/2 kodlu ikili tedavi bir birimlik fark olduğundan \hat\theta değişmez. - Eş doğrusal ya da sabit karıştırıcı.
lmöğrenicisinde inc ile 2\cdot inc birlikte ise "doğrusal bağımlı" hatası; rastgele ormanda aynı sütun çifti hatasız çalışır (\hat\theta=9320{,}44;dml_esdogrusal_rf). Sabit sütun her öğrenicide hata verir. - Eksik değerli satırlar. Sessizce atılır (n=9908; 7 satır); atılan sayı çıktıda yoktur. Çıktıdaki n'yi veri sayınızla karşılaştırın.
- Karıştırıcı listesine tedavi koymak. Sessizce çıkarılır; x=\{e401,age\} yalnız
ageile çalışır (\hat\theta=18755{,}2, düzeltmesiz) ve bunu fark etmek zordur. - Küçük örneklem. 120 satırlık altörneklemde doğrusal PLR \hat\theta=-2143{,}63 (SH 10822{,}8), 100 ağaçlı IRM 6278{,}62 (SH 18822{,}1): kestirim ve aralık bilgi vermez. En az 5K gözlem ve IRM'de her grupta 2K gözlem koşulu yalnız hesabın çalışması içindir.
- Lasso \lambda seçimi.
lambda.min5937{,}75 (SH 1525{,}87),lambda.1se6747{,}20 (SH 1626{,}22): daha sade (daha çok cezalı) bir yardımcı model \hat\ell ve \hat m'de artık bırakır; kestirim ve SH kaymıştır. Yardımcı RMSE'lerlambda.1seiken büyüktür (59542 ve 0{,}450). mtryve ağaç derinliği.mtrykarıştırıcı sütun sayısını aşamaz (9 için 99 hata verir); derinlik sınırı (0 = sınırsız) sonucu bir bölme içinde değiştirir: 9070{,}63 (sınırsız) ve 9332{,}26 (5).
124.9 Uzman soruları
S1. DML neden EKK'den farklı bir sonuç veriyor ve hangisine inanmalıyım?
Doğrusal öğrenici ve çapraz uydurmasız iken DML, EKK katsayısına birebir eşittir (5896{,}198). Fark, yardımcı fonksiyonların esnekliğinden gelir: rastgele orman karıştırıcıların etkisini ve eşleşmesini doğrusal olmayan biçimde alır ve \hat\theta=9332{,}26 verir. İkisini karşılaştırmak, karıştırıcı doğrusal olmama kuşkusunu sınar; bu veride yayımlanan rastgele orman sonucu da 9247'dir (Chernozhukov ve ark., 2018, Tablo 2). Her iki sonuç da "gözlenen karıştırıcılar yeterlidir" varsayımına bağlıdır.
S2. Çapraz uydurma neden gerekli?
Yardımcı fonksiyon aynı gözlemle uydurulup aynı gözlemde tahmin edilirse esnek öğrenici gürültüyü öğrenir ve artıkları küçültür; \hat\theta bu aşırı uyumun yanlılığını taşır. Çapraz uydurma her gözlem için dışarıdan tahmin kullanır. Şablonda capraz = kapalı seçeneği bunu gösterir: rastgele ormanla \hat\theta=9349{,}97 (SH 1254{,}22) çıkar ve RMSE 50469'a düşer.
S3. PLR ile IRM hangi varsayımlarda ayrılır?
PLR etkinin karıştırıcılardan bağımsız bir sabit olduğunu varsayar; etki türdeşliği yoksa PLR, ağırlıklı bir ortalama etkiyi kestirir ve ATE'den farklı olabilir. IRM etkiye karıştırıcıya göre değişme izni verir ve ATE (ya da ATTE) tanımlar, ama örtüşme (pozitiflik) koşulu ve ağırlıklardaki 1/\hat m nedeniyle uç ağırlıklara duyarlıdır. Bu veride rastgele ormanla PLR 9332{,}26, IRM 8472{,}02 verir.
S4. DML1 ile DML2 ne zaman ayrışır?
Büyük n ve kararlı yardımcı tahminlerde iki yordam asimptotik olarak eşdeğerdir. Küçük ya da kat başına gözlem azsa DML1 kat ortalaması, DML2 ise tüm skoru birlikte çözer; paydalar (\sum\hat v^2) kat içinde dengesiz ise DML1 gürültüleşir. Örnek veride \hat\theta 5940{,}64 (DML2) ve 5955{,}18 (DML1), SH'ler özdeştir (1522{,}09 ve 1522{,}10). Chernozhukov ve ark. DML2'yi önerir.
S5. `tekrar` kaç olmalı ve ortanca neden kullanılıyor?
Bölme rastgele olduğundan her bölme farklı bir \hat\theta_r verir. Ortanca, uç bölmelere dayanıklıdır; SH'ye eklenen (\hat\theta_r-\hat\theta)^2 terimi bölmeler arası değişkenliği yansıtır. Yayımlanan çalışma 100 bölme kullanır; hesap maliyeti bölme sayısıyla doğrusaldır (5 bölme 70{,}7 s). Pratikte rapor edilen sonuç için 20–100 bölme önerilir; şablonun varsayılanı 1'dir ve çıktı notu bunu hatırlatır.
S6. Yardımcı modellerin RMSE'si neden önemli?
DML'nin geçerliliği yardımcı fonksiyonların yeterince hızlı kestirilmesine bağlıdır (çarpımsal hata n^{-1/2}'den küçük). RMSE bu yeteneğin kaba bir ölçüsüdür: \ell için RMSE'nin Y'nin sd'sine yakın olması (54963 ve 63523) karıştırıcıların sonucu az açıkladığını, m için 0{,}443'ün tedavi oranının sd'sine (0{,}483) yakın olması eğilimi zayıf ayırdığını söyler. İkisi de kötü öğrenilmiş yardımcı model değil, veriye özgü zayıf sinyal olabilir; şablon RMSE'yi tek başına bir eşikle yorumlamaz.
S7. Sınır durumu: küçük örneklem ya da dengesiz tedavi
120 satırda \hat\theta=-2143{,}63 ve SH 10822{,}8: aralık 0'ı geniş biçimde içerir. IRM'de bir tedavi grubunda 2K'den az gözlem şablonu durdurur (181). Eğilimin kuyrukları (\hat m 0'a ya da 1'e yakın) ağırlıkları büyütür; kirpma bu durumda sonucu yönetir; örtüşme tanısı tablosu kırpılan sayıyı yazar (124.7, 124.8).
S8. Rastgele orman yerine lasso ne zaman?
Karıştırıcı sayısı gözlem sayısına yakın ya da seyrek doğrusal yapı makulse lasso daha kararlı ve hızlıdır (8,89 s). Doğrusal olmayan ilişkiler varsa rastgele orman. Bu veride lasso (5937{,}75) doğrusal öğrenici (5940{,}64) ile hemen hemen aynıdır; ormanla \approx3400 fark vardır: veri doğrusal olmayan yapı içeriyor demektir.
S9. Başka bir uygulama ile sonuç neden 10^{-2} ayrışır?
Aynı bölme, aynı skor ve doğrusal öğrenicide özdeş sonuç beklenir (124.6.1: 10^{-13}). Rastgele ormanda ağaç üretimi ve kat bölmesi paket ve tohuma bağlıdır; farklı bir ortamda ya da farklı ranger sürümüyle \hat\theta bir yarım SH içinde ayrışabilir. Karşılaştırma için bölme tekrarını yüksek tutun (ortanca kararlıdır).
124.10 Kaynaklar
- Bach, P., Kurz, M. S., Chernozhukov, V., Spindler, M., & Klaassen, S. (2024). DoubleML: An object-oriented implementation of double machine learning in R. Journal of Statistical Software, 108(3). https://doi.org/10.18637/jss.v108.i03
- Chernozhukov, V., Chetverikov, D., Demirer, M., Duflo, E., Hansen, C., Newey, W., & Robins, J. (2018). Double/debiased machine learning for treatment and structural parameters. The Econometrics Journal, 21(1), C1–C68. https://doi.org/10.1111/ectj.12097
- Chernozhukov, V., & Hansen, C. (2004). The effects of 401(k) participation on the wealth distribution: An instrumental quantile regression analysis. Review of Economics and Statistics, 86(3), 735–751. https://doi.org/10.1162/0034653041811734
- Crump, R. K., Hotz, V. J., Imbens, G. W., & Mitnik, O. A. (2009). Dealing with limited overlap in estimation of average treatment effects. Biometrika, 96(1), 187–199. https://doi.org/10.1093/biomet/asn055
- Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1). https://doi.org/10.18637/jss.v033.i01
- Lang, M., Binder, M., Richter, J., Schratz, P., Pfisterer, F., Coors, S., Au, Q., Casalicchio, G., Kotthoff, L., & Bischl, B. (2019). mlr3: A modern object-oriented machine learning framework in R. Journal of Open Source Software, 4(44), 1903. https://doi.org/10.21105/joss.01903
- Lovell, M. C. (1963). Seasonal adjustment of economic time series and multiple regression analysis. Journal of the American Statistical Association, 58(304), 993–1010. https://doi.org/10.1080/01621459.1963.10480682
- Robinson, P. M. (1988). Root-N-consistent semiparametric regression. Econometrica, 56(4), 931–954. https://doi.org/10.2307/1912705
- Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1). https://doi.org/10.18637/jss.v077.i01
- Yazılım kaydı (şablonun
ozet.jsonçıktısı): R 4.5.3; DoubleML 1.0.2, mlr3 1.8.0, mlr3learners 0.16.0, ranger 0.18.0, data.table 1.18.4, lgr 0.5.2, glmnet 5.1.