194. Ağ meta-analizi (frekansçı, çizge kuramsal) ve P-skoru sıralaması
Şablon kimliği: ag_meta · Kategori: meta-analiz · Dil: R · Dosya: pro/sablonlar/meta_analiz/ag_meta.R (satır 1–224; üstbilgi 1–101) · Örnek veri: _ornek/senn2013.csv · Paketler: netmeta 3.7-0 (meta 8.5-0), R 4.5.3
194.1 Ne işe yarar
Şablon, üç ya da daha çok tedavinin (müdahalenin) karşılaştırıldığı, ama her çalışmanın bunların yalnız birkaçını içerdiği durumda doğrudan kanıtı (aynı çalışmada karşılaştırılan tedaviler) ve dolaylı kanıtı (ortak bir karşılaştırıcı üzerinden) tek tutarlı modelde birleştirir. Girdi karşılaştırma düzeyindeki veridir: her satır bir çalışmanın bir karşılaştırmasıdır (çalışma, tedavi 1, tedavi 2, etki = tedavi 1 - tedavi 2, etkinin standart hatası). Kestirim netmeta ile yapılır (Balduzzi ve ark., 2023); yöntem Rücker'in (2012) çizge kuramsal, yani elektrik ağı benzetmesine dayanan ağırlıklı en küçük karelerdir.
- y_i: i. karşılaştırmanın etkisi (tedavi 1 - tedavi 2); s_i: standart hatası; a(i), b(i): karşılaştırmadaki iki tedavi.
- \delta_t: t tedavisinin (belirsiz bir sabite kadar tanımlı) gerçek etkisi. Yalnız farklar \theta_{ab}=\delta_a-\delta_b yorumlanır; şablon bunları başvuru tedaviye göre ve tüm çiftler için (lig tablosu) verir.
- Aynı çalışmadaki birden çok karşılaştırma ilişkilidir (ortak kollar); şablon bunu "çok kollu çalışma" olarak otomatik ele alır (194.4.2).
Şablon ortak etki ve rastgele etkiler modelini birlikte kurar; \tau^2 (çalışmalar arası varyans), toplam Q ve onun tasarım içi/tasarımlar arası ayrıştırması (tutarsızlık), I^2, P-skorları (ya da benzetimle SUCRA), lig tablosu, ağ çizgesi ve orman grafiğini üretir.
Ne zaman kullanılır? En az üç tedavi vardır, ağ bağlıdır (her tedaviden her tedaviye karşılaştırma yolu bulunur) ve elinizde karşılaştırma başına etki ile standart hata vardır. Aynı tedavi çifti için doğrudan ve dolaylı kanıt birleşir; hiç karşılaştırılmamış çiftlerin farkı da kestirilir.
Ne zaman kullanılmaz?
- Yalnız iki tedavi varsa: temel programdaki meta-analiz ya da
cok_duzeyli_meta(Bölüm 196) veoran_meta(ikili sonuç için tek karşılaştırma). Şablon üç tedaviden azında durur (194.2). - Aynı çalışmadan birden çok sonuç varsa (ör. iki ayrı ölçüt):
cok_degiskenli_meta(Bölüm 195). Bu şablon her çalışma-karşılaştırmayı tek sonuç sayar. - Ağ bağlı değilse (iki ayrı alt ağ): şablon durur; ayrı ağları ayrı çözümleyin ya da bağlayıcı bir karşılaştırma ekleyin (194.2).
- Veri kol düzeyindedir (olay sayıları, ortalama ve sd): bu şablon kol verisini kullanmaz; önce karşılaştırma düzeyine (etki, SH) dönüştürmelisiniz. Çok kollu bir çalışmada tüm ikili karşılaştırmaları ve aralarındaki ilişkiyi tutarlı verin (194.4.2).
- Doz–yanıt ilişkisi için
doz_yanit_meta; tanısal doğruluk içintanisal_meta.
Temel programla ilişki. Temel programda ağ meta-analizi yoktur; ikili (çiftli) meta-analiz her karşılaştırmayı ayrı toplar ve dolaylı kanıtı kullanmaz. Bu şablon bütün ağı tek modelde kestirir ve doğrudan ile dolaylı kanıtın tutarlı olup olmadığını Q ayrıştırmasıyla sınar.
194.2 Şablonun girdileri
Form, üstbilgideki 14 [[param]] bloğundan kurulur (ag_meta.R:10–100). Türlerin anlamı ve ortak denetimi Bölüm 1.2'dedir. te ve se sayısal roldür: Veri sekmesinde "kategorik" olsalar da R'ye sayı gider (Bölüm 1.3). Tedavi ve çalışma sütunları kategorik_sutun'dur: sayısal ya da metin olabilir; kodda metne çevrilirler (mq_kimlik, 122).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Etki (tedavi 1 − tedavi 2) · te |
sayısal sütun · Değişkenler | uygun ilk sayısal sütun | sayısal sütun | y_i (10–14, 106, 123). |
Etkinin standart hatası · se |
sayısal sütun · Değişkenler | uygun ilk sayısal sütun | sayısal sütun, >0 | s_i (15–19, 106, 123, 126). |
Tedavi 1 · tedavi1 |
kategorik sütun · Değişkenler | uygun ilk sütun | sütun | Pozitif işaretli tedavi (20–24, 122). |
Tedavi 2 · tedavi2 |
kategorik sütun · Değişkenler | uygun ilk sütun | sütun | Negatif işaretli tedavi (25–29, 122). |
Çalışma etiketi · calisma |
kategorik sütun · Değişkenler | uygun ilk sütun | sütun | Çok kollu çalışmayı tanıtır (30–34, 122). |
Referans tedavi · referans |
metin · Seçenekler | boş | boş ya da veride bulunan tedavi | Etki tablosunun başvurusu; boşsa sıradaki ilk tedavi: adlar sayıysa sayısal, değilse harf sırası (35–40, 128–141). |
Etki ölçüsü · olcu |
seçim · Model | MD |
MD, SMD, OR, RR, HR |
sm (41–47, 173). Hesabı değiştirmez; yalnız konsol çıktısının ölçeğini ve etiketini belirler; tablo başlıklarına "(log ölçeği)" eklenir (194.8). |
Küçük etki değerleri · kucuk_iyi |
seçim · Seçenekler | iyi |
iyi, kotu |
small.values; P-skorunun yönü (48–54, 176). |
\tau^2 kestiricisi · tau_yontemi |
seçim · Model | DL |
DL, REML, ML |
DL: netmeta(method.tau); REML/ML: τ² önce metafor::rma.mv ile tam çok kollu kovaryansla kestirilir ve tau.preset ile verilir (55–61, 145–176). |
Rastgele etkiler güven aralığı · rastgele_ga |
seçim · Seçenekler | classic |
classic, t-dist |
method.random.ci (62–68, 174). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | level.ma (69–76, 174; orman grafiği başlığı 219–221). |
Tedavi sıralama ölçütü · siralama |
seçim · Seçenekler | P-score |
P-score, SUCRA |
netrank(method =) (77–83, 203–204). |
SUCRA benzetim sayısı · nsim |
tamsayı · Seçenekler | 1000 | 100–100 000 | Yalnız SUCRA'da (84–92, 204). |
Lig tablosu ondalık basamağı · ondalik |
tamsayı · Çıktı | 3 | 0–10 | round(…, ondalik) (93–100, 213). |
Örnek ayar (ornek_param, satır 9): te = TE, se = seTE, tedavi1 = treat1, tedavi2 = treat2, calisma = studlab, referans = plac, kucuk_iyi = iyi; öteki varsayılan.
Tohum. P-skoru, ortak/rastgele etki ve Q belirlenimcidir. Yalnız siralama = SUCRA seçiliyken benzetim vardır ve sonuç tohuma bağlıdır; Kod panelinin isteğe bağlı Tohum alanı (Bölüm 1.3) aynı tohumda aynı SUCRA'yı verir. Şablonun kendi formunda tohum alanı yoktur.
Şablonun kendi denetimleri (mq_hata):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 105 |
| Beş sütundan ikisi aynı | "Beş sütun birbirinden farklı olmalı." | 107 |
| Eksiksiz karşılaştırma <3 | "En az 3 karşılaştırma gerekli." | 125 |
| Bir SH sonlu değil ya da \le0 | "Standart hatalar pozitif olmalı." | 126 |
| Bir satırda tedavi 1 = tedavi 2 | "Bir satırda tedavi 1 ile tedavi 2 aynı." | 127 |
| Tedavi sayısı <3 | "Ağ için en az 3 tedavi gerekli." | 132 |
| Referans veride yok | "Referans tedavi '…' veride yok. Tedaviler: …" | 140 |
netmeta hata verirse (ör. ağ bağlı değil) |
"Ağ meta-analizi kurulamadı (ağ bağlı olmayabilir): …" | 177 |
| Çok kollu çalışmanın (üç ya da daha çok satır) yalnız bir kısmı eksik | "'…' çok kollu çalışmasının … karşılaştırmasından … tanesinde eksik değer var; …" | 113–116 |
| Tedavi ya da çalışma adı boş | "Tedavi ya da çalışma adı boş olan satır var." | 124 |
Eksik değerli satırlar atılır ve sayısı konsola yazılır: "Not: eksik değer içeren 1 satır çözümlemeden çıkarıldı (28 satırdan 27 satır kaldı)" (109–120). Çok kollu bir çalışmanın (üç ya da daha çok satırı olan) yalnız bir kısmı eksikse çalışma durur: kalan satırlarla çalışma içi kovaryans düzeltmesi kurulamaz (113–116). Referans metni baş/son boşluktan arındırılır (133). Sıralama ve şekil adımları hata verirse ilgili tablo ya da şekil atlanır ve hatanın iletisi "… hesaplanamadı / çizilemedi" notuyla yazılır (204–205, 216–223).
194.3 Örnek veri
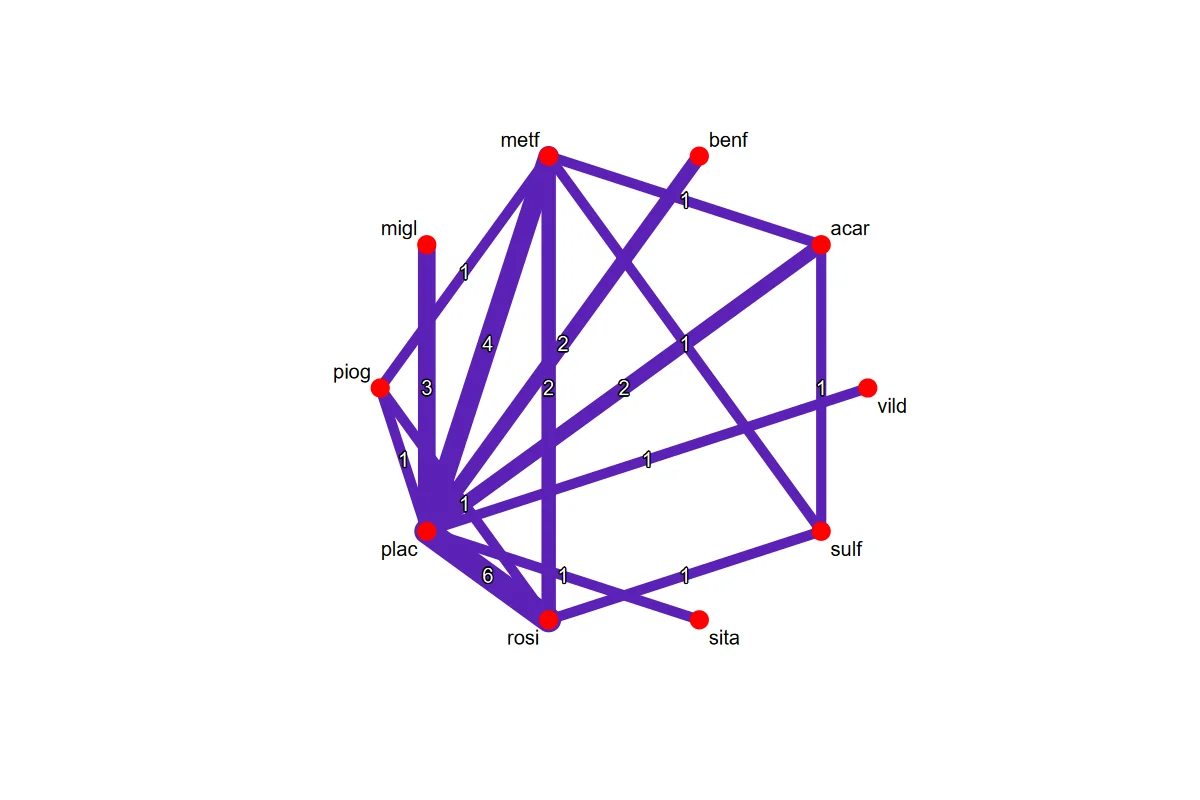
senn2013.csv, Senn ve ark. (2013) tip 2 diyabette glisemik kontrol ağıdır; sonuç HbA1c'deki ortalama farktır (küçük, yani daha çok düşüş istenir). 28 satır, 26 çalışma, 10 tedavi, 15 tasarım; eksik değer yok. Bir çalışma (Willms1999) üç kollu olduğundan üç satırdır (metf–plac, acar–plac, metf–acar). Aynı veri netmeta paketinin örnek verisidir.
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
studlab |
çalışma | kategorik | 26 çalışma; Willms1999 3 satır |
treat1, treat2 |
tedavi 1, tedavi 2 | kategorik | acar, benf, metf, migl, piog, plac, rosi, sita, sulf, vild |
TE |
etki (tedavi 1 - tedavi 2) | sayısal | -1{,}90 ile 0{,}16 arası (ortalama -0{,}78) |
seTE |
standart hata | sayısal | 0{,}0849–0{,}4669 |
Düzey sırası: şablon tedavi adlarını mq_kimlik ile metne çevirir ve sıralar (122, 128–131): bütün adlar sayıya çevrilebiliyorsa sayısal sıra (2, 10), değilse sort(method = "radix") ile harf sırası; Veri sekmesinin düzey sırası (ilk görülme kuralı, Bölüm 1.3) kullanılmaz. Etki tablosu ve lig tablosu bu sırayla yazılır (180, 213). Sıra yalnız boş bırakılan referansı ve tablo sırasını etkiler: boş referansta sıradaki ilk tedavi (örnekte harf sırasına göre acar, verideki ilk tedavi metf değil) başvuru alınır ve çıktıya "Başvuru tedavisi boş bırakıldı: tedavi sırasında (harf sırası) ilk olan 'acar' başvuru alındı" yazılır (134–139). 1–10 kodlu tedavilerde sıra "1, 2, …, 10"dur.
Bu bölümde kullanılan çalıştırmalar (ayrıntı dogrulama/ag_meta/):
| Ad | Ayar |
|---|---|
q4_ag_ornek |
örnek ayar |
q4_ag_reml, q4_ag_ml, q4_ag_reml_metf |
tau_yontemi = REML; ML; REML ve referans = metf |
q4_ag_tkotu |
rastgele_ga = t-dist, kucuk_iyi = kotu, guven = 0,90 |
q4_ag_sucra1, q4_ag_sucra1b, q4_ag_sucra2 |
siralama = SUCRA, nsim = 1000; tohum 12345 (iki kez) ve 999 |
q4_ag_metf, q4_ag_refyok, q4_ag_refbos |
referans = metf; olmayan referans; boş referans |
q4_ag_or |
olcu = OR |
q4_ag_baglantisiz, q4_ag_ayni, q4_ag_ters, q4_ag_eksik, q4_ag_uc, q4_ag_sayisal |
veri türevleri: iki alt ağ; bir satırda tedavi 1 = tedavi 2; bütün karşılaştırmalar ters yönlü; bir SH eksik; 3 çalışmalık dalsız ağ; tedaviler 1–10 kodlu |
194.4 Yöntem: formüller ve hesap adımları
Şablon beş sütunu seçer, tamamlanmış satırları alır, tedavi ve çalışma adlarını metne çevirir (106–124), denetimleri yapar (125–141), REML/ML seçiliyse τ²'yi tam çok kollu kovaryansla kestirir (142–172) ve netmeta(TE, seTE, tedavi1, tedavi2, calisma, …, common = TRUE, random = TRUE) ile hem ortak hem rastgele etkiler modelini kestirir (173–177). Sonra konsola summary yazar (178) ve başvuruya göre etkiler, heterojenlik, sıralama ve lig tablolarını çıkarır.
194.4.1 Çizge kuramsal ortak etki kestirimi
N bağımsız karşılaştırma ve n tedavi için \mathbf B (N\times n) her satırda tedavi 1 için +1, tedavi 2 için -1 taşıyan çizge ilişki matrisidir; \mathbf W=\operatorname{diag}(1/s_i^2). Ağın Laplace matrisi \mathbf L=\mathbf B^{\top}\mathbf W\mathbf B (n\times n, tekil) ve genelleştirilmiş tersidir \mathbf L^{+} (Rücker, 2012):
- \mathbf L: tedaviler çizgesinin Laplace matrisi; kenar ağırlığı 1/s_i^2, yani kanıtın hassasiyeti ("iletkenlik"). L^{+} Moore–Penrose tersidir; \delta yalnız sabite kadar tanımlı olduğundan \mathbf L tersinemez.
- \mathbf H: şapka matrisi; \hat{\mathbf y}=\mathbf H\mathbf y modelin karşılaştırmalar için uyduğu değerlerdir. Köşegen H_{ii}, i. karşılaştırmanın kendi verisine verdiği ağırlığı (kaldıraç) gösterir; konsol çıktısındaki
Q leveragesütunu buna dayanır. - Bu çözüm, tedavi etkilerinin başvuruya göre kestirildiği genelleştirilmiş en küçük kareler (GLS) çözümüyle aynıdır (Lu ve Ades, 2004); 194.6'da GLS yoluyla yeniden hesaplanır.
Neden çizge yöntemi
Ağırlıklı en küçük kareler çözümü matris tersine dayanır; elektrik ağı benzetmesi ise "ters varyans = iletkenlik" ve "tedavi etkisi = düğüm potansiyeli" eşlemesiyle aynı çözümü verir ve hat matrisinin yorumunu sağlar. Hesap sonuçları GLS ile bire bir eşittir; fark yalnız gösterimdedir.
Ortak etki modeli, tüm çalışmaların aynı gerçek etkiyi paylaştığını varsayar (\tau^2=0). Her tedavi-başvuru farkı için güven aralığı ve p değeri normal dağılıma dayanır:
- g:
guven(0{,}95); z_{(1+g)/2} standart normal kuantili. Aralıklarlevel.maile g düzeyindedir (174).
194.4.2 Çok kollu çalışmalar
a kollu bir çalışma a(a-1)/2 ikili karşılaştırma içerir ama yalnız a-1 tanesi bağımsızdır; satırlar arasında ortak kol nedeniyle ilişki vardır. Bu şablonun girdisi yalnız y_i ve s_i olduğundan netmeta, çalışma içi ilişkiyi karşılaştırma varyanslarından kurar: a kollu çalışmada başvuru kola göre a-1 karşılaştırmanın kovaryans matrisi
- b: çalışmanın başvuru kolu; s_{ij}: i ile j kolları arasındaki karşılaştırmanın SH'si. Kollar bağımsızsa s_{ij}^2=v_i+v_j (v: kol varyansı) olur ve \Sigma_{ij}=v_b çıkar (kutuplaştırma özdeşliği).
- Örnekte
Willms1999: s^2 değerleri 0{,}3758^2=0{,}14123 (metf–plac), 0{,}4669^2=0{,}21800 (acar–plac), 0{,}3579^2=0{,}12809 (metf–acar); buradan v_{\text{metf}}=0{,}02566, v_{\text{acar}}=0{,}10243, v_{\text{plac}}=0{,}11556 ve plasebo başvurulu iki karşılaştırmanın kovaryansı 0{,}11556 çıkar.
Rücker ve Schwarzer (2014) çizge yönteminde aynı şeyi, çok kollu çalışmanın kenar ağırlıklarını düşürerek yapar ("ağırlık azaltma"). Ortak etki sonuçları GLS ile 10^{-6} içinde örtüşür (194.6). Konsol çıktısındaki seTE.adj.c ve seTE.adj.r sütunları bu ayarlanmış standart hataları gösterir.
Çok kollu çalışmanın tüm satırları verilmeli
Üç kollu bir çalışmayı yalnız iki satırla (ör. iki kolun plasebo ile farkı) verirseniz ilişki bilgisi eksik kalır; netmeta tutarsız varyans bulursa ya da satırlar eksikse sonuç yanlıdır. Üç kollu çalışma için üç satırın üçünü de girin ve SH'leri aynı kol varyanslarından üretin.
194.4.3 Heterojenlik, tasarım ayrıştırması ve \tau^2
Uyum kalıntısı ve toplam heterojenlik istatistiği
- \mathbf W^{*}: çok kollu düzeltmeli ağırlık matrisi; N bağımsız karşılaştırma sayısı (28 satır içinde 27 bağımsız:
Willms1999iki bağımsız karşılaştırma sağlar). Örnekte \mathrm{sd}=27-9=18. - I^2: toplam değişkenliğin heterojenliğe düşen payı.
\tau^2 (DL). Varsayılan kestirici genelleştirilmiş DerSimonian–Laird moment kestiricisidir (DerSimonian ve Laird, 1986; çok değişkenli biçimi Jackson ve ark., 2010). Her çalışmada karşılaştırmaların rastgele etkileri, ortak kollar nedeniyle kovaryans \tau^2/2 ve varyans \tau^2 taşır:
- \mathbf X: karşılaştırmaları başvuruya göre tedavi parametrelerine bağlayan tasarım matrisi; \mathbf Z: çalışma bloklarında \tfrac12(\mathbf I+\mathbf J) olan matris (\mathbf J: birler).
- Örnekte c=726{,}525 ve \hat\tau^2=(96{,}98555-18)/726{,}5249=0{,}108717.
Rastgele etkiler modelinde çalışma içi kovaryans matrisine \hat\tau^2\mathbf Z eklenir ve aynı GLS çözülür. Yalnız bir çalışmayla desteklenen karşılaştırmada rastgele etkiler SH'si \sqrt{s^2+\tau^2} olur: sita için \sqrt{0{,}1291^2+0{,}108717}=0{,}35410 (tabloda 0{,}3541).
Q ayrıştırması. Toplam Q, tasarım içi heterojenlik ile tasarımlar arası tutarsızlığa ayrılır (Higgins ve ark., 2012; Krahn ve ark., 2013): tasarım içi bileşen her tasarımda, o tasarımın çalışmalarını ayrı birleştirerek bulunan Q'ların toplamıdır; fark tasarımlar arası Q'dur:
- Tasarım d: bir çalışmada karşılaştırılan tedaviler kümesi (ör. {metf, plac}); örnekte 15 tasarım. Q_{\text{içi}} aynı tasarımdaki çalışmalar arasında, Q_{\text{arası}} ise tasarımlar arasında tutarsızlık gösterir (Q_{\text{arası}} anlamlıysa doğrudan ve dolaylı kanıt birbirine uymuyordur).
Koddaki tercih
DL seçildiğinde netmeta(method.tau = "DL") yukarıdaki kapalı biçimi kullanır (174). REML ve ML seçildiğinde şablon \tau^2'yi kendisi kestirir (tau_kesin, 145–168): her çalışmada alfabetik ilk kol başvuru alınır ve a-1 karşılaştırma kurulur, çalışma içi kovaryans 194.4.2'deki kutuplaştırma formülüyle tam yazılır, rastgele etki yapısı \mathbf Z=\tfrac12(\mathbf I+\mathbf J) (her kolda bağımsız rastgele etki; \rho=0{,}5) olur ve metafor::rma.mv(…, random = ~ factor(kol) | calisma, rho = 0.5) ile REML/ML eniyilenir. Elde edilen \hat\tau^2 netmeta'ya tau.preset = sqrt(tau2) ile verilir (175); rastgele etkiler tablosu, P-skorları ve lig tablosu bu \tau^2'yle hesaplanır. Bu \tau^2 başvuru tedaviden bağımsızdır (olabilirlik, başvuru kol seçiminden değişmez). Bir çalışmada bir karşılaştırma çifti eksik ya da yinelenmişse ya da rma.mv yakınsamazsa netmeta'nın kendi kestirimi kullanılır ve not yazılır (170–172).
t aralığı. rastgele_ga = t-dist seçildiğinde rastgele etkiler aralıkları ve p değerleri normal yerine t dağılımına dayanır; serbestlik derecesi Q'nun sd'sidir (örnekte 18): q4_ag_tkotu çıktısı "Random effects confidence intervals based on t-distribution (df = 18)" der. Ortak etki aralıkları değişmez (194.7). Bu, Knapp–Hartung ayarı değildir: SH'ler aynı kalır, yalnız kritik değer değişir (Knapp ve Hartung, 2003; IntHout ve ark., 2014).
194.4.4 P-skoru, SUCRA ve lig tablosu
İki tedavi için, bir tedavinin ötekinden daha iyi olduğu tek yönlü olasılık (küçük değerler istenirse):
- \widehat{\mathrm{se}}_{ij}^2=L^{+}_{ii}+L^{+}_{jj}-2L^{+}_{ij} (rastgele etkilerde \tau^2 eklenmiş ağdan). P_{ij}: i'nin j'den daha küçük etkiye sahip olma olasılığı;
kucuk_iyi = kotuise işaret ters çevrilir. - P-skoru 1'e yakınsa tedavi öbürlerinden neredeyse hep daha iyidir; 0'a yakınsa neredeyse hep daha kötü. Ortalama 0{,}5'tir (Rücker ve Schwarzer, 2015).
SUCRA (Salanti ve ark., 2011), kestirimlerin çok değişkenli normal dağılımından nsim çekim yapıp tedavilerin sıra olasılıklarını bularak aynı ölçüyü verir; P-skoru onun analitik karşılığıdır, benzetimsiz ve tohumdan bağımsızdır. Lig tablosu (lig, 213) rastgele etkiler modelinin tüm çift farklarıdır: satır tedavi - sütun tedavi, round(…, ondalik) ile yuvarlanmış.
Koddaki tercih
netrank(nm) ya da netrank(nm, method = "SUCRA", nsim = …) (204). Tablo rastgele etkiler P-skoruna göre azalan sıralanır (209), ortak sütunu aynı sırada yazılır ve ortak etkilerde sıra farklı olabilir. netrank hata verirse tablo atlanır ve "tedavi sıralaması hesaplanamadı: …" notu yazılır (205).
194.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 102–105 | .m() yardımcısı; netmeta yüklenir; veri denetimi. |
|
| 106–120 | Beş sütunun farklılığı; sütunlar seçilir; eksik satırlar sayılır (çok kollu çalışmadan yarım eksik hata); atılan satır sayısı yazılır. | |
| 121–127 | Adlar TE, seTE, t1, t2, st yapılır; tedaviler ve çalışma metne (mq_kimlik), etki ve SH sayıya (mq_sayisal) çevrilir; satır sayısı (\ge3), SH pozitifliği, kendi kendine karşılaştırma denetimleri. |
Sayısal rol sütunlar zaten sayı olarak gelir. |
| 128–141 | Tedavi sırası (sayısal ya da harf), tedavi sayısı (\ge3); referans: boşsa sıradaki ilk tedavi ve not; veride yoksa hata. | |
| 142–172 | tau_kesin: REML/ML için tam çok kollu kovaryansla \tau^2; kurulamazsa not. |
DL'de çalışmaz. |
| 173–178 | netmeta(…) çağrısı (tau.preset); hata iletisi çevrilir; summary(nm) konsola yazılır. |
Uyarılar bastırılır (suppressWarnings). |
| 180–189 | Başvuruya göre etkiler tablosu: ortak ve rastgele; etki, SH, GA, p. OR/RR/HR seçiliyse başlıkta "(log ölçeği)". |
|
| 191–201 | Heterojenlik tablosu: k, tedavi, tasarım, Q, sd, p, \tau^2, \tau, I^2, Q_{\text{içi}}, Q_{\text{arası}}. Dalsız ağda (\mathrm{sd}=0) not yazılır, Q'lar 0 gösterilir. | k çalışma sayısıdır (26). |
| 203–212 | P-skoru ya da SUCRA; rastgele P-skoruna göre sıralı tablo. | Hata olursa not. |
| 213–214 | Lig tablosu (tedavi sırasıyla). | Yuvarlama yalnız tabloya uygulanır. |
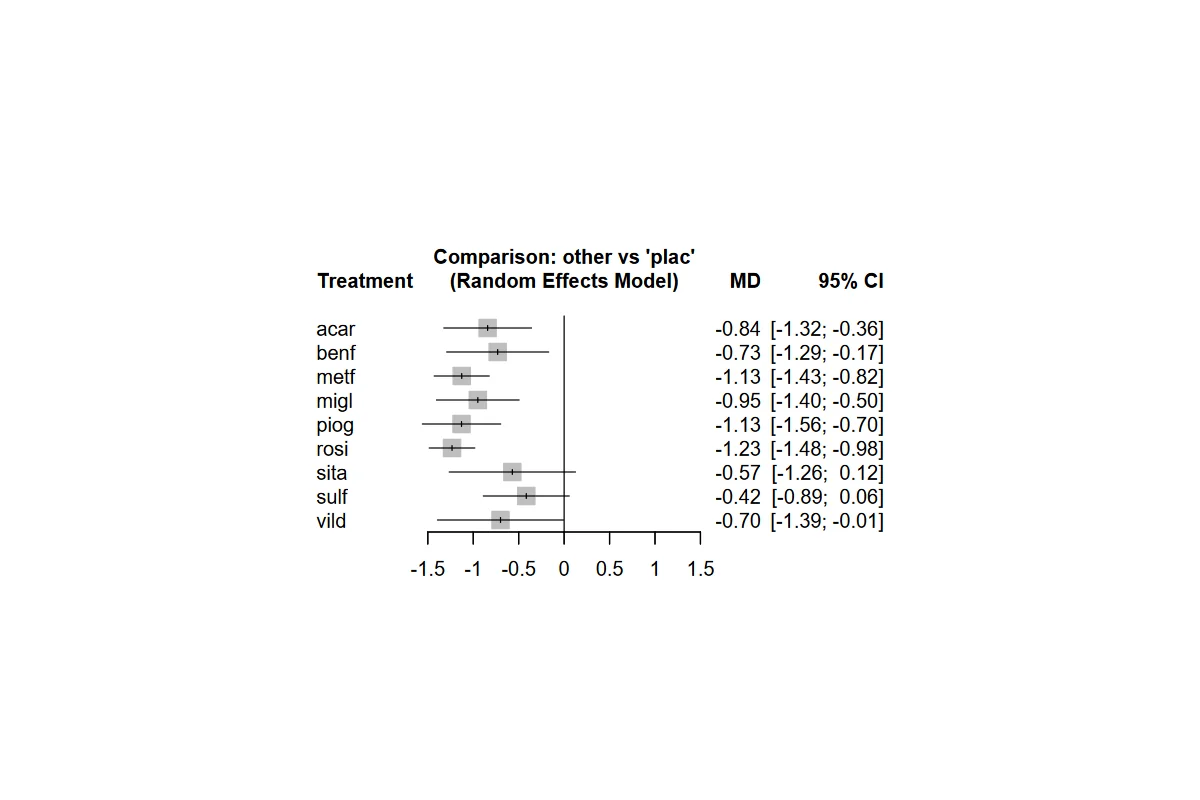
| 216–223 | Ağ çizgesi (kenar kalınlığı çalışma sayısı) ve rastgele etkiler orman grafiği (başlık guven düzeyini yazar). |
Hata olursa not. |
194.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/ag_meta/elle_hesap.py (numpy/scipy; netmeta ve şablonun ana işlevi kullanılmaz) ve r_dogrulama.R (açık matris formülü; REML/ML için metafor::rma.mv) ile hesaplanmıştır. İkisi de aynı yoldan gider: her çalışmada alfabetik ilk kolu başvuru alıp a-1 karşılaştırma kurar, kovaryansı 194.4.2'deki kutuplaştırma formülüyle yazar ve GLS çözer. Başvuru olarak plac alındığında tedavi parametreleri 9'dur.
Adım 1 — Tasarım. 28 satır içinden 27 bağımsız karşılaştırma (25 ikili çalışma + Willms1999'dan 2) ve 9 parametre kalır; \mathrm{sd}=27-9=18. 15 tasarım vardır.
Adım 2 — Ortak etki. \hat{\boldsymbol\delta}=(\mathbf X^{\top}\mathbf V^{-1}\mathbf X)^{-1}\mathbf X^{\top}\mathbf V^{-1}\mathbf y; örneğin acar için -0{,}827370 (SH 0{,}108521), metf için -1{,}114110 (0{,}059611), rosi için -1{,}201842 (0{,}047662).
Adım 3 — Q ve \tau^2. Q=96{,}985553, \mathrm{sd}=18, I^2=0{,}814405; c=\operatorname{tr}(\mathbf P\mathbf Z)=726{,}52491; \hat\tau^2=0{,}10871692.
Adım 4 — Rastgele etki. \mathbf V+\hat\tau^2\mathbf Z ile aynı GLS: acar -0{,}841785 (SH 0{,}245820), rosi -1{,}233456 (0{,}127802).
Adım 5 — Tasarım ayrıştırması. 15 tasarımın her biri ayrı uydurulur: Q_{\text{içi}}=74{,}455282 (sd 11); Q_{\text{arası}}=96{,}985553-74{,}455282=22{,}530271 (sd 7; p=0{,}0020570).
Adım 6 — P-skoru. Her çift için P_{ij}=\Phi(\cdot) ve ortalama: ortak etkilerde rosi 0{,}978903, plac 6{,}49\cdot10^{-7}; rastgele etkilerde rosi 0{,}893368, plac 0{,}013895.
Adım 7 — REML ve ML. Çok kollu kovaryansın tam kullanıldığı model (\mathbf V blok-köşegen, \mathbf Z=\tfrac12(\mathbf I+\mathbf J)): \hat\tau^2_{\text{REML}}=0{,}0999175, \hat\tau^2_{\text{ML}}=0{,}0563861 (bağımsız Python ve rma.mv); şablonun çıktısı da bu değerleri verir.
194.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| ortak etki, acar | −0,82736897 | −0,82736897 | −0,82736897 | 1,0e−14 | ✓ |
| ortak etki, benf | −0,90518645 | −0,90518645 | −0,90518645 | 1,4e−13 | ✓ |
| ortak etki, metf | −1,11411019 | −1,11411019 | −1,11411019 | 2,1e−14 | ✓ |
| ortak etki, migl | −0,94393296 | −0,94393296 | −0,94393296 | 3,2e−15 | ✓ |
| ortak etki, piog | −1,06643311 | −1,06643311 | −1,06643311 | 1,0e−14 | ✓ |
| ortak etki, rosi | −1,20184201 | −1,20184201 | −1,20184201 | 1,5e−14 | ✓ |
| ortak etki, sita | −0,57 | −0,57 | −0,57 | 5,0e−15 | ✓ |
| ortak etki, sulf | −0,43949715 | −0,43949715 | −0,43949715 | 9,2e−15 | ✓ |
| ortak etki, vild | −0,7 | −0,7 | −0,7 | 1,1e−14 | ✓ |
| ortak SH, acar | 0,10852085 | 0,10852085 | 0,10852085 | 6,2e−16 | ✓ |
| ortak SH, benf | 0,12709113 | 0,12709113 | 0,12709113 | 6,9e−16 | ✓ |
| ortak SH, metf | 0,05961148 | 0,05961148 | 0,05961148 | 2,2e−16 | ✓ |
| ortak SH, migl | 0,12690612 | 0,12690612 | 0,12690612 | 5,0e−16 | ✓ |
| ortak SH, piog | 0,07584751 | 0,07584751 | 0,07584751 | 1,4e−17 | ✓ |
| ortak SH, rosi | 0,04766217 | 0,04766217 | 0,04766217 | 1,1e−16 | ✓ |
| ortak SH, sita | 0,1291 | 0,1291 | 0,1291 | 0 | ✓ |
| ortak SH, sulf | 0,09147913 | 0,09147913 | 0,09147913 | 8,3e−17 | ✓ |
| ortak SH, vild | 0,1273 | 0,1273 | 0,1273 | 0 | ✓ |
| Q | 96,98555301 | 96,98555301 | 96,98555301 | 1,5e−16 | ✓ |
| Q sd | 18 | 18 | 18 | 0 | ✓ |
| τ² | 0,10871692 | 0,10871692 | 0,10871692 | 3,3e−16 | ✓ |
| I² | 0,81440535 | 0,81440535 | 0,81440535 | 3,3e−16 | ✓ |
| Q tasarım içi | 74,45528174 | 74,45528174 | 74,45528174 | 3,8e−16 | ✓ |
| Q tasarımlar arası | 22,53027127 | 22,53027127 | 22,53027127 | 7,9e−16 | ✓ |
| Q tasarımlar arası sd | 7 | 7 | 7 | 0 | ✓ |
| rastgele etki, acar | −0,84178494 | −0,84178494 | −0,84178494 | 1,0e−15 | ✓ |
| rastgele etki, benf | −0,73114721 | −0,73114721 | −0,73114721 | 3,2e−14 | ✓ |
| rastgele etki, metf | −1,12677535 | −1,12677535 | −1,12677535 | 4,3e−15 | ✓ |
| rastgele etki, migl | −0,94972638 | −0,94972638 | −0,94972638 | 1,6e−15 | ✓ |
| rastgele etki, piog | −1,12909195 | −1,12909195 | −1,12909195 | 7,9e−16 | ✓ |
| rastgele etki, rosi | −1,23345575 | −1,23345575 | −1,23345575 | 3,2e−15 | ✓ |
| rastgele etki, sita | −0,57 | −0,57 | −0,57 | 4,0e−15 | ✓ |
| rastgele etki, sulf | −0,4165588 | −0,4165588 | −0,4165588 | 3,5e−15 | ✓ |
| rastgele etki, vild | −0,7 | −0,7 | −0,7 | 2,0e−15 | ✓ |
| rastgele SH, acar | 0,24582031 | 0,24582031 | 0,24582031 | 3,3e−16 | ✓ |
| rastgele SH, benf | 0,28607505 | 0,28607505 | 0,28607505 | 6,1e−16 | ✓ |
| rastgele SH, metf | 0,15426658 | 0,15426658 | 0,15426658 | 1,9e−16 | ✓ |
| rastgele SH, migl | 0,23175854 | 0,23175854 | 0,23175854 | 8,3e−17 | ✓ |
| rastgele SH, piog | 0,21963813 | 0,21963813 | 0,21963813 | 1,9e−16 | ✓ |
| rastgele SH, rosi | 0,12780164 | 0,12780164 | 0,12780164 | 6,7e−16 | ✓ |
| rastgele SH, sita | 0,35409566 | 0,35409566 | 0,35409566 | 5,6e−17 | ✓ |
| rastgele SH, sulf | 0,24088381 | 0,24088381 | 0,24088381 | 1,4e−16 | ✓ |
| rastgele SH, vild | 0,35344337 | 0,35344337 | 0,35344337 | 4,4e−16 | ✓ |
| P-skoru (ortak), plac | 6,490743·10−7 | 6,490743·10−7 | 6,490743·10−7 | 4,6e−20 | ✓ |
| P-skoru (rastgele), plac | 0,01389505 | 0,01389505 | 0,01389505 | 1,4e−16 | ✓ |
| P-skoru (ortak), acar | 0,47918355 | 0,47918355 | 0,47918355 | 2,3e−14 | ✓ |
| P-skoru (rastgele), acar | 0,52026442 | 0,52026442 | 0,52026442 | 1,9e−15 | ✓ |
| P-skoru (ortak), benf | 0,57266419 | 0,57266419 | 0,57266419 | 1,4e−13 | ✓ |
| P-skoru (rastgele), benf | 0,43581702 | 0,43581702 | 0,43581702 | 2,3e−14 | ✓ |
| P-skoru (ortak), metf | 0,85127716 | 0,85127716 | 0,85127716 | 3,3e−14 | ✓ |
| P-skoru (rastgele), metf | 0,78177653 | 0,78177653 | 0,78177653 | 2,1e−15 | ✓ |
| P-skoru (ortak), migl | 0,62000441 | 0,62000441 | 0,62000441 | 2,6e−14 | ✓ |
| P-skoru (rastgele), migl | 0,61365553 | 0,61365553 | 0,61365553 | 3,7e−15 | ✓ |
| P-skoru (ortak), piog | 0,76863257 | 0,76863257 | 0,76863257 | 1,9e−14 | ✓ |
| P-skoru (rastgele), piog | 0,77456973 | 0,77456973 | 0,77456973 | 2,3e−15 | ✓ |
| P-skoru (ortak), rosi | 0,97890324 | 0,97890324 | 0,97890324 | 4,0e−15 | ✓ |
| P-skoru (rastgele), rosi | 0,89336818 | 0,89336818 | 0,89336818 | 2,1e−15 | ✓ |
| P-skoru (ortak), sita | 0,23861464 | 0,23861464 | 0,23861464 | 1,2e−15 | ✓ |
| P-skoru (rastgele), sita | 0,33309921 | 0,33309921 | 0,33309921 | 4,8e−15 | ✓ |
| P-skoru (ortak), sulf | 0,13949166 | 0,13949166 | 0,13949166 | 3,3e−15 | ✓ |
| P-skoru (rastgele), sulf | 0,21030766 | 0,21030766 | 0,21030766 | 3,8e−15 | ✓ |
| P-skoru (ortak), vild | 0,35122792 | 0,35122792 | 0,35122792 | 2,8e−14 | ✓ |
| P-skoru (rastgele), vild | 0,42324667 | 0,42324667 | 0,42324667 | 3,4e−15 | ✓ |
| τ² (REML) | 0,10105008 | 0,10105008 | 0,10105008 | 4,2e−10 | ✓ |
| rastgele etki acar (REML) | −0,84143319 | −0,84143319 | −0,84143319 | 2,0e−11 | ✓ |
| rastgele SH acar (REML) | 0,23940315 | 0,23940315 | 0,23940315 | 3,6e−10 | ✓ |
| τ² (ML) | 0,05673855 | 0,05673855 | 0,05673855 | 2,5e−10 | ✓ |
| rastgele etki acar (ML) | −0,83860232 | −0,83860232 | −0,83860232 | 2,1e−11 | ✓ |
| rastgele SH acar (ML) | 0,19668911 | 0,19668911 | 0,19668911 | 2,8e−10 | ✓ |
Ölçütü karşılayan: 69/69. REML ve ML satırlarında fark, iki kestirimin tek boyutlu eniyilemede yakınsama toleransından gelir (ölçüt 10−5).
194.7 Çıktıyı okuma
Örnek ayarın konsol özetinden (kısaltılmış) ve tablolarından:
Number of studies: k = 26
Number of pairwise comparisons: m = 28
Number of treatments: n = 10
Number of designs: d = 15

Random effects model
Treatment estimate (other treatments vs 'plac'):
          MD             95% CI     z  p-value
acar -0.8418 [-1.3236; -0.3600] -3.42   0.0006
metf -1.1268 [-1.4291; -0.8244] -7.30 < 0.0001
rosi -1.2335 [-1.4839; -0.9830] -9.65 < 0.0001
sita -0.5700 [-1.2640;  0.1240] -1.61   0.1075

Quantifying heterogeneity / inconsistency:
tau^2 = 0.1087; tau = 0.3297; I^2 = 81.4% [72.0%; 87.7%]

Tests of heterogeneity (within designs) and inconsistency (between designs):
                    Q d.f.  p-value
Total           96.99   18 < 0.0001
Within designs  74.46   11 < 0.0001
Between designs 22.53    7   0.0021
P-skoru sıralaması                      Lig tablosu (rastgele; satır − sütun; kısmen)
 tedavi P_skoru_ortak P_skoru_rastgele         acar   metf   plac   rosi
   rosi      0.978903          0.893368   acar  0      0.285 -0.842  0.392
   metf      0.851277          0.781777   metf -0.285  0     -1.127  0.107
   piog      0.768633          0.774570   plac  0.842  1.127  0      1.233
   ...                                    rosi -0.392 -0.107 -1.233  0
   plac      0.000001          0.013895
Şekil 194.1. Şablonun çizdiği ağ çizgesi (örnek veri): düğümler tedavi, kenar kalınlığı ve üzerindeki sayı o karşılaştırmayı içeren çalışma sayısıdır. `plac`–`rosi` (6 çalışma) ve `plac`–`metf` (4) en iyi bilgilendirilmiş kenarlardır; `benf`, `sita` ve `vild` yalnız plaseboya bağlıdır.
Şekil 194.2. Rastgele etkiler orman grafiği (örnek veri): her tedavinin plaseboya göre ortalama farkı ve %95 aralığı. `sita`, `sulf` ve `vild` aralıkları sıfırı içerir ya da ona dayanır; sıfır çizgisinin solundaki değerler HbA1c'de düşüş demektir.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Başvuruya göre etki (ortak, rastgele) | \hat\theta, SH, GA, p | Etki "tedavi - başvuru"dur; negatif değer HbA1c'de başvurudan fazla düşüş demektir. Ortak etki aralıkları daha dardır; heterojenlik büyükse rastgele etkiler aralıkları esas alınır. |
Q, Q_sd, Q_p |
Toplam heterojenlik | Q=96{,}99, sd 18, p<10^{-12}: çalışmalar arası ve/veya tasarımlar arası belirgin farklılık. |
tau2, tau, I2 |
Çalışmalar arası varyans ve pay | \tau^2=0{,}109, I^2=\%81{,}4: yüksek heterojenlik. \tau etki ölçeğindedir (HbA1c yüzde puanı). |
Q tasarım içi |
Aynı tasarımdaki çalışmaların uyumsuzluğu | 74{,}46 (sd 11): aynı karşılaştırmayı yapan çalışmalar birbirinden ayrışıyor. |
Q tasarımlar arası (tutarsızlık) |
Doğrudan/dolaylı kanıt uyumsuzluğu | 22{,}53 (sd 7, p=0{,}0021): tutarlılık varsayımı sorgulanmalı; ağdaki hangi döngünün sorumlu olduğu bu şablonda ayrıca gösterilmez (194.9). |
| P-skoru | Sıra olasılığı ortalaması | rosi (0{,}89) en iyi, plac (0{,}01) en kötü sırada. Sıralama belirsizliği göstermez: metf (0{,}78), piog (0{,}77) ve rosi etki aralıkları büyük ölçüde örtüşür. |
| Lig tablosu | Tüm çift farkları | \text{piog}-\text{metf}=-0{,}002: iki tedavi ayırt edilemez. Satır - sütun işaretine dikkat edin. |
Rapor cümlesi. Tip 2 diyabette dokuz oral antidiyabetik ile plasebo, 26 çalışmayla çizge kuramsal frekansçı ağ meta-analiziyle karşılaştırılmıştır (netmeta; rastgele etkiler, DerSimonian–Laird tipi \tau^2). HbA1c'de plaseboya göre ortalama fark rosiglitazon için -1{,}23 (%95 GA -1{,}48; -0{,}98), metformin için -1{,}13 (-1{,}43; -0{,}82) ve sitagliptin için -0{,}57 (-1{,}26; 0{,}12) bulunmuştur. Heterojenlik yüksektir (\tau^2=0{,}109; I^2=\%81{,}4) ve tasarımlar arası tutarsızlık anlamlıdır (Q=22{,}53, sd =7, p=0{,}002). P-skorlarına göre en yüksek sıra rosiglitazon (0{,}89), metformin (0{,}78) ve pioglitazondadır (0{,}77).
194.8 Sık hatalar ve tuzaklar
- Etki yönü = tedavi 1 - tedavi 2. Satırların bir kısmını ters (tedavi 2 - tedavi 1) girerseniz etki işaretini de değiştirmelisiniz. Bütün karşılaştırmaları ters yönlü verip TE işaretini çevirmek aynı sonucu verir (
q4_ag_ters: tüm çıktılar özdeş); işaretsiz ters çevirmek sonucu bozar ve şablon bunu denetleyemez. - Kol verisinde ters yön. Etkinin tanımı tedavi 1 - tedavi 2 olmalıdır;
kucuk_iyiile birlikte düşünülür: küçük değerler istenirse P-skoru yüksek olan tedavi etkisi en küçük olandır.kucuk_iyi = kotuverilirse sıra tersine döner (q4_ag_tkotu:plac0{,}98 ile ilk,rosi0{,}11 ile son). - Bağlantısız ağ durdurur. İki ayrı alt ağ varken ileti "Network consists of 2 separate sub-networks" olur (
q4_ag_baglantisiz); ağı bağlayacak bir çalışma yoksa ayrı çözümleyin. - Referans etiketi veri sırasına göre değil tedavi sırasına göredir. Boş bırakınca "ilk tedavi", adlar sayıysa sayısal sıradaki, değilse harf sırasındaki ilk tedavidir (örnekte
acar;q4_ag_refbos) ve çıktı bunu yazar. Sayısal kodlarda sıra "1, 2, …, 10"dur. - Referans seçimi sonucu değiştirmez ama etiketi değiştirir. P-skorları, Q, I^2 ve lig tablosu başvuruya bağlı değildir (
q4_ag_metf: P-skorları özdeş).REMLveMLseçildiğinde de \tau^2 başvurudan bağımsızdır: 0{,}09992 (\text{plac} ve \text{metf}). REML/MLçok kollu çalışmanın kovaryansını hesaba katar. Örnek ayardaREMLiçin \hat\tau^2=0{,}09992 veMLiçin 0{,}05639 çıkar (DL: 0{,}10872). Kestirim kurulamazsa (eksik ya da yinelenen karşılaştırma çifti)netmeta'nın kendi \tau^2'si kullanılır ve not yazılır.olcu: tablolar log ölçeğindedir.OR,RR,HRseçilincesummarykonsolu etkileri üstel ölçekte yazar (\text{acar} için 0{,}431); etki ve lig tablolarının başlıklarına "(log ölçeği)" eklenir ve değerler log ölçeğinde kalır (-0{,}842).- Çok az çalışma ve dalsız ağ. Hiç döngü yoksa (4 tedavi, 3 çalışma) sd =0: \tau^2, I^2 ve Q_p
NaNkalır (kestirilemez), Q değerleri 0 yazılır ve "ağda döngü yok; heterojenlik ve tutarsızlık kestirilemez" notu eklenir; rastgele ve ortak sonuçlar özdeştir. - Eksik değerli satır atılır ve bildirilir. Bir SH'si eksik satır atıldığında tedavi sayısı aynı kalsa bile tasarım sayısı (15\to14) ve çalışma sayısı (26\to25) düşer; konsola atılan satır sayısı yazılır. Çok kollu çalışmanın yalnız bir satırı eksikse şablon durur.
- Güven düzeyi şeklin başlığına yansır.
guven = 0,90iken orman grafiği %90 aralıkları çizer ve sütun başlığı "%90 GA" yazar. - Veri sekmesinde "kategorik" görünen etki ve SH sütunları.
tevesesayısal roldür; Veri sekmesinde kategorik yapılsalar bile R'ye sayı olarak gider ve sonuç değişmez (q4_ag_kat: tüm etkiler birebir aynı). Tedavi ve çalışma sütunları ise zaten metne çevrilir. - P-skoru kesinliği değildir. Sıra, tedavi etkilerinin belirsizliğini göstermez; tek başına tedavi seçimi için yetmez. Aralıklarla birlikte okuyun.
- SUCRA benzetimdir.
siralama = SUCRAile sıra sonucu tohuma bağlıdır: tohum 12345'terosirastgele SUCRA'sı 0{,}8938, tohum 999'da 0{,}8871; analitik P-skoru 0{,}8934. Aynı tohum aynı sonucu verir (q4_ag_sucra1veq4_ag_sucra1bözdeş). - t aralığı serbestlik derecesi Q'nunkidir. Küçük ağlarda bu derece çok küçük olabilir (sd =0'da aralık tanımsız);
t-dist, Knapp–Hartung ayarı değildir. - Tutarsızlık yerelleştirilmez. Anlamlı Q_{\text{arası}} görüldüğünde hangi döngünün sorumlu olduğu bu şablonda gösterilmez; ayrı bir düğüm bölme ya da tasarım temelli inceleme gerekir.
194.9 Uzman soruları
S1. Çizge yöntemi ile GLS neden aynı sonucu verir?
Çizge yöntemi ortak etki çözümünü \mathbf L^{+}\mathbf B^{\top}\mathbf W\mathbf y olarak yazar; GLS ise başvuruya göre parametreleştirip (\mathbf X^{\top}\mathbf V^{-1}\mathbf X)^{-1}\mathbf X^{\top}\mathbf V^{-1}\mathbf y çözer. \mathbf L tersinemez, \mathbf L^{+} yalnız sabit eklenmiş çözümü seçer; fark \delta_a-\delta_b sabitten bağımsızdır. Örnekte bağımsız GLS, netmeta çıktısını 10^{-6} içinde yeniden üretir (194.6.1).
S2. Çok kollu çalışma nasıl ele alınıyor ve neden üç satır giriyoruz?
a kollu çalışma a-1 bağımsız karşılaştırma içerir; satırlar ortak kol yüzünden ilişkilidir. netmeta kovaryansı karşılaştırma varyanslarından kutuplaştırma formülüyle (\Sigma_{ij}=\tfrac12(s_{ib}^2+s_{jb}^2-s_{ij}^2)) kurar ve ağırlıkları buna göre ayarlar. Bunun için çalışmanın üç ikili karşılaştırmasının hepsi gerekir; biri eksikse kovaryans kurulamaz. Çok kollu çalışmadan bir satır eksikse şablon durur.
S3. Rastgele etkiler modelinde \tau^2 neden ağ boyunca tek bir değerdir?
Ortak \tau^2 varsayımı, tüm karşılaştırmaların aynı heterojenliği taşıdığını söyler; bu, az çalışmalı karşılaştırmalar için \tau^2'nin kestirilebilirliğini sağlar ama gerçekte karşılaştırmaya özgü heterojenliği gizleyebilir. Şablonda tedaviye ya da karşılaştırmaya özgü \tau^2 seçeneği yoktur.
S4. REML neden DL'den farklı?
DL kapalı biçimle tam çok kollu kovaryansı kullanır; REML/ML ise olabilirliği eniyiler: aynı kovaryans yapısında (\mathbf V blok-köşegen, \mathbf Z=\tfrac12(\mathbf I+\mathbf J)) \hat\tau^2_{\text{REML}}=0{,}09992, DL 0{,}10872'dir. Fark, momentler yöntemi ile olabilirlik yönteminin farkıdır; çok kollu çalışmanın kovaryansından gelmez. Şablon \tau^2'yi kendisi rma.mv ile kestirip netmeta'ya verdiği için sonuç başvuru tedaviye bağlı değildir. İki kestirici yakındır ve sıralamayı değiştirmez.
S5. I^2 ağ meta-analizinde nasıl tanımlıdır?
I^2=\max(0,(Q-\mathrm{sd})/Q) toplam Q ve onun sd'sinden gelir; \tau^2'den değil. Q hem tasarım içi heterojenliği hem tasarımlar arası tutarsızlığı kapsar; bu yüzden yüksek I^2 tek başına "heterojenlik" değil "heterojenlik ve/veya tutarsızlık" demektir. Ayrıştırma tablosuna bakılmalıdır: örnekte Q'nun \%23'ü tasarımlar arasındadır.
S6. Anlamlı tasarımlar arası Q sonucu ne yapar?
Doğrudan ve dolaylı kanıt birbirine uymuyor demektir; tutarlılık varsayımı sorgulanır. Şablon bunu yerelleştirmez. Pratikte çalışma özellikleri (ör. başlangıç HbA1c) farklıysa ağ üstünlüğü bozulmuş olabilir; bu durumda moderatörlü model ya da alt ağ analizi gerekir.
S7. P-skoru ile SUCRA ne kadar farklıdır?
P-skoru SUCRA'nın analitik karşılığıdır: aynı niceliği çok değişkenli normal varsayımla benzetimsiz verir. nsim = 1000 ile fark \approx0{,}001–0{,}01'dir (rosi, rastgele: 0{,}8934 karşı 0{,}8938 ve 0{,}8871). Benzetim sayısı arttıkça fark küçülür.
S8. t dağılımı aralığı neden bu serbestlik derecesini kullanıyor?
method.random.ci = "t-dist" serbestlik derecesini Q'nun sd'sine (N-(n-1)=18) bağlar. Bu çalışma sayısına dayalı Knapp–Hartung kritik değerinden farklıdır; şablonda Knapp–Hartung ayarlı SH seçeneği yoktur. Çok az çalışmalı ağlarda t aralığı daha geniştir ve daha güvenlidir.
S9. Başka bir paketle fark ne olurdu?
gemtc Bayes ağ meta-analizi yapar, çok kollu çalışmalar için arm düzeyinde veri ister ve sıra olasılıkları MCMC'den gelir; bu şablonla sonuç aynı veride yakındır ama aralıklar önsele bağlıdır. meta/netmeta'nın netsplit ve decomp.design işlevleri tutarsızlığı döngü bazında yerelleştirir; şablon yalnız toplam ayrıştırmayı yazar.
194.10 Kaynaklar
- Balduzzi, S., Rücker, G., Nikolakopoulou, A., Papakonstantinou, T., Salanti, G., Efthimiou, O., & Schwarzer, G. (2023). netmeta: An R package for network meta-analysis using frequentist methods. Journal of Statistical Software, 106(2). https://doi.org/10.18637/jss.v106.i02
- DerSimonian, R., & Laird, N. (1986). Meta-analysis in clinical trials. Controlled Clinical Trials, 7(3), 177–188. https://doi.org/10.1016/0197-2456(86)90046-2
- Higgins, J. P. T., Jackson, D., Barrett, J. K., Lu, G., Ades, A. E., & White, I. R. (2012). Consistency and inconsistency in network meta-analysis: Concepts and models for multi-arm studies. Research Synthesis Methods, 3(2), 98–110. https://doi.org/10.1002/jrsm.1044
- IntHout, J., Ioannidis, J. P. A., & Borm, G. F. (2014). The Hartung-Knapp-Sidik-Jonkman method for random effects meta-analysis is straightforward and considerably outperforms the standard DerSimonian-Laird method. BMC Medical Research Methodology, 14, 25. https://doi.org/10.1186/1471-2288-14-25
- Jackson, D., White, I. R., & Thompson, S. G. (2010). Extending DerSimonian and Laird's methodology to perform multivariate random effects meta-analyses. Statistics in Medicine, 29(12), 1282–1297. https://doi.org/10.1002/sim.3602
- Knapp, G., & Hartung, J. (2003). Improved tests for a random effects meta-regression with a single covariate. Statistics in Medicine, 22(17), 2693–2710. https://doi.org/10.1002/sim.1482
- Krahn, U., Binder, H., & König, J. (2013). A graphical tool for locating inconsistency in network meta-analyses. BMC Medical Research Methodology, 13, 35. https://doi.org/10.1186/1471-2288-13-35
- Lu, G., & Ades, A. E. (2004). Combination of direct and indirect evidence in mixed treatment comparisons. Statistics in Medicine, 23(20), 3105–3124. https://doi.org/10.1002/sim.1875
- R Core Team (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing.
- Rücker, G. (2012). Network meta-analysis, electrical networks and graph theory. Research Synthesis Methods, 3(4), 312–324. https://doi.org/10.1002/jrsm.1058
- Rücker, G., & Schwarzer, G. (2014). Reduce dimension or reduce weights? Comparing two approaches to multi-arm studies in network meta-analysis. Statistics in Medicine, 33(25), 4353–4369. https://doi.org/10.1002/sim.6236
- Rücker, G., & Schwarzer, G. (2015). Ranking treatments in frequentist network meta-analysis works without resampling methods. BMC Medical Research Methodology, 15, 58. https://doi.org/10.1186/s12874-015-0060-8
- Salanti, G., Ades, A. E., & Ioannidis, J. P. A. (2011). Graphical methods and numerical summaries for presenting results from multiple-treatment meta-analysis: An overview and tutorial. Journal of Clinical Epidemiology, 64(2), 163–171. https://doi.org/10.1016/j.jclinepi.2010.03.016
- Senn, S., Gavini, F., Magrez, D., & Scheen, A. (2013). Issues in performing a network meta-analysis. Statistical Methods in Medical Research, 22(2), 169–189. https://doi.org/10.1177/0962280211432220
- Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03