71. F-İstatistikleri, İkili FST, Hedrick G''ST ve Jost D
Şablon kimliği: f_istatistikleri · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/f_istatistikleri.R (satır 1–221; üstbilgi 1–79) · Örnek veri: _ornek/abies_cilicica.csv · Paketler: hierfstat 0.5-11, mmod 1.3.3, adegenet 2.1.11
71.1 Ne işe yarar
Şablon, diploit ve eş baskın (iki aleli de okunabilen) belirteçlerle genotiplenmiş bireylerde popülasyonlar arasındaki genetik farklılaşmayı ölçer. Cevapladığı soru şudur: "Toplam genetik çeşitliliğin ne kadarı popülasyonların birbirinden farklı olmasından, ne kadarı popülasyonların içindeki bireylerden geliyor ve popülasyonların içinde heterozigot eksikliği var mı?"
Wright'ın üç F-istatistiği bu soruyu üç oranla cevaplar ve birbirine şu özdeşlikle bağlıdır:
- F_{ST}: popülasyonlar arası farklılaşma; aynı popülasyondan rastgele çekilen iki alelin, bütün örneklemden çekilen iki alele göre ne kadar daha benzer olduğunu ölçer. 0 farklılaşma yok demektir.
- F_{IS}: popülasyon içinde bireyin iki aleli arasındaki korelasyon; pozitifse heterozigot eksikliği (akrabalı çiftleşme, alt yapı, okunamayan aleller), negatifse heterozigot fazlalığı vardır.
- F_{IT}: ikisinin birleşik etkisi; bireyin iki alelinin bütün örnekleme göre korelasyonu.
Şablon bu üç istatistiği Weir ve Cockerham'ın (1984) varyans bileşeni kestiricileriyle lokus başına ve genel olarak verir, genel değerlere lokuslar üzerinden bootstrap güven aralığı ekler, her popülasyon çifti için ikili F_{ST} hesaplar ve heterozigotluğa dayalı dört ölçütü (Nei G_{ST}, Hedrick G''_{ST}, Jost D, isteğe bağlı \Phi'_{ST}) aynı çıktıda yan yana koyar.
Ne zaman kullanılır? Bireyler önceden tanımlı popülasyonlara (yöre, meşcere, koloni, ırk) aitse; belirteçler mikrosatellit, SNP ya da başka bir eş baskın sistemse; sorulan soru "popülasyonlar ayrışmış mı, hangi çiftler birbirine yakın" ise.
Ne zaman kullanılmaz?
- Popülasyonların üstünde bir düzey daha (bölge içinde popülasyon) varsa:
amovaşablonu hiyerarşik varyans ayrıştırması yapar. - Popülasyonlar önceden bilinmiyorsa, gruplar veriden çıkarılacaksa:
populasyon_yapisi. - Veri DNA dizisiyse (haplotipler):
dizi_amova; nötrallik soruluyorsanotralite_testleri. - Yalnız popülasyon içi çeşitlilik (alel zenginliği, gözlenen ve beklenen heterozigotluk) isteniyorsa:
genetik_cesitlilik; Hardy–Weinberg sınaması içinhardy_weinberg. - İkili F_{ST} coğrafi uzaklıkla ilişkilendirilecekse:
uzaklikla_yalitim(bu şablonun doğrusallaştırma seçeneği o çözümleme için hazırlık yapar). - Baskın belirteçler (AFLP, RAPD) ya da poliploit türler: şablonun ayrıştırıcısı yalnız diploit, iki alelli genotip yazımını kabul eder.
Temel programla ilişki. Temel programda F-istatistikleri hesaplayan bir analiz yoktur; bu şablon MerQuR+'a özgüdür.
71.2 Şablonun girdileri
Form, üstbilgideki on [[param]] bloğundan kurulur (f_istatistikleri.R:11–78).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Lokus sütunları · lokuslar |
sütunlar · Değişkenler | yok | en az 1 sütun | Her sütun bir lokus; ayrıştırılır ve kodlanır (116, 120). |
Popülasyon · populasyon |
kategorik sütun · Değişkenler | ilk uygun sütun | herhangi bir sütun | Bireyin popülasyonu; düzeyler ada göre sıralanır (113). |
Alel ayırıcısı · ayirici |
metin · Değişkenler | / |
boş olmayan metin | Metin genotipini iki alele böler (84–90, 119). |
Eksik genotip kodları · eksik_kodlar |
metin · Değişkenler | boş | virgülle ayrılmış kodlar | Boşsa varsayılan liste (boş hücre, NA, 0, 00, 000, ?, -, ., -9) eksik sayılır; doluysa alandaki kodlar bu listenin yerine geçer (boş hücre ve NA her zaman eksik); baş ve son boşluk kırpılır, boş kodlar atılır (satır 84–85; Bölüm 1.5). |
Bootstrap tekrar sayısı · B |
tam sayı · Seçenekler | 199 | 0–2000 | Genel ve ikili F_{ST} güven aralıkları; 0 ise yapılmaz (158–171, 195–199). |
İkili FST, Jost D ve G''ST · ikili |
onay · Çıktı | açık | açık / kapalı | İkili tablo ve ısı haritası (185–214). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | Bootstrap kantilleri (123–124). |
ΦST de hesaplansın · phi_st |
onay · Seçenekler | kapalı | açık / kapalı | diff_stats(phi_st = TRUE); tablolara Phi_ST sütunu (174–182). |
İkili D ve G''ST doğrusallaştırılsın · dogrusal |
onay · Seçenekler | kapalı | açık / kapalı | İkili değerler x/(1-x) olur (189–192). |
İkili Jost D için Hs/Ht ortalaması · hsht_ortalama |
seçim · Gelişmiş | arithmetic |
arithmetic, harmonic |
Yalnız ikili D'de lokuslar üzerinden ortalamanın türü (187–190). |
Örnek ayar (ornek_param, satır 9): on lokus (NFF3, NFF7, NFH15, NFH3, SF1, SF333, SF50, SF78, SFb4, SFb5) ve populasyon = pop. Öteki alanlar varsayılandadır.
Genotip yazımı (ortak ayrıştırıcı mq_genotip, satır 82–90; Bölüm 1.5). Sütun sayısalsa değerler yalnız 0, 1, 2 olabilir ve "B alelinin sayısı" diye okunur: 0 → A/A, 1 → A/B, 2 → B/B. Veri sekmesinde "kategorik" ya da metin türünde gelen ve değerlerinin hepsi 0, 1, 2 olan sütun da aynı biçimde okunur (85–90). Sütun metinse her hücre ayırıcıyla ikiye bölünür (136/142). Şu yazımlar eksik genotip sayılır: boş hücre, NA, na, 0, 00, 000, ?, -, ., -9; iki alel de eksik kodu olmalıdır (0/0). Alellerinden yalnız biri eksik kodu olan genotip (0/1) çalıştırmayı durdurur; adı 0 olan gerçek bir alel varsa yeniden kodlanmalıdır (71.8). Eksik genotip kodları alanı doluysa (virgülle ayrılmış, ör. .) alandaki kodlar bu listenin yerine eksik sayılır; boş hücre ve NA her zaman eksiktir ve yarı eksik durma kuralı yeni listeye göre işler: VCF tarzı 0/1 kodlu veride alana yalnız . yazılırsa 0 gerçek alel olur (satır 84–85). Eksik sayılan genotiplerin dökümü konsola yazılır (121).
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 93 |
| Lokus bütünüyle eksik | "lokusunda hiç genotip yok" | ortak mq_genotip (85) |
| Sayısal lokusta 0/1/2 dışında değer | "sayısal genotip yalnız 0/1/2 olabilir" | ortak mq_genotip (85) |
| Ayırıcı boş | "Alel ayırıcısı boş olamaz." | ortak mq_genotip (85) |
| Ayırıcı içermeyen genotip | "ayırıcı içermeyen genotip var … haploit veri çözümlenemez" | ortak mq_genotip (85) |
| İkiden çok alelli genotip | "yalnız diploit veri desteklenir" | ortak mq_genotip (85) |
Alellerinden yalnız biri eksik kodu olan genotip (0/1) |
"alellerden yalnız biri eksik kodu" | ortak mq_genotip (85) |
| Popülasyon sütunu lokus olarak da seçilmiş | "Popülasyon sütunu lokus olarak da seçilemez." | 98 |
| Popülasyon sütunu yok | "popülasyon sütunu gerekli" | 118 |
| Hiçbir bireyin popülasyonu belli değil | "Popülasyonu belli birey yok." | 102 |
| Bir lokusta 899'dan çok alel | "desteklenmiyor" | 125 |
| Tek popülasyon | "en az iki popülasyon gerekli" | 126 |
| Çok biçimli lokus kalmadı | "farklılaşma hesaplanamaz" | 132 |
| En az iki bireyli popülasyon sayısı 2'den az | "en az iki birey içeren en az iki popülasyon gerekli" | 134–135 |
hsht_ortalama tanımsız |
"Geçersiz Hs/Ht ortalaması." | 188 |
Uyarılar (durdurmaz): popülasyonu eksik bireyler çıkarılır ve sayısı yazılır (100–101); tek biçimli lokuslar çıkarılır ve adları yazılır (129–131); tek bireyli popülasyonlar "kestirimler güvenilmez" notuyla listelenir (136); beşten az çok biçimli lokus varsa "bootstrap için en az 5 çok biçimli lokus gerekir" notu yazılır ve güven aralıkları hesaplanmaz (159–165); phi_st açıkken eksik genotipli bireyler yüzünden genel \Phi'_{ST}'nin kaç bireye dayandığı yazılır (175).
Eksik değer: bir bireyin bir lokustaki genotipi eksikse birey yalnız o lokusun hesabından düşer; öteki lokuslarda kullanılır. Tek istisna genel \Phi'_{ST}'dir: orada herhangi bir lokusu eksik olan birey bütünüyle atılır (71.4.6).
71.3 Örnek veri
Dosya: _ornek/abies_cilicica.csv. Lübnan'daki 15 Toros göknarı (Abies cilicica) popülasyonundan 351 ağacın 10 çekirdek mikrosatellit lokusundaki genotipleri (Awad ve ark., 2014). Sütunlar: birey kimliği, popülasyon, on lokus, boylam ve enlem.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
birey |
kullanılmaz | metin | 351 ağaç. |
pop |
Popülasyon | kategorik (15 düzey) | Popülasyon büyüklükleri 11–30: KCHB 30, BTJF 30, CHIR 28, JBMD 30, MKTF 30, NBSH 30, QARS 11, QJRN 28, QEMN 28, HNKT 12, HNKF 21, GHAB 24, HKYT 12, KMHR 18, EHDN 19. |
NFF3 … SFb5 |
Lokuslar | kategorik (metin genotip) | Alel sayıları: NFF3 4, NFF7 17, NFH15 13, NFH3 27, SF1 3, SF333 5, SF50 6, SF78 18, SFb4 13, SFb5 3. |
boylam, enlem |
kullanılmaz | coğrafi | Popülasyon koordinatları. |
Eksik genotip: SF1 1, SF50 3, SF78 1, SFb4 12, SFb5 55 birey; öteki lokuslar tamdır. On lokusun hepsinde genotipi olan birey sayısı 289'dur.
Popülasyon sırası: alfabetik
Veri sekmesi pop sütununu ilk görülme sırasıyla (KCHB, BTJF, …) aktarır; ancak şablon popülasyon düzeylerini kendi içinde ada göre sıralar (factor(pv, levels = sort(unique(pv))), satır 113). Tablolardaki ve ısı haritasındaki sıra bu yüzden BTJF, CHIR, EHDN, GHAB, HKYT, HNKF, HNKT, JBMD, KCHB, KMHR, MKTF, NBSH, QARS, QEMN, QJRN'dir. Sıralama metin sıralamasıdır: popülasyonlar 1, 2, …, 15 diye adlandırılmışsa sıra 1, 10, 11, …, 15, 2, 3 olur. Sıra hiçbir kestirimi değiştirmez; yalnız satırların ve ısı haritası eksenlerinin dizilişini belirler. Tek istisna \Phi'_{ST}'dir (71.4.6).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) aynı ayar, başka bir çalıştırma tohumu; (3) phi_st açık, dogrusal açık, hsht_ortalama = harmonic, guven = 0,90; (4) B = 0, ikili kapalı; (5) popülasyon adına göre sıralanmış aynı veri, phi_st açık; (6) sınır durumları için türetilmiş küçük veriler (dört lokus, üç popülasyon, SNP kodlamaları).
71.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) genotipler ayrıştırılır, popülasyonu eksik bireyler ve tek biçimli lokuslar çıkarılır, aleller tam sayı kodlarına çevrilir; (2) hierfstat::wc ile alel başına üç varyans bileşeni ve bunlardan lokus ve genel F değerleri hesaplanır; (3) lokuslar yeniden örneklenerek genel değerlerin güven aralıkları bulunur; (4) mmod::diff_stats ile H_S, H_T, G_{ST}, G''_{ST}, D (ve istenirse \Phi'_{ST}) hesaplanır; (5) her popülasyon çifti için 2–4. adımlar yinelenir; (6) tablolar ve iki şekil yazılır.
71.4.1 Weir–Cockerham varyans bileşenleri
Bir lokusun bir A aleli için her gamete "alel A mı?" göstergesi atanır. Bu göstergenin toplam varyansı üç düzeye ayrılır: popülasyonlar arası (a), popülasyon içinde bireyler arası (b), birey içinde iki gamet arası (c). Weir ve Cockerham'ın (1984) kestiricileri:
- r: lokusta genotiplenmiş bireyi olan popülasyon sayısı; n_i: i. popülasyonda o lokusta genotipi olan birey sayısı.
- \bar n=\sum_i n_i/r: ortalama örneklem büyüklüğü; n_c=\big(r\bar n-\sum_i n_i^2/(r\bar n)\big)/(r-1): dengesiz örneklemde etkin büyüklük.
- \bar p=\sum_i n_ip_i/(r\bar n): alelin ağırlıklı ortalama frekansı; p_i popülasyon frekansı.
- s^2=\sum_i n_i(p_i-\bar p)^2/\big((r-1)\bar n\big): frekansın popülasyonlar arası örneklem varyansı.
- \bar h=\sum_i n_ih_i/(r\bar n): A alelini taşıyan heterozigotların ağırlıklı ortalama oranı.
Neden n_c ve neden s^2'den bir düzeltme çıkarılıyor?
s^2, popülasyon frekanslarının gözlenen saçılımıdır ve iki kaynağı vardır: gerçek farklılaşma ve her popülasyondan sınırlı sayıda birey örneklenmesi. Köşeli parantezdeki ikinci terim örneklemeden gelen payı çıkarır; popülasyonlar gerçekte aynıysa a'nın beklenen değeri sıfırdır. Bu yüzden kestirim sıfırın altına düşebilir (71.9 S2). n_c, popülasyon büyüklükleri eşit değilken tek yönlü varyans çözümlemesindeki "ortalama grup büyüklüğü"dür; eşit büyüklükte n_c=\bar n olur.
Bileşenler bir lokusun bütün alelleri üzerinden toplanır ve oranlar toplamlardan alınır:
- Lokus başına değerlerde toplam o lokusun alelleri üzerindendir; genel değerlerde bütün lokusların bütün alelleri üzerinden.
- Genel F_{ST} lokus F_{ST}'lerinin ortalaması değildir; çeşitliliği yüksek lokuslar (payda büyük) daha çok ağırlık taşır.
Koddaki tercih
Bileşenler hierfstat::wc(hdf) çağrısından gelir (satır 150). wc, aynı kestiricileri varyans çözümlemesi biçiminde kurar: c=\mathrm{KO}_G, b=(\mathrm{KO}_I-\mathrm{KO}_G)/2, a=(\mathrm{KO}_P-\mathrm{KO}_I)/(2n_c); iki yazım cebirsel olarak özdeştir (71.6.1). hierfstat genotipi tek bir tam sayı olarak ister; şablon alel adlarını lokus içinde sıralayıp 101'den başlayan üç basamaklı kodlara çevirir ve küçük kodu başa yazar (101102; satır 105–110, 140). Sıralama, adların hepsi sayıya çevrilebiliyorsa sayısal, değilse metin sırasıdır (107–108); kodlama sonucu etkilemez. Şablon wc çıktısından F_{IS} ve F_{ST}'yi alır, F_{IT}'yi 1-(1-F_{IS})(1-F_{ST}) özdeşliğinden hesaplar (153); bu, yukarıdaki oranla aynı sayıdır.
71.4.2 Lokuslar üzerinden bootstrap
L lokusun her biri için (a_\ell,b_\ell,c_\ell) üçlüsü bir kez hesaplanır. Her bootstrap tekrarında L lokus yerine koyarak yeniden çekilir, çekilen üçlüler toplanır ve oranlar yeniden kurulur:
- S_k: k. tekrarda çekilen L lokusluk küme (bir lokus birden çok kez gelebilir).
- Q_q: B değerin q kantili (R'nin varsayılan kantil tanımı, tür 7); \alpha=1-\texttt{guven}.
- Tabloda ayrıca ortanca (Q_{0{,}5}) verilir. F_{IT} ve F_{IS} için aynı yeniden örneklemeler kullanılır.
Neden bireyler değil lokuslar yeniden örnekleniyor?
Her lokus, popülasyonların ortak geçmişinin bağımsız bir gerçekleşmesidir; F_{ST}'nin belirsizliğinin büyük kısmı genomun hangi bölgelerinin örneklendiğinden gelir. Lokuslar üzerinden bootstrap bu "evrimsel" varyansı ölçer. Bedeli, yeniden örneklenen birim sayısının lokus sayısı kadar olmasıdır: 10 lokusla güven aralığı kabadır (71.9 S3).
Koddaki tercih
Genel değerler için hierfstat::boot.vc(…, nboot = B, quant = q)$ci (satır 158–166), ikili F_{ST} için hierfstat::boot.ppfst(hdf, nboot = B, quant = q[c(1, 3)]) (196) çağrılır. İki ayrıntı çıktıyı etkiler: (i) boot.vc güven sınırlarını dört ondalığa yuvarlar; ikili sınırlar yuvarlanmaz. (ii) boot.vc beşten az lokusta çalışmaz; şablon bootstrap'e yalnız en az beş çok biçimli lokus varsa girişir (159) ve paket yine de hata verirse (varyans bileşeni hesaplanabilen lokus beşten azsa) bunu notla bildirir (162–164). Daha az lokusta tablo 2 verilmez ve ikili tabloda FST_alt, FST_ust sütunları yer almaz; nokta kestirimleri hesaplanır. Rastgelelik R'nin sample fonksiyonundan gelir; önce genel değerler için B, ardından ikili değerler için B çekiliş yapılır.
Tohum. Bootstrap sonuçları çalıştırmanın tohumuna (seed) bağlıdır. Şablon formunda tohum alanı yoktur; tohum Kod panelindeki Tohum alanından verilir (Bölüm 1.3). Alan boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar; kullanılan tohumu künyeye yazar ve betik adımına kaydeder; betik yeniden oynatıldığında aynı tohum kullanılır ve aynı aralıklar çıkar (Bölüm 57). Bu bölümdeki sayılar, yürütücüye sabit tohum (2026) verilerek üretilmiştir.
71.4.3 Nei–Chesser heterozigotlukları ve G_{ST}
Heterozigotluğa dayalı ölçütler iki büyüklükten türetilir: popülasyonların içindeki ortalama beklenen heterozigotluk H_S ve popülasyonlar birleştirildiğindeki beklenen heterozigotluk H_T. Nei ve Chesser'in (1983) örneklem düzeltmeli kestiricileri, bir lokus için:
- k: lokusta verisi olan popülasyon sayısı; p_{ij}: i. popülasyonda j. alelin frekansı.
- \bar p_j=\frac1k\sum_i p_{ij}: popülasyon frekanslarının ağırlıksız ortalaması (Weir–Cockerham'daki \bar p ağırlıklıdır).
- \tilde n=k/\sum_i(1/n_i): popülasyon örneklem büyüklüklerinin harmonik ortalaması.
Neden 2\tilde n/(2\tilde n-1) çarpanı ve \hat H_S/(2\tilde nk) eklemesi?
1-\sum p^2, sonlu bir örneklemde gerçek heterozigotluğu aşağı yanlı kestirir: aynı aleli iki kez çekme olasılığı örneklemde biraz büyüktür. 2\tilde n gamet için yanlılık çarpanı (2\tilde n-1)/(2\tilde n)'dir; ilk düzeltme bunu tersine çevirir. H_T'deki ek terim aynı yanlılığın birleşik frekanslardaki karşılığıdır. Harmonik ortalama, küçük örneklemli popülasyonların yanlılığa daha çok katkı yapmasını yansıtır.
Genel değerlerde önce \hat H_S ve \hat H_T lokuslar üzerinden aritmetik ortalanır, sonra oran alınır; k yerine bütün verideki popülasyon sayısı kullanılır.
71.4.4 Hedrick G''_{ST} ve Jost D
G_{ST}'nin üst sınırı 1 değil, yaklaşık 1-H_S'dir: popülasyonlar hiçbir aleli paylaşmasa bile, popülasyon içi çeşitlilik yüksekse G_{ST} küçük kalır. İki düzeltme bu sorunu farklı yönlerden ele alır:
- G''_{ST} (Hedrick, 2005; Meirmans ve Hedrick, 2011): G_{ST}'nin, o H_S ve o k ile ulaşabileceği en büyük değere bölünmüş biçimi; k küçükken de 0–1 aralığını dolduracak biçimde düzeltilmiştir.
- D (Jost, 2008): alelik farklılaşma; popülasyonlar aynı alel frekanslarına sahipse 0, hiçbir aleli paylaşmıyorsa 1. Kestiricisi D_{est} olarak da anılır.
- k/(k-1): sonlu sayıda popülasyon için ölçekleme; k=2'de çarpan 2'dir.
Genel D iki yolla verilir. D_Jost_het, lokuslar üzerinden ortalanmış \hat H_S ve \hat H_T'den hesaplanır. D_Jost_harmonik, lokus D'lerinin harmonik ortalamasıdır: L/\sum_\ell(1/D_\ell).
Koddaki tercih
Değerler mmod::diff_stats(gi, phi_st = …) çağrısından gelir (satır 176). mmod her lokusta genotipi eksik bireyleri atar, k'yi o lokusta verisi kalan popülasyon sayısı olarak alır; genel G''_{ST} ve D'de ise k bütün verideki popülasyon sayısıdır. Harmonik ortalama negatif bir değerde tanımsızdır: mmod, lokus D'lerinden biri negatifse sonucu eksik (NA) döndürür ve tabloda D_Jost_harmonik hücresi boş kalır. Farklılaşmanın zayıf olduğu veride bu sık görülür; o durumda D_Jost_het okunur. Şablon mmod'un uyarılarını gizler (suppressWarnings, 185).
71.4.5 İkili karşılaştırmalar ve doğrusallaştırma
ikili açıkken, K popülasyonun K(K-1)/2 çiftinin her biri için veri o iki popülasyona indirgenir ve aynı kestiriciler yeniden hesaplanır: hierfstat::pairwise.WCfst genel Weir–Cockerham F_{ST}'sini (186), mmod::pairwise_D ve mmod::pairwise_Gst_Hedrick iki popülasyonluk genel D ve G''_{ST}'yi verir (190–191). İkili D'de lokuslar üzerinden \hat H_S ve \hat H_T ortalaması hsht_ortalama ile aritmetik ya da harmonik seçilebilir; seçenek yalnız ikili D'yi etkiler.
dogrusal açıkken ikili D ve G''_{ST} şu dönüşümle yazılır:
- x: çiftin ikili D ya da G''_{ST} değeri; dönüşüm 0'da 0'dır, x\to1 iken sınırsız büyür, negatif x negatif kalır.
Neden x/(1-x)?
Uzaklıkla yalıtım çözümlemelerinde farklılaşma ölçütü coğrafi uzaklığa (ya da logaritmasına) karşı regresyona sokulur; kuramsal beklenti ölçütün kendisi için değil x/(1-x) biçimi için doğrusaldır. Dönüşüm, 1'e yaklaşan değerleri açar ve regresyonu doğrusallaştırır. Şablon dönüşümü yalnız D ve G''_{ST} sütunlarına uygular; FST_WC sütunu ve güven sınırları dönüştürülmez.
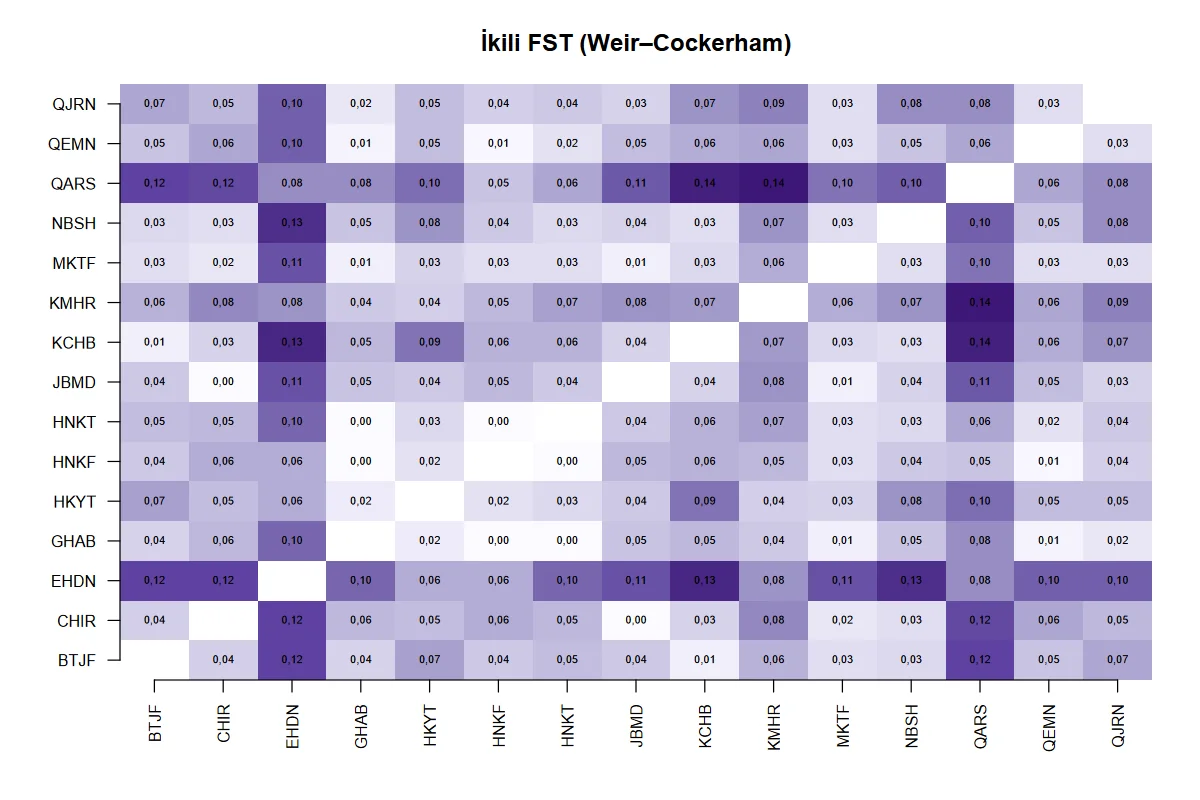
İkili F_{ST}'nin güven aralığı 71.4.2'deki yöntemle, çiftin kendi lokus bileşenleri yeniden örneklenerek bulunur. Isı haritası (şekil 1) FST_WC matrisini gösterir; popülasyon sayısı 20'yi aşmıyorsa hücrelere iki ondalıklı değer yazılır (212).
71.4.6 \Phi'_{ST} (isteğe bağlı)
phi_st açıkken mmod, bireyler arası uzaklıklardan moleküler varyans çözümlemesi (AMOVA; Excoffier ve ark., 1992) kurar ve Meirmans'ın (2006) standardını uygular. İki birey arasındaki uzaklık, bir lokusta paylaşılmayan alel oranıdır (0; 0,5; 1) ve lokuslar üzerinden ortalanır; çözümlemeye uzaklıkların karesi girer.
- \mathrm{KO}_{\text{iç}}, \mathrm{KO}_{\text{arası}}: kareli uzaklıklardan kurulan popülasyon içi ve popülasyonlar arası kareler ortalamaları; n_0=\big(N-\sum_i n_i^2/N\big)/(K-1).
- \Phi_{ST}^{\max}: popülasyon içi uzaklıklar olduğu gibi bırakılıp popülasyonlar arası bütün uzaklıklar en büyük değerine (1) çekildiğinde elde edilen \Phi_{ST}.
- Genel değerde herhangi bir lokusu eksik olan bireyler atılır (örnek veride 351 bireyden 289'u kalır); lokus başına değerlerde yalnız o lokusu eksik olanlar atılır.
Koddaki tercih: bireyler popülasyona göre sıralanır
mmod'un bu hesabı, popülasyon içi kareler toplamlarını bireylerin ilk görülme sırasıyla, popülasyon büyüklüklerini ise düzey sırasıyla dizer ve ikisini sırayla eşleştirir; iki sıra ancak bireyler popülasyonun düzey sırasına göre dizilmişse aynıdır. Şablon genind nesnesini kurmadan önce bireyleri popülasyon düzeyine göre sıralar (order(V$pop), satır 143–147); bu yüzden \Phi'_{ST} dosyanın satır sırasına bağlı değildir. Örnek veride genel \Phi'_{ST}=0{,}1842'dir ve bağımsız hesapla aynıdır (71.6). Öteki bütün ölçütler satır sırasından zaten bağımsızdır.
71.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–79 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, dokuz parametre. | Form buradan kurulur (Bölüm 1.2). |
| 80–91 | .m() ileti seçici; genetik şablonlarının ortak genotip ayrıştırıcısı .gn_genotip. |
n\times2 alel adı matrisi döndürür; eksik genotipte iki hücre de NA. Ayrıştırıcı ortak mq_genotip'tir; eksik sayılan yazımlar mq_genotip_eksik listesindedir (84–90). |
| 93–114 | .gn_hazirla: popülasyonu eksik bireyleri atar, lokusları ayrıştırır, alel adlarını sıralı tam sayı kodlarına çevirir. |
Popülasyon düzeyleri sort(unique()) ile sıralanır (113). |
| 116–136 | Parametreler okunur; kantil vektörü kurulur; tek popülasyon, tek biçimli lokus ve tek bireyli popülasyon denetimleri. | q = ((1−g)/2; 0,5; 1−(1−g)/2) (124). |
| 138–147 | hierfstat biçimi (hdf: popülasyon + lokus başına altı basamaklı genotip kodu) ve adegenet genind nesnesi (gi). |
Aynı veri iki pakete iki biçimde verilir; df2genind uyarıları gizlenir. |
| 149–171 | wc → tablo 1; boot.vc → tablo 2. |
F_{IT} özdeşlikten (153). Bootstrap koşulu B > 0 ve en az beş çok biçimli lokus (159–165). |
| 173–183 | diff_stats → tablo 3 (lokus) ve tablo 4 (genel). |
phi_st açıksa Phi_ST sütunu eklenir (178, 182). |
| 185–214 | İkili F_{ST}, D, G''_{ST}; boot.ppfst; tablo 5; ısı haritası. |
boot.ppfst yalnız üst üçgeni doldurur; alt üçgen yansıtılır (198). D ve G''_{ST} ada göre eşlenir (201–202). |
| 215–220 | Lokus başına F_{ST} ve D çubuk grafiği. | Dikey eksen negatif değerleri de kapsar (217). |
Konsola tek satırlık özet yazılır (154–156): birey, lokus ve popülasyon sayısı ile genel F_{ST}, F_{IS}, F_{IT} (dört ondalık, arayüz diline göre ondalık virgül). Buradaki birey sayısı, popülasyonu belli olan bütün bireylerdir; hiçbir lokusta genotipi olmayan birey de sayıya girer.
71.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/f_istatistikleri/elle_hesap.py ile, hierfstat, mmod ve adegenet kullanılmadan hesaplanmıştır: Weir–Cockerham bileşenleri 71.4.1'deki formüllerle alel alel, Nei–Chesser büyüklükleri 71.4.3'teki formüllerle. R tarafında (r_dogrulama.R) lokus F değerleri pegas::Fst ile, genel ve ikili değerler varyans çözümlemesi biçimiyle, \Phi_{ST} pegas::amova ile yeniden kurulmuştur.
Adım 1 — NFF3 lokusunda bileşenler. Lokusta dört alel ve 15 popülasyonda 351 genotip vardır: r=15, \bar n=351/15=23{,}4, n_c=23{,}2475.
| Alel | \bar p | s^2 | \bar h | a | b | c |
|---|---|---|---|---|---|---|
| 105 | 0,831909 | 0,006901 | 0,284900 | 0,004152 | −0,006279 | 0,142450 |
| 109 | 0,014245 | 0,000329 | 0,022792 | −0,000030 | 0,002698 | 0,011396 |
| 121 | 0,015670 | 0,000618 | 0,031339 | 0,000307 | −0,000509 | 0,015670 |
| 143 | 0,138177 | 0,006281 | 0,230769 | 0,003827 | 0,000316 | 0,115385 |
| Toplam | 0,008256 | −0,003774 | 0,284900 |
F_{IT}=(0{,}008256-0{,}003774)/0{,}289382=0{,}015488; özdeşlikle 1-(1+0{,}013424)(1-0{,}028529)=0{,}015488.
Adım 2 — Genel değerler. On lokusun bileşen toplamları \sum a=0{,}339610, \sum b=0{,}176685, \sum c=5{,}825371:
Awad ve ark. (2014) aynı veride popülasyonlar arası F_{ST}=0{,}0536 ve genel F_{IS}=0{,}029 bildirmiştir.
Adım 3 — Bootstrap. B=199 tekrarda lokus üçlüleri yeniden çekilmiştir. Tohum 2026 ile F_{ST}^{*} değerlerinin %2,5 ve %97,5 kantilleri 0,038726 ve 0,078544, ortancası 0,052892'dir; dört ondalığa yuvarlanınca tablodaki 0,0387; 0,0529; 0,0785 elde edilir. Bootstrap değerlerinin standart sapması 0,0096'dır; lokuslar üzerinden birini dışarıda bırakma (jackknife) yöntemiyle bulunan standart hata da 0,0096'dır.
Adım 4 — NFF3'te Nei–Chesser büyüklükleri. \tilde n=20{,}5801; popülasyon içi düzeltmesiz ortalama 0{,}284259; birleşik frekanslardan 1-\sum\bar p_j^2=0{,}302235:
Adım 5 — Genel heterozigotluk ölçütleri. Lokus ortalamaları \hat H_S=0{,}595049, \hat H_T=0{,}629598; k=15:
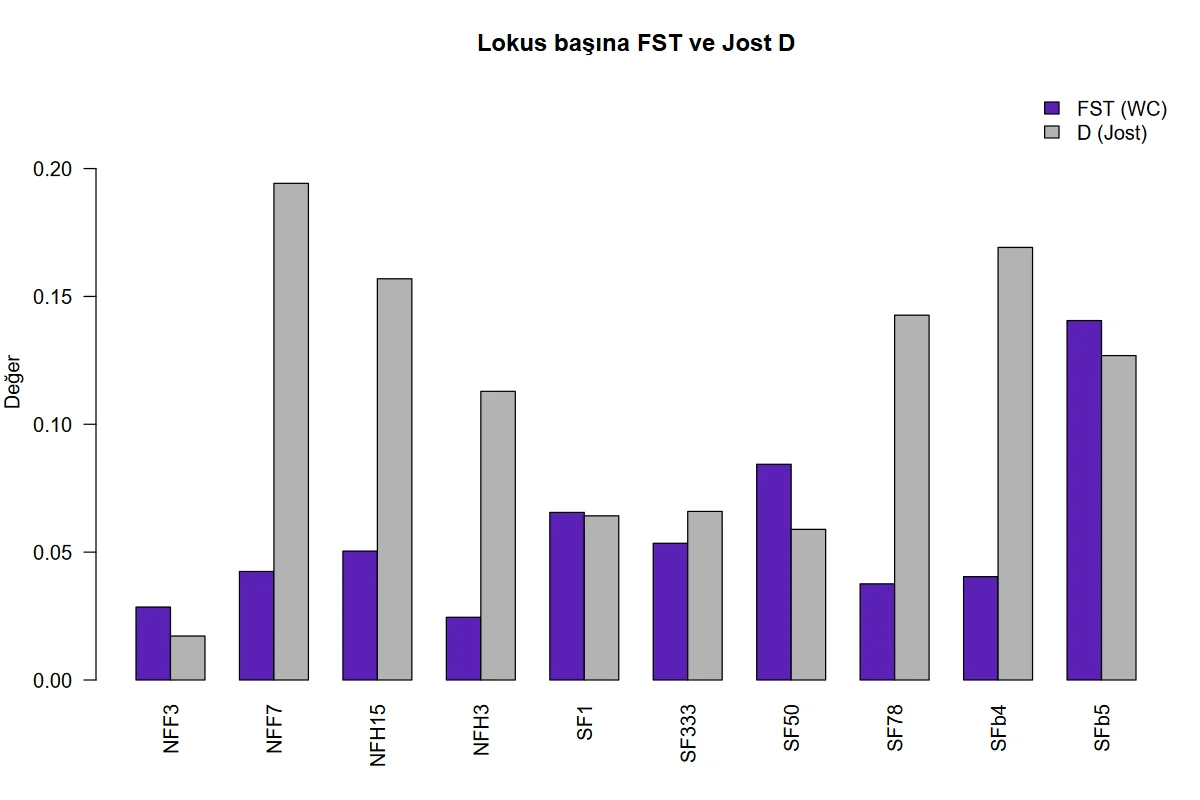
Lokus D'lerinin (0,0172 ile 0,1942 arası) harmonik ortalaması 0,067989'dur.
Adım 6 — Bir popülasyon çifti. BTJF–CHIR çifti için (30 ve 28 ağaç) F_{ST}=0{,}037963, D=0{,}064699, G''_{ST}=0{,}100488; bootstrap sınırları 0,008631 ve 0,079807. En yakın çift HNKF–HNKT'dir (F_{ST}=-0{,}002599); en uzak çift KMHR–QARS'tır (F_{ST}=0{,}142617).
Adım 7 — \Phi'_{ST}. Eksiksiz 289 bireyde \Phi_{ST}=0{,}134939, \Phi_{ST}^{\max}=0{,}732389, \Phi'_{ST}=0{,}134939/0{,}732389=0{,}184245.
71.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle okunmuştur (çalıştırmalar 1, 2, 3 ve 5). Bootstrap satırlarında Python ve R, şablonla aynı tohumu ve aynı çekiliş sırasını kullanır; Python tarafında R'nin rastgele sayı üreteci yeniden kurulmuştur.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Genel F_{ST} | 0,05355214 | 0,05355214 | 0,05355214 | 4,9e−17 | ✓ |
| Genel F_{IS} | 0,02943748 | 0,02943748 | 0,02943748 | 4,9e−17 | ✓ |
| Genel F_{IT} | 0,08141318 | 0,08141318 | 0,08141318 | 9,7e−17 | ✓ |
| NFF3: F_{ST} | 0,0285291 | 0,0285291 | 0,0285291 | 3,1e−17 | ✓ |
| NFF3: F_{IS} | −0,01342433 | −0,01342433 | −0,01342433 | 1,9e−16 | ✓ |
| NFF3: F_{IT} | 0,01548776 | 0,01548776 | 0,01548776 | 1,8e−16 | ✓ |
| SFb5: F_{ST} | 0,14054409 | 0,14054409 | 0,14054409 | 3,3e−16 | ✓ |
| SFb5: F_{IS} | 0,13996792 | 0,13996792 | 0,13996792 | 1,7e−16 | ✓ |
| SFb5: F_{IT} | 0,26084035 | 0,26084035 | 0,26084035 | 4,4e−16 | ✓ |
| Bootstrap FST alt (%95) | 0,0387 | 0,0387 | 0,0387 | 0 | ✓ |
| Bootstrap FST ortanca (%95) | 0,0529 | 0,0529 | 0,0529 | 0 | ✓ |
| Bootstrap FST üst (%95) | 0,0785 | 0,0785 | 0,0785 | 0 | ✓ |
| Bootstrap FIT alt (%95) | 0,0364 | 0,0364 | 0,0364 | 0 | ✓ |
| Bootstrap FIT ortanca (%95) | 0,0826 | 0,0826 | 0,0826 | 0 | ✓ |
| Bootstrap FIT üst (%95) | 0,1391 | 0,1391 | 0,1391 | 0 | ✓ |
| Bootstrap FIS alt (%95) | −0,0149 | −0,0149 | −0,0149 | 0 | ✓ |
| Bootstrap FIS ortanca (%95) | 0,0299 | 0,0299 | 0,0299 | 0 | ✓ |
| Bootstrap FIS üst (%95) | 0,0818 | 0,0818 | 0,0818 | 0 | ✓ |
| Bootstrap FST alt (başka tohum: 7) | 0,0402 | 0,0402 | 0,0402 | 0 | ✓ |
| Bootstrap FST üst (başka tohum: 7) | 0,0753 | 0,0753 | 0,0753 | 0 | ✓ |
| Bootstrap FST alt (%90) | 0,0405 | 0,0405 | 0,0405 | 0 | ✓ |
| Bootstrap FST üst (%90) | 0,0725 | 0,0725 | 0,0725 | 0 | ✓ |
| NFF3: H_S | 0,29133718 | 0,29133718 | 0,29133718 | 5,0e−16 | ✓ |
| NFF3: H_T | 0,30270677 | 0,30270677 | 0,30270677 | 6,1e−16 | ✓ |
| NFF3: G_{ST} | 0,03755974 | 0,03755974 | 0,03755974 | 1,4e−16 | ✓ |
| NFF3: G''_{ST} | 0,0566347 | 0,0566347 | 0,0566347 | 2,6e−16 | ✓ |
| NFF3: D | 0,0171897 | 0,0171897 | 0,0171897 | 9,4e−17 | ✓ |
| NFF7: H_S | 0,79406315 | 0,79406315 | 0,79406315 | 2,2e−16 | ✓ |
| NFF7: H_T | 0,83139316 | 0,83139316 | 0,83139316 | 2,2e−16 | ✓ |
| NFF7: G_{ST} | 0,04490055 | 0,04490055 | 0,04490055 | 2,8e−17 | ✓ |
| NFF7: G''_{ST} | 0,23285747 | 0,23285747 | 0,23285747 | 0 | ✓ |
| NFF7: D | 0,19421701 | 0,19421701 | 0,19421701 | 2,5e−16 | ✓ |
| Genel H_S | 0,59504923 | 0,59504923 | 0,59504923 | 0 | ✓ |
| Genel H_T | 0,62959821 | 0,62959821 | 0,62959821 | 3,3e−16 | ✓ |
| Genel G_{ST} | 0,05487465 | 0,05487465 | 0,05487465 | 2,2e−16 | ✓ |
| Genel G''_{ST} | 0,14462182 | 0,14462182 | 0,14462182 | 3,3e−16 | ✓ |
| Genel D (ortalama H'lerden) | 0,09141054 | 0,09141054 | 0,09141054 | 2,5e−16 | ✓ |
| Genel D (harmonik ortalama) | 0,06798891 | 0,06798891 | 0,06798891 | 2,1e−16 | ✓ |
| BTJF–CHIR: F_{ST} | 0,03796327 | 0,03796327 | 0,03796327 | 5,6e−17 | ✓ |
| BTJF–CHIR: F_{ST} bootstrap alt | 0,00863081 | 0,00863081 | 0,00863081 | 3,5e−17 | ✓ |
| BTJF–CHIR: F_{ST} bootstrap üst | 0,07980696 | 0,07980696 | 0,07980696 | 0 | ✓ |
| BTJF–CHIR: Jost D | 0,06469949 | 0,06469949 | 0,06469949 | 5,1e−16 | ✓ |
| BTJF–CHIR: G''_{ST} | 0,10048759 | 0,10048759 | 0,10048759 | 4,6e−16 | ✓ |
| EHDN–KCHB: F_{ST} | 0,13172895 | 0,13172895 | 0,13172895 | 5,6e−17 | ✓ |
| EHDN–KCHB: F_{ST} bootstrap alt | 0,03756466 | 0,03756466 | 0,03756466 | 4,2e−17 | ✓ |
| EHDN–KCHB: F_{ST} bootstrap üst | 0,23400585 | 0,23400585 | 0,23400585 | 1,1e−16 | ✓ |
| EHDN–KCHB: Jost D | 0,20842057 | 0,20842057 | 0,20842057 | 5,0e−16 | ✓ |
| EHDN–KCHB: G''_{ST} | 0,31632056 | 0,31632056 | 0,31632056 | 4,4e−16 | ✓ |
| HNKF–HNKT: F_{ST} | −0,00259942 | −0,00259942 | −0,00259942 | 1,7e−18 | ✓ |
| HNKF–HNKT: F_{ST} bootstrap alt | −0,01757103 | −0,01757103 | −0,01757103 | 1,0e−17 | ✓ |
| HNKF–HNKT: F_{ST} bootstrap üst | 0,01278481 | 0,01278481 | 0,01278481 | 4,3e−17 | ✓ |
| HNKF–HNKT: Jost D | −0,00627227 | −0,00627227 | −0,00627227 | 1,7e−18 | ✓ |
| HNKF–HNKT: G''_{ST} | −0,01024117 | −0,01024117 | −0,01024117 | 3,5e−17 | ✓ |
| BTJF–CHIR: D/(1-D), harmonik H ortalaması | 0,07790292 | 0,07790292 | 0,07790292 | 1,4e−17 | ✓ |
| BTJF–CHIR: G''_{ST}/(1-G''_{ST}) | 0,11171339 | 0,11171339 | 0,11171339 | 8,0e−16 | ✓ |
| Genel \Phi'_{ST} (veri popülasyona göre sıralı) | 0,1842447 | 0,1842447 | 0,1842447 | 4,4e−16 | ✓ |
| Genel \Phi'_{ST} (örnek dosyanın satır sırası) | 0,1842447 | 0,1842447 | 0,1842447 | 4,4e−16 | ✓ |
Ölçütü karşılayan: 57/57. Python: Weir ve Cockerham (1984) eş. 2–4 ve Nei–Chesser formülleri; bootstrap, R'nin rastgele sayı akışı yeniden kurularak. R: pegas::Fst (lokus), ANOVA biçimi (genel, ikili), set.seed + sample; \Phi'_{ST} açık AMOVA formülü. Şablon bireyleri popülasyona göre sıralayarak mmod'a verdiğinden \Phi'_{ST} dosyanın satır sırasından bağımsızdır (71.4.6).
Genel \Phi'_{ST} hem örnek dosyanın satır sırasıyla hem de popülasyona göre sıralanmış veriyle aynı değeri verir; üç hesap örtüşür (71.4.6).
71.7 Çıktıyı okuma
Örnek ayarın konsol metni iki satırdır; ilki eksik sayılan genotiplerin dökümüdür (örnek veride 72 boş hücre):
Genotip okuma: 10 lokusta 3510 genotipin 72 tanesi eksik sayıldı (boş hücre: 72; eksik kodu: 0; alellerinden yalnız biri eksik kodu: 0; başka neden: 0).
F-istatistikleri: 351 birey, 10 lokus, 15 popülasyon; Weir–Cockerham FST = 0,0536, FIS = 0,0294, FIT = 0,0814
Tablolar (ilk satırlar; tablolarda tam hassasiyet saklanır):
Weir–Cockerham F-istatistikleri (lokus başına ve genel)
 lokus        FIS        FST        FIT
  NFF3  -0.013424   0.028529   0.015488
  NFF7  -0.018431   0.042439   0.024790
 NFH15  -0.044642   0.050401   0.008009
  NFH3  -0.008601   0.024533   0.016142
   SF1  -0.067170   0.065537   0.002769
 SF333   0.009601   0.053459   0.062547
  SF50   0.079722   0.084360   0.157357
  SF78   0.078566   0.037609   0.113220
  SFb4   0.138835   0.040430   0.173651
  SFb5   0.139968   0.140544   0.260840
 Genel   0.029437   0.053552   0.081413

Lokuslar üzerinden bootstrap güven aralıkları (%95; B = 199)
 istatistik      alt  ortanca     ust
        FST   0.0387   0.0529  0.0785
        FIT   0.0364   0.0826  0.1391
        FIS  -0.0149   0.0299  0.0818

Genel ayrışma ölçütleri (mmod; …)
       Hs        Ht       GST  G2ST_Hedrick  D_Jost_het  D_Jost_harmonik
 0.595049  0.629598  0.054875      0.144622    0.091411         0.067989

İkili FST (Weir–Cockerham; %95 bootstrap GA, lokuslar üzerinden), Jost D ve Hedrick G''ST
 pop1  pop2    FST_WC   FST_alt   FST_ust    D_Jost  G2ST_Hedrick
 BTJF  CHIR  0.037963  0.008631  0.079807  0.064699      0.100488
 BTJF  EHDN  0.119151  0.056035  0.191577  0.181295      0.281730
 CHIR  EHDN  0.117332  0.030347  0.224804  0.187704      0.286004
 …
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Tablo 1, lokus satırları | Lokus başına F_{IS}, F_{ST}, F_{IT} | Lokuslar arası tutarlılığa bakılır. Örnekte F_{ST} 0,025–0,141 arasındadır; SFb5 öbürlerinden yüksektir. F_{IS}'in yalnız birkaç lokusta (SF50, SF78, SFb4, SFb5) yüksek olması okunamayan alel belirtisidir (71.9 S7). |
| Tablo 1, "Genel" | Bileşen toplamlarından oranlar | Raporlanacak ana değerler. |
| Tablo 2 | Genel değerlerin bootstrap sınırları ve ortancası (dört ondalık) | Aralık sıfırı içermiyorsa istatistik sıfırdan farklıdır. Örnekte F_{ST} aralığı sıfırı dışlar, F_{IS} aralığı içerir. |
| Tablo 3 | Lokus başına H_S, H_T, G_{ST}, G''_{ST}, D | H_S yüksek lokuslarda G_{ST} ile G''_{ST} arasındaki fark büyür (NFF7: 0,045 ve 0,233). |
| Tablo 4 | Genel H_S, H_T ve dört ölçüt | D_Jost_harmonik boşsa bir lokusun D'si negatiftir. |
| Tablo 5 | Her çift için F_{ST}, bootstrap sınırları, D, G''_{ST} | Satırlar alfabetik popülasyon sırasının üst üçgenidir. Örnekte 105 çiftin 97'sinde alt sınır sıfırdan büyüktür. |
| Şekil 1 | İkili F_{ST} ısı haritası | Koyu hücreler uzak çiftler; köşegen boştur. |
| Şekil 2 | Lokus başına F_{ST} ve D çubukları | İki ölçütün lokuslar arasındaki sıralaması farklı olabilir: D çeşitliliği yüksek lokuslarda büyür. |
Şekil 71.1. Şablonun çizdiği ikili Weir–Cockerham F_{ST} ısı haritası (örnek veri, 15 popülasyon). EHDN, KCHB, KMHR ve QARS öteki popülasyonlardan en çok ayrışanlardır.
Şekil 71.2. Lokus başına F_{ST} (mor) ve Jost D (gri). NFF3 ve SFb5 gibi az alelli lokuslarda D küçük, NFF7 gibi çok alelli lokuslarda büyüktür.
Rapor cümlesi (örnek ayar):
On mikrosatellit lokusunda 15 popülasyon arasındaki farklılaşma düşük, ama sıfırdan farklıydı (Weir–Cockerham F_{ST} = 0{,}054; lokuslar üzerinden bootstrap %95 GA 0,039–0,079). Popülasyon içi heterozigot eksikliği belirgin değildi (F_{IS} = 0{,}029; %95 GA −0,015–0,082). Popülasyon içi heterozigotluk yüksek olduğundan (H_S = 0{,}595) standartlaştırılmış ölçütler daha büyüktü: Hedrick G''_{ST} = 0{,}145, Jost D = 0{,}091. İkili F_{ST} −0,003 (HNKF–HNKT) ile 0,143 (KMHR–QARS) arasında değişti.
71.8 Sık hatalar ve tuzaklar
- Alel adı olarak 0 kullanmak.
0,00ve000eksik veri kodudur. Alelleri 0 ve 1 diye adlandırılmış bir veride (0/0,0/1,1/1)0/1genotipleri alellerinden yalnız biri eksik kodu olduğu için çalıştırmayı durdurur ve ileti sayıyı ve örneği yazar. AlellerA/Bya da1/2gibi adlarla yeniden yazılır; SNP'ler için sayısal 0/1/2 kodlaması ayrı bir yoldur. Alana Eksik genotip kodları yalnız veride gerçekten eksik olan kodu (ör..) yazmak yeniden kodlamayı gereksiz kılar:0o zaman gerçek alel sayılır. - 0/1/2 kodlu SNP sütununun türü. Sütun veri sekmesinde "kategorik" ya da "metin" türünde olsa bile değerlerinin hepsi 0, 1, 2 ise sayısal kodlama olarak okunur. Aralarında başka değer bulunan sütun metin genotip sayılır ve ayırıcı gerektirir.
- İki–dört lokusla bootstrap beklemek. Lokuslar üzerinden bootstrap en az beş çok biçimli lokus ister. Daha az lokusta şablon notla bildirir, güven aralıklarını hesaplamaz ve yalnız nokta kestirimlerini verir.
- Az lokusla güven aralığına fazla güvenmek. On lokusta her tekrar on lokusluk bir çekiliştir. B=199 ile aralığın üst sınırı çalıştırmadan çalıştırmaya değişir: 200 farklı tohumda örnek verinin %95 üst sınırı 0,069 ile 0,079, alt sınırı 0,036 ile 0,042 arasında kalmıştır. Yayın için B en az 999 seçilir; lokus sayısının azlığı ise B büyütülerek giderilemez.
- Genel F_{ST}'yi lokus ortalaması sanmak. Lokus F_{ST}'lerinin aritmetik ortalaması 0,0568'dir; genel değer 0,0536'dır. Genel değer bileşen toplamlarının oranıdır.
- Negatif F_{ST} ya da D'yi hata sanmak. Kestiriciler örnekleme düzeltmesi içerdiğinden gerçek değer sıfıra yakınken negatif çıkabilir; sıfır olarak yorumlanır. Ancak negatif bir lokus D'si
D_Jost_harmonikhücresini boşaltır. - F_{ST}, G''_{ST} ve D'yi aynı ölçekte karşılaştırmak. Üçü farklı büyüklükleri ölçer. Örnekte 0,054; 0,145 ve 0,091'dir ve hiçbiri ötekinin "düzeltilmişi" değildir (71.9 S4).
- Genel \Phi'_{ST}'nin yalnız eksiksiz bireylere dayandığını unutmak. Herhangi bir lokusu eksik olan birey genel kestirimden çıkar (örnekte 351 bireyden 289'u kalır); şablon bu sayıyı notla yazar (71.4.6). Lokus başına değerlerde yalnız o lokusu eksik olanlar atılır.
- Yüksek F_{IS}'i akrabalı çiftleşme diye yorumlamak. F_{IS} lokuslar arasında tutarsızsa neden çoğu kez okunamayan alellerdir. Örnekte en yüksek F_{IS} değerleri, en çok eksik genotipi olan iki lokustadır (SFb4, SFb5).
- Doğrusallaştırılmış değerleri F_{ST} ile aynı tabloda yorumlamak.
dogrusalaçıkken D ve G''_{ST} sütunları dönüştürülmüş,FST_WCsütunu ham değerdir. - Tek bireyli popülasyon. Şablon uyarır ve sürdürür; o popülasyonun katıldığı ikili değerler tek bir genotipe dayanır. Böyle popülasyonlar çözümlemeden önce çıkarılır ya da komşusuyla birleştirilir.
- Çok sayıda ikili aralığı tek tek yorumlamak. 105 çiftin her birine %95 aralık verilir; çoklu karşılaştırma düzeltmesi yoktur.
71.9 Uzman soruları
S1. Weir–Cockerham F_{ST} ile Nei G_{ST} neden aynı sayı değil?
İkisi de "popülasyonlar arası payı" ölçer, ama kestiricileri farklıdır. Weir–Cockerham popülasyonları örneklem büyüklükleriyle ağırlıklandırır, gözlenen heterozigotları kullanır ve hem bireylerin hem popülasyonların örneklenmesini düzeltir. Nei–Chesser popülasyon frekanslarını ağırlıksız ortalar, yalnız beklenen heterozigotluğu kullanır ve popülasyon sayısının sonluluğunu düzeltmez. Örnekte F_{ST}=0{,}0536, G_{ST}=0{,}0549'dur; popülasyon büyüklükleri çok farklıysa ya da popülasyon sayısı azsa fark büyür.
S2. F_{ST} nasıl negatif olabilir?
a bileşeni, frekansların gözlenen saçılımından (s^2) örneklemenin beklenen katkısı çıkarılarak kestirilir. Gerçek farklılaşma sıfıra yakınsa gözlenen saçılım rastlantıyla beklenenden küçük kalabilir ve a<0 olur. HNKF–HNKT çiftinde F_{ST}=-0{,}0026, bootstrap aralığı [-0{,}0176;\ 0{,}0128]'dir: iki popülasyon ayırt edilemez. Negatif değer sıfıra kırpılmaz; kırpmak ortalamaları yukarı yanlı yapardı.
S3. On lokusla bootstrap güven aralığı ne kadar güvenilir?
Aralık, on değerin yerine koyarak yeniden çekilmesine dayanır; kuyruk kantilleri az sayıda farklı birleşimden gelir ve kaba olur. Örnekte bootstrap standart sapması ile jackknife standart hatası aynıdır (0,0096), yani ölçek tutarlıdır; ama yüzdelik aralığın kapsaması küçük lokus sayısında nominal düzeyin altında kalır. hierfstat bu yüzden beş lokusun altında bootstrap yapmaz. Yüzlerce SNP varsa yöntem iyi çalışır; on mikrosatellitte aralık "kabaca" diye okunur.
S4. F_{ST}, G''_{ST} ve D'den hangisi raporlanmalı?
Soruya bağlıdır. Gen akışı, sürüklenme ve demografik çıkarım için kuramsal karşılığı olan ölçüt F_{ST}'dir. Popülasyonların alel bileşimi bakımından ne kadar ayrıştığı soruluyorsa D uygundur; mutasyon hızı yüksek belirteçlerde F_{ST} küçük kalırken D ayrışmayı gösterir. G''_{ST}, farklı çeşitlilikteki belirteçlerle yapılmış çalışmaları karşılaştırılabilir kılar. Meirmans ve Hedrick (2011) F_{ST} ile standartlaştırılmış bir ölçütün birlikte verilmesini önerir; şablon bu yüzden hepsini aynı çıktıda sunar.
S5. Genel D için iki değer var; fark nereden geliyor?
D_Jost_het (0,0914) önce heterozigotlukları lokuslar üzerinden ortalar, sonra tek bir D hesaplar; çeşitliliği yüksek lokuslar ağırlık kazanır. D_Jost_harmonik (0,0680) her lokusun D'sini ayrı hesaplayıp harmonik ortalar; küçük D'li lokuslar sonucu aşağı çeker. Jost'un (2008) lokuslar arası birleştirme için önerdiği harmonik ortalamadır; ancak negatif bir lokus değerinde tanımsızdır. İkili D sütunu her zaman heterozigotluk ortalamasından hesaplanır.
S6. Lokuslar arasında eksik veri farklıysa hesap nasıl etkilenir?
Weir–Cockerham bileşenleri her lokusta o lokusun kendi örneklem büyüklükleriyle hesaplanır; SFb5'te 55 genotip eksiktir ve \tilde n 20,58'den 17,51'e düşer. Genel değer lokus bileşenlerinin toplamı olduğundan eksik veri yalnız ilgili lokusun kesinliğini azaltır. Eksiklik genotipe bağlıysa (belirli aleller okunamıyorsa) yanlılık doğar; bu, eksik sayısından değil eksikliğin nedeninden kaynaklanır.
S7. SFb4 ve SFb5'te F_{IS} neden 0,14?
Akrabalı çiftleşme bütün lokusları aynı ölçüde etkiler; burada altı lokusta F_{IS} sıfıra yakın ya da negatif, dördünde pozitiftir. Lokusa özgü heterozigot eksikliğinin olağan nedeni okunamayan (boş) alellerdir: heterozigot birey homozigot gibi, iki boş alel taşıyan birey eksik genotip olarak kaydedilir. En yüksek F_{IS}'in en çok eksik genotipli iki lokusta görülmesi bu açıklamayla uyumludur. Boş alel frekansı bu şablonda kestirilmez; şüpheli lokuslar çıkarılarak duyarlılık denetlenir.
S8. \Phi'_{ST} neden F_{ST}'den çok büyük çıkıyor (0,184 ve 0,054)?
İki neden vardır. \Phi'_{ST} standartlaştırılmıştır: ham \Phi_{ST} 0,135'tir ve ulaşılabilir en büyük değere (0,732) bölünür. Ayrıca mmod çözümlemeye, lokuslar üzerinden ortalanmış uzaklıkların karesini sokar; bu, lokus bazında kareli uzaklıkların toplamına dayanan olağan AMOVA'dan farklı bir ölçektir ve hem popülasyon içi hem popülasyonlar arası payı değiştirir. \Phi'_{ST} bu nedenle amova şablonunun \Phi_{ST}'siyle doğrudan karşılaştırılmaz.
S9. İkili F_{ST}'ler için anlamlılık sınaması var mı?
Yoktur; şablon her çifte bootstrap aralığı verir. Aralığın sıfırı dışlaması bir sınama gibi okunabilir, ama iki sınırlama unutulmaz: aralıklar az lokusla kabadır ve çok sayıda çift için düzeltme yapılmaz. Genotiplerin popülasyonlar arasında karıştırılmasına dayanan permütasyon sınaması istenirse amova şablonu kullanılır.
S10. Popülasyon büyüklükleri 11 ile 30 arasında; bu dengesizlik sonucu bozar mı?
Weir–Cockerham kestiricisi dengesizlik için tasarlanmıştır: n_c ve ağırlıklı \bar p küçük popülasyonların payını küçültür. Nei–Chesser tarafında ağırlıksız ortalama kullanıldığından 11 ağaçlık QARS ile 30 ağaçlık KCHB aynı ağırlığı taşır; küçük popülasyonun frekans gürültüsü H_T'yi ve dolayısıyla G_{ST}, G''_{ST} ve D'yi yukarı iter. Harmonik ortalama düzeltmesi bunun ortalama etkisini giderir, ama tek tek ikili değerlerde küçük popülasyonlu çiftler daha oynaktır.
71.10 Kaynaklar
- Awad, L., Fady, B., Khater, C., Roig, A., & Cheddadi, R. (2014). Genetic structure and diversity of the endangered fir tree of Lebanon (Abies cilicica Carr.): Implications for conservation. PLoS ONE, 9(2), e90086. https://doi.org/10.1371/journal.pone.0090086
- Excoffier, L., Smouse, P. E., & Quattro, J. M. (1992). Analysis of molecular variance inferred from metric distances among DNA haplotypes: Application to human mitochondrial DNA restriction data. Genetics, 131(2), 479–491. https://doi.org/10.1093/genetics/131.2.479
- Goudet, J. (2005). hierfstat, a package for R to compute and test hierarchical F-statistics. Molecular Ecology Notes, 5(1), 184–186. https://doi.org/10.1111/j.1471-8286.2004.00828.x
- Goudet, J., & Jombart, T. (2022). hierfstat: Estimation and tests of hierarchical F-statistics (R package version 0.5-11). https://doi.org/10.32614/CRAN.package.hierfstat
- Hedrick, P. W. (2005). A standardized genetic differentiation measure. Evolution, 59(8), 1633–1638. https://doi.org/10.1111/j.0014-3820.2005.tb01814.x
- Jombart, T. (2008). adegenet: A R package for the multivariate analysis of genetic markers. Bioinformatics, 24(11), 1403–1405. https://doi.org/10.1093/bioinformatics/btn129
- Jost, L. (2008). G_{ST} and its relatives do not measure differentiation. Molecular Ecology, 17(18), 4015–4026. https://doi.org/10.1111/j.1365-294X.2008.03887.x
- Meirmans, P. G. (2006). Using the AMOVA framework to estimate a standardized genetic differentiation measure. Evolution, 60(11), 2399–2402. https://doi.org/10.1111/j.0014-3820.2006.tb01874.x
- Meirmans, P. G., & Hedrick, P. W. (2011). Assessing population structure: F_{ST} and related measures. Molecular Ecology Resources, 11(1), 5–18. https://doi.org/10.1111/j.1755-0998.2010.02927.x
- Nei, M. (1973). Analysis of gene diversity in subdivided populations. Proceedings of the National Academy of Sciences, 70(12), 3321–3323. https://doi.org/10.1073/pnas.70.12.3321
- Nei, M., & Chesser, R. K. (1983). Estimation of fixation indices and gene diversities. Annals of Human Genetics, 47(3), 253–259. https://doi.org/10.1111/j.1469-1809.1983.tb00993.x
- Paradis, E. (2010). pegas: An R package for population genetics with an integrated–modular approach. Bioinformatics, 26(3), 419–420. https://doi.org/10.1093/bioinformatics/btp696
- Weir, B. S., & Cockerham, C. C. (1984). Estimating F-statistics for the analysis of population structure. Evolution, 38(6), 1358–1370. https://doi.org/10.1111/j.1558-5646.1984.tb05657.x
- Winter, D. J. (2012). mmod: An R library for the calculation of population differentiation statistics. Molecular Ecology Resources, 12(6), 1158–1160. https://doi.org/10.1111/j.1755-0998.2012.03174.x
- Wright, S. (1949). The genetical structure of populations. Annals of Eugenics, 15(1), 323–354. https://doi.org/10.1111/j.1469-1809.1949.tb02451.x