107. Markov rejim değiştirme regresyonu (Python)
Şablon kimliği: markov_rejim_py · Kategori: zaman serisi · Dil: Python · Dosya: pro/sablonlar/zaman_serisi/markov_rejim_py.py (satır 1–378; üstbilgi 1–101) · Örnek veri: _ornek/usmacro.csv · Paketler: statsmodels 0.14.6, numpy 2.4.6, scipy 1.16.3, pandas 2.3.3, matplotlib 3.10.9 (Python 3.13.1) · R eşi: Bölüm 106
107.1 Ne işe yarar
Şablon, Bölüm 106'daki markov_rejim şablonunun Python karşılığıdır ve aynı soruyu yanıtlar: yanıtın kesişimi, açıklayıcılarının ve gecikmesinin katsayıları (isteğe bağlı olarak hata varyansı) gizli bir Markov zincirine göre değişiyorsa, her dönemde hangi rejimin geçerli olduğu, rejimlerin kalıcılığı ve rejime göre katsayılar nelerdir?
Hesabı R şablonunun kendi yazdığı süzgeç ve en büyükleyici yapmaz; statsmodels.tsa.regime_switching.MarkovRegression yapar. Şablon veriyi hazırlar, modeli uydurur, statsmodels'in parametre adlarını R şablonunun tablo düzenine çevirir, rejimleri kesişime göre sıralar ve altı tabloyla bir şekil üretir. Kavramların ayrıntılı anlatımı (Hamilton süzgeci, Kim düzgünleştiricisi, rejim sıralaması, SH'ler) Bölüm 106.4'tedir; bu bölüm kendi başına okunabilmesi için formülleri kısaca yeniden verir ve Python uygulamasının farklarına odaklanır.
Önemli: İki şablon örnek ayarda ve değişken varyanslı modelde aynı sayıları verir (107.6.1). Üç rejimde farklı yerel en büyüklere varabilirler ve bu fark yalnız ikizi çalıştırarak fark edilir (107.7).
Ne zaman kullanılır?
- R'nin kurulu olmadığı ya da kullanıcının Python yorumlayıcısıyla (gömülü işçi ya da harici) çalıştığı bilgisayarlarda.
- Aynı model R ikiziyle de çalıştırılıp iki çözümün log-olabilirliği karşılaştırılacaksa: iki şablonun aynı değeri vermesi çözümün sağlam olduğunun iyi bir işaretidir; farklı çıkması bir yerel en büyüğün işaretidir.
Ne zaman kullanılmaz?
- Rejimi gözlenen bir değişken belirliyorsa: Bölüm 100
esik_ar. Kırılma tarihi biliniyorsa: Bölüm 112yapisal_kirilmave Python eşi Bölüm 113. - Değişen şey yalnız oynaklıksa: Bölüm 102
garch_genis. - Hamilton'ın ortalama değiştiren AR'si isteniyorsa: bu şablon yanıt gecikmelerini açıklayıcı alır ve katsayılarını rejime göre değiştirir (106.4.1); statsmodels'in
MarkovAutoregressionsınıfı farklı bir modeldir ve şablonda kullanılmaz. - Değişken varyansla çalışılacaksa ya da k=3 gerekiyorsa ve sonuç tek bir çalıştırmaya dayanacaksa: Python şablonunun yerel en büyüğe takılma riski (107.7) k=3'te R şablonundan daha yüksek görülmüştür; her iki şablonu ve birkaç tohumu karşılaştırmak gerekir.
Temel programla ilişki. Temel programda rejim değiştirme regresyonu yoktur; doğrulama bağımsız Python ve R hesaplarıyla ve R ikiziyle yapılmıştır (107.6).
107.2 Şablonun girdileri
Form, üstbilgideki 12 [[param]] bloğundan kurulur (markov_rejim_py.py:11–100); alanların çoğu R eşiyle özdeştir. Türlerin ve formun ortak denetiminin anlamı Bölüm 1.2'de anlatılmıştır. R şablonunda bulunan nlminb_incelt ve hessian_adim alanları burada yoktur; Python şablonuna özgü bir alan em_yineleme'dir.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | y_t (11–15, 121). |
Açıklayıcılar · x |
sütunlar (sayısal, isteğe bağlı) · Değişkenler | boş | sayısal sütunlar | Katsayıları rejime göre değişir; y ve zaman listeden çıkarılır (16–22, 118, 122). |
Yanıtın gecikme sayısı · gecikme |
tamsayı · Model | 0 | 0–4 | y(t-l) sütunları (23–30, 123–124). |
Rejim sayısı · k |
tamsayı · Model | 2 | 2–3 | k_regimes (31–38, 119, 212). |
Hata varyansı da değişsin · degisken_varyans |
onay · Model | kapalı | açık/kapalı | switching_variance (39–44, 173, 213). |
Zaman etiketi · zaman |
sütun (isteğe bağlı) · Değişkenler | boş | herhangi sütun | Etiket; seçiliyse artan ve tekil olması denetlenir (45–50, 117, 126–159, 376). |
Başlangıç noktası sayısı · baslangic |
tamsayı · Gelişmiş | 10 | 1–50 | search_reps; değişken varyans ya da k=3 ise en az 30 (51–58, 190–191, 215). |
Güven düzeyi (%) · guven |
ondalık · Seçenekler | 95 | 50–99,9 | GA (59–66, 184, 333). |
Rastgele başlangıç tohumu · tohum |
tamsayı · Gelişmiş | 1 | 0–2147483647 | np.random.seed(tohum) (67–75, 185, 214). |
Ön EM yineleme sayısı · em_yineleme |
tamsayı · Gelişmiş | 20 | 0–1000 | fit(em_iter=…) (76–84, 186, 215). |
En çok yineleme · en_cok_yineleme |
tamsayı · Gelişmiş | 2000 | 10–100000 | Her fit çağrısının maxiter değeri (85–92, 187, 215–216). |
BFGS gradyan toleransı · tolerans |
ondalık · Gelişmiş | 10^{-10} | 10^{-16}–10^{-3} | İkinci fit çağrısında gtol (93–100, 188, 217). |
Şablonun kendi denetimleri (R eşiyle aynı iletiler):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 115–116 |
| n<\max(30,\,3\,\text{npar}) | "Tam gözlem sayısı (n) … parametre için çok az; en az … gerekli." | 135–137 |
| Yanıt sabit | "Yanıt sabit." | 138–139 |
Açıklayıcılar sabit ya da doğrusal bağımlı (matrix_rank(X) < p) |
"Açıklayıcılar sabit ya da doğrusal bağımlı; birini çıkarın." | 141–142 |
fit bir istisna fırlatır |
"Olabilirlik en büyüklenemedi: " + istisna iletisi | 158–159 |
| Parametre ya da log-olabilirlik sonlu değil | "Olabilirlik en büyüklenemedi (rejimler ayrışmıyor olabilir); rejim sayısını azaltın." | 161–163 |
zaman sütunu artan değil ya da tekrar eden dönem içeriyor |
"'…' zaman sütunu artan sırada değil ya da tekrar eden dönem içeriyor (ilk sorun: …)…" | 153, 157 |
| Serinin ortasında eksik gözlem | "Serinin ortasında eksik gözlem var (… satır; ilk: …)…" | 166 |
| Değişken varyansta her başlangıç dejenere çözüme vardı | "Her başlangıç dejenere bir çözüme … vardı; …" | 255 |
Hessian ters çevrilemedi (SH hepsi NaN) |
Uyarı: "Hessian tersine çevrilemedi; standart hatalar verilemiyor…"; k=3'te ek olarak çok tepelilik uyarısı; çalıştırma sürer | 272–274, 285–287 |
Parametre sayısı R eşindeki gibi \text{npar}=k(k-1)+kp+n_v'dir (174). Örnekte 2+8+1=11.
Tohum. Kod panelinin Tohum alanı (Bölüm 1.3) bu şablonun rastgele başlangıç aramasını etkilemez: şablon 214. satırda np.random.seed(tohum) ile kendi form değerini yeniden kurar ve statsmodels'in search_reps araması bu genel üretecten çeker. Sonucu yinelenebilir kılan formdaki "Rastgele başlangıç tohumu"dur (varsayılan 1). Python üreteci R üretecinden farklı olduğundan, aynı tohum iki şablonda aynı başlangıçları vermez.
Örnek ayar (ornek_param, satır 9): y = fedfunds, x = [ogap, enflasyon], gecikme = 1, k = 2, degisken_varyans = kapalı, zaman = ceyrek, baslangic = 10; öteki alanlar varsayılandadır. R ikiziyle aynıdır.
107.3 Örnek veri
usmacro.csv, R ikiziyle aynı dosyadır (Bölüm 106.3): 226 satır, 1954Q3–2010Q4, ceyrek (zaman etiketi; veri sekmesi tür olarak "tarih" algılar), fedfunds (yanıt), ogap ve enflasyon (sayısal; enflasyon ilk 4 satırda eksik). Bir gecikmeyle n=222'dir. Kategorik değişken yoktur.
Bu bölümde şu çalıştırmalar kullanılır: markov_rejim_py_ornek, _sabit (yalnız kesişim), _gec0, _dv, _dv_t2, _dv_b30 (değişken varyans; tohum 2; 30 başlangıç), _k3, _k3_b30, _tohum7, _b1, _em0 (ön EM yok), _ters, _ortaeksik, _kisa36, _sabity, _bagimli, _virgul, _kategorik. R ikizinin aynı ayarlı çalıştırmaları Bölüm 106.3'tedir.
107.4 Yöntem: formüller ve hesap adımları
Hesap sırası: yanıtın gecikmeleri açıklayıcıya eklenir ve eksik satırlar atılır (121–171); MarkovRegression modeli kurulur ve iki aşamada uydurulur (209–258); parametreler statsmodels adlarından okunup R şablonunun düzenine yerleştirilir (288–309); rejimler kesişime göre sıralanır (311–330); tablolar ve şekil üretilir (332–378).
107.4.1 Model ve olabilirlik
Model ve olabilirlik Bölüm 106.4.2'dekiyle aynı Hamilton olabilirliğidir:
- \mathbf e_t: rejim koşullu normal yoğunluklar; \mathbf P: satırları kaynak rejim olan geçiş matrisi; \boldsymbol\xi_{t|t-1}, \boldsymbol\xi_{t|t}: tahmin ve süzülmüş rejim olasılıkları.
- Düzgünleştirilmiş olasılıklar statsmodels'in Kim düzgünleştiricisinden gelir (
smoothed_marginal_probabilities, 242).
Koddaki tercih
MarkovRegression(y, k_regimes=k, trend="c", exog=Xr if p > 1 else None, switching_variance=…) (212–213). switching_trend ve switching_exog varsayılan olarak doğrudur: kesişim ve bütün açıklayıcıların katsayıları rejime göre değişir (R şablonuyla aynı). Başlangıç rejim dağılımı statsmodels'in varsayılan "steady-state" dağılımıdır; yani geçiş matrisinin ergodik dağılımı (R şablonunun 106.4.2'deki tercihi). exog, kesişim sütununu içermez (Xr; kesişimi trend="c" ekler).
107.4.2 İki aşamalı uydurma
np.random.seed(tohum)
res = mod.fit(search_reps=baslangic, em_iter=em_it, maxiter=maxit, disp=False)
res = mod.fit(start_params=res.params, maxiter=maxit, disp=False, method="bfgs",
              optim_complex_step=False, gtol=gtol)
Birinci çağrı statsmodels'in başlangıç stratejisini kullanır (kaynak: MarkovSwitching.fit): (i) baslangic kadar rastgele başlangıç aranır; her biri, sınırsız (dönüştürülmemiş) uzayda başlangıç vektörüne U(-0{,}5;\,0{,}5) gürültü eklenerek kurulur ve 5 EM adımı çalıştırılır (search_iter varsayılanı); en yüksek log-olabilirlikli başlangıç korunur; (ii) bu noktadan em_iter (= em_yineleme, varsayılan 20) EM adımı daha atılır; (iii) sonuç BFGS'ye başlangıç olur (maxiter = en_cok_yineleme; BFGS gradyan toleransı paketin varsayılanında kalır).
İkinci çağrı birinci çözümün parametrelerinden başlar ve BFGS'yi gtol = tolerans (10^{-10}) ile yeniden çalıştırır. em_iter bu çağrıda verilmediğinden paketin varsayılanı olan 5 EM adımı yeniden çalışır. Her iki çağrıda da warnings susturulmuştur (209–210) ve herhangi bir istisna tek bir iletiye çevrilir (218–219).
Koddaki tercih
R şablonunun aksine burada başlangıçlar statsmodels'in search_reps mekanizmasındandır: paketin kendi başlangıç vektörü ve ona gürültü eklenerek kurulan adaylar EM ile iyileştirilip en yüksek olabilirlikli nokta seçilir, BFGS yalnız bu noktadan çalışır. R şablonunda her başlangıç ayrı bir BFGS'ye gider ve en iyi sonuç seçilir. Bu nedenle iki şablonun "10 başlangıcı" aynı iş değildir ve zor modellerde farklı yerel en büyüklere varmaları beklenir (107.7).
Değişken varyanslı modelde ek başlangıçlar. degisken_varyans açıkken olabilirlik \sigma_j\to0 için sınırsızdır ve search_reps araması dejenere bir çözümü en iyi diye seçebilir. Şablon bu durumda yukarıdaki iki çağrıdan sonra kendi başlangıçlarını da dener (219–258): paketin başlangıç vektörüne, \sigma^2 için \exp(N(0;1{,}5^2)) çarpanı, kesişimler için N(0;\mathrm{sd}(y)^2) gürültüsü ve öteki katsayılar için N(0;[0{,}1(|\beta|+0{,}1)]^2) gürültüsü ekleyip (geçiş olasılıkları aynı kalır) EM ve BFGS çalıştırır; toplam en az 30 başlangıç kullanılır. Bir rejimin \hat\sigma_j<10^{-3}\,\mathrm{sd}(y) olduğu ya da düzgünleştirilmiş olasılıklarının toplamının 5 gözlemden az olduğu çözümler atılır ve geçerli çözümlerin en yüksek log-olabilirlikli olanı seçilir; tohum np.random.RandomState(tohum) ile kurulur. Çıktıya kaç başlangıcın en iyi çözüme vardığı yazılır (276–284). k=3'te de en az 30 search_reps kullanılır (190–191).
`tolerans` iki şablonda aynı büyüklük değildir
R eşinde tolerans göreli bir olabilirlik değişimidir (reltol, varsayılan 10^{-14}); burada BFGS'nin gradyan normu eşiğidir (gtol, varsayılan 10^{-10}). Aynı sayıyı iki şablona girmek aynı yakınsama ölçütünü vermez.
107.4.3 Standart hatalar, parametre eşlemesi ve sıralama
SH'ler res.cov_params_approx'ın köşegeninin kareköküdür (266–267); statsmodels bu matrisi olabilirliğin sayısal ikinci türevinden (gözlenen bilgi) kurar. Matris kurulamazsa ya da sonlu olmayan bir SH çıkarsa bütün SH'ler NaN olur (268–271) ve uyarı yazılır (272–274); k=3'te bunun nedeninin çok tepeli olabilirlik olabileceğini ve sonucu R şablonuyla karşılaştırmayı öneren bir uyarı eklenir (285–287). Parametreler res.model.param_names ile okunur (289–309): p[i->j] (j<k-1), const[j], x{a}[j] ve sigma2 ya da sigma2[j].
- \hat\sigma^2 ve \mathrm{SH}(\hat\sigma^2) doğrudan statsmodels'ten; \mathrm{SH}(\hat\sigma) delta yöntemiyle (346).
- Süreler, AIC ve BIC şablonda hesaplanır (355–360); n gecikme ve eksikler düştükten sonraki gözlem sayısıdır.
Sıralama. Rejimler kesişimlere göre artan sıralanır (np.argsort(B[0]), 311); geçiş matrisi hem satır hem sütun, katsayılar ve (değişken varyansta) \sigma^2 aynı permütasyonla yeniden düzenlenir (312–315). Sıra değiştiyse geçiş SH'leri yeniden eşlenir: ilk k-1 hedef için ilgili p[i->j] SH'si alınır, özgün son hedefe düşen için SH, ilgili satırdaki k-1 olasılığın kovaryans bloğunun toplamının kareköküdür (317–330). Yeni son sütun için SH her zaman NaN'dır (317, 330).
Rejim olasılıkları. smoothed_marginal_probabilities ve filtered_marginal_probabilities sütunları aynı permütasyonla düzenlenir (353–354). Ergodik dağılım \big[(\mathbf I-\mathbf P)';\mathbf 1'\big]\boldsymbol\pi=(\mathbf 0{,}1)' sisteminin np.linalg.lstsq çözümüdür (351–352).
107.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–101 | Üstbilgi: 12 parametre, örnek veri ve ayar. | 10. satırdaki yan dosya alanı kitap dışıdır. |
| 102–116 | İçe aktarmalar, _m dil yardımcısı, veri denetimi. |
statsmodels yoksa şablon çalışmaz. |
| 117–171 | zaman, xs, k, L; yanıt, açıklayıcı ve gecikme sütunları; tam satırlar; n, p. |
Gecikmeler özgün konumdan kurulur (123–126), zaman sırası denetlenir (128–159), sonra baştaki/sondaki eksik satırlar atılır, ortadaki eksik durdurur (160–171). |
| 173–182 | n_v, npar, n ve sabit yanıt ve rank denetimleri. | R eşiyle aynı eşikler. |
| 184–188 | Seçeneklerin okunması. | P.get ile; eksik alan varsayılana düşer. |
| 209–219 | İki aşamalı fit. |
İstisna tek iletiye çevrilir (218–219). |
| 259–274 | Sonluluk denetimi, kovaryans ve SH. | Tek bir sonlu olmayan SH hepsini NaN yapar (269). |
| 288–330 | param_names eşlemesi, sıralama, SH yeniden eşleme. |
Yeni son sütun SH'si NaN (317, 330). |
| 332–366 | Altı tablo: katsayılar, \sigma, geçişler, süreler, uyum, rejim olasılıkları. | R eşiyle aynı sütun adları. |
| 368–378 | İki panelli şekil. | Yatay eksen etiketleri 8 noktada (374–376). |
Süre: örnek ayarda çalıştırma 4,25 s sürmüştür (R eşi 11,2 s).
107.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/markov_rejim/elle_hesap.py ile hesaplanmıştır (Bölüm 106.6'daki aynı betik; statsmodels ya da şablon çağrılmaz). Girdi, bu şablonun kestirimleridir (markov_rejim_py_ornek, tablo1–3).
Adım 1 — Olabilirlik. Log uzayında ileri özyineleme: şablonun \hat{\mathbf P}, \hat{\boldsymbol\beta} ve \hat\sigma=0{,}5764495 değerleriyle \ell=-229{,}2561443; şablonun değeriyle 5\times10^{-15} içinde aynı.
Adım 2 — Ergodik dağılım ve süreler. \boldsymbol\pi=(0{,}5626782;\ 0{,}4373218), \hat E[D]=(4{,}7290764;\ 3{,}6755081) dönem; AIC =480{,}5122887, BIC =517{,}9417399.
Adım 3 — Olasılıklar. Düzgünleştirme alfa-beta çarpımıyla: t=1 için (0{,}5935476;\ 0{,}4064524), t=50 için 0{,}5932227 (rejim 1); ilk gözlemde süzülmüş (0{,}5565758;\ 0{,}4434242).
Adım 4 — Yeniden en büyükleme. Şablonun çözümünden scipy BFGS aynı \ell=-229{,}2561443354'te kalır, parametreler en çok 1{,}4\times10^{-9} oynar; bozulmuş bir başlangıçtan aynı noktaya varılır. R'de nlm aynı sonucu verir.
Adım 5 — SH. Bağımsız Richardson Hessian'ından \mathrm{SH}(\hat\alpha_1)=0{,}1279227; şablon (statsmodels) 0{,}1279232, R numDeriv (r=6) 0{,}1279168 (en büyük ayrılık 5\times10^{-5} göreli).
107.6.1 Doğrulama: MerQuR+, Python ve R
Birinci tablo bu şablonun tablolarını bağımsız Python ve R hesaplarıyla karşılaştırır. Standart hata satırlarının ölçütü 10^{-4}'tür (sayısal Hessian); yeniden en büyüklenen katsayılarda 10^{-5}; öbürlerinde 10^{-6}.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | Ölçüt | |
|---|---|---|---|---|---|---|
| Log-olabilirlik | −229,25614434 | −229,25614434 | −229,25614434 | 5,0e−15 | 1e−6 | ✓ |
| AIC | 480,51228867 | 480,51228867 | 480,51228867 | 4,5e−15 | 1e−6 | ✓ |
| BIC | 517,94173987 | 517,94173987 | 517,94173987 | 4,2e−15 | 1e−6 | ✓ |
| Yeniden en büyükleme: log-olabilirlik (şablon çözümünden başlayarak) | −229,25614434 | −229,25614434 | −229,25614434 | 6,2e−16 | 1e−6 | ✓ |
| Yeniden en büyükleme: log-olabilirlik (bozulmuş başlangıçtan) | −229,25614434 | −229,25614434 | −229,25614434 | 3,7e−11 | 1e−6 | ✓ |
| Rejim 1: kesişim, yeniden en büyüklenmiş | −0,09449236 | −0,09449236 | −0,09449236 | 1,1e−9 | 1e−5 | ✓ |
| Rejim 1: ogap, yeniden en büyüklenmiş | 0,03430718 | 0,03430717 | 0,03430718 | 4,2e−9 | 1e−5 | ✓ |
| Rejim 1: enflasyon, yeniden en büyüklenmiş | 0,21252747 | 0,21252747 | 0,21252747 | 3,3e−9 | 1e−5 | ✓ |
| Rejim 1: yanıt(t−1), yeniden en büyüklenmiş | 0,92925739 | 0,92925738 | 0,92925739 | 8,9e−9 | 1e−5 | ✓ |
| Rejim 2: kesişim, yeniden en büyüklenmiş | 0,65549533 | 0,65549533 | 0,65549533 | 1,5e−9 | 1e−5 | ✓ |
| Rejim 2: ogap, yeniden en büyüklenmiş | 0,13554246 | 0,13554246 | 0,13554246 | 2,9e−9 | 1e−5 | ✓ |
| Rejim 2: enflasyon, yeniden en büyüklenmiş | −0,02739279 | −0,02739279 | −0,02739279 | 3,8e−9 | 1e−5 | ✓ |
| Rejim 2: yanıt(t−1), yeniden en büyüklenmiş | 0,83144577 | 0,83144577 | 0,83144577 | 7,5e−9 | 1e−5 | ✓ |
| p_{11}, yeniden en büyüklenmiş | 0,78854222 | 0,78854222 | 0,78854222 | 1,0e−9 | 1e−5 | ✓ |
| p_{21}, yeniden en büyüklenmiş | 0,27207123 | 0,27207123 | 0,27207123 | 9,5e−10 | 1e−5 | ✓ |
| \sigma, yeniden en büyüklenmiş | 0,57644947 | 0,57644947 | 0,57644947 | 1,5e−10 | 1e−5 | ✓ |
| Beklenen süre, rejim 1 | 4,72907643 | 4,72907643 | 4,72907643 | 1,1e−15 | 1e−6 | ✓ |
| Beklenen süre, rejim 2 | 3,67550809 | 3,67550809 | 3,67550809 | 9,7e−16 | 1e−6 | ✓ |
| Durağan olasılık, rejim 1 | 0,56267819 | 0,56267819 | 0,56267819 | 2,2e−16 | 1e−6 | ✓ |
| Durağan olasılık, rejim 2 | 0,43732181 | 0,43732181 | 0,43732181 | 6,1e−16 | 1e−6 | ✓ |
| Düzgünleştirilmiş olasılık ortalaması, rejim 1 | 0,56239539 | 0,56239539 | 0,56239539 | 1,4e−15 | 1e−6 | ✓ |
| Düzgünleştirilmiş olasılık, t=1, rejim 1 | 0,5935476 | 0,5935476 | 0,5935476 | 1,3e−15 | 1e−6 | ✓ |
| Düzgünleştirilmiş olasılık, t=50, rejim 1 | 0,59322274 | 0,59322274 | 0,59322274 | 1,0e−14 | 1e−6 | ✓ |
| Düzgünleştirilmiş olasılık, t=n, rejim 2 | 0,40941422 | 0,40941422 | 0,40941422 | 5,7e−15 | 1e−6 | ✓ |
| Süzülmüş olasılık, t=1, rejim 1 (ergodik başlangıç) | 0,55657581 | 0,55657581 | — | 1,1e−16 | 1e−6 | ✓ |
| Süzülmüş olasılık, t=n, rejim 2 | 0,40941422 | 0,40941422 | — | 5,7e−15 | 1e−6 | ✓ |
| SH rejim 1: kesişim | 0,12792315 | 0,12792272 | 0,12791683 | 6,3e−6 | 1e−4 | ✓ |
| SH rejim 1: ogap | 0,02401375 | 0,02401374 | 0,02401339 | 3,6e−7 | 1e−4 | ✓ |
| SH rejim 1: enflasyon | 0,02973511 | 0,0297351 | 0,02973512 | 1,1e−8 | 1e−4 | ✓ |
| SH rejim 1: yanıt(t−1) | 0,02708524 | 0,02708522 | 0,02708472 | 5,1e−7 | 1e−4 | ✓ |
| SH rejim 2: kesişim | 0,13738892 | 0,13738892 | 0,13738882 | 1,1e−7 | 1e−4 | ✓ |
| SH rejim 2: ogap | 0,02941126 | 0,02941126 | 0,02941128 | 1,6e−8 | 1e−4 | ✓ |
| SH rejim 2: enflasyon | 0,04080567 | 0,04080568 | 0,04080774 | 2,1e−6 | 1e−4 | ✓ |
| SH rejim 2: yanıt(t−1) | 0,03332356 | 0,03332356 | 0,03332457 | 1,0e−6 | 1e−4 | ✓ |
| SH p_{11} | 0,06411791 | 0,06411792 | 0,06411795 | 3,6e−8 | 1e−4 | ✓ |
| SH p_{21} | 0,09299152 | 0,09299155 | 0,09299166 | 1,3e−7 | 1e−4 | ✓ |
| SH \sigma^2 | 0,03488229 | 0,03488229 | 0,03488226 | 2,9e−8 | 1e−4 | ✓ |
| SH \sigma (delta yöntemi) | 0,03025616 | 0,03025616 | 0,03025613 | 2,5e−8 | 1e−4 | ✓ |
Ölçütü karşılayan: 38/38. Örnek ayar (fedfunds ~ ogap, enflasyon, fedfunds(t−1); k=2). Bağımsız Python hesabı log-uzayda ileri özyineleme, ileri-geri (alfa-beta) düzgünleştirme, özdeğer çözümüyle ergodik dağılım, scipy BFGS/Nelder–Mead ile yeniden en büyükleme ve kendi Richardson Hessian'ını kullanır; R hesabı ölçekli ileri-geri özyineleme, eigen, nlm ve numDeriv::hessian (d = 10⁻³, r = 6) kullanır. Standart hatalar sayısal ikinci türevdir; yöntemler arasında \approx4\times10^{-5} göreli farkla ayrışır, bu yüzden SH satırlarının ölçütü 10^{-4}'tür.
R ikiziyle karşılaştırma. Aynı veri ve aynı örnek ayarda iki şablonun çıktıları:
| Büyüklük | MerQuR+ (Python şablonu) | MerQuR+ (R şablonu) | — | En büyük fark | Ölçüt | |
|---|---|---|---|---|---|---|
| Log-olabilirlik | −229,25614434 | −229,25614434 | — | 6,2e−16 | 1e−6 | ✓ |
| AIC | 480,51228867 | 480,51228867 | — | 3,5e−16 | 1e−6 | ✓ |
| BIC | 517,94173987 | 517,94173987 | — | 2,2e−16 | 1e−6 | ✓ |
| Katsayı: rejim 1, kesişim | −0,09449236 | −0,09449239 | — | 3,3e−8 | 1e−6 | ✓ |
| Katsayı: rejim 1, ogap | 0,03430718 | 0,03430717 | — | 2,0e−9 | 1e−6 | ✓ |
| Katsayı: rejim 1, enflasyon | 0,21252747 | 0,21252748 | — | 8,4e−9 | 1e−6 | ✓ |
| Katsayı: rejim 1, yanıt(t−1) | 0,92925739 | 0,92925739 | — | 1,2e−9 | 1e−6 | ✓ |
| Katsayı: rejim 2, kesişim | 0,65549533 | 0,65549528 | — | 5,3e−8 | 1e−6 | ✓ |
| Katsayı: rejim 2, ogap | 0,13554246 | 0,13554245 | — | 6,1e−9 | 1e−6 | ✓ |
| Katsayı: rejim 2, enflasyon | −0,02739279 | −0,02739279 | — | 3,4e−9 | 1e−6 | ✓ |
| Katsayı: rejim 2, yanıt(t−1) | 0,83144577 | 0,83144577 | — | 8,2e−10 | 1e−6 | ✓ |
| \sigma | 0,57644947 | 0,57644948 | — | 1,0e−8 | 1e−6 | ✓ |
| p_{11} | 0,78854222 | 0,78854223 | — | 4,6e−9 | 1e−6 | ✓ |
| p_{21} | 0,27207123 | 0,27207123 | — | 1,2e−9 | 1e−6 | ✓ |
| Beklenen süre, rejim 1 | 4,72907643 | 4,72907653 | — | 2,2e−8 | 1e−6 | ✓ |
| Durağan olasılık, rejim 1 | 0,56267819 | 0,5626782 | — | 4,3e−9 | 1e−6 | ✓ |
| Düzgünleştirilmiş olasılık, t=1, rejim 1 | 0,5935476 | 0,59354752 | — | 7,5e−8 | 1e−6 | ✓ |
| Süzülmüş olasılık, t=n, rejim 2 | 0,40941422 | 0,40941422 | — | 5,5e−9 | 1e−6 | ✓ |
| SH: rejim 1, kesişim | 0,12792315 | 0,12791899 | — | 4,2e−6 | 1e−4 | ✓ |
| SH: rejim 1, ogap | 0,02401375 | 0,02401348 | — | 2,8e−7 | 1e−4 | ✓ |
| SH: rejim 1, enflasyon | 0,02973511 | 0,02973508 | — | 2,8e−8 | 1e−4 | ✓ |
| SH: rejim 1, yanıt(t−1) | 0,02708524 | 0,02708495 | — | 2,8e−7 | 1e−4 | ✓ |
| SH: rejim 2, kesişim | 0,13738892 | 0,13738855 | — | 3,7e−7 | 1e−4 | ✓ |
| SH: rejim 2, ogap | 0,02941126 | 0,0294112 | — | 5,7e−8 | 1e−4 | ✓ |
| SH: rejim 2, enflasyon | 0,04080567 | 0,04080479 | — | 8,7e−7 | 1e−4 | ✓ |
| SH: rejim 2, yanıt(t−1) | 0,03332356 | 0,03332317 | — | 3,9e−7 | 1e−4 | ✓ |
| SH \sigma | 0,03025616 | 0,03025614 | — | 1,7e−8 | 1e−4 | ✓ |
| SH p_{11} | 0,06411791 | 0,06411787 | — | 4,9e−8 | 1e−4 | ✓ |
Ölçütü karşılayan: 28/28. Aynı veri ve aynı örnek ayar; yalnız bu ayarda iki şablon aynı yerel en büyüğe varır (107.7'de farklı ayarlar gösterilir). Standart hata satırlarında ölçüt 10^{-4}'tür: R şablonu numDeriv Hessian'ı, Python şablonu statsmodels yaklaşık Hessian'ı kullanır.
107.7 Çıktıyı okuma
Örnek ayarın çıktısı R eşininkiyle kestirimlerde yedinci ondalığa, standart hatalarda dördüncü anlamlı basamağa kadar aynıdır; ondalık biçimi nokta olarak gösterilmiştir. Konsol metni ve tablolar Bölüm 106.7'deki gibidir:
n = 222 (gecikmeler ve eksikler düşüldükten sonra); 2 rejim; 11 parametre; log-olabilirlik = -229,25614

rejim  terim           kestirim    SH         z          p
1      kesişim         -0.0944924  0.127923  -0.738665   0.460110
1      ogap             0.0343072  0.0240138  1.42865    0.153106
1      enflasyon        0.212527   0.0297351  7.14736    8.84634e-13
1      fedfunds(t-1)    0.929257   0.0270852 34.3086     5.83528e-258
2      kesişim          0.655495   0.137389   4.77109    1.83229e-06
…
rejim  sigma     SH_sigma   sigma2    SH_sigma2
ortak  0.576449  0.0302562  0.332294  0.0348823
kaynak hedef olasilik SH :  1→1 0.788542 0.0641179 ; 1→2 0.211458 NA ; 2→1 0.272071 0.0929915 ; 2→2 0.727929 NA
logLik -229.256 | AIC 480.512 | BIC 517.942 | n 222 | parametre 11
Şekil 107.1. Şablonun çizdiği grafik (örnek veri): üstte `fedfunds`, altta en yüksek kesişimli rejim için düzgünleştirilmiş olasılık. Görünüm R eşinin şekliyle aynı düzendedir.
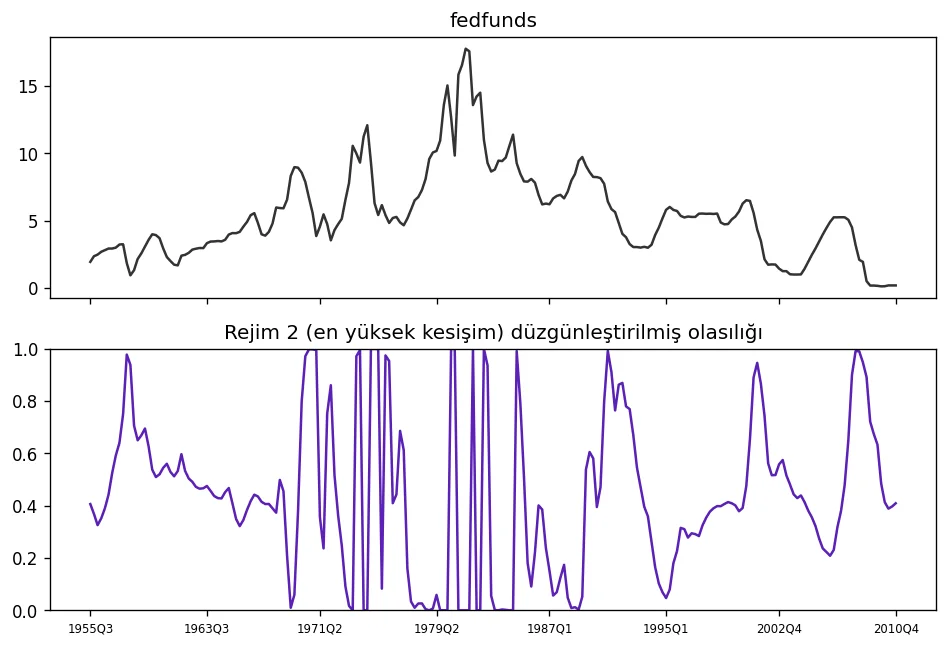
Sütunların anlamı ve yorumu Bölüm 106.7'deki tablodakiyle aynıdır: katsayılar rejime göre (örnekte rejim 1'de enflasyon, rejim 2'de çıktı açığı anlamlıdır), \hat p_{11}=0{,}789 ve \hat p_{22}=0{,}728, beklenen süreler 4{,}73 ve 3{,}68 çeyrek.
İkizin ayrıştığı ayarlar. Aynı veri, aynı form ayarı; log-olabilirlik (\ell) iki şablonda:
| Çalıştırma | R şablonu (\ell) | Python şablonu (\ell) | Python'da SH | Not |
|---|---|---|---|---|
| örnek ayar | -229{,}256 | -229{,}256 | var | aynı çözüm |
yalnız kesişim, gecikme = 0 |
-508{,}636 | -508{,}636 | var | aynı çözüm |
gecikme = 0, iki açıklayıcı |
-360{,}618 | -360{,}618 | var | aynı çözüm |
| ortada 10 eksik | hata | hata | — | iki şablon da "serinin ortasında eksik gözlem" iletisiyle durur |
| ters sıralı veri | hata | hata | — | iki şablon da "artan sırada değil" iletisiyle durur |
| k=3 (en az 30 başlangıç) | -180{,}806 | -182{,}272 | hepsi NaN | Python R'nin -180{,}806 değerine varmaz; çok tepelilik uyarısı yazılır |
degisken_varyans (en az 30 başlangıç) |
-201{,}878 | -201{,}878 | var | iki şablon da dejenere olmayan aynı çözüme varır |
degisken_varyans satırında iki şablon da dejenere olmayan aynı çözüme varır (\hat\sigma=1{,}360;\ 0{,}296). Olabilirlik \sigma\to0 için sınırsız olduğundan sınırsız bir aramada çok daha yüksek log-olabilirlikler vardır (bir rejim \hat\sigma\approx10^{-16} ile birkaç gözlemi tam açıklar); bunlar iyi çözüm değil dejenere çözümdür ve şablonlar tarafından atılır. Bağımsız çok başlangıçlı arama (\sigma\ge0{,}1) bu çözümü doğrulamıştır (Bölüm 106.7).
Rapor cümlesi (örnek ayar): Bölüm 106.7'deki cümle aynen geçerlidir; yöntem satırına "statsmodels MarkovRegression, 10 başlangıç ve 20 ön EM adımıyla" eklenebilir.
107.8 Sık hatalar ve tuzaklar
- Standart hataların hepsi
NaN. Tek bir sonlu olmayan SH (sınıra yapışmış bir olasılık, \sigma\to0, çok az gözlemli bir rejim) bütün SH sütunlarınıNaNyapar (269); katsayılar yazılır, z, p ve GANaNolur. Uyarı yalnız konsol metnindedir; tablo kendi başına bunu söylemez.NaNgörülürse çözümü kabul etmeyin: \sigma_j ve \hat p_{ij} değerlerine bakın. - Dejenere çözüm.
degisken_varyansaçıkken \hat\sigma_j<10^{-3}\,\mathrm{sd}(y) ya da 5 gözlemden az rejim dejenere sayılır ve şablon bu çözümleri atar; geçerli çözüm kalmazsa çalıştırma durur. - Yerel en büyük.
search_repsEM ile iyileştirilmiş rastgele başlangıçlar arar; k=3'te R eşinden farklı bir çözüme varabilir (107.7). Sonuç tek bir çalıştırmaya dayanacaksa farklı tohum vebaslangicdeğerleriyle yineleyip log-olabilirlikleri karşılaştırın. - Zaman sırası. Zaman sütunu seçiliyse artan ve tekil olmalıdır; ters sıralı veride çalıştırma "artan sırada değil" iletisiyle durur (106.8). Zaman sütunu seçilmediyse veri sırası kullanıcının sorumluluğundadır.
- Ortadaki eksikler. Ortada eksik gözlem varsa (örnekte n=211 olurdu) çalıştırma satır sayısını ve ilk satırı söyleyen bir iletiyle durur; eksikleri doldurun ya da kesintisiz bir bölümü çözümleyin.
toleransve R eşi. 10^{-10} burada gradyan normudur; R eşindeki 10^{-14} olabilirliğin göreli değişimidir (107.4.2).- Tohum. Kod panelinin Tohum alanı etkisizdir; formdaki tohum kullanılır. Aynı tohum R ve Python'da aynı başlangıçları vermez.
- Ön EM kapatılabilir.
em_yineleme = 0ile örnek ayar aynı çözümü verir (\ell=-229{,}25614); zor modellerde EM adımları çözümün seçimini etkileyebilir, bu bölümde yalnız örnek ayar için denenmiştir. - Sayısal Hessian farkı. Aynı çözümde R ve Python SH'leri en çok \approx5\times10^{-5} göreli farklıdır (iki farklı sayısal türev); bundan büyük bir fark çözümlerin farklı olduğunu gösterir.
107.9 Uzman soruları
S1. İki şablon aynı model için neden farklı yerel en büyüklere varıyor?
İkisi de aynı olabilirliği en büyükler, ama başlangıç stratejileri farklıdır: R şablonu OLS artıklarına dayalı bir başlangıç ve 9 rastgele başlangıçtan her birini ayrı BFGS'ye verir; Python şablonu U(-0{,}5;0{,}5) gürültüsüyle baslangic rastgele nokta deneyip her birine 5 EM adımı uygular, en iyisini seçer ve ondan BFGS çalıştırır. Olabilirlik çok tepeli olduğundan (özellikle k=3 ve değişken varyansta) iki strateji farklı tepelere varabilir. Karşılaştırma ölçütü log-olabilirliktir: örnek ayarda iki şablon aynı değeri verir.
S2. Neden iki ayrı fit çağrısı var?
Birinci çağrı başlangıç aramasını ve EM adımlarını yürütür; ikinci çağrı bulunan çözümden BFGS'yi daha sıkı bir gradyan toleransıyla (10^{-10}) yeniden çalıştırır ve optim_complex_step=False ile sayısal (karmaşık adımsız) gradyan kullanır. Böylece çözüm daha kesin bir duruma gelir; yerel en büyük seçimini ise birinci çağrı belirler.
S3. tolerans R ile Python'da neden aynı değil?
R eşi, optim'in göreli olabilirlik değişimi eşiğini (reltol) kullanır; Python'da BFGS'nin gradyan normu eşiği (gtol) vardır. İkisi farklı birimdedir ve varsayılanları bu yüzden 10^{-14} ve 10^{-10}'dur.
S4. R ve Python SH'leri neden dördüncü ondalıkta ayrışıyor?
İkisi de gözlenen bilgi matrisinin sayısal tersidir ama farklı sayısal türev yöntemleriyle: R numDeriv::hessian (Richardson, d=10^{-3}), Python statsmodels yaklaşık Hessian'ı. Örnekte birinci rejimin kesişim SH'si bağımsız Python Richardson Hessian'ından 0{,}127923, Python şablonundan 0{,}127923, R numDeriv'den 0{,}127917'dir. Fark kestirim farkı değil, türevin sayısal hatasıdır (en büyük ayrılık \approx5\times10^{-5} göreli).
S5. Hessian neden bazen tersine çevrilemiyor?
Sınırda (\hat p_{ij}\to0 ya da 1), \sigma_j\to0 olan dejenere çözümde ya da rejimlerin gözlemle ayrışmadığı durumlarda olabilirliğin ikinci türevi tekil ya da sonsuzdur. Şablon bu durumda uyarı yazar ve SH vermez; ama çözümü reddetmez. Bu durumu bir yakınsama hatası değil, çözümün incelenmesi gereken bir işareti olarak okuyun.
S6. Sıralama sonrası geçiş SH'si nasıl eşleniyor?
statsmodels p[i->j] parametrelerini özgün rejim etiketleriyle ve yalnız j<k-1 için verir. Sıralama etiketleri değiştirirse, yeni (i,j) çiftinin SH'si özgün (o_i,o_j) çiftinin SH'sidir; özgün son hedefe düşen eleman için ilgili satırın bağımsız k-1 olasılığının toplamının varyansı, kovaryansların toplamı olarak alınır (219). Örnekte sıralama etiketleri değiştirmediğinden bu dal çalışmaz.
S7. R ikizine karşı hangi durumda hangisine güvenilir?
Örnekte olduğu gibi iki şablon aynı log-olabilirliği verirse çözüm sağlamdır. Farklıysa log-olabilirliği yüksek olan aday, ancak dejenere değilse (her \hat\sigma_j makul, SH'ler sonlu, her rejimin payı birkaç gözlemden büyük) tercih edilir; sonuç yine yeni başlangıç ve tohumlarla doğrulanmalıdır.
107.10 Kaynaklar
- Hamilton, J. D. (1989). A new approach to the economic analysis of nonstationary time series and the business cycle. Econometrica, 57(2), 357–384. https://doi.org/10.2307/1912559
- Hamilton, J. D. (1990). Analysis of time series subject to changes in regime. Journal of Econometrics, 45(1–2), 39–70. https://doi.org/10.1016/0304-4076(90)90093-9
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Kim, C.-J. (1994). Dynamic linear models with Markov-switching. Journal of Econometrics, 60(1–2), 1–22. https://doi.org/10.1016/0304-4076(94)90036-1
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. Proceedings of the 9th Python in Science Conference, 92–96. https://doi.org/10.25080/Majora-92bf1922-011
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2