23. Doğrusal karma modelde heteroskedastik varyans yapıları (varIdent, varPower, varExp, varConstPower)
Şablon kimliği: lme_varyans_yapilari · Kategori: karma model · Dil: R · Dosya: pro/sablonlar/karma_model/lme_varyans_yapilari.R (satır 1–280; üstbilgi 1–135) · Örnek veri: _ornek/bodyweight.csv · Paketler: nlme 3.1-168
23.1 Ne işe yarar
Doğrusal model ve doğrusal karma model, hata varyansının bütün gözlemlerde aynı olduğunu varsayar. Şablon bu varsayımı gevşetir: hata standart sapmasını bir varyans fonksiyonu ile bir gruba, bir ortak değişkene ya da kestirilen ortalamaya bağlar. Cevapladığı soru şudur: "Ölçümlerin saçılımı gruplar arasında ya da ortalama büyüdükçe değişiyor mu; değişiyorsa bunu hesaba katan modelde sabit etkilerin standart hataları ve testleri ne olur?"
- y_{ij}: i. grubun (birey, parsel) j. gözlemi; \mathbf x_{ij}^{\top}\boldsymbol\beta sabit etkiler.
- \mathbf z_{ij}^{\top}\mathbf b_i: grubun rastgele kesişimi ve seçildiyse rastgele eğimleri; \mathbf D bunların kovaryans matrisi. Gruplama faktörü seçilmezse bu terim yoktur (model
nlme::glsile kurulur). - g(\cdot): varyans fonksiyonu; v_{ij} onun ortak değişkeni (bir grup düzeyi, sayısal bir sütun ya da kestirilen değer); \boldsymbol\delta kestirilen varyans parametreleri.
- \sigma: g=1 olan gözlemlerin hata standart sapması; herhangi bir gözlemin hata standart sapması \sigma\,g(v_{ij},\boldsymbol\delta)'dır.
Dört varyans fonksiyonu seçilebilir:
- s(ij): gözlemin varyans değişkenindeki düzeyi (katmanı). Başvuru katmanında \delta=1'dir; öteki \delta_s değerleri o katmanın standart sapmasının başvuru katmanınkine oranıdır.
- varPower: varyans \lvert v\rvert^{2\delta} ile orantılıdır. \delta=0 sabit varyans, \delta=0{,}5 ortalamayla orantılı varyans, \delta=1 sabit değişim katsayısıdır (v kestirilen ortalamayken).
- varExp: v sıfır ya da negatif değer alabildiğinde kullanılır; standart sapma v'nin her biriminde e^{\delta} katına çıkar.
- varConstPower: küçük v değerlerinde standart sapmanın sıfıra inmesini c sabitiyle engeller.
Şablon aynı sabit ve rastgele etkilerle homoskedastik modeli de kurar; iki modeli olabilirlik oranı testi, AIC ve BIC ile karşılaştırır; varyans fonksiyonunun parametrelerini ve standartlaştırılmış artık grafiğini verir.
Ne zaman kullanılır? Artık grafiği huni biçimindeyse (saçılım ortalamayla büyüyorsa); işlem grupları ya da ölçüm dönemleri arasında saçılım belirgin farklıysa; farklı duyarlıkta aygıtlarla ya da laboratuvarlarla ölçülmüş veriler birlikte modelleniyorsa; yanıtı dönüştürmek (logaritma) yorumu bozacağı için özgün ölçekte kalmak isteniyorsa.
Ne zaman kullanılmaz?
- Varyans farkı tek bir etkenin grupları arasındaysa ve gözlemler bağımsızsa (rastgele etki, ortak değişken yok): temel programdaki Tek Yönlü ANOVA'nın Welch seçeneği yeterlidir.
- Sorun farklı varyans değil, yakın gözlemlerin korelasyonuysa:
lme_uzamsal_korelasyon. - Yanıt sayım ya da oran olduğu için varyans ortalamaya bağlıysa:
glmer_ileri,glmmtmb_aileler,r_glmmtmb_nb; varyans–ortalama ilişkisi orada dağılımın kendisinden gelir. - Farklı varyansın kaynağı birkaç aykırı gözlemse:
saglam_karma(sağlam karma model). - Model doğrusal değilse (büyüme eğrisi, doz–yanıt):
nlme_karma. - Amaç varyans yapısını modellemek değil, yalnız doğru grup karşılaştırması yapmaksa ve tek faktör, tek gruplama değişkeni varsa:
r_emmeans_kontrast.
Temel programla ilişki. Temel programdaki LMM (Doğrusal Karma Modeller) analizi aynı sabit ve rastgele etkili modeli sabit hata varyansıyla kurar; bu şablonun "Homoskedastik" satırı o modele karşılık gelir. Şablonun eklediği, nlme'nin varyans fonksiyonlarıdır (Pinheiro ve Bates, 2000, Bölüm 5.2).
23.2 Şablonun girdileri
Form, üstbilgideki on yedi [[param]] bloğundan kurulur (lme_varyans_yapilari.R:10–134).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Bağımlı değişken (148–153, 185). |
Sabit etkiler · x |
sütunlar · Değişkenler | boş (en az biri seçilmeli) | en az bir sütun | Sağ taraf; yanıt ve grup sütunu listeden düşülür (143, 183–185). |
Sabit etkiler arasında ikili etkileşimler · etkilesim |
onay · Model | kapalı | açık / kapalı | İki değişkende a * b, üç ve fazlasında (a + b + …)^2 (183–184). |
Faktör olarak ele alınacak sayısal sütunlar · faktor |
sütunlar · Değişkenler | boş | sabit etkilerdeki sütunlar | factor(); yalnız sabit etkilerde olanlara uygulanır (154). |
Gruplama faktörü (rastgele kesişim; boşsa gls) · grup |
kategorik sütun · Değişkenler | boş | herhangi bir sütun; boş olabilir | Doluysa lme; boşsa gls (141, 161–164, 199–202). |
Rastgele eğimler · egim |
sütunlar (sayısal) · Değişkenler | boş | sayısal sütunlar | random = ~ eğimler | grup; grup boşsa kullanılmaz (144, 160, 201). |
Varyans fonksiyonu · varyans |
seçim · Model | varIdent |
varIdent, varPower, varExp, varConstPower |
weights = … (186–190, 198). |
Varyans değişkeni (varIdent: grup; diğerleri: ortak değişken, boşsa kestirilen ortalama) · varyans_degiskeni |
sütun · Değişkenler | boş | varIdent'te zorunlu; ötekilerde sayısal sütun ya da boş | Varyans fonksiyonunun formülü (142, 165–180, 187–190). |
Kestirim yöntemi · yontem |
seçim · Model | REML |
REML, ML |
method = …; iki model de aynı yöntemle (196). |
Sabit etki güven aralıkları tablosu · guven_araliklari |
onay · Çıktı | kapalı | açık / kapalı | Aralık tablosu ve ML notu (216–228). Form açıklaması: "Kestirim ± t × SH; standart hata ve serbestlik derecesi sabit etkiler tablosundakilerdir." |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | Aralık tablosunun düzeyi (219, 221). |
Optimizasyon algoritması · optimizer |
seçim · Gelişmiş | nlminb |
nlminb, optim |
opt = … (191–194). |
En çok dış yineleme · maks_yineleme |
tamsayı · Gelişmiş | 200 | 5–10000 | maxIter (191, 193). |
En çok optimizasyon yinelemesi · maks_ic_yineleme |
tamsayı · Gelişmiş | 200 | 5–10000 | msMaxIter (191, 193). |
Yakınsama toleransı · tolerans |
ondalık · Gelişmiş | 10⁻⁶ | 10⁻¹²–0,01 | tolerance (191, 193). |
Optimizasyon toleransı · ic_tolerans |
ondalık · Gelişmiş | 10⁻⁷ | 10⁻¹²–0,01 | msTol (192, 194). |
Başlangıç EM yinelemesi · em_yineleme |
tamsayı · Gelişmiş | 25 | 0–1000 | niterEM; yalnız gruplama faktörlü modelde (194). |
Örnek ayar (ornek_param, satır 9): y = weight, x = [Time, Diet], etkilesim açık, grup = Rat, egim = [Time], varyans = varIdent, varyans_degiskeni = Diet. Kurulan model: sabit etkiler weight ~ Time * Diet, rastgele etkiler ~ Time | Rat, hata varyansı diyete göre farklı.
Şablonun kendi denetimleri. Biçimsel denetimden (Bölüm 1.2) sonra kod şunları durdurur:
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 140 |
| Yanıt ve grup dışında sabit etki kalmıyor | "en az bir sabit etki seçin" | 145 |
| varIdent seçili, varyans değişkeni boş | "varIdent için varyans değişkeni (grup) seçin" | 146 |
| Varyans değişkeni yanıtın kendisi | "Varyans değişkeni yanıt olamaz." | 147 |
| Eksiksiz satır sayısı < 10 | "Eksiksiz en az 10 satır gerekli." | 151 |
| Yanıt sayısal değil ya da sabit | "Yanıt sayısal olmalı." / "Yanıt sabit." | 152–153 |
| Sabit etki tek düzeyli ya da sabit | "sabit etkiden çıkarın" | 157–158 |
| Rastgele eğim sayısal değil ya da sabit | "Rastgele eğim '…' sayısal ve değişken olmalı." | 160 |
| Gruplama faktöründe 3'ten az düzey | "en az 3 düzey içermeli" | 163 |
| varIdent değişkeninde 2'den az düzey | "en az 2 düzey içermeli" | 171 |
| varIdent değişkeninin bir düzeyinde 3'ten az gözlem | "her düzeyde en az 3 gözlem gerekli" | 172 |
| Öteki fonksiyonlarda ortak değişken sayısal değil ya da sabit | "Varyans ortak değişkeni sayısal ve değişken olmalı." | 174 |
| varPower / varConstPower, ortak değişkenin tümü sıfır | "sıfırdan farklı değerler içermeli" | 175 |
| varPower, ortak değişkende en az bir sıfır | "varPower için varyans ortak değişkeni sıfır içeremez …" (tam metin 23.4.3) | 176–178 |
| Homoskedastik model kurulamadı | "Homoskedastik model kurulamadı: …" | 204 |
| Varyans fonksiyonlu model hata verdi | "Varyans fonksiyonlu model yakınsamadı: …" | 205 |
Eksik değer: kullanılan sütunların herhangi birinde eksik olan satır liste bazında atılır (complete.cases, satır 150). Sabit etkilerdeki metin ve mantıksal sütunlar etkene çevrilir (155); sayısal sütunlar, "Faktör olarak ele alınacak sayısal sütunlar" listesinde değilse ortak değişken (eğim) olarak girer.
varIdent katmanları ayrı bir sütunda tutulur
varIdent seçildiğinde varyans değişkeninin düzeyleri veri çerçevesine eklenen ayrı bir etken sütununa (.mq_vg) yazılır (satır 167–169); varyans değişkeninin kendisi değişmez. Aynı sütun sabit etkiler ya da rastgele eğimler listesindeyse modelin o kısmı seçildiği gibi kalır: sayısal bir sütun sabit etkide eğim, rastgele kısımda rastgele eğim olmayı sürdürür; yalnız varyans fonksiyonu onu katman olarak okur. Örnek veride varyans değişkeni Time seçildiğinde sabit etkiler yine altı katsayıdır (Time tek eğim), hata varyansı ise 11 tartım gününün her birinde ayrı kestirilir (10 ek parametre). Bu nedenle konsol özetinde varyans formülü varyans değişkeninin adıyla değil, ~1 | .mq_vg olarak görünür; katman adları varyans değişkeninin düzeyleridir.
23.3 Örnek veri
Dosya: _ornek/bodyweight.csv. Hand ve Crowder'ın (1996) sıçan ağırlık verisi; Pinheiro ve Bates (2000) kitabının BodyWeight verisi. Üç diyetten birine atanmış 16 sıçan 64 gün boyunca 11 kez tartılmıştır; toplam 176 gözlem, eksik değer yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
weight |
Yanıt | sayısal | Canlı ağırlık (g); 225–628, ortalama 384,48. |
Time |
Sabit etki, rastgele eğim | sayısal | Gün: 1, 8, 15, 22, 29, 36, 43, 44, 50, 57, 64. |
Diet |
Sabit etki, varyans değişkeni | kategorik (3 düzey) | D1: 8 sıçan, 88 gözlem, ortalama 263,72, SS 13,69. D2: 4 sıçan, 44 gözlem, 484,70, SS 65,36. D3: 4 sıçan, 44 gözlem, 525,80, SS 24,43. |
Rat |
Gruplama faktörü | kategorik (16 düzey) | R1–R16; her sıçanda 11 ölçüm. |
Tasarım dengelidir: her sıçan aynı 11 günde ölçülmüş ve her sıçan tek bir diyette kalmıştır. Diyetlerin ham standart sapmaları çok farklıdır, ama bu farkın büyük bölümü sıçanlar arası düzey farkıdır (D2'de R12'nin ortalaması 590,5, öteki üç sıçanınki 440,8–454,8); varyans fonksiyonu ise sıçan içi saçılımı modeller (23.6, Adım 5).
Düzey sırası ve başvuru düzeyi
Diet (D1, D2, D3) ve Rat (R1–R16) etiketlerinin hepsi rakam içerdiğinden düzeyler doğal sırayla aktarılır (Bölüm 1.3); sabit etkilerde referans D1'dir ve satır sırasına bağlı değildir. Rakam içermeyen etiketlerde sıra verideki ilk görülme sırasıdır: dönem etiketleri "erken", "orta", "gec" olan ve satırları zamana göre azalan sıralanmış bir veride düzeyler gec, orta, erken olur ve referans "gec"tir. varIdent'in başvuru katmanı şablonun tablolarında her zaman varyans değişkeninin ilk düzeyidir (burada D1; dönem örneğinde "gec") ve satır sırasına bağlı değildir. nlme'nin kendi özeti (konsol metni) ise oranı 1 olan katmanı modelin sıraladığı veride ilk rastlanan düzeyden alır: gruplama faktörü varken veri gruba göre sıralanır (ilk grup R1, diyeti D1), gruplama faktörü yokken verinin kendi satır sırası geçerlidir. İkisi farklıysa şablon tabloları ilk düzeye göre yeniden ölçekler ve bunu bir notla bildirir (23.4.2, 23.8).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar (varIdent, REML); (2) aynı ayar, sıkı toleranslar (tolerans = ic_tolerans = 10⁻¹⁰); (3) güven aralıkları tablosu açık; (4) ML; (5) varPower ve varExp, varyans değişkeni Time; (6) varPower ve varExp, varyans değişkeni boş (kestirilen ortalama); (7) varConstPower; (8) gruplama faktörsüz kapalı biçim denetimi: x = [Diet], etkileşim kapalı, grup ve eğim boş, ML; (9) 8. çalıştırmanın, satırları ters çevrilmiş aynı veriyle yinelenmesi.
23.4 Yöntem: formüller ve hesap adımları
Şablonun hesap sırası: (1) eksik satırları at, girdileri denetle, etkenleri kur; (2) sabit etki formülünü ve varyans fonksiyonu nesnesini oluştur; (3) homoskedastik modeli ve varyans fonksiyonlu modeli aynı yöntemle kestir; (4) sabit etki tablosunu, istenirse güven aralıklarını, varyans fonksiyonu parametrelerini ve varyans bileşenlerini yaz; (5) iki modeli karşılaştır; (6) standartlaştırılmış artıkları kestirilen değere karşı çiz.
23.4.1 Marjinal kovaryans ve profil olabilirlik
i. grubun gözlem vektörü için:
- \mathbf Z_i: grubun rastgele etki tasarım matrisi (kesişim sütunu ve eğim sütunları); \mathbf D: rastgele etkilerin kovaryansı.
- \mathbf G_i: varyans fonksiyonu değerlerinin köşegen matrisi. Homoskedastik modelde \mathbf G_i=\mathbf I.
- Farklı grupların gözlemleri bağımsızdır; toplam kovaryans matrisi blok köşegendir.
\mathbf D^{*}=\mathbf D/\sigma^2 ve \mathbf V_i^{*}=\mathbf V_i/\sigma^2 yazıldığında \boldsymbol\beta ve \sigma^2 kapalı biçimde bulunur; olabilirlik yalnız \mathbf D^{*} ve \boldsymbol\delta'ya bağlı kalır. REML için:
- N: toplam gözlem sayısı; p: sabit etki katsayısı sayısı.
- ML seçilirse \hat\sigma^2'nin paydası N olur, köşeli parantezin çarpanı N/2 olur ve son terim düşer.
- Gruplama faktörü yoksa \mathbf V^{*}=\mathbf G^2 köşegendir; model ağırlıklı en küçük karelere iner ve ağırlıklar 1/g^2'dir.
Neden ağırlıkları önceden verip ağırlıklı regresyon yapmıyoruz?
Ağırlıklı en küçük kareler ağırlıkların bilindiğini varsayar. Burada \boldsymbol\delta bilinmez; varyans fonksiyonu modelin parçası olarak sabit etkiler ve rastgele etki varyanslarıyla birlikte kestirilir, belirsizliği olabilirliğe girer ve varyans yapısının gerekli olup olmadığı sınanabilir (Carroll ve Ruppert, 1988; Davidian ve Giltinan, 1995).
Standart hatalar \operatorname{SH}(\hat\beta_k)=\hat\sigma\sqrt{\big[(\sum_i\mathbf X_i^{\top}\hat{\mathbf V}_i^{*-1}\mathbf X_i)^{-1}\big]_{kk}}'dır; nlme ML'de bunu \sqrt{N/(N-p)} ile çarpar. Serbestlik dereceleri nlme'nin düzey kuralından gelir: grup içinde değişen terimler için N-G-p_{\text{iç}}, grup düzeyinde sabit kalan terimler için G-p_{\text{dış}} (G grup sayısı). Örnek veride kesişim, Time ve Time:Diet terimlerinin sd'si 176-16-3=157, Diet terimlerininki 16-3=13'tür. Gruplama faktörü yokken bütün terimlerin sd'si N-p'dir.
23.4.2 varIdent: katmana göre farklı varyans
Her katmanın kendi hata standart sapması \sigma_s=\sigma\,\delta_s vardır. S katmanlı bir değişken modele S-1 parametre ekler.
Rastgele etkisi olmayan ve sabit etkileri yalnız katman ortalamaları olan modelde ML kestirimi kapalı biçimdedir:
- n_s, \bar y_s: s. katmanın gözlem sayısı ve ortalaması.
- Olabilirlik katmanlara ayrışır; her katmanın varyansı kendi içindeki kareler ortalamasıdır (ML'de payda n_s).
- Aynı model REML ile kurulursa payda n_s-1 olur: sıradan örneklem varyansları.
Bu kapalı biçim şablonun denetimi için kullanılır (23.6, Adım 1). Rastgele etkili modelde kapalı biçim yoktur; \delta_s değerleri 23.4.1'deki profil olabilirliğin sayısal en büyüklenmesiyle bulunur.
Koddaki tercih
Varyans fonksiyonu varIdent(form = ~ 1 | .mq_vg) olarak kurulur (satır 187; .mq_vg varyans değişkeninin düzeylerini taşıyan ayrı sütundur, 23.2) ve başlangıç değeri verilmez; nlme bütün oranları 1'den başlatır. Parametreler coef(vs, unconstrained = FALSE, allCoef = TRUE) ile alınır (231): allCoef = TRUE paketin başvuru aldığı katmanı da (oran 1) verir. nlme bu katmanı veride ilk rastladığı düzeyden seçtiği için şablon oranları etkenin düzey sırasına dizer ve ilk düzeye göre yeniden ölçekler (234–241):
Burada \delta_{\text{ilk}}, etkenin ilk düzeyinin paketteki oranıdır; paket zaten ilk düzeyi başvuru almışsa 1'dir ve hiçbir sayı değişmez. Çarpım \sigma\,\delta_s (katmanın hata standart sapması), log-olabilirlik ve sabit etkiler ölçeklemeden etkilenmez: model aynıdır. Aynı çarpan varyans bileşenleri tablosunun artık satırına (258) ve "Artık standart sapması (σ)" satırına (248, 271) uygulanır. Paketin başvurusu ilk düzey değilse şu not yazılır (242–245): "Not: konsol özetindeki varyans oranları ve artık SS '…' düzeyine göredir; tablolar etkenin ilk düzeyine ('…') göre yeniden ölçeklendi (model aynıdır)." Tablodaki açıklama sütunu oranın tanımını ve başvuru düzeyinin adını yazar: "SS(düzey) / SS(başvuru düzeyi: D1)" (251).
23.4.3 varPower, varExp, varConstPower: ortak değişkene ya da ortalamaya bağlı varyans
Varyans değişkeni alanı doluysa v o sütundur (form = ~ değişken, satır 188–190). Boş bırakılırsa nlme'nin varsayılanı kullanılır: v kestirilen değerdir (~ fitted(.)).
- \hat{\mathbf b}_i: grubun rastgele etkilerinin en iyi doğrusal yansız öngörüsü (BLUP). Gruplama faktörlü modelde v grubun kendi kestirilen değeridir (en iç düzey), yalnız sabit etkilerden gelen ortalama değil.
- Gruplama faktörü yoksa v_{j}=\mathbf x_{j}^{\top}\hat{\boldsymbol\beta}'dır.
Neden kestirilen değere bağlı model dönüşümlü kestirilir?
v kestirilen değer olduğunda varyans, kestirilmekte olan parametrelere bağlıdır; olabilirlik tek adımda yazılamaz. nlme şöyle ilerler: (1) v sabit tutulup \mathbf D^{*} ve \boldsymbol\delta için 23.4.1'deki olabilirlik en büyüklenir; (2) yeni \hat{\boldsymbol\beta} ve \hat{\mathbf b}_i ile v yenilenir; (3) parametrelerin göreli değişimi "Yakınsama toleransı"nın altına inene kadar yinelenir ("En çok dış yineleme" bu döngünün sınırıdır). Bulunan nokta bu döngünün sabit noktasıdır; tek bir olabilirlik fonksiyonunun en büyüğü değildir (Davidian ve Giltinan, 1995, sözde olabilirlik).
Sıfır ve negatif değerler
varPower ve varConstPower \lvert v\rvert^{\delta} kullanır: v=0 olan tek bir gözlem bile \delta>0 iken sıfır varyans, \delta<0 iken sonsuz varyans demektir. Bu nedenle varPower'da ortak değişken tek bir sıfır bile içeriyorsa şablon hesaba başlamadan durur (satır 176–178): "varPower için varyans ortak değişkeni sıfır içeremez (|v|^δ sıfırda tanımsız ya da sıfır varyans verir). Sıfırdan farklı bir ölçek kullanın ya da varExp / varConstPower seçin." varConstPower'da sıfır geçerli bir girdidir (c+\lvert0\rvert^{\delta}=c tanımlıdır) ve durdurulmaz; yalnız ortak değişkenin tümünün sıfır olduğu durum iki fonksiyonda da durdurulur (175). Sıfır içeren ortak değişkende (ör. başlangıç günü 0 olan zaman) varExp ya da varConstPower kullanılır ya da ortak değişken kaydırılır. Kestirilen değer işaret değiştirebiliyorsa (yanıt sıfır çevresinde) \lvert\hat y\rvert'ye bağlı varyansın anlamı kalmaz.
23.4.4 Model karşılaştırması
- \ell_0, \ell_1: homoskedastik ve varyans fonksiyonlu modelin log-olabilirlikleri (aynı yöntemle).
- k: parametre sayısı (tablodaki
sdsütunu): sabit etkiler + rastgele etki kovaryans parametreleri + \sigma + varyans fonksiyonu parametreleri. Örnek ayarda 6+3+1+2=12 ve 10. - N^{*}: nlme REML'de N-p, ML'de N alır.
- LR, sd'si eklenen varyans parametresi sayısı olan ki-kare dağılımıyla sınanır (
anova, satır 261): varIdent'te S-1, varPower ve varExp'te 1, varConstPower'da 2.
Neden REML olabilirlikleri karşılaştırılabilir ve ki-kare burada geçerlidir?
İki modelin sabit etkileri aynıdır; REML olabilirlikleri aynı hata kontrastlarına dayanır. Homoskedastik model, varIdent'te \delta_s=1, varPower ve varExp'te \delta=0 ile elde edilir; bu değerler parametre uzayının iç noktalarıdır, sınır sorunu yoktur ve ki-kare yaklaşımı olağan koşullarda geçerlidir. varConstPower'da homoskedastik model tek bir noktaya karşılık gelmez (\delta=0 iken c belirsizdir); bu fonksiyonda p değeri yaklaşık sayılır ve AIC ile birlikte değerlendirilir.
23.4.5 Standartlaştırılmış artıklar
- \hat y_{ij}: kestirilen değer (gruplama faktörlü modelde BLUP dahil).
- Payda gözlemin kendi kestirilen hata standart sapmasıdır; nlme bu artığa "pearson" der (satır 274).
Varyans fonksiyonu saçılım farkını yakaladıysa standartlaştırılmış artıkların yayılımı kestirilen değer boyunca ve gruplar arasında aynıdır; kabaca %95'i ±2 çizgileri arasında kalır (şeklin noktalı çizgileri, satır 278).
23.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–135 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on yedi parametre. | Form ve varsayılanlar buradan kurulur (Bölüm 1.2). |
| 136–139 | .m() ileti dili; nlme yüklenir; bos() yardımcı işlevi. |
Boş bırakılan seçmeli alanları tek biçime indirir. |
| 140–147 | Roller: grup, vd (varyans değişkeni), xs (sabit etkiler), egim. |
Grup boşsa eğim listesi boşaltılır (144). |
| 148–164 | Eksiksiz satırlar; yanıt, sabit etki, eğim ve grup denetimleri; etkene çevirme. | faktor yalnız xs içindeki sütunlara uygulanır (154). |
| 165–180 | Varyans değişkeni denetimleri: varIdent'te katman sütunu (.mq_vg) ve düzey sayıları; ötekilerde sayısallık ve sıfır denetimi. |
Katmanlar ayrı sütuna yazılır, varyans değişkeni değişmez (169; 23.2). varPower tek bir sıfırda durur (176–178). |
| 182–190 | Sabit etki formülü ve varyans fonksiyonu nesnesi (vf). |
Varyans değişkeni boşsa varPower() gibi biçimsiz çağrı: ortak değişken kestirilen değer (188–190). |
| 191–203 | Denetim (control) listesi; kur(): gruba göre gls ya da lme. |
Aynı işlev weights olmadan homoskedastik modeli kurar (198). |
| 204–207 | m0 (homoskedastik), m1 (varyans fonksiyonlu); summary(m1) konsola. |
nlme hataları çevrilmiş önekle iletiye dönüşür. |
| 209–228 | "Sabit etkiler" tablosu; istenirse güven aralıkları tablosu ve ML notu. | gls'te dört, lme'de sd ile beş sayısal sütun. Aralık kestirim ± t × SH'dir; SH ve sd sabit etkiler tablosundan alınır, gls'te sd =N-p (218–219). Yöntem ML ise SH çarpanını bildiren not yazılır (222–226). |
| 230–260 | "Varyans fonksiyonu parametreleri" ve (grup varsa) "Varyans bileşenleri" tablosu. | varIdent oranları ve \hat\sigma etkenin ilk düzeyine göre yeniden ölçeklenir (234–248). Bileşen tablosundaki artık SS, g=1 olan gözlemler içindir (258–259). |
| 261–271 | "Model karşılaştırması" tablosu ve \hat\sigma satırı. | anova(m0, m1) hata verirse LR ve p sütunları eklenmez. |
| 273–279 | Standartlaştırılmış artık grafiği; mq_sekil. |
Yatay çizgiler −2, 0, 2. |
"Varyans bileşenleri" tablosundaki değerler nlme'nin VarCorr çıktısından sayıya çevrilir (satır 256–257); bu çıktı biçimlenmiş metin olduğundan değerler yedi–sekiz anlamlı basamakla saklanır. Öteki tablolar tam hassasiyetlidir; varIdent'te yeniden ölçekleme yapıldıysa artık satırı da tam hassasiyetli \hat\sigma'dan yazılır (258).
Güven aralıkları tablosu sabit etkiler tablosuyla aynı standart hatayı ve serbestlik derecesini kullandığından iki tablo her yöntemde tutarlıdır: \hat\beta_k\pm t_{(1+\text{güven})/2;\,\text{sd}_k}\operatorname{SH}(\hat\beta_k). ML'de nlme'nin özeti standart hatayı \sqrt{N/(N-p)} ile çarpar (23.4.1); sabit etkiler tablosundaki SH bu çarpılmış değerdir ve aralık onunla kurulur. Yöntem ML iken (gruplama faktörlü ve faktörsüz modelde aynı biçimde) aralık tablosunun ardından çarpanı bildiren bir not yazılır (222–226); örnek ayarın ML çalıştırmasında: "Not: ML'de standart hata √(N/(N − p)) = 1,01749 ile çarpılmıştır (nlme özet tanımı); aralıklar bu SH ile kurulur. Çarpansız SH = SH / 1,01749." REML'de çarpan yoktur ve not yazılmaz.
23.6 Elle hesap: örnek veride bağımsız yeniden hesap
Değerler dogrulama/lme_varyans_yapilari/elle_hesap.py ile, nlme kullanılmadan bulunmuştur: marjinal kovaryans matrisi 23.4.1'deki formülle kurulmuş, profil olabilirlik \mathbf D^{*}'ın log-Cholesky parametreleri ve varyans parametreleri üzerinde yarı-Newton aramasıyla ve sonlu farklı Newton adımlarıyla en büyüklenmiştir. R tarafında (r_dogrulama.R) aynı olabilirlik sıçan bazında toplanarak, nlme yüklenmeden yeniden kurulmuştur.
Adım 1 — Kapalı biçim (gruplama faktörsüz, weight ~ Diet, ML). Diyet içi ML varyansları ve oranları:
| Diyet | n_s | Ortalama | \hat\sigma_s^2 (payda n_s) | Oran \hat\delta_s |
|---|---|---|---|---|
| D1 | 88 | 263,7159 | 185,2261 | 1 |
| D2 | 44 | 484,7045 | 4174,8445 | 4,747545 |
| D3 | 44 | 525,7955 | 583,3900 | 1,774714 |
Homoskedastik modelde \hat\sigma^2=1282{,}1717 ve \ell_0=-879{,}488510; \mathrm{LR}=152{,}961570. Kesişimin (D1 ortalaması) SH'si \sqrt{185{,}2261/88}\cdot\sqrt{176/173}=1{,}463333'tür. Şablonun bu ayardaki çıktısı aynı değerleri verir (23.6.1).
Adım 2 — Örnek ayar: homoskedastik karma model (REML).
Adım 3 — Örnek ayar: varIdent (REML). En büyüklenen profil olabilirlik:
Diyetlere göre hata standart sapmaları \hat\sigma\hat\delta_s: D1 3,6450; D2 4,2764; D3 5,8592. Rastgele etkiler: kesişim SS 36,861858; Time eğimi SS 0,244956; korelasyon −0,139.
Adım 4 — Karşılaştırma ölçütleri. k_1=12, k_0=10, N^{*}=176-6=170:
Homoskedastik model için AIC 1171,719749 ve BIC 1203,077733'tür.
Adım 5 — Sezgisel denetim: sıçan içi saçılım. Her sıçana ayrı bir doğru (en küçük kareler) uydurulup artık kareler toplamları diyet içinde birleştirildiğinde:
| Diyet | Artık KT | sd | Artık SS | Oran |
|---|---|---|---|---|
| D1 | 960,8385 | 72 | 3,6531 | 1 |
| D2 | 651,7507 | 36 | 4,2549 | 1,1647 |
| D3 | 1230,7812 | 36 | 5,8471 | 1,6006 |
Bu oranlar (1,165 ve 1,601) karma modelin REML kestirimlerine (1,173 ve 1,607) çok yakındır: varIdent parametreleri sıçanların kendi büyüme doğruları çevresindeki saçılımı ölçer. Adım 1'deki oranlar (4,75 ve 1,77) ise sıçanlar arası düzey farklarını da hata sayan modele aittir; D2'deki büyük oran tek bir ağır sıçandan (R12) gelir.
Adım 6 — Sabit etkiler. Tasarım dengeli ve her sıçan tek diyette olduğundan genelleştirilmiş en küçük kareler kestirimleri sıradan en küçük karelerinkine eşittir ve varyans yapısından etkilenmez: kesişim 251,651652; Time 0,359639; DietD2 200,665486; DietD3 252,071678; Time:DietD2 0,605839; Time:DietD3 0,298338. Değişen standart hatalardır:
| Terim | SH (homoskedastik) | SH (varIdent) | sd | t | p |
|---|---|---|---|---|---|
Time |
0,091140 | 0,088878 | 157 | 4,0464 | 0,000081 |
Time:DietD2 |
0,157859 | 0,154914 | 157 | 3,9108 | 0,000137 |
Time:DietD3 |
0,157859 | 0,157993 | 157 | 1,8883 | 0,060832 |
DietD2 |
22,679516 | 22,623000 | 13 | 8,8700 | 7,10·10⁻⁷ |
Time için %95 güven aralığı 0{,}359639\pm1{,}975189\cdot0{,}088878=[0{,}184088;\ 0{,}535191]; DietD2 için 200{,}665486\pm2{,}160369\cdot22{,}623000=[151{,}7915;\ 249{,}5395].
Adım 7 — Ortak değişkene bağlı varyans (REML). Varyans değişkeni Time iken varPower \hat\delta=-0{,}065805 (\mathrm{LR}=1{,}1862; p=0{,}276), varExp \hat\delta=0{,}001208 (\mathrm{LR}=0{,}1106; p=0{,}739): hata varyansı zamanla değişmemektedir.
Adım 8 — Kestirilen değere bağlı varyans (REML). 23.4.3'teki dönüşümlü yineleme, kestirilen değerlerin en büyük değişimi 10^{-10}'un altına inene kadar sürdürüldüğünde varPower için \hat\delta=0{,}542844, \hat\sigma=0{,}175171, \ell=-570{,}960711 (\mathrm{LR}=9{,}7983; p=0{,}00175) bulunur. Hata standart sapması 0{,}175171\cdot\hat y^{\,0{,}542844}'tür: kestirilen ağırlık 250 g iken 3,509, 500 g iken 5,112. varExp için \hat\delta=0{,}00145296, \ell=-570{,}774569 (\mathrm{LR}=10{,}1706).
23.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından alınmıştır (çalıştırmalar 2–6, 8 ve 9; "ML: %95 GA" satırları 3 ve 4'ün birlikte seçildiği çalıştırmadandır). Python ve R sütunlarında nlme kullanılmamıştır.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| varIdent: oran D2 | 1,17321106 | 1,1732109 | 1,1732109 | 1,4e−7 | ✓ |
| varIdent: oran D3 | 1,60746439 | 1,6074639 | 1,6074639 | 3,0e−7 | ✓ |
| varIdent: \hat\beta (kesişim) | 251,65165156 | 251,65165156 | 251,65165156 | 3,5e−15 | ✓ |
| varIdent: \hat\beta (Time) | 0,35963911 | 0,35963911 | 0,35963911 | 1,8e−15 | ✓ |
| varIdent: \hat\beta (DietD2) | 200,66548646 | 200,66548646 | 200,66548646 | 8,5e−16 | ✓ |
| varIdent: \hat\beta (DietD3) | 252,07167777 | 252,07167777 | 252,07167777 | 1,7e−15 | ✓ |
| varIdent: \hat\beta (Time:DietD2) | 0,60583916 | 0,60583916 | 0,60583916 | 2,2e−15 | ✓ |
| varIdent: \hat\beta (Time:DietD3) | 0,29833752 | 0,29833752 | 0,29833752 | 1,6e−15 | ✓ |
| varIdent: SH (kesişim) | 13,05562763 | 13,05563085 | 13,05563083 | 2,5e−7 | ✓ |
| varIdent: SH (Time) | 0,08887833 | 0,08887834 | 0,08887834 | 3,1e−9 | ✓ |
| varIdent: SH (DietD2) | 22,62299473 | 22,62300029 | 22,62300027 | 2,5e−7 | ✓ |
| varIdent: SH (DietD3) | 22,65499347 | 22,65499901 | 22,65499898 | 2,4e−7 | ✓ |
| varIdent: SH (Time:DietD2) | 0,15491426 | 0,15491427 | 0,15491427 | 4,6e−9 | ✓ |
| varIdent: SH (Time:DietD3) | 0,15799344 | 0,15799344 | 0,15799344 | 2,0e−9 | ✓ |
| varIdent: t (Time) | 4,04642056 | 4,04642042 | 4,04642042 | 3,5e−8 | ✓ |
| varIdent: p (Time:DietD3; sd 157) | 0,06083164 | 0,06083164 | 0,06083165 | 3,3e−9 | ✓ |
| varIdent: p (DietD2; sd 13) | 7,097571·10−7 | 7,097590·10−7 | 7,097590·10−7 | 2,0e−12 | ✓ |
| varIdent: SS (kesişim) | 36,8618489 | 36,86185802 | 36,86185799 | 2,5e−7 | ✓ |
| varIdent: SS (Time eğimi) | 0,2449555 | 0,24495551 | 0,24495551 | 9,1e−9 | ✓ |
| varIdent: artık SS \hat\sigma (D1) | 3,6450019 | 3,64500221 | 3,64500221 | 8,5e−8 | ✓ |
| varIdent: varyans (kesişim) | 1358,7959051 | 1358,79657694 | 1358,79657424 | 4,9e−7 | ✓ |
| varIdent: logLik | −569,98027352 | −569,98027352 | −569,98027352 | 8,2e−15 | ✓ |
| varIdent: AIC | 1163,96054704 | 1163,96054704 | 1163,96054704 | 8,0e−15 | ✓ |
| varIdent: BIC | 1201,59012829 | 1201,59012829 | 1201,59012829 | 5,3e−15 | ✓ |
| Homoskedastik: logLik | −575,85987441 | −575,85987441 | −575,85987441 | 2,7e−14 | ✓ |
| Homoskedastik: AIC | 1171,71974882 | 1171,71974882 | 1171,71974882 | 2,3e−14 | ✓ |
| varIdent: LR (sd 2) | 11,75920178 | 11,75920178 | 11,75920178 | 3,6e−12 | ✓ |
| varIdent: p (LR) | 0,0027959 | 0,0027959 | 0,0027959 | 5,9e−14 | ✓ |
| varIdent: %95 GA alt (Time) | 0,18408759 | 0,18408759 | 0,18408759 | 6,2e−9 | ✓ |
| varIdent: %95 GA üst (Time) | 0,53519063 | 0,53519064 | 0,53519064 | 6,2e−9 | ✓ |
| varIdent: %95 GA alt (DietD2) | 151,79147774 | 151,79146571 | 151,79146576 | 7,9e−8 | ✓ |
| varIdent: %95 GA üst (DietD2) | 249,53949518 | 249,53950721 | 249,53950716 | 4,8e−8 | ✓ |
| ML: oran D2 | 1,17702694 | 1,17702673 | 1,17702673 | 1,8e−7 | ✓ |
| ML: oran D3 | 1,60939909 | 1,60939869 | 1,60939869 | 2,5e−7 | ✓ |
| ML: SH (kesişim) | 11,96702267 | 11,96702043 | 11,96702044 | 1,9e−7 | ✓ |
| ML: SS (kesişim) | 33,1938093 | 33,19380303 | 33,19380306 | 1,9e−7 | ✓ |
| ML: artık SS \hat\sigma (D1) | 3,6417759 | 3,64177626 | 3,64177626 | 9,9e−8 | ✓ |
| ML: logLik | −577,01892171 | −577,01892171 | −577,01892171 | 6,3e−15 | ✓ |
| ML: LR | 11,82031651 | 11,82031651 | 11,82031651 | 1,9e−12 | ✓ |
| ML: BIC | 1216,08365136 | 1216,08365136 | 1216,08365136 | 3,0e−15 | ✓ |
| ML: %95 GA alt (kesişim) | 228,01451806 | 228,0145225 | 228,01452248 | 1,9e−8 | ✓ |
| ML: %95 GA üst (kesişim) | 275,28878506 | 275,28878063 | 275,28878064 | 1,6e−8 | ✓ |
| ML: %95 GA alt (DietD2) | 155,8615665 | 155,86157493 | 155,8615749 | 5,4e−8 | ✓ |
| ML: %95 GA üst (DietD2) | 245,46940642 | 245,46939799 | 245,46939802 | 3,4e−8 | ✓ |
| varPower(Time): \hat\delta | −0,06580534 | −0,0658054 | −0,0658054 | 5,9e−8 | ✓ |
| varPower(Time): \hat\sigma | 5,46349 | 5,46349085 | 5,46349087 | 1,6e−7 | ✓ |
| varPower(Time): \hat\beta (Time) | 0,35353582 | 0,35353582 | 0,35353582 | 5,4e−9 | ✓ |
| varPower(Time): SH (Time) | 0,08989718 | 0,0898972 | 0,0898972 | 2,0e−8 | ✓ |
| varPower(Time): logLik | −575,26678376 | −575,26678376 | −575,26678376 | 3,4e−15 | ✓ |
| varPower(Time): LR (sd 1) | 1,1861813 | 1,1861813 | 1,1861813 | 2,4e−11 | ✓ |
| varPower(Time): p (LR) | 0,27610119 | 0,27610119 | 0,27610119 | 5,8e−12 | ✓ |
| varExp(Time): \hat\delta | 0,00120808 | 0,00120804 | 0,00120804 | 3,8e−8 | ✓ |
| varExp(Time): \hat\sigma | 4,262041 | 4,26204674 | 4,26204674 | 1,3e−6 | ✗ |
| varExp(Time): \hat\beta (Time) | 0,36136076 | 0,3613607 | 0,3613607 | 5,4e−8 | ✓ |
| varExp(Time): SH (Time) | 0,09153856 | 0,09153848 | 0,09153848 | 7,7e−8 | ✓ |
| varExp(Time): logLik | −575,80456591 | −575,80456591 | −575,80456591 | 3,2e−13 | ✓ |
| varExp(Time): LR (sd 1) | 0,110617 | 0,110617 | 0,110617 | 4,0e−10 | ✓ |
| varExp(Time): p (LR) | 0,73944278 | 0,73944278 | 0,73944278 | 4,5e−10 | ✓ |
| varPower(kestirilen değer): \hat\delta | 0,54284745 | 0,54284436 | 0,54284437 | 3,1e−6 | ✗ |
| varPower(kestirilen değer): \hat\sigma | 0,1751676 | 0,17517081 | 0,1751708 | 3,2e−6 | ✗ |
| varPower(kestirilen değer): \hat\beta (Time) | 0,36108796 | 0,36108795 | 0,36108795 | 6,7e−9 | ✓ |
| varPower(kestirilen değer): SH (Time) | 0,08837747 | 0,08837728 | 0,08837728 | 1,9e−7 | ✓ |
| varPower(kestirilen değer): SS (kesişim) | 36,8981758 | 36,89822782 | 36,89822783 | 1,4e−6 | ✗ |
| varPower(kestirilen değer): logLik | −570,96071119 | −570,96071086 | −570,96071086 | 5,6e−10 | ✓ |
| varPower(kestirilen değer): LR (sd 1) | 9,79832645 | 9,79832709 | 9,79832709 | 6,5e−8 | ✓ |
| varExp(kestirilen değer): \hat\delta | 0,00145266 | 0,00145296 | 0,00145296 | 3,0e−7 | ✓ |
| varExp(kestirilen değer): \hat\sigma | 2,4573541 | 2,45703461 | 2,45703461 | 1,3e−4 | ✗ |
| varExp(kestirilen değer): \hat\beta (Time) | 0,36063396 | 0,36063415 | 0,36063415 | 1,9e−7 | ✓ |
| varExp(kestirilen değer): SH (Time) | 0,08843675 | 0,08844832 | 0,08844832 | 1,2e−5 | ✗ |
| varExp(kestirilen değer): SS (kesişim) | 36,9027827 | 36,90456317 | 36,90456325 | 4,8e−5 | ✗ |
| varExp(kestirilen değer): logLik | −570,77456728 | −570,77456893 | −570,77456893 | 2,9e−9 | ✓ |
| varExp(kestirilen değer): LR (sd 1) | 10,17061425 | 10,17061097 | 10,17061097 | 3,2e−7 | ✓ |
| Kapalı biçim (ML): oran D2 | 4,74754453 | 4,74754456 | 4,74754456 | 5,8e−9 | ✓ |
| Kapalı biçim (ML): oran D3 | 1,77471401 | 1,77471401 | 1,77471401 | 3,8e−9 | ✓ |
| Kapalı biçim: kesişim (D1 ortalaması) | 263,71590909 | 263,71590909 | 263,71590909 | 2,2e−16 | ✓ |
| Kapalı biçim: DietD2 | 220,98863636 | 220,98863636 | 220,98863636 | 1,7e−15 | ✓ |
| Kapalı biçim: SH (kesişim) | 1,46333261 | 1,46333261 | 1,46333261 | 2,4e−9 | ✓ |
| Kapalı biçim: SH (DietD2) | 9,93325419 | 9,93325422 | 9,93325422 | 3,3e−9 | ✓ |
| Kapalı biçim: SH (DietD3) | 3,95349566 | 3,95349566 | 3,95349566 | 8,9e−10 | ✓ |
| Kapalı biçim: logLik | −803,00772507 | −803,00772507 | −803,00772507 | 1,4e−16 | ✓ |
| Kapalı biçim: homoskedastik logLik | −879,48850983 | −879,48850983 | −879,48850983 | 5,2e−16 | ✓ |
| Kapalı biçim: AIC | 1618,01545013 | 1618,01545013 | 1618,01545013 | 1,3e−15 | ✓ |
| Kapalı biçim: BIC | 1637,0383541 | 1637,0383541 | 1637,0383541 | 5,6e−16 | ✓ |
| Kapalı biçim: LR (sd 2) | 152,96156952 | 152,96156952 | 152,96156952 | 3,2e−15 | ✓ |
| Kapalı biçim, satırlar ters: oran D2 | 4,74754437 | 4,74754456 | 4,74754456 | 4,0e−8 | ✓ |
| Kapalı biçim, satırlar ters: oran D3 | 1,77471393 | 1,77471401 | 1,77471401 | 4,9e−8 | ✓ |
Ölçütü karşılayan: 79/86. Python ve R: marjinal kovaryans açık formülle kurulmuş (Python tüm veri matrisiyle, R sıçan bazında toplamla), profil log-olabilirlik yarı-Newton aramasıyla ve sonlu farklı Newton adımlarıyla en büyüklenmiştir; nlme yüklenmemiştir. Kestirilen değere bağlı varyans fonksiyonunda ortak değişken her dış adımda en iç düzey kestirilen değerle yenilenmiş, değişim 10^{-10}'un altına inene kadar sürdürülmüştür. ✗ satırlarının gerekçesi metindedir.
Ölçütü karşılamayan yedi satırın altısı kestirilen değere bağlı varyans fonksiyonlarındadır. nlme dönüşümlü yinelemeyi varPower'da 3, varExp'te 8 dış adımda bitirir; durduğu noktanın kestirilen değerleriyle model yeniden kurulduğunda parametreler bağımsız hesabın bulduğu sabit noktaya doğru kayar (\hat\delta: 0,542847 → 0,542843). Farklar varPower'da en çok 3{,}2\times10^{-6}, varExp'te \hat\sigma için 1{,}3\times10^{-4}'tür; varExp'te \hat\sigma ile \hat\delta birbirini dengeleyen yassı bir sırt üzerindedir (\hat\sigma\,e^{\hat\delta\hat y} çarpımı iki noktada dört basamak aynıdır). Yedinci satır (varExp, ortak değişken Time) olabilirlik oranı 0,11 olan, \delta'nın neredeyse belirlenemediği bir modelin \hat\sigma değeridir; log-olabilirlikler on basamak aynıdır. Ölçütü karşılayan 79 satır arasında iki denetim ayrıca anılmalıdır. "ML: %95 GA" satırlarında bağımsız aralık, \sqrt{N/(N-p)} düzeltmeli standart hata ve sabit etkiler tablosundaki sd ile kurulmuştur; şablonun aralığı aynıdır (kesişimde [228,0145; 275,2888], yarı genişlik 23,6371). "Satırlar ters" satırlarında (çalıştırma 9) nlme D3'ü başvuru alır (konsolda D3 1; D2 2,6751; D1 0,5635); şablonun tablosu ilk düzeye göre yazıldığından oranlar özgün satır sırasındakilerle ve kapalı biçimle aynıdır (D2 4,7475; D3 1,7747).
23.7 Çıktıyı okuma
Örnek ayarın konsol metni (katsayı korelasyon matrisi ve artık özetleri çıkarılmıştır):
Linear mixed-effects model fit by REML
  Data: d
       AIC     BIC    logLik
  1163.961 1201.59 -569.9803

Random effects:
 Formula: ~Time | Rat
 Structure: General positive-definite, Log-Cholesky parametrization
            StdDev     Corr
(Intercept) 36.8618489 (Intr)
Time         0.2449555 -0.139
Residual     3.6450019

Variance function:
 Structure: Different standard deviations per stratum
 Formula: ~1 | .mq_vg
 Parameter estimates:
      D1       D2       D3
1.000000 1.173211 1.607464
Fixed effects:  weight ~ Time * Diet
                Value Std.Error  DF   t-value p-value
(Intercept) 251.65165 13.055628 157 19.275339  0.0000
Time          0.35964  0.088878 157  4.046421  0.0001
DietD2      200.66549 22.622995  13  8.869979  0.0000
DietD3      252.07168 22.654993  13 11.126539  0.0000
Time:DietD2   0.60584  0.154914 157  3.910803  0.0001
Time:DietD3   0.29834  0.157993 157  1.888291  0.0608
...
Number of Observations: 176
Number of Groups: 16
Artık standart sapması (σ) = 3,645
"Variance function" başlığındaki ~1 | .mq_vg, varyans katmanlarının tutulduğu sütundur (23.2); katmanlar Diet düzeyleridir.
Tablolar:
| Tablo | Satır | Değerler |
|---|---|---|
| Varyans fonksiyonu parametreleri (varIdent) | D1 | 1,000000 (SS(düzey) / SS(başvuru düzeyi: D1)) |
| D2 | 1,173211 | |
| D3 | 1,607464 | |
| Varyans bileşenleri (artık SS referans düzey/birim için) | (Intercept) | varyans 1358,7959; SS 36,8618 |
| Time | 0,0600032; 0,2449555 | |
| Residual | 13,2860389; 3,6450019 | |
| Model karşılaştırması (REML; olabilirlik oranı testi) | Homoskedastik | sd 10; logLik −575,8599; AIC 1171,7197; BIC 1203,0777 |
| varIdent | sd 12; logLik −569,9803; AIC 1163,9605; BIC 1201,5901; LR 11,7592; p 0,0028 |
Aynı sabit ve rastgele etkilerle öteki varyans fonksiyonları (REML):
| Varyans fonksiyonu | Ortak değişken | Parametre | sd | logLik | AIC | LR | p |
|---|---|---|---|---|---|---|---|
| (homoskedastik) | — | — | 10 | −575,8599 | 1171,720 | — | — |
| varIdent | Diet |
1,1732; 1,6075 | 12 | −569,9803 | 1163,961 | 11,759 | 0,0028 |
| varPower | kestirilen değer | 0,5428 | 11 | −570,9607 | 1163,921 | 9,798 | 0,0017 |
| varExp | kestirilen değer | 0,001453 | 11 | −570,7746 | 1163,549 | 10,171 | 0,0014 |
| varPower | Time |
−0,0658 | 11 | −575,2668 | 1172,534 | 1,186 | 0,276 |
| varExp | Time |
0,001208 | 11 | −575,8046 | 1173,609 | 0,111 | 0,739 |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| "Variance function" / parametre tablosu | varIdent'te her katmanın oranı; ötekilerde \hat\delta (power, expon) ve varsa \hat c (const) |
Başvuru katmanı varyans değişkeninin ilk düzeyidir (oran 1); adı açıklama sütununda yazar. D3'te hata SS'si D1'inkinin 1,61 katıdır (varyans 2,58 katı). Konsol özeti başka bir katmanı başvuru almışsa çıktıdaki not bunu bildirir. |
| Varyans bileşenleri | Rastgele kesişim ve eğim varyansı; "Residual" | "Residual" \hat\sigma'dır: varIdent'te başvuru katmanının (ilk düzeyin), ötekilerde g=1 olan gözlemin SS'si. varPower'da \hat\sigma=0{,}175 küçük görünür, çünkü \hat y^{\,0{,}54} ile çarpılacaktır. |
| Güven aralıkları (istenirse) ve ML notu | Kestirim, alt ve üst sınır; ML'de SH çarpanı | Aralık kestirim ± t × SH'dir (SH ve sd sabit etkiler tablosundan). ML'de not, SH'nin \sqrt{N/(N-p)} ile çarpıldığını ve çarpanın değerini yazar; çarpansız SH = SH / çarpan. |
| Sabit etkiler | Katsayı, SH, sd, t, p | Kesişim D1'in 0. gündeki ağırlığı; Time D1'in günlük artışı (0,360 g); Time:DietD2 D2'nin eğim farkı. |
| Model karşılaştırması | sd, logLik, AIC, BIC, LR, p | LR homoskedastik modele karşıdır. Farklı varyans fonksiyonları iç içe olmadığından AIC ile karşılaştırılır. |
| \hat\sigma satırı | Artık standart sapması | Bütün veri için tek bir SS değildir; yukarıdaki anlamda başvuru değeridir. |
| Artık grafiği | Standartlaştırılmış artık ↔ kestirilen değer | Yayılım soldan sağa ve kümeler arasında benzer olmalıdır. |
Şekil 23.1. Şablonun çizdiği standartlaştırılmış artıklar (örnek ayar, varIdent). Soldaki küme D1, sağdaki geniş küme D2 ve D3 sıçanlarıdır; standartlaştırma sonrası iki kümenin düşey yayılımı benzerdir.
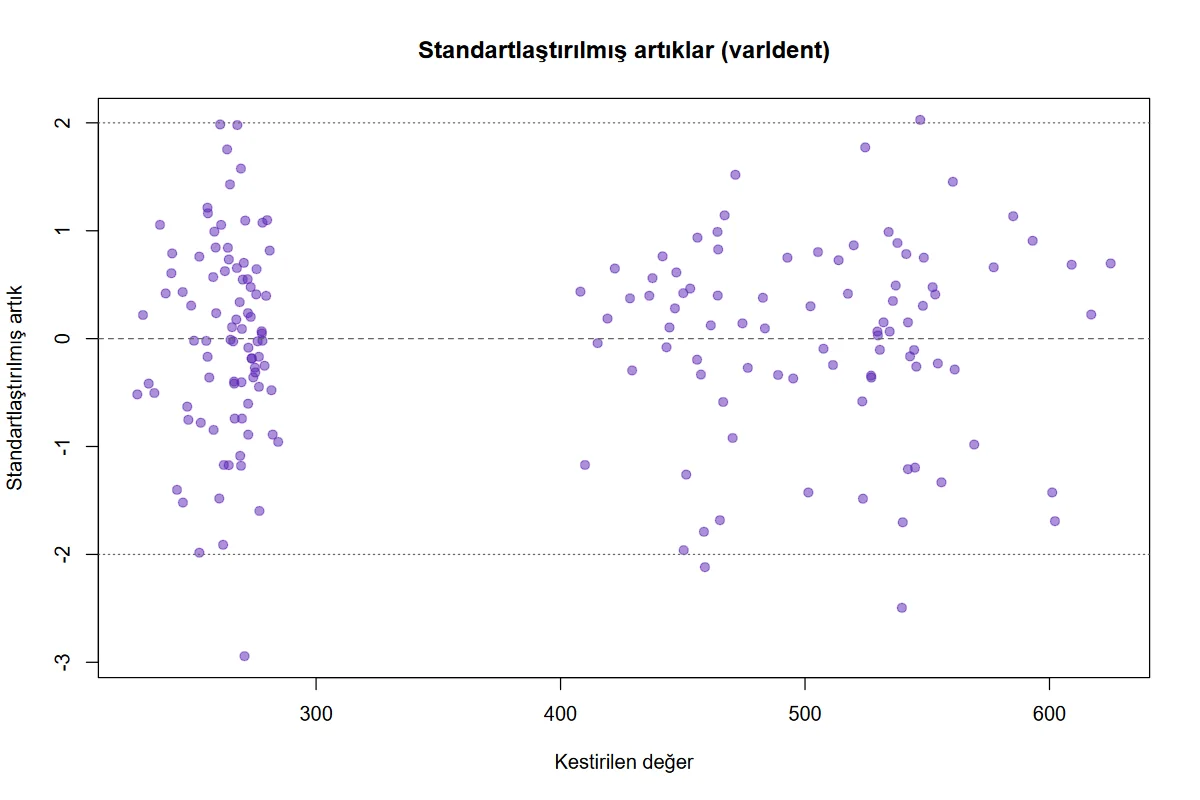
Örnek veride üç model (diyete göre varIdent, kestirilen değere göre varPower ve varExp) birbirine çok yakın AIC verir (1163,5–1164,0): D2 ve D3 sıçanları daha ağır olduğundan "diyete göre farklı varyans" ile "ağırlıkla artan varyans" bu veride ayırt edilemez. Zamanla tekdüze değişen varyans (varPower ve varExp, ortak değişken Time) desteklenmez. Her tartım gününe ayrı varyans tanıyan model (varIdent, varyans değişkeni Time; 10 ek parametre, model sd'si 20) ise olabilirliği belirgin yükseltir (logLik −555,4028; LR 40,914; p<0{,}001; AIC 1150,806), ama BIC'i homoskedastik modelinkinin üstüne çıkarır (1213,522 ve 1203,078): günler arasında düzenli bir eğilim göstermeyen saçılım farkları vardır (oranlar 0,28–1,07) ve bunların modele alınıp alınmayacağı ölçüte göre değişir.
Rapor cümlesi (örnek ayar):
Sıçan ağırlıkları, zaman, diyet ve etkileşimlerinin sabit; sıçana özgü kesişim ve zaman eğiminin rastgele etki olduğu doğrusal karma modelle (REML) çözümlendi. Hata varyansının diyete göre farklılaşmasına izin veren model, sabit varyanslı modelden daha iyi uydu (olabilirlik oranı \chi^2(2) = 11{,}76, p = 0{,}003; AIC 1164,0 ve 1171,7); hata standart sapması birinci diyette 3,65, ikinci diyette bunun 1,17 ve üçüncü diyette 1,61 katı kestirildi. Birinci diyette günlük ağırlık artışı 0,360 g (SH 0,089), ikinci diyette bundan 0,606 g fazla idi (t(157) = 3{,}91, p < 0{,}001); üçüncü diyetin eğim farkı anlamlı değildi (0,298 g; t(157) = 1{,}89, p = 0{,}061).
23.8 Sık hatalar ve tuzaklar
- varIdent değişkeni olarak çok değerli sayısal bir sütun seçmek. Sütunun her farklı değeri ayrı bir katman olur ve her katman bir parametre ekler: örnek veride
Timeile 11 katman, 10 ek parametre (model sd'si 12 yerine 20). Sabit etkilerdeki ve rastgele eğimdekiTimesayısal kalır (23.2); artan yalnız varyans parametreleridir. Sürekli bir ortak değişkende değerlerin çoğu bir iki kez görüldüğünden şablon "varIdent için her düzeyde en az 3 gözlem gerekli." iletisiyle durur; böyle bir değişken için varPower ya da varExp seçilir. - Sayı kodlu grubu etken sanmak. Diyet 1, 2, 3 diye kodlanmış ve sütun sayısal türdeyse sabit etkilerde tek bir eğim olur. Aynı sütunun varIdent'in varyans değişkeni seçilmesi bunu değiştirmez: örnek veride varyans katmanları 1, 2, 3 olarak doğru kurulur (oranlar 1,1713 ve 1,6077), ama sabit etkilerde
Diettek katsayıdır (132,768; dört sabit etki, model sd'si 10). Sütun "Faktör olarak ele alınacak sayısal sütunlar" listesine eklenir; sabit etkinin kodlaması konsoldaki "Fixed effects:" satırlarından denetlenir. - Konsol özetindeki oranları tablodakilerle karıştırmak. Tablolar varyans değişkeninin ilk düzeyine göre yazılır; nlme'nin özeti ise veride ilk rastladığı katmana göredir. Örnek verinin satırları ters çevrilip 23.6 Adım 1'deki model kurulduğunda konsol D3'ü başvuru alır (D3 1; D2 2,6751; D1 0,5635; "Residual standard error" 24,1535), tablo D1'i (D1 1; D2 4,7475; D3 1,7747; \hat\sigma=13{,}6098) ve çıktıya "Not: konsol özetindeki varyans oranları ve artık SS 'D3' düzeyine göredir; tablolar etkenin ilk düzeyine ('D1') göre yeniden ölçeklendi (model aynıdır)." yazılır. İki gösterim aynı modeldir (4{,}7475/1{,}7747=2{,}6751; 13{,}60978\cdot1{,}774714=24{,}15347) ve log-olabilirlik aynıdır. Raporda tablodaki değerler ve açıklama sütunundaki başvuru düzeyi kullanılır; böylece varyans oranlarının başvurusu sabit etkilerin referans düzeyiyle (D1) aynı olur.
- Metin etiketli dönemlerde sırayı varsaymak. "erken", "orta", "gec" gibi rakamsız etiketlerde düzey sırası verideki ilk görülme sırasıdır; sabit etkilerin referansı ve katsayı adları buna göre oluşur. Zaman sırası isteniyorsa veri sekmesinde düzey sırası tanımlanır ya da etiketler "1 erken", "2 orta", "3 gec" biçiminde yazılır.
- Yinelenen ölçümleri gruplama faktörsüz çözümlemek. Grup boş bırakılırsa bütün gözlemler bağımsız sayılır ve bireyler arası fark hataya karışır: örnek veride diyet oranları 4,75 ve 1,77 çıkar (karma modelde 1,17 ve 1,61) ve standart hatalar anlamını yitirir. Gruplama faktörsüz kullanım, her birimin tek gözlemi olan veriler içindir.
- Sıfır içeren ortak değişkenle varPower kullanmak. Örnek veride zaman 0'dan başlatılırsa (
Time − 1) şablon "varPower için varyans ortak değişkeni sıfır içeremez …" iletisiyle durur (23.4.3). varExp aynı ortak değişkenle çalışır (\hat\delta=0{,}000309). - varConstPower'dan her veride sonuç beklemek. İki parametre (c, \delta) çoğu veride birlikte belirlenemez. Örnek veride kestirilen değerle "Singularity in backsolve" iletisi alınır; sıfırdan başlatılmış zamanla (
Time − 1) şablon girdiyi kabul eder, ama nlme "false convergence (8)" verir ve çalışma "Varyans fonksiyonlu model yakınsamadı" önekiyle durur;Timeile \hat c=1{,}559, \hat\delta=-8{,}512 bulunur: \lvert t\rvert^{-8{,}5} yalnız t=1'de 1'dir, öteki günlerde sıfıra yakındır; fonksiyon "ilk tartımda farklı varyans" göstergesine dönüşmüştür. Bu fonksiyon, ortak değişkenin sıfıra yaklaştığı ve varPower'ın çöktüğü veriler içindir. - \hat\sigma satırını genel hata SS'si diye raporlamak. varIdent'te başvuru katmanının (varyans değişkeninin ilk düzeyinin) SS'sidir; öteki katmanlar için oranla çarpılır. varPower ve varExp'te tek başına yorumlanmaz.
- ML'de güven aralığını başka bir kaynağın aralığıyla birebir beklemek. nlme'nin özeti ML'de standart hatayı \sqrt{N/(N-p)} ile çarpar; şablonun aralığı sabit etkiler tablosundaki bu SH ile kurulur ve çıktıdaki not çarpanı yazar. Örnek ayarın ML çalıştırmasında çarpan \sqrt{176/170}=1{,}01749, kesişimin SH'si 11,9670, sd'si 157, aralığı [228,0145; 275,2888]'dir (yarı genişlik 1{,}975189\cdot11{,}9670=23{,}6371). R'de nlme'nin
intervals()işlevi çarpansız standart hatayı kullandığından aynı modelde daha dar aralık verir: çarpansız SH =11{,}9670/1{,}01749=11{,}7613, yarı genişlik 23,2307, aralık [228,4209; 274,8824]. İki aralık aynı kestirimin iki SH tanımıdır; karşılaştırma yapılırken nottaki çarpanla birbirine çevrilir. Fark küçük örneklemde ve çok sabit etkili modelde büyür. - Varyans yapısını yalnız p değerine göre seçmek. Örnek ayarda AIC 7,76 düşer, BIC yalnız 1,49 düşer; kanıt orta düzeydedir. Artık grafiği ve konunun bilgisi (ağır hayvanlarda tartım saçılımının artması beklenir mi?) kararın parçasıdır.
23.9 Uzman soruları
S1. Sabit etki kestirimleri varyans yapısı değişince neden değişmedi?
Tasarım dengeli: her sıçan aynı 11 günde ölçülmüş, her sıçan tek diyette ve varIdent ağırlığı sıçan içinde sabit. Bu durumda her diyetin kesişim ve eğim kestirimi, o diyetteki sıçanların ayrı ayrı en küçük kareler doğrularının ortalamasıdır; ağırlıklar ve rastgele etki varyansları bu ortalamayı değiştirmez. Kestirimler sıradan en küçük kareler değerleriyle on iki basamaktan fazla aynıdır (elle_hesap.json). Varyans yapısı yalnız standart hataları ve testleri etkiler. Ağırlık sıçan içinde değişiyorsa (varPower, ortak değişken Time) kestirimler de değişir: Time katsayısı 0,3596 yerine 0,3535 olur.
S2. varIdent oranları gruplama faktörsüz modelde 4,75 ve 1,77 iken karma modelde neden 1,17 ve 1,61?
İki model farklı şeyi ölçer. Gruplama faktörsüz modelde hata, sıçanlar arası düzey farkını da içerir; D2'de bir sıçan (R12, ortalama 590,5) ötekilerden (440,8–454,8) çok ağırdır ve D2'nin "hata" varyansını büyütür. Karma modelde sıçanlar arası fark rastgele kesişim ve eğime gider; varIdent yalnız sıçan içi saçılımı karşılaştırır. Sıçan başına ayrı doğrulardan hesaplanan birleştirilmiş artık SS oranları (1,165 ve 1,601) karma modelin kestirimlerini doğrular (23.6, Adım 5).
S3. Rastgele etkilerin varyansı da diyete göre farklı olamaz mı?
Olabilir; bu şablon yalnız hata varyansını katmanlara ayırır, rastgele etki kovaryansı \mathbf D bütün sıçanlar için ortaktır. Örnek veride D1 sıçanlarının düzeyleri birbirine yakın (237,6–274,7), D2 ve D3'ünkiler dağınıktır; ortak \mathbf D bu farkı modellemez. Diyete göre ayrı \mathbf D gerekiyorsa şablon kodunda rastgele etki yapısı düzenlenir; formdan seçilemez.
S4. Kestirilen değere bağlı varPower gerçek bir en çok olabilirlik kestirimi midir?
Tam olarak değil. Varyans, kestirilen değerin (BLUP dahil) fonksiyonu olduğunda ortak olabilirliğin en büyüklenmesi yerine dönüşümlü bir yordam izlenir: ortak değişken sabitken olabilirlik en büyüklenir, sonra ortak değişken yenilenir. Sonuç bu yordamın sabit noktasıdır (sözde olabilirlik; Davidian ve Giltinan, 1995). Yazılan log-olabilirlik, son adımdaki ortak değişken verilmiş sayılarak hesaplanmıştır; LR ve AIC bu koşulla yorumlanır. Örnek veride nlme'nin durduğu nokta ile yinelemenin tam sabit noktası arasındaki fark \hat\delta'da 3\times10^{-6}'dır (23.6.1); uygulamada önemsizdir.
S5. \hat\delta=0{,}54 neyi söyler?
Hata varyansı \hat y^{\,2\cdot0{,}5428}=\hat y^{\,1{,}086} ile orantılıdır: varyans ortalamayla yaklaşık doğru orantılı artar (Poisson benzeri bir ilişki), standart sapma ortalamanın karekökü gibi büyür. Sabit değişim katsayısı (\delta=1) bu veriyle uyumlu değildir; logaritmik dönüşüm (\delta=1'e karşılık gelir) saçılımı fazla düzeltirdi. Karekök dönüşümü varyansı yaklaşık dengeler, ama doğrusal büyüme modelini bozar; varyans fonksiyonu özgün ölçekte kalmayı sağlar.
S6. varIdent ile varPower arasında nasıl seçilir?
İkisi iç içe değildir; olabilirlik oranı testi kurulamaz. AIC ya da BIC karşılaştırılır: örnekte AIC 1163,96 (varIdent, 12 parametre) ve 1163,92 (varPower, 11 parametre); fark yok sayılır. Seçim soruya göre yapılır: saçılım farkının nedeni işlemin kendisiyse varIdent, ölçek büyüdükçe artan ölçüm hatasıysa varPower anlamlıdır. İkisi birlikte de kurulabilir (nlme varComb); şablon tek fonksiyon alır, birleşik yapı için kod düzenlenir.
S7. Sabit etkilerin serbestlik dereceleri (157 ve 13) nasıl bulunuyor?
nlme terimleri değiştikleri düzeye göre sınıflar. Diet sıçan içinde sabittir (dış düzey): sd =G-p_{\text{dış}}=16-3=13 (kesişim ve iki diyet göstergesi). Time ve Time:Diet sıçan içinde değişir (iç düzey): sd =N-G-p_{\text{iç}}=176-16-3=157. Kesişime de iç düzey sd'si verilir. Bu sd'ler varyans parametrelerinin kestirilmiş olmasını hesaba katmaz; dört sıçanlı diyetlerde Diet karşılaştırmaları için 13 sd gerçekçidir, 157 ise eğim testleri için iyimser olabilir (rastgele eğim varken eğim farkının bilgisi sıçan sayısıyla sınırlıdır).
S8. İki bağımsız grubun farklı varyanslı karşılaştırmasıyla (Welch) ilişkisi nedir?
Gruplama faktörsüz, tek etkenli model varIdent ile kurulduğunda her grubun kendi varyansı kestirilir ve grup ortalamaları farkının standart hatası \sqrt{\hat\sigma_1^2/n_1+\hat\sigma_2^2/n_2} biçimindedir; bu, Welch'in (1947) istatistiğinin paydasıdır. Fark serbestlik derecesindedir: nlme N-p kullanır, Welch yaklaşımı varyansların kestirim belirsizliğini yansıtan daha küçük bir sd hesaplar. Küçük ve dengesiz gruplarda Welch testi daha tutucudur; bağımsız grupların karşılaştırması için temel programdaki Tek Yönlü ANOVA'nın Welch seçeneği kullanılır, bu şablon ortak değişkenli ve rastgele etkili modeller içindir.
S9. REML yerine ML ne zaman seçilir ve ne değişir?
Varyans yapılarının karşılaştırması (aynı sabit etkiler) REML ile yapılır. Sabit etkileri farklı modeller karşılaştırılacaksa ML gerekir. Örnek ayarda ML ile oranlar 1,1770 ve 1,6094, LR 11,820 olur (REML: 1,1732; 1,6075; 11,759); varyans fonksiyonu parametreleri yönteme az duyarlıdır. Rastgele kesişim SS'si belirgin değişir (ML 33,19; REML 36,86), çünkü ML sabit etkilerin harcadığı serbestlik derecesini hesaba katmaz (Patterson ve Thompson, 1971) ve 16 sıçanla bu yanlılık büyüktür.
23.10 Kaynaklar
- Carroll, R. J., & Ruppert, D. (1988). Transformation and weighting in regression. Chapman & Hall. https://doi.org/10.1007/978-1-4899-2873-3
- Davidian, M., & Giltinan, D. M. (1995). Nonlinear models for repeated measurement data. Chapman & Hall. https://doi.org/10.1201/9780203745502
- Hand, D. J., & Crowder, M. J. (1996). Practical longitudinal data analysis. Chapman & Hall. https://doi.org/10.1007/978-1-4899-3033-0
- Patterson, H. D., & Thompson, R. (1971). Recovery of inter-block information when block sizes are unequal. Biometrika, 58(3), 545–554. https://doi.org/10.1093/biomet/58.3.545
- Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer. https://doi.org/10.1007/b98882
- Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models (R package version 3.1-168). https://doi.org/10.32614/CRAN.package.nlme
- Welch, B. L. (1947). The generalization of 'Student's' problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28