17. Çok yanıtlı (çok değişkenli) doğrusal karma model
Şablon kimliği: cok_yanitli_karma · Kategori: karma model · Dil: R · Dosya: pro/sablonlar/karma_model/cok_yanitli_karma.R (satır 1–321; üstbilgi 1–120) · Örnek veri: _ornek/btdata.csv · Paketler: glmmTMB 1.1.15.2 (REML/ML yolu); MCMCglmm 2.36, coda 0.19-4.1 (MCMC yolu)
17.1 Ne işe yarar
Şablon, aynı bireyde ölçülen iki ya da daha çok sürekli yanıtı tek bir karma modelde birlikte kurar ve yanıtlar arasındaki ilişkiyi kaynaklarına ayırır. Cevapladığı soru şudur: "İki özellik arasındaki korelasyonun ne kadarı kümelerin (ana, yuva, okul, tarla) ortak etkisinden, ne kadarı bireyin kendisinden geliyor; her kaynak her yanıtın varyansının ne kadarını taşıyor?"
- \mathbf y_i: i. bireyin q yanıtı (q\ge2); i=1,\dots,n.
- \mathbf x_i: sabit etki değişkenleri (kesişim dahil); \mathbf B: her yanıt için ayrı katsayı sütunu taşıyan matris. Bir açıklayıcının tarsus üzerindeki etkisi ile sırt rengi üzerindeki etkisi ayrı kestirilir.
- \mathbf u_{s,l}: s. gruplamanın l. düzeyinin q boyutlu rastgele etkisi; g_s(i) bireyin o gruplamadaki düzeyi. \boldsymbol\Sigma_s yanıtlar arası q\times q kovaryans matrisidir.
- \mathbf e_i: birey içi artık; \boldsymbol\Sigma_e aynı bireyin yanıtları arasındaki artık kovaryansıdır.
Her \boldsymbol\Sigma matrisinin köşegeni o kaynağın yanıta özgü varyansını, köşegen dışı öğesi iki yanıtın o kaynaktaki kovaryansını verir. Kantitatif genetikte \boldsymbol\Sigma_{\text{ana}} ya da soy ağacına bağlı karşılığı "G matrisi" diye anılır (Hadfield, 2010).
Şablon iki kestirim yolu sunar: REML (ya da ML; glmmTMB, sonuç belirlenimci) ve Bayesci MCMC (MCMCglmm; sonsal ortalama ve en yüksek sonsal yoğunluk, HPD, aralıkları).
Ne zaman kullanılır? İki ya da daha çok sürekli özellik aynı bireylerde ölçülmüşse ve bireyler kümelenmişse; özellikler arası korelasyonun küme düzeyi ve birey düzeyi bileşenleri isteniyorsa; bir yanıttaki eksik bilgi ötekinden ödünç alınarak varyans bileşenleri daha kesin kestirilecekse.
Ne zaman kullanılmaz?
- Tek yanıt varsa: temel programdaki LMM (Doğrusal Karma Modeller), çapraz gruplamalarda Çapraz LMM (Çapraz Rastgele Etkili Karma Model).
- Küme yoksa (bireyler bağımsız) ve yalnız grup ortalamaları karşılaştırılacaksa: temel programdaki MANOVA.
- Yanıtlar sürekli değilse (ikili, sayım, sıralı): tek yanıt için
glmer_ileri,glmmtmb_aileler,clmm_sirali_karma. Bu şablonun iki yolu da normal dağılımlı yanıt kurar (satır 200, 248). - Yanıtlar aynı özelliğin farklı zamanlardaki ölçümleriyse ve zaman içi korelasyon yapısı aranıyorsa:
lme_varyans_yapilari. - Yanıtlar çok sayıda çevredeki aynı özellikse ve kovaryans matrisi düşük ranklı kurulacaksa:
fa_karma_model(Bölüm 18). - Rastgele eğim gerekiyorsa: form yalnız rastgele kesişim (yanıta özgü) kurar; şablon kodu düzenlenir.
Temel programla ilişki. Temel programın karma model analizleri tek yanıtlıdır; iki yanıt ayrı ayrı çözülürse her yanıtın varyans bileşenleri bulunur, ama yanıtlar arası kovaryanslar (\boldsymbol\Sigma'ların köşegen dışı öğeleri) kestirilemez. MANOVA yanıtlar arası kovaryansı kullanır, ama rastgele etki içermez. Bu şablon ikisini birleştirir.
17.2 Şablonun girdileri
Form, üstbilgideki on dört [[param]] bloğundan kurulur (cok_yanitli_karma.R:11–127).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıtlar (en az iki sürekli değişken) · y |
sütunlar · Değişkenler | — | en az 2 sayısal sütun | Yanıtlar; uzun biçimde yanıt etkeninin düzeyleri (132–133, 242–243). |
Sabit etkiler (her yanıt için ayrı katsayı) · x |
sütunlar · Değişkenler | boş | herhangi sütunlar | yanıt × açıklayıcı terimleri (136, 152–157, 172–173). |
Rastgele etki grupları (yanıtlar arası yapısız kovaryans) · gruplar |
sütunlar · Değişkenler | — | en az 1 sütun | Her biri için q\times q kovaryans (134–135, 147–151, 193, 244). |
Kestirim yolu · yontem |
seçim · Model | reml |
reml, mcmc |
glmmTMB ya da MCMCglmm dalı (183, 240). |
Gruplama düzeyi kovaryans yapısı · kov_yapisi |
seçim · Model | us |
us (yapısız), diag (köşegen) |
Grup matrislerinde kovaryans kestirilir ya da 0 alınır; artık matrisi her zaman yapısız (193, 244). |
REML (kapalıysa ML) · reml |
onay · Model | açık | açık / kapalı | glmmTMB(REML = …); yalnız REML/ML yolunda (248). |
MCMC toplam yineleme · nitt |
tamsayı · Gelişmiş | 60000 | 1000–2000000 | MCMCglmm(nitt = …) (185, 201). |
MCMC ısınma · burnin |
tamsayı · Gelişmiş | 10000 | 100–1000000 | Atılan ilk yinelemeler (185). |
MCMC seyreltme · thin |
tamsayı · Gelişmiş | 25 | 1–1000 | Her kaçıncı örnek saklanır (185). |
Optimizasyon algoritması · optimizer |
seçim · Gelişmiş | nlminb |
nlminb, BFGS |
glmmTMBControl (245–246). |
En çok yineleme · maks_yineleme |
tamsayı · Gelişmiş | 2000 | 50–100000 | iter.max ya da BFGS maxit (245–246). |
En çok işlev değerlendirmesi · maks_degerlendirme |
tamsayı · Gelişmiş | 2000 | 50–100000 | Yalnız nlminb: eval.max (246). |
Ters-Wishart önseli: q − 1 üzerine eklenen ν · prior_nu |
ondalık · Gelişmiş | 0,002 | 0–1000 | Önsel derecesi \nu=q-1+ bu değer; \mathbf V=\mathbf I (194–197). |
MCMC önselinin ölçeği (V) · onsel_olcegi |
seçim · Gelişmiş | birim |
birim, varyans |
birim: \mathbf V=\mathbf I; varyans: \mathbf V=\mathrm{diag}(\widehat{\sigma}^2_{y_1},\dots,\widehat{\sigma}^2_{y_q})/(G+1), G gruplama sayısı (192–199). Yalnız MCMC. |
HPD aralık olasılığı · hpd |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | coda::HPDinterval(prob = …) (203, 209). |
Örnek ayar (ornek_param, satır 9): y = tarsus, back, x = sex, hatchdate, gruplar = dam, fosternest, yontem = reml. Örnek ayar MCMC alanlarını varsayılandan kısa tutar: nitt = 13000, burnin = 3000, thin = 10 (1000 saklanan örnek); bunlar yalnız kestirim yolu MCMC'ye çevrilirse kullanılır.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 123 |
| İkiden az farklı yanıt | "En az iki yanıt seçin." | 125 |
| Yanıtlar dışında gruplama kalmadı | "Yanıtlardan farklı en az bir gruplama seçin." | 126–127 |
| Eksiksiz satır 10q'dan az | "Yanıt sayısına göre çok az tam satır var." | 132 |
| Bir yanıt sayısal değil | "'…' sayısal değil." | 134 |
| Bir yanıt sabit | "'…' sabit." | 135 |
| En büyük ve en küçük yanıt SS'sinin oranı 1000'den büyük | "Yanıtların ölçekleri çok farklı (SS oranı > 1000); önce ölçekleyin." | 137–138 |
| Bir gruplamada 3'ten az düzey | "… grubunun en az 3 düzeyi olmalı." | 141 |
| Bir gruplamada düzey sayısı ≥ satır sayısı | "… grubunda tekrarlı gözlem yok." | 142 |
| Bir sabit etki sabit | "… sabit; sabit etkilerden çıkarın." | 148 |
| MCMC: ısınma ≥ toplam yineleme | "Isınma, toplam yinelemeden küçük olmalı." | 178 |
| MCMC: saklanan örnek 100'den az | "Saklanan örnek sayısı en az 100 olmalı ((nitt − burnin) / thin)." | 183 |
| Model kurulamadı | "Model kurulamadı: …" / "MCMC modeli kurulamadı: …" | 190, 238 |
| REML/ML: katsayılardan biri ya da log-olabilirlik sonlu değil | "Kestirimler ya da log-olabilirlik sonlu değil; model kurulamadı. …" | 269–270 |
Eksik değer: yanıtlar, sabit etkiler ve gruplamalardan herhangi birinde eksiği olan birey bütün yanıtlarıyla atılır (complete.cases, satır 138); bir yanıtı eksik bireyin öteki yanıtı da kullanılmaz. Uyarılar (durdurmaz): eniyileyicinin yakınsama uyarıları ve "Hessian pozitif tanımlı değil" notu (278) çıktının sonunda "Uyarılar:" satırında toplanır (312).
17.3 Örnek veri
Dosya: _ornek/btdata.csv. MCMCglmm paketindeki BTdata: çapraz evlat edindirme (cross-fostering) deneyindeki mavi baştankara yavruları (Hadfield ve ark., 2007). Yavrular yumurtadan çıktıktan sonra yuvalar arasında değiştirilmiştir; böylece genetik ana (dam) ile büyüdüğü yuva (fosternest) birbirinden ayrışır. 828 satır, eksik değer yok.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
tarsus |
Yanıt 1 | sayısal | Tarsus (ayak kemiği) uzunluğu; standartlaştırılmış (ortalama 0, SS 1). |
back |
Yanıt 2 | sayısal | Sırt tüyü rengi; standartlaştırılmış. |
sex |
Sabit etki | kategorik (3 düzey) | Fem 373, Male 408, UNK 47 (cinsiyeti belirlenemeyen). |
hatchdate |
Sabit etki | sayısal | Yumurtadan çıkış tarihi; standartlaştırılmış; 18 farklı değer. |
dam |
Gruplama 1 | kategorik (106 düzey) | Genetik ana; ana başına 1–15 yavru (ortanca 8). |
fosternest |
Gruplama 2 | kategorik (104 düzey) | Büyüdüğü yuva; yuva başına 1–15 yavru (ortanca 9). |
animal |
kullanılmaz | metin | Birey kimliği (828 farklı değer). |
İki gruplama çaprazdır: 106 ana ve 104 yuvanın 199 farklı birleşimi gözlenmiştir. İki yanıtın ham korelasyonu -0{,}033'tür; model bu küçük korelasyonun, kaynaklara ayrıldığında zıt işaretli ve büyük bileşenlerden oluştuğunu gösterir (17.7).
Düzey sırası: Fem, Male, UNK
sex kategoriktir ve düzeyleri verideki ilk görülme sırasıyla R'ye aktarılır (Bölüm 1.3): Fem, Male, UNK. Model kesişimsiz, yanıta özgü ortalamalarla kurulduğundan (0 + trait + trait:sex) çıktıdaki tarsus ve back satırları ilk düzeyin (Fem), hatchdate = 0 iken ortalamalarıdır; tarsus:sexMale erkek − dişi farkıdır. Veri başka bir satır sırasıyla açılırsa referans düzey ve bu satırların anlamı değişir. Gruplama değişkenlerinde düzey sırası sonucu etkilemez.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar (REML, yapısız); (2) reml kapalı (ML); (3) kov_yapisi = diag; (4) optimizer = BFGS; (5) _ornek/btdata_dengeli.csv ile dengeli tek yönlü tasarım (x boş, gruplar = fosternest); (6) MCMC, örnek ayarın kısa zinciri, tohum 20261116; (7) MCMC, varsayılan zincir (60000 / 10000 / 25), aynı tohum.
17.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) eksik bireyleri at, yanıtları ve gruplamaları denetle; (2) veriyi uzun biçime çevir (her birey q satır); (3) seçilen yolla modeli kur; (4) yanıta özgü sabit etkiler tablosu; (5) her kaynağın kovaryans matrisi, korelasyonu ve varyans oranı; (6) uyum ölçütleri ve korelasyon grafiği.
17.4.1 Uzun biçim ve model formülü
q yanıt alt alta dizilir: \mathbf y=(\mathbf y_{(1)}^{\top},\dots,\mathbf y_{(q)}^{\top})^{\top}, uzunluğu N=nq. Yanıtı gösteren trait faktörüyle model tek yanıtlı bir karma model gibi yazılır: (Kodda yanıt etkeninin adı REML/ML yolunda .mq_yanit, değer sütununun adı .mq_deger, birey kimliğinin adı .mq_birey'dir; MCMCglmm yanıt etkenini trait adıyla kendisi kurar. Aşağıda kısalık için trait yazılmıştır.)
0 + trait: ortak kesişim yerine her yanıta ayrı ortalama.trait:x: her açıklayıcının her yanıt için ayrı katsayısı; sabit etki sayısı p=q\times(\text{tek yanıtlı modelin sütun sayısı}).- \operatorname{us}(0+\texttt{trait}\mid g): g'nin her düzeyi için q boyutlu, yapısız kovaryanslı rastgele etki.
- \mathbf W_s: n\times L_s gösterge matrisi (L_s düzey sayısı); (\mathbf W_s\mathbf W_s^{\top})_{ij}=1, i ve j bireyleri aynı düzeydeyse. \otimes Kronecker çarpımıdır.
- Son terim birey içi artıktır: aynı bireyin iki yanıtı \boldsymbol\Sigma_e'nin köşegen dışı öğesi kadar ilişkilidir.
Koddaki tercih
glmmTMB'de (Brooks ve ark., 2017) artık varyansı tek bir sayıdır; yanıta özgü artık varyansları ve aralarındaki kovaryans doğrudan yazılamaz. Şablon bunu iki adımda çözer (satır 168, 244, 248): her bireye bir kimlik (.mq_birey) verip \boldsymbol\Sigma_e'yi birey düzeyinde yapısız rastgele etki olarak kurar, gözlem düzeyi hata varyansını ise dispformula = ~0 ile sıfıra sabitler. Böylece "artık" tümüyle \boldsymbol\Sigma_e'de toplanır ve tablodaki "Artık (birey içi)" satırları bu matristir. Bu, aynı olabilirliği veren, yalnız yazımı farklı bir kurulumdur.
Kovaryans yapısı. us (yapısız) seçeneğinde her gruplama için q(q+1)/2 parametre kestirilir. diag seçeneğinde gruplama matrisleri köşegendir (her yanıtın kendi varyansı, kovaryans 0; q parametre); artık matrisi her iki seçenekte yapısızdır.
17.4.2 REML ve ML
- \boldsymbol\theta: bütün \boldsymbol\Sigma matrislerinin serbest öğeleri. Örnek ayarda 3\times3=9 parametre.
- \mathbf X: uzun biçimdeki sabit etki tasarım matrisi (N\times p; örnekte 1656\times8).
- ML'de ikinci terim yoktur ve sabit N\log2\pi'dir. Tablodaki "REML logLik" / "ML logLik" \ell'nin kendisidir (sabit dahil).
Neden varsayılan REML?
ML, varyansları kestirirken sabit etkilerin harcadığı serbestlik derecesini hesaba katmaz; varyans bileşenleri aşağı yanlıdır. Çok yanıtlı modelde sabit etki sayısı yanıt sayısıyla çarpıldığından (p=8) yanlılık büyür: örnek veride ana düzeyi tarsus varyansı REML ile 0,2292, ML ile 0,2241'dir. ML, sabit etkileri farklı iki modelin olabilirlik oranıyla karşılaştırılması gerektiğinde seçilir (Patterson ve Thompson, 1971).
Dengeli tek yönlü tasarımda kapalı biçim. Tek gruplama, sabit etki olarak yalnız ortalamalar ve her kümede k birey varsa REML kestirimleri çok değişkenli varyans analizinin kareler ve çarpımlar ortalamalarıdır (Searle ve ark., 1992):
- G: küme sayısı; k: küme başına birey; n=Gk. \bar{\mathbf y}_l küme, \bar{\mathbf y} genel ortalama vektörü.
- \mathbf W, \mathbf B: küme içi ve kümeler arası kareler ve çarpımlar ortalaması matrisleri. E(\mathbf B)=\boldsymbol\Sigma_e+k\boldsymbol\Sigma_u olduğundan \boldsymbol\Sigma_u bu eşitliğin çözümüdür.
- Çözüm, \mathbf B-\mathbf W pozitif tanımlıysa REML kestirimidir; değilse kestirim sınırdadır ve kapalı biçim geçerli olmaz.
17.4.3 Sabit etkilerin standart hatası ve testi
- Birinci terim, varyans parametreleri biliniyormuş gibi hesaplanan model tabanlı kovaryanstır.
- İkinci terim, \hat{\boldsymbol\theta}'nın kestirilmiş olmasından gelen eklentidir: \hat{\boldsymbol\Sigma}_\theta ölçütün (-\ell_R ya da -\ell) \boldsymbol\theta'ya göre Hessian'ının tersi, \mathbf J katsayıların varyans parametrelerine duyarlılığıdır.
- \Phi standart normal dağılım işlevi; test Wald z testidir, serbestlik derecesi kullanılmaz.
Koddaki tercih
Şablon SH'yi sqrt(diag(vcov(m)$cond)) ile alır (satır 280). glmmTMB, REML'de sabit etkileri bütünleştirilen etkiler olarak ele alır ve kovaryansı TMB'nin (Kristensen ve ark., 2016) ortak Hessian'ından üretir; sonuç yukarıdaki iki terimli ifadedir. Yalnız birinci terimi raporlayan uygulamalara göre SH'ler biraz büyüktür: örnek veride fark tarsus için %0,04, en büyük olduğu tarsus:sexUNK için %0,57'dir (17.6, Adım 3). Dengeli tasarımda \mathbf J sıfıra yakındır ve iki tanım çakışır.
p değerleri normal dağılımdandır
Tablodaki z ve p asimptotiktir. Küme sayısı küçükse (onlarca değil, birkaç tane) bu p iyimserdir. Tek yanıt için Kenward-Roger düzeltmeli test r_emmeans_kontrast şablonundadır; çok yanıtlı modelde MCMC yolunun HPD aralıkları küçük örneklem belirsizliğini doğrudan taşır.
17.4.4 Kovaryans, korelasyon ve varyans oranı
- r_{s,tu}: s. kaynakta t ve u yanıtlarının korelasyonu (satır 180). Ana düzeyinde genetik (ve anaya bağlı) korelasyon, yuva düzeyinde ortak çevre korelasyonu, artıkta birey içi korelasyon diye okunur.
- \text{oran}_{s,t}: t yanıtının, sabit etkiler ayıklandıktan sonraki toplam varyansında s. kaynağın payı (satır 301–302). Her yanıtta oranların toplamı 1'dir.
17.4.5 Uyum ölçütleri
- \ell: seçilen ölçütün (REML ya da ML) log-olabilirliği; m: kovaryans parametresi sayısı.
- "parametre" satırı p+m'dir: örnek ayarda 8+9=17; köşegen yapıda 8+7=15.
AIC'deki parametre sayısı sabit etkileri de içerir
glmmTMB, REML'de de sabit etkileri parametre sayar. REML ölçütünde yalnız kovaryans parametrelerini sayan uygulamaların AIC'si 2p kadar küçüktür (örnekte 4396{,}43-16=4380{,}43). Aynı sabit etkili iki modelin AIC farkı iki tanımda da aynıdır. Sabit etkileri farklı modeller REML olabilirliğiyle karşılaştırılmaz; ML'ye geçilir.
17.4.6 Bayesci MCMC yolu
Aynı model MCMCglmm ile kurulur (satır 192–201): cbind(y₁, …, y_q) ~ 0 + trait + trait:x, random = ~ us(trait):g₁ + … (köşegen yapıda idh), rcov = ~ us(trait):units, her yanıt için normal aile. Her kovaryans matrisine ters Wishart önseli verilir:
- \nu: önselin "inanç derecesi"; \nu>q-1 olmalıdır. \nu_0 küçüldükçe önsel zayıflar.
- \mathbf V=\mathbf I_q: önselin ölçek matrisi. Ölçek verinin birimlerine bağlıdır: yanıtlar standartlaştırılmışsa (örnek veri) birim matris makul bir ölçektir; varyansı 10^{-4} ya da 10^{4} düzeyinde olan yanıtlarda aynı önsel sırasıyla çok baskın ya da çok zayıf kalır. "MCMC önselinin ölçeği" alanı
varyansyapılırsa \mathbf V yanıt varyanslarından kurulur (köşegen, her kaynak için aynı \mathbf V, kaynak sayısına — gruplamalar ve artık — bölünmüş); önsel yanıtların birimine bağımlı olmaktan çıkar ve ölçek uyarısı yazılmaz. Örnek veride (tarsus, back; dam ve fosternest; 60000 yineleme, ısınma 10000, seyreltme 25) dam için back varyansının sonsal ortalaması \mathbf V=\mathbf I ile 0,1205,varyansile 0,0924 çıkar; bağımsız bir MCMCglmm çağrısıyla Monte Carlo hatası içinde aynıdır. Yanıtlar 10'a bölününcevaryansseçeneğinde varyans bileşenleri Monte Carlo hatası içinde 1/100 ölçeğinde kalır. Varsayılanbirim'dir. Parametre genişletmeli önsel eklenmedi. - Sabit etkilere paketin varsayılan (çok geniş varyanslı normal) önseli uygulanır.
Zincirden (nitt − burnin) / thin örnek saklanır. Sabit etkiler için sonsal ortalama, sonsal SS, HPD aralığı ve etkin örneklem büyüklüğü (ESS; ikisi de coda paketinden, Plummer ve ark., 2006); (ko)varyanslar için sonsal ortalama, HPD ve ESS; uyum için sapma bilgi ölçütü (DIC; Spiegelhalter ve ark., 2002) verilir. "Kovaryans matrisleri" tablosu bu yolda sonsal ortalama kovaryanslardan kurulur (satır 206–216). Korelasyon, zincirin her örneğinde r^{(t)}=\Sigma_{12}^{(t)}/\sqrt{\Sigma_{11}^{(t)}\Sigma_{22}^{(t)}} olarak hesaplanır; tablonun korelasyon sütunu bu değerlerin sonsal ortalamasıdır ve ayrı bir tabloda HPD aralığı ve ESS ile birlikte verilir (satır 217–236). Sonsal ortalama kovaryansların oranı kullanılmaz. Çıktının sonuna, sonsal ortalamanın REML kestirimiyle aynı tanım olmadığını ve önselin yanıtların birimine bağlı olduğunu söyleyen bir not yazılır (satır 307–310).
Neden iki yol birden?
REML hızlıdır, tohum gerektirmez ve yaygın karma model yazılımlarının sonuçlarıyla karşılaştırılabilir. Ama kovaryans parametrelerinin belirsizliğini vermez (şablon kovaryanslar için SH ya da aralık raporlamaz) ve küçük küme sayısında sınır çözümleri (korelasyon \pm1, varyans 0) üretebilir. MCMC her parametre için aralık verir ve sınırda takılmaz; karşılığında sonuç önsele, zincir uzunluğuna ve tohuma bağlıdır. İki yolun kestirimleri aynı tanım değildir: REML olabilirliğin tepe noktası, MCMC sonsal dağılımın ortalamasıdır (17.9 S5).
17.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–120 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on dört parametre. | Form ve varsayılanlar (Bölüm 1.2). |
| 121–132 | Roller: yanıtlar, yanıtlardan farklı gruplar, ikisinden farklı sabit etkiler; eksik satırlar atılır; n\ge10q. | Aynı sütun iki role verilirse sessizce öncelikli rolde kalır (134, 136). |
| 133–149 | Yanıt, gruplama ve sabit etki denetimleri; gruplamalar faktör yapılır; metin/mantıksal sabit etkiler faktöre çevrilir. | Sayısal sabit etki tek eğimle, faktör sabit etki gösterge sütunlarıyla girer. |
| 150–173 | Sütunlar geçerli ve birbirinden farklı R adlarına çevrilir; iç adlarla çakışabilecek sütunlar (trait, units, .mq_ ile başlayanlar) takma adla taşınır; birey kimliği .mq_birey; uyarı toplayıcı; sabit etki formülünün sağ yanı; kovaryans tablosu işlevi. |
Şablonun kendi sütunları .mq_ ile başlar; kullanıcının sütun adı ne olursa olsun üzerine yazılmaz. Tablolarda özgün adlar kullanılır (163–164, 174). |
| 175–227 | MCMC dalı: formüller, önseller, MCMCglmm; sonsal özetler, HPD, ESS, DIC; her örnekte korelasyon. |
Zincir sütunları kaynak sırasıyla (gruplar, sonra artık) ve konumla ayrıştırılır: yapısız kaynakta q^2, köşegen kaynakta q sütun (206–216). |
| 228–281 | REML/ML dalı: uzun biçim, rastgele etki terimleri, eniyileyici ayarı, glmmTMB(dispformula = ~0, REML = …); Newton adımlarıyla inceltme (251–277); katsayılar, SH, z, p; VarCorr'dan matrisler; log-olabilirlik, AIC, parametre sayısı, en büyük |gradyan|. |
Hessian pozitif tanımlı değilse not eklenir (278); kestirimler ya da log-olabilirlik sonlu değilse durur (281–282). |
| 282–300 | Özet satırı; tablolar: sabit etkiler, kovaryans matrisleri, varyans oranları, (MCMC'de) bileşenlerin ve korelasyonların sonsal özeti, model uyumu; uyarılar. | Özet satırındaki "yöntem" REML, ML ya da MCMC yazar (295). |
| 301–308 | Kaynaklara göre yanıtlar arası korelasyon çubuk grafiği. | Yalnız köşegen dışı satırlar; köşegen yapıda grup çubukları 0'dır. |
Uzun biçime çevirme ve model çağrısı (satır 242–248, kısaltılmış):
L <- do.call(rbind, lapply(seq_along(yn), function(j) { u <- d; u$.mq_deger <- d[[yn[j]]]; u$.mq_yanit <- yn[j]; u }))
L$.mq_yanit <- factor(L$.mq_yanit, levels = yn)
re <- paste0(c(rep(if (identical(P$kov_yapisi, "diag")) "diag" else "us", length(gn)), "us"),
             "(0 + .mq_yanit | ", c(gn, ".mq_birey"), ")", collapse = " + ")
m <- glmmTMB(.mq_deger ~ 0 + .mq_yanit + .mq_yanit:x + re, dispformula = ~0, REML = isTRUE(P$reml), data = L, control = kontrol)
Uzun biçim .mq_deger, .mq_yanit ve .mq_birey adlı üç sütun ekler. Kullanıcının sütunları bu adlarla çakışamaz: .mq_ ile başlayan ya da MCMCglmm'in ayırdığı adları (trait, units) taşıyan bir sütun rol almışsa model içinde takma adla (mq_trait gibi) taşınır ve tablolarda özgün adıyla yazılır (satır 158–168). value adlı bir sabit etki öteki sütunlar gibi çalışır.
İnceltme. Bu modelde olabilirlik tepe çevresinde çok düzdür (iki gruplama büyük ölçüde örtüşür) ve eniyileyici gradyan sıfırlanmadan durabilir: örnek ayarda durduğu noktada en büyük |gradyan| 4{,}5\times10^{-3}'tür. Şablon bu noktadan Newton adımları atar, \boldsymbol\theta\leftarrow\boldsymbol\theta-\mathbf H^{-1}\mathbf g (\mathbf g gradyan, \mathbf H gradyanın sayısal türevi), en büyük |gradyan| 10^{-7}'nin altına inene ya da adım gradyanı küçültmez olana kadar (en çok 8 adım; satır 251–277). Adım gradyanı küçültmüyorsa eniyileyicinin noktası korunur. Örnek ayarda bir–iki adım yeter (son |gradyan| 1{,}7\times10^{-7}); ulaşılan nokta bağımsız çözümle dokuz basamak aynıdır (17.6.1). Son gradyan "Model uyumu" tablosunda "en büyük |gradyan|" satırında yazılır; 10^{-3}'ü aşıyorsa uyarı verilir.
17.6 Elle hesap: örnek veride bağımsız yeniden hesap
Hesaplar dogrulama/cok_yanitli_karma/elle_hesap.py ve r_dogrulama.R ile yapılmıştır. Python, 17.4.2'deki olabilirliği \mathbf V matrisini açıkça kurarak yazar ve kendisi en büyükler: \boldsymbol\Sigma=\mathbf L\mathbf L^{\top} parametrelemesi, analitik gradyanlı BFGS ve üç Newton adımı (son gradyan <10^{-12}); glmmTMB ve TMB kullanılmaz. R, aynı modeli lme4 ile kurar: lme4'te gözlem hatası sıfırlanamadığından birey içi kovaryans \hat{\boldsymbol\Sigma}_e=\hat{\boldsymbol\Sigma}_{\text{birey}}+\hat\sigma^2\mathbf I toplamı olarak okunur (yalnız toplam tanımlıdır).
Adım 1 — Dengeli tasarımda kapalı biçim (btdata_dengeli.csv: 95 yuva, yuva başına 5 yavru, n=475):
\mathbf B-\mathbf W'nin özdeğerleri pozitiftir (\hat{\boldsymbol\Sigma}_u için 0,1682 ve 0,2325), kapalı biçim REML çözümüdür. Yuva düzeyi korelasyon 0{,}017773/\sqrt{0{,}227133\cdot0{,}173603}=0{,}0895, artık korelasyonu -0{,}0607; yuvanın varyans payı tarsusta 0{,}227133/(0{,}227133+0{,}757256)=0{,}2307, sırt renginde 0,1651'dir. Şablon bu çalıştırmada 0,227137; 0,017766; 0,173607 ve 0,757251; −0,049504; 0,877993 verir.
Adım 2 — Ana model (REML). n=828, N=1656, p=8, m=9. Kendi eniyilememizin sonucu:
| Kaynak | (tarsus, tarsus) | (tarsus, back) | (back, back) | Korelasyon |
|---|---|---|---|---|
| dam | 0,229228 | −0,069062 | 0,069471 | −0,5473 |
| fosternest | 0,069975 | 0,074235 | 0,115711 | 0,8250 |
| Artık (birey içi) | 0,567613 | −0,036955 | 0,804427 | −0,0547 |
\ell_R=-2181{,}215027. lme4 aynı noktaya varır (\ell_R=-2181{,}215027; kovaryanslar 3\times10^{-7} içinde).
Adım 3 — Sabit etkiler ve iki SH tanımı.
| Terim | \hat\beta | Model tabanlı SH | Tam SH (17.4.3) | Şablon SH |
|---|---|---|---|---|
| tarsus | −0,407910 | 0,067770 | 0,067800 | 0,067800 |
| back | −0,012285 | 0,064317 | 0,064368 | 0,064367 |
| tarsus:sexMale | 0,770895 | 0,056953 | 0,056977 | 0,056977 |
| back:sexMale | 0,008248 | 0,066769 | 0,066791 | 0,066791 |
| tarsus:sexUNK | 0,229599 | 0,126579 | 0,127306 | 0,127306 |
| back:sexUNK | 0,153604 | 0,147933 | 0,148772 | 0,148771 |
| tarsus:hatchdate | −0,042894 | 0,057454 | 0,057493 | 0,057493 |
| back:hatchdate | −0,090718 | 0,051434 | 0,051478 | 0,051477 |
"Tam SH" sütunu (\mathbf X^{\top}\hat{\mathbf V}^{-1}\mathbf X)^{-1}+\mathbf J\hat{\boldsymbol\Sigma}_\theta\mathbf J^{\top}'nin köşegenidir (\mathbf J ve Hessian merkezi farklarla); şablonun SH'siyle 10^{-6} içinde aynıdır. lme4'ün SH'leri model tabanlı sütunla aynıdır.
Adım 4 — Test. tarsus:sexMale için z=0{,}770895/0{,}056977=13{,}53, p<10^{-40}; back:hatchdate için z=-0{,}090718/0{,}051478=-1{,}762, p=2\,\Phi(-1{,}762)=0{,}0780.
Adım 5 — Varyans oranları (tarsus): toplam 0{,}229228+0{,}069975+0{,}567613=0{,}866816; ana 0{,}2644, yuva 0{,}0807, artık 0{,}6548. Sırt renginde: 0,0702; 0,1169; 0,8129.
Adım 6 — AIC. -2\ell_R=4362{,}430054; \mathrm{AIC}=4362{,}430054+2\cdot17=4396{,}430054.
Adım 7 — ML ve köşegen yapı. ML: \ell=-2167{,}362692; ana düzeyi tarsus varyansı 0,224062. Köşegen yapı (REML): \ell_R=-2186{,}976260, parametre sayısı 15. Yapısız ve köşegen modeller aynı sabit etkileri taşıdığından REML olabilirlik oranıyla karşılaştırılabilir:
İki gruplama düzeyindeki yanıtlar arası kovaryanslar birlikte sıfırdan farklıdır.
17.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–3 ve 5).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| REML sabit etki: tarsus | −0,40791046 | −0,40791046 | −0,40791045 | 1,1e−8 | ✓ |
| REML sabit etki: back | −0,01228491 | −0,01228491 | −0,0122849 | 8,5e−9 | ✓ |
| REML sabit etki: tarsus:sexMale | 0,77089544 | 0,77089544 | 0,77089545 | 6,2e−9 | ✓ |
| REML sabit etki: back:sexMale | 0,00824756 | 0,00824756 | 0,00824754 | 1,7e−8 | ✓ |
| REML sabit etki: tarsus:sexUNK | 0,22959896 | 0,22959896 | 0,22959883 | 1,4e−7 | ✓ |
| REML sabit etki: back:sexUNK | 0,15360385 | 0,15360385 | 0,15360379 | 5,9e−8 | ✓ |
| REML sabit etki: tarsus:hatchdate | −0,04289386 | −0,04289386 | −0,04289384 | 2,3e−8 | ✓ |
| REML sabit etki: back:hatchdate | −0,09071758 | −0,09071758 | −0,09071757 | 9,8e−9 | ✓ |
| REML SH: tarsus | 0,06779986 | 0,06779986 | — | 5,1e−9 | ✓ |
| REML SH: back | 0,06436789 | 0,06436787 | — | 1,2e−8 | ✓ |
| REML SH: tarsus:sexMale | 0,05697722 | 0,05697722 | — | 2,6e−9 | ✓ |
| REML SH: back:sexMale | 0,06679091 | 0,06679091 | — | 6,5e−10 | ✓ |
| REML SH: tarsus:sexUNK | 0,12730583 | 0,12730584 | — | 1,2e−9 | ✓ |
| REML SH: back:sexUNK | 0,14877156 | 0,14877156 | — | 8,2e−10 | ✓ |
| REML SH: tarsus:hatchdate | 0,05749301 | 0,057493 | — | 1,1e−8 | ✓ |
| REML SH: back:hatchdate | 0,05147778 | 0,05147778 | — | 2,3e−9 | ✓ |
| REML z: tarsus:sexMale | 13,52988875 | 13,52988813 | — | 4,6e−8 | ✓ |
| REML p: back:hatchdate | 0,07802425 | 0,07802426 | — | 1,4e−8 | ✓ |
| REML kovaryans: dam (tarsus, tarsus) | 0,22922787 | 0,22922787 | 0,22922808 | 2,1e−7 | ✓ |
| REML kovaryans: dam (tarsus, back) | −0,06906226 | −0,06906227 | −0,0690621 | 1,6e−7 | ✓ |
| REML kovaryans: dam (back, back) | 0,06947094 | 0,06947094 | 0,06947111 | 1,7e−7 | ✓ |
| REML kovaryans: fosternest (tarsus, tarsus) | 0,06997514 | 0,06997514 | 0,06997489 | 2,4e−7 | ✓ |
| REML kovaryans: fosternest (tarsus, back) | 0,07423521 | 0,07423521 | 0,07423518 | 2,5e−8 | ✓ |
| REML kovaryans: fosternest (back, back) | 0,11571141 | 0,11571141 | 0,11571134 | 7,0e−8 | ✓ |
| REML kovaryans: Artık (tarsus, tarsus) | 0,5676132 | 0,56761321 | 0,56761323 | 3,4e−8 | ✓ |
| REML kovaryans: Artık (tarsus, back) | −0,03695479 | −0,03695479 | −0,03695506 | 2,7e−7 | ✓ |
| REML kovaryans: Artık (back, back) | 0,80442712 | 0,80442713 | 0,80442711 | 1,4e−8 | ✓ |
| REML korelasyon: dam | −0,54727488 | −0,54727488 | −0,54727265 | 2,2e−6 | ✗ |
| REML korelasyon: fosternest | 0,82499242 | 0,82499243 | 0,82499383 | 1,4e−6 | ✗ |
| REML korelasyon: Artık | −0,05468914 | −0,05468914 | −0,05468954 | 4,0e−7 | ✓ |
| REML varyans oranı: dam, tarsus | 0,26444807 | 0,26444807 | — | 1,4e−10 | ✓ |
| REML varyans oranı: fosternest, tarsus | 0,08072661 | 0,08072661 | — | 1,2e−10 | ✓ |
| REML varyans oranı: Artık, tarsus | 0,65482532 | 0,65482532 | — | 2,6e−10 | ✓ |
| REML log-olabilirliği | −2181,21502718 | −2181,21502702 | −2181,21502702 | 7,2e−11 | ✓ |
| AIC (REML) | 4396,43005435 | 4396,43005404 | — | 7,1e−11 | ✓ |
| ML log-olabilirliği | −2167,36269043 | −2167,36269186 | −2167,36269186 | 6,6e−10 | ✓ |
| ML kovaryans: dam (tarsus, tarsus) | 0,22406217 | 0,22406217 | 0,22406179 | 3,8e−7 | ✓ |
| ML kovaryans: Artık (back, back) | 0,80240801 | 0,80240802 | 0,80240796 | 4,9e−8 | ✓ |
| ML SH: tarsus | 0,06726619 | 0,06726619 | — | 1,1e−11 | ✓ |
| Köşegen yapı: REML log-olabilirliği | −2186,976259 | −2186,9762598 | −2186,9762598 | 3,7e−10 | ✓ |
| Köşegen yapı: dam (tarsus, tarsus) | 0,21788014 | 0,21788014 | 0,21788024 | 9,7e−8 | ✓ |
| Köşegen yapı: fosternest (back, back) | 0,12382738 | 0,12382738 | 0,12382735 | 3,5e−8 | ✓ |
| Köşegen yapı: Artık (tarsus, back) | −0,03478842 | −0,03478842 | −0,03478869 | 2,7e−7 | ✓ |
| Dengeli: \hat\Sigma_u (tarsus, tarsus) | 0,22713337 | 0,22713337 | 0,22713337 | 9,0e−10 | ✓ |
| Dengeli: \hat\Sigma_u (tarsus, back) | 0,01777258 | 0,01777258 | 0,01777258 | 3,3e−10 | ✓ |
| Dengeli: \hat\Sigma_u (back, back) | 0,17360329 | 0,17360329 | 0,17360329 | 1,8e−9 | ✓ |
| Dengeli: \hat\Sigma_e (tarsus, tarsus) | 0,75725553 | 0,75725554 | 0,75725554 | 1,5e−8 | ✓ |
| Dengeli: \hat\Sigma_e (tarsus, back) | −0,04950898 | −0,04950898 | −0,04950898 | 1,5e−10 | ✓ |
| Dengeli: \hat\Sigma_e (back, back) | 0,87800004 | 0,87800006 | 0,87800006 | 1,5e−8 | ✓ |
| Dengeli: ortalama (tarsus) | −0,0248858 | −0,0248858 | −0,0248858 | 3,8e−17 | ✓ |
| Dengeli: ortalama (back) | 0,01826161 | 0,01826161 | 0,01826161 | 5,9e−17 | ✓ |
| Dengeli: REML log-olabilirliği | −1329,22882601 | −1329,22882626 | — | 1,8e−10 | ✓ |
Ölçütü karşılayan: 50/52. Python: REML/ML olabilirliğinin açık formülü, analitik gradyanlı BFGS ve Newton cilası (gradyan < 10⁻¹²); SH sütunu (\mathbf X^{\top}\mathbf V^{-1}\mathbf X)^{-1}+\mathbf J\boldsymbol\Sigma_\theta\mathbf J^{\top}. R: lme4::lmer (uzun biçim, \mathbf S_e=\mathbf S_{\text{birey}}+\sigma^2\mathbf I); dengeli tasarımda her iki dilde kapalı biçim MANOVA kestiricileri. ✗ satırlarında Python ile R birbirine 10^{-6} içinde yakındır; fark, şablonun eniyilemesinin durduğu noktadan gelir (17.6.1).
Şablonun değerleri bağımsız Python çözümüyle bütün satırlarda 10^{-6} ölçütünün içinde, çoğunda 10^{-8} düzeyinde aynıdır. İki ✗ satırında (ana ve yuva düzeyi korelasyonları) şablon ile Python 3\times10^{-9} içinde eşittir; ölçütü aşan fark R sütunundadır: lme4'ün eniyileyicisi düz olabilirlikte tepeye altıncı basamakta varır (2\times10^{-6}). Şablonun eniyileyici seçeneği (nlminb / BFGS) sonucu değiştirmez: inceltmeden sonra iki seçenek aynı noktaya ulaşır (ana düzeyi sırt rengi varyansı ikisinde de 0,06947094). Dengeli tasarımda kapalı biçimin değerleri kesindir; şablon onlardan en çok 4\times10^{-9} göreli ayrışır.
MCMC yolu rastgele örneklemeye dayandığından bu tabloya alınmamıştır; aynı tohumla iki çalıştırma bit düzeyinde aynı sonucu verir (17.7).
17.7 Çıktıyı okuma
Örnek ayarda konsol metni:
n = 828 birey, 2 yanıt (tarsus, back); gruplar: dam, fosternest; yöntem REML
Yanıta özgü sabit etkiler (REML)
| terim | kestirim | SH | z | p |
|---|---|---|---|---|
| tarsus | −0,4079 | 0,0678 | −6,016 | 1{,}8\times10^{-9} |
| back | −0,0123 | 0,0644 | −0,191 | 0,849 |
| tarsus:sexMale | 0,7709 | 0,0570 | 13,530 | 1{,}0\times10^{-41} |
| back:sexMale | 0,0082 | 0,0668 | 0,123 | 0,902 |
| tarsus:sexUNK | 0,2296 | 0,1273 | 1,804 | 0,071 |
| back:sexUNK | 0,1536 | 0,1488 | 1,032 | 0,302 |
| tarsus:hatchdate | −0,0429 | 0,0575 | −0,746 | 0,456 |
| back:hatchdate | −0,0907 | 0,0515 | −1,762 | 0,078 |
Kovaryans matrisleri (kaynak × yanıt çifti) ve Varyans oranları
| kaynak | (tarsus, tarsus) | (tarsus, back) | (back, back) | korelasyon | oran: tarsus | oran: back |
|---|---|---|---|---|---|---|
| dam | 0,2292 | −0,0691 | 0,0695 | −0,547 | 0,264 | 0,070 |
| fosternest | 0,0700 | 0,0742 | 0,1157 | 0,825 | 0,081 | 0,117 |
| Artık (birey içi) | 0,5676 | −0,0370 | 0,8044 | −0,055 | 0,655 | 0,813 |
Model uyumu: n 828; yanıt sayısı 2; REML logLik −2181,2150; AIC 4396,4301; parametre 17.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
tarsus, back satırları |
Referans düzeyde (Fem), sayısal açıklayıcılar 0 iken yanıt ortalaması | Ortak bir kesişim yoktur; her yanıtın kendi ortalaması vardır. |
yanıt:terim satırları |
Açıklayıcının o yanıt üzerindeki etkisi | Erkeklerin tarsusu dişilerden 0,77 SS uzundur; sırt renginde cinsiyet farkı yoktur. |
| Kovaryans tablosu | Her kaynak için matrisin üst üçgeni; aynı yanıt çiftinde korelasyon 1 | Köşegen satırlar varyans, karışık satır kovaryanstır. |
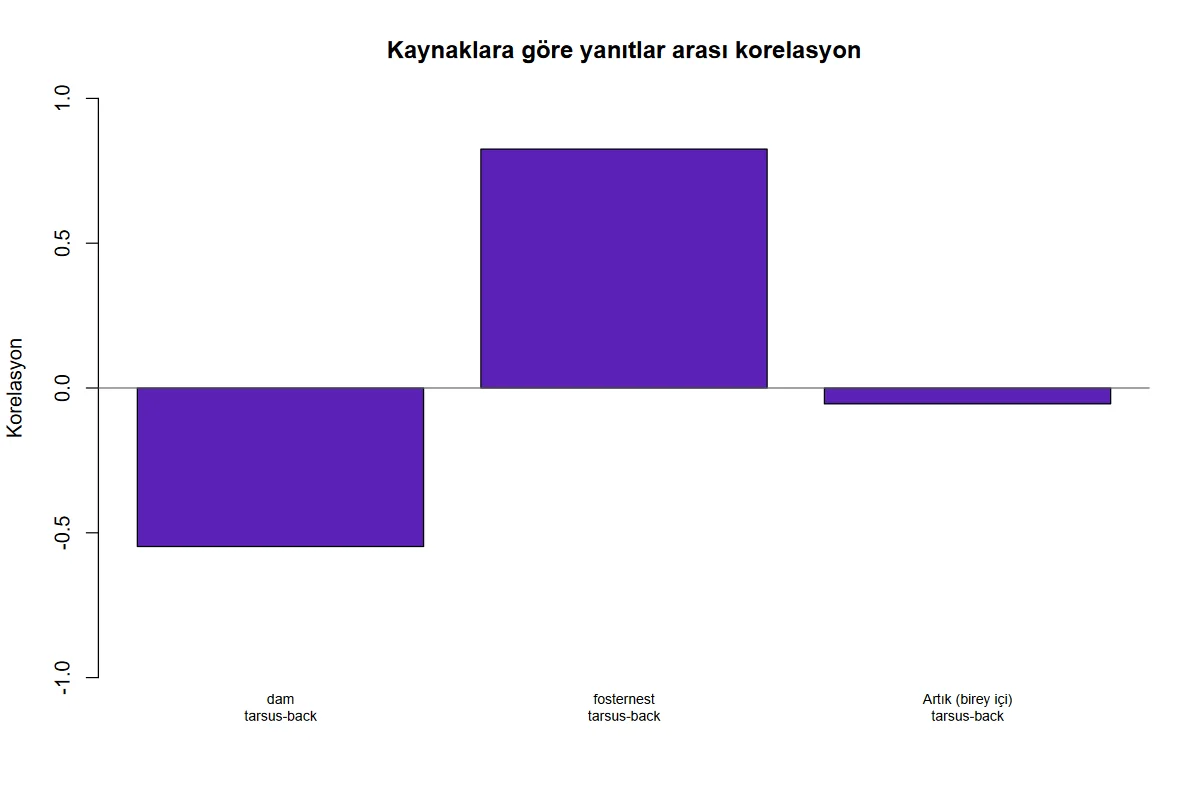
| korelasyon | Kaynağa özgü yanıtlar arası korelasyon | Ana düzeyinde −0,55 (uzun tarsuslu ailelerde sırt rengi değeri düşük), yuva düzeyinde +0,82 (iyi yuva her ikisini artırır), birey içinde yaklaşık 0. |
| Varyans oranları | Kaynağın o yanıttaki payı | Tarsus varyansının %26'sı anaya, %8'i yuvaya bağlıdır; sırt renginde %7 ve %12. |
| REML logLik, AIC, parametre | Ölçüt, bilgi ölçütü, p+m | Aynı sabit etkili modeller karşılaştırılır (17.4.5). |
| "Uyarılar:" satırı | Eniyileyici ya da Hessian uyarıları | Sınır çözümü ya da düz olabilirlik belirtisidir; kovaryanslar ihtiyatla yorumlanır. |
Ham korelasyonun sıfıra yakın olması (-0{,}033), iki yanıtın ilişkisiz olduğu anlamına gelmez: ana düzeyinde negatif, yuva düzeyinde pozitif iki bileşen birbirini götürmektedir. Çok yanıtlı karma modelin tek yanıtlı çözümlere eklediği bilgi budur.
Şekil 17.1. Şablonun çizdiği, kaynaklara göre yanıtlar arası korelasyon (örnek ayar, REML): ana −0,55, yuva +0,82, birey içi −0,05.
MCMC yolu. Başlık "Yanıta özgü sabit etkiler (sonsal, %95 HPD)" olur; sütunlar sonsal_ortalama, sonsal_SS, HPD_alt, HPD_ust, ESS. Ek tablo "(Ko)varyans bileşenleri: sonsal ortalama ve %95 HPD" her matrisin üst üçgenini kaynak, yanit1, yanit2 sütunlarıyla listeler (her öğe bir kez; köşegen yapıda yalnız varyanslar). "Yanıtlar arası korelasyonlar: sonsal ortalama ve %95 HPD" tablosu her kaynak için korelasyonun sonsal ortalamasını, HPD aralığını ve ESS'sini verir: örnek ayarın kısa zincirinde ana düzeyi −0,257 [−0,550; 0,068], yuva düzeyi 0,297 [−0,014; 0,628], artık −0,051 [−0,138; 0,015]. Uyum tablosunda log-olabilirlik ve AIC yerine DIC ve saklanan örnek sayısı bulunur. Aynı veri üç yolla:
| Büyüklük | REML | MCMC (13000 / 3000 / 10) | MCMC (60000 / 10000 / 25) |
|---|---|---|---|
| tarsus:sexMale | 0,7709 (SH 0,0570) | 0,7630 (SS 0,0561) | 0,7690 (SS 0,0580) |
| dam (tarsus, tarsus) | 0,2292 | 0,2325 [0,149; 0,331] | 0,2345 |
| dam (back, back) | 0,0695 | 0,1187 [0,063; 0,189] | 0,1206 |
| dam (tarsus, back) | −0,0691 | −0,0427 [−0,099; 0,014] | −0,0439 |
| fosternest (tarsus, tarsus) | 0,0700 | 0,1225 [0,069; 0,189] | 0,1234 |
| fosternest (tarsus, back) | 0,0742 | 0,0394 [−0,011; 0,086] | 0,0407 |
| Artık (back, back) | 0,8044 | 0,7959 [0,710; 0,874] | 0,7991 |
| Korelasyon: dam | −0,547 | −0,257 | −0,261 |
| Korelasyon: fosternest | 0,825 | 0,296 | 0,306 |
| DIC | — | 4240,94 | 4240,97 |
Köşeli ayraçlar %95 HPD aralığıdır. Aynı tohumla (20261116) yinelenen çalıştırma aynı sayıları verir; tohum verilmediğinde kovaryanslar üçüncü ondalıkta değişir (en büyük fark 0,0023). İki zincir uzunluğu birbirine yakındır: REML ile fark zincirin kısalığından değil, tanımdan ve önselden gelir (17.9 S5).
Rapor cümlesi (örnek ayar):
Tarsus uzunluğu ve sırt rengi, genetik ana ve büyüme yuvası için yapısız kovaryanslı rastgele etkiler içeren iki yanıtlı doğrusal karma modelle birlikte çözümlendi (REML; n = 828). Erkeklerin tarsusu dişilerinkinden uzundu (b = 0{,}77; SH = 0{,}06; z = 13{,}53; p < 0{,}001); sırt renginde cinsiyet farkı yoktu (b = 0{,}01; p = 0{,}90). İki özellik arasındaki korelasyon ana düzeyinde -0{,}55, yuva düzeyinde 0{,}82 ve birey içinde -0{,}05 kestirildi. Tarsus varyansının %26'sı anaya, %8'i yuvaya; sırt rengi varyansının %7'si anaya, %12'si yuvaya bağlıydı. Gruplama düzeyindeki kovaryansların sıfır olduğu model anlamlı biçimde daha kötü uyum gösterdi (\chi^2(2) = 11{,}52; p = 0{,}003).
17.8 Sık hatalar ve tuzaklar
- Sabit etkilerden biri yanıtlardan biriyle aynı bilgiyi taşıyorsa. Model yanıtı kendisiyle açıklar; katsayı 1, varyanslar sıfıra yakın çıkar. Log-olabilirlik sonlu değilse şablon durur; standart hatalar hesaplanamıyorsa uyarı yazar. Sütun adları sorun değildir:
value,trait,unitsadlı sütunlar öteki sütunlar gibi kullanılabilir. - Sayısal bir açıklayıcıyı "kategorik" türde bırakmak.
hatchdatekategorik türdeyse 18 düzeyli faktör olur; tek eğim yerine yanıt başına 17 gösterge katsayısı kestirilir (parametre sayısı 17'den 49'a çıkar) ve eniyileyici yakınsama uyarısı verir. Yanıtlar sayısal role atandığı için türü "kategorik" olsa da değerleriyle aktarılır (Bölüm 1.3). - Yöntemi yalnız tablo başlığından okumak. Özet satırı kestirim yöntemini yazar: REML, ML ya da MCMC. Aynı bilgi sabit etkiler tablosunun başlığında ("(REML)" / "(ML)") ve uyum tablosundaki "REML logLik" / "ML logLik" satırındadır.
- "en büyük |gradyan|" satırına bakmamak. Düz olabilirlikte eniyileyici tepeye varmadan durabilir; şablon kestirimi Newton adımlarıyla inceltir ve son gradyanı uyum tablosuna yazar. Değer 10^{-6} dolayında ya da daha küçükse kovaryanslar başka yazılımlarla altı–yedi basamak karşılaştırılabilir; büyükse (uyarı çıkar) son basamaklara güvenilmez.
- MCMC ile REML korelasyonlarını aynı büyüklük saymak. MCMC yolundaki korelasyon, zincirin her örneğinde hesaplanan korelasyonun sonsal ortalamasıdır; REML'deki değer olabilirliğin tepe noktasındaki orandır. Korelasyonun HPD aralığı sıfırı içeriyorsa (örnekte ana düzeyi: [−0,550; 0,068]) işareti de belirsizdir.
- Önseli ölçeği düşünmeden kullanmak. \mathbf V=\mathbf I önseli yanıtların birimine bağlıdır ve standart sapması 1'e yakın yanıtlar için uygundur. Örnek verinin yanıtları 10'a bölündüğünde (SS ≈ 0,1) ana düzeyi tarsus varyansı özgün birimde 0,23 yerine 1,66 çıkar ve korelasyon sıfıra çöker: önsel veriyi bastırır. Şablon MCMC yolunda herhangi bir yanıtın standart sapması 0,3'ten küçük ya da 3'ten büyükse yanıtı ve SS'sini yazan bir uyarı verir (satır 187–190); böyle yanıtlar önce standartlaştırılır ya da REML yolu kullanılır.
- Kısa zincirle yetinmek ve ESS'ye bakmamak. Örnek ayarın 1000 saklanan örneği tanıtım içindir. Raporlanacak çözümlemede varsayılan (2000 örnek) ya da daha uzun zincir kullanılır; ESS birkaç yüzün altındaysa
thinvenittartırılır. - Tohum vermeden MCMC raporlamak. Sonuç yeniden üretilemez; tohum kaydedilir.
- Bir yanıtı eksik bireyleri kaybetmek. Eksik satırlar birey bütünüyle atılır. Yanıtlardan biri çok eksikse örneklem o yanıtın gözlendiği bireylere iner.
- Çok düzeyli gruplamada q'yu büyütmek. Her gruplama q(q+1)/2 parametre ekler: dört yanıt ve iki gruplamada 30 kovaryans parametresi. Küme sayısı az iken matrisler sınırda (tekil) kestirilir ve "Hessian pozitif tanımlı değil" uyarısı çıkar; köşegen yapı ya da daha az yanıt denenir.
17.9 Uzman soruları
S1. Artık kovaryansı neden birey düzeyinde rastgele etki olarak kuruluyor; bu bir yaklaşım mı?
Değil. \boldsymbol\Sigma_e\otimes\mathbf I_n terimi, her bireye q boyutlu yapısız bir rastgele etki verip gözlem hatasını sıfırlamakla aynı \mathbf V matrisini üretir. glmmTMB gözlem hatasının standart sapmasını dispformula = ~0 ile çok küçük bir sabite (\sqrt{\varepsilon_{\text{makine}}}\approx1{,}5\times10^{-8}) bağlar; olabilirlik üzerindeki etkisi 10^{-9} göreli düzeydedir. Bağımsız hesap \mathbf V'yi doğrudan Kronecker biçiminde kurar ve aynı log-olabilirliği bulur (-2181{,}215027'ye karşı -2181{,}215025).
S2. Standart hatalar neden (\mathbf X^{\top}\hat{\mathbf V}^{-1}\mathbf X)^{-1}'in karekökünden büyük?
Şablonun SH'si glmmTMB'nin ortak Hessian'dan ürettiği kovaryanstır ve varyans parametrelerinin kestirilmiş olmasından gelen \mathbf J\hat{\boldsymbol\Sigma}_\theta\mathbf J^{\top} terimini içerir (17.4.3). Örnek veride fark %0,04–0,57 arasındadır; en büyük fark 47 bireylik UNK düzeyinin katsayılarındadır. İki terimli ifade bağımsız olarak hesaplandığında şablonun SH'siyle 10^{-6} içinde aynıdır. Bu, Kenward-Roger düzeltmesiyle aynı şey değildir: orada kovaryansın yanlılığı düzeltilir ve sd kestirilir; burada yalnız delta yöntemi eklentisi vardır, test yine z'dir.
S3. Bu modelin REML log-olabilirliği başka karma model yazılımlarının değeriyle karşılaştırılabilir mi?
Evet; ölçüt 17.4.2'deki ifadedir ve sabit (N-p)\log2\pi'yi içerir. lme4 ile kurulan eşdeğer model aynı değeri verir (-2181{,}215027). Karşılaştırmada dikkat edilecek iki nokta: bazı uygulamalar -2\ell_R raporlar (4362,43); AIC'de sayılan parametre sayısı uygulamaya göre 9 ya da 17'dir (17.4.5).
S4. Yapısız yerine köşegen yapı ne zaman seçilir ve iki model nasıl karşılaştırılır?
Köşegen yapı, gruplama düzeyinde yanıtların ilişkisiz olduğu varsayımıdır; küme sayısı kovaryansı kestirmeye yetmiyorsa ya da yapısız model sınırda kalıyorsa kullanılır. İki model aynı sabit etkileri taşıdığından REML olabilirlik oranı geçerlidir: örnekte \chi^2=11{,}52, sd 2 (gruplama başına bir kovaryans), p=0{,}003. Sıfır kovaryans parametre uzayının sınırında olmadığından (kovaryans negatif de olabilir) \chi^2 dağılımı burada düzeltme gerektirmez; varyansın sıfır olduğu sınanırken durum farklıdır.
S5. MCMC sonuçları REML'den neden bu kadar farklı (ana düzeyi korelasyon −0,55'e karşı −0,26)?
Üç neden birlikte işler. (i) Tanım: REML olabilirliğin tepe noktasını, MCMC sonsal ortalamayı verir; varyansların sonsalı sağa çarpıktır ve ortalaması tepe noktasından büyüktür. (ii) Önsel: \mathcal{IW}(\mathbf I,\,1{,}002) her gruplamanın kareler toplamına birim matris kadar ekleme yapar; yaklaşık 105 düzeyli gruplamada bu varyans başına 0,01 dolayındadır ve 0,07 büyüklüğündeki bir varyans için küçümsenemez; ayrıca kovaryansları sıfıra çeker. (iii) Düz olabilirlik: ana ve yuva kısmen örtüştüğünden veri bu bileşenleri zayıf ayırır, önselin ve çarpıklığın payı büyür. Zinciri uzatmak sonucu değiştirmez (−0,257'ye karşı −0,261). Hangi değerin raporlanacağı çözümleme çerçevesine bağlıdır; ikisi aynı cümlede karşılaştırılmaz.
S6. Önselin derecesi neden q-1+0{,}002?
Ters Wishart dağılımı \nu>q-1 için tanımlıdır; \nu=q-1+0{,}002 bu sınırın hemen üstündedir ve her varyansın marjinal önseli şekil parametresi 0,001 olan ters gama dağılımıdır (tek yanıtlı modellerde yaygın kullanılan zayıf önselin çok değişkenli karşılığı). Form alanı bu eklentiyi değiştirir: \nu_0=2 (\nu=q+1) korelasyonlara marjinal olarak düzgün dağılım veren seçimdir ve küçük küme sayısında daha kararlıdır. \nu_0=0 dağılımı tanımsız yapar.
S7. Dengeli tasarımda şablonun sonucu kapalı biçimle tam aynı mı?
Altıncı basamağa kadar. Kapalı biçim \hat{\boldsymbol\Sigma}_u=(\mathbf B-\mathbf W)/k kesin REML çözümüdür; şablon 0,227137 (kapalı biçim 0,227133) ve 0,757251 (0,757256) verir. Fark eniyileyicinin durma ölçütünden gelir; log-olabilirlikler 10^{-9} göreli düzeyde aynıdır (-1329{,}228825'e karşı -1329{,}228826).
S8. Ana düzeyi matris "genetik kovaryans" diye yorumlanabilir mi?
Bu veride tam olarak değil. dam rastgele etkisi, aynı anadan gelen yavruların ortak payını ölçer: toplamsal genetik varyansın bir bölümünü (tam kardeşlerde yarısını), baskınlık payını ve yumurta yoluyla taşınan anaya bağlı etkileri birlikte içerir. Toplamsal genetik kovaryans matrisi için soy ağacına dayalı "hayvan modeli" gerekir; MCMCglmm bunu pedigree bağımsız değişkeniyle kurar, bu şablonun formu ise akrabalık matrisi almaz. Çapraz evlat edindirme tasarımının sağladığı, ana etkisini büyüme ortamından (yuva) ayırmaktır.
17.10 Kaynaklar
- Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- Hadfield, J. D. (2010). MCMC methods for multi-response generalized linear mixed models: The MCMCglmm R package. Journal of Statistical Software, 33(2), 1–22. https://doi.org/10.18637/jss.v033.i02
- Hadfield, J. D., Nutall, A., Osorio, D., & Owens, I. P. F. (2007). Testing the phenotypic gambit: Phenotypic, genetic and environmental correlations of colour. Journal of Evolutionary Biology, 20(2), 549–557. https://doi.org/10.1111/j.1420-9101.2006.01262.x
- Kristensen, K., Nielsen, A., Berg, C. W., Skaug, H., & Bell, B. M. (2016). TMB: Automatic differentiation and Laplace approximation. Journal of Statistical Software, 70(5), 1–21. https://doi.org/10.18637/jss.v070.i05
- Patterson, H. D., & Thompson, R. (1971). Recovery of inter-block information when block sizes are unequal. Biometrika, 58(3), 545–554. https://doi.org/10.1093/biomet/58.3.545
- Plummer, M., Best, N., Cowles, K., & Vines, K. (2006). CODA: Convergence diagnosis and output analysis for MCMC. R News, 6(1), 7–11.
- Searle, S. R., Casella, G., & McCulloch, C. E. (1992). Variance components. Wiley. https://doi.org/10.1002/9780470316856
- Spiegelhalter, D. J., Best, N. G., Carlin, B. P., & van der Linde, A. (2002). Bayesian measures of model complexity and fit. Journal of the Royal Statistical Society: Series B, 64(4), 583–639. https://doi.org/10.1111/1467-9868.00353