143. Cezalı Cox regresyonu: lasso ve elastik ağ
Şablon kimliği: cezali_cox · Kategori: sağkalım · Dil: R · Dosya: pro/sablonlar/sagkalim/cezali_cox.R (satır 1–291; üstbilgi 1–146) · Örnek veri: _ornek/cezali_cox_coxexample.csv · Paketler: glmnet 5.1, survival 3.8-6
143.1 Ne işe yarar
Şablon, çok sayıda aday öngörücüyle (öngörücü sayısı p büyük, hatta gözlem sayısından büyük) bir sağkalım modeli kurar ve hangi öngörücülerin modelde kalacağını ceza ile seçer. Kısmi olabilirlik, katsayıların büyüklüğüne konan bir cezayla birlikte en büyütülür (Tibshirani, 1997; Simon vd., 2011). Cevapladığı soru: "Yüzlerce aday değişken arasından, sansürlü sağkalım süresini öngörmeye yetecek en az değişken kümesi hangisi ve her birinin tehlike oranı kaç?" Örnekte (glmnet vinyetinin CoxExample verisi, n=1000, p=30) otuz adaydan sekizi seçilir.
Ceza, katsayıların standartlaştırılmış ölçeğinde şu biçimdedir:
\alpha=1 lassodur (bazı katsayıları tam sıfıra indirir: değişken seçer), 0<\alpha<1 elastik ağdır (Zou ve Hastie, 2005: ilişkili değişkenleri birlikte tutar), \alpha=0 sırt (ridge) regresyonudur (Hoerl ve Kennard, 1970: hiçbir katsayıyı sıfırlamaz, yalnız küçültür). Ceza şiddeti \lambda çapraz doğrulamayla seçilir.
Ne zaman kullanılır?
- Aday öngörücü sayısı olay sayısına yakın ya da ondan fazladır; olağan Cox modeli kurulamaz ya da aşırı uyum yapar.
- Amaç öngörü ve değişken seçimidir (ör. gen ifadesi, laboratuvar paneli, çok sayıda kovaryat); katsayıların kendisi değil, hangi değişkenlerin önemli göründüğü ve ayırma gücü (C-indeksi) istenir.
- Öngörücüler birbiriyle ilişkiliyse ve hepsini küçülterek tutmak isteniyorsa sırt ya da elastik ağ.
Ne zaman kullanılmaz?
- Küçük sayıda önceden belirlenmiş değişkenle nedensel bir etki kestirilecekse: temel programdaki Cox modeli. Cezalı katsayılar yanlıdır (sıfıra doğru küçülür) ve şablon standart hata ya da p değeri vermez.
- Öngörücülerin etkisi zamanla değişiyorsa (orantılı tehlike varsayımı bozuksa):
kesikli_zaman_sagkalim(Bölüm 149) ya daesnek_parametrik(Bölüm 146); bu şablon orantılı tehlikeyi sınamaz. - Kümelenmiş ya da merkez etkili veri:
karma_etkili_cox(Bölüm 148); aynı bireyde yinelenen olay:yineleyen_olay(Bölüm 154). - Zamana bağlı bir tanılama ölçüsü (zamana bağlı ROC, kalibrasyon) isteniyorsa:
zamana_bagli_rocveklinik_tahmin(Bölüm 155 ve 150); şablonun C-indeksi uygulama verisindeki (iyimser) tek sayıdır. - Kategorik öngörücü varsa: önce 0/1 göstergelere çevrilmelidir; şablon yalnız sayısal sütun kabul eder (143.8).
Temel programla ilişki. Temel programda Cox regresyonu cezasızdır ve değişken seçimi (adım adım) ayrıca yapılır; lasso, elastik ağ ve çapraz doğrulamayla \lambda seçimi yalnız MerQuR+'tadır. Cezasız model, şablonun karşılaştırma tablosunda aynı veriyle verilir (143.4.5).
143.2 Şablonun girdileri
Form on yedi [[param]] bloğundan kurulur (cezali_cox.R:10–145). Türlerin ve formun ortak denetiminin anlamı Bölüm 1.2'de anlatılmıştır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Takip süresi · zaman |
sayısal sütun · Değişkenler | yok (zorunlu) | pozitif sayılar | T (10–15, 158, 160). |
Durum · durum |
sayısal sütun · Değişkenler | yok (zorunlu) | yalnız 0 ve 1 | \delta (16–21, 158, 161). |
Aday öngörücüler · ongoruculer |
sütunlar (sayısal) · Değişkenler | yok (en az 2) | sayısal sütunlar | X (22–29, 152, 165). |
α karışım parametresi · alfa |
ondalık · Model | 1,0 | 0–1 | glmnet(alpha =) (30–38, 175, 189). |
Raporlanan λ · lambda_secimi |
seçim · Model | lambda.1se |
lambda.1se, lambda.min |
Seçilen değişken ve C-indeksi bu λ'da (39–46, 179, 196). |
Sabit λ · lambda_sabit |
ondalık · Model | 0,0 (kullanma) | \ge0 | Ek tablo (47–54, 220, 239–246). |
Çapraz doğrulama ölçütü · olcut |
seçim · Seçenekler | deviance |
deviance, C |
type.measure (55–62, 178, 194). |
Kat sayısı · kat_sayisi |
tamsayı · Seçenekler | 10 | 3–50 | nfolds (63–71, 163, 194). |
Bağ yöntemi · baglar |
seçim · Seçenekler | breslow |
breslow, efron |
cox.ties; cezasız model de aynı yöntemle (72–79, 177, 189, 224). |
Standartlaştır · standartlastir |
onay · Seçenekler | açık | açık/kapalı | standardize (80–86, 183, 189). |
λ dizisinin en çok uzunluğu · lambda_sayisi |
tamsayı · Gelişmiş | 100 | 10–1000 | nlambda, üst sınır; hesaplanan λ sayısı çıktıya yazılır (87–95, 184, 189, 207–211). |
En küçük λ / en büyük λ · lambda_oran |
ondalık · Gelişmiş | 0,0 (otomatik) | 0–0,99 | lambda.min.ratio; otomatik: n>p ise 10^{-4}, değilse 10^{-2} (96–104, 180–182). |
Gruplu ÇD sapması · gruplu |
onay · Gelişmiş | açık | açık/kapalı | grouped (105–111, 198). |
Yakınsama eşiği üssü · esik_us |
tamsayı · Gelişmiş | 7 | 2–12 | thresh = 10^{-k} (112–120, 190). |
En çok yineleme · en_cok_yineleme |
tamsayı · Gelişmiş | 100000 | 100–10 000 000 | maxit (121–129, 191). |
Rastgele tohum (kat ataması; 0 = çalıştırmanın tohumu) · tohum |
tamsayı · Gelişmiş | 1 | 0–2 147 483 647 | set.seed (130–138, 193–195). |
Cezasız modeli göster · cezasiz_goster |
onay · Çıktı | açık | açık/kapalı | Karşılaştırma tablosu (139–145, 240). |
Örnek ayar (ornek_param, satır 9): zaman = time, durum = status, ongoruculer = V1…V30; öteki alanlar varsayılandır. Dikkat: vinyet değerleri (0,03356 ve 0,05865) type.measure = "C" ayarıyla ve \lambda=0{,}05 için elde edilir; örnek ayar ise olcut = deviance ile çalışır ve \lambda_{\min}, \lambda_{1se} için 0,01920 ve 0,09338 verir. Üstbilgideki doğrulama notu hangi ayarın hangi değeri verdiğini ayrı ayrı yazar (143.3).
Şablonun kendi denetimleri (hepsi mq_hata ile çalıştırmayı durdurur):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 150 |
| Zaman ve durum aynı sütun | "Zaman ve durum farklı sütunlar olmalı." | 151 |
| Zaman ve durumdan farklı 2'den az öngörücü | "…en az iki öngörücü seçin." | 153 |
| Eksiksiz 20'den az gözlem | "Eksiksiz en az 20 gözlem gerekli." | 159 |
| Süre sonlu değil ya da \le0 | "Takip süreleri pozitif sayılar olmalı (…)" | 160 |
| Durum 0/1 dışında | "Durum yalnız 0 (sansürlü) ve 1 (olay) değerlerini almalı." | 161 |
| Olay sayısı <\max(5,k) | "En az %d olay gerekli (kat sayısı ve kararlı kestirim için); şu an %d." | 164 |
| Sayısal olmayan öngörücü | "Sayısal olmayan öngörücü(ler): …" | 168 |
| Sabit olmayan 2'den az öngörücü | "Sabit olmayan en az iki öngörücü gerekli." | 174 |
| \alpha\notin[0{,}1] | "α 0 ile 1 arasında olmalı." | 176 |
| \lambda oranı \notin[0{,}1) | "λ oranı 0 ile 1 arasında olmalı." | 181 |
glmnet ya da cv.glmnet hata verir |
"Cezalı Cox yolu hesaplanamadı: …", "Çapraz doğrulama yapılamadı: …" | 192, 194 |
Notlar (çalıştırmayı durdurmaz): eksik değerli satırlar sayılarak çıkarılır (157); sabit öngörücüler adlarıyla bildirilip çıkarılır (170–173); seçilen \lambda'da bütün katsayılar sıfırsa "boş model" notu (228–229); sabit \lambda yol aralığının dışındaysa not (258–260); cezasız model kurulamazsa ya da olay sayısı öngörücü sayısından büyük değilse not (249–251); kat ataması tohumu çıktıya yazılır (199); yol istenen \lambda sayısından önce kesilirse hesaplanan sayı ve \lambda aralığı (207–211); olay zamanlarında bağ varsa çapraz doğrulama sapmasının tanımı (212–214); glmnet yakınsama uyarıları çıktının başında (200–206), öteki uyarılar sonda tek satırda (268–269). Form, sayısal rol sütununun metin türünde olmasına izin vermez ve çalıştırmayı "sayısal bir sütun değil" iletisiyle durdurur (Bölüm 1.2).
Tohum. Şablonun kendi formunda bir Tohum alanı vardır ve çapraz doğrulama katlarını bu alan belirler (varsayılan 1). Alan 0 (ya da boş) verilirse kod panelindeki çalıştırma tohumu (mq_tohum) kullanılır, o da yoksa 1: kod set.seed(tohum_) çağırır (193–195) ve kullanılan tohumu çıktıya yazar (199). Alan varsayılanı 1 iken sonuç kod panelindeki tohumdan bağımsızdır (panelde tohum 123 verildiğinde sonuç, alan 1 iken elde edilenle aynıdır: cc_panel_tohum123); alan 0 iken künyedeki tohum sonucu belirler. Sonucu yinelemek için alan 1 ya da pozitif bir sayı olarak, ya da alan 0 iken künyedeki tohum korunmalıdır.
143.3 Örnek veri
cezali_cox_coxexample.csv: glmnet'in CoxExample verisi (Simon vd., 2011; Friedman vd., 2010). 1000 gözlem, 692 olay (308 sansür), eksik değer yok; süre 0,0022 ile 51,70 arasında, ortancası 0,595; 1000 farklı süre değeri vardır, yani bağlı olay zamanı yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
time |
takip süresi | sayısal | 0,0022 – 51,70; ortanca 0,595 |
status |
durum (1 = olay) | ikili (0/1) | 692 olay |
V1 … V30 |
aday öngörücüler | sayısal | ortalamaları 0'a yakın (en çok 0{,}060 mutlak değer), standart sapmaları 0,965–1,042 |
Düzey sırası. Hiçbir öngörücü kategorik değildir. status ikili sayısal sütundur ve sayı olarak aktarılır; metin kodlu durum ("olay"/"sansur") form tarafından kabul edilmez. Sütun adları sıraya göre düzenlenmez: tablolarda öngörücüler katsayının mutlak değerine göre, eğri ve yol tablolarında \lambda'ya göre sıralıdır.
Bu bölümde kullanılan çalıştırmalar: cc_ornek (örnek ayar); cc_min (lambda_secimi = lambda.min); vinyet ayarı cc_C (olcut = C, lambda_sabit = 0,05) ve cc_C_min; cc_sabit05, cc_sabit_disi (\lambda=5), cc_sabit_kucuk (\lambda=10^{-5}); cc_ridge (\alpha=0), cc_enet (\alpha=0{,}5); cc_efron, cc_std_kapali, cc_gruplu_kapali, cc_tohum2, cc_tohum3, cc_panel_tohum123, cc_kat5, cc_nl20, cc_oran, cc_cezasiz_kapali, cc_esik3, cc_esik12, cc_yin5; sınır durumları cc_sifir, cc_neg, cc_kod12, cc_metin, cc_eksik, cc_pn (n=40), cc_sabit (sabit öngörücü), cc_azolay (8 olay), cc_bag ve cc_bag_efron (103 farklı süre, bağlı veri), cc_bag_C, cc_ayrisma (öngörücü = durum), cc_virgul, cc_tamkol (V_2=2V_1+1), cc_kat (metin düzeyli öngörücü), cc_bos (gürültü öngörücüler). Ek veriler veri_uret.py ile türetilmiştir (tohum 11).
143.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (i) veri doğrulanır, eksik satırlar ve sabit sütunlar çıkarılır; (ii) glmnet ile \lambda dizisi boyunca katsayı yolu hesaplanır; (iii) cv.glmnet ile k katlı çapraz doğrulama yapılır ve \lambda_{\min} ile \lambda_{1se} bulunur; (iv) seçilen \lambda'da katsayılar, tehlike oranları ve Harrell C-indeksi yazılır; (v) olay sayısı yeterliyse cezasız Cox modeli kurulup karşılaştırılır; (vi) isteğe bağlı sabit \lambda tablosu; (vii) iki şekil çizilir.
143.4.1 Cezalı kısmi olabilirlik
Süreler t_i, olay göstergeleri \delta_i, öngörücü satırları x_i olsun; R_i=\{j:t_j\ge t_i\} i'nin risk kümesidir. Bağsız veride Cox kısmi log-olabilirliği (Cox, 1972)
ve cezalı amaç işlevi (en küçüklenir)
- n: gözlem sayısı; \ell/n ortalama kısmi log-olabilirlik. Ceza, standartlaştırılmış katsayılar \beta_j^{s}=\beta_j\,s_j üzerindedir (s_j: j. öngörücünün 1/n paydalı standart sapması); özgün ölçekteki katsayı \beta_j=\beta_j^{s}/s_j olarak geri verilir.
- \lambda\ge0: ceza şiddeti. \lambda büyüdükçe katsayılar küçülür; yeterince büyük \lambda'da hepsi sıfırdır.
- \alpha: lasso (\alpha=1) ve sırt (\alpha=0) arasındaki karışım.
Neden standartlaştırma?
Ceza katsayının büyüklüğüne bakar; öngörücü ölçüsü değişince katsayı da değişir. Standartlaştırma olmadan, ölçeği küçük (katsayısı büyük) değişken haksız yere daha çok cezalanır. Açık (standartlastir = true) iken her öngörücü ortalaması 0, standart sapması 1 olacak biçimde ölçeklenip ceza bu ölçekte uygulanır; katsayılar her durumda özgün ölçeğe çevrilir (standardize, 86). Kapatılırsa ceza özgün ölçekte uygulanır ve yalnız öngörücüler zaten karşılaştırılabilir ölçekteyse anlamlıdır. Örnekte standart sapmalar 1'e yakın olduğundan iki ayar yakın sonuç verir (\lambda_{1se} 0,09247 ve 0,09338).
Koddaki tercih: Breslow
baglar = breslow (varsayılan; 75, 189) bağlı olay zamanlarında \log\sum_{j\in R_i}e^{x_j'\beta} terimini her bağlı olay için aynı alır. efron seçilirse Efron yaklaşımı kullanılır: d_t bağlı olay için paydalar \sum_{R_t}e^{\eta}-\tfrac{k}{d_t}\sum_{D_t}e^{\eta}, k=0,\dots,d_t-1 (Efron, 1977; Breslow, 1974). Bağ yoksa ikisi aynıdır (CoxExample'da bağ yoktur: cc_efron ile cc_ornek aynı sonucu verir). glmnet 5.0'ın varsayılanı Breslow'dur; 5.1'de Efron olacağı bildirilmiştir. Şablon seçimi açıkça verdiğinden sonuç sürüme bağlı değildir. Cezasız karşılaştırma modeli aynı bağ yöntemiyle kurulur (242).
143.4.2 λ dizisi ve katsayı yolu
\lambda_{\max}, bütün katsayıların sıfır olduğu en küçük \lambda'dır: standartlaştırılmış ölçekte gradyanın en büyük mutlak değeri,
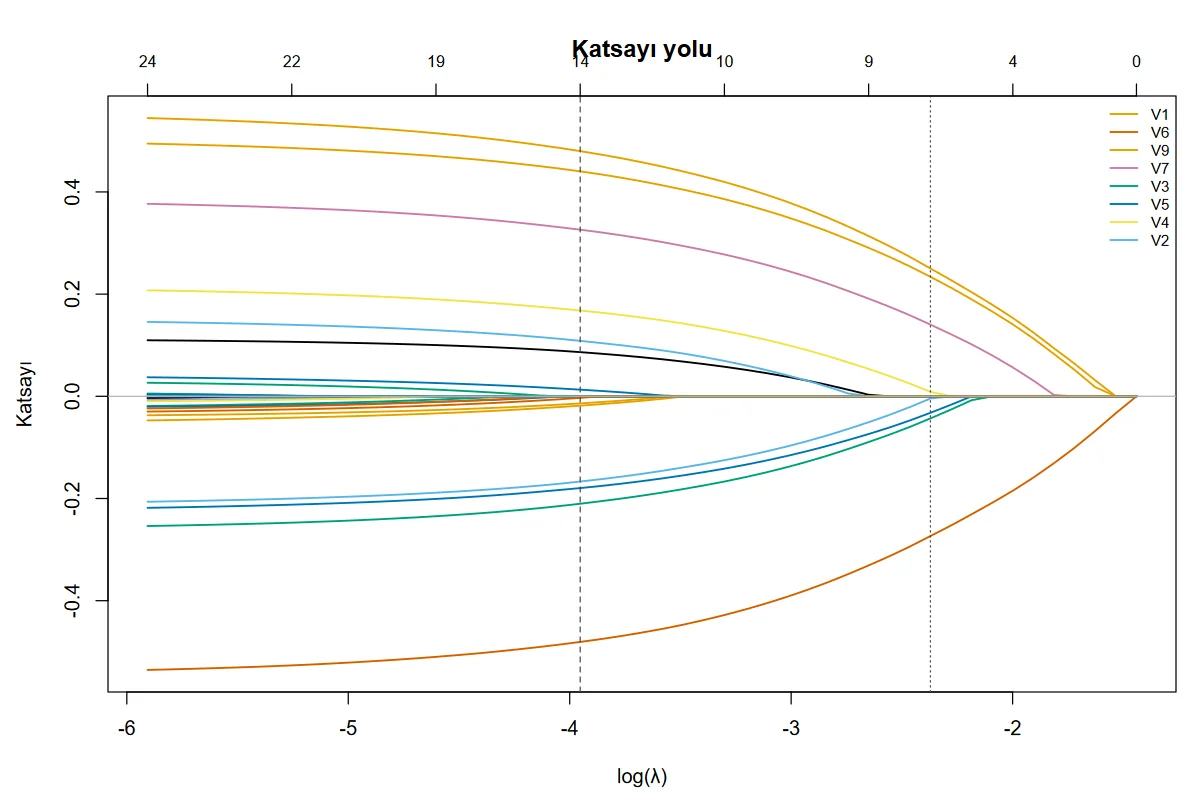
Dizi \lambda_{\max}'tan başlayıp geometrik olarak \lambda_{\max}\cdot r'ye iner; r lambda_oran'dır (0 ise n>p için 10^{-4}, aksi hâlde 10^{-2}; 180–182) ve dizi lambda_sayisi noktadır. \alpha=0 için payda 10^{-3} alındığından sırt yolu çok büyük bir \lambda'dan başlar. Yol, dizinin sonuna varmadan durabilir: glmnet, sapmanın göreli iyileşmesi çok küçüldüğünde ya da açıklanan sapma oranı sınıra vardığında yolu keser. Örnekte 100 noktalık dizinin yalnız 49'u hesaplanır (\lambda 0,2368'den 0,00272'ye; en küçük \lambda'da 24 katsayı sıfırdan farklıdır) ve lambda_sayisi bu nedenle bir üst sınırdır. Koordinat inişi her \lambda'da bir önceki çözümden başlar (sıcak başlangıç) ve katsayı değişimi thresh değerinin altına inince durur (esik_us, 190; en çok en_cok_yineleme yineleme, 191).
143.4.3 Çapraz doğrulama ve λ seçimi
cv.glmnet veriyi tohumla (195) rastgele k kata böler. Her kat \kappa için glmnet, o katın dışındaki verilerde kendi \lambda dizisiyle uydurulur ve tam veri \lambda'larındaki katsayılar komşu iki dizi noktasından \lambda'da doğrusal ara değerle alınır (predict(…, s = λ)). Sapma ölçütünde ve gruplu (gruplu = true) durumda kat \kappa için ham değer
(Verweij ve van Houwelingen, 1993; "çıkarma yöntemi"), çapraz doğrulama sapması \mathrm{cvm}(\lambda)=\sum_\kappa c_\kappa/n ve standart hatası
olur (n_\kappa: kattaki gözlem sayısı). \lambda_{\min} en küçük \mathrm{cvm}'i veren \lambda'dır (eşitlikte en büyüğü); \lambda_{1se}, \mathrm{cvm}\le\mathrm{cvm}_{\min}+\mathrm{cvsd}_{\min} koşulunu sağlayan en büyük \lambda'dır, yani en iyinin bir standart hatası içinde kalan en seyrek modeldir. olcut = C seçilirse her kat için tahmin edilen doğrusal öngörücüyle kat içinde Harrell C hesaplanır ve en büyük ortalama C aranır (sapma yerine); gruplu bu durumda etkisizdir.
Neden iki λ?
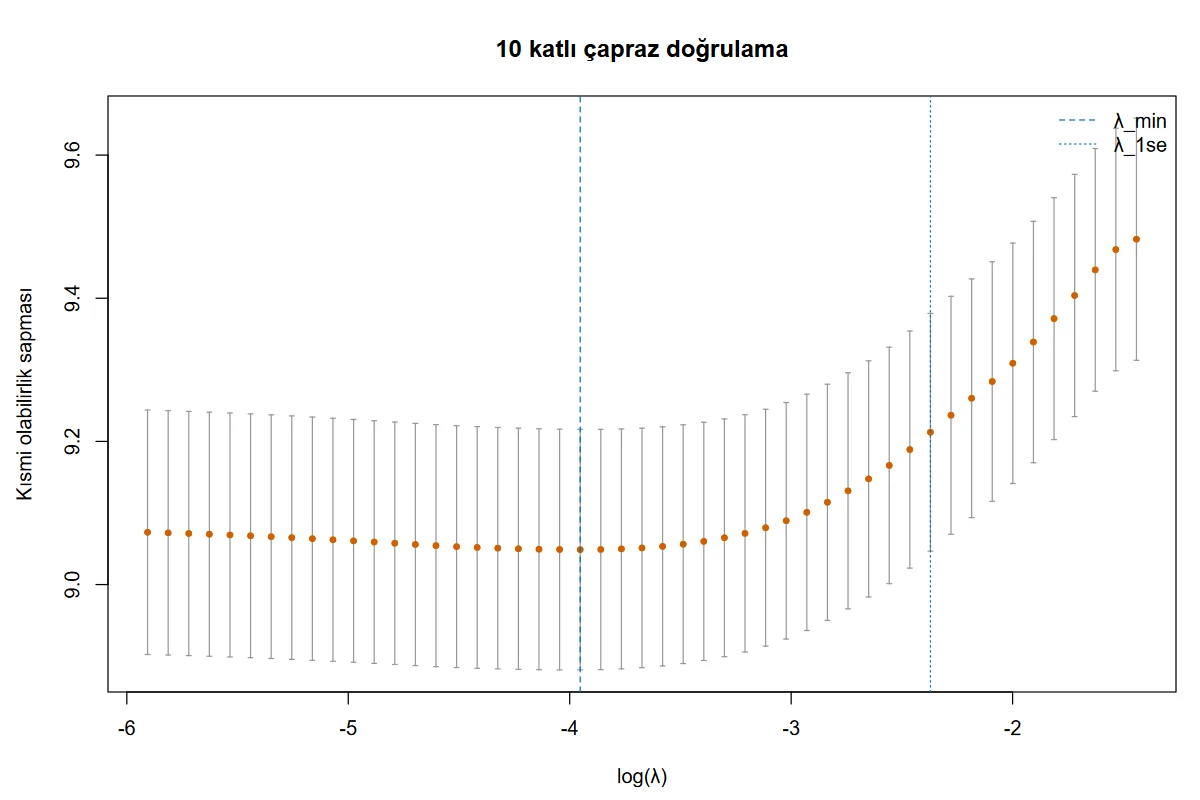
\lambda_{\min} öngörü hatasını en küçükleyen, ama gürültü değişkenleri de tutabilen düzeydir. \lambda_{1se} bir standart hata kadar bir başarım kaybını daha seyrek bir modelle takas eder; çapraz doğrulama eğrisi \lambda_{\min} çevresinde çok düz olduğundan bu fark istatistiksel olarak ayırt edilemez. Örnekte \lambda_{\min}=0{,}01920 14, \lambda_{1se}=0{,}09338 8 değişken seçer; sapmalar 9,0488 ve 9,2128, standart hata 0,168'dir. Şablon varsayılan olarak \lambda_{1se}'yi raporlar (coef.cv.glmnet varsayılanı; 42, 179).
Koddaki tercih: kat ataması
Kat ataması set.seed(tohum_) sonrasında yapılır (195). cv.glmnet, sample(rep(1:k, length = n)) ile kat numaralarını çeker; aynı tohum ve aynı n aynı katları verir (bu bölümün doğrulamasında R, aynı katları foldid ile verip aynı sonucu aldı). Farklı tohum farklı \lambda_{1se} verir: tohum 1, 2, 3 için \lambda_{1se} = 0,0934, 0,1125, 0,0706 ve seçilen değişken sayısı 8, 5, 9'dur. Çapraz doğrulama bir kez, tek bölmeyle yapıldığından seçim bu rastgeleliğe duyarlıdır (143.8).
143.4.4 Seçilen değişkenler, tehlike oranları, C-indeksi
Seçilen \lambda'da (lambda_secimi) coef(fit, s = λ) alınır; sıfırdan farklı katsayılar \exp(\hat\beta) ile birlikte mutlak değere göre azalan sırayla yazılır (224–235). Tablo her iki \lambda'nın katsayısını da gösterir. Doğrusal öngörücü \hat\eta_i=x_i'\hat\beta ile Harrell C-indeksi (Harrell vd., 1982) survival::concordance(y ~ lp, reverse = TRUE) ile hesaplanır (236–237):
- Paydadaki çiftler, olayı i'nin yaşadığı ve j'nin t_i'den sonra hâlâ izlendiği çiftlerdir (örnekte 346 277 çift). Tehlikesi yüksek (öngörücüsü büyük) olanın olayı daha erken yaşamasını bekleriz;
reverse = TRUEbu yönü verir. - C=0{,}5 rastgele, C=1 kusursuz sıralamadır. SH,
concordance'ın varyansından gelir.
C-indeksi kestirimin yapıldığı aynı veride hesaplanır; bu nedenle iyimserdir (tablo başlığında "uygulama verisi; iyimser" yazar). Çapraz doğrulanmış C için olcut = C ile çapraz doğrulama eğrisi kullanılır (örnekte 0,7267, 143.7). Seçilen \lambda'da bütün katsayılar sıfırsa doğrusal öngörücünün varyansı sıfırdır ve C ve SH NA olur (cc_bos).
143.4.5 Cezasız karşılaştırma ve sabit λ
Olay sayısı öngörücü sayısından büyükse (nolay > ncol(X); 241) survival::coxph(y ~ X, ties = baglar) kurulur ve katsayı, SH, HR ve cezalı katsayı yan yana yazılır; C-indeksi tablosuna "Harrell C (cezasız Cox)" eklenir (255). coxph yakınsamazsa ya da bir katsayı sonlu değilse (tam eş doğrusallık: NA; ayrışma) tablo atlanır ve not yazılır (249). Olay sayısı yetmiyorsa (örn. n=40, 19 olay, 30 öngörücü) model hiç kurulmaz (250–251).
lambda_sabit > 0 ise o \lambda'da bütün katsayılar ayrıca verilir (261–263). Değer dizi noktası değilse glmnet, iki komşu dizi noktasının katsayısını \lambda'da doğrusal ara değerle alır (coef(fit, s = λ), exact = FALSE). Değer yol aralığının dışındaysa katsayılar uç noktadan alınır ve not yazılır (258–260): \lambda=5 için yolun başı (tüm katsayılar sıfır), \lambda=10^{-5} için yolun sonu (24 sıfırdan farklı katsayı) verilir; bu sonuncusu \lambda=10^{-5}'in gerçek çözümü değildir. Vinyetin \lambda=0{,}05 değeri yol aralığı içindedir ve yayımlı katsayılarla beş ondalıkta eşleşir (143.6).
143.4.6 Şekiller ve çıktı tabloları
Şekil 1: \log\lambda'ya karşı katsayı yolu (üst eksende sıfırdan farklı katsayı sayısı; kesikli \lambda_{\min}, noktalı \lambda_{1se}; açıklamada son noktada mutlak değeri en büyük sekiz öngörücü); Şekil 2: çapraz doğrulama eğrisi ve \pm1 SH çubukları (270–290). Renkler Okabe–Ito paletinin sekiz rengidir ve sekizden fazla değişkende yinelenir. Tablolar sırasıyla: çapraz doğrulama özeti, seçilen değişkenler, (cezasız karşılaştırma), ayırma gücü, (sabit \lambda), çapraz doğrulama eğrisi; hepsi tam hassasiyetle saklanır (Bölüm 1.4).
143.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 147–153 | Paketler, veri ve zaman/durum denetimi, öngörücü listesi | Zaman ve durum öngörücülerden çıkarılır. |
| 154–161 | Eksiksiz satırlar (not), 20 gözlem, pozitif süre, 0/1 durum | Sayısal rol sütunları sayı olarak gelir (Bölüm 1.3). |
| 162–168 | Olay sayısı \ge\max(5,k); öngörücü matrisi, sayısal olmayan sütun | Olay azsa katlar kararsızdır. |
| 169–174 | Sabit öngörücülerin çıkarılması (sd == 0) |
Sabit olmayan en az iki sütun kalmalı. |
| 175–188 | \alpha, bağ, ölçüt, \lambda oranı, Surv, uyarı toplayıcı (sar) |
sar hata ve uyarıyı yakalar; yakınsama uyarıları çıktının başında, öteki uyarılar sonda yazılır. |
| 189–198 | ayar listesi, glmnet yolu, tohum (tohum_), set.seed, cv.glmnet |
thresh ve maxit aynı listede iki çağrıya da gider; tohum alanı 0 ise çalıştırma tohumu. |
| 199–214 | Tohum notu, yakınsama uyarısı, yol kesilme notu, bağ notu | Yakınsama uyarısı çıktının başındadır; seçilen \lambda kesilen yolun ucundaysa ayrıca belirtilir. |
| 198, 215–223 | \lambda_{\min}, \lambda_{1se}, çapraz doğrulama özeti | lambda_secimi yalnız raporlanan \lambda'yı belirler. |
| 224–235 | Katsayılar, boş model notu, seçilen değişken tablosu | Mutlak değere göre sıralı. |
| 236–237 | Doğrusal öngörücü, C-indeksi | Sabit öngörücüde C yok (NULL). |
| 238–256 | Cezasız coxph, karşılaştırma ve C tablosu |
Yalnız olay sayısı öngörücü sayısından büyükse. |
| 257–267 | Sabit \lambda tablosu, çapraz doğrulama eğrisi tablosu | Aralık dışı not. |
| 268–269 | Öteki glmnet uyarıları ("cox.ties" ve yakınsama uyarıları hariç) |
Ayrışma ve eş doğrusallık uyarıları burada görünür. |
| 270–290 | Katsayı yolu ve çapraz doğrulama şekilleri |
143.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bağımsız Python glmnet'i çağırmaz: Breslow kısmi olabilirliğinin gradyanını ve Hesse matrisini risk kümesi toplamlarının ters kümülatif toplamlarıyla kendisi kurar, elastik ağ amacını yakın-Newton adımlarıyla (her adımda ikinci derece yaklaşımın koordinat inişi, yumuşak eşik ve geri izleme) 10^{-13}'e kadar çözer. R tarafında katsayılar glmnet'ten (eşik 10^{-14}) alınır; ancak çözümün doğruluğu glmnet'e güvenilmeden, survival::coxph'in martingal artığından hesaplanan skorla (optimum koşulları) ayrıca sınanır.
Adım 1 — \lambda_{\max} ve dizi. Başlangıçta \beta=0'da standartlaştırılmış gradyanın en büyük mutlak değeri \lambda_{\max}=0{,}2367594 (Python 0{,}2367594045, R aynı); dizinin 2. ve 5. noktası \lambda_{\max}\cdot10^{-4\,(k-1)/99}=0{,}2157264 ve 0{,}1631891. Şablon aynı değerleri verir.
Adım 2 — Tam veride çözüm. \lambda_{1se}=0{,}0933828 ve \lambda_{\min}=0{,}0192043 (şablonun çapraz doğrulamasından) için bağımsız Python çözümü (5 yineleme) ve glmnet (eşik 10^{-14}) şablonun esik_us = 12 çalıştırmasıyla 2\times10^{-7} içinde örtüşür:
| Değişken | \hat\beta (\lambda_{1se}) şablon (esik_us = 12) |
Python | R | \hat\beta (\lambda_{\min}) şablon | Python |
|---|---|---|---|---|---|
| V6 | -0{,}273511 | -0{,}273512 | -0{,}273512 | -0{,}480861 | -0{,}480861 |
| V1 | 0{,}250315 | 0{,}250315 | 0{,}250315 | 0{,}480076 | 0{,}480076 |
| V9 | 0{,}234007 | 0{,}234007 | 0{,}234007 | 0{,}440442 | 0{,}440443 |
| V7 | 0{,}140389 | 0{,}140389 | 0{,}140389 | 0{,}326274 | 0{,}326275 |
| V3 | -0{,}043288 | -0{,}043288 | -0{,}043288 | -0{,}210327 | -0{,}210327 |
| V5 | -0{,}032242 | -0{,}032242 | -0{,}032242 | -0{,}179620 | -0{,}179620 |
| V4 | 0{,}008835 | 0{,}008835 | 0{,}008835 | 0{,}167946 | 0{,}167946 |
| V2 | -0{,}004232 | -0{,}004232 | -0{,}004232 | -0{,}166890 | -0{,}166890 |
Tehlike oranları: \exp(0{,}250315)=1{,}28443 (V1), \exp(-0{,}273511)=0{,}76070 (V6): V1'in bir birim artışı tehlikeyi %28,4 artırır, V6'nın bir birim artışı %24,0 azaltır.
Adım 3 — Optimum koşulu. Çözümün doğruluğu coxph(init = β, iter.max = 0) martingal artığından g_j=\sum_i x_{ij}r_i/n ile sınanır: standartlaştırılmış ölçekte |g_j/s_j|\le\lambda\alpha (\hat\beta_j=0) ve g_j/s_j=\lambda\alpha\,\mathrm{işaret}(\hat\beta_j) (\hat\beta_j\ne0). esik_us = 12 çalıştırmasında en büyük ihlal 1{,}1\times10^{-7}, varsayılan eşik (10^{-7}) çalıştırmasında 5{,}5\times10^{-5}'tir (λ'nın %0,06'sı): varsayılan eşikte katsayılar 10^{-4} düzeyinde optimumdan ayrılır (kesin çözümle fark en çok 1{,}4\times10^{-4}). Elastik ağ, sırt, standartlaştırmasız, Efron ve bağlı veri çalıştırmalarının hepsi aynı sınamadan geçer.
Adım 4 — Çapraz doğrulama. R aynı tohumla kat atamasını (sample(rep(1:10, length = 1000))) verir. Python her kat için o katın dışında modeli kendi \lambda dizisinde (\lambda_{\max,\kappa}\cdot10^{-4\,j/99}) uydurur, \lambda_{1se}'yi çevreleyen iki dizi noktasında çözüp doğrusal ara değer alır ve c_\kappa'yı hesaplar. Sonuç: \mathrm{cvm}(\lambda_{\min})=9{,}048753 ve \mathrm{cvsd}=0{,}168021; \mathrm{cvm}(\lambda_{1se})=9{,}212729 ve \mathrm{cvsd}=0{,}166011. Kural kontrolü: 9{,}048753+0{,}168021=9{,}216774\ge9{,}212729 (\lambda_{1se}'nin sapması en iyinin bir SH'si içindedir). Not: kat modelinin katsayısı tam \lambda'da çözülürse (ara değersiz) sapma 9,213386 çıkar; fark glmnet'in ara değerlemesinden gelir ve bağımsız Python bu ara değerlemeyi yineleyerek 3\times10^{-9} içinde eşleşir.
Adım 5 — Cezasız Cox ve C-indeksi. Python, Newton–Raphson ile cezasız Breslow modelini çözer: \hat\beta_{V1}=0{,}556846 (SH 0{,}042727), \hat\beta_{V2}=-0{,}213249 (SH 0{,}039882); log-olabilirlik -3848{,}4082; C =0{,}734288. \lambda_{1se} modelinin C-indeksi 0{,}714604 (SH 0{,}010709). Python, çiftleri doğrudan sayarak (346 277 çift) aynı iki C değerini 10^{-15} içinde bulur.
Adım 6 — Yayımlı değerler. cc_C çalıştırması (olcut = C, tohum 1): \lambda_{\min}=0{,}03356 ve \lambda_{1se}=0{,}05865 (vinyet: 0,03356 ve 0,05865); lambda_sabit = 0,05 için V1…V8 katsayıları 0{,}37711,\ -0{,}09555,\ -0{,}13605,\ 0{,}09820,\ -0{,}11442,\ -0{,}38912,\ 0{,}24303,\ 0{,}03651 (vinyet aynı).
Adım 7 — Ridge ve elastik ağ. Bağımsız Python, şablonun (\alpha=0 ve \alpha=0{,}5) çalıştırmalarının kendi \lambda_{1se} değerlerinde (0{,}8122 ve 0{,}1551) çözümü yineler; katsayılar 6{,}4\times10^{-5} içinde eşleşir (varsayılan eşik). Sırt çözümünde otuz katsayının hepsi sıfırdan farklıdır.
143.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| λ_max (yolun ilk λ'sı) | 0,2367594 | 0,2367594 | 0,2367594 | 3,1e−16 | ✓ |
| λ dizisinin ikinci noktası | 0,21572635 | 0,21572635 | 0,21572635 | 4,7e−16 | ✓ |
| λ dizisinin beşinci noktası | 0,16318907 | 0,16318907 | 0,16318907 | 2,5e−16 | ✓ |
| Yolda kalan λ sayısı (nlambda = 100 üst sınır) | 49 | 49 | 49 | 0 | ✓ |
| Çapraz doğrulama: aynı tohum aynı kat ataması (cv.glmnet ≡ foldid) | 1 | 1 | — | 0 | ✓ |
| λ_min | 0,01920429 | 0,01920429 | 0,01920429 | 0 | ✓ |
| λ_min: ÇD sapması (cvm) | 9,04877332 | 9,04875326 | 9,04875326 | 2,2e−6 | ✓ |
| λ_min: ÇD standart hatası (cvsd) | 0,16801604 | 0,16802066 | 0,16802066 | 4,6e−6 | ✓ |
| λ_min: sıfırdan farklı katsayı sayısı | 14 | 14 | 14 | 0 | ✓ |
| λ_1se | 0,09338279 | 0,09338279 | 0,09338279 | 0 | ✓ |
| λ_1se: ÇD sapması (cvm) | 9,21281773 | 9,21272877 | 9,21272881 | 9,7e−6 | ✓ |
| λ_1se: ÇD standart hatası (cvsd) | 0,16601108 | 0,16601077 | 0,16601078 | 3,1e−7 | ✓ |
| λ_1se: sıfırdan farklı katsayı sayısı | 8 | 8 | 8 | 0 | ✓ |
| [eşik 1e−12] λ_min: ÇD sapması | 9,04875333 | 9,04875326 | 9,04875326 | 8,3e−9 | ✓ |
| [eşik 1e−12] λ_min: ÇD standart hatası | 0,16802065 | 0,16802066 | 0,16802066 | 1,4e−8 | ✓ |
| [eşik 1e−12] λ_1se: ÇD sapması | 9,21272902 | 9,21272877 | 9,21272881 | 2,6e−8 | ✓ |
| [eşik 1e−12] λ_1se: ÇD standart hatası | 0,16601078 | 0,16601077 | 0,16601078 | 4,7e−9 | ✓ |
| [eşik 1e−12] β(V6) λ_1se | −0,27351141 | −0,2735116 | −0,27351157 | 2,0e−7 | ✓ |
| [eşik 1e−12] β(V6) λ_min | −0,48086079 | −0,48086124 | −0,4808612 | 4,5e−7 | ✓ |
| [eşik 1e−12] HR(V6) λ_1se | 0,76070366 | 0,76070351 | 0,76070354 | 1,5e−7 | ✓ |
| [eşik 1e−12] β(V1) λ_1se | 0,25031495 | 0,25031521 | 0,25031516 | 2,6e−7 | ✓ |
| [eşik 1e−12] β(V1) λ_min | 0,4800759 | 0,48007648 | 0,48007642 | 5,8e−7 | ✓ |
| [eşik 1e−12] HR(V1) λ_1se | 1,28442988 | 1,28443022 | 1,28443016 | 2,6e−7 | ✓ |
| [eşik 1e−12] β(V9) λ_1se | 0,23400726 | 0,23400746 | 0,23400742 | 2,0e−7 | ✓ |
| [eşik 1e−12] β(V9) λ_min | 0,44044222 | 0,4404427 | 0,44044265 | 4,8e−7 | ✓ |
| [eşik 1e−12] HR(V9) λ_1se | 1,26365366 | 1,26365391 | 1,26365387 | 2,0e−7 | ✓ |
| [eşik 1e−12] β(V7) λ_1se | 0,14038867 | 0,14038883 | 0,14038881 | 1,7e−7 | ✓ |
| [eşik 1e−12] β(V7) λ_min | 0,32627431 | 0,32627469 | 0,32627465 | 3,8e−7 | ✓ |
| [eşik 1e−12] HR(V7) λ_1se | 1,15072096 | 1,15072115 | 1,15072112 | 1,7e−7 | ✓ |
| [eşik 1e−12] β(V3) λ_1se | −0,04328821 | −0,04328835 | −0,04328832 | 1,4e−7 | ✓ |
| [eşik 1e−12] β(V3) λ_min | −0,21032682 | −0,21032712 | −0,21032709 | 2,9e−7 | ✓ |
| [eşik 1e−12] HR(V3) λ_1se | 0,95763535 | 0,95763522 | 0,95763524 | 1,3e−7 | ✓ |
| [eşik 1e−12] β(V5) λ_1se | −0,03224186 | −0,03224194 | −0,03224192 | 7,4e−8 | ✓ |
| [eşik 1e−12] β(V5) λ_min | −0,17961998 | −0,17962016 | −0,17962014 | 1,7e−7 | ✓ |
| [eşik 1e−12] HR(V5) λ_1se | 0,96827237 | 0,96827229 | 0,96827231 | 7,2e−8 | ✓ |
| [eşik 1e−12] β(V4) λ_1se | 0,00883454 | 0,00883463 | 0,00883461 | 9,0e−8 | ✓ |
| [eşik 1e−12] β(V4) λ_min | 0,16794604 | 0,16794625 | 0,16794623 | 2,1e−7 | ✓ |
| [eşik 1e−12] HR(V4) λ_1se | 1,00887368 | 1,00887377 | 1,00887375 | 9,0e−8 | ✓ |
| [eşik 1e−12] β(V2) λ_1se | −0,00423166 | −0,00423176 | −0,00423174 | 1,1e−7 | ✓ |
| [eşik 1e−12] β(V2) λ_min | −0,16688971 | −0,16688994 | −0,16688992 | 2,3e−7 | ✓ |
| [eşik 1e−12] HR(V2) λ_1se | 0,99577728 | 0,99577718 | 0,9957772 | 1,1e−7 | ✓ |
| [eşik 1e−7] β(V6) λ_1se | −0,27341722 | −0,2735116 | −0,27351157 | 9,4e−5 | ✓ |
| [eşik 1e−7] β(V1) λ_1se | 0,25019091 | 0,25031521 | 0,25031516 | 1,2e−4 | ✓ |
| [eşik 1e−7] β(V9) λ_1se | 0,23391115 | 0,23400746 | 0,23400742 | 9,6e−5 | ✓ |
| [eşik 1e−7] β(V7) λ_1se | 0,14030851 | 0,14038883 | 0,14038881 | 8,0e−5 | ✓ |
| [eşik 1e−7] β(V3) λ_1se | −0,04322306 | −0,04328835 | −0,04328832 | 6,5e−5 | ✓ |
| [eşik 1e−7] β(V5) λ_1se | −0,0322063 | −0,03224194 | −0,03224192 | 3,6e−5 | ✓ |
| [eşik 1e−7] β(V4) λ_1se | 0,00879122 | 0,00883463 | 0,00883461 | 4,3e−5 | ✓ |
| [eşik 1e−7] β(V2) λ_1se | −0,00418099 | −0,00423176 | −0,00423174 | 5,1e−5 | ✓ |
| Cezasız Cox: β(V1) | 0,55684611 | 0,55684611 | 0,55684611 | 3,4e−12 | ✓ |
| Cezasız Cox: SH(V1) | 0,04272667 | 0,04272667 | 0,04272667 | 2,8e−14 | ✓ |
| Cezasız Cox: β(V6) | −0,5459048 | −0,5459048 | −0,5459048 | 3,7e−12 | ✓ |
| Cezasız Cox: SH(V6) | 0,0430539 | 0,0430539 | 0,0430539 | 3,2e−14 | ✓ |
| Cezasız Cox: β(V30) | −0,03515706 | −0,03515706 | −0,03515706 | 6,5e−13 | ✓ |
| Cezasız Cox: SH(V30) | 0,03906149 | 0,03906149 | 0,03906149 | 3,1e−15 | ✓ |
| Harrell C (λ_1se, uygulama verisi) | 0,71458976 | 0,7146042 | 0,7146042 | 1,4e−5 | ✓ |
| Harrell C, SH (survival::concordance) | 0,01070877 | — | 0,01070896 | 1,8e−7 | ✓ |
| Harrell C (cezasız Cox) | 0,73428787 | 0,73428787 | 0,73428787 | 1,1e−16 | ✓ |
| Vinyet: λ_min (type.measure = C, tohum 1) | 0,03356 | 0,03356 | — | 0 | ✓ |
| Vinyet: λ_1se (type.measure = C, tohum 1) | 0,05865 | 0,05865 | — | 0 | ✓ |
| Vinyet: coef(fit, s = 0,05) V1 (5 ondalık) | 0,37711 | 0,37711 | 0,37711 | 0 | ✓ |
| Vinyet: coef(fit, s = 0,05) V2 (5 ondalık) | −0,09555 | −0,09555 | −0,09555 | 0 | ✓ |
| Vinyet: coef(fit, s = 0,05) V3 (5 ondalık) | −0,13605 | −0,13605 | −0,13605 | 0 | ✓ |
| Vinyet: coef(fit, s = 0,05) V4 (5 ondalık) | 0,0982 | 0,0982 | 0,0982 | 0 | ✓ |
| Vinyet: coef(fit, s = 0,05) V5 (5 ondalık) | −0,11442 | −0,11442 | −0,11442 | 0 | ✓ |
| Vinyet: coef(fit, s = 0,05) V6 (5 ondalık) | −0,38912 | −0,38912 | −0,38912 | 0 | ✓ |
| Vinyet: coef(fit, s = 0,05) V7 (5 ondalık) | 0,24303 | 0,24303 | 0,24303 | 0 | ✓ |
| Vinyet: coef(fit, s = 0,05) V8 (5 ondalık) | 0,03651 | 0,03651 | 0,03651 | 0 | ✓ |
| Sırt (α = 0): β(V6) λ_1se | −0,18348789 | −0,1835045 | — | 1,7e−5 | ✓ |
| Sırt (α = 0): β(V1) λ_1se | 0,17000459 | 0,17002341 | — | 1,9e−5 | ✓ |
| Sırt (α = 0): β(V22) λ_1se | 1,808458·10−4 | 1,800558·10−4 | — | 7,9e−7 | ✓ |
| Elastik ağ (α = 0,5): β(V6) λ_1se | −0,26931901 | −0,26936774 | — | 4,9e−5 | ✓ |
| Elastik ağ (α = 0,5): β(V1) λ_1se | 0,24907992 | 0,24914417 | — | 6,4e−5 | ✓ |
| Elastik ağ (α = 0,5): β(V2) λ_1se | −0,02529407 | −0,02531928 | — | 2,5e−5 | ✓ |
| Standartlaştırma kapalı: β(V6) λ_1se | −0,27494275 | −0,27504866 | — | 1,1e−4 | ✓ |
| Standartlaştırma kapalı: β(V1) λ_1se | 0,25426161 | 0,25440043 | — | 1,4e−4 | ✓ |
| Standartlaştırma kapalı: β(V2) λ_1se | −0,00966487 | −0,00972117 | — | 5,6e−5 | ✓ |
| Bağlı veri, Breslow (103 farklı süre): β(V6) λ_1se | −0,32893225 | −0,3290147 | — | 8,2e−5 | ✓ |
| Bağlı veri, Breslow (103 farklı süre): β(V1) λ_1se | 0,31717293 | 0,31727804 | — | 1,1e−4 | ✓ |
| Bağlı veri, Breslow (103 farklı süre): β(V10) λ_1se | 0,00876352 | 0,0087912 | — | 2,8e−5 | ✓ |
| Bağlı veri: λ_min ÇD sapması (doymuş terim dahil) | 3,64325513 | 3,64323957 | — | 4,3e−6 | ✓ |
| Bağlı veri: λ_min ÇD standart hatası | 0,06147847 | 0,06148059 | — | 2,1e−6 | ✓ |
| Bağlı veri: λ_1se ÇD sapması (doymuş terim dahil) | 3,69822766 | 3,69817139 | — | 1,5e−5 | ✓ |
| Bağlı veri: λ_1se ÇD standart hatası | 0,06037811 | 0,06037867 | — | 5,7e−7 | ✓ |
| Optimum koşulu ihlali (en büyük), örnek ayar (Breslow) | 5,470969·10−5 | 0 | — | 5,5e−5 | ✓ |
| Optimum koşulu ihlali (en büyük), Efron (bağsız veri) | 6,373848·10−5 | 0 | — | 6,4e−5 | ✓ |
| Optimum koşulu ihlali (en büyük), bağlı veri, Breslow | 4,505729·10−5 | 0 | — | 4,5e−5 | ✓ |
| Optimum koşulu ihlali (en büyük), bağlı veri, Efron | 5,211957·10−5 | 0 | — | 5,2e−5 | ✓ |
| Optimum koşulu ihlali (en büyük), elastik ağ α = 0,5 | 3,339524·10−5 | 0 | — | 3,3e−5 | ✓ |
| Optimum koşulu ihlali (en büyük), sırt α = 0 | 2,390354·10−5 | 0 | — | 2,4e−5 | ✓ |
| Optimum koşulu ihlali (en büyük), standartlaştırma kapalı | 6,166355·10−5 | 0 | — | 6,2e−5 | ✓ |
| Optimum koşulu ihlali (en büyük), eşik 1e−12 | 1,138171·10−7 | 0 | — | 1,1e−7 | ✓ |
Ölçütü karşılayan: 92/92. Ölçüt satır başına yazılıdır: λ dizisi 10^{-9}; yakınsama eşiği 1e−7 (varsayılan) ile çalışan glmnet çıktısı için 3\times10^{-4} (glmnet koordinat inişini bu eşikte durdurur; katsayı farkı en çok 1{,}4\times10^{-4}, ÇD sapması ve standart hatası farkı en çok 10^{-5}); esik_us = 12 ile çalıştırılan satırlarda ([eşik 1e−12] önekli satırlar) 10^{-6} ve bağımsız çözümle fark 10^{-7}'nin altındadır. Bağımsız Python, Breslow kısmi olabilirliğinin yakın-Newton + koordinat inişi çözücüsünü kendisi yazar (glmnet ve scikit-survival çağrılmaz) ve çapraz doğrulamayı glmnet'in tanımıyla yineler: kat modeli kendi λ dizisinde uydurulur, tam-veri λ'sındaki katsayı komşu iki dizi noktasından doğrusal ara değerle alınır, sapma farkı (D_{tam}-D_{-k})/n. R sütunu: glmnet (eşik 10^{-14}) ile aynı tohumun kat ataması, survival::coxph ile cezasız model ve concordance; optimum koşulu (Karush–Kuhn–Tucker) coxph(init = β, iter.max = 0) martingal artığından sınanır ve şablonun bildirdiği katsayılara uygulanır. Yayımlı değerler glmnet vinyeti 'Regularized Cox Regression' (CoxExample): \lambda_{\min}=0{,}03356, \lambda_{1se}=0{,}05865 ve coef(fit, s = 0.05); MerQuR+ değeri beş ondalığa yuvarlanarak karşılaştırılır.
143.7 Çıktıyı okuma
Örnek ayar (cc_ornek), konsol:
Cezalı Cox regresyonu (lasso, α = 1): n = 1000, olay = 692, aday öngörücü = 30; 10 katlı ÇD (kısmi olabilirlik sapması), bağlar: breslow
Tablolar (kısaltılmış):
Çapraz doğrulama özeti (ölçüt: kısmi olabilirlik sapması)
        secim    lambda  log_lambda  CV_olcut     CV_SH  sifirdan_farkli
   lambda.min  0.019204   -3.952622  9.048773  0.168016               14
   lambda.1se  0.093383   -2.371048  9.212818  0.166011                8

Seçilen değişkenler (lambda.1se = 0.09338): katsayı ve tehlike oranı
degisken   katsayi        HR  katsayi_lambda_min  katsayi_lambda_1se
      V6 -0.273417  0.760775           -0.480733           -0.273417
      V1  0.250191  1.284271            0.479912            0.250191
      V9  0.233911  1.263532            0.440307            0.233911
      V7  0.140309  1.150629            0.326166            0.140309
      V3 -0.043223  0.957698           -0.210244           -0.043223
      V5 -0.032206  0.968307           -0.179571           -0.032206
      V4  0.008791  1.008830            0.167886            0.008791
      V2 -0.004181  0.995828           -0.166824           -0.004181

Karşılaştırma: cezasız Cox modeli (bütün öngörücüler) ve cezalı katsayılar
degisken   katsayi        SH        HR  katsayi_cezali
      V1  0.556846  0.042727  1.745160        0.250191
      V6 -0.545905  0.043054  0.579317       -0.273417
      V8  0.113296  0.036369  1.119964        0.000000
     V30 -0.035157  0.039061  0.965454        0.000000

Ayırma gücü: Harrell C-indeksi (uygulama verisi; iyimser)
                     olcut     deger
    Harrell C (lambda.1se)  0.714590
                        SH  0.010709
   seçilen değişken sayısı  8.000000
   Harrell C (cezasız Cox)  0.734288

Çapraz doğrulama eğrisi (49 satır)
    lambda  log_lambda  CV_olcut    CV_alt    CV_ust  sifirdan_farkli
  0.236759   -1.440711  9.482493  9.313289  9.651696                0
  0.093383   -2.371048  9.212818  9.046807  9.378829                8
  0.002722   -5.906330  9.073051  8.902319  9.243782               24
Şekil 143.1. Örnek ayar: katsayı yolu. Üst eksen sıfırdan farklı katsayı sayısı; kesikli çizgi \lambda_{\min}, noktalı çizgi \lambda_{1se}.
Şekil 143.2. Örnek ayar: 10 katlı çapraz doğrulama eğrisi (kısmi olabilirlik sapması) ve \pm1 SH çubukları.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Çapraz doğrulama özeti | \lambda_{\min}, \lambda_{1se}, ölçüt değeri, SH, sıfırdan farklı sayısı | Sapma küçüldükçe (C büyüdükçe) öngörü iyidir; \lambda_{1se} daha seyrektir. Bağlı zamanlarda sapmanın mutlak değeri doymuş model terimiyle kayar (143.8). |
| Seçilen değişkenler | Özgün ölçekte \hat\beta ve \exp(\hat\beta) | Bir birimlik artışın tehlike oranı; küçültülmüş (yanlı) değerdir, güven aralığı yoktur. |
| Cezasız karşılaştırma | Cezasız \hat\beta, SH, HR ve cezalı katsayı | Cezalı katsayının sıfıra doğru küçüldüğünü ve sıfırlanan değişkenleri gösterir. SH yalnız cezasız model içindir. |
| Harrell C | C, SH, seçilen sayısı | Uygulama verisinde sıralama gücü; cezasız modelinki daha yüksektir (aşırı uyum ödülü). |
| Sabit \lambda tablosu | Bütün katsayılar | İstenen \lambda'da katsayılar (ara değerli). |
| Çapraz doğrulama eğrisi | Her \lambda için cvm, alt/üst sınır, sıfırdan farklı | Yolun tamamı; \lambda_{\min} çevresinde eğrinin düzlüğü seçimin kararsızlığını gösterir. |
Rapor cümlesi: Otuz aday öngörücü arasından değişken seçimi için 10 katlı çapraz doğrulamalı lasso-Cox regresyonu kullanıldı (n = 1000, 692 olay; glmnet 5.1, Breslow bağları, standartlaştırılmış öngörücüler, tohum 1). En seyrek model, çapraz doğrulama sapmasının en iyi değerin bir standart hatası içinde kaldığı ceza düzeyinde (λ = 0,093) sekiz öngörücü seçti; V1 (HR = 1,28) ve V9 (HR = 1,26) riski artıran, V6 (HR = 0,76) azaltan en güçlü öngörücüler oldu. Seçilen modelin Harrell C-indeksi uygulama verisinde 0,715'ti (cezasız modelde 0,734; iyimser). Tehlike oranları cezalı (küçültülmüş) kestirimlerdir.
143.8 Sık hatalar ve tuzaklar
- Cezalı katsayı güven aralığı değildir. Lasso katsayıları yanlıdır ve seçimden sonra klasik SH/p geçerli değildir; şablon bu nedenle SH vermez. Cezasız tablodaki SH, tüm değişkenlerin modelde olduğu başka bir modelindir. Seçilen değişkenleri cezasız yeniden uydurmak "gevşetilmiş lasso" gibi bir yöntemdir ve şablonda yoktur.
- \lambda_{1se} tohuma bağlıdır. Tohum 1, 2, 3 için \lambda_{1se} 0,0934, 0,1125, 0,0706; seçilen sayı 8, 5, 9 (
cc_ornek,cc_tohum2,cc_tohum3). Çapraz doğrulama bir kez yapılır; kararlılık için farklı tohumlarla yineleyin ve hep seçilen değişkenlere bakın. Kat sayısı da etkilidir (cc_kat5: \lambda_{1se}=0{,}0851). - Tohum alanı 1 iken panel tohumu etkisizdir. Şablonun
tohumalanı varsayılan 1 iken kat ataması bu değerle yapılır (195) ve künyedeki tohum sonucu belirlemez; alan 0 yapılırsa künyedeki çalıştırma tohumu kullanılır (143.2). - λ dizisi 100 değildir. Örnekte yol 49 noktada kesilir (
lambda_sayisien çok değerdir; hesaplanan sayı ve \lambda aralığı çıktıya yazılır, 207–211);lambda_sabitbu aralığın dışındaysa uç nokta katsayıları verilir ve \lambda=10^{-5} gibi bir değer gerçek çözüm değildir (cc_sabit_kucuk: V1 = 0,5446, \lambda=0{,}00272'nin değeri). Yol uzunluğu kontrolü içinlambda_oran'ı küçültmek yetmez: dizi noktaları artar, kesme kuralı yine geçerlidir. - Yakınsama uyarısı çıktının başındadır. Gözlemden fazla öngörücü olan ya da
en_cok_yinelemeküçük verilerdeglmnetbazı \lambda'larda yakınsamaz ("Convergence for 70th lambda value not reached after maxit=100000 iterations; solutions for larger lambdas returned":cc_pn;cc_yin5: 10. \lambda'da). Yol kesilir; şablon bunu çıktının başında "UYARI" satırıyla bildirir (kesilen nokta sayısı, seçilen \lambda yolun son noktasıysa ayrıca belirtilir) ve tablolar yalnız yakınsayan \lambda'ları kapsar. n=40, 19 olay, 30 öngörücüde \lambda_{1se} boş modeldir. - Varsayılan eşikte katsayılar 10^{-4} düzeyinde yaklaşıktır.
esik_us = 7'de katsayılar kesin çözümden en çok 1{,}4\times10^{-4} ayrılır, sapma değerleri 10^{-5} düzeyinde oynar (143.6); sonuçları yayımlamadan önceesik_us = 12ile bir kez doğrulayın.esik_us = 3(eşik 10^{-3}) \lambda_{\min} ve \lambda_{1se}'yi (0,0175 ve 0,0851) değiştirir. - Bağlı olay zamanları. Gerçek veride bağ çoksa Breslow ve Efron ayrışır; bağlı sürede (103 farklı süre,
cc_bag) \lambda_{1se} Breslow'da 0,0553, Efron'da 0,0631 ve seçilen sayılar 10 ve 9'dur. Çapraz doğrulama sapması her iki seçimde de Breslow olabilirliğiyle ve doymuş-model terimi eklenerek hesaplanır: aynı veride mutlak sapma 3,64'tür, oysa terimsiz kısmi olabilirlik farkı 9,18'dir. Değerler arası \lambda karşılaştırması geçerlidir, ama sapmanın mutlak değeri cezasız modelin sapmasıyla karşılaştırılamaz; şablon olay zamanlarında bağ varsa bunu çıktıda not eder (212–214). - Ayrışma. Öngörücü olay göstergesinin kendisiyse (
cc_ayrisma, V_{31}= durum) cezasız model \hat\beta=19{,}66 (SH 1041) verir ve "coefficient may be infinite" uyarısı gelir, cezalı model ise 2,06 gibi sonlu bir katsayı verir. Uyarı hangi modele ait olduğunu söylemez. - Tam eş doğrusallık. V_2=2V_1+1 (
cc_tamkol): cezasız Cox kurulamaz, not yazılır ve yol 49 noktada durur; lasso iki sütundan yalnız birini ya da ikisini ve küçük katsayıyla tutabilir (seçim kararsızdır). Sırt ya da elastik ağ ilişkili değişkenleri birlikte tutar. - Boş model. Gürültü öngörücülerde (
cc_bos) \lambda_{\min}=\lambda_{1se}=\lambda_{\max}, katsayıların tümü sıfır, C-indeksiNA'dır. Bu başarısızlık değil, sonuçtur: veri öngörücü içermiyor demektir. - Girdi hataları. Süre \le0 (
cc_sifir,cc_neg) hata verir; durum 1/2 kodluysa (cc_kod12) ya da metinse (cc_metin) durur; metin düzeyli öngörücü (cc_kat) ve ondalık virgüllü öngörücü (cc_virgul, sütun metin okunur) form tarafından reddedilir; 10 katla 8 olay (cc_azolay) "En az 10 olay gerekli" ile durur. Eksik değerli satırlar çıkarılır ve sayılır (cc_eksik: 4 satır); sabit sütun adıyla bildirilip çıkarılır (cc_sabit). - Şekilde renk yinelenir. Sekiz renk sırayla kullanıldığından V1 ile V9 aynı renktedir ve üst eksen başlıkla çakışabilir; değişkeni rengi değil, mutlak değere göre sıralı açıklama ve tablo ayırt eder.
- Kategorik öngörücü. Önce 0/1 göstergelere çevirin (referans düzeyi dışarıda bırakarak); cezalı modelde tüm düzeylerin göstergesini tutmak katsayıları referansa göre değil, ceza yoluyla belirler ve yorumu değiştirir.
- C-indeksi iyimserdir. Seçim ve uydurma aynı veride yapıldığı için uygulama verisindeki C (0{,}715) çapraz doğrulanmış C'den (0{,}727,
olcut = C) farklı bir şeydir; gerçek ayırma gücü için bağımsız veri ya da iç içe çapraz doğrulama gerekir.
143.9 Uzman soruları
S1. λ_min mi λ_1se mi?
\lambda_{\min} çapraz doğrulama sapmasını en küçük yapan değerdir; \lambda_{1se} bir standart hata içinde kalan en seyrek modeldir. Örnekte ikisi 9,049 ve 9,213 sapma ve 14 ile 8 değişken verir; fark standart hatanın (0,168) altındadır, yani veri ikisini birbirinden ayırt edemez. Amaç öngörü doğruluğuysa \lambda_{\min}, yorumlanabilir küçük bir model isteniyorsa \lambda_{1se} (şablonun ve glmnet'in varsayılanı). Yanlı ayrım yoktur; ama \lambda_{1se} tohuma duyarlıdır (143.8).
S2. Standartlaştırma neden varsayılan açık ve katsayılar neden özgün ölçekte?
Ceza katsayı büyüklüğüne bakar; ölçeği küçük değişken haksız cezalanır. Standartlaştırma \beta^s=\beta s üzerinden cezalandırır ve özgün ölçeğe geri döner (standardize). Böylece tehlike oranı "bir birimlik artış" olarak okunur. Kapatıldığında (cc_std_kapali) ceza özgün ölçekte uygulanır ve ölçeği büyük değişken (küçük katsayılı) avantajlıdır. Örnek veride standart sapmalar 1'e yakın olduğundan iki ayar yakın sonuç verir.
S3. Neden standart hata ve p değeri yok?
Lasso yanlıdır ve değişken seçimi örneklem varyansını artırır; seçimden sonra klasik Wald aralığı geçersizdir (seçim sonrası çıkarım ayrı bir yöntem gerektirir). Şablon bilinçli olarak yalnız cezasız tam modelin SH'sini gösterir. Güven aralığı gerekiyorsa önyükleme (yeniden örnekleme) ya da seçim sonrası çıkarım yöntemi kullanılmalıdır; bunlar şablonda yoktur.
S4. p > n olduğunda ne olur?
Cezasız Cox kurulamaz (şablon olay sayısı \le p ise atlar). Lasso çözümünde sıfırdan farklı katsayı sayısı gözlem sayısını aşmaz. Yakınsama zorlaşır ve glmnet bazı \lambda'larda iterasyon sınırına dayanabilir (cc_pn); bu durumda yol kesilir ve uyarı yazılır. lambda_oran otomatik olarak 0{,}01 alınır (n\le p).
S5. Efron ve Breslow ne zaman ayrışır?
Çok sayıda bağlı olay varsa Breslow yaklaşımı risk kümesi toplamını olduğundan büyük alır ve katsayıları sıfıra doğru yanlar; Efron bu yanı azaltır (Efron, 1977). CoxExample'da bağ yoktur ve ikisi aynıdır; bağlı veride (103 farklı süre) \lambda_{1se} 0,0553 ve 0,0631 olur. Çapraz doğrulama sapması her iki durumda Breslow tanımıyla hesaplanır; \lambda sıralaması için bu yeterlidir, mutlak sapma için değildir.
S6. Harrell C ile sapma ölçütü hangi durumda tercih edilir?
Amaç sıralama gücüyse (öngörü sıralaması) C; olabilirlik tabanlı genel uyum ve kalibrasyon ise sapma. C ölçütü her katı ayrı ayrı sıralar ve ortalamasını alır; örnekte vinyet değerlerini (0,03356 ve 0,05865) verir ve çapraz doğrulanmış C 0,7267'dir. C ölçütünde \lambda_{\min} ve \lambda_{1se} sapma ölçütünden farklı ve birbirine yakındır; sapma (ham olabilirlik) ölçütünde 14 ve 8 değişken seçilirken C ölçütünde ikisi de 10 değişken seçer.
S7. Elastik ağ ne zaman lasso'dan iyidir?
Öngörücüler birbiriyle güçlü ilişkiliyse lasso ilişkili grubun yalnız birini rastgele seçer; elastik ağ (\alpha<1) grubu birlikte tutar. Örnekte \alpha=0{,}5 ile \lambda_{1se}=0{,}155 ve 8 değişken; sırtta (\alpha=0) otuz katsayının hepsi sıfırdan farklıdır. \alpha şablonda çapraz doğrulamayla seçilmez; birkaç değer deneyip çapraz doğrulama sapmalarını karşılaştırmak gerekir.
S8. Sabit λ ile katsayı alınırsa ne olur?
Yol üzerindeki iki komşu nokta arasında doğrusal ara değer alınır; gerçek çözümden küçük farklıdır. Yol aralığının dışında uç nokta verilir (not düşer). \lambda değerini yol üzerinde bir dizi noktası olarak seçmek (çapraz doğrulama eğrisi tablosundaki değer) ara değer etkisini ortadan kaldırır.
143.10 Kaynaklar
- Breslow, N. (1974). Covariance analysis of censored survival data. Biometrics, 30(1), 89–99. https://doi.org/10.2307/2529620
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B, 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Efron, B. (1977). The efficiency of Cox's likelihood function for censored data. Journal of the American Statistical Association, 72(359), 557–565. https://doi.org/10.1080/01621459.1977.10480613
- Friedman, J., Hastie, T. ve Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- Harrell, F. E., Califf, R. M., Pryor, D. B., Lee, K. L. ve Rosati, R. A. (1982). Evaluating the yield of medical tests. JAMA, 247(18), 2543–2546. https://doi.org/10.1001/jama.1982.03320430047030
- Hoerl, A. E. ve Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- Simon, N., Friedman, J., Hastie, T. ve Tibshirani, R. (2011). Regularization paths for Cox's proportional hazards model via coordinate descent. Journal of Statistical Software, 39(5), 1–13. https://doi.org/10.18637/jss.v039.i05
- Therneau, T. M. ve Grambsch, P. M. (2000). Modeling survival data: Extending the Cox model. Springer. https://doi.org/10.1007/978-1-4757-3294-8
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B, 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Tibshirani, R. (1997). The lasso method for variable selection in the Cox model. Statistics in Medicine, 16(4), 385–395. https://doi.org/10.1002/(SICI)1097-0258(19970228)16:4<385::AID-SIM380>3.0.CO;2-3
- Verweij, P. J. M. ve van Houwelingen, H. C. (1993). Cross-validation in survival analysis. Statistics in Medicine, 12(24), 2305–2314. https://doi.org/10.1002/sim.4780122407
- Zou, H. ve Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B, 67(2), 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x
- Friedman, J., Hastie, T., Tibshirani, R., Narasimhan, B., Tay, K., Simon, N. ve Qian, J. (2026). glmnet: Lasso and elastic-net regularized generalized linear models (R paketi, sürüm 5.1). https://CRAN.R-project.org/package=glmnet
- Therneau, T. M. (2026). survival: Survival analysis (R paketi, sürüm 3.8-6). https://CRAN.R-project.org/package=survival
- R Core Team (2026). R: a language and environment for statistical computing. R Foundation for Statistical Computing.