2. Alfa ve kafes (lattice) tasarımları: üretim ve tamamlanmamış blok çözümlemesi
Şablon kimliği: alfa_kafes · Kategori: deney_tasarimi · Dil: R · Dosya: pro/sablonlar/deney_tasarimi/alfa_kafes.R (satır 1–243; üstbilgi 1–103) · Örnek veri: _ornek/alfa_kafes.csv · Paketler: lme4 (lmer), agricolae (design.alpha; yalnız üretim kipinde), stats, graphics
2.1 Ne işe yarar
Şablon, çok sayıda genotipin (çeşit, hat, klon) karşılaştırıldığı tarla denemeleri için iki iş yapar. Üretim kipinde çözülebilir (resolvable) bir tamamlanmamış blok tasarımı, yani alfa tasarımı kurar ve tarla planını verir. Çözümleme kipinde böyle bir denemenin verisini doğrusal karma modelle çözümler. Cevapladığı soru şudur: "Otuz, yüz ya da beş yüz genotipi tek bir homojen bloğa sığdıramıyorsam, parselleri nasıl düzenlerim ve genotipleri blok farklarından arındırarak nasıl karşılaştırırım?"
Tam bloklu tasarımda her blok bütün genotipleri içerir; genotip sayısı arttıkça blok büyür, blok içi toprak değişkenliği artar ve karşılaştırmalar duyarlılığını yitirir. Alfa tasarımı her tekrarı (bütün genotipleri bir kez içeren tam kopya) k parsellik küçük bloklara böler. Bloklar genotiplerin yalnız bir kısmını içerdiğinden "tamamlanmamış"tır; her tekrar yine bütün genotipleri içerdiğinden tasarım "çözülebilir"dir. Çözümleme modeli:
- y_{ijk}: j. tekrarın k. bloğundaki i. genotipin parsel değeri (ör. verim).
- \mu: genel düzey. g_i: genotip etkisi; sabit (varsayılan) ya da rastgele, g_i\sim N(0,\sigma^2_g).
- r_j\sim N(0,\sigma^2_r): tekrar etkisi (rastgele).
- b_{k(j)}\sim N(0,\sigma^2_b): j. tekrarın içindeki k. bloğun etkisi (rastgele).
- e_{ijk}\sim N(0,\sigma^2_e): parsel hatası. Bütün rastgele terimler birbirinden bağımsızdır.
Ne zaman kullanılır? Genotip sayısı tam bloklara sığmayacak kadar çoksa (kabaca 20'nin üstünde); genotip sayısı blok boyunun katıysa (t=s\cdot k); 2–4 tekrar yapılacaksa; her tekrar ayrı bir tarla şeridinde ya da ayrı bir günde yönetilecekse (çözülebilirlik bunu sağlar). k=s olduğunda tasarım bir kare kafestir (square lattice); kafes çözümlemesi aynı modelle yapılır.
Ne zaman kullanılmaz?
- Genotipler tek homojen bloğa sığıyorsa: tam bloklu tasarım daha yalın ve daha etkindir; temel programdaki İki Yönlü ANOVA (genotip + blok) ya da çok lokasyonlu denemede Çok Lokasyonlu Tesadüf Blokları (Birleştirilmiş Varyans Analizi).
- Deneme birden çok lokasyon ve yılda yinelenmişse ve her lokasyonda tam bloklar kullanılmışsa:
lokasyon_yil_tbdşablonu (Bölüm 11). - Parseller arasında komşuluk ilişkisi (satır-sütun eğilimi, AR1 × AR1 hata) modellenecekse:
lme_uzamsal_korelasyonşablonu. - Genotip × çevre etkileşimi faktör analitik yapıyla modellenecekse:
fa_karma_modelşablonu. - Tasarım, özel bir model ve parsel sayısı için eniyilenecekse (blok boyu genotip sayısını bölmüyor, eşit olmayan bloklar):
optimal_tasarimşablonu. - Yanıt sayım ya da oran ise (hastalıklı bitki sayısı, çimlenme): aynı blok yapısıyla genelleştirilmiş karma model;
glmer_ilerişablonu. - Düzeltilmiş ortalamalar arasında çoklu karşılaştırma ya da özel kontrast isteniyorsa: bu şablon yalnız ortalamaları ve ortalama fark standart hatasını verir; karşılaştırmalar için
r_emmeans_kontrastşablonu.
Temel programla ilişki. Temel programdaki İç İçe LMM (Çoklu Hiyerarşik Karma Model) analizi aynı varyans yapısını (tekrar içinde blok) kurabilir. Bu şablon ona üç şey ekler: tasarımın kendisini üretir, tasarımın etkinlik çarpanını hesaplar ve genotip rastgele alındığında BLUP'ları, kestirim hatası varyanslarını ve Cullis kalıtım derecesini verir.
2.2 Şablonun girdileri
Form, üstbilgideki on üç [[param]] bloğundan kurulur (alfa_kafes.R:10–102). İlk alan (İşlem) şablonun hangi kipte çalışacağını belirler; alanların bir kısmı yalnız bir kipte kullanılır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
İşlem · kip |
seçim · Model | analiz |
analiz, uret |
Kip seçimi (117, 148). |
Yanıt (ör. verim) · y |
sayısal sütun · Değişkenler | boş | sayısal sütun | y; çözümleme (152–157). |
Genotip / çeşit · genotip |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | g_i; factor (158). |
Tekrar (replication) · tekrar |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | r_j; factor (158). |
Tamamlanmamış blok (tekrar içinde) · blok |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | b_{k(j)}; tekrar etiketiyle birleştirilir (158). |
Genotip etkisi · genotip_etkisi |
seçim · Model | sabit |
sabit, rastgele |
Model formülü (165–166); çıktı dalı (191, 211). |
Genotip sayısı t · n_genotip |
tamsayı · Model | 30 | 4–2000 | Üretim: t (119). |
Blok boyu k · blok_boyu |
tamsayı · Model | 4 | 2–100 | Üretim: k (119). |
Tekrar sayısı r · n_tekrar |
tamsayı · Model | 2 | 2–4 | Üretim: r (119). |
Rastgeleleştirme tohumu · tohum |
tamsayı · Gelişmiş | 0 | 0–1 000 000 | Üretim: seed; 0 ise rastgele seçilir ve tabloya yazılır (125). |
Varyans bileşeni kestiricisi · kestirici |
seçim · Model | REML |
REML, ML |
Çözümleme: lmer(REML = …) (168–169). |
Parsel numaralandırma serisi · parsel_numarasi |
seçim · Çıktı | 2 |
1, 2, 3 |
Üretim: serie; parsel numaraları 11…, 101…, 1001… (127). |
Genotipleri rastgele dağıt · rastgele_dagit |
onay · Seçenekler | açık | açık / kapalı | Üretim: randomization; kapalıysa sistematik dizi (127). |
Örnek ayar (satır 9): kip = analiz, y = yield, genotip = Genotype, tekrar = replication, blok = block, genotip_etkisi = sabit; üretim alanları n_genotip = 30, blok_boyu = 3, n_tekrar = 2, tohum = 5. Blok boyu (3) ve tohum (5) varsayılandan (4 ve 0) farklıdır; bu değerlerle üretim kipi örnek verinin tasarımını yeniden üretir.
Dört sütun alanı formda "zorunlu değil" olarak tanımlıdır (satır 21, 27, 33, 39), çünkü üretim kipinde veri gerekmez; bu yüzden form açıldığında boş gelirler ve kendiliğinden sütun önerilmez. Çözümleme kipinde dördü de seçilmelidir; bunu şablonun kendisi denetler.
Şablonun kendi denetimleri: üretim kipi.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| t, k'nin katı değil | "Genotip sayısı blok boyunun katı olmalı (t = s·k)." | 120 |
| k>s | "Blok boyu k (…), blok sayısını s = t/k (…) aşamaz." | 122 |
| r=3, s çift ve k\ge s | "r = 3 ve çift s için k < s olmalı." | 123 |
| r=4 ve s 2'ye ya da 3'e bölünüyor | "r = 4 alfa dizisi yalnız 2'ye ve 3'e bölünmeyen s için vardır." | 124 |
design.alpha tasarım döndürmedi |
"Bu t, k, r için alfa tasarımı üretilemedi." | 128 |
Şablonun kendi denetimleri: çözümleme kipi.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde deneme verisini açın." | 149 |
| Dört sütundan biri seçilmemiş | "Çözümleme için yanıt, genotip, tekrar ve blok sütunlarını seçin." | 151 |
| Aynı sütun iki role verilmiş | "…farklı sütunlar olmalı." | 153 |
| 10'dan az tam gözlem | "En az 10 tam gözlem gerekli." | 159 |
| Yanıt sabit | "Yanıt sabit." | 160 |
| 3'ten az genotip | "En az 3 genotip gerekli." | 161 |
| 2'den az tekrar | "En az 2 tekrar gerekli." | 162 |
| Blok sayısı tekrar sayısını aşmıyor | "Tekrar içinde birden çok blok yok; tamamlanmamış blok yapısı bulunamadı." | 163 |
| n\le t+2 | "Genotip sayısına göre gözlem sayısı yetersiz." | 164 |
lmer hata verdi |
"Karma model kurulamadı: …" | 171 |
| Kestirilemeyen genotip etkisi var | "Bazı genotip etkileri kestirilemedi (bağlantısız tasarım)." | 198 |
Eksik değer: dört sütundan herhangi birinde eksik olan satır atılır (complete.cases, satır 155). lmer'in uyarıları çalıştırmayı durdurmaz; toplanır ve çıktının sonunda "Uyarılar:" satırında yazılır (172, 241).
2.3 Örnek veri
Dosya: _ornek/alfa_kafes.csv. agricolae paketinin öğreticisindeki alfa tasarımı örneğidir (de Mendiburu, 2023): 30 genotip, 2 tekrar, tekrar başına 3 parsellik 10 blok; 60 parsel, eksik değer yok. Tasarım design.alpha ile tohum 5 kullanılarak üretilmiş, verim değerleri öğreticiden alınmıştır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
plots |
(kullanılmaz) | sayısal | Parsel numarası: 101–130 (1. tekrar), 201–230 (2. tekrar). |
cols |
(kullanılmaz) | sayısal | Blok içindeki sıra: 1, 2, 3. |
block |
Tamamlanmamış blok | sayısal | 1–10 (1. tekrar), 11–20 (2. tekrar). |
Genotype |
Genotip | metin | geno1 … geno30; her biri 2 parsel. |
replication |
Tekrar | ikili | 1, 2; her biri 30 parsel. |
yield |
Yanıt | sayısal | Tamsayı, 1–9; ortalama 4,5333; standart sapma 2,3468. |
Tekrar ortalamaları 4,6333 ve 4,4333'tür; iki tekrar neredeyse aynı düzeydedir. Blok ortalamaları ise 1,33 ile 8,00 arasında değişir: değişkenliğin büyük kısmı tekrarlar arasında değil, tekrar içindeki bloklar arasındadır.
Düzey sırası. Genotype sütunu veri sekmesinde "metin" olarak algılanır; şablon factor() ile düzeyleri alfabetik sıraya dizer (geno1, geno10, geno11, …). Bu sıra yalnız tasarım matrisinin sütun sırasını belirler; düzeltilmiş ortalamalar ve BLUP'lar büyükten küçüğe sıralanarak yazıldığından (satır 202, 234) sonuçların anlamı düzey sırasına bağlı değildir. Blok etiketleri tekrar etiketiyle birleştirilir ("1:4", "2:16"; satır 158); farklı tekrarlarda aynı blok numarası kullanılmış olsa da bloklar tekrar içinde ayrı sayılır.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar (çözümleme, sabit genotip, REML); (2) örnek ayar + rastgele genotip; (3) örnek ayar + ML; (4) üretim kipi (t=30, k=3, r=2, tohum 5); (5) karşılaştırma için dört ek üretim (t,k,r = 9, 3, 2; 30, 5, 2; 20, 4, 3; 35, 5, 4).
2.4 Yöntem: formüller ve hesap adımları
Üretim kipinin hesap sırası: (1) t, k, r uyumunu denetle; (2) alfa dizisinden tasarımı kur ve rastgeleleştir; (3) etkinlik çarpanını ve üst sınırını hesapla; (4) özet ve tarla planı tablolarını yaz. Çözümleme kipinin hesap sırası: (1) veriyi hazırla ve denetle; (2) karma modeli REML (ya da ML) ile uydur; (3) varyans bileşenlerini, log-olabilirliği ve tasarımın etkinliğini yaz; (4) genotip sabitse Wald F, düzeltilmiş ortalamalar ve ortalama fark standart hatası; rastgeleyse BLUP, kestirim hatası varyansı ve kalıtım derecesi.
2.4.1 Alfa tasarımının yapısı
Alfa tasarımı üç sayıyla tanımlanır: t genotip, k parsellik bloklar ve r tekrar. Her tekrar s=t/k bloktan oluşur; toplam b=r\,s blok ve n=r\,t parsel vardır. Tasarım, k\times r boyutlu bir "alfa dizisi"nden döngüsel kaydırmalarla türetilir (Patterson ve Williams, 1976): birinci tekrarın blokları genotipleri sırayla k'lı gruplara ayırır; sonraki her tekrar, dizinin ilgili sütunundaki kaydırma miktarlarıyla blokları yeniden karıştırır. Amaç, iki genotipin aynı blokta buluşma sayısını (eşleşme, concurrence) olabildiğince eşit tutmaktır. Buluşma sayıları yalnız 0 ve 1 değerlerini alıyorsa tasarım \alpha(0{,}1) türündedir.
Koddaki tercih
Tasarım agricolae::design.alpha(trt, k, r, serie, seed, randomization) ile kurulur (satır 127). Genotipler G1 … Gt olarak adlandırılır (126). agricolae'nin dizileri yalnız belirli yapılar için tanımlıdır; şablon bu koşulları çağrıdan önce kendi iletileriyle denetler (120–124): t=s\,k; k\le s; r=3 ve s çiftse k<s; r=4 ise s 2'ye ve 3'e bölünmemeli. Tohum 0 bırakılırsa 1 ile 1 000 000 arasında rastgele bir tohum seçilir ve özet tablosuna yazılır (125, 134); aynı planı yeniden üretmek için bu değer saklanmalıdır. design.alpha'nın konsola yazdığı özet bastırılır (capture.output).
Neden çözülebilir bir tasarım?
Tekrarların her biri bütün genotipleri içerdiğinden deneme tekrar tekrar ekilebilir, hasat edilebilir ve değerlendirilebilir; bir tekrar kaybedilirse kalanlar hâlâ tam bir denemedir. Ayrıca bloklar değişkenliği yakalayamazsa (blok varyansı sıfıra yakınsa) çözümleme kendiliğinden tam bloklu tasarımın çözümlemesine iner; tamamlanmamış blok kullanmanın bedeli olmaz.
2.4.2 Tasarımın etkinliği
Bir tamamlanmamış blok tasarımında genotip farkları yalnız blok içi karşılaştırmalarla kestirilirse, farkların varyansı aynı hata varyansına sahip tam bloklu tasarıma göre büyür. Bu kaybı etkinlik çarpanı ölçer. Şablon çarpanı tasarımın bilgi matrisinden hesaplar (satır 107–114):
- \mathbf N: t\times b rastlantı (incidence) matrisi; N_{ij}=1 ise i. genotip j. bloktadır.
- \mathbf N\mathbf N^{\top}: köşegeni r, köşegen dışı öğeleri iki genotipin aynı blokta buluşma sayısı olan matris.
- e_i: kanonik etkinlik çarpanları, 0<e_i\le1. Tam bloklu tasarımda hepsi 1'dir.
- E: çarpanların harmonik ortalaması, yani ortalama etkinlik çarpanı. Blok içi çözümlemede bütün ikili genotip farklarının ortalama varyansı 2\sigma^2_e/(rE)'dir.
- Kodda 10^{-8}'den küçük özdeğerler sıfır sayılır (satır 111).
Neden harmonik ortalama?
Bir kanonik karşılaştırmanın varyansı 1/e_i ile orantılıdır. İkili farkların ortalama varyansı bu yüzden 1/e_i'lerin aritmetik ortalamasıyla, yani e_i'lerin harmonik ortalamasının tersiyle orantılıdır. Aritmetik ortalama kullanılsaydı, çok kötü kestirilen tek bir karşılaştırma (e_i sıfıra yakın) gözden kaçardı.
Şablon ikinci bir sayı daha verir: Patterson ve Williams'ın (1976) üst sınırı (satır 115).
- Çözülebilir bir tasarımda t-1 çarpanın (t-1)-r(s-1) tanesi tam 1'dir; geri kalan r(s-1) tanesinin toplamı sabittir. Hepsi eşit olsaydı ulaşılacak harmonik ortalama bu sınırdır.
- E_{\max} yalnız t, r, s'ye bağlıdır; genotiplerin bloklara nasıl dağıtıldığını görmez.
Gerçek etkinlik ile üst sınır aynı şey değildir
agricolae'nin design.alpha çıktısında "Efficiency factor (E)" başlığıyla yazdığı sayı bu üst sınırdır. Örnek tasarımda üst sınır 0,6170, tasarımın gerçek ortalama etkinlik çarpanı ise 0,3775'tir. Şablon ikisini ayrı satırlarda verir; tasarımları karşılaştırırken "gerçek" satırı kullanılır.
Örnek tasarımda iki sayının bu kadar ayrışması tasarımın yapısından gelir. İki tekrarlı bir tasarımda 1'den küçük çarpanlar \tfrac12\pm\sigma_m/(2k) biçiminde çiftler oluşturur; \sigma_m, birinci tekrarın bloklarıyla ikinci tekrarın bloklarının kaç genotip paylaştığını gösteren s\times s matrisin tekil değerleridir. k=3, s=10 için alfa dizisi ikinci tekrarı 0, 1, 2 kaydırmalarıyla kurar; rastgeleleştirmeden önceki sistematik dizide her blok karşı tekrarın yalnız ardışık üç bloğuyla bağlanır. Bu zincir yapısında en büyük tekil değer 1+2\cos36^\circ=2{,}618'dir ve ona karşılık gelen çarpan \tfrac12-2{,}618/6=0{,}0637'ye düşer. Blok boyu büyüdükçe bağlantılar sıklaşır ve gerçek etkinlik sınıra yaklaşır:
| t | k | r | s | Gerçek E | Üst sınır |
|---|---|---|---|---|---|
| 30 | 3 | 2 | 10 | 0,3775 | 0,6170 |
| 30 | 5 | 2 | 6 | 0,7280 | 0,7436 |
| 9 | 3 | 2 | 3 | 0,6667 | 0,6667 |
| 20 | 4 | 3 | 5 | 0,7447 | 0,7600 |
| 35 | 5 | 4 | 7 | 0,7967 | 0,8095 |
Düşük bir E, tasarımın işe yaramadığı anlamına gelmez. E yalnız blok içi bilgiyi sayar ve hata varyansının tam bloklu tasarımdakiyle aynı olduğunu varsayar. Küçük bloklar hata varyansını düşürür; ayrıca karma model bloklar arası bilgiyi de kullanır (2.4.4). Gerçek kazanç, iki tasarımın ortalama fark varyanslarının karşılaştırılmasıyla görülür (2.6, Adım 4).
2.4.3 Karma model ve REML
Model matris biçiminde \mathbf y=\mathbf X\boldsymbol\beta+\mathbf Z_r\mathbf u_r+\mathbf Z_b\mathbf u_b+\mathbf e yazılır. Gözlemlerin kovaryans matrisi:
- \mathbf X: sabit etkilerin tasarım matrisi (n\times p). Genotip sabitse p=t (kesişim + t-1 genotip sütunu); rastgeleyse p=1 ve \mathbf V'ye \sigma^2_g\mathbf Z_g\mathbf Z_g^{\top} eklenir.
- \mathbf Z_r, \mathbf Z_b: tekrar ve blok gösterge matrisleri. Aynı bloktaki iki parselin kovaryansı \sigma^2_r+\sigma^2_b, aynı tekrarın farklı bloklarındaki iki parselinki \sigma^2_r'dir.
Varyans bileşenleri kısıtlı (artık) en çok olabilirlikle kestirilir (Patterson ve Thompson, 1971):
- \mathbf y^{\top}\mathbf P\mathbf y: genelleştirilmiş en küçük kareler artıklarının ağırlıklı kareler toplamı.
- \ln\lvert\mathbf X^{\top}\mathbf V^{-1}\mathbf X\rvert: sabit etkilerin kestirilmesiyle yitirilen bilginin düzeltmesi. ML'de bu terim yoktur ve (n-p) yerine n yazılır.
- Her bileşen \sigma^2\ge0 ile sınırlıdır; en büyük değer sınırda (\hat\sigma^2=0) bulunabilir.
Neden REML, ML değil?
ML, varyans bileşenlerini sabit etkiler biliniyormuş gibi kestirir ve onları aşağı doğru yanlı verir; yanlılık p/n ile büyür. Bu modelde genotip sabitken p=30, n=60'tır: parametrelerin yarısı sabit etkidir. Örnek veride artık varyans REML ile 1,6571, ML ile 0,5614 çıkar; ortalama fark standart hatası 1,7041'den 1,0838'e düşer. REML, olabilirliği sabit etkilerden arındırılmış artıkların dağılımından kurar ve bu yanlılığı giderir. ML seçeneği yalnız, sabit etkileri farklı modellerin olabilirlik oranıyla karşılaştırılması gerektiğinde anlamlıdır.
Koddaki tercih
Model lme4::lmer ile (Bates ve ark., 2015) uydurulur (satır 166–172): sabit genotipte .y ~ .g + (1 | .r) + (1 | .b), rastgele genotipte .y ~ 1 + (1 | .g) + (1 | .r) + (1 | .b). Denetim ayarı lmerControl(check.conv.singular = "ignore", calc.derivs = FALSE)'dir: bir bileşen sınırda kestirildiğinde lme4'ün yazacağı "tekil uyum" iletisi bastırılır ve yakınsama sonrası türev denetimi yapılmaz. Tekrar varyansının sıfır çıkması bu tasarımlarda olağandır; model geçerli kalır ve blok varyansı tekrarlar arası farkı da üstlenir.
Kestirimlerin sayısal hassasiyeti
lmer olabilirliği türevsiz bir eniyileyiciyle (varsayılan ayarlarıyla) en büyükler; eniyileyici olabilirlik 10^{-8} düzeyinde değişmez olduğunda durur. REML yüzeyi en büyük noktanın çevresinde yassı olduğundan varyans bileşenleri bu noktada beşinci-altıncı anlamlı basamağa kadar belirlidir. Çıktıdaki sayılar dört ondalıkla raporlandığında bu fark görünmez; bağımsız bir hesapla yedinci basamakta karşılaştırma yapıldığında görünür (2.6.1).
2.4.4 Düzeltilmiş ortalamalar ve standart hataları
Varyans bileşenleri kestirildikten sonra sabit etkiler genelleştirilmiş en küçük karelerle (GLS) bulunur:
- \mathbf x_i: i. genotipin tasarım satırı (kesişim + o genotipin göstergesi); satır 195–196.
- \hat\mu_i: düzeltilmiş ortalama; genotipin, ortalama bir bloktaki beklenen değeri. Ham ortalamadan farkı, genotipin rastladığı blokların iyi ya da kötü oluşunun giderilmesidir.
- \operatorname{SED}: bütün ikili farkların varyanslarının ortalamasının karekökü (satır 204–205). Tek tek farkların standart hatalarının ortalaması değildir.
Neden ham ortalama yetmez?
Tamamlanmamış bloklarda her genotip blokların yalnız bir kısmında yer alır. İyi topraklı bloklara düşen bir genotipin ham ortalaması, genotipin kendisi iyi olmasa da yüksek çıkar. Düzeltilmiş ortalama, her parselden o parselin blok etkisinin kestirimini çıkarır. Örnek veride geno19 ham ortalamada birincidir (8,0), düzeltilmiş ortalamada 6,72 ile ikinciliğe iner: iki parseli de ortalamanın üstündeki bloklardadır.
Neden blok etkisi rastgele?
Blok sabit alınırsa genotip farkları yalnız aynı blokta buluşan parsellerden kestirilir (blok içi çözümleme). Blok rastgele alındığında blok toplamlarının taşıdığı bilgi de kullanılır: iki blok farklı genotipler içerdiğinden, blok ortalamaları arasındaki farkın bir kısmı genotip farkıdır. Buna bloklar arası bilginin geri kazanılması denir (Patterson ve Thompson, 1971). Kazanç, \sigma^2_b küçüldükçe büyür; \sigma^2_b=0 olduğunda çözümleme tam bloklu tasarımınkine eşit olur.
Şablon ayrıca genel ortalamayı ve değişim katsayısını verir: \mathrm{DK}=100\sqrt{\hat\sigma^2_e}/\bar y (satır 188). Bu DK, blok etkisi ayıklandıktan sonraki parsel hatasına dayanır; tam bloklu bir çözümlemenin DK'sından küçüktür.
2.4.5 Genotip için Wald F
- \hat{\boldsymbol\beta}_g: t-1 genotip katsayısı (her genotipin ilk düzeyle farkı); H_0: bütün genotipler eşit.
- Tabloda \mathrm{KT}=F\,(t-1)\,\hat\sigma^2_e ve \mathrm{KO}=\mathrm{KT}/(t-1) de yazılır; bunlar
anova()'nın ölçeklenmiş biçimidir ve klasik varyans çözümlemesinin kareler toplamı değildir.
Koddaki tercih
F, stats::anova(m) ile alınır (satır 192–194). lme4'ün bu tablosu payda serbestlik derecesi ve p değeri içermez; şablon da tablo başlığında bunu belirtir. Varyans bileşenleri kestirildiği için F'nin dağılımı tam bir F dağılımı değildir ve payda sd'si bir yaklaşımla (Kenward ve Roger, 1997) bulunmalıdır. Şablon bu yaklaşımı uygulamaz; F betimleyici bir büyüklük olarak verilir.
2.4.6 Rastgele genotip: BLUP, kestirim hatası varyansı ve kalıtım derecesi
Genotipler daha geniş bir kitlenin rastgele örneği sayılırsa (ıslah programının erken kuşakları), amaç genotip değerlerini öngörmek ve seçmektir. En iyi doğrusal yansız öngörücü (BLUP):
- \hat u_{g,i}: i. genotipin genel ortalamadan öngörülen sapması; tabloda
BLUP.tahmini_deger=\hat\mu+\hat u_{g,i}. - PEV (prediction error variance): öngörü hatasının varyans-kovaryans matrisi; köşegeni tabloda
PEV. Genel ortalamanın kestirilmesinden gelen belirsizliği de içerir. - BLUP'lar sıfıra doğru büzülür: bilgi azaldıkça (\sigma^2_g küçük, \sigma^2_e büyük) büzülme artar.
Koddaki tercih
Şablon PEV'i Henderson'ın (1975) karma model denklemlerinden kurar (satır 216–231): sabit ve rastgele etkilerin birleşik katsayı matrisinin tersinin genotip bloğu, \hat\sigma^2_e ile ölçeklenir. Bu, lme4::ranef(condVar = TRUE)'nin verdiği koşullu varyanstan farklıdır: condVar sabit etkileri bilinen sayar ve genotipler arası kovaryansı vermez. Katsayı matrisi tersinemezse ya da \hat\sigma^2_g=0 ise kalıtım derecesi boş bırakılır ve PEV sütununa condVar değerleri yazılır (213, 223–224).
Kalıtım derecesi Cullis, Smith ve Coombes'un (2006) genelleştirilmiş tanımıyla verilir:
- \bar v_{\Delta}: iki genotipin BLUP farkının öngörü hatası varyansının bütün çiftler üzerinden ortalaması (satır 229).
- 2\hat\sigma^2_g: iki genotipin gerçek değer farkının varyansı. Oran, farkın ne kadarının öngörü hatası olduğunu gösterir.
- H^2_C\in[0{,}1]; 1'e yakın değer, genotip sıralamasının güvenilir olduğunu gösterir.
Neden klasik formül değil?
Klasik giriş ortalaması kalıtım derecesi \sigma^2_g/(\sigma^2_g+\sigma^2_e/r), bütün genotip farklarının aynı varyansla kestirildiğini varsayar. Tamamlanmamış bloklarda bu doğru değildir: aynı blokta buluşan çiftler daha kesin, buluşmayanlar daha az kesin karşılaştırılır ve blok varyansı da farkların varyansına girer. Cullis tanımı farkların gerçek varyanslarını kullanır (Piepho ve Möhring, 2007). Örnek veride klasik formül 0,412, Cullis tanımı 0,327 verir; klasik formül güvenilirliği olduğundan yüksek gösterir.
2.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–103 | Üstbilgi: açıklama, örnek veri ve ayar, on üç parametre. | Form ve varsayılanlar (Bölüm 1.2). |
| 104–115 | Dil seçici .m; etkinlik() ve ust_sinir() işlevleri. |
İki kip de aynı etkinlik işlevini kullanır (130, 179). |
| 117–128 | Üretim: t, k, r denetimleri; tohum; design.alpha çağrısı. |
Tohum 0 ise rastgele tohum seçilir ve raporlanır (125). |
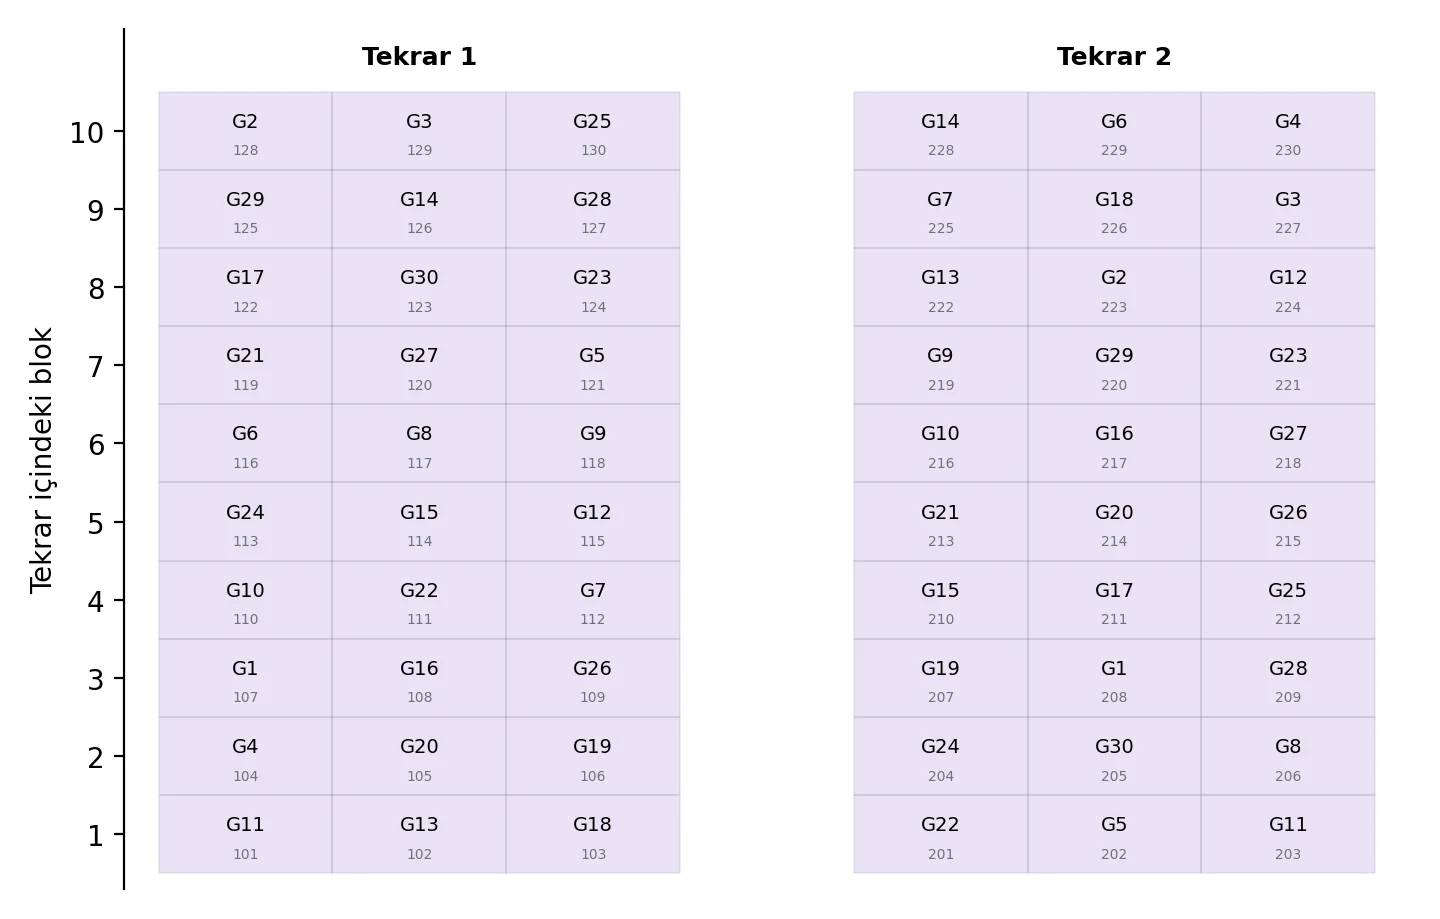
| 129–147 | Üretim: etkinlik, özet tablosu, tarla planı tablosu, "Tarla düzeni" çizimi. | Plan tablosu sütunları: parsel, tekrar, blok, sütun, genotip (136). |
| 148–164 | Çözümleme: sütun seçimi, eksik satırların atılması, etmenler, yapı denetimleri. | Blok etiketi tekrar:blok biçiminde birleştirilir (158). |
| 165–179 | Model formülü, lmer, varyans bileşenleri, log-olabilirlik, etkinlik. |
Etkinlik yalnız her genotip eşit sayıda ve bloklar eşit boydaysa hesaplanır (179). |
| 180–190 | Varyans bileşenleri ve "Model uyumu ve tasarım etkinliği" tabloları. | Üst sınır yalnız etkinlik hesaplanabildiyse yazılır (189). |
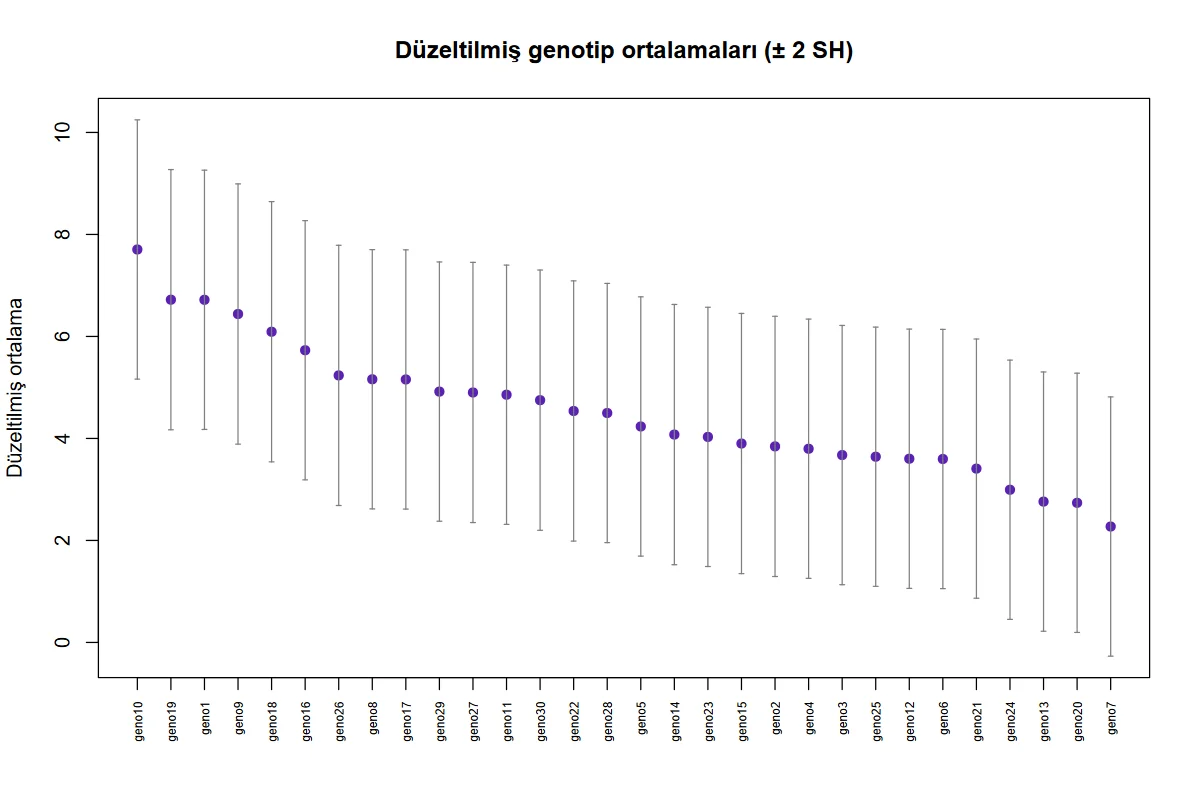
| 191–210 | Sabit genotip: Wald F, düzeltilmiş ortalamalar, SED, ortalama grafiği. | Grafikteki çubuklar ± 2 SH'dir, güven aralığı değildir (206–208). |
| 211–240 | Rastgele genotip: BLUP, Henderson PEV'i, Cullis H^2, BLUP histogramı. | PEV tam matristen; kovaryanslar H^2'ye girer (228–230). |
| 241–243 | Toplanan uyarıların yazılması. | Uyarı yoksa satır yazılmaz. |
Etkinlik hesabının koşulu (satır 176–179) eksik parselli veride önem kazanır. Kod önce genotip başına ortalama parsel sayısını (r_ort) ve ortalama blok boyunu (k_ort) bulur; ikisi de tamsayıysa etkinlik() çağrılır, değilse sonuç NA olur. Eksik parsel varsa bu ortalamalar tamsayı çıkmaz; etkinlik ve üst sınır boş bırakılır, karma model yine uydurulur.
2.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/alfa_kafes/elle_hesap.py ile hesaplanmıştır. Bu betik lme4'ü ve şablon kodunu kullanmaz: REML denklemlerini numpy ile, Fisher puanlama yinelemesiyle (skor vektörü ve beklenen bilgi matrisi) doğrudan çözer; sabit etkileri GLS ile, BLUP ve PEV'i karma model denklemleriyle hesaplar. R tarafında aynı model nlme::lme ile kurulmuş, etkinlik çarpanı farklı bir yoldan (ikil tasarımın özdeğerlerinden) bulunmuştur (r_dogrulama.R).
Adım 1 — Rastlantı matrisi ve etkinlik. t=30, b=20, r=2, k=3, s=10. Her genotip 2 blokta, her blokta 3 genotip vardır; 435 genotip çiftinin 60'ı bir blokta buluşur, 375'i hiç buluşmaz (\alpha(0{,}1)). \mathbf C/r'nin 29 sıfır dışı özdeğerinden 11'i 1'dir; geri kalan 18'i çiftler hâlinde 1'e tamamlanır:
| Çarpan çifti | 0,0637 / 0,9363 | 0,2303 / 0,7697 | 0,3333 / 0,6667 | 0,3970 / 0,6030 | 0,4363 / 0,5637 |
|---|---|---|---|---|---|
| Kaç kez | 2 | 2 | 1 | 2 | 2 |
En küçük iki çarpan (0,0637) toplamın 31,4'ünü tek başına üretir; ortalama etkinliği düşüren bu iki karşılaştırmadır.
Adım 2 — REML: Fisher puanlama. Sabit genotipte p=30, n-p=30. Üç bileşen örneklem varyansının üçte biriyle (5{,}5073/3=1{,}8358) başlatılır. Her adımda skor ve beklenen bilgi matrisi hesaplanır, \boldsymbol\sigma^2\leftarrow\boldsymbol\sigma^2+\mathbf I^{-1}\mathbf s uygulanır; negatife geçen bileşen sıfırda tutulur.
| Yineleme | \sigma^2_b | \sigma^2_r | \sigma^2_e | \ell_R |
|---|---|---|---|---|
| 0 | 1,835782 | 1,835782 | 1,835782 | −76,636149 |
| 1 | 5,132120 | 0 | 1,179229 | −74,780180 |
| 2 | 3,168037 | 0 | 1,840342 | −74,151530 |
| 3 | 4,034153 | 0 | 1,544852 | −74,067815 |
| 4 | 3,619974 | 0 | 1,706061 | −74,042622 |
| 5 | 3,821169 | 0 | 1,632312 | −74,037579 |
| son (41) | 3,756077 | 0 | 1,657119 | −74,035966 |
Tekrar varyansı ilk adımda sınıra iner ve orada kalır: iki tekrarın ortalamaları (4,63 ve 4,43) blok varyansının açıklayabileceğinden daha yakındır. Son noktada olabilirliğin parçaları:
\mathbf y^{\top}\hat{\mathbf P}\mathbf y=n-p eşitliği REML çözümünün bir özelliğidir ve yakınsamanın denetimi olarak kullanılabilir.
Adım 3 — Düzeltilmiş ortalamalar. GLS çözümünde her genotipin düzeltilmiş ortalaması, parsel değerlerinden blok etkilerinin öngörüleri (\hat u_b=\hat\sigma^2_b\mathbf Z_b^{\top}\hat{\mathbf P}\mathbf y) çıkarıldıktan sonraki ortalamaya eşittir:
| Genotip | Parsel (tekrar:blok) | y | \hat u_b | y-\hat u_b | Ham ort. | Düzeltilmiş ort. |
|---|---|---|---|---|---|---|
geno10 |
1:4 | 9 | 0,7216 | 8,2784 | ||
| 2:16 | 5 | −2,1318 | 7,1318 | 7,0 | 7,7051 | |
geno19 |
1:2 | 9 | 1,6689 | 7,3311 | ||
| 2:13 | 7 | 0,8899 | 6,1101 | 8,0 | 6,7206 | |
geno7 |
1:4 | 2 | 0,7216 | 1,2784 | ||
| 2:19 | 5 | 1,7321 | 3,2679 | 3,5 | 2,2731 |
geno10'un ikinci parseli denemenin en zayıf bloklarından birindedir (\hat u_b=-2{,}13); düzeltme ortalamasını 7,0'dan 7,71'e yükseltir. geno19'un iki parseli de iyi bloklardadır; ortalaması 8,0'dan 6,72'ye iner. Blok etkisi öngörüleri −2,80 ile 3,33 arasında değişir.
Adım 4 — Standart hatalar ve tasarımın kazancı. Düzeltilmiş ortalamaların SH'si iki değer alır: 1,270782 (20 genotip) ve 1,275590 (10 genotip); fark, genotiplerin blok komşuluklarının aynı olmamasından gelir. İkili farkların standart hatası 1,4564 ile 1,7945 arasında değişir:
| Çift türü | Çift sayısı | Farkın SH'si (karesel ortalama) |
|---|---|---|
| Aynı blokta buluşan | 60 | 1,461835 |
| Hiç buluşmayan | 375 | 1,739711 |
| Bütün çiftler (SED) | 435 | 1,704079 |
Aynı veri blok yok sayılarak tam bloklu tasarım gibi çözümlenirse (genotip + tekrar) hata kareler ortalaması 6,668966 (sd 29) ve fark standart hatası \sqrt{2\cdot6{,}668966/2}=2{,}582434 olur. Göreli etkinlik (2{,}582434/1{,}704079)^2=2{,}30'dur: tamamlanmamış bloklar, etkinlik çarpanı 0,38 olmasına karşın farkların varyansını yarıdan fazla küçültmüştür. Bunun nedeni blok varyansının (3,76) artık varyansın (1,66) iki katından büyük olmasıdır.
Adım 5 — Wald F. 29 genotip katsayısı ve kovaryans matrisiyle:
Adım 6 — Rastgele genotip. Dört bileşenli modelde (p=1) REML çözümü \hat\sigma^2_g=0{,}555014, \hat\sigma^2_b=3{,}579155, \hat\sigma^2_r=0, \hat\sigma^2_e=1{,}582996; \ell_R=-124{,}673891. geno10 için ham ortalamanın genel ortalamadan sapması 7{,}0-4{,}5333=2{,}4667 iken BLUP 1,0384'tür: blok düzeltmesi ve büzülme birlikte etkir. PEV köşegeni 0,379770 ve 0,379789 değerlerini alır.
Karşılaştırma için: PEV'lerin kovaryansı yok sayılırsa 1-\overline{\operatorname{PEV}}/\hat\sigma^2_g=1-0{,}379777/0{,}555014=0{,}3157; klasik formül 0{,}555014/(0{,}555014+1{,}582996/2)=0{,}4122 verir.
2.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–4). İlk tablo, olabilirliğin en büyük noktasına bağlı büyüklükleri üç yöntemle karşılaştırır.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Ortalama etkinlik çarpanı E (çözümleme) | 0,37750304 | 0,37750304 | 0,37750304 | 1,8e−15 | ✓ |
| Ortalama etkinlik çarpanı E (üretilen tasarım) | 0,37750304 | 0,37750304 | 0,37750304 | 1,8e−15 | ✓ |
| Patterson–Williams üst sınırı | 0,61702128 | 0,61702128 | 0,61702128 | 3,3e−16 | ✓ |
| Genel ortalama | 4,53333333 | 4,53333333 | — | 7,8e−16 | ✓ |
| Sabit genotip: REML log-olabilirlik | −74,03596613 | −74,03596613 | −74,03596613 | 3,5e−12 | ✓ |
| Sabit genotip: \hat\sigma^2_b blok(tekrar) | 3,75605014 | 3,75607652 | 3,75607653 | 7,0e−6 | ✗ |
| Sabit genotip: \hat\sigma^2_r tekrar | 0 | 0 | 0 | 0 | ✓ |
| Sabit genotip: \hat\sigma^2_e artık | 1,65712852 | 1,65711865 | 1,65711865 | 6,0e−6 | ✗ |
| Sabit genotip: değişim katsayısı (%) | 28,39621415 | 28,39612958 | — | 3,0e−6 | ✗ |
| Sabit genotip: Wald F | 1,40460219 | 1,40460952 | 1,40460952 | 5,2e−6 | ✗ |
| Sabit genotip: düzeltilmiş ortalama geno10 | 7,70509645 | 7,70509849 | 7,70509849 | 2,7e−7 | ✓ |
| Sabit genotip: düzeltilmiş ortalama geno19 | 6,7206074 | 6,72060281 | 6,72060281 | 6,8e−7 | ✓ |
| Sabit genotip: düzeltilmiş ortalama geno7 | 2,2731381 | 2,27313609 | 2,27313609 | 8,9e−7 | ✓ |
| Sabit genotip: SH (geno10) | 1,27078353 | 1,27078208 | 1,27078208 | 1,1e−6 | ✗ |
| ML: \hat\sigma^2_b | 3,42166347 | 3,42170751 | 3,42170751 | 1,3e−5 | ✗ |
| ML: \hat\sigma^2_e | 0,56140084 | 0,5613975 | 0,5613975 | 3,3e−6 | ✗ |
| Rastgele genotip: REML log-olabilirlik | −124,6738908 | −124,6738908 | −124,6738908 | 4,3e−12 | ✓ |
| Rastgele genotip: \hat\sigma^2_g | 0,55499707 | 0,55501366 | 0,55501366 | 1,7e−5 | ✗ |
| Rastgele genotip: \hat\sigma^2_b | 3,57915401 | 3,57915461 | 3,57915461 | 1,7e−7 | ✓ |
| Rastgele genotip: \hat\sigma^2_e | 1,58300947 | 1,58299597 | 1,58299597 | 8,5e−6 | ✗ |
| Rastgele genotip: Cullis H^2 | 0,32661428 | 0,32662227 | 0,32662227 | 8,0e−6 | ✗ |
| Rastgele genotip: BLUP geno10 | 1,03837213 | 1,03839763 | 1,03839763 | 2,5e−5 | ✗ |
Ölçütü karşılayan: 11/22. Python: Fisher puanlama yinelemesiyle REML/ML (numpy; lme4 kullanılmadan), GLS ve Henderson denklemleri. R: nlme::lme (rastgele genotipte pdBlocked + açık Fisher puanlama adımları), etkinlik ikil tasarımın özdeğerlerinden. Python ve R sütunları birbiriyle 10^{-9} içinde aynıdır; ✗ satırlarındaki fark şablonun lmer çağrısındaki eniyileyicinin durma toleransından gelir (log-olabilirlikler 10^{-9} içinde eşittir).
Bağımsız Python ve R çözümleri birbirleriyle 10^{-9} içinde aynıdır ve log-olabilirlikleri MerQuR+'ınkinden 3\times10^{-10} daha büyüktür. MerQuR+'ın varyans bileşenleri bu çözümden göreli 10^{-5} düzeyinde ayrılır; fark, lmer'in eniyileyicisinin yassı REML yüzeyinde durduğu noktadan gelir (2.4.3) ve ortalamalara, standart hatalara, F'ye ve H^2'ye aynı büyüklükte yansır. Dört ondalıkla raporlanan sonuçların hiçbiri değişmez. Formüllerin kendisini eniyileyici farkından ayırmak için ikinci tabloda aynı büyüklükler, MerQuR+'ın yazdığı varyans bileşenleri yerine konarak yeniden hesaplanmıştır.
| Büyüklük | MerQuR+ | Python (şablonun \hat\sigma^2'leriyle) | R | En büyük fark | |
|---|---|---|---|---|---|
| Wald F | 1,40460219 | 1,40460219 | — | 6,3e−16 | ✓ |
| KT (genotip) | 67,50058413 | 67,50058413 | — | 1,5e−15 | ✓ |
| Düzeltilmiş ortalama geno10 | 7,70509645 | 7,70509645 | — | 6,9e−16 | ✓ |
| Düzeltilmiş ortalama geno19 | 6,7206074 | 6,7206074 | — | 3,3e−15 | ✓ |
| Düzeltilmiş ortalama geno1 | 6,71857817 | 6,71857817 | — | 8,7e−15 | ✓ |
| Düzeltilmiş ortalama geno9 | 6,43989995 | 6,43989995 | — | 1,8e−15 | ✓ |
| Düzeltilmiş ortalama geno7 | 2,2731381 | 2,2731381 | — | 4,7e−15 | ✓ |
| SH (geno10; 2 tekrar, aynı yapı) | 1,27078353 | 1,27078353 | — | 2,3e−15 | ✓ |
| SH (geno19) | 1,27559114 | 1,27559114 | — | 1,7e−15 | ✓ |
| Cullis H^2 | 0,32661428 | 0,32661428 | — | 5,6e−17 | ✓ |
| BLUP geno10 | 1,03837213 | 1,03837213 | — | 1,1e−15 | ✓ |
| BLUP geno18 | 0,72866634 | 0,72866634 | — | 1,1e−16 | ✓ |
| BLUP geno7 | −0,90803411 | −0,90803411 | — | 1,0e−15 | ✓ |
| PEV geno10 | 0,37976306 | 0,37976306 | — | 1,1e−16 | ✓ |
| PEV geno18 | 0,37978218 | 0,37978218 | — | 1,0e−15 | ✓ |
| REML log-olabilirlik (sabit) | −74,03596613 | −74,03596613 | — | 1,9e−16 | ✓ |
| REML log-olabilirlik (rastgele) | −124,6738908 | −124,6738908 | — | 3,1e−15 | ✓ |
Ölçütü karşılayan: 17/17. Python sütunu, MerQuR+'ın varyans bileşenleri tablosundaki değerler yerine konarak açık formüllerle (GLS, Wald, Henderson, Cullis) hesaplanmıştır; R sütunu bu tabloda kullanılmaz.
Varyans bileşenleri aynı alındığında GLS ortalamaları, standart hatalar, Wald F, BLUP, Henderson PEV'i ve Cullis H^2 makine hassasiyetinde örtüşür.
2.7 Çıktıyı okuma
Çalıştırma 1'in (örnek ayar) metin çıktısı:
n = 60 parsel; 30 genotip, 2 tekrar, 20 blok; REML log-olabilirlik = -74,03597
İki genotip farkının ortalama standart hatası (SED) = 1,7041
"Varyans bileşenleri (REML)" ve "Model uyumu ve tasarım etkinliği" tabloları:
| bilesen | varyans | olcut | deger | |
|---|---|---|---|---|
| blok(tekrar) | 3,7561 | REML log-olabilirlik | −74,0360 | |
| tekrar | 0,0000 | −2 REML log-olabilirlik | 148,0719 | |
| artık | 1,6571 | genel ortalama | 4,5333 | |
| değişim katsayısı (%) | 28,3962 | |||
| ortalama etkinlik çarpanı (gerçek) | 0,3775 | |||
| Patterson-Williams üst sınırı | 0,6170 |
"Genotip için Wald F testi": pay sd 29, KT 67,5006, KO 2,3276, F 1,4046. "Düzeltilmiş genotip ortalamaları" tablosunun ilk ve son satırları:
| genotip | ham_ortalama | duzeltilmis_ortalama | SH |
|---|---|---|---|
| geno10 | 7,0 | 7,7051 | 1,2708 |
| geno19 | 8,0 | 6,7206 | 1,2756 |
| geno1 | 7,5 | 6,7186 | 1,2708 |
| geno9 | 6,5 | 6,4399 | 1,2756 |
| … | |||
| geno20 | 2,5 | 2,7382 | 1,2708 |
| geno7 | 3,5 | 2,2731 | 1,2708 |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İlk satır | Parsel, genotip, tekrar ve blok sayıları; log-olabilirlik | Blok sayısı tekrar × tekrar başına blok olmalıdır (20 = 2 × 10); değilse blok sütunu yanlış seçilmiştir. |
| Varyans bileşenleri | \hat\sigma^2_b, \hat\sigma^2_r, \hat\sigma^2_e (ve rastgele genotipte \hat\sigma^2_g) | \hat\sigma^2_b\gg\hat\sigma^2_e ise bloklama işe yaramıştır. Sıfır tekrar varyansı kusur değildir. |
| −2 log-olabilirlik | Model karşılaştırma ölçüsü | REML değerleri yalnız aynı sabit etkili modeller arasında karşılaştırılır; sabit ve rastgele genotipli modellerin değerleri (148,07 ve 249,35) birbiriyle karşılaştırılamaz. |
| Değişim katsayısı | 100\sqrt{\hat\sigma^2_e}/\bar y | Blok etkisinden arındırılmış parsel hatasına göredir. |
| Etkinlik çarpanı (gerçek) | E | Blok içi bilginin tam bloklu tasarıma oranı; tasarımın özelliğidir, veriye bağlı değildir. |
| Üst sınır | E_{\max} | Bu t, r, s ile ulaşılabilecek en iyi değer; gerçek değer bundan küçüktür. |
| Wald F | Genotip farklarının toplu ölçüsü | p değeri verilmez; 2.9, S3. |
| Düzeltilmiş ortalama, SH | \hat\mu_i ve standart hatası | Sıralama ve seçim bu sütuna göre yapılır; SH tek bir ortalamanın belirsizliğidir, iki ortalamanın farkı için SED kullanılır. |
| SED satırı | Ortalama fark standart hatası | Kabaca 2\times\mathrm{SED}=3{,}41'den büyük farklar dikkate değerdir. |
Şekil 2.1. Şablonun çizdiği düzeltilmiş genotip ortalamaları (örnek veri; büyükten küçüğe). Çubuklar ± 2 SH'dir. Çubukların hemen hepsi üst üste biner: bu denemede genotip farkları, tek tek ortalamaların belirsizliğine göre küçüktür.
Rastgele genotip (çalıştırma 2) çıktısında Wald F ve düzeltilmiş ortalamalar yerine iki tablo gelir. "Kalıtım derecesi": genotip varyansı 0,5550; Cullis H^2 0,3266. "Genotip BLUP'ları": geno10 BLUP 1,0384, tahmini değer 5,5717, PEV 0,3798; geno7 BLUP −0,9080, tahmini değer 3,6253. Tahmini değerlerin aralığı (3,63–5,57) düzeltilmiş ortalamalarınkinden (2,27–7,71) çok dardır: H^2=0{,}33 iken gözlenen farkların üçte ikisi gürültü sayılır ve geri çekilir. Şekil olarak BLUP'ların histogramı çizilir.
Üretim kipi (çalıştırma 4) iki tablo verir. "Alfa tasarımı (seri I)": t=30, k=3, s=10, r=2, parsel sayısı 60, gerçek etkinlik 0,3775, üst sınır 0,6170, tohum 5. Başlıktaki "seri", agricolae'nin kullandığı alfa dizisinin türüdür (I–IV); parsel numaralandırma serisiyle ilgisi yoktur. "Tarla planı (tasarım kitabı)" her parsel için parsel numarasını, tekrarı, bloğu, blok içindeki sırayı ve genotipi verir; tarlaya bu tablo götürülür. Blok numaraları tekrarlar boyunca sürer (2. tekrarın blokları 11–20'dir). Şekil 2.2 bu tablodan çizilmiştir.
Şekil 2.2. Üretim kipinin tarla planı tablosundan çizilen yerleşim (t = 30, k = 3, r = 2, tohum 5). Her satır bir tamamlanmamış bloktur; kutularda genotip ve parsel numarası yazar. Örnek veri bu planın verisidir (G11 = geno11).
Rapor cümlesi:
Otuz genotip, iki tekrarlı ve üç parsellik bloklu bir alfa tasarımında (60 parsel; ortalama etkinlik çarpanı 0,38) denendi. Verim, genotipin sabit, tekrar ve tekrar içi bloğun rastgele alındığı doğrusal karma modelle (REML) çözümlendi. Tekrar içi blok varyansı 3,76, artık varyans 1,66, tekrar varyansı 0 olarak kestirildi; değişim katsayısı %28,4 idi. Düzeltilmiş genotip ortalamaları 2,27 ile 7,71 arasında değişti (iki ortalamanın farkının ortalama standart hatası 1,70); genotip etkisi için Wald F = 1{,}40 (pay sd = 29) bulundu. Genotip rastgele alındığında genotip varyansı 0,56 ve Cullis genelleştirilmiş kalıtım derecesi 0,33 idi.
2.8 Sık hatalar ve tuzaklar
- Blok sütunu yerine tekrar sütununu vermek. Blok sayısı tekrar sayısını aşmıyorsa şablon durur (satır 163). Blok ve tekrar ters verilirse model yine uyar ama varyans bileşenleri yanlış adlandırılır; ilk satırdaki "20 blok, 2 tekrar" sayıları denetlenmelidir.
- Üst sınırı tasarımın etkinliği sanmak. agricolae'nin yazdırdığı ve birçok kaynakta "etkinlik" diye geçen sayı E_{\max}'tır. Örnek tasarımda 0,62'ye karşılık gerçek değer 0,38'dir. Tasarım seçerken birkaç k değeri üretim kipinde denenip gerçek E karşılaştırılmalıdır.
- Düşük etkinlik çarpanından tasarımın kötü olduğu sonucunu çıkarmak. E blok varyansını hesaba katmaz. Örnek veride E=0{,}38 olduğu hâlde tasarım, tam bloklu çözümlemeye göre fark varyansını 2,3 kat küçültür.
- Ham ortalamalarla sıralama yapmak.
geno19ham ortalamada birinci, düzeltilmiş ortalamada ikincidir;geno16ham ortalamada (5,0) ortalarda, düzeltilmişte (5,73) altıncıdır. Seçim düzeltilmiş ortalamaya ya da BLUP'a göre yapılır. - Sabit genotipli modelde ML seçmek. Parametrelerin yarısı sabit etki olduğunda ML artık varyansı 1,66 yerine 0,56 verir, SED'i 1,70'ten 1,08'e ve Wald F'yi 1,40'tan 4,01'e taşır. Bu fark bilgi kazancı değil, ML'nin yanlılığıdır.
- Wald F'yi tablo değeriyle karşılaştırıp karar vermek. Tabloda payda sd'si ve p yoktur. Blok içi artık sd'siyle (n-t-(b-1)=11) yaklaşık bir p hesaplanabilir (0,28); \chi^2 yaklaşımı (0,07) küçük denemede fazla iyimserdir.
- Tek tek SH çubuklarından fark okumak. Şekildeki çubuklar ± 2 SH'dir ve blok varyansını içerir; iki genotipin farkının belirsizliği (SED 1,70) iki SH'nin karesel toplamından (\sqrt2\cdot1{,}27=1{,}80) küçüktür, çünkü ortak blok etkileri farkta sadeleşir.
- Tohumu kaydetmemek. Tohum 0 bırakılırsa her çalıştırma farklı bir plan üretir; kullanılan tohum özet tablosunun son satırındadır ve deneme defterine yazılmalıdır.
- Eksik parselli veride etkinlik beklemek. Eksik parsel varsa etkinlik ve üst sınır boş çıkar (satır 179); düzeltilmiş ortalamalar ve SH'ler yine doğrudur, yalnız genotipten genotipe daha çok değişir.
- Genotip kimliklerinin tasarımdakiyle uyuşmaması. Üretim kipi genotipleri
G1 … Gtdiye adlandırır. Gerçek adlar plan tablosuna sonradan eşlenir; verim girilirken eşleme tablosu kullanılmalıdır.
2.9 Uzman soruları
S1. Tekrar varyansı sıfır çıktı; tekrar terimi modelden çıkarılmalı mı?
Gerekmez. Sınırdaki bir bileşen olabilirliğe katkı vermez; tekrar terimi çıkarılmış model aynı olabilirliği, aynı blok ve artık varyanslarını, aynı düzeltilmiş ortalamaları verir. R doğrulamasında iki model de kurulmuştur: log-olabilirlikler −74,035966 ile aynıdır, iç içe modelde tekrar varyansı 6\times10^{-9} çıkar. Terimi modelde tutmak tasarımın rastgeleleştirme yapısını yansıtır ve başka bir veride tekrar farkı varsa onu yakalar.
S2. Blok sabit alınsaydı ne değişirdi?
Blok içi çözümleme elde edilirdi: genotip farkları yalnız aynı blokta buluşan parsellerden, bağlantılar üzerinden kestirilirdi ve ortalama fark varyansı 2\sigma^2_e/(rE) olurdu. E=0{,}3775 ile bu, 2\cdot\sigma^2_e/0{,}755 demektir. Rastgele blok modeli bloklar arası bilgiyi de kullanır; kazanç \sigma^2_b/\sigma^2_e oranı küçüldükçe artar. Etkinliği düşük tasarımlarda (bu örnek gibi) bloklar arası bilginin payı büyüktür ve rastgele blok modeli belirgin biçimde daha kesindir. Buna karşılık blok sayısı azsa \sigma^2_b kötü kestirilir; o durumda sabit blok daha güvenlidir.
S3. Wald F için neden p değeri verilmiyor?
lme4::anova payda serbestlik derecesi hesaplamaz; varyans bileşenleri kestirildiğinde F istatistiğinin dağılımı kesin değildir. İki yaklaşık yol vardır: Kenward–Roger düzeltmesi (hem F'yi ölçekler hem sd'yi kestirir) ve Satterthwaite sd'si. Şablon ikisini de uygulamaz. Aynı modelin nlme ile uydurulmasında payda sd'si 11 alınır ve p=0{,}282 çıkar; 29F=40{,}73'ün \chi^2_{29} ile karşılaştırılması p=0{,}073 verir. İkisinin arasındaki fark, 60 parsellik bir denemede payda belirsizliğinin ne kadar önemli olduğunu gösterir. Kesin bir test gerekiyorsa model r_emmeans_kontrast şablonuyla ya da kodu düzenleyip lmerTest ile uydurulur.
S4. Etkinlik çarpanı neden veriden değil tasarımdan hesaplanıyor?
\mathbf C matrisi yalnız rastlantı matrisine bağlıdır; yanıt değerleri girmez. Bu yüzden üretim kipi (veri yokken) ile çözümleme kipi aynı sayıyı verir: 0,3775. Veriye bağlı olan, bu etkinliğin ne kadar önemli olduğudur: \sigma^2_b büyükse blok içi bilgi baskındır ve E belirleyicidir; \sigma^2_b küçükse bloklar arası bilgi kaybı telafi eder.
S5. Henderson PEV'i ile lme4'ün condVar değeri arasındaki fark ne kadar?
condVar, rastgele etkilerin sabit etkiler ve varyans bileşenleri bilinirken koşullu varyansıdır; \hat\mu'nün kestirim hatasını ve genotipler arası kovaryansı içermez. Henderson PEV'i ikisini de içerir ve H^2_C için gereken, farkların varyansıdır. Örnek veride yalnız köşegen kullanılırsa 1-\overline{\operatorname{PEV}}/\hat\sigma^2_g=0{,}316, kovaryanslarla birlikte Cullis tanımı 0,327 çıkar. Kovaryanslar pozitiftir (ortak \hat\mu ve ortak bloklar), bu yüzden farkların varyansı 2\,\overline{\operatorname{PEV}}'den küçüktür.
S6. Sabit mi, rastgele mi genotip?
Soruya bağlıdır. Belirli çeşitlerin ortalamaları raporlanacak ve karşılaştırılacaksa (tescil, çeşit önerisi) genotip sabittir; düzeltilmiş ortalamalar yansızdır. Çok sayıda hattan en iyileri seçilecekse (ıslah) genotip rastgeledir; BLUP'lar büzülerek seçim hatasını azaltır ama tek tek genotiplerin ortalaması olarak yorumlanmaz. İki modelin sıralaması çoğunlukla benzerdir; örnek veride ilk beş genotip iki modelde de aynıdır, sıraları farklıdır (BLUP'ta geno18 ikinci, düzeltilmiş ortalamada beşinci).
S7. Kare kafes ya da dikdörtgen kafes için ayrı bir çözümleme gerekir mi?
Hayır. Kafes tasarımları alfa tasarımlarının özel durumudur (k=s kare, k=s-1 dikdörtgen kafes) ve aynı karma modelle çözümlenir. Klasik kafes çözümlemesinin "düzeltilmiş genotip toplamları" ve ağırlık katsayıları, bu modelin dengeli tasarımdaki kapalı biçimidir (Yates, 1936). Üretim kipinde t=9, k=3, r=2 seçildiğinde üretilen 3 × 3 kafesin gerçek etkinliği üst sınıra eşittir (0,6667).
S8. Varyans bileşenlerinin altıncı basamağı neden bağımsız hesapla aynı değil?
REML olabilirliği en büyük noktanın çevresinde yassıdır: varyans bileşenleri göreli 10^{-5} kadar değiştiğinde log-olabilirlik 10^{-10} kadar değişir. Türevsiz eniyileyici, olabilirlikteki değişim toleransının altına indiğinde durur; bu noktada parametreler beş-altı anlamlı basamağa kadar belirlidir. Skor denklemlerini doğrudan çözen Fisher puanlama aynı noktayı on üç basamakla verir. Fark istatistiksel belirsizliğin (SH'lerin) yanında on binlerce kat küçüktür ve hiçbir yorumu değiştirmez; yalnız başka bir yazılımla yedinci basamakta karşılaştırma yapıldığında görünür.
S9. Tekrar sayısı neden 2–4 ile sınırlı?
Patterson ve Williams'ın (1976) alfa dizileri r=2{,}3{,}4 için çizelgelenmiştir ve agricolae bu dizileri kullanır. Daha çok tekrar için dizinin ilk sütunları yinelenebilir ya da bilgisayar aramasıyla yeni diziler bulunur (Patterson, Williams ve Hunter, 1978); bunlar bu şablonda yoktur. Dört tekrardan fazlası gerekiyorsa optimal_tasarim şablonu kullanılır.
2.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Cullis, B. R., Smith, A. B., & Coombes, N. E. (2006). On the design of early generation variety trials with correlated data. Journal of Agricultural, Biological, and Environmental Statistics, 11(4), 381–393. https://doi.org/10.1198/108571106X154443
- de Mendiburu, F. (2023). agricolae: Statistical procedures for agricultural research (R paketi, sürüm 1.3-7). https://doi.org/10.32614/CRAN.package.agricolae
- Henderson, C. R. (1975). Best linear unbiased estimation and prediction under a selection model. Biometrics, 31(2), 423–447. https://doi.org/10.2307/2529430
- Kenward, M. G., & Roger, J. H. (1997). Small sample inference for fixed effects from restricted maximum likelihood. Biometrics, 53(3), 983–997. https://doi.org/10.2307/2533558
- Patterson, H. D., & Thompson, R. (1971). Recovery of inter-block information when block sizes are unequal. Biometrika, 58(3), 545–554. https://doi.org/10.1093/biomet/58.3.545
- Patterson, H. D., & Williams, E. R. (1976). A new class of resolvable incomplete block designs. Biometrika, 63(1), 83–92. https://doi.org/10.1093/biomet/63.1.83
- Patterson, H. D., Williams, E. R., & Hunter, E. A. (1978). Block designs for variety trials. The Journal of Agricultural Science, 90(2), 395–400. https://doi.org/10.1017/S0021859600055507
- Piepho, H.-P., & Möhring, J. (2007). Computing heritability and selection response from unbalanced plant breeding trials. Genetics, 177(3), 1881–1888. https://doi.org/10.1534/genetics.107.074229
- Yates, F. (1936). A new method of arranging variety trials involving a large number of varieties. The Journal of Agricultural Science, 26(3), 424–455. https://doi.org/10.1017/S0021859600022760