178. Büyüme karışım modeli ve gizil sınıf büyüme analizi (lcmm)
Şablon kimliği: buyume_karisim · Kategori: yapısal eşitlik / gizil değişken · Dil: R · Dosya: pro/sablonlar/yem/buyume_karisim.R (satır 1–222; üstbilgi 1–103) · Örnek veri: _ornek/paquid.csv · Paketler: lcmm 2.2.2, R 4.5.3
178.1 Ne işe yarar
Şablon, aynı bireylerden yinelenen ölçümlerde gelişim yörüngelerinin gözlenmeyen alt gruplarını (gizil sınıflar) arar. Her bireyin hangi sınıftan geldiği bilinmez; şablon hem sınıfların ortalama yörüngelerini hem de her bireyin sınıflara ait olma olasılığını birlikte kestirir (Proust-Lima ve ark., 2017; lcmm::hlme). Zamanın doğrusal, karesel ya da kübik polinomu (ham kuvvetler) her sınıfa özgü ortalama yörüngeyi verir. Ortak değişkenlerin etkisi sınıflar arasında ortaktır.
- y_{ij}: i. bireyin j. ölçümü; t_{ij}: zaman; c_i: bireyin gizil sınıfı (1,\dots,G).
- \beta_{0g},\beta_{1g},\beta_{2g}: g. sınıfın kesişimi ve zaman katsayıları (derece 2 için); \boldsymbol\delta: ortak değişkenlerin (ortak) etkisi; \mathbf w_i: ortak değişkenler.
- \mathbf z_{ij}: rastgele etkilerin tasarım vektörü; \mathbf b_i\sim N(\mathbf 0,\mathbf G): bireyin rastgele etkileri; \varepsilon_{ij}\sim N(0,\sigma^2).
- \gamma_g: sınıf üyeliği çok terimli lojit kesişimleri; son sınıf başvurudur (\gamma_G=0). Üyeliği açıklayan ortak değişken bu şablonda yoktur.
Rastgele etkilerin yapısına göre üç model vardır (rastgele):
| Seçenek | \mathbf z_{ij} | Ad |
|---|---|---|
tam |
(1,t,t^2,\dots): polinomun bütün terimleri | Büyüme karışım modeli (GMM) |
kesisim |
(1) | Sınıfa özgü yörünge + rastgele kesişim |
yok |
boş: \mathbf V_i=\sigma^2\mathbf I | Gizil sınıf büyüme analizi (LCGA; Nagin, 1999) |
GMM'de (Muthén ve Shedden, 1999) birey içi değişim sınıf yörüngesi etrafında rastgele etkilerle de yayılır; LCGA'da sınıf içinde bütün bireyler aynı yörüngeyi izler ve sınıf içi bireyler arası değişim hiç yoktur. Şablonda \mathbf G sınıflar arasında ortaktır (yapısız kovaryans); sinifa_ozgu_varyans açıkken sınıfa göre orantılı değişir.
Her g=1,\dots,G_{\max} için model kurulur ve BIC ile karşılaştırılır; çok sınıflı modellerin başlangıç değerleri tek sınıflı modelden üretilir. Yerel en büyüklere karşı isteğe bağlı bir ızgara araması vardır; karşılaştırma tablosu her modelin kullandığı başlangıç sayısını (baslangic sütunu) yazar ve tek başlangıçla kurulan üç ve daha çok sınıflı modeller için yerel en büyük uyarısı verir.
Ne zaman kullanılır?
- Boylamsal ölçümlerde ortalama eğrinin tüm bireyleri temsil etmediğinden şüpheleniliyorsa (ör. bilişsel gerileme hızı gruplara göre çok farklı).
- Sınıf sayısı bilinmiyorsa ve BIC ile birlikte yörünge biçimlerinden seçilmek isteniyorsa.
- Birey sayısı yeterince büyükse (şablon alt sınırı 10\,G bireydir) ve her birey için en az iki ölçüm varsa (bireylerin en az yarısında).
Ne zaman kullanılmaz?
- Tek bir ortalama yörünge ve bireyler arası farklılık yeterliyse: temel programın doğrusal karma modeli ya da gizil büyüme eğrisi
gizil_buyume(Bölüm 181). Bu şablon sınıfsız modeli yalnız G=1 satırı olarak verir. - Yanıt sürekli değilse (sayım, ikili, sıralı):
hlmeGauss yanıt içindir; bağlantı işlevli ya da sıralı model bu şablonda yoktur. - Sınıf üyeliği ortak değişkenlerle açıklanmak isteniyorsa (
classmb): bu şablon üyeliği yalnız kesişimle modeller. - Sınıflar arası geçiş (zamana göre değişen sınıf) isteniyorsa:
gizil_gecis(Bölüm 183). - Aykırı bireylerin sahte sınıf yarattığından şüphelenilen ya da normal olmayan artıklı veri: GMM, rastgele etkilerin normalliğine duyarlıdır ve çarpık dağılımı sahte sınıf olarak ayrıştırabilir (Bauer ve Curran, 2003; 178.8).
Temel programla ilişki. Temel programda gizil sınıf (LCA) ve gizil profil (LPA) analizleri tek zamanlı göstergelerden grup bulur; boylamsal yörünge sınıflaması yoktur. Temel programdaki karma model yörüngeyi tek bir ortalama eğri ve bireye özgü rastgele etkilerle verir; bu şablon, o modeli sınıflar için çoğullar ve G=1 satırında aynı modeli (ortak değişkenli, polinomlu doğrusal karma model) kestirir.
178.2 Şablonun girdileri
Form, üstbilgideki 13 [[param]] bloğundan kurulur (buyume_karisim.R:11–102). Türlerin anlamı ve formun ortak denetimi Bölüm 1.2'dedir. Yanıt ve zaman sayisal_sutun türündedir, yani sayısal roldür: Veri sekmesinde türü "kategorik" olsa da R'ye sayı olarak gider (Bölüm 1.3). Birey kategorik_sutun; ortak değişkenler sutunlar türündedir ve sayısal rol değildir: metin sütunlar factor olur.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Boylamsal yanıt · y |
sayısal sütun · Değişkenler | uygun ilk sütun (Bölüm 1.2) | sayısal sütun | Yanıt (11–15, 108–118). |
Zaman değişkeni · zaman |
sayısal sütun · Değişkenler | uygun ilk sütun | sayısal sütun | Polinom terimlerinin kaynağı (16–20, 133–135). |
Birey (denek) kimliği · birey |
kategorik sütun · Değişkenler | uygun ilk sütun | sütun | Küme kimliği (21–25, 120). |
Ortak değişkenler · ortak |
sütunlar (isteğe bağlı) · Değişkenler | boş | sütunlar | Sınıflar arasında ortak etki (26–31, 109–110, 127–132). |
Zaman polinomunun derecesi · derece |
seçim · Model | 2 | 1, 2, 3 | Ham kuvvetler t,t^2,t^3 (32–38, 119, 134–135). |
En büyük sınıf sayısı · ng |
tamsayı · Model | 3 | 2–6 | 1'den G'ye kadar kurulur (39–46, 119, 161). |
Rastgele etkiler · rastgele |
seçim · Model | tam |
tam, kesisim, yok |
random formülü (47–53, 141). |
Izgara araması başlangıç sayısı · izgara |
tamsayı · Gelişmiş | 0 | 0–200 | gridsearch(rep =) (54–61, 160–168). |
Rastgele etki kovaryansı köşegen · kosegen_kov |
onay · Model | kapalı | açık/kapalı | idiag = TRUE (62–68, 143). |
Sınıfa özgü rastgele etki varyansı · sinifa_ozgu_varyans |
onay · Model | kapalı | açık/kapalı | nwg = TRUE (69–75, 142–143). |
En çok yineleme · maks_yineleme |
tamsayı · Gelişmiş | 500 | 10–100 000 | maxiter, yalnız 500'den farklıysa (76–84, 144). |
Yakınsama ölçütü · yakinsama_tol |
ondalık · Gelişmiş | 10^{-4} | 10^{-12}–0,1 | convB, convL, convG, yalnız farklıysa (85–93, 145). |
Izgara aramasında başlangıç başına yineleme · izgara_yineleme |
tamsayı · Gelişmiş | 15 | 1–1000 | gridsearch(maxiter =) (94–102, 167). |
Örnek ayar (ornek_param, satır 9): y = normMMSE, zaman = age65, birey = ID, ortak = [CEP], derece = 2, ng = 2, rastgele = tam, izgara = 0. Form varsayılanı G_{\max}=3'tür; örnek G_{\max}=2 ile çalışır.
Tohum. Şablonun kendi tohum alanı yoktur; izgara = 0 iken hiçbir adım rastgele değildir (ng = 3 için tohum 1 ve 7 aynı sonucu verir; en büyük fark 0). Izgara araması rastgele başlangıç ürettiğinden, izgara > 0 iken sonuç Kod panelindeki Tohum alanına (Bölüm 1.3) bağlıdır; şablon ayrıca tohum yazmaz.
Şablonun kendi denetimleri (mq_hata):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 107 |
| Yanıt, zaman, birey aynı sütun | "Yanıt, zaman ve birey farklı sütunlar olmalı." | 108 |
| Yanıt ya da zaman sayıya çevrilemiyor | "'…' sütunu sayıya çevrilemedi: … değer sayı değil …" (ortak yardımcı) | 111 |
| Tam gözlem <30 | "En az 30 tam gözlem gerekli." | 116 |
| Yanıt ya da zaman sabit | "Yanıt sabit." / "Zaman değişkeni sabit." | 117–118 |
| Birey sayısı <10\,G_{\max} | "G sınıf için en az 10G birey gerekli (şu an …)." | 123 |
| Bireylerin yarısından azında \ge2 ölçüm | "Bireylerin çoğunda tekrarlı ölçüm yok; boylamsal model kurulamaz." | 125 |
| Zamanın farklı değer sayısı \le derece | "Zamanın farklı değer sayısı polinom derecesi için yetersiz." | 126 |
| Ortak değişken sabit | "'…' sabit; ortak değişkenlerden çıkarın." | 127–132 |
Sınıfa özgü varyans ve rastgele = yok |
"Sınıfa özgü varyans yalnız rastgele etkili modelde kullanılabilir." | 142 |
| g sınıflı model kurulamadı | "g sınıflı model kurulamadı: …" | 154–155 |
| Tek sınıflı model yakınsamadı | "Tek sınıflı model yakınsamadı; zaman ölçeğini küçültmeyi (ör. yıl/10) ya da daha düşük derece deneyin; yineleme sınırını (şu an N) artırmak da yardımcı olabilir." | 158 |
| Izgara araması başarısız | "g sınıflı ızgara araması başarısız: …" | 167–168 |
Eksik değer. Yanıt, zaman, birey ve ortak değişkenlerden birinde eksik olan satır complete.cases ile atılır (113) ve atılan gözlem ile tümüyle kaybolan birey sayısı konsola yazılır (114–115): "N gözlem eksik değer nedeniyle çıkarıldı (n = 2250 → 2214); K birey modelden tümüyle çıktı." Örnek veride normMMSE'de 36 eksik vardır ve "36 gözlem eksik değer nedeniyle çıkarıldı (n = 2250 → 2214)" yazılır; ek 40 eksik yanıtla 3 birey tümüyle kaybolur (n = 2174 gözlem, 497 birey; 178.8).
Tek sınıflı model yakınsamadan çok sınıflı modellere geçilmez. Yineleme sınırı (10) tek sınıflı modele de uygulandığından, bu durumda da aynı iletide yineleme sınırı da anılır ve geçerli sınır yazılır.
178.3 Örnek veri
paquid.csv, lcmm paketinin paquid verisidir (PAQUID kohortu; Proust-Lima ve ark., 2017): 500 yaşlı birey (ID), toplam 2250 satır; bireyde en çok 9, ortalama 4,5 ölçüm. Eksik yanıt normMMSE'de (ve MMSE'de) 36 hücredir; kalan 2214 gözlem 500 bireye aittir (birey başına ortalama 4,4; en az 1, en çok 9).
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
ID |
birey kimliği | sayısal | 1–500 |
normMMSE |
yanıt | sayısal | normalleştirilmiş MMSE (bilişsel test; 0–100), ortalama 67{,}7 |
age65 |
zaman | sayısal | yaş -65 (yıl), 0{,}128–3{,}506 (tam gözlemlerde) |
CEP |
ortak değişken | ikili | eğitim (ilkokul diploması; 1 = var), bireylerin \%71'i |
male |
(örnekte yok) | ikili | cinsiyet (1 = erkek), \%42{,}4 |
MMSE, age |
modelde kullanılmaz | sayısal | ham MMSE; yaş (66–102) |
CEP Veri sekmesinde "ikili" sayılır, ama sayı değerli olduğundan R'ye sayı gelir (katsayı adı CEP, CEP1 değil). Metin değerli kategorik bir ortak değişken factor olur ve ilk görülme sırasına göre kukla kodlanır (Bölüm 1.3): örneğin düşük/orta/yüksek düzeyli bir sütunda ilk görülen düzey başvurudur ve katsayılar öteki düzeyler için yazılır (egitimdüşük, egitimorta).
Bu bölümde kullanılan çalıştırmalar (Kod paneli tohumu 1; ayrıntı dogrulama/buyume_karisim/calistir.sh):
| Ad | Veri | Ayar |
|---|---|---|
p8_bk_ornek |
paquid.csv |
örnek ayar (G_{\max}=2, GMM) |
p8_bk_g3, p8_bk_ornek_t7 |
aynı | G_{\max}=3; Kod paneli tohumu 7 |
p8_bk_g3_izgara, p8_bk_izgara_t1…t3 |
aynı | G_{\max}=3, izgara = 30; izgara = 10, tohum 1, 2, 3 |
p8_bk_lcga, p8_bk_kesisim, p8_bk_kosegen, p8_bk_nwg |
aynı | rastgele = yok; kesisim; kosegen_kov; sinifa_ozgu_varyans |
p8_bk_derece1, p8_bk_derece3, p8_bk_ortaksiz, p8_bk_ortak2 |
aynı | derece 1; derece 3; ortak değişkensiz; CEP+male |
p8_bk_yas, p8_bk_iter, p8_bk_tol, p8_bk_cat |
aynı | zaman = age; maks_yineleme = 10; yakinsama_tol = 0,01; yanıt ve zaman kategorik |
p8_bk_birey_metin, p8_bk_faktor, p8_bk_zaman_adi |
benzetim türevleri | metin birey kimliği; 3 düzeyli metin ortak değişken; "zaman" içeren sütun adları |
p8_bk_eksik, p8_bk_tekli, p8_bk_n25, p8_bk_virgul |
benzetim türevleri | ek eksik; birey başına tek ölçüm; 25 birey; ondalık virgüllü yanıt |
178.4 Yöntem: formüller ve hesap adımları
Şablon veriyi temizler, zaman polinomunu ve ortak değişkenleri kurar, G=1 modelini hlme ile uydurur ve yakınsamayı denetler. Sonra g=2,\dots,G_{\max} için modeli ya tek sınıflı modelden türetilen başlangıçla ya da gridsearch ile kurar. Sonunda model karşılaştırma tablosunu, en çok sınıflı modelin parametre tablosunu ve sonsal sınıflandırmayı yazar, ortalama yörüngeleri çizer.
178.4.1 Olabilirlik
Birey i için yanıt vektörü \mathbf y_i (n_i ölçüm), sınıf g verildiğinde çok değişkenli normaldir:
- \mathbf X_i: (n_i\times3) [1,t,t^2] tasarım matrisi (derece 2); \boldsymbol\beta_g: sınıfa özgü katsayılar; \mathbf W_i\boldsymbol\delta: ortak değişken etkisi (sınıflar arasında aynı).
- \mathbf G: rastgele etki kovaryans matrisi (\mathbf Z_i=\mathbf X_i,
tam; yalnız kesişim; ya da yok).nwgaçıkken \mathbf G_g=\omega_g^{2}\mathbf G (sınıf G'nin \omega_G=1; diğerlerivarprop). - \phi: çok değişkenli normal yoğunluk; toplam bireyler üzerindendir (N birey sayısı, n_{\text{gözlem}} değil).
- \ell: bireyler üzerinden toplanmış log-olabilirlik;
logLiksütunu budur.
Neden \mathbf G sınıflar arasında ortak
Sınıfa özgü \mathbf G_g parametre sayısını G kat artırır ve küçük sınıflarda kestirilemez. Ortak \mathbf G sınıflar arasında eşit bireyler arası değişim varsayar (GMM'nin en sık kullanılan sınırlaması). nwg bu sınırı gevşetir ama yalnız ölçek çarpanıyla (varprop).
Koddaki tercih
hlme(fixed = .y ~ zaman + zaman2 + ortak…, mixture = ~ zaman + zaman2, random = ~ zaman + zaman2, subject = ".id", ng = g, data = d, B = m1) (149–156). Zaman polinomu ham kuvvetlerle kurulur (zs^k; 130–132): ortogonal polinom değil. mixture formülü kesişimi de içerdiğinden kesişim ve zaman terimleri sınıfa özgüdür; fixed'in geri kalanı (ortak değişkenler) sınıflar arasında ortaktır. birey sütunu ardışık tamsayıya (.id) çevrilir ve veri bireye, sonra zamana göre sıralanır (120–121).
178.4.2 Kestirim: Marquardt algoritması ve başlangıç değerleri
Log-olabilirlik, Marquardt'ın (1963) değiştirilmiş Gauss–Newton algoritmasıyla en büyüklenir (Proust-Lima ve ark., 2017). maks_yineleme en çok yineleme sayısını, yakinsama_tol üç ölçütün ortak eşiğini verir:
Üçü de göreli ölçütlerdir (varsayılan 10^{-4}). hlme, yakınsamayı conv koduyla bildirir; şablon conv = 1 dışındaki her durumu "yakınsamadı" sayar.
Başlangıç. G=1 modeli kolayca yakınsar. Çok sınıflı modeller (izgara = 0) B = m1 ile kurulur: başlangıç değerleri tek sınıflı modelin kestirimlerinden türetilir (paketin önerdiği yol); bu yol belirlenimcidir (tohum etkisiz). Bu başlangıç yerel bir en büyüğe götürebilir (178.7). izgara > 0 iken gridsearch(m, rep = izgara, maxiter = izgara_yineleme, minit = m1) çağrılır: izgara rastgele başlangıçtan her biri izgara_yineleme (15) yineleme çalıştırılır, en yüksek log-olabilirlikli başlangıç yakınsayana kadar sürdürülür.
Izgara araması başlangıç sayısına ve tohuma bağlıdır
Örnek veride üç sınıflı modelde izgara = 0 log-olabilirliği -8898{,}23 verir; izgara = 30 -8891{,}35'e ulaşır (üstbilgi bu değerleri belirtir). izgara = 10 ise üç ayrı tohumda da -8898{,}23'te kalır: başlangıç sayısı yetersizdir. Ayrıca iki çözümün sınıf büyüklükleri tümüyle farklıdır (178.7).
178.4.3 Model karşılaştırma ve sınıf sayısı
Her g için tabloda log-olabilirlik, parametre sayısı d (npm; sınıf üyeliği, sınıfa özgü ve ortak sabit etkiler, rastgele etki ve artık varyans parametreleri), BIC ve AIC bulunur:
- N: birey sayısı (500), gözlem sayısı (2214) değil; lcmm'nin BIC tanımıdır (Schwarz, 1978 ölçütünün birey düzeyli sürümü). Örnekte d=11 için \mathrm{BIC}=17841{,}25+11\ln500=17909{,}61.
- d: iki sınıfta 15=1 (üyelik) +\ 6 (sınıfa özgü \beta) +\ 1 (
CEP) +\ 6 (\mathbf G) +\ 1 (\sigma).
Şablon sınıf sayısını seçmez; tabloyu verir. BIC genelde sınıf sayısı için en güvenilir ölçüttür (Nylund ve ark., 2007), ama yüksek ayrışmadan çok çarpık dağılımı da sınıf diye kabul edebilir (Bauer ve Curran, 2003). Tabloda ICL, entropi ya da olabilirlik oranı sınaması yoktur; seçim BIC, yörünge yorumlanabilirliği, sınıf büyüklükleri ve sonsal olasılıklarla birlikte yapılmalıdır (Jung ve Wickrama, 2008; Henson ve ark., 2007).
178.4.4 Parametre tablosu ve Wald testi
Seçilen en çok sınıflı modelin her parametresi için şablon
yazar. SH, vcov(m) köşegeninin karekökündür (188–189). Rastgele etki kovaryans parametreleri (varcov k) ve stderr için z ve p yazılmaz; stderr için SH yazılır. varcov parametreleri kovaryans matrisinin elemanlarıdır (sütun sütun üst üçgen: G_{11},G_{12},G_{22},G_{13},G_{23},G_{33}); bağımsız olabilirlik hesabı bu yorumla log-olabilirliği yeniden üretir (178.6). Etiketler: üyelik: intercept class g üyelik kesişimleri; intercept class g, age65 class g, age65^2 class g sınıfa özgü yörünge; ortak değişken adı olduğu gibi (tek katsayı); varprop class g nwg açıkken varyans çarpanı.
Wald p ve SH güvenilirliği
SH'ler hlme'nin kestirimin bulunduğu yola bağlı sayısal Hessian'ından gelir. İyi ayrışmış iki sınıflı çözümde bağımsız sayısal Hessian ile \%0{,}05 içinde uyuşur (178.6); üç sınıflı yerel çözümde ise aynı kestirimler için intercept SH'si çalıştırmaya göre 5{,}6 ile 17{,}4 arasında değişir (178.8). Düz olabilirlik, zayıf ayrışmış sınıf ya da küçük sınıfta Wald p güvenilmez; yorumda dikkate alınmamalıdır.
178.4.5 Sonsal sınıflandırma
Her birey için sınıf üyeliğinin sonsal olasılığı Bayes kuralıyla hesaplanır:
Tablo "Sonsal sınıflandırma": satırlar atanan sınıf \hat c_i=k, n o sınıfa atanan birey sayısı, yuzde yüzdesi ve ort_sonsal_g atanan sınıf k olan bireylerin \hat p_{ig} ortalamasıdır. Köşegen elemanlar (ör. 0{,}805) atamanın kesinliğini verir; 0{,}8'in altı zayıf ayrışmayı gösterir. Model karşılaştırma tablosundaki sinif*_% sütunları da bu atama oranlarıdır; önsel sınıf olasılığı \hat\pi_g değildir (\hat\pi_1=0{,}211 iken atama oranı 0{,}124; 178.8).
178.4.6 Yan seçenekler
- Derece (
derece): 1{,}2{,}3; zaman ham kuvvetleri t,t^2,t^3. Derece arttıkça katsayılar birbirine çok bağımlı olur ve ham kuvvetlerde yakınsama zorlaşır. - Rastgele etkiler (
rastgele):tam(bütün polinom terimleri),kesisim,yok(LCGA). - Köşegen kovaryans (
kosegen_kov): \mathbf G köşegen; rastgele etkiler arası kovaryanslar 0. Yalnız rastgele etkili modelde etkilidir. - Sınıfa özgü varyans (
sinifa_ozgu_varyans,nwg): \mathbf G_g=\omega_g^2\mathbf G; her sınıf (sonuncusu hariç) içinvarpropparametresi.rastgele = yokile birlikte hata verir. - Yineleme sınırı ve ölçüt: yalnız form varsayılanından farklıysa
hlme'ye aktarılır (144–145);hlme'nin kendi varsayılanları da 500 yineleme ve 10^{-4}'tür, yani form varsayılanıyla aynıdır.
178.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 104–105 | .m() yardımcısı, lcmm yükleme. |
|
| 107–118 | Denetimler: veri, sütun kopyası, sütun seçimi, mq_sayisal, complete.cases ve eksik gözlem/birey bildirimi (111–115), n\ge30, sabitlik. |
Atılan gözlem ve birey sayısı yazılır. |
| 119–126 | .id tamsayı kimliği; sıralama; birey sayısı ve tekrarlı ölçüm denetimi; zaman değer sayısı. |
ns < 10G yalnız G_{\max} içindir. |
| 127–132 | Ortak değişkenler: metin ve mantıksal sütunlar factor; sabit denetimi. |
Ortak değişken sutunlar türünde; sayısal rol değil. |
| 133–141 | Zaman polinomu (zaman, zaman2, zaman3), fixed, mixture, random formülleri. |
Ham kuvvetler; kesişim mixture'a dahil. |
| 142–148 | nwg/idiag/maxiter/yakınsama argümanları; uyarı yakalayıcı. |
Yalnız varsayılandan farklıysa aktarılır. |
| 149–159 | kur(g, B); G=1 model; yakınsama denetimi (iletide yineleme sınırı). |
G=1 yakınsamazsa hiçbir çok sınıflı model kurulmaz. |
| 160–171 | g=2,\dots,G_{\max}: ızgara varsa gridsearch, yoksa kur(g, m1). |
Çok sınıflı modeller için yakınsama burada denetlenmez; yakinsadi sütunu. |
| 172–184 | Sınıf atama oranları; karşılaştırma tablosu ve baslangic sütunu (177); başlangıç düzeni notu (181–182); tek başlangıç ve SH uyarıları (183–184). |
npm = length(m$best). |
| 185–201 | Seçilen model (G_{\max}): uyarı; vcov, SH, Wald z, p; "üyelik:" öneki; parametre adı eşlemesi (191–194, tam sözcük eşleşmesi); parametre tablosu. |
varcov, stderr için z/p boş. |
| 202–209 | Sonsal sınıflandırma tablosu; uyarı satırı. | Boş sınıfta ortalama NaN. |
| 210–221 | Ortalama yörüngeler: predictY (60 zaman noktası, ortak değişkenler ortalamaya); matplot çizimi. |
Eğri bütün zaman aralığında çizilir; ortak değişken ortalamada. |
178.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/buyume_karisim/elle_hesap.py (numpy/scipy; lcmm ve şablon çağrılmaz) ve r_dogrulama.R (nlme::lme; ayrıca yalnız temel R ile açık olabilirlik) ile hesaplanmıştır.
Adım 1 — Bir sınıflı model. Python'da \ell(\boldsymbol\theta)=\sum_i\ln N(\mathbf y_i;\mathbf X_i\boldsymbol\beta+\mathbf W_i\delta,\ \mathbf Z\mathbf G\mathbf Z^\top+\sigma^2\mathbf I), \mathbf G'nin Cholesky çarpanı ve \ln\sigma üzerinden BFGS ile en büyüklenir: \hat\beta=(64{,}6104;\ 5{,}6393;\ -6{,}1066), \hat\delta=13{,}6766, \hat\sigma=10{,}0722, \ell=-8920{,}622622; \hat{\mathbf G}'nin köşegeni (212{,}86;\ 456{,}23;\ 59{,}35). R'de nlme::lme(method = "ML") \ell=-8920{,}623243 verir (nlme'nin durma ölçütü gevşektir; Python'dan 6\cdot10^{-4} küçük). Şablonun tablosu -8920{,}622652'dir; üçü 10^{-6} (göreli) içindedir. BIC =-2\ell+11\ln500=17909{,}6059, AIC =17863{,}2452 şablonla aynıdır.
Adım 2 — İki sınıflı model, şablonun kestirimlerinde. Şablonun parametre tablosundan alınan \hat\gamma=-1{,}318061, \hat{\boldsymbol\beta}_1=(64{,}0329;\ 17{,}9720;\ -16{,}3014), \hat{\boldsymbol\beta}_2=(63{,}5549;\ 3{,}5515;\ -3{,}8158), \hat\delta=14{,}1115, varcov ve \hat\sigma=10{,}0549 ile Python ve R kendi sınıf karışımı olabilirliklerini hesaplar: \ell=-8899{,}227699 (şablon -8899{,}227730). Önsel sınıf olasılığı \hat\pi_1=e^{\hat\gamma}/(1+e^{\hat\gamma})=0{,}211141; \mathrm{BIC}=17891{,}6745, \mathrm{AIC}=17828{,}4554.
Adım 3 — Küresel en büyük. Python'da dört bağımsız başlangıç (biri şablonun çözümü, üçü rastgele) iki sınıflı modelde aynı log-olabilirliğe varır: -8899{,}227699; -8899{,}227700; -8899{,}227707; -8899{,}227708. Şablonun çözümü küresel en büyüktür.
Adım 4 — Sonsal sınıflandırma. \hat p_{ig} Bayes kuralıyla: atama 62/438 (şablon 62/438); atanan sınıf 1'de ortalama sonsal (0{,}805398;\ 0{,}194602), atanan sınıf 2'de (0{,}127023;\ 0{,}872977). Şablonun "Sonsal sınıflandırma" tablosuyla aynıdır.
Adım 5 — Standart hatalar. Şablonun çözümünde logaritma-olabilirliğin sayısal Hessian'ı (merkezî fark, adım 2\cdot10^{-3}) ters çevrilir; üyelik kesişimi ve sınıfa özgü katsayıların SH'leri şablonun vcov'undan gelenlerle \%0{,}1 içinde uyuşur (en büyük göreli fark 4{,}4\cdot10^{-4}) (ör. sınıf 1 kesişimi 5{,}9686 ve 5{,}9710). Aynı Hessian adım uzunluğu 10^{-4} ile hesaplandığında kayan nokta gürültüsü \%3 sapma verir; adım büyütülünce sapma kaybolur.
178.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | Ölçüt | |
|---|---|---|---|---|---|---|
| log-olabilirlik, 1 sınıf | −8920,62265226 | −8920,6226218 | −8920,62324301 | 6,6e−8 | 1e−6 | ✓ |
| parametre sayısı, 1 sınıf | 11 | 11 | 11 | 0 | 1e−6 | ✓ |
| BIC (ln nbirey), 1 sınıf | 17909,60599361 | 17909,60593267 | 17909,60717511 | 6,6e−8 | 1e−6 | ✓ |
| AIC, 1 sınıf | 17863,24530453 | 17863,24524359 | 17863,24648603 | 6,6e−8 | 1e−6 | ✓ |
| log-olabilirlik, 2 sınıf | −8899,22772976 | −8899,22769895 | −8899,22769895 | 3,5e−9 | 1e−6 | ✓ |
| parametre sayısı, 2 sınıf | 15 | 15 | 15 | 0 | 1e−6 | ✓ |
| BIC (ln nbirey), 2 sınıf | 17891,67458099 | 17891,67451938 | 17891,67451938 | 3,4e−9 | 1e−6 | ✓ |
| AIC, 2 sınıf | 17828,45545952 | 17828,45539791 | 17828,45539791 | 3,5e−9 | 1e−6 | ✓ |
| 2 sınıf: bağımsız çok başlangıçlı en büyükleme, en iyi log-olabilirlik (4 başlangıç) | −8899,22772976 | −8899,22769895 | — | 3,5e−9 | 1e−6 | ✓ |
| 2 sınıf: en kötü başlangıç, log-olabilirlik | −8899,22772976 | −8899,22770796 | — | 2,4e−9 | 1e−6 | ✓ |
| sınıf 1 önsel olasılığı \pi_1=e^{\gamma}/(1+e^{\gamma}) | 0,21114109 | 0,21114109 | 0,21114109 | 5,6e−17 | 1e−6 | ✓ |
| sınıf 1: atanan birey sayısı (en büyük sonsal) | 62 | 62 | 62 | 0 | 1e−6 | ✓ |
| sınıf 2: atanan birey sayısı | 438 | 438 | 438 | 0 | 1e−6 | ✓ |
| ortalama sonsal olasılık: atanan 1, sınıf 1 | 0,80539795 | 0,80539795 | 0,80539795 | 2,3e−15 | 1e−6 | ✓ |
| ortalama sonsal olasılık: atanan 1, sınıf 2 | 0,19460205 | 0,19460205 | 0,19460205 | 2,3e−15 | 1e−6 | ✓ |
| ortalama sonsal olasılık: atanan 2, sınıf 1 | 0,12702253 | 0,12702253 | 0,12702253 | 2,2e−16 | 1e−6 | ✓ |
| ortalama sonsal olasılık: atanan 2, sınıf 2 | 0,87297747 | 0,87297747 | 0,87297747 | 4,4e−16 | 1e−6 | ✓ |
| SH (sayısal Hessian, ölçüt 2e−3), üyelik: intercept class1 | 0,23136339 | 0,23139115 | — | 2,8e−5 | 2e−3 | ✓ |
| SH (sayısal Hessian, ölçüt 2e−3), intercept class1 | 5,97103986 | 5,96858013 | — | 4,1e−4 | 2e−3 | ✓ |
| SH (sayısal Hessian, ölçüt 2e−3), age65 class1 | 9,1696101 | 9,16595543 | — | 4,0e−4 | 2e−3 | ✓ |
| SH (sayısal Hessian, ölçüt 2e−3), age65^2 class1 | 2,63239177 | 2,63217262 | — | 8,3e−5 | 2e−3 | ✓ |
| SH (sayısal Hessian, ölçüt 2e−3), intercept class2 | 2,34102232 | 2,34055984 | — | 2,0e−4 | 2e−3 | ✓ |
| SH (sayısal Hessian, ölçüt 2e−3), age65 class2 | 3,20621261 | 3,20537248 | — | 2,6e−4 | 2e−3 | ✓ |
| SH (sayısal Hessian, ölçüt 2e−3), age65^2 class2 | 1,00330835 | 1,00298053 | — | 3,3e−4 | 2e−3 | ✓ |
| SH (sayısal Hessian, ölçüt 2e−3), CEP | 1,33671514 | 1,33661831 | — | 7,2e−5 | 2e−3 | ✓ |
| SH (sayısal Hessian, ölçüt 2e−3), stderr | 0,20136395 | 0,20131453 | — | 4,9e−5 | 2e−3 | ✓ |
Ölçütü karşılayan: 26/26. Python ve R, şablonun kestirimlerinde olabilirliği kendi formüllerinden yeniden hesaplar (iki sınıflı satırlar); bir sınıflı model her ikisinde de bağımsız en büyüklenir (Python: BFGS + doğrudan en büyükleme; R: nlme::lme, ML). Dört bağımsız başlangıç iki sınıflı modelde aynı en büyüğe varır. SH satırlarında şablon, lcmm'nin sayısal Hessian'ından gelir; bağımsız Hessian farklı bir adım uzunluğuyla hesaplanır.
Ek denetim: üstbilgi üç sınıflı çözümü -8898{,}23 (izgara = 0) ve -8891{,}35 (30 başlangıçlı ızgara) diye bildirir; bu bölümde şablon iki değeri de yeniden üretmiştir (p8_bk_g3: -8898{,}2312; p8_bk_g3_izgara: -8891{,}3508).
178.7 Çıktıyı okuma
Örnek ayarın konsol çıktısı (p8_bk_ornek):
36 gözlem eksik değer nedeniyle çıkarıldı (n = 2250 → 2214); 0 birey modelden tümüyle çıktı.
n = 2214 gözlem, 500 birey; derece 2; rastgele etkiler: tam
Başlangıç: 2 ve daha çok sınıflı modeller tek sınıflı modelin kestirimlerinden türetilen tek başlangıçla kuruldu (ızgara araması kapalı).
Tablolar (Sonuçlar sekmesi; ondalık nokta tablodaki gibi; sütunlar kısaltılmıştır):
Sınıf sayısına göre model karşılaştırması
 G      logLik  npm         BIC         AIC  yakinsadi  sinif1_%  sinif2_%  baslangic
 1 -8920.622652   11  17909.605994  17863.245305   True      100.0       NaN          1
 2 -8899.227730   15  17891.674581  17828.455460   True       12.4      87.6          1

2 sınıflı model: parametreler
                 parametre   kestirim        SH      Wald        p
 üyelik: intercept class1  -1.318061  0.231363 -5.696930  0.000000
          intercept class1  64.032870  5.971040 10.723906  0.000000
          intercept class2  63.554865  2.341022 27.148338  0.000000
              age65 class1  17.972030  9.169610  1.959956  0.050001
              age65 class2   3.551486  3.206213  1.107689  0.267996
            age65^2 class1 -16.301435  2.632392 -6.192633  0.000000
            age65^2 class2  -3.815822  1.003308 -3.803239  0.000143
                       CEP  14.111459  1.336715 10.556819  0.000000
                  varcov 1 221.242501       NaN       NaN       NaN
                  ...
                    stderr  10.054864  0.201364       NaN       NaN

Sonsal sınıflandırma
 sinif   n  yuzde  ort_sonsal_1  ort_sonsal_2
     1  62   12.4      0.805398      0.194602
     2 438   87.6      0.127023      0.872977
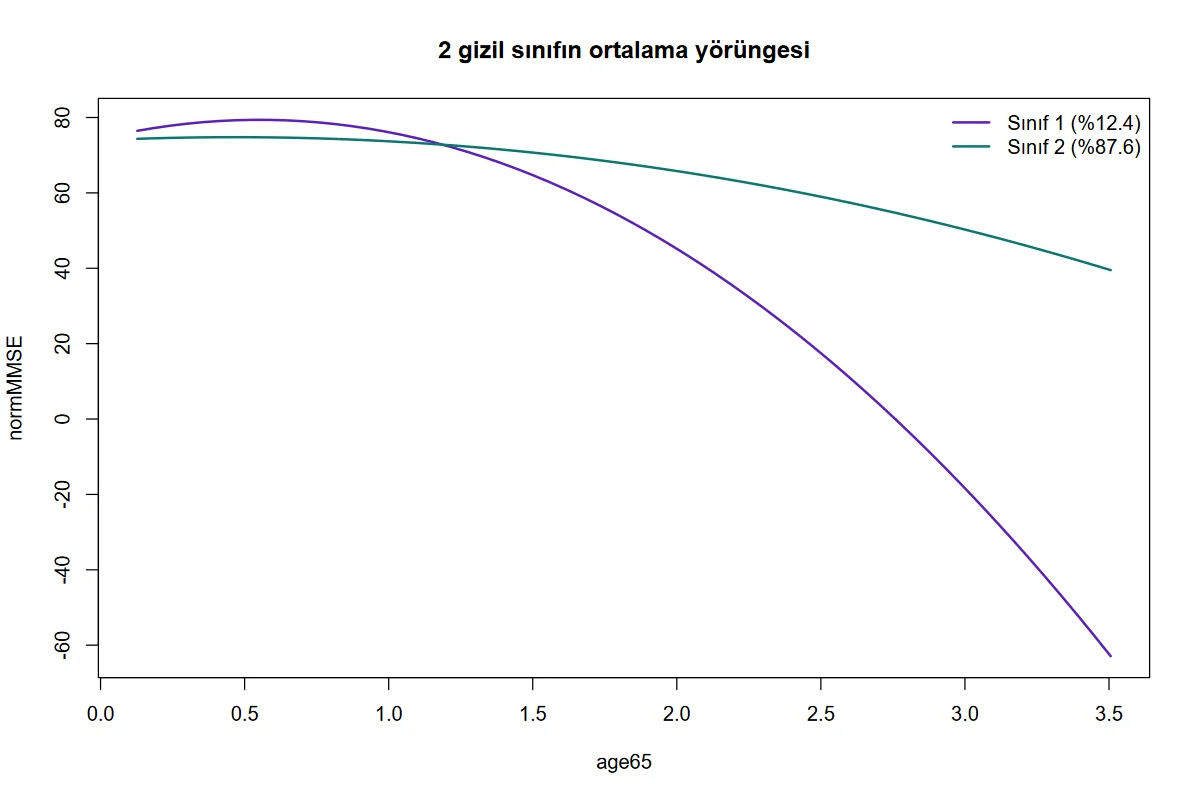
Şekil 178.1. Şablonun çizdiği sınıf yörüngeleri (örnek veri): iki sınıfın ortalama normMMSE eğrisi (`CEP` ortalamasında). Sınıf 1 (mor, atanan bireylerin %12,4'ü) hızla gerileyen küçük grup, sınıf 2 (yeşil) yavaş gerileyen büyük gruptur. Eğriler bütün zaman aralığında çizilir; sınıf 1 için son bölümde veri azdır ve eğri yanıtın olabilir aralığının (0–100) altına iner.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
logLik, npm, BIC, AIC |
Her sınıf sayısı için uyum | BIC küçük olan tercih edilir (örnekte G=2: 17891{,}67<17909{,}61). BIC birey sayısıyla cezalıdır. |
yakinsadi |
conv = 1 |
FALSE ise o modelin sonucu güvenilmez; tablo yine yazılır. |
baslangic |
Modelin kurulduğu başlangıç sayısı | G=1 için 1; G\ge2 için izgara >0 ise ızgaradaki rastgele başlangıç sayısı, değilse 1 (tek sınıflı modelden türetilen başlangıç). |
sinif*_% |
Atama oranı (en büyük sonsal) | Sınıf büyüklüğü; önsel olasılıkla aynı değildir (0{,}211 karşı 0{,}124). |
üyelik: intercept class g |
Üyelik logit kesişimi | Son sınıfa göre sınıf g'nin log-oranı. Örnekte \hat\pi_1=0{,}211. |
intercept, age65, age65^2 (sınıf) |
Sınıfa özgü yörünge | Sınıf 1: 65 yaşında ortalama 64{,}0; hızlı kuadratik düşüş (-16{,}3\,t^2). Sınıf 2: yavaş (-3{,}8\,t^2). Katsayılar ham kuvvetlerdendir; tek tek yorumlanmaz, yörünge olarak yorumlanır. |
CEP |
Ortak etki | CEP =1 olan bireylerin ortalaması her sınıfta 14{,}1 puan yüksek (\mathrm{SH}=1{,}34). |
varcov 1–6 |
Rastgele etki kovaryansı | Kesişim varyansı 221{,}2 (\mathrm{sd}=14{,}9); eğim ve kuadratik terim varyansları ve korelasyonlar. SH ve p yazılmaz. |
stderr |
Artık sd \sigma | Birey içi, rastgele etkilerden sonra kalan sapma (10{,}05). |
Sonsal sınıflandırma |
Atama ve ortalama sonsal | Köşegen 0{,}81 ve 0{,}87: atama orta kesinlikte. Sınıf 1'deki bireylerin ortalama olasılığı sınıf 2'ye 0{,}19 düşer. |
Rapor cümlesi. PAQUID kohortunda (N=500 yaşlı birey, 2214 ölçüm) normalleştirilmiş MMSE puanı için zamanın karesel polinomu, rastgele kesişim, eğim ve karesel terimle ve eğitim göstergesinin sınıflar arası ortak etkisiyle bir ve iki sınıflı büyüme karışım modelleri uydurulmuştur (\mathrm{lcmm} paketi, ML). BIC iki sınıflı modeli desteklemiştir (17891{,}7; tek sınıf 17909{,}6). Bireylerin yaklaşık %12'si hızla gerileyen, %88'i yavaş gerileyen yörüngeye atanmıştır (sınıf olasılıkları 0{,}21 ve 0{,}79; atanan bireylerin ortalama sonsal olasılığı 0{,}81 ve 0{,}87). Eğitimli bireyler her iki sınıfta da ortalama 14{,}1 puan (\mathrm{SH}=1{,}34) daha yüksek puan almıştır.
178.8 Sık hatalar ve tuzaklar
- Yerel en büyük ve üç sınıf. Varsayılan ayar (G=3,
izgara = 0) üç sınıflı modelde \ell=-8898{,}23 verir veyakinsadi = TRUEyazar; 30 başlangıçlı ızgara -8891{,}35'e ulaşır ve sınıf büyüklükleri 13{,}2/56{,}4/30{,}4 yerine 4{,}0/85{,}8/10{,}2 olur. Ayrıcaizgara = 10üç tohumda da yerel en büyükte kalmıştır. Şablon bu durumu gizlemez: tablodabaslangic = 1yazılır, konsola "Başlangıç: … tek başlangıçla kuruldu" notu ve "yakınsama yerel bir en büyük değerde olabilir" uyarısı düşer. G\ge3 içinizgara'yı en az 30 yapın ve en yüksek log-olabilirliğe varılıp varılmadığını birkaç tohumla doğrulayın (B2). - Eksik satırlar. Örnek veride 36 eksik yanıt atılır ve "36 gözlem eksik değer nedeniyle çıkarıldı (n = 2250 → 2214)" yazılır; ek 40 eksikte üç birey tümüyle kaybolur ve bu da bildirilir (497 birey). Eksik oranını yine de kendiniz değerlendirin (B1).
- Zaman ölçeği. Ham kuvvet polinomu büyük sayılarda dengesizdir: zaman olarak yaş (66–102) seçilirse tek sınıflı model yakınsamaz ve şablon "Tek sınıflı model yakınsamadı; zaman ölçeğini küçültmeyi (ör. yıl/10) ya da daha düşük derece deneyin" der (
p8_bk_yas). Zamanı merkezleyin ve ölçekleyin (age65). - Yineleme sınırı çok küçük.
maks_yineleme = 10tek sınıflı modeli de yakınsatmaz; ileti ölçek önerisinin yanında yineleme sınırını da anar ve geçerli sınırı yazar (B6). - Parametre adları. Ad eşlemesi tam sözcük eşleşmesiyle yapılır: zaman sütununun adı "zaman" içerse (
zaman_yil) ya da ortak değişken adında "zaman" geçse (ilkzaman) adlar bozulmaz (zaman_yil^2,ilkzaman) (B3). - SH güvenilirliği. Üç sınıflı yerel çözümde aynı kestirimler için SH çalıştırmaya göre 3 kat değişir. Üç ve daha çok sınıflı modelde şablon SH'lerin yaklaşık sayılması gerektiğini konsola yazar; SH'ye ve Wald p'ye yalnız iyi ayrışmış çözümlerde güvenin (B4).
- Sınıf numarası ve yüzdeler. Sınıf etiketleri keyfidir (G=2 ızgara çalıştırmasında sınıf 1 ile 2 yer değiştirir). Tablodaki yüzde, atama yüzdesidir (B8, B10).
- Ortak değişken kodlaması. Kategorik ortak değişkende başvuru düzeyi ilk görülen düzeydir (
egitimdüşük,egitimortakatsayıları; başvuruyüksek). 0/1 sütun sayısaldır (CEP). Sayısal sütun "kategorik" olsa da zaman ve yanıt sayı olarak gelir; ortak değişken isefactorolur (sayısal rol değil). - Küçük örneklem ve küçük sınıf. 25 bireyde iki sınıf kurulur ve sınıf 2'ye 3 birey düşer; şablon yalnız toplam birey sayısını denetler (B9).
- LCGA çok iyi uymaz.
rastgele = yokile G=2'de BIC 18317{,}1 (GMM'de 17891{,}7): sınıf içi bireyler arası değişim yok sayıldığında uyum belirgin kötüleşir.kesisim17917{,}9;kosegen_kov17893{,}6. - Eğri grafiği ekstrapolasyon yapar. Sınıf 1 eğrisi yanıtın aralığının altına iner; bu veri değil, polinom ekstrapolasyonudur (B5).
- Ondalık virgüllü yanıt. Metin olarak okunmuş bir yanıt sütunu form denetimince sayısal olmayan sütun olarak reddedilir ("… is not a numeric column"); şablon çalışmaz.
- Birey başına tek ölçüm. Bireylerin çoğunda tek ölçüm varsa "Bireylerin çoğunda tekrarlı ölçüm yok; boylamsal model kurulamaz" iletisiyle durur (
p8_bk_tekli).
178.9 Uzman soruları
S1. Neden BIC'te N gözlem sayısı değil birey sayısıdır?
lcmm'nin tanımıdır: \mathrm{BIC}=-2\ell+d\ln N_{\text{birey}} (örnekte \ln500). Boylamsal veride bilgi birey düzeyindedir: aynı bireyin yinelenen ölçümleri bağımsız değildir. Gözlem sayısı (\ln2214) kullanılsaydı ceza büyür ve daha az sınıf seçilirdi. Başka programların BIC'iyle karşılaştırırken tanım denetlenmelidir.
S2. GMM ile LCGA arasındaki fark nedir ve hangisini seçmeliyim?
LCGA'da sınıf içinde bireyler arası değişim yoktur (\mathbf V_i=\sigma^2\mathbf I); GMM'de rastgele etkilerle vardır. Örnekte BIC GMM'yi güçlü biçimde destekler (17891{,}7 karşı 18317{,}1). LCGA, gerçek bireyler arası değişimi ek sınıflarla yakalamaya çalıştığından gereğinden fazla sınıf gerektirebilir; GMM ise çarpık dağılımı da sınıf diye yorumlayabilir (Bauer ve Curran, 2003). İkisini de uydurup BIC ve yorumlanabilirlikle seçmek yaygındır. LCGA'nın sorun yaratması sık olduğundan örnekte tam varsayılandır.
S3. Sınıf sayısını nasıl seçmeliyim?
BIC küçük olan; ama tek başına yeterli değildir: (i) en küçük sınıf büyüklüğü ve sonsal olasılıkların köşegeni (\ge0{,}8 iyi); (ii) yörüngelerin yorumlanabilirliği; (iii) sınıfların aynı çözüme farklı başlangıçlarla varılması. Şablon ICL, entropi ya da olabilirlik oranı sınaması vermez; sonsal sınıflandırma tablosundan entropi benzeri bir ölçü elle hesaplanabilir. Örnekte BIC G=2'yi seçer (17891{,}7 karşı G=3: 17900{,}8 ızgara ya da 17914{,}5 yerel).
S4. `izgara = 0` sonucuna ne kadar güvenebilirim?
G=2'de dört bağımsız rastgele başlangıç aynı en büyüğe vardığından güvenilir; G=3'te üstbilgide ve burada gösterildiği gibi yerel en büyükte kalabilir (-8898{,}23 karşı -8891{,}35). Şablon başlangıç sayısını tabloya yazar (baslangic) ve tek başlangıçlı üç ve daha çok sınıflı modelde uyarır; yakınsama kodu yerel en büyüklerde de 1'dir. Çok sınıflı modelde çözümü en az 30 başlangıç ve farklı tohumlarla doğrulayın.
S5. SH'ler neden çalıştırmadan çalıştırmaya değişiyor?
hlme'nin vcov'u kestirimin bulunduğu yolda hesaplanan sayısal Hessian'dır ve sınıf ayrışması zayıf olduğunda olabilirlik düzdür; küçük sayısal farklar çok büyük SH değişimine yol açar. Üç sınıflı yerel çözümde aynı kestirimler için bir kesişimin SH'si 5{,}57, 7{,}17, 7{,}85 ve 17{,}45 çıktı. İki sınıflı iyi ayrışmış çözümde bağımsız Hessian ile \%0{,}05 içinde uyuştu. Güvenilir çıkarım için profil olabilirlik ya da parametrik önyükleme gerekir.
S6. Sınıf üyeliğini ortak değişkenle açıklayabilir miyim?
Bu şablonda hayır: üyelik yalnız kesişimle modellenir (classmb yok). Ortak değişken (CEP) yörüngeyi sınıflar arasında aynı miktarda kaydırır (tek katsayı 14{,}1). Eğitimin sınıf üyeliğini de belirlediği bir soru için lcmm::hlme(classmb = ~ CEP) ya da üç adımlı yaklaşımlar gerekir; bu şablonun kapsamı dışındadır.
S7. Ham kuvvet polinomu yerine ortogonal polinom kullanmak sonucu değiştirir mi?
Log-olabilirlik, sınıf atamaları ve uyum ölçütleri değişmez (aynı yörünge uzayı); katsayılar, SH'ler ve rastgele etki kovaryansı farklı bir tabana göre yazılır. Ham kuvvetlerde zaman 0'dan uzaksa kesişim yorumsuzlaşır ve katsayılar birbirine çok bağımlıdır; bu, yakınsamayı da zorlaştırır. Örnek veride zaman age65 olduğundan kesişim 65 yaşındaki ortalama puandır. Zamanı merkezleyin.
S8. `nwg` açıkken `varprop`'un Wald p'si neden yanıltıcı?
varprop class 1 sınıf 1'in rastgele etki kovaryansını sınıf 2'ye göre çarpar; boş hipotez "eşit varyans" yani 1'dir. Tablo z=\hat\theta/\mathrm{SH} ile 0'a karşı sınar (1{,}57/0{,}177=8{,}9); p<10^{-3} eşit varyans hakkında bilgi vermez. Doğru test z=(1{,}57-1)/0{,}177=3{,}2'dir (B7).
S9. Bağımsız olabilirlik hesabı neden 10^{-6} içinde tutuyor ama SH için daha gevşek?
Olabilirlik kapalı biçimli çok değişkenli normal yoğunluktur; şablonun parametreleriyle hesaplandığında yalnız kayan nokta hatası kalır (3\cdot10^{-5} mutlak, 3\cdot10^{-9} göreli). SH ise sayısal ikinci türevden gelir ve hem lcmm'nin hem bağımsız hesabın adım uzunluğuna duyarlıdır: adım 10^{-4}'te bağımsız SH \%3 saparken 2\cdot10^{-3}'te \%0{,}05 içine girer; bu yüzden SH satırları 2\cdot10^{-3} ölçütüyle karşılaştırılmıştır.
178.10 Kaynaklar
- Bauer, D. J., & Curran, P. J. (2003). Distributional assumptions of growth mixture models: Implications for overextraction of latent trajectory classes. Psychological Methods, 8(3), 338–363. https://doi.org/10.1037/1082-989X.8.3.338
- Henson, J. M., Reise, S. P., & Kim, K. H. (2007). Detecting mixtures from structural model differences using latent variable mixture modeling: A comparison of relative model fit statistics. Structural Equation Modeling, 14(2), 202–226. https://doi.org/10.1080/10705510709336744
- Jung, T., & Wickrama, K. A. S. (2008). An introduction to latent class growth analysis and growth mixture modeling. Social and Personality Psychology Compass, 2(1), 302–317. https://doi.org/10.1111/j.1751-9004.2007.00054.x
- Laird, N. M., & Ware, J. H. (1982). Random-effects models for longitudinal data. Biometrics, 38(4), 963–974. https://doi.org/10.2307/2529876
- Marquardt, D. W. (1963). An algorithm for least-squares estimation of nonlinear parameters. Journal of the Society for Industrial and Applied Mathematics, 11(2), 431–441. https://doi.org/10.1137/0111030
- Muthén, B., & Shedden, K. (1999). Finite mixture modeling with mixture outcomes using the EM algorithm. Biometrics, 55(2), 463–469. https://doi.org/10.1111/j.0006-341X.1999.00463.x
- Nagin, D. S. (1999). Analyzing developmental trajectories: A semiparametric, group-based approach. Psychological Methods, 4(2), 139–157. https://doi.org/10.1037/1082-989X.4.2.139
- Nylund, K. L., Asparouhov, T., & Muthén, B. O. (2007). Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Structural Equation Modeling, 14(4), 535–569. https://doi.org/10.1080/10705510701575396
- Proust-Lima, C., Philipps, V., & Liquet, B. (2017). Estimation of extended mixed models using latent classes and latent processes: The R package lcmm. Journal of Statistical Software, 78(2), 1–56. https://doi.org/10.18637/jss.v078.i02
- R Core Team (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing.
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136