19. Genelleştirilmiş doğrusal karma model: rastgele eğim, çoklu gruplama, uyarlanır Gauss-Hermite kareleme
Şablon kimliği: glmer_ileri · Kategori: karma model · Dil: R · Dosya: pro/sablonlar/karma_model/glmer_ileri.R (satır 1–305; üstbilgi 1–132) · Örnek veri: _ornek/cbpp.csv · Paketler: lme4 2.0-6
19.1 Ne işe yarar
Şablon, yanıtı ikili, oran (başarı / deneme) ya da sayım olan ve gözlemleri gruplar içinde kümelenmiş verilere genelleştirilmiş doğrusal karma model (GLMM) uydurur. Cevapladığı soru şudur: "Grupların (sürü, hasta, okul, tarla) kendi düzey farkları rastgele etki olarak ayrıldığında, açıklayıcı değişkenler başarı olasılığını ya da olay hızını nasıl değiştiriyor?"
- y_{ij}: j. gruptaki i. gözlem. Binom ailesinde n_{ij} denemedeki başarı sayısı (y_{ij}\mid\mathbf b_j\sim\text{Binom}(n_{ij},\mu_{ij})), Poisson ailesinde sayım (y_{ij}\mid\mathbf b_j\sim\text{Poisson}(\mu_{ij})).
- g: bağlantı fonksiyonu. Lojit \log\{\mu/(1-\mu)\}, probit \Phi^{-1}(\mu) ya da log \log\mu.
- \mathbf x_{ij}^{\top}\boldsymbol\beta: sabit etkiler; o_{ij}: ofset (katsayısı 1 olan bilinen terim; seçilmezse 0).
- \mathbf z_{ij}^{\top}\mathbf b_j: rastgele etkiler. Yalnız rastgele kesişimde \mathbf z_{ij}=1 ve \boldsymbol\Sigma=\sigma_b^2; rastgele eğim eklenince \mathbf z_{ij}=(1,x_{ij}) ve \boldsymbol\Sigma varyansları ve kovaryansı içeren bir matristir.
Şablonun "ileri" olan yanı dört seçenektir: (1) birinci gruplama faktörüne rastgele eğimler (kesişimle ilişkili ya da ilişkisiz); (2) çapraz ya da iç içe ikinci bir gruplama faktörü; (3) olabilirliğin Laplace yaklaşımı yerine uyarlanır Gauss-Hermite kareleme (AGQ) ile hesaplanması; (4) sabit etkiler için Wald aralığı yanında profil olabilirlik aralığı.
Ne zaman kullanılır? Aynı gruptan birden çok gözlem varsa ve yanıt normal dağılmıyorsa (hasta/sağlam sayısı, olay sayısı, 0/1 sonuç); grup sayısı sabit etki olarak modele konamayacak kadar çoksa ya da gruplar daha büyük bir kitlenin örneklemiyse; bir değişkenin etkisinin gruptan gruba değiştiği düşünülüyorsa (rastgele eğim); iki ayrı kümelenme kaynağı varsa (denek ve madde, sürü ve dönem).
Ne zaman kullanılmaz?
- Yanıt sürekli ve normal ise: temel programdaki LMM (Doğrusal Karma Modeller); karşılaştırma katmanı gerekiyorsa
r_emmeans_kontrast. - Sayım yanıtında aşırı yayılım ya da sıfır fazlalığı varsa:
r_glmmtmb_nb(negatif binom, sıfır şişirilmiş ve engel modelleri). - Yanıt (0, 1) aralığında sürekli bir oransa (deneme sayısı yoksa) ya da pozitif süreklilikteyse:
glmmtmb_aileler(beta, Gamma, Tweedie). - Yanıt sıralı kategorikse:
clmm_sirali_karma; sırasız çok kategoriliysenominal_karma. - Gruplama yoksa (gözlemler bağımsız): temel programdaki İkili Lojistik Regresyon, Probit Regresyon ya da Poisson / Negatif Binomial Regresyon.
- Denek-özgü değil, kitle ortalaması (marjinal) etkiler isteniyorsa: temel programdaki GEE (Genelleştirilmiş Tahmin Denklemleri).
Temel programla ilişki. Temel programın GLMM (Genelleştirilmiş Doğrusal Karma Modeller) analizi rastgele kesişimli binom ve sayım modellerini kurar. Bu şablon modeli lme4 paketinin glmer fonksiyonuyla kurar ve onun üç yeteneğini forma açar: rastgele eğim ve ikinci gruplama faktörü, AGQ ve profil olabilirlik aralığı. Katsayıların tanımı (denek-özgü log-odds ya da log-oran) iki yerde aynıdır; fark integral yaklaşımında ve rastgele etki yapısının zenginliğindedir.
19.2 Şablonun girdileri
Form, üstbilgideki on sekiz [[param]] bloğundan kurulur (glmer_ileri.R:10–131).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt (başarı sayısı, 0/1 ya da sayım) · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | negatif olmayan tamsayı | Bağımlı değişken (154–156, 183). |
Deneme sayısı (binom; isteğe bağlı) · deneme |
sayısal sütun · Değişkenler | boş | pozitif tamsayı, ≥ yanıt | cbind(y, deneme − y) (183); boşsa yanıt 0/1 olmalı (159). |
Dağılım ve bağlantı · aile |
seçim · Model | binom_logit |
binom_logit, binom_probit, poisson |
family = … (192). |
Sabit etkiler · x |
sütunlar · Değişkenler | boş | herhangi sütunlar | Formülün sağ yanı; boşsa yalnız kesişim (184). |
Faktör olarak ele alınacak sayısal sütunlar · faktor |
sütunlar · Değişkenler | boş | x içindeki sütunlar |
factor() (168). |
Gruplama faktörü 1 · grup |
kategorik sütun · Değişkenler | ilk uygun sütun | en az 3 düzey | (… | grup) (175–176, 187). |
Gruplama faktörü 1 için rastgele eğimler · egim |
sütunlar (sayısal) · Değişkenler | boş | sayısal, değişken sütunlar | (1 + eğim | grup) (174, 185). |
Rastgele kesişim ve eğimler ilişkili · iliskili |
onay · Model | açık | açık / kapalı | | ya da || (186). |
Gruplama faktörü 2 (isteğe bağlı) · grup2 |
kategorik sütun · Değişkenler | boş | en az 2 düzey | İkinci rastgele kesişim (177–180, 188–190). |
Faktör 2, faktör 1 içinde iç içe (yoksa çapraz) · ic_ice |
onay · Model | kapalı | açık / kapalı | (1 | grup:grup2) ya da (1 | grup2) (189). |
Olabilirlik yaklaşımı · yontem |
seçim · Model | laplace |
laplace, agq |
nAGQ = 1 ya da nagq (193–197). |
AGQ kareleme noktası sayısı · nagq |
tamsayı · Gelişmiş | 25 | 2–50 | Yalnız agq seçiliyse (196). |
Önsel ağırlık (isteğe bağlı) · agirlik |
sayısal sütun · Değişkenler | boş | negatif olmayan, hepsi sıfır değil | weights = … (152, 205). |
Ofset (bağlantı ölçeğinde; isteğe bağlı) · ofset |
sayısal sütun · Değişkenler | boş | sonlu sayılar | + offset(…) (153, 191). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | Wald ve profil aralıkları (220, 225); şekil (297). |
Sabit etki güven aralığı · ga_yontemi |
seçim · Seçenekler | wald |
wald, profile |
confint(method = "profile") (224–228). |
Optimizasyon algoritması · optimizer |
seçim · Gelişmiş | bobyqa |
bobyqa, Nelder_Mead, nloptwrap |
glmerControl(optimizer = …) (200); Laplace'ta tolPwrss = 1e-9 eklenir (203). |
En çok işlev değerlendirmesi · maks_fonk |
tamsayı · Gelişmiş | 200000 | 100–10000000 | maxfun ya da maxeval (199). |
Örnek ayar (ornek_param, satır 9): y = incidence, deneme = size, aile = binom_logit, x = [period], faktor = [period], grup = herd. Öteki alanlar varsayılandadır.
Şablonun kendi denetimleri. Biçimsel denetimden (Bölüm 1.2) sonra kod şunları durdurur:
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 136 |
| Poisson ailesinde deneme sayısı verilmiş | "Deneme sayısı yalnız binom ailesinde kullanılır." | 140 |
| İki gruplama faktörü aynı sütun | "İki gruplama faktörü farklı olmalı." | 144 |
| Ağırlık ya da ofset; yanıt, deneme ya da gruplama sütunlarından biri | "Ağırlık/ofset sütunu … olamaz." | 147 |
| Eksiksiz satır sayısı 10'dan az | "Eksiksiz en az 10 satır gerekli." | 151 |
| Ağırlık sayısal değil, negatif ya da hepsi sıfır | "Ağırlıklar negatif olmayan sayılar olmalı …" | 152 |
| Ofset sayısal değil ya da sonsuz | "Ofset sonlu sayısal değerler içermeli." | 153 |
| Yanıt sayısal değil | "Yanıt sayısal olmalı." | 155 |
| Yanıt negatif ya da tamsayı değil | "Yanıt negatif olmayan tamsayı olmalı." | 156 |
| Binom, deneme yok, yanıt 0/1 dışında değer içeriyor | "Deneme sayısı verilmezse binom yanıt 0/1 olmalı." | 159 |
| Deneme sayısı sütunu sayısal değil | "Deneme sayısı sayısal olmalı." | 162 |
| Deneme < yanıt, deneme ≤ 0 ya da tamsayı değil | "Deneme sayısı pozitif tamsayı ve yanıttan büyük ya da eşit olmalı." | 163–164 |
| Yanıt sabit | "Yanıt sabit; model kurulamaz." | 167 |
| Bir sabit etki tek düzeyli ya da sabit | "'…' tek düzeyli / sabit; sabit etkiden çıkarın." | 171–172 |
| Rastgele eğim sütunu sayısal değil ya da sabit | "Rastgele eğim '…' sayısal ve değişken olmalı." | 174 |
| Gruplama faktörü 1'de 3'ten az düzey | "Gruplama faktörü 1 en az 3 düzey içermeli." | 176 |
| Gruplama faktörü 2'de 2'den az düzey | "Gruplama faktörü 2 en az 2 düzey içermeli." | 179 |
| AGQ seçili ve rastgele eğim ya da ikinci faktör var | "AGQ yalnız tek gruplama faktörü ve yalnız rastgele kesişimle kullanılabilir; Laplace seçin." | 195 |
glmer hata verdi |
"Model kurulamadı: …" | 208 |
| Profil aralığı hesaplanamadı | "Profil güven aralığı hesaplanamadı: …" | 225–226 |
Durdurmayan iletiler: sabit etkilerden çıkarılan sütunları bildiren not (211–213), Laplace'ta PIRLS toleransını bildiren not (216–217), AGQ'da log-olabilirliğin yeniden hesaplandığını bildiren not (274–275), Pearson \chi^2/sd 1,5'i aşarsa aşırı yayılım notu (285–287; probitte yazılmaz), tekil uyum uyarısı (288) ve glmer'in kendi uyarıları tek satırda "Kestirim uyarıları:" başlığıyla (206–209, 289).
Sessizce yapılanlar. Eksik değer: modele giren sütunlardan herhangi birinde eksik olan satır liste bazında atılır (148–150). Sabit etki listesinde yanıt, deneme ya da gruplama sütunlarından biri seçilmişse o sütun sabit etkilerden çıkarılır (141–142) ve çıktıya "Not: … yanıt, deneme sayısı ya da gruplama faktörü olarak da seçildiği için sabit etkilerden çıkarıldı." satırı yazılır (211–213). Aynı sütunlar rastgele eğim listesinden de çıkarılır (143); bunun için not yazılmaz. "Faktör olarak ele al" işareti yalnız sabit etki listesindeki sütunlara uygulanır (168). "İç içe" onayı ikinci gruplama faktörü boşken etkisizdir (188). Yanıt, deneme sayısı, ağırlık ve ofset sayısal roldür: yalnız bu alanlara atanmış bir sütun veri sekmesinde kategorik olsa da koda sayı olarak ulaşır (Bölüm 1.3).
19.3 Örnek veri
Dosya: _ornek/cbpp.csv. Etiyopya'da 15 zebu sürüsünde sığır bulaşıcı plöropnömonisinin (CBPP) dört dönem boyunca izlendiği çalışmanın (Lesnoff ve ark., 2004) lme4 paketiyle dağıtılan özetidir: her satır bir sürünün bir dönemidir. 56 satır, eksik değer yok.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
incidence |
Yanıt | sayısal | O dönemde hastalanan hayvan sayısı; 0–12, toplam 99. |
size |
Deneme sayısı | sayısal | Dönem başında sürüdeki hayvan sayısı; 2–34, toplam 842. |
period |
Sabit etki (faktör) | sayısal (1–4) | Dönem. Ham oranlar: 61/278 = 0,219; 17/212 = 0,080; 14/197 = 0,071; 7/155 = 0,045. |
herd |
Gruplama faktörü | kategorik (15 düzey) | Sürü, H1–H15. 13 sürüde 4, H2'de 3, H8'de 1 dönem. |
period sayısal algılanır; faktör işareti örnek ayardan gelir
Veri sekmesi period'u sayısal (1, 2, 3, 4) algılar. Örnek ayar bu sütunu "Faktör olarak ele alınacak sayısal sütunlar" listesine koyar; böylece dört dönem üç gösterge değişkenle modele girer ve referans dönem 1'dir (sayısal etiketlerde düzey sırası sayısal sıradır, Bölüm 1.3). İşaret kaldırılırsa period tek bir doğrusal eğilim katsayısıyla girer: aynı veride katsayı −0,5594 (dönem başına log-odds değişimi) ve logLik −93,285 olur; dört düzeyli modelin logLik değeri −92,026'dır. herd kategoriktir, düzey sırası verideki ilk görülme sırasıdır (H1, H2, …, H15); rastgele etkide sıra sonucu değiştirmez, yalnız şeklin etiketlerini belirler.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar (Laplace, Wald); (2) AGQ, 25 nokta; (3) AGQ, 9 nokta; (4) probit; (5) profil olabilirlik aralığı; (6) güven düzeyi 0,90; (7) period sayısal + rastgele eğim; (8) çapraz ikinci faktör (period); (9) iç içe ikinci faktör (gözlem düzeyi rastgele etki); (10) Poisson + ofset, Laplace ve AGQ; (11) önsel ağırlık, Laplace ve AGQ; (12) üç eniyileyici. (9)–(11) için örnek veriye üç sütun eklenmiş bir kopya kullanılmıştır: logsize =\log(\text{size}), w (1 ve 2 dönüşümlü) ve per (period'un kopyası).
19.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) kullanılan sütunlar seçilir, eksik satırlar atılır, girdiler denetlenir; (2) formül metin olarak kurulur; (3) glmer modeli Laplace ya da AGQ ile en çok olabilirlikle kestirir; (4) sabit etki tablosu (Wald ya da profil aralığı, üstel dönüşüm); (5) rastgele etki varyans ve korelasyonları; (6) uyum ölçütleri, AGQ'da log-olabilirliğin yeniden hesabı; (7) koşullu modların şekli.
19.4.1 Koşullu dağılım ve marjinal olabilirlik
Rastgele etkiler gözlenmez; olabilirlik onların üzerinden integral alınarak bulunur:
- f: koşullu yoğunluk. Binom: \binom{n}{y}\mu^{y}(1-\mu)^{n-y}; Poisson: e^{-\mu}\mu^{y}/y!; \mu=g^{-1}(\eta).
- \phi(\mathbf b;\mathbf 0,\boldsymbol\Sigma): rastgele etkilerin çok değişkenli normal yoğunluğu.
- w_{ij}: önsel ağırlık (seçilmezse 1). Ağırlık gözlemin log-olabilirlik katkısını çarpar.
- J: grup sayısı; çapraz faktörlerde integral gruplara ayrışmaz, bütün rastgele etkiler tek integraldedir.
Bu integralin kapalı biçimi yoktur. Şablon iki yaklaşım sunar.
19.4.2 Laplace yaklaşımı
Tek skaler rastgele kesişim için integrandın logaritması h_j(b)=\sum_i w_{ij}\log f(y_{ij}\mid\eta^0_{ij}+b)+\log\phi(b;0,\sigma_b^2) olsun (\eta^0_{ij}=\mathbf x_{ij}^{\top}\boldsymbol\beta+o_{ij}). Laplace yaklaşımı h_j'yi tepe noktası \hat b_j çevresinde ikinci dereceden açar:
- \hat b_j: koşullu mod; h_j'(\hat b_j)=0 denkleminin çözümü. lme4 bunu cezalı yinelemeli yeniden ağırlıklı en küçük karelerle (PIRLS) bulur.
- W_{ij}=w_{ij}\,(d\mu/d\eta)^2/\operatorname{Var}(y_{ij}): PIRLS ağırlığı. Binom-lojitte n_{ij}\mu_{ij}(1-\mu_{ij}), Poisson-logda \mu_{ij}, binom-probitte n_{ij}\varphi(\eta_{ij})^2/\{\mu_{ij}(1-\mu_{ij})\}.
- \sum_iW_{ij}+1/\sigma_b^2: -h_j''(\hat b_j)'nin Fisher puanlamasındaki karşılığı. Çok boyutlu durumda yerini \lvert\mathbf Z^{\top}\mathbf W\mathbf Z+\boldsymbol\Sigma^{-1}\rvert alır.
Neden tepe noktası ve eğrilik yeter?
Grup içi gözlem sayısı arttıkça integrand normal yoğunluğa benzer; normal bir yoğunluğun integrali tepe değeri ile eğriliğinden tam olarak hesaplanır. Yaklaşımın hatası grup içi bilgi azaldıkça büyür: küçük gruplar, ikili (0/1) yanıt ve büyük rastgele etki varyansı Laplace için en zor durumdur. Örnek veride sürü başına en çok 4 gözlem vardır; Laplace ile AGQ arasında \hat\sigma_b^2 için 0,4125 ve 0,4193 farkı buradan gelir.
Koddaki tercih
glmer(..., nAGQ = 1) Laplace'tır (193, 204); bu seçenekte denetim çağrısına tolPwrss = 1e-9 eklenir (201–203). lme4 kestirimi iki aşamada yapar: önce \boldsymbol\beta'yı da PIRLS içinde çözerek yalnız \boldsymbol\theta (rastgele etki parametreleri) üzerinden kaba bir eniyileme, sonra (\boldsymbol\theta,\boldsymbol\beta) üzerinden Laplace sapmasının eniyilemesi. Seçilen eniyileyici iki aşamada da kullanılır (200). Eğrilik terimi PIRLS ağırlıklarıyla, yani beklenen bilgiyle hesaplanır; kanonik bağlantıda (lojit, log) bu gözlenen ikinci türevle aynıdır, probitte değildir (19.9 S6).
Şablon PIRLS toleransını 1e-9 alır; lme4'ün varsayılan çıktısı dördüncü basamakta farklıdır
lme4, koşullu modları ararken PIRLS'i cezalı sapmadaki göreli değişim bir toleransın altına inince durdurur; paketin varsayılanı 10^{-7}'dir (glmerControl(tolPwrss = 1e-7)). Bu toleransta eğrilik terimi son adımdan bir önceki ağırlıklarla kalır ve Laplace sapması tam değerinden dördüncü anlamlı basamakta ayrılır. Şablon Laplace seçeneğinde toleransı 10^{-9} alır (203); böylece kestirim Laplace tanımının tam en büyüğüdür. Örnek veride şablonun sonucu logLik −92,026282, kesişim −1,39853, SH 0,23247'dir ve bağımsız hesapla altı-yedi basamak aynıdır (19.6.1). Aynı model lme4'te varsayılan toleransla kurulduğunda logLik −92,026566, kesişim −1,39833, SH 0,23121 çıkar; lme4 belgelerindeki cbpp örneğinin değerleri (−1,3983; SH 0,2312) bunlardır. Fark katsayılarda 2\times10^{-4} ile 6\times10^{-4}, standart hatalarda %0,5 ile %1,3 arasındadır (dönem 4'ün SH'si varsayılan toleransla 0,4220, şablonda 0,4274); istatistiksel belirsizliğin çok altındadır. Çıktıdaki not bunu anımsatır (216–217): "Not: PIRLS toleransı 1e-9 (tolPwrss); lme4 varsayılanı (1e-7) ile katsayılar 4. basamakta, standart hatalar %0,5–1,3 farklı olabilir." Şablonun sonucunu R'de yinelemek için glmer çağrısına control = glmerControl(tolPwrss = 1e-9) verilir. AGQ seçeneğinde tolerans değiştirilmez ve not yazılmaz: 25 noktada sonuçlar varsayılan toleransla da bağımsız hesapla 10^{-7} içinde aynıdır (19.6.1).
19.4.3 Uyarlanır Gauss-Hermite kareleme
AGQ, aynı integrali tepe noktası çevresine yerleştirilmiş K düğümde integrandı değerlendirerek hesaplar:
- x_k, \omega_k: K noktalı Gauss-Hermite düğümleri ve ağırlıkları (\int e^{-x^2}g(x)\,dx\approx\sum_k\omega_kg(x_k); \sum_k\omega_k=\sqrt\pi).
- \hat b_j, \hat s_j: koşullu mod ve onun yaklaşık standart sapması; düğümler her grubun kendi tepe noktasına taşınır ve kendi genişliğiyle ölçeklenir ("uyarlanır").
- e^{x_k^2}: Gauss-Hermite kuralının ağırlık fonksiyonunu (e^{-x^2}) götürür.
- K=1 için x_1=0, \omega_1=\sqrt\pi ve formül Laplace yaklaşımına iner.
Neden uyarlanır, neden 25 nokta?
Düğümler sıfır çevresine sabit konursa, tepe noktası sıfırdan uzak ve dar olan gruplarda integrandın kütlesi düğümlerin arasına düşer; uyarlama aynı doğruluğa çok daha az noktayla ulaşır (Liu ve Pierce, 1994; Pinheiro ve Bates, 1995). Örnek veride 9 noktalı AGQ logLik −91,9833718, 25 noktalı AGQ −91,9833690 verir; fark 3\times10^{-6}'dır ve 25 noktanın değeri sayısal integralle (R, integrate) on dört basamak aynıdır. Varsayılan 25 nokta bu nedenle "kesin" marjinal olabilirlik sayılabilir; süre tek skaler rastgele etkide önemsizdir.
Koddaki tercih
lme4, nAGQ > 1 seçeneğini yalnız tek gruplama faktörü ve tek skaler rastgele etki için destekler; şablon rastgele eğim ya da ikinci faktör varken AGQ seçilirse çalıştırmayı kendi iletisiyle durdurur (195). nagq 2–50 aralığındadır (82–83).
lme4'ün nAGQ > 1 için bildirdiği log-olabilirlik, doymuş modele göre sapmadan hesaplanır ve doymuş modelin log-olabilirliği kadar bir sabit içermez; Laplace değeriyle aynı ölçekte değildir. Şablon bu yüzden log-olabilirliği kendisi yeniden hesaplar (244–276): düğüm ve ağırlıkları Golub ve Welsch (1969) yöntemiyle (Jacobi matrisinin özdeğerleri, 248–253) üretir, koşullu modları ve standart sapmalarını ranef(m, condVar = TRUE)'dan alır (257–258) ve yukarıdaki formülü tam yoğunlukla (dbinom, dpois) uygular (261–271). Önsel ağırlık seçilmişse her gözlemin log-yoğunluğu ağırlığıyla çarpılır (262, 267); böylece h_j, kestirimde kullanılan ağırlıklı olabilirlikle aynı tanımdadır. Uyum tablosundaki logLik, AIC ve BIC bu değerdendir ve çıktıya şu not yazılır (274–275): "Not: AGQ'da logLik, AIC ve BIC tam yoğunlukla, aynı kareleme noktalarıyla yeniden hesaplandı (konsol özetindeki lme4 değeri doymuş modele göre sapmadan türetilir; Laplace ile aynı ölçekte değildir)." Konsoldaki lme4 özeti kendi değerini yazmayı sürdürür (örnek veride −50,0 ve −91,98; fark doymuş modelin log-olabilirliği −41,978'dir).
19.4.4 Rastgele etki yapıları
| Form seçimi | Formül terimi | Kestirilen parametreler |
|---|---|---|
Yalnız grup |
(1 | grup) |
\sigma_b^2 |
egim = x, ilişkili |
(1 + x | grup) |
\sigma_0^2, \sigma_1^2, \rho_{01} |
egim = x, ilişkisiz |
(1 + x || grup) |
\sigma_0^2, \sigma_1^2 (\rho_{01}=0) |
grup2, çapraz |
(1 | grup) + (1 | grup2) |
\sigma_{b}^2, \sigma_{c}^2 |
grup2, iç içe |
(1 | grup) + (1 | grup:grup2) |
\sigma_{b}^2, \sigma_{c(b)}^2 |
- \sigma_0^2: grupların kesişimlerinin varyansı (x=0 noktasında); \sigma_1^2: eğimlerinin varyansı; \rho_{01}: kesişim ile eğim arasındaki korelasyon.
- Rastgele etkiler tablosunda varyans satırlarında varyans ve standart sapma, kovaryans satırında kovaryans ve korelasyon yazar (238–241). İlişkisiz seçenekte kovaryans satırı yoktur; kesişim ve eğim varyansları ayrı satırlardadır (19.8).
- İç içe seçeneğinde ikinci faktörün düzeyleri birinci faktörün her düzeyi içinde ayrı sayılır (
grup:grup2birleşimi); çaprazda aynı etiket bütün gruplarda aynı düzeydir.
Neden rastgele eğim sütunu sayısal olmak zorunda?
Rastgele eğim, bir değişkenin katsayısının gruptan gruba değişmesidir; tek bir katsayı için değişkenin sayısal olması gerekir. Kategorik bir değişkenin rastgele etkisi düzey sayısı kadar boyutlu bir kovaryans matrisi ister ve şablonun formu bunu kurmaz (174). Aynı sütun hem faktör olarak sabit etkide hem rastgele eğimde kullanılamaz: "faktör" işareti sütunu factor'a çevirir ve eğim denetimi onu reddeder.
19.4.5 Sabit etkiler: standart hata, test ve aralık
- \operatorname{SH}:
summary(m)$coefficients'ın ikinci sütunu (219). lme4 bunu sapmanın (\boldsymbol\theta,\boldsymbol\beta)'ya göre sonlu farkla hesaplanmış Hessian'ından alır: \hat{\mathbf V}_\beta=2\,[\mathbf H^{-1}]_{\beta\beta}. Bu, rastgele etki parametrelerinin belirsizliğini de içeren gözlenen bilgi matrisidir. - \gamma: güven düzeyi; z_{(1+\gamma)/2}=
qnorm((1 + guven)/2)(220). \gamma=0{,}95 için 1,959964. - Test asimptotik z testidir; serbestlik derecesi düzeltmesi yoktur.
Üstel dönüşüm. Lojit ve log bağlantıda tabloya exp(kestirim) ve aralık uçlarının üsteli eklenir (229–234): binomda sütun adları odds_orani, OO_GA_alt, OO_GA_ust; Poisson'da oran_orani, OrO_GA_alt, OrO_GA_ust. Probitte katsayının üsteli yorumlanabilir bir büyüklük olmadığından bu sütunlar yazılmaz.
Profil olabilirlik aralığı. ga_yontemi = profile seçilirse aralık uçları confint(m, parm = "beta_", method = "profile") ile değiştirilir (224–228); z, p ve SH sütunları Wald değerleridir.
- İç en büyükleme: \beta_k sabit tutulup öteki bütün parametreler yeniden kestirilir (profil log-olabilirlik).
- \chi^2_{1,\gamma}: 1 sd'li ki-kare dağılımının \gamma kantili (0,95 için 3,8415).
- lme4 profili bir ızgarada hesaplar ve işaretli karekök istatistiğini eğriyle ara değerler; uçlar bu ara değerlemenin çözümüdür.
Neden profil aralığı Wald'dan farklı çıkar?
Wald aralığı log-olabilirliği tepe çevresinde parabol sayar ve simetriktir. Olay sayısı az olan düzeylerde log-olabilirlik çarpıktır; profil aralığı bu çarpıklığı izler. Örnek veride dönem 4 (7 olay) için Wald aralığı [−2,418; −0,743], profil aralığı [−2,501; −0,801]'dir: alt uç 0,083 daha uzaktadır.
19.4.6 Uyum ölçütleri
- k: kestirilen parametre sayısı = sabit etki sayısı + rastgele etki parametre sayısı (
attr(logLik, "df"), 272, 282). Örnek ayarda 4+1=5. - N: kullanılan satır sayısı (gözlem sayısı; deneme toplamı değil).
- \hat m_i, \hat v_i: koşullu modlar yerine konarak hesaplanan ortalama ve varyans (
residuals(m, type = "pearson"), 277). Binomda oran ölçeğinde: y_i/n_i-\hat\mu_i ve \hat\mu_i(1-\hat\mu_i)/n_i. - sd =N-k (
df.residual, 278).
Neden 1,5 eşiği ve neden yalnız bir not?
Binom ve Poisson ailelerinde varyans ortalamadan belirlenir; Pearson \chi^2/sd'nin 1'den belirgin büyük olması verinin modelin öngördüğünden daha saçılmış olduğunu (aşırı yayılım) düşündürür. Karma modelde bu oran yalnız yaklaşık bir göstergedir: koşullu modlar büzüldüğü için sd tam değildir. Şablon bu yüzden test yapmaz, 1,5'i aşınca yalnız not yazar (285). Çözüm önerisi notta yazar: gözlem düzeyi rastgele etki (19.9 S8) ya da negatif binom model (r_glmmtmb_nb).
19.4.7 Koşullu modlar ve şekil
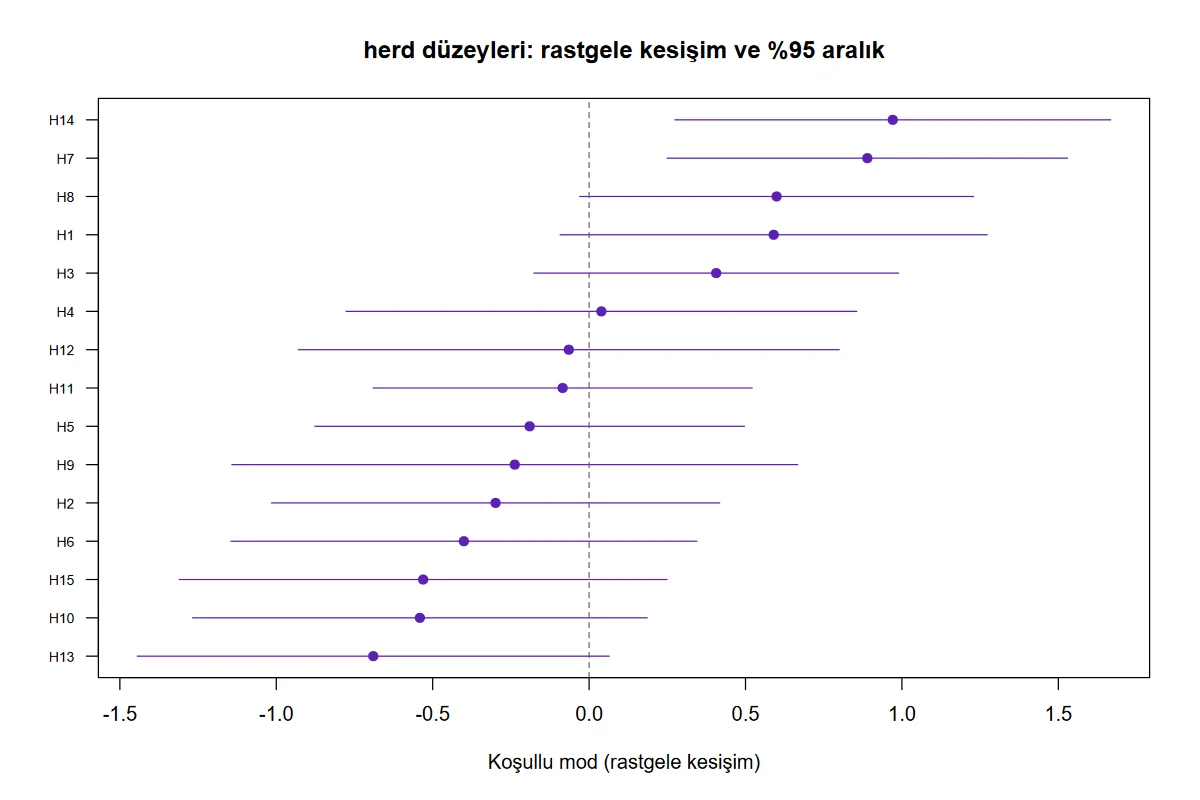
Şekil, birinci gruplama faktörünün her düzeyi için rastgele kesişimin koşullu modunu (\hat b_j) ve \hat b_j\pm z\,\hat s_j aralığını küçükten büyüğe sıralı çizer (291–304). \hat s_j, ranef(m, condVar = TRUE)'nun koşullu varyansının kareköküdür; tek rastgele kesişimde 19.4.3'teki \hat s_j ile aynıdır. İlişkisiz rastgele eğimde lme4 koşullu varyansı her terim için ayrı verir; şekil kesişim teriminin koşullu varyansını kullanır (293). Çarpan her güven düzeyinde qnorm((1 + guven)/2)'dir (297; 0,95 için 1,959964), yani sabit etkiler tablosundaki Wald aralığının çarpanıyla aynıdır. Bu aralık sabit etkilerin belirsizliğini içermez; grupları sıralamak ve aykırı grubu görmek için bir tanılama grafiğidir.
19.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–132 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on sekiz parametre. | Form ve varsayılanlar buradan kurulur (Bölüm 1.2). |
| 133–153 | lme4 yüklenir; isteğe bağlı alanlar NULL'a çevrilir; sabit etki ve eğim listelerinden yanıt, deneme ve gruplama sütunları çıkarılır; eksik satırlar atılır; ağırlık ve ofset denetlenir. |
Sabit etkilerden çıkarılan sütunlar dusen'de tutulur (142) ve model kurulduktan sonra notla bildirilir (211–213). complete.cases liste bazında silme yapar (150). |
| 154–180 | Yanıt, deneme, sabit etki, eğim ve gruplama denetimleri; faktor listesindeki sütunlar ve metin sütunları factor yapılır. |
factor() var olan düzey sırasını korur; sayısal sütunda sıra sayısaldır (168–169). |
| 182–192 | Formül metinden kurulur: sol yan cbind(y, n − y) ya da y; sağ yan sabit etkiler, ofset ve rastgele terimler; aile nesnesi seçilir. |
Sütun adları ters tırnakla korunur (182); etkileşim terimi kurulmaz. |
| 193–217 | nAGQ belirlenir; glmerControl çağrısı kurulur (Laplace'ta tolPwrss = 1e-9 ile, 203); glmer çalışır; uyarılar toplanır; formül, sabit etkilerden çıkarılan sütunların notu, yaklaşım, lme4 özeti ve Laplace'ta tolerans notu konsola yazılır. |
Uyarılar bastırılıp sonda tek satırda verilir (209, 289). Ağırlık sütunu veri çerçevesine .mq_agirlik adıyla kopyalanır (205). |
| 219–236 | Sabit etkiler tablosu: kestirim, SH, z, p, Wald ya da profil aralığı, üstel sütunlar. | Profil seçilince yalnız aralık sütunları değişir (227). |
| 238–241 | Rastgele etkiler tablosu (VarCorr). |
Kovaryans satırında SS_korelasyon sütunu korelasyondur. |
| 243–289 | Log-olabilirlik; AGQ'da tam yoğunlukla yeniden hesap; uyum tablosu; aşırı yayılım, tekil uyum ve kestirim uyarıları. | Yeniden hesap yalnız nagq > 1 iken çalışır (244); önsel ağırlık yoğunluğu çarpar (262, 267). |
| 291–305 | Koşullu modların şekli. | Yalnız birinci faktörün rastgele kesişimi çizilir (293–295). |
Model çağrısı bquote ile kurulur; böylece lme4 özetindeki "Control:" satırı seçilen eniyileyiciyi, sınırı ve Laplace'ta PIRLS toleransını açıkça gösterir:
kont  <- as.call(list(quote(glmerControl), optimizer = ..., optCtrl = ...))
cagri <- bquote(glmer(formul, data = d, family = aile, nAGQ = nagq, control = .(kont)))
19.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/glmer_ileri/elle_hesap.py ile, lme4 ve başka hiçbir karma model paketi kullanılmadan hesaplanmıştır: koşullu modlar kendi Newton döngüsüyle, Laplace ve AGQ toplamları 19.4.2–19.4.3'teki formüllerle, dış eniyileme BFGS ve Newton adımlarıyla, standart hatalar sapmanın sayısal Hessian'ından. Aşağıdaki adımlar 25 noktalı AGQ çalıştırmasının kestirimlerinde H1 sürüsünü izler (\hat{\boldsymbol\beta}=(-1{,}399230;\,-0{,}991404;\,-1{,}127819;\,-1{,}579471), \hat\sigma_b^2=0{,}419280).
Adım 1 — Sabit kısım. H1'in dört dönemi için y=(2{,}3{,}4{,}0), n=(14{,}12{,}9{,}5) ve \eta^0=(-1{,}399230;\ -2{,}390634;\ -2{,}527050;\ -2{,}978701) (kesişim + dönem katsayısı).
Adım 2 — Koşullu mod. h_1'(b)=\sum_i(y_i-n_i\mu_i)-b/\sigma_b^2=0 denkleminin Newton çözümü \hat b_1=0{,}593025'tir. Bu noktada \mu=(0{,}308700;\ 0{,}142142;\ 0{,}126306;\ 0{,}084271) ve PIRLS ağırlıkları n\mu(1-\mu)=(2{,}987658;\ 1{,}463255;\ 0{,}993173;\ 0{,}385849).
Adım 3 — Eğrilik.
Adım 4 — H1'in katkısı. h_1(\hat b_1)=-9{,}568022.
25 düğümde (x_1=-6{,}164272, \omega_1=2{,}71\times10^{-17}, …) toplam \ell_1^{\text{AGQ}}=-9{,}698342 verir. İki değer arasındaki 0,0037 fark, integrandın normalden sapmasının bu sürüdeki payıdır.
Adım 5 — Toplam. 15 sürünün AGQ katkılarının toplamı \ell=-91{,}983369; aynı parametrelerde Laplace toplamı -92{,}026715'tir. AIC =2\cdot91{,}983369+2\cdot5=193{,}966738; BIC =183{,}966738+5\log56=204{,}093497.
Adım 6 — Sabit etki testi. Dönem 2 için z=-0{,}991404/0{,}306768=-3{,}231770, p=0{,}001230; %95 Wald aralığı [-1{,}592658;\ -0{,}390149]; odds oranı e^{-0{,}991404}=0{,}371055, aralığı [0{,}203384;\ 0{,}676956].
Adım 7 — Pearson istatistiği. Koşullu modlar yerine konunca \sum_i n_i(y_i/n_i-\hat\mu_i)^2/\{\hat\mu_i(1-\hat\mu_i)\}=62{,}975350; sd =56-5=51; oran 1,234811.
Adım 8 — Laplace'ın tam en büyüğü. Aynı kod Laplace toplamını en büyüklediğinde \hat{\boldsymbol\beta}=(-1{,}398532;\,-0{,}992333;\,-1{,}128672;\,-1{,}580314), SH =(0{,}232472;\ 0{,}306642;\ 0{,}326638;\ 0{,}427437), \hat\sigma_b^2=0{,}412500 ve \ell=-92{,}026282 bulunur. Şablonun Laplace çalıştırması (örnek ayar) ve R'de başka bir paketin (glmmTMB) Laplace kestirimi bu değerlerle altı-yedi basamak aynıdır.
19.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun "Sabit etkiler", "Rastgele etkiler" ve "Model uyumu" tablolarından tam hassasiyetle alınmıştır. R sütunu lme4 kullanmaz: AGQ satırlarında grup başına integrate() ile hesaplanan kesin marjinal olabilirlik nlminb ve Newton adımlarıyla en büyüklenmiş; Laplace satırlarında glmmTMB (TMB'nin Laplace yaklaşımı) kullanılmıştır. Önsel ağırlıklı modelde glmmTMB'nin varsayılan eniyileyicisi en büyüğe varmadan durduğundan (en büyük gradyan 2{,}7\times10^{-4}) bu model BFGS ile kestirilmiştir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| AGQ 25: (Intercept) | −1,39923045 | −1,39923044 | −1,39923044 | 5,2e−9 | ✓ |
| AGQ 25: period2 | −0,99140367 | −0,99140367 | −0,99140367 | 2,7e−9 | ✓ |
| AGQ 25: period3 | −1,12781948 | −1,12781947 | −1,12781947 | 1,2e−8 | ✓ |
| AGQ 25: period4 | −1,57947072 | −1,57947075 | −1,57947075 | 1,8e−8 | ✓ |
| AGQ 25: SH((Intercept)) | 0,23351156 | 0,2335116 | 0,23351159 | 3,4e−8 | ✓ |
| AGQ 25: SH(period2) | 0,30676795 | 0,306768 | 0,30676799 | 4,8e−8 | ✓ |
| AGQ 25: SH(period3) | 0,32676831 | 0,32676835 | 0,32676837 | 6,3e−8 | ✓ |
| AGQ 25: SH(period4) | 0,42759433 | 0,42759453 | 0,4275945 | 2,0e−7 | ✓ |
| AGQ 25: z(period2) | −3,2317707 | −3,2317702 | — | 1,5e−7 | ✓ |
| AGQ 25: p(period2) | 0,00123026 | 0,00123026 | — | 2,1e−9 | ✓ |
| AGQ 25: period2 %95 GA alt | −1,5926578 | −1,5926579 | — | 6,0e−8 | ✓ |
| AGQ 25: period2 %95 GA üst | −0,39014954 | −0,39014945 | — | 9,1e−8 | ✓ |
| AGQ 25: odds oranı (period2) | 0,37105549 | 0,37105548 | — | 9,9e−10 | ✓ |
| AGQ 25: OO GA üst (period2) | 0,67695564 | 0,6769557 | — | 6,1e−8 | ✓ |
| AGQ 25: \sigma_b^2 | 0,41928016 | 0,41928018 | 0,41928018 | 2,2e−8 | ✓ |
| AGQ 25: \sigma_b | 0,64751846 | 0,64751848 | — | 1,7e−8 | ✓ |
| AGQ 25: logLik (tam yoğunluk) | −91,98336904 | −91,98336904 | −91,98336904 | 3,2e−15 | ✓ |
| AGQ 25: AIC | 193,96673807 | 193,96673807 | — | 8,8e−16 | ✓ |
| AGQ 25: BIC | 204,09349653 | 204,09349653 | — | 5,6e−16 | ✓ |
| AGQ 25: Pearson \chi^2/sd | 1,23481079 | 1,23481078 | — | 4,4e−9 | ✓ |
| AGQ 9: (Intercept) | −1,39923019 | −1,39923019 | — | 1,7e−9 | ✓ |
| AGQ 9: \sigma_b^2 | 0,41927918 | 0,41927919 | — | 1,0e−8 | ✓ |
| AGQ 9: logLik | −91,9833718 | −91,9833718 | — | 3,9e−11 | ✓ |
| Poisson AGQ 25: (Intercept) | −1,6490031 | −1,6490031 | −1,6490031 | 2,3e−9 | ✓ |
| Poisson AGQ 25: period4 | −1,38999852 | −1,38999849 | −1,38999849 | 2,0e−8 | ✓ |
| Poisson AGQ 25: SH(period4) | 0,40925672 | 0,40925686 | 0,40925681 | 1,5e−7 | ✓ |
| Poisson AGQ 25: oran oranı (period4) | 0,24907567 | 0,24907568 | — | 6,9e−9 | ✓ |
| Poisson AGQ 25: \sigma_b^2 | 0,24476013 | 0,24476012 | 0,24476012 | 8,4e−9 | ✓ |
| Poisson AGQ 25: logLik | −90,24451312 | −90,24451312 | −90,24451312 | 5,5e−15 | ✓ |
| Ağırlıklı AGQ 25: (Intercept) | −1,28548647 | −1,28548657 | — | 7,6e−8 | ✓ |
| Ağırlıklı AGQ 25: period4 | −1,79584586 | −1,79584583 | — | 1,5e−8 | ✓ |
| Ağırlıklı AGQ 25: SH(period4) | 0,35956713 | 0,35956725 | — | 1,1e−7 | ✓ |
| Ağırlıklı AGQ 25: \sigma_b^2 | 0,40311816 | 0,40311818 | — | 1,5e−8 | ✓ |
| Ağırlıklı AGQ 25: logLik (ağırlıklı yoğunluk) | −129,23703839 | −129,23703839 | — | 4,4e−16 | ✓ |
| Ağırlıklı AGQ 25: AIC | 268,47407678 | 268,47407678 | — | 4,2e−16 | ✓ |
| Ağırlıklı AGQ 25: BIC | 278,60083523 | 278,60083523 | — | 1,4e−15 | ✓ |
| Ağırlıklı AGQ 25: Pearson \chi^2/sd | 1,62778541 | 1,62778538 | — | 2,0e−8 | ✓ |
| Laplace (örnek ayar): (Intercept) | −1,39853212 | −1,39853214 | −1,39853247 | 2,5e−7 | ✓ |
| Laplace (örnek ayar): period2 | −0,99233275 | −0,99233273 | −0,99233229 | 4,5e−7 | ✓ |
| Laplace (örnek ayar): period3 | −1,12867208 | −1,12867208 | −1,1286713 | 7,0e−7 | ✓ |
| Laplace (örnek ayar): period4 | −1,58031387 | −1,58031388 | −1,58031369 | 1,2e−7 | ✓ |
| Laplace (örnek ayar): SH((Intercept)) | 0,23247189 | 0,232472 | 0,23247205 | 1,6e−7 | ✓ |
| Laplace (örnek ayar): SH(period2) | 0,30664224 | 0,3066425 | 0,30664249 | 2,6e−7 | ✓ |
| Laplace (örnek ayar): SH(period3) | 0,32663754 | 0,32663787 | 0,32663781 | 3,3e−7 | ✓ |
| Laplace (örnek ayar): SH(period4) | 0,42743615 | 0,4274366 | 0,4274366 | 4,5e−7 | ✓ |
| Laplace (örnek ayar): \sigma_b^2 | 0,41249972 | 0,41249977 | 0,41250006 | 3,4e−7 | ✓ |
| Laplace (örnek ayar): logLik | −92,02628187 | −92,02628186 | −92,02628186 | 7,3e−11 | ✓ |
| Laplace (örnek ayar): AIC | 194,05256374 | 194,05256373 | 194,05256373 | 6,9e−11 | ✓ |
| Laplace (örnek ayar): BIC | 204,1793222 | 204,17932218 | 204,17932218 | 6,6e−11 | ✓ |
| Laplace (örnek ayar): Pearson \chi^2/sd | 1,23682915 | 1,23682914 | — | 5,6e−9 | ✓ |
| Laplace, profil GA: period2 alt | −1,61675336 | −1,61676618 | −1,61676618 | 7,9e−6 | ✗ |
| Laplace, profil GA: period2 üst | −0,40779721 | −0,40778017 | −0,40778017 | 1,7e−5 | ✗ |
| Laplace, profil GA: period4 alt | −2,50074007 | −2,50075745 | — | 6,9e−6 | ✗ |
| Probit Laplace: (Intercept) | −0,83547491 | −0,83547776 | — | 2,9e−6 | ✗ |
| Probit Laplace: period4 | −0,79957007 | −0,79956314 | — | 6,9e−6 | ✗ |
| Probit Laplace: \sigma_b^2 | 0,11423428 | 0,11423867 | — | 4,4e−6 | ✗ |
| Probit Laplace: logLik | −92,62124257 | −92,62122332 | — | 2,1e−7 | ✓ |
| Poisson Laplace: (Intercept) | −1,64836473 | −1,64836489 | −1,6483649 | 1,0e−7 | ✓ |
| Poisson Laplace: period4 | −1,3910465 | −1,39104651 | −1,39104666 | 1,2e−7 | ✓ |
| Poisson Laplace: \sigma_b^2 | 0,24164987 | 0,24164993 | 0,24165005 | 1,8e−7 | ✓ |
| Poisson Laplace: logLik | −90,24164772 | −90,24164771 | −90,24164771 | 1,7e−10 | ✓ |
| Ağırlıklı Laplace: (Intercept) | −1,28490837 | −1,28490831 | −1,2849083 | 5,6e−8 | ✓ |
| Ağırlıklı Laplace: period4 | −1,7965353 | −1,79653542 | −1,79653542 | 6,6e−8 | ✓ |
| Ağırlıklı Laplace: \sigma_b^2 | 0,3988981 | 0,39889816 | 0,39889817 | 6,6e−8 | ✓ |
| Ağırlıklı Laplace: logLik | −129,27898181 | −129,27898181 | −129,27898181 | 1,5e−11 | ✓ |
| Rastgele eğim: period (sabit) | −0,60242645 | — | −0,6024264 | 4,1e−8 | ✓ |
| Rastgele eğim: Var(kesişim) | 1,13870371 | — | 1,13870334 | 3,2e−7 | ✓ |
| Rastgele eğim: Var(eğim) | 0,11674444 | — | 0,11674422 | 2,2e−7 | ✓ |
| Rastgele eğim: korelasyon | −0,86189735 | — | −0,86189783 | 4,8e−7 | ✓ |
| Rastgele eğim: logLik | −92,08761814 | — | −92,08761805 | 9,6e−10 | ✓ |
| İlişkisiz eğim: (Intercept) | −0,93235767 | −0,93235772 | — | 5,7e−8 | ✓ |
| İlişkisiz eğim: period (sabit) | −0,55940103 | −0,55940102 | — | 3,5e−9 | ✓ |
| İlişkisiz eğim: Var(kesişim) | 0,44052568 | 0,44052581 | — | 1,3e−7 | ✓ |
| İlişkisiz eğim: Var(eğim) | 0 | 0 | — | 0 | ✓ |
| İlişkisiz eğim: logLik | −93,28466296 | −93,28466296 | — | 6,5e−11 | ✓ |
| İlişkisiz eğim: AIC | 194,56932592 | 194,56932591 | — | 6,3e−11 | ✓ |
| İlişkisiz eğim: BIC | 202,67073269 | 202,67073268 | — | 6,0e−11 | ✓ |
| Çapraz: Var(herd) | 0,46924396 | — | 0,46924355 | 4,1e−7 | ✓ |
| Çapraz: Var(period) | 0,31000664 | — | 0,31000648 | 1,5e−7 | ✓ |
| Çapraz: logLik | −96,93896913 | — | −96,93896913 | 2,3e−11 | ✓ |
| İç içe (gözlem düzeyi): period2 | −1,226501 | −1,22650889 | −1,22650889 | 6,4e−6 | ✗ |
| İç içe: Var(herd:per) | 0,79400214 | 0,79402083 | 0,79402082 | 1,9e−5 | ✗ |
| İç içe: Var(herd) | 0,03384184 | 0,03383654 | 0,03383654 | 5,3e−6 | ✗ |
| İç içe: logLik | −87,31916357 | −87,31915554 | −87,31915554 | 9,2e−8 | ✓ |
Ölçütü karşılayan: 75/84. Python: grup başına tek boyutlu integralin Laplace ve uyarlanır Gauss–Hermite yaklaşımı (kendi iç Newton döngüsü; ilişkisiz eğimli ve iç içe modellerde çok boyutlu Laplace), dış eniyileme BFGS + Newton, SH sapmanın sayısal Hessian'ından. R: Laplace için glmmTMB, AGQ için GLMMadaptive::mixed_model ve grup başına integrate() ile kesin log-olabilirlik. lme4 çağrılmamıştır. ✗ satırlarının gerekçesi metindedir.
AGQ satırlarının hepsi ölçütü karşılar: şablonun 25 noktalı AGQ kestirimi kesin marjinal olabilirliğin en büyüğüdür ve yeniden hesaplanan log-olabilirlik on dört basamak aynıdır. Önsel ağırlıklı AGQ çalıştırmasında da kestirimler bağımsız hesapla 1{,}1\times10^{-7} içinde örtüşür; ağırlıklı yoğunlukla yeniden hesaplanan log-olabilirlik (−129,2370), AIC ve BIC on dört basamak aynıdır. Lojit ve log bağlantılı Laplace satırları da ölçütü karşılar: örnek ayar, Poisson, önsel ağırlıklı, ilişkili ve ilişkisiz rastgele eğimli ve çapraz modellerde şablonun kestirimi bağımsız Python hesabıyla ve glmmTMB ile 10^{-6} içinde aynıdır. İlişkisiz rastgele eğimli modelde iki boyutlu Laplace yaklaşımının bağımsız hesabı da eğim varyansını sınırda (sıfır) bulur.
✗ satırları üç yerdedir ve hepsinde fark 2\times10^{-5}'in altındadır. (1) Profil aralığı uçları (7\times10^{-6}–1{,}7\times10^{-5}): lme4 profili bir ızgarada hesaplar ve uçları eğriyle ara değerler; Python ve R sütunları kökü doğrudan arar ve birbirleriyle sekiz basamak aynıdır. (2) Probit (3\times10^{-6}–7\times10^{-6}): Python hesabı lme4'ün tanımını (eğrilik PIRLS ağırlıklarıyla) uygular; kanonik olmayan bağlantıda PIRLS daha yavaş yakınsadığından 10^{-9} toleransta bu kadar fark kalır (lme4'te tolerans 10^{-12} alındığında fark 3\times10^{-7}'ye iner). glmmTMB probitte eğriliği gözlenen ikinci türevle aldığından başka bir değere yakınsar (19.9 S6) ve tabloya konmamıştır. (3) İç içe (gözlem düzeyi) model (5\times10^{-6}–1{,}9\times10^{-5}): Python ve glmmTMB sekiz basamak aynı noktayı bulur. Olabilirlik yüzeyi bu modelde çok düzdür: şablonun bulduğu nokta ile bu nokta arasındaki log-olabilirlik farkı 2\times10^{-9}'dur; lme4'ün bildirdiği log-olabilirlik ise aynı noktadaki bağımsız değerden 8\times10^{-6} düşüktür ve varyans kestirimleri beşinci basamakta ayrılır. Log-olabilirlik satırı ölçütü karşılar.
19.7 Çıktıyı okuma
Örnek ayarın (Laplace) konsol metni:
Model formülü: cbind(incidence, size - incidence) ~ period + (1 | herd)
Yaklaşım: Laplace

Generalized linear mixed model fit by maximum likelihood (Laplace
  Approximation) [glmerMod]
 Family: binomial  ( logit )
Formula: cbind(incidence, size - incidence) ~ period + (1 | herd)
Control: glmerControl(optimizer = "bobyqa", optCtrl = list(maxfun = 2e+05),
    tolPwrss = 1e-09)
      AIC       BIC    logLik -2*log(L)  df.resid
    194.1     204.2     -92.0     184.1        51
Random effects:
 Groups Name        Variance Std.Dev.
 herd   (Intercept) 0.4125   0.6423
Number of obs: 56, groups:  herd, 15
Fixed effects:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -1.3985     0.2325  -6.016 1.79e-09 ***
period2      -0.9923     0.3066  -3.236 0.001212 **
period3      -1.1287     0.3266  -3.455 0.000549 ***
period4      -1.5803     0.4274  -3.697 0.000218 ***
Not: PIRLS toleransı 1e-9 (tolPwrss); lme4 varsayılanı (1e-7) ile katsayılar 4. basamakta, standart hatalar %0,5–1,3 farklı olabilir.
Tablolar (ilk dört ondalık):
| Tablo | Satır | Değerler |
|---|---|---|
| Sabit etkiler (Wald %95 GA) | (Intercept) | kestirim −1,3985; SH 0,2325; z −6,0159; GA [−1,8542; −0,9429]; odds 0,2470 |
| period2 | −0,9923; 0,3066; −3,2361; p 0,0012; GA [−1,5933; −0,3913]; odds oranı 0,3707 [0,2032; 0,6762] | |
| period3 | −1,1287; 0,3266; −3,4554; p 0,0005; odds oranı 0,3235 [0,1705; 0,6136] | |
| period4 | −1,5803; 0,4274; −3,6972; p 0,0002; odds oranı 0,2059 [0,0891; 0,4759] | |
| Rastgele etkiler | herd, (Intercept) | varyans 0,4125; SS 0,6423 |
| Model uyumu | n 56; grup sayısı 15; logLik −92,0263; −2logLik 184,0526; AIC 194,0526; BIC 204,1793; Pearson χ²/sd 1,2368 |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| "Model formülü", "Yaklaşım" | Kurulan lme4 formülü ve integral yaklaşımı | Seçimlerin modele nasıl çevrildiğini denetlemek için ilk bakılacak satırlar. |
| lme4 özeti | Paketin kendi çıktısı | AGQ'da buradaki AIC, BIC ve logLik uyum tablosuyla aynı ölçekte değildir (19.4.3); tablo kullanılır. |
| "Not: PIRLS toleransı 1e-9 (tolPwrss); …" | Laplace'ta koşullu modların arandığı tolerans | Yalnız Laplace'ta yazılır; lme4'ün varsayılan ayarıyla alınmış bir çıktıyla dördüncü basamaktaki farkın nedenidir (19.4.2). |
| (Intercept) | Referans düzeyde (dönem 1), ortalama bir sürüde (b=0) log-odds | e^{-1{,}399}=0{,}247 bir odds'tur (olasılık 0,198); "odds oranı" değildir. |
| period2–period4 | Dönem 1'e göre log-odds farkı | Odds oranı 0,37: aynı sürüde dönem 2'de hastalanma odds'u dönem 1'in %37'si. Denek-özgü (koşullu) etkidir. |
| Rastgele etkiler | \hat\sigma_b^2 ve karekökü | Sürüler arası log-odds standart sapması 0,64: ortalamanın bir SS üstündeki sürüde odds e^{0{,}64}=1{,}90 kat. |
| Pearson χ²/sd | 1,24 | 1,5 eşiğinin altında; not yazılmaz. |
| "Not: … sabit etkilerden çıkarıldı." | Sabit etki listesinden çıkarılan sütunlar | Sütun aynı zamanda yanıt, deneme sayısı ya da gruplama faktörüdür; modelde sabit etki olarak yer almaz (19.8). |
| "Not: AGQ'da logLik, AIC ve BIC … yeniden hesaplandı" | Uyum tablosunun log-olabilirliği şablonun kendi hesabıdır | Yalnız AGQ'da yazılır; konsol özetindeki değerle fark beklenen bir şeydir (19.4.3). |
| Tekil uyum uyarısı | Bir varyans sıfır ya da korelasyon ±1 | Rastgele etki yapısı verinin taşıyabileceğinden zengin; yapı sadeleştirilir. |
Şekil 19.1. Şablonun çizdiği koşullu modlar: 15 sürünün rastgele kesişimi ve %95 aralığı (örnek ayar). Aralık yalnız koşullu standart sapmaya dayanır.
Rapor cümlesi (örnek ayar):
Sürü rastgele kesişimli lojistik karma modelde (Laplace yaklaşımı, 56 sürü-dönem, 15 sürü) hastalanma odds'u dönem 1'e göre dönem 2'de 0,37 (%95 GA [0,20; 0,68], z = -3{,}24, p = 0{,}001), dönem 3'te 0,32 ([0,17; 0,61], p < 0{,}001) ve dönem 4'te 0,21 ([0,09; 0,48], p < 0{,}001) katına düştü. Sürüler arası varyans log-odds ölçeğinde 0,41 (SS 0,64) kestirildi.
19.8 Sık hatalar ve tuzaklar
- Sayısal kodlanmış kategoriyi faktör işaretlemeden bırakmak.
periodgibi 1–4 kodlu bir sütun işaretlenmezse tek bir doğrusal eğilim katsayısı kestirilir (örnek veride −0,559); düzeyler arası farklar için sütun "Faktör olarak ele alınacak sayısal sütunlar" listesine de eklenir. - Gruplama sütununu sabit etki olarak da seçmek. Sabit etki listesindeki bir sütun aynı zamanda yanıt, deneme sayısı ya da gruplama faktörü 1 ya da 2 ise sabit etkilerden çıkarılır ve çıktıya bir not yazılır (142, 211–213). Örneğin
x = periodvegrup2 = periodseçilirse model~ 1 + (1 | herd) + (1 | period)olur; "Model formülü" satırının altında "Not: period yanıt, deneme sayısı ya da gruplama faktörü olarak da seçildiği için sabit etkilerden çıkarıldı." yazar. Dönem bu modelde sabit katsayılarla değil, dört düzeyli bir rastgele kesişimin varyansıyla (0,3100) temsil edilir. Rastgele eğim listesinden aynı nedenle çıkarılan sütun için not yazılmaz (143); kurulan rastgele terim "Model formülü" satırından denetlenir. - İlişkisiz rastgele eğimde rastgele etkiler tablosunu yanlış okumak. "Rastgele kesişim ve eğimler ilişkili" onayı kaldırıldığında formül
(1 + x || grup)olur; lme4 terimi iki ayrı bloğa böler ((1 | grup) + (0 + x | grup)) ve korelasyon kestirilmez. Rastgele etkiler tablosunda kovaryans satırı yoktur; kesişim varyansıgrupadıyla, eğim varyansıgrup.1adıyla ayrı satırlarda yazar. Örnek veride (periodsayısal,egim = period) kesişim varyansı 0,4405 (SS 0,6637),herd.1satırındaki eğim varyansı 0 kestirilir ve tekil uyum uyarısı çıkar; logLik −93,2847 ile rastgele kesişimli modelin değeriyle aynıdır, AIC ise fazladan sayılan parametre yüzünden 192,57 yerine 194,57'dir.herd.1ikinci bir gruplama faktörü değildir. Şekil bu seçenekte de yalnız kesişimin koşullu modlarını çizer (293–295). - AGQ'yı rastgele eğimle ya da ikinci faktörle birlikte seçmek. Çalıştırma kendi iletisiyle durur (195); bu yapılarda yalnız Laplace kullanılabilir.
- AGQ'da konsoldaki AIC ile tablodaki AIC'yi karıştırmak. Konsoldaki lme4 özeti 110,0, uyum tablosu 193,97 yazar; çıktıdaki not farkın nedenini bildirir (19.4.3). Laplace modelleriyle ve başka programlarla karşılaştırılabilir olan tablodaki değerdir. Önsel ağırlıklı modelde de böyledir: örnek veride
wağırlığıyla konsol özeti 139,9, uyum tablosu 268,47 yazar (Laplace çalıştırması 268,56). - Sayısal olması gereken sütunun veri sekmesinde kategorik işaretlenmesi. Yanıt, deneme sayısı, ağırlık ve ofset alanları sayısal roldür; yalnız bu alanlara atanmış bir sütun, veri sekmesindeki türü kategorik olsa da koda sayı olarak ulaşır (Bölüm 1.3) ve sonuç, sütun sayısalken elde edilenle aynıdır (örnek veride
incidence,size,wvelogsizesırayla kategorik yapılarak denenmiştir). Aynı sütun sabit etkiler listesine de konmuşsa veri sekmesindeki türü korunur ve koda faktör olarak gelir; bu durumda şablon kendi iletisiyle durur: yanıtta "Yanıt sayısal olmalı." (155), deneme sütununda "Deneme sayısı sayısal olmalı." (162), ağırlıkta ve ofsette 152 ve 153'teki iletiler. Rastgele eğim sütunu sabit etkiler listesinde de yer alıyorsa (olağan durum) ve kategorik işaretliyse "Rastgele eğim '…' sayısal ve değişken olmalı." iletisi çıkar (174); sütun türü sayısala çevrilir. Sabit etki sütunu kategorik işaretlenirse faktör olarak modele girer; bu beklenen davranıştır ve sonuç "faktör" işaretiyle aynıdır. - Poisson'da ofseti ham ölçekte vermek. Ofset bağlantı ölçeğindedir: maruz kalma süresi ya da nüfus için sütunun logaritması verilir. Örnek veride
logsizeofsetiyle Poisson modeli dönem 4 için oran oranı 0,249 verir. - Kesişimin üstelini odds oranı diye okumak. Tablo sütunu bütün satırlarda
odds_oraniadını taşır; kesişim satırındaki değer referans düzeyin odds'udur. - Koşullu etkiyi kitle ortalaması etkisi gibi raporlamak. Katsayılar "aynı gruptaki" karşılaştırmadır; rastgele etki varyansı büyüdükçe kitle ortalaması odds oranı 1'e daha yakın olur. Kitle ortalaması etkisi için temel programdaki GEE kullanılır.
- Az grupla rastgele eğim kestirmek. 15 sürü ve sürü başına en çok 4 gözlemle
(1 + period | herd)modeli korelasyonu −0,86 kestirir ve log-olabilirliği rastgele kesişimli modelden (aynı sabit etkilerle −93,285) yalnız 1,2 birim iyileştirir; iki ek parametre bu veriyle desteklenmez.
19.9 Uzman soruları
S1. Laplace ile AGQ bu veride ne kadar ayrışıyor ve hangisi raporlanmalı?
25 noktalı AGQ kesin marjinal olabilirliğin en büyüğünü verir: \hat\sigma_b^2=0{,}4193, kesişim −1,3992, logLik −91,9834. Laplace \hat\sigma_b^2=0{,}4125, kesişim −1,3985, logLik −92,0263 verir. Sabit etki farkları standart hataların yüzde birinden küçüktür; varyans Laplace'ta %1,6 daha küçük kestirilir (Laplace'ın bilinen aşağı yanlılığı). Tek rastgele kesişimli modelde AGQ'nın ek maliyeti yoktur ve raporlanması gereken odur; Laplace, AGQ'nın kullanılamadığı yapılar (rastgele eğim, çapraz ya da iç içe faktör) içindir.
S2. AGQ neden yalnız tek skaler rastgele etkide kullanılabiliyor?
q boyutlu rastgele etkide K noktalı kareleme grup başına K^q değerlendirme ister; çapraz faktörlerde integral gruplara ayrışmadığından boyut bütün düzeylerin toplamıdır. lme4 bu nedenle nAGQ > 1'i tek gruplama faktörü ve tek skaler etkiyle sınırlar. Şablon aynı sınırı kendi iletisiyle uygular (195). Rastgele eğimli modelde kareleme isteyen kullanıcı için seçenek başka bir kestirim yöntemidir (ör. Bayesçi örnekleme); bu şablonun kapsamında değildir.
S3. lme4 AGQ'da logLik −50,0 yazarken şablon neden −91,98 veriyor?
lme4 nAGQ > 1 için sapmayı doymuş modele göre hesaplar; bildirdiği "logLik" doymuş modelin log-olabilirliğini içermez. Örnek veride \sum_i\log\text{Binom}(y_i;n_i,y_i/n_i)=-41{,}978 ve -50{,}005-41{,}978=-91{,}983'tür. Şablon aynı düğümlerle tam yoğunluğu toplayarak bu sabiti geri koyar (244–276); sonuç grup başına sayısal integralle hesaplanan kesin değerle on dört basamak aynıdır. Poisson ailesinde de aynı durum vardır (−44,66 ve −90,245; sabit −45,587); yeniden hesap aile ayırmadan yapılır ve çıktıdaki not iki ailede de aynıdır: konsol özetindeki lme4 değerinin doymuş modele göre sapmadan türetildiğini bildirir.
S4. Standart hatalar hangi bilgi matrisinden geliyor?
summary(m) sabit etki kovaryansını vcov(m)'den alır; lme4 GLMM'lerde varsayılan olarak yakınsama noktasında sonlu farkla hesapladığı sapma Hessian'ını kullanır ve (\boldsymbol\theta,\boldsymbol\beta) bloğunun tersinden \boldsymbol\beta bloğunu alır. Bu, varyans parametresinin kestirilmiş olmasının belirsizliğini içerir. Öteki seçenek, varyans parametreleri bilinirmiş gibi yalnız sabit etki bloğuna dayanan kovaryanstır (use.hessian = FALSE); örnek veride kesişimin SH'si 0,2325 yerine 0,2279 çıkar. Şablon varsayılanı değiştirmez.
S5. Şablonun Laplace sonucu, aynı modelin R'de `glmer` ile varsayılan ayarlarla alınan sonucundan dördüncü basamakta neden ayrılıyor?
İki hesap aynı yaklaşımı farklı sayısal duyarlıkla yapar. lme4 koşullu modları ararken PIRLS'i varsayılan olarak göreli 10^{-7} toleransla durdurur; eğrilik terimi son adımın bir önceki ağırlıklarıyla kalır ve Laplace sapması yaklaşık 6\times10^{-4} kayar. Şablon toleransı 10^{-9} alır (203); örnek veride kesişim −1,398532, SH 0,232472 ve logLik −92,026282 olur. Bu, bağımsız Python hesabının ve tepe noktasını otomatik türevle makine duyarlığına yakın bulan uygulamaların (TMB) değeridir. Varsayılan toleransla lme4 kesişim −1,398332, SH 0,231212 ve logLik −92,026566 verir; paketin belgelerindeki örnek çıktı da budur. Fark istatistiksel belirsizliğin çok altındadır (katsayıda SH'nin binde biri), ama iki çıktı basamak basamak karşılaştırılırken bilinmelidir; R'de şablonla aynı sonuç glmerControl(tolPwrss = 1e-9) ile alınır. AGQ bu duyarlılığı taşımaz, çünkü 25 düğümlü toplam ölçekteki küçük hatalara duyarsızdır; şablon AGQ'da toleransı değiştirmez.
S6. Probit bağlantıda lme4'ün Laplace'ı başka uygulamalardan neden farklı?
Laplace yaklaşımının eğrilik terimi integrandın tepe noktasındaki ikinci türevidir. lme4 bu terimi PIRLS ağırlıklarından, yani beklenen bilgiden alır; kanonik bağlantıda beklenen ve gözlenen bilgi eşittir, probit gibi kanonik olmayan bağlantıda değildir. Örnek veride şablonun probit sonucu kesişim −0,83547, \hat\sigma_b^2=0{,}11423, logLik −92,6212'dir ve bu tanımı uygulayan bağımsız hesapla 7\times10^{-6} içinde örtüşür. Eğriliği gözlenen ikinci türevle alan glmmTMB kesişim −0,83185, varyans 0,11467, logLik −92,5833 verir. Katsayı farkı SH'nin (0,126) yüzde üçü kadardır. Probit modelde karşılaştırılabilir sonuç için, tek rastgele kesişim varsa, AGQ seçilir.
S7. "Tekil uyum" uyarısı çıktığında sonuçlar kullanılabilir mi?
Uyarı, bir varyansın sıfıra ya da bir korelasyonun ±1'e kestirildiğini söyler (isSingular, 288). Sabit etki kestirimleri geçerlidir, ama rastgele etki yapısı veriyle belirlenememiştir ve o parametreye dayalı çıkarım (profil aralığı, olabilirlik oranı testi) sınır koşulundan etkilenir. Örnek veride ilişkisiz eğimli model eğim varyansını sıfır kestirir (19.8). Uygulamada yapı bir basamak sadeleştirilir (eğim çıkarılır) ve sabit etkilerin değişip değişmediğine bakılır.
S8. Aşırı yayılım için "gözlem düzeyi rastgele etki" bu şablonda nasıl kurulur?
Her satıra kendi rastgele kesişimini veren ikinci bir faktörle. Satırlar birinci faktörün içinde tek tek ayrışıyorsa, ikinci gruplama faktörü olarak grup içinde tekrar etmeyen bir sütun seçilip "iç içe" işaretlenir: (1 | herd:per) 56 düzeylidir. Örnek veride (per, period'un kopyası) bu model sürü varyansını 0,034'e, gözlem düzeyi varyansı 0,794'e kestirir; logLik −92,026'dan −87,319'a yükselir (AIC 194,05 → 186,64) ve Pearson χ²/sd 0,48'e düşer. Dönem katsayılarının SH'leri büyür (dönem 2: 0,307 → 0,480): önceki modelin güven aralıkları aşırı yayılımı yok saydığı için dardı. İkinci faktör olarak sabit etkideki sütunun kendisi seçilemez (19.8); kopyası kullanılır.
S9. Wald mı profil mi?
Wald aralığı hızlıdır ve büyük örneklemde yeterlidir. Olay sayısı az olan düzeylerde, sınıra yakın olasılıklarda ve az grupta profil aralığı adlandırılan kapsama oranına daha yakındır, çünkü log-olabilirliğin çarpıklığını izler. Örnek veride dönem 4 için alt uç 0,083 farklıdır. Profil hesabı modelin onlarca kez yeniden kestirilmesini gerektirir; büyük veride ya da rastgele eğimli modelde dakikalar sürebilir. Tabloda p değeri her iki seçenekte Wald z testindendir; profil aralığı sıfırı içermediği hâlde p>0{,}05 çıkması (ya da tersi) bu yüzden olanaklıdır.
S10. Önsel ağırlık sıklık ağırlığı mıdır?
Ağırlık, gözlemin log-olabilirlik katkısını çarpar (19.4.1). Tamsayı ağırlıkta nokta kestirimleri o satırın ağırlık kadar yinelendiği veriyle aynıdır; gözlem sayısı N ise satır sayısı olarak kalır, bu yüzden BIC ve Pearson χ²/sd yinelenmiş veridekinden farklıdır. Rastgele etki yapısı da değişmez: ağırlık yeni grup üyesi yaratmaz. Örnek veride w ağırlığıyla Laplace logLik −129,279 ve Pearson χ²/sd 1,63 olur; 25 noktalı AGQ ile logLik −129,237'dir. AGQ'da yeniden hesaplanan log-olabilirlik de ağırlıklı yoğunluktandır (19.4.3), bu yüzden iki yaklaşımın değerleri aynı ölçektedir.
19.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Bolker, B. M., Brooks, M. E., Clark, C. J., Geange, S. W., Poulsen, J. R., Stevens, M. H. H., & White, J.-S. S. (2009). Generalized linear mixed models: A practical guide for ecology and evolution. Trends in Ecology & Evolution, 24(3), 127–135. https://doi.org/10.1016/j.tree.2008.10.008
- Breslow, N. E., & Clayton, D. G. (1993). Approximate inference in generalized linear mixed models. Journal of the American Statistical Association, 88(421), 9–25. https://doi.org/10.1080/01621459.1993.10594284
- Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- Golub, G. H., & Welsch, J. H. (1969). Calculation of Gauss quadrature rules. Mathematics of Computation, 23(106), 221–230. https://doi.org/10.1090/S0025-5718-69-99647-1
- Harrison, X. A. (2014). Using observation-level random effects to model overdispersion in count data in ecology and evolution. PeerJ, 2, e616. https://doi.org/10.7717/peerj.616
- Lesnoff, M., Laval, G., Bonnet, P., Abdicho, S., Workalemahu, A., Kifle, D., Peyraud, A., Lancelot, R., & Thiaucourt, F. (2004). Within-herd spread of contagious bovine pleuropneumonia in Ethiopian highlands. Preventive Veterinary Medicine, 64(1), 27–40. https://doi.org/10.1016/j.prevetmed.2004.03.005
- Liu, Q., & Pierce, D. A. (1994). A note on Gauss–Hermite quadrature. Biometrika, 81(3), 624–629. https://doi.org/10.1093/biomet/81.3.624
- Nelder, J. A., & Mead, R. (1965). A simplex method for function minimization. The Computer Journal, 7(4), 308–313. https://doi.org/10.1093/comjnl/7.4.308
- Pinheiro, J. C., & Bates, D. M. (1995). Approximations to the log-likelihood function in the nonlinear mixed-effects model. Journal of Computational and Graphical Statistics, 4(1), 12–35. https://doi.org/10.1080/10618600.1995.10474663
- Powell, M. J. D. (2009). The BOBYQA algorithm for bound constrained optimization without derivatives (Report DAMTP 2009/NA06). University of Cambridge.
- Tierney, L., & Kadane, J. B. (1986). Accurate approximations for posterior moments and marginal densities. Journal of the American Statistical Association, 81(393), 82–86. https://doi.org/10.1080/01621459.1986.10478240