79. Dar Anlamda Kalıtım Derecesi ve Islah Değerleri
Şablon kimliği: kalitim_derecesi · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/kalitim_derecesi.R (satır 1–363; üstbilgi 1–104) · Örnek veri: _ornek/hanover_akcam.csv (hayvan modeli için mrode_ornek31.csv, grifon_hayvan.csv) · Paketler: lme4 (yalnız yarım kardeş modeli)
79.1 Ne işe yarar
Şablon, bir özellikteki bireyler arası farkın ne kadarının ebeveynden döle aktarılan (eklemeli) genetik farklardan kaynaklandığını ölçer. Bu oran dar anlamda kalıtım derecesidir:
- \sigma^2_A: eklemeli genetik varyans; bireylerin ıslah değerleri arasındaki varyans.
- \sigma^2_P: fenotipik varyans; seçimin yapıldığı birimler (ağaçlar, hayvanlar) arasında gözlenen varyans.
- h^2: 0 ile 1 arasında beklenir; seçilen bireylerin üstünlüğünün hangi oranda döle geçeceğini söyler.
\sigma^2_A doğrudan gözlenmez; akrabaların birbirine benzerliğinden çıkarılır. Şablon bunu iki ayrı veri yapısı için yapar ve formdaki Model alanıyla seçtirir:
| Model | Veri | Ne kestirir |
|---|---|---|
| Yarım kardeş döl denemesi | Aileler (baba ya da açık tozlaşmış ana), isteğe bağlı ikinci ebeveyn ve blok | Aile varyansı \sigma^2_f; h^2=4\sigma^2_f/\sigma^2_P. İkinci ebeveyn verilirse çaprazlı (North Carolina II) tasarım: baba, ana ve baba × ana bileşenleri. |
| Hayvan modeli | Birey, baba, ana sütunlu soy kütüğü ve kayıtlar | \sigma^2_A ve \sigma^2_e; h^2=\sigma^2_A/(\sigma^2_A+\sigma^2_e); her bireyin ıslah değeri (BLUP), tahmin hata varyansı ve doğruluğu. |
Bu bölüm, nicel genetik grubundaki dört şablonun (bu bölüm, Bölüm 80, 83 ve 89) ortak kuramını da taşır: varyans bileşenleri, akrabalık katsayısı, kalıtım derecesinin tanımları, standart hataların kaynağı. Öteki üç bölüm bu kısımlara gönderme yapar.
Ne zaman kullanılır? Tek lokasyonlu, tek özellikli bir döl denemesinde ya da soy kütüğü tutulan bir popülasyonda kalıtım derecesi ve ıslah değeri gerektiğinde.
Ne zaman kullanılmaz?
- Klon denemesi (geniş anlamda kalıtım, tekrarlanma derecesi), birden çok lokasyon (tip B genetik korelasyon) ya da yaş–yaş korelasyonu:
klon_lokasyon_genetik(Bölüm 80). - Populasyonlar (orijinler) ve bunların içinde aileler:
orijin_dol_denemesi(Bölüm 83); populasyon varyansı aile varyansından ayrılmazsa h^2 şişer. - Kalıtım derecesinden seleksiyon kazancına ve seleksiyon indeksine geçiş:
seleksiyon_kazanci(Bölüm 89). - Soy kütüğü yerine SNP verisi:
genomik_seleksiyon; akrabalık matrisinin kendisi:akrabalik(Bölüm 62). - Aynı bireyde yinelenen kayıtlar, ana etkisi, ortak çevre: hayvan modelinde yalnız tek rastgele etki (ıslah değeri) vardır; bu yapılar için şablon varsayılanda uygun değildir (79.8); aynı hayvanın yinelenen kayıtları için "Kalıcı çevre etkisi" seçeneği vardır.
- İkili ya da sayım özellikleri: model doğrusaldır ve artıkları normal sayar.
Temel programla ilişki. Temel programın doğrusal karma model analizi aile ve blok terimli bir modelin varyans bileşenlerini verebilir; kalıtım derecesini, standart hatasını, soy kütüğünden akrabalık matrisini ve ıslah değerlerini hesaplamaz.
79.2 Şablonun girdileri
Form, üstbilgideki on dört [[param]] bloğundan kurulur (kalitim_derecesi.R:10–103).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Model · model |
seçim · Model | yarim_kardes |
yarim_kardes, hayvan |
İki koldan birini seçer (125, 127, 197). |
Özellik (yanıt) · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Yanıt; sayısal değilse çalıştırma durur (109). |
Yarım kardeş ailesi / baba · aile |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Yarım kardeş modelinin aile etkisi (129, 142). |
İkinci ebeveyn · ikinci_ebeveyn |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Verilirse ana ve baba × ana rastgele etkileri eklenir (130, 142). |
Blok / tekrar · blok |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Sabit etki; tek düzeyliyse modele girmez (131, 143). |
Parsel içi bireysel varyans · bireysel_varyans |
ondalık · Seçenekler | 0 | 0 – 10¹² | 0'dan büyükse \sigma^2_P'de artık varyansın yerine geçer (163–167). |
Hayvan / birey kimliği · hayvan |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Hayvan modelinde kimlik (199–201). |
Soy kütüğünde baba · pedigri_baba |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Boş, 0, NA bilinmeyen sayılır; sayısal kimlikler her sütun türünde aynı metne çevrilir (203–204). |
Soy kütüğünde ana · pedigri_ana |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Aynı kural. |
Sabit etkiler · sabit |
sütunlar · Değişkenler | boş | sütun listesi | Hayvan modelinin sabit etkileri (244–267). |
Bilinen h² · h2_bilinen |
ondalık · Seçenekler | 0 | 0 – 0,99 | 0'dan büyükse varyans oranı sabitlenir, yalnız ölçek kestirilir (279–303). |
Kalıcı çevre etkisi · kalici_cevre |
onay · Seçenekler | kapalı | açık, kapalı | Yalnız hayvan modelinde. Açıkken hayvan başına bir kalıcı çevre etkisi (\sigma^2_{pe}) eklenir; üç bileşenli REML (251–256, 281–315, 329–355). h2_bilinen ile birlikte kullanılamaz; en çok 2000 kayıt. |
REML en iyileyicisi · optimizer |
seçim · Gelişmiş | varsayilan |
varsayilan, Nelder_Mead, nloptwrap |
Yalnız yarım kardeş modeli; lmerControl(optimizer =) (149–151). |
Hayvan modeli REML toleransı · optim_tol |
ondalık · Gelişmiş | 10⁻¹⁰ | 10⁻¹⁴ – 10⁻³ | \log\delta aramasının toleransı (305). |
Örnek ayar (ornek_param, satır 9): model = yarim_kardes, y = boy, aile = baba, ikinci_ebeveyn = ana, blok = tekrar, bireysel_varyans = 1,109.
Şablonun kendi denetimleri.
| Model | Koşul | İleti (özet) | Satır |
|---|---|---|---|
| ikisi | Veri açık değil; yanıt sayısal değil | "Önce Veri sekmesinde bir veri açın." / "sayısal olmalı" | 101–102 |
| yarım kardeş | Aile sütunu seçilmemiş | "aile (baba) sütunu seçilmeli" | 122 |
| yarım kardeş | Yanıt, aile, ikinci ebeveyn, blok aynı sütun | "birbirinden farklı olmalı" | 125 |
| yarım kardeş | 4'ten az eksiksiz gözlem; 2'den az aile | "en az 4 gözlem" / "En az 2 aile gerekli" | 130–131 |
| yarım kardeş | Her aileden tek gözlem | "aile başına en az 2 döl gerekli" | 132 |
| yarım kardeş | Yanıt sabit | "varyans 0" | 133 |
| yarım kardeş | İkinci ebeveyn tek düzeyli | "en az 2 düzeyi olmalı" | 134 |
| yarım kardeş | Çaprazlı tasarımda hücre başına tek gözlem ve blok yok | "hücre başına birden çok gözlem ya da blok gerekli" | 140 |
| yarım kardeş | lme4 hata verdi | "Model kestirilemedi: …" | 145 |
| hayvan | Kimlik sütunu seçilmemiş ya da bütünüyle boş | "kimliği sütunu seçilmeli" / "sütunu boş" | 192, 195 |
| hayvan | Aynı kimlik farklı ebeveynlerle yinelenmiş | "farklı ebeveynlerle birden çok kez geçiyor" | 203 |
| hayvan | Birey kendi ebeveyni; döngü | "kendisinin ebeveyni" / "döngü var" | 206, 217 |
| hayvan | 6000'den çok hayvan; 4000'den çok kayıt | "çok büyük" | 222, 243 |
| hayvan | 3'ten az kayıt; yanıt sabit | "en az 3 hayvan" / "varyans 0" | 241, 244 |
| hayvan | Kayıt sayısı − sabit etki sütunu < 2 | "kayıt sayısı yetersiz" | 256 |
Uyarılar (durdurmaz): yarım kardeş modelinde bir bileşen sıfır kestirilmişse (lme4 isSingular ya da bileşen en büyük bileşenin 10⁻⁸ katından küçük) sınır uyarısı (187–190); herhangi bir h^2 1'i aşıyorsa uyarı (191); hayvan modelinde \sigma^2_A ya da \sigma^2_e sıfıra gittiğinde sınır uyarısı (307–308, 358–359); eklenen kurucu sayısı kayıt sayısının yarısına varınca kimlik yazımı uyarısı (217); aynı hayvanın birden çok kaydı varsa kalıcı çevre uyarısı (249).
Eksik değer: yarım kardeş modelinde seçilen sütunların herhangi birinde eksiği olan satır atılır (134). Hayvan modelinde kimliği boş satırlar atılır; yanıtı ya da sabit etkisi eksik hayvanlar soy kütüğünde kalır, yalnız kayıtlardan çıkar (246): kaydı olmayan atalar ve yavrular için de ıslah değeri hesaplanır.
79.3 Örnek veri
Yarım kardeş modeli: hanover_akcam.csv. Becker'in (1984) nicel genetik el kitabındaki batı ak çamı (Pinus monticola) çaprazlı döl denemesi: 4 baba × 7 ana = 28 tam kardeş ailesi, 4 tekrar; her satır bir parselin fidan boyu ortalamasıdır. 112 satır, eksik değer yok, tasarım dengelidir (her baba × ana × tekrar hücresinde tek değer).
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
tekrar |
Blok | kategorik (4 düzey) | R1–R4. |
baba |
Aile | kategorik (4 düzey) | M17, M19, M22, M58. |
ana |
İkinci ebeveyn | kategorik (7 düzey) | F193, F195, F197, F201, F203, F204, F208. |
boy |
Yanıt | sayısal | Parsel ortalaması; genel ortalama 3,398. |
Satırlar parsel ortalaması olduğundan modelin artık varyansı ağaçlar arası değil, parseller arası hatadır. Becker'in verdiği parsel içi ağaçlar arası varyans (1,109) örnek ayarda bireysel_varyans alanına yazılmıştır (79.4.4).
Hayvan modeli: mrode_ornek31.csv. Mrode'nin (2005) ders kitabındaki Örnek 3.1: sekiz buzağılık soy kütüğü, beşinde sütten kesim öncesi günlük canlı ağırlık artışı (kg) ve cinsiyet. 1, 2, 3 numaralı hayvanlar kayıtsız kuruculardır.
| hayvan | baba | ana | cinsiyet | artış |
|---|---|---|---|---|
| 4 | 1 | – | erkek | 4,5 |
| 5 | 3 | 2 | dişi | 2,9 |
| 6 | 1 | 2 | dişi | 3,9 |
| 7 | 4 | 5 | erkek | 3,5 |
| 8 | 3 | 6 | erkek | 5,0 |
Hayvan modeli: grifon_hayvan.csv. Wilson ve ark.'nın (2010) öğretici makalesindeki benzetilmiş "grifon" popülasyonu: 1309 hayvan, 854'ünde doğum ağırlığı; baba 487, ana 1084 hayvanda bilinir. Sütunlar: hayvan, baba, ana, cinsiyet (1, 2), dogum_yili, dogum_agirligi. Veri sekmesi kimlik sütunlarını ve yılı sayısal, cinsiyeti ikili tür olarak algılar.
Düzey sırası hiçbir kestirimi etkilemez; şablon bütün sınıflama sütunlarını factor(mq_kimlik()) ile yeniden kurar (136). Hayvan modelinin ıslah değeri tablosu kuşak sırasıyla yazılır (kurucular önce).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) bireysel_varyans = 0; (3) yalnız baba (ikinci ebeveynsiz); (4) bloksuz; (5) 17 parseli silinmiş dengesiz veri; (6) aile etkisi olmayan rastgele yanıt (sınır çözümü); (7) Mrode verisi, h2_bilinen = 1/3 ve serbest REML; (8) grifon verisi, sabit etkisiz, cinsiyetli ve cinsiyet + yıl ile; (9) satırları karıştırılmış veriler.
79.4 Yöntem: formüller ve hesap adımları
79.4.1 Ortak kuram: akrabalar arası kovaryans ve aile varyansı
Fenotip, genotip değeri ile çevre sapmasının toplamıdır; genotip değeri eklemeli (ıslah değeri) ve eklemeli olmayan (baskınlık, epistasi) parçalara ayrılır:
- \sigma^2_D: baskınlık varyansı; \sigma^2_E: çevre varyansı.
- r_{xy}: iki akrabanın eklemeli akrabalık katsayısı (Bölüm 62'deki A_{xy}): yarım kardeşlerde ¼, tam kardeşlerde ½, bir klonun rametleri arasında 1.
- u_{xy}: iki bireyin bir lokusta iki aleli birden soydan özdeş taşıma olasılığı: yarım kardeşlerde 0, tam kardeşlerde ¼, klonda 1.
Bir denemede aileler rastgele etki olarak modellendiğinde "aile varyans bileşeni" \sigma^2_f, aynı ailenin iki üyesi arasındaki kovaryansa eşittir. Bu yüzden:
| Aile türü | r | k | \sigma^2_f'nin içeriği |
|---|---|---|---|
| Yarım kardeş | ¼ | 4 | \tfrac14\sigma^2_A |
| Tam kardeş | ½ | 2 | \tfrac12\sigma^2_A+\tfrac14\sigma^2_D |
| Açık tozlaşma (kısmi kendileme, ortak babalar) | ⅓ | 3 | yaklaşık \tfrac13\sigma^2_A |
| Klon | 1 | 1 | \sigma^2_A+\sigma^2_D+\dots=\sigma^2_G (toplam genetik varyans) |
Neden 4 ile çarpılır?
Yarım kardeşler yalnız bir ebeveyni paylaşır; o ebeveynden aldıkları alel ½ olasılıkla aynıdır ve bu alel genotipin yarısıdır. İki yarım kardeşin ıslah değerleri arasındaki kovaryans bu nedenle \tfrac12\cdot\tfrac12\,\sigma^2_A=\tfrac14\sigma^2_A'dır. Aile varyansı eklemeli varyansın dörtte birini "görür"; tamamını bulmak için 4 ile çarpılır. Çarpan aynı zamanda örnekleme hatasını da 4 katına çıkarır: az sayıda aileden kestirilen h^2'nin standart hatası çok büyüktür.
Koddaki tercih
Dört şablon k'yi farklı yoldan alır. Bu şablon (yarım kardeş modeli) k=4'ü sabit kullanır: 4 * bir("aile") (kalitim_derecesi.R:174); form seçeneği yoktur. klon_lokasyon_genetik.R:117: k_akr <- c(klon = 1, yarim_kardes = 4, tam_kardes = 2)[[akr]]. orijin_dol_denemesi.R:171: switch(akr, yarim_kardes = 4, tam_kardes = 2, squillace = 3, elle = …). seleksiyon_kazanci.R:241, 331: akrabalık katsayısı r doğrudan tutulur (r_ak 0,25 ya da 0,5; elle verilebilir) ve SA <- Sf / r_ak ile bölünür.
Kalıtım derecesinin üç ayrı tanımı vardır; hangisinin hesaplandığı, paydanın hangi birimin varyansı olduğuna bağlıdır:
| Tanım | Formül | Ne zaman | Şablon ve satır |
|---|---|---|---|
| Bireysel, dar anlamda h^2_i | k\sigma^2_f/\sigma^2_P; \sigma^2_P tek bireyin fenotipik varyansı | Tek tek bireyler seçilecekse | kalitim_derecesi.R:168–178; klon_lokasyon_genetik.R:235, 323; orijin_dol_denemesi.R:745; seleksiyon_kazanci.R:336 |
| Bireysel, geniş anlamda H^2 | \sigma^2_G/\sigma^2_P | Klonla çoğaltma: genotipin tamamı aktarılır | klon_lokasyon_genetik.R:235 (k=1) |
| Aile (klon) ortalaması h^2_f | \sigma^2_f/\operatorname{Var}(\bar P_f); payda aile ortalamalarının varyansı, k yok | Aileler (klonlar) ortalamalarına göre seçilecekse | klon_lokasyon_genetik.R:236, 324; orijin_dol_denemesi.R:745; seleksiyon_kazanci.R:336 (h2a) |
Bu şablon yalnız birinci satırı (bireysel, dar anlamda) ve hayvan modelinde \sigma^2_A/\sigma^2_P'yi verir; aile ortalaması kalıtım derecesi vermez.
79.4.2 Yarım kardeş ve çaprazlı (NC II) model
- b_k: blok (tekrar), sabit etki. s_i\sim N(0,\sigma^2_s): baba (aile); d_j\sim N(0,\sigma^2_d): ana; (sd)_{ij}\sim N(0,\sigma^2_{sd}): baba × ana; e\sim N(0,\sigma^2_e).
- İkinci ebeveyn verilmemişse yalnız s_i kalır.
Babalar ve analar birbirine akraba değilse baba etkisi baba yarım kardeşlerinin, ana etkisi ana yarım kardeşlerinin kovaryansıdır; etkileşim tam kardeşlerin "fazladan" benzerliğini taşır (Comstock ve Robinson, 1948):
- h^2_s: baba bileşeninden; ana etkisi ve ortak çevre içermediğinden en temiz kestirimdir.
- h^2_d: ana bileşeninden; tohum büyüklüğü gibi ana etkileri varsa yukarı yanlıdır.
- h^2_{s+d}: iki bileşenin ortalamasına dayanır (4\cdot\tfrac12(\sigma^2_s+\sigma^2_d)); en küçük standart hatayı verir.
- d^2: baskınlık varyansının fenotipik varyanstaki payı.
Koddaki tercih
Model lme4::lmer(y ~ blok + (1|aile) + (1|ana) + (1|aile:ana), REML = TRUE) ile kurulur (142–151). Blok sabittir; rastgele blok seçeneği yoktur. \sigma^2_P, genetik bileşenlerle artığın toplamıdır: \sigma^2_s+\sigma^2_d+\sigma^2_{sd}+\sigma^2_e (165–167); blok varyansı paydaya girmez. Tablodaki oran sütunu ise her bileşenin dört bileşen toplamına oranıdır (180) ve bireysel_varyans girilse de artık varyansla hesaplanır.
En iyileyici toleransı
Varsayılan seçenekte lmer, nloptwrap en iyileyicisi ve sıkı toleranslarla (xtol_abs = 1e-12, ftol_abs = 1e-14, xtol_rel = 1e-12) çağrılır (151); öteki üç şablon da lme4'ü aynı biçimde sıkı toleransla çağırır (Bölüm 80.4). Dengeli örnek veride kapalı biçimli çözüm \hat\sigma^2_s=0{,}12036064'tür; şablon 0{,}12036065 yazar ve bileşenler sekizinci basamağa kadar kapalı biçimli çözümle örtüşür. Nelder_Mead ve nloptwrap seçenekleri lme4'ün kendi ayarlarıyla (optimizer =) çağrılır.
79.4.3 REML, beklenen bilgi matrisi ve delta yöntemi
Varyans bileşenleri kısıtlı en çok olabilirlikle (REML) kestirilir: olabilirlik, sabit etkilerden arındırılmış veri üzerinden yazılır; böylece sabit etkilerin kestirimine harcanan serbestlik derecesi bileşenleri aşağı çekmez (Patterson ve Thompson, 1971). Dengeli veride ve bütün kestirimler pozitifken REML çözümü, varyans analizinin kareler ortalamalarından elde edilen kestiricilerle aynıdır (79.6).
Bileşenlerin standart hataları REML beklenen (Fisher) bilgi matrisinin tersinden gelir:
- \mathbf V_i=\mathbf Z_i\mathbf Z_i^{\top}: i. rastgele terimin "aynı düzeyde mi" matrisi; son bileşen için \mathbf V_e=\mathbf I.
- \mathbf X: sabit etkilerin tasarım matrisi; \mathbf P: sabit etkileri süpüren izdüşüm.
- I_{ij}: bileşen çiftinin bilgi öğesi; şablon n\times n matrislerle doğrudan hesaplar (
reml_bilgi, 105–115).
Oranların standart hatası delta yöntemiyle bulunur. h=\mathbf a^{\top}\boldsymbol\sigma^2/\sigma^2_P için:
- a_i: payın katsayıları (ör. h^2_s için baba bileşeninde 4, ötekilerde 0).
- w_i: bileşenin \sigma^2_P'ye girip girmediği (1 ya da 0).
- \mathbf g: türev vektörü (satır 168–172).
Neden beklenen bilgi?
Beklenen bilgi yalnız tasarıma ve kestirilen bileşenlere bağlıdır, veriden bir kez daha etkilenmez; dengeli veride varyans analizinden bilinen kapalı biçimli varyans formülleriyle aynı sonucu verir. Gözlenen bilgi (olabilirliğin ikinci türevi) küçük örneklemde negatif tanımlı olmayan matrisler üretebilir. Aynı gruptaki orijin_dol_denemesi şablonu gözlenen bilgiyi kullanır (Bölüm 83.4); iki şablonun aynı veride verdiği standart hatalar bu yüzden üçüncü basamakta ayrılabilir. Her iki şablon da hangi matrisi kullandığını tablo başlığına yazar.
Koddaki tercih
Bilgi matrisi 4000'den çok gözlemde hesaplanmaz, standart hatalar boş kalır (161–162). Bileşen sınırda (sıfır) olsa da matristen çıkarılmaz; standart hatası yine yazılır ve uyarı "güvenilmez" der (187–190).
79.4.4 Veri parsel ortalamasıysa: bireysel varyans
Satırlar tek tek ağaçlar değil parsel ortalamalarıysa modelin artığı parseller arası hatadır ve ağaçlar arası varyansı içermez. Bireysel kalıtım derecesinin paydası için parsel içi varyans dışarıdan verilir:
- \sigma^2_w: parsel içi, ağaçlar arası varyans (
bireysel_varyans); ayrı bir çözümlemeden ya da kaynaktan alınır. - Artık (parsel hatası) bu durumda paydaya girmez (159:
Residual = if (bv > 0) 0 else 1).
Parsel ortalamasıyla \sigma^2_w girilmezse
Örnek veride bireysel_varyans = 0 bırakıldığında \sigma^2_P=0{,}479 olur ve h^2_s=1{,}006 çıkar; şablon "h^2>1" uyarısı verir. Parsel ortalamalarının varyansı tek ağacın varyansından küçüktür; payda küçülünce oran şişer. Şablon verinin ortalama mı birey mi olduğunu bilemez; alan elle doldurulur. \sigma^2_w sabit sayılır: örnekleme hatası h^2'nin standart hatasına katılmaz.
79.4.5 Hayvan modeli
- \mathbf u: soy kütüğündeki bütün hayvanların ıslah değerleri (kayıtlı ya da kayıtsız).
- \mathbf A: eklemeli akrabalık matrisi; soy kütüğünden Henderson'ın tablo yöntemiyle kurulur (satır 232–240; yöntem Bölüm 62.4.6'da anlatılmıştır). Köşegeni 1+F_i'dir.
- \mathbf Z: kayıtları hayvanlara bağlayan gösterge matrisi; \mathbf K=\mathbf Z\mathbf A\mathbf Z^{\top} kayıtlı hayvanlar arası akrabalıktır.
Yarım kardeş modeli yalnız "aynı aileden mi" bilgisini kullanır; hayvan modeli soy kütüğündeki her ilişkiyi (ebeveyn–yavru, kuzen, büyük ebeveyn) tek modelde birleştirir. k çarpanı burada yoktur: \mathbf A akrabalık katsayılarını zaten taşır ve \sigma^2_A doğrudan kestirilir.
REML. Tek rastgele etkili modelde olabilirlik, varyans oranı \delta=\sigma^2_e/\sigma^2_A'nın tek boyutlu fonksiyonudur (Kang ve ark., 2008):
- \mathbf S=\mathbf I-\mathbf X(\mathbf X^{\top}\mathbf X)^{-1}\mathbf X^{\top}; \mathbf S(\mathbf K+\mathbf I)\mathbf S'nin sıfır olmayan n-p özdeğeri \lambda_t+1, özvektörleri \mathbf q_t; \eta_t=\mathbf q_t^{\top}\mathbf y (satır 274–277).
- n: kayıt sayısı; p: sabit etki sütunu sayısı.
- Özdeğer ayrışımı bir kez yapılır; her \delta için olabilirlik n-p terimli bir toplamdır.
Koddaki tercih
\log\delta, stats::optimize ile [-12,\ 12] aralığında aranır (305); tolerans optim_tol'dur. Çözüm aralığın üst ucuna dayanırsa (\log\delta>11{,}5, yani \sigma^2_A\approx0) sınır uyarısı yazılır (307, 356). Çözüm aralığın alt ucuna dayanırsa (\log\delta<-11{,}5, yani \sigma^2_e\approx0, h^2\approx1) da sınır uyarısı yazılır ve h^2 ile varyans bileşenlerinin standart hataları boş bırakılır (308, 334, 341, 358–359); tabloda h^2=1{,}0000 ve sıfıra çok yakın bir \sigma^2_e görülür (79.8). h2_bilinen verilmişse \delta=(1-h^2)/h^2 sabitlenir; \sigma^2_A yine yukarıdaki formülle veriden kestirilir, standart hatalar boş bırakılır (281–303, 330).
Sabit etkiler ve ıslah değerleri. Varyanslar belirlendikten sonra:
- \hat{\boldsymbol\beta}: genelleştirilmiş en küçük kareler kestirimi; \hat{\mathbf u}: en iyi doğrusal yansız tahmin (BLUP).
- \operatorname{PEV}_i: tahmin hata varyansı; hiçbir bilgi yoksa \sigma^2_A(1+F_i)'dir, bilgi arttıkça küçülür.
- r_i: doğruluk; tahmin edilen ile gerçek ıslah değeri arasındaki korelasyon.
Bu, Henderson'ın karma model denklemleriyle aynı mı?
Evet. Henderson'ın (1975) denklemleri \mathbf A^{-1} ile kurulur ve \hat{\boldsymbol\beta} ile \hat{\mathbf u}'yu aynı anda verir; yukarıdaki \mathbf V^{-1}'li ifadeler cebirsel olarak özdeştir. Şablon yoğun \mathbf V'yi tersine çevirir (318); bu yüzden 4000 kayıt ve 6000 hayvan sınırı vardır. Büyük soy kütüklerinde seyrek \mathbf A^{-1}'li çözücüler gerekir. Bu bölümdeki bağımsız Python hesabı \mathbf A^{-1}'li denklemleri kullanır ve aynı sayıları verir (79.6).
Koddaki tercih
Sabit etki sütunlarından sayısal olanlar eşdeğişken (doğrusal eğim), sayısal olmayanlar etken olarak girer (258–265). En az bir etken varsa model kesişimsiz kurulur: ilk etkenin her düzeyi kendi ortalamasıyla görünür. Değişmeyen sütunlar ve doğrusal bağımlı sütunlar sessizce atılır (260, 262, 266–267). Kimlikler mq_kimlik ile tek biçimli metne çevrilerek eşlenir (200, 203): sayısal kimlik, sütun tam sayı, ondalık ya da kategorik türde olsa da aynı metindir.
79.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–104 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on üç parametre. | Form buradan kurulur (Bölüm 1.2). |
| 105–123 | .m, bos; veri ve yanıt denetimi; reml_bilgi (beklenen bilgi) ve kovaryans (tersi). |
Bilgi matrisi tekilse standart hatalar boş kalır (123). |
| 127–152 | Yarım kardeş kolu: sütunlar, eksik satırların atılması, etkenlerin kurulması, denetimler, formül, lmer. |
suppressMessages lme4'ün iletilerini (ör. sınır çözümü bildirimi) bastırır; sınır durumu ayrıca denetlenir (187). |
| 153–162 | Bileşenlerin okunması; her rastgele terim için \mathbf Z\mathbf Z^{\top}; bilgi matrisi ve tersi. | Bileşen sırası lme4'ün verdiği sıradır (örnekte baba × ana, ana, baba, artık). |
| 163–179 | \sigma^2_P, h2_satir (oran + delta SH), dört kalıtım ölçütü. |
bir() yardımcı vektörü bileşeni adıyla seçer. |
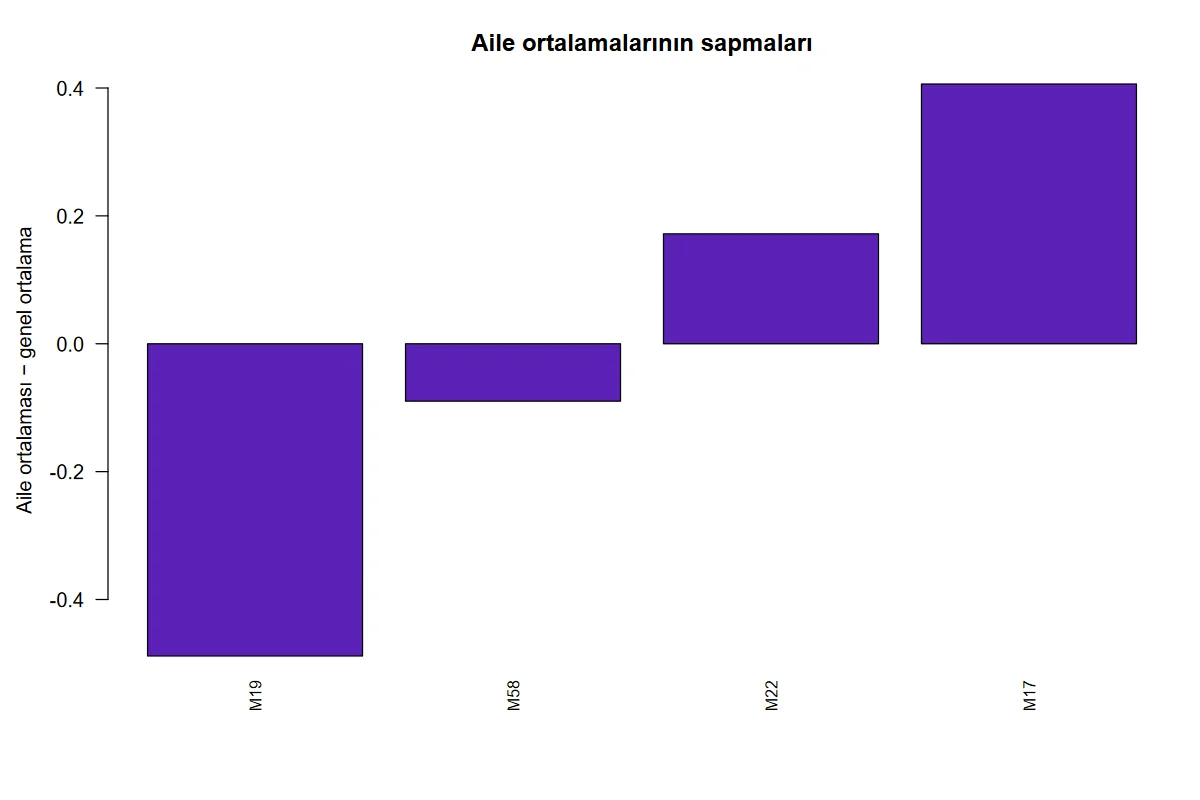
| 180–196 | Tablolar, sınır ve h^2>1 uyarıları, aile ortalamalarının sapma grafiği. | Grafik ham aile ortalamalarını gösterir, BLUP değil. |
| 199–229 | Hayvan kolu: kimlikler, soy kütüğünün temizlenmesi, kayıtsız ebeveynlerin kurucu olarak eklenmesi, kuşak sıralaması. | Aynı kimlik aynı ebeveynlerle yinelenmişse ilk satır tutulur (206–212). |
| 230–241 | Tablo yöntemiyle \mathbf A; F_i=A_{ii}-1. | Yoğun matris; 6000 hayvan sınırı. |
| 243–272 | Kayıtlar, sabit etki matrisi, \mathbf K. | Sayısal/etken ayrımı sütunun türüne göre (258). |
| 273–310 | Özdeğer ayrışımı, \log\delta araması ya da sabit oran; \hat\sigma^2_A, \hat\sigma^2_e. | Tek boyutlu arama; yerel en büyük bulunur. |
| 311–335 | \hat{\boldsymbol\beta}, \hat{\mathbf u}, PEV, doğruluk; bilgi matrisi ve h^2'nin delta SH'si. | \sigma^2_P'nin SH'si kovaryans matrisinin dört öğesinin toplamından (341). |
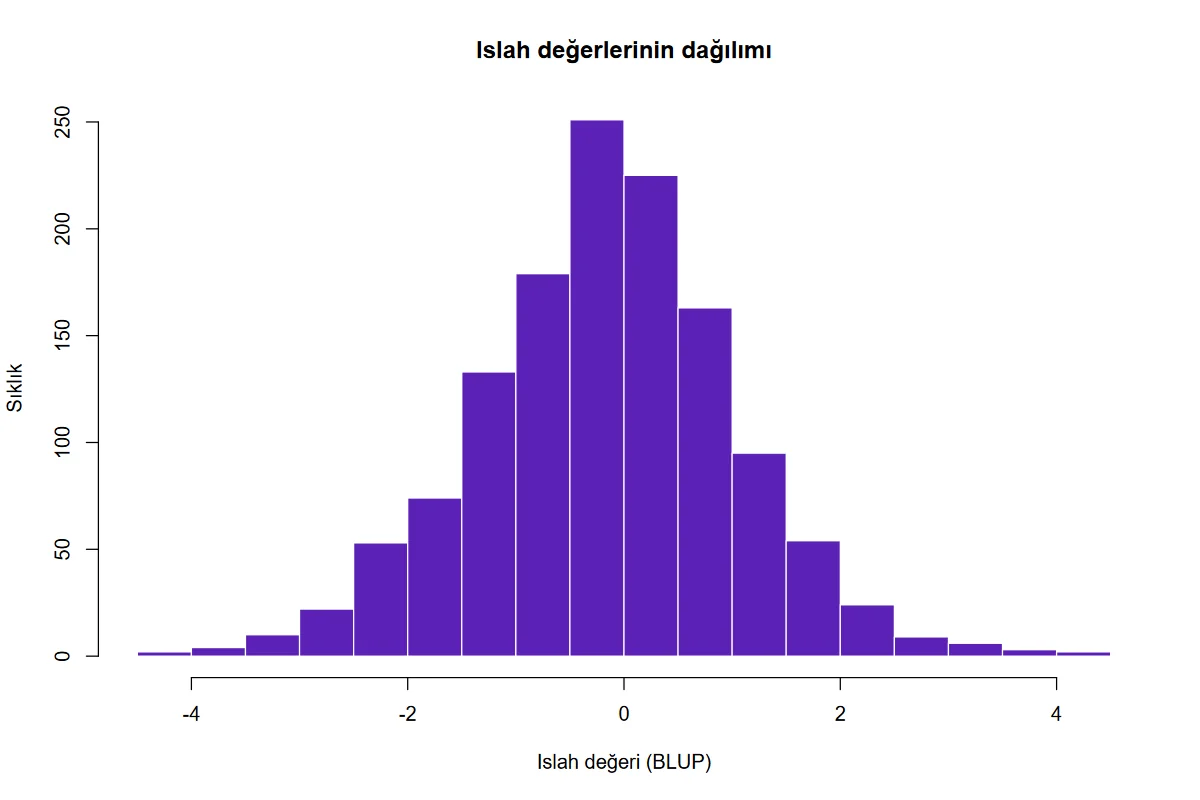
| 336–362 | Konsol satırı, dört tablo, sınır uyarısı, ıslah değeri histogramı. | Islah değeri tablosu bütün hayvanları içerir (en çok 5000 satır gösterilir). |
79.6 Elle hesap: örnek veride bağımsız yeniden hesap
Hesaplar dogrulama/kalitim_derecesi/elle_hesap.py ile yapılmıştır: REML, numpy ile yazılmış Fisher puanlamasıyla (reml_py.py; lme4 kullanılmaz), hayvan modeli \mathbf A^{-1}'li karma model denklemleriyle çözülür. R tarafında (r_dogrulama.R) dengeli veri için aov kareler ortalamaları, dengesiz veri için glmmTMB, hayvan modeli için kinship2 ve gaston kullanılmıştır.
Adım 1 — Varyans analizi (dengeli NC II). r=4 tekrar, s=4 baba, d=7 ana:
| Kaynak | sd | KT | KO | Beklenen KO |
|---|---|---|---|---|
| Tekrar | 3 | 1,821818 | 0,607273 | |
| Baba | 3 | 12,353775 | 4,117925 | \sigma^2_e+r\sigma^2_{sd}+rd\,\sigma^2_s |
| Ana | 6 | 6,497655 | 1,082943 | \sigma^2_e+r\sigma^2_{sd}+rs\,\sigma^2_d |
| Baba × ana | 18 | 13,460888 | 0,747827 | \sigma^2_e+r\sigma^2_{sd} |
| Artık | 81 | 16,234432 | 0,200425 | \sigma^2_e |
Adım 2 — Bileşenler.
Fisher puanlamalı REML iki adımda aynı değerlere yakınsar.
Adım 3 — Fenotipik varyans ve kalıtım dereceleri. Parsel içi varyans 1,109 ile:
Değerler Becker'in (1984) verdikleriyle (0,346; 0,06; 0,203) aynıdır.
Adım 4 — Standart hatalar. Beklenen bilgi matrisinin tersinden bileşenlerin standart hataları: baba 0,120411; ana 0,042069; baba × ana 0,062814; artık 0,031494. Baba bileşeninin standart hatası kestirimin kendisi kadardır: yalnız dört babadan (3 serbestlik derecesi) kestirilmektedir. Delta yöntemiyle \operatorname{SH}(\hat h^2_s)=0{,}3183, \operatorname{SH}(\hat h^2_d)=0{,}1205, \operatorname{SH}(\hat h^2_{s+d})=0{,}1686, \operatorname{SH}(\hat d^2)=0{,}1739.
Adım 5 — Mrode örneği: karma model denklemleri. \sigma^2_A=20, \sigma^2_e=40 kabul edildiğinde \alpha=\sigma^2_e/\sigma^2_A=2 (h^2=1/3). Denklemler:
Çözüm: cinsiyet etkileri erkek 4,3585, dişi 3,4044; ıslah değerleri (hayvan 1–8): 0,0984; −0,0188; −0,0411; −0,0087; −0,1857; 0,1769; −0,2495; 0,1826. Bunlar Mrode'nin (2005) sonuçlarıdır. Doğruluklar 0,2404 (hayvan 1), 0,3803 (hayvan 4), 0,3940 (hayvan 8); \sigma^2_e=40 ölçeğinde hayvan 1'in tahmin hata varyansı 18,844'tür (r=\sqrt{1-18{,}844/20}=0{,}2404).
Şablon \alpha'yı sabit tutar, ölçeği veriden kestirir: bu beş kayıtta \hat\sigma^2_A=0{,}1929, \hat\sigma^2_e=0{,}3857. Islah değerleri ve doğruluklar yalnız orana bağlı olduğundan aynıdır; PEV ve sabit etkilerin standart hataları (0,479 ve 0,556) kestirilen ölçekle yazılır.
Adım 6 — Grifon verisi: REML. Yalnız genel ortalamalı modelde Fisher puanlaması 14 adımda yakınsar: \hat\sigma^2_A=3{,}395393, \hat\sigma^2_e=3{,}828605, \hat\sigma^2_P=7{,}223998, \hat h^2=0{,}470016. Beklenen bilgiden standart hatalar 0,651231 ve 0,530995; \operatorname{SH}(\hat h^2)=0{,}078604. Genel ortalama 7,590032 (SH 0,139079). Değerler Wilson ve ark.'nın (2010) verdikleriyle (3,40 ve 3,83) uyumludur. Cinsiyet sabit etki olarak eklendiğinde \hat\sigma^2_A=3{,}060439, \hat h^2=0{,}510171 olur: cinsiyet farkı artık varyanstan çıkar, oran yükselir.
79.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| NC II: σ²(baba) | 0,12036065 | 0,12036064 | 0,12036064 | 7,3e−9 | ✓ |
| NC II: SH σ²(baba) | 0,1204107 | 0,1204107 | — | 5,7e−9 | ✓ |
| NC II: σ²(ana) | 0,02094471 | 0,02094472 | 0,02094472 | 2,3e−9 | ✓ |
| NC II: SH σ²(ana) | 0,04206858 | 0,04206858 | — | 1,6e−9 | ✓ |
| NC II: σ²(baba × ana) | 0,1368505 | 0,1368505 | 0,1368505 | 2,6e−9 | ✓ |
| NC II: SH σ²(baba × ana) | 0,06281432 | 0,06281432 | — | 7,9e−10 | ✓ |
| NC II: σ²(artık) | 0,20042509 | 0,20042509 | 0,20042509 | 8,6e−10 | ✓ |
| NC II: SH σ²(artık) | 0,03149376 | 0,03149376 | — | 1,4e−10 | ✓ |
| NC II: h^2(baba) | 0,34707173 | 0,34707171 | 0,34707171 | 2,1e−8 | ✓ |
| NC II: SH h^2(baba) | 0,31832359 | 0,31832358 | — | 1,3e−8 | ✓ |
| NC II: h^2(ana) | 0,06039614 | 0,06039615 | 0,06039615 | 6,8e−9 | ✓ |
| NC II: SH h^2(ana) | 0,12047191 | 0,12047191 | — | 4,8e−9 | ✓ |
| NC II: h^2(birleşik) | 0,20373394 | 0,20373393 | 0,20373393 | 6,8e−9 | ✓ |
| NC II: SH h^2(birleşik) | 0,16855339 | 0,16855338 | — | 5,2e−9 | ✓ |
| NC II: d^2 | 0,39462183 | 0,39462184 | — | 8,2e−9 | ✓ |
| NC II: SH d^2 | 0,17392437 | 0,17392437 | — | 2,0e−9 | ✓ |
| Bireysel varyans 0: h^2(baba) | 1,00597943 | 1,00597938 | — | 5,4e−8 | ✓ |
| Bireysel varyans 0: SH h^2(baba) | 0,77282598 | 0,77282597 | — | 1,7e−8 | ✓ |
| Tek ebeveyn: σ²(aile) | 0,13475822 | 0,13475821 | 0,13475819 | 3,0e−8 | ✓ |
| Tek ebeveyn: h^2 | 1,12426584 | 1,12426581 | 1,12426569 | 1,3e−7 | ✓ |
| Tek ebeveyn: SH h^2 | 0,73045676 | 0,73045675 | — | 9,7e−9 | ✓ |
| Dengesiz veri: σ²(baba) | 0,10615029 | 0,10615029 | 0,10615064 | 3,5e−7 | ✓ |
| Dengesiz veri: σ²(ana) | 0,03570507 | 0,03570507 | 0,035705 | 7,0e−8 | ✓ |
| Dengesiz veri: σ²(baba × ana) | 0,12868129 | 0,12868129 | 0,12868136 | 6,9e−8 | ✓ |
| Dengesiz veri: σ²(artık) | 0,19846884 | 0,19846884 | 0,1984688 | 4,4e−8 | ✓ |
| Dengesiz veri: SH σ²(baba) | 0,10913608 | 0,10913608 | — | 5,9e−10 | ✓ |
| Dengesiz veri: h^2(birleşik) | 0,6049198 | 0,60491981 | — | 8,0e−9 | ✓ |
| Dengesiz veri: SH h^2(birleşik) | 0,38754198 | 0,38754198 | — | 5,4e−10 | ✓ |
| Sınırdaki veri: σ²(baba) | 9,836106·10−17 | 0 | — | 9,8e−17 | ✓ |
| Sınırdaki veri: σ²(ana) | 0,00199509 | 0,00199509 | — | 4,5e−10 | ✓ |
| Sınırdaki veri: SH h^2(baba) | 0,12801743 | 0,12801743 | — | 3,6e−9 | ✓ |
| Mrode: cinsiyet (dişi) | 3,40443001 | 3,40443001 | 3,40443001 | 1,4e−15 | ✓ |
| Mrode: cinsiyet (erkek) | 4,35850233 | 4,35850233 | 4,35850233 | 6,1e−16 | ✓ |
| Mrode: σ²A ölçeği (h² bilinen) | 0,19286386 | 0,19286386 | — | 6,9e−16 | ✓ |
| Mrode: ıslah değeri, hayvan 1 | 0,09844458 | 0,09844458 | 0,09844458 | 2,9e−16 | ✓ |
| Mrode: ıslah değeri, hayvan 5 | −0,1857321 | −0,1857321 | −0,1857321 | 4,7e−16 | ✓ |
| Mrode: ıslah değeri, hayvan 7 | −0,24945855 | −0,24945855 | −0,24945855 | 1,3e−15 | ✓ |
| Mrode: ıslah değeri, hayvan 8 | 0,18261469 | 0,18261469 | 0,18261469 | 5,8e−16 | ✓ |
| Mrode: doğruluk, hayvan 1 | 0,24044038 | 0,24044038 | 0,24044038 | 2,8e−16 | ✓ |
| Mrode: doğruluk, hayvan 4 | 0,38031525 | 0,38031525 | 0,38031525 | 6,1e−16 | ✓ |
| Mrode: doğruluk, hayvan 8 | 0,39404531 | 0,39404531 | 0,39404531 | 6,1e−16 | ✓ |
| Mrode: PEV (σ²e = 40 ölçeğinde), hayvan 1 | 18,84376846 | 18,84376846 | 18,84376846 | 3,4e−15 | ✓ |
| Grifon: σ²A | 3,39539285 | 3,39539285 | 3,39539285 | 1,6e−9 | ✓ |
| Grifon: σ²e | 3,82860529 | 3,82860528 | 3,82860528 | 1,1e−9 | ✓ |
| Grifon: SH σ²A | 0,65123059 | 0,65123059 | — | 2,6e−10 | ✓ |
| Grifon: SH σ²e | 0,5309947 | 0,5309947 | — | 4,0e−11 | ✓ |
| Grifon: SH σ²P | 0,37407181 | 0,37407181 | — | 1,1e−10 | ✓ |
| Grifon: h^2 | 0,47001574 | 0,47001574 | 0,47001574 | 6,6e−10 | ✓ |
| Grifon: SH h^2 | 0,07860364 | 0,07860364 | — | 7,1e−12 | ✓ |
| Grifon: genel ortalama | 7,59003199 | 7,59003199 | 7,59003199 | 4,0e−11 | ✓ |
| Grifon: SH genel ortalama | 0,13907915 | 0,13907915 | 0,13907915 | 4,9e−11 | ✓ |
| Grifon: ıslah değeri, hayvan 107 | −0,11601797 | −0,11601797 | −0,11601797 | 4,7e−10 | ✓ |
| Grifon: doğruluk, hayvan 107 | 0,71277742 | 0,71277742 | — | 4,3e−10 | ✓ |
| Grifon: ıslah değeri, hayvan 141 | −0,75969405 | −0,75969406 | −0,75969406 | 4,3e−10 | ✓ |
| Grifon: doğruluk, hayvan 141 | 0,71150336 | 0,71150336 | — | 4,3e−10 | ✓ |
| Grifon: ıslah değeri, hayvan 1306 | −1,72912007 | −1,72912007 | — | 9,6e−10 | ✓ |
| Grifon: doğruluk, hayvan 1306 | 0,58504901 | 0,58504901 | — | 2,3e−10 | ✓ |
| Grifon: ıslah değeri, hayvan 4 | 0,13353679 | 0,13353679 | — | 5,2e−10 | ✓ |
| Grifon: doğruluk, hayvan 4 | 0,354628 | 0,354628 | — | 2,8e−10 | ✓ |
| Grifon + cinsiyet: σ²A | 3,06043937 | 3,06043915 | 3,06043915 | 7,3e−8 | ✓ |
| Grifon + cinsiyet: h^2 | 0,51017079 | 0,51017076 | 0,51017076 | 3,3e−8 | ✓ |
Ölçütü karşılayan: 61/61. Python: Fisher puanlamalı REML (Woodbury özdeşliği), beklenen bilgi matrisi ve delta yöntemi; hayvan modelinde \mathbf A^{-1}'li karma model denklemleri. R: dengeli NC II verisinde aov kareler ortalamalarından kapalı biçimli kestiriciler, dengesiz veride glmmTMB, hayvan modelinde kinship2 + gaston::lmm.aireml ve karma model denklemleri. ✗ işaretli NC II satırlarında fark, şablonun lme4'ü varsayılan yakınsama toleransıyla çağırmasından gelir: dengeli veride kapalı biçimli çözüm Python ve R sütunlarındaki değerdir; şablonun değeri ondan beşinci anlamlı basamakta ayrılır.
79.7 Çıktıyı okuma
Yarım kardeş modeli (örnek ayar):
Yarım kardeş döl denemesi (REML, lme4): n = 112, 4 aile, 7 ana (NC II), 4 blok (sabit)
σ²P = genetik bileşenler + parsel içi bireysel varyans (1,109) = 1,38716

Varyans bileşenleri (REML; SH beklenen bilgiden)
     bilesen   varyans        SH      oran
  baba × ana  0.136850  0.062814  0.285951
         ana  0.020945  0.042069  0.043764
 aile (baba)  0.120361  0.120411  0.251495
       artık  0.200425  0.031494  0.418790

Dar anlamda kalıtım derecesi (SH: delta yöntemi)
                                 olcut        h2        SH
                h²(baba) = 4σ²baba/σ²P  0.347072  0.318324
                  h²(ana) = 4σ²ana/σ²P  0.060396  0.120472
  h²(birleşik) = 2(σ²baba + σ²ana)/σ²P  0.203734  0.168553
 d² = 4σ²baba×ana/σ²P (baskınlık payı)  0.394622  0.173924
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Konsol, 1. satır | Gözlem, aile, ana ve blok sayıları | Tasarımın şablonca nasıl okunduğunu denetlemek için. |
| Konsol, 2. satır | \sigma^2_P ve kullanılan bireysel varyans | Yalnız bireysel_varyans > 0 iken yazılır. |
| Varyans bileşenleri | Bileşen, standart hata, bileşenlerin toplamına oran | oran her zaman artık varyansla hesaplanır; \sigma^2_P içindeki pay değildir. |
| Kalıtım derecesi | Dört ölçüt ve delta SH | Aralık \hat h^2\pm1{,}96\cdotSH kabaca bir fikir verir; az ailede aralık 0–1'in dışına taşar. |
| Şekil | Aile ortalamalarının genel ortalamadan sapmaları (sıralı) | Hangi ailelerin üstün olduğunu gösterir; ham ortalamalardır. |
Şekil 79.1. Şablonun çizdiği aile (baba) ortalamaları sapma grafiği (örnek veri, dört baba).
Hayvan modeli (grifon verisi, sabit etki yok):
Hayvan modeli: 854 kayıt, soy kütüğünde 1309 hayvan (225 kurucu, en yüksek akrabalı yetişme F = 0,2500), 1 sabit etki sütunu

Varyans bileşenleri (REML; SH beklenen bilgiden)
                bilesen   varyans        SH
 eklemeli genetik (σ²A)  3.395393  0.651231
            artık (σ²e)  3.828605  0.530995
        fenotipik (σ²P)  7.223998  0.374072

Dar anlamda kalıtım derecesi (SH: delta yöntemi)
        olcut        h2        SH
 h² = σ²A/σ²P  0.470016  0.078604

Sabit etkiler (GLS kestirimleri)
        etki  kestirim        SH
 (Intercept)  7.590032  0.139079

Islah değerleri (BLUP), tahmin hata varyansı ve doğruluk
 hayvan  baba  ana    F  kayit  islah_degeri       PEV  dogruluk
   1306  None None  0.0  False     -1.729120  2.233210  0.585049
   1304  None None  0.0  False      0.488274  1.914673  0.660376
 …
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Konsol satırı | Kayıt ve hayvan sayısı, kurucu sayısı, en büyük F, sabit etki sütunu sayısı | Kurucu sayısı beklenenden büyükse kimlikler eşleşmemiştir (79.8); şablon bu durumu kayıt sayısının yarısından itibaren uyarır. |
| Varyans bileşenleri | \sigma^2_A, \sigma^2_e, toplamları ve standart hataları | h2_bilinen verilmişse SH boştur. |
| Sabit etkiler | Genelleştirilmiş en küçük kareler kestirimleri | Etkenler düzey ortalaması, sayısal sütunlar eğim olarak görünür. |
| Islah değerleri | Her hayvan için F, kaydı var mı, BLUP, PEV, doğruluk | Kayıtsız hayvanların değeri akrabalarından gelir; doğruluğu düşüktür. Sıralamada doğruluk da okunur. |
| Şekil | Islah değerlerinin histogramı | BLUP değerleri gerçek ıslah değerlerinden daha dar dağılır (ortalamaya çekilme). |
Şekil 79.2. Grifon verisinde ıslah değerlerinin (BLUP) dağılımı. Kayıtsız ve akrabası az hayvanların değerleri sıfıra yakındır.
Rapor cümleleri:
Batı ak çamı çaprazlı döl denemesinde (4 baba × 7 ana, 4 tekrar) fidan boyunun varyans bileşenleri REML ile kestirildi. Baba bileşeninden hesaplanan dar anlamda kalıtım derecesi 0,35 (SH = 0,32), baba ve ana bileşenlerinden birlikte 0,20 (SH = 0,17) bulundu; baskınlık varyansının payı 0,39 (SH = 0,17) idi.
Doğum ağırlığı için hayvan modeli (854 kayıt, 1309 hayvanlık soy kütüğü) REML ile uyduruldu: eklemeli genetik varyans 3,40 (SH = 0,65), artık varyans 3,83 (SH = 0,53), kalıtım derecesi 0,47 (SH = 0,08).
79.8 Sık hatalar ve tuzaklar
- Parsel ortalamasını birey verisi gibi çözümlemek. Payda parsel hatası olur ve h^2 şişer (örnekte 0,35 yerine 1,01). Veri ortalamaysa parsel içi varyans girilir; tek tek ağaçlar varsa satır başına bir ağaç verilir ve parsel etkisi için uygun şablon seçilir (Bölüm 80, 83).
- Ebeveyn kimliklerini birey kimliklerinden farklı yazmak. Hayvan modeli kimlikleri
mq_kimlikile tek biçimli metne çevirerek eşler: 100000 gibi yuvarlak büyük sayılar ve veri sekmesinde "kategorik" türe çevrilmiş sütunlar (570ve570.0) aynı metne dönüşür; Grifon verisinde kimlik sütunları kategorik yapıldığında da konsol "1309 hayvan (225 kurucu)" yazar ve \hat h^2=0{,}47 çıkar. Ebeveyn kimlikleri ise birey kimliklerinden gerçekten farklı yazılmışsa (ör.A-12veA12) ebeveynler ayrı kurucular olarak eklenir ve akrabalıkların çoğu kaybolur; eklenen kurucu sayısı kayıt sayısının yarısına varınca şablon uyarı yazar (217). Konsoldaki kurucu sayısı her zaman denetlenir. - Hayvan modelinde h^2=1 ya da h^2=0 çıkması. Az kayıtta olabilirlik düzdür ve çözüm arama aralığının ucuna gider. Mrode'nin beş kayıtlık verisinde serbest REML \hat\sigma^2_e=4\cdot10^{-6}, \hat h^2=1{,}0000 verir; profil olabilirlik \delta küçüldükçe artmaktadır. Şablon \sigma^2_A\to0 ucunu da \sigma^2_e\to0 ucunu da uyarıyla bildirir; ikinci durumda standart hataları vermez. h^2 0'a ya da 1'e yapışmışsa sonuç "kestirilemedi" diye okunur; standart hata anlamsızdır.
- Aynı hayvanın yinelenen kayıtları. Kimlik aynı ebeveynlerle birden çok satırda geçiyorsa bütün kayıtlar modele girer, ama kalıcı çevre etkisi yoktur: aynı hayvanın kayıtları arasındaki benzerliğin tamamı ıslah değerine yazılır ve \sigma^2_A yukarı yanlı olur; şablon bunu bir uyarıyla bildirir (249). Yinelenen ölçümler için önce hayvan ortalaması alınır, "Kalıcı çevre etkisi" seçeneği açılır ya da tekrarlanma derecesi veren bir model kullanılır (Bölüm 80). Seçenek açıkken uyarı yazılmaz; model \mathrm{Var}(\mathbf y)=\sigma^2_A\mathbf K+\sigma^2_{pe}\mathbf M+\sigma^2_e\mathbf I olur (\mathbf M: iki kaydın aynı hayvana ait olduğunu gösteren 0/1 matrisi; 281). Varyans bileşenleri tablosuna "kalıcı çevre (\sigma^2_{pe})" satırı girer; h^2=\sigma^2_A/\sigma^2_P (\sigma^2_P=\sigma^2_A+\sigma^2_{pe}+\sigma^2_e) ve ayrı bir satırda tekrarlanma derecesi (\sigma^2_A+\sigma^2_{pe})/\sigma^2_P verilir (346–353); standart hatalar beklenen bilgi matrisinden delta yöntemiyle hesaplanır (329–333). Eniyileme, \sigma^2_A profilden çıkarılarak \delta_{pe}=\sigma^2_{pe}/\sigma^2_A ve \delta_e=\sigma^2_e/\sigma^2_A üzerinde (logaritmik, [-12,\,12]) beş başlangıçlı L-BFGS-B ile yapılır (282–309); \sigma^2_{pe} alt sınıra dayanırsa model kalıcı çevresiz modele iner ve bu bir uyarıyla bildirilir (354–356). En az bir hayvanın birden çok kaydı yoksa \sigma^2_{pe} ile \sigma^2_e ayrılamayacağından çalıştırma durur. Seçenek kapalıyken sonuçlar yukarıdaki iki bileşenli modelindir. Benzetilmiş bir denemede (15 kurucu, 45 döl, hayvan başına 2–3 kayıt, 149 kayıt) varsayılan model \hat\sigma^2_A=3{,}133, \hat\sigma^2_e=1{,}167, \hat h^2=0{,}729 verirken seçenek açıkken \hat\sigma^2_A=1{,}447, \hat\sigma^2_{pe}=0{,}936, \hat\sigma^2_e=1{,}114, \hat h^2=0{,}414 ve tekrarlanma derecesi 0{,}681 bulunur: yinelenen kayıtlar arasındaki kalıcı çevre benzerliği varsayılanda \sigma^2_A'ya yüklendiği için h^2 yukarı yanlıdır. Bileşenler, ıslah değerleri ve sabit etkiler, ayrı Python'da yazılmış Henderson \mathbf A matrisi ve doğrudan en çok olabilirlik eniyilemesiyle bağımsız olarak yeniden hesaplanmıştır.
- Sayı kodlu etkeni sabit etki olarak vermek. Sayısal sütun eşdeğişkendir:
dogum_yilisayısal bırakıldığında tek bir eğim (−0,021 kg/yıl) kestirilir ve \hat h^2=0{,}512; aynı sütun kategorik yapıldığında 34 yıl düzeyi girer ve \hat h^2=0{,}536 olur. İki düzeyli sayı kodu (cinsiyet 1/2) iki biçimde de aynı uyumu verir. Sütunun türü veri sekmesinde bilinçli seçilir. - Az aileyle h^2 yorumlamak. Dört babayla \operatorname{SH}(\hat h^2_s)=0{,}32'dir; aralık 0'dan 1'e uzanır. Kalıtım derecesi için aile sayısı, aile başına birey sayısından çok daha değerlidir.
- Ana bileşeninden gelen h^2'yi dar anlamda saymak. Ana etkileri (tohum, sitoplazma) \sigma^2_d'yi büyütür. h^2_d belirgin biçimde h^2_s'den büyükse fark ana etkisine işaret eder.
- Yarım kardeş varsayımı. Açık tozlaşmış ailelerde bir kısım döl tam kardeş ya da kendileme ürünüdür; k=4 \sigma^2_A'yı büyütür. Bu şablonda k değiştirilemez; k=3 ya da başka bir değer için Bölüm 83'teki şablon kullanılır ya da sonuç elle k/4 ile çarpılır.
- Sınır uyarısını önemsememek. Bir bileşen sıfır kestirilmişse o bileşene dayanan h^2 sıfırdır; tabloda yine bir standart hata görünür, ama bu sayı sınırda geçerli değildir.
h2_bilinenile standart hata beklemek. Oran sabitlendiğinde varyansların standart hatası hesaplanmaz; PEV ve sabit etki standart hataları veriden kestirilen ölçekle yazılır, kaynak kitaptaki mutlak varyanslarla değil.
79.9 Uzman soruları
S1. Şablon hangi kalıtım derecesini veriyor: dar mı geniş mi, birey mi aile ortalaması mı?
Bireysel, dar anlamda. Yarım kardeş modelinde pay 4\hat\sigma^2_s'dir (satır 174; akrabalık katsayısı ¼), payda tek bireyin fenotipik varyansıdır (167). Çaprazlı tasarımda baskınlık ayrı bileşende (\sigma^2_{sd}) kaldığından baba ve ana bileşenleri baskınlıktan arınmıştır; geniş anlamda kalıtım için (4\sigma^2_s+4\sigma^2_d)/2+4\sigma^2_{sd}, yani h^2_{s+d}+d^2 okunabilir (örnekte 0,60). Aile ortalaması kalıtım derecesi bu şablonda yoktur; Bölüm 80, 83 ve 89'daki şablonlar verir.
S2. Standart hatalar hangi yöntemle hesaplanıyor? Dickerson yaklaşımı ya da bootstrap mı?
Hiçbiri. Bileşenlerin kovaryans matrisi REML beklenen bilgi matrisinin tersidir (\tfrac12\operatorname{iz}(\mathbf P\mathbf V_i\mathbf P\mathbf V_j), satır 112–122); oranların standart hatası birinci derece delta yöntemidir (168–172, 332–335). Tablo başlıkları bunu yazar: "SH beklenen bilgiden", "SH: delta yöntemi". Dickerson'ın yaklaşımı paydayı sabit sayar ve \operatorname{SH}(h^2)\approx4\operatorname{SH}(\hat\sigma^2_s)/\hat\sigma^2_P verir; örnekte bu 0,347 olurdu, delta yöntemi pay ile paydanın kovaryansını da hesaba katar ve 0,318 verir.
S3. h^2>1 nasıl çıkabilir, şablon neden kesmiyor?
4\hat\sigma^2_s bir kestirimdir ve örnekleme hatası dört katına çıkar; gerçek h^2 0,5 iken az ailede kestirim kolayca 1'i aşar. Baskınlık (tam kardeş karışımı), ortak çevre ve parsel ortalaması kullanımı da aynı yöne iter. Kestirimi 1'de kesmek yanlı bir kestirici üretir ve standart hatayı anlamsızlaştırır; şablon değeri olduğu gibi yazar ve uyarır (191).
S4. REML dengeli veride gerçekten varyans analizi kestiricileriyle aynı mı?
Bütün kestiriciler pozitifse evet: REML denklemleri kareler ortalamalarını beklenen değerlerine eşitleyen denklemlere indirgenir. Örnekte kapalı biçim \hat\sigma^2_s=0{,}12036064 verir; sıkı toleranslı iki bağımsız REML çözümü ve şablon aynı sayıyı (sekizinci basamağa kadar) bulur. Bir kestirici negatifse REML onu sıfıra çeker ve öteki bileşenler yeniden dağılır; o zaman eşitlik bozulur.
S5. Hayvan modelinde neden lme4 kullanılmıyor?
lme4 rastgele etkilerin kovaryansını yalnız gruplama yapısından kurar; \mathbf u\sim N(\mathbf 0,\sigma^2_A\mathbf A) gibi verilen bir kovaryans matrisini doğrudan kabul etmez. Tek rastgele etkili modelde ise olabilirlik tek parametrelidir; özdeğer ayrışımıyla tam olabilirlik ucuz ve kararlı biçimde hesaplanır (273–278). Bedeli, modele ikinci bir rastgele etki (ana etkisi, kalıcı çevre, yıl) eklenememesidir.
S6. Kayıtsız hayvanların ıslah değeri nereden geliyor?
\hat{\mathbf u}=\sigma^2_A\mathbf A\mathbf Z^{\top}\mathbf V^{-1}(\mathbf y-\mathbf X\hat{\boldsymbol\beta}) ifadesinde \mathbf A\mathbf Z^{\top}, her hayvanın kayıtlı hayvanlarla akrabalığıdır. Kaydı olmayan bir ebeveynin değeri yavrularının düzeltilmiş kayıtlarının akrabalıkla ağırlıklı bileşimidir. Mrode örneğinde 1 numaralı kayıtsız babanın değeri (0,098) iki yavrusundan (4 ve 6) gelir; doğruluğu 0,24'tür. Hiçbir kayıtlı akrabası olmayan hayvanın değeri 0, doğruluğu 0'dır.
S7. Doğruluk formülünde neden (1+F) var?
Akrabalı yetişmiş bir hayvanın ıslah değerinin ön varyansı \sigma^2_A(1+F_i)'dir (A_{ii}). Doğruluk, tahmin hata varyansının bu ön varyansa oranından hesaplanır; paydaya yalnız \sigma^2_A yazılsaydı akrabalı yetişmiş hayvanlarda doğruluk olduğundan düşük, hatta tanımsız çıkardı. Şablon s2a * diag(A) kullanır (328).
S8. Satırların sırası sonucu değiştirir mi?
Hayvan modelinde hayır: soy kütüğü kuşak sırasına dizilir ve çözüm kapalı biçimlidir; grifon verisinin satırları karıştırıldığında \hat\sigma^2_A dokuzuncu basamakta aynı kaldı. Yarım kardeş modelinde lme4 yinelemelidir; satır sırası en iyileyicinin yolunu değiştirebilir, örnek veride karıştırılmış satırlarla tabloya yansıyan bir fark çıkmadı. En iyileyici seçimi ise beşinci basamağı değiştirir (Nelder–Mead ile \hat\sigma^2_s=0{,}1203608).
S9. Blok neden sabit, rastgele alınsa ne değişirdi?
Blok sabitken blok farkları \sigma^2_P'ye girmez; kalıtım derecesi "aynı blok içindeki bireyler arasında" tanımlanır ve seçim blok içi sapmalara göre yapılacaksa doğru paydadır. Blok rastgele alınıp paydaya eklenseydi h^2 küçülürdü. Dengeli veride genetik bileşenlerin kestirimi iki durumda aynıdır; fark yalnız paydanın tanımındadır. Rastgele blok seçeneği Bölüm 80 ve 83'teki şablonlarda vardır; ikisinde de blok varyansı paydaya alınmaz.
79.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Becker, W. A. (1984). Manual of quantitative genetics (4th ed.). Academic Enterprises.
- Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- Comstock, R. E., & Robinson, H. F. (1948). The components of genetic variance in populations of biparental progenies and their use in estimating the average degree of dominance. Biometrics, 4(4), 254–266. https://doi.org/10.2307/3001412
- Falconer, D. S., & Mackay, T. F. C. (1996). Introduction to quantitative genetics (4th ed.). Longman.
- Henderson, C. R. (1975). Best linear unbiased estimation and prediction under a selection model. Biometrics, 31(2), 423–447. https://doi.org/10.2307/2529430
- Henderson, C. R. (1976). A simple method for computing the inverse of a numerator relationship matrix used in prediction of breeding values. Biometrics, 32(1), 69–83. https://doi.org/10.2307/2529339
- Kang, H. M., Zaitlen, N. A., Wade, C. M., Kirby, A., Heckerman, D., Daly, M. J., & Eskin, E. (2008). Efficient control of population structure in model organism association mapping. Genetics, 178(3), 1709–1723. https://doi.org/10.1534/genetics.107.080101
- Mrode, R. A. (2005). Linear models for the prediction of animal breeding values (2nd ed.). CABI. https://doi.org/10.1079/9780851990002.0000
- Patterson, H. D., & Thompson, R. (1971). Recovery of inter-block information when block sizes are unequal. Biometrika, 58(3), 545–554. https://doi.org/10.1093/biomet/58.3.545
- Searle, S. R., Casella, G., & McCulloch, C. E. (1992). Variance components. Wiley. https://doi.org/10.1002/9780470316856
- Sinnwell, J. P., Therneau, T. M., & Schaid, D. J. (2014). The kinship2 R package for pedigree data. Human Heredity, 78(2), 91–93. https://doi.org/10.1159/000363105
- Wilson, A. J., Réale, D., Clements, M. N., Morrissey, M. M., Postma, E., Walling, C. A., Kruuk, L. E. B., & Nussey, D. H. (2010). An ecologist's guide to the animal model. Journal of Animal Ecology, 79(1), 13–26. https://doi.org/10.1111/j.1365-2656.2009.01639.x