205. Kısıtlı ordinasyon: CCA, RDA, kısmi ordinasyon ve varyans bölümleme
Şablon kimliği: kisitli_ordinasyon · Kategori: ekoloji · Dil: R · Dosya: pro/sablonlar/ekoloji/kisitli_ordinasyon.R (satır 1–241; üstbilgi 1–99) · Örnek veri: _ornek/vare.csv · Paketler: vegan 2.7-6
205.1 Ne işe yarar
Şablon, bir tür matrisini (örnek alan × tür; bolluk, örtü ya da var/yok) ölçülmüş çevre değişkenleriyle doğrudan ilişkilendirir. Cevapladığı soru şudur: "Alanlar arasındaki tür bileşimi farkının ne kadarı ölçtüğüm çevre değişkenleriyle açıklanıyor, bu pay rastlantıyla beklenenden büyük mü ve hangi değişken hangi yönde etkili?" İki yöntem sunar: kanonik uygunluk analizi (CCA; ter Braak, 1986; türlerin gradyan boyunca tek tepeli yanıt verdiği varsayımı, \chi^2 uzaklığı) ve artıklık analizi (RDA; doğrusal yanıt, Öklid uzaklığı). Model, tür matrisi \mathbf Y'nin çevre matrisi \mathbf X üzerine çok değişkenli doğrusal bağlanımıdır; "kısıtlı" sözü ordinasyon eksenlerinin \mathbf X'in doğrusal bileşimi olmaya zorlanmasından gelir.
- \mathbf Y^{*}: dönüştürülmüş tür matrisi (CCA'da \chi^2 ölçeğine getirilmiş, RDA'da merkezlenmiş ve isteğe bağlı dönüştürülmüş; 205.4).
- \mathbf X^{*}: açıklayıcı değişkenlerin (varsa ağırlıklandırılmış) merkezlenmiş tasarım matrisi; etken değişkenler düzey göstergelerine açılır.
- Eylemsizlik (inertia): \mathbf Y^{*}'nin kareler toplamı (RDA'da n-1'e bölünür). Kısıtlı pay ne kadar büyükse çevre değişkenleri tür bileşimini o kadar açıklar.
Şablonun sunduğu beş iş: (1) CCA ya da RDA uydurma; (2) isteğe bağlı koşul değişkenleriyle kısmi ordinasyon (blok, yıl, uzamsal konum gibi ilgilenilmeyen etkiler önce çıkarılır); (3) permütasyon testleri: genel model, her terim ve her kanonik eksen; (4) düzeltilmiş R^2; (5) ikinci bir açıklayıcı küme seçilirse varyans bölümleme ve triplot.
Ne zaman kullanılır? Tür verisi çok sayıda sıfır içerdiğinde ve tür sayısı örnek sayısını aştığında (klasik çok değişkenli bağlanım uygulanamaz); amaç ordinasyonun çevre ile açıklanabilen kısmını görmek olduğunda; çevre değişkenleri sürekli ya da etken (kategorik) olduğunda; önce bir kümenin etkisi çıkarılıp sonra kalanın sınanması gerektiğinde.
Ne zaman kullanılmaz?
- Tek bir grup etkeni üzerinden "gruplar arasında bileşim farkı var mı?" soruluyorsa ve eksen/gradyan yorumu gerekmiyorsa:
permanova_mantel(Bölüm 207), uzaklık ölçüsü seçilebilir. - Yalnız tür matrisinin kendi yapısı inceleniyorsa (çevre değişkeni yok): temel programdaki PCA (doğrusal), Correspondence Analysis (CA) (tek tepeli) ya da Multidimensional Scaling (MDS) (Bray-Curtis uzaklıklı).
- Yanıt bir tür matrisi değil, birkaç sürekli ölçümse ve çok değişkenli normallik makulse: temel programdaki MANOVA.
- İki sürekli değişken kümesi arasındaki kanonik ilişki isteniyorsa: temel programdaki Canonical Correlation.
- Aynı analizin Python karşılığı gerekiyorsa:
kisitli_ordinasyon_py(Bölüm 206); R şablonunun terim/eksen testleri ve triplot ölçeklemesi orada yoktur. - Tür çeşitliliği göstergelerini (Shannon, Simpson, seyreltme) çevreye bağlamak için: Bölüm 202 ve özellik ağırlıklı ortalamaları gradyana bağlamak için Bölüm 203.
Temel programla ilişki. Temel programda kısıtlı ordinasyon, PERMANOVA ya da Mantel testi yoktur. Yakın analizler şunlardır: CA kısıtsız tek tepeli ordinasyondur; CCA, CA'nın eksenlerini çevre değişkenlerinin doğrusal bileşimi olmaya zorlayan hâlidir (CA bu şablonun "kısıtsız eksenleri" kısmıdır). PCA kısıtsız doğrusal ordinasyondur; RDA, PCA'nın kısıtlı hâlidir. Canonical Correlation iki sürekli kümeyi birbirine bağlar; \chi^2 ağırlıklandırması, permütasyon testi, etken değişken ve koşul değişkeni yoktur (stats/canonical_correlation.py). MDS (stats/dimensionality_advanced.py) tür matrisinden uzaklık kurar ama çevre değişkeniyle bağlamaz. Şablonun yeni getirdiği: çevre kısıtı, kısmi ordinasyon, permütasyonlu anlamlılık ve varyans bölümleme.
205.2 Şablonun girdileri
Form, üstbilgideki on üç [[param]] bloğundan kurulur (kisitli_ordinasyon.R:10–98).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Tür (yanıt) sütunları · turler |
sayısal sütunlar · Değişkenler | boş (en az 2) | sayısal sütunlar | Tür matrisi \mathbf Y (105, 120); açıklayıcılarla ortak sütun çıkarılmaz, açıklayıcılar çıkarılır (106). |
Açıklayıcı (çevre) değişkenler · cevre |
sütunlar · Değişkenler | boş (en az 1) | sayısal ya da kategorik | Formülün sağ yanı (106, 145); tür sütunlarıyla ortaklar atılır; hepsi atılırsa hata (113). |
Koşul değişkenleri · kosul |
sütunlar · Değişkenler | boş | sayısal ya da kategorik | Condition(…) (107, 146); turler ile ortak sütunlar atılır (107); cevre ile ortak sütun varsa çalıştırma açık iletiyle durur (109–110). |
Yöntem · yontem |
seçim · Model | cca |
cca, rda |
vegan::cca ya da vegan::rda (149). |
RDA için tür verisi dönüşümü · donusum |
seçim · Model | yok |
yok, hellinger, sqrt, wisconsin, log1p |
Yalnız RDA'da (136–140); CCA'da seçilirse not düşer (141). |
RDA: türleri birim varyansa ölçekle · olcekle |
onay · Model | kapalı | açık / kapalı | rda(…, scale = TRUE) (142–143, 149). |
Varyans bölümleme için ikinci küme · grup2 |
sütunlar · Değişkenler | boş | sayısal ya da kategorik | varpart ya da koşul varken kısmi RDA kesirleri (198–229); turler ile ortaklar atılır, cevre ya da kosul ile ortak sütun varsa çalıştırma açık iletiyle durur (111–112). |
Permütasyon sayısı · perm |
tamsayı · Seçenekler | 999 | 99–99999 | how(nperm = …) (180). |
CCA'da düzeltilmiş R^2 tanımı · r2_tanim |
seçim · Seçenekler | vegan |
vegan, ezekiel |
vegan: RsquareAdj permütasyonla kestirir (tohuma bağlı); ezekiel: kapalı formül (163–178). RDA'da iki seçenek aynıdır. |
Örnek alanı etiketi · etiket |
kategorik sütun · Çıktı | boş | herhangi sütun | Triplotta alan etiketi (104, 236); eksik değer taşıyan satırı da eler (114–118). |
Permütasyon modeli · perm_model |
seçim · Gelişmiş | reduced |
reduced, direct, full |
anova(…, model = …) (182, 184–186). |
Terim testleri · terim_testi |
seçim · Seçenekler | margin |
margin, terms |
anova(…, by = …) (183, 185, 191). |
Triplot ölçeklemesi · olcekleme |
seçim · Çıktı | 2 |
1, 2, 3 |
plot(…, scaling = …) (232, 234–238). |
Örnek ayar (ornek_param, satır 9): turler = vare verisinin 44 tür sütunu, cevre = [Al, P, K], perm = 499. Öteki alanlar varsayılandadır.
Şablonun kendi denetimleri (mq_hata; ortak biçimsel denetimden sonra):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 103 |
| Koşul değişkeni açıklayıcıyla ortak | "'…' hem açıklayıcı değişken hem koşul değişkeni; birinden çıkarın." | 109–110 |
| İkinci küme açıklayıcı ya da koşulla ortak | "'…' ikinci açıklayıcı kümede ve ayrıca açıklayıcı ya da koşul değişkeni olarak seçili; birinden çıkarın." | 111–112 |
| Çevre listesi tür sütunlarına indirgenmiş | "Tür sütunlarından farklı en az bir açıklayıcı değişken seçin." | 113 |
| Eksiksiz örnek alanı <5 | "Eksiksiz en az 5 örnek alanı gerekli." | 119 |
| Negatif bolluk | "Tür bollukları negatif olamaz." | 121 |
| Sıfır olmayan toplamlı tür <2 | "Sıfırdan farklı toplamlı en az 2 tür gerekli." | 126 |
| CCA ve boş satır (hiç tür yok) | "CCA için her örnek alanında en az bir tür bulunmalı (boş satır var)." | 127 |
| RDA, Hellinger ya da Wisconsin ve boş satır | "Hellinger/Wisconsin dönüşümü için her örnek alanında en az bir tür bulunmalı (boş satır var)." | 128 |
| Açıklayıcı, koşul ya da ikinci küme sabit | "'…' sabit ya da tek düzeyli; çıkarın." | 133–134 |
| Ölçekleme istenip sıfır varyanslı tür | "Ölçekleme için sıfır varyanslı tür sütunu var." | 142–143 |
| Model kurulamadı | "Ordinasyon kurulamadı: …" (paket iletisi) | 148–150 |
| Kısıtlı eksen yok | "Açıklayıcı değişkenler kısıtlı eksen üretmedi (doğrusal bağımlı ya da koşulla aynı)." | 151 |
Eksik değerler. turler, cevre, kosul, grup2 ve etiket sütunlarından birinde eksik değeri olan satır atılır (114–118) ve atılan örnek alanı sayısı ile satır numaraları not olarak yazılır ("Not: eksik değer nedeniyle 2 örnek alanı atıldı (satırlar: 6, 8)."). Toplamı sıfır olan tür sütunları çıkarılır ve sayıları ile adları yazılır (122–125). Tohum: şablonun kendi tohum alanı yoktur; Kod panelinin Tohumu set.seed ile uygulanır (Bölüm 1.3) ve permütasyon p değerlerini, CCA'da (varsayılan r2_tanim = vegan) ayrıca düzeltilmiş R^2'yi belirler (205.4.5); kullanılan tohum çıktıya yazılır. Etken sütunların düzey sırası ve başvuru (ilk) düzeyi, açıklayıcı olarak seçilen her etken için tek satırda yazılır (mq_duzey_notu, 131).
205.3 Örnek veri
vare.csv, vegan paketinin varespec ve varechem veri kümelerinin birleşimidir (Väre ve ark., 1995): Finlandiya'da ren geyiği otlatılan kuru çam ormanlarının 24 örnek alanında 44 yer örtüsü türünün örtü yüzdesi ve 14 toprak değişkeni. Eksik değer yoktur; her alanda en az bir tür vardır (tür örtüsü toplamı 64,11–125,61); tür matrisinin yüzde 41,9'u sıfırdır.
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
alan |
alan kimliği | metin | 24 benzersiz kimlik |
44 tür sütunu (Callvulg … Cladphyl) |
yanıt | sayısal | örtü yüzdesi; sıfır oranı 0,419 |
Al |
açıklayıcı | sayısal | ort. 142,48; sd 122,32; 12,1–435,1 |
P |
açıklayıcı | sayısal | ort. 45,08; sd 14,95; 22,7–73,5 |
K |
açıklayıcı | sayısal | ort. 162,93; sd 64,84; 43,6–313,8 |
Ca, Mg |
ikinci küme (örnekte) | sayısal | ort. 569,66 ve 87,46 |
pH |
koşul (örnekte) | sayısal | ort. 2,933; sd 0,214 |
N, S, Fe, Mn, Zn, Mo, Baresoil, Humdepth |
kullanılmayan | sayısal | — |
İkinci bir veri olarak dune.csv (Jongman ve ark., 1995; Hollanda kumul çayırları, 20 alan, 30 tür) kategorik açıklayıcı denemek için kullanılmıştır: Management etkeni ilk görülme sırasıyla SF, BF, HF, NM düzeylerine sahiptir (6, 3, 5, 6 alan); A1 toprak üst katman kalınlığıdır (ort. 4,85). Moisture ve Manure tam sayı kodlu olduğundan veri sekmesi bunları "sayısal" sayar; kategorik olarak ele almak için Veri sekmesinde türün değiştirilmesi gerekir (205.8).
Düzey sırası. R tarafında Veri sekmesinde "kategorik" olan etken, Veri sekmesinin düzey sırasıyla (bu verideki ilk görülme sırası) düzeylenir (Bölüm 1.3); şablon her açıklayıcı etken için düzey sırasını ve başvuru (ilk) düzeyi tek satırda yazar (131). vegan terim adlarını ilk düzeye göre farklarla yazar: ManagementBF, ManagementHF, ManagementNM (başvuru SF). Modelin uydurduğu değerler başvuru düzeyine bağlı değildir; yalnız biplot skorlarının satır adları ve işaretleri ona göre kurulur. Python ikizi aynı sırayı kullanır.
Bu bölümde kullanılan çalıştırmalar (ko_…; tohum 20261119; adı geçen dışında ayarlar örnek ayardır): ornek (vare CCA); ornek_s1, ornek_s2, ornek_s3 (tohum 1, 2, 3); kismi (kosul = [pH]); rda_hel (RDA, Hellinger, grup2 = [Ca, Mg]); cca_g2 (CCA, grup2); kismi_g2; terms_direct (terim_testi = terms, perm_model = direct, olcekleme = 1); dune_kat (dune, A1 + Management, 499 permütasyon); dune_rda_olcekli (RDA, olcekle); dune_moist_kat (Moisture kategorik); eksik, bos_cca, bos_rda, kosul_ayni (sınır durumları).
205.4 Yöntem: formüller ve hesap adımları
Hesap sırası: veri hazırlanır, eksik satırlar atılır, tür matrisi ve açıklayıcılar denetlenir (103–135); RDA'da dönüşüm uygulanır (136–143); formül kurulup cca ya da rda uydurulur (144–152); eylemsizlik ayrışımı, kanonik özdeğerler ve R^2 yazılır (154–178); permütasyon testleri yapılır (180–193); biplot skorları (195–196), varyans bölümleme (198–229) ve triplot (231–240) üretilir.
205.4.1 CCA: \chi^2 ağırlıklı kısıtlı ordinasyon
- y_{ij}: i. alandaki j. türün bolluğu; y_{++} genel toplam.
- r_i: alan ağırlığı (alanın toplam bolluğunun payı); c_j: tür ağırlığı.
- Q_{ij}: bağımsızlık altında beklenen r_ic_j'den standartlaştırılmış sapma.
Kısıtlı kısım, \mathbf Q'nun satırlar r_i ile ağırlıklı çevre değişkenlerine bağlanımıdır: \mathbf X^{*}=\mathrm{diag}(\sqrt{r})\,(\mathbf X-\mathbf 1\,\bar{\mathbf x}_r^{\top}) (\bar{\mathbf x}_r=\sum_i r_i\mathbf x_i ağırlıklı ortalama); uygun değerler \hat{\mathbf Q}=\mathbf X^{*}(\mathbf X^{*\top}\mathbf X^{*})^{-}\mathbf X^{*\top}\mathbf Q. Kısıtlı eylemsizlik \|\hat{\mathbf Q}\|^2, kısıtsız eylemsizlik \|\mathbf Q-\hat{\mathbf Q}\|^2'dir. Kanonik özdeğerler \hat{\mathbf Q}^{\top}\hat{\mathbf Q}'nun özdeğerleri; sayıları açıklayıcıların (etkenlerde düzey göstergelerinin) sırasına eşittir.
Neden \chi^2 uzaklığı ve alan ağırlıkları
CCA, türlerin gradyan boyunca çan biçimli (tek tepeli) yanıt verdiği ve türlerin ağırlıklı ortalamalarının kanonik eksen üzerinde sıralandığı modele dayanır (ter Braak, 1986). \chi^2 uzaklığı tür bolluğunun toplamından bağımsız oransal bileşimi karşılaştırır ve nadir türlere yüksek ağırlık verir; ağırlıklar r_i bolluğu yüksek alanların daha belirleyici olmasını sağlar. Bu nedenle CCA'da boş satır tanımsızdır: r_i=0 olur (127).
205.4.2 RDA: doğrusal yanıt
- \bar{\mathbf y}: tür başına ortalama; \hat{\mathbf Y}: merkezli \mathbf X üzerine bağlanımla uygun değerler.
olcekleaçıksa her tür sütunu örneklem standart sapmasına (n-1 paydalı) bölünür; toplam eylemsizlik tür sayısına eşit olur (dune örneğinde 30,0000; çalıştırmadune_rda_olcekli).
Dönüşümler (donusum, yalnız RDA; 116–120): hellinger \sqrt{y_{ij}/y_{i+}} (Legendre ve Gallagher, 2001; satır toplamı oranının karekökü, RDA'yı \chi^2 duyarlı çözüme yaklaştırır); sqrt karekök; wisconsin önce tür maksimumuna sonra alan toplamına bölme (çift standartlaştırma); log1p \ln(1+y).
Koddaki tercih
Şablon vegan::decostand(Y, "hellinger") ve vegan::wisconsin(Y) işlevlerini çağırır (137, 140); sqrt ve log1p R'nin temel işlevleridir. Boş satır olursa Hellinger ve Wisconsin dönüşümü 0/0 üretirdi; bu yüzden şablon dönüşümden önce açık bir ileti verip durur (128; ko_bos_rda: "Hellinger/Wisconsin dönüşümü için her örnek alanında en az bir tür bulunmalı (boş satır var)."). CCA seçiliyken donusum ≠ yok ise yalnız "Not: dönüşüm yalnız RDA'da uygulanır." yazılır (141).
205.4.3 Koşul değişkenleri (kısmi ordinasyon)
Koşul değişkenleri \mathbf Z verilirse önce \mathbf Q'nun \mathbf Z ile açıklanan kısmı çıkarılır (koşullu eylemsizlik), ardından açıklayıcılar kalan matrise ve \mathbf Z'den arındırılmış \mathbf X'e uygulanır:
- \mathbf H_Z: koşul değişkenlerinin (CCA'da ağırlıklı) izdüşüm matrisi; \mathbf H_{X|Z}: \mathbf Z'den arındırılmış \mathbf X'in izdüşümü.
- Toplam = koşullu + kısıtlı + kısıtsız. R^2 kısıtlı payı toplam eylemsizliğe böler (koşullu pay paydada kalır).
Koşul sütunu açıklayıcıyla ortak ise çalıştırma açık iletiyle durur (109–110; kosul_ayni): aksi hâlde model koşulsuz uydurulur ve kısmi ordinasyon yapılmış sanılırdı.
205.4.4 Permütasyon testleri
Genel model için pseudo-F:
- q: kısıtlı eksen sayısı (açıklayıcıların serbestlik derecesi); q_Z: koşulun derecesi; B: permütasyon sayısı (
perm). - F^{*}_b: b. permütasyonda aynı istatistik. En küçük olası p, 1/(1+B)'dir: B=499 için 0,002.
anova(ord, permutations = how(nperm = B)) genel testi (181), by = "margin" ya da "terms" terim testlerini (185), by = "axis" eksen testlerini (186) yapar. perm_model (182) hangi artıkların permüte edileceğini seçer: reduced (varsayılan) indirgenmiş modelin artıklarını, direct yanıtın kendisini, full tam modelin artıklarını. Terim testi margin her terimi öteki terimler modelde dururken sınar (sıradan bağımsız); terms terimleri girilme sırasıyla ardışık (I. tür) sınar. Eksen testleri ardışıktır: ilk eksenin testi, ikinci eksen testi birinci çıkarıldıktan sonra yapılır (Legendre ve ark., 2011).
Koddaki tercih
Üç test (g, tm, ax) aynı how(nperm = B) nesnesini ama ayrı çağrılarla kullanır; her çağrı rastgele sayı akışından ilerler, dolayısıyla aynı tohumda tablo satırları sırayla hesaplanır ve tohum değiştiğinde üç testin p değerleri birlikte değişir (205.7). Çoklu karşılaştırma düzeltmesi uygulanmaz (bulgular\kisitli_ordinasyon.md B7).
205.4.5 Düzeltilmiş R^2
- Ezekiel düzeltmesi RDA'da kapalı formüldür (
RsquareAdjRDA için bu tanımı kullanır); koşul değişkeni varsa R^2_{\text{düz}}=E(R^2+R^2_Z;\,q+q_Z)-E(R^2_Z;\,q_Z) (E: Ezekiel düzeltmesi, R^2_Z: koşulun payı). - CCA'da
r2_tanimiki tanım sunar.vegan(varsayılan):RsquareAdjkapalı formül yerine kısıtlı payın permütasyon altındaki ortalamasını çıkarır (veganRsquareAdj.cca, 1000 permütasyon); bu yüzden değer tohuma bağlıdır vepermalanından bağımsızdır. Çıktı satırı bunu yazar: "(CCA: 1000 permütasyonla kestirildi; sonuç tohuma bağlıdır, tohum: N; …)".ezekiel: aynı kapalı formül; tohumdan bağımsızdır (vare CCA'da 0,2056). - CCA'da koşul değişkeni varsa iki tanım da koşullu biçimde uygulanır (
kismi:vegan0,1579;ezekiel0,1578). Python ikizi (Bölüm 206) aynı iki tanımı aynı adlarla sunar ve varsayılanı aynıdır (vegan).
205.4.6 Varyans bölümleme
İkinci küme \mathbf X_2 verilirse düzeltilmiş R^2 RDA ile dört parçaya ayrılır (vegan::varpart; Borcard ve ark., 1992; Peres-Neto ve ark., 2006). Koşul değişkeni yoksa varpart çağrılır; koşul değişkeni varsa her kesir koşul çıkarıldıktan sonra kısmi RDA ile hesaplanır (aşağıda):
- R^2_{1}, R^2_{2}, R^2_{12}: küme 1, küme 2 ve ikisinin birlikte düzeltilmiş R^2'leri (Ezekiel). Küme 1
cevre, küme 2grup2'dir. - Yalnız küme 1 payı R^2_{12}-R^2_{2}, yalnız küme 2 payı R^2_{12}-R^2_{1}, ortak pay (kesişim) üçünden türer; R^2_d artıktır. Düzeltilmiş paylar negatif olabilir (sıfıra yakın, gerçek açıklama yok).
CCA seçiliyse bölümleme Hellinger dönüşümlü verinin RDA'sıyla yapılır (199) ve not düşer (227): CCA'nın \chi^2 ağırlıklı yapısı varpart'ta yoktur. Koşul değişkenleri varsa bölümleme onları çıkararak yapılır (200–226; kismi_g2): her kesir rda(Y ~ küme + Condition(koşul)) ile ve RsquareAdj'ın kısmi tanımıyla hesaplanır, tabloya koşulun payı [Z] = Condition satırı olarak eklenir ve bir not yazılır. Böylece [a]+[b]+[c]+[Z]+[d]=1 olur ve [a]+[c], yalnız küme 1 ile yapılan kısmi ordinasyonun düzeltilmiş R^2'sine eşittir (kismi_g2: 0,0750 + 0,1083 = 0,1833). Çıktı satır adları ve sırası vegan'ınkidir ve tablo başlığıyla örtüşür: [a] = X1|X2 (yalnız küme 1), [b] = X2|X1 (yalnız küme 2), [c] (ortak), [d] = Residuals; Python ikizi aynı adları aynı sırada yazar.
205.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 100–102 | İki dilli ileti işlevi .m; vegan yüklenir. |
Arayüz dili mq_dil ile gelir. |
| 103–127 | Veri, açıklayıcılar, koşul ve ikinci küme ayrıştırılır; kümeler arası ortak sütunlar atılır; eksik satırlar çıkarılır; tür matrisi denetlenir. | Atılan satırlar ve sıfır toplamlı türler not olarak yazılır; koşul ya da ikinci küme açıklayıcıyla ortaksa durur. CCA için boş satır yasaktır. |
| 129–135 | Metin ve mantıksal sütunlar factor'a çevrilir; sabit sütun hata verir. |
Veri sekmesinde "kategorik" olan sütun factor gelir; sayı kodlu etiket sayısal kalır (205.8). |
| 136–143 | RDA dönüşümü; ölçekleme için sıfır varyans denetimi. | CCA'da dönüşüm uygulanmaz. |
| 144–152 | Y ~ cevre + Condition(kosul) formülü, sütun adları ters tırnakla; cca ya da rda uydurulur; kısıtlı sıra 0 ise hata. |
Ters tırnak boşluklu adları korur. Hata iletisi paket iletisini olduğu gibi (İngilizce) taşır. |
| 154–178 | Eylemsizlik ayrışımı ve kanonik özdeğer tabloları; R^2 ve düzeltilmiş R^2 (RsquareAdj). |
r2_tanim ile CCA'da permütasyonla kestirim ya da Ezekiel formülü; hatada "—" yazılır (163–178). |
| 180–193 | Genel, terim ve eksen permütasyon testleri tek tabloda birleştirilir. | Test başarısızsa o satır sessizce boş kalır (tryCatch → NULL, 181, 185–186). |
| 195–196 | Açıklayıcıların biplot skorları (ilk iki eksen). | Etken değişken düzeylerine ayrı satır yazılır. |
| 198–229 | varpart (RDA) ve bölümleme tablosu. |
CCA'da Hellinger RDA; koşul varsa kesirler koşul çıkarılarak hesaplanır, [Z] satırı eklenir. |
| 231–240 | Kısıtlı eksen \ge 2 ise triplot: alanlar, türler, açıklayıcı okları; olcekleme 1, 2 ya da 3. |
Tek kısıtlı eksende grafik çizilmez. |
205.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bağımsız hesaplar dogrulama/kisitli_ordinasyon/elle_hesap.py (numpy/scipy; ağırlıklı en küçük kareler lstsq ile, özdeğerler Gram matrisinin özayrışımıyla; vegan ve şablon kodu çağrılmaz) ve r_dogrulama.R (yalnız temel R: qr, eigen; vegan yok) ile yapılmıştır.
Adım 1 — Toplam eylemsizlik. vare verisinde \mathbf P=\mathbf Y/y_{++}, r_i, c_j ve \mathbf Q kurulur; \sum Q_{ij}^2=2{,}08319829 (vegan vinyetindeki 2,0832 ile aynı). Üç hesap aynı değeri verir.
Adım 2 — Kısıtlı ve kısıtsız eylemsizlik. \mathbf X^{*}'e (Al, P, K) ağırlıklı bağlanım: kısıtlı 0{,}64413333, kısıtsız 1{,}43906496; toplamları 2{,}08319829'dur. Oran 0{,}644133/2{,}083198=0{,}3092. Kısıtsız eksen sayısı 24-1-3=20.
Adım 3 — Kanonik özdeğerler. \hat{\mathbf Q}^{\top}\hat{\mathbf Q}'nun özdeğerleri: 0{,}36155661; 0{,}16995998; 0{,}11261674 (toplamı kısıtlı eylemsizlik). Vinyetteki CCA1 =0{,}3616.
Adım 4 — Genel F. F=\dfrac{0{,}64413333/3}{1{,}43906496/20}=\dfrac{0{,}21471111}{0{,}07195325}=2{,}98403638. Permütasyon p için bağımsız Python hesabı 4999 permütasyonla p=0{,}0002 buldu (hiçbir permütasyon gözlenen F'yi aşmadı: 1/5000); şablonun 499 permütasyonlu sonucu 0{,}0020=1/500'dür; ikisi de aynı sonucu (en küçük olası p) verir.
Adım 5 — Kısmi ordinasyon ve RDA. Koşul pH: koşullu 0{,}14583161, kısıtlı 0{,}53568484, kısıtsız 1{,}40168184, genel F=2{,}42042849. Hellinger RDA: toplam 0{,}36467324, kısıtlı 0{,}13387078, F=3{,}86682151, Ezekiel düzeltilmiş R^2=0{,}27216260.
Adım 6 — Düzeltilmiş R^2'nin iki tanımı. CCA'da Ezekiel kapalı formülü 1-(1-0{,}309204)\cdot 23/20=0{,}205585 (r2_tanim = ezekiel: 0,2056); varsayılan vegan permütasyonlu tanımı tohuma göre 0{,}2049–0{,}2067 verir (tohum 20261119: 0{,}2051). Koşullu modelde (pH) bağımsız Ezekiel hesabı E(R^2+R^2_Z;\,4)-E(R^2_Z;\,1)=0{,}1578 verir; vegan'ın permütasyonlu değeri 0,1579'dur.
Adım 7 — Varyans bölümleme. Hellinger RDA ile R^2_{12}=0{,}23258032, R^2_1=0{,}27216260, R^2_2=0{,}03957434: yalnız küme 1 =0{,}19300598, ortak =0{,}07915661, yalnız küme 2 =-0{,}03958228, artık =0{,}76741968. Şablon tablosunda [a] 0{,}1930, [b] (yalnız küme 2) -0{,}0396, [c] (ortak) 0{,}0792, [d] 0{,}7674 (205.4.6). Koşul pH ile (kismi_g2) her kesir koşul çıkarılarak hesaplanır: [a] 0{,}0750, [b] -0{,}0365, [c] 0{,}1083, [Z] 0{,}0745, [d] 0{,}7787; toplam 1'dir ve [a]+[c]=0{,}1833 yalnız küme 1 ile yapılan kısmi ordinasyonun düzeltilmiş R^2'sine (0{,}1833) eşittir.
205.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| vare CCA: toplam eylemsizlik | 2,08319829 | 2,08319829 | 2,08319829 | 3,7e−13 | ✓ |
| vare CCA: kısıtlı eylemsizlik | 0,64413333 | 0,64413333 | 0,64413333 | 4,4e−13 | ✓ |
| vare CCA: kısıtsız eylemsizlik | 1,43906496 | 1,43906496 | 1,43906496 | 3,3e−12 | ✓ |
| vare CCA: kanonik özdeğer 1 | 0,36155661 | 0,36155661 | 0,36155661 | 2,4e−13 | ✓ |
| vare CCA: kanonik özdeğer 2 | 0,16995998 | 0,16995998 | 0,16995998 | 3,6e−13 | ✓ |
| vare CCA: kanonik özdeğer 3 | 0,11261674 | 0,11261674 | 0,11261674 | 1,6e−13 | ✓ |
| vare CCA: genel F | 2,98403638 | 2,98403638 | 2,98403638 | 1,3e−12 | ✓ |
| vare CCA: R² (4 hane) | 0,3092 | 0,30920404 | 0,30920404 | 4,0e−6 | ✓ |
| vare kısmi CCA (koşul pH): toplam eylemsizlik | 2,08319829 | 2,08319829 | 2,08319829 | 3,7e−13 | ✓ |
| vare kısmi CCA (koşul pH): kısıtlı eylemsizlik | 0,53568484 | 0,53568484 | 0,53568484 | 2,2e−13 | ✓ |
| vare kısmi CCA (koşul pH): kısıtsız eylemsizlik | 1,40168184 | 1,40168184 | 1,40168184 | 2,1e−12 | ✓ |
| vare kısmi CCA (koşul pH): koşullu eylemsizlik | 0,14583161 | 0,14583161 | 0,14583161 | 9,0e−15 | ✓ |
| vare kısmi CCA (koşul pH): kanonik özdeğer 1 | 0,27745552 | 0,27745552 | 0,27745552 | 4,8e−13 | ✓ |
| vare kısmi CCA (koşul pH): kanonik özdeğer 2 | 0,15071392 | 0,15071392 | 0,15071392 | 2,7e−14 | ✓ |
| vare kısmi CCA (koşul pH): kanonik özdeğer 3 | 0,1075154 | 0,1075154 | 0,1075154 | 2,3e−13 | ✓ |
| vare kısmi CCA (koşul pH): genel F | 2,42042849 | 2,42042849 | 2,42042849 | 9,6e−13 | ✓ |
| vare kısmi CCA (koşul pH): R² (4 hane) | 0,2571 | 0,25714539 | 0,25714539 | 4,5e−5 | ✓ |
| vare RDA Hellinger: toplam eylemsizlik | 0,36467324 | 0,36467324 | 0,36467324 | 2,2e−13 | ✓ |
| vare RDA Hellinger: kısıtlı eylemsizlik | 0,13387078 | 0,13387078 | 0,13387078 | 1,7e−13 | ✓ |
| vare RDA Hellinger: kısıtsız eylemsizlik | 0,23080245 | 0,23080245 | 0,23080245 | 3,9e−13 | ✓ |
| vare RDA Hellinger: kanonik özdeğer 1 | 0,09800703 | 0,09800703 | 0,09800703 | 1,4e−14 | ✓ |
| vare RDA Hellinger: kanonik özdeğer 2 | 0,02226884 | 0,02226884 | 0,02226884 | 1,8e−14 | ✓ |
| vare RDA Hellinger: kanonik özdeğer 3 | 0,01359492 | 0,01359492 | 0,01359492 | 4,1e−15 | ✓ |
| vare RDA Hellinger: genel F | 3,86682151 | 3,86682151 | 3,86682151 | 1,3e−12 | ✓ |
| vare RDA Hellinger: R² (4 hane) | 0,3671 | 0,36709791 | 0,36709791 | 2,1e−6 | ✓ |
| vare RDA Hellinger: düzeltilmiş R² (Ezekiel; 4 hane) | 0,2722 | 0,2721626 | 0,2721626 | 3,7e−5 | ✓ |
| dune CCA (A1 + Management): toplam eylemsizlik | 2,11526375 | 2,11526375 | 2,11526375 | 5,1e−13 | ✓ |
| dune CCA (A1 + Management): kısıtlı eylemsizlik | 0,77977785 | 0,77977785 | 0,77977785 | 1,6e−13 | ✓ |
| dune CCA (A1 + Management): kısıtsız eylemsizlik | 1,3354859 | 1,3354859 | 1,3354859 | 9,3e−13 | ✓ |
| dune CCA (A1 + Management): kanonik özdeğer 1 | 0,318749 | 0,318749 | 0,318749 | 2,8e−13 | ✓ |
| dune CCA (A1 + Management): kanonik özdeğer 2 | 0,23718475 | 0,23718475 | 0,23718475 | 1,3e−13 | ✓ |
| dune CCA (A1 + Management): kanonik özdeğer 3 | 0,13216523 | 0,13216523 | 0,13216523 | 2,7e−13 | ✓ |
| dune CCA (A1 + Management): kanonik özdeğer 4 | 0,09167888 | 0,09167888 | 0,09167888 | 1,7e−14 | ✓ |
| dune CCA (A1 + Management): genel F | 2,18959028 | 2,18959028 | 2,18959028 | 1,7e−12 | ✓ |
| dune CCA (A1 + Management): R² (4 hane) | 0,3686 | 0,36864332 | 0,36864332 | 4,3e−5 | ✓ |
| dune RDA ölçekli: toplam eylemsizlik | 30 | 30 | 30 | 0 | ✓ |
| dune RDA ölçekli: kısıtlı eylemsizlik | 10,71007369 | 10,71007369 | 10,71007369 | 2,2e−12 | ✓ |
| dune RDA ölçekli: kısıtsız eylemsizlik | 19,28992631 | 19,28992631 | 19,28992631 | 1,2e−12 | ✓ |
| dune RDA ölçekli: kanonik özdeğer 1 | 4,19274817 | 4,19274817 | 4,19274817 | 9,1e−13 | ✓ |
| dune RDA ölçekli: kanonik özdeğer 2 | 3,35695765 | 3,35695765 | 3,35695765 | 6,0e−13 | ✓ |
| dune RDA ölçekli: kanonik özdeğer 3 | 1,70091 | 1,70091 | 1,70091 | 2,5e−12 | ✓ |
| dune RDA ölçekli: kanonik özdeğer 4 | 1,45945787 | 1,45945787 | 1,45945787 | 2,5e−12 | ✓ |
| dune RDA ölçekli: genel F | 2,0820596 | 2,0820596 | 2,0820596 | 1,6e−12 | ✓ |
| dune RDA ölçekli: R² (4 hane) | 0,357 | 0,35700246 | 0,35700246 | 2,5e−6 | ✓ |
| dune RDA ölçekli: düzeltilmiş R² (Ezekiel; 4 hane) | 0,1855 | 0,18553644 | 0,18553644 | 3,6e−5 | ✓ |
| vare varyans bölümleme: yalnız küme 1 ([a]) | 0,19300598 | 0,19300598 | 0,19300598 | 8,8e−14 | ✓ |
| vare varyans bölümleme: yalnız küme 2 (şablon çıktısında 2. satır) | −0,03958228 | −0,03958228 | −0,03958228 | 7,7e−15 | ✓ |
| vare varyans bölümleme: ortak (şablon çıktısında 3. satır) | 0,07915661 | 0,07915661 | 0,07915661 | 2,2e−14 | ✓ |
| vare varyans bölümleme: artık | 0,76741968 | 0,76741968 | 0,76741968 | 3,4e−13 | ✓ |
| vare CCA + ikinci küme: bölümleme [a] (Hellinger RDA) | 0,19300598 | 0,19300598 | 0,19300598 | 8,8e−14 | ✓ |
Ölçütü karşılayan: 50/50. Düzeltilmiş R² yalnız RDA için karşılaştırıldı: CCA'da şablonun kullandığı vegan tanımı permütasyonla kestirilir ve tohuma bağlıdır (bölüm 205.7). Permütasyon p değerleri her programda ayrı rastgele sayı akışı kullandığından karşılaştırma dışıdır; bağımsız Python 4999 permütasyonla vare CCA genel testi için p = 0,0002 verdi (şablon, 499 permütasyon: 0,0020 = 1/500).
Ek denetimler: aynı veride CCA'nın düzeltilmiş R^2 (tohum 1, 2, 3, 20261119) 0{,}2049; 0{,}2067; 0{,}2054; 0{,}2051 (ornek_s1…s3, ornek). Kategorik açıklayıcıda (dune, A1 + Management) toplam, kısıtlı ve kısıtsız eylemsizlik ile genel F üç hesapta aynıdır; tasarım sütunları farklı kodlansa da (bağımsız Python: alfabetik başvuru) izdüşüm aynı olduğundan sonuç değişmez.
205.7 Çıktıyı okuma
vare verisi, örnek ayar, tohum 20261119 (ko_ornek); konsol:
Call: cca(formula = Y ~ Al + P + K, data = X)

              Inertia Proportion Rank
Total          2.0832     1.0000
Constrained    0.6441     0.3092    3
Unconstrained  1.4391     0.6908   20

Inertia is scaled Chi-square

Eigenvalues for constrained axes:
  CCA1   CCA2   CCA3
0.3616 0.1700 0.1126

Eigenvalues for unconstrained axes:
   CA1    CA2    CA3    CA4    CA5    CA6    CA7    CA8
0.3500 0.2201 0.1851 0.1551 0.1351 0.1003 0.0773 0.0537
(Showing 8 of 20 unconstrained eigenvalues)

R² = 0,3092; düzeltilmiş R² = 0,2051 (CCA: 1000 permütasyonla kestirildi; sonuç tohuma bağlıdır, tohum: 20261119; kapalı formül için 'CCA'da düzeltilmiş R² tanımı' alanını kullanın)
Tablolar (mq_tablo; kısaltılmış):
| Tablo | Öğe | Değer |
|---|---|---|
| Eylemsizlik ayrışımı (CCA) | toplam / kısıtlı / kısıtsız | 2,0832 / 0,6441 (oran 0,3092) / 1,4391 (0,6908) |
| Kanonik özdeğerler | CCA1, CCA2, CCA3 | 0,3616 (toplamın 0,1736'sı; kısıtlının 0,5613'ü), 0,1700 (0,0816; 0,2639), 0,1126 (0,0541; 0,1748) |
| Permütasyon testleri (499) | Genel: F (sd 3 ve 20) | 2,9840; p=0{,}002 |
| Terim (marjinal) Al / P / K | F=4{,}3340, p=0{,}002 / 2{,}3362, 0{,}022 / 2{,}1688, 0{,}022 | |
| Eksen CCA1 / CCA2 / CCA3 | F=5{,}0249, p=0{,}002 / 2{,}4761, 0{,}010 / 1{,}7130, 0{,}076 | |
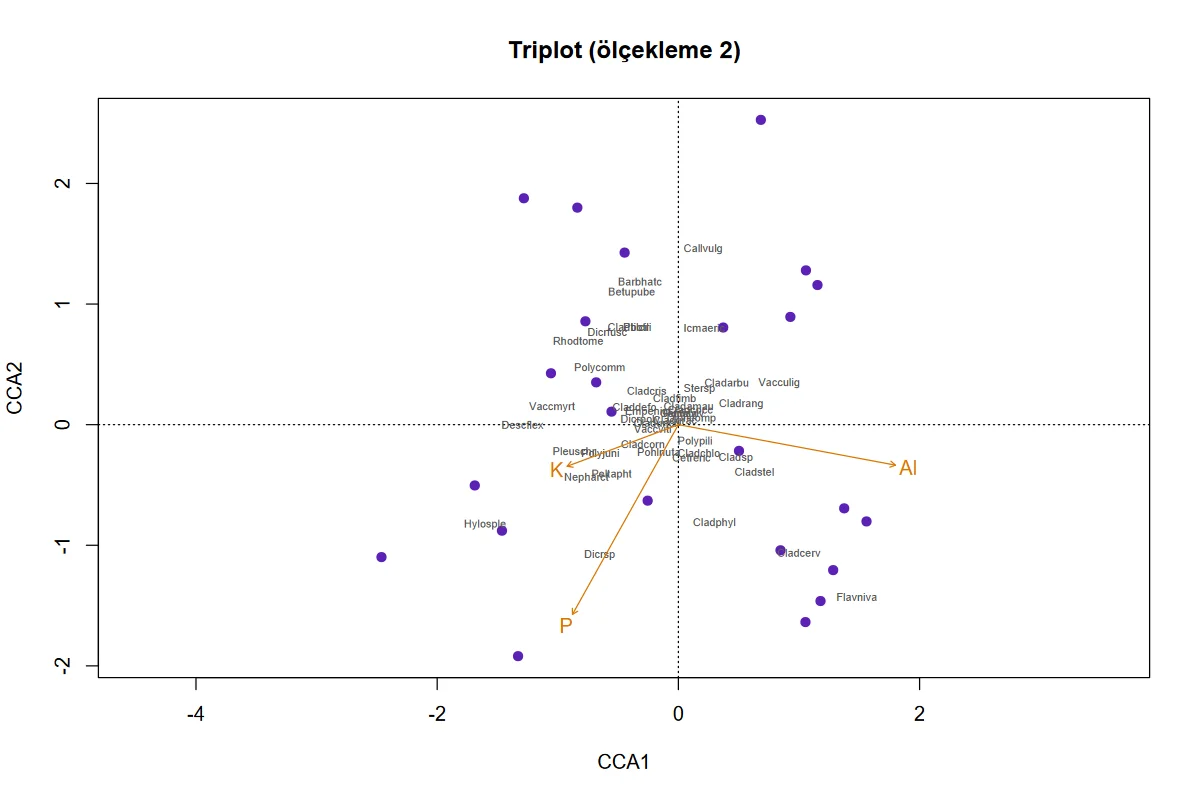
| Biplot skorları (CCA1, CCA2) | Al / P / K | 0,8599 ve −0,1604 / −0,4195 ve −0,7513 / −0,4404 ve −0,1647 |
Şekil 205.1. Şablonun triplotu (vare, ölçekleme 2): mor noktalar örnek alanlarını, gri adlar türleri, turuncu oklar Al, P ve K değişkenlerini gösterir.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Toplam, kısıtlı, kısıtsız eylemsizlik | Tür bileşimindeki toplam değişkenliğin kısıtlı (çevreyle açıklanan) ve artık payı. | Kısıtlı oran R^2'dir (0,3092): bileşim değişkenliğinin yüzde 30,9'u Al, P, K ile açıklanır. |
| Koşullu eylemsizlik | Yalnız koşul değişkeni verilirse; koşulun açıkladığı pay. | Kısmi ordinasyonda "çıkarılan" kısımdır. |
| Kanonik özdeğer | Her kısıtlı eksenin açıkladığı eylemsizlik. | CCA1 tek başına kısıtlı payın yüzde 56,1'ini taşır; eksen sayısı açıklayıcı sayısıyla sınırlıdır. |
| Düzeltilmiş R^2 | Açıklayıcı sayısına göre düzeltilmiş açıklanan oran. | 0,205: çok sayıda açıklayıcıyla şişen R^2'ye karşı daha dürüst ölçü. CCA'da varsayılan tanım tohuma göre dalgalanır (çıktı satırı bunu ve tohumu yazar); kapalı formül için r2_tanim = ezekiel. |
| Genel test | Modelin tümü için permütasyon F ve p. | p=0{,}002 en küçük olası değerdir (1/500); "permütasyon sayısı artırılırsa daha küçük olabilir". |
| Terim testi (marjinal) | Her değişkenin öteki ikisi modeldeyken katkısı. | Al en güçlü (F=4{,}33); P ve K ikisi de p=0{,}022. Birbirine bağlı değişkenlerde marjinal katkı küçülür. |
| Eksen testi | Ardışık: ilk eksen, sonra birinci çıkarılınca ikinci… | İlk iki eksen anlamlı, üçüncü değil (p=0{,}076; tohuma göre 0,076–0,104). |
| Biplot skorları | Değişkenlerin ilk iki eksenle ilişkisi (ok yönü ve uzunluğu). | Al CCA1'in pozitif ucunu, P ikinci eksenin negatif ucunu belirler. |
| Varyans bölümleme tablosu | [a] yalnız küme 1, [b] yalnız küme 2, [c] ortak ve [d] artık düzeltilmiş R^2 (rda_hel: 0,1930; −0,0396; 0,0792; 0,7674); koşul varsa [Z] satırı. |
Satır adları başlıkla örtüşür (205.4.6); negatif değer "açıklama yok" demektir. |
| Triplot | Alanlar (nokta), türler (ad), değişkenler (ok). | Ok yönünde yer alan alanlarda o değişken yüksektir; bir türün adı bir değişkenin okuna yakınsa tür o değişkenin yüksek olduğu alanlarda bolca bulunur. Ölçekleme 1'de alanlar arası, 2'de türler arası ilişki doğru okunur. |
Rapor cümlesi. Alüminyum, fosfor ve potasyum, 24 örnek alanındaki tür bileşimi değişkenliğinin (toplam eylemsizlik 2,0832, \chi^2 ölçeği) yüzde 30,9'unu açıkladı (CCA; düzeltilmiş R^2\approx0{,}21). Model permütasyon testiyle anlamlıydı (F_{3,\,20}=2{,}98; p=0{,}002; 499 permütasyon); terimler arasında alüminyum en güçlü açıklayıcıydı (F=4{,}33; p=0{,}002) ve ilk iki kanonik eksen anlamlıydı.
205.8 Sık hatalar ve tuzaklar
- CCA'da düzeltilmiş R^2 tohuma bağlıdır (varsayılan tanımda). Aynı veri ve ayarla 0{,}2049–0{,}2067 arasında değişir; ikinci ya da üçüncü ondalığı raporlamak anlamsızdır. Çıktı satırı bunu ve kullanılan tohumu yazar; tohumdan bağımsız değer için
r2_tanim = ezekielseçin. RDA'da kapalı formül kullanılır, sonuç yinelenir. - Permütasyon sayısı p'nin çözünürlüğüdür. B=499'da en küçük p=0{,}002; eksen testlerinde tohum değişince 0{,}002 ile 0{,}004 ya da 0{,}076 ile 0{,}104 arasında dalgalanma görülür. Kenar değerde (p\approx0{,}05) B'yi 9999'a çıkarın.
- Sayı kodlu kategorik değişken.
Moisture(1, 2, 4, 5) Veri sekmesinde "sayısal" sayıldığından bir doğrusal değişken olarak girer (1 sd; R^2=0{,}2530); türü "kategorik" yapılınca üç göstergeye açılır (3 sd; R^2=0{,}3516). Model ve anlamlılık değişir; hangisinin amaçlandığı Veri sekmesinde bilinçli seçilmelidir (dune_moist_kat). - Düzey sırası. Etken için Veri sekmesindeki ilk düzey başvuru olur (
SF); şablon sırayı çıktıya yazar, biplot satır adları ve işaretler buna göre kurulur (Bölüm 1.3). - Çok sayıda açıklayıcı. Açıklayıcı sayısı n-1'e yaklaşınca R^2 şişer ve kısıtsız serbestlik derecesi küçülür; düzeltilmiş R^2 ve eksen testlerine bakın.
- CCA ve nadir türler. \chi^2 ağırlığı nadir türlere büyük ağırlık verir; ordinasyon birkaç nadir tür tarafından yönlendirilebilir. Çok sıfırlı, kısa gradyanlı verilerde Hellinger dönüşümlü RDA tercih edilir.
- Boş satır. CCA ve Hellinger/Wisconsin dönüşümlü RDA açık iletiyle durur (205.4.2).
- Eleme bildirilir. Eksik değerli satırlar (
ko_eksik: 24 alandan 22'si kaldı; "Not: eksik değer nedeniyle 2 örnek alanı atıldı (satırlar: 6, 8).") ve sıfır toplamlı türler yazılır; açıklayıcıyla ortak koşul sütunu çalıştırmayı durdurur (ko_kosul_ayni). - Varyans bölümleme ve koşul.
grup2vekosulbirlikte seçilince bölümleme koşul çıkarılarak yapılır ([Z]satırı); CCA'da bölümleme Hellinger RDA'dır (205.4.6). - Terim ve eksen testleri düzeltilmez. Çok sayıda terim sınanıyorsa p değerleri çoklu karşılaştırma için düzeltilmemiştir.
205.9 Uzman soruları
S1. CCA ile RDA arasında hangisini seçmeliyim?
Gradyan uzunluğuna ve veri yapısına bağlıdır. Türler gradyan boyunca tek tepeli yanıt veriyorsa (uzun gradyan) CCA uygundur; kısa gradyanda doğrusal yanıt makuldür ve RDA tercih edilir. Şablon CCA'yı \chi^2 uzaklığıyla, RDA'yı Öklid uzaklığıyla kurar (149). Çok sıfırlı veride Öklid uzaklığı çift sıfırı benzerlik sayar; Hellinger dönüşümü (137) bu etkiyi azaltır (Legendre ve Gallagher, 2001).
S2. Marjinal ve ardışık terim testi hangi durumda ayrışır?
Açıklayıcılar birbiriyle ilişkiliyse. Ardışık testte ilk giren terim, öteki terimlerin açıkladığını da üstlenir; marjinal testte her terim yalnız kendine özgü katkısıyla sınanır. vare'de ardışık sıra Al, P, K iken Al'ın kareler toplamı 0{,}2982, marjinalde 0{,}3118; P için sırasıyla 0{,}1899 ve 0{,}1681 (terms_direct, ornek). Ardışık sonuçlar terim sırasına bağlıdır; şablon sırayı formdaki seçim sırasıyla alır.
S3. `perm_model` `reduced`, `direct` ve `full` ne zaman farklı sonuç verir?
reduced (varsayılan) ve full artıkları permüte eder; direct yanıtı. vare'de genel test reduced ve direct ile en küçük p=0{,}002 verir; fark eksen ve terim testlerinde görünür (CCA2 ekseni: 0,010 ve 0,032; ornek, terms_direct). Aynı çalıştırmada terim testi de değiştiği (ardışık) için tek başına perm_model etkisi bu iki çalıştırmadan ayrıştırılamaz; kenar değerde üç seçenek ayrı ayrı denenmelidir.
S4. Kısıtlı eksen sayısı neden açıklayıcı sayısına eşit?
Kısıtlı uzayın boyutu, açıklayıcıların izdüşüm matrisinin sırasıdır; Al, P, K için 3 (Rank sütunu). Etken değişken k düzeyde k-1 gösterge ekler (dune A1 + Management: 1 + 3 = 4 eksen). Eksen sayısı \min(q,\ \text{tür sayısı},\ n-1) ile sınırlıdır; hiç kısıtlı eksen çıkmazsa şablon 131. satırdaki denetimle durur.
S5. Düzeltilmiş R^2 neden negatif ya da çıktıdaki "—" olabilir?
Kapalı formül n-q-1\le0 olduğunda tanımsızdır; şablon RsquareAdj hata verir ya da sonuç boş dönerse "—" yazar (163–178). Negatif değer, açıklayıcıların rastlantıdan fazlasını açıklamadığını gösterir. Varyans bölümlemesinde küçük paylar bu yüzden negatif çıkabilir (-0{,}0396).
S6. Varyans bölümleme tablosunun satır adları neden `[a] = X1|X2` biçiminde?
Satır adları vegan::varpart'ın indfract çıktısından gelir ve tablo başlığıyla örtüşür: [a] = X1|X2 yalnız küme 1, [b] = X2|X1 yalnız küme 2, [c] ortak, [d] = Residuals artık (rda_hel: 0,1930; −0,0396; 0,0792; 0,7674; bağımsız hesap aynıdır). Koşul değişkeni varsa tabloya [Z] = Condition satırı eklenir (200–226). Python ikizi aynı adları ve sırayı yazar.
S7. CCA ile yapılan bölümleme neden RDA'dır?
varpart yalnız RDA tanımıyla çalışır; şablon CCA seçilince tür matrisini Hellinger ile dönüştürüp RDA'yı kullanır ve bunu bir notla bildirir (199, 227). Bu nedenle bölümlemenin R^2 değerleri CCA'nın R^2 değerleriyle karşılaştırılamaz.
S8. Aynı analiz başka bir tanımla ya da pakette farklı çıkar mı?
Eylemsizlik, özdeğer ve F üç ayrı hesapta aynıdır (205.6.1); fark yalnız tanımlı seçeneklerdedir: CCA düzeltilmiş R^2 (permütasyonlu ya da Ezekiel), triplot ölçeklemesi ve \chi^2 ağırlıkları. Ölçekleme 3 (simetrik) ve türlerin ağırlıklı ortalamalarına dayalı skorlama farklı yazılımlarda farklı ölçeklerle sunulur; ordinasyon eksenlerinin işareti keyfidir.
205.10 Kaynaklar
- Borcard, D., Legendre, P., & Drapeau, P. (1992). Partialling out the spatial component of ecological variation. Ecology, 73(3), 1045–1055. https://doi.org/10.2307/1940179
- Jongman, R. H. G., ter Braak, C. J. F., & van Tongeren, O. F. R. (Eds.). (1995). Data analysis in community and landscape ecology. Cambridge University Press. https://doi.org/10.1017/CBO9780511525575
- Legendre, P., & Gallagher, E. D. (2001). Ecologically meaningful transformations for ordination of species data. Oecologia, 129(2), 271–280. https://doi.org/10.1007/s004420100716
- Legendre, P., Oksanen, J., & ter Braak, C. J. F. (2011). Testing the significance of canonical axes in redundancy analysis. Methods in Ecology and Evolution, 2(3), 269–277. https://doi.org/10.1111/j.2041-210X.2010.00078.x
- Peres-Neto, P. R., Legendre, P., Dray, S., & Borcard, D. (2006). Variation partitioning of species data matrices: Estimation and comparison of fractions. Ecology, 87(10), 2614–2625. https://doi.org/10.1890/0012-9658(2006)87[2614:VPOSDM]2.0.CO;2
- ter Braak, C. J. F. (1986). Canonical correspondence analysis: A new eigenvector technique for multivariate direct gradient analysis. Ecology, 67(5), 1167–1179. https://doi.org/10.2307/1938672
- Väre, H., Ohtonen, R., & Oksanen, J. (1995). Effects of reindeer grazing on understorey vegetation in dry Pinus sylvestris forests. Journal of Vegetation Science, 6(4), 523–530. https://doi.org/10.2307/3236351
- Yazılım kaydı: vegan 2.7-6 (Oksanen ve ark., 2026; https://doi.org/10.32614/CRAN.package.vegan), R 4.5.3 (şablon çalıştırmasının yazılım kaydından).