26. Karma Modelde Özel Kontrastlar (lme4 + emmeans)
Şablon kimliği: r_emmeans_kontrast · Kategori: karma model · Dil: R · Dosya: pro/sablonlar/karma_model/r_emmeans_kontrast.R (satır 1–129; üstbilgi 1–68) · Örnek veri: _ornek/oats.csv · Paketler: lme4 2.0-6, emmeans 2.0.4 (Kenward-Roger için pbkrtest)
26.1 Ne işe yarar
Şablon, bir faktörün düzeylerini, gözlemleri gruplayan rastgele bir etkiyi (blok, denek, tarla, laboratuvar) hesaba katarak karşılaştırır. Cevapladığı soru şudur: "Blokların kendi düzey farkları ayıklandığında, faktör düzeylerinin ortalamaları arasında, benim seçtiğim karşılaştırmalarda fark var mı?"
- y_{ijk}: j. gruptaki (blok) i. faktör düzeyinin k. gözlemi; i=1,\dots,a, j=1,\dots,b.
- \mu+\alpha_i: i. düzeyin ortalaması (sabit etki). Kodlamada ilk düzey referanstır, \alpha_1=0.
- b_j: grubun rastgele kesişimi; grupların birbirinden bağımsız, ortalaması sıfır sapmaları. \sigma_b^2 gruplar arası varyanstır.
- \varepsilon_{ijk}: grup içi hata; b_j'den bağımsız.
Model kurulduktan sonra şablon üç şey verir: her düzeyin düzeltilmiş ortalaması (kestirilen marjinal ortalama, emmean), seçilen karşılaştırmalar (tüm ikililer, ilk düzeye karşı ya da kullanıcının katsayılarıyla tek bir kontrast) ve küçük örneklem için serbestlik derecesi (sd) düzeltmesi (Kenward-Roger, Satterthwaite ya da asimptotik z).
Ne zaman kullanılır? Tek bir sabit faktör ve tek bir gruplama değişkeni varsa; gözlemler grup içinde bağımlıysa (aynı bloktaki parseller, aynı hastanın ölçümleri); sorulan soru ikili farklardan daha özelse (ör. "kontrol, iki yeni işlemin ortalamasından farklı mı?"); karma modelde Kenward-Roger sd'si isteniyorsa.
Ne zaman kullanılmaz?
- İkinci bir faktör, ortak değişken, etkileşim ya da iç içe rastgele etki gerekiyorsa: şablonun formu bunları almaz. Temel programdaki Doğrusal Karma Model (LMM) ya da şablon kodu düzenlenerek kurulan model kullanılır (26.8).
- Yanıt ikili ya da sayımsa:
glmer_ileri(genelleştirilmiş karma model) ya dar_glmmtmb_nbşablonu. - Grup değişkeni yoksa (gözlemler bağımsız): temel programdaki Tek Yönlü ANOVA ve post-hoc testleri.
- Grup içi korelasyon yapısı (zamana bağlı, mekânsal) modellenecekse:
lme_varyans_yapilari,lme_uzamsal_korelasyon.
Temel programla ilişki. Temel programın Doğrusal Karma Model analizi aynı rastgele kesişimli modeli kurabilir. Bu şablon modeli lme4 ile kurar ve karşılaştırma katmanını emmeans'e bırakır: sd yöntemi, kontrole karşı aile, kullanıcı katsayılı kontrast ve düzeltmeler emmeans'in tanımlarıdır. Şablonun açıklaması da onu temel programın sonucunu bağımsız olarak denetleme aracı diye tanıtır (satır 7).
26.2 Şablonun girdileri
Form, üstbilgideki yedi [[param]] bloğundan kurulur (r_emmeans_kontrast.R:10–67).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Bağımlı değişken (satır 76–78). |
Faktör (sabit etki) · faktor |
kategorik sütun · Değişkenler | ilk uygun sütun | herhangi bir sütun | factor() ile sabit etki (79). |
Rastgele kesişim grubu · grup |
kategorik sütun · Değişkenler | ilk uygun sütun | herhangi bir sütun | (1 | grup) (80, 88). |
Kontrast türü · kontrast |
seçim · Model | pairwise |
pairwise, trt.vs.ctrl, ozel |
contrast(method = …) (99–112). |
Özel katsayılar · katsayilar |
metin · Model | boş | düzey sayısı kadar sayı, virgülle | Yalnız ozel seçiliyse (100–108). |
Çoklu karşılaştırma düzeltmesi · duzeltme |
seçim · Seçenekler | holm |
tukey, holm, bonferroni, dunnettx, none |
adjust = … (109, 111). |
Serbestlik derecesi yöntemi · sd_yontemi |
seçim · Model | kenward-roger |
kenward-roger, satterthwaite, asymptotic |
emm_options(lmer.df = …) (92). |
REML kestirimi (kapalıysa ML) · reml |
onay · Model | açık | açık / kapalı | lmer(REML = …) (88). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | Ortalama ve kontrast GA'ları (94, 113). |
Örnek ayar (ornek_param, satır 9): y = verim, faktor = cesit, grup = blok, kontrast = ozel, katsayilar = "1, -0.5, -0.5". Öteki alanlar varsayılandadır.
Şablonun kendi denetimleri. Biçimsel denetimden (Bölüm 1.2) sonra kod şunları durdurur:
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 74 |
| Yanıt, faktör ve grup aynı sütunlardan ikisini paylaşıyor | "farklı sütunlar olmalı" | 75 |
| Faktörde 2'den az düzey | "en az iki düzey gerekli" | 81 |
| Grupta 3'ten az düzey | "en az 3 düzey gerekli" | 82 |
| Grup sayısı ≥ tam gözlem sayısı | "her grupta birden çok gözlem" | 83–84 |
| Yanıt sayısal değil ya da sabit | "sayısal olmalı ve değişkenlik göstermeli" | 85–86 |
lmer hata verdi |
"Karma model kurulamadı: …" | 88–89 |
| Özel katsayı sayısı yanlış ya da sayı değil | "%d sayı girin (düzeyler: …)" | 101–103 |
| Özel katsayıların hepsi sıfır | "hepsi sıfır olamaz" | 104 |
Eksik değer: yanıt, faktör ya da grupta eksik olan satır liste bazında atılır (complete.cases, satır 77); n kalan satır sayısıdır ve son özet satırında yazılır (117–119). Uyarı (durdurmaz): tekil uyum (grup varyansı sıfır sınırında, satır 91) ve katsayı toplamı sıfır değilse "doğrusal birleşim" notu (105–106).
26.3 Örnek veri
Dosya: _ornek/oats.csv. Yates'in (1935) yulaf denemesi: 6 blokta 3 yulaf çeşidi ve 4 azot dozu; toplam 72 parsel verimi. Eksik değer yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
verim |
Yanıt | sayısal | Parsel verimi (1/4 libre birimi). Çeşit ortalamaları: Victory 97,625, Golden Rain 104,500, Marvellous 109,792. |
cesit |
Faktör | kategorik (3 düzey) | Victory, Golden Rain, Marvellous; her çeşitte 24 parsel. |
blok |
Grup | kategorik (6 düzey) | I–VI; her blokta 12 parsel (her çeşitten 4). |
azot |
kullanılmaz | sayısal | 0; 0,2; 0,4; 0,6 (cwt/akre). |
Tasarım dengelidir: her blokta her çeşitten aynı sayıda (4) parsel vardır. Bu, aşağıdaki kestirimlerin kapalı formüllerle de yazılabilmesini sağlar (26.6).
Düzey sırası: Victory, Golden Rain, Marvellous
Veri sekmesi cesit'i kategorik algılar (3 düzey / 72 satır) ve düzeyleri verideki ilk görülme sırasıyla R'ye aktarır (Bölüm 1.3): dosyanın ilk satırı Victory olduğundan sıra Victory, Golden Rain, Marvellous'tur. Bu sıra üç şeyi belirler: modelin referans düzeyi (sabit etki tablosundaki kesişim Victory'dir), "Kontrole karşı (ilk düzey)" seçeneğindeki kontrol (Victory) ve özel katsayıların hangi düzeye uygulandığı. Örnek ayardaki 1, -0.5, -0.5 bu yüzden Victory'yi öteki iki çeşidin ortalamasıyla karşılaştırır. Sütun "metin" türüne çevrilirse R düzeyleri alfabetik sıralar (Golden Rain, Marvellous, Victory) ve aynı katsayılar başka bir soruyu sorar.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar (özel kontrast); (2) ikili karşılaştırmalar, Holm; (3) ikili, Tukey; (4) kontrole karşı, Dunnett (yaklaşık), asimptotik; (5) ML kestirimi, Satterthwaite, düzeltmesiz. Hepsinde öteki ayarlar varsayılandadır.
26.4 Yöntem: formüller ve hesap adımları
Şablonun hesap sırası: (1) eksik satırları at, faktör ve grubu factor yap; (2) lmer ile modeli REML (ya da ML) ile kestir; (3) emmeans ile her düzeyin düzeltilmiş ortalamasını, SH'sini ve seçilen yöntemle sd'sini hesapla; (4) contrast ile karşılaştırmaları kur ve düzelt; (5) tabloları, özeti ve şekli yaz.
26.4.1 REML kestirimi
Matris gösterimiyle \mathbf y=\mathbf X\boldsymbol\beta+\mathbf Z\mathbf b+\boldsymbol\varepsilon, \operatorname{Var}(\mathbf y)=\mathbf V=\sigma_b^2\mathbf Z\mathbf Z^{\top}+\sigma^2\mathbf I. lme4, varyans parametreleri \boldsymbol\theta=(\sigma_b^2,\sigma^2) için kısıtlanmış log-olabilirliği en büyükler:
- \mathbf X: sabit etki tasarım matrisi (N\times a; kesişim + a-1 gösterge sütunu). \mathbf Z: grup gösterge matrisi (N\times b).
- \hat{\boldsymbol\beta}=(\mathbf X^{\top}\mathbf V^{-1}\mathbf X)^{-1}\mathbf X^{\top}\mathbf V^{-1}\mathbf y: genelleştirilmiş en küçük kareler kestirimi.
- Çıktıdaki "REML criterion" -2\ell_R'dir (sabit dahil).
Neden REML, neden ML değil?
ML, varyansları kestirirken \boldsymbol\beta'yı biliniyormuş gibi kullanır ve sabit etkilerin harcadığı a serbestlik derecesini hesaba katmaz; varyanslar aşağı yanlı çıkar. REML, olabilirliği \boldsymbol\beta'dan bağımsız doğrusal birleşimler (hata kontrastları) üzerinden kurar; dengeli tasarımda kestirimler ANOVA kareler ortalamalarından elde edilen yansız kestiricilere eşittir. Örnek veride ML artık varyansı \mathrm{KT}_e/66=520{,}07, REML ise \mathrm{KT}_e/64=536{,}32'dir (26.9 S3).
Dengeli tasarımda kapalı biçim. Varyans bileşenleri pozitif kaldıkça REML kestirimleri, y\sim\text{faktör}+\text{grup} sabit etkili iki yönlü ANOVA'nın kareler ortalamalarından elde edilir:
- \mathrm{KT}_e, \mathrm{KO}_e: iki yönlü ANOVA'nın hata kareler toplamı ve ortalaması; sd =N-a-b+1=72-3-6+1=64.
- \mathrm{KO}_b: grup (blok) kareler ortalaması, sd =b-1=5. E(\mathrm{KO}_b)=\sigma^2+(N/b)\,\sigma_b^2 olduğundan \sigma_b^2 kestiricisi bu eşitliğin çözümüdür; N/b=12 bir bloktaki gözlem sayısıdır.
- \mathrm{KO}_b<\mathrm{KO}_e ise \hat\sigma_b^2 sınırda sıfır olur (tekil uyum, satır 91).
26.4.2 Düzeltilmiş ortalamalar
emmeans, her düzey için bir satır vektörü \mathbf L_i kurar (referans ızgarası) ve
- \mathbf L_1=(1{,}0{,}0), \mathbf L_2=(1{,}1{,}0), \mathbf L_3=(1{,}0{,}1): kesişim + ilgili gösterge. Tek faktörlü modelde düzeltilmiş ortalama düzeyin kestirilen ortalamasıdır; dengeli veride ham ortalamaya eşittir.
- \hat{\mathbf V}_{\beta}=(\mathbf X^{\top}\hat{\mathbf V}^{-1}\mathbf X)^{-1}: sabit etkilerin kestirilen kovaryansı. Kenward-Roger seçiliyse emmeans bunun yerine pbkrtest'in küçük örneklem düzeltmeli kovaryansını kullanır.
Dengeli tasarımda varyans iki kareler ortalamasının doğrusal birleşimidir:
Neden blok varyansı ortalamanın varyansına girer?
Bir düzeyin ortalaması 6 bloğun ortalamasıdır; başka bir bloklar kümesinde deneme yinelense blok etkileri de değişirdi. Düzey ortalaması bu yüzden b bağımsız blok sapmasının ortalamasını taşır (\sigma_b^2/b). İki düzeyin farkında ise aynı bloklar her iki ortalamada aynı katsayıyla yer alır ve birbirini götürür; fark yalnız \sigma^2'ye bağlıdır (26.4.4).
26.4.3 Serbestlik derecesi: Kenward-Roger, Satterthwaite, asimptotik
t=\hat\psi/\operatorname{SH}(\hat\psi) istatistiğinin dağılımı karma modelde tam olarak t değildir; SH kestirilmiş varyans bileşenlerine dayanır. Satterthwaite (1946) yaklaşımı varyansı, ölçeklenmiş bir ki-kare değişkenine eşleyerek sd'yi kestirir. Varyans kareler ortalamalarının doğrusal birleşimi \sum_r k_r\mathrm{KO}_r olduğunda:
- k_r: r. kareler ortalamasının katsayısı; düzeltilmiş ortalama için k_b=1/N, k_e=(a-1)/N.
- \nu_r: o kareler ortalamasının sd'si (blok 5, hata 64).
- Genel karma modelde aynı fikir, \operatorname{Var}(\hat\psi)'nin varyans parametrelerine göre türevleri ve bu parametrelerin asimptotik kovaryansıyla uygulanır (emmeans bunu lmerTest ile hesaplar).
Kenward-Roger (1997), (i) \hat{\mathbf V}_\beta'nın varyans parametrelerinin belirsizliğinden gelen küçük örneklem yanlılığını düzeltir, (ii) sd'yi düzeltilmiş istatistiğin ilk iki momentini F dağılımına eşleyerek kestirir. Bu dengeli tasarımda düzeltme SH'yi değiştirmez ve sd Satterthwaite değerine eşittir (26.6.1 tablosunda KR değerleri kapalı formülle aynıdır). Asimptotik seçenekte sd sonsuz alınır, test z testidir; tablodaki GA sütunları asymp.LCL, asymp.UCL adını alır.
Koddaki tercih
sd yöntemi tek satırla, oturum seçeneği olarak verilir: emm_options(lmer.df = P$sd_yontemi) (satır 92). Varsayılan Kenward-Roger'dır (satır 48) ve REML ile birlikte kullanılmak üzere tanımlıdır. emmeans seçimi koşullu uygular (emmeans:::emm_basis.merMod): pbkrtest yüklenemezse ya da gözlem sayısı pbkrtest.limit değerini (3000) aşarsa Kenward-Roger yerine Satterthwaite'e geçer; lmerTest yoksa ya da gözlem sayısı lmerTest.limit değerini (3000) aşarsa asimptotiğe iner ve "D.f. calculations have been disabled" notunu yazar. Şablon bu sınırları değiştirmez; 3000'den çok gözlemde formdaki seçim ne olursa olsun test z testidir.
26.4.4 Kontrastlar
Bir kontrast \psi=\sum_i c_i\mu_i'dir. Kestirimi, SH'si ve testi:
- \mathbf c: katsayı vektörü (düzey sırasıyla). \hat{\mathbf V}_\mu: düzeltilmiş ortalamaların kovaryansı.
- \sum_i c_i=0 ise kontrasttır: dengeli tasarımda blok bileşeni düşer ve \operatorname{Var}(\hat\psi)=\sigma^2\sum_i c_i^2/(N/a), \nu=N-a-b+1.
- \sum_i c_i\neq0 ise doğrusal birleşimdir; blok varyansı geri girer ve \nu küçülür. Örneğin (1{,}1{,}1) için \operatorname{Var}=\mathrm{KO}_b/8 ve \nu=5; şablon bu durumda not yazar (satır 105–106).
Kontrast türleri emmeans'in yerleşik aileleridir: pairwise tüm a(a-1)/2 farkı \mu_i-\mu_j (i<j, düzey sırasıyla) verir; trt.vs.ctrl her düzeyi ilk düzeyle karşılaştırır (\mu_i-\mu_1); ozel, metin alanındaki sayıları tek bir vektör olarak contrast(em, method = list(...)) çağrısına verir. Özel kontrastın satır adı katsayıları ve düzey adlarını birlikte yazar (satır 108).
26.4.5 Çoklu karşılaştırma düzeltmeleri
m karşılaştırmanın ham p değerleri p_1,\dots,p_m olsun.
- p_{(j)}: küçükten büyüğe sıralanmış j. ham p. Q_{a,\nu}: a ortalamalı, \nu sd'li çalışmalı aralık (studentized range) dağılımı.
- Holm için eşzamanlı GA tanımlı değildir; emmeans GA'ları Bonferroni çarpanıyla (t_{1-\alpha/(2m),\,\nu}) kurar. Örnek veride çarpan 2{,}4585'tir.
dunnettx, kontrole karşı ailede Dunnett (1955) yönteminin emmeans'teki hızlı yaklaşığıdır.
Koddaki tercih
Özel kontrast tek bir karşılaştırmadır: şablon Tukey ve Dunnett seçildiğinde düzeltmeyi "none" yapar (satır 109); Holm ve Bonferroni tek testte p'yi zaten değiştirmez. emmeans'in kendi kuralı da işe karışır: Tukey yöntemi ikili karşılaştırma dışındaki bir aileye (kontrole karşı) uygulanırsa emmeans onu Šidák'a çevirir ve çıktıya "sidak method for 2 tests" yazar. Bu durumda şablonun özet satırı yine "düzeltme: tukey" der (satır 117–119); geçerli olan emmeans çıktısındaki satırdır.
26.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–68 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, yedi parametre. | Form ve varsayılanlar buradan kurulur (Bölüm 1.2). |
| 69–72 | lme4 ve emmeans yüklenir; .m() iletileri arayüz diline göre seçer. |
Paketler yazılım kaydına girer. |
| 74–86 | Girdi denetimleri; d veri çerçevesi y, faktor, grup adlarıyla kurulur. |
complete.cases liste bazında silme yapar (77). factor() var olan düzey sırasını korur (79–80). |
| 88–91 | lmer(y ~ faktor + (1 | grup), REML = …); summary(m) konsola yazılır; tekil uyum uyarısı. |
Hata tryCatch ile çevrilmiş iletiye dönüşür (89). |
| 92–96 | sd yöntemi ayarlanır; emmeans(m, ~ faktor); ilk tablo "Düzeltilmiş ortalamalar". |
level = P$guven GA düzeyini belirler (94). |
| 98–112 | Kontrast: ozel ise katsayılar ayrıştırılır, denetlenir, adlandırılır; değilse yerleşik aile. |
Tukey/Dunnett özel kontrastta none olur (109). |
| 113–119 | İkinci tablo "Kontrastlar" (infer = c(TRUE, TRUE): GA ve test birlikte); emmeans çıktısı ve tek satırlık özet. |
Özet satırı sd yöntemini ve seçilen düzeltmeyi yazar. |
| 121–128 | Düzeltilmiş ortalamalar ve GA çubukları; mq_sekil. |
Asimptotikte sütun adları asymp.* olduğundan iki yol denetlenir (121). |
Katsayı ayrıştırması (satır 100) virgülle böler ve boşlukları kırpar; ondalık ayırıcı nokta olmalıdır (-0.5). Türkçe ondalık virgülle yazılan -0,5 bölünmede iki ayrı sayı olur ve sayı adedi denetimine takılır (101–103).
26.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/r_emmeans_kontrast/elle_hesap.py ile, lme4 ve emmeans kullanılmadan, dengeli tasarımın kapalı formülleriyle hesaplanmıştır. R tarafında aynı büyüklükler nlme paketinin lme fonksiyonu ve açık formüllerle (r_dogrulama.R) yeniden kurulmuştur.
Adım 1 — İki yönlü ANOVA kareler ortalamaları. N=72, a=3, b=6:
| Kaynak | KT | sd | KO |
|---|---|---|---|
| Çeşit | 1786,361 | 2 | |
| Blok | 15875,278 | 5 | 3175,056 |
| Hata | 34324,306 | 64 | 536,317 |
Adım 2 — Varyans bileşenleri.
Standart sapmalar 23,159 ve 14,829; lme4 çıktısındaki "Residual 536.3 / 23.16" ve "grup 219.9 / 14.83" ile aynıdır.
Adım 3 — Düzeltilmiş ortalamanın SH'si ve sd'si.
t_{0{,}975;\,8{,}8699}=2{,}267226; Victory için %95 GA 97{,}625\pm2{,}267226\cdot7{,}680866=[80{,}2107;\ 115{,}0393].
Adım 4 — İkili farklar. \operatorname{SH}=\sqrt{2\cdot536{,}317/24}=6{,}685290, sd =64, t_{0{,}975;\,64}=1{,}997730.
| Fark | Kestirim | t | ham p | Holm | Tukey |
|---|---|---|---|---|---|
| Victory − Golden Rain | −6,875 | −1,0284 | 0,30764 | 0,61529 | 0,56184 |
| Victory − Marvellous | −12,167 | −1,8199 | 0,07345 | 0,22035 | 0,17126 |
| Golden Rain − Marvellous | −5,292 | −0,7915 | 0,43155 | 0,61529 | 0,70956 |
Holm adımları: en küçük p 0{,}07345\times3=0{,}22035; ikincisi 0{,}30764\times2=0{,}61529; üçüncüsü 0{,}43155\times1=0{,}43155, ama sıralamayı korumak için öncekinin en büyüğü alınır: 0{,}61529. Tukey GA çarpanı q_{0{,}95;\,3{,}64}/\sqrt2=2{,}399423; Holm GA'sının Bonferroni çarpanı t_{1-0{,}05/6;\,64}=2{,}458533.
Adım 5 — Örnek ayardaki özel kontrast \mathbf c=(1;\ -0{,}5;\ -0{,}5) (Victory − öteki ikisinin ortalaması):
%95 GA [-21{,}0870;\ 2{,}0453] (sd 64).
Adım 6 — ML ile karşılaştırma. ML artık varyansı \mathrm{KT}_e/66=520{,}065, blok varyansı 177,151'dir; fark SH'si \sqrt{2\cdot520{,}065/24}=6{,}583219 ve Satterthwaite sd'si 66 olur.
26.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun "Düzeltilmiş ortalamalar" ve "Kontrastlar" tablolarından, tam hassasiyetle alınmıştır (çalıştırmalar 1–3 ve 5). R sütunu lme4 ve emmeans kullanmaz: varyans bileşenleri ve sabit etki kovaryansı nlme::lme'den, sd'ler Satterthwaite formülünden, düzeltmeler ptukey ve p.adjust'tan gelir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Düzeltilmiş ortalama: Victory | 97,625 | 97,625 | 97,625 | 2,0e−15 | ✓ |
| Düzeltilmiş ortalama: Golden Rain | 104,5 | 104,5 | 104,5 | 0 | ✓ |
| Düzeltilmiş ortalama: Marvellous | 109,79166667 | 109,79166667 | 109,79166667 | 3,0e−15 | ✓ |
| Düzeltilmiş ortalama SH | 7,68086578 | 7,68086557 | 7,68086557 | 2,7e−8 | ✓ |
| Düzeltilmiş ortalama sd (Kenward-Roger) | 8,86988084 | 8,86988118 | 8,86988118 | 3,9e−8 | ✓ |
| GA alt: Victory | 80,21074212 | 80,2107427 | 80,21074269 | 7,2e−9 | ✓ |
| GA üst: Victory | 115,03925788 | 115,0392573 | 115,03925731 | 5,0e−9 | ✓ |
| Victory - Golden Rain: fark | −6,875 | −6,875 | −6,875 | 1,0e−14 | ✓ |
| Victory - Golden Rain: t | −1,02837719 | −1,02837718 | −1,02837718 | 2,9e−9 | ✓ |
| Victory - Golden Rain: p (Holm) | 0,61528689 | 0,61528689 | 0,61528689 | 2,8e−9 | ✓ |
| Victory - Golden Rain: p (Tukey) | 0,56184094 | 0,56184094 | 0,56184094 | 1,9e−9 | ✓ |
| Victory - Golden Rain: Tukey GA alt | −22,91584237 | −22,91584241 | — | 1,9e−9 | ✓ |
| Victory - Golden Rain: Holm GA alt (Bonferroni) | −23,31100671 | −23,31100676 | — | 2,0e−9 | ✓ |
| Victory - Marvellous: fark | −12,16666667 | −12,16666667 | −12,16666667 | 8,2e−15 | ✓ |
| Victory - Marvellous: t | −1,81991599 | −1,81991599 | −1,81991599 | 2,9e−9 | ✓ |
| Victory - Marvellous: p (Holm) | 0,22034625 | 0,22034626 | 0,22034626 | 2,4e−9 | ✓ |
| Victory - Marvellous: p (Tukey) | 0,17126427 | 0,17126428 | 0,17126428 | 1,7e−9 | ✓ |
| Victory - Marvellous: Tukey GA alt | −28,20750903 | −28,20750908 | — | 1,6e−9 | ✓ |
| Victory - Marvellous: Holm GA alt (Bonferroni) | −28,60267338 | −28,60267343 | — | 1,7e−9 | ✓ |
| Golden Rain - Marvellous: fark | −5,29166667 | −5,29166667 | −5,29166667 | 1,8e−15 | ✓ |
| Golden Rain - Marvellous: t | −0,7915388 | −0,7915388 | −0,7915388 | 2,3e−9 | ✓ |
| Golden Rain - Marvellous: p (Holm) | 0,61528689 | 0,61528689 | 0,61528689 | 2,8e−9 | ✓ |
| Golden Rain - Marvellous: p (Tukey) | 0,70955505 | 0,70955505 | 0,70955505 | 1,4e−9 | ✓ |
| Golden Rain - Marvellous: Tukey GA alt | −21,33250903 | −21,33250908 | — | 2,1e−9 | ✓ |
| Golden Rain - Marvellous: Holm GA alt (Bonferroni) | −21,72767338 | −21,72767343 | — | 2,2e−9 | ✓ |
| Fark SH | 6,68529027 | 6,68529028 | 6,68529028 | 2,9e−9 | ✓ |
| Fark sd | 64 | 64 | 64 | 0 | ✓ |
| Özel kontrast \hat\psi | −9,52083333 | −9,52083333 | −9,52083333 | 6,2e−15 | ✓ |
| Özel kontrast SH | 5,7896312 | 5,78963122 | 5,78963122 | 2,9e−9 | ✓ |
| Özel kontrast t | −1,64446283 | −1,64446283 | −1,64446283 | 2,9e−9 | ✓ |
| Özel kontrast p | 0,1049843 | 0,1049843 | 0,1049843 | 9,9e−10 | ✓ |
| Özel kontrast GA alt | −21,08695127 | −21,08695131 | — | 1,6e−9 | ✓ |
| ML: fark SH | 6,58321879 | 6,58321879 | 6,58321879 | 2,1e−10 | ✓ |
Ölçütü karşılayan: 33/33. Python: dengeli tasarımda ANOVA kareler ortalamalarından kapalı REML ve Satterthwaite formülleri. R: nlme::lme (lme4 ve emmeans kullanılmadan) ve açık formüller (ptukey, p.adjust). ML satırında Python sütunu \mathrm{KT}_e/66'dan hesaplanmıştır.
Farkların büyüklüğü (\le4\times10^{-8}) lme4'ün varyans parametrelerini sayısal eniyilemeyle bulmasından gelir; kapalı formül ve nlme birbirine 10^{-9} düzeyinde yakındır.
26.7 Çıktıyı okuma
İkili karşılaştırma (Holm) çalıştırmasının konsol metni:
Linear mixed model fit by REML ['lmerMod']
Formula: y ~ faktor + (1 | grup)
REML criterion at convergence: 647.9
Random effects:
 Groups   Name        Variance Std.Dev.
 grup     (Intercept) 219.9    14.83
 Residual             536.3    23.16
Number of obs: 72, groups:  grup, 6
Fixed effects:
                  Estimate Std. Error t value
(Intercept)         97.625      7.681  12.710
faktorGolden Rain    6.875      6.685   1.028
faktorMarvellous    12.167      6.685   1.820
 contrast                 estimate   SE df t.ratio p.value
 Victory - Golden Rain       -6.88 6.69 64  -1.028  0.6153
 Victory - Marvellous       -12.17 6.69 64  -1.820  0.2203
 Golden Rain - Marvellous    -5.29 6.69 64  -0.792  0.6153
Degrees-of-freedom method: kenward-roger
P value adjustment: holm method for 3 tests
Model: verim ~ cesit + (1 | blok); n = 72; serbestlik derecesi: Kenward-Roger; düzeltme: holm
Tablolar (tam hassasiyetli değerler, ilk dört ondalık):
| Tablo | Satır | Değerler |
|---|---|---|
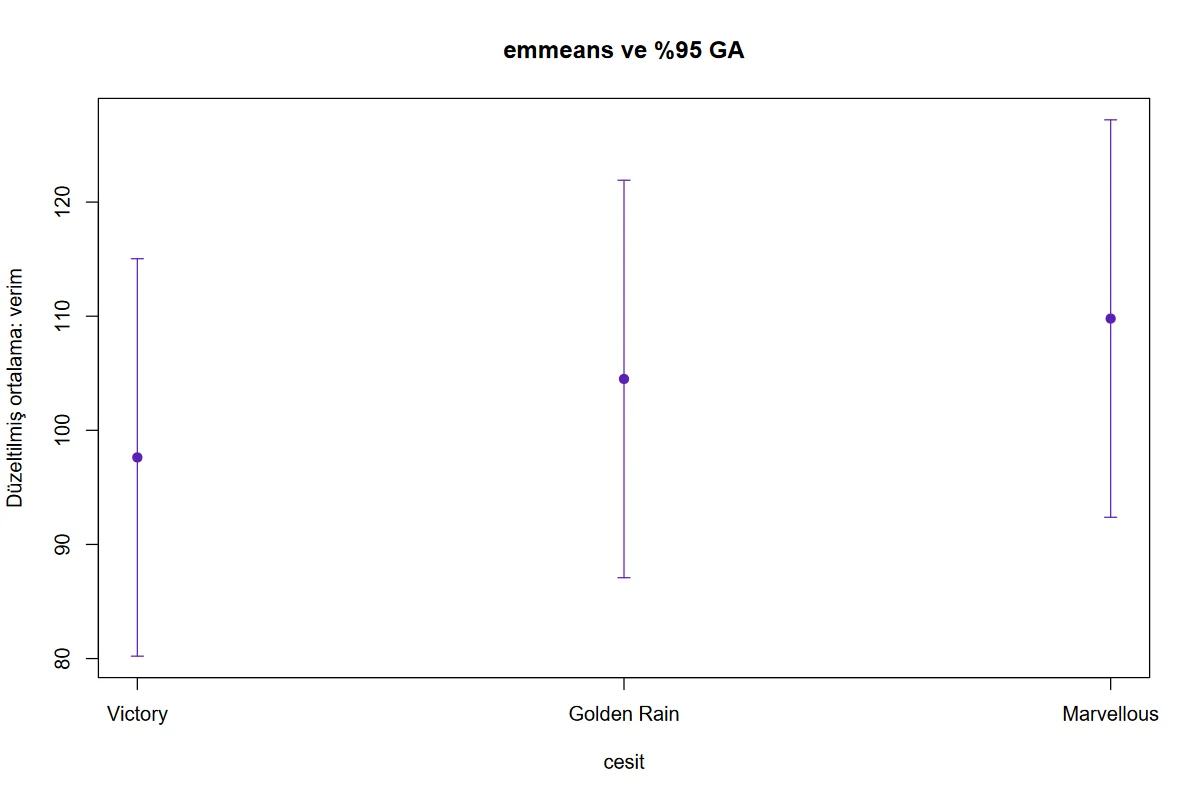
| Düzeltilmiş ortalamalar | Victory | emmean 97,6250; SE 7,6809; df 8,8699; GA [80,2107; 115,0393] |
| Golden Rain | 104,5000; 7,6809; 8,8699; [87,0857; 121,9143] | |
| Marvellous | 109,7917; 7,6809; 8,8699; [92,3774; 127,2059] | |
| Kontrastlar (örnek ayar) | +1·Victory −0,5·Golden Rain −0,5·Marvellous | estimate −9,5208; SE 5,7896; df 64; GA [−21,0870; 2,0453]; t −1,6445; p 0,1050 |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Random effects | \hat\sigma_b^2, \hat\sigma^2 ve karekökleri | Grup içi korelasyon \hat\sigma_b^2/(\hat\sigma_b^2+\hat\sigma^2)=0{,}29. |
| Fixed effects | Kesişim (ilk düzeyin ortalaması) ve ilk düzeye göre farklar | SH'ler lme4'ündür; sd ve p içermez. Test için kontrast tablosu kullanılır. |
| Düzeltilmiş ortalamalar | emmean, SE, df, GA | df ortalamanın sd'sidir (blok varyansını taşır; burada 8,87). |
| Kontrastlar | estimate, SE, df, GA, t.ratio, p.value | p seçilen düzeltmeyle; Holm'da GA Bonferroni çarpanıyla. |
| "Degrees-of-freedom method", "P value adjustment" | emmeans'in gerçekte uyguladığı yöntem | Özet satırındaki düzeltme seçimden gelir; emmeans Tukey'i Šidák'a çevirdiyse geçerli olan bu satırdır. |
| Tekil uyum uyarısı | \hat\sigma_b^2=0 | Model sıradan tek yönlü ANOVA'ya iner. |
Şekil 26.1. Şablonun çizdiği düzeltilmiş ortalamalar ve %95 GA çubukları (örnek veri, Kenward-Roger). Çubuklar ortalamanın GA'sıdır, fark testinin değil.
Rapor cümlesi (örnek ayar):
Blok rastgele kesişimli doğrusal karma modelde (REML, Kenward-Roger sd) Victory çeşidinin verimi, Golden Rain ve Marvellous çeşitlerinin ortalamasından 9,52 birim düşük kestirildi; fark anlamlı değildi, t(64) = -1{,}64, p = 0{,}105, %95 GA [−21,09; 2,05]. Düzeltilmiş ortalamalar Victory 97,63, Golden Rain 104,50 ve Marvellous 109,79 idi (her biri SH 7,68).
26.8 Sık hatalar ve tuzaklar
- Düzey sırasını bilmeden katsayı girmek. Katsayılar arayüzdeki düzey sırasına uygulanır (verideki ilk görülme). Örnek veride
1, -0.5, -0.5Victory'yi karşılaştırır; Golden Rain'i karşılaştırmak için-0.5, 1, -0.5yazılır. Yanlış sayıda katsayı girildiğinde hata iletisi sırayı gösterir; çalıştırmadan önce konsoldaki "Fixed effects" satırlarından da okunabilir. - Ondalık virgülle katsayı yazmak.
-0,5iki sayıya bölünür; katsayılar nokta ile yazılır. - Tasarımı modelden eksik kurmak. Örnek veri bölünmüş parsel denemesidir: çeşit ana parsele, azot alt parsele uygulanmıştır. Şablonun modeli ana parsel hatasını (blok içinde çeşit) ve azotu dışarıda bırakır; çeşit farkının SH'si 6,685 (sd 64) çıkar. Tasarıma uygun model
verim ~ cesit * azot + (1 | blok/cesit)ile aynı fark için SH 7,079, sd 10 ve Victory − Marvellous için Holm p=0{,}349 (şablonda 0,220) bulunur (r_dogrulama.R). Şablon tek faktör + tek rastgele kesişim içindir; bölünmüş parsel denemesi için temel programdaki Karma Desen (Bölünmüş Parsel) ANOVA kullanılır ya da şablon kodu düzenlenir. - Fixed effects tablosundaki t'yi test sanmak. lme4 sd ve p vermez; kontrast tablosundaki Kenward-Roger testi kullanılır.
- Doğrusal birleşimi kontrast gibi yorumlamak. Katsayı toplamı sıfır değilse blok varyansı sonuca girer; (1{,}1{,}1) için sd 5'e düşer. Şablon bunu not olarak yazar.
- Kontrole karşı seçeneğinde kontrolü yanlış bilmek. Kontrol her zaman ilk düzeydir; başka bir düzey için verinin satır sırası ya da düzey tanımı değiştirilir.
- REML'i kapatıp Kenward-Roger'ı açık bırakmak. Kenward-Roger REML için tanımlıdır; ML ile birlikte bu örnekte SH'ler REML değerinde, sd'ler 13,75 ve 68,06 çıkar ve hiçbir tutarlı yöntemle örtüşmez. ML gerekiyorsa sd yöntemi Satterthwaite ya da asimptotik seçilir.
- Büyük veride Kenward-Roger beklemek. 3000'den çok gözlemde emmeans sd düzeltmesini kapatır ve asimptotik z'ye geçer; konsoldaki "Degrees-of-freedom method" satırı ve tablodaki
df = Infbunu gösterir. Bu büyüklükte t ile z arasındaki fark çoğu zaman önemsizdir, ama grup sayısı azsa önemli olabilir. - Ortalama GA'larının örtüşmesinden fark yokluğu çıkarmak. Şekil 26.1'deki çubuklar blok varyansını da taşır; farkın SH'si (6,69) daha küçüktür.
26.9 Uzman soruları
S1. Kenward-Roger burada neden Satterthwaite ile aynı sonucu veriyor?
Tasarım dengeli ve model tek rastgele kesişimli. Bu durumda sabit etkilerin kovaryans matrisi kareler ortalamalarının doğrusal birleşimidir; KR'nin küçük örneklem düzeltmesi SH'yi değiştirmez ve moment eşlemesi Satterthwaite'in sd'sine iner. Doğrulama tablosunda KR değerleri (SH 7,680866; sd 8,869881) kapalı Satterthwaite formülüyle 4\times10^{-8} içinde aynıdır. Dengesiz veride ya da birden çok varyans bileşeninde KR SH'yi büyütür ve sd'ler ayrışır.
S2. Düzeltilmiş ortalamanın sd'si 8,87 iken farkların sd'si neden 64?
Ortalamanın varyansı blok bileşenini taşır: (\mathrm{KO}_b+2\mathrm{KO}_e)/72; bunun %75'i yalnız 5 sd'li blok kareler ortalamasından gelir ve Satterthwaite sd'si 5 ile 64 arasında, 5'e yakın çıkar. Toplamı sıfır olan bir kontrastta aynı bloklar birbirini götürür; varyans yalnız \mathrm{KO}_e'ye bağlıdır ve sd hatanın sd'si olan 64'tür.
S3. ML seçilince farkların sd'si neden 66?
ML artık varyansı \mathrm{KT}_e/66'dır (66=N-b): sabit etkilerin harcadığı a-1=2 sd düşülmez. Toplamı sıfır olan kontrastın varyansı yalnız bu kestiriciye bağlı olduğundan Satterthwaite sd'si de kestiricinin paydasına, 66'ya eşit çıkar (tabloda 66,0000000). REML'de payda ve sd 64'tür. Küçük örneklemde fark büyür; karma model karşılaştırmaları REML ile yapılır, ML yalnız sabit etkileri farklı modellerin olabilirlik oranı karşılaştırması için gereklidir.
S4. Holm seçildiğinde GA'lar neden Bonferroni genişliğinde?
Holm adımsal bir p düzeltmesidir; eşzamanlı güven bölgesi tanımlamaz. emmeans bu durumda GA'ları Bonferroni çarpanıyla (t_{1-\alpha/(2m),\,\nu}=2{,}4585) kurar. Bu yüzden Holm'da bir fark "p<0{,}05" çıkıp GA'sı sıfırı içerebilir; rapor p ile GA'yı ayrı ayrı yorumlar.
S5. Kontrole karşı ailede Tukey seçilirse ne olur?
Tukey yalnız tüm ikili karşılaştırma ailesi için tanımlıdır. emmeans bunu Šidák'a çevirir: örnek veride p=1-(1-0{,}30764)^2=0{,}52064 ve 1-(1-0{,}07345)^2=0{,}14150. Konsol "sidak method for 2 tests" der; şablonun özet satırı seçimi ("tukey") yazar. Kontrole karşı ailede doğru seçim Dunnett'tir.
S6. "Dunnett (yaklaşık)" ne kadar yaklaşık?
dunnettx, Dunnett'in çok değişkenli t olasılığını hızlı bir yaklaşıkla hesaplar. Asimptotik sd ile örnek veride 0,48626 ve 0,12645 verir; çok değişkenli normal olasılığın sayısal integrali (korelasyon 0,5; mvtnorm) 0,48358 ve 0,12309'dur. Fark üçüncü ondalıktadır; karar sınırına yakın bir p'de kesin hesap tercih edilir.
S7. Katsayıların toplamı sıfır değilse emmeans ne hesaplar?
Doğrusal birleşimi \sum c_i\mu_i hesaplar ve test eder; yalnız adı "kontrast" değildir. Varyans artık blok bileşenini içerir. (1{,}1{,}1) örneğinde \operatorname{Var}=\mathrm{KO}_b/8=396{,}88, SH 19,92 ve sd tam 5'tir (yalnız blok kareler ortalaması). Şablon toplamın sıfırdan farkını 10^{-8} eşiğiyle denetler ve not yazar.
S8. Grup varyansı sıfır kestirilirse sonuçlar neye döner?
lme4 sınırda \hat\sigma_b^2=0 verir ve şablon tekil uyum uyarısı yazar (satır 91); çalıştırma durmaz. Kestirimler, gruplamanın hiç olmadığı modelinkine iner: düzeltilmiş ortalamaların varyansı \hat\sigma^2/(N/a) olur. Dengeli tasarımda bu, \mathrm{KO}_b\le\mathrm{KO}_e durumudur (26.4.1). Grup etkisi tasarımın parçasıysa modelde tutulur; uyarı, verinin bu etkiyi kestirmeye yetmediğini söyler.
26.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Dunnett, C. W. (1955). A multiple comparison procedure for comparing several treatments with a control. Journal of the American Statistical Association, 50(272), 1096–1121. https://doi.org/10.1080/01621459.1955.10501294
- Halekoh, U., & Højsgaard, S. (2014). A Kenward-Roger approximation and parametric bootstrap methods for tests in linear mixed models: The R package pbkrtest. Journal of Statistical Software, 59(9), 1–32. https://doi.org/10.18637/jss.v059.i09
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Kenward, M. G., & Roger, J. H. (1997). Small sample inference for fixed effects from restricted maximum likelihood. Biometrics, 53(3), 983–997. https://doi.org/10.2307/2533558
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means (R package version 2.0.4). https://doi.org/10.32614/CRAN.package.emmeans
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Searle, S. R., Speed, F. M., & Milliken, G. A. (1980). Population marginal means in the linear model: An alternative to least squares means. The American Statistician, 34(4), 216–221. https://doi.org/10.1080/00031305.1980.10483031
- Yates, F. (1935). Complex experiments. Supplement to the Journal of the Royal Statistical Society, 2(2), 181–223. https://doi.org/10.2307/2983638