87. QTL Aralık Haritalama
Şablon kimliği: qtl_haritalama · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/qtl_haritalama.R (satır 1–309; üstbilgi 1–126) · Örnek veri: _ornek/qtl_fake_bc.csv · Paketler: qtl 1.74
87.1 Ne işe yarar
Şablon, deneysel bir çaprazlamada "bu nicel özelliği etkileyen lokuslar (QTL, quantitative trait locus) genomun neresinde?" sorusunu cevaplar. İki kendilenmiş ebeveynin melezinden türetilen bir popülasyonda (geri melez, F2, rekombinant kendilenmiş hat, çift haploit) her bireyin her markerdeki genotipi hangi ebeveynden geldiğini gösterir. Genom, markerlerin arasındaki konumlar da dahil olmak üzere adım adım taranır ve her konumda tek QTL'li model, QTL'siz modelle karşılaştırılır:
- y_i: bireyin fenotipi; g_i(\ell): bireyin \ell konumundaki (çoğu kez gözlenmeyen) genotipi; \varepsilon_i\sim N(0,\sigma^2).
- L_1(\ell): \ell konumunda bir QTL bulunan modelin, L_0: QTL'siz modelin en büyük olabilirliği.
- LOD 3: veri, QTL'li model altında QTL'siz modele göre 1000 kat daha olasıdır.
Çıktı beş parçadır: kromozom başına en yüksek LOD ve genom boyu anlamlılığı; permütasyonla bulunan LOD eşiği; anlamlı her QTL için konum aralığı; anlamlı QTL'lerin birlikte kurulduğu çok QTL'li model (açıklanan varyans ve etkiler); isteğe bağlı iki QTL'li tarama.
Ne zaman kullanılır? İki ebeveynli deneysel çaprazlamalarda, bir bağlantı haritası (markerlerin kromozom ve santimorgan konumu) eldeyken. Bu tasarımda bağlantı dengesizliği yalnız yakın akrabalıktan değil doğrudan rekombinasyondan geldiği için birkaç yüz birey ve yüz kadar marker büyük etkili lokusları bulmaya yeter; karşılığında konum çözünürlüğü kabadır (onlarca cM).
Ne zaman kullanılmaz?
- Doğal popülasyon, çeşit koleksiyonu ya da akrabalığı bilinmeyen bireyler:
gwas. Orada markerler arası konumlar taranmaz, akrabalık karma modelle düzeltilir. - Dört yollu çaprazlama, ileri geri melez kuşakları, çok ebeveynli popülasyonlar: desteklenmez (şablon durur).
- İkili ya da sayım türünde fenotip: yalnız normal model kurulur; ikili özellik için
vaka_kontrol_genetikya da tek marker lojistik regresyonu düşünülür. - Bağlantı haritasının kendisinin kurulması (marker sırası, rekombinasyon kestirimi): şablon haritayı girdi olarak alır.
- Yalnız iki marker arasındaki bağlantı dengesizliği:
bag_dengesizligi. - Amaç lokus bulmak değil genetik değeri kestirmekse:
genomik_seleksiyon.
Temel programla ilişki. Temel programda karşılığı yoktur. Tek bir markerin genotip sınıflarını karşılaştırmak (marker regresyonu) temel programın tek yönlü varyans analiziyle yapılabilir; aralık haritalaması, eşik ve aralıklar yalnız bu şablondadır.
87.2 Şablonun girdileri
Form, üstbilgideki on altı [[param]] bloğundan kurulur (qtl_haritalama.R:11–125).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Fenotip · fenotip |
sayısal sütun · Değişkenler | ilk sayısal sütun | fenotip sütunu | Taranan özellik (132, 197). |
Eklemeli ortak değişkenler · ortak_degiskenler |
sütunlar (sayısal) · Değişkenler | boş | fenotip sütunları | Her modelde sabit terim olarak yer alır (133, 200). |
Haritalama yöntemi · yontem |
seçim · Model | hk |
hk, ehk, mr, em |
scanone(method =) (205–206). |
Hesap adımı (cM) · adim |
ondalık · Gelişmiş | 2,5 | 0,5–20 | Markerler arasına eklenen konumların aralığı (203). |
Genotipleme hatası olasılığı · hata_olasiligi |
ondalık · Gelişmiş | 0,0001 | 0–0,2 | Gizli Markov modelinin gözlem hatası (203). |
Permütasyon sayısı · n_perm |
tam sayı · Seçenekler | 500 | 0–10000 | 0 ise sabit eşik kullanılır (208–215). |
Genom boyu anlamlılık düzeyi · alfa |
ondalık · Seçenekler | 0,05 | 0,001–0,5 | Eşik, permütasyon dağılımının 1-\alpha kantilidir (213). |
Sabit LOD eşiği · sabit_esik |
ondalık · Seçenekler | 3 | 0,5–20 | Yalnız n_perm = 0 iken (210). |
QTL güven aralığı · aralik |
seçim · Seçenekler | lod |
lod, bayes |
LOD düşüş ya da Bayes aralığı (245–246). |
LOD düşüşü · lod_dusus |
ondalık · Seçenekler | 1,5 | 0,5–3 | lodint(drop =) (246). |
Bayes aralığı olasılığı · bayes_olasilik |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | bayesint(prob =) (245). |
İki QTL'li tarama · iki_qtl |
onay · Seçenekler | kapalı | açık / kapalı | scantwo ve grafiği (296–308). |
Çaprazlama türü · capraz |
seçim · Değişkenler | otomatik |
otomatik, bc, f2, riself, risib, dh |
read.cross(crosstype =); otomatikte genotip kodlarından çıkarılır (175, 179). |
Genotip kodları · genotipler |
metin · Değişkenler | A,H,B,D,C |
virgülle ayrılmış beş kod | read.cross(genotypes =) (155, 179). |
Harita fonksiyonu · harita_fonksiyonu |
seçim · Model | haldane |
haldane, kosambi, c-f, morgan |
cM uzaklığının rekombinasyon oranına çevrilmesi (204). |
Aralıkları markerlere genişlet · marker_genislet |
onay · Çıktı | kapalı | açık / kapalı | Aralık uçları en yakın dış markere taşınır (245–246). |
Örnek ayar (ornek_param, satır 9): fenotip = pheno1; öteki alanlar varsayılandadır.
Veri biçimi. Şablon R/qtl'nin tek tablolu "csv" biçimini okur. Başlık satırı fenotip ve marker adlarını taşır; başlığın altındaki birinci veri satırı her markerin kromozomunu, ikinci veri satırı konumunu (cM) verir; fenotip sütunlarında bu iki hücre boştur. Sonraki her satır bir bireydir. Bir sütunun fenotip mi marker mı olduğuna yalnız birinci satırdaki hücresine bakılarak karar verilir (satır 138–141): boşsa fenotip, doluysa marker.
Genotip kodlarının sırası R/qtl'nin sırasıdır ve beş kod birden verilir: birinci ebeveyn gibi homozigot (AA), heterozigot (AB), ikinci ebeveyn gibi homozigot (BB), BB olmayan (AA ya da AB; baskın markerde A alelinin görüldüğü durum) ve AA olmayan (AB ya da BB). Varsayılan kodlarla D "BB değil", C "AA değil" demektir. Eksik genotip - ya da boş hücredir.
Dördüncü ve beşinci kodun anlamı
Formdaki etiket ve ilgili hata iletisi beş kodu R/qtl'nin sırasıyla ("AA, AB, BB, BB değil, AA değil") adlandırır: dördüncü kod "BB değil" (AA ya da AB), beşinci kod "AA değil" (AB ya da BB) anlamındadır ve hesap buna göre yapılır. Varsayılan A,H,B,D,C dizisi bu sıradadır. Baskın markerler için kendi kodlarını yazan kullanıcı sırayı R/qtl'ye göre verir: dördüncü sıraya "A aleli görüldü" (BB değil), beşinci sıraya "B aleli görüldü" (AA değil) kodu yazılır.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 129 |
| qtl paketi kurulu değil | "Bu şablon qtl (R/qtl) paketini gerektirir." | 130 |
| Tabloda 5'ten az satır | "… en az 2 harita satırı ve 3 birey gerekli." | 131 |
| Fenotip ortak değişken olarak da seçilmiş | "Fenotip ortak değişken olarak da seçilemez." | 134 |
| Birinci satırı dolu sütun yok | "Marker bulunamadı: … ilk satır markerlerin kromozomunu, ikinci satır konumunu (cM) taşımalı …" | 142 |
| Seçilen fenotipin birinci satır hücresi dolu | "'…' fenotip sütunu olarak tanınmadı" | 144 |
| Ortak değişken bir marker sütunu | "Ortak değişkenler fenotip sütunlarından seçilmeli" | 145 |
| Konum satırında sayı olmayan hücre | "Konum satırında sayısal olmayan ya da boş değer var (ör. marker '…': '…')" | 147 |
| Fenotipte 3'ten az gözlem; varyans yok | "Fenotipte en az 3 gözlem gerekli." / "Fenotipte varyans yok …" | 151–152 |
| Kod sayısı beş değil | "Genotip kodları virgülle ayrılmış beş kod olmalı …" | 156 |
| Tanınmayan genotip kodu | "Genotip kodu tanınmadı: …. Geçerli kodlar: …" | 160 |
| Bütün genotipler eksik | "Bütün markerlerde genotip eksik." | 164 |
| R/qtl veriyi okuyamadı | "R/qtl veriyi okuyamadı: …" | 182 |
| Desteklenmeyen çaprazlama türü | "Bu çaprazlama türü şablonda desteklenmiyor …" | 190 |
| Tarama hata verdi | "scanone çalıştırılamadı: …" | 207 |
Notlar (durdurmaz): genotipi bütünüyle eksik markerler (195); tek kromozom (196); ortak değişkeni eksik bireyler (201); eşiği aşan QTL yok (240); tanımlanamayan etki parametreleri (270); iki QTL'li taramada eşiği aşan çift yok (302). Aynı konumdaki markerler için konumlar ayrılır ve sayıları yazılır (188); fenotipi eksik bireyler taramadan çıkarılır, kaç birey çıkarıldığı ve kaç bireyin çözümlendiği yazılır (199); konsol başlığındaki birey sayısı dosyadaki sayıdır.
87.3 Örnek veri
Dosya: _ornek/qtl_fake_bc.csv. R/qtl paketiyle dağıtılan benzetim verisi fake.bc (Broman ve ark., 2003): 400 bireyli bir geri melez, fare genomunun 19 otozomu üzerinde 91 marker. Fenotipler benzetimle üretilmiştir; veri iki fenotip ve iki ortak değişken (sex, age) taşır.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
pheno1 |
Fenotip | sayısal | 400 gözlem; ortalama 6,196. |
pheno2 |
İkinci fenotip | sayısal | 400 gözlem. |
sex |
İsteğe bağlı ortak değişken | ikili | 0/1. |
age |
İsteğe bağlı ortak değişken | sayısal | Sürekli. |
D1M430 … D19M117 |
Markerler | kategorik | 91 sütun; kromozom başına 2–11 marker; A 13 263, H 13 211, eksik 9926 hücre (%27,3). |
Marker sütunları harita satırları yüzünden karışık içeriklidir (kromozom numarası, konum, sonra harfler) ve veri sekmesinde kategorik görünür; bu beklenen durumdur. Geri melezde yalnız iki genotip vardır: A (AA) ve H (AB). Kromozom uzunlukları 27,4 cM (18.) ile 103,8 cM (1.) arasındadır.
Düzey sırası rol oynamaz: genotip kodlarının anlamı genotipler alanındaki sırayla belirlenir, verideki görülme sırasıyla değil. Bireylerin sırası LOD değerlerini değiştirmez; permütasyon eşiği ise bireylerin sırasına bağlıdır (aynı tohumla bile karıştırılmış veride farklı permütasyonlar oluşur).
Bu bölümde kullanılan çalıştırmalar (tohum 20261117): (1) örnek ayar; (2) tohum 7; (3) fenotip = pheno2; (4) yontem = em, ehk, mr; (5) ortak değişkenler sex, age; (6) aralik = bayes; lod_dusus = 1; marker_genislet açık; (7) n_perm = 0; alfa = 0,10; (8) adim = 1; harita_fonksiyonu = kosambi; hata_olasiligi = 0,01; (9) iki_qtl açık; (10) R/qtl'nin fake.f2 verisi (F2, X kromozomu); (11) türetilmiş veriler: karıştırılmış bireyler, eksik fenotipler, sayısal genotip kodları, aynı konumda iki marker, birebir aynı genotipli markerler, tek kromozom.
87.4 Yöntem: formüller ve hesap adımları
87.4.1 Harita fonksiyonu ve hesap ızgarası
Bağlantı haritası uzaklıkları santimorgan (cM) verir; iki konum arasındaki rekombinasyon oranı r harita fonksiyonuyla bulunur (d Morgan cinsinden, yani cM/100):
- Haldane: çaprazlamalar birbirinden bağımsızdır (girişim yok). Kosambi: yakın çaprazlamalar birbirini engeller (pozitif girişim); aynı d için daha büyük r verir. Carter–Falconer daha güçlü girişim varsayar; Morgan tam girişimdir.
- 10 cM için r: Haldane 0,0906; Kosambi 0,0987.
Her kromozomda hesap ızgarası, marker konumları ile kromozomun başından itibaren adim katlarındaki konumların birleşimidir; bir markerle çakışan kat ayrıca eklenmez. Örnekte 2,5 cM adımla 91 marker 472 konuma çıkar; 5. kromozomun ızgarası 0; 1,1; 2,2; 2,5; 3,3; 4,4; 5; 7,5; 9,8; 10; 10,9; 12,5; … biçimindedir.
Neden markerler arası konumlar?
QTL bir markerin üzerinde olmak zorunda değildir. İki marker arasındaki bir konumda bireyin genotipi gözlenmez, ama komşu markerlerden olasılığı hesaplanabilir. Yalnız markerlerde sınama yapmak (marker regresyonu) seyrek haritada QTL'nin etkisini küçümser ve konumunu en yakın markere yapıştırır; ayrıca genotipi eksik bireyleri o markerde dışarıda bırakır.
87.4.2 Genotip olasılıkları: gizli Markov modeli
Bir kromozom boyunca bireyin gerçek genotipleri bir Markov zinciri oluşturur; gözlenen marker genotipleri bu zincirin hatalı ve eksikli gözlemleridir. Izgaranın her konumu için genotip olasılığı ileri–geri algoritmasıyla bulunur:
- t_\ell(k',k): ardışık iki ızgara konumu arasında k' genotipinden k'ya geçiş olasılığı. Geri melezde aynı kalma 1-r, değişme r; F2'de AA→AA (1-r)^2, AA→AB 2r(1-r), AA→BB r^2, AB→AB (1-r)^2+r^2.
- e_\ell(k): gözlem olasılığı. Marker olmayan konumda ve eksik genotipte 1; gözlenen genotip k ile aynıysa 1-\epsilon, değilse \epsilon (F2'de öteki iki genotipin her biri için \epsilon/2). \epsilon =
hata_olasiligi. - Başlangıç olasılıkları: geri melezde (\tfrac12,\tfrac12), F2'de (\tfrac14,\tfrac12,\tfrac14).
Hata olmadığında ve iki komşu marker de gözlendiğinde geri melez için sonuç kapalı biçimdedir. Sol markere r_1, sağ markere r_2 uzaklıktaki bir konumda (r_{12} iki marker arası):
Neden iki komşu marker yetmiyor da bütün kromozom kullanılıyor?
Komşu markerlerden biri eksikse bilgi bir sonraki gözlenen markerden gelir; örnek veride genotiplerin dörtte birinden fazlası eksiktir. Ayrıca genotipleme hatası payı bırakıldığında, komşularıyla uyuşmayan tek bir genotip (iki yanında çok yakın çift rekombinasyon gerektiren) olası hata olarak değerlendirilir ve etkisi azaltılır. \epsilon=0 seçilirse gözlenen her genotip kesin sayılır.
Koddaki tercih
qtl::calc.genoprob(cr, step, error.prob, map.function) (satır 203–204); off.end = 0 (kromozom uçlarının ötesi taranmaz) ve stepwidth = "fixed" paketin varsayılanlarıdır. Veri, şablonun geçici bir csv dosyasına yeniden yazıp qtl::read.cross("csv", …, convertXdata = TRUE) ile okumasıyla R/qtl nesnesine dönüşür (167–182). Okuma sırasında paketin ürettiği iletiler ve uyarılar toplanır ama çıktıya yazılmaz. Aynı konumu paylaşan marker varsa şablon, R/qtl'nin önerisiyle qtl::jittermap çağırır: konumlar 10^{-6} cM'lik rastgele bir sapmayla ayrılır ve kaç marker için yapıldığı konsola yazılır (satır 185–189); aralık tablosunda konumlar üç ondalığa yuvarlanır (250–251). Bu sapma tohuma bağlıdır ama sonuçları pratikte değiştirmez (87.8).
87.4.3 LOD: dört yöntem
Haley–Knott regresyonu (hk, varsayılan). Bilinmeyen genotip göstergesi yerine olasılığı konur ve sıradan regresyon yapılır:
- \text{KT}_0: QTL'siz modelin (yalnız kesişim ve varsa ortak değişkenler) artık kareler toplamı; \text{KT}_1(\ell): \ell konumundaki olasılıklar eklendiğinde.
- Geri melezde tek bir açıklayıcı vardır (p_{i,\text{AB}}), F2'de iki (p_{i,\text{AB}}, p_{i,\text{BB}}).
- Normal modelde olabilirlik oranı kareler toplamlarının oranına indirgenir; formül bundan gelir.
Standart aralık haritalaması (em; Lander ve Botstein, 1989). Fenotip, genotip sınıflarının normal dağılımlarının karışımıdır; karışım ağırlıkları p_{ik}(\ell)'dir:
Olabilirlik EM algoritmasıyla en büyüklenir: her adımda bireyin her genotipe ait olma sonsal ağırlığı hesaplanır, sonra ortalamalar ve varyans bu ağırlıklarla güncellenir.
Genişletilmiş Haley–Knott (ehk; Feenstra ve ark., 2006). Haley–Knott regresyonunun ortalama modelini korur, ama genotip belirsizliğinin artık varyansı bireyden bireye değiştirdiğini de hesaba katar.
Marker regresyonu (mr). Yalnız marker konumlarında, o markerde genotipi gözlenen bireylerle genotip sınıflarının ortalamaları karşılaştırılır; her markerde birey sayısı farklı olabilir.
Neden Haley–Knott varsayılan?
Genotip bilgisi tam ya da tama yakınken dört yöntem aynı sonucu verir. Haley–Knott tek bir regresyondur, yinelemesizdir ve permütasyonlarla birlikte bile saniyeler sürer. Zayıf yanı, marker aralığı geniş ya da eksik genotip çokken artık varyansı olduğundan büyük saymasıdır; LOD biraz şişebilir. EM kuramsal olarak doğrudur ama yavaştır ve çok tepeli olabilirlikte yerel en büyüğe takılabilir. Örnekte 5. kromozomdaki tepe Haley–Knott ile 7,90, EM ile 7,76, genişletilmiş Haley–Knott ile 7,75, marker regresyonuyla 7,07'dir (en yakın markerde).
Koddaki tercih
qtl::scanone(cr, pheno.col, method, addcovar) (satır 206). Ortak değişkenler yalnız eklemeli olarak girer; QTL × ortak değişken etkileşimi (ör. cinsiyete özgü QTL etkisi) kurulmaz. Ortak değişkeni eksik bireyler çıkarılır. EM'in yineleme sınırı ve yakınsama toleransı paketin varsayılanlarıdır (4000 yineleme, 10^{-4}); yakınsamayan konum olursa paketin uyarısı çıktıya yansımaz.
87.4.4 Genom boyu eşik: permütasyon
Yüzlerce konum sınandığından tek bir konum için alışılmış anlamlılık sınırı yanıltıcıdır. Churchill ve Doerge (1994), sıfır hipotezi altındaki dağılımı verinin kendisinden üretir:
- Fenotipler bireyler arasında rastgele karıştırılır; genotipler yerinde kalır. Karıştırma, fenotip ile genotip arasındaki her ilişkiyi koparır, ama markerler arası bağlantıyı ve fenotipin dağılımını korur.
- Karıştırılmış fenotiple bütün genom taranır ve en yüksek LOD saklanır.
- Bu, B kez yinelenir.
- M_b: b. permütasyonda genom boyunca en yüksek LOD; Q_{1-\alpha}: örneklem kantili (R'nin varsayılan tanımı).
- \text{LOD}_c: c kromozomundaki en yüksek LOD; p_{\text{genom}}: bu kadar ya da daha yüksek bir tepenin genomun herhangi bir yerinde rastlantıyla çıkma olasılığı.
- Ortak değişken varsa fenotip ve ortak değişkenler birlikte karıştırılır.
Neden sabit LOD 3 yerine permütasyon?
LOD 3, insan bağlantı çözümlemesinden kalma bir alışkanlıktır. Doğru eşik genomun uzunluğuna, marker yoğunluğuna, çaprazlama türüne (serbestlik derecesi), birey sayısına ve fenotipin dağılımına bağlıdır. Örnekte 19 kromozomlu geri melez için %5 eşiği 2,51'dir; F2 örneğinde (iki serbestlik derecesi, 200 birey) otozomlar için 3,61. Permütasyon ayrıca fenotip normal dağılmasa da geçerlidir.
Tohum. Permütasyonlar rastgeledir. Şablon formunda tohum alanı yoktur; tohum Kod panelindeki Tohum alanından verilir (Bölüm 1.3). Alan boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar; kullanılan tohum künyeye ve betik adımına yazılır, betik yeniden oynatıldığında aynı tohum kullanılır (Bölüm 57). Örnekte 500 permütasyonla eşik tohum 20261117 ile 2,508, tohum 7 ile 2,536'dır. Eşiğe yakın bir tepenin anlamlılığı bu oynaklıktan etkilenir; böyle durumda permütasyon sayısı artırılır (1000 ve üstü).
X kromozomu. Veride X kromozomu ve en az bir otozom varsa şablon X'e özgü permütasyon ister (perm.Xsp, satır 212). X'te genotip sınıfı sayısı ve dolayısıyla serbestlik derecesi otozomlardan farklıdır; tek bir eşik X'te çok fazla ya da çok az yanlış pozitif verir (Broman ve ark., 2006). Otozomlar ve X ayrı ayrı permüte edilir ve genom boyu hata \alpha iki parçaya uzunlukla orantılı bölünür:
- L_A, L_X: otozomların ve X'in toplam harita uzunluğu; L=L_A+L_X.
- Otozom eşiği otozom permütasyonlarının 1-\alpha_A, X eşiği X permütasyonlarının 1-\alpha_X kantilidir.
- B_X: X için yapılan permütasyon sayısı. \alpha_X çok küçük olduğundan kantilin güvenilir kestirilmesi için daha çok permütasyon gerekir.
X kromozomlu veride süre ve p değerinin anlamı
fake.f2 verisinde L_A=979{,}2 cM, L_X=26{,}2 cM'dir: n_perm = 300 ile X için 11 212 permütasyon yapılır ve çalıştırma yaklaşık 40 saniye sürer; eşik tablosunda yazan permütasyon sayısı otozomlarınkidir. Bu düzende önce tepenin kendi kromozom türünün permütasyonlarına göre oranı p_{\text{tür}} bulunur, sonra genom boyuna çevrilir: p_{\text{genom}}=1-(1-p_{\text{tür}})^{L/L_{\text{tür}}}, L=L_A+L_X (R/qtl'nin summary.scanone(…, perms, pvalues = TRUE) dönüşümüyle aynı; satır 222–228). Otozomlarda fark küçüktür (p_{\text{tür}}=0{,}240\to p_{\text{genom}}=0{,}246). X'te büyüktür: rastgele bir fenotiple X kromozomunun tepesi için p_{\text{tür}}=0{,}386 iken p_{\text{genom}} 1'e çok yakındır. Sonuç anlamli sütunuyla tutarlıdır: eşiği aşmayan her satırda p_{\text{genom}}>\alpha.
Koddaki tercih
qtl::scanone(…, n.perm, perm.Xsp) ve summary(perms, alpha) (satır 212–214). Ortak değişkensiz Haley–Knott taramasında paket bütün permütasyonları tek geçişte hesaplar; ortak değişken varsa her permütasyon ayrı bir taramadır ve süre permütasyon sayısıyla orantılı artar. n_perm = 0 iken eşik sabit_esik değeridir ve p_genom sütunu tabloda yer almaz. Bir tepe eşiğe eşit ya da büyükse anlamlı sayılır (231). Hiçbir permütasyon tepeyi aşmamışsa p_{\text{genom}}=0 yazılır; bu "1/B'den küçük" olarak okunur.
87.4.5 Konum aralıkları
Tepe noktası QTL'nin konumunun nokta kestirimidir; belirsizliği iki yoldan biriyle verilir.
LOD düşüş aralığı. LOD'un tepe değerinden en çok d birim aşağıda kaldığı bölge:
Bayes aralığı. 10^{\text{LOD}(\ell)}, QTL konumunun (tek QTL ve düz önsel varsayımıyla) sonsal yoğunluğuyla orantılıdır:
- d =
lod_dusus; w_j: j. ızgara konumunun temsil ettiği genişlik (iki komşusuna uzaklıkların yarıları toplamı; uç konumlarda komşuya uzaklığın tamamı). - Aralık, seçilen konumların en küçüğü ile en büyüğü arasıdır.
marker_genisletaçıksa iki uç, dışarıdaki en yakın gerçek markere taşınır.
Neden 1,5 ve neden bir konum dışarı?
Olabilirlik oranı kuramına göre 1-LOD düşüşü yaklaşık %96,8'lik bir aralığa karşılık gelirdi, ama QTL konumu için düzenlilik koşulları sağlanmaz. Benzetimler, 1,5-LOD aralığının ve %95 Bayes aralığının geri melez ve F2'de gerçek konumu yaklaşık %95 oranında kapsadığını göstermiştir (Manichaikul ve ark., 2006). Izgara seyrek olduğundan LOD'un tam d kadar düştüğü nokta iki ızgara konumu arasındadır; aralık tutucu olsun diye bir sonraki konuma genişletilir.
Eşiği aşan QTL yoksa şablon, en yüksek LOD'lu kromozom için aralığı ve etkiyi yine verir ve bunun yalnız betimleyici olduğunu konsola yazar (satır 239–241). Aralıklar tek QTL'li taramadan hesaplanır; aynı kromozomda iki QTL varsa (örnekte 5. kromozomda 40 cM çevresindeki ikinci tümsek) aralık ikisini birlikte kapsayabilir. En yüksek LOD birden çok konumda birebir aynıysa (ör. genotipleri aynı markerlerde marker regresyonu) qtl::lodint alt uç, bütün tepeler ve üst uç olmak üzere ikiden fazla satır döndürür; şablon alt ve üst uç olarak ilk ve son satırı, tepe olarak özet tablosundaki ilk en yüksek konumu alır (satır 247–248).
87.4.6 Çok QTL'li model
Aralık tablosundaki tepe konumları birlikte tek bir modele konur (fitqtl, her zaman Haley–Knott):
- x_{iqk}: q. QTL'nin konumundaki genotip olasılıklarından kurulan açıklayıcılar; z_{ij} ortak değişkenler.
- Geri melezde açıklayıcı p_{i,\text{AB}}-\tfrac12'dir; katsayısı heterozigot ile homozigot arasındaki ortalama farktır. F2'de iki açıklayıcı vardır: eklemeli etki
a(iki homozigotun farkının yarısı) ve baskınlık etkisid(heterozigotun homozigotların ortasından sapması). - \text{KT}_0: yalnız kesişimli modelin, \text{KT}_{\text{tam}}: bütün terimlerin, \text{KT}_{(-q)}: q. terim çıkarılmış modelin artık kareler toplamı.
- \%\text{var}=100(1-\text{KT}_{\text{tam}}/\text{KT}_0) ile aynı şeydir: modelin R^2'si.
Neden tek QTL taramasının üstüne bir de bu model?
Tek QTL taramasında her QTL, ötekilerin açıkladığı varyans artık varyansta kalırken sınanır. Birlikte kurulan model her QTL'nin katkısını ötekiler hesaba katılmışken verir: bir terim çıkarıldığında LOD ne kadar düşüyor? Bağlı ya da aynı yönde etkili QTL'lerde bu değer tek QTL LOD'undan küçük, artık varyansı büyük ölçüde azaltan ortak değişkenler eklendiğinde büyük olabilir.
Koddaki tercih
qtl::makeqtl(cr, chr, pos, what = "prob") ve qtl::fitqtl(…, method = "hk", get.ests = TRUE, dropone = TRUE) (satır 256–259). Tarama yöntemi EM ya da marker regresyonu seçilmiş olsa da bu model Haley–Knott ile kurulur; tablo başlığı bunu belirtir. Ortak değişkenler modele girer ve bir terim çıkarma tablosunda kendi satırlarını alır. Tek bir QTL varsa bir terim çıkarma tablosu üretilmez. X kromozomunda QTL bulunan modellerde paket genotipleri cinsiyet ve çaprazlama yönüyle birlikte kodlar; standart hatası sonsuz ya da anlamsız büyük çıkan satırlar tablodan atılır ve sayısı konsola yazılır (268–273). Bu durumda otozomal QTL'lerin satırları da a/d yerine genotip göstergeleri (.2, .3: AB ve BB'nin AA'dan farkı) olarak adlandırılır. fitqtl hata verirse üç tablo sessizce atlanır (259–260).
87.4.7 İki QTL'li tarama
iki_qtl açıkken bütün konum çiftleri için iki QTL'li model kurulur (scantwo, Haley–Knott) ve beş LOD türetilir: tam model (iki QTL ve etkileşimleri), eklemeli model, etkileşim (ikisinin farkı) ve bunların en iyi tek QTL modeline göre koşullu biçimleri. Özet tablosuna yalnız Broman ve Sen'in (2009) fare genomu için önerdiği eşikleri aşan kromozom çiftleri yazılır: geri melezde 6,0; 4,7; 4,4; 4,7; 2,6 ve F2'de 9,1; 7,1; 6,3; 6,3; 3,3 (satır 298). Eşikler bu şablonda permütasyonla hesaplanmaz; genomu fareden çok farklı uzunlukta olan türlerde yalnız yol göstericidir. Örnekte eşikleri aşan çift yoktur.
87.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–126 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on altı parametre. | Form buradan kurulur (Bölüm 1.2). |
| 127–153 | Biçimin çözülmesi: kromozom ve konum satırları; marker ve fenotip sütunlarının ayrılması; fenotip denetimleri. | Ayrım yalnız birinci veri satırına göre (140–141). |
| 155–164 | Genotip kodları; tanınmayan kod ve bütünüyle eksik marker denetimi. | Boş hücre ve NA eksik sayılır. |
| 166–190 | Geçici csv dosyası; read.cross; çaprazlama türünün denetimi. |
Paketin okuma iletileri toplanır, yazılmaz. |
| 191–207 | Konsol başlığı; genotip olasılıkları; tek QTL taraması. | Başlıktaki birey sayısı dosyadaki sayıdır. |
| 208–236 | Permütasyon; eşikler; kromozom başına tepe tablosu ve eşik tablosu. | X varsa iki eşik; p_genom genom boyuna çevrilir (222–228). |
| 238–253 | Anlamlı QTL'ler (yoksa en yüksek tepe); aralıklar; en yakın marker. | Paketin aralık fonksiyonunun ilk üç satırı alt uç, tepe ve üst uç olarak okunur (247). |
| 255–278 | Çok QTL'li model: tam model, bir terim çıkarma, etkiler. | Her zaman Haley–Knott. |
| 280–295 | LOD profili ve en çok dört QTL için etki grafiği. | Etki grafiği yalnız tepeye en yakın gerçek marker için çizilir (290). |
| 296–308 | İki QTL'li tarama, özeti ve ısı haritası. | Sabit eşikler. |
hucre <- function(v) { s <- trimws(as.character(v)); s[is.na(s)] <- ""; s }
kr <- vapply(df, function(v) hucre(v)[1], "")
ko <- vapply(df, function(v) hucre(v)[2], "")
mk <- names(df)[nzchar(kr)]
fenler <- names(df)[!nzchar(kr)]
87.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bütün adımlar dogrulama/qtl_haritalama/elle_hesap.py ile, qtl paketi kullanılmadan, numpy ile yeniden kurulmuştur: csv çözümü, ızgara, ileri–geri algoritması (geri melez ve F2), Haley–Knott ve marker regresyonu, EM, permütasyonlar (R'nin rastgele sayı üreteci yeniden kurularak şablondakiyle aynı karıştırmalar), aralıklar ve çok QTL'li model. R tarafında (r_dogrulama.R) aynı adımlar yalnız taban R ile (lm.fit, set.seed, sample, quantile, lm, drop1) yinelenmiştir.
Adım 1 — Izgara. 91 marker, 19 kromozom; 2,5 cM adımla 472 konum. 5. kromozomda (10 marker, 62,3 cM) 34 konum vardır.
Adım 2 — Bir konumda genotip olasılığı. 5. kromozomda 17,5 cM, D5M197 (10,9 cM) ile D5M157 (24 cM) arasındadır. Haldane ile r_1=\tfrac12(1-e^{-2\cdot0{,}066})=0{,}061830, r_2=0{,}060952, r_{12}=0{,}115244. İki marker de H ise:
İkisi de A ise 0{,}004260; soldaki H, sağdaki A ise 0{,}4962; tersi 0{,}5038. İleri–geri algoritmasının verdiği değerler bunlara çok yakındır: 1. birey (H, H) için 0,995740, 2. birey (A, A) için 0,004260. Küçük farklar genotipleme hatası payından ve daha uzaktaki markerlerden gelir. Bu konumda bireylerin %81,5'inin olasılığı 0,01'in altında ya da 0,99'un üstündedir; kalanlarda komşu markerlerden en az biri eksiktir ya da iki marker arasında rekombinasyon vardır.
Adım 3 — Haley–Knott regresyonu. 400 bireyin pheno1 değeri bu olasılığa regresyona sokulur: \hat y=5{,}6791+1{,}0707\,p.
Bu konum 5. kromozomun tepesidir. Tek başına açıkladığı varyans 100\,(1-10^{-2\cdot7{,}9005/400})=\%8{,}69'dur.
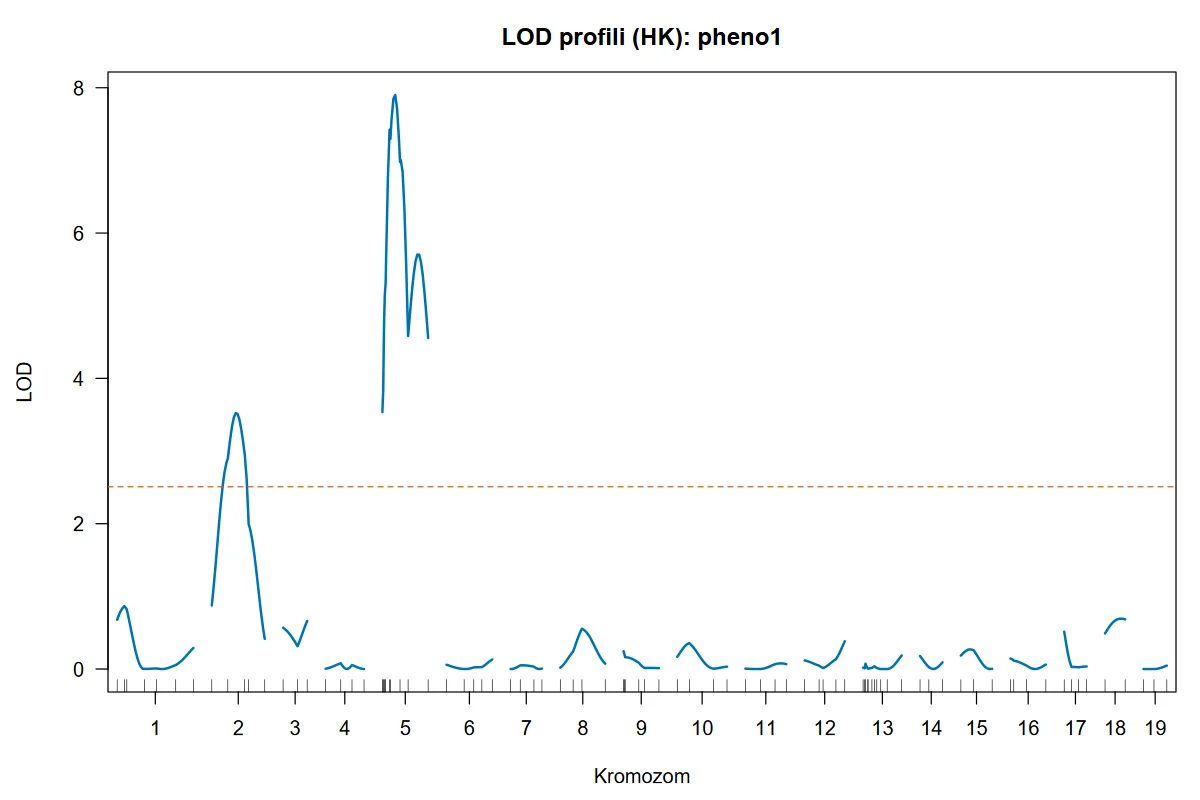
Adım 4 — Kromozom tepeleri. 2. kromozomda 32,5 cM'de LOD 3,5210; 5. kromozomda 17,5 cM'de 7,9005. Öteki 17 kromozomun tepeleri 0,05 ile 0,87 arasındadır.
Adım 5 — Permütasyon eşiği. Tohum 20261117 ile ilk üç permütasyonun genom boyu en yüksek LOD'ları 1,560; 1,112; 1,353'tür. 500 değerin ortalaması 1,497, en büyüğü 4,597, 0,95 kantili 2,5080'dir (0,90 kantili 2,2235). 500 permütasyonun 5'inde en yüksek LOD 3,521'i aşmıştır: 2. kromozom için p_{\text{genom}}=5/500=0{,}010. 5. kromozomun tepesini aşan permütasyon yoktur.
Adım 6 — Aralıklar. 5. kromozomda LOD'un 7{,}9005-1{,}5=6{,}4005'in üstünde kaldığı konumlar 7,5 ile 27,5 cM arasındadır; birer konum dışarı alınınca 1,5-LOD aralığı 5,0–30,0 cM olur. %95 Bayes aralığı 9,8–27,5 cM'dir. 2. kromozomda 1,5-LOD aralığı 10,0–50,2 cM (72 cM'lik kromozomun yarısından fazlası), Bayes aralığı 17,5–47,5 cM'dir: LOD 3,5'lik bir QTL'nin konumu ancak bu kadar belirlenir.
Adım 7 — Çok QTL'li model. x_1=p(2@32{,}5)-\tfrac12, x_2=p(5@17{,}5)-\tfrac12 ile \hat y=6{,}2133+0{,}6040\,x_1+0{,}9784\,x_2; standart hatalar 0,1867 ve 0,1742.
- kromozomdaki QTL çıkarılınca kareler toplamı 26,9076 artar: \text{LOD}_{(-1)}=2{,}2595, \%\text{var}=100\cdot26{,}9076/1147{,}669=2{,}34, F_{1,\,397}=10{,}46. 5. kromozomdaki için 81,0967; 6,6389; %7,07; F=31{,}53. İki QTL'nin birlikteki LOD'ları tek QTL taramasındakinden (3,52 ve 7,90) küçüktür: her biri ötekinin açıkladığı varyansın bir bölümünü paylaşır.
Adım 8 — Ortak değişkenler. sex ve age eklemeli ortak değişken yapıldığında artık varyans büyük ölçüde azalır ve tepeler yükselir: 2. kromozom 8,60 (30 cM), 5. kromozom 9,05, ayrıca 10. kromozomda 27,5 cM'de 6,45'lik yeni bir tepe. Eşik (200 permütasyon) 2,472'dir. Beş terimli model varyansın %63,0'ını açıklar (LOD 86,34).
87.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle okunmuştur. Permütasyon eşikleri ve p değerleri aynı tohumla (20261117; belirtilen yerde 7) bağımsız olarak yeniden üretilmiştir. "En büyük farklı LOD" satırları 19 kromozomun tepe değerleri üzerinden en kötü durumu gösterir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Örnek ayar: 2. kromozom en yüksek LOD | 3,52104434 | 3,52104434 | 3,52104434 | 2,6e−14 | ✓ |
| Örnek ayar: 2. kromozom tepe konumu (cM) | 32,5 | 32,5 | 32,5 | 0 | ✓ |
| Örnek ayar: 5. kromozom en yüksek LOD | 7,90047738 | 7,90047738 | 7,90047738 | 2,0e−14 | ✓ |
| Örnek ayar: 5. kromozom tepe konumu (cM) | 17,5 | 17,5 | 17,5 | 0 | ✓ |
| Örnek ayar: 19 kromozomda en büyük farklı LOD | 7,90047738 | 7,90047738 | 7,90047738 | 2,0e−14 | ✓ |
| Genom boyu LOD eşiği (500 permütasyon, \alpha=0{,}05) | 2,50798637 | 2,50798637 | 2,50798637 | 9,6e−15 | ✓ |
| Genom boyu p, 1. kromozom | 0,938 | 0,938 | 0,938 | 0 | ✓ |
| Genom boyu p, 2. kromozom | 0,01 | 0,01 | 0,01 | 0 | ✓ |
| Genom boyu p, 18. kromozom | 0,99 | 0,99 | 0,99 | 0 | ✓ |
| 1,5-LOD aralığı, 2. kromozom: alt sınır (cM) | 10 | 10 | 10 | 0 | ✓ |
| 1,5-LOD aralığı, 2. kromozom: üst sınır (cM) | 50,2 | 50,2 | 50,2 | 0 | ✓ |
| 1,5-LOD aralığı, 5. kromozom: alt sınır (cM) | 5 | 5 | 5 | 0 | ✓ |
| 1,5-LOD aralığı, 5. kromozom: üst sınır (cM) | 30 | 30 | 30 | 0 | ✓ |
| %95 Bayes aralığı, 2. kromozom: alt sınır (cM) | 17,5 | 17,5 | — | 0 | ✓ |
| %95 Bayes aralığı, 2. kromozom: üst sınır (cM) | 47,5 | 47,5 | — | 0 | ✓ |
| %95 Bayes aralığı, 5. kromozom: alt sınır (cM) | 9,8 | 9,8 | — | 0 | ✓ |
| %95 Bayes aralığı, 5. kromozom: üst sınır (cM) | 27,5 | 27,5 | — | 0 | ✓ |
| 1-LOD aralığı, 5. kromozom: alt sınır (cM) | 7,5 | 7,5 | — | 0 | ✓ |
| 1-LOD aralığı, 5. kromozom: üst sınır (cM) | 27,5 | 27,5 | — | 0 | ✓ |
| Çok QTL'li model: model kareler toplamı | 126,69000957 | 126,69000957 | 126,69000957 | 7,1e−15 | ✓ |
| Çok QTL'li model: hata kareler toplamı | 1020,97902272 | 1020,97902272 | 1020,97902272 | 2,2e−15 | ✓ |
| Çok QTL'li model: LOD | 10,15996882 | 10,15996882 | 10,15996882 | 6,3e−15 | ✓ |
| Çok QTL'li model: açıklanan varyans (%) | 11,03889763 | 11,03889763 | 11,03889763 | 6,9e−15 | ✓ |
| Çok QTL'li model: p (\chi^2) | 6,918810·10−11 | 6,918806·10−11 | — | 3,6e−17 | ✓ |
| Çok QTL'li model: p (F) | 8,245760·10−11 | 8,245765·10−11 | 8,245765·10−11 | 5,2e−17 | ✓ |
| 2@32,5 çıkarılınca: III. tip kareler toplamı | 26,90755187 | 26,90755187 | 26,90755187 | 2,0e−14 | ✓ |
| 2@32,5 çıkarılınca: LOD | 2,25949144 | 2,25949144 | 2,25949144 | 1,7e−14 | ✓ |
| 2@32,5 çıkarılınca: açıklanan varyans (%) | 2,34453933 | 2,34453933 | 2,34453933 | 2,1e−14 | ✓ |
| 2@32,5 çıkarılınca: F | 10,4627988 | 10,4627988 | 10,4627988 | 1,6e−14 | ✓ |
| 5@17,5 çıkarılınca: III. tip kareler toplamı | 81,09671498 | 81,09671498 | 81,09671498 | 1,6e−14 | ✓ |
| 5@17,5 çıkarılınca: LOD | 6,63892448 | 6,63892448 | 6,63892448 | 1,5e−14 | ✓ |
| 5@17,5 çıkarılınca: açıklanan varyans (%) | 7,06621096 | 7,06621096 | 7,06621096 | 1,6e−14 | ✓ |
| 5@17,5 çıkarılınca: F | 31,53384656 | 31,53384656 | 31,53384656 | 1,6e−14 | ✓ |
| Etki, kesişim: kestirim | 6,21331649 | 6,21331649 | 6,21331649 | 2,9e−16 | ✓ |
| Etki, kesişim: SH | 0,08023681 | 0,08023681 | 0,08023681 | 0 | ✓ |
| Etki, 2@32,5: kestirim | 0,60403819 | 0,60403819 | 0,60403819 | 1,9e−15 | ✓ |
| Etki, 2@32,5: SH | 0,18674133 | 0,18674133 | 0,18674133 | 5,8e−16 | ✓ |
| Etki, 5@17,5: kestirim | 0,97842486 | 0,97842486 | 0,97842486 | 1,8e−15 | ✓ |
| Etki, 5@17,5: SH | 0,17423645 | 0,17423645 | 0,17423645 | 5,6e−17 | ✓ |
| pheno2: 5. kromozom en yüksek LOD | 3,89862749 | 3,89862749 | 3,89862749 | 4,2e−14 | ✓ |
| pheno2: 5. kromozom tepe konumu (cM) | 9,8 | 9,8 | 9,8 | 0 | ✓ |
| pheno2: 2. kromozom en yüksek LOD | 1,91083373 | 1,91083373 | 1,91083373 | 3,5e−14 | ✓ |
| pheno2: 2. kromozom tepe konumu (cM) | 37,5 | 37,5 | 37,5 | 0 | ✓ |
| pheno2: LOD eşiği | 2,53623251 | 2,53623251 | 2,53623251 | 1,6e−14 | ✓ |
| Tohum 7: LOD eşiği | 2,53637747 | 2,53637747 | 2,53637747 | 6,5e−14 | ✓ |
| \alpha=0{,}10: LOD eşiği | 2,22352093 | 2,22352093 | — | 4,0e−15 | ✓ |
| Ortak değişken (sex, age): 2. kromozom en yüksek LOD | 8,59761096 | 8,59761096 | 8,59761096 | 7,2e−15 | ✓ |
| Ortak değişken (sex, age): 5. kromozom en yüksek LOD | 9,05153332 | 9,05153332 | 9,05153332 | 2,6e−15 | ✓ |
| Ortak değişken (sex, age): 10. kromozom en yüksek LOD | 6,44714018 | 6,44714018 | 6,44714018 | 9,2e−15 | ✓ |
| Ortak değişken: LOD eşiği (200 permütasyon) | 2,47212141 | 2,47212141 | 2,47212141 | 5,6e−15 | ✓ |
| Ortak değişken, çok QTL'li model: LOD | 86,33732067 | 86,33732067 | — | 1,6e−16 | ✓ |
| Ortak değişken, etki 2@30,0 | 0,73343351 | 0,73343351 | — | 3,4e−15 | ✓ |
| Ortak değişken, etki 5@17,5 | 0,69378677 | 0,69378677 | — | 1,6e−15 | ✓ |
| Ortak değişken, etki 10@27,5 | 0,80638925 | 0,80638925 | — | 0 | ✓ |
| Ortak değişken, etki sex | 1,69802439 | 1,69802439 | — | 1,3e−15 | ✓ |
| Ortak değişken, etki age | 0,10484342 | 0,10484342 | — | 2,4e−14 | ✓ |
| Marker regresyonu: 2. kromozom en yüksek LOD | 2,8402097 | 2,8402097 | — | 6,6e−15 | ✓ |
| Marker regresyonu: 5. kromozom en yüksek LOD | 7,0703474 | 7,0703474 | — | 1,5e−14 | ✓ |
| Marker regresyonu: 19 kromozomda en büyük farklı LOD | 7,0703474 | 7,0703474 | — | 1,5e−14 | ✓ |
| EM: 2. kromozom en yüksek LOD | 3,52039385 | 3,52039399 | — | 4,0e−8 | ✓ |
| EM: 5. kromozom en yüksek LOD | 7,76418129 | 7,76418129 | — | 4,9e−10 | ✓ |
| Adım 1 cM: 2. kromozom en yüksek LOD | 3,52516641 | 3,52516641 | — | 8,6e−15 | ✓ |
| Adım 1 cM: 5. kromozom en yüksek LOD | 7,90948465 | 7,90948465 | — | 1,0e−14 | ✓ |
| Adım 1 cM: 19 kromozomda en büyük farklı LOD | 0,07994916 | 0,07994916 | — | 2,1e−13 | ✓ |
| Kosambi: 2. kromozom en yüksek LOD | 3,52266833 | 3,52266833 | — | 4,9e−14 | ✓ |
| Kosambi: 5. kromozom en yüksek LOD | 7,90034187 | 7,90034187 | — | 5,6e−15 | ✓ |
| Kosambi: 19 kromozomda en büyük farklı LOD | 3,52266833 | 3,52266833 | — | 4,9e−14 | ✓ |
| Hata olasılığı 0,01: 2. kromozom en yüksek LOD | 3,42680814 | 3,42680814 | — | 3,8e−14 | ✓ |
| Hata olasılığı 0,01: 5. kromozom en yüksek LOD | 7,75081741 | 7,75081741 | — | 3,0e−14 | ✓ |
| Hata olasılığı 0,01: 19 kromozomda en büyük farklı LOD | 7,75081741 | 7,75081741 | — | 3,0e−14 | ✓ |
| 30 eksik fenotip: 5. kromozom en yüksek LOD | 8,27464775 | 8,27464775 | — | 1,3e−14 | ✓ |
| 30 eksik fenotip: LOD eşiği (200 permütasyon) | 2,47178353 | 2,47178353 | — | 3,2e−15 | ✓ |
| Satır sırası karıştırılmış veri: en büyük farklı LOD | 0,55509577 | 0,55509577 | — | 1,1e−13 | ✓ |
| Tek kromozom: LOD eşiği (100 permütasyon) | 1,35561284 | 1,35561284 | — | 3,2e−14 | ✓ |
| F2 (fake.f2): 1. kromozom en yüksek LOD | 5,11630433 | 5,11630433 | — | 1,9e−15 | ✓ |
| F2 (fake.f2): 1. kromozom tepe konumu (cM) | 27,5 | 27,5 | — | 0 | ✓ |
| F2 (fake.f2): 13. kromozom en yüksek LOD | 8,95208551 | 8,95208551 | — | 1,2e−14 | ✓ |
| F2 (fake.f2): 13. kromozom tepe konumu (cM) | 27,5 | 27,5 | — | 0 | ✓ |
| F2: 1,5-LOD aralığı, 13. kromozom: alt sınır (cM) | 18,63 | 18,63 | — | 0 | ✓ |
| F2: 1,5-LOD aralığı, 13. kromozom: üst sınır (cM) | 40 | 40 | — | 0 | ✓ |
Ölçütü karşılayan: 80/80. Python: gizli Markov modeli (ileri–geri), Haley–Knott ve marker regresyonu, EM, aralıklar ve çok QTL'li model numpy ile; permütasyonlar R'nin rastgele sayı üreteci yeniden kurularak şablondakiyle aynı sırada. R: aynı adımlar yalnız taban R ile (lm.fit, set.seed, sample, quantile, lm, drop1); qtl paketi kullanılmamıştır. EM satırlarında Python sütunu olabilirliği 10^{-12} toleransla yakınsatır; paketin duruş ölçütü 10^{-4}'tür ve fark bundan gelir.
87.7 Çıktıyı okuma
Örnek ayarın konsol metni:
QTL aralık haritalaması: çaprazlama bc, 400 birey, 19 kromozom, 91 marker; fenotip 'pheno1', yöntem HK, adım 2,5 cM
Tablolar (kısaltılmış; tohum 20261117):
Kromozom başına en yüksek LOD (HK); genom boyu eşik 500 permütasyon, α = 0,05
 kromozom  konum_cM       LOD  p_genom      esik  anlamli
        1      9.80  0.865951    0.938  2.507986    False
        2     32.50  3.521044    0.010  2.507986     True
        3     32.80  0.660857    0.992  2.507986    False
        4     20.70  0.079949    1.000  2.507986    False
        5     17.50  7.900477    0.000  2.507986     True
        …

LOD eşikleri
                          olcu       deger
 Genom boyu LOD eşiği (otozom)    2.507986
      Genom boyu LOD eşiği (X)         NaN
            Permütasyon sayısı  500.000000

QTL LOD düşüş aralıkları (1,5-LOD)
 kromozom  alt_cM  tepe_cM  ust_cM  LOD_tepe yakin_marker
        2      10     32.5    50.2  3.521044       D2M241
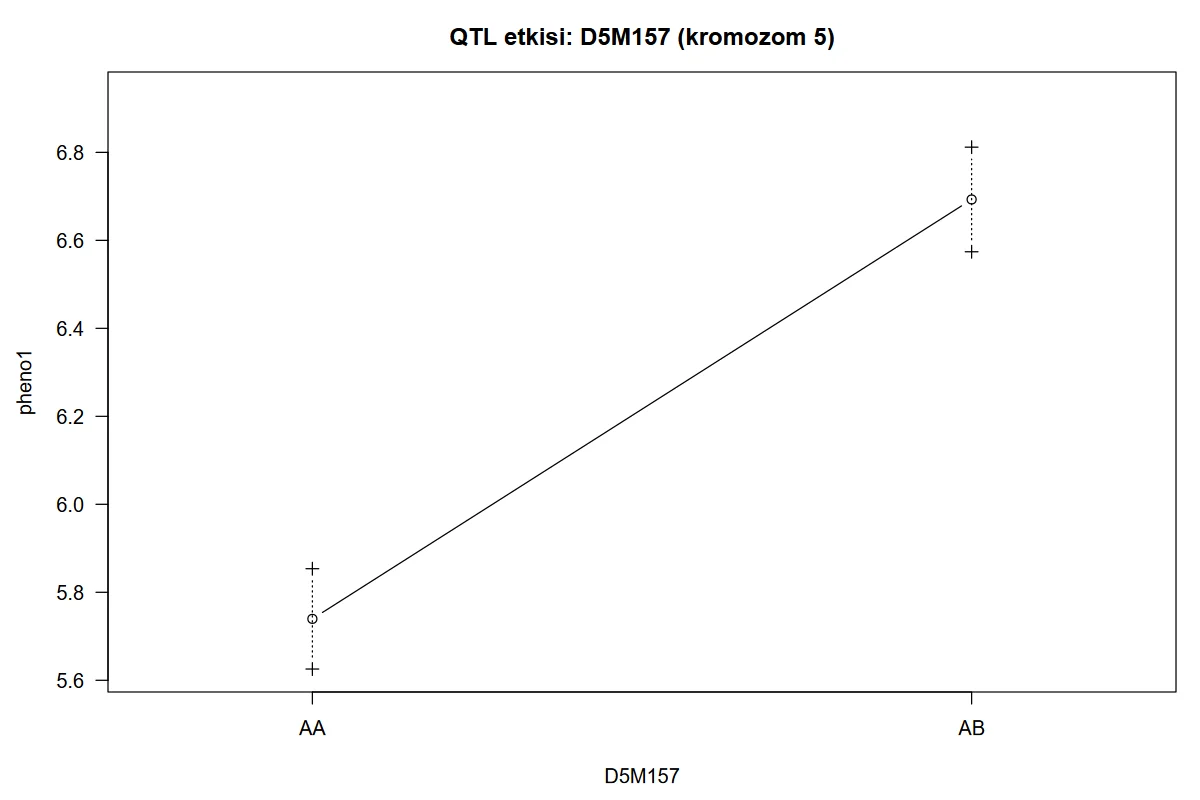
        5       5     17.5    30.0  7.900477       D5M157

Çok QTL'li model (fitqtl, Haley–Knott): bütün model
 kaynak   df           SS         MS        LOD       %var  Pvalue(Chi2)     Pvalue(F)
  Model    2   126.690010  63.345005  10.159969  11.038898  6.918810e-11  8.245760e-11
  Error  397  1020.979023   2.571736        NaN        NaN           NaN           NaN
  Total  399  1147.669032        NaN        NaN        NaN           NaN           NaN

QTL başına katkı (bir terim çıkarılınca LOD ve açıklanan varyans %)
  terim  df  Type III SS       LOD      %var    F value  Pvalue(Chi2)     Pvalue(F)
 2@32.5   1    26.907552  2.259491  2.344539  10.462799  1.256512e-03  1.320010e-03
 5@17.5   1    81.096715  6.638924  7.066211  31.533847  3.214749e-08  3.689585e-08

QTL etkileri (R/qtl kodlaması: a ve d eklemeli ve baskınlık etkisidir; '.2' ve '.3' sonekleri AB ve BB'nin AA'dan farkıdır; tahmin ve SH)
     terim       est        SE          t
 Intercept  6.213316  0.080237  77.437237
    2@32.5  0.604038  0.186741   3.234625
    5@17.5  0.978425  0.174236   5.615501
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
konum_cM, LOD |
Kromozomdaki en yüksek LOD ve yeri | Her kromozomdan yalnız bir tepe; aynı kromozomdaki ikinci QTL bu tabloda görünmez, LOD profilinden okunur. |
p_genom |
Tepeyi aşan permütasyonların oranı | Genom boyu anlamlılık. 0: hiçbir permütasyon aşmadı (<1/B). X'e özgü permütasyon varsa kromozom türünün oranı genom boyuna çevrilmiştir (87.4.4). |
esik, anlamli |
Kromozomun türüne uygun eşik; LOD \ge eşik | Karar bu sütundan okunur. |
| LOD eşikleri | Otozom ve X eşiği, permütasyon sayısı | X yoksa ikinci satır boş. |
alt_cM, tepe_cM, ust_cM |
Aralığın alt ucu, tepe, üst ucu | QTL'nin olası konum bölgesi; aday gen araması bu bölgede yapılır. |
yakin_marker |
Tepeye en yakın gerçek marker | Etki grafiği bu marker için çizilir; marker destekli seçilimde kullanılacak belirteç. |
| Bütün model | Kareler toplamları, LOD, %var, iki p |
%var: QTL'lerin (ve ortak değişkenlerin) birlikte açıkladığı fenotipik varyans payı. |
| QTL başına katkı | Terim çıkarılınca kayıp | Her QTL'nin ötekiler varken katkısı. Paylar toplamı %var'a eşit olmak zorunda değildir. |
| QTL etkileri | Katsayı, SH, t | Geri melezde heterozigotun homozigottan farkı (özelliğin biriminde). Anlamlı diye seçilmiş QTL'lerde yukarı yanlıdır. |
Şekil 87.1. Şablonun çizdiği LOD profili (örnek veri, `pheno1`, Haley–Knott). Kesikli çizgi permütasyon eşiğidir (2,51). 2. ve 5. kromozomdaki tepeler eşiği aşar; 5. kromozomda 40 cM çevresindeki ikinci tümsek aynı kromozomda ikinci bir lokusa işaret eder. Yatay eksendeki çentikler marker konumlarıdır.
Şekil 87.2. 5. kromozomdaki tepeye en yakın marker `D5M157` için genotip sınıflarının fenotip ortalaması ± standart hata. Heterozigotların (AB) ortalaması homozigotlarınkinden (AA) yaklaşık 0,95 birim yüksektir.
Rapor cümlesi (örnek ayar):
Geri melez popülasyonunda (n = 400; 19 kromozomda 91 marker) fenotip, Haley–Knott regresyonuyla 2,5 cM adımlarla tarandı; genom boyu %5 LOD eşiği 500 permütasyonla 2,51 bulundu. İki QTL saptandı: 2. kromozomda 32,5 cM'de (LOD 3,52; genom boyu p = 0{,}010; 1,5-LOD aralığı 10,0–50,2 cM) ve 5. kromozomda 17,5 cM'de (LOD 7,90; p < 0{,}002; aralık 5,0–30,0 cM). İki QTL'yi birlikte içeren model fenotipik varyansın %11,0'ını açıkladı; heterozigotların homozigotlara göre farkı sırasıyla 0,60 (SH 0,19) ve 0,98 (SH 0,17) idi.
87.8 Sık hatalar ve tuzaklar
- Harita satırlarını unutmak ya da yanlış yere koymak. Kromozom satırı başlığın hemen altında, konum satırı onun altında olmalıdır. Bir fenotip sütununun birinci satır hücresine yanlışlıkla bir değer yazılırsa sütun marker sayılır; bir markerin kromozom hücresi boş bırakılırsa fenotip sayılır ve genotipleri okunmaz.
- Aynı konumda birden çok marker. Gerçek haritalarda birlikte ayrılan markerler aynı cM değerini taşır. Şablon bunları 10^{-6} cM'lik bir sapmayla ayırır (R/qtl'nin
jittermapönerisi) ve sayısını konsola yazar; çok QTL'li model çalışır. Aralık ve tepe konumları bu sapma kadar (üç ondalığa yuvarlanmış tabloda görünmeyecek ölçüde) oynar; ayrı bir konum istenirse çakışan markerlerin konumu elle ayrılır ya da biri tablodan çıkarılır. - Baskın marker kodlarını R/qtl sırasının dışında yazmak. Dördüncü kod "BB değil", beşinci kod "AA değil" anlamındadır (87.2). Ters yazılan kodlar hata vermez; genotip olasılıkları yanlış ebeveyne göre hesaplanır.
- Çaprazlama türünü elle yanlış seçmek. Tür verideki kodlarla denetlenmez. Geri melez verisi
f2olarak çalıştırıldığında tarama iki serbestlik dereceli modelle yapılır ve LOD'lar değişir (örnekte 3,52 ve 7,90 yerine 3,64 ve 8,06). Emin değilsenizotomatikbırakılır ve konsol başlığındaki tür okunur. - Fenotipi eksik bireyleri saymak. Konsol başlığı dosyadaki birey sayısını yazar. 30 bireyin fenotipi silinmiş veride başlık yine "400 birey" der; tarama 370 bireyle yapılır, çok QTL'li model tablosunun toplam serbestlik derecesi (369) gerçek sayıyı gösterir ve konsola "fenotipi eksik 30 birey çözümlemeden çıkarıldı (çözümlenen birey sayısı 370)" notu yazılır (198–199).
- Sabit LOD 3 eşiğine güvenmek.
n_perm = 0hızlıdır ama eşik veriye uymaz: örnek geri melezde permütasyon eşiği 2,51, F2 örneğinde 3,61'dir. Sabit eşik yalnız ön inceleme içindir. - Az permütasyonla eşiğe yakın tepeyi yorumlamak. 500 permütasyonda %5 kantili en büyük 25 değere dayanır; tohumdan tohuma 0,03 LOD oynar. p_{\text{genom}} 0,03–0,08 aralığındaysa permütasyon sayısı artırılır.
- X kromozomlu veride süreyi ve
p_genomsütununu yanlış okumak. X için yapılan permütasyon sayısı L_A/L_X katıdır ve çalıştırma uzun sürer;p_genomkromozom türüne özgüdür (87.4.4). - Aralığı güven aralığı gibi daraltmak. 1,5-LOD aralığı onlarca cM olabilir; bu, yöntemin değil verinin sınırıdır. Daraltmak için daha çok birey ya da ilgili bölgede daha çok rekombinant gerekir, daha çok marker tek başına yetmez.
- Birebir aynı genotipli markerlerde marker regresyonu. İki ya da daha çok konum tam aynı en yüksek LOD'u verirse paketin aralık fonksiyonu her tepe için ayrı satır döndürür; şablon uçlar olarak ilk ve son satırı, tepe olarak özet tablosundaki ilk en yüksek konumu okur. Örnek veriden türetilen ve üç markerin (9,8; 10,9; 24 cM) genotipleri aynı yapılan veride tablodaki 1,5-LOD aralığı 4,4–35,01 cM'dir (tepe 9,8 cM, LOD 6,454); düşüş kuralının verdiği aralıkla aynıdır. Aynı veride Bayes aralığı 9,8–24 cM'dir; iki aralığın farkı yöntem farkıdır.
- Seçilmiş QTL'lerin etkisini ve açıkladığı varyansı olduğu gibi raporlamak. Eşiği aşan tepeler kısmen rastlantıyla yüksek çıkmış tepelerdir; etkileri ve
%vardeğerleri yukarı yanlıdır ("Beavis etkisi"), küçük örneklemde belirgin biçimde. - Ortak değişkenleri atlamak. Fenotipi güçlü etkileyen bir etken modelde yoksa artık varyans büyür ve QTL'ler kaçar: örnekte
sexveageeklenince 10. kromozomdaki QTL ortaya çıkar. Öte yandan QTL'nin kendisinden etkilenen bir ara değişken ortak değişken yapılırsa QTL'nin etkisi silinir. - İki QTL'li taramanın eşiklerini her türe uygulamak. Eşikler fare genomu içindir; başka türlerde
scantwopermütasyonu gerekir ve bu şablonda yoktur.
87.9 Uzman soruları
S1. Haley–Knott regresyonu ne zaman yanıltır?
Yöntem, bilinmeyen genotip yerine beklenen değerini koyar; ortalama modeli doğrudur, ama artıkların karışım dağılımını ve bireyden bireye değişen varyansını yok sayar. Genotip bilgisi azken (geniş marker aralığı, çok eksik genotip, seçici genotipleme) artık varyans olduğundan büyük kestirilir ve LOD, bilgi azlığı olan bölgelerde yapay tepeler gösterebilir. Örnek veride eksik oranı %27 olmasına karşın fark küçüktür (7,90 ve 7,76). Seçici genotiplemede (yalnız uç fenotipli bireylerin genotiplenmesi) Haley–Knott kullanılmaz; EM ya da genişletilmiş Haley–Knott seçilir.
S2. Permütasyon neden yalnız en yüksek LOD'u saklıyor?
Sınanan hipotez "genomun hiçbir yerinde QTL yok"tur ve test istatistiği genom boyu en büyük LOD'dur. Her permütasyonda en büyüğü almak, konumlar arası bağımlılığı (komşu konumların LOD'ları yüksek korelasyonludur) kendiliğinden hesaba katar; Bonferroni gibi bir düzeltme bu bağımlılığı bilmeden çok tutucu olurdu. Sonuç, aile bazında hata oranını denetleyen bir eşiktir: QTL'siz bir özellikte en az bir yanlış tepenin eşiği aşma olasılığı \alpha'dır.
S3. Ortak değişken varken permütasyon nasıl yapılıyor ve bu doğru mu?
Fenotip ve ortak değişkenler birlikte karıştırılır; yani her bireyin fenotip–ortak değişken ikilisi korunur, genotiple bağı koparılır. Bu, "ortak değişkenler hesaba katıldıktan sonra genotip fenotipi açıklamıyor" hipotezine uygundur. Yalnız fenotipin karıştırılması ortak değişken–fenotip ilişkisini de bozar ve eşiği yanlış kestirirdi. Ortak değişkenin genotiple ilişkili olduğu durumda (ör. cinsiyet ile X kromozomu) bu şema da tam değildir; tabakalı permütasyon gerekir ve şablonda yoktur.
S4. `p_genom = 0` ne demek? p değeri sıfır olabilir mi?
500 permütasyonun hiçbiri tepeyi aşmamıştır; söylenebilecek olan p<1/500'dür. Permütasyon p değerinin yansız olmayan ama geçerli kestiricisi (b+1)/(B+1)'dir ve hiçbir zaman sıfır vermez; şablon b/B yazar. Raporda "p<0{,}002" biçimi kullanılır. Daha küçük bir üst sınır için permütasyon sayısı artırılır.
S5. Bayes aralığı gerçekten Bayesçi mi?
Sınırlı anlamda. 10^{\text{LOD}} profil olabilirliktir: her konumda etki ve varyans en çok olabilirlik değerlerine sabitlenmiştir, üzerlerinden integral alınmamıştır. Konum üzerinde düz önsel ve kromozomda tam bir QTL varsayımıyla bu, yaklaşık bir sonsal dağılım verir. Benzetimlerde kapsaması iyi bulunmuştur; kuramsal bir güvence değil, deneysel olarak ayarlanmış bir kuraldır. Önyükleme (bootstrap) aralıkları bu sorun için kötü çalışır (Manichaikul ve ark., 2006) ve şablonda sunulmaz.
S6. Çok QTL'li modelde QTL konumları yeniden aranıyor mu?
Hayır. Konumlar tek QTL taramasının tepelerinde sabitlenir ve yalnız etkiler kestirilir. Öteki QTL'ler hesaba katıldığında bir QTL'nin en iyi konumu kayabilir; paketin konum inceltme ve ileri–geri model seçimi adımları şablonda çağrılmaz. Çok QTL'li tablodaki LOD'lar bu yüzden koşullu en iyi değerler değildir ve tek QTL taramasında görünmeyen (başka bir QTL tarafından maskelenen) lokuslar bulunmaz.
S7. Geri melezde etki neden "eklemeli etki" değil?
Geri melezde yalnız AA ve AB gözlenir; aralarındaki fark a+d ya da d-a'dır (hangi ebeveyne geri melezlendiğine göre) ve eklemeli ile baskınlık etkisi ayrılamaz. Tablo başlığı genel bir ifadedir; geri melezde est, heterozigot ortalaması eksi homozigot ortalamasıdır. İkisini ayırmak için F2 gerekir: orada a ve d satırları ayrı ayrı verilir.
S8. Hesap adımı sonucu ne kadar değiştirir?
Adım, LOD eğrisinin örneklenme sıklığıdır; yöntemi değiştirmez. Örnekte adım 2,5 cM'den 1 cM'ye indirildiğinde 5. kromozomun tepesi 17,5 cM'den 17,0 cM'ye, LOD 7,9005'ten 7,9095'e geçer. Aralık uçları ızgaraya bağlı olduğundan daha ince adım aralığı biraz daraltabilir. Permütasyon eşiği de ızgaraya çok az bağlıdır. 1–2,5 cM çoğu harita için yeterlidir; marker aralığı zaten 1 cM'nin altındaysa adım küçültmenin yararı yoktur.
S9. Genotipleme hatası olasılığını artırmak neyi değiştirir?
Model, komşularıyla çelişen genotipleri daha kolay "hata" sayar ve olasılıkları yumuşatır. Örnekte 0,0001'den 0,01'e çıkarıldığında tepeler 3,52'den 3,43'e ve 7,90'dan 7,75'e iner. Gerçek hata oranı yüksekken küçük bir değer kullanmak, hatalı genotiplerin yapay çift rekombinasyonlar olarak modele girmesine ve harita uzunluğuna uymayan olasılıklara yol açar; hatasız veride büyük bir değer kullanmak ise gerçek rekombinasyonları siler ve gücü düşürür.
87.10 Kaynaklar
- Broman, K. W., & Sen, Ś. (2009). A guide to QTL mapping with R/qtl. Springer. https://doi.org/10.1007/978-0-387-92125-9
- Broman, K. W., Sen, Ś., Owens, S. E., Manichaikul, A., Southard-Smith, E. M., & Churchill, G. A. (2006). The X chromosome in quantitative trait locus mapping. Genetics, 174(4), 2151–2158. https://doi.org/10.1534/genetics.106.061176
- Broman, K. W., Wu, H., Sen, Ś., & Churchill, G. A. (2003). R/qtl: QTL mapping in experimental crosses. Bioinformatics, 19(7), 889–890. https://doi.org/10.1093/bioinformatics/btg112
- Churchill, G. A., & Doerge, R. W. (1994). Empirical threshold values for quantitative trait mapping. Genetics, 138(3), 963–971. https://doi.org/10.1093/genetics/138.3.963
- Dempster, A. P., Laird, N. M., & Rubin, D. B. (1977). Maximum likelihood from incomplete data via the EM algorithm. Journal of the Royal Statistical Society: Series B, 39(1), 1–22. https://doi.org/10.1111/j.2517-6161.1977.tb01600.x
- Feenstra, B., Skovgaard, I. M., & Broman, K. W. (2006). Mapping quantitative trait loci by an extension of the Haley–Knott regression method using estimating equations. Genetics, 173(4), 2269–2282. https://doi.org/10.1534/genetics.106.058537
- Haley, C. S., & Knott, S. A. (1992). A simple regression method for mapping quantitative trait loci in line crosses using flanking markers. Heredity, 69(4), 315–324. https://doi.org/10.1038/hdy.1992.131
- Kosambi, D. D. (1943). The estimation of map distances from recombination values. Annals of Eugenics, 12(1), 172–175. https://doi.org/10.1111/j.1469-1809.1943.tb02321.x
- Lander, E. S., & Botstein, D. (1989). Mapping Mendelian factors underlying quantitative traits using RFLP linkage maps. Genetics, 121(1), 185–199. https://doi.org/10.1093/genetics/121.1.185
- Lander, E., & Kruglyak, L. (1995). Genetic dissection of complex traits: Guidelines for interpreting and reporting linkage results. Nature Genetics, 11(3), 241–247. https://doi.org/10.1038/ng1195-241
- Manichaikul, A., Dupuis, J., Sen, Ś., & Broman, K. W. (2006). Poor performance of bootstrap confidence intervals for the location of a quantitative trait locus. Genetics, 174(1), 481–489. https://doi.org/10.1534/genetics.106.061549
- Sen, Ś., & Churchill, G. A. (2001). A statistical framework for quantitative trait mapping. Genetics, 159(1), 371–387. https://doi.org/10.1093/genetics/159.1.371